Josvier Rodríguez y Emilio José George Rodríguez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)
Un proyecto final de grado que integra calidad de datos, optimización combinatoria, trazabilidad y apoyo a la toma de decisiones académicas.
En una universidad, un horario no es una simple cuadrícula de días y horas. Detrás de cada casilla existe una decisión que compromete la disponibilidad de un docente, la capacidad de un aula, la continuidad de una asignatura, la carga de una sección y la experiencia de cientos de estudiantes. Cuando esas decisiones se realizan con archivos dispersos, reglas implícitas y correcciones manuales, un cambio aparentemente pequeño puede producir choques de recursos, sobreocupaciones o secuencias académicas difíciles de justificar. La programación de horarios pertenece, por esa razón, a una familia de problemas combinatorios en la que la cantidad de alternativas crece con rapidez y donde obtener una propuesta válida requiere mucho más que acomodar materias en una semana [1]. En la práctica, una corrección tardía rara vez afecta una sola clase: puede obligar a mover otra sección, cambiar de espacio, alterar la jornada de un docente y comunicar una nueva versión a estudiantes y coordinadores. Esa propagación explica por qué la planificación necesita mecanismos preventivos, no únicamente capacidad de reaccionar cuando el conflicto ya fue publicado.
MOSAIC nació para responder a ese escenario desde la Escuela de Ingeniería en Computación y Telecomunicaciones de la Pontificia Universidad Católica Madre y Maestra. El proyecto fue desarrollado por Josvier Rodríguez y Emilio José George Rodríguez, bajo la asesoría de Rafael Omar Batista, como trabajo final de grado en Ciencias de la Computación. Su propósito no fue reemplazar a quienes planifican la oferta académica, sino construir una herramienta capaz de convertir datos institucionales en propuestas de horario verificables, comparables y explicables. El nombre identifica un motor analítico para propuestas de horarios universitarios: una plataforma que recibe archivos CSV o XLSX, prepara su estructura, mide el estado inicial, ejecuta un proceso de optimización y conserva evidencia de cada corrida. El desarrollo se situó en la intersección entre investigación operativa e ingeniería de software. Esa combinación permitió que las decisiones matemáticas no quedaran aisladas en un experimento, sino integradas a un flujo de carga, validación, ejecución, historial y exportación. El resultado es un artefacto académico que puede discutirse desde el algoritmo, la arquitectura y la utilidad institucional.
La pertinencia del proyecto se relaciona con la transformación digital que atraviesa la educación superior. Las universidades generan cada vez más datos sobre matrícula, asignaturas, infraestructura, modalidades y disponibilidad docente, pero disponer de información no garantiza que esta se convierta en una decisión útil. La literatura sobre instituciones universitarias digitales y analítica académica insiste en que el valor aparece cuando los registros se integran, se validan y se presentan de forma que apoyen el juicio humano [13]-[16]. MOSAIC adopta precisamente esa perspectiva: el algoritmo es importante, pero también lo son la calidad de entrada, la trazabilidad del proceso y la capacidad de explicar por qué una alternativa resulta factible o por qué no puede corregirse sin modificar una condición institucional. Este enfoque también responde a una necesidad regional: muchas instituciones latinoamericanas modernizan sus procesos mientras conviven con exportaciones tabulares, plataformas no interoperables y políticas que se aplican mediante conocimiento tácito. Una herramienta de apoyo debe tolerar esa realidad sin normalizarla de manera silenciosa; debe indicar qué datos faltan, cuáles fueron transformados y qué supuestos sostienen cada resultado [13], [16].
Cuando construir un horario deja de ser una cuadrícula
Este artículo presenta el recorrido del proyecto con una redacción orientada tanto a lectores técnicos como a personas vinculadas con la gestión académica. Primero se explica por qué la programación universitaria continúa siendo un problema abierto; luego se describe la metodología híbrida utilizada, la arquitectura del sistema y la forma en que se protegen la factibilidad y la reproducibilidad. Finalmente, se analizan los resultados con el mismo criterio utilizado en el informe final: separar lo que está implementado y verificado de aquello que todavía necesita validación institucional. Esa distinción es esencial porque un prototipo de investigación puede demostrar una base tecnológica sólida sin afirmar, de manera prematura, que ya está listo para operar a escala de campus. La promesa editorial y técnica es, por tanto, deliberadamente moderada. El artículo no presenta la automatización como una respuesta universal ni convierte una demostración en una adopción institucional. Expone cómo se construyó la solución, qué evidencia respalda cada afirmación y cuáles decisiones todavía pertenecen a las autoridades académicas. Esa honestidad fortalece, en lugar de debilitar, el aporte del proyecto.
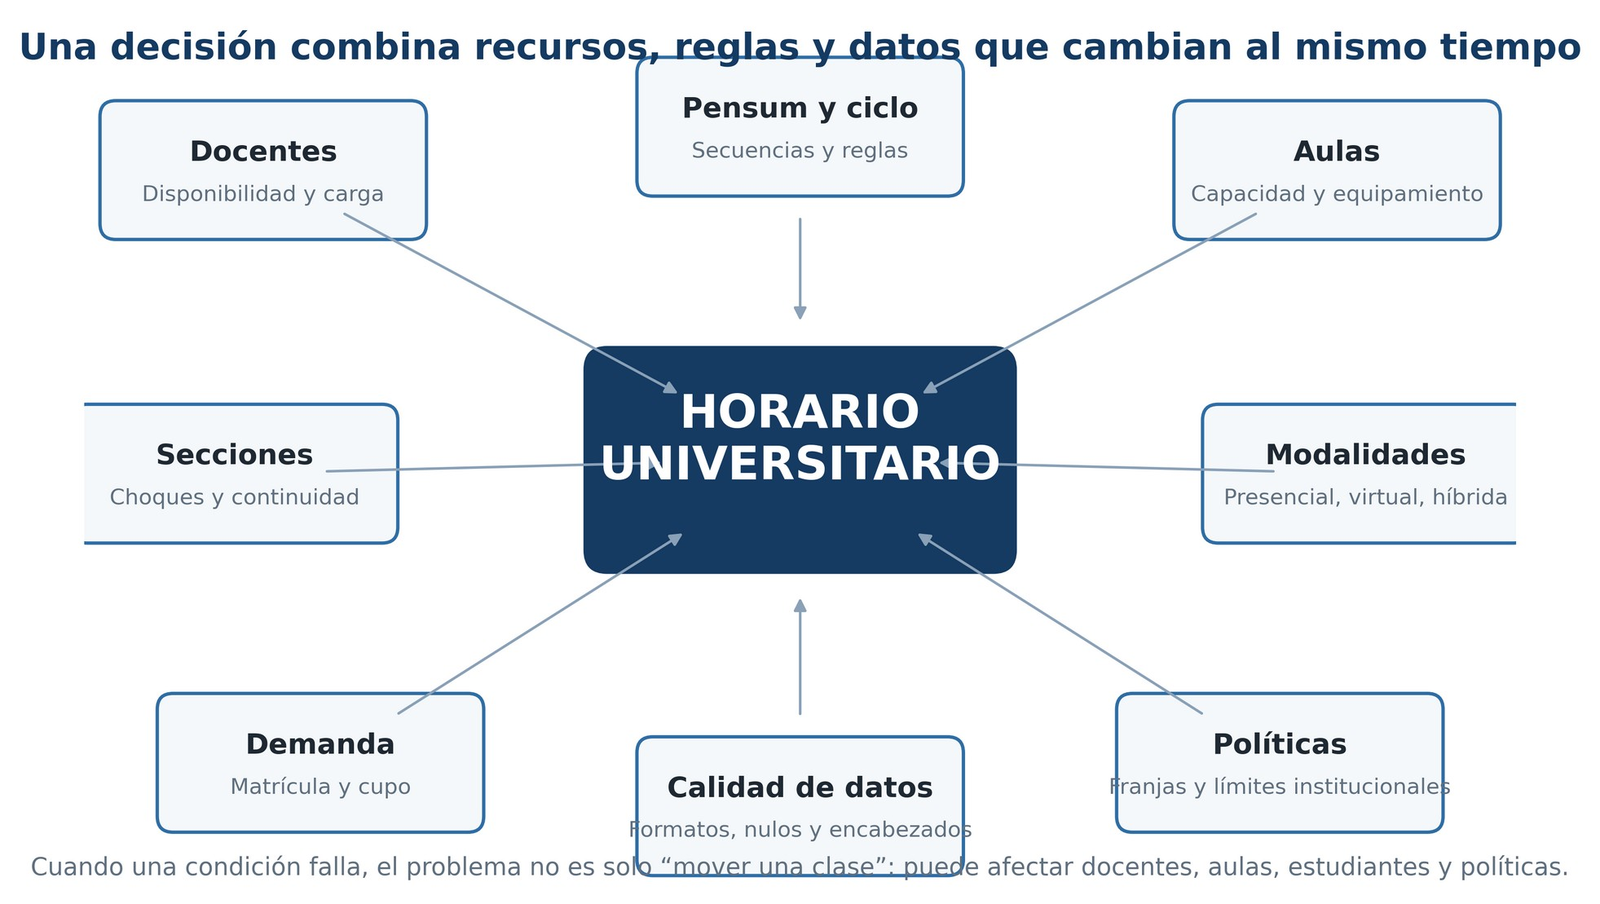
La dificultad del problema comienza por la cantidad de actores y recursos que deben coordinarse al mismo tiempo. Dos clases no pueden utilizar la misma aula en intervalos solapados; un profesor no puede impartir sesiones simultáneas; una sección debe respetar sus horas semanales, su continuidad y su relación con el pensum; una clase presencial necesita un espacio compatible con su matrícula, mientras una sesión virtual no debería reservar infraestructura física. A esas condiciones se agregan franjas institucionales, aulas obligatorias para laboratorios, límites de carga docente y días lectivos permitidos. En la literatura, estas condiciones se distinguen entre restricciones duras, cuya violación invalida la propuesta, y criterios blandos, que permiten comparar la calidad de horarios ya factibles [1], [3], [6]. Esta separación evita comparar como equivalentes situaciones de naturaleza distinta. Un hueco entre clases puede ser inconveniente, pero no tiene el mismo impacto que asignar simultáneamente al mismo docente o exceder la capacidad de un laboratorio. Al modelar prioridades explícitas, el sistema refleja que la calidad se optimiza después de asegurar que la propuesta pueda operar en la realidad universitaria.
El problema se vuelve aún más complejo cuando la información de partida no está preparada para un optimizador. Un archivo puede contener encabezados desplazados, columnas con nombres diferentes, horarios escritos con convenciones incompatibles, capacidades vacías o modalidades registradas de forma contradictoria. Si un valor de aula se interpreta mal, el sistema puede creer que existe un recurso disponible; si una hora no puede convertirse a un intervalo, no será posible detectar un solapamiento; si falta el identificador de un profesor, una doble asignación puede pasar inadvertida. Por eso, MOSAIC trata la preparación de datos como parte del problema de ingeniería y no como una actividad secundaria. La calidad de la solución depende de la fidelidad con la que la instancia represente la realidad institucional. La dificultad no se resuelve eliminando filas problemáticas sin dejar rastro. MOSAIC conserva un checklist de ingestión y comunica las columnas detectadas, las ausentes y las conversiones realizadas. Esta conducta es importante para el gobierno del dato: permite corregir la fuente, repetir el análisis y evitar que una aparente mejora sea solo consecuencia de haber ignorado registros que no pudieron interpretarse.
Los enfoques exactos, como la programación entera y la programación por restricciones, ofrecen formulaciones rigurosas y pueden demostrar optimalidad o infactibilidad dentro del modelo construido. Sin embargo, su costo puede aumentar cuando se combinan cientos de sesiones, aulas y candidatos temporales. Trabajos recientes han mostrado que la programación universitaria real contiene variantes multiphase, currículos, asignaciones de docentes y objetivos que dificultan una formulación única [4], [7], [17]. Esto no significa que los modelos exactos sean inadecuados; significa que deben utilizarse con un alcance cuidadosamente definido, límites de tiempo y mecanismos que permitan continuar cuando la instancia crece o incluye reglas difíciles de expresar en una formulación compacta. En MOSAIC, esa tensión se administra reduciendo el dominio de la fase exacta y estableciendo rutas de respaldo. El solucionador puede concentrarse en aulas compatibles y candidatos de tiempo permitidos, mientras otras reglas se verifican o reparan en etapas posteriores. La arquitectura acepta que una formulación técnicamente elegante no siempre es la alternativa más operativa cuando la instancia llega incompleta o cambia durante el ciclo.
Las metaheurísticas, por su parte, exploran el espacio de soluciones mediante movimientos y estrategias que buscan mejorar progresivamente un horario. La Búsqueda Tabú es especialmente útil porque incorpora memoria: evita regresar de inmediato a movimientos recientes, permite escapar de óptimos locales y puede aceptar una transición que no sea mejor en el corto plazo si abre una ruta hacia una solución superior [11]. Su flexibilidad resulta valiosa cuando las preferencias institucionales son numerosas o cambian con frecuencia. No obstante, una metaheurística pura necesita una solución inicial y puede dedicar gran parte de su esfuerzo a corregir factibilidad. Si las restricciones obligatorias no están controladas, el algoritmo podría encontrar un horario cómodo o equilibrado que siga siendo operacionalmente imposible. Su utilización también exige disciplina experimental. La semilla, el tamaño del vecindario, el número máximo de iteraciones y el criterio de estancamiento deben quedar registrados, porque dos ejecuciones con parámetros distintos no constituyen la misma prueba. MOSAIC incorpora esos metadatos para que la búsqueda no funcione como una caja negra y para que la comparación pueda reconstruirse posteriormente.
La tendencia de investigación ha favorecido, por ello, métodos híbridos que distribuyen responsabilidades entre varias técnicas. Una fase exacta puede construir una base factible; operadores especializados pueden reparar reglas de dominio; y una búsqueda local puede refinar preferencias sin comprometer condiciones críticas [5], [12]. Las revisiones sobre el University Course Timetabling Problem señalan que no existe un único método dominante para todas las instituciones, porque cada universidad combina políticas, estructuras curriculares y recursos distintos [3], [6]. MOSAIC se ubica en esa línea, pero añade una preocupación de producto: además de producir una propuesta, debe conservar los parámetros, desglosar las violaciones y permitir que un comité compare el estado original con la salida. La hibridación no consiste en encadenar algoritmos de manera decorativa. Cada componente responde a una limitación concreta: CP-SAT organiza una parte de la factibilidad, los reparadores incorporan conocimiento institucional y Tabú explora calidad. El valor surge de la coordinación entre fases y de una función de evaluación común que permite observar cómo cambia el horario sin perder el vínculo con sus restricciones.
Los estudios recientes también han ampliado el problema hacia modalidades híbridas, trayectorias curriculares personalizadas y asignaciones orientadas por demanda. Estas investigaciones muestran que una solución puede ser matemáticamente atractiva y, aun así, requerir mecanismos adicionales para responder a cambios de matrícula, indisponibilidad de recursos o secuencias de estudio no convencionales [8]-[10]. De esta evidencia surge una idea central del proyecto: evaluar un horario solo en condiciones nominales no basta. Dos propuestas pueden tener cero conflictos en el momento de su generación, pero reaccionar de manera diferente cuando aumenta la demanda o se bloquea un aula. La robustez debe observarse como una dimensión posterior y distinta de la optimización. La robustez adquiere especial relevancia porque la planificación se realiza antes de que todas las condiciones permanezcan estables. La matrícula puede variar, un profesor puede quedar indisponible o un aula puede salir de servicio. Incorporar escenarios no elimina la incertidumbre, pero permite identificar propuestas demasiado dependientes de recursos críticos y ofrecer al comité una señal temprana antes de aprobar la versión definitiva.
Una meta concreta: convertir datos dispersos en decisiones comparables
Otra brecha aparece entre los modelos publicados y las herramientas que usan las personas responsables de la planificación. Muchos trabajos comparan algoritmos sobre conjuntos de datos previamente estructurados, mientras las oficinas académicas deben resolver primero inconsistencias de archivos, reglas no documentadas y cambios de última hora. Además, una puntuación única no siempre explica por qué una propuesta es mejor. Los sistemas de apoyo a decisiones deben combinar automatización con transparencia, conservar la posibilidad de intervención y evitar que el usuario confunda una recomendación con una decisión obligatoria [2], [14]. MOSAIC se diseñó como una ayuda para el análisis: genera evidencia y alternativas, pero mantiene la aprobación final en manos del comité académico. También existe una diferencia entre demostrar un algoritmo y entregar una experiencia de uso. Una coordinación necesita cargar archivos, entender advertencias, revisar indicadores, localizar la causa de una violación y descargar resultados. Si el sistema solo devuelve un número final, obliga a confiar sin comprender. Por eso, la interfaz y la persistencia forman parte de la solución científica: convierten el cálculo en evidencia examinable.
Del archivo institucional a una representación confiable
El objetivo completado fue desarrollar una herramienta de apoyo a la toma de decisiones para generar y mejorar horarios universitarios a partir de datos académicos institucionales, permitiendo comparar la factibilidad y la calidad entre una programación base y una alternativa procesada. Para alcanzarlo, el proyecto implementó la carga, validación y normalización de archivos CSV y XLSX; construyó un modelo híbrido con CP-SAT, reparadores y Búsqueda Tabú; definió indicadores de restricciones duras, criterios blandos, puntuación global y robustez; y desarrolló una interfaz web conectada a servicios de ejecución, historial, persistencia y exportación. El cumplimiento se evaluó dentro del alcance de tesis, sin presentar la plataforma como una integración productiva con el sistema de gestión académica. El cumplimiento se materializó en cuatro capacidades observables: ingesta y normalización de CSV/XLSX; un modelo híbrido con restricciones y criterios de calidad; indicadores para factibilidad, calidad y estabilidad; y una interfaz conectada a servicios de ejecución, persistencia y exportación. El objetivo se considera completado dentro del alcance de tesis, sin extender esa afirmación a una integración productiva con sistemas institucionales.
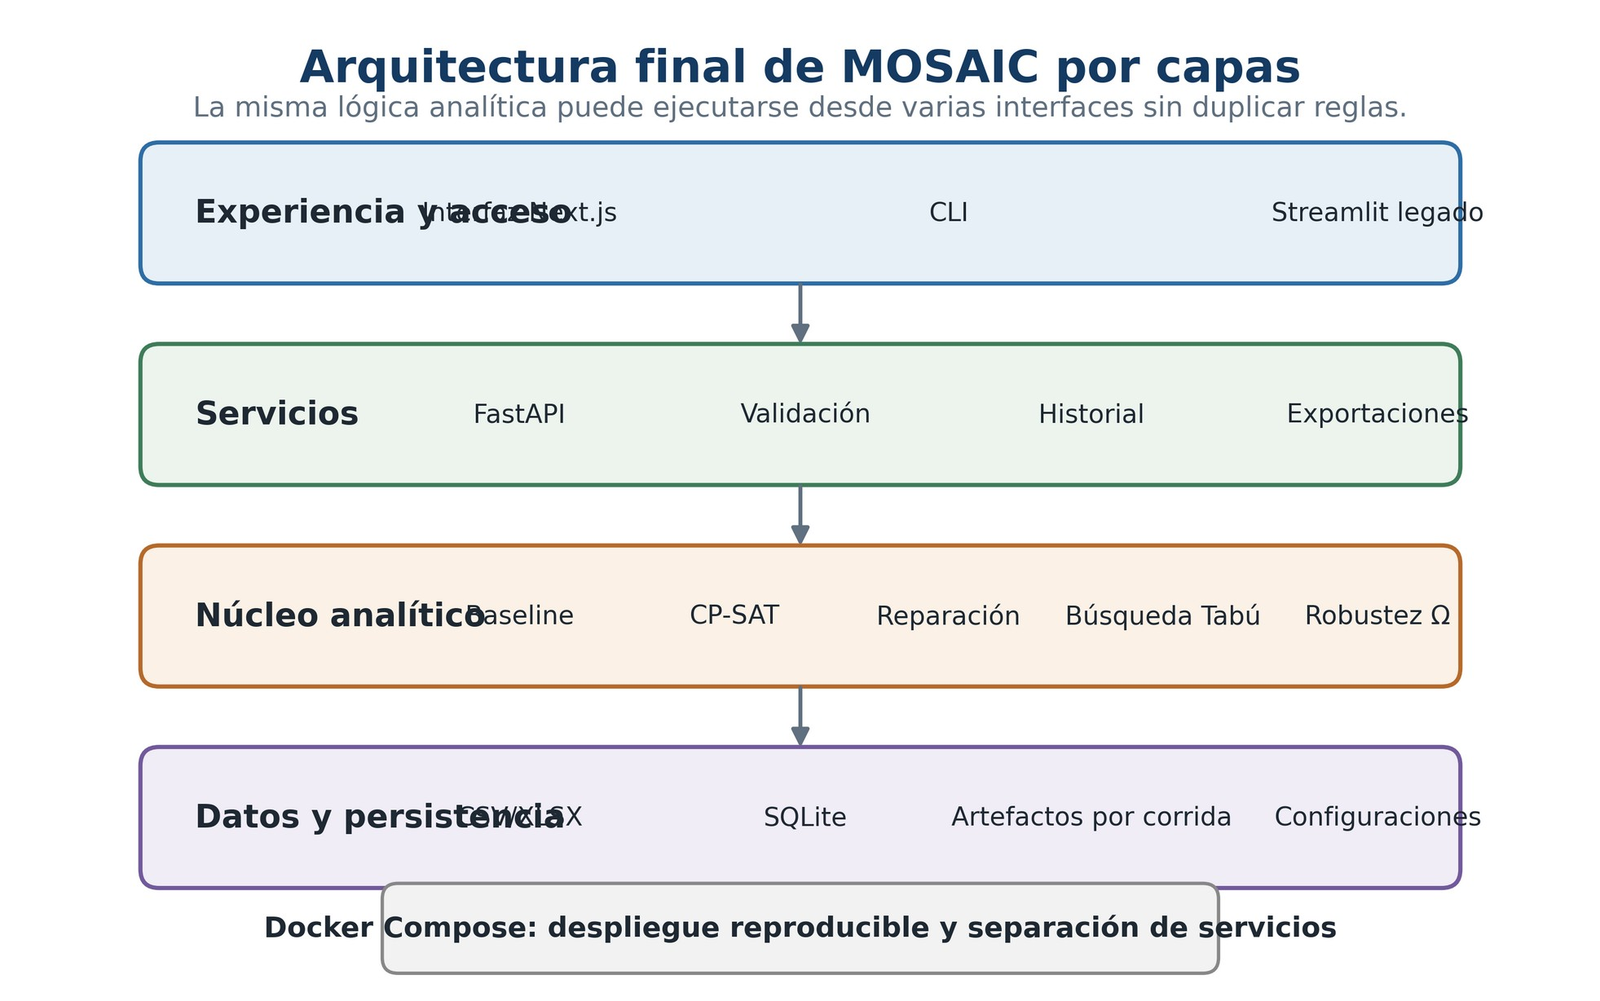
La metodología comienza con una arquitectura por capas que separa la experiencia del usuario, los servicios y el núcleo analítico. La interfaz final se desarrolló con Next.js y TypeScript; FastAPI expone validación, creación de corridas, historial, detalle, horario, indicadores y exportaciones; el motor Python contiene la lógica de ingesta, evaluación y optimización; y SQLite, junto con archivos organizados por corrida, conserva el estado. Esta separación evita que una regla exista solo en la pantalla o que una exportación calcule resultados distintos. El mismo pipeline puede ejecutarse desde la interfaz, la API o la línea de comandos, lo que favorece las pruebas y reduce el acoplamiento entre la lógica matemática y la presentación. La separación evita duplicar lógica entre pantallas y exportaciones. El mismo núcleo analítico puede ser invocado desde línea de comandos, API o interfaz web, de modo que la cifra mostrada al usuario proviene del mismo cálculo que se conserva en los artefactos. Esta decisión reduce inconsistencias, facilita las pruebas y permite evolucionar la experiencia visual sin reescribir las reglas académicas.
La entrada se organiza mediante un contrato extendido de veintiséis columnas que incluye ciclo, código y nombre de asignatura, número de clase, estado, cupo, matriculados, créditos, modalidad, profesor, aula, capacidad, días, horas, campus, tipo de clase, requisitos y observaciones, entre otros atributos. El sistema admite aliases y puede recuperar encabezados que no aparecen en la primera fila. También convierte valores vacíos, normaliza nombres, interpreta horarios y preserva columnas aparentemente anónimas cuando contienen información. El objetivo no es aceptar cualquier archivo sin advertencia, sino tolerar variaciones comunes y devolver un checklist claro de lo detectado, lo ausente y lo que debe corregirse antes de ejecutar el modelo. La tolerancia de entrada se combina con límites explícitos. El flujo reconoce alias y variaciones comunes, pero no inventa valores necesarios para decidir. Campos como matrícula, modalidad, aula, profesor, días y horas deben alcanzar un nivel mínimo de interpretabilidad. De esa forma, la flexibilidad sirve para incorporar exportaciones reales sin convertir datos ambiguos en certezas artificiales para el solucionador.
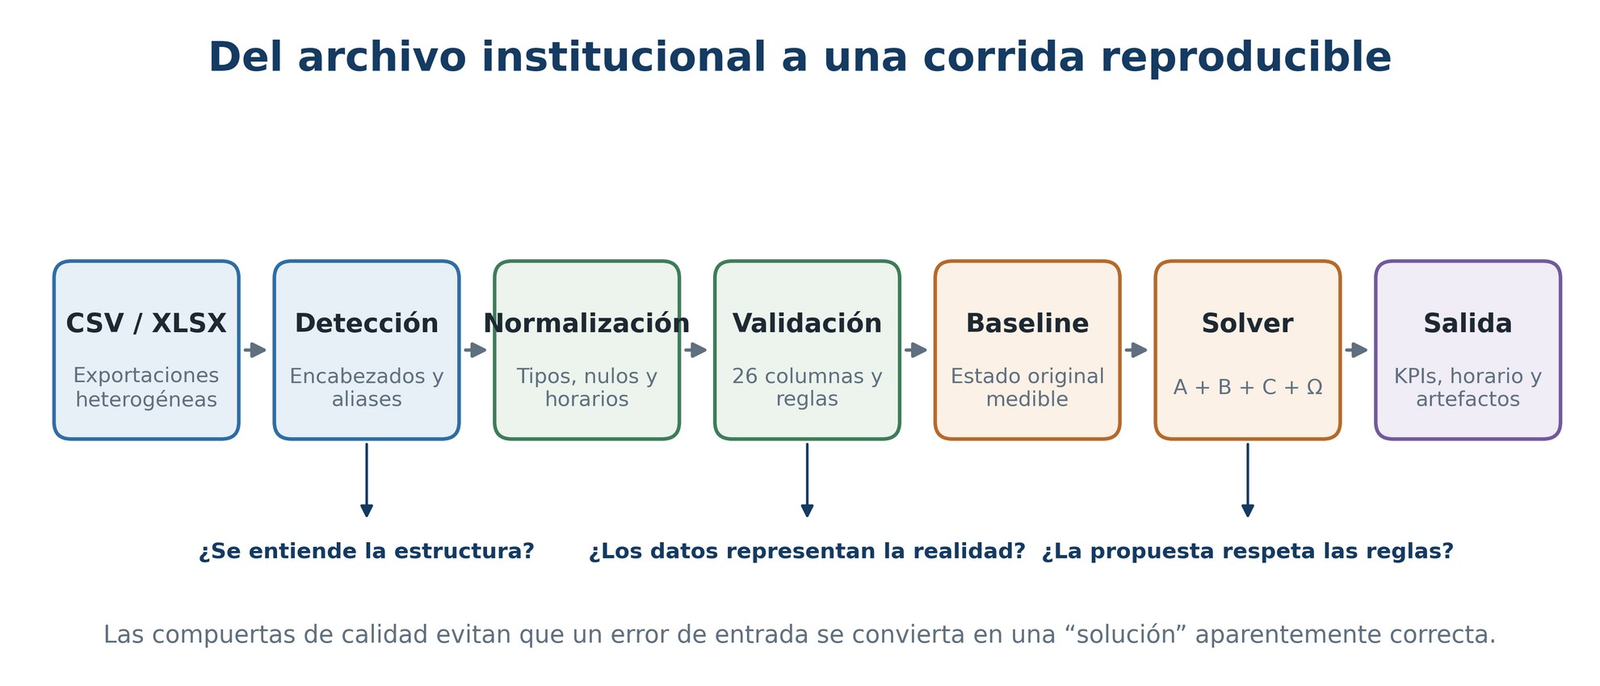
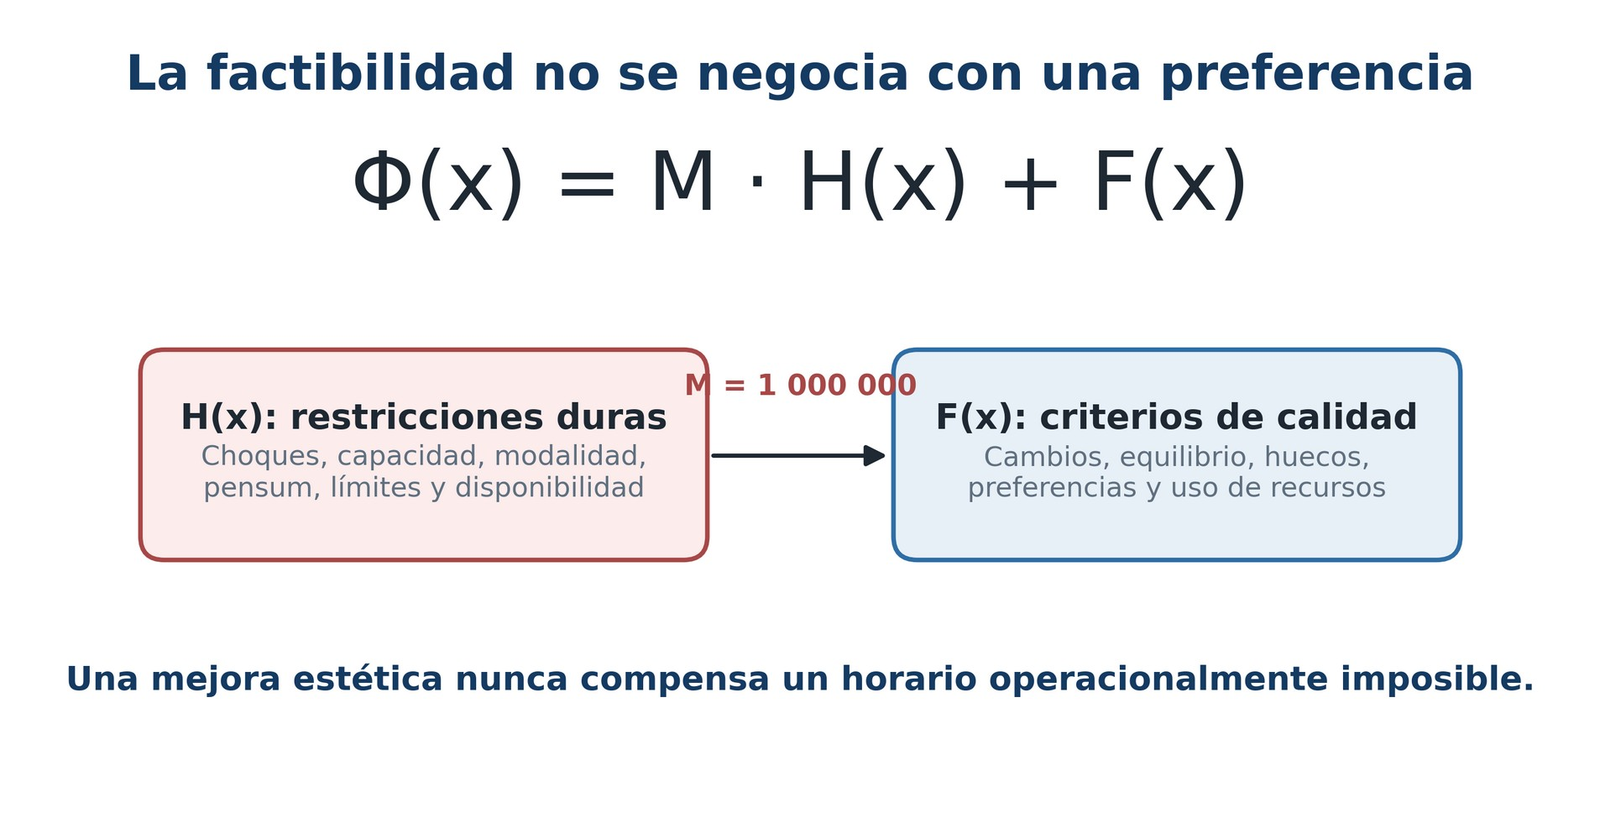
Después de la normalización, MOSAIC construye un baseline: una representación medible del horario recibido. Sobre ese estado calcula H, la suma de veinte restricciones duras, y F, la combinación ponderada de trece criterios blandos. La puntuación global se expresa como Φ(x) = M·H(x) + F(x), donde M vale 1 000 000. Esa constante establece una jerarquía operativa: una diferencia de factibilidad domina cualquier mejora razonable de calidad. El sistema no se limita a mostrar Φ; también presenta el desglose de H y F, porque dos valores globales similares pueden ocultar causas completamente distintas. Esta trazabilidad permite distinguir un choque de profesor de una capacidad insuficiente o de una regla de pensum. El baseline cumple una función metodológica y comunicativa. Permite responder qué problemas existían antes de intervenir y evita atribuir al algoritmo mejoras que ya estaban presentes en el archivo original. Cada fase se compara contra ese punto de partida mediante H, F y Φ, con desgloses por regla. Así, una reducción puede vincularse con choques, capacidad, modalidad o preferencias específicas.
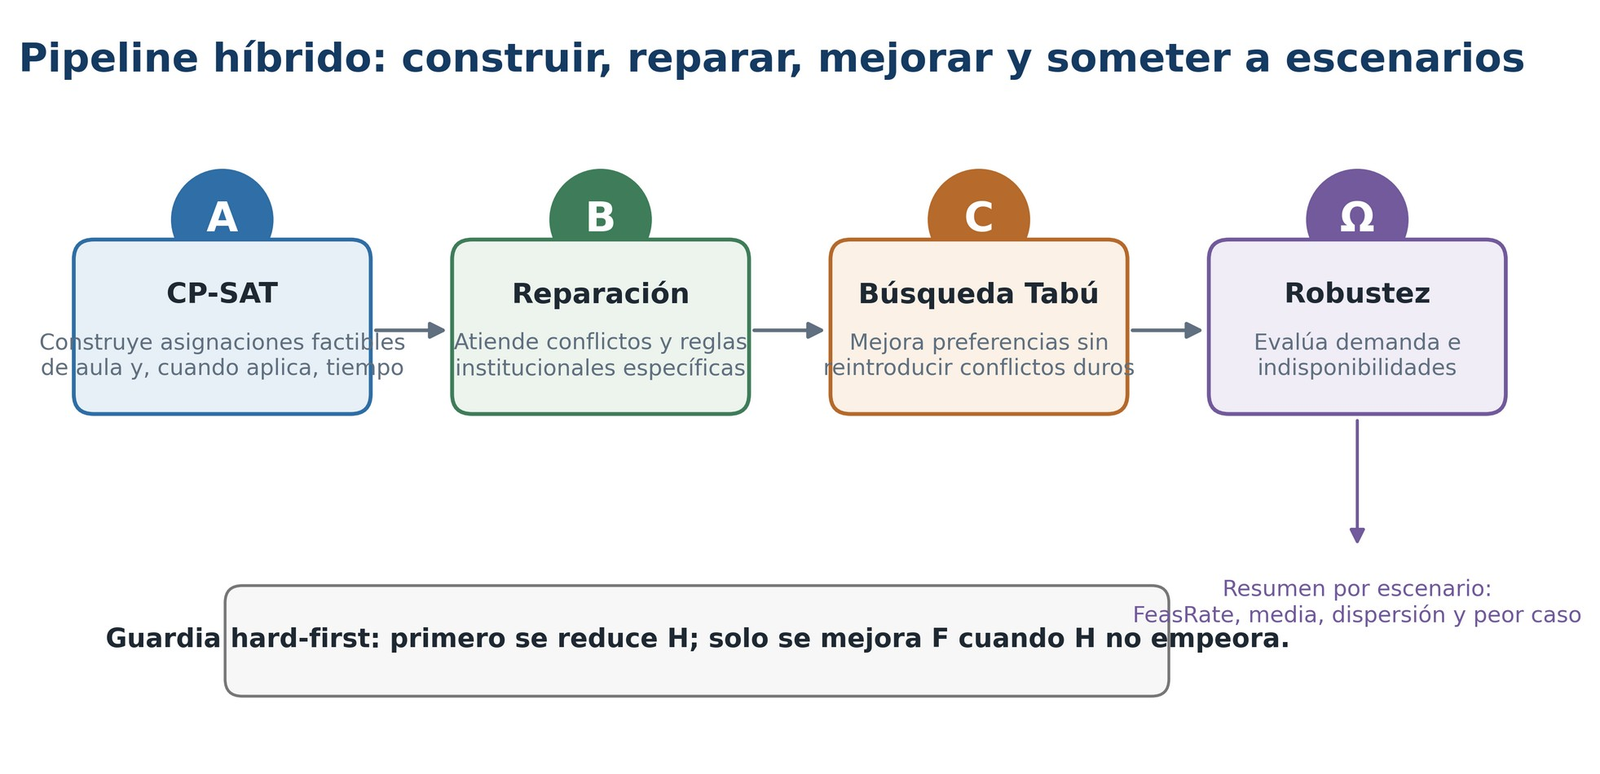
La política hard-first protege el propósito institucional de la solución. Mientras existan violaciones duras, el proceso prioriza reducirlas. Una vez que H llega a cero, un movimiento que vuelva a crear un conflicto obligatorio se rechaza aunque disminuya F. Esta decisión evita que una preferencia, como reducir huecos o minimizar cambios de aula, compense una condición que haría inviable el horario. El principio se relaciona con la optimización lexicográfica utilizada en problemas de asignación, donde los objetivos se ordenan por niveles de prioridad [1], [17]. En términos prácticos, MOSAIC intenta primero producir una propuesta que pueda operar; solo entonces busca que esa propuesta sea más conveniente, equilibrada o estable. La constante M se configuró en 1,000,000 como separación de órdenes de magnitud, no como costo monetario. La consecuencia es equivalente a una prioridad lexicográfica: primero se comparan las violaciones obligatorias y solo cuando H es igual se utiliza F para ordenar la conveniencia. Esta decisión hace visible una política que, en procesos manuales, suele quedar implícita en la experiencia del planificador.
La fase A utiliza CP-SAT para estructurar la asignación inicial. Para cada sesión presencial se construyen aulas cuya capacidad cubre la matrícula y candidatos temporales dentro del dominio institucional. Las variables binarias representan la asignación de una sesión a un aula y, cuando corresponde, a un candidato de tiempo. Las restricciones lineales impiden solapamientos de aula, profesor y sección. El solver opera con un límite temporal y reporta su estado, modelo utilizado y violaciones residuales. Para controlar el crecimiento, la reasignación temporal completa se aplica a instancias de hasta cuatrocientas sesiones presenciales; en archivos mayores se utiliza un modelo reducido centrado en aulas y mecanismos de respaldo. El modelo devuelve estados como OPTIMAL o FEASIBLE dentro de la formulación ejecutada y un límite temporal controla el costo. En instancias mayores, la reasignación temporal completa se reduce y puede utilizarse un constructor de respaldo antes de la reparación. Es importante subrayar que un estado del solver describe el modelo compacto, no certifica por sí solo toda la realidad institucional.
La fase B incorpora reparadores especializados. Algunos atienden inconsistencias básicas, como una sesión virtual con aula, una clase presencial sin espacio, una capacidad insuficiente o un choque de profesor. Otros utilizan configuraciones institucionales para revisar horas semanales, continuidad, máximo de sesiones por día, dominio de horarios, límites de carga docente, días lectivos, aulas obligatorias, franjas reservadas y coherencia con el pensum por ciclo. Un reparador no fuerza una corrección imposible. Si no existe un aula con capacidad suficiente o una franja permitida, la violación se conserva y se acompaña de contexto. Esa decisión es importante: modificar datos institucionales para fabricar factibilidad sería menos transparente que reportar un límite estructural. La reparación no fuerza resultados imposibles. Si ninguna aula disponible satisface la matrícula o si todas las franjas válidas están bloqueadas, el sistema preserva la violación y aporta contexto. Esta conducta protege la integridad del dato: es preferible presentar un conflicto residual explicado que modificar capacidades, disponibilidades o reglas sin autorización para producir una apariencia artificial de factibilidad.
La fase C ejecuta Búsqueda Tabú sobre la solución reparada. Los vecindarios se forman mediante cambios e intercambios de aula y tiempo; cada candidato se evalúa con Φ; la lista tabú evita ciclos inmediatos; y un criterio de aspiración permite aceptar un movimiento prohibido cuando produce una mejora global. Cada iteración registra fase, número, H, F, Φ y una nota, de modo que el usuario pueda observar cómo evolucionó la propuesta. En archivos muy grandes, el sistema reduce automáticamente iteraciones, tamaño de vecindario y estancamiento, porque cada vecino requiere copiar y evaluar una estructura tabular. La prioridad es conservar la estabilidad de la aplicación antes que simular una búsqueda profunda que agote memoria. Cada iteración registra la fase, H, su desglose, F, Φ y una nota del movimiento. El resultado incluye la razón de parada y la cantidad de iteraciones ejecutadas. En modo ligero, la plataforma declara que Tabú fue omitida, en vez de presentar la salida como si hubiese atravesado todas las fases. Esa transparencia impide confundir validación rápida con optimización completa.
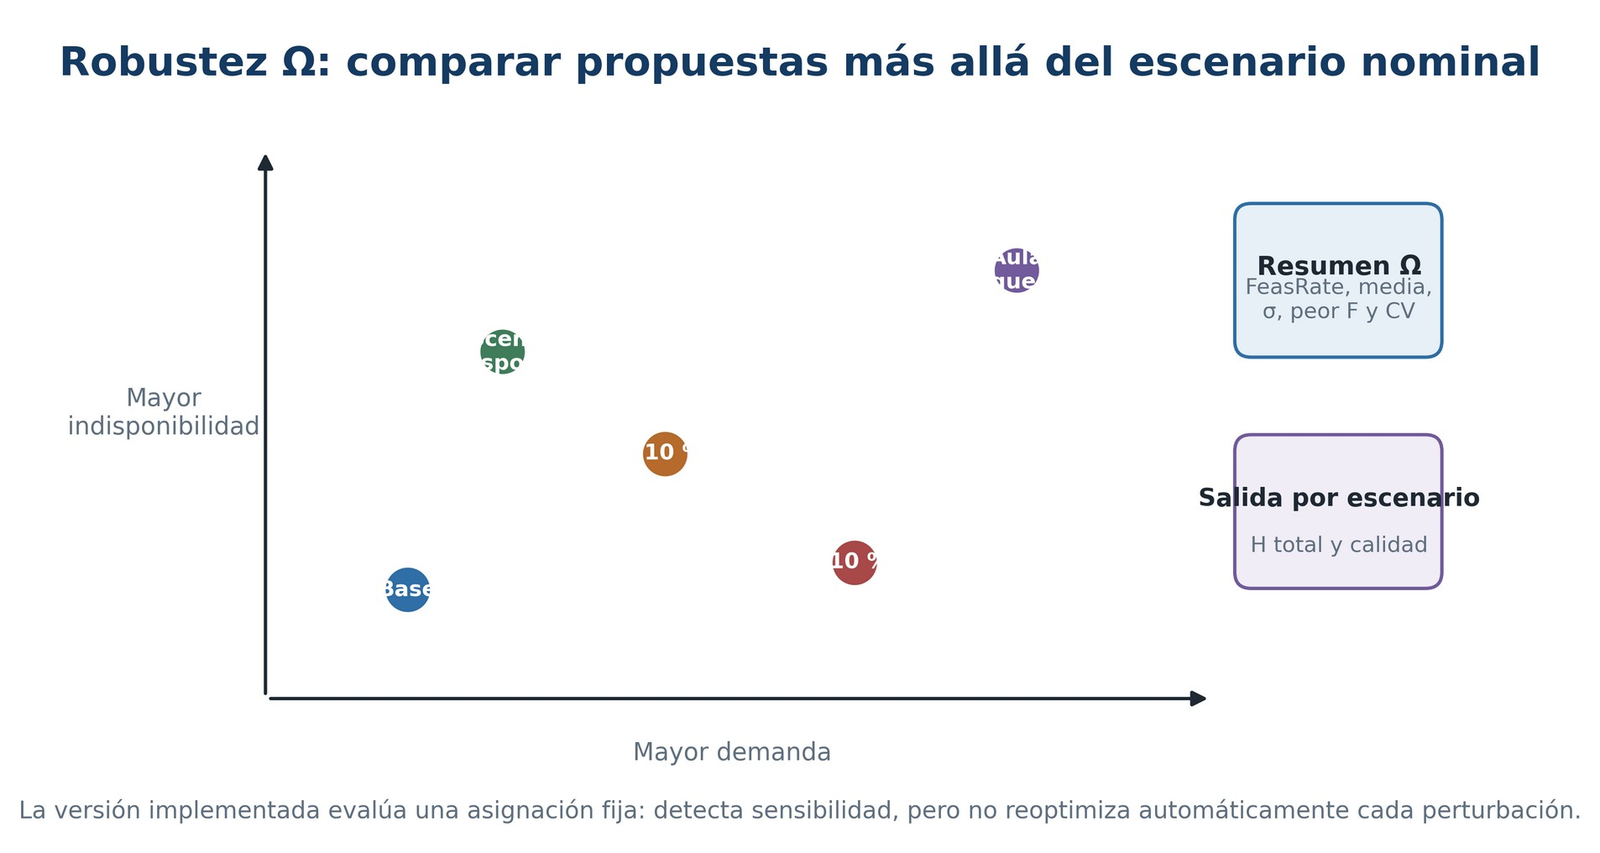
Después de la optimización, el componente Ω evalúa la propuesta bajo escenarios. La demanda puede aumentar o disminuir y determinados docentes o aulas pueden marcarse como no disponibles. MOSAIC no modifica el horario en esta etapa: vuelve a calcular H y F sobre la asignación fija y produce una tasa de factibilidad, media, desviación, varianza, mejor y peor valor de F y coeficiente de variación. Esta separación evita confundir robustez con reoptimización. Ω responde a una pregunta preventiva: si las condiciones cambian después de seleccionar una propuesta, ¿cuánto depende su factibilidad de recursos sin margen o de aulas cercanas a su capacidad? El resumen de Ω contempla tasa de factibilidad, media, desviación, varianza, mejor y peor F y coeficiente de variación. La asignación se mantiene fija para medir sensibilidad, por lo que el componente no debe describirse como una reoptimización automática. Su propósito es comparar margen operativo: revelar si una propuesta nominalmente válida depende de capacidades o disponibilidades con poca holgura.
La metodología se completa con persistencia y reproducibilidad. Cada corrida puede conservar un manifiesto, parámetros, resúmenes, desgloses, horario base, horario procesado y exportaciones. El índice SQLite permite reconstruir el historial después de reiniciar el backend, mientras Docker Compose coordina los servicios en un entorno reproducible. La semilla, la versión, el límite de tiempo y los parámetros de búsqueda forman parte de los metadatos. El repositorio incluye pruebas segmentadas para ingesta, API, pensum, restricciones, CP-SAT, reparación, CLI y construcción del frontend. No se reporta un porcentaje agregado de cobertura que no esté respaldado por un artefacto; la evidencia se expresa como flujos y subsistemas comprobados. La reproducibilidad requiere más que guardar el archivo final. Para repetir una corrida deben conservarse la entrada o su huella, las tablas auxiliares, la versión del sistema, la semilla y los parámetros de ejecución. MOSAIC estructura esa evidencia alrededor de cada identificador de corrida, lo que facilita auditoría, comparación y recuperación incluso después de reiniciar el servicio.
De prototipo exploratorio a plataforma trazable
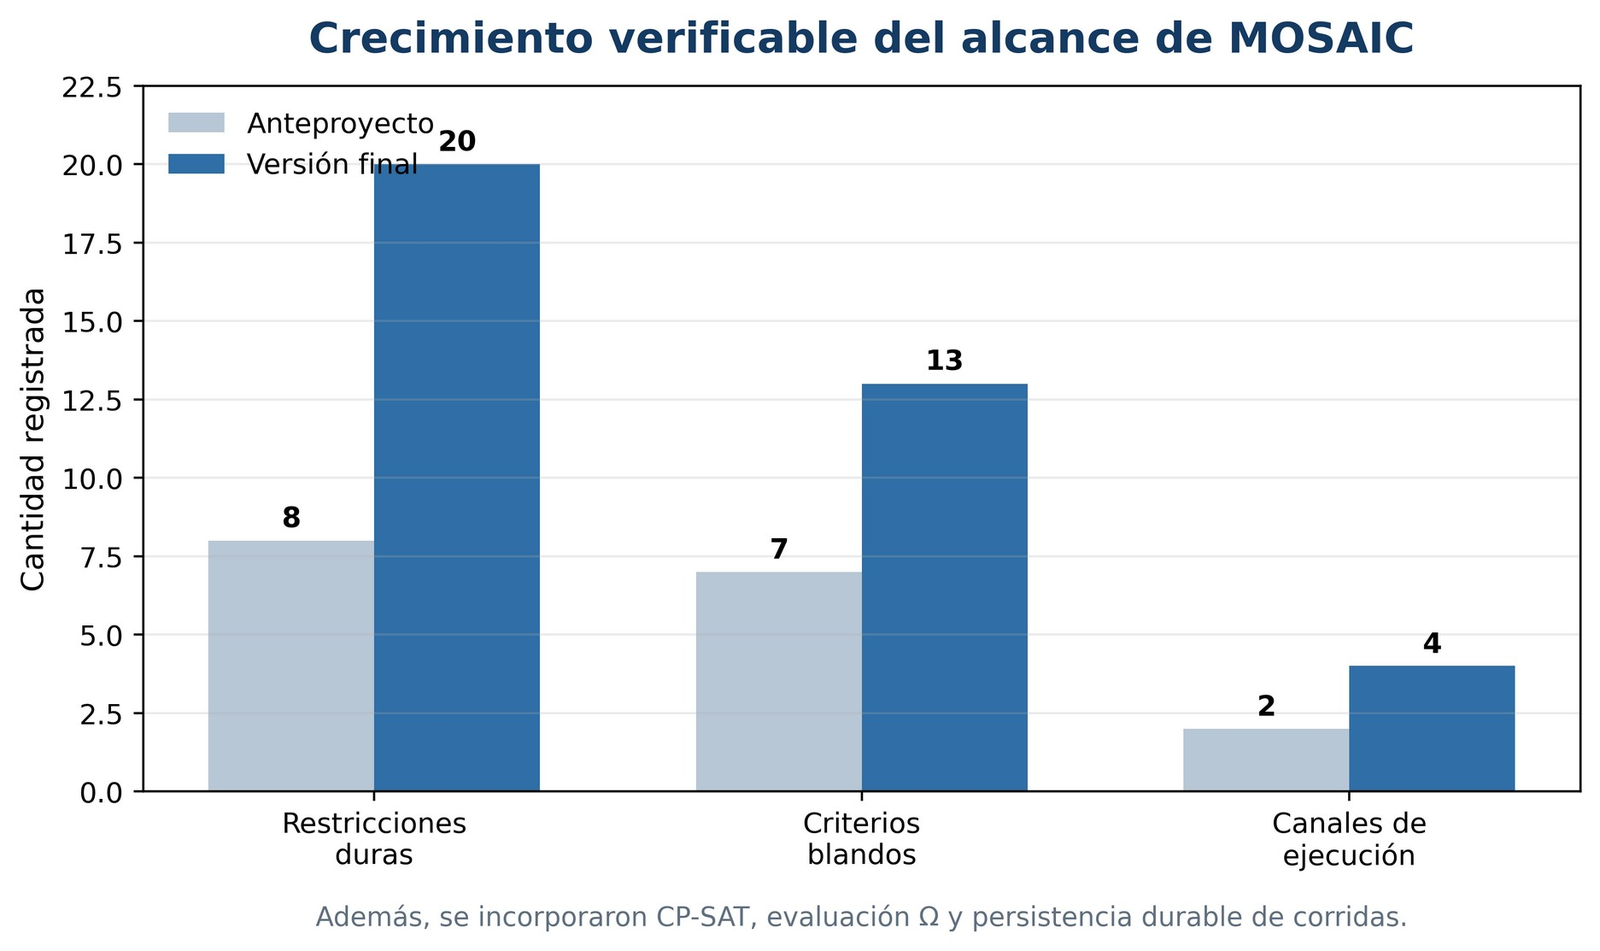
La evolución desde el anteproyecto fue cuantificable. El prototipo inicial registraba ocho restricciones duras y siete criterios blandos; la versión final incorporó veinte restricciones y trece criterios, equivalentes a incrementos de 150 % y aproximadamente 85.7 %, respectivamente. Los canales de ejecución pasaron de CLI y Streamlit a CLI, API, Next.js y Streamlit conservado como legado. También se incorporaron CP-SAT, la evaluación Ω y la persistencia durable de corridas. Estos cambios no fueron una ampliación decorativa: surgieron de problemas observados con archivos institucionales, navegación entre ejecuciones, historial, reglas académicas y necesidad de separar la robustez de la mejora del horario. El cambio cuantitativo se acompañó de una transformación arquitectónica. Streamlit fue útil para validar la idea, pero el historial y la navegación entre corridas justificaron una interfaz Next.js conectada a FastAPI. SQLite y los directorios de artefactos sustituyeron la dependencia de una sesión activa. El prototipo anterior se conservó como evidencia de evolución, no como interfaz oficial final.
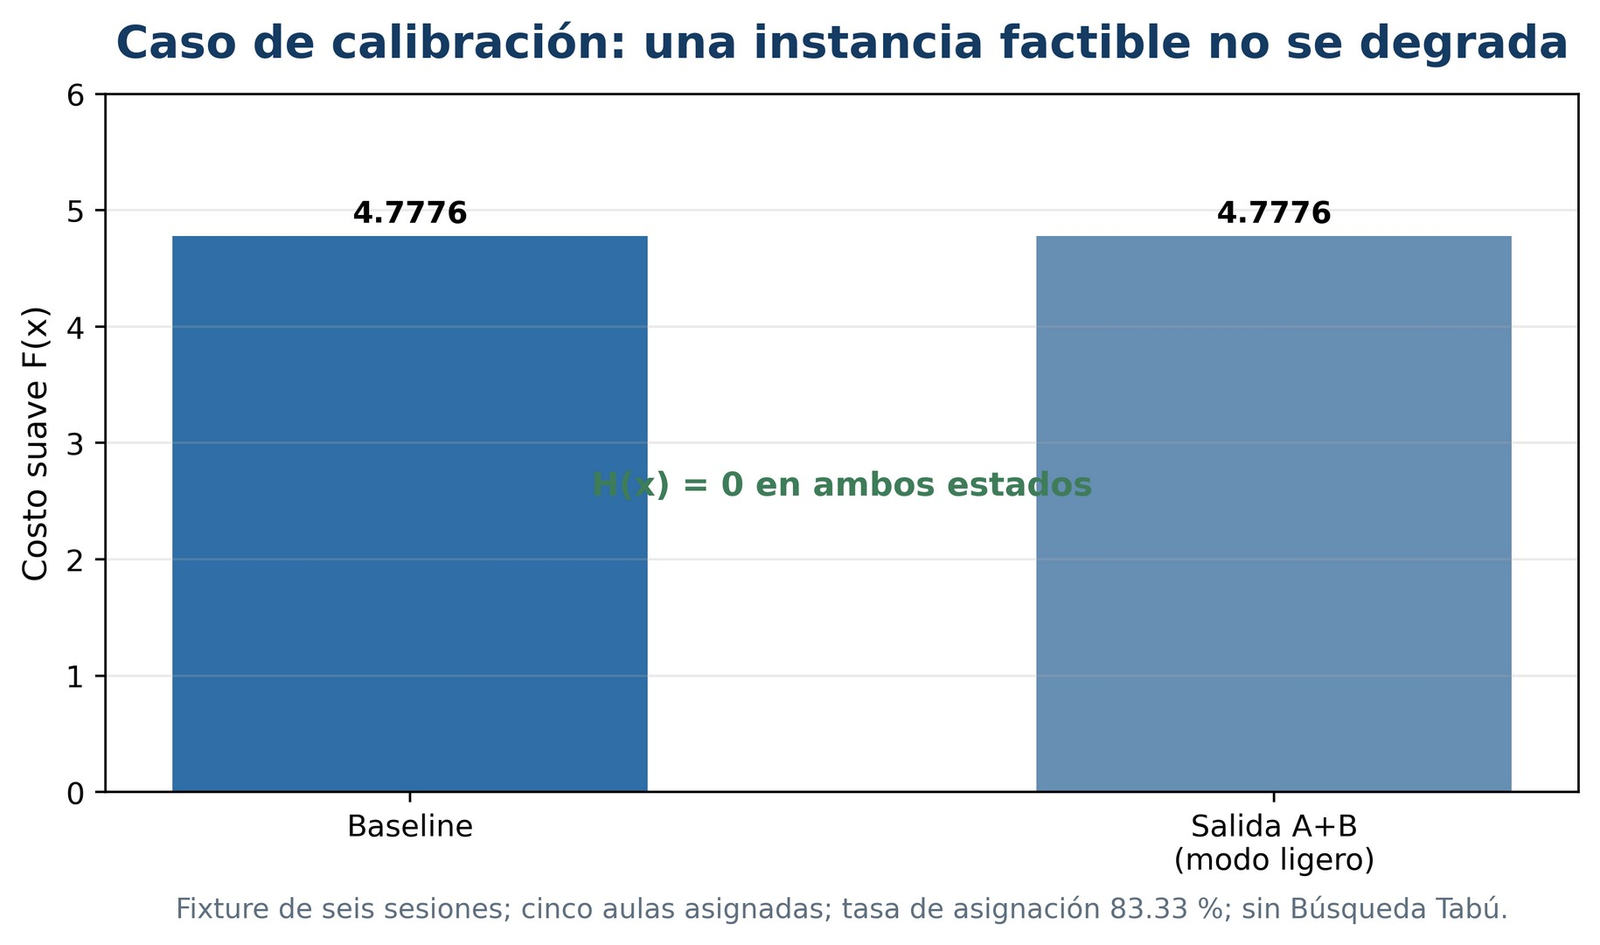
El caso de calibración final utiliza un fixture de seis sesiones y se ejecutó en modo ligero, sin Búsqueda Tabú, con semilla 42. El baseline y la salida A+B conservaron cinco aulas asignadas, una tasa de 83.33 %, cero conflictos de aula, profesor y sección, cero excesos de capacidad, H igual a cero, F igual a 4.7776 y Φ igual a 4.78. Este resultado no demuestra una mejora, porque la instancia ya era factible. Su valor es otro: confirma que las fases de construcción y reparación no degradaron una propuesta válida ni alteraron su costo suave. En ingeniería de optimización, preservar una solución correcta es tan importante como mejorar una defectuosa. La estabilidad es un resultado válido aunque no implique una reducción. En este caso, A+B recibió una instancia ya factible y mantuvo intactos sus indicadores, demostrando que el pipeline no introdujo conflictos al procesarla. La prueba también establece un límite interpretativo: al no ejecutarse Tabú y utilizar solo seis sesiones, no sirve para afirmar rendimiento, escalabilidad ni superioridad algorítmica.
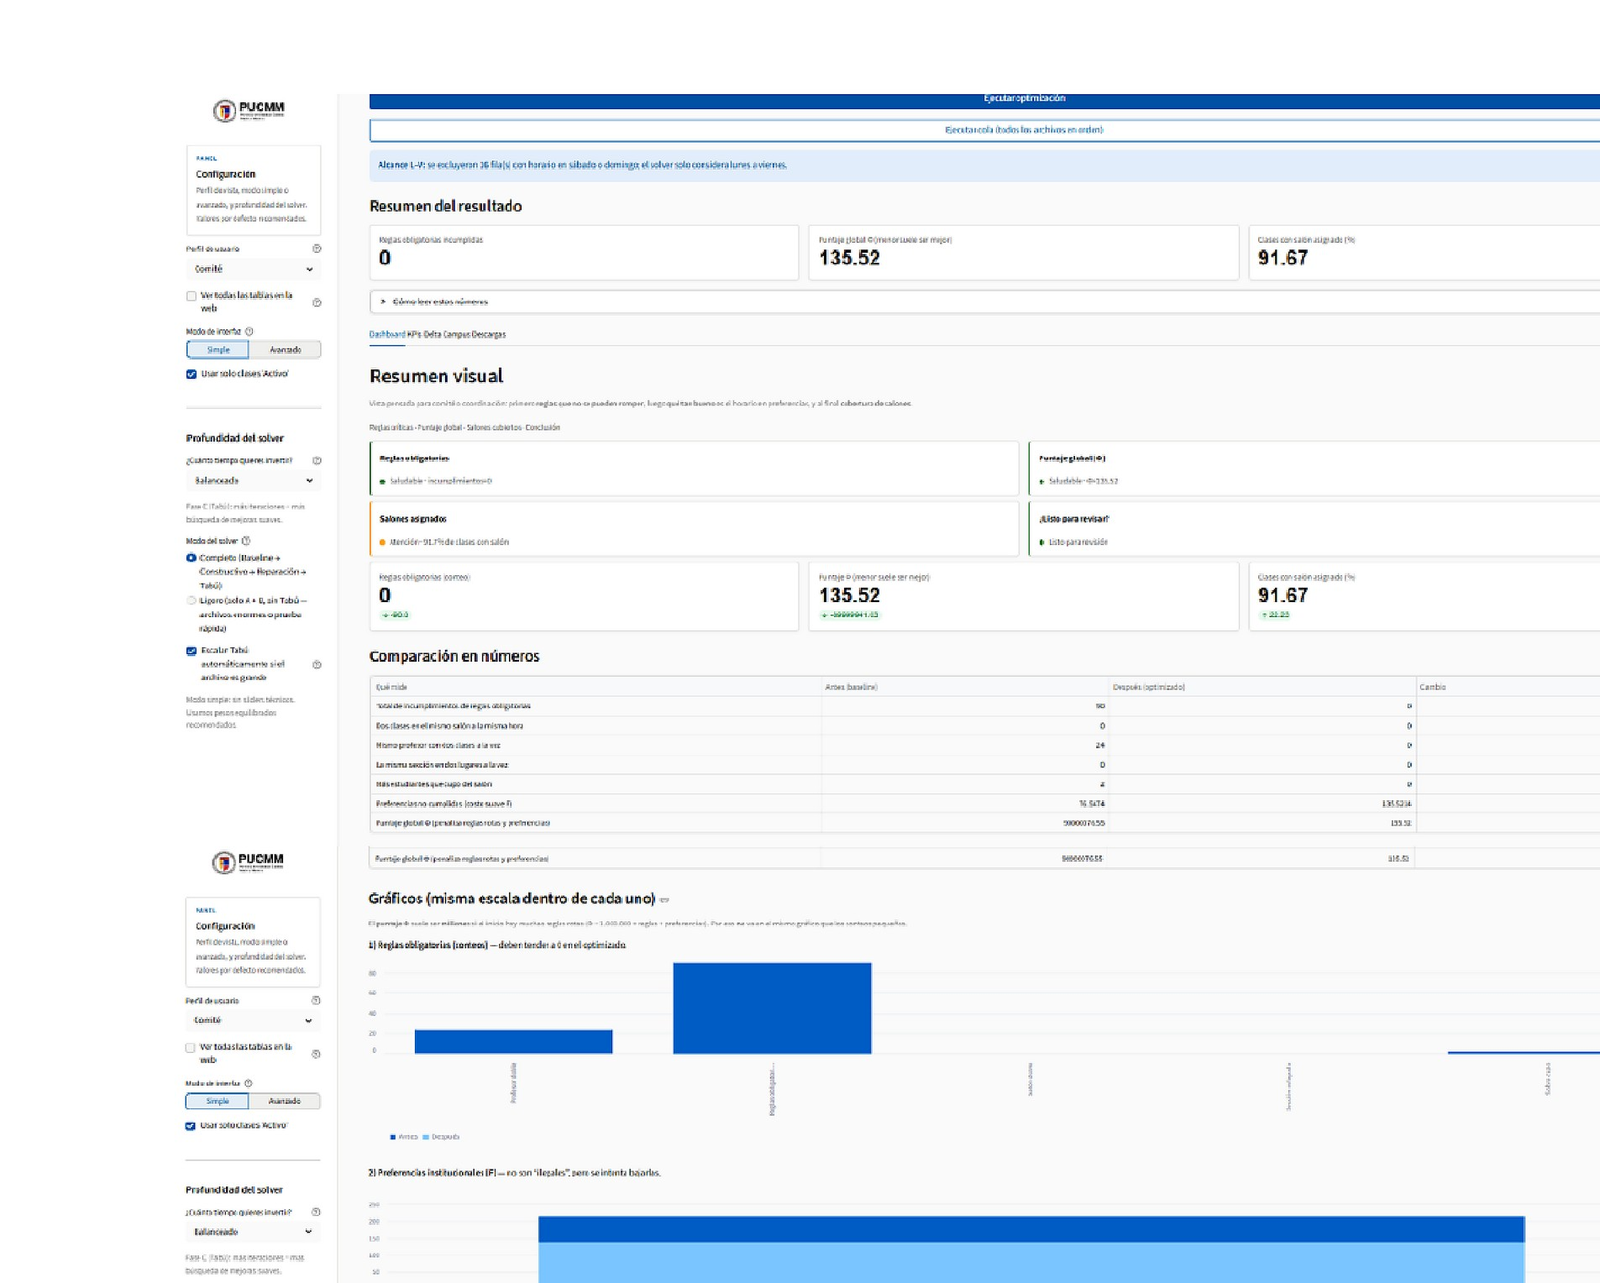
El proyecto también conserva evidencia histórica del prototipo Streamlit. En una corrida de una configuración anterior, la interfaz mostró una reducción de noventa violaciones duras a cero y de veinticuatro choques de profesor a cero, con una tasa final de aulas asignadas de 91.67 % y una puntuación global de 135.52. Estos números no se utilizan como benchmark del modelo final H1-H20 porque cambiaron las reglas, los pesos y la implementación. Mantener la captura, en lugar de mezclarla con la calibración actual, fortalece la honestidad experimental: permite observar la evolución del producto y, al mismo tiempo, evita presentar resultados incompatibles como si pertenecieran a una sola evaluación. La corrida histórica conserva valor como prueba de concepto porque evidencia que el flujo anterior podía eliminar conflictos concretos. Sin embargo, sus pesos, reglas y arquitectura eran distintos. Presentarla separadamente evita una comparación engañosa con el modelo final H1-H20. Esta distinción entre evidencia histórica y benchmark reproducible es necesaria para que el análisis no convierta resultados de etapas diferentes en una sola narrativa cuantitativa.
En la arquitectura final, una ejecución puede iniciarse, persistirse, consultarse y exportarse a través de capas separadas. La API dispone de rutas para validar archivos, crear corridas, consultar historial, recuperar el horario, revisar indicadores y generar exportaciones. Los artefactos por corrida incluyen manifest.json, parameters.json, summary.json, counts.json, baseline_schedule.csv, optimized_schedule.csv y, bajo demanda, un PDF institucional. La interfaz Next.js organiza el flujo alrededor de carga, ejecución, historial y detalle, con vistas de indicadores, comparación, evolución, horario y robustez. La evidencia técnica es cualitativamente amplia, aunque el proyecto reconoce que no se conservó un reporte agregado de cobertura asociado al corte final. La API organiza rutas para validar, crear corridas, listar historial, consultar detalle, paginar el horario, recuperar KPIs y exportar CSV, JSON o PDF. Docker Compose coordina frontend y backend en un entorno reproducible. Las pruebas verifican flujos de ingesta, modelo, optimización e interfaces, aunque el corte analizado no conserva un porcentaje agregado de cobertura que permita resumir toda la suite en una cifra.
La robustez aporta una lectura que no aparece en una comparación nominal. H igual a cero es una condición necesaria, pero no suficiente para afirmar que una propuesta soportará cambios. Una tasa de factibilidad baja bajo escenarios indicaría que el horario depende de recursos sin alternativas; una dispersión alta de F revelaría sensibilidad de la calidad aunque no aparezcan nuevos conflictos. En el corte analizado, Ω está integrado y sus métricas están definidas, pero no existe un archivo institucional publicable con resultados finales de escenarios. Por eso, el artículo presenta esta capacidad como una función implementada y no como una mejora cuantitativa ya demostrada. La distinción protege la validez del proyecto y señala con claridad el experimento que falta. Esta lectura preventiva ayuda a elegir entre horarios aparentemente equivalentes. Una solución que utiliza aulas al límite o concentra sesiones en pocos recursos puede ser más frágil que otra con igual H y un margen mayor. El componente permite formular esa discusión con métricas, aunque todavía falta una corrida Ω sobre una instancia institucional publicable para demostrar una mejora cuantitativa en condiciones reales.
Los resultados deben leerse con límites explícitos. MOSAIC no certifica un óptimo global para todo un campus; la reasignación temporal CP-SAT se reduce en instancias grandes; los pesos de los trece criterios blandos necesitan calibración con responsables académicos; y las reglas H9-H20 dependen de tablas auxiliares completas y vigentes. Tampoco se realizó una prueba controlada con usuarios institucionales ni una integración con el sistema de gestión académica. En seguridad, el aislamiento local es adecuado para una tesis, pero una adopción real requiere autenticación, roles, auditoría, cifrado de respaldos, observabilidad y controles de descarga. Estas limitaciones no invalidan el trabajo; delimitan lo que puede afirmarse y orientan la siguiente etapa. Las limitaciones no invalidan el trabajo, sino que definen el significado de sus resultados. La evidencia es fuerte en trazabilidad, arquitectura y cobertura funcional; es más limitada en benchmarks de gran escala, validación con usuarios y seguridad productiva. Reconocer esa distribución impide extrapolar una prueba controlada a un campus completo y orienta de manera concreta las actividades de una siguiente fase.
Lo que MOSAIC demuestra y lo que todavía debe demostrar
La principal contribución de MOSAIC no es prometer un horario perfecto, sino demostrar una forma más rigurosa de construir, medir y discutir propuestas. El proyecto integra datos imperfectos, reglas institucionales, optimización híbrida y una capa de producto capaz de conservar el historial. La estrategia hard-first resulta coherente con el dominio: primero se protege la operación académica y luego se mejoran preferencias. La trazabilidad entre modelo, código, pruebas y artefactos permite explicar qué ocurrió en cada fase y evita que la salida dependa de una sesión efímera o de una captura aislada. Esta combinación aproxima el trabajo a los sistemas de apoyo a decisiones descritos en la literatura, donde la utilidad depende tanto del cálculo como de la comprensión del resultado [2], [14]. Ese enfoque es relevante porque la programación académica contiene excepciones legítimas que no siempre deben automatizarse. La herramienta puede señalar el costo y la consecuencia de una decisión, pero la aprobación final permanece en el comité. La explicabilidad, entonces, no es un complemento visual: es el mecanismo que permite combinar capacidad computacional con responsabilidad institucional y documentar por qué se aceptó una alternativa.
El paso siguiente debe ser un piloto institucional paralelo al proceso actual. Antes de integrar registros de producción, conviene construir un benchmark anonimizado y versionado con tamaños crecientes, múltiples semillas y métricas H, F, Φ, tiempo y FeasRate. Los pesos deben calibrarse mediante sesiones con coordinación académica y un comité responsable de reglas. El piloto debería comparar la línea base con propuestas de MOSAIC, registrar excepciones y medir no solo la calidad del horario, sino el tiempo de revisión, la claridad de las explicaciones y la confianza de los usuarios. Solo después de validar datos, políticas y experiencia de uso sería razonable avanzar hacia una integración gradual con el sistema institucional. Un diseño de evaluación riguroso debería incluir casos nominales y perturbados, comparaciones por tamaño y sesiones de revisión con usuarios. También conviene registrar cuántas advertencias requieren intervención, qué reglas producen más conflictos y cuánto tiempo se reduce en la preparación y verificación. Estas medidas conectarían el rendimiento técnico con el impacto organizacional que justifica la adopción de la plataforma.
También será necesario fortalecer el gobierno tecnológico. Las configuraciones de pensum, límites docentes, franjas reservadas y aulas especializadas deben tener responsables, fechas de vigencia y procedimientos de actualización. Un solver puede ejecutar correctamente una regla obsoleta y producir un resultado difícil de detectar; por eso, la mantenibilidad no depende únicamente del código. En el plano técnico, lint y formato deben convertirse en controles bloqueantes de integración continua, las pruebas de rendimiento deben cubrir instancias mayores y Ω puede evolucionar desde la evaluación hacia mecanismos de recuperación o reoptimización. En el plano de seguridad, la autenticación institucional, la autorización por roles y la auditoría de exportaciones son condiciones previas para utilizar información real. La sostenibilidad exige además documentación que sobreviva al equipo desarrollador. Las reglas, contratos, endpoints y decisiones de arquitectura deben mantenerse alineados con el código y con el ciclo académico vigente. Un proceso de control de cambios permitiría saber quién modificó una política, desde cuándo aplica y qué corridas deben repetirse. Esa disciplina convierte la trazabilidad técnica en gobierno institucional.
El impacto potencial se extiende más allá de la construcción de un horario. Una planificación mejor documentada puede reducir correcciones tardías, facilitar la coordinación entre escuelas, hacer más transparente el uso de aulas y ofrecer evidencia para discutir inversiones en infraestructura. También puede convertir los conflictos recurrentes en conocimiento institucional: si determinadas franjas, capacidades o asignaturas concentran problemas en varios ciclos, la universidad puede actuar sobre la causa y no únicamente sobre cada incidencia. Este horizonte requiere colaboración entre ingeniería, registro, coordinaciones, docentes y autoridades. MOSAIC propone un lenguaje común basado en datos, restricciones y métricas, pero su evolución dependerá de que esas áreas validen las reglas y definan qué significa calidad en su contexto. El siguiente paso no es automatizarlo todo, sino abrir un piloto controlado donde el sistema pueda ser cuestionado, corregido y medido antes de asumir responsabilidades operativas mayores.
MOSAIC muestra cómo un proyecto final de grado puede conectar investigación operativa, ingeniería de software y necesidades concretas de la gestión universitaria. Su valor está en convertir un proceso frecuentemente manual en una secuencia observable: recibir, validar, medir, construir, reparar, mejorar, someter a escenarios y conservar evidencia. La plataforma todavía necesita validación externa y madurez productiva, pero deja una base clara para continuar investigando y colaborando con las áreas académicas. En lugar de presentar la automatización como sustituto del criterio humano, propone una relación más responsable: que los algoritmos reduzcan el trabajo repetitivo, expongan conflictos y permitan que las decisiones finales se tomen con información verificable, contexto institucional y capacidad de rendir cuentas. El proyecto aporta también una experiencia formativa: obligó a traducir políticas académicas a modelos comprobables, distinguir factibilidad de preferencia y comunicar incertidumbre sin ocultarla. En un contexto donde se promueven universidades inteligentes, este tipo de trabajo muestra que la innovación no consiste solo en agregar inteligencia artificial, sino en construir sistemas confiables, auditables y coherentes con las responsabilidades de sus usuarios.
Referencias
- S. Ceschia, L. Di Gaspero, and A. Schaerf, “Educational timetabling: Problems, benchmarks, and state-of-the-art results,” European Journal of Operational Research, vol. 308, no. 1, pp. 1-18, 2023, doi: 10.1016/j.ejor.2022.07.011.
- G. Xue, O. F. Offodile, R. Razavi, D.-H. Kwak, and J. Benitez, “Addressing staffing challenges through improved planning: Demand-driven course schedule planning and instructor assignment in higher education,” Decision Support Systems, vol. 187, Art. no. 114345, 2024.
- S. Abdipoor, R. Yaakob, S. L. Goh, and S. Abdullah, “Meta-heuristic approaches for the University Course Timetabling Problem,” Intelligent Systems with Applications, vol. 19, Art. no. 200253, 2023, doi: 10.1016/j.iswa.2023.200253.
- R. Esmaeilbeigi, V. Mak-Hau, J. Yearwood, and V. Nguyen, “The multiphase course timetabling problem,” European Journal of Operational Research, vol. 300, no. 3, pp. 1098-1119, 2022, doi: 10.1016/j.ejor.2021.10.014.
- F. Dunke and S. Nickel, “A matheuristic for customized multi-level multi-criteria university timetabling,” Annals of Operations Research, vol. 328, no. 2, pp. 1313-1348, 2023, doi: 10.1007/s10479-023-05325-2.
- A. Bashab et al., “Optimization Techniques in University Timetabling Problem: Constraints, Methodologies, Benchmarks, and Open Issues,” Computers, Materials & Continua, vol. 74, no. 3, pp. 6461-6484, 2023, doi: 10.32604/cmc.2023.034051.
- C. B. Mallari, J. L. San Juan, and R. Li, “The University Coursework Timetabling Problem: An Optimization Approach to Synchronizing Course Calendars,” Computers & Industrial Engineering, vol. 184, Art. no. 109561, 2023, doi: 10.1016/j.cie.2023.109561.
- T. Müller, H. Rudová, and Z. Müllerová, “Real-world university course timetabling at the International Timetabling Competition 2019,” Journal of Scheduling, vol. 28, pp. 247-267, 2025, doi: 10.1007/s10951-023-00801-w.
- E. Steiner, U. Pferschy, and A. Schaerf, “Curriculum-based university course timetabling considering individual course of studies,” Central European Journal of Operations Research, vol. 33, pp. 277-314, 2025, doi: 10.1007/s10100-024-00923-2.
- M. Davison, A. Kheiri, and K. G. Zografos, “Modelling and solving the university course timetabling problem with hybrid teaching considerations,” Journal of Scheduling, vol. 28, pp. 195-215, 2025, doi: 10.1007/s10951-024-00817-w.
- M. Chen et al., “A randomized tabu search for university course timetabling,” Computers & Operations Research, vol. 123, Art. no. 105007, 2020, doi: 10.1016/j.cor.2020.105007.
- M. Chiarandini, K. Socha, M. Birattari, and O. Rossi-Doria, “An effective hybrid algorithm for university course timetabling,” Journal of Scheduling, vol. 9, pp. 403-432, 2006, doi: 10.1007/s10951-006-8495-8.
- K. Okoye et al., “Impact of digital technologies upon teaching and learning in higher education in Latin America: An outlook on the reach, barriers, and bottlenecks,” Education and Information Technologies, vol. 28, no. 2, pp. 2291-2360, 2023, doi: 10.1007/s10639-022-11214-1.
- A. Stojanov and B. K. Daniel, “A decade of research into the application of big data and analytics in higher education: A systematic review of the literature,” Education and Information Technologies, vol. 29, no. 5, pp. 5807-5831, 2024, doi: 10.1007/s10639-023-12033-8.
- K. Polin, T. Yigitcanlar, M. Limb, and T. Washington, “The Making of Smart Campus: A Review and Conceptual Framework,” Buildings, vol. 13, no. 4, Art. no. 891, 2023, doi: 10.3390/buildings13040891.
- R. Sequeira, A. Reis, P. Alves, and F. Branco, “Roadmap for Implementing Business Intelligence Systems in Higher Education Institutions: Systematic Literature Review,” Information, vol. 15, no. 4, Art. no. 208, 2024, doi: 10.3390/info15040208.
- E. Rappos, E. Thiémard, S. Robert, and J.-F. Hêche, “A mixed-integer programming approach for solving university course timetabling problems,” Journal of Scheduling, vol. 25, no. 4, pp. 391-404, 2022.