Cuando la inteligencia artificial no responde por ti

Cristian Ignacio de la Hoz Reyes y Manuel José Rodríguez Cruz – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Una respuesta correcta puede ser una mala experiencia de aprendizaje. Cuando un estudiante que comienza a programar recibe en segundos el ciclo, la condición y el arreglo que necesitaba construir, el ejercicio queda resuelto, pero no necesariamente la duda que lo originó. Esa tensión dio forma al Tutor Socrático, un sistema inteligente de tutoría desarrollado por Cristian Ignacio de la Hoz Reyes y Manuel José Rodríguez Cruz en la Escuela de Ingeniería en Computación y Telecomunicaciones de la Pontificia Universidad Católica Madre y Maestra, bajo la asesoría de la profesora Lisibonny Beato Castro. En ICC-101-T, Introducción a la Algoritmia, el proyecto planteó una pregunta educativa: ¿cómo aprovechar la capacidad conversacional de los modelos de lenguaje sin permitir que la rapidez de la respuesta sustituya el proceso de pensar? La propuesta no intenta esconder la inteligencia artificial ni convertirla en un buscador con restricciones. Busca preservar la participación del estudiante, solicitar indicios de lo que comprende, hacer visible el punto de bloqueo y ofrecer apoyo para el siguiente paso. La Figura 1 resume ese contraste.

La programación introductoria es un escenario sensible para esa pregunta. Aprender a programar implica descomponer problemas, representar estados, anticipar el flujo de ejecución, verificar hipótesis y corregir modelos mentales, habilidades del pensamiento computacional que trascienden la sintaxis [1]. En los primeros cursos, los errores conceptuales suelen acumularse: confundir un contador, recorrer incorrectamente una matriz o no distinguir el valor de una variable de su dirección puede afectar ejercicios posteriores aunque el código compile [2]. En el contexto dominicano, las diferencias de experiencia previa y concepciones docentes vuelven necesaria una mediación intencional [3]. Por eso, una herramienta que produce programas completos plantea una paradoja. Puede reducir la fricción y ampliar el acceso a explicaciones, pero también ocultar las operaciones cognitivas que el curso pretende desarrollar. El valor de un tutor no reside, entonces, en escribir más código que el estudiante, sino en ayudarle a construir una explicación que pueda defender, modificar y transferir.

La literatura reciente confirma que la inteligencia artificial generativa no produce un efecto educativo único. Una revisión rápida sobre programación identifica oportunidades para explicar, generar ejemplos y apoyar la depuración, junto con riesgos de inexactitud, dependencia y evaluación superficial [4]. Una revisión sistemática de cuarenta estudios empíricos concluye que los resultados dependen de la integración, las estrategias de interacción y la evaluación [5]. En educación superior, el uso intensivo puede relacionarse con procrastinación, deterioro del desempeño y pérdida de control cuando sustituye el esfuerzo [6]. Al mismo tiempo, una colaboración bien estructurada puede favorecer motivación y desempeño [7]. La conclusión útil no es aceptar o prohibir la IA de forma absoluta. Es diseñar condiciones para que funcione como andamiaje temporal: una ayuda que observa el intento, ajusta la dificultad, solicita evidencia y se retira gradualmente. En ese punto se sitúa el Tutor Socrático, una arquitectura que convierte principios pedagógicos en reglas operativas.

El resultado es una plataforma funcional que integra conversación guiada, memoria, materiales autorizados, preguntas diagnósticas, actividades y un depurador visual de C. Su aporte principal no es un mensaje ingenioso ni un modelo particular. Es una arquitectura replicable que mantiene identidad, permisos, persistencia y evidencia bajo control de la plataforma, mientras el modelo interpreta el contexto y genera una intervención pedagógica. Esa separación responde a un problema conocido: los modelos pueden producir afirmaciones plausibles sin respaldo o variar según el contexto [8]. También recoge que la IA educativa requiere gobernanza, transparencia y participación humana, no solo precisión técnica [9]. El proyecto une dos escalas. En el turno conversacional, pregunta en vez de resolver y ofrece pistas acotadas. En la escala institucional, reconoce clases, docentes, estudiantes, materiales y actividades. Esta doble mirada permite evaluar no solo si el modelo “suena socrático”, sino si el sistema sostiene una tutoría responsable.
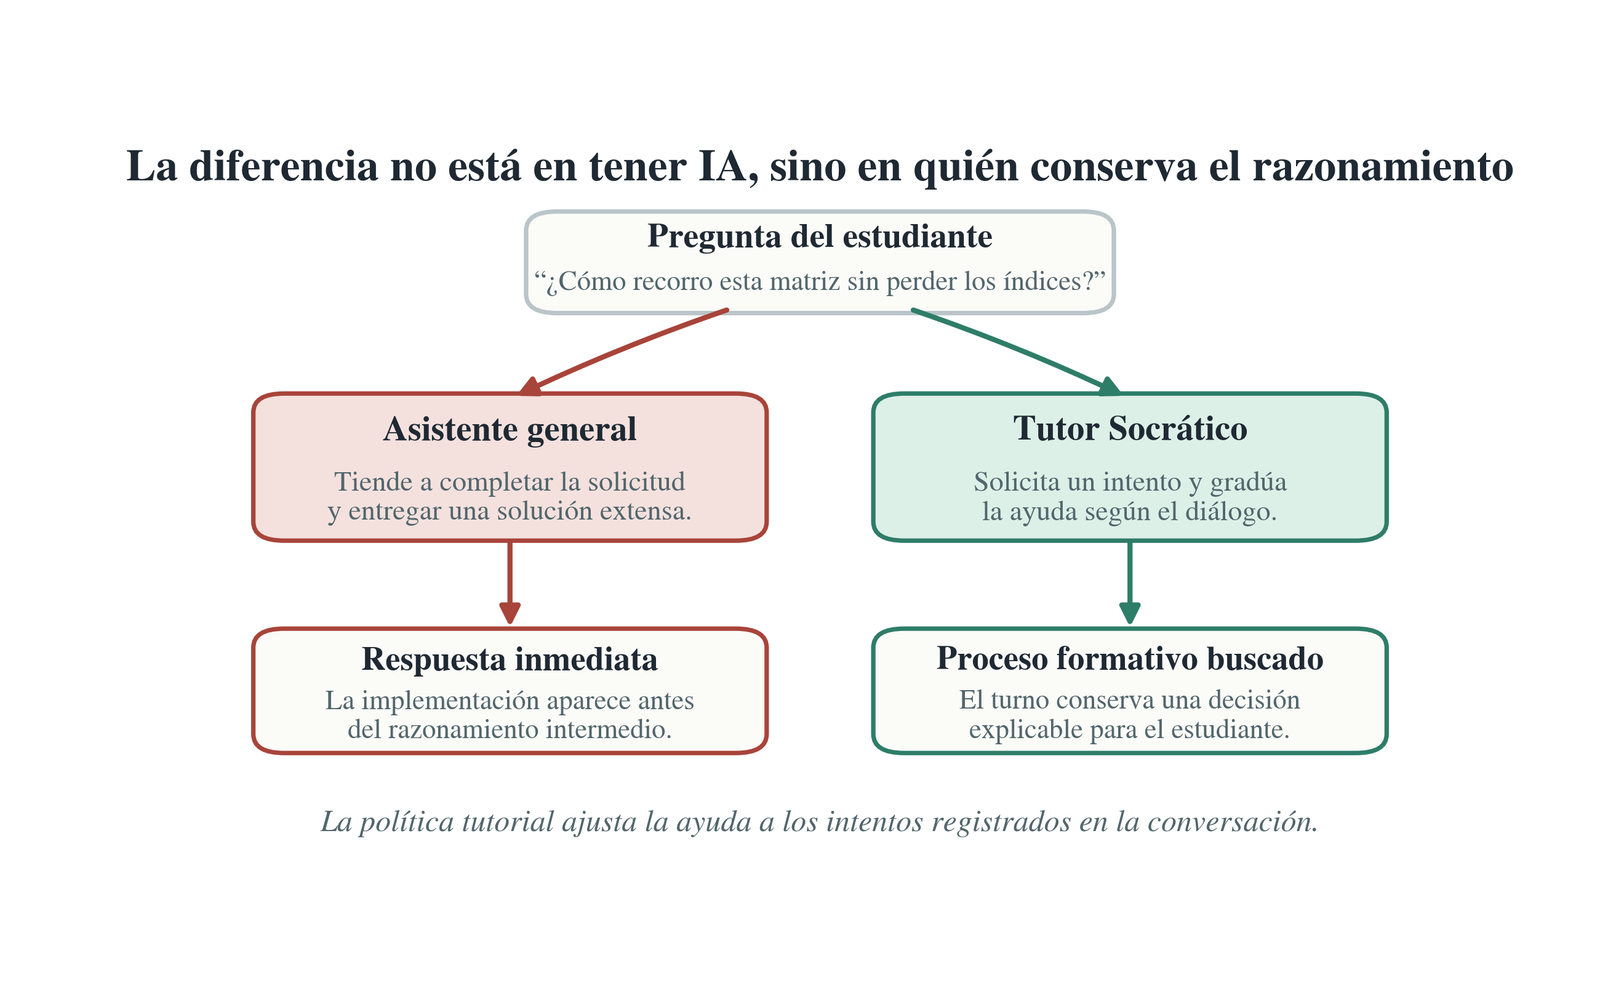
De la respuesta inmediata al andamiaje cognitivo: el asistente general completa, mientras el Tutor Socrático conserva decisiones esenciales en manos del estudiante
Figura 1. De la respuesta inmediata al andamiaje cognitivo: el asistente general completa, mientras el Tutor Socrático conserva decisiones esenciales en manos del estudiante. Fuente: Elaboración propia.

Problemática y estado del arte

En ICC-101-T, una solución sintácticamente válida puede dejar intacto el error que importa. Un estudiante puede copiar un recorrido de arreglo sin comprender por qué el índice comienza en cero, ajustar una condición hasta que el programa termine o repetir una función sin reconocer sus entradas y salidas. Estas dificultades exigen retroalimentación oportuna, pero el tiempo docente es limitado. Los asistentes generales parecen llenar el vacío porque están disponibles y producen ejemplos con rapidez. Sin embargo, fueron optimizados para completar instrucciones, no para proteger una secuencia didáctica. Suelen inferir que la mejor ayuda es la solución más acabada. En un entorno profesional eso puede aumentar productividad; en un curso inicial puede saltar desde la confusión hasta el producto final y eliminar la observación del razonamiento intermedio. El desafío no consiste solo en evitar respuestas extensas. Consiste en reconocer el estado del estudiante, decidir qué apoyo es proporcional, mantener continuidad y conservar evidencia que permita al docente interpretar cómo se construyó la respuesta.

Esta diferencia puede entenderse mediante la descarga cognitiva. Las personas usan recursos externos para reducir demandas de memoria, cálculo o atención, algo adaptativo cuando libera capacidad para tareas complejas [10]. El problema aparece cuando el recurso reemplaza la práctica que debía consolidar una habilidad. Un almacén externo puede disminuir el esfuerzo de estudio y cambiar lo recordado [11], e incluso incrementar errores cuando la persona confía en que la información seguirá accesible [12]. Con IA, el costo puede incluir pérdida de confianza para resolver, aceptación sin inspección y debilitamiento de hábitos metacognitivos [13]. Por eso, el Tutor Socrático no trata cada solicitud como una orden. La interpreta como evidencia parcial de un estado cognitivo. “Hazme este ejercicio” puede esconder desconocimiento del enunciado, dificultad para descomponerlo o prisa. Antes de producir código, el sistema debe distinguir esas posibilidades y devolver al estudiante una decisión que todavía le pertenezca.

La evidencia empírica vuelve concreta esa preocupación. En un estudio sobre chatbots en educación de programación, el rendimiento pasó de 48.33 a 74.47 puntos, con un tamaño de efecto reportado de 1.56, pero el beneficio convivió con una señal crítica: ante respuestas incorrectas de la IA, 33 de 36 estudiantes las siguieron y 22 copiaron y pegaron el contenido [14]. El dato muestra que una herramienta puede elevar resultados inmediatos y, simultáneamente, reforzar conductas de dependencia. En otra disciplina, un ensayo a gran escala en matemáticas encontró que el acceso a IA con salvaguardas podía apoyar la práctica, mientras la versión sin guardas podía perjudicar el aprendizaje posterior cuando la herramienta dejaba de estar disponible [15]. No corresponde trasladar esos efectos de manera automática a ICC-101-T, pero sí reconocer el mecanismo de riesgo: si la interfaz recompensa obtener una respuesta y no justificarla, el estudiante aprende a optimizar la conversación, no necesariamente el concepto. De ahí que la seguridad pedagógica deba diseñarse en el flujo del sistema y no quedar como una recomendación escrita al inicio de la sesión.

Los proyectos más próximos al estado del arte han comenzado a responder con guardas y conversación guiada. CodeHelp limita la entrega de soluciones completas y organiza el apoyo para clases de programación a escala [16]. Ruffle & Riley explora un tutor conversacional basado en modelos de lenguaje y documenta las decisiones de diseño necesarias para sostener una interacción pedagógica [17]. Un estudio controlado con 42 participantes comparó un asistente guiado, que evitaba soluciones directas, con uno de uso irrestricto; el grupo guiado mostró mejores mejoras de aprendizaje, aunque los autores también identificaron intentos de eludir las restricciones mediante instrucciones adversarias [18]. Más recientemente, un estudio aleatorizado con 94 estudiantes informó que un agente conversacional socrático superó a una versión no socrática en rendimiento y pensamiento reflexivo, con diferencias particularmente visibles en reflexión y reflexión crítica, pero sin ventaja equivalente en motivación [19]. En conjunto, estas investigaciones apoyan una idea sobria: las restricciones pedagógicas pueden ser valiosas, pero necesitan persistencia, medición y un diseño resistente a la variabilidad de los modelos.

Aun así, una respuesta socrática aislada no constituye un sistema de tutoría. Un chatbot puede formular una buena pregunta y perderla en el turno siguiente, consultar un material que no pertenece a la clase, mostrar información de otro usuario o generar un informe sin trazabilidad. También puede impedir toda ayuda bajo la etiqueta de seguridad, frustrando a quien necesita una explicación legítima. El reto arquitectónico consiste en coordinar elementos con objetivos distintos: control de acceso, contexto académico, memoria, recuperación documental, llamadas a herramientas, transmisión progresiva de la respuesta, registro de eventos y revisión docente. Además, la relación entre usuario y modelo de código no es neutral. Estudios sobre programadores muestran que las personas alternan entre acelerar una tarea y explorar lo que el modelo puede hacer, lo cual modifica la forma de inspeccionar y aceptar sugerencias [20]. Para principiantes, esa asimetría es mayor porque disponen de menos criterios para verificar. La plataforma debe, por tanto, conservar la frontera entre una explicación persuasiva y una evidencia autorizada, entre una sugerencia y una decisión académica, y entre el rol técnico de una cuenta y su pertenencia real a una clase.

El vacío que motivó el proyecto fue precisamente esa integración. Existían asistentes generales con gran capacidad de generación, prototipos con guardas conversacionales y estudios que demostraban el potencial del método socrático, pero faltaba una propuesta local que uniera pedagogía, control institucional y herramientas de programación en una misma cadena verificable. El Tutor Socrático aborda el problema sin asumir que la prohibición es sostenible ni que el acceso irrestricto es educativo. Su tesis de diseño es que la ayuda debe estar delimitada por el propósito de la asignatura y por el progreso expresado en la conversación. Una respuesta útil no se mide solo por su exactitud, sino por lo que permite hacer después sin la herramienta. La recuperación de práctica, por ejemplo, produce más aprendizaje que formas de estudio elaborativo cuando obliga a reconstruir activamente el conocimiento [21]. Trasladado al diálogo, esto significa que el sistema debe pedir al estudiante que prediga, explique, trace o corrija antes de formalizar la solución. Esa regla conecta la literatura con una necesidad concreta de aula y justifica que el proyecto se evalúe como plataforma académica, no como una colección de prompts.

Objetivos completados

El proyecto completó la implementación de un sistema de tutoría inteligente para Introducción a la Algoritmia que orienta mediante apoyo cognitivo progresivo, preguntas reflexivas, pistas y explicaciones graduadas. El sistema se diseñó para promover la descomposición de problemas, el razonamiento algorítmico y la construcción lógica, al tiempo que limita la entrega ordinaria de soluciones completas generadas por herramientas de propósito general. Para cumplir ese objetivo se diseñó y consolidó una arquitectura replicable y se materializó en una plataforma académica funcional; se recopiló y organizó conocimiento pedagógico de la asignatura, incluidos contenidos, ejercicios representativos, materiales autorizados y estrategias de acompañamiento docente; se construyó y evaluó un motor de razonamiento pedagógico basado en modelos de lenguaje y estrategias socráticas; y se implementó una interfaz conversacional que mantiene el registro de las progresiones de razonamiento y permite intervenciones en múltiples etapas. La solución integra, además, identidad académica, permisos contextuales, memoria, recuperación documental, preguntas estructuradas, actividades formativas, informes revisables y depuración visual de código C.

Metodología
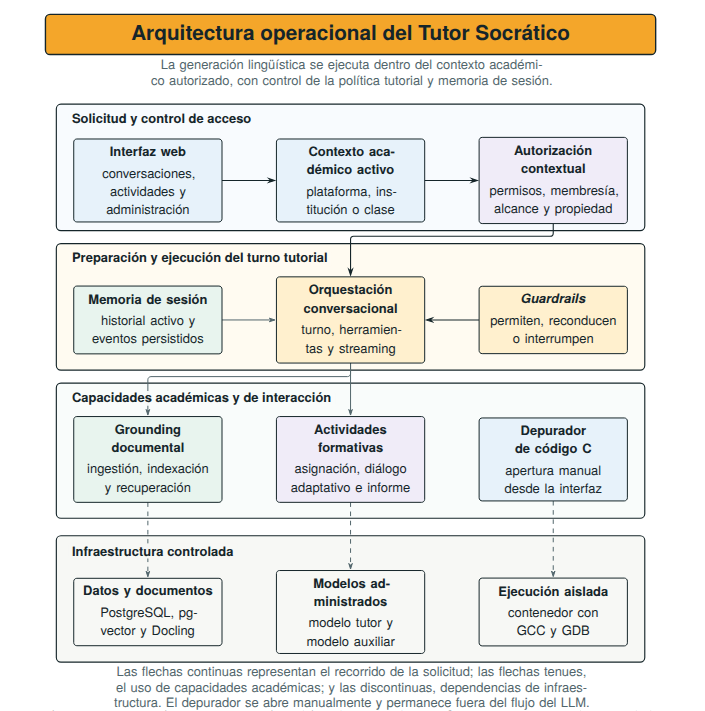
Arquitectura operacional implementada del Tutor Socrático
Figura 2. Arquitectura operacional implementada del Tutor Socrático. Fuente: Reproducción íntegra de la figura documentada en el proyecto.

La solución se construyó a partir de una separación explícita entre la plataforma y el modelo de lenguaje. La plataforma autentica a la persona, resuelve el contexto académico activo, comprueba permisos y propiedad, conserva el historial, habilita recursos y registra los eventos del turno. El modelo recibe únicamente el contexto preparado por esos servicios, interpreta las instrucciones tutoriales y produce una intervención o una llamada estructurada a una herramienta disponible. Esta distribución de responsabilidades impide trasladar al texto generado decisiones institucionales como la pertenencia a una clase, la lectura de un material o la modificación de una evidencia. La arquitectura se organiza en una interfaz académica, servicios de dominio autorizados, el harness tutorial, persistencia conversacional, materiales y herramientas, y un servidor de inferencia reemplazable. El harness coordina la guardia, la memoria, el contexto académico y las llamadas a herramientas; no representa un modelo adicional ni una clase aislada. La Figura 2 muestra las fronteras y el sentido del flujo: la autorización ocurre antes de construir el contexto, y las herramientas se ejecutan mediante servicios controlados cuando el modelo las solicita.

La autorización se aplica antes de invocar la inteligencia artificial. El dominio distingue tres niveles: plataforma, institución y clase. Una misma cuenta puede asumir funciones diferentes en espacios distintos, por lo que el sistema separa el rol configurable de la identidad académica expresada por la membresía. Cada operación combina el permiso requerido, la institución, la pertenencia a la clase y la propiedad del recurso cuando corresponde. La protección se repite en la navegación y en los servicios: ocultar una opción de menú mejora la interfaz, pero la decisión efectiva se toma en la capa que consulta o modifica los datos. Los permisos se expresan mediante códigos estables de recurso y acción, mientras las instantáneas de acceso se almacenan temporalmente y se invalidan cuando cambia un rol o una asignación. En consecuencia, una conversación, un material o una actividad se recuperan dentro del espacio autorizado antes de formar el contexto del modelo. Esta estructura permite que el profesor administre los recursos de sus clases y que el estudiante acceda a sus conversaciones y asignaciones sin convertir ninguna identidad académica en una autoridad global.

Cada turno sigue una cadena explícita. La guardia clasifica el mensaje junto con el historial activo relevante y el contexto de la asignatura; así puede interpretar respuestas breves que dependen de una pregunta anterior. Sus acciones son permitir, reconducir o interrumpir. La versión reconducida es la que continúa hacia la memoria, mientras una interrupción detiene la cadena antes de incorporar el contenido a la sesión. Después, el sistema reúne la memoria activa y el contexto académico permitido. El modelo puede generar texto o solicitar una herramienta registrada. Una de ellas, interrogateUser, presenta de una a tres preguntas diagnósticas con opciones o respuesta escrita, conserva los borradores, valida el contenido y devuelve el resultado al mismo turno para que continúe la generación. La salida llega a la interfaz en streaming y se persiste como eventos coherentes de usuario, asistente y herramientas. Esta orquestación responde a la posibilidad de generar información no fundamentada [8] y a los intentos de eludir restricciones conversacionales [18].

La memoria distingue la evidencia persistente del contexto enviado a inferencia. Cada conversación utiliza una sesión basada en eventos ordenados; estos pueden marcarse como reales, sintéticos o archivados. La interfaz conserva la transcripción de los mensajes reales, mientras el modelo recibe la memoria sintética más reciente y los turnos activos que caben dentro del presupuesto configurado. Cuando el historial alcanza el umbral de compactación, la estrategia recorre los eventos desde el más reciente, conserva una ventana de intercambios y resume la parte anterior. El punto de corte se desplaza hasta un evento raíz de usuario para no separar una respuesta o una salida de herramienta de la pregunta que le da sentido. El resumen previo puede incorporarse de manera recursiva, y los eventos antiguos se archivan en lugar de eliminarse. Con ello, la plataforma mantiene dos proyecciones del mismo historial: una transcripción canónica para consulta y trazabilidad, y una memoria sintética para sostener continuidad sin reenviar toda la conversación en cada turno.

Sobre esa base, la política socrática se implementó como una progresión regulada por los indicios del diálogo. El tutor intenta localizar la dificultad mediante una explicación del objetivo, una predicción, un intento de código o la identificación del punto de bloqueo. Después propone una acción abordable, como formular una condición o trazar algunas iteraciones. Si el intento registrado muestra estancamiento, introduce una pista limitada; posteriormente puede formalizar el concepto y plantear una variación para comprobar la continuidad del razonamiento. El nivel de ayuda cambia según las respuestas conservadas en la conversación y el tutor puede corregir una idea cuando el intercambio aporta evidencia suficiente. Este diseño coincide con estudios donde el diálogo socrático se relacionó con mejor rendimiento y pensamiento reflexivo [19], y con propuestas que utilizan la IA como apoyo a la metacognición y la autorregulación [22]. El propósito de la secuencia es mantener una acción intelectual concreta en el siguiente turno, no prolongar una cadena de preguntas sin orientación.

El grounding documental incorpora materiales proporcionados por el profesor mediante un flujo revisable. El documento se asocia con la clase activa, Docling lo transforma a Markdown y segmentos, y la interfaz permite revisar el contenido antes de aprobarlo. Tras la aprobación, el servicio calcula embeddings y almacena los fragmentos con metadatos de procedencia, clase, autor, posición, estado e identificador de ingestión. La recuperación se ofrece al tutor mediante herramientas para buscar materiales y continuar la lectura de un documento. Antes de consultar el índice vectorial, el servicio exige la clase autorizada y filtra por ese contexto y por el estado disponible; el modelo recibe los fragmentos que el sistema ya delimitó. La búsqueda semántica se combina con cursores opacos para avanzar dentro de la misma fuente sin exponer identificadores internos. Este enfoque se relaciona con la generación aumentada por recuperación, que combina el conocimiento paramétrico con evidencia externa [23]. En el Tutor Socrático, su función es vincular la explicación con materiales académicos revisados y conservar la procedencia de lo recuperado. La Figura 3 muestra la carga del PDF transformado y la revisión de sus segmentos antes de la indexación.
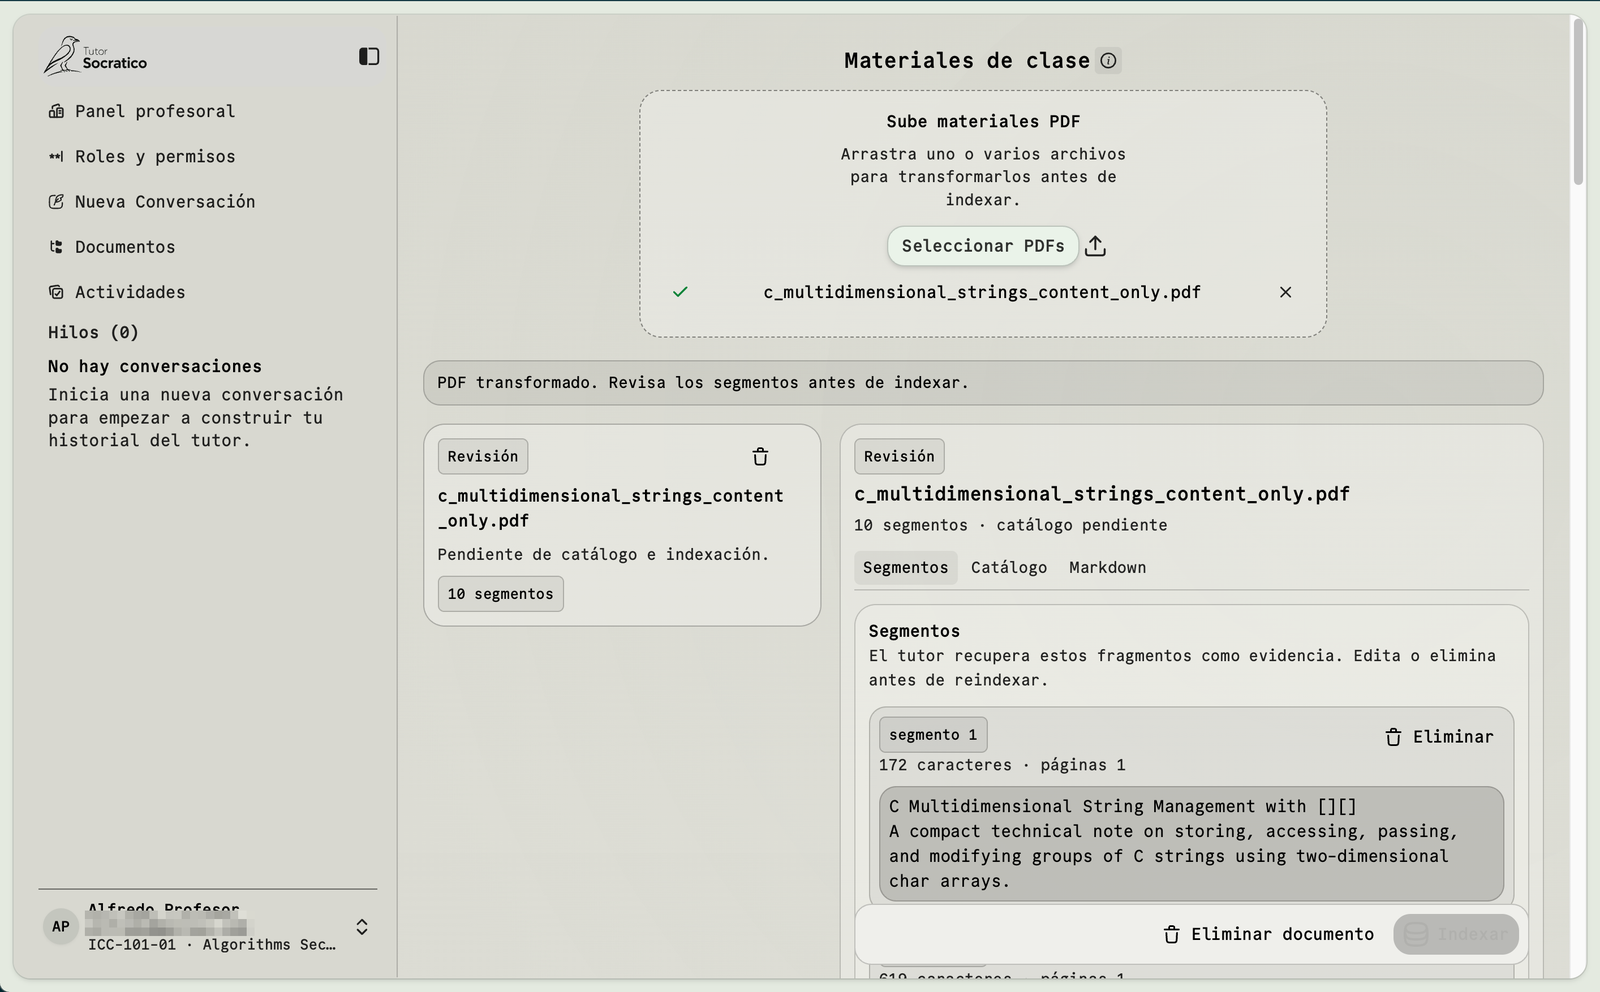
Vista docente para cargar un material PDF y revisar los segmentos transformados antes de su indexación
Figura 3. Vista docente para cargar un material PDF y revisar los segmentos transformados antes de su indexación. Fuente: Captura original del flujo de grounding documental conservada en la versión actualizada del proyecto.

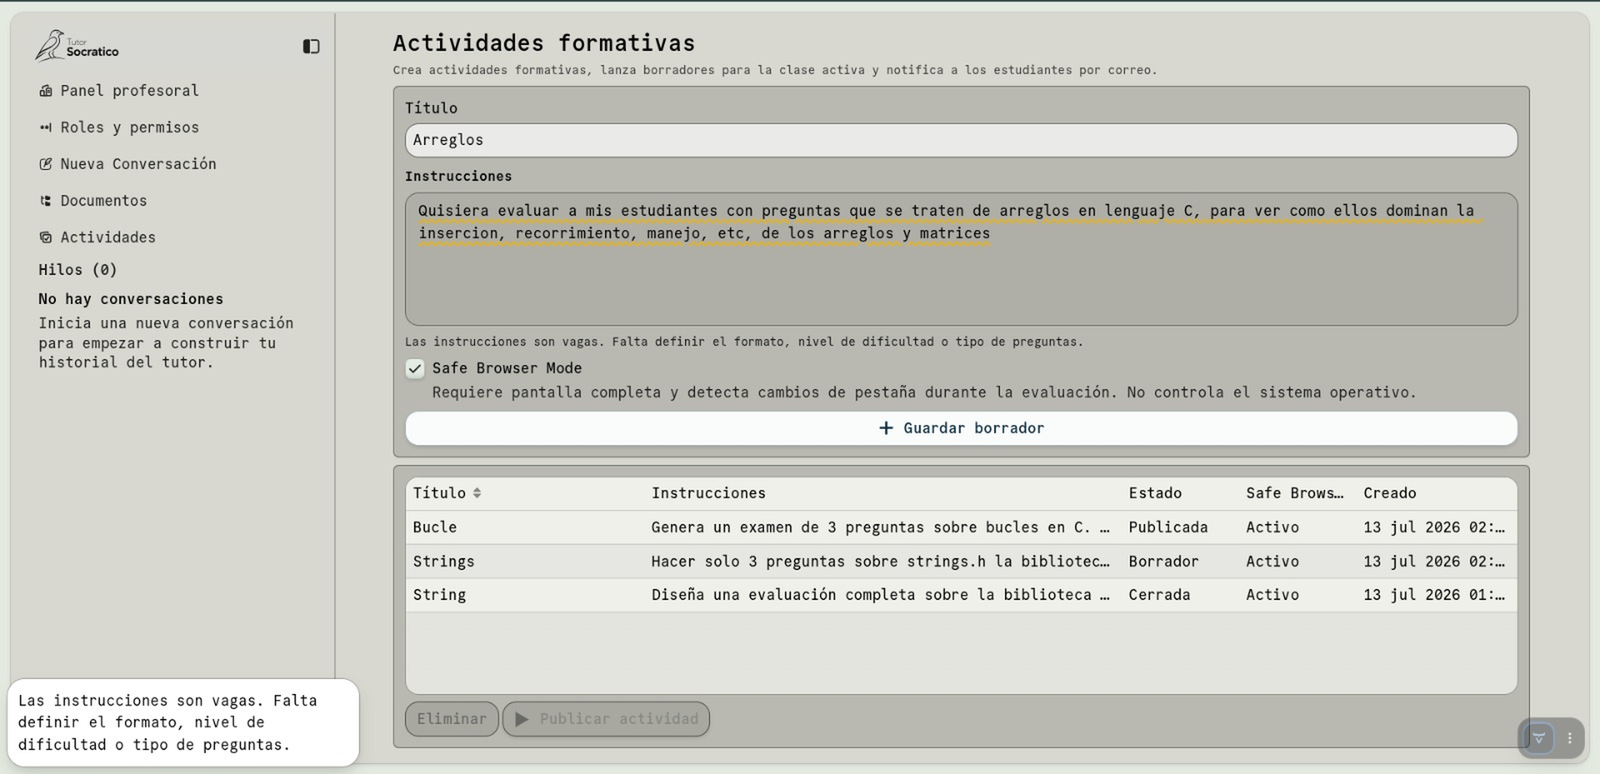
El módulo de actividades formativas amplía la tutoría más allá de una conversación iniciada libremente por el estudiante. El profesor redacta una consigna, la guarda como borrador y puede solicitar una revisión asistida que combina validaciones locales con una salida estructurada del modelo auxiliar. La revisión identifica ambigüedades, ausencia de criterios verificables o condiciones que dificultarían observar el razonamiento; su propuesta queda sujeta a la decisión del docente. Al publicar, el sistema crea las asignaciones correspondientes y comunica su disponibilidad. Durante la realización, un servicio adaptativo genera la primera pregunta y, después de cada respuesta, decide de forma estructurada si debe continuar o completar la actividad según la evidencia reunida. Cada intercambio conserva la pregunta exacta y la respuesta del estudiante. Al finalizar, el sistema genera un informe revisable que mantiene la transcripción canónica como fundamento. El modo de navegación controlada, cuando se habilita, registra eventos como pérdida de visibilidad, salida de pantalla completa, desenfoque o interrupción del latido y puede producir una alerta para revisión. Las Figuras 4 y 5 muestran el flujo y la vista real de preparación de una actividad.
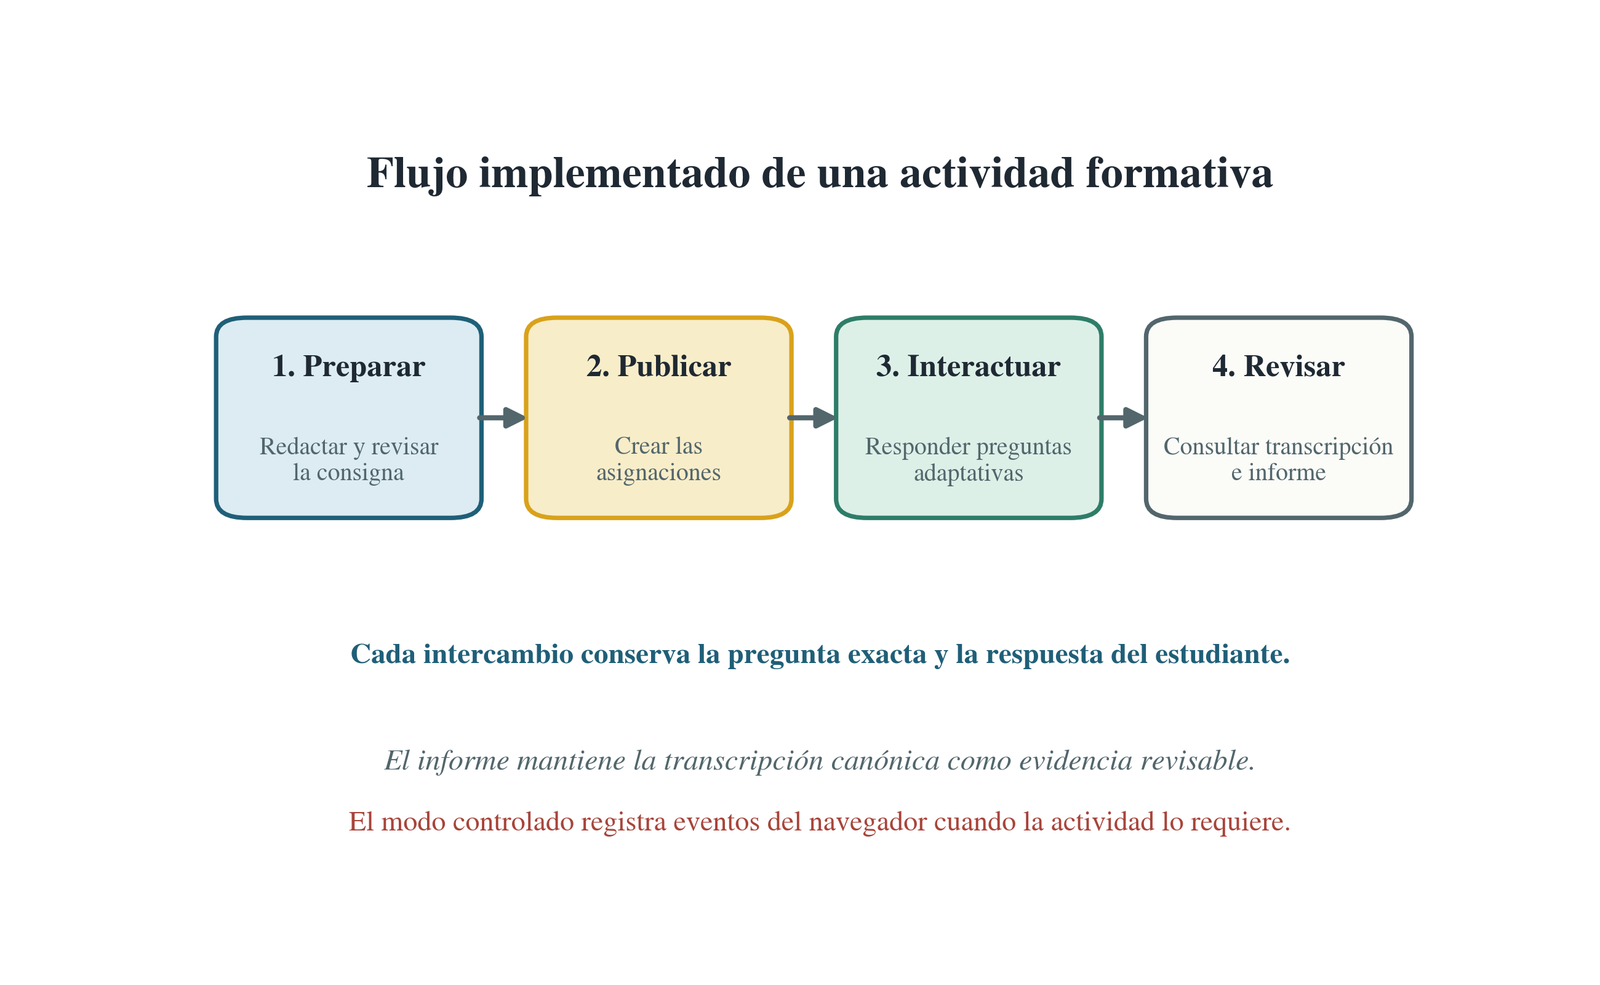
Flujo de una actividad formativa: preparación y revisión de la consigna, publicación, interacción adaptativa y consulta de la transcripción y del informe
Figura 4. Flujo de una actividad formativa: preparación y revisión de la consigna, publicación, interacción adaptativa y consulta de la transcripción y del informe. Fuente: Elaboración propia a partir del módulo implementado.
Vista docente para redactar una actividad, revisar la calidad de la consigna, configurar el modo de navegación y conservarla como borrador
Figura 5. Vista docente para redactar una actividad, revisar la calidad de la consigna, configurar el modo de navegación y conservarla como borrador. Fuente: Captura original del prototipo final conservada en el proyecto.

El depurador visual constituye una herramienta propia de la plataforma y se abre manualmente desde un bloque de código; el modelo no la activa dentro de la cadena de herramientas. El servidor crea un espacio temporal y ejecuta GCC o GDB en un contenedor con límites de tiempo, memoria, CPU, procesos y salida. La comunicación con GDB utiliza su interfaz de máquina, y el analizador convierte la traza real en una secuencia de instantáneas con la línea activa, las variables, la salida estándar y las líneas ejecutables. En la interfaz, el estudiante puede iniciar, avanzar una instrucción, desplazarse hasta una línea ejecutable y reiniciar el recorrido. El editor muestra el código y los diagnósticos de compilación; la tabla de variables presenta valores simples, arreglos, matrices y direcciones cuando GDB las expone; y la terminal reúne entrada y salida. Esta representación permite relacionar una instrucción de C con el cambio de estado que produce. La Figura 6 documenta la vista integrada del depurador, con los controles, las variables, la línea resaltada, el código fuente y la terminal dentro del espacio de trabajo del tutor.
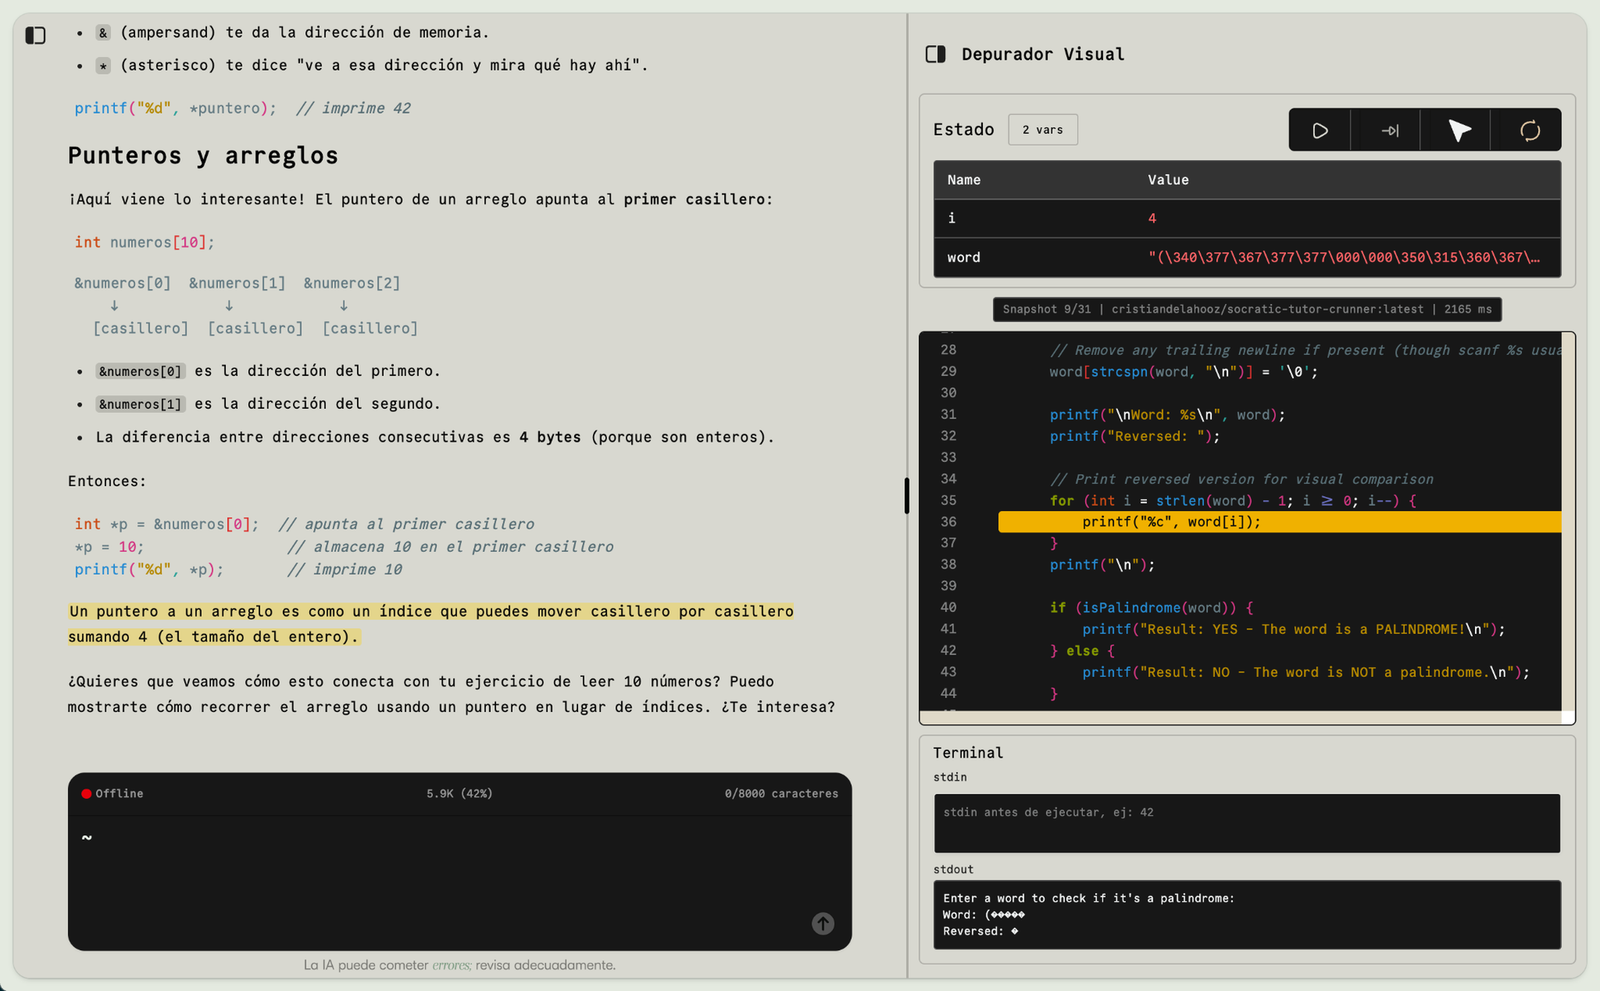
Vista integrada del depurador de C con controles de recorrido, variables, línea activa, código fuente y terminal
Figura 6. Vista integrada del depurador de C con controles de recorrido, variables, línea activa, código fuente y terminal. Fuente: Captura original del sistema integrado conservada en el proyecto.

El ajuste supervisado se desarrolló como un experimento complementario de especialización conversacional. Cinco conversaciones docentes sobre ciclos, funciones, arreglos, matrices y cadenas sirvieron para extraer patrones de intervención: localizar la dificultad, formular una pregunta contestable, ofrecer una pista limitada, formalizar después del intento y comprobar la continuidad del razonamiento. Esos patrones se expandieron en diálogos sintéticos multivuelta sometidos a curación manual, con prioridad en la calidad y diversidad de las demostraciones [24], [25]. El entrenamiento utilizó Qwen3-8B cuantizado a cuatro bits y QLoRA, técnica que mantiene congelado el modelo base y actualiza adaptadores de bajo rango para reducir el uso de memoria [26]. La comparación cualitativa examinó cadenas, una operación de cajero y el recorrido de matrices. Después, el artefacto se probó dentro del harness, donde debía coordinar memoria, contexto recuperado y herramientas. Para la plataforma integrada se seleccionó Ornith 9B por la continuidad observada en esas pruebas, mientras el ajuste de Qwen3 se conservó como evidencia experimental del cambio en el patrón de respuesta.

Resultados

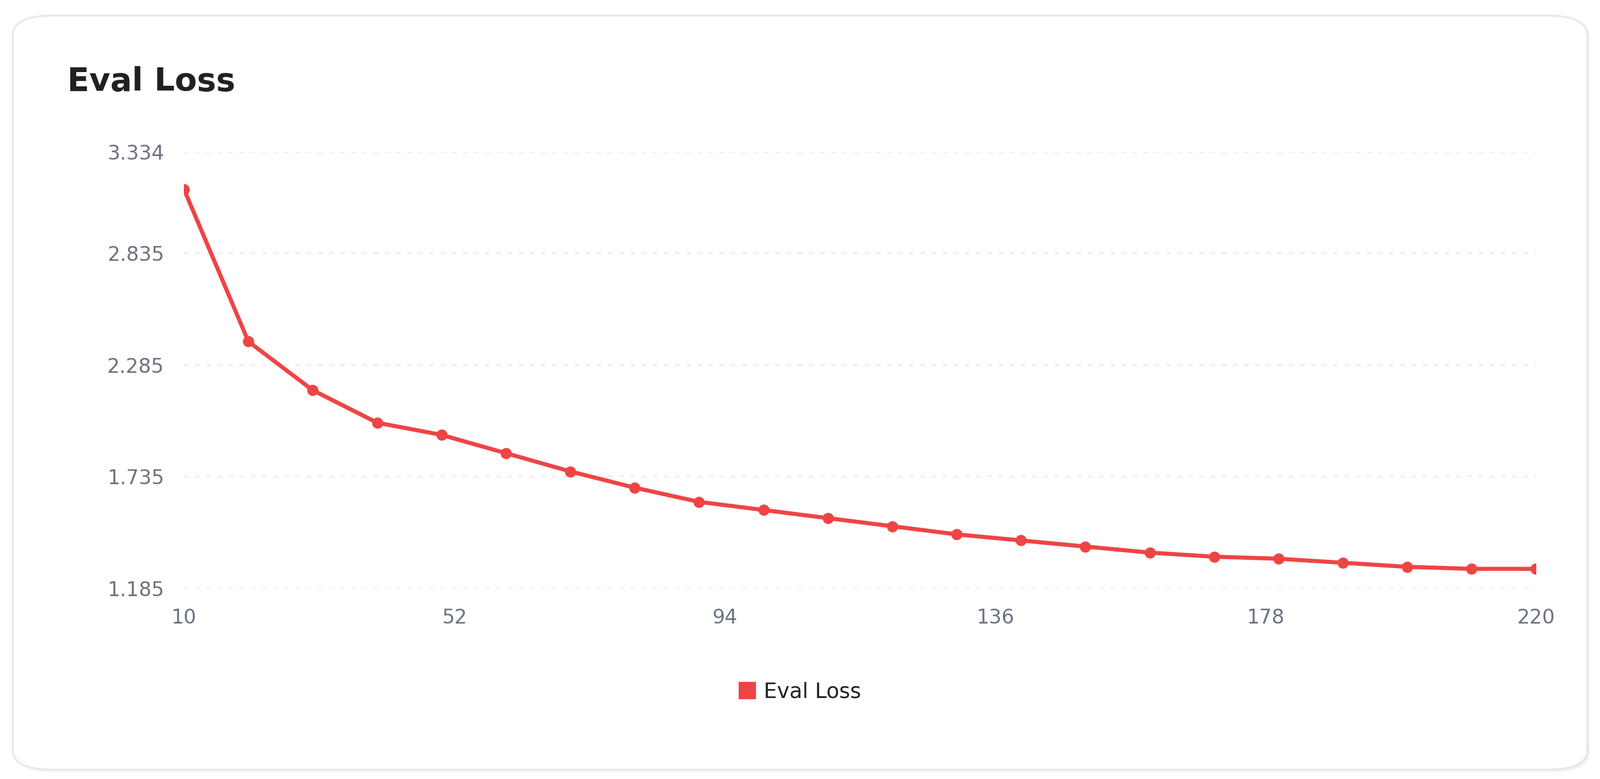
Las métricas de la corrida documentada muestran que los adaptadores se aproximaron al patrón conversacional utilizado en el ajuste. La pérdida de entrenamiento descendió con rapidez al inicio y continuó bajando de manera gradual durante las épocas registradas. La pérdida de evaluación, calculada sobre conversaciones retenidas, pasó aproximadamente de 3.1 a 1.3 y mantuvo una tendencia descendente hasta el último punto visible. La norma del gradiente permaneció en un rango finito mientras la tasa de aprendizaje siguió el calentamiento y el decaimiento configurados. Leídas en conjunto, estas señales documentan una optimización estable del objetivo supervisado: respuestas en español para programación introductoria en C, con diagnóstico, ayuda parcial y continuidad entre turnos. Las Figuras 7 y 8 reproducen las capturas originales utilizadas en el capítulo de resultados del proyecto. La primera muestra la pérdida de entrenamiento y su tendencia suavizada; la segunda presenta la pérdida de evaluación obtenida periódicamente durante la misma ejecución. El análisis conductual posterior permitió observar cómo ese cambio estadístico se manifestaba en las conversaciones comparadas.
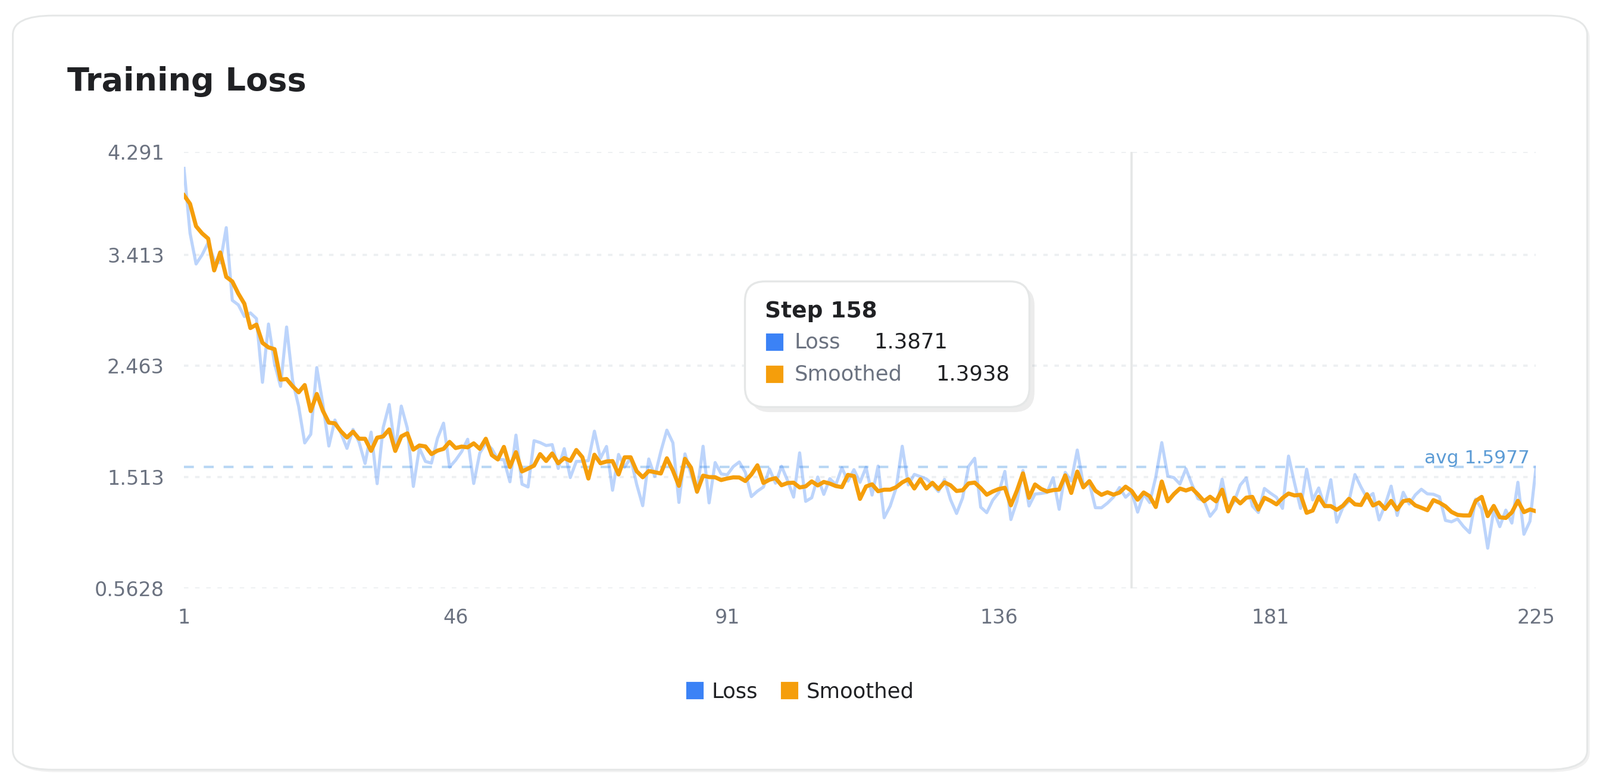
Pérdida de entrenamiento por paso y tendencia suavizada durante la corrida QLoRA documentada
Figura 7. Pérdida de entrenamiento por paso y tendencia suavizada durante la corrida QLoRA documentada. Fuente: Captura original utilizada en el capítulo de resultados del proyecto.
Pérdida de evaluación sobre las conversaciones retenidas, calculada periódicamente durante la corrida documentada
Figura 8. Pérdida de evaluación sobre las conversaciones retenidas, calculada periódicamente durante la corrida documentada. Fuente: Captura original utilizada en el capítulo de resultados del proyecto.

En los tres escenarios ilustrativos, el cambio de comportamiento buscado apareció de forma reconocible. Qwen3 base comenzaba con implementaciones extensas o asumía decisiones del ejercicio; el modelo ajustado iniciaba con preguntas de diagnóstico, dividía el problema y ofrecía fragmentos de ayuda. En cadenas distinguió la dificultad antes de presentar código; en el escenario de cajero separó las operaciones y los datos necesarios; y en matrices pidió identificar el recorrido, el valor conservado y la condición de parada. Al incorporar el checkpoint al harness, el equipo observó respuestas breves o repetitivas en intercambios multivuelta y menor estabilidad al coordinar herramientas. Ornith 9B mantuvo mayor continuidad dentro del flujo completo, que combina instrucciones, historial, evidencia recuperada y resultados de herramientas, y por ello se eligió como modelo tutorial operativo. El resultado de ingeniería quedó así dividido en dos artefactos con funciones documentadas: Qwen3 ajustado como experimento de cambio conductual y Ornith como modelo servido durante la evaluación de la plataforma integrada.

La evaluación final examinó la versión integrada de la plataforma con Ornith, la conversación guiada, el depurador y los flujos académicos implementados. El instrumento estudiantil se organizó alrededor de dos escenarios de uso, arreglos unidimensionales y matrices, junto con un bloque de percepción general. Sus ítems recogieron claridad, apoyo para comprender la lógica, utilidad de las explicaciones y experiencia con las herramientas. El instrumento docente revisó por separado el tutor conversacional, el depurador paso a paso, las actividades formativas y el reporte disponible para el profesor; también incluyó observaciones abiertas, banderas críticas y un dictamen global. El análisis mantuvo separadas ambas poblaciones porque cada instrumento responde a una pregunta diferente: la experiencia de uso en los escenarios estudiantiles y la alineación técnica y pedagógica observada por docentes. Para cada bloque se calcularon media, mediana y proporción de valoraciones situadas en los niveles 4 y 5. Esta estructura permite leer los agregados junto con los comentarios asociados a componentes concretos del sistema.

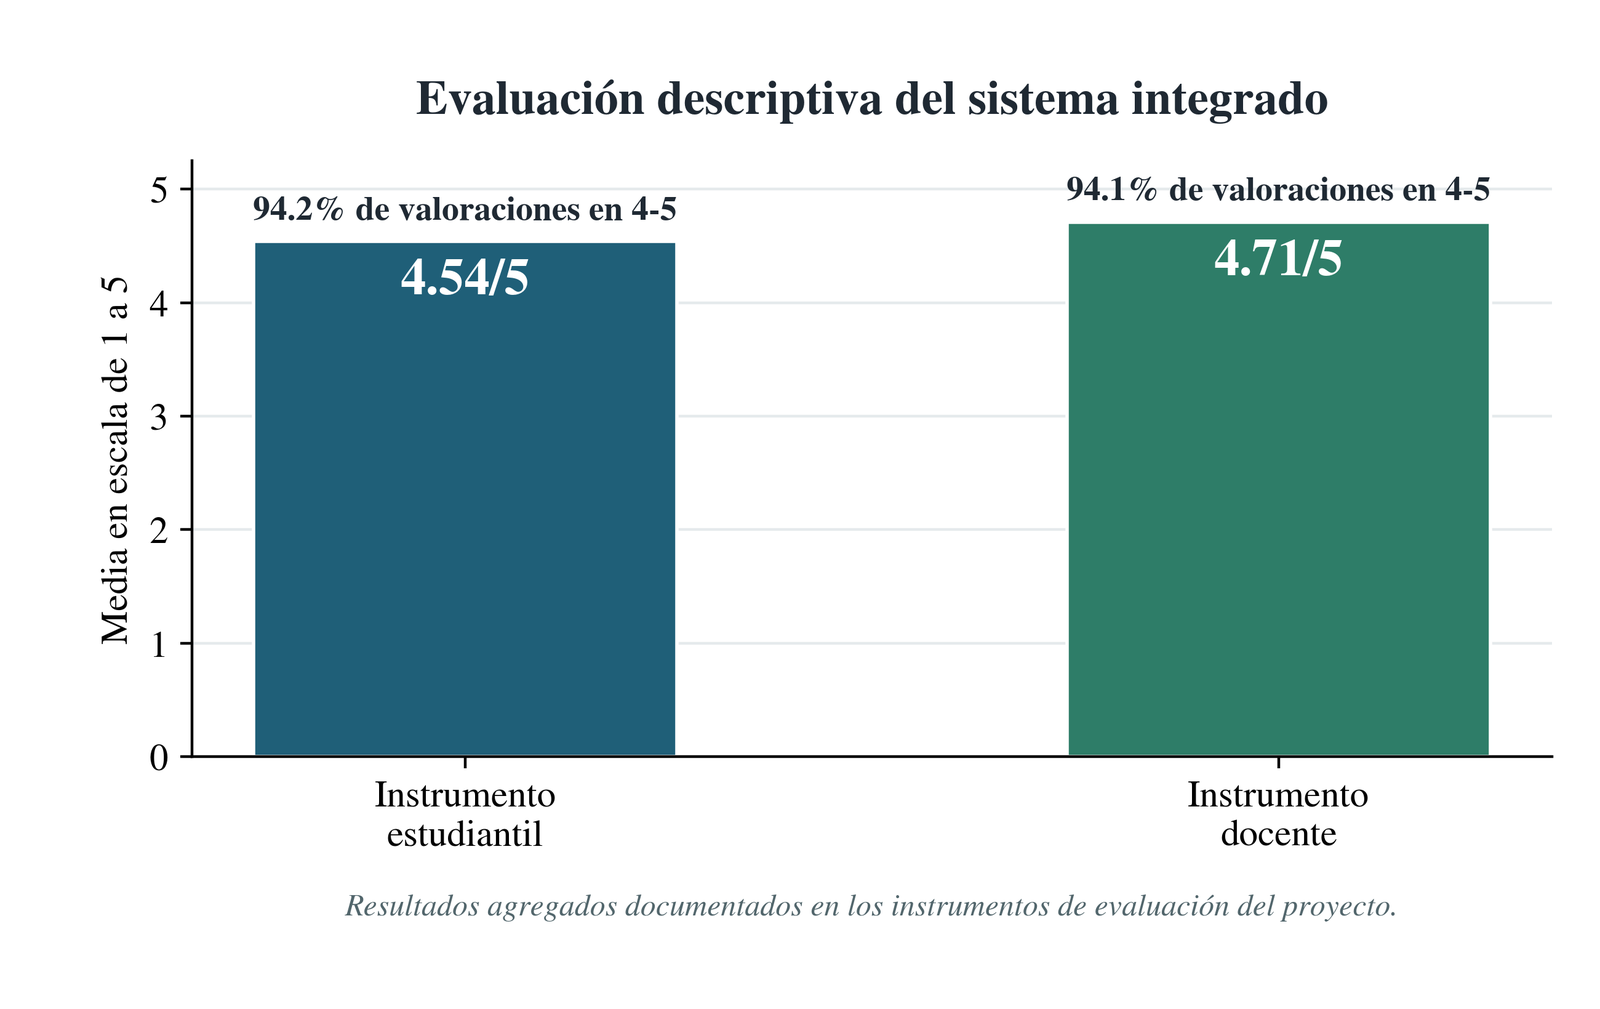
El instrumento estudiantil alcanzó una media global de 4.54 sobre 5, una mediana de 5 y un 94.2 % de valoraciones en los niveles 4 y 5. El escenario de arreglos unidimensionales obtuvo una media de 4.60; el escenario de matrices, 4.45; y el bloque de percepción general, 4.58. Los valores muestran una concentración favorable en los tres bloques y, al mismo tiempo, permiten localizar interacciones con menor claridad percibida. Las puntuaciones más bajas aparecieron en el apoyo sobre contadores y acumuladores, en el diagnóstico inicial del escenario de matrices y en una tarea de copia entre matrices. Las respuestas abiertas destacaron los ejemplos y la posibilidad de recibir explicaciones desde los fundamentos. También señalaron que el depurador era fácil de comprender y ayudaba a seguir el comportamiento del programa. Un comentario indicó que todavía no se dominaba el uso de punteros, lo que aporta contexto para interpretar esa parte de la experiencia sin convertir el promedio global en una descripción uniforme de cada concepto trabajado.

La síntesis docente documentó una media global de 4.71 sobre 5, mediana de 5 y 94.1 % de valoraciones en los niveles 4 y 5. El tutor conversacional obtuvo una media de 4.60 y el reporte al profesor, 4.50. El depurador paso a paso alcanzó 5.00 y concentró todas sus valoraciones válidas en el nivel máximo, el respaldo más uniforme entre los componentes examinados. Los comentarios docentes destacaron la ejecución por líneas, la visualización de variables y memoria y la posibilidad de seguir el flujo del programa. Ese resultado coincide con las menciones estudiantiles y respalda la decisión de integrar la depuración al espacio del tutor. Los dictámenes globales registrados utilizaron la categoría “Alineación suficiente para validación controlada”. La Figura 9 muestra el reporte revisable disponible para el profesor después de una actividad formativa. La Figura 10 conserva el diseño comparativo de la síntesis final y presenta únicamente los agregados globales documentados para estudiantes y docentes; los porcentajes corresponden a valoraciones de ítems ubicadas en los niveles superiores de sus respectivas escalas.
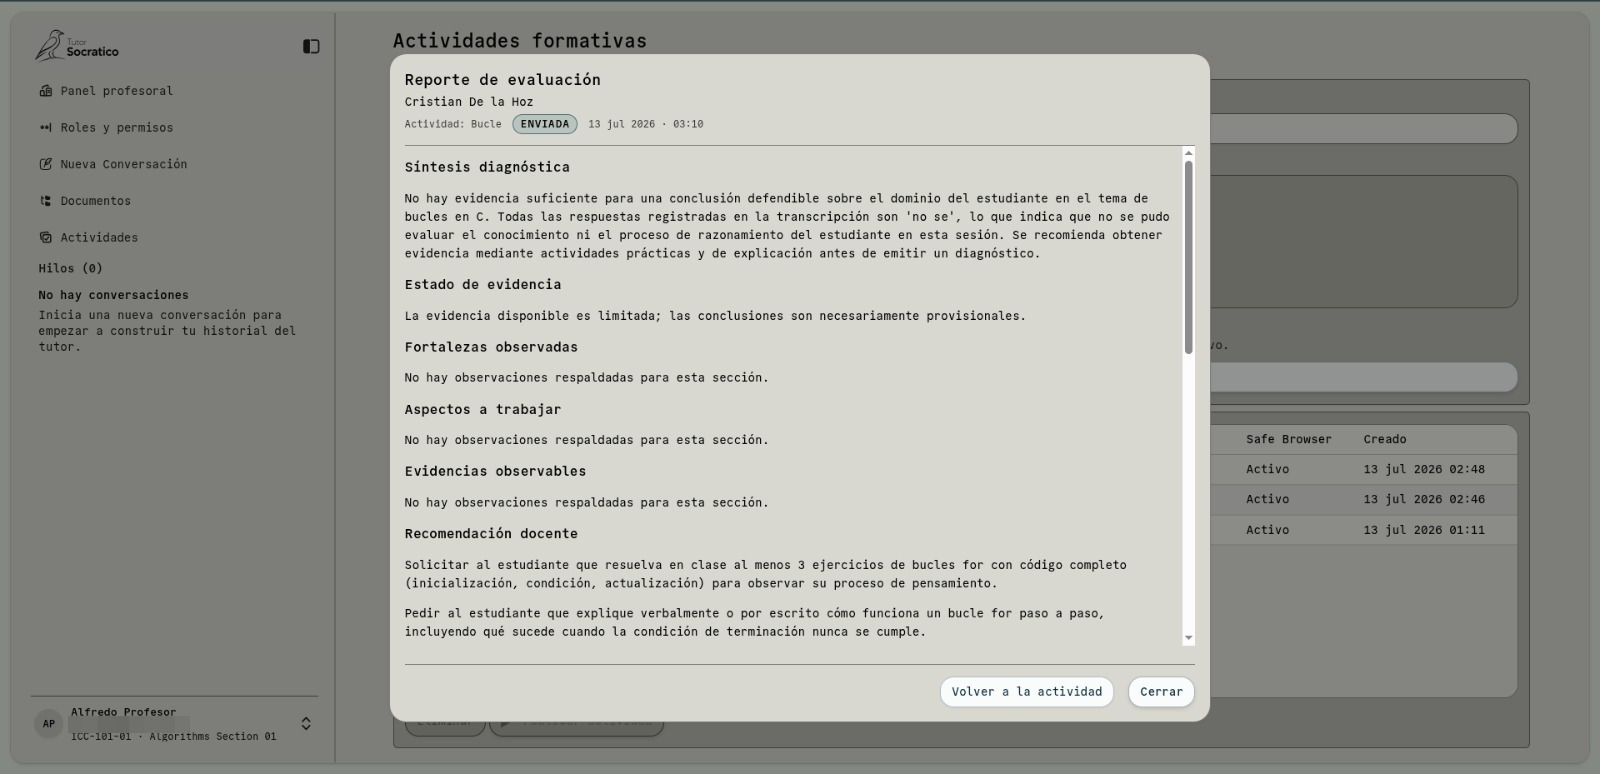
Reporte de evaluación disponible para el profesor después de una actividad formativa, con síntesis diagnóstica, estado de evidencia, observaciones y recomendación docente
Figura 9. Reporte de evaluación disponible para el profesor después de una actividad formativa, con síntesis diagnóstica, estado de evidencia, observaciones y recomendación docente. Fuente: Captura original del prototipo final conservada en el proyecto.
Síntesis de las medias globales y de la proporción de valoraciones ubicadas en los niveles 4 y 5 de cada instrumento
Figura 10. Síntesis de las medias globales y de la proporción de valoraciones ubicadas en los niveles 4 y 5 de cada instrumento. Fuente: Elaboración propia a partir de los resultados agregados documentados en el proyecto.

Los comentarios abiertos precisaron las prioridades de la siguiente iteración. En la experiencia estudiantil aparecieron solicitudes de mayor rapidez, una observación sobre la rigidez del tutor al aplicar sus restricciones y la preferencia por una apariencia clara o modo blanco. En la revisión docente se propuso incorporar un resumen de temas y un control para solicitar una explicación adicional. También se activó una alerta de posible error conceptual, conservada como caso para revisión. Estas observaciones se relacionan con componentes distintos y, por tanto, conducen a acciones de ingeniería separables: medir el tiempo hasta el primer fragmento y la duración total de la respuesta; calibrar la guardia con mensajes que dependan del turno anterior; ampliar las opciones de visualización; mantener el vínculo entre el informe y la transcripción; y facilitar la revisión de respuestas específicas. La estructura modular permite atender cada punto sin trasladar permisos, memoria o decisiones académicas al modelo de lenguaje.

La lectura conjunta de la evidencia sitúa el aporte principal en el sistema integrado. La conversación organiza preguntas, pistas y explicaciones; la guardia aplica la política antes de la memoria; la compactación conserva una transcripción real y prepara otra proyección para inferencia; el grounding entrega fragmentos revisados dentro de la clase autorizada; las actividades mantienen consignas, respuestas e informes vinculados; y el depurador convierte una ejecución real en instantáneas observables. El ajuste de Qwen3 documenta un cambio complementario en la forma de responder, mientras Ornith sostiene la operación evaluada dentro del harness. Los resultados globales y los dictámenes docentes respaldan la viabilidad funcional y la pertinencia académica de esta combinación para una validación controlada. Dentro de esa síntesis, el depurador sobresale por la uniformidad de su valoración y las actividades muestran cómo la inteligencia artificial puede incorporarse a un flujo preparado y revisado por el profesor, en lugar de quedar limitada a intercambios privados sin una evidencia organizada.

Conclusión

El proyecto alcanzó su objetivo de implementar un sistema de tutoría inteligente que orienta el razonamiento algorítmico mediante diálogo guiado y limita la generación de código como respuesta ordinaria. La solución final no depende exclusivamente de una instrucción socrática. Integra identidad académica, autorización contextual, guardia, memoria basada en eventos, compactación, recuperación documental, actividades formativas, informes y depuración visual de C dentro de un flujo coherente. Esta integración materializa el aporte técnico central: una arquitectura replicable cuyas responsabilidades permanecen separadas del modelo de lenguaje. Los servicios determinan el acceso y preparan el contexto; el modelo interpreta ese contexto y genera la intervención; las herramientas ejecutan operaciones delimitadas; y la persistencia conserva la evidencia asociada con la clase y la persona autorizada. La organización permite sustituir el artefacto de inferencia o adaptar el dominio académico sin reconstruir los límites de autorización, memoria y trazabilidad que sostienen la plataforma.

La memoria y las actividades muestran cómo esa arquitectura se traduce en operación académica. La primera conserva la transcripción real y construye una memoria sintética para el modelo, de modo que la continuidad conversacional no sustituya la evidencia literal del intercambio. Las actividades permiten al profesor redactar y revisar consignas, publicarlas, observar preguntas adaptativas y consultar un informe enlazado con la transcripción canónica. El depurador completa el acompañamiento con una representación ejecutable de líneas, variables, arreglos, matrices, memoria y salida del programa. Fue el componente con el respaldo más uniforme en el instrumento docente, con una media de 5.00, y también apareció en los comentarios estudiantiles como una herramienta fácil de comprender. En conjunto, la evaluación registró una media estudiantil de 4.54 sobre 5 y una media docente de 4.71, con medianas de 5 y una concentración de valoraciones en los niveles superiores de ambas escalas.

El ajuste de Qwen3 aportó un resultado complementario: en los escenarios examinados, el modelo pasó de iniciar con implementaciones extensas a diagnosticar, dividir el problema y ofrecer ayudas parciales. La selección posterior de Ornith reforzó una exigencia de la arquitectura: el modelo operativo debe sostener esa orientación mientras trabaja con memoria, materiales recuperados y herramientas. La evidencia reunida respalda el funcionamiento, la utilidad percibida y la alineación pedagógica del Tutor Socrático en una aplicación controlada. Las siguientes iteraciones tienen una ruta concreta: conservar el depurador como capacidad central, medir y reducir la latencia percibida, calibrar la guardia con mensajes dependientes del contexto, reforzar la revisión de respuestas y ampliar los informes de actividades sin perder su vínculo con la transcripción. Con estas prioridades, el proyecto establece una base técnica y académica para continuar validando una tutoría en la que la inteligencia artificial participa dentro de límites institucionales verificables y el razonamiento del estudiante permanece como objeto principal del acompañamiento.

Referencias

  1. J. M. Wing, “Computational thinking,” Communications of the ACM, vol. 49, no. 3, pp. 33-35, 2006, doi: 10.1145/1118178.1118215.
  2. J. Insuasti Portilla, “Problemas de enseñanza y aprendizaje de los fundamentos de programación,” Educación y Desarrollo Social, vol. 10, no. 2, pp. 234-246, 2016, doi: 10.18359/reds.1701.
  3. L. Beato-Castro, C. Hevia, L. Lehoux y L. A. Fermín-Genao, “Formación inicial y permanente de los docentes en pensamiento computacional: percepciones y preconcepciones en el contexto dominicano,” Cuaderno de Pedagogía Universitaria, vol. 20, no. 39, pp. 158-176, 2023, doi: 10.29197/cpu.v20i39.494.
  4. M. B. Garcia, “Teaching and learning computer programming using ChatGPT: A rapid review of literature amid the rise of generative AI technologies,” Education and Information Technologies, vol. 30, no. 12, pp. 16721-16745, 2025, doi: 10.1007/s10639-025-13452-5.
  5. J. Nathaniel, S. S. Oyelere, J. Suhonen y M. Tedre, “Literature review on the integration of generative AI in programming education,” International Journal of Artificial Intelligence in Education, vol. 35, no. 5, pp. 2724-2755, 2025, doi: 10.1007/s40593-025-00524-3.
  6. M. Abbas, F. A. Jam y T. I. Khan, “Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students,” International Journal of Educational Technology in Higher Education, vol. 21, art. 10, 2024, doi: 10.1186/s41239-024-00444-7.
  7. G. Fan, D. Liu, R. Zhang y L. Pan, “The impact of AI-assisted pair programming on student motivation, programming anxiety, collaborative learning, and programming performance,” International Journal of STEM Education, vol. 12, art. 16, 2025, doi: 10.1186/s40594-025-00537-3.
  8. Z. Ji et al., “Survey of hallucination in natural language generation,” ACM Computing Surveys, vol. 55, no. 12, 2023, doi: 10.1145/3571730.
  9. J. Yang y D.-M. Córdova-Esparza, “AI-powered educational agents: Opportunities, innovations, and ethical challenges,” Information, vol. 16, no. 6, art. 469, 2025, doi: 10.3390/info16060469.
  10. E. F. Risko y S. J. Gilbert, “Cognitive offloading,” Trends in Cognitive Sciences, vol. 20, no. 9, pp. 676-688, 2016, doi: 10.1016/j.tics.2016.07.002.
  11. M. O. Kelly y E. F. Risko, “Study effort and the memory cost of external store availability,” Cognition, vol. 228, art. 105228, 2022, doi: 10.1016/j.cognition.2022.105228.
  12. X. Lu, M. O. Kelly y E. F. Risko, “Offloading information to an external store increases false recall,” Cognition, vol. 205, art. 104428, 2020, doi: 10.1016/j.cognition.2020.104428.
  13. B. Jose, D. Joseph, V. Mohan, E. Alexander, S. K. Varghese y A. Roy, “Outsourcing cognition: The psychological costs of AI-era convenience,” Frontiers in Psychology, vol. 16, art. 1645237, 2025, doi: 10.3389/fpsyg.2025.1645237.
  14. G. Akçapınar y E. Sidan, “AI chatbots in programming education: Guiding success or encouraging plagiarism,” Discover Artificial Intelligence, vol. 4, art. 87, 2024, doi: 10.1007/s44163-024-00203-7.
  15. H. Bastani, O. Bastani, A. Sungu, H. Ge, Ö. Kabakcı y R. Mariman, “Generative AI without guardrails can harm learning: Evidence from high school mathematics,” Proceedings of the National Academy of Sciences, vol. 122, no. 26, 2025, doi: 10.1073/pnas.2422633122.
  16. M. Liffiton, B. Sheese, J. Savelka y P. Denny, “CodeHelp: Using large language models with guardrails for scalable support in programming classes,” in Proc. 23rd Koli Calling International Conf. Computing Education Research, art. 8, 2023, doi: 10.1145/3631802.3631830.
  17. R. Schmucker, M. Xia, A. Azaria y T. Mitchell, “Ruffle & Riley: Insights from designing and evaluating a large language model-based conversational tutoring system,” in Artificial Intelligence in Education, LNCS 14829, pp. 75-90, 2024, doi: 10.1007/978-3-031-64302-6_6.
  18. T. Noraset, A. Supratak, C. Ragkhitwetsagul, N. Worathong y S. Tuarob, “Evaluating lab assistant chatbot on student learning and behaviors in a programming short course,” Computers and Education: Artificial Intelligence, vol. 10, art. 100527, 2026, doi: 10.1016/j.caeai.2025.100527.
  19. L. Xi, Y. Zhang y Q. Wang, “Investigating the effects of an LLM-based Socratic conversational agent on students’ academic performance and reflective thinking in higher education,” Computers & Education, vol. 241, art. 105494, 2026, doi: 10.1016/j.compedu.2025.105494.
  20. S. Barke, M. B. James y N. Polikarpova, “Grounded Copilot: How programmers interact with code-generating models,” Proceedings of the ACM on Programming Languages, vol. 7, no. OOPSLA1, 2023, doi: 10.1145/3586030.
  21. J. D. Karpicke y J. R. Blunt, “Retrieval practice produces more learning than elaborative studying with concept mapping,” Science, vol. 331, no. 6018, pp. 772-775, 2011, doi: 10.1126/science.1199327.
  22. H. Tomisu, J. Ueda y T. Yamanaka, “The cognitive mirror: A framework for AI-powered metacognition and self-regulated learning,” Frontiers in Education, vol. 10, art. 1697554, 2025, doi: 10.3389/feduc.2025.1697554.
  23. P. Lewis et al., “Retrieval-augmented generation for knowledge-intensive NLP tasks,” in Advances in Neural Information Processing Systems, vol. 33, pp. 9459-9474, 2020.
  24. C. Zhou et al., “LIMA: Less is more for alignment,” in Advances in Neural Information Processing Systems, vol. 36, 2023.
  25. L. Chen et al., “AlpaGasus: Training a better Alpaca with fewer data,” in Proc. International Conference on Learning Representations, 2024.
  26. T. Dettmers, A. Pagnoni, A. Holtzman y L. Zettlemoyer, “QLoRA: Efficient finetuning of quantized LLMs,” in Advances in Neural Information Processing Systems, vol. 36, pp. 10088-10115, 2023.
SIGA: Una solución inteligente para la gestión del agua en viviendas dominicanas

Scarlett Betania Rodríguez Bravo y Alam Emilio Cordero – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La urgencia de modernizar la gestión del agua: un reto global y nacional

La gestión eficiente del agua constituye uno de los principales desafíos para el desarrollo sostenible debido al crecimiento de la población, el aumento del consumo y los efectos asociados al cambio climático [2]. La disponibilidad del recurso no depende únicamente de la existencia de fuentes naturales, sino también de la capacidad de administrarlas responsablemente, reducir las pérdidas y aprovechar fuentes alternativas. Esta situación ha impulsado el desarrollo de estrategias orientadas a modernizar los procesos de almacenamiento, distribución y consumo mediante tecnologías capaces de proporcionar información en tiempo real y facilitar una gestión basada en datos.

A esta problemática se suma la necesidad de considerar la relación entre el desarrollo tecnológico y el medio ambiente. Desde la perspectiva de la ecología humana, se plantea que las acciones y desarrollos humanos deben analizarse considerando su interacción con el entorno natural [3]. Bajo este enfoque, la tecnología puede representar un desafío cuando sus efectos ambientales no son considerados, pero también puede convertirse en una herramienta para favorecer el aprovechamiento responsable de los recursos naturales. En el ámbito hídrico, esto implica desarrollar soluciones que, además de automatizar procesos, contribuyan a reducir el desperdicio, aprovechar fuentes alternativas y promover una gestión sostenible del agua.

En la República Dominicana, esta necesidad adquiere especial importancia debido a las deficiencias existentes en la administración y distribución del recurso hídrico. A pesar de iniciativas como el Compromiso Nacional para un Pacto por el Agua 2021-2036, investigaciones han señalado problemas relacionados con la gestión de los consumos y las pérdidas en las redes de distribución, factores que pueden comprometer la sostenibilidad hídrica del país a largo plazo [1]. En numerosos hogares y establecimientos, además, la administración del agua almacenada continúa realizándose de manera manual, dificultando conocer con precisión la cantidad disponible, el consumo realizado y las condiciones de las diferentes fuentes de abastecimiento.

Otro aspecto relevante es el limitado aprovechamiento del agua de lluvia como fuente complementaria. La captación pluvial puede utilizarse para determinadas actividades secundarias, como limpieza o riego, reduciendo el uso innecesario del suministro público. Sin embargo, su incorporación requiere mecanismos capaces de conocer la disponibilidad del recurso y determinar cuándo resulta conveniente utilizar una fuente u otra. La ausencia de esta integración limita las posibilidades de administrar de manera conjunta el suministro público, el almacenamiento y la captación pluvial.

Frente a estas necesidades, diferentes investigaciones han explorado la automatización como alternativa para mejorar la gestión hídrica. Sharma [4], por ejemplo, propuso un sistema basado en Arduino orientado a la recolección, almacenamiento y distribución automática del agua de lluvia. Asimismo, sistemas de supervisión como SCADA permiten monitorear variables hidráulicas, detectar determinadas condiciones anormales y mejorar el control de procesos relacionados con el agua [5]. Estos antecedentes evidencian el potencial de integrar electrónica, comunicaciones y automatización para responder a problemas relacionados con la administración del recurso.

Dentro de este contexto, el Internet de las Cosas (IoT) proporciona herramientas que permiten conectar sensores, actuadores, microcontroladores y plataformas digitales para recopilar información y ejecutar acciones de manera automatizada. Variables como el nivel de almacenamiento, la presión y el caudal pueden ser supervisadas continuamente, mientras que protocolos de comunicación como MQTT permiten transmitir los datos entre dispositivos y sistemas de gestión. Microcontroladores como el ESP32 facilitan además la implementación de estas arquitecturas mediante capacidades de procesamiento y conectividad inalámbrica.

A partir de esta problemática surge el Sistema Inteligente de Gestión del Agua (SIGA), desarrollado por Scarlett Betania Rodríguez Bravo y Alam Emilio Cordero, estudiantes de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del Ing. Víctor Manuel Mancebo de León. El proyecto propone integrar diferentes fuentes de suministro de agua mediante una arquitectura IoT compuesta por sensores, actuadores, microcontroladores y una plataforma digital, con el propósito de monitorear las condiciones del sistema y gestionar el recurso de manera automatizada.

SIGA integra el suministro público y la captación pluvial mediante una lógica de control que permite tomar decisiones según la disponibilidad y las condiciones detectadas. El sistema monitorea variables como nivel, presión, caudal y consumo, establece comunicación en tiempo real entre los dispositivos, el servidor y la plataforma de gestión, y proporciona al usuario herramientas para visualizar el comportamiento de la infraestructura y configurar sus parámetros operativos. Además, incorpora información histórica y meteorológica como apoyo para el análisis y la gestión del recurso.

De esta manera, SIGA no se limita a automatizar una infraestructura hidráulica, sino que busca utilizar la tecnología como una herramienta para responder simultáneamente a una necesidad práctica y ambiental. El aprovechamiento del agua de lluvia, la supervisión del consumo, la detección de condiciones anormales y la gestión automatizada de las fuentes buscan contribuir a la reducción del desperdicio y a un uso más responsable del agua. El proyecto demuestra así cómo la integración de hardware, software y telecomunicaciones puede aplicarse al desarrollo de soluciones orientadas hacia una gestión hídrica más eficiente y sostenible.

Finalmente, la propuesta constituye un prototipo funcional que puede servir como referencia para futuras implementaciones en hogares, instituciones educativas, comercios y otros establecimientos que dispongan de sistemas de almacenamiento y distribución de agua. Aunque una implementación a mayor escala requiere adaptar la infraestructura hidráulica y dimensionar adecuadamente sus componentes, SIGA presenta un modelo tecnológico que evidencia el potencial del IoT para contribuir al desarrollo de edificaciones y ciudades inteligentes, utilizando la innovación tecnológica no solo para automatizar procesos, sino también para favorecer una relación más responsable con los recursos naturales.

Desconexión estructural: problemática en la gestión hídrica y límites del estado del arte

A pesar de los avances tecnológicos en el sector hídrico, la gestión del agua en viviendas y pequeños establecimientos continúa realizándose, en muchos casos, mediante mecanismos manuales o sistemas de automatización básicos que ofrecen escasa información sobre el estado del recurso. Esta situación dificulta conocer en tiempo real el nivel de almacenamiento, el consumo de agua y las condiciones de operación del sistema, limitando la capacidad de prevenir desperdicios y optimizar el uso de fuentes alternativas como la captación de agua de lluvia [1], [5].

En la República Dominicana, esta realidad se acentúa debido a las variaciones en el suministro de agua potable y a la dependencia de depósitos de almacenamiento para garantizar la disponibilidad del servicio. Aunque el agua de lluvia representa un recurso con un importante potencial de aprovechamiento, en la mayoría de las edificaciones no existen mecanismos que permitan administrarla de forma automática junto con la red pública. Como resultado, el agua potable continúa utilizándose en actividades que no requieren calidad para consumo humano, como el riego de jardines, la limpieza de patios o el lavado de vehículos, reduciendo la eficiencia en el aprovechamiento del recurso [5], [6].

La falta de monitoreo también dificulta la detección temprana de fugas, fallos en bombas o problemas de abastecimiento. En muchos casos, los usuarios desconocen el estado real de sus reservas de agua hasta que ocurre una interrupción del servicio o se presenta una avería en el sistema hidráulico. La ausencia de información en tiempo real limita la toma de decisiones y favorece el desperdicio de agua y energía, especialmente en instalaciones donde el llenado y el cambio entre fuentes de suministro continúan dependiendo de la intervención humana [1].

Además de afectar la disponibilidad del recurso, esta forma tradicional de administración incrementa la dependencia de la supervisión constante por parte del usuario. Es frecuente que las personas deban verificar manualmente el nivel de los depósitos, activar bombas de agua o cambiar el suministro entre distintas fuentes según su experiencia o percepción del estado del sistema. Estas actividades, aunque sencillas, pueden provocar errores humanos que derivan en reboses de depósitos, funcionamiento en seco de las bombas, consumo innecesario de energía eléctrica o interrupciones inesperadas en el abastecimiento. La automatización de estos procesos representa una oportunidad para mejorar tanto la eficiencia operativa como la comodidad del usuario final.

Por otra parte, el crecimiento de las tecnologías inteligentes ha impulsado una transformación significativa en la forma en que se diseñan los sistemas de monitoreo y control. La disponibilidad de sensores electrónicos de bajo costo, redes inalámbricas y plataformas de desarrollo abiertas ha permitido que soluciones anteriormente reservadas para aplicaciones industriales puedan implementarse también en viviendas y pequeñas empresas. Este cambio ha favorecido el desarrollo de sistemas IoT capaces de recopilar información continuamente y transmitirla a plataformas digitales para facilitar la supervisión remota y la toma de decisiones basada en datos [1], [2].

Diversas investigaciones han demostrado que el Internet de las Cosas constituye una alternativa viable para modernizar la gestión hídrica mediante el uso de sensores, actuadores y plataformas de monitoreo remoto. Sistemas basados en ESP32, Arduino y protocolos de comunicación ligeros como MQTT permiten supervisar variables hidráulicas y automatizar procesos de forma más eficiente que los mecanismos tradicionales, además de ofrecer acceso remoto a la información del sistema [1], [2], [3], [6].

La literatura científica también destaca la importancia de utilizar arquitecturas de comunicación ligeras y escalables para garantizar el intercambio eficiente de información entre dispositivos conectados. Protocolos como MQTT han demostrado ofrecer un excelente desempeño en aplicaciones donde múltiples sensores deben transmitir información de forma continua utilizando un ancho de banda reducido. Asimismo, el empleo de plataformas de desarrollo modernas facilita la integración entre el hardware instalado en campo y aplicaciones web o móviles que permiten visualizar el estado del sistema desde cualquier ubicación con acceso autorizado [2], [3].

En cuanto a la instrumentación, los avances recientes han permitido incorporar sensores de nivel, presión y caudal con mayor precisión y confiabilidad, ampliando considerablemente las posibilidades de supervisión. La combinación de estas variables proporciona una visión más completa del comportamiento hidráulico del sistema, permitiendo identificar anomalías operativas, verificar el correcto funcionamiento de bombas y válvulas, y conocer el consumo de agua con un mayor nivel de detalle. La integración de múltiples sensores también incrementa la confiabilidad de la información obtenida, ya que permite validar el comportamiento del sistema a partir de diferentes mediciones físicas [4].

Sin embargo, gran parte de las soluciones reportadas en la literatura se enfocan únicamente en la supervisión del nivel del agua o en la automatización del llenado de depósitos, sin integrar múltiples variables hidráulicas dentro de un mismo sistema de decisión. Asimismo, muchos desarrollos funcionan como prototipos experimentales y no incorporan una plataforma de monitoreo integral que permita visualizar el estado del sistema, generar alertas y facilitar la interacción del usuario con la infraestructura instalada [1], [2].

De igual forma, numerosas soluciones existentes fueron diseñadas para resolver problemas específicos y presentan limitaciones cuando se pretende ampliar sus funcionalidades. Algunos sistemas carecen de interfaces gráficas que faciliten la interpretación de los datos por parte del usuario, mientras que otros no permiten integrar nuevas fuentes de información ni modificar fácilmente las reglas de operación. Esta falta de flexibilidad dificulta su adaptación a distintos escenarios de uso y limita su aplicación en proyectos de mayor alcance orientados a la gestión inteligente del agua.

En este contexto, surge la necesidad de desarrollar una solución que combine monitoreo en tiempo real, automatización, conectividad y facilidad de uso dentro de una arquitectura de bajo costo y adaptable a entornos residenciales. El proyecto SIGA responde a esta necesidad mediante la integración de sensores, dispositivos de control, comunicaciones IoT y una plataforma web que permite administrar de forma inteligente el uso del agua proveniente tanto de la red pública como de la captación pluvial, contribuyendo a una gestión más eficiente y sostenible del recurso hídrico [1], [2], [5].

Más allá del desarrollo de un prototipo funcional, SIGA busca demostrar que la integración de tecnologías ampliamente disponibles puede convertirse en una alternativa viable para promover un uso más racional del agua en el contexto dominicano. La combinación de monitoreo continuo, automatización de procesos y visualización de información en tiempo real proporciona a los usuarios herramientas que favorecen una administración más eficiente del recurso, reducen la dependencia de operaciones manuales y contribuyen a la adopción de prácticas sostenibles. De esta manera, el proyecto se posiciona como una propuesta que integra los avances reportados en la literatura con las necesidades específicas de los hogares y pequeñas edificaciones, ofreciendo una solución tecnológica adaptable, escalable y orientada a mejorar la gestión hídrica mediante el uso del Internet de las Cosas.

Objetivos completados

El desarrollo del Sistema Inteligente de Gestión del Agua (SIGA) permitió cumplir el objetivo general de diseñar e implementar una solución inteligente orientada a optimizar la administración del agua en entornos residenciales mediante la integración de tecnologías de Internet de las Cosas (IoT), automatización y monitoreo en tiempo real. Este objetivo respondió a la necesidad de ofrecer una alternativa tecnológica que permitiera mejorar el aprovechamiento del recurso hídrico, reducir la dependencia de procesos manuales y facilitar la toma de decisiones relacionadas con el abastecimiento de agua. Para alcanzar este propósito se diseñó e implementó una infraestructura instrumentada con sensores ultrasónicos para la medición del nivel de agua, sensores de presión para supervisar las condiciones de suministro, caudalímetros para registrar el flujo de agua, válvulas solenoides para controlar automáticamente la distribución entre las diferentes fuentes y bombas de agua controladas mediante microcontroladores ESP32, permitiendo la integración de todos los dispositivos dentro de una misma arquitectura inteligente. Asimismo, se desarrolló una lógica de control encargada de gestionar automáticamente la conmutación entre la red pública y el sistema de captación pluvial de acuerdo con las condiciones detectadas por los sensores, priorizando la utilización del agua almacenada cuando las condiciones del sistema lo permitieran y garantizando la continuidad del suministro cuando fuera necesario recurrir al acueducto. De igual manera, se implementó una arquitectura de comunicaciones basada en el protocolo MQTT para la transmisión eficiente de información entre los dispositivos IoT y la plataforma de monitoreo, permitiendo la actualización continua de las variables hidráulicas y facilitando la supervisión remota del sistema. Como complemento, se desarrolló una plataforma web que permite visualizar en tiempo real el nivel de los depósitos, el estado de los dispositivos, los valores registrados por los sensores y las principales variables hidráulicas, además de ofrecer herramientas para la administración del sistema y la generación de notificaciones ante eventos relevantes. La integración de estos componentes permitió validar el funcionamiento del prototipo bajo diferentes escenarios de operación, demostrando que es posible implementar una solución de bajo costo, escalable y adaptable para optimizar la gestión del agua en viviendas y pequeñas edificaciones. En conjunto, los objetivos específicos alcanzados evidencian la viabilidad técnica de combinar automatización, comunicaciones inalámbricas y monitoreo inteligente en una única plataforma capaz de contribuir al uso más eficiente del recurso hídrico y de servir como base para futuras investigaciones y desarrollos orientados a la construcción de infraestructuras residenciales más sostenibles e inteligentes.

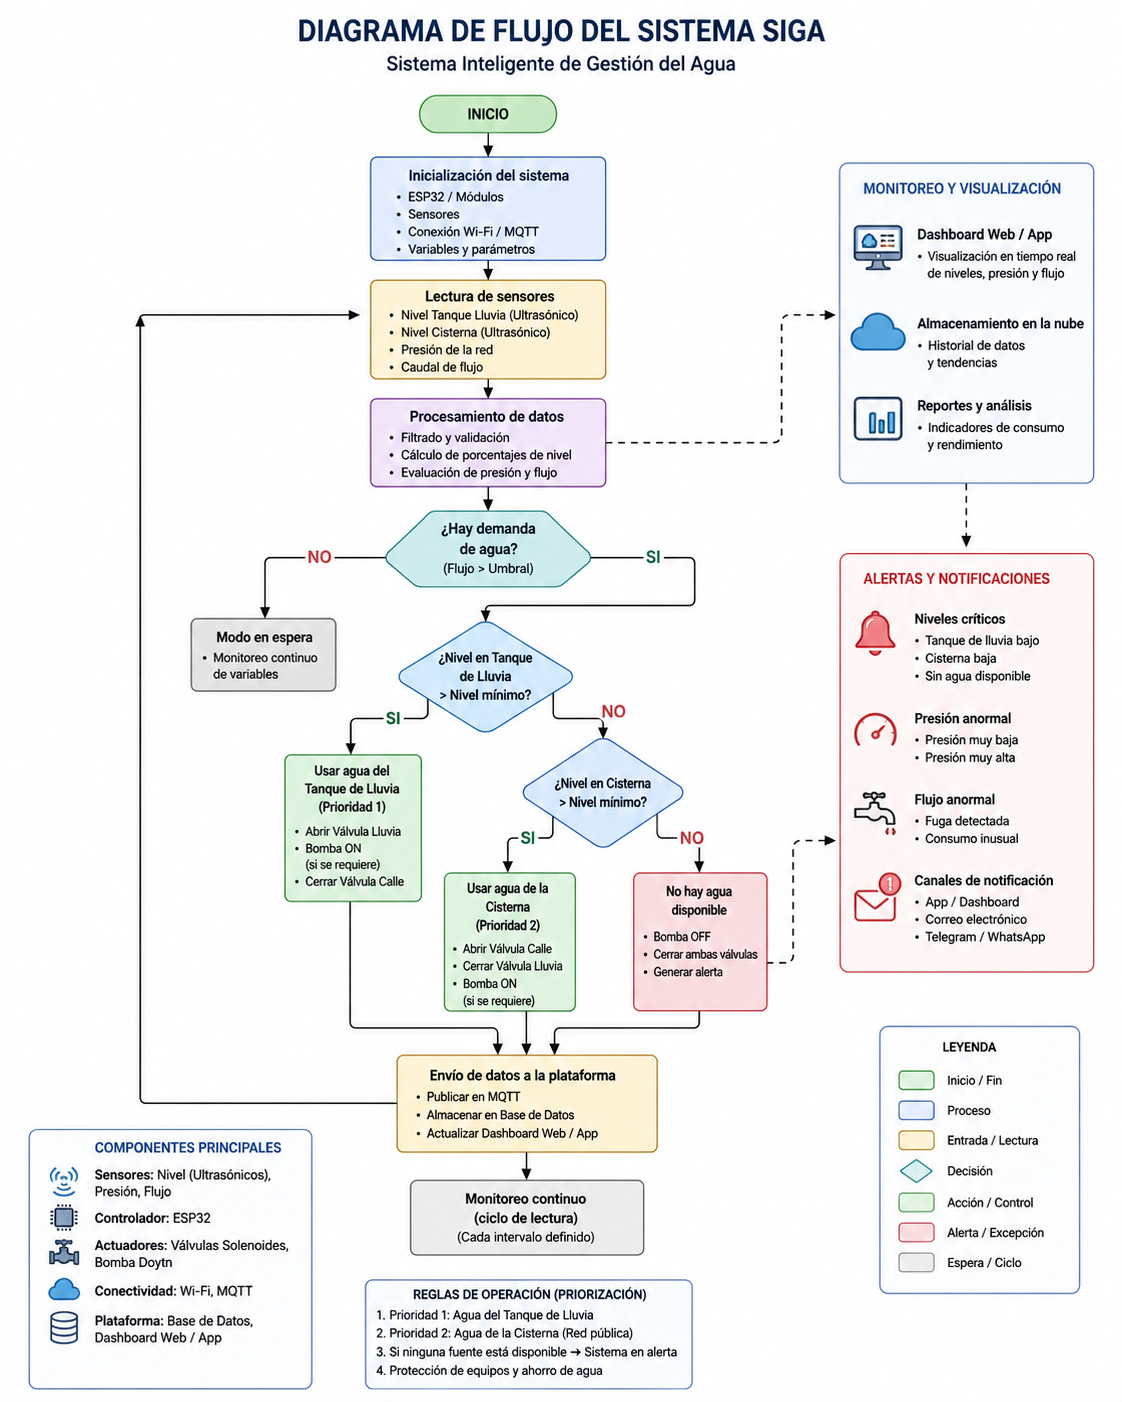
Diagrama de flujo del sistema SIGA: lectura de sensores, decisión entre tanque de lluvia y cisterna, envío de datos y alertas
Figura 1. Diagrama de funcionamiento.

Metodología y arquitectura técnica: hardware en el borde y lógica algorítmica

La construcción del sistema SIGA se desarrolló siguiendo una metodología de trabajo organizada por etapas, lo que permitió avanzar de manera progresiva en el diseño, la integración y las pruebas de cada uno de sus componentes. Este enfoque facilitó realizar mejoras continuas durante el desarrollo, corrigiendo errores y agregando nuevas funciones conforme el sistema evolucionaba. Gracias a ello, fue posible obtener una solución más estable y adaptada a las necesidades planteadas desde el inicio del proyecto.

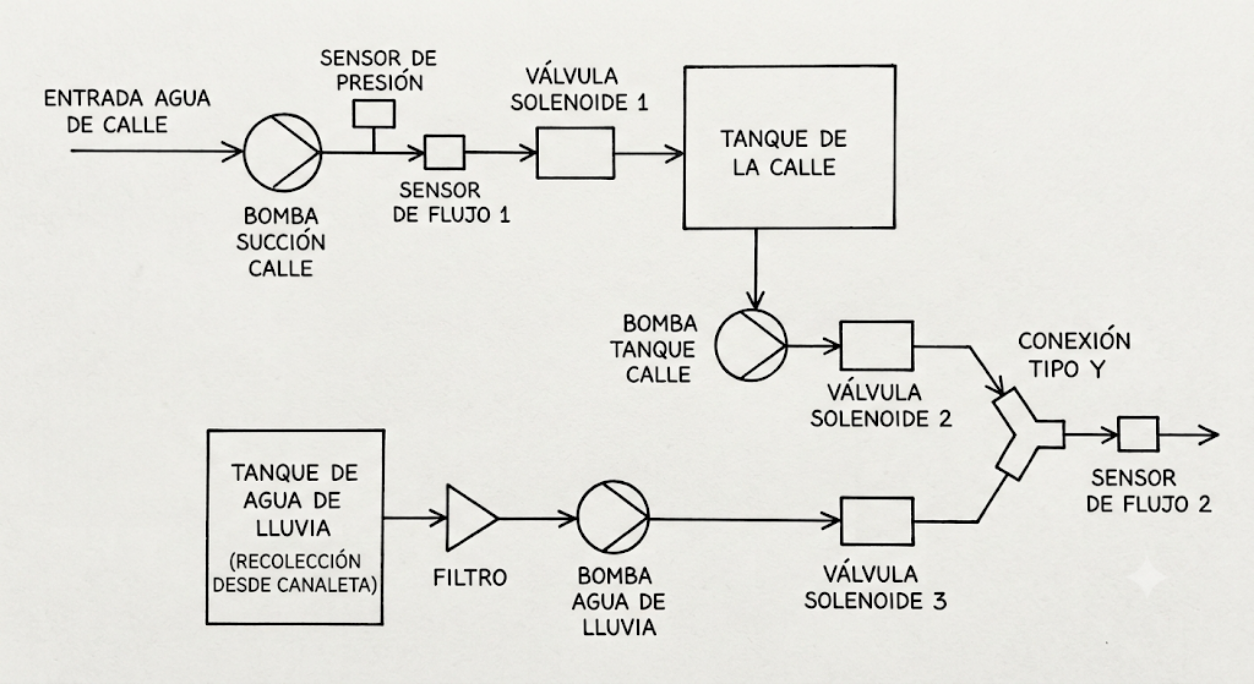
Diagrama hidráulico: bombas, sensores de presión y flujo, válvulas solenoides, tanque de la calle y tanque de agua de lluvia
Figura 2. Arquitectura del sistema.

El sistema fue diseñado para supervisar de forma constante el estado de los depósitos de agua mediante sensores que permiten conocer el nivel disponible sin necesidad de contacto directo. Esta mejora sustituyó métodos tradicionales que presentaban limitaciones por desgaste o menor precisión con el paso del tiempo. De esta manera, se obtuvo un monitoreo más confiable y con menor necesidad de mantenimiento, contribuyendo a una mejor administración del recurso hídrico.

Además del nivel del agua, SIGA también registra información relacionada con el flujo y la presión del suministro. Estos datos permiten identificar situaciones como una disminución en el abastecimiento, un consumo fuera de lo habitual o posibles fallas en la distribución. Al disponer de esta información en tiempo real, el sistema puede tomar decisiones más acertadas para garantizar la continuidad del servicio y optimizar el uso del agua.

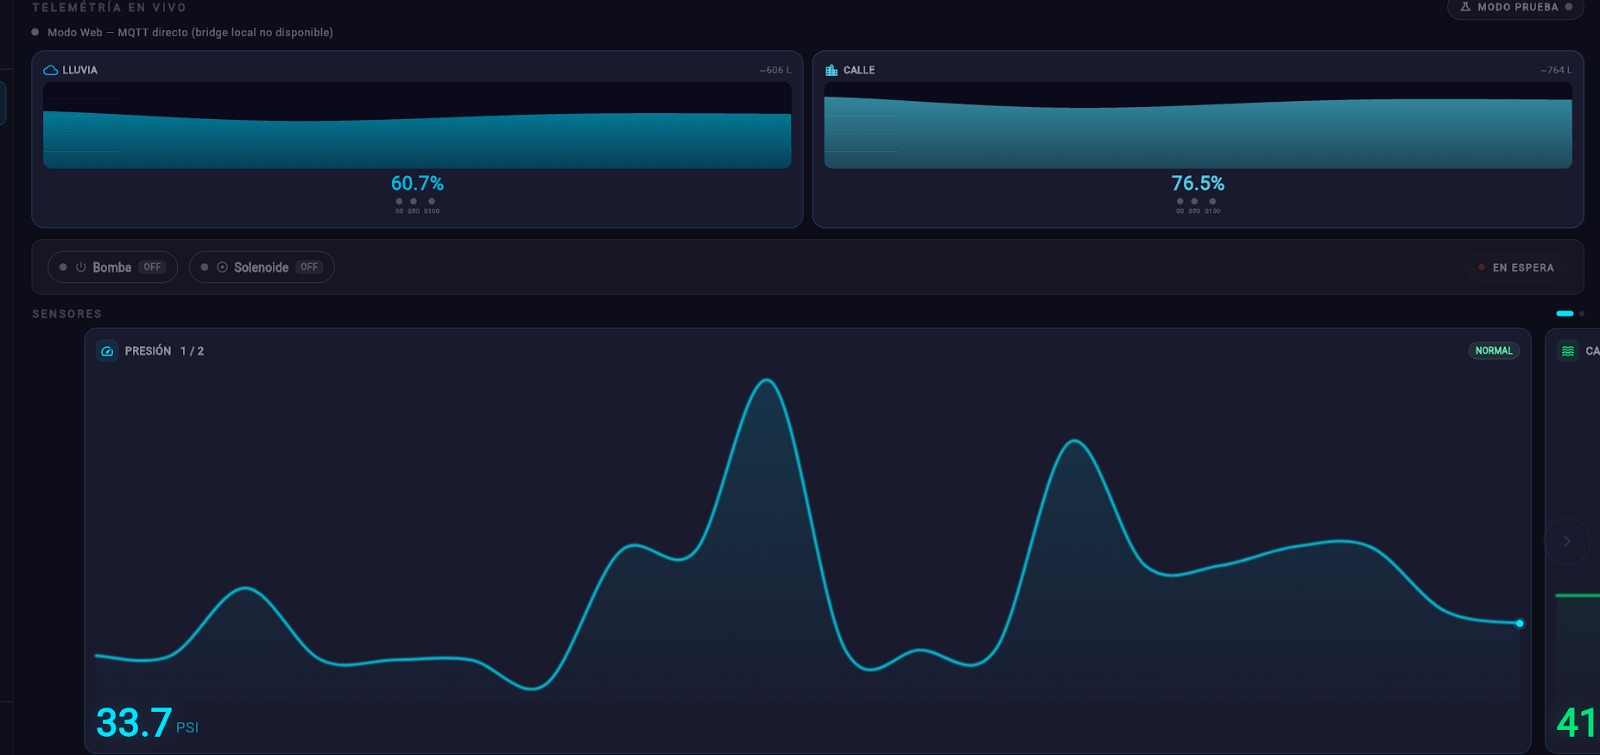
Dashboard web con el nivel de los tanques de lluvia y calle, estado de bomba y solenoide y gráfica de presión
Figura 3. Dashboard de la web.

Para controlar el paso del agua entre las diferentes fuentes de abastecimiento, el sistema incorpora válvulas y bombas que se activan automáticamente cuando las condiciones lo requieren. Este funcionamiento evita la intervención constante del usuario y permite que el cambio entre las distintas fuentes se realice de manera ordenada y segura. Asimismo, se implementaron mecanismos de protección para asegurar el funcionamiento continuo de los equipos y prolongar su vida útil.

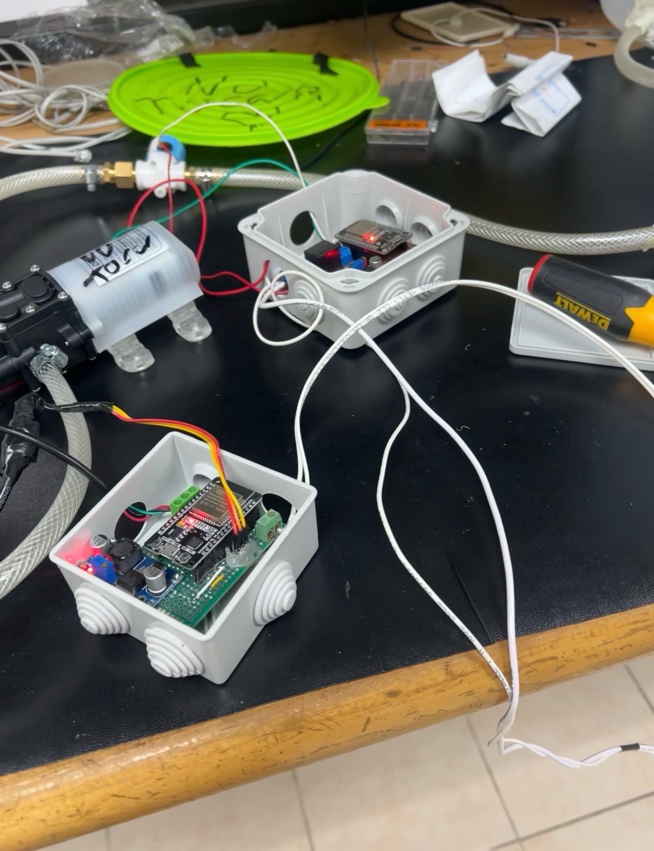
Prototipo: cajas de conexión con ESP32 y placas de control junto a una bomba de agua y mangueras
Figura 4. Circuitos protegidos de la bomba y la válvula.

Todos los dispositivos del sistema se encuentran conectados entre sí y envían la información recopilada hacia un servidor central, donde los datos son organizados y procesados. Esta comunicación permite que el estado del sistema esté disponible en todo momento y que las acciones necesarias puedan ejecutarse de forma rápida cuando se detecta algún cambio importante [3].

La información recopilada también se almacena para mantener un historial del comportamiento del sistema. Este registro facilita consultar el consumo de agua, revisar eventos anteriores y analizar el funcionamiento general de la instalación. Además, los usuarios pueden acceder a esta información desde una aplicación web o móvil, donde es posible visualizar el estado del sistema de forma sencilla y en tiempo real [6].

Uno de los aspectos más innovadores de SIGA es su capacidad para tomar decisiones automáticamente a partir de la información que recibe. En lugar de limitarse únicamente a mostrar datos, el sistema analiza las condiciones existentes y determina cuándo utilizar cada fuente de agua, cuándo activar las bombas y cuándo generar alertas para el usuario. Esta característica reduce el desperdicio de agua y mejora la eficiencia del proceso de distribución.

Como complemento, el sistema considera el comportamiento histórico del consumo para adaptar su funcionamiento con el paso del tiempo. También consulta información sobre las condiciones climáticas para anticipar posibles lluvias y recomendar estrategias que permitan aprovechar mejor el agua disponible. Esta capacidad de adaptación representa una diferencia importante respecto a los sistemas convencionales, ya que convierte a SIGA en una herramienta que no solo supervisa el recurso hídrico, sino que también contribuye a una gestión más eficiente, preventiva e inteligente del agua.

Resultados

Con el objetivo de validar el funcionamiento del Sistema Inteligente de Gestión del Agua (SIGA), se realizaron diferentes pruebas en un prototipo instalado en un ambiente controlado que simuló el funcionamiento de una vivienda. Durante estas pruebas se evaluó el monitoreo del nivel de agua, el cambio automático entre las fuentes de abastecimiento, el envío de alertas, el registro de información y el funcionamiento de la plataforma web.

Los resultados obtenidos demostraron que el sistema cumplió con los objetivos planteados durante el desarrollo. Los sensores registraron correctamente el nivel de agua de ambas cisternas, mientras que el sistema respondió automáticamente cuando fue necesario cambiar entre el agua de lluvia y la red pública. Además, toda la información fue visualizada en tiempo real desde la plataforma web.

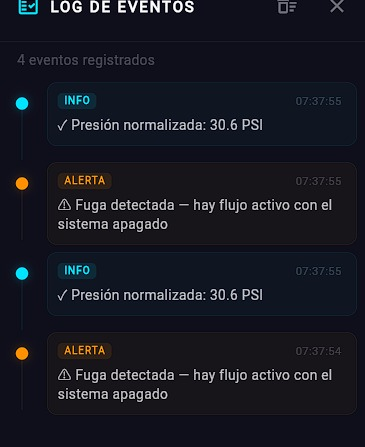
Log de eventos de la plataforma con alertas de fuga detectada y avisos de presión normalizada
Figura 5. Plataforma web mostrando las alertas del sistema.

Durante las pruebas de monitoreo se verificó que las mediciones realizadas por los sensores ultrasónicos fueron consistentes y permitieron conocer el nivel de agua de forma continua. La aplicación web actualizó la información pocos segundos después de producirse cualquier cambio en el sistema, permitiendo al usuario supervisar el estado de las cisternas desde cualquier dispositivo conectado.

En las pruebas de conmutación automática se simuló el vaciado de la cisterna de agua de lluvia. Una vez alcanzado el nivel mínimo establecido, el sistema cerró automáticamente esa fuente de suministro y habilitó la alimentación desde la red pública, manteniendo el flujo de agua sin intervención del usuario.

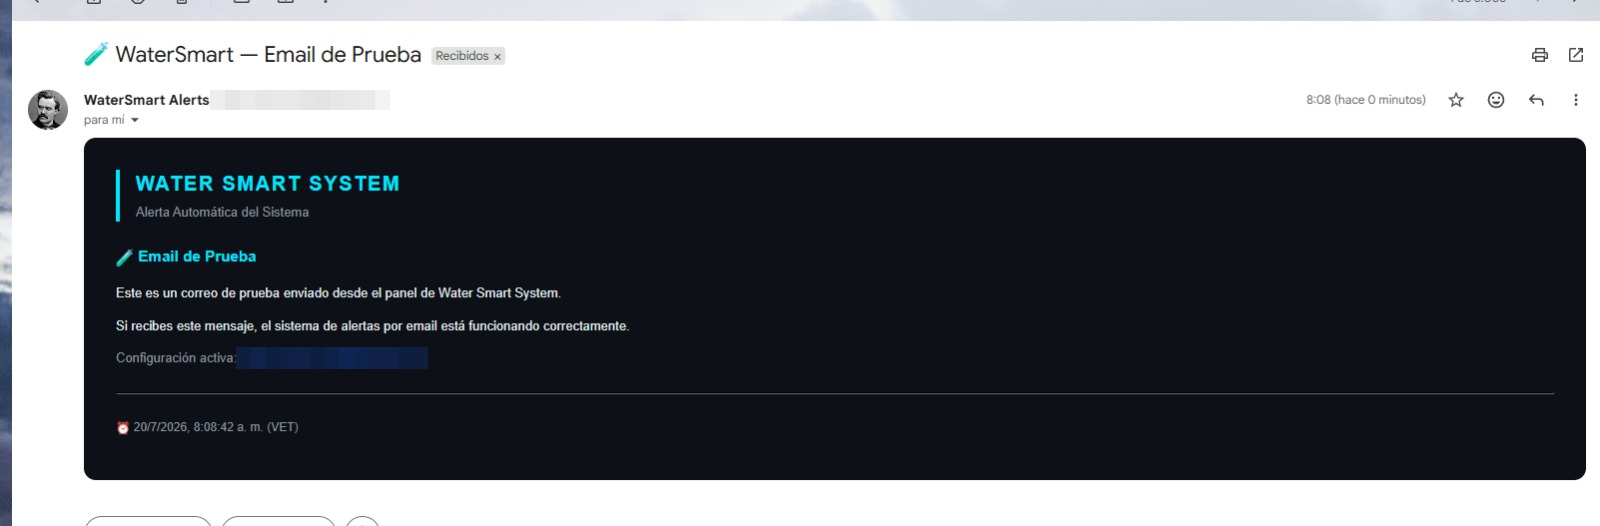
También se evaluó el sistema de alertas. Cuando se simuló una condición anormal, como la ausencia de flujo de agua o una posible fuga, la plataforma registró el evento y envió una notificación al usuario mediante correo electrónico. Esto permitió comprobar que el sistema puede informar oportunamente situaciones que requieren atención.

Correo electrónico de prueba enviado por el sistema de alertas
Figura 6. Notificación enviada por correo electrónico.

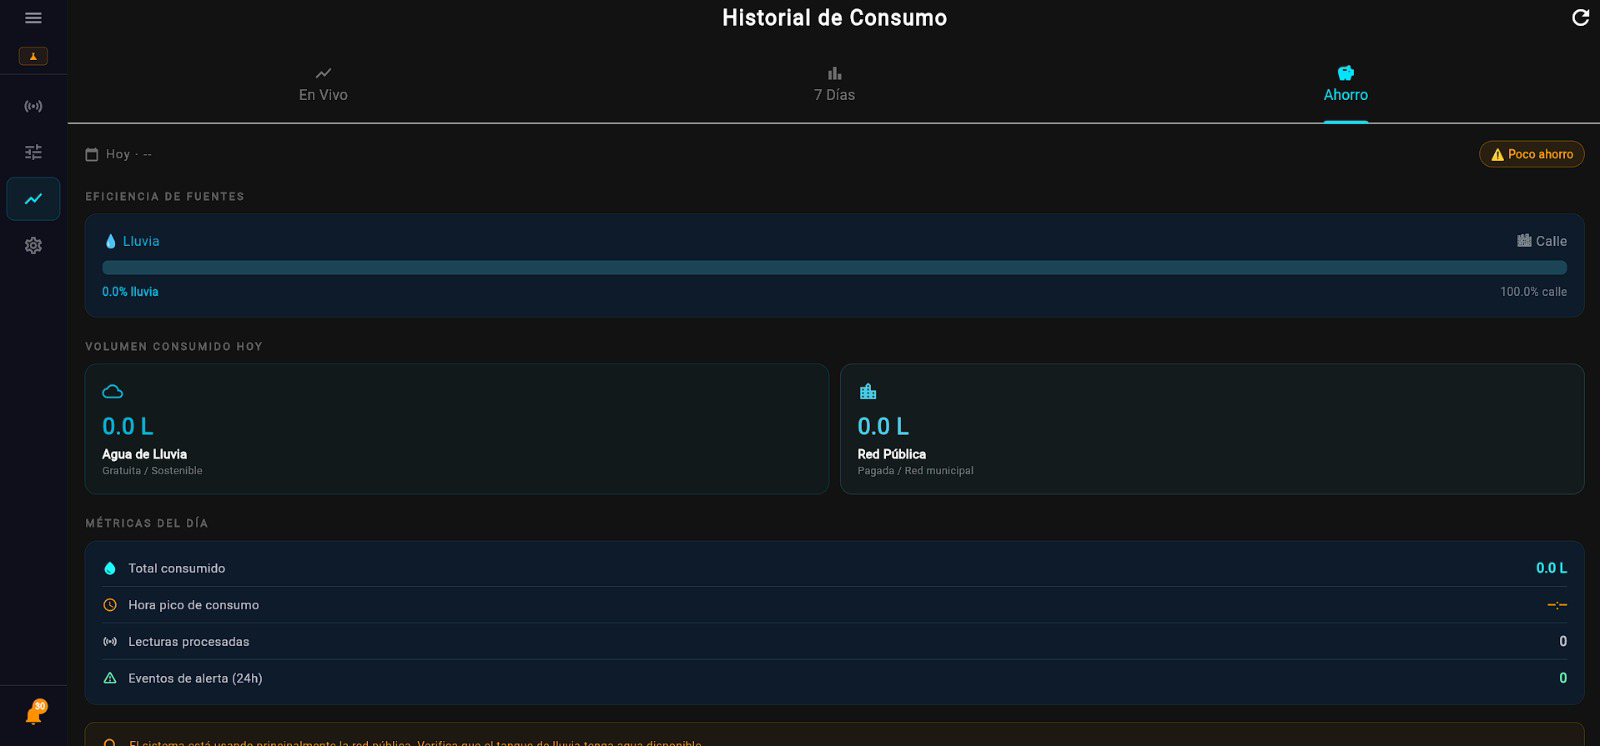
Otro aspecto evaluado fue el registro histórico de la información. Todas las mediciones generadas por los sensores fueron almacenadas en la base de datos y posteriormente representadas mediante gráficos dentro de la plataforma web. Esto facilita el seguimiento del consumo de agua y permite identificar tendencias de uso con el paso del tiempo.

Pantalla de historial de consumo con eficiencia de fuentes, volumen consumido y métricas del día
Figura 7. Historial de consumo en la plataforma web.

Finalmente, se realizaron pruebas desconectando temporalmente la conexión a Internet. Durante este período el sistema continuó controlando las bombas y válvulas utilizando la información disponible en los sensores. Una vez restablecida la conexión, los datos fueron sincronizados nuevamente con la plataforma, demostrando que el sistema puede seguir funcionando incluso cuando no existe comunicación con el servidor.

Área evaluadaPrueba realizadaResultado obtenido
Monitoreo del nivelMedición continua de ambas cisternasLecturas estables y actualización correcta en la plataforma
Cambio de fuenteVaciado de la cisterna de lluviaCambio automático hacia la red pública
Plataforma webVisualización de datosInformación mostrada en tiempo real
Sistema de alertasSimulación de fuga y ausencia de flujoNotificación enviada al usuario por correo electrónico
HistorialRegistro continuo de medicionesDatos almacenados correctamente en la base de datos
Funcionamiento sin InternetDesconexión temporal de la redEl sistema continuó operando y sincronizó la información al reconectarse
Tabla 1. Resultados obtenidos durante las pruebas.

En comparación con otros proyectos de monitoreo de agua reportados en la literatura, SIGA incorpora en una sola plataforma el monitoreo del nivel de agua, el cambio automático entre dos fuentes de abastecimiento, el almacenamiento del historial, el envío de alertas y la consulta desde una aplicación web. Esta integración permite ofrecer una solución más completa para la gestión del agua en viviendas.

Conclusión

El desarrollo del Sistema Inteligente de Gestión del Agua (SIGA) permitió demostrar que es posible administrar de manera automática dos fuentes de abastecimiento de agua mediante el uso de sensores, dispositivos electrónicos y una plataforma web de monitoreo. Los resultados obtenidos durante las pruebas confirmaron que el sistema cumple con los objetivos propuestos, ofreciendo una solución que facilita el aprovechamiento del agua de lluvia y reduce la dependencia de la red pública.

Uno de los principales aprendizajes obtenidos durante el desarrollo fue la importancia de integrar el hardware y el software de manera coordinada para lograr un funcionamiento confiable. La sustitución de los sensores de nivel inicialmente considerados por sensores ultrasónicos permitió mejorar la estabilidad de las mediciones, mientras que la implementación de un sistema de monitoreo en tiempo real facilitó el seguimiento del comportamiento de todo el sistema.

El proyecto también demuestra que un sistema puede considerarse inteligente sin utilizar modelos avanzados de inteligencia artificial. En el caso de SIGA, la toma de decisiones se basa en reglas previamente definidas, información proporcionada por los sensores y el análisis de las condiciones del sistema, permitiendo automatizar tareas que normalmente requerirían la intervención del usuario.

Como trabajo futuro, se propone incorporar sensores que permitan evaluar la calidad del agua, integrar una fuente de alimentación mediante paneles solares para aumentar la autonomía del sistema y desarrollar modelos predictivos que ayuden a estimar el consumo de agua según el comportamiento histórico y las condiciones climáticas.

En conclusión, SIGA representa una alternativa tecnológica para mejorar la gestión del agua en viviendas, promoviendo un uso más eficiente de este recurso. Se espera que este proyecto pueda continuar evolucionando mediante futuras investigaciones y pruebas en escenarios reales, contribuyendo al desarrollo de soluciones sostenibles para el aprovechamiento del agua en la República Dominicana.

Referencias

  1. J. A. P. Al-Shurman, B. A. M. Abdullah, and M. I. I. A. Ahmed, “A comprehensive review of IoT-based smart water management systems,” IEEE Access, vol. 9, pp. 112111–112130, 2021.
  2. K. Hassan, “Development of a real-time monitoring system using Flutter and MQTT protocol for IoT applications,” J. Sensors, vol. 2022, pp. 1–12, 2022.
  3. S. Kumar, “Low-cost smart home automation using ESP32 and MQTT,” Int. J. Comput. Sci. Eng., vol. 18, no. 5, pp. 202–210, 2020.
  4. A. S. Morris and R. Langari, Measurement and Instrumentation: Theory and Application, 3rd ed. Oxford, UK: Elsevier, 2020.
  5. E. Rodríguez, A. L. Peña, and J. M. García, “An IoT-enabled architecture for efficient urban water distribution in developing economies,” Int. J. Eng. Telematics, vol. 5, no. 2, pp. 45–56, 2022.
  6. V. Sharma, “Arduino Based Smart Water Management,” International Journal of Engineering Research and Technology, vol. 9, Sep. 2020, doi: 10.17577/IJERTV9IS080239.

SIEMIA: Sistema para la Interpretación de Electrocardiogramas Mediante Machine Learning para la Detección Temprana de Arritmias

María Isabel Tiburcio Arias y Fernando Elías Rodríguez Bueno – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Las enfermedades cardiovasculares continúan siendo, año tras año, una de las principales causas de muerte a nivel mundial, y dentro de ellas las arritmias cardíacas ocupan un lugar de especial relevancia por su capacidad de manifestarse de forma silenciosa, intermitente o súbita. Desde la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la Pontificia Universidad Católica Madre y Maestra (PUCMM), un equipo conformado por María Isabel Tiburcio Arias y Fernando Elías Rodríguez Bueno, desarrolla SIEMIA: un Sistema para la Interpretación de Electrocardiogramas Mediante Machine Learning para la Detección Temprana de Arritmias.

La motivación detrás de este proyecto surge de una realidad muy concreta dentro de los centros de salud dominicanos y latinoamericanos: la lectura del electrocardiograma (ECG) aún depende, en gran medida, de las experiencias del especialista. En una entrevista realizada como parte de la investigación, el cardiólogo Dr. Samuel Ramos señaló que, en horas de mayor demanda, puede llegar a recibir entre 20 y 40 electrocardiogramas diarios, un volumen que naturalmente incrementa la presión diagnóstica y el riesgo de pasar por alto hallazgos relevantes. Esta necesidad de apoyo tecnológico, y no de reemplazo del criterio médico, es el punto de partida de SIEMIA.

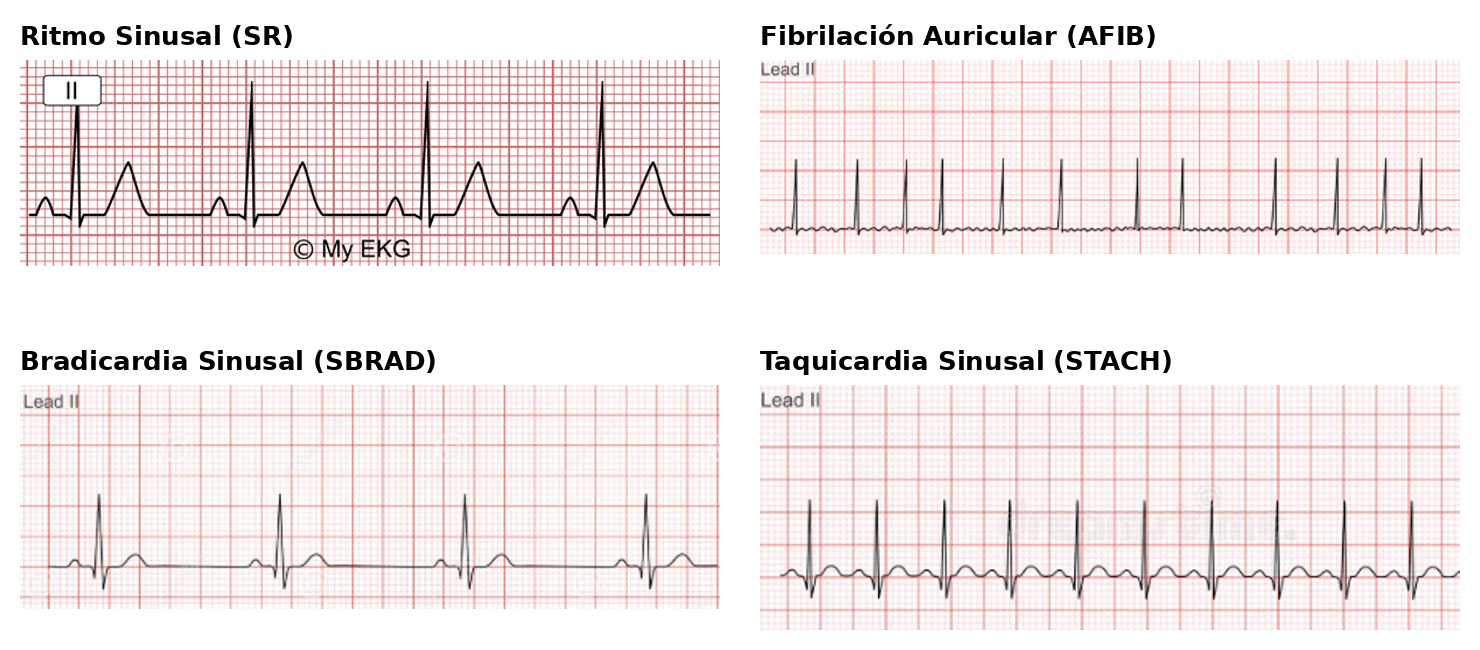
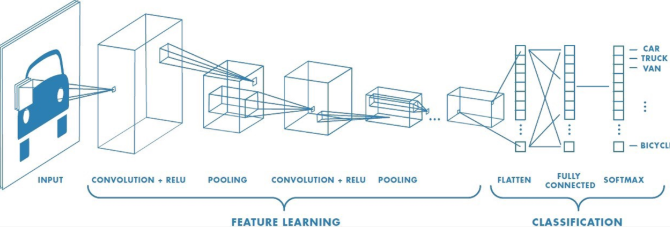
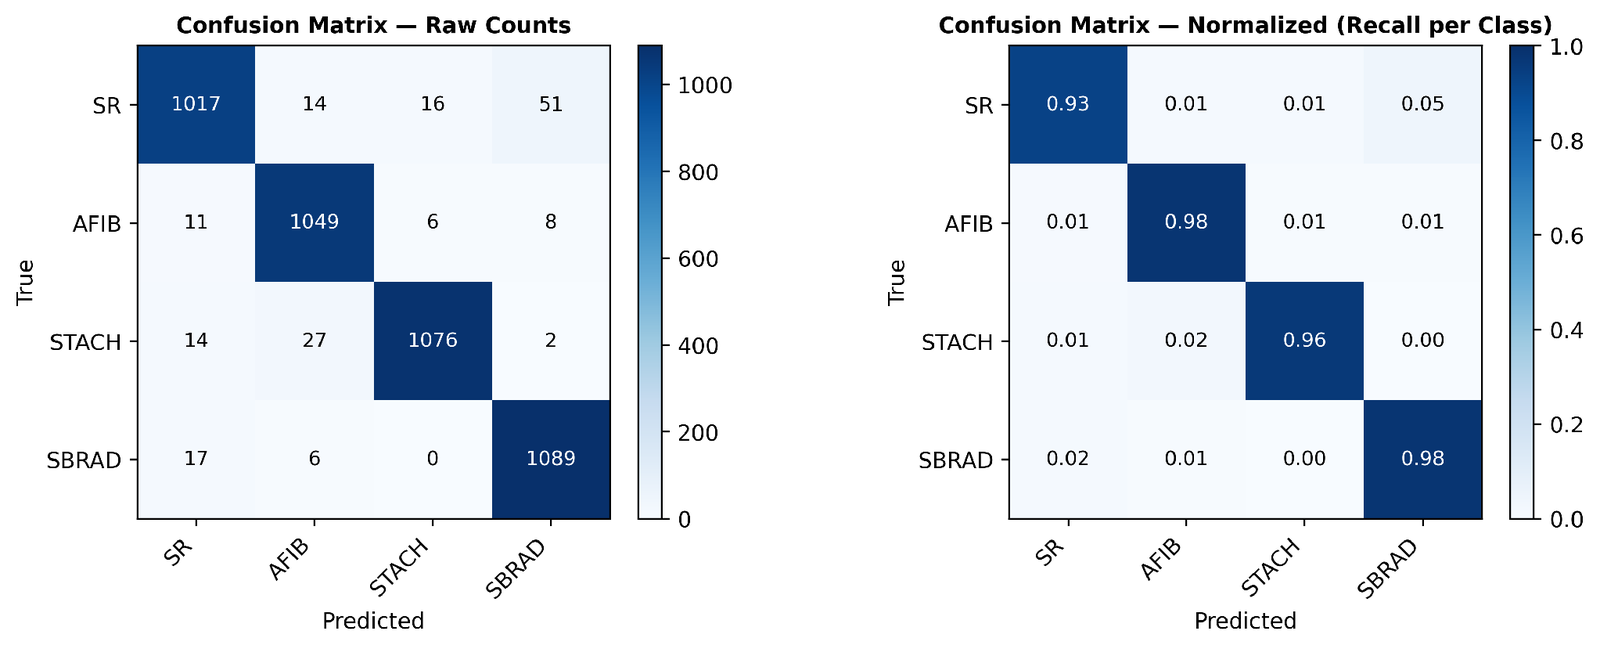
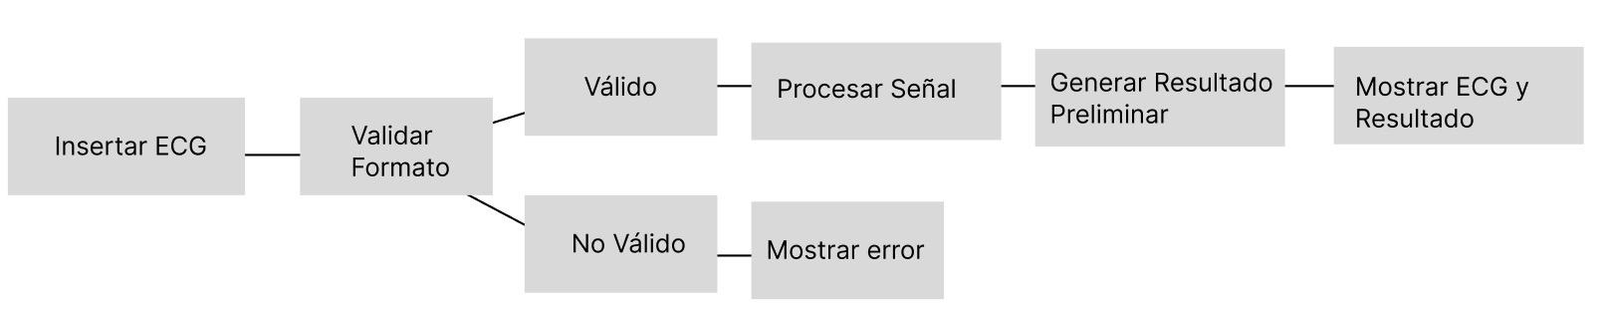
El proyecto propone el desarrollo de un sistema basado en técnicas de Machine Learning y Deep Learning capaz de analizar señales de electrocardiograma y aprender los patrones asociados a distintas anomalías del ritmo cardíaco. Puntualmente, el sistema se apoya en una red neuronal convolucional (CNN) entrenada para diferenciar, a partir de datos digitales de ECG, entre cuatro ritmos cardíacos: el ritmo sinusal normal, la fibrilación auricular, la bradicardia sinusal y la taquicardia sinusal. La visión a más largo plazo contempla, además, extender el análisis a imágenes de electrocardiogramas y aplicar técnicas de Inteligencia Artificial Explicable (XAI) como Grad-CAM, de manera que el sistema no solo clasifique, sino que también pueda mostrar qué porciones de la señal influyeron en su predicción.

El peso de las arritmias y los límites de la lectura manual

Según cifras de la Organización Mundial de la Salud (OMS), un estimado de 19.8 millones de personas murieron a causa de enfermedades cardiovasculares en 2022, lo que representa aproximadamente un 32% de todas las muertes registradas este año a nivel global.[1] Una proporción considerable de estos casos ocurre en países de bajos y medianos ingresos, una tendencia que se confirma en un estudio centrado específicamente en el cuidado de arritmias en América Latina, el cual señala que buena parte de los países de la región carece de la disponibilidad de tecnología y de personal especializado suficiente para identificar y tratar estas alteraciones del ritmo cardíaco.[2]

Dentro del grupo de enfermedades cardiovasculares, las arritmias ocupan un lugar particular, ya que alteran el ritmo normal del corazón y pueden manifestarse de forma silenciosa, intermitente o súbita, lo que dificulta su detección temprana. Un diagnóstico tardío puede traducirse en complicaciones serias como mareos, desmayos, falta de oxígeno o incluso muerte súbita. El electrocardiograma continúa siendo la herramienta más utilizada para detectar estas alteraciones, ya que registra la actividad eléctrica del corazón y permite observar patrones asociados a distintas anomalías del ritmo. Sin embargo, su interpretación sigue dependiendo en gran medida de la experiencia del profesional que la analiza[2], lo que convierte al proceso diagnóstico en una tarea sensible a factores humanos como la fatiga, la sobrecarga laboral o la variabilidad entre especialistas.

En gran parte de los centros médicos de la República Dominicana y Latinoamérica, la lectura manual del ECG es lo común, especialmente en contextos donde no siempre hay un cardiólogo disponible de forma inmediata. Esta dependencia puede derivar en errores humanos, reportes tardíos y dificultades para dar seguimiento de largo plazo a pacientes crónicos. El problema radica en la necesidad de construir soluciones que ayuden a interpretar los electrocardiogramas de forma más rápida, consistente y accesible, particularmente en escenarios donde el tiempo y los recursos humanos son limitados.

La comunidad científica ha respondido a este reto desde hace varios años. Ribeiro et al. demostraron que un modelo de redes neuronales profundas puede diagnosticar múltiples condiciones cardíacas a partir de ECG de 12 derivaciones con aplicabilidad clínica real[3], mientras que Kachuee et al. desarrollaron un modelo de clasificación de latidos cardíacos a partir de señales de ECG crudas, evidenciando que trabajar directamente sobre la señal permite capturar patrones más complejos que los métodos tradicionales.[4] En una línea similar, Narotamo et al. compararon representaciones 1D y 2D de la señal de ECG, así como enfoques de fusión multimodal, encontrando diferencias relevantes en la precisión final de los modelos según la forma en que se representan los datos.[5]

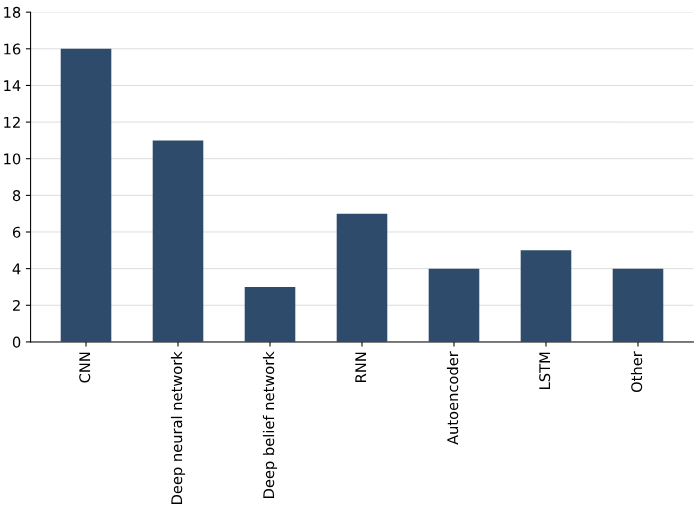
Un aporte particularmente útil proviene de la revisión de Saber y Abotaleb, quienes recopilaron las técnicas modernas de clasificación de arritmias más utilizadas junto con sus porcentajes de precisión, destacando a las redes neuronales convolucionales (CNN) como una de las arquitecturas más frecuentes y efectivas en proyectos similares, con precisiones reportadas entre el 95% y el 99%.[6] Esta revisión, sumada al análisis de conjuntos de datos públicos como PTB-XL[7] y la base de datos de 12 derivaciones para estudio de arritmias publicada por Zheng et al.[8] (también conocida como el dataset de Chapman), da la base necesaria para justificar tanto la arquitectura del modelo como la selección de los datos de entrenamiento.

Actualmente, el diagnóstico a partir del ECG en la República Dominicana se basa principalmente en la experiencia clínica manual. Si bien existen equipos con interpretación automática incorporada, muchos presentan limitaciones significativas: baja precisión en modelos que no fueron adaptados a poblaciones locales, poca explicabilidad de sus resultados y un costo de implementación elevado para centros de salud con recursos limitados. Frente a este panorama, el Dr. Ramos ha señalado el valor que tendría un sistema como SIEMIA no solo para agilizar diagnósticos en casos de emergencia y reducir errores de lectura, sino también para brindar soporte en la identificación de patrones complejos, ahorrar tiempo en interpretaciones repetitivas, ayudar a organizar mejor los casos prioritarios y dar mayor autonomía a los centros de salud que no cuentan con un cardiólogo residente.

Para poder construir un sistema de este tipo era necesario, primero, comprender con precisión qué es lo que se está tratando de clasificar.

Un electrocardiograma (ECG) es una herramienta no invasiva que registra los latidos del corazón y su actividad eléctrica a lo largo de un período determinado, comúnmente entre 10 a 12 segundos, mediante electrodos colocados sobre la piel.[9] En la figura 1 se representa de forma gráfica los tres componentes principales: la onda P, que representa la despolarización auricular y marca el inicio del latido; el complejo QRS, asociado a la despolarización ventricular y a la contracción del músculo cardíaco; y la onda T, que representa la repolarización ventricular, es decir, la recuperación eléctrica del corazón tras la contracción.[18]

Onda de electrocardiograma con la onda P, el complejo QRS, la onda T, segmentos e intervalos
Figura 1. Componentes principales de una onda de electrocardiograma: onda P, complejo QRS y onda T.

Una arritmia cardíaca, en términos simples, es cualquier alteración del ritmo normal del corazón.[10] Este proyecto se enfoca en diferenciar cuatro de los ritmos más comunes dentro de la práctica clínica.

El ritmo sinusal (SR) es el patrón normal, originado en el nodo sinoauricular, con una frecuencia habitual de entre 60 y 100 latidos por minuto (lpm), y sirve como referencia frente a la cual se comparan las demás alteraciones.[11]

La fibrilación auricular (AFIB), por su parte, se caracteriza por una actividad eléctrica desorganizada en las aurículas que produce un ritmo irregular y, frecuentemente, una frecuencia cardíaca elevada; debido a esta irregularidad, el flujo sanguíneo dentro del corazón se vuelve turbulento, lo que incrementa el riesgo de formación de coágulos que pueden desplazarse hacia otras partes del cuerpo y ocasionar complicaciones graves como un accidente cerebrovascular; en el ECG, su patrón suele describirse como “irregularmente irregular”, con ausencia de ondas P distinguibles.[12]

La bradicardia sinusal (SB) mantiene el origen sinusal del impulso, pero con una frecuencia inferior a 60 lpm, y puede ser un hallazgo normal en atletas o durante el sueño, o bien estar asociada a alteraciones que afectan la perfusión sanguínea.[13]

Finalmente, la taquicardia sinusal (ST) conserva igualmente el patrón sinusal, pero con una frecuencia superior a 100 lpm en reposo, y puede ser tanto una respuesta fisiológica al ejercicio o al estrés como un signo temprano de un proceso patológico subyacente.[14]

Trazos de ECG de ritmo sinusal, fibrilación auricular, bradicardia sinusal y taquicardia sinusal
Figura 2. Los 4 tipos de arritmias que se trabajan en este proyecto.

Objetivos completados

Hemos logrado implementar y entrenar un modelo de clasificación basado en redes neuronales convolucionales (CNN) capaz de interpretar electrocardiogramas digitales y diferenciar entre cuatro ritmos cardíacos clínicamente relevantes, evaluando su desempeño mediante métricas de precisión, sensibilidad, especificidad y F1-score sobre un conjunto de datos balanceado de cerca de 30,000 registros, alcanzando una exactitud global del 96% en la clasificación de los cuatro ritmos evaluados. Este resultado valida el enfoque metodológico planteado y sienta las bases técnicas necesarias para las siguientes fases del proyecto: la incorporación de técnicas de explicabilidad (XAI) y el desarrollo de la interfaz clínica que permitirá a los médicos visualizar el ECG junto al análisis automático del sistema.

Metodología

Para este proyecto nos estamos enfocando en incorporar técnicas de aprendizaje automático o Machine Learning (ML), que permite que un sistema aprenda a partir de datos en lugar de depender de reglas programadas explícitamente[15], y, un nivel más profundo, el aprendizaje profundo o Deep Learning (DL), que utiliza redes neuronales de múltiples capas para aprender representaciones directamente a partir de datos crudos, sin necesidad de que un humano seleccione manualmente qué atributos son relevantes.[16]

Las redes neuronales convolucionales (CNN), en particular, sobresalen en el reconocimiento de patrones espaciales dentro de los datos, lo que las ha convertido en una arquitectura de referencia tanto para el reconocimiento de imágenes como para el análisis de señales fisiológicas como el ECG.[17]

La elección de CNN como clasificador principal de SIEMIA no fue arbitraria. Además del respaldo que ofrece la revisión de Saber y Abotaleb en cuanto a su desempeño frente a otras arquitecturas,[6] se consideraron alternativas como Random Forest o Support Vector Machine (SVM), comúnmente utilizadas sobre características tabulares extraídas manualmente de la señal. Sin embargo, ese tipo de modelos depende en buena medida de variables diseñadas a mano, mientras que una CNN puede aprender directamente a partir de la forma de la señal cruda, sin ese paso intermedio de extracción manual de atributos, lo que resulta especialmente conveniente para una señal tan rica en matices morfológicos como el ECG.

Esquema de una red neuronal convolucional con capas de convolución, pooling y clasificación
Figura 3. Funcionamiento general de una red neuronal convolucional: extracción de características por capas de convolución y clasificación final.

Con la arquitectura definida, el siguiente reto fue construir un banco de datos suficientemente robusto para entrenarla. El conjunto final, denominado balanced_dataset_v3.csv, resulta de la fusión de dos bases de datos públicas de ECG ampliamente reconocidas en la literatura: PTB-XL[7], una de las bases clínicas de electrocardiografía de 12 derivaciones más extensas y mejor documentadas disponibles a través de PhysioNet, con 21,837 registros de 18,885 pacientes; y la base publicada por Zheng et al. (2022), conocida como el dataset de Chapman[8], con 45,152 registros centrados específicamente en la variabilidad del ritmo cardíaco. La combinación de ambos conjuntos permitió reunir alrededor de 65,000 registros médicos con más de 100 anomalías o condiciones cardíacas distintas.

A partir de ese conjunto fusionado, el equipo filtró únicamente las condiciones de tipo rítmico y seleccionó las cuatro con mayor relevancia clínica y volumen de datos: ritmo sinusal, fibrilación auricular, bradicardia sinusal y taquicardia sinusal. Dado que estas categorías no estaban distribuidas de forma pareja, se aplicó un proceso de undersampling, reduciendo cada clase a la cantidad de la categoría más pequeña —7,339 registros—, para obtener así un conjunto balanceado final de 29,356 registros. Este balance es clave en un problema de clasificación médica, ya que evita que el modelo aprenda a favorecer las clases mayoritarias en detrimento de aquellas con menor representación, pero de igual o mayor relevancia clínica.

Gráfico de barras con la frecuencia de uso de técnicas de clasificación de arritmias, encabezado por CNN
Figura 4. Técnicas de clasificación más utilizadas en la literatura de arritmias, según Saber y Abotaleb [6].

Una vez definido el conjunto de datos, se aplicó un protocolo de preprocesamiento orientado a preservar la integridad del entrenamiento. Todos los registros fueron estandarizados a una frecuencia de muestreo de 100 Hz y normalizados mediante z-score, de manera que cada señal quedara representada por 1,000 muestras, favoreciendo un entrenamiento más ligero y consistente. Adicionalmente, se implementó un pipeline de control de calidad para descartar registros corruptos, con picos de voltaje fuera de rangos biológicos razonables (superiores a 20 milivoltios), valores no numéricos (NaN) o rutas de acceso inválidas. Finalmente, el conjunto de datos depurado fue pre-calculado y almacenado en formato tensor de PyTorch (.pt), lo que reduce cuellos de botella durante el entrenamiento y asegura un formato de datos único y consistente.

La arquitectura de la red se implementó como una CNN unidimensional (1D-CNN) bajo el ecosistema de PyTorch, organizada en capas de convolución para la extracción de rasgos, funciones de activación no lineales, capas de pooling para reducir la dimensionalidad y capas densas para la clasificación final entre las cuatro categorías de ritmo.

El entrenamiento se gestionó mediante el algoritmo de optimización Adam junto con Data Loaders para el procesamiento eficiente por lotes, dividiendo el conjunto de datos en subconjuntos de entrenamiento y validación mediante un train-test split convencional, lo que permite evaluar el modelo sobre datos que no ha visto durante el aprendizaje.

A nivel de gestión del proyecto, el desarrollo del software se organizó bajo una metodología ágil basada en Scrum, complementada con un seguimiento visual tipo Kanban. En lugar de construir el sistema completo en una sola fase extensa, el trabajo se dividió en bloques de avance que permitieron levantar primero una versión funcional básica (centrada en el análisis de señales digitales de ECG) para luego mejorarla progresivamente hacia una solución más completa, con visualización de resultados y preparación para futuras funciones de explicabilidad.

En general, el sistema recibe electrocardiogramas en formato digital, procesa la señal, extrae los patrones relevantes y genera una clasificación preliminar entre las cuatro categorías de ritmo definidas, presentando el resultado junto a la visualización del propio ECG. En cambio, no clasifica arritmias fuera de esas cuatro categorías en esta etapa, no reemplaza el criterio médico ni emite diagnósticos definitivos, no prescribe tratamientos y no realiza monitoreo cardíaco en tiempo real, ya que podría afectar negativamente métricas como la precisión que resultan fundamentales para que la herramienta tenga utilidad real como apoyo clínico.

Resultados

Tras entrenar el clasificador sobre el conjunto de datos balanceado, la validación del modelo se realizó utilizando un marco de métricas de precision, recall, F1-score y matrices de confusión. Esta decisión responde a que, en un entorno clínico, el costo de un falso negativo, no detectar una arritmia maligna, puede ser considerablemente más alto que el de un falso positivo, por lo que resulta indispensable observar el comportamiento del modelo clase por clase y no solo su desempeño promedio.

Sobre un conjunto de validación de 4,403 registros, el modelo alcanzó una exactitud (accuracy) global del 96%. Al desglosar el desempeño por clase, la fibrilación auricular (AFIB) obtuvo un F1-score de 0.97 (precision 0.96, recall 0.98), la taquicardia sinusal (STACH) un F1-score de 0.97 (precision 0.98, recall 0.96), la bradicardia sinusal (SBRAD) un F1-score de 0.96 (precision 0.95, recall 0.98) y el ritmo sinusal (SR) un F1-score de 0.94 (precision 0.96, recall 0.93), tal como se resume en la tabla 1.

ClasePrecisionRecallF1-scoreSoporte
Ritmo sinusal (SR)0.960.930.941098
Fibrilación auricular (AFIB)0.960.980.971074
Taquicardia sinusal (STACH)0.980.960.971119
Bradicardia sinusal (SBRAD)0.950.980.961112
Accuracy global0.964403
Macro avg0.960.960.964403
Weighted avg0.960.960.964403
Tabla 1. Reporte de clasificación del modelo CNN sobre el conjunto de validación (4,403 registros).

La matriz de confusión permite observar con más detalle dónde se concentran los errores del modelo. El ritmo sinusal (SR) es la clase con más confusiones: de 1,098 casos reales, pero el modelo tiende a confundir el ritmo sinusal normal con sus variantes de frecuencia (más lenta o más rápida) en los casos límite, un comportamiento razonable considerando que la diferencia entre estas clases depende principalmente de la frecuencia cardíaca y no de un cambio morfológico marcado en la señal. En contraste, la fibrilación auricular y la bradicardia sinusal presentan muy pocas confusiones con las demás clases (recall de 0.98 en ambas), ya que estas dos condiciones se encuentran entre las de mayor relevancia clínica dentro del alcance del proyecto.

Matrices de confusión del modelo en conteos absolutos y normalizadas por clase
Figura 5. Matrices de confusión del modelo: conteos absolutos (izquierda) y valores normalizados por clase real (derecha).

Estos resultados son consistentes con lo reportado en la literatura para arquitecturas CNN aplicadas a la clasificación de arritmias, donde se documentan precisiones de entre 95% y 99%[6], y validan la hipótesis planteada al inicio del proyecto: que un modelo de redes neuronales convolucionales, entrenado con datos de ECG adecuadamente preprocesados y balanceados, puede clasificar patrones arrítmicos con métricas de desempeño clínicamente útiles.

Más allá del modelo en sí, el equipo ha avanzado también en el diseño de la experiencia de usuario del sistema, con un mockup preliminar de la interfaz que el personal médico utilizará para insertar un electrocardiograma, visualizar la señal y recibir el resultado del análisis, así como el diagrama de flujo que describe el recorrido completo desde que se inserta un ECG hasta que se muestra el resultado preliminar.

Diagrama de flujo: insertar ECG, validar formato, procesar señal y mostrar resultado o error
Figura 6. Diagrama de flujo del proceso de inserción y análisis de un electrocardiograma en la interfaz.

Conclusión

Los resultados obtenidos hasta el momento confirman que un modelo de aprendizaje profundo, entrenado sobre una base de datos suficientemente grande y balanceada, puede aprender a distinguir con alta precisión entre distintos ritmos cardíacos a partir de la señal cruda del electrocardiograma. Para un equipo de tesis, alcanzar un 96% de exactitud global, con métricas por clase que se mantienen consistentemente altas incluso en la categoría más difícil de diferenciar, es una validación fuerte de que el enfoque técnico elegido (CNN 1D, entrenada sobre datos fusionados de PTB-XL y Chapman) es el adecuado para este problema.

El propio alcance del proyecto limita, de forma deliberada, la clasificación a cuatro tipos de ritmo, dejando fuera un número considerable de arritmias que también requieren atención clínica; ampliar esa cobertura implica un proceso de entrenamiento, validación y ajuste más exigente. De igual forma, el sistema aún no incorpora las técnicas de explicabilidad (XAI) contempladas desde el planteamiento inicial, un componente que resulta especialmente importante en el ámbito médico, donde un modelo que sólo entrega una etiqueta sin justificación difícilmente genera la confianza necesaria para ser adoptado por profesionales de la salud.

En un país donde la transformación digital del sector salud continúa en proceso, este proyecto aspira a convertirse en una herramienta de apoyo accesible que ayude a los profesionales de la salud dominicanos a detectar arritmias con mayor rapidez, consistencia y respaldo tecnológico, sin pretender jamás sustituir el criterio clínico que solo un especialista puede ofrecer.

Fusionar y balancear dos conjuntos de datos de procedencias distintas, depurar registros corruptos y decidir qué arritmias priorizar dentro de un alcance realista fueron, en la práctica, tareas tan determinantes para el resultado final como la propia arquitectura de la red neuronal. Los hallazgos recolectados hasta la fecha no solo confirman la eficiencia del modelo desarrollado, sino que además sientan los cimientos para su posterior evolución hacia una solución de soporte tecnológico cada vez más robusta e integral para el diagnóstico cardiovascular.

Referencias

  1. World Health Organization, “Cardiovascular diseases (CVDs),” 2025. Available: https://www.who.int/news-room/fact-sheets/detail/cardiovascular-diseases-(cvds)
  2. U. Rojel et al., “Current state of arrhythmia care in Latin America: A statement from the Latin American Heart Rhythm Society,” Heart Rhythm O2, 2024. DOI: 10.1016/j.hroo.2024.11.010
  3. A. Ribeiro et al., “Automatic diagnosis of the 12-lead ECG using deep neural networks,” Nature Communications, 2020. https://pubmed.ncbi.nlm.nih.gov/32273514/
  4. M. Kachuee et al., “ECG heartbeat classification using deep neural networks,” IEEE EMBC, 2023. https://pmc.ncbi.nlm.nih.gov/articles/PMC10128986/
  5. H. Narotamo et al., “Deep learning for ECG classification: A comparative study of 1D and 2D representations and multimodal fusion approaches,” ScienceDirect, 2024. DOI: 10.1016/j.bspc.2024.106141
  6. M. Saber and M. Abotaleb, “Arrhythmia Modern Classification Techniques: A Review,” Journal of Artificial Intelligence and Metaheuristics, vol. 1, no. 2, pp. 42-53, 2022. DOI: 10.54216/JAIM.010205
  7. P. Wagner et al., “PTB-XL: A large publicly available ECG dataset,” PhysioNet, 2020. DOI: 10.13026/x4td-x982
  8. J. Zheng et al., “A large scale 12-lead electrocardiogram database for arrhythmia study,” PhysioNet, 2022. DOI: 10.13026/92ks-sq55
  9. Y. Sattar and L. Chhabra, “Electrocardiogram,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK549803/
  10. S. Dhaval, “Arrhythmias,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK558923/
  11. B. Rogoff et al., “EKG Rhythm,” StatPearls, 2022. Available: https://www.ncbi.nlm.nih.gov/books/NBK555952/
  12. Z. Nesheiwat et al., “Atrial Fibrillation,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK526072/
  13. Y. Hafeez et al., “Sinus Bradycardia,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK493201/
  14. A. Henning et al., “Sinus Tachycardia,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK553128/
  15. N. Maslej et al., “Artificial Intelligence Index Report 2025,” arXiv, 2025. Available: https://arxiv.org/pdf/2504.07139
  16. M. Liakat et al., “Deep Learning vs. Machine Learning for Intrusion Detection in Computer Networks: A Comparative Study,” Applied Sciences, 2025. DOI: 10.3390/app15041903
  17. M. Krichen, “Convolutional Neural Networks: A Survey,” Computers, 2023. DOI: 10.3390/computers12080151
  18. “Cómo interpretar un ECG: guía para profesionales de la salud,” Feb. 2026. Available: https://mesimedical.com/es/noticias/como-interpretar-el-ecg

MOSAIC: una plataforma híbrida para construir, evaluar y explicar horarios universitarios

Josvier Rodríguez y Emilio José George Rodríguez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Un proyecto final de grado que integra calidad de datos, optimización combinatoria, trazabilidad y apoyo a la toma de decisiones académicas.

En una universidad, un horario no es una simple cuadrícula de días y horas. Detrás de cada casilla existe una decisión que compromete la disponibilidad de un docente, la capacidad de un aula, la continuidad de una asignatura, la carga de una sección y la experiencia de cientos de estudiantes. Cuando esas decisiones se realizan con archivos dispersos, reglas implícitas y correcciones manuales, un cambio aparentemente pequeño puede producir choques de recursos, sobreocupaciones o secuencias académicas difíciles de justificar. La programación de horarios pertenece, por esa razón, a una familia de problemas combinatorios en la que la cantidad de alternativas crece con rapidez y donde obtener una propuesta válida requiere mucho más que acomodar materias en una semana [1]. En la práctica, una corrección tardía rara vez afecta una sola clase: puede obligar a mover otra sección, cambiar de espacio, alterar la jornada de un docente y comunicar una nueva versión a estudiantes y coordinadores. Esa propagación explica por qué la planificación necesita mecanismos preventivos, no únicamente capacidad de reaccionar cuando el conflicto ya fue publicado.

MOSAIC nació para responder a ese escenario desde la Escuela de Ingeniería en Computación y Telecomunicaciones de la Pontificia Universidad Católica Madre y Maestra. El proyecto fue desarrollado por Josvier Rodríguez y Emilio José George Rodríguez, bajo la asesoría de Rafael Omar Batista, como trabajo final de grado en Ciencias de la Computación. Su propósito no fue reemplazar a quienes planifican la oferta académica, sino construir una herramienta capaz de convertir datos institucionales en propuestas de horario verificables, comparables y explicables. El nombre identifica un motor analítico para propuestas de horarios universitarios: una plataforma que recibe archivos CSV o XLSX, prepara su estructura, mide el estado inicial, ejecuta un proceso de optimización y conserva evidencia de cada corrida. El desarrollo se situó en la intersección entre investigación operativa e ingeniería de software. Esa combinación permitió que las decisiones matemáticas no quedaran aisladas en un experimento, sino integradas a un flujo de carga, validación, ejecución, historial y exportación. El resultado es un artefacto académico que puede discutirse desde el algoritmo, la arquitectura y la utilidad institucional.

La pertinencia del proyecto se relaciona con la transformación digital que atraviesa la educación superior. Las universidades generan cada vez más datos sobre matrícula, asignaturas, infraestructura, modalidades y disponibilidad docente, pero disponer de información no garantiza que esta se convierta en una decisión útil. La literatura sobre instituciones universitarias digitales y analítica académica insiste en que el valor aparece cuando los registros se integran, se validan y se presentan de forma que apoyen el juicio humano [13]-[16]. MOSAIC adopta precisamente esa perspectiva: el algoritmo es importante, pero también lo son la calidad de entrada, la trazabilidad del proceso y la capacidad de explicar por qué una alternativa resulta factible o por qué no puede corregirse sin modificar una condición institucional. Este enfoque también responde a una necesidad regional: muchas instituciones latinoamericanas modernizan sus procesos mientras conviven con exportaciones tabulares, plataformas no interoperables y políticas que se aplican mediante conocimiento tácito. Una herramienta de apoyo debe tolerar esa realidad sin normalizarla de manera silenciosa; debe indicar qué datos faltan, cuáles fueron transformados y qué supuestos sostienen cada resultado [13], [16].

Cuando construir un horario deja de ser una cuadrícula

Este artículo presenta el recorrido del proyecto con una redacción orientada tanto a lectores técnicos como a personas vinculadas con la gestión académica. Primero se explica por qué la programación universitaria continúa siendo un problema abierto; luego se describe la metodología híbrida utilizada, la arquitectura del sistema y la forma en que se protegen la factibilidad y la reproducibilidad. Finalmente, se analizan los resultados con el mismo criterio utilizado en el informe final: separar lo que está implementado y verificado de aquello que todavía necesita validación institucional. Esa distinción es esencial porque un prototipo de investigación puede demostrar una base tecnológica sólida sin afirmar, de manera prematura, que ya está listo para operar a escala de campus. La promesa editorial y técnica es, por tanto, deliberadamente moderada. El artículo no presenta la automatización como una respuesta universal ni convierte una demostración en una adopción institucional. Expone cómo se construyó la solución, qué evidencia respalda cada afirmación y cuáles decisiones todavía pertenecen a las autoridades académicas. Esa honestidad fortalece, en lugar de debilitar, el aporte del proyecto.

Diagrama: el horario universitario en el centro, rodeado por docentes, pensum y ciclo, aulas, secciones, modalidades, demanda, calidad de datos y políticas
Figura 1. Variables que convergen en la programación de un horario universitario. Fuente: elaboración propia a partir del modelo conceptual de MOSAIC.

La dificultad del problema comienza por la cantidad de actores y recursos que deben coordinarse al mismo tiempo. Dos clases no pueden utilizar la misma aula en intervalos solapados; un profesor no puede impartir sesiones simultáneas; una sección debe respetar sus horas semanales, su continuidad y su relación con el pensum; una clase presencial necesita un espacio compatible con su matrícula, mientras una sesión virtual no debería reservar infraestructura física. A esas condiciones se agregan franjas institucionales, aulas obligatorias para laboratorios, límites de carga docente y días lectivos permitidos. En la literatura, estas condiciones se distinguen entre restricciones duras, cuya violación invalida la propuesta, y criterios blandos, que permiten comparar la calidad de horarios ya factibles [1], [3], [6]. Esta separación evita comparar como equivalentes situaciones de naturaleza distinta. Un hueco entre clases puede ser inconveniente, pero no tiene el mismo impacto que asignar simultáneamente al mismo docente o exceder la capacidad de un laboratorio. Al modelar prioridades explícitas, el sistema refleja que la calidad se optimiza después de asegurar que la propuesta pueda operar en la realidad universitaria.

El problema se vuelve aún más complejo cuando la información de partida no está preparada para un optimizador. Un archivo puede contener encabezados desplazados, columnas con nombres diferentes, horarios escritos con convenciones incompatibles, capacidades vacías o modalidades registradas de forma contradictoria. Si un valor de aula se interpreta mal, el sistema puede creer que existe un recurso disponible; si una hora no puede convertirse a un intervalo, no será posible detectar un solapamiento; si falta el identificador de un profesor, una doble asignación puede pasar inadvertida. Por eso, MOSAIC trata la preparación de datos como parte del problema de ingeniería y no como una actividad secundaria. La calidad de la solución depende de la fidelidad con la que la instancia represente la realidad institucional. La dificultad no se resuelve eliminando filas problemáticas sin dejar rastro. MOSAIC conserva un checklist de ingestión y comunica las columnas detectadas, las ausentes y las conversiones realizadas. Esta conducta es importante para el gobierno del dato: permite corregir la fuente, repetir el análisis y evitar que una aparente mejora sea solo consecuencia de haber ignorado registros que no pudieron interpretarse.

Los enfoques exactos, como la programación entera y la programación por restricciones, ofrecen formulaciones rigurosas y pueden demostrar optimalidad o infactibilidad dentro del modelo construido. Sin embargo, su costo puede aumentar cuando se combinan cientos de sesiones, aulas y candidatos temporales. Trabajos recientes han mostrado que la programación universitaria real contiene variantes multiphase, currículos, asignaciones de docentes y objetivos que dificultan una formulación única [4], [7], [17]. Esto no significa que los modelos exactos sean inadecuados; significa que deben utilizarse con un alcance cuidadosamente definido, límites de tiempo y mecanismos que permitan continuar cuando la instancia crece o incluye reglas difíciles de expresar en una formulación compacta. En MOSAIC, esa tensión se administra reduciendo el dominio de la fase exacta y estableciendo rutas de respaldo. El solucionador puede concentrarse en aulas compatibles y candidatos de tiempo permitidos, mientras otras reglas se verifican o reparan en etapas posteriores. La arquitectura acepta que una formulación técnicamente elegante no siempre es la alternativa más operativa cuando la instancia llega incompleta o cambia durante el ciclo.

Las metaheurísticas, por su parte, exploran el espacio de soluciones mediante movimientos y estrategias que buscan mejorar progresivamente un horario. La Búsqueda Tabú es especialmente útil porque incorpora memoria: evita regresar de inmediato a movimientos recientes, permite escapar de óptimos locales y puede aceptar una transición que no sea mejor en el corto plazo si abre una ruta hacia una solución superior [11]. Su flexibilidad resulta valiosa cuando las preferencias institucionales son numerosas o cambian con frecuencia. No obstante, una metaheurística pura necesita una solución inicial y puede dedicar gran parte de su esfuerzo a corregir factibilidad. Si las restricciones obligatorias no están controladas, el algoritmo podría encontrar un horario cómodo o equilibrado que siga siendo operacionalmente imposible. Su utilización también exige disciplina experimental. La semilla, el tamaño del vecindario, el número máximo de iteraciones y el criterio de estancamiento deben quedar registrados, porque dos ejecuciones con parámetros distintos no constituyen la misma prueba. MOSAIC incorpora esos metadatos para que la búsqueda no funcione como una caja negra y para que la comparación pueda reconstruirse posteriormente.

La tendencia de investigación ha favorecido, por ello, métodos híbridos que distribuyen responsabilidades entre varias técnicas. Una fase exacta puede construir una base factible; operadores especializados pueden reparar reglas de dominio; y una búsqueda local puede refinar preferencias sin comprometer condiciones críticas [5], [12]. Las revisiones sobre el University Course Timetabling Problem señalan que no existe un único método dominante para todas las instituciones, porque cada universidad combina políticas, estructuras curriculares y recursos distintos [3], [6]. MOSAIC se ubica en esa línea, pero añade una preocupación de producto: además de producir una propuesta, debe conservar los parámetros, desglosar las violaciones y permitir que un comité compare el estado original con la salida. La hibridación no consiste en encadenar algoritmos de manera decorativa. Cada componente responde a una limitación concreta: CP-SAT organiza una parte de la factibilidad, los reparadores incorporan conocimiento institucional y Tabú explora calidad. El valor surge de la coordinación entre fases y de una función de evaluación común que permite observar cómo cambia el horario sin perder el vínculo con sus restricciones.

Los estudios recientes también han ampliado el problema hacia modalidades híbridas, trayectorias curriculares personalizadas y asignaciones orientadas por demanda. Estas investigaciones muestran que una solución puede ser matemáticamente atractiva y, aun así, requerir mecanismos adicionales para responder a cambios de matrícula, indisponibilidad de recursos o secuencias de estudio no convencionales [8]-[10]. De esta evidencia surge una idea central del proyecto: evaluar un horario solo en condiciones nominales no basta. Dos propuestas pueden tener cero conflictos en el momento de su generación, pero reaccionar de manera diferente cuando aumenta la demanda o se bloquea un aula. La robustez debe observarse como una dimensión posterior y distinta de la optimización. La robustez adquiere especial relevancia porque la planificación se realiza antes de que todas las condiciones permanezcan estables. La matrícula puede variar, un profesor puede quedar indisponible o un aula puede salir de servicio. Incorporar escenarios no elimina la incertidumbre, pero permite identificar propuestas demasiado dependientes de recursos críticos y ofrecer al comité una señal temprana antes de aprobar la versión definitiva.

Una meta concreta: convertir datos dispersos en decisiones comparables

Otra brecha aparece entre los modelos publicados y las herramientas que usan las personas responsables de la planificación. Muchos trabajos comparan algoritmos sobre conjuntos de datos previamente estructurados, mientras las oficinas académicas deben resolver primero inconsistencias de archivos, reglas no documentadas y cambios de última hora. Además, una puntuación única no siempre explica por qué una propuesta es mejor. Los sistemas de apoyo a decisiones deben combinar automatización con transparencia, conservar la posibilidad de intervención y evitar que el usuario confunda una recomendación con una decisión obligatoria [2], [14]. MOSAIC se diseñó como una ayuda para el análisis: genera evidencia y alternativas, pero mantiene la aprobación final en manos del comité académico. También existe una diferencia entre demostrar un algoritmo y entregar una experiencia de uso. Una coordinación necesita cargar archivos, entender advertencias, revisar indicadores, localizar la causa de una violación y descargar resultados. Si el sistema solo devuelve un número final, obliga a confiar sin comprender. Por eso, la interfaz y la persistencia forman parte de la solución científica: convierten el cálculo en evidencia examinable.

Del archivo institucional a una representación confiable

El objetivo completado fue desarrollar una herramienta de apoyo a la toma de decisiones para generar y mejorar horarios universitarios a partir de datos académicos institucionales, permitiendo comparar la factibilidad y la calidad entre una programación base y una alternativa procesada. Para alcanzarlo, el proyecto implementó la carga, validación y normalización de archivos CSV y XLSX; construyó un modelo híbrido con CP-SAT, reparadores y Búsqueda Tabú; definió indicadores de restricciones duras, criterios blandos, puntuación global y robustez; y desarrolló una interfaz web conectada a servicios de ejecución, historial, persistencia y exportación. El cumplimiento se evaluó dentro del alcance de tesis, sin presentar la plataforma como una integración productiva con el sistema de gestión académica. El cumplimiento se materializó en cuatro capacidades observables: ingesta y normalización de CSV/XLSX; un modelo híbrido con restricciones y criterios de calidad; indicadores para factibilidad, calidad y estabilidad; y una interfaz conectada a servicios de ejecución, persistencia y exportación. El objetivo se considera completado dentro del alcance de tesis, sin extender esa afirmación a una integración productiva con sistemas institucionales.

La metodología comienza con una arquitectura por capas que separa la experiencia del usuario, los servicios y el núcleo analítico. La interfaz final se desarrolló con Next.js y TypeScript; FastAPI expone validación, creación de corridas, historial, detalle, horario, indicadores y exportaciones; el motor Python contiene la lógica de ingesta, evaluación y optimización; y SQLite, junto con archivos organizados por corrida, conserva el estado. Esta separación evita que una regla exista solo en la pantalla o que una exportación calcule resultados distintos. El mismo pipeline puede ejecutarse desde la interfaz, la API o la línea de comandos, lo que favorece las pruebas y reduce el acoplamiento entre la lógica matemática y la presentación. La separación evita duplicar lógica entre pantallas y exportaciones. El mismo núcleo analítico puede ser invocado desde línea de comandos, API o interfaz web, de modo que la cifra mostrada al usuario proviene del mismo cálculo que se conserva en los artefactos. Esta decisión reduce inconsistencias, facilita las pruebas y permite evolucionar la experiencia visual sin reescribir las reglas académicas.

Arquitectura por capas de MOSAIC: experiencia y acceso, servicios, núcleo analítico y datos y persistencia, desplegados con Docker Compose
Figura 2. Arquitectura final de MOSAIC por capas. Fuente: elaboración propia a partir de la arquitectura documentada del proyecto.

La entrada se organiza mediante un contrato extendido de veintiséis columnas que incluye ciclo, código y nombre de asignatura, número de clase, estado, cupo, matriculados, créditos, modalidad, profesor, aula, capacidad, días, horas, campus, tipo de clase, requisitos y observaciones, entre otros atributos. El sistema admite aliases y puede recuperar encabezados que no aparecen en la primera fila. También convierte valores vacíos, normaliza nombres, interpreta horarios y preserva columnas aparentemente anónimas cuando contienen información. El objetivo no es aceptar cualquier archivo sin advertencia, sino tolerar variaciones comunes y devolver un checklist claro de lo detectado, lo ausente y lo que debe corregirse antes de ejecutar el modelo. La tolerancia de entrada se combina con límites explícitos. El flujo reconoce alias y variaciones comunes, pero no inventa valores necesarios para decidir. Campos como matrícula, modalidad, aula, profesor, días y horas deben alcanzar un nivel mínimo de interpretabilidad. De esa forma, la flexibilidad sirve para incorporar exportaciones reales sin convertir datos ambiguos en certezas artificiales para el solucionador.

Flujo de datos de MOSAIC: CSV/XLSX, detección, normalización, validación, baseline, solver y salida, con compuertas de calidad
Figura 3. Flujo de datos y compuertas de calidad antes de la optimización. Fuente: elaboración propia a partir del proceso de ingesta de MOSAIC.

Después de la normalización, MOSAIC construye un baseline: una representación medible del horario recibido. Sobre ese estado calcula H, la suma de veinte restricciones duras, y F, la combinación ponderada de trece criterios blandos. La puntuación global se expresa como Φ(x) = M·H(x) + F(x), donde M vale 1 000 000. Esa constante establece una jerarquía operativa: una diferencia de factibilidad domina cualquier mejora razonable de calidad. El sistema no se limita a mostrar Φ; también presenta el desglose de H y F, porque dos valores globales similares pueden ocultar causas completamente distintas. Esta trazabilidad permite distinguir un choque de profesor de una capacidad insuficiente o de una regla de pensum. El baseline cumple una función metodológica y comunicativa. Permite responder qué problemas existían antes de intervenir y evita atribuir al algoritmo mejoras que ya estaban presentes en el archivo original. Cada fase se compara contra ese punto de partida mediante H, F y Φ, con desgloses por regla. Así, una reducción puede vincularse con choques, capacidad, modalidad o preferencias específicas.

La política hard-first protege el propósito institucional de la solución. Mientras existan violaciones duras, el proceso prioriza reducirlas. Una vez que H llega a cero, un movimiento que vuelva a crear un conflicto obligatorio se rechaza aunque disminuya F. Esta decisión evita que una preferencia, como reducir huecos o minimizar cambios de aula, compense una condición que haría inviable el horario. El principio se relaciona con la optimización lexicográfica utilizada en problemas de asignación, donde los objetivos se ordenan por niveles de prioridad [1], [17]. En términos prácticos, MOSAIC intenta primero producir una propuesta que pueda operar; solo entonces busca que esa propuesta sea más conveniente, equilibrada o estable. La constante M se configuró en 1,000,000 como separación de órdenes de magnitud, no como costo monetario. La consecuencia es equivalente a una prioridad lexicográfica: primero se comparan las violaciones obligatorias y solo cuando H es igual se utiliza F para ordenar la conveniencia. Esta decisión hace visible una política que, en procesos manuales, suele quedar implícita en la experiencia del planificador.

Esquema de la función objetivo Φ(x) = M·H(x) + F(x): restricciones duras H(x) ponderadas por M = 1 000 000 y criterios de calidad F(x)
Figura 4. Jerarquía hard-first de la función objetivo. Fuente: elaboración propia a partir de la formulación Φ(x) = M·H(x) + F(x).

La fase A utiliza CP-SAT para estructurar la asignación inicial. Para cada sesión presencial se construyen aulas cuya capacidad cubre la matrícula y candidatos temporales dentro del dominio institucional. Las variables binarias representan la asignación de una sesión a un aula y, cuando corresponde, a un candidato de tiempo. Las restricciones lineales impiden solapamientos de aula, profesor y sección. El solver opera con un límite temporal y reporta su estado, modelo utilizado y violaciones residuales. Para controlar el crecimiento, la reasignación temporal completa se aplica a instancias de hasta cuatrocientas sesiones presenciales; en archivos mayores se utiliza un modelo reducido centrado en aulas y mecanismos de respaldo. El modelo devuelve estados como OPTIMAL o FEASIBLE dentro de la formulación ejecutada y un límite temporal controla el costo. En instancias mayores, la reasignación temporal completa se reduce y puede utilizarse un constructor de respaldo antes de la reparación. Es importante subrayar que un estado del solver describe el modelo compacto, no certifica por sí solo toda la realidad institucional.

La fase B incorpora reparadores especializados. Algunos atienden inconsistencias básicas, como una sesión virtual con aula, una clase presencial sin espacio, una capacidad insuficiente o un choque de profesor. Otros utilizan configuraciones institucionales para revisar horas semanales, continuidad, máximo de sesiones por día, dominio de horarios, límites de carga docente, días lectivos, aulas obligatorias, franjas reservadas y coherencia con el pensum por ciclo. Un reparador no fuerza una corrección imposible. Si no existe un aula con capacidad suficiente o una franja permitida, la violación se conserva y se acompaña de contexto. Esa decisión es importante: modificar datos institucionales para fabricar factibilidad sería menos transparente que reportar un límite estructural. La reparación no fuerza resultados imposibles. Si ninguna aula disponible satisface la matrícula o si todas las franjas válidas están bloqueadas, el sistema preserva la violación y aporta contexto. Esta conducta protege la integridad del dato: es preferible presentar un conflicto residual explicado que modificar capacidades, disponibilidades o reglas sin autorización para producir una apariencia artificial de factibilidad.

La fase C ejecuta Búsqueda Tabú sobre la solución reparada. Los vecindarios se forman mediante cambios e intercambios de aula y tiempo; cada candidato se evalúa con Φ; la lista tabú evita ciclos inmediatos; y un criterio de aspiración permite aceptar un movimiento prohibido cuando produce una mejora global. Cada iteración registra fase, número, H, F, Φ y una nota, de modo que el usuario pueda observar cómo evolucionó la propuesta. En archivos muy grandes, el sistema reduce automáticamente iteraciones, tamaño de vecindario y estancamiento, porque cada vecino requiere copiar y evaluar una estructura tabular. La prioridad es conservar la estabilidad de la aplicación antes que simular una búsqueda profunda que agote memoria. Cada iteración registra la fase, H, su desglose, F, Φ y una nota del movimiento. El resultado incluye la razón de parada y la cantidad de iteraciones ejecutadas. En modo ligero, la plataforma declara que Tabú fue omitida, en vez de presentar la salida como si hubiese atravesado todas las fases. Esa transparencia impide confundir validación rápida con optimización completa.

Después de la optimización, el componente Ω evalúa la propuesta bajo escenarios. La demanda puede aumentar o disminuir y determinados docentes o aulas pueden marcarse como no disponibles. MOSAIC no modifica el horario en esta etapa: vuelve a calcular H y F sobre la asignación fija y produce una tasa de factibilidad, media, desviación, varianza, mejor y peor valor de F y coeficiente de variación. Esta separación evita confundir robustez con reoptimización. Ω responde a una pregunta preventiva: si las condiciones cambian después de seleccionar una propuesta, ¿cuánto depende su factibilidad de recursos sin margen o de aulas cercanas a su capacidad? El resumen de Ω contempla tasa de factibilidad, media, desviación, varianza, mejor y peor F y coeficiente de variación. La asignación se mantiene fija para medir sensibilidad, por lo que el componente no debe describirse como una reoptimización automática. Su propósito es comparar margen operativo: revelar si una propuesta nominalmente válida depende de capacidades o disponibilidades con poca holgura.

Pipeline híbrido en cuatro fases: A CP-SAT, B reparación, C Búsqueda Tabú y Ω robustez
Figura 5. Fases del solver híbrido y evaluación de robustez. Fuente: elaboración propia a partir del orquestador final de MOSAIC.

La metodología se completa con persistencia y reproducibilidad. Cada corrida puede conservar un manifiesto, parámetros, resúmenes, desgloses, horario base, horario procesado y exportaciones. El índice SQLite permite reconstruir el historial después de reiniciar el backend, mientras Docker Compose coordina los servicios en un entorno reproducible. La semilla, la versión, el límite de tiempo y los parámetros de búsqueda forman parte de los metadatos. El repositorio incluye pruebas segmentadas para ingesta, API, pensum, restricciones, CP-SAT, reparación, CLI y construcción del frontend. No se reporta un porcentaje agregado de cobertura que no esté respaldado por un artefacto; la evidencia se expresa como flujos y subsistemas comprobados. La reproducibilidad requiere más que guardar el archivo final. Para repetir una corrida deben conservarse la entrada o su huella, las tablas auxiliares, la versión del sistema, la semilla y los parámetros de ejecución. MOSAIC estructura esa evidencia alrededor de cada identificador de corrida, lo que facilita auditoría, comparación y recuperación incluso después de reiniciar el servicio.

De prototipo exploratorio a plataforma trazable

La evolución desde el anteproyecto fue cuantificable. El prototipo inicial registraba ocho restricciones duras y siete criterios blandos; la versión final incorporó veinte restricciones y trece criterios, equivalentes a incrementos de 150 % y aproximadamente 85.7 %, respectivamente. Los canales de ejecución pasaron de CLI y Streamlit a CLI, API, Next.js y Streamlit conservado como legado. También se incorporaron CP-SAT, la evaluación Ω y la persistencia durable de corridas. Estos cambios no fueron una ampliación decorativa: surgieron de problemas observados con archivos institucionales, navegación entre ejecuciones, historial, reglas académicas y necesidad de separar la robustez de la mejora del horario. El cambio cuantitativo se acompañó de una transformación arquitectónica. Streamlit fue útil para validar la idea, pero el historial y la navegación entre corridas justificaron una interfaz Next.js conectada a FastAPI. SQLite y los directorios de artefactos sustituyeron la dependencia de una sesión activa. El prototipo anterior se conservó como evidencia de evolución, no como interfaz oficial final.

El caso de calibración final utiliza un fixture de seis sesiones y se ejecutó en modo ligero, sin Búsqueda Tabú, con semilla 42. El baseline y la salida A+B conservaron cinco aulas asignadas, una tasa de 83.33 %, cero conflictos de aula, profesor y sección, cero excesos de capacidad, H igual a cero, F igual a 4.7776 y Φ igual a 4.78. Este resultado no demuestra una mejora, porque la instancia ya era factible. Su valor es otro: confirma que las fases de construcción y reparación no degradaron una propuesta válida ni alteraron su costo suave. En ingeniería de optimización, preservar una solución correcta es tan importante como mejorar una defectuosa. La estabilidad es un resultado válido aunque no implique una reducción. En este caso, A+B recibió una instancia ya factible y mantuvo intactos sus indicadores, demostrando que el pipeline no introdujo conflictos al procesarla. La prueba también establece un límite interpretativo: al no ejecutarse Tabú y utilizar solo seis sesiones, no sirve para afirmar rendimiento, escalabilidad ni superioridad algorítmica.

Gráfico de barras: restricciones duras de 8 a 20, criterios blandos de 7 a 13 y canales de ejecución de 2 a 4 entre el anteproyecto y la versión final
Figura 6. Evolución cuantitativa del alcance implementado. Fuente: elaboración propia a partir del registro final del proyecto.

El proyecto también conserva evidencia histórica del prototipo Streamlit. En una corrida de una configuración anterior, la interfaz mostró una reducción de noventa violaciones duras a cero y de veinticuatro choques de profesor a cero, con una tasa final de aulas asignadas de 91.67 % y una puntuación global de 135.52. Estos números no se utilizan como benchmark del modelo final H1-H20 porque cambiaron las reglas, los pesos y la implementación. Mantener la captura, en lugar de mezclarla con la calibración actual, fortalece la honestidad experimental: permite observar la evolución del producto y, al mismo tiempo, evita presentar resultados incompatibles como si pertenecieran a una sola evaluación. La corrida histórica conserva valor como prueba de concepto porque evidencia que el flujo anterior podía eliminar conflictos concretos. Sin embargo, sus pesos, reglas y arquitectura eran distintos. Presentarla separadamente evita una comparación engañosa con el modelo final H1-H20. Esta distinción entre evidencia histórica y benchmark reproducible es necesaria para que el análisis no convierta resultados de etapas diferentes en una sola narrativa cuantitativa.

Gráfico de barras: costo suave F igual a 4.7776 en el baseline y en la salida A+B, con H igual a cero en ambos estados
Figura 7. Caso de calibración: estabilidad de una instancia factible. Fuente: elaboración propia a partir de calibration_baseline_kpis.json.

En la arquitectura final, una ejecución puede iniciarse, persistirse, consultarse y exportarse a través de capas separadas. La API dispone de rutas para validar archivos, crear corridas, consultar historial, recuperar el horario, revisar indicadores y generar exportaciones. Los artefactos por corrida incluyen manifest.json, parameters.json, summary.json, counts.json, baseline_schedule.csv, optimized_schedule.csv y, bajo demanda, un PDF institucional. La interfaz Next.js organiza el flujo alrededor de carga, ejecución, historial y detalle, con vistas de indicadores, comparación, evolución, horario y robustez. La evidencia técnica es cualitativamente amplia, aunque el proyecto reconoce que no se conservó un reporte agregado de cobertura asociado al corte final. La API organiza rutas para validar, crear corridas, listar historial, consultar detalle, paginar el horario, recuperar KPIs y exportar CSV, JSON o PDF. Docker Compose coordina frontend y backend en un entorno reproducible. Las pruebas verifican flujos de ingesta, modelo, optimización e interfaces, aunque el corte analizado no conserva un porcentaje agregado de cobertura que permita resumir toda la suite en una cifra.

Captura del dashboard Streamlit del prototipo con el resumen del resultado y la comparación antes y después de la optimización
Figura 8. Captura histórica del dashboard Streamlit conservada como evidencia del prototipo. Fuente: evidencia visual incluida en el informe final de MOSAIC; corresponde a una configuración legacy.

La robustez aporta una lectura que no aparece en una comparación nominal. H igual a cero es una condición necesaria, pero no suficiente para afirmar que una propuesta soportará cambios. Una tasa de factibilidad baja bajo escenarios indicaría que el horario depende de recursos sin alternativas; una dispersión alta de F revelaría sensibilidad de la calidad aunque no aparezcan nuevos conflictos. En el corte analizado, Ω está integrado y sus métricas están definidas, pero no existe un archivo institucional publicable con resultados finales de escenarios. Por eso, el artículo presenta esta capacidad como una función implementada y no como una mejora cuantitativa ya demostrada. La distinción protege la validez del proyecto y señala con claridad el experimento que falta. Esta lectura preventiva ayuda a elegir entre horarios aparentemente equivalentes. Una solución que utiliza aulas al límite o concentra sesiones en pocos recursos puede ser más frágil que otra con igual H y un margen mayor. El componente permite formular esa discusión con métricas, aunque todavía falta una corrida Ω sobre una instancia institucional publicable para demostrar una mejora cuantitativa en condiciones reales.

Los resultados deben leerse con límites explícitos. MOSAIC no certifica un óptimo global para todo un campus; la reasignación temporal CP-SAT se reduce en instancias grandes; los pesos de los trece criterios blandos necesitan calibración con responsables académicos; y las reglas H9-H20 dependen de tablas auxiliares completas y vigentes. Tampoco se realizó una prueba controlada con usuarios institucionales ni una integración con el sistema de gestión académica. En seguridad, el aislamiento local es adecuado para una tesis, pero una adopción real requiere autenticación, roles, auditoría, cifrado de respaldos, observabilidad y controles de descarga. Estas limitaciones no invalidan el trabajo; delimitan lo que puede afirmarse y orientan la siguiente etapa. Las limitaciones no invalidan el trabajo, sino que definen el significado de sus resultados. La evidencia es fuerte en trazabilidad, arquitectura y cobertura funcional; es más limitada en benchmarks de gran escala, validación con usuarios y seguridad productiva. Reconocer esa distribución impide extrapolar una prueba controlada a un campus completo y orienta de manera concreta las actividades de una siguiente fase.

Diagrama conceptual de escenarios de robustez Ω según la demanda y la indisponibilidad de recursos
Figura 9. Espacio conceptual de escenarios para la evaluación Ω. Fuente: elaboración propia a partir del componente de robustez de MOSAIC.

Lo que MOSAIC demuestra y lo que todavía debe demostrar

La principal contribución de MOSAIC no es prometer un horario perfecto, sino demostrar una forma más rigurosa de construir, medir y discutir propuestas. El proyecto integra datos imperfectos, reglas institucionales, optimización híbrida y una capa de producto capaz de conservar el historial. La estrategia hard-first resulta coherente con el dominio: primero se protege la operación académica y luego se mejoran preferencias. La trazabilidad entre modelo, código, pruebas y artefactos permite explicar qué ocurrió en cada fase y evita que la salida dependa de una sesión efímera o de una captura aislada. Esta combinación aproxima el trabajo a los sistemas de apoyo a decisiones descritos en la literatura, donde la utilidad depende tanto del cálculo como de la comprensión del resultado [2], [14]. Ese enfoque es relevante porque la programación académica contiene excepciones legítimas que no siempre deben automatizarse. La herramienta puede señalar el costo y la consecuencia de una decisión, pero la aprobación final permanece en el comité. La explicabilidad, entonces, no es un complemento visual: es el mecanismo que permite combinar capacidad computacional con responsabilidad institucional y documentar por qué se aceptó una alternativa.

El paso siguiente debe ser un piloto institucional paralelo al proceso actual. Antes de integrar registros de producción, conviene construir un benchmark anonimizado y versionado con tamaños crecientes, múltiples semillas y métricas H, F, Φ, tiempo y FeasRate. Los pesos deben calibrarse mediante sesiones con coordinación académica y un comité responsable de reglas. El piloto debería comparar la línea base con propuestas de MOSAIC, registrar excepciones y medir no solo la calidad del horario, sino el tiempo de revisión, la claridad de las explicaciones y la confianza de los usuarios. Solo después de validar datos, políticas y experiencia de uso sería razonable avanzar hacia una integración gradual con el sistema institucional. Un diseño de evaluación riguroso debería incluir casos nominales y perturbados, comparaciones por tamaño y sesiones de revisión con usuarios. También conviene registrar cuántas advertencias requieren intervención, qué reglas producen más conflictos y cuánto tiempo se reduce en la preparación y verificación. Estas medidas conectarían el rendimiento técnico con el impacto organizacional que justifica la adopción de la plataforma.

También será necesario fortalecer el gobierno tecnológico. Las configuraciones de pensum, límites docentes, franjas reservadas y aulas especializadas deben tener responsables, fechas de vigencia y procedimientos de actualización. Un solver puede ejecutar correctamente una regla obsoleta y producir un resultado difícil de detectar; por eso, la mantenibilidad no depende únicamente del código. En el plano técnico, lint y formato deben convertirse en controles bloqueantes de integración continua, las pruebas de rendimiento deben cubrir instancias mayores y Ω puede evolucionar desde la evaluación hacia mecanismos de recuperación o reoptimización. En el plano de seguridad, la autenticación institucional, la autorización por roles y la auditoría de exportaciones son condiciones previas para utilizar información real. La sostenibilidad exige además documentación que sobreviva al equipo desarrollador. Las reglas, contratos, endpoints y decisiones de arquitectura deben mantenerse alineados con el código y con el ciclo académico vigente. Un proceso de control de cambios permitiría saber quién modificó una política, desde cuándo aplica y qué corridas deben repetirse. Esa disciplina convierte la trazabilidad técnica en gobierno institucional.

El impacto potencial se extiende más allá de la construcción de un horario. Una planificación mejor documentada puede reducir correcciones tardías, facilitar la coordinación entre escuelas, hacer más transparente el uso de aulas y ofrecer evidencia para discutir inversiones en infraestructura. También puede convertir los conflictos recurrentes en conocimiento institucional: si determinadas franjas, capacidades o asignaturas concentran problemas en varios ciclos, la universidad puede actuar sobre la causa y no únicamente sobre cada incidencia. Este horizonte requiere colaboración entre ingeniería, registro, coordinaciones, docentes y autoridades. MOSAIC propone un lenguaje común basado en datos, restricciones y métricas, pero su evolución dependerá de que esas áreas validen las reglas y definan qué significa calidad en su contexto. El siguiente paso no es automatizarlo todo, sino abrir un piloto controlado donde el sistema pueda ser cuestionado, corregido y medido antes de asumir responsabilidades operativas mayores.

MOSAIC muestra cómo un proyecto final de grado puede conectar investigación operativa, ingeniería de software y necesidades concretas de la gestión universitaria. Su valor está en convertir un proceso frecuentemente manual en una secuencia observable: recibir, validar, medir, construir, reparar, mejorar, someter a escenarios y conservar evidencia. La plataforma todavía necesita validación externa y madurez productiva, pero deja una base clara para continuar investigando y colaborando con las áreas académicas. En lugar de presentar la automatización como sustituto del criterio humano, propone una relación más responsable: que los algoritmos reduzcan el trabajo repetitivo, expongan conflictos y permitan que las decisiones finales se tomen con información verificable, contexto institucional y capacidad de rendir cuentas. El proyecto aporta también una experiencia formativa: obligó a traducir políticas académicas a modelos comprobables, distinguir factibilidad de preferencia y comunicar incertidumbre sin ocultarla. En un contexto donde se promueven universidades inteligentes, este tipo de trabajo muestra que la innovación no consiste solo en agregar inteligencia artificial, sino en construir sistemas confiables, auditables y coherentes con las responsabilidades de sus usuarios.

Referencias

  1. S. Ceschia, L. Di Gaspero, and A. Schaerf, “Educational timetabling: Problems, benchmarks, and state-of-the-art results,” European Journal of Operational Research, vol. 308, no. 1, pp. 1-18, 2023, doi: 10.1016/j.ejor.2022.07.011.
  2. G. Xue, O. F. Offodile, R. Razavi, D.-H. Kwak, and J. Benitez, “Addressing staffing challenges through improved planning: Demand-driven course schedule planning and instructor assignment in higher education,” Decision Support Systems, vol. 187, Art. no. 114345, 2024.
  3. S. Abdipoor, R. Yaakob, S. L. Goh, and S. Abdullah, “Meta-heuristic approaches for the University Course Timetabling Problem,” Intelligent Systems with Applications, vol. 19, Art. no. 200253, 2023, doi: 10.1016/j.iswa.2023.200253.
  4. R. Esmaeilbeigi, V. Mak-Hau, J. Yearwood, and V. Nguyen, “The multiphase course timetabling problem,” European Journal of Operational Research, vol. 300, no. 3, pp. 1098-1119, 2022, doi: 10.1016/j.ejor.2021.10.014.
  5. F. Dunke and S. Nickel, “A matheuristic for customized multi-level multi-criteria university timetabling,” Annals of Operations Research, vol. 328, no. 2, pp. 1313-1348, 2023, doi: 10.1007/s10479-023-05325-2.
  6. A. Bashab et al., “Optimization Techniques in University Timetabling Problem: Constraints, Methodologies, Benchmarks, and Open Issues,” Computers, Materials & Continua, vol. 74, no. 3, pp. 6461-6484, 2023, doi: 10.32604/cmc.2023.034051.
  7. C. B. Mallari, J. L. San Juan, and R. Li, “The University Coursework Timetabling Problem: An Optimization Approach to Synchronizing Course Calendars,” Computers & Industrial Engineering, vol. 184, Art. no. 109561, 2023, doi: 10.1016/j.cie.2023.109561.
  8. T. Müller, H. Rudová, and Z. Müllerová, “Real-world university course timetabling at the International Timetabling Competition 2019,” Journal of Scheduling, vol. 28, pp. 247-267, 2025, doi: 10.1007/s10951-023-00801-w.
  9. E. Steiner, U. Pferschy, and A. Schaerf, “Curriculum-based university course timetabling considering individual course of studies,” Central European Journal of Operations Research, vol. 33, pp. 277-314, 2025, doi: 10.1007/s10100-024-00923-2.
  10. M. Davison, A. Kheiri, and K. G. Zografos, “Modelling and solving the university course timetabling problem with hybrid teaching considerations,” Journal of Scheduling, vol. 28, pp. 195-215, 2025, doi: 10.1007/s10951-024-00817-w.
  11. M. Chen et al., “A randomized tabu search for university course timetabling,” Computers & Operations Research, vol. 123, Art. no. 105007, 2020, doi: 10.1016/j.cor.2020.105007.
  12. M. Chiarandini, K. Socha, M. Birattari, and O. Rossi-Doria, “An effective hybrid algorithm for university course timetabling,” Journal of Scheduling, vol. 9, pp. 403-432, 2006, doi: 10.1007/s10951-006-8495-8.
  13. K. Okoye et al., “Impact of digital technologies upon teaching and learning in higher education in Latin America: An outlook on the reach, barriers, and bottlenecks,” Education and Information Technologies, vol. 28, no. 2, pp. 2291-2360, 2023, doi: 10.1007/s10639-022-11214-1.
  14. A. Stojanov and B. K. Daniel, “A decade of research into the application of big data and analytics in higher education: A systematic review of the literature,” Education and Information Technologies, vol. 29, no. 5, pp. 5807-5831, 2024, doi: 10.1007/s10639-023-12033-8.
  15. K. Polin, T. Yigitcanlar, M. Limb, and T. Washington, “The Making of Smart Campus: A Review and Conceptual Framework,” Buildings, vol. 13, no. 4, Art. no. 891, 2023, doi: 10.3390/buildings13040891.
  16. R. Sequeira, A. Reis, P. Alves, and F. Branco, “Roadmap for Implementing Business Intelligence Systems in Higher Education Institutions: Systematic Literature Review,” Information, vol. 15, no. 4, Art. no. 208, 2024, doi: 10.3390/info15040208.
  17. E. Rappos, E. Thiémard, S. Robert, and J.-F. Hêche, “A mixed-integer programming approach for solving university course timetabling problems,” Journal of Scheduling, vol. 25, no. 4, pp. 391-404, 2022.

Arquitectura analítica de datos para mejorar las decisiones en la universidad: un prototipo de lakehouse académico

Carolina Bencosme Gómez y Jean Carlos Pérez Ortega – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Las universidades no carecen de datos. Carecen de un lugar común, gobernado y reutilizable donde esos datos dejen de ser un extracto de fin de cuatrimestre y pasen a ser un insumo de decisión. Matrícula, rendimiento, ayuda económica y trayectoria ocurren todos los días en el sistema académico. Lo que suele faltar es una capa analítica que no compita con el sistema transaccional ni dependa de un único proveedor comercial para almacenar, curar y consultar. Este artículo resume un proyecto de grado de Ingeniería en Ciencias de la Computación desarrollado en la Pontificia Universidad Católica Madre y Maestra. Carolina Bencosme Gómez y Jean Carlos Pérez Ortega diseñaron e implementaron un prototipo de arquitectura de datos de código abierto, tipo lakehouse, con el fin de mostrar cómo una institución de educación superior puede integrar extractos académicos y alimentar, desde el mismo suelo, proyección de matrícula y predicción de retención.

La motivación no fue adornar el expediente con un dashboard. Fue una brecha concreta: planificación y acompañamiento piden series y segmentos de riesgo, y el ERP responde con pantallas de trámite. La literatura de analítica institucional describe ese desajuste desde hace años. El valor no aparece por acumular registros, sino por alinear dato, modelo y decisión [1], [2], [5]. En América Latina la adopción de inteligencia artificial en educación ha crecido, pero con evidencia desigual y con poca infraestructura de datos que sostenga el modelo después del artículo [3], [6]. La transformación digital de una universidad no es comprar una licencia de reportes. Es cambiar dónde vive la verdad analítica y quién puede consultarla sin copiar tablas a un correo [4], [16].

El recorte fue deliberado. No se pretendió el almacén de toda la institución ni un conector permanente al sistema académico de producción. Se pretendió demostrar que un lago con propiedades transaccionales, un modelo dimensional y dos preguntas de negocio bastan para un ciclo completo: aterrizar, curar, modelar y consumir. Eso importa para otras instituciones de educación superior porque el beneficio no está en una nube hipotética. Está en poder empezar con extractos tabulares, hardware modesto y software abierto, sin hipotecar el dato a un formato propietario [8], [9], [14]. Si el prototipo funciona en un computador portátil con contenedores reproducibles, el argumento deja de ser de catálogo y pasa a ser de ingeniería. Por indicación de la dirección del proyecto, las series, volúmenes y capturas de dashboard de este artículo son un banco sintético de demostración, generado en local. Los extractos canónicos del prototipo se depositaron en custodia de la asesora y no se reproducen aquí.

El lector de este blog no necesita ser ingeniero de plataformas. Sí necesita una tesis clara. Una IES puede implementar una arquitectura abierta que separe almacenamiento de cómputo, que publique marts legibles por inteligencia de negocios y que deje al científico de datos trabajar sobre vistas ya unidas. El precio de esa promesa es honesto: el prototipo no opera veinticuatro horas, no sustituye al ERP y no afirma política de cupos ni de expulsión. Afirma un método exportable, con métricas de holdout del experimento y con límites que se dicen en voz alta. Esas métricas no son los puntos dibujados en las figuras de demostración.

El ERP resuelve la operación. No resuelve la pregunta analítica

En la PUCMM, como en otras universidades dominicanas, los portales de matrícula y de aula cumplen su trabajo: inscribir, publicar notas, entregar evidencias. Eso no equivale a disponer de un repositorio analítico con grano explícito, calidad medible y linaje. El analista pide un recuento por plan y campus. El sistema responde con una transacción de inscripción. Entre ambas capas alguien exporta, une y olvida de qué período era el archivo. Esa práctica no es negligencia personal. Es el síntoma de una arquitectura que nunca contempló el consumo analítico como un producto [1], [7], [13].

El patrón se repite fuera del país. Universidades que construyen plataformas de datos educativos reportan las mismas fricciones: fuentes heterogéneas, calidad irregular y ausencia de un contrato estable entre quien produce el dato y quien lo modela [8]. Las revisiones sobre inteligencia artificial en educación superior insisten en que los modelos aparecen más rápido que las condiciones para usarlos con justicia y con contexto pedagógico [6]. Un clasificador de abandono sin dashboard que llegue a orientación es un ejercicio de laboratorio. Un dashboard sin capa curada es un dibujo sobre un CSV semanal. El problema no es la falta de algoritmos. Es la falta de una capa intermedia gobernada [11], [12].

El almacén de datos clásico y el lago de archivos resuelven mitades. El primero ofrece esquema y SQL, pero se vuelve rígido cuando llega un dominio nuevo. El segundo admite cualquier archivo, pero entrega caos en cuanto dos cuadernos leen versiones distintas. El lakehouse surge para no escoger entre esos dos males. Unifica el almacenamiento de objetos con tablas que admiten transacciones, evolución de esquema y consulta SQL [9], [14], [17]. No es magia. Es un pacto de formato abierto: el motor de consultas, el cuaderno y el dashboard hablan de tablas, no de carpetas con fecha en el nombre.

Hay un segundo vacío local. Las estrategias nacionales de datos e inteligencia artificial hablan de infraestructuras compartidas y de incorporar analítica en educación. El documento de política no construye el catálogo ni el mart. Si una universidad espera el hub nacional para empezar, seguirá pegando hojas en cada ciclo lectivo. Si empieza con extractos propios y software abierto, gana soberanía sobre el dato y una base sobre la cual, más adelante, sí podrá conectar el sistema transaccional con ventanas controladas [4], [16]. Ese orden importa: primero el contrato interno, después el conector.

Las suites comerciales de inteligencia de negocios tampoco cierran solas la brecha. Un dashboard pegado al ERP hereda la carga operativa y la semántica del trámite. Un dashboard pegado a un archivo plano hereda la caducidad del archivo. El beneficio de una arquitectura abierta no es ahorrar la licencia del visor, que la institución puede seguir usando. El beneficio es que el visor deje de ser el lugar donde se limpia el dato. Limpieza, grano y calidad viven abajo. El dashboard solo consume. Esa inversión de responsabilidades es la que la literatura de inteligencia de negocios describió cuando distinguió almacenamiento de impacto [5]. Aquí se traduce a un campus que no puede, o no debe, saturar Oracle con consultas de exploración.

La comparación internacional no debe leerse como receta. Las plataformas documentadas en acceso abierto suelen asumir nube institucional, equipos de datos y convenios estables con el sistema académico [8]. Una IES dominicana de tamaño medio suele tener otra realidad: hardware personal de los tesistas, restricciones de privacidad, y un acceso a producción que no es un servicio, sino una ventana. Experiencias de campus que montan una arquitectura de datos abierta para servicios institucionales muestran que el patrón es viable, siempre que el dato no se confunda con el trámite cotidiano [18]. El estado del arte dice qué arquitectura es razonable. No dice cómo bajarla a un prototipo que quepa en laptops y que, aun así, entregue métricas reproducibles. Ese hueco es el que este proyecto intentó ocupar, sin pretender que el resultado sea ya política institucional.

En retención, además, el debate ya no es si se puede predecir el abandono. Es si la predicción llega a quien interviene y si el dashboard se entiende [11]. Revisiones regionales recuerdan que la deserción es un fenómeno con causas académicas, económicas y de trayectoria, y que un único indicador suele mentir [12]. Una arquitectura abierta no “resuelve” la deserción. Permite publicar un scoring con linaje, un segmento de riesgo y una vista individual sin reconstruir el análisis en una hoja privada. El beneficio institucional es de gobierno del dato, no de milagro pedagógico.

Qué se dio por cumplido

El desarrollo de este proyecto implementó un prototipo de arquitectura analítica tipo lakehouse, de componentes abiertos, adaptada a las restricciones de una institución de educación superior dominicana, con el propósito de integrar extractos académicos y habilitar decisiones basadas en datos. El objetivo general se desglosó en tres resultados verificables. Primero, un análisis de brechas entre el enfoque transaccional local y las arquitecturas lakehouse y de analítica institucional descritas en la literatura. Segundo, el diseño e implementación de un flujo por capas de aterrizaje, curación dimensional y mart de consumo, desplegable de forma reproducible en contenedores, con consulta SQL unificada y entornos de exploración para el científico de datos. Tercero, dos casos de uso académicos, cerrados hasta dashboard, que proyectan matrícula por carrera y campus con modelos de series temporales y priorizan riesgo de retención con un clasificador evaluado en un holdout temporal. El alcance es una prueba de concepto operable, no un sistema institucional continuo ni un conector de producción al ERP. La conexión permanente al sistema académico, la migración a servidores de la universidad y la operación continua del orquestador quedan explícitamente como trabajo futuro.

Un flujo, dos preguntas de negocio

La metodología partió de un recorte de producto, no de un catálogo de herramientas. Si el lakehouse no respondía a una decisión existente, se convertía en infraestructura sin dueño. Se eligieron dos preguntas que ya viven en la universidad. Cuántos alumnos esperar por plan y campus en los siguientes ciclos. A quién priorizar en acompañamiento si el riesgo de no retener se estima con historial académico. La primera sirve para la planificación. La segunda, la orientación. El analista interviene en ambas. El dashboard es el contrato de consumo, no el lugar donde se inventa el modelo [5], [11].

Diagrama de casos de uso: planificación, orientación y analista de datos usan el prototipo para proyectar matrícula y priorizar riesgo de retención
Figura 1. Casos de uso del prototipo: proyección de matrícula y predicción de retención.

Esa división no es cosmética. Matrícula y retención no comparten el mismo grano. La primera es una serie por plan, campus y período: una celda, una cuenta de alumnos. La segunda, en el modelo publicado, es estudiante por carrera y año de observación, con señales de carga, índice y ayuda. Forzar ambos dominios en una sola tabla ancha habría sido más rápido de dibujar y más caro de mantener. El modelado dimensional clásico sigue siendo el antídoto contra ese atajo [10]. Dos espacios de trabajo sobre la misma plataforma, con catálogos distintos, fue el trade-off: más orquestación, menos contaminación de semántica.

Capas, no un único servidor con todos los roles

El diseño lógico separa fuente, flujo gobernado, exploración y consumo. La fuente canónica sigue siendo el sistema académico institucional. En el prototipo, sin embargo, no se consulta en vivo de forma permanente. Las consultas pesadas se materializaron como archivos planos de respaldo. Las conexiones seguras de red se usaron solo para diagnóstico. El túnel no se sostuvo como camino diario, y eso se aceptó como hallazgo de implementación, no como nota al pie. Una IES que copie el método debe planear el extracto offline como camino realista mientras no exista un conector de solo lectura con ventana controlada [8], [14].

Diagrama de bloques: extracto tabular, pipelines de curación, almacén de objetos, catálogo de tablas abiertas, motor SQL, cuadernos y tableros de negocio
Figura 2. Diagrama de bloques del prototipo: extracto tabular, curación, almacén de objetos, catálogo de tablas abiertas, motor SQL y dashboards.

Sobre el almacén de objetos se montaron tablas de formato abierto y catálogo, de modo que el motor SQL y los cuadernos hablen el mismo lenguaje de tablas [9], [14]. El flujo productivo recorre aterrizaje en bruto, curación dimensional y publicación del mart. En paralelo, el analista explora la capa curada en un entorno acotado y solo promueve a consumo lo validado. Esa es la decisión que más beneficio institucional produce y la que más disciplina exige. Si el científico escribe el mart desde el cuaderno, el dashboard vuelve a ser un silo. Si el dashboard escribe reglas de negocio que el modelo no versiona, el scoring deja de ser auditable.

Diagrama de flujo: extracto tabular, aterrizaje en bruto, verificación de contrato, curación dimensional, verificación de calidad, modelado y mart de consumo
Figura 3. Flujo gobernado: aterrizaje, curación dimensional, modelado de las dos preguntas y mart de consumo. Si falla el contrato o la calidad, la corrida se detiene.

Distribuir componentes evita saturar un solo servidor con todos los roles. El almacenamiento masivo no es el motor de consultas. El motor no es el cuaderno. El cuaderno no es el dashboard. En hardware de laptop esa separación también es una defensa contra la memoria agotada. El prototipo no demostró escalamiento a miles de usuarios concurrentes. Demostró que el patrón no obliga a copiar el lago dentro de la herramienta de reportes. Para una IES, eso es el beneficio práctico de lo abierto: se puede cambiar el visor o el motor sin rehacer el contrato de tablas [9], [17].

La orquestación se pensó como dependencias estrictas, no como un reloj que afirma disponibilidad continua. Una corrida tiene identificador, recorre aterrizaje, calidad, transformación y publicación, y deja un resumen auditable. Si falla la ingesta, no avanza la curación. Si falla la calidad, no se publica el mart. El formato de tablas abiertas fue el que otorgó propiedades transaccionales al lago: no se trata de “archivos más ordenados”, sino de poder volver a un estado coherente [14]. Afirmar operación continua sería adelantar un resultado que no se midió. El beneficio medido es reproducibilidad de la evidencia, no un acuerdo de nivel de servicio.

Entorno local del prototipo: almacén de objetos, catálogo, cuadernos y motor SQL, con consumo en inteligencia de negocios
Figura 4. Entorno local del prototipo: almacén, catálogo, cuadernos y motor SQL.

El empaquetado en contenedores fue, además, una decisión de metodología de equipo. El hardware del proyecto no es un clúster. Son computadores portátiles con arquitecturas distintas. Sin imágenes compartidas, cada integrante instala a mano el almacén, el catálogo, el motor SQL y el seguimiento de experimentos, con versiones que no coinciden y resultados que un tercero no puede auditar. Lo abierto aquí no es un eslogan. Es la única forma razonable de que dos estudiantes y una asesora vean el mismo prototipo. Una IES que adopte el patrón puede, más adelante, mover esos mismos contratos a servidores institucionales. El prototipo no hizo esa migración. La deja como futuro explícito [8].

Cómo se modeló sin reescribir la limpieza en cada cuaderno

Para matrícula se construyó una vista compacta: el hecho ya unido a nombres de dimensión, lista para series temporales. El científico no arma la unión de planes y periodos en el cuaderno. Lee la compacta y entrena. Eso parece menor hasta que se cuenta cuántas veces un proyecto estudiantil vuelve a limpiar el mismo extracto [2], [10]. El candidato usado en el piloto reconoce estacionalidad de tres periodos académicos por año, coherente con el calendario de la institución y con la práctica estándar de series temporales [15].

Para retención se evitó entrenar sobre el detalle crudo de cada inscripción. El panel canónico agrega al año de observación señales de asignaturas, créditos, índice, ayuda económica, campus, sexo y facultad. La transición normal entre programas equivalentes de ciencias de la salud no entra al scoring de riesgo: confundirla con abandono habría inflado el drama y mentido al dashboard. El holdout fue temporal, no aleatorio. En datos académicos, barajar filas mezcla el futuro con el pasado y produce una precisión que no se puede gastar [6], [12]. El trade-off es una prueba más honesta y, a veces, un número menos lisonjero.

El consumo se diseñó para no crear un tercer silo. El mart se consulta con el motor SQL del lakehouse. Los dashboards leen ese mart. Los experimentos de series temporales y de clasificación se registran con identificadores de corrida. Las compuertas de calidad se colocaron donde duele: contrato de columnas al aterrizar, consistencia semántica al curar, y no publicar si el mart no cumple el umbral acordado. No se usaron identificadores más allá de los necesarios para el grano. No se trajo correo ni texto libre de plataformas de aula. No se prometió personalización clínica. El beneficio de lo abierto no incluye, en este prototipo, un producto de bienestar estudiantil con datos de salud [3], [11].

Lo que el prototipo llegó a medir

Las métricas de holdout que siguen describen el experimento de evaluación del prototipo. Las figuras de este apartado, en cambio, muestran un banco sintético de demostración: mismas formas de análisis, volúmenes distintos, leyendas etiquetadas como sintéticas. No se afirma que el error de matrícula se mantenga en producción ni que el clasificador sustituya al criterio de orientación [1], [5]. El prototipo corre en local. Eso limita la generalización y, a la vez, obliga a un contrato repetible: si se refresca el extracto, se puede volver a publicar el mart y comparar.

En Medicina, campus Santiago, el candidato estacional de tres periodos replicó el ritmo de inscripción en la prueba. El error absoluto medio fue de 32 alumnos y el error porcentual absoluto medio, de 3,0 por ciento. El historial de entrenamiento, el holdout y la proyección se leen en la misma gráfica. El ciclo académico se ve. Eso es lo que la planificación puede usar como insumo, no como oráculo [15].

Gráfica de matrícula de Medicina en Santiago: entrenamiento, prueba y pronóstico estacional
Figura 5. Proyección de matrícula, Medicina, campus Santiago. Banco sintético de demostración.

Ingeniería Industrial y de Sistemas, en el mismo campus, usó el mismo tipo de modelo estacional. El pronóstico sigue el diente de sierra académico, pero en el tramo final de la prueba la matrícula de holdout se separó al alza. El error porcentual absoluto medio subió a 8,5 por ciento y el error absoluto medio, a 21,1 alumnos. El modelo no “falló el calendario”. Falló el nivel en un tramo. Esa distinción importa si alguien pretende dimensionar la oferta con una serie frágil. En Santo Domingo, Medicina marcó 1,7 por ciento de error porcentual absoluto medio e Ingeniería Industrial y de Sistemas, 14,8 por ciento con candidato no estacional.

Gráfica de matrícula de Ingeniería Industrial y de Sistemas en Santiago: entrenamiento, prueba y pronóstico estacional
Figura 6. Proyección de matrícula, Ingeniería Industrial y de Sistemas, campus Santiago. Banco sintético de demostración.

El mayor logro técnico de este caso no es el número más bajo. Es que ambos algoritmos leyeron la compacta de la capa curada. El científico no reescribió la limpieza. El dashboard de proyección, conectado al mart mediante el motor SQL, concentra histórico y proyección de las dos carreras del piloto. El beneficio institucional es poder ver demanda sin interrogar el sistema de matrícula en vivo [5], [8].

Dashboard de proyección de matrículas con filtros de campus, año, plan de estudios y la serie histórica y proyectada por ciclo
Figura 7. Dashboard de proyección de matrícula. Captura de demostración con volúmenes sintéticos.

En clasificación, el holdout temporal eligió aumento de gradiente. Exactitud 0,857, medida F1 0,909 y área bajo la curva ROC 0,867. El bosque aleatorio quedó cerca en área bajo la curva, 0,860. La regresión logística alcanzó precisión 0,939 a costa de un recall de 0,650. No se eligió el modelo más “preciso” en un cartel. Se eligió el que mejor equilibró discriminación y exhaustividad sobre datos no vistos en el tiempo. Ese criterio es más aburrido y más usable que coronar un campeón por una sola métrica [6], [11]. El área bajo la curva indica discriminación útil en prueba. No indica el umbral de intervención. Ese umbral es política de orientación, no un parámetro que el prototipo imponga.

El scoring publicado es otro objeto. En el banco de demostración son 82 400 filas estudiante-carrera, con 44,0 por ciento en riesgo bajo, 13,2 por ciento medio, 23,6 por ciento alto y 19,2 por ciento crítico. Alto y crítico suman 42,8 por ciento. Mezclar ese universo con el holdout sería deshonesto [11], [12].

Gráfico de barras con los segmentos de riesgo bajo, medio, alto y crítico del scoring de retención
Figura 8. Segmentos de riesgo del scoring publicado.

El dashboard de retención tiene dos caras, y conviene no mezclarlas. La vista agregada diagnostica deserción descriptiva por sexo, facultad y quinquenio. La vista individual prioriza un historial de ejemplo. Juntas, cierran el ciclo de consumo: el mart se lee en inteligencia de negocios, no se reanaliza en una hoja suelta. Los KPI del dashboard descriptivo no son las métricas del clasificador. Las capturas que siguen son de demostración: no deben citarse como deserción institucional [1], [11].

Dashboard de retención estudiantil con tasa de deserción, distribución por sexo y facultad y tendencia por quinquenio
Figura 9. Dashboard de retención, vista general. Captura de demostración con indicadores sintéticos.
Dashboard individual con probabilidad de retención, probabilidad de graduación y variables consideradas
Figura 10. Dashboard de retención, vista individual.

Ejemplo sintético (IIS, FCI, Santiago): retención 27 por ciento y graduación 34 por ciento. El indicador de graduación es un proxy de dashboard, no el target k a k+1 del clasificador.

Lo que no salió como se pensó

Tres resultados no estaban en el plan. El acceso seguro al sistema académico no se sostuvo: quedó como prueba de diagnóstico y el extracto fuera de línea cargó con el piloto. El dominio clínico del anteproyecto dejó de aportar en cuanto los historiales académicos bastaron para cerrar los dos casos. Y en el dashboard de riesgo hubo que calibrar por índice académico; sin esa regla, el scoring subestima la exigencia de la prueba y distorsionaba la cola de acompañamiento. Ninguno de los tres es un fracaso de la arquitectura abierta. Son el tipo de hallazgo que solo aparece cuando se implementa, no cuando se dibuja la lámina.

Qué gana una institución si copia el método, no la etiqueta

El prototipo demuestra algo más modestamente útil que declarar a la universidad “orientada por datos”. Demuestra que extractos académicos pueden aterrizar, curarse en un modelo dimensional y alimentar, sin rehacer la limpieza, un modelo de matrícula y un clasificador de retención, con dashboards que leen el mart. La separación de almacenamiento y cómputo evitó saturar el sistema transaccional con analítica. La separación de espacios de trabajo evitó el monolito en el que matrícula y deserción se pisan el esquema. Las métricas, imperfectas y desiguales entre series, son suficientes para una prueba de concepto e insuficientes para fijar política de cupos o de expulsión [5], [14], [15].

Los beneficios concretos, si otra IES adopta el patrón, se pueden enumerar sin inflar el lenguaje. Primero, soberanía del dato: el formato abierto y el aterrizaje propio reducen la hipoteca a un único fabricante [9], [17]. Segundo, no competir con el ERP: la consulta pesada vive fuera del trámite [8]. Tercero, reproducibilidad en hardware heterogéneo, gracias a contenedores y a corridas con identificador. Cuarto, un contrato de consumo: el científico lee compactas, el dashboard lee el mart, y el linaje explica de dónde salió el número. Quinto, dos productos de decisión sobre la misma plataforma, lo que abarata el segundo dominio respecto de empezar de cero. Sexto, evidencia de calidad por corrida, no una foto de un dashboard sin fecha. Nada de eso requiere declarar una transformación digital nacional. Requiere disciplina de grano y de capas [4], [10], [16].

El aprendizaje más exportable no es el nombre de un contenedor. Es ese contrato. Donde no existe, el siguiente estudiante volverá a unir archivos planos. Donde existe, se puede cambiar el modelo y conservar el linaje. Esa es la diferencia entre un cuaderno brillante y una plataforma, aunque la plataforma aún quepa en un computador portátil [5], [14]. Hay un límite de honestidad que conviene no cruzar. El prototipo no demostró que integrar todas las fuentes de la universidad aumente la precisión de los modelos. Demostró dos dominios académicos con extractos definidos. Tampoco demostró políticas de seguridad de acceso en un directorio institucional. El aislamiento fue el del equipo local. Quien cite este trabajo como si ya hubiera un hub nacional de datos universitarios estará leyendo la estrategia, no el entregable [16].

Como trabajo futuro, el prototipo pide un conector de solo lectura al sistema académico, con ventanas controladas, sin abandonar el aterrizaje. Pide una historia más larga antes de usar series frágiles para dimensionar la oferta. Pide promover el espacio de exploración al mart con contratos automáticos, y versionar las reglas de negocio de retención junto al modelo. Un piloto de agendado del orquestador puede venir después. Afirmar hoy operación continua sería adelantar un resultado que no se midió. Migrar a servidores institucionales, con roles de acceso y sin identificadores personales de más, es el paso que convierte esta prueba en capacidad de la universidad, no en un entregable de curso.

Quien administra tecnología en una institución suele preguntar, con razón, cuánto cuesta y quién lo opera. Este prototipo no cotiza un contrato de soporte. Cotiza una lección de diseño: el costo de no tener capa analítica ya se paga, en horas de extractos y en decisiones tomadas con el archivo del cuatrimestre anterior. Lo abierto desplaza ese costo hacia un contrato interno que se puede auditar. El personal mínimo no es un equipo de veinte. Es alguien que defienda el grano, alguien que publique el mart y alguien de negocio que lea el dashboard sin pedir una nueva unión. Si esa tríada no existe, ninguna pila, abierta o cerrada, sostiene el beneficio [1], [5], [16].

Quien lea esto desde otra institución de educación superior no necesita copiar la pila. Necesita copiar la disciplina: una fuente, un grano por pregunta, una capa que no se reescribe en el dashboard, y métricas que se atreven a ser malas en una serie si eso es lo que el holdout mostró. El llamado es prosaico y, por eso, viable. Repetir el piloto en un siguiente ciclo lectivo, con un extracto fresco y un usuario de planificación sentado al lado del dashboard, antes de hablar de inteligencia artificial oficial.

Referencias

  1. S. Gaftandzhieva, S. Hussain, S. Hilcenko, R. Doneva, y K. Boykova, «Data-driven Decision Making in Higher Education Institutions: State-of-play», Int. J. Adv. Comput. Sci. Appl., vol. 14, n.º 6, pp. 400–411, 2023, doi: 10.14569/IJACSA.2023.0140645.
  2. B. Daniel, «Big Data and analytics in higher education: Opportunities and challenges», Br. J. Educ. Technol., vol. 46, n.º 5, pp. 904–920, 2015, doi: 10.1111/bjet.12230.
  3. S. Z. Salas-Pilco y Y. Yang, «Artificial intelligence applications in Latin American higher education: a systematic review», Int. J. Educ. Technol. High. Educ., vol. 19, n.º 1, p. 21, 2022, doi: 10.1186/s41239-022-00326-w.
  4. G. Vial, «Understanding digital transformation: A review and a research agenda», J. Strateg. Inf. Syst., vol. 28, n.º 2, pp. 118–144, 2019, doi: 10.1016/j.jsis.2019.01.003.
  5. H. Chen, R. H. L. Chiang, y V. C. Storey, «Business Intelligence and Analytics: From Big Data to Big Impact», MIS Q., vol. 36, n.º 4, pp. 1165–1188, 2012, doi: 10.2307/41703503.
  6. O. Zawacki-Richter, V. I. Marín, M. Bond, y F. Gouverneur, «Systematic review of research on artificial intelligence applications in higher education – where are the educators?», Int. J. Educ. Technol. High. Educ., vol. 16, n.º 1, p. 39, 2019, doi: 10.1186/s41239-019-0171-0.
  7. L. E. Contreras Bravo, J. I. Rodríguez Molano, y H. J. Fuentes López, «Analítica académica: nuevas herramientas aplicadas a la educación», Rev. Bol. Redipe, vol. 10, n.º 3, pp. 137–158, 2021, doi: 10.36260/rbr.v10i3.1228.
  8. A. A. Munshi y A. Alhindi, «Big Data Platform for Educational Analytics», IEEE Access, vol. 9, pp. 52883–52890, 2021, doi: 10.1109/ACCESS.2021.3070737.
  9. N. Janssen, T. Ilayperuma, J. Jayasinghe, F. Bukhsh, y M. Daneva, «The evolution of data storage architectures: examining the secure value of the Data Lakehouse», J. Data Inf. Manag., vol. 6, 2024.
  10. R. Kimball y M. Ross, The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling, 3.ª ed. Indianapolis, IN, EE. UU.: Wiley, 2013.
  11. J. Guerra et al., «Adaptation and evaluation of a learning analytics dashboard to improve academic support at three Latin American universities», Br. J. Educ. Technol., vol. 51, n.º 4, pp. 973–1004, 2020, doi: 10.1111/bjet.12935.
  12. G. B. N. Silva, «Deserción estudiantil en Institutos Superiores Tecnológicos de Ecuador: Una revisión de la literatura», Rev. Latinoam. Ogmios, vol. 3, n.º 8, pp. 25–32, 2023, doi: 10.53595/rlo.v3.i8.084.
  13. B. Williamson, «Policy networks, performance metrics and platform markets: Charting the expanding data infrastructure of higher education», Br. J. Educ. Technol., vol. 50, n.º 6, pp. 2794–2809, 2019, doi: 10.1111/bjet.12861.
  14. M. Armbrust et al., «Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics», en Proc. 11th Conf. Innovative Data Syst. Res. (CIDR), 2021.
  15. R. J. Hyndman y G. Athanasopoulos, Forecasting: Principles and Practice, 3.ª ed. Melbourne, Australia: OTexts, 2021.
  16. J. Komljenovic, S. Sellar, y K. Birch, «Turning universities into data-driven organisations: seven dimensions of change», High. Educ., vol. 89, n.º 5, pp. 1369–1386, 2025, doi: 10.1007/s10734-024-01277-z.
  17. P. Dubey, «The Data Lakehouse: An Evolving Paradigm in Data Architecture», Int. J. Comput. Eng., vol. 7, n.º 10, pp. 30–47, 2025, doi: 10.47941/ijce.2958.
  18. W. Villegas-Ch, X. Palacios-Pacheco, y S. Luján-Mora, «Application of a Smart City Model to a Traditional University Campus with a Big Data Architecture: A Sustainable Smart Campus», Sustainability, vol. 11, n.º 10, p. 2857, 2019, doi: 10.3390/su11102857.

DriveSense: Sistema Inteligente para la Clasificación de Perfiles de Conducción mediante Inteligencia Artificial

Iván Paul Marcelino y Juan Alfonso Alvarado Batista – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La seguridad vial continúa siendo uno de los principales retos asociados a los sistemas de transporte. La forma en que una persona acelera, frena, gira, mantiene la velocidad o reacciona ante una situación inesperada puede influir directamente en el nivel de riesgo de un recorrido. A escala internacional, los siniestros de tránsito continúan generando una elevada cantidad de muertes y lesiones, mientras que factores relacionados con el comportamiento humano permanecen entre los elementos de mayor interés para su prevención [1], [2]. Dentro de este contexto, el análisis del comportamiento del conductor mediante herramientas tecnológicas se ha convertido en una línea de investigación capaz de transformar acciones que tradicionalmente eran observadas de forma subjetiva en información cuantificable que puede ser estudiada mediante técnicas estadísticas y computacionales [6], [9].

En respuesta a esta problemática surge DriveSense, proyecto desarrollado por Iván Paul Marcelino y Juan Alfonso Alvarado Batista, estudiantes de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del ingeniero Rafael Omar Batista Jorge y dentro de la Escuela de Ingeniería en Computación y Telecomunicaciones. DriveSense fue concebido como un sistema para capturar, procesar y analizar datos de conducción generados dentro de un entorno de simulación controlado, con el propósito de identificar patrones y clasificar el comportamiento observado en diferentes perfiles. En lugar de limitarse a registrar una puntuación final, la propuesta integra la adquisición de telemetría, el procesamiento de los datos, el entrenamiento de modelos de aprendizaje automático y la presentación de resultados mediante una plataforma web.

El uso de simuladores ofrece una ventaja importante al estudiar este tipo de comportamiento. Determinadas situaciones que serían difíciles, costosas o inseguras de reproducir intencionalmente en una vía pública pueden ejecutarse de manera controlada dentro de un entorno virtual. Investigaciones previas han demostrado la utilidad de los simuladores para estudiar aspectos relacionados con la velocidad, las curvas y la respuesta de los conductores bajo condiciones repetibles [3]–[5]. Esta característica permite que distintos participantes realicen sesiones bajo condiciones previamente definidas y que los datos obtenidos puedan ser comparados sin exponer a los usuarios ni a terceros a las consecuencias de provocar deliberadamente una situación de riesgo real.

La motivación de DriveSense parte precisamente de combinar esa capacidad experimental con las posibilidades actuales del análisis de datos. Durante una sesión de conducción pueden generarse miles de observaciones relacionadas con velocidad, aceleración, frenado, dirección y otras variables del vehículo. Analizadas de forma aislada, estas señales pueden resultar difíciles de interpretar. Sin embargo, al organizarlas temporalmente y utilizar modelos capaces de reconocer patrones, es posible construir una representación más detallada de la forma en que una persona conduce [6], [12]. DriveSense utiliza este principio para transformar la telemetría producida durante una sesión en información que pueda ser consultada, comparada e interpretada posteriormente.

Puesto de simulación con volante, pedales y monitores que muestran el simulador y la plataforma DriveSense
Figura 1. Entorno utilizado para realizar una sesión de conducción con DriveSense, mostrando el simulador y la plataforma desarrollada.

Del problema vial al análisis inteligente del comportamiento

En la República Dominicana, la seguridad vial constituye una problemática especialmente relevante. El exceso de velocidad, las maniobras imprudentes, las aceleraciones repentinas, las frenadas intensas y diferentes formas de conducción agresiva pueden aumentar tanto la probabilidad de un incidente como la gravedad de sus consecuencias. A esto se agregan situaciones comunes en las que el conductor debe reaccionar rápidamente ante congestión, cambios de carril de otros vehículos, obstáculos o modificaciones inesperadas en el flujo del tránsito. Aunque muchas de estas conductas pueden identificarse mediante observación, convertirlas en información cuantitativa permite analizarlas con un mayor nivel de detalle y conservar un registro de lo ocurrido durante diferentes momentos de un recorrido.

Los métodos convencionales para valorar el desempeño de un conductor dependen en gran medida de la observación directa, de evaluaciones realizadas durante un período limitado o de información obtenida después de un incidente. Estos mecanismos continúan siendo necesarios, pero presentan limitaciones cuando se desea estudiar con precisión cómo cambió el comportamiento durante una sesión. Una evaluación humana puede indicar que una persona condujo de manera insegura, por ejemplo, pero los datos de telemetría permiten complementar esa observación indicando cuándo ocurrió una aceleración brusca, cuál era la velocidad en ese momento, cuánto se utilizó el freno o cómo varió la dirección. Esta posibilidad ha impulsado el desarrollo de investigaciones que utilizan información del vehículo para reconocer diferentes patrones de manejo [6], [12].

La literatura relacionada con el perfilado de conductores ha evolucionado progresivamente desde reglas construidas sobre unas pocas variables hacia métodos capaces de estudiar grandes cantidades de información. La clasificación de comportamientos mediante aprendizaje automático permite encontrar relaciones que pueden resultar difíciles de representar utilizando únicamente límites fijos o promedios generales [9], [11]. Diferentes investigaciones han utilizado telemetría vehicular para estudiar estilos de conducción, mientras que otros trabajos han incorporado métodos de ensemble y aprendizaje profundo con el propósito de representar relaciones más complejas entre las características disponibles [13], [15]. En todos estos casos, la calidad de los resultados depende no solamente del algoritmo utilizado, sino también de la forma en que los datos fueron capturados, organizados y preparados.

Precisamente, uno de los retos encontrados durante el desarrollo de DriveSense fue la ausencia de un conjunto de datos que reuniera exactamente las variables, condiciones experimentales y categorías requeridas por el proyecto. Los datasets disponibles en investigaciones previas fueron construidos bajo vehículos, sensores, poblaciones, carreteras y criterios de clasificación diferentes. Utilizar uno de ellos directamente habría significado adaptar el proyecto a condiciones que no necesariamente correspondían con el experimento propuesto. Por esta razón, se decidió construir un dataset propio mediante sesiones realizadas por participantes dentro del simulador, manteniendo un procedimiento común de captura y criterios previamente establecidos para representar los comportamientos estudiados.

Otro aspecto relevante es la dimensión temporal de la conducción. Un conductor no mantiene necesariamente el mismo comportamiento durante todo un recorrido. Una sesión que globalmente parece normal puede incluir algunos segundos de agresividad, distracción o conducción pasiva. Trabajos recientes han reforzado la importancia de estudiar secuencias y patrones temporales en lugar de representar toda una conducción mediante un único promedio [12], [13]. DriveSense adopta esta idea dividiendo la información en ventanas temporales. Cada ventana resume una parte de la sesión y posteriormente puede ser evaluada de forma independiente, permitiendo reconstruir cómo fue cambiando el comportamiento durante el recorrido completo.

Esta aproximación también responde a una necesidad de interpretabilidad. En una aplicación relacionada con personas y seguridad no resulta suficiente presentar únicamente una etiqueta generada por un algoritmo. Es importante conservar las métricas que dieron origen al análisis y disponer de mecanismos que ayuden a entender por qué el sistema produce determinados resultados. La inteligencia artificial explicable ha adquirido relevancia justamente por la necesidad de comprender la influencia que tienen diferentes características dentro de las predicciones [17], [20]. Por esta razón, DriveSense incorporó SHAP como técnica complementaria para estudiar la participación de las variables en las decisiones del modelo, manteniendo separada la predicción del proceso utilizado para explicarla.

Esquema en etapas: sesión, telemetría, procesamiento, modelo ML, resultado, estadísticas e interpretación
Figura 2. Esquema general del problema abordado: comportamiento del conductor, generación de telemetría, procesamiento de los datos y clasificación del perfil.

El desarrollo de DriveSense permitió cumplir el objetivo de construir una solución inteligente orientada a la clasificación de perfiles de conducción a partir de datos de telemetría obtenidos en un entorno de simulación controlado. Para lograrlo, se diseñó una arquitectura capaz de capturar, estructurar y almacenar telemetría vehicular a una frecuencia de 20 Hz; se implementaron mecanismos para analizar estadísticamente las variables obtenidas y estudiar sus diferencias entre sesiones y grupos de conductores; se desarrolló un proceso para entrenar y evaluar modelos supervisados de aprendizaje automático; y se incorporaron mecanismos para representar cuantitativamente los resultados, conservar las diferentes versiones de los modelos, analizar la influencia de las características y presentar la información al usuario mediante una plataforma centralizada. De esta manera, el objetivo general se desglosó en componentes medibles y verificables que abarcan el ciclo completo desde la generación del dato hasta la interpretación del resultado.

De una sesión simulada a un sistema completo de datos

El funcionamiento de DriveSense comienza antes de que el conductor inicie el recorrido. Desde la aplicación web se registra o selecciona al participante y se crea una nueva sesión indicando la información necesaria para la prueba, incluyendo el escenario y el vehículo que serán utilizados. Esta sesión queda registrada en el servidor con un estado inicial y puede ser validada posteriormente desde la computadora encargada de ejecutar la simulación. Esta separación permite mantener un registro de cada prueba y relacionar los datos producidos posteriormente con el conductor y las condiciones correspondientes, evitando que los archivos de telemetría queden aislados de su contexto experimental.

En la computadora de simulación se utiliza DriveSense Local Client, componente encargado de validar que la sesión corresponde con la información registrada en el servidor y preparar el entorno necesario para realizarla. Una vez completada la validación, el cliente inicia los componentes requeridos para trabajar con Assetto Corsa y entrega a Logger_BD la configuración asociada a la sesión. Durante este proceso, la sesión puede pasar por distintos estados, permitiendo que la plataforma conozca si se encuentra pendiente, en ejecución o completada. Este mecanismo también disminuye la cantidad de configuraciones que el usuario debe introducir manualmente en la computadora donde se realiza la prueba.

Diagrama de arquitectura de DriveSense: aplicación web, servidor, Local Client, Assetto Corsa, Logger_BD, almacenamiento y clasificación
Figura 3. Arquitectura general de DriveSense y comunicación entre la aplicación web, el servidor, DriveSense Local Client, Assetto Corsa, Logger_BD, el almacenamiento y el componente de clasificación.

Una vez iniciada la conducción, Logger_BD obtiene información directamente desde la telemetría generada por Assetto Corsa. La captura se realiza a una frecuencia de 20 Hz, equivalente a veinte muestras por segundo. Entre las variables registradas se encuentran velocidad, revoluciones por minuto, acelerador, freno, dirección y valores relacionados con la dinámica del vehículo. Esta frecuencia permite observar variaciones que podrían perderse si únicamente se conservaran valores globales al finalizar la sesión. La telemetría vehicular ha sido utilizada ampliamente como una fuente de información para reconocer comportamientos, ya que permite representar de forma cuantitativa las acciones ejecutadas durante la conducción [6], [12].

Los datos crudos de cada recorrido se conservan en archivos CSV, manteniendo un registro que puede utilizarse posteriormente para revisar una sesión o para construir nuevos conjuntos de entrenamiento. Paralelamente, DriveSense procesa la información y la organiza en segmentos y ventanas temporales que son almacenados en PostgreSQL. Esta combinación responde a dos necesidades diferentes: conservar la telemetría completa y, al mismo tiempo, disponer de una estructura más eficiente para consultas, evaluaciones y visualizaciones. De esta forma, no es necesario procesar nuevamente cada muestra del archivo original cada vez que se quiere consultar un resultado.

La arquitectura fue diseñada además para disminuir el riesgo de pérdida de información ante problemas de conectividad. Si durante una conducción el equipo de simulación no puede comunicarse temporalmente con el servidor, los datos pendientes permanecen almacenados de manera local. Cuando la comunicación vuelve a estar disponible, el sistema intenta enviarlos nuevamente. Esta estrategia permite que una interrupción de red no implique necesariamente perder la sesión completa. Mantener la persistencia de los datos fue considerado especialmente importante debido al esfuerzo requerido para reunir participantes y repetir las condiciones experimentales de una prueba.

Evaluación de sesión: sesión grabada, división en ventanas, clasificación ML, clase global con confianza y línea de tiempo por ventana
Figura 4. Flujo de los datos desde la captura de telemetría hasta su almacenamiento, procesamiento, clasificación y presentación de resultados.

Una vez almacenada la telemetría, la información se transforma en características que puedan utilizarse en el proceso de clasificación. En lugar de introducir directamente una secuencia extensa de muestras individuales al modelo, las ventanas permiten obtener representaciones de intervalos concretos de la sesión. A partir de ellas pueden calcularse valores relacionados con la velocidad, el uso del acelerador y del freno, la dirección, la variabilidad del comportamiento y la presencia de determinados eventos. La ingeniería de características constituye una etapa fundamental en problemas de clasificación porque permite representar los datos originales de una manera adecuada para que los algoritmos puedan identificar diferencias entre clases [9], [12].

Para determinar qué método resultaba más apropiado para el conjunto de datos disponible, durante el proyecto se trabajó con diferentes algoritmos supervisados: Random Forest, Support Vector Machine (SVM), XGBoost y Multi-Layer Perceptron (MLP). Los modelos fueron entrenados utilizando las mismas características de entrada para permitir una comparación bajo condiciones equivalentes. Random Forest representa un método ampliamente utilizado para problemas de clasificación por su capacidad de combinar múltiples árboles de decisión y manejar relaciones no lineales [10]. XGBoost, por su parte, utiliza un enfoque de gradient boosting que ha demostrado un elevado rendimiento en problemas con datos estructurados [19].

El proceso de entrenamiento no se limitó a generar una única partición del dataset. Para evaluar los modelos se utilizó validación cruzada k-fold, dividiendo repetidamente la información disponible entre subconjuntos de entrenamiento y validación. Este procedimiento reduce la dependencia de una sola división de los datos y permite observar la estabilidad del desempeño del modelo. Para realizar la comparación se consideraron métricas como Accuracy, F1-score, ROC-AUC y matrices de confusión. Cada una aporta una perspectiva diferente: mientras Accuracy representa la proporción global de clasificaciones correctas, F1 permite considerar simultáneamente precisión y exhaustividad, y la matriz de confusión permite estudiar en cuáles categorías se producen los errores.

A medida que el proyecto evolucionó también cambió la definición del problema. Las primeras pruebas trabajaban con tres categorías principales, pero posteriormente se incorporó el comportamiento distraído, dando lugar a las cuatro clases finales utilizadas por DriveSense: agresivo, distraído, normal y pasivo. Este cambio implicó volver a entrenar y evaluar los modelos bajo la nueva estructura. Finalmente se seleccionó XGBoost como clasificador principal y se implementó un sistema de versionado que permite conservar los modelos producidos durante diferentes entrenamientos. En lugar de sustituir simplemente un archivo cada vez que se entrena nuevamente, DriveSense registra qué versión fue generada, con qué datos se construyó, cuáles fueron sus métricas y cuál se encuentra activa.

La interpretabilidad complementa este proceso mediante SHAP, técnica que permite estudiar cómo las características utilizadas contribuyen a las predicciones realizadas. La idea no es modificar la clasificación obtenida, sino proporcionar una herramienta adicional para analizar la participación de las variables dentro del modelo. SHAP se apoya en principios de teoría de juegos para asignar valores de contribución a las características y se ha convertido en una técnica reconocida dentro del campo de la inteligencia artificial explicable [20]. En DriveSense, esta información sirve como apoyo al análisis de las decisiones del clasificador y ayuda a evitar que el sistema sea presentado únicamente como una caja negra que produce etiquetas sin contexto.

Tarjeta de estado del modelo activo XGBoost v3 con horas de entrenamiento y métricas
Figura 5. Flujo metodológico empleado para la preparación de los datos, entrenamiento, validación, selección y versionado de los modelos de clasificación.

El sistema se completa mediante la plataforma web, desde la cual se pueden registrar conductores, crear nuevas sesiones, consultar recorridos anteriores, visualizar evaluaciones y acceder a estadísticas. La interfaz reúne información que originalmente se encuentra distribuida entre archivos, registros de base de datos, predicciones y métricas. Además, permite realizar comparaciones utilizando características como género y rango de edad, así como consultar las versiones existentes de los modelos y sus procesos de entrenamiento. Esta centralización facilita que DriveSense pueda utilizarse no solamente como un experimento aislado, sino como una plataforma que mantiene la trazabilidad de las pruebas efectuadas.

En las fases finales se incorporó adicionalmente una capa de interpretación mediante la API de Gemini. Esta funcionalidad surgió al observar que porcentajes, métricas y gráficas pueden resultar difíciles de comprender para usuarios sin experiencia en ciencia de datos. Es importante diferenciar claramente sus funciones: Gemini no clasifica al conductor, no modifica los resultados del modelo y no participa en el cálculo de las predicciones. DriveSense y XGBoost continúan siendo responsables del procesamiento y la clasificación; la API recibe únicamente resultados ya generados y los transforma en una explicación en lenguaje natural. El backend controla además la información compartida, evitando transmitir identificadores directos como el nombre o el número de licencia del participante.

Interfaz web DriveSense Monitor con el resumen general, la lista de sesiones y la distribución de etiquetas
Figura 6. Ejemplo de la interfaz web de DriveSense para la gestión de sesiones, consulta del modelo activo y visualización de información del sistema.

Resultados que muestran más que una etiqueta

Durante el desarrollo del componente de inteligencia artificial se realizaron distintas iteraciones hasta llegar a la configuración final. En una etapa inicial se evaluó una implementación basada en RAPIDS AI utilizando CPU y GPU. La variante ejecutada mediante CPU obtuvo un Accuracy de 96.66 %, un Macro F1-score de 0.62 y un Weighted F1-score de 0.76, con un tiempo de entrenamiento de aproximadamente 0.3561 segundos. Para el volumen de información utilizado en ese momento, la ejecución mediante GPU presentó un desempeño similar pero requirió un tiempo mayor, por lo que la aceleración mediante GPU no se mantuvo como una necesidad del sistema. Estos resultados también evidenciaron la importancia de analizar múltiples métricas: un valor elevado de Accuracy no implica necesariamente un comportamiento igualmente uniforme entre todas las categorías.

Posteriormente, el problema fue ampliado de tres a cuatro clases y se adoptó XGBoost como modelo principal. La versión activa XGBoost v3 fue entrenada utilizando 23 sesiones, equivalentes a aproximadamente 6 horas y 18 minutos de conducción. Esta versión obtuvo un Accuracy baseline de 93.49 % y un F1-score baseline de 93.45 %. Bajo el criterio de evaluación estricto se obtuvo un Accuracy de 75.82 % y un F1-score de 60.76 %. Adicionalmente, las predicciones del modelo presentan una confianza promedio cercana al 83 %. Las métricas de esta versión no deben compararse directamente con los valores de la etapa inicial, ya que fueron obtenidas utilizando diferente cantidad de clases, distintas configuraciones del conjunto de datos y un procedimiento de evaluación actualizado.

La diferencia entre las métricas baseline y las obtenidas bajo un criterio más estricto constituye un resultado importante del proyecto. Presentar únicamente la cifra más alta habría proporcionado una visión incompleta del rendimiento. La evaluación estricta permite observar que el problema se vuelve considerablemente más exigente cuando se establecen condiciones destinadas a reducir la posibilidad de que información demasiado relacionada aparezca simultáneamente en entrenamiento y validación. Esto ayuda a representar de manera más realista la capacidad de generalización del modelo y demuestra por qué la evaluación de un sistema de aprendizaje automático no debe resumirse exclusivamente mediante una sola métrica.

DriveSense tampoco limita el resultado a una única clasificación para toda la sesión. Cada una de las ventanas procesadas conserva su propio resultado, lo que permite construir una línea de tiempo del comportamiento. Como ejemplo, una de las sesiones analizadas fue clasificada globalmente como pasiva con un 75.2 % de confianza. Sin embargo, al estudiar sus 80 ventanas, se observó que el comportamiento pasivo representó el 58.8 % del tiempo evaluado, mientras que el comportamiento distraído correspondió al 28.7 %, el normal al 10.0 % y el agresivo al 2.5 %. La clasificación global resume el patrón predominante, mientras que la línea temporal permite identificar los cambios que ocurrieron durante el recorrido.

Este nivel de detalle representa una de las características más útiles de la solución. Dos sesiones podrían terminar con la misma clasificación general y, aun así, haber llegado a ese resultado mediante patrones diferentes. Una puede mantener un comportamiento relativamente uniforme y otra alternar repetidamente entre distintas clases. Por esta razón, la plataforma presenta conjuntamente la clasificación global, la confianza, las métricas de conducción, la distribución de comportamientos, los eventos detectados y los intervalos temporales. El propósito es que el resultado pueda examinarse desde diferentes perspectivas y no interpretar al conductor únicamente a partir de una etiqueta aislada.

Evaluación de una sesión clasificada como pasiva con 75.2 % de confianza, métricas de conducción e interpretación del comportamiento
Figura 7. Clasificación general y nivel de confianza de la sesión evaluada.
Línea de tiempo de la sesión por ventanas, distribución de comportamientos y eventos bruscos detectados
Figura 8. Evolución temporal, distribución de comportamientos y eventos detectados durante la sesión.
Gráfico radar que compara las características de conducción de la sesión con los perfiles de referencia
Figura 9. Comparación de las características de conducción e interpretación de sus valores respecto a los perfiles de referencia.

Los datos reunidos también hicieron posible realizar comparaciones descriptivas entre diferentes grupos de la muestra. Para la comparación por género se analizaron 26 sesiones correspondientes a conductores masculinos y 12 sesiones correspondientes a conductores femeninos. Entre las sesiones femeninas, la conducción normal representó aproximadamente el 42 %, seguida de la pasiva con 25 %, mientras que agresiva y distraída representaron alrededor de 17 % cada una. Entre las sesiones masculinas, la categoría agresiva alcanzó aproximadamente 39 %, la normal 35 %, la pasiva 15 % y la distraída alrededor de 11 %. Estos valores describen solamente el comportamiento de las sesiones disponibles y no deben interpretarse como una afirmación general sobre hombres y mujeres.

En la comparación por edad, el grupo de 20 a 29 años concentró la mayor cantidad de observaciones, con 23 sesiones. En este rango, el 39.1 % fue clasificado como agresivo, el 34.8 % como normal, el 21.7 % como pasivo y el 4.3 % como distraído. Para el grupo de 30 a 39 años se analizaron cinco sesiones, con un 40 % normal, 40 % distraído y 20 % agresivo. En el rango de 40 a 49 años solo estuvieron disponibles dos sesiones, ambas clasificadas como normales. Finalmente, en el grupo de 50 años o más se analizaron ocho sesiones, distribuidas en proporciones de 25 % para cada una de las cuatro categorías. Las diferencias en el tamaño de cada grupo impiden utilizar estos resultados como representación de la población general; su valor dentro del proyecto es principalmente descriptivo y demuestra la capacidad del sistema para organizar este tipo de comparaciones.

Comparativa por género de la distribución de clases agresivo, normal, pasivo y distraído, con interpretación
Figura 10. Comparación de la distribución de comportamientos por género.
Comparativa por rango de edad de la distribución de clases y de las métricas de conducción, con interpretación
Figura 11. Comparación de la distribución de comportamientos por rango de edad.

Una base para seguir investigando la conducción

Los resultados obtenidos permiten concluir que es posible integrar un entorno de simulación, captura de telemetría, almacenamiento estructurado y aprendizaje automático dentro de un mismo sistema para analizar perfiles de conducción. DriveSense no se limita al modelo de clasificación, sino que incorpora el proceso completo que permite producir y conservar los datos utilizados por ese modelo. Desde la creación de una sesión hasta la presentación de sus resultados, cada etapa mantiene información que permite posteriormente revisar cómo se obtuvo una determinada clasificación. Esta trazabilidad es especialmente importante en un proyecto experimental, debido a que permite continuar incorporando datos sin perder las versiones y resultados producidos previamente.

Al mismo tiempo, los resultados deben interpretarse dentro de las condiciones bajo las cuales fueron obtenidos. Assetto Corsa permite capturar telemetría detallada y realizar pruebas controladas, pero no fue diseñado específicamente como una plataforma para reproducir absolutamente todas las situaciones presentes en el tránsito cotidiano. El comportamiento del tráfico, determinadas interacciones con otros vehículos, las condiciones ambientales y otros factores de la vía real dependen de las posibilidades ofrecidas por el simulador. A esto se agrega que el dataset fue construido específicamente para esta investigación y que las categorías agresivo, distraído, normal y pasivo responden a los criterios establecidos para las sesiones realizadas. Por tanto, el modelo aprende patrones correspondientes al contexto experimental de DriveSense.

Estas limitaciones también señalan directamente los próximos pasos del proyecto. La incorporación de nuevos participantes permitiría aumentar la diversidad del dataset y mejorar la cantidad de observaciones disponibles en cada grupo de edad y género. Nuevos escenarios aportarían una mayor variedad de situaciones de conducción. También sería posible continuar aumentando la automatización de la interacción con el simulador para disminuir la intervención necesaria durante el inicio y finalización de una sesión. Gracias al sistema de versionado incorporado, estas nuevas sesiones pueden utilizarse para producir modelos posteriores y comparar su rendimiento antes de decidir cuál versión debe mantenerse activa.

Finalmente, una de las líneas de trabajo más relevantes consiste en estudiar DriveSense utilizando otras fuentes de telemetría. La arquitectura no depende conceptualmente de una única categoría de simulador: si otra fuente puede proporcionar las variables requeridas, el proceso de captura puede adaptarse y posteriormente construir un nuevo dataset representativo de ese entorno. Una futura evaluación con vehículos reales permitiría investigar hasta qué punto los patrones identificados mediante simulación se mantienen fuera de Assetto Corsa y qué modificaciones serían necesarias para aplicaciones relacionadas con evaluación, capacitación o análisis de conductores. En este sentido, DriveSense representa no solamente el resultado de un proyecto académico, sino una base tecnológica y metodológica sobre la cual puede continuar desarrollándose investigación relacionada con el comportamiento al volante y la seguridad vial.

Referencias

  1. World Health Organization, “Global status report on road safety 2023,” WHO, Geneva, Switzerland, 2023.
  2. National Highway Traffic Safety Administration, “Traffic Safety Facts Annual Report 2022,” U.S. Department of Transportation, 2023.
  3. A. Bella and A. Calvi, “Effects of simulator training on driver speed behavior in curves,” Accident Analysis & Prevention, vol. 43, no. 3, pp. 1166–1172, 2011.
  4. S. T. Godley, T. J. Triggs, and B. N. Fildes, “Driving simulator validation for speed research,” Accident Analysis & Prevention, vol. 34, no. 5, pp. 589–600, 2002.
  5. A. Calvi, “A study on driving performance along horizontal curves using a driving simulator,” Journal of Transportation Safety & Security, vol. 7, no. 3, pp. 243–257, 2015.
  6. Y. Zhang, X. Wang, and L. Li, “Driving behavior recognition based on vehicle telemetry data,” Sensors, vol. 21, no. 4, pp. 1–18, 2021.
  7. P. Sun, J. Hu, and Y. Zhang, “Real-time driving risk evaluation based on vehicle dynamics,” IEEE Transactions on Intelligent Transportation Systems, vol. 23, no. 6, pp. 5678–5689, 2022.
  8. M. Taamneh et al., “Detection of driver stress in real-world driving environments,” IEEE Transactions on Intelligent Transportation Systems, vol. 21, no. 12, pp. 5007–5017, 2020.
  9. J. Ferreira, J. Carvalho, and J. Fonseca, “Driver behavior profiling: An investigation with machine learning,” Expert Systems with Applications, vol. 123, pp. 1–12, 2019.
  10. L. Breiman, “Random forests,” Machine Learning, vol. 45, no. 1, pp. 5–32, 2001.
  11. M. Saeedmanesh and N. Geroliminis, “Dynamic clustering and classification of driving behavior,” Transportation Research Part C, vol. 102, pp. 195–214, 2019.
  12. S. Wang, C. Li, and R. Fu, “Driver behavior recognition using vehicle data and machine learning,” IEEE Sensors Journal, vol. 20, no. 10, pp. 5674–5683, 2020.
  13. Y. Li, Z. Chen, and H. Zhang, “Driver behavior classification using deep learning and vehicle telemetry data,” IEEE Access, vol. 10, pp. 112345–112357, 2022.
  14. J. Kim and S. Lee, “Real-time driver risk assessment using machine learning and vehicle dynamics,” Sensors, vol. 23, no. 2, pp. 1–15, 2023.
  15. R. Gupta, A. Sharma, and P. Singh, “Driving style analysis using telematics data and ensemble learning methods,” Expert Systems with Applications, vol. 213, 2023.
  16. T. Nguyen and M. Arif, “A survey on driver behavior analysis using machine learning techniques,” IEEE Access, vol. 11, pp. 45678–45700, 2023.
  17. L. Zhao et al., “Explainable AI for driver behavior profiling using SHAP and ensemble models,” IEEE Transactions on Intelligent Transportation Systems, 2024.
  18. H. Eren et al., “Estimating driving behavior by a smartphone,” in Proc. IEEE Intelligent Vehicles Symposium, 2012.
  19. T. Chen and C. Guestrin, “XGBoost: A scalable tree boosting system,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 785–794, 2016.
  20. S. M. Lundberg and S.-I. Lee, “A unified approach to interpreting model predictions,” in Advances in Neural Information Processing Systems, vol. 30, 2017.

AgroSat IoT: Integración de Sensores y Teledetección para la Agricultura 4.0 en República Dominicana

Carlos García Núñez y Dariel Alexander Vargas Francisco – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

La agricultura constituye uno de los ejes fundamentales para el desarrollo económico y la seguridad alimentaria a nivel global. En la República Dominicana, el sector agrícola se destaca por su gran capacidad exportadora, siendo el cultivo de banano (Musa paradisiaca) un pilar estratégico que representa aproximadamente el 30% de las exportaciones agropecuarias del país [1]. Estas cifras consolidan al banano como un generador indispensable de divisas, con una presencia notable en mercados internacionales de alta exigencia, como la Unión Europea y el Reino Unido. Gran parte de esta competitividad se basa en la producción orgánica, una modalidad que añade un enorme valor comercial al producto dominicano, pero que simultáneamente impone restricciones severas en el uso de insumos químicos para el manejo fitosanitario de las plantaciones.

Esta restricción en el manejo sintético subraya una vulnerabilidad crítica: la exposición de los cultivos a amenazas bióticas y abióticas fluctuantes. Ante esta realidad, surge la necesidad apremiante de modernizar los métodos de supervisión en campo, transitando desde modelos reactivos hacia la adopción de la denominada Agricultura 4.0 [2]. Esta transición implica la incorporación de tecnologías de monitoreo continuo que aporten una capa de inteligencia basada en datos concretos y localizados, lo que permite la anticipación de escenarios de estrés en el cultivo, garantizando así la sostenibilidad y el rendimiento de las fincas agrícolas.

En este contexto de innovación tecnológica, estudiantes de la Facultad de Ciencia de la Ingeniería, pertenecientes al Departamento de Ingeniería Telemática y Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), han desarrollado una iniciativa pionera. Bajo el liderazgo de Carlos García Núñez y Dariel Vargas, y con la asesoría del Ing. Jorge Alejandro Luna Martínez, nace el proyecto AgroSat IoT. Esta propuesta fusiona el potencial de las redes de telemetría de largo alcance con el análisis de imágenes satelitales, creando un entorno de supervisión integral que redefine la toma de decisiones en el ámbito agrario.

La motivación principal detrás de AgroSat IoT radica en empoderar a los productores bananeros con herramientas tecnológicas accesibles y de alta precisión. A través de la recolección de datos microclimáticos in situ y la superposición de metadatos macroespaciales, la solución no solo aspira a diagnosticar problemas de forma oportuna, sino a establecer una metodología replicable que promueva el uso eficiente de recursos hídricos y nutricionales, salvaguardando así el liderazgo de la producción orgánica nacional.

Problemática y estado del arte

A pesar de su evidente relevancia económica, la cadena de producción del banano enfrenta desafíos de naturaleza sistémica y fisiológica, especialmente pronunciados en la etapa de poscosecha. Entre las amenazas más destructivas destaca la pudrición de la corona, una patología fúngica asociada a microorganismos como Fusarium spp. y Colletotrichum musae [3].

Esta enfermedad suele desarrollarse de manera latente en el campo, manifestándose únicamente durante el proceso de empaque o transporte, lo que resulta en rechazos masivos de lotes en el mercado internacional y pérdidas económicas devastadoras. En el entorno de la producción orgánica, donde los fungicidas de síntesis química están estrictamente prohibidos, la gestión de esta enfermedad depende casi por completo de un control preventivo fundamentado en la excelente salud fisiológica de la planta desde su fase de desarrollo temprano.

Paralelamente, el banano es una especie botánica con una elevada demanda hídrica, lo que lo vuelve excepcionalmente sensible a las fluctuaciones en la humedad del suelo [4]. Un déficit hídrico sostenido provoca el cierre de los estomas, reduciendo drásticamente las tasas fotosintéticas y afectando el llenado del fruto. Por otro lado, un escenario de anegamiento promueve la hipoxia radicular y crea un microclima ideal para la proliferación de fitopatógenos del suelo. Esta delicada ventana de homeostasis hídrica exige un escrutinio meticuloso, el cual es inalcanzable utilizando únicamente métodos empíricos de observación visual.

Actualmente, el principal agravante de esta problemática en la región es la dependencia histórica de la gestión agraria tradicional. Las anomalías nutricionales y el estrés hídrico ocurren de forma silenciosa, y para el momento en que los síntomas se vuelven visibles en el follaje o en el racimo, el daño celular y la merma en la productividad ya son irreversibles. Los productores carecen de medios tecnológicos continuos para monitorear el subsuelo en tiempo real, favoreciendo así un ciclo crónico de ineficiencia donde los recursos como el agua y los biofertilizantes se aplican a ciegas, basándose en calendarios estáticos en lugar de necesidades fisiológicas reales.

En el estado del arte internacional, se han propuesto diversas aproximaciones para mitigar este desfase informativo. Huamán Correa (2023) introdujo un sistema de monitoreo en Perú orientado a la correlación de datos ambientales para la predicción de plagas en bananeras, subrayando la utilidad de la telemetría en tiempo real [5]. De manera similar, Rincón Vargas y Vargas Romero (2023) desarrollaron un prototipo de medición localizada de temperatura y humedad edáfica, demostrando que la vigilancia constante optimiza notablemente las estrategias de riego [6].

Por otra parte, desde la perspectiva de la teledetección macroscópica, Castillo Idrovo (2021) validó la viabilidad del uso de constelaciones satelitales para analizar el vigor vegetal mediante índices espectrales, lo que permite localizar zonas de bajo rendimiento en extensiones vastas que serían inviables de inspeccionar a pie [7]. Estas investigaciones ratifican que tanto el enfoque micro (sensores de campo) como el enfoque macro (satélites) poseen un valor innegable para la gestión agrícola moderna.

Sin embargo, a pesar de los avances documentados, las soluciones actuales presentan una fragmentación operativa. Los agricultores dominicanos no cuentan con plataformas unificadas que correlacionen de manera fluida y nativa los datos químicos del sustrato (como el pH, la conductividad eléctrica y los niveles de macronutrientes NPK) con la perspectiva radiométrica satelital a gran escala. Esta desconexión impide un diagnóstico agronómico verdaderamente holístico, limitando la adopción de una agricultura de precisión adaptada a la topografía y climatología específicas de los valles productivos de la República Dominicana.

Objetivos completados

El desarrollo de este proyecto ha implementado un sistema de diagnóstico agrícola integral y en tiempo real para cultivos de banano, estructurado sobre una arquitectura híbrida que combina el despliegue de redes de sensores IoT (LoRa) de bajo consumo para la captura in situ de variables edáficas (humedad, pH, NPK, conductividad eléctrica) y el procesamiento automatizado de imágenes satelitales (Sentinel-2) para la extracción de índices espectrales (NDVI, NDWI). El sistema proporciona una plataforma web centralizada capaz de correlacionar estos datos, generando reportes analíticos y alertas tempranas, lo que garantiza a los productores una herramienta de apoyo crítico para optimizar el uso de recursos, anticipar escenarios de estrés hídrico o nutricional, y mejorar sustancialmente el manejo preventivo de enfermedades en la producción bananera.

Metodología

Para materializar esta solución integral, se implementó una metodología de desarrollo concurrente, dividiendo el trabajo en subsistemas aislados pero altamente interdependientes: adquisición de hardware, procesamiento geoespacial y desarrollo de la arquitectura backend/frontend. El diseño de este ecosistema tecnológico se enfocó en garantizar estabilidad en entornos remotos, escalabilidad de la red de telemetría y una presentación de la información que fuera inmediatamente procesable por el usuario final, todo ello apoyado en protocolos de transmisión de bajo consumo energético.

Diagrama de bloques del flujo desde las variables del cultivo y los sensores hasta el módulo LoRa y el gateway
Figura 1. Diagrama esquemático del flujo de telemetría desde los nodos en campo hasta el panel de visualización en la nube.

Adquisición de datos a través de nodos IoT en el borde

El núcleo de la recolección de campo se basó en el diseño de estaciones de monitoreo equipadas con microcontroladores ESP32 que integran módulos transceptores LoRa V3 (SX1262 a 915 MHz). Esta selección de hardware obedece a las estrictas demandas topológicas de las áreas de cultivo, donde la conectividad celular (GSM/LTE) suele ser inestable y el consumo energético debe ser minimizado para permitir la operación autónoma. Cada nodo fue dotado de un conjunto robusto de sensores diseñados para medir variables críticas: humedad del suelo (mediante sensores capacitivos resistentes a la oxidación), temperatura y humedad relativa (BME280), radiación solar, así como electrodos especializados para la medición continua de pH, conductividad eléctrica y concentración de macronutrientes (Nitrógeno, Fósforo y Potasio).

La lógica embebida en estos nodos se encarga del acondicionamiento de las señales analógicas, su conversión digital y el empaquetado estructurado de las tramas de datos. Esta telemetría es enviada periódicamente a través de enlaces de radiofrecuencia de largo alcance hacia un Gateway centralizador, el cual actúa como puente (bridge) utilizando el protocolo MQTT para derivar la información de forma segura hacia los servidores en la nube. Este esquema asegura una alta tolerancia a fallos y permite la expansión futura de la red mediante la adición de nuevos nodos sin saturar el espectro de comunicación.

Diagrama del módulo: sensores de temperatura y humedad, NPK, humedad de suelo, luz solar, conductividad eléctrica y pH conectados al módulo LoRa
Figura 2. Diagrama de bloques del nodo IoT: sensores conectados al módulo LoRa para la transmisión de telemetría.

Análisis satelital automatizado con Google Earth Engine

Para superar las limitaciones de la observación estrictamente puntual, la metodología incorporó un motor de procesamiento de imágenes satelitales fundamentado en la plataforma Google Earth Engine (GEE). A través de scripts automatizados en Python, el sistema consulta periódicamente el catálogo Harmonized de la misión Copernicus Sentinel-2 de la Agencia Espacial Europea. Este proceso incluye un filtrado algorítmico riguroso para discriminar la cobertura nubosa, un fenómeno meteorológico muy frecuente en las zonas tropicales, garantizando que los análisis radiométricos se realicen únicamente sobre píxeles de alta pureza visual.

Topología de red: módulos Norte y Sur conectados al gateway LoRa, al servidor y base de datos, y a la aplicación web
Figura 3. Arquitectura centralizada de la topología de red, ilustrando la convergencia de datos desde el borde hacia el servidor central.

El núcleo analítico de esta sección calcula dos métricas fundamentales: el Índice de Vegetación de Diferencia Normalizada (NDVI) para cuantificar la actividad fotosintética y el vigor de la biomasa, y el Índice de Agua de Diferencia Normalizada (NDWI), el cual revela el estado del dosel foliar respecto a su contenido hídrico.

El sistema no solo extrae estos valores promedios para los polígonos correspondientes a la finca, sino que aplica una lógica de clasificación basada en umbrales (ej. NDVI ≥ 0.6 clasificado como ‘Saludable’), traduciendo metadatos crudos en evaluaciones comprensibles para el manejo agronómico.

Los resultados son inyectados al servidor mediante APIs REST, evitando el almacenamiento local pesado de archivos de imagen (rasters).

Arquitectura backend y plataforma web interactiva

La gestión integral de la información se orquestó sobre una arquitectura de software empresarial multicapa utilizando Java 17 y el ecosistema Spring Boot. Este backend MVC gestiona la persistencia de datos relacionales en MariaDB, estructurando historiales complejos de mediciones, configuración de sensores y registros de eventos. Para asegurar que la latencia entre un evento de campo y la notificación al productor fuera mínima, se implementaron túneles bidireccionales mediante WebSockets, dotando al frontend de capacidades reactivas sin la necesidad de recargar el navegador [8].

Dashboard web de monitoreo con las lecturas de las estaciones Norte y Sur: temperatura, humedad, luz, pH, conductividad y NPK
Figura 4. Dashboard interactivo de la plataforma web, presentando indicadores consolidados de sensores y alertas del sistema.

El diseño de la interfaz de usuario se realizó bajo principios de usabilidad orientados a perfiles no técnicos. El entorno web permite la administración de estaciones, la generación de reportes en PDF, el seguimiento de labores mediante un calendario agrícola interactivo, y de manera crucial, la configuración de un motor de alertas lógicas. Este motor evalúa cada paquete de datos entrante contra umbrales personalizados; si, por ejemplo, la tensión matricial del suelo indica deshidratación, el sistema detona una notificación inmediata y altera los indicadores visuales en el panel principal.

Resultados

La validación de AgroSat IoT en un entorno controlado arrojó resultados altamente satisfactorios, confirmando la resiliencia de la arquitectura técnica y la viabilidad de la propuesta para su posterior escalado comercial. En términos de conectividad en el nivel físico, los nodos basados en el transceptor SX1262 demostraron una confiabilidad sobresaliente en la propagación de señales a través de obstáculos típicos del cultivo bananero. La tasa de éxito en la entrega de paquetes de datos (Packet Delivery Ratio) hacia el gateway superó el 95% bajo condiciones de línea de vista parcial, demostrando que la tecnología LoRaWAN es perfectamente adecuada para superar la densidad foliar que caracteriza a este tipo de plantaciones.

A nivel de software, el backend en Spring Boot procesó eficientemente los flujos de telemetría entrantes, registrando y estructurando correctamente las variables en la base de datos MariaDB. Esto permitió la generación de historiales densos y consistentes. La interfaz de usuario respondió de manera fluida a las actualizaciones impulsadas por WebSockets; durante las pruebas, cualquier fluctuación anómala provocada deliberadamente en el entorno de los sensores se reflejó en el panel de control web en un tiempo inferior a los 3 segundos, validando la naturaleza ‘en tiempo real’ de la solución.

Google Earth Engine mostrando el mapa NDVI del área de estudio y los valores promedio de NDVI y NDWI en la consola
Figura 5. Análisis de NDVI y NDWI con Sentinel-2 en Google Earth Engine sobre el área de estudio.

El subsistema de teledetección probó ser un complemento excepcional. El script de automatización en Python interactuó exitosamente con la API de Google Earth Engine, mitigando el ruido causado por la cobertura de nubes y extrayendo los índices NDVI y NDWI con precisión espacial. La correlación observada entre una caída del índice NDWI satelital y la disminución de la capacitancia reportada por los sensores de humedad del suelo corroboró la robustez de combinar enfoques macro y micro para la toma de decisiones, brindando un mapa de calor virtual de las zonas de estrés en la finca.

Finalmente, el motor de alertas evidenció su eficacia operativa. Al exceder los límites predefinidos de salinidad (conductividad eléctrica) o de temperatura crítica, el sistema generó correctamente las advertencias visuales y registró las entradas en el historial de auditoría. Adicionalmente, el mecanismo de comprobación de estado (heartbeat) de los nodos fue validado exitosamente: al desconectar la alimentación de un módulo, la plataforma detectó la caída del enlace en el margen de tiempo estipulado y notificó al usuario la inactividad de la estación, lo cual es vital para el mantenimiento de la red.

Conclusión

La culminación de este proyecto marca un hito significativo en la modernización de la gestión agrícola en la República Dominicana. AgroSat IoT demuestra de manera concluyente que la barrera de entrada para la Agricultura 4.0 puede ser superada mediante el diseño ingenieril inteligente. Al integrar exitosamente arquitecturas de microcontroladores de bajo costo, protocolos inalámbricos de amplia cobertura como LoRa, y plataformas de análisis satelital de acceso abierto, se ha logrado materializar una herramienta de diagnóstico agronómico de primer nivel, capaz de sustituir la intuición empírica por certezas científicas basadas en telemetría continua y espacial.

El impacto a largo plazo de este desarrollo no se limita únicamente a la prevención de patógenos como la pudrición de la corona o a la mitigación del estrés hídrico; radica en la habilitación de una trazabilidad química e hídrica profunda, la cual es la piedra angular para maximizar el rendimiento en nichos de alto valor como lo es la producción de banano orgánico de exportación. Las lecciones aprendidas durante la fase de despliegue reafirman que la infraestructura tecnológica debe ser tan resistente como las plantas que monitorea, y que las interfaces de software deben decodificar la complejidad de los datos en directrices accionables y simples para el productor.

Como próximos pasos, se vislumbra la evolución de esta plataforma hacia esquemas predictivos más agresivos. La inmensa cantidad de datos recabados sienta las bases ideales para la futura implementación de modelos de aprendizaje automático (Machine Learning), los cuales podrán predecir curvas de degradación del suelo o brotes epidemiológicos días antes de que ocurran. Es el momento de que el sector agroindustrial, la academia y el Estado unan fuerzas para escalar estos prototipos hacia mallas de sensores a nivel nacional, transformando definitivamente el paisaje agrícola hacia una matriz de producción resiliente, tecnificada e hiperconectada.

Referencias

  1. Ministerio de Economía, Planificación y Desarrollo (MEPYD), “Ministerio de Economía pondera importancia del sector bananero y oportunidades para su revitalización,” Oct. 19, 2023.
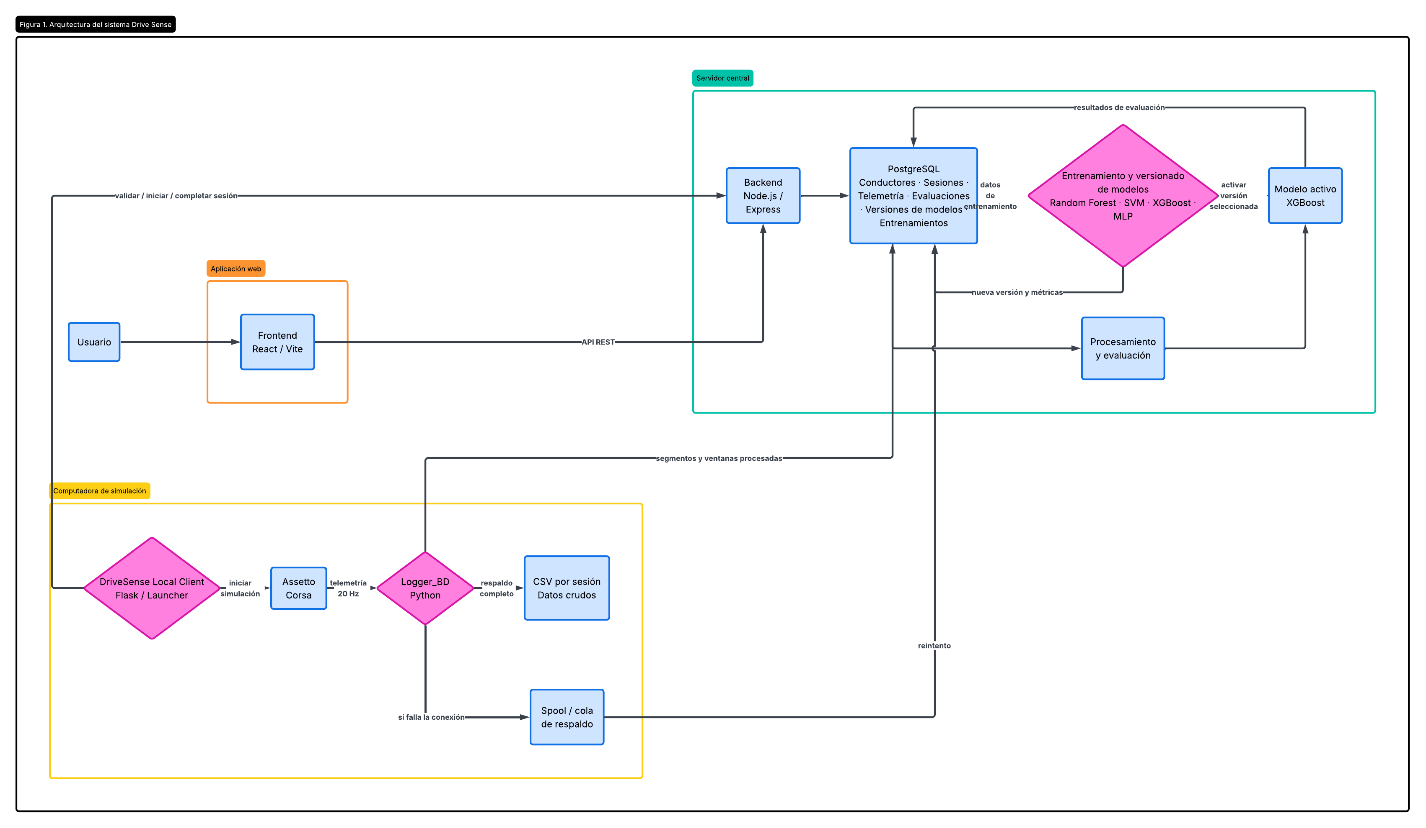
  2. J. Tovar-Quiroz, “Agricultura 4.0: uso de tecnologías de precisión y aplicación para pequeños productores,” Informador Técnico, vol. 87, no. 1, 2023.
  3. D. Toribio-Flórez, F. Carreel, C. Jenny, y J. Carlier, “Crown rot disease in bananas: A review of current knowledge,” Postharvest Biology and Technology, vol. 116, pp. 34–40, 2016.
  4. Y. Barrera-Pardo et al., “Respuesta fisiológica al estrés hídrico de plantas de banano cv. ‘Pineo gigante’ (Musa AAA),” Biotecnología Vegetal, vol. 14, no. 3, pp. 155-162, 2014.
  5. J. A. Huamán Correa, Sistema IoT para el monitoreo climático y detección temprana de plagas en cultivos de banano mediante inteligencia artificial en la región de Piura, Tesis de Maestría, Universidad de Piura, Perú, 2023.
  6. M. F. Rincón Vargas y C. J. Vargas Romero, Diseño e implementación de un prototipo de sistema de monitoreo de temperatura y humedad del suelo en cultivos de banano. Bogotá, Colombia: UNAD, 2023.
  7. J. P. Castillo Idrovo, Aplicación de índices de vegetación NDVI a partir de imágenes Sentinel-2 para el monitoreo de cultivos de banano. Cuenca, Ecuador: Universidad de Cuenca, 2021.
  8. A. Augustin, J. Yi, T. Clausen, y W. M. Townsley, “A Study of LoRa: Long Range & Low Power Networks for the Internet of Things,” Sensors, vol. 16, no. 9, p. 1466, 2016.

AURORA SDR: cómo dos estudiantes de la PUCMM construyeron un radiotelescopio con una lata de salsa y equipo reciclado

Ismael Ricardo Ortega Almonte y Fernando José Espinal Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

En Santiago de los Caballeros, en la Escuela de Ingeniería en Computación y Telecomunicaciones de la PUCMM, dos estudiantes de Ingeniería Telemática se propusieron construir algo que casi no existe en el país: un radiotelescopio que funcione de verdad. El proyecto se llama AURORA SDR. Lo hicieron Ismael Ricardo Ortega Almonte y Fernando José Espinal Rodríguez, con la profesora Arlene Estévez como asesora. La meta: captar, procesar y mostrar en tiempo real señales de radio que vienen del espacio, específicamente la línea de emisión del hidrógeno neutro a 1420 MHz [1].

En las universidades dominicanas casi no hay forma de trabajar con radiofrecuencia real conectada a algo astronómico. Los laboratorios se quedan en simulaciones o en equipos de frecuencias bajas, y ahí se acaba la cosa. Un radiotelescopio educativo comercial arranca en 19,450 dólares. Uno profesional pasa fácilmente de los 100,000 [2]. Con esos precios, y sin infraestructura dedicada en ninguna universidad del país, a los estudiantes no les queda otra que aprender la teoría sin tocar nunca el equipo real.

El equipo no empezó de cero, eso ayudó bastante. Ya tenían acceso a un transceptor bladeRF 2.0 micro xA9 y una Raspberry Pi 4 en los laboratorios de la PUCMM. A eso le agregaron una antena parabólica reciclada, de esas que las compañías de televisión satelital retiran cuando un cliente cancela el servicio, y un alimentador (feedhorn) que armaron a mano con una lata de acero galvanizado. Meses de pruebas y ajustes después, el sistema logró detectar la señal del hidrógeno galáctico de forma repetible, algo que hasta ese momento nadie había documentado con este nivel de detalle en un proyecto académico del país.

La línea de hidrógeno neutro no se escogió al azar. Ocurre cuando el electrón de un átomo de hidrógeno invierte su espín y suelta un fotón con una longitud de onda de 21 centímetros. El hidrógeno es el elemento más abundante del universo, así que esta señal funciona casi como un mapa: con ella se ha trazado la forma espiral de la Vía Láctea, se ha calculado su curva de rotación, y se ha encontrado evidencia sobre la materia oscura [3].

De eso trata este artículo: del problema que empujó a Ismael y Fernando a meterse en esto, de lo que ya se había hecho antes en otros países, de cómo fueron armando cada pieza del sistema, y de lo que encontraron al apuntar, finalmente, su antena artesanal hacia el centro de la Vía Láctea.

Problemática y estado del arte

Escuchar el espacio sin gastar una fortuna

Las señales que llegan del espacio son débiles, muy débiles. Y cualquier ciudad moderna está llena de ruido electromagnético que las tapa. El campus de la PUCMM no es la excepción: ahí conviven señales de telefonía celular, redes Wi-Fi y transmisiones de FM que caen cerca de la frecuencia astronómica que interesa. Sin algo que filtre ese ruido, un estudiante dominicano no tiene forma real de observar el cosmos [4].

Para tener una idea del tamaño del problema: la señal de hidrógeno que Aurora buscaba llega a la Tierra con apenas -145 dBm, miles de veces más débil que cualquier señal de comunicación normal. Cualquier ruido cercano, sea térmico, industrial o de otra transmisión de radiofrecuencia, la puede sepultar si no se filtra bien [1]. En un campus rodeado de antenas celulares, routers Wi-Fi y transmisores de FM, eso pesa más que en un observatorio profesional, que de entrada se construye lejos de cualquier ciudad.

Un ingeniero de telecomunicaciones puede pasar la carrera entera estudiando cómo se propaga una onda de radio, cómo se diseña un amplificador de bajo ruido o cómo funciona la transformada rápida de Fourier. Y graduarse sin haber capturado jamás una señal que venga de fuera de la atmósfera terrestre [5]. Ese es el hueco que Aurora quiso llenar.

La respuesta del equipo fue construir un radiotelescopio barato y fácil de operar. Uno que capturara señales astronómicas reales, las procesara para sacar su contenido espectral, y mostrara los resultados en una página web accesible desde cualquier dispositivo conectado a la red de la universidad. La meta no era solo probar que se podía hacer una vez. Era dejar un instrumento instalado, funcionando, para las próximas generaciones de estudiantes.

Lo que otros ya habían intentado

El equipo no partió en un vacío total de conocimiento previo. A nivel internacional existen varios antecedentes de radiotelescopios de bajo costo basados en Radio Definida por Software (SDR) que sirvieron como referencia directa. Phelps (2024) documentó la construcción de un radiotelescopio para la línea de hidrógeno usando un dongle RTL-SDR, de apenas unos 20 dólares, junto a una antena parabólica económica, y logró detectar la emisión galáctica con un presupuesto total inferior a 300 USD [6]. Es un antecedente valioso, pero limitado: el conversor analógico-digital de 8 bits del RTL-SDR reduce considerablemente el rango dinámico del sistema, lo que dificulta distinguir señales débiles cuando hay interferencias fuertes cerca.

Otros proyectos apuntaron a mayor escala y precisión. Almutairi et al. (2025) presentaron el diseño optimizado de un radiotelescopio de 5 metros de diámetro, que también trabaja en la banda de 1.4 GHz, con especial atención a la relación ganancia-temperatura del sistema (G/T), una métrica que determina qué tan bien un receptor distingue la señal deseada del ruido térmico propio [7]. De Silva et al. (2024), por su parte, implementaron una arquitectura SDR más avanzada, con calibración espectral y corrección Doppler realizada completamente en software, lo que eliminó la necesidad de osciladores locales analógicos costosos [8].

También existen iniciativas centradas en la simplicidad educativa más que en la precisión radiométrica. El Canadian Centre for Experimental Radio Astronomy (CCERA) propone diseños específicos para la banda de 21 centímetros que reutilizan platos satelitales de televisión ya dados de baja, un enfoque que resultó directamente inspirador para Aurora [2]. Y Campbell-Wilson et al. (2025) construyeron un radiotelescopio de 2.4 metros que también reutiliza un plato satelital, y lograron incluso detectar púlsares con un desembolso inferior a 200 USD [9].

Vale la pena recordar, además, que la radioastronomía como disciplina nació prácticamente por accidente: en 1931, el ingeniero Karl Jansky detectó por primera vez radiación de origen cósmico mientras investigaba interferencias en comunicaciones de radio para los Laboratorios Bell, y descubrió, sin buscarlo, que el centro de la Vía Láctea emitía en frecuencias de radio [10]. Casi un siglo después, la posibilidad de repetir observaciones de ese tipo, aunque a una escala infinitamente más modesta, ya no depende de instalaciones estatales multimillonarias, sino de una combinación accesible de hardware SDR, procesamiento digital y software libre. Ese es, más o menos, el terreno donde se mueve el proyecto Aurora.

Lo que el equipo de Aurora notó al revisar estos antecedentes es que, aunque casi todos lograban la detección básica de la señal, ninguno integraba una arquitectura de transmisión telemática en tiempo real. La mayoría opera en modo de «grabación local», donde los datos se guardan en un archivo y se analizan después, sin visualización remota ni acceso simultáneo de múltiples usuarios. Aurora buscó cerrar esa brecha al incorporar protocolos como ZeroMQ y WebSocket para desacoplar la adquisición de la visualización, lo que permite que varios estudiantes puedan observar el mismo espectro en tiempo real desde sus propios dispositivos, algo poco común en implementaciones de bajo costo [11]. Esa combinación de hardware reciclado, procesamiento digital adaptativo para entornos urbanos con alta interferencia, y una capa de conectividad tipo Internet de las Cosas, es lo que el equipo identifica como el aporte diferencial de su proyecto frente a la literatura existente.

Objetivos completados

El equipo desarrolló un dispositivo de captación radioastronómica basado en tecnología SDR

El objetivo era capturar, procesar digitalmente y visualizar en tiempo casi real señales astronómicas reales en la banda de 1420 MHz. Con eso se buscaba resolver la falta de plataformas prácticas de radiofrecuencia en la formación universitaria dominicana. Ese objetivo general se dividió en seis objetivos específicos, cada uno pensado como una meta concreta y medible por sí sola: Implementar una cadena de adquisición RF estable en la banda de interés. Desarrollar el procesamiento digital de señales mediante FFT. Diseñar un sistema de transmisión de datos en tiempo casi real hacia un servidor. Construir una interfaz gráfica web accesible de forma remota. Integrar almacenamiento y generación de reportes automáticos. Y validar todo el sistema con pruebas experimentales que midieran su estabilidad y la calidad de los datos en un entorno urbano con alta interferencia radioeléctrica.

Metodología

De una lata de salsa a un radiotelescopio

La arquitectura de Aurora tiene cuatro etapas, y entre todas se encargan de que la señal llegue intacta desde su origen cósmico hasta la pantalla. La primera es la captación. Ahí es donde el proyecto se ve más artesanal: en vez de comprar un alimentador de antena (feedhorn) comercial, el equipo construyó el suyo con una lata de acero galvanizado, sin pintura por dentro. Las dimensiones no salieron al azar. El cilindro se cortó con un diámetro interior de 15 centímetros, lo que sitúa la frecuencia de corte del modo de propagación fundamental cerca de 1.84 GHz, y una longitud total de 18 centímetros, dentro del rango que se recomienda para que las ondas se estabilicen antes de llegar al punto de captura. Dentro del cilindro, a 5.2 centímetros del fondo cerrado (una distancia que corresponde a un cuarto de la longitud de onda guiada), soldaron una sonda de cobre sólido que convierte la onda electromagnética capturada en una señal eléctrica utilizable.

Lata metálica con un conector SMA en su costado, usada como feedhorn artesanal
Figura 1. El feedhorn artesanal, construido con una lata de acero galvanizado sin pintura interior, con la sonda de cobre soldada al conector SMA.

Ese feedhorn artesanal se acopló al punto focal de una antena parabólica comercial reutilizada, del tipo que instalan compañías de televisión satelital como Altice o Claro. Justo después del feedhorn, la señal, todavía muy débil, pasa por un amplificador de bajo ruido: un Nooelec SAWbird+ H1. Este da una ganancia de entre 40 y 45 dB, con una figura de ruido de apenas 0.6 a 0.8 dB en la banda de interés. Y hace doble trabajo: amplifica la señal sin sumarle mucho ruido propio, y de paso filtra buena parte de la interferencia urbana común (redes 4G, Wi-Fi de 2.4 GHz, señales de FM), gracias a un filtro SAW integrado centrado entre 1.35 y 1.50 GHz.

Antena parabólica sobre un marco de madera con el feedhorn de lata en el foco
Figura 2. Prototipo integrado: parábola, feedhorn y amplificador de bajo ruido (LNA) montados como una sola unidad de observación.

De ahí, la señal viaja por un cable coaxial de baja pérdida hasta el bladeRF 2.0 micro xA9, un transceptor de radio definida por software que hace el trabajo pesado del sistema. Este convierte la señal analógica en muestras digitales complejas (I/Q) mediante un convertidor analógico-digital de 12 bits, lo que da un rango dinámico teórico cercano a 74 dB. Es suficiente para trabajar con señales astronómicas que están muy por debajo del ruido térmico ambiental. El bladeRF, eso sí, no entrega corriente por su puerto de radiofrecuencia. Por eso el equipo integró un inyector Bias-T en la línea coaxial, para alimentar el LNA sin necesitar una fuente externa adicional en la azotea.

El cerebro digital detrás de la antena

Todo este flujo de datos converge en una Raspberry Pi 4. Aquí no funciona como una computadora de escritorio, sino como un controlador embebido dedicado: gestiona la cadena de radiofrecuencia y mantiene el enlace con el servidor remoto [12]. Está conectada al bladeRF por USB 3.0, un puerto necesario porque el volumen de datos entre ambos dispositivos supera los 320 Mbps cuando se trabaja a una tasa de muestreo de 10 megamuestras por segundo con 16 bits de profundidad [13]. Sobre esa placa corre GNU Radio, el software que arma visualmente todo el pipeline de procesamiento: desde la fuente de muestras hasta el cálculo de la transformada rápida de Fourier (FFT), pasando por bloques de integración temporal que promedian cientos de capturas para reducir el ruido aleatorio y dejar visible la señal astronómica, que es miles de veces más débil que el piso de ruido del propio receptor [14].

El pipeline de procesamiento cambió bastante durante el desarrollo. La primera versión usaba un esquema de retardo y suma (delay-and-sum), sin ningún mecanismo de calibración de temperatura del sistema ni referencia de tiempo estable. Eso hacía que la línea base del espectro se moviera de forma errática entre una sesión y otra, según la ganancia y la temperatura ambiental del receptor en cada momento. Esa inestabilidad, sumada a horarios de prueba limitados, interrupciones por lluvia y bastante ruido de fondo confundible con la señal buscada, llevó al equipo a rediseñar el esquema por completo.

El modelo final se bautizó internamente como spectrometer_w_cal. Incorporó un oscilador de referencia GPSDO para estabilizar la frecuencia, subió la tasa de muestreo de 4 a 10 megamuestras por segundo, y agregó un bloque de calibración de temperatura de sistema que permite alternar entre una vista sin filtrar, una vista calibrada, y modos de referencia caliente (hot) y fría (cold) para contrastar el ruido del propio instrumento contra el del cielo. También sumaron un promedio móvil configurable y salidas más completas: exportación a CSV, generación automática de imágenes del espectro, y una interfaz gráfica propia bautizada AURORA_SDR, con pestañas separadas para el espectro y para el monitoreo de temperatura del sistema y ganancia.

Del lado del software de transmisión, el sistema quedó organizado en cuatro capas desacopladas. GNU Radio controla el bladeRF, calcula la FFT de 4096 puntos y publica los vectores de potencia resultantes mediante ZeroMQ, un protocolo de mensajería liviano que no necesita un intermediario (broker) central, a diferencia de opciones como MQTT [15]. Un script puente en Python recibe esos datos y los reenvía a un servidor backend construido en Spring Boot mediante WebSocket, que mantiene una conexión persistente y de baja latencia con los clientes conectados [16]. Ese backend distribuye la información a todos los navegadores conectados y guarda instantáneas periódicas. Mientras tanto, en el navegador, una interfaz construida con Chart.js actualiza en vivo tanto el espectro como una gráfica tipo cascada (waterfall) que muestra la evolución temporal de la señal. Todo el recorrido, desde que la antena capta la onda hasta que aparece en pantalla, se completa en menos de 500 milisegundos, lo que da una experiencia de observación prácticamente en tiempo real [16].

Diseñar esta capa de comunicación no fue trivial. Transmitir las muestras crudas I/Q capturadas por el bladeRF directamente por la red hubiera sido inviable: a una tasa de muestreo de 6 megamuestras por segundo con resolución compleja de 16 bits, ese flujo bruto llega a cerca de 192 Mbps, suficiente para saturar cualquier red Wi-Fi convencional del campus. Por eso el procesamiento se hace en el borde (edge computing): la Raspberry Pi calcula la densidad espectral de potencia localmente y solo transmite el vector ya reducido. Para una FFT de 2048 puntos enviada 20 veces por segundo con precisión de coma flotante, el ancho de banda necesario cae a apenas 1.3 Mbps. Esa reducción de más de cien veces es lo que finalmente permite mantener una latencia menor a 500 milisegundos incluso en una red universitaria compartida. El sistema se diseñó, además, con objetivos concretos de calidad de servicio: disponibilidad igual o superior al 95% durante las sesiones de observación, pérdida de paquetes menor al 1%, y una relación señal-ruido mínima de 10 dB tras 60 minutos de integración continua. Esas métricas sirvieron como referencia para validar que el prototipo fuera realmente utilizable en un entorno educativo, y no solo una prueba de concepto de laboratorio.

Del lado de la experiencia de usuario, la interfaz web se pensó simple a propósito: un panel superior con el gráfico de espectro de potencia en tiempo real, centrado en la banda de 1420.4 MHz con un marcador vertical en esa frecuencia exacta, y valores numéricos en vivo como la frecuencia central en curso, el tamaño de la FFT, la tasa de muestreo y el estado del inyector Bias-T del LNA. Debajo, un panel inferior muestra el gráfico tipo cascada (waterfall), que representa la evolución temporal del espectro con una escala de color pensada para resaltar los picos de interés. Todo el diseño usa un tema oscuro, tanto para facilitar la lectura en un proyector de salón de clases como para reducir la fatiga visual durante observaciones nocturnas, que es cuando suele haber menos interferencia electromagnética en el campus. El sistema contempla también la generación de reportes automáticos y alertas configurables ante eventos inusuales, como picos de actividad solar.

Tres intentos hasta encontrar el diseño correcto

El equipo probó tres configuraciones de antena en paralelo, mientras seguía refinando el procesamiento de señal, y cada una les dejó una lección concreta para el diseño final.

La primera fue la antena parabólica pequeña reciclada de Altice, montada sobre un marco de madera con el LNA puesto directamente en el foco. Con esta no lograron detectar la línea de hidrógeno. El plato estaba diseñado originalmente para otra frecuencia y tenía un área útil reducida, así que la ganancia en 1420 MHz no alcanzó para distinguir la señal del ruido, ni siquiera con el procesamiento ya mejorado. Esa primera derrota les dejó clara una lección: no basta con reciclar cualquier plato disponible, hace falta un alimentador diseñado específicamente para la frecuencia de trabajo.

Dos vistas de la antena parabólica de Altice sobre un marco de madera en el césped
Figura 3. Modelo 1: antena parabólica de Altice reutilizada, con el LNA montado en el foco. No se logró detectar la línea de hidrógeno con esta configuración.

El segundo modelo abandonó por completo la parábola. Fue un feedhorn cónico construido enteramente por el equipo, pensado para funcionar solo, sin ningún reflector, con el LNA Nooelec SAWbird+ H1 conectado directamente en su base. Probaron dos variantes de este diseño. Y fue justo esta configuración la que dio los primeros resultados sólidos: captó la línea de hidrógeno con buena calidad, funcionando sola, sin parábola. Ahí el equipo entendió algo importante: el feed cónico, diseñado a la medida de la frecuencia de trabajo, era lo que le había faltado al Modelo 1.

Feedhorn cónico de lámina metálica sobre una mesa, de noche
Figura 4. Modelo 2: feedhorn cónico construido por el equipo, funcionando de forma independiente (sin parábola), con el LNA conectado directamente en su base.

El tercer y último modelo combinó el feedhorn cónico que ya había funcionado bien por sí solo con la parábola grande: lo montaron en el foco de un plato de malla de 2 metros de diámetro. Así aprovecharon a la vez la mayor área de captación del plato y el buen patrón de radiación del feed. Apuntando a mano hacia distintas zonas de la Vía Láctea, con ayuda de una aplicación de mapa celeste, llegó la detección clara y repetible que se documenta más adelante en este artículo. Las capturas finales de la interfaz AURORA_SDR, con el pico en 1420.57 MHz y que se muestran en la siguiente sección, corresponden exactamente a esta configuración: el feed cónico sobre la parábola de 2 metros.

Dos vistas de la parábola de malla de 2 metros en una azotea, con el feedhorn en el foco y una laptop
Figura 5. Modelo 3 (final): feedhorn cónico montado en el foco de una parábola de malla de 2 metros de diámetro. Con esta configuración se obtuvo la detección clara y repetible de la línea de hidrógeno en 1420.57 MHz.

Resultados

Un fantasma en el espectro

Antes de poder confiar en cualquier resultado, el equipo tuvo que resolver un problema que al principio parecía ser justo la señal que buscaban. En las primeras capturas de prueba, el espectro mostraba un pico angosto, de apenas uno o dos píxeles de ancho, ubicado exactamente en el centro de la banda observada. Por un momento se pudo confundir con la señal de hidrógeno. No lo era. La emisión real de hidrógeno galáctico, producto del movimiento y colisión del gas en el espacio, genera un perfil ancho por efecto Doppler, típicamente de 100 a 500 kHz de ancho, no un pico tan estrecho.

Captura de GNU Radio con un espectro plano y un pico angosto en el centro de la banda
Figura 6. Espectro con el pico anómalo (DC spike) antes del ajuste de frecuencia: un pico angosto justo en el centro de la banda, que en un principio pudo confundirse con la señal de hidrógeno.

Tras analizarlo, el equipo dio con la causa: era un «DC spike», un artefacto que producen casi todos los receptores SDR por culpa de su propio oscilador local, y que siempre aparece justo en la frecuencia exacta a la que se sintoniza el equipo. Es un fenómeno bien documentado en la radioastronomía amateur, y la solución también se conoce: aplicar una técnica de sintonía desplazada (LO offset). El equipo movió la frecuencia central de captura de 1420.405 MHz a 1420.000 MHz, y así sacó el artefacto 405 kHz fuera de la ventana de observación que les interesaba. Las pruebas posteriores confirmaron que, con este ajuste, la banda de interés quedaba completamente libre de ese ruido fantasma generado por el propio hardware.

Gráfica del espectro calibrado HI entre 1419.5 y 1421.5 MHz con la frecuencia de reposo del hidrógeno marcada
Figura 7. Espectro calibrado tras aplicar el offset de oscilador local de 405 kHz: la banda de interés queda libre del artefacto de hardware.

La señal que confirmó que el sistema funciona

Para comprobar que toda la cadena, desde la antena hasta el software, era capaz de aislar una señal astronómica real del ruido del propio instrumento, el equipo aplicó el método de calibración Hot/Cold, el procedimiento estándar en radioastronomía para convertir las lecturas relativas del receptor en valores de temperatura de antena reales. Consiste en comparar dos referencias: una “caliente”, bloqueando por completo la apertura del feedhorn con un material opaco a la señal para que el receptor vea únicamente su propia temperatura ambiente, y una “fría”, destapando el feedhorn para que observe el cielo despejado. Al contrastar ambas capturas, el sistema puede distinguir el ruido que genera el propio instrumento del que realmente proviene del espacio, dejando visible la señal astronómica sobre una línea base calibrada. Fue precisamente con este esquema de calibración Hot/Cold, aplicado sobre el Modelo 3 (feed cónico montado en la parábola de 2 metros), que el equipo obtuvo las dos capturas finales que se muestran a continuación, con el pico de hidrógeno en 1420.57 MHz.

Uno de los estudiantes sostiene el feedhorn cónico apuntándolo hacia el cielo nocturno
Figura 8. Antena en posición COLD, apuntando hacia el plano galáctico durante las pruebas de conmutación HOT/COLD.
Uno de los estudiantes coloca el feedhorn cónico en el suelo, fuera del plano galáctico
Figura 9. Antena en posición HOT, desplazada fuera del plano galáctico.

Los primeros intentos de calibración Hot/Cold, hechos antes de corregir el artefacto del oscilador, arrastraban el mismo pico angosto del DC spike. Costaba distinguir la referencia caliente de la fría con ese ruido de por medio. Ya con el ajuste de frecuencia aplicado, las sesiones siguientes (de madrugada, para evitar la interferencia del campus) mostraron una diferencia limpia entre ambas referencias. El sistema por fin se enfocaba en la zona espectral que interesaba, sin ruido propio del hardware de por medio.

Con el esquema de calibración final ya funcionando, y usando el Modelo 3 (feed cónico montado sobre la parábola de malla de 2 metros), el equipo caracterizó primero el espectro base del sistema: una FFT de 4096 bins, una tasa de muestreo de 10 megamuestras por segundo, una resolución espectral cercana a 2.44 kHz por bin, y un ancho de banda observado de ±2.5 MHz alrededor de la frecuencia central. Con esta configuración, el equipo obtuvo un pico definido y repetible en distintas sesiones de observación, centrado en 1420.57 MHz, cercano a la frecuencia de referencia de la línea de hidrógeno neutro (1420.406 MHz), sobre una línea base notablemente más estable que la del diseño inicial. El indicador de estabilidad del sistema, denominado internamente “System Heartbeat”, mostró durante estas capturas valores concentrados cerca de cero: no hubo saturación de ganancia, y la calibración funcionó como debía.

Interfaz AURORA_SDR con controles de calibración, el indicador System Heartbeat y el espectro con la línea de hidrógeno
Figura 10. Interfaz AURORA_SDR mostrando la línea de hidrógeno detectada con el esquema calibrado: pico en 1420.57 MHz sobre una línea base estable.
Segunda captura de la interfaz AURORA_SDR con un espectro de forma similar
Figura 11. Segunda observación con el esquema calibrado, mostrando que la forma de la línea base y la posición del pico se mantienen consistentes entre sesiones.

Vale la pena comparar estos resultados con los antecedentes internacionales que se revisaron antes. Phelps (2024) logró una detección básica con un RTL-SDR de 8 bits por menos de 300 USD [6]. Campbell-Wilson et al. (2025) detectaron púlsares con una inversión inferior a 200 USD usando un plato de 2.4 metros [9]. Aurora llegó a una detección repetible y calibrada de la línea de hidrógeno con un gasto real de apenas 5,050 pesos dominicanos, poco más de 84 USD. Eso fue posible porque la mayor parte del hardware crítico (el bladeRF, la Raspberry Pi 4 y las antenas) ya era de la universidad. El costo teórico de replicar el sistema completo desde cero, sin reutilizar nada, se estima en 1,292.79 USD. Aun así, esa cifra queda muy por debajo de los sistemas comerciales educativos, que arrancan en 19,450 USD [2].

Aplicar el método de calibración Hot/Cold no fue sencillo, porque el procedimiento tradicional exige mover físicamente la antena entre una referencia “caliente” a temperatura ambiente y una referencia “fría” de cielo despejado, y la antena de la universidad quedó instalada en un montaje fijo, sin esa posibilidad de movimiento. En lugar de forzar una solución que el hardware disponible no podía soportar, el equipo diseñó una alternativa práctica: bloquear por completo la apertura del feedhorn con un material opaco a la señal para simular la referencia caliente, y luego destaparlo para dejar que observara el cielo normalmente como referencia fría. Esa adaptación fue precisamente la que permitió obtener la calibración estable detrás de la detección mostrada en la sección anterior, aunque el equipo reconoce que un sistema de apuntado motorizado, capaz de mover físicamente la antena entre ambas referencias, sigue siendo una mejora pendiente para ganar todavía más precisión radiométrica.

Es importante ser igual de honestos sobre las limitaciones generales del sistema en su estado actual. La interferencia de otras señales de radiofrecuencia presentes en el campus sigue dificultando la recepción de la señal débil de hidrógeno, incluso con todo el filtrado aplicado. La antena depende de ajuste completamente manual, lo que limita tanto la precisión como la duración práctica de cada sesión de observación. El feedhorn artesanal, aunque funcional, ofrece un rendimiento inferior al de un modelo comercial optimizado. Y como cualquier sistema de observación radioastronómica en superficie, la calidad de los datos capturados depende de condiciones ambientales que el equipo no puede controlar. Ninguna de estas limitaciones invalida lo logrado, pero mapear con claridad hasta dónde llega el sistema actual es lo que permite planificar con seriedad los próximos pasos.

Conclusión

Lo que sigue para Aurora

Más allá del logro técnico puntual, el proyecto deja varias lecciones que probablemente sean tan valiosas como la propia detección de la señal. La primera es que un artefacto de hardware, lejos de ser un fracaso, terminó siendo una oportunidad de aprendizaje: identificar y corregir el DC spike obligó al equipo a entender a fondo el comportamiento interno de un receptor SDR, algo que ningún curso teórico enseña con la misma claridad que un problema real en el laboratorio. La segunda es que la calibración tradicional de referencia caliente/fría, pensada para antenas móviles, tuvo que adaptarse a las limitaciones físicas de un montaje fijo, una solución práctica ante una restricción real de infraestructura.

De cara al futuro, el equipo ya identificó mejoras concretas para la siguiente etapa del proyecto: sustituir el plato reflector actual por una antena parabólica simétrica de mayor tamaño, reemplazar el feedhorn artesanal por uno cónico diseñado específicamente para esas nuevas dimensiones, y automatizar el apuntado del radiotelescopio con motores paso a paso controlados desde la Raspberry Pi, de forma que el sistema pueda seguir el movimiento de la Vía Láctea sin intervención manual constante. También se contempla mejorar la organización del código fuente y respaldarlo en el repositorio institucional de la Escuela, para que el proyecto pueda ser retomado, auditado o replicado por otros estudiantes en ciclos académicos posteriores.

Aurora demuestra algo que va más allá de la radioastronomía: que es posible construir instrumentación científica funcional en un contexto universitario con recursos limitados, siempre que exista disposición para experimentar, fallar, entender por qué se falló, y volver a intentarlo. Para un país como República Dominicana, sin plataformas accesibles de este tipo, ese es quizás el aporte más importante del proyecto: mostrar que escuchar el universo no tiene por qué ser un privilegio reservado a observatorios con presupuestos millonarios, y que ese primer paso puede darse, literalmente, con una lata de salsa y equipo que otros ya habían dado por obsoleto.

Referencias

  1. J. D. Kraus, Radio Astronomy, 2nd ed. Powell, OH, USA: Cygnus-Quasar Books, 1986.
  2. Canadian Centre for Experimental Radio Astronomy (CCERA), “A 21cm radio telescope for the cost-conscious,” [Online]. Available: http://www.ccera.ca/papers/a-21cm-radio-telescope-for-the-cost-conscious/
  3. “Línea de hidrógeno,” AcademiaLab. [Online]. Available: https://academia-lab.com/enciclopedia/linea-de-hidrogeno/. Accessed: Feb. 11, 2026.
  4. Observatorio Astronómico UTP, “Radioastronomía,” Universidad Tecnológica de Pereira. [Online]. Available: https://observatorioastronomico.utp.edu.co/radioastronomia/
  5. C. V. Niño Rondón et al., “Radio definida por software: una mirada a las tendencias y aplicaciones,” Revista Ingenierías USBMed, vol. 14, no. 1, 2023. [Online]. Available: https://portal.amelica.org/ameli/journal/536/5364250007/html/. Accessed: Feb. 11, 2026.
  6. J. Phelps, “Paper on building a low cost RTL-SDR based hydrogen line radio telescope,” RTL-SDR Blog, 2024. [Online]. Available: https://www.rtl-sdr.com/paper-on-building-a-low-cost-rtl-sdr-based-hydrogen-line-radiotelescope/
  7. N. Almutairi et al., “Design and optimization of a low-cost 5-m radio telescope at 1.4 GHz,” Radio Science, vol. 59, no. 2, 2025. doi: 10.1029/2024RS008170.
  8. B. A. De Silva et al., “Design and implementation of a software defined radio-based radio telescope for hydrogen line observation at 1.42 GHz,” TechRxiv, 2024. doi: 10.36227/techrxiv.722721.v1.
  9. D. Campbell-Wilson, C. Flynn, and T. Bateman, “Observations of the Vela pulsar with a low-cost, 2.4m radio telescope at Woodchester Observatory,” Publications of the Astronomical Society of Australia, vol. 42, 2025. doi: 10.1017/pasa.2025.12.
  10. Astromía, “Historia de la radioastronomía,” n.d. [Online]. Available: https://www.astromia.com/astronomia/radiohistoria.html
  11. A. Banks and R. Gupta, “MQTT Version 5.0,” OASIS Standard, Oct. 2019. [Online]. Available: https://docs.oasis-open.org/mqtt/mqtt/v5.0/mqtt-v5.0.html
  12. Raspberry Pi Foundation, “Raspberry Pi 4 technical datasheet,” 2024. [Online]. Available: https://www.raspberrypi.com/products/raspberry-pi-4-model-b/specifications/
  13. GNU Radio Project, “GNU Radio manual and documentation,” 2024. [Online]. Available: https://wiki.gnuradio.org/index.php/Tutorials
  14. “WebSocket protocol,” RFC 6455, Dec. 2011. [Online]. Available: https://datatracker.ietf.org/doc/html/rfc6455
  15. R. T. Fielding, “Architectural styles and the design of network-based software architectures,” Ph.D. dissertation, Univ. California, Irvine, 2000.
  16. E. A. Lee and S. A. Seshia, Introduction to Embedded Systems: A Cyber-Physical Systems Approach, 2nd ed. MIT Press, 2017.

Sistema Inteligente de Ecualización Acústica mediante Procesamiento Digital de Señales

Wilfrido Guillermo Perdomo Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El sonido en espacios cerrados raramente se conforma de manera uniforme. En espacios como auditorios, aulas universitarias y salas de conferencias, la distribución acústica puede ser afectada por múltiples factores como son: la arquitectura del espacio, como su geometría, los materiales utilizados en las superficies, el ruido en el ambiente generado por sistemas de ventilación y la ubicación de fuentes sonoras con respecto a los oyentes.

Este proyecto propone la creación de un sistema de ecualización acústica inteligente que opera de forma autónoma y en tiempo real capaz de ser ajustada al ambiente de uso. De esta forma creando un cambio de vista hacia la ecualización adaptiva, en donde los sensores monitorean el entorno constantemente y ajustan el audio de forma dinámica.

Problemática y estado del arte

En un espacio cerrado como salas de conferencias o aulas, al hacer uso de sistemas de climatización, se genera un ruido constante que mientras de vez en cuando no es detrimental a la experiencia auditiva, termina causando problemas al oyente ya que es un ruido constante que termina enmascarando otros sonidos en el mismo rango de frecuencias. También, al hacer uso de bocinas u otros sistemas reproductores, es posible que, en espacios alejados a la fuente, el sonido no se llegue a percibir correctamente debido a la cercanía o distancia del oyente a estas fuentes.

Es por esto que normalmente la solución a algunos de estos problemas es el aumento del volumen general del sistema de audio, lo que termina siendo contraproducente al generar mayor malestar físico y reverberación al oyente, no logrando así resolver el desbalance espectral que causa el ruido ambiental.

A través de las pruebas hechas a través del desarrollo se encontró que el ruido ambiental en ciertas aulas universitarias no es uniforme, sino que se concentra en la banda de frecuencias graves, con niveles que pueden alcanzar incluso a valores como 123 dB, donde si se sigue las soluciones tradicionales de simplemente subir el volumen, las frecuencias se saturan y no se resuelve el problema principal de la saturación de la banda de frecuencias grave, creando así una experiencia sonora físicamente molesta.

Aunque actualmente existan diversos métodos para mitigar los problemas acústicos que se generan ocasionalmente, la mayoría de estas soluciones se encuentran detrás de barreras como lo que es la accesibilidad, la necesidad de un experto en el tema, o el conocimiento previo de cómo funciona el audio en su totalidad.

Muchos acercamientos utilizan el procesamiento en la nube para el control de los sistemas, pero se enfrentan a los problemas como la latencia y la saturación de red, que son aspectos que no pueden ser ignorados por lo delicado que es la transmisión de audio, en donde incluso un detenimiento de un fragmento de segundo puede ser detectado y alertado por el oído humano.

Para la realización de un sistema que cumpla con todos los requerimientos que se tienen, es necesario usar la Transformada Rápida de Fourier (FFT) que permite la caracterización de señales acústicas en tiempo real utilizando la escala logarítmica. Reduciendo la complejidad computacional del análisis espectral y haciendo posible el procesamiento en tiempo real del sonido de un espacio.

Además de esto, al hacer uso de la ecualización adaptiva podemos responder a cambios en el entorno acústico, haciendo cambios a los coeficientes de ecualización y eficientizando el uso de los recursos disponibles. Haciendo uso de filtros IIR se permite implementar ecualizadores paramétricos, dando la posibilidad de modificar los coeficientes de la banda de frecuencias mientras se ejecuta.

Para superar estas limitaciones de latencia y congestión de red, este proyecto adopta un enfoque en donde se ejecuta la Transformada Rápida de Fourier (FFT) de forma local en nodos sensores, evitando así que el sistema transmita flujos de audio pesados y, en su lugar, envía únicamente metadatos espectrales procesados a un servidor central. Esta arquitectura no solo garantiza la privacidad de los usuarios al no retransmitir audio crudo, sino que permite una capacidad de respuesta inmediata ante variaciones acústicas, logrando un sistema de ecualización verdaderamente adaptativo y eficiente en el uso de recursos de red.

Objetivos completados

El desarrollo de este proyecto ha logrado implementar un sistema de ecualización acústica inteligente mediante el uso de procesamiento digital de señales para resolver la degradación de la inteligibilidad en ambientes cerrados. El sistema integra nodos de captura basados en ESP32 que ejecutan localmente la Transformada Rápida de Fourier (FFT), permitiendo la extracción y envío de metadatos espectrales precisos hacia un servidor central de manera eficiente. Asimismo, se desarrolló e implementó un algoritmo de control proporcional capaz de ajustar hasta 10 bandas de frecuencia de forma independiente, garantizando una alta velocidad de estabilización acústica. Finalmente, mediante la integración de GStreamer, el sistema provee una salida de audio continua con 0 ms de interrupción durante los cambios dinámicos de coeficientes, asegurando una experiencia de uso fluida y profesional frente a condiciones de ruido ambiental variable.

Metodología

La metodología adoptada para este proyecto se fundamenta en un diseño de hardware y software distribuido, enfocado en la eficiencia de cómputo y la respuesta en tiempo real. A diferencia de los acercamientos tradicionales que requieren una conexión física compleja, esta solución propone un ecosistema inalámbrico modular capaz de adaptarse a diferentes geometrías arquitectónicas sin necesidad de reconfiguraciones profundas en el código base.

Arquitectura de adquisición y procesamiento de datos

El primer pilar de la solución es la red de nodos sensores de bajo costo. Cada nodo está integrado por un microcontrolador ESP32 y un micrófono digital INMP441 con interfaz I2S. La elección de una interfaz digital es crítica, ya que permite mantener la integridad de la señal acústica desde la captura, evitando las interferencias electromagnéticas comunes en las señales analógicas. Lo novedoso de esta etapa reside en que el ESP32 no actúa como un simple transmisor, este ejecuta localmente una Transformada Rápida de Fourier (FFT) para descomponer el sonido ambiente en sus componentes espectrales.

Diagrama de la arquitectura: bocina, dos micrófonos INMP441 con nodos ESP32, Raspberry Pi, computadora transmisora y display gráfico
Figura 1. Esquema general de la arquitectura distribuida del sistema.

Al procesar la FFT, el sistema solo transmite vectores de datos que representan la energía de las frecuencias detectadas. Este enfoque reduce drásticamente el uso del ancho de banda y mitiga los problemas de congestión de red mencionados anteriormente. Además, al no transmitir el audio crudo, se garantiza una capa de privacidad intrínseca, ya que el servidor central nunca recibe ni almacena grabaciones de voz, sino únicamente metadatos matemáticos de la acústica del salón.

Servidor central y gestión de audio con GStreamer

La unidad de procesamiento central, basada en una Raspberry Pi 4, actúa como el integrador de la inteligencia del sistema. Aquí se recibe la información espectral de todos los nodos de la red AudioNet y se gestiona el flujo de audio mediante la librería GStreamer. Esta herramienta permite la creación de pipelines de procesamiento multihilo, donde se insertan filtros de respuesta al impulso infinito (IIR) para cada una de las 10 bandas de frecuencia configuradas.

Diagrama del pipeline de audio: entrada, conversión, ecualizador IIR de 10 bandas con inyección de control y salida
Figura 2. Visualización del procesamiento dinámico de filtros sin interrupción de señal.

La ventaja de utilizar GStreamer frente a otras soluciones de software es su capacidad para manipular propiedades de los filtros mientras se reproduce audio. Mientras que otros sistemas presentan latencias audibles al actualizar el pipeline de uso, ya sea reiniciándolo al mismo tiempo, o creando otro sub-pipeline. El pipeline implementado permite modificar los coeficientes de ecualización de forma síncrona, logrando que el ajuste sea imperceptible para el oído humano, manteniendo una salida de audio constante y libre de artefactos sonoros.

Algoritmo de control y calibración dinámica

Para la toma de decisiones, se implementó un algoritmo de control proporcional que opera de manera cíclica. El proceso inicia con una fase de calibración dinámica donde el sistema mide el “piso de ruido” del ambiente durante 10 segundos. Una vez establecido este umbral, el algoritmo compara en tiempo real las variaciones energéticas reportadas por los nodos. Si se detecta un incremento sostenido en una banda específica, el sistema calcula automáticamente una ganancia negativa proporcional para compensar dicho ruido.

Diagrama de flujo del algoritmo de control: detección de feedback, cálculo del error por banda, ajuste proporcional y aplicación en GStreamer
Figura 3. Lógica de decisión para el ajuste automático de bandas de frecuencia.

Para garantizar la estabilidad del sistema, se incorporó una “zona muerta”. Permitiendo evitar que el sistema reaccione de forma errática ante ruidos transitorios o picos de señal insignificantes, asegurando que la ecualización solo cambie ante variaciones reales y persistentes de la acústica del entorno. Este enfoque preventivo garantiza que el audio se mantenga estable y confortable para el usuario final.

Interfaz visual y modos de operación

Finalmente, el sistema se complementa con una interfaz táctil basada en el ESP32-S3-Touch-LCD-7. Esta permite al usuario observar de manera gráfica y en tiempo real el comportamiento del espectro en las diferentes zonas del recinto. La metodología de diseño de la interfaz se centró en la usabilidad, ofreciendo al usuario la posibilidad de elegir entre una operación totalmente autónoma o una modalidad de recomendación manual, donde el operador toma las decisiones de cómo manipular el sistema.

Prototipo del sistema: pantalla táctil con la interfaz de la red de micrófonos, nodos sensores en carcasas impresas y bocina
Figura 4. Implementación final del centro de control táctil del sistema.

Resultados

Durante el desarrollo del proyecto, se ha podido observar el cumplimiento de ciertas facetas de los objetivos propuestos, validando así el funcionamiento del sistema, obteniendo resultados como los siguientes:

  • Precisión en la detección espectral. El sistema logró identificar con éxito los niveles críticos de ruido en espacios reales de la universidad, registrando hasta picos de 123.3 dB en salones universitarios frente a picos de 107 dB en entornos residenciales, permitiendo una compensación precisa al enmascaramiento sonoro.
  • Latencia de procesamiento. A través del proyecto se estaba haciendo uso de librerías específicas para la transmisión y el control del audio saliente, luego de una transición hacia GStreamer se ha logrado eliminar todos los cortes de audio existentes en el sistema, logrando así un procesamiento y cambio de bandas que se asemejan a sistemas profesionales.
  • El algoritmo ha demostrado ser capaz de adaptarse rápidamente a las variaciones del ruido en el ambiente, consiguiendo alcanzar la convergencia y estabilidad en un promedio de 16 segundos.

Conclusiones

El desarrollo del proyecto confirma que la integración de hardware utilizando nodos de procesamiento y algoritmos de control proporcional eficaces permiten resolver problemas acústicos con una eficiencia comparable a sistemas profesionales. La investigación y las pruebas realizadas permiten extraer las siguientes conclusiones:

Continuidad y calidad de uso: la transición técnica a mejores tecnologías fue un aspecto clave para el éxito de todo el sistema, reduciendo la latencia de la conmutación de filtros y validando la posibilidad de realizar ajustes dinámicos de ecualización de forma no audible al oído humano.

Innovación en el procesamiento: la capacidad de ejecutar procesos complicados como lo es la Transformada Rápida de Fourier (FFT) en los nodos sensores de audio representa un avance para el procesamiento eficaz de datos en comparación de sistemas centralizados convencionales.

Visualización y control táctil: la interfaz desarrollada utilizando una pantalla touch con un ESP32 integrado permite que el usuario tenga acceso a diferentes opciones, no técnicas y técnicas. Como es la visualización del comportamiento espectral y poder elegir entre dos modos de ecualización, autónomo o asistido, permitiendo que el usuario pueda tomar decisiones operativas según su parecer.

Referencias

  1. Widrow, B., Glover, J. R., McCool, J. M., Kaunitz, J., Williams, C. S., Hearn, R. H., … & Goodlin, R. C. (1975). Adaptive noise cancelling: Principles and applications. Proceedings of the IEEE, 63(12), 1692-1716. https://ieeexplore.ieee.org/document/1451965
  2. Cecchi, S., Bruschi, V., Peretti, P., & Bettarelli, F. (2024). Real Time System for Sound Enhancement in Noisy Environment. 27th International Conference on Digital Audio Effects (DAFx24), Guildford, UK, pp. 381–387. https://www.dafx.de/paper-archive/2024/papers/DAFx24_paper_70.pdf
  3. Avargel, Y., & Cohen, I. (2007). On multiplicative transfer function approximation in the short-time Fourier transform domain. IEEE Signal Processing Letters, 14(5), 337-340. https://ieeexplore.ieee.org/document/4154719
  4. Abhayapala, T. D., & Ward, D. B. (2002). Theory and design of high order sound field microphones using spherical microphone array. IEEE International Conference on Acoustics, Speech, and Signal Processing, 2, 1949–1952. https://researchportalplus.anu.edu.au/en/publications/theory-and-design-of-high-order-sound-field-microphones-using-sph-2
  5. Espressif Systems. (2023). ESP32 Technical Reference Manual. https://www.espressif.com/sites/default/files/documentation/esp32_technical_reference_manual_en.pdf
  6. Sebastià V., & Malte Kob. (2016). Real-time auralization of room acoustics for the study of live music performance. https://www.researchgate.net/publication/299560219_Real-time_auralization_of_room_acoustics_for_the_study_of_live_music_performance
  7. Mignot et al. (2023). “Reconstruction of transient acoustic field using sparse real-time near-field acoustic holography.” Journal of the Acoustical Society of America, 154(4), 2023. https://www.sciencedirect.com/science/article/abs/pii/S0022460X23004224
  8. Corey, R. M., Skarha, M. D., & Singer, A. C. (2019). Cooperative Audio Source Separation and Enhancement Using Distributed Microphone Arrays and Wearable Devices. arXiv preprint arXiv:1912.05038. https://arxiv.org/abs/1912.05038

Sistema de detección temprana de fuego mediante el uso de cámaras termográficas biespectrales en almacenes de fábricas textiles

Nicolás de Jesús Familia Mateo – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La innovación como respuesta a una problemática crítica

Los incendios en almacenes de fábricas textiles representan una amenaza constante para la continuidad operativa, la preservación de mercancías y sobre todo la vida humana. En este contexto fue desarrollado, en la Pontificia Universidad Católica Madre y Maestra, un proyecto de grado enfocado en el diseño e implementación de un sistema de detección temprana de fuego mediante el uso de cámaras termográficas biespectrales, procesamiento local en el borde y una plataforma web de monitoreo en tiempo real. La propuesta se origina dentro de la carrera de Ingeniería Telemática con la autoría de Nicolás de Jesús Familia Mateo y se inserta dentro de una línea de trabajo donde convergen visión computacional, redes, sistemas embebidos y desarrollo de software orientado a la supervisión de eventos críticos.

La motivación principal del proyecto parte de una observación puntual: en entornos industriales con alta presencia de materiales inflamables, como ocurre en la industria textil, la detección tradicional basada exclusivamente en sensores puntuales puede resultar insuficiente cuando se requiere cobertura amplia, baja tasa de falsas alarmas y capacidad de anticipación. El problema no se limita a detectar humo o calor cuando el incendio ya se encuentra claramente desarrollado, puesto que su verdadero valor está en identificar conatos de fuego y comportamientos térmicos anómalos antes de que la situación escale a un evento de gran magnitud.

Bajo esa premisa, se propuso una solución híbrida que aprovecha la capacidad de una cámara biespectral para observar simultáneamente el espectro visible y el espectro infrarrojo, el poder de cómputo local de una unidad Jetson Orin para ejecutar inferencia en tiempo real y una aplicación web centralizada capaz de recibir, almacenar, visualizar y notificar alertas. El sistema además incorpora un microcontrolador ESP32-S3 para accionar una sirena estroboscópica, un pulsador de incendios y habilitar interfaces analógicas de integración con subsistemas externos, como mecanismos de supresión contra incendios.

Más allá de su valor técnico, el proyecto busca ser una respuesta realista a necesidades presupuestarias y operativas en entornos como el de la República Dominicana. En lugar de plantear una arquitectura dependiente de grandes despliegues de sensores especializados y de costosas instalaciones distribuidas, la propuesta explora cómo una misma cámara puede cubrir áreas amplias y cómo el procesamiento en el borde puede reducir la latencia sin trasladar toda la carga operativa a la nube. El resultado es un enfoque que busca ser tecnológicamente sólido, económicamente razonable y adaptable a condiciones reales de operación.

Cuando la detección tradicional deja espacios de riesgo

El riesgo de incendio en la industria textil se ve intensificado por la presencia de fibras, polvos en suspensión, materiales combustibles, cableados eléctricos, maquinaria sometida a altas temperaturas y procesos donde un pequeño error puede desencadenar una propagación rápida del fuego. A ello se suma que los almacenes concentran mercancía en volúmenes importantes, de modo que una ignición inicial puede encontrar en cuestión de segundos o minutos una carga combustible suficiente para convertirse en una emergencia mayor. Por esta razón, la prevención y la detección son asuntos esenciales de la seguridad industrial.

Adicionalmente, el inconveniente también posee una dimensión humana y social. En casos de incendios en fábricas textiles de Bangladesh se han llegado a producir decenas de muertes y numerosos heridos, evidenciando que la ausencia de mecanismos adecuados de prevención y respuesta puede conducir a catástrofes irreversibles [15]. Estos antecedentes, aunque ocurridos fuera del país, sirven como recordatorio de que el riesgo es estructural y no debe interpretarse como una posibilidad remota. En la República Dominicana y en otros países en vías de desarrollo, donde las limitaciones presupuestarias suelen condicionar la adopción tecnológica, el desafío se vuelve todavía más delicado.

Los sistemas convencionales de detección presentan ventajas conocidas, pero también varias restricciones dentro de este tipo de entorno. Los detectores puntuales de humo, calor o llama deben ser instalados de forma estratégica y en gran cantidad para ofrecer una cobertura adecuada. Aun así, pueden quedar zonas poco protegidas y, además, la propagación del humo o del calor no es instantánea. En consecuencia, la alerta puede llegar cuando el fenómeno ya alcanzó una etapa visible o claramente peligrosa. En fábricas y almacenes donde el objetivo es ganar incluso una pequeña ventana de tiempo para actuar este retraso reduce el valor preventivo del sistema.

A lo anterior se añaden las falsas alarmas, que en un ambiente con motas de fibra, polvo y partículas suspendidas pueden presentarse con mayor frecuencia, especialmente en detectores de humo ópticos [1]. Cada falsa activación, además de implicar una interrupción de las operaciones, también representa un desgaste progresivo de la confianza del personal en el sistema. Una arquitectura que produce demasiadas alarmas injustificadas termina siendo operativamente costosa y, en el peor de los casos, psicológicamente ineficaz, porque el personal comienza a normalizar eventos que deberían ser tratados con seriedad [4].

Frente a estas limitaciones, la visión computacional ha ganado relevancia como alternativa para la detección de fuego y humo mediante análisis de video. A diferencia del enfoque puntual, los sistemas basados en video observan la escena de forma continua y pueden extraer patrones relacionados con el color, la forma, el parpadeo, el crecimiento y el comportamiento espaciotemporal del fuego y del humo. Cuando esta lógica se combina con termografía, la capacidad analítica se amplía aún más, ya que el sistema puede considerar también la temperatura, la distribución térmica y anomalías invisibles al ojo humano.

Diversos trabajos previos han validado el uso de arquitecturas basadas en CNN y en la familia YOLO para la detección de humo y fuego en tiempo real [17]. Sin embargo, el estado del arte también deja claro que no existe una solución universal. El rendimiento depende de la calidad del dataset, del tipo de entorno, de las condiciones de iluminación, de la capacidad computacional disponible y de la forma en que se integran los componentes físicos y lógicos del sistema. En ese punto es donde se sitúa la contribución del presente proyecto: no se limitó a entrenar un clasificador, sino que articuló una solución integral de hardware, software, red y notificación enfocada en almacenes textiles [11, 13].

El componente diferencial más importante de la propuesta radica en la biespectralidad, ya que mientras que muchos esquemas de detección por video dependen exclusivamente del canal RGB, aquí se trabajó con una cámara Hikvision capaz de ofrecer simultáneamente visión óptica e infrarroja. Esa dualidad permite observar la escena y contextualizarla visualmente, pero al mismo tiempo medir y vigilar el comportamiento térmico de los objetos presentes en el campo de visión. Con ello se refuerza la posibilidad de advertir escenarios previos a la ignición, un aspecto particularmente valioso cuando se pretende pasar de un enfoque reactivo a uno más proactivo.

Diagrama en bloques: cámara Hikvision, Jetson Orin, ESP32 con sirena y pulsador, y servidores de la EICT con base de datos, backend y aplicación web
Figura 1. Diagrama en bloques de la solución de detección temprana de fuego diseñada
Diagrama de flujo de datos: detección con la cámara y el Jetson, envío del JSON, alerta en la web, correo electrónico y disparo de la sirena
Figura 2. Diagrama de flujo de datos de la solución propuesta

Objetivos completados

El desarrollo del presente proyecto permitió crear un sistema de detección de fuego mediante video para la identificación temprana de focos de fuego en almacenes de fábricas textiles, integrando una cámara termográfica biespectral para la captura simultánea del entorno en tiempo real, un esquema local de procesamiento con Jetson Orin para eficientizar la inferencia y reducir la latencia, una interfaz analógica habilitada mediante un microcontrolador ESP32-S3 para la activación de sirena estroboscópica y la posible integración de mecanismos de supresión, y una aplicación web de monitoreo capaz de recibir, administrar, visualizar y notificar alertas en tiempo real, consolidando así un flujo completo de adquisición, análisis, decisión y respuesta acorde con los objetivos planteados desde el inicio del proyecto.

Metodología basada en subsistemas para construir una solución integral

La metodología adoptada se apoyó en una lógica de subsistemas. En lugar de intentar una integración completa desde las primeras etapas, el desarrollo se organizó de forma que cada componente pudiera ser validado de manera independiente antes de su unificación final. Este enfoque permitió aislar problemas, asignar responsabilidades técnicas claras y reducir la complejidad durante el prototipado. El hardware, el software de inferencia, la plataforma web y la orquestación de alertas físicas fueron tratados como módulos con funciones específicas aunque desarrollados desde el principio como partes de un mismo flujo operativo.

En el plano del hardware se trabajó con tres piezas principales: la cámara termográfica biespectral Hikvision DS-2TD2617, la unidad de procesamiento local Jetson Orin y el microcontrolador ESP32-S3 con conectividad Ethernet. La cámara fue validada en sus dos canales de video RGB e infrarrojo, así como en su capacidad de retransmisión mediante protocolos IP como RTSP. El Jetson fue evaluado como plataforma para entrenamiento e inferencia con aceleración gráfica, mientras que el ESP32-S3 fue preparado para integrarse como publicador y suscriptor MQTT y como controlador de la interfaz de potencia asociada a la sirena y al pulsador manual de incendios.

El sistema físico también exigió resolver aspectos de instalación y soporte, puesto que la cámara Hikvision, debido a razones de sus características de peso y formato, requirió el diseño de un mecanismo de acople a un trípode robusto, construido a partir de una estructura metálica disponible en laboratorio y adaptaciones mecánicas sobre un registro genérico. Aunque a primera vista esto podría parecer una tarea menor, en realidad fue fundamental para viabilizar las pruebas en distintos escenarios y conservar movilidad durante la etapa experimental. El prototipo debía ser funcional, no obstante también manipulable y replicable dentro de un entorno académico controlado.

En lo relativo al procesamiento inteligente, se seleccionó la arquitectura YOLO en su variante YOLOv8n. Esta decisión respondió a dos criterios principales. En primer lugar, YOLO ha demostrado un balance favorable entre velocidad y precisión para tareas de detección en tiempo real [11]. Segundo, la variante nano resulta apropiada para una plataforma embebida como el Jetson Orin, donde la eficiencia en el uso de recursos es un factor estratégico. El proyecto valoró la posibilidad de emplear versiones más recientes, sin embargo, al final se priorizó la estabilidad y la documentación disponible alrededor de YOLOv8.

La construcción del banco de datos fue uno de los pasos más determinantes de la metodología. Se partió de un dataset curado de 9,775 imágenes proveniente de Roboflow Universe. Además, se adicionaron más de 150 imágenes elaboradas específicamente para el escenario de despliegue del sistema. Estas imágenes extra incorporaron variaciones de llamas, objetos incendiados y distintos niveles de iluminación dentro del espacio controlado del Laboratorio de Comunicaciones Aplicadas. Más adelante, mediante técnicas de aumento de datos, ese conjunto fue ampliado significativamente hasta conformar un dataset final de 24,558 imágenes, fortaleciendo la capacidad de generalización del modelo frente a distintas condiciones.

Dos capturas de la herramienta de etiquetado con llamas y humo anotados en el laboratorio
Figura 3. Ejemplares de imágenes caracterizadas para el dataset. Lugar de despliegue: Laboratorio de Comunicaciones Aplicadas, Campus Santiago

Las técnicas de aumento aplicadas incluyeron modificaciones de saturación, rotación, brillo y exposición. La decisión metodológica detrás de estas transformaciones fue simple pero importante: si la solución iba a ser usada en escenarios donde la iluminación cambia, donde la cámara puede no estar siempre en el mismo ángulo o donde el humo altera visualmente la escena, entonces el modelo debía ser expuesto durante el entrenamiento a esa diversidad de condiciones. De ese modo, se buscó disminuir la fragilidad del clasificador ante desviaciones razonables respecto del patrón base del dataset.

En la etapa de entrenamiento se fijó un máximo inicial de 300 epochs, acompañado de un mecanismo de parada temprana, criterio que fue coherente con prácticas comunes para datasets suficientemente curados, pero también evitó desperdiciar recursos computacionales cuando el proceso dejara de mostrar mejoras relevantes. El entrenamiento finalizó de manera prematura en 201 epochs, lo que fue interpretado como un indicio de convergencia alcanzada antes del límite establecido. La ejecución se realizó sobre el Jetson Orin, reforzando así el interés del proyecto por demostrar viabilidad real en una plataforma de borde y no únicamente en un entorno de laboratorio idealizado.

La metodología de inferencia no se limitó al análisis del video RGB, puesto que este no era el punto más fuerte del proyecto. El script desarrollado en Python 3.11 integró dos hilos de trabajo principales. El primero, apoyado en GStreamer y un enlace RTSP, se encargaba de recibir video en tiempo real, ejecutar inferencia con YOLOv8n y generar capturas asociadas a eventos detectados. El segundo se enfocaba en la lectura de temperatura desde la cámara Hikvision mediante ISAPI, la interfaz REST propietaria del fabricante Hikvision. Esta integración no fue trivial, puesto que requirió ajustar el modo de operación térmico de la cámara y resolver retos asociados con autenticación tipo Digest mediante la clase HTTPDigestAuth de la librería requests.

Otra decisión metodológica importante fue la definición del escenario de demostración. El proyecto estableció que la validación debía ocurrir en un entorno controlado capaz de simular condiciones de un almacén textil sin comprometer la seguridad del laboratorio. Para ello se contempló el uso de una unidad de cuerpo negro para inducir puntos calientes sin combustión real, así como pruebas adicionales con mechero y eyector de humo para reproducir situaciones de mayor riesgo. La importancia de esta estrategia radica en que permitió evaluar temperatura, humo y fuego en etapas iniciales bajo condiciones medibles, con posibilidad de variar distancia, iluminación y presencia de obstáculos parciales como cajas o estanterías.

La lógica de decisión se estructuró, primero, haciendo que el sistema verificara la existencia de fuego o humo mediante el clasificador de visión computacional. Luego, validaba la presencia de cuerpos de calor dentro de umbrales previamente definidos para los niveles de severidad establecidos: pre-alerta, alerta y acción. Finalmente, el sistema consolidaba ambos criterios y decidía qué información enviar al servidor centralizado en caso que aplicase. Esta articulación entre visión y temperatura constituye uno de los aportes metodológicos más valiosos del proyecto, puesto que evita depender exclusivamente de un único tipo de evidencia y aprovecha la riqueza de una cámara biespectral.

De manera paralela, se desarrolló una plataforma web sobre Java Spring Boot con arquitectura modular, separando controladores, servicios y repositorios. La aplicación integró Thymeleaf para el renderizado dinámico de vistas, WebSocket para la notificación inmediata de nuevas alertas, acceso a base de datos relacional para la persistencia de eventos y rutinas periódicas para verificación del estado de conexión de las cámaras. En conjunto, esta metodología permitió construir un sistema de monitoreo con trazabilidad, visualización histórica y capacidad de administración remota.

Dashboard web Fireblink con una notificación de nueva alerta de detección, contadores de alertas y últimas detecciones registradas
Figura 4. Alerta de detección informada en tiempo real a través de la página web mediante WebSocket. Pestaña: Dashboard

La etapa final de la metodología fue la integración del subsistema físico de respuesta. El ESP32-S3 fue programado para publicar y suscribirse a tópicos MQTT, recibir comandos desde el servidor y manipular el encendido o apagado de la sirena estroboscópica a través de un relay controlado por GPIO. En adición a lo anterior, se habilitó un pulsador de incendios que permite disparar la alarma manualmente desde el sitio de despliegue. De esta forma, el proyecto ideado conservó una filosofía híbrida: automatización cuando la evidencia lo exige y posibilidad de intervención física directa en escenarios donde el criterio humano sigue siendo necesario.

Caja de control con el ESP32-S3 y relé conectada a una sirena estroboscópica y a un pulsador de incendios rojo
Figura 5. Subsistema de hardware: controlador de interfaz de potencia con el ESP32-S3, sirena estroboscópica y pulsador de incendios

Resultados que validan la solución propuesta

Los resultados obtenidos permitieron constatar el funcionamiento general de la solución en el entorno controlado de pruebas. En términos globales, el sistema logró detectar conatos de incendios y eventos térmicos a partir de la combinación de los dos espectros trabajados, al mismo tiempo que consiguió registrar, almacenar y notificar las alertas a través de la plataforma web y de mecanismos físicos complementarios. Esto significa que el proyecto no se quedó en una validación aislada del modelo de visión, lo que se afirma bajo el enunciado de que se demostró la operatividad del flujo completo desde la captura hasta la alerta final.

En el caso del modelo de visión computacional, el entrenamiento con el dataset final de 24,558 imágenes mostró una tendencia progresiva de mejora en las pérdidas asociadas a localización y clasificación. El reporte describe una disminución sostenida en los valores de entrenamiento y validación, así como un comportamiento consistente cuando el modelo fue expuesto a muestras no vistas previamente. También se observó que la precisión aumentó de forma marcada al inicio del proceso y luego se estabilizó, comportamiento coherente con una curva de aprendizaje donde el modelo captura primero patrones más evidentes y después entra en una fase de refinamiento.

En la interpretación de clases bajo el modelo, el fuego alcanzó una detección correcta superior a la del humo, registrándose valores reportados en torno al 86 % en la matriz de confusión normalizada, mientras que el humo se ubicó alrededor del 67 %. Esta diferencia fue atribuida a la complejidad visual del humo, la cual con frecuencia se confunde con el fondo o pierde nitidez en condiciones de poca iluminación, aspecto que, principalmente, estuvo relacionado con limitaciones del hardware de video empleado.

Matriz de confusión normalizada con las clases Fire, Smoke y background
Figura 6. Matriz de confusión resultante del entrenamiento (normalizada)

Desde el punto de vista térmico, la cámara Hikvision logró detectar y reportar valores de temperatura dentro del rango esperado, luego de ser calibrada con una unidad de cuerpo negro capaz de inducir temperaturas aproximadas de 0 °C a 200 °C. El sistema comenzó a operar sobre valores mínimos útiles alrededor de 35 a 40 °C, conforme a las exigencias del firmware del dispositivo y no presentó inconvenientes en la identificación de cuerpos calientes dentro de ese dominio operativo. Se destaca, no obstante, una incertidumbre promedio de aproximadamente ± 5 % respecto del valor esperado, asociada a las características físicas y de diseño de la cámara.

La integración entre el Jetson Orin y el backend basado en Spring Boot también fue validada satisfactoriamente. Cada vez que el script detectaba un evento relevante, generaba una captura del momento, la almacenaba localmente y ejecutaba el proceso de registro hacia el servidor central. Esto incluía la inserción de la alerta en la base de datos, la publicación por WebSocket para los usuarios conectados y el envío de la imagen en Base64 para su posterior exposición dentro del sistema. En la práctica, esta secuencia permitió visualizar casi de inmediato el evento de detección en la plataforma de monitoreo, conservando además evidencia visual para fines de auditoría y análisis posterior.

La aplicación web cumplió con el objetivo de centralizar la información y hacerla operativamente útil, permitiendo visualizar alertas recientes, consultar el historial de imágenes asociadas, administrar dispositivos de detección, generar reportes filtrados por fecha y nivel de gravedad y revisar el estado de conexión de las cámaras desplegadas. La incorporación de WebSocket fue especialmente relevante, ya que aseguró la actualización en tiempo real de la interfaz sin necesidad de recargar manualmente la página, característica indispensable en un sistema donde segundos de retraso pueden tener consecuencias materiales y humanas.

La plataforma web también fue concebida desde una lógica de uso operativo y no únicamente de demostración académica. Por esa razón, la interfaz fue diseñada con énfasis en claridad visual, identificación rápida por niveles de severidad y acceso directo a acciones relevantes. Las vistas de detecciones recientes, detalles del evento, dispositivos registrados, historial y dashboard buscaban que el usuario no tuviera que interpretar estructuras complejas en un momento crítico. Esta preocupación por la usabilidad se conecta con la idea central del proyecto sugerida por maestros y superiores de que una buena precisión técnica pierde valor si la información no se presenta de manera comprensible y accionable para el personal responsable.

En cuanto a las notificaciones, el proyecto implementó un enfoque redundante y complementario, contando con el monitoreo visual mediante la aplicación web y la habilitación del envío de correo electrónico con la información principal de la detección, ampliando la posibilidad de reconocimiento del evento desde dispositivos móviles. Paralelamente, el subsistema físico basado en la sirena estroboscópica y el pulsador de incendios se integró con éxito, de modo que una alerta crítica podía traducirse en un aviso sonoro y luminoso directamente en el lugar de riesgo.

El comportamiento del ESP32-S3 resultó satisfactorio dentro de la lógica bidireccional prevista, puesto que el microcontrolador respondió correctamente tanto a las directivas MQTT emitidas por el servidor como a la activación local del pulsador manual, y envió las señales necesarias a la interfaz de potencia para encender la sirena y permitir la futura integración de otros subsistemas, como mecanismos de supresión. Este resultado es particularmente importante porque confirma que la solución puede ir más allá de la mera notificación y convertirse en una plataforma de orquestación de respuestas automáticas condicionadas al nivel de gravedad de la alerta.

En términos de alcance, el proyecto demostró que la arquitectura propuesta puede cubrir el ciclo completo de identificación, validación, transmisión, notificación y activación local. Al mismo tiempo, se evidencia que los resultados dejaron ver de forma honesta ciertas limitaciones. La efectividad del clasificador depende de que el entorno final se encuentre adecuadamente representado en el dataset. Además, variaciones importantes en iluminación o en condiciones físicas del espacio pueden repercutir en el rendimiento del modelo. Del mismo modo, el sistema necesita suministro eléctrico continuo, lo que abre la puerta a futuras mejoras relacionadas con respaldo energético. Lejos de debilitar la propuesta, estas observaciones ayudan a ubicarla dentro de un marco técnico realista y a orientar sus siguientes etapas de evolución.

Una base sólida para futuras implementaciones

Considerando los resultados obtenidos, el proyecto cumplió con las expectativas definidas en su objetivo general y en sus objetivos específicos. Fue posible construir un sistema capaz de observar un entorno de almacén mediante una cámara biespectral, procesar localmente la información con un modelo de visión computacional, combinar esa inferencia con lectura térmica, transmitir las alertas a un servidor centralizado y notificar al personal a través de una plataforma web, correo electrónico y mecanismos físicos de alarma. La integración de todos estos componentes, lograda dentro de un contexto académico y con énfasis en viabilidad práctica, confirma el valor del trabajo desarrollado.

Uno de los aportes más relevantes de la solución es haber demostrado que la detección temprana de fuego puede abordarse desde una arquitectura híbrida y escalable, donde una cámara con capacidades térmicas y visibles, apoyada por procesamiento en el borde puede ofrecer cobertura útil sin depender exclusivamente de una gran cantidad de sensores puntuales. De acuerdo con el propio análisis del proyecto, una sola cámara biespectral puede cubrir entre 100 y 150 metros cuadrados, mientras que una misma unidad Jetson Orin podría albergar la operatividad de múltiples cámaras. Esta observación sugiere un potencial importante de crecimiento para futuras implementaciones.

En adición al flujo principal de detección, el envío periódico de health checks introdujo un componente de autovigilancia del propio sistema. Al medir latencia, pérdida de paquetes y ancho de banda, la solución informaba sobre el estado operativo de la infraestructura que debía detectar los eventos de riesgo. Esta capa de observabilidad es particularmente útil en despliegues reales, donde una cámara desconectada o con mala calidad de enlace puede crear una falsa percepción de seguridad. En consecuencia, el proyecto integró la noción de que monitorear el detector es casi tan importante como monitorear el entorno detectado.

También resulta valioso destacar que el proyecto no buscó presentar su solución como sustituto universal de todos los sistemas convencionales, sino como una respuesta frente a necesidades específicas de la industria textil y el ahorro de costos sin sacrificio de funcionalidad y seguridad. En lugar de generalizar indebidamente, lo propuesto se posiciona como una arquitectura con alta pertinencia para almacenes textiles y otros espacios donde conviene anticipar anomalías térmicas y fenómenos visuales antes de que el incendio se consolide.

De cara al futuro el propio desarrollo deja abiertas varias líneas de mejora, siendo una de ellas avanzar hacia configuraciones automáticas de períodos de entrenamiento y caracterización del entorno, de modo que el sistema pueda ajustar dinámicamente umbrales según temperatura promedio, objetos comunes en la escena o comportamientos regulares del espacio de despliegue. Otra línea natural de evolución es la incorporación de canales adicionales de notificación, como llamadas VoIP o mensajería instantánea, fortaleciendo todavía más la capacidad de respuesta en situaciones de mayor gravedad.

Los resultados alcanzados deben interpretarse dentro de la filosofía de desarrollo planteada desde el inicio. El proyecto pretendía demostrar la factibilidad técnica de una solución integral y sentar bases para evoluciones posteriores. Bajo ese criterio, la validación de la comunicación entre subsistemas, la correcta persistencia de evidencias, la activación física de alertas y la obtención consistente de valores térmicos adquieren un peso considerable, porque prueban que la arquitectura es coherente y que sus módulos pueden crecer sin necesidad de replantear por completo el sistema.

A modo de cierre, este proyecto ofrece una evidencia concreta de cómo la integración entre componentes que podrían anteriormente considerarse como “aislados” puede traducirse en una herramienta útil para la prevención de incendios en entornos industriales sensibles. Desde una perspectiva de innovación aplicada, el trabajo confirma que la ingeniería adquiere mayor valor cuando se orienta a proteger vidas, reducir riesgos y ofrecer alternativas viables frente a limitaciones del contexto. Por ello, el sistema desarrollado se visualiza como una plataforma inicial sobre la cual continuar investigando, refinando el modelo, ampliando las capacidades de notificación e impulsando futuras implementaciones piloto en escenarios cada vez más cercanos a la operación real.

Referencias

  1. M. T. Siraj, B. Debnath, S. B. Payel, A. B. M. M. Bari, y A. R. M. Towfiqul Islam, «Analysis of the fire risks and mitigation approaches in the apparel manufacturing industry: Implications toward operational safety and sustainability», sep. 2023. [En línea]. Disponible en: https://www.cell.com/heliyon/fulltext/S2405-8440(23)07520-5?uuid=uuid%3Af099052d-3f01-48bf-9adb-6c0d2124e28c
  2. S. S. Moumgiakmas, G. G. Samatas, y G. A. Papakostas, «Computer Vision for Fire Detection on UAVs—From Software to Hardware», Future Internet, vol. 13, n.º 8, p. 200, jul. 2021, doi: 10.3390/fi13080200.
  3. B. Li, F. Xu, X. Li, C. Yu, y X. Zhang, «Early Stage Fire Detection System Based on Shallow Guide Deep Network», Fire Technology, vol. 60, n.º 3, pp. 1803-1821, feb. 2024, doi: 10.1007/s10694-024-01549-1.
  4. J. Lin y X. Xu, «Design of a textile storage environment fire detection system based on ZigBee and NB-IoT», Journal Of Physics Conference Series, vol. 2797, n.º 1, p. 012031, jul. 2024, doi: 10.1088/1742-6596/2797/1/012031.
  5. Q. Zhang, Y. Tian, J. Chen, X. Zhang, y Z. Qi, «To ensure the safety of storage: Enhancing accuracy of fire detection in warehouses with deep learning models», jul. 2024. [En línea]. Disponible en: https://www.sciencedirect.com/science/article/abs/pii/S0957582024009303
  6. J. Ryu y D. Kwak, «A Study on a Complex Flame and Smoke Detection Method Using Computer Vision Detection and Convolutional Neural Network», Fire, vol. 5, n.º 4, p. 108, jul. 2022, doi: 10.3390/fire5040108.
  7. K. Avazov, M. K. Jamil, B. Muminov, A. B. Abdusalomov, y Y.-I. Cho, «Fire Detection and Notification Method in Ship Areas Using Deep Learning and Computer Vision Approaches», Sensors, vol. 23, n.º 16, p. 7078, ago. 2023, doi: 10.3390/s23167078.
  8. Khondaker, A. Khandaker, y J. Uddin, «Computer Vision-based Early Fire Detection Using Enhanced Chromatic Segmentation and Optical Flow Analysis Technique», mar. 2020. [En línea]. Disponible en: https://d1wqtxts1xzle7.cloudfront.net/84536670/18967-libre.pdf
  9. A. B. A. J. C. Mukhriddin Mukhiddinov, «A Wildfire Smoke Detection System Using Unmanned Aerial,» 2022. [En línea]. Available: https://mdpi-res.com/d_attachment/sensors/sensors-22-09384/article_deploy/sensors-22-09384.pdf?version=1669897124.
  10. L. W. T. L. P. S. Zhong Wang, «A Smoke Detection Model Based on Improved YOLOv5,» 2022. [En línea]. Available: https://mdpi-res.com/d_attachment/mathematics/mathematics-10-01190/article_deploy/mathematics-10-01190.pdf?version=1649216740.
  11. M. Mukhiddinov, A. B. Abdusalomov, and J. Cho, “Automatic Fire Detection and Notification System Based on Improved YOLOv4 for the Blind and Visually Impaired,” Sensors, vol. 22, no. 9, May 2022, doi: 10.3390/s22093307.
  12. M. A. Rahman, S. T. Hasan, and M. A. Kader, “Computer Vision Based Industrial and Forest Fire Detection Using Support Vector Machine (SVM),” in 2022 International Conference on Innovations in Science, Engineering and Technology, ICISET 2022, Institute of Electrical and Electronics Engineers Inc., 2022, pp. 233–238. doi: 10.1109/ICISET54810.2022.9775775.
  13. C. Jin et al., “Video Fire Detection Methods Based on Deep Learning: Datasets, Methods, and Future Directions,” Fire, vol. 6, no. 8. Multidisciplinary Digital Publishing Institute (MDPI), Aug. 01, 2023. doi: 10.3390/fire6080315.
  14. K. Avazov, M. Mukhiddinov, F. Makhmudov, and Y. I. Cho, “Fire detection method in smart city environments using a deep-learning-based approach,” Electronics (Switzerland), vol. 11, no. 1, Jan. 2022, doi: 10.3390/electronics11010073.
  15. S. Islam, M. Abdul Hannan Mia, and M. Zoynal Abedin, “Evaluation of Causes and Effects of Fire and Other Safety Incidents in Readymade Garment Industry of Bangladesh,” American Journal of Mechanical and Industrial Engineering, vol. 7, no. 2, p. 13, 2022, doi: 10.11648/j.ajmie.20220702.11.
  16. S. Saponara, A. Elhanashi, and A. Gagliardi, “Real-time video fire/smoke detection based on CNN in antifire surveillance systems,” Journal of Real-Time Image Processing, vol. 18, no. 3, pp. 889–900, Jun. 2021, doi: 10.1007/s11554-020-01044-0.
  17. S. Geetha, C. S. Abhishek, and C. S. Akshayanat, “Machine Vision Based Fire Detection Techniques: A Survey,” Fire Technology, vol. 57, no. 2. Springer, pp. 591–623, Mar. 01, 2021. doi: 10.1007/s10694-020-01064-z.
  18. A. Gaur, A. Singh, A. Kumar, A. Kumar, and K. Kapoor, “Video Flame and Smoke Based Fire Detection Algorithms: A Literature Review,” Fire Technology, vol. 56, no. 5. Springer, pp. 1943–1980, Sep. 01, 2020. doi: 10.1007/s10694-020-00986-y.
  19. K. R. Ahmed and M. Alomgir Hossain, “An automated IOT based fire detection & safety control for garments industry in Bangladesh: A-study,” in 2021 International Conference on Automation, Control and Mechatronics for Industry 4.0, ACMI 2021, Institute of Electrical and Electronics Engineers Inc., Jul. 2021. doi: 10.1109/ACMI53878.2021.9528094.
  20. K. Howell, K. Dudek, and M. Soroko, “Thermal camera performance and image analysis repeatability in equine thermography,” Infrared Physics and Technology, vol. 110, Nov. 2020, doi: 10.1016/j.infrared.2020.103447.

Sistema de monitoreo de trampas para insectos

Jordy Johan Camacho Taveras y Emil Arias – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la automatización y el análisis de datos comienzan a revolucionar el sector agroindustrial, el presente proyecto nace como una solución práctica, innovadora y replicable para el control de plagas en ambientes de almacenamiento, específicamente en almacenes de tabaco. Esta iniciativa fue desarrollada por los estudiantes Emil Arias y Jordy Johan Camacho como parte de su Proyecto Final de Grado para optar por el título de Ingeniero en Telemática en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Bajo la guía académica de la Escuela de Computación y Telecomunicaciones (EICT), el proyecto se enfocó en transformar un proceso manual e ineficiente —la inspección visual de trampas adhesivas para insectos— en una plataforma inteligente, autónoma y accesible.

La motivación surgió de una problemática real: almacenes agrícolas en República Dominicana dependen de la revisión humana para detectar plagas en trampas físicas, lo que implica tiempo, errores humanos y decisiones poco fundamentadas. La falta de registros históricos, la ausencia de análisis en tiempo real y el uso excesivo de pesticidas sin validación técnica son consecuencias directas de esta carencia de tecnología. Frente a ello, se propuso un sistema integral que incorpora elementos de visión por computadora, aprendizaje automático y arquitectura IoT con dispositivos de bajo costo, logrando así una alternativa accesible para pequeños y medianos productores.

El proyecto integra un nodo inteligente de captura y análisis local basado en Raspberry Pi 5, equipado con una cámara IMX577 de alta resolución y un aro LED WS2812, el cual permite generar condiciones de iluminación constante para mejorar la calidad de las capturas. Sobre estas imágenes se ejecuta un modelo de detección de objetos optimizado con YOLO + NCNN, el cual identifica y clasifica insectos detectados sobre las trampas. Los resultados, junto con las imágenes anotadas, se envían mediante el protocolo MQTT a un servidor Raspberry Pi secundario que actúa como plataforma de recepción, almacenamiento en base de datos y presentación a través de una interfaz web sencilla y funcional. Esta arquitectura no solo permite monitoreo remoto, sino también almacenamiento local en caso de desconexión, garantizando resiliencia ante fallos.

Prototipo: interior de la caja con dos trampas adhesivas bajo la cámara y vista exterior del dispositivo
Figura 1. Vista de prototipo.

Este tipo de tecnología ya ha sido explorado en países desarrollados mediante soluciones como Trapview y PestNet, que utilizan cámaras y procesamiento en la nube para visualizar trampas electrónicas. Sin embargo, muchas de estas plataformas exigen altos costos de adquisición o suscripción, y requieren conectividad constante a internet, lo cual no es viable en muchas zonas rurales del país [1][2]. En contraposición, este sistema fue diseñado para operar de manera autónoma, sin depender de servicios externos, lo que lo convierte en una opción viable para entornos donde los recursos son limitados.

El uso de modelos como YOLO en la agricultura de precisión ha sido validado por estudios recientes. Por ejemplo, el trabajo de Sun et al. [3] demostró la efectividad del modelo YOLOv8 para detectar plagas del tabaco en condiciones complejas de luz y fondo. Asimismo, investigaciones como las de Ramalingam et al. [4] destacan cómo la visión artificial puede reducir significativamente la intervención humana en tareas de monitoreo. Estos antecedentes avalan el enfoque técnico del presente proyecto, que no solo replica, sino que adapta estas metodologías a una realidad local dominicana.

El desarrollo de este proyecto ha implementado un sistema de monitoreo de trampas adhesivas basado en visión por computadora y dispositivos IoT, orientado a reducir los errores humanos, mejorar la trazabilidad, y permitir una respuesta ágil ante infestaciones en almacenes de tabaco. Se logró crear una solución funcional capaz de detectar insectos automáticamente, registrar los datos con imágenes auditables, transmitir los resultados mediante MQTT, almacenarlos en una base de datos MySQL, y presentarlos de forma clara en una interfaz web, cumpliendo todos los objetivos específicos planteados.

Para alcanzar estos resultados, se diseñaron dos módulos: el primero, un nodo de detección autónomo con la capacidad de capturar imágenes cada dos minutos, analizarlas mediante el modelo entrenado y generar imágenes anotadas con bounding boxes de distintos colores según la clase detectada. El segundo módulo funciona como servidor web y base de datos, permitiendo centralizar y consultar los resultados desde una interfaz organizada. A nivel técnico, se integró una lógica de tolerancia a fallos: cuando no se detecta conexión con el broker MQTT, los resultados se almacenan localmente y se reenvían una vez restablecida la conexión.

Diagrama de bloques: cámara USB y aro LED, Raspberry Pi de detección, modelo, MQTT, Raspberry Pi servidor web, MySQL y página web
Figura 2. Diagrama de bloques del sistema.
Pantalla de inicio de sesión y panel principal de la interfaz SmartTrap
Figura 3. Interfaz visual.

Una de las características más relevantes del sistema es su capacidad de alertar automáticamente sobre situaciones críticas. Se desarrolló una lógica que permite generar alertas en tres escenarios: detección crítica (por cantidad alta de insectos), aumento sostenido (presencia progresiva día tras día), y presencia persistente (cuando un mismo tipo de insecto aparece durante varios días consecutivos). Estas alertas se visualizan en el dashboard, permitiendo al personal técnico actuar a tiempo y aplicar pesticidas de forma más responsable.

En cuanto a la validación, se llevaron a cabo dos fases. En la primera, se colocaron insectos reales (muertos) sobre trampas adhesivas en un entorno de laboratorio para simular escenarios de infestación. El sistema logró detectar correctamente múltiples especies, alcanzando un mean Average Precision (mAP) superior al 90%, lo que evidenció la precisión del modelo YOLO optimizado bajo condiciones controladas.

Para la segunda fase, aunque se planificó una prueba extendida en un almacén real de tabaco, no se obtuvieron los permisos necesarios para realizar la validación completa en ese entorno. Sin embargo, se simuló el comportamiento del sistema en condiciones similares, procesando más de 1000 capturas obtenidas a partir de datos de pruebas internas y casos registrados previamente. Las pruebas demostraron que el sistema mantenía un desempeño estable ante variaciones de iluminación y presencia de interferencias visuales como polvo o residuos, confirmando su capacidad de operar en condiciones reales.

Panel con gráficas de detecciones por tipo de insecto y alertas por severidad
Figura 4. Gráfica de detecciones por tipo de insecto.
Pantalla de gestión de alertas de SmartTrap
Figura 5. Tabla de alertas.

Entre los beneficios más destacados está la reducción estimada del uso innecesario de pesticidas en un 30%, la disminución de horas de inspección manual, y la trazabilidad digital que permite revisar históricamente el comportamiento de las plagas por trampa, tipo y fecha. Además, la arquitectura utilizada es completamente replicable: con una sola Raspberry Pi por trampa y otra como servidor central, el sistema puede escalar fácilmente a más ubicaciones sin necesidad de conexión a internet externa, ya que puede operar de forma autónoma dentro de una red local.

A pesar de los logros obtenidos, se identificaron algunas limitaciones que serán abordadas en futuras versiones. Por ejemplo, aunque el sistema no requiere conexión a internet, sí necesita una red Wi-Fi local para la transmisión de datos entre las trampas y el servidor. En zonas rurales sin infraestructura de red, será necesario incorporar módulos de comunicación celular. También se identificó que la detección puede verse afectada si la trampa está mal posicionada o sucia, y que actualmente solo se detectan especies entrenadas previamente, por lo que se planea ampliar la base de datos con más clases.

El impacto de este proyecto no se limita al almacén de tabaco donde se probó. Su arquitectura modular, bajo costo y facilidad de uso lo convierten en una herramienta adaptable a otros sectores agrícolas y productivos. Su diseño responde directamente a las necesidades del contexto local, permitiendo un avance en la transformación digital del agro dominicano. Asimismo, fomenta una cultura de control basado en datos y evidencia, necesaria para optimizar recursos, cumplir regulaciones sanitarias y proteger el medio ambiente.

Tabla de lecturas por captura con filtros en la interfaz web
Figura 6. Interfaz web, mostrando historial por trampas y filtros por fecha/tipo de insecto.

Resultados

La validación del sistema de monitoreo inteligente para trampas adhesivas fue una etapa crucial para demostrar su efectividad técnica y su aplicabilidad práctica. Para ello, se diseñó una estrategia de pruebas dividida en dos fases complementarias: una fase experimental bajo condiciones controladas en laboratorio y una fase aplicada en campo simulado, debido a limitaciones de acceso a almacenes reales.

Fase 1: Validación en laboratorio

Durante esta fase se buscó verificar la precisión del modelo en un entorno ideal. Se utilizaron trampas adhesivas sobre las cuales se colocaron manualmente insectos reales (muertos) pertenecientes a diferentes especies objetivo, como hormigas, cucarachas, polillas, moscas y lasioderma. Estas trampas fueron iluminadas con el aro LED Neopixel incluido en el sistema, y las imágenes fueron capturadas por la cámara de alta resolución conectada a la Raspberry Pi.

Posteriormente, cada imagen fue procesada por el modelo entrenado YOLOv8 adaptado a NCNN, con el objetivo de identificar correctamente cada clase de insecto. Los resultados obtenidos fueron altamente satisfactorios. Se alcanzó un mAP superior al 90%, lo cual indica una precisión promedio muy alta en la detección de las distintas clases.

En la Figura 7 se presenta la curva de precisión frente a confianza para cada clase, incluyendo un resumen de desempeño general. Se observa que todas las clases muestran altos niveles de precisión incluso en niveles de confianza elevados, lo que evidencia una baja tasa de falsos positivos.

Curva de precisión frente a confianza por clase de insecto
Figura 7. Curva Precisión–Confianza por clase, incluyendo promedio general del modelo.

Adicionalmente, se evaluó el comportamiento del modelo durante su proceso de entrenamiento. En la Figura 8 se muestran las gráficas de pérdidas (box, clasificación y distribución focal) tanto en entrenamiento como en validación, así como la evolución de métricas clave como precisión, recall y mAP en distintas variantes. Estas gráficas evidencian una convergencia estable y efectiva del modelo, sin señales de sobreajuste.

Gráficas de pérdidas, precisión, recall y mAP durante el entrenamiento
Figura 8. Gráficas de pérdida, precisión y mAP durante el entrenamiento y validación del modelo.

Por último, se realizó una evaluación cualitativa de los resultados mediante la revisión visual de las imágenes etiquetadas automáticamente por el sistema. En la Figura 9, se muestra un conjunto representativo de estas detecciones, donde puede observarse claramente cómo el sistema reconoce múltiples insectos de diferentes clases en una misma trampa, asignando bounding boxes con etiquetas precisas y colores distintos por clase, incluso bajo iluminación variable.

Mosaico de capturas de trampas con insectos detectados y etiquetados
Figura 9. Detecciones de insectos en trampas adhesivas utilizando el modelo entrenado.

Fase 2: Validación en entorno real simulado

Aunque inicialmente se había planificado implementar el sistema dentro de un almacén real de tabaco para evaluar su funcionamiento en condiciones operativas reales, no se obtuvieron los permisos necesarios para realizar dicha instalación. No obstante, se optó por una validación alternativa simulando condiciones reales: el sistema operó durante una semana consecutiva, en un entorno preparado que replicaba iluminación ambiental tenue, interferencias como polvo, y rotación de trampas con capturas reales.

Durante esta etapa, el sistema generó más de 1000 capturas, las cuales fueron procesadas y analizadas de manera autónoma por la Raspberry Pi. El sistema detectó exitosamente la presencia de insectos en trampas, enviando los resultados al servidor mediante MQTT, o almacenándolos temporalmente en memoria local si había problemas de conectividad.

La tasa de detección se mantuvo alta incluso ante interferencias visuales, y el sistema demostró un desempeño robusto en condiciones menos controladas. Esta validación fue clave para comprobar que el modelo no solo funciona en condiciones ideales, sino también en escenarios más complejos y con ruido visual, como los que se encuentran en almacenes de productos agrícolas.

Impacto operativo y funcional

Más allá del rendimiento técnico del modelo, el sistema demostró tener un impacto positivo a nivel operativo y práctico. Entre los beneficios observados destacan:

  • Reducción del uso innecesario de pesticidas: Se estima una disminución del 30% en aplicaciones químicas innecesarias, ya que ahora las acciones se toman con base en datos y alertas reales.
  • Ahorro de tiempo en inspecciones manuales: Las inspecciones, que antes podían tardar horas en recorridos físicos por cada trampa, se redujeron a minutos gracias al monitoreo remoto desde la plataforma web.
  • Generación de alertas inteligentes: El sistema fue capaz de emitir alertas automáticas en base a distintos patrones de riesgo definidos (detección crítica, aumento sostenido y presencia persistente). Estas alertas permitieron al personal técnico reaccionar de manera proactiva, evitando la propagación de infestaciones.
  • Integridad de los datos: La lógica de almacenamiento local ante pérdidas de conectividad temporal demostró ser efectiva, evitando pérdidas de información valiosa.

Conclusión

El desarrollo del sistema inteligente de monitoreo de trampas adhesivas representa una contribución significativa al proceso de transformación digital en la industria agrícola de la República Dominicana. Esta solución, concebida e implementada por estudiantes de ingeniería de la PUCMM, demuestra cómo desde el entorno académico pueden generarse innovaciones tecnológicas de bajo costo, basadas en arquitecturas distribuidas y modelos de inteligencia artificial entrenados localmente, capaces de responder a problemáticas concretas del sector agroindustrial.

Más allá de su funcionalidad técnica, el sistema impulsa una nueva forma de gestión agrícola basada en datos objetivos, permitiendo optimizar la toma de decisiones, reducir el uso innecesario de pesticidas, minimizar el tiempo de inspección manual y mantener trazabilidad histórica sobre la actividad biológica en almacenes. Su diseño modular y escalable, que combina dispositivos Raspberry Pi en campo con un servidor local central, permite su replicación sin necesidad de conexión a internet externa, funcionando de manera autónoma en redes Wi-Fi privadas. No obstante, para escenarios rurales sin cobertura, se plantea como mejora futura la incorporación de conectividad 4G.

Asimismo, se reconocen oportunidades de evolución como el entrenamiento de nuevos modelos con más especies, el perfeccionamiento del posicionamiento físico de trampas y la implementación de lógica predictiva basada en tendencias. Estas mejoras permitirán al sistema no solo detectar plagas en tiempo real, sino también anticipar su aparición y facilitar respuestas tempranas más eficientes.

En definitiva, este proyecto reafirma el rol estratégico de la academia como motor de soluciones tecnológicas orientadas a los sectores productivos. Su desarrollo es una muestra concreta del impacto que pueden tener los proyectos estudiantiles bien dirigidos, cuando se articulan conocimientos técnicos con necesidades reales del entorno nacional.

Referencias

  1. TrapView – Sistema de monitoreo de plagas basado en visión artificial. [En línea]. Disponible en: https://www.trapview.com/
  2. PestNet – Monitoreo de trampas en cultivos. [En línea]. Disponible en: https://pestnet-europe.es/
  3. D. Sun et al., “Efficient Tobacco Pest Detection in Complex Environments Using an Enhanced YOLOv8 Model”, Agriculture, vol. 14, no. 3, p. 353, 2024.
  4. B. Ramalingam et al., “Remote Insects Trap Monitoring System Using Deep Learning Framework and IoT”, Sensors, vol. 20, no. 18, p. 5280, 2020.
  5. K. S. & K. D. Suresh, “Crop Pest Control using IoT Real-Time Monitoring and Intervention”, IEEE Access, 2023.
  6. M. Inoue, “IoT Monitoring System for Agricultural Pests and Diseases”, IEEE, 2018.

Creación de algoritmo de optimización para gestionar en un ambiente simulado el tráfico en ciertas intersecciones de la ciudad de Santiago

Romario Isaías Abreu Santos y Demian Fernando Reynoso Gómez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El acelerado crecimiento urbano de Santiago de los Caballeros ha transformado radicalmente la dinámica de movilidad en la segunda ciudad más importante de República Dominicana, generando una presión sin precedentes sobre su infraestructura vial. Este proyecto, desarrollado por Romario Isaías Abreu Santos y Demian Fernando Reynoso Gómez bajo la asesoría del profesor Jorge Alejandro Luna Martínez en la Pontificia Universidad Católica Madre y Maestra, surge como respuesta innovadora a la creciente problemática de congestión vehicular que afecta tanto la productividad económica como la calidad de vida de los santiagueros.

A medida que la ciudad experimenta un proceso de densificación urbana acelerado, las avenidas principales como Estrella Sadhalá, 27 de Febrero y Juan Pablo Duarte han sido testigos de una saturación progresiva que evidencia las limitaciones de los sistemas tradicionales de gestión del tráfico. La motivación principal de esta iniciativa radica en la urgente necesidad de modernizar la infraestructura de control semafórico, transitando desde sistemas rígidos de tiempo fijo hacia soluciones adaptativas que respondan dinámicamente a las variaciones del flujo vehicular [1], [2].

La relevancia de este proyecto trasciende el ámbito académico para posicionarse como una contribución directa al desarrollo de ciudades inteligentes en el contexto dominicano. A diferencia de las implementaciones costosas de infraestructura nueva, esta propuesta aprovecha las capacidades de simulación computacional y algoritmos de optimización para evaluar y validar soluciones antes de su posible implementación física, representando un enfoque costo-efectivo particularmente apropiado para ciudades en desarrollo [3], [4].

El desarrollo de esta solución se enmarca dentro del área emergente de sistemas inteligentes de transporte (ITS), integrando técnicas avanzadas de optimización evolutiva con modelado microscópico de tráfico. Esta aproximación metodológica permite no solo evaluar el impacto de diferentes estrategias de control semafórico, sino también generar evidencia cuantitativa sobre los beneficios potenciales de la automatización en la gestión del tráfico urbano, contribuyendo así al corpus de conocimiento sobre movilidad sostenible en América Latina [7], [8].

La problemática del tráfico en Santiago

El crecimiento descontrolado del parque vehicular en Santiago de los Caballeros ha superado significativamente la capacidad de adaptación de su infraestructura vial, creando un desequilibrio crítico entre la oferta de espacios de circulación y la demanda de movilidad urbana. Este fenómeno, común en ciudades intermedias de países en desarrollo, se ve agravado por sistemas de control de tráfico obsoletos que operan con lógicas de temporización fija, incapaces de responder a las variaciones dinámicas inherentes al flujo vehicular urbano. La consecuencia directa de esta rigidez operacional se manifiesta en tiempos de espera excesivos durante períodos de baja demanda y colapsos sistemáticos durante las horas de mayor afluencia vehicular [7], [8].

Esta problemática no se limita únicamente a inconvenientes de movilidad, sino que genera externalidades negativas de amplio espectro que incluyen incremento en el consumo de combustible, elevación de emisiones contaminantes, deterioro de la calidad del aire urbano y reducción de la productividad económica por pérdidas de tiempo en desplazamientos. La literatura especializada documenta ampliamente cómo la congestión vehicular en entornos urbanos densos contribuye al fenómeno de islas de calor urbano, degradación de la salud pública por exposición a contaminantes atmosféricos, y efectos psicológicos negativos asociados al estrés del conductor [9], [11].

En el contexto específico de Santiago de los Caballeros, intersecciones críticas como las ubicadas en la Avenida Estrella Sadhalá con Gregorio Luperón, 27 de Febrero, Juan Pablo Duarte y Hatuey, experimentan niveles de saturación que comprometen la conectividad eficiente entre diferentes sectores de la ciudad. La ausencia de coordinación entre semáforos adyacentes y la falta de adaptabilidad temporal de las fases semafóricas resultan en patrones de tráfico ineficientes que penalizan tanto a usuarios del transporte privado como público, limitando las opciones de movilidad sostenible para la población [10].

Estado del arte

El estado del arte en optimización de sistemas de control de tráfico ha experimentado avances sustanciales mediante la aplicación de técnicas computacionales avanzadas. Investigaciones pioneras como las desarrolladas por Jia et al. han demostrado el potencial del aprendizaje reforzado profundo para la optimización dinámica de fases semafóricas, logrando reducciones significativas en tiempos de espera mediante algoritmos como Clipped Double Deep Q-Learning que aprenden y se adaptan continuamente a patrones de tráfico variables [1]. Complementariamente, estudios comparativos realizados por Gunarathne et al. han validado la superioridad de sistemas de simulación integrados como VISSIM sobre métodos analíticos tradicionales como Webster, especialmente en términos de precisión predictiva y facilidad de implementación operacional [2].

Los algoritmos genéticos han emergido como una de las técnicas más prometedoras para la optimización multiobjetivo de sistemas semafóricos. Trabajos desarrollados por Al-Turki et al., Sanchez-Medina et al., y Teklu et al. han demostrado consistentemente que estos algoritmos evolutivos pueden identificar configuraciones óptimas de temporización semafórica que balancean múltiples criterios de desempeño simultáneamente, incluyendo minimización de retrasos, reducción de emisiones, y optimización de consumo energético [3], [4], [5]. La efectividad de estos enfoques radica en su capacidad para explorar espacios de solución complejos donde métodos de optimización tradicionales frecuentemente fallan debido a la naturaleza no lineal y multimodal del problema [6], [16].

La simulación microscópica de tráfico ha sido reconocida como una herramienta fundamental para la validación y evaluación de estrategias de optimización semafórica. Plataformas como SUMO (Simulation of Urban Mobility), desarrollada por el Centro Aeroespacial Alemán, han ganado aceptación amplia en la comunidad científica debido a su capacidad para modelar comportamientos vehiculares realistas, su arquitectura modular extensible, y su compatibilidad con interfaces de programación que facilitan la implementación de algoritmos de control externos [15]. Esta flexibilidad tecnológica permite la evaluación rigurosa de diferentes estrategias de optimización en entornos controlados antes de considerar implementaciones en sistemas reales.

Sin embargo, la transferencia efectiva de estas tecnologías avanzadas a contextos urbanos de países en desarrollo como República Dominicana enfrenta desafíos específicos relacionados con la disponibilidad y calidad de datos de tráfico, características particulares de patrones de movilidad local, limitaciones en infraestructura tecnológica de soporte, y restricciones presupuestarias para implementación de sistemas automatizados. La mayoría de las soluciones documentadas en la literatura internacional han sido desarrolladas para ciudades con recursos tecnológicos y financieros superiores, lo que hace necesario adaptar y contextualizar estos enfoques a las realidades y limitaciones específicas del entorno dominicano [12], [13].

El desarrollo de este proyecto ha logrado implementar un sistema integral de optimización de tráfico que utiliza algoritmos genéticos para mejorar dinámicamente la gestión semafórica en el corredor de la Avenida Estrella Sadhalá en Santiago de los Caballeros, desde la intersección con Gregorio Luperón hasta Hatuey. Para alcanzar este objetivo general, se ejecutaron múltiples objetivos específicos que incluyeron la recolección sistemática y análisis detallado de datos macroscópicos de flujo vehicular mediante observación directa y medición instrumental con radar de velocidad, garantizando la captura representativa de patrones de comportamiento del tráfico en diferentes períodos temporales y condiciones operacionales. Se desarrolló un modelo de simulación de alta fidelidad utilizando SUMO (Simulation of Urban Mobility) que replica con precisión las características geométricas, topológicas y operacionales de las intersecciones estudiadas, incorporando datos empíricos de velocidades vehiculares, densidades de tráfico y configuraciones semafóricas existentes para asegurar la validez y confiabilidad del entorno de pruebas. Finalmente, se diseñó e implementó un algoritmo genético especializado que optimiza de manera adaptativa las duraciones de fases semafóricas, logrando mejoras medibles en indicadores clave de desempeño como reducción de tiempos de espera promedio, incremento en velocidades de tránsito, disminución de paradas vehiculares y optimización del flujo global del corredor mediante adaptación continua a condiciones variables de demanda vehicular.

Metodología

Para poder probar la propuesta, fue necesario combinar varios pasos que van desde la recopilación de información en la calle hasta la simulación en computadora y la optimización mediante un algoritmo. Todo inició con la toma de datos en campo, donde se midió cuántos vehículos pasaban por distintos puntos del corredor de la Avenida Estrella Sadhalá en intervalos de diez minutos. Estos conteos se realizaron manualmente, apoyados también por el uso de un radar de velocidad para registrar la rapidez de los vehículos. Con esta información se obtuvo un panorama real del tráfico en horas representativas, y luego los datos se ajustaron a escala de una hora para que fueran más fáciles de comparar entre intersecciones.

Con esos datos como base, el siguiente paso fue llevar la realidad de las calles a un entorno virtual. Para esto se utilizó SUMO (Simulation of Urban Mobility), un software de simulación de tráfico muy utilizado a nivel mundial. Primero, se importó el mapa del tramo estudiado desde la plataforma OpenStreetMap y se ajustó con una herramienta llamada NETEDIT, que permite corregir detalles como carriles, intersecciones y semáforos. De esta manera, se construyó un modelo digital que reflejaba fielmente la geometría y las condiciones actuales del corredor vial en Santiago.

Una vez que la red estuvo lista, se incorporaron los datos recolectados (velocidades, densidad de vehículos y tiempos semafóricos actuales) para que la simulación se comportara de manera lo más cercana posible a la realidad. Esto fue clave, ya que permitió observar en la computadora los mismos patrones de congestión que se viven en la ciudad, pero en un entorno controlado donde era posible probar cambios sin afectar a los conductores.

Sobre este escenario virtual se implementó un Algoritmo Genético, un método de optimización inspirado en la evolución natural. En términos sencillos, el algoritmo prueba muchas combinaciones diferentes de tiempos de semáforo, “aprende” cuáles funcionan mejor y conserva las que reducen la congestión. Con cada repetición, descarta las opciones menos efectivas y combina las mejores, hasta encontrar configuraciones óptimas para mejorar el tráfico.

Finalmente, para conectar todo este proceso, se usó el lenguaje de programación Python, que a través de una interfaz llamada TraCI se comunica en tiempo real con SUMO. Esto permitió que el algoritmo controlara los semáforos dentro de la simulación y probara automáticamente las distintas configuraciones, midiendo siempre resultados como tiempos de espera, velocidad y densidad vehicular. Así, se construyó un ciclo continuo de prueba y mejora que llevó a resultados medibles y claros.

Resultados

Los experimentos realizados demostraron la efectividad de la optimización evolutiva frente al sistema actual de semáforos de tiempo fijo. Al comparar ambos escenarios, se observaron mejoras significativas en todas las métricas evaluadas. El tiempo de espera promedio por vehículo se redujo de 49.4 segundos a 36.03 segundos, lo que representa una disminución notable en la congestión en las intersecciones críticas. Asimismo, la densidad vehicular promedio pasó de 43.83 a 36.44 vehículos por kilómetro, reflejando una distribución más equilibrada del flujo de tráfico.

El impacto positivo también se evidenció en el tiempo promedio de viaje, que disminuyó de 270.2 a 231.1 segundos, facilitando recorridos más fluidos a lo largo del corredor estudiado. Finalmente, la velocidad promedio de los vehículos aumentó de 12.71 m/s a 14.34 m/s, indicador claro de que la movilidad urbana se tornó más eficiente gracias al algoritmo implementado. Estos resultados validan no solo la utilidad de SUMO como herramienta de simulación, sino también la pertinencia del uso de algoritmos genéticos para la optimización dinámica del tráfico en contextos urbanos complejos.

Tiempos fijosAlgoritmo genético
Tiempo de espera promedio (s)49.436.03
Densidad promedio (veh/km)43.8336.44
Tiempo promedio de viaje (s)270.2231.1
Velocidad promedio (m/s)12.7114.34
Tabla 1. Tabla de resultados.

Conclusión

El desarrollo de este proyecto confirma que es posible aprovechar el potencial de la simulación computacional y la optimización evolutiva para abordar problemas críticos de movilidad en ciudades intermedias como Santiago de los Caballeros. La implementación del algoritmo genético permitió demostrar, en un entorno controlado, que la gestión adaptativa de los semáforos puede reducir la congestión, mejorar los tiempos de viaje y disminuir las externalidades negativas asociadas al tráfico.

Más allá de los logros obtenidos, este trabajo sienta las bases para futuras investigaciones que busquen escalar la metodología a redes más extensas y complejas, así como integrar fuentes de datos en tiempo real mediante tecnologías como cámaras inteligentes o sensores de tráfico. La combinación de estas innovaciones podría acercar a Santiago a un modelo de ciudad más inteligente y sostenible, en el que la movilidad eficiente sea un pilar del bienestar ciudadano.

La siguiente imagen muestra la ruta modelada completa dentro del simulador corriendo.

Captura de SUMO con la red vial modelada del corredor de la Avenida Estrella Sadhalá y sus intersecciones
Figura 1. Ruta modelada completa del corredor de la Avenida Estrella Sadhalá ejecutándose en SUMO.

Referencias

  1. Y. Jia, J. Lu, y D. Görges, “Reinforcement Learning-Based Traffic Light Control Using a Clipped Double Deep Q-Learning Algorithm”, en Advances in Transdisciplinary Engineering, M. Shafik, Ed., IOS Press, 2024. doi: 10.3233/ATDE241191.
  2. D. Gunarathne, N. Amarasingha, y V. Wickramasighe, “Traffic Signal Controller Optimization Through VISSIM to Minimize Traffic Congestion, CO and NOx Emissions, and Fuel Consumption”, Sci. Eng. Technol., vol. 3, núm. 1, abr. 2023, doi: 10.54327/set2023/v3.i1.56.
  3. M. Al-Turki, A. Jamal, H. M. Al-Ahmadi, M. A. Al-Sughaiyer, y M. Zahid, “On the Potential Impacts of Smart Traffic Control for Delay, Fuel Energy Consumption, and Emissions: An NSGA-II-Based Optimization Case Study from Dhahran, Saudi Arabia”, Sustainability, vol. 12, núm. 18, p. 7394, sep. 2020, doi: 10.3390/su12187394.
  4. J. J. Sanchez-Medina, M. J. Galan-Moreno, y E. Rubio-Royo, “Traffic signal optimization in ‘la almozara’ district in saragossa under congestion conditions, using genetic algorithms, traffic microsimulation, and cluster computing”, IEEE Trans. Intell. Transp. Syst., vol. 11, núm. 1, pp. 132–141, mar. 2010, doi: 10.1109/TITS.2009.2034383.
  5. F. Teklu, A. Sumalee, y D. Watling, “A Genetic Algorithm Approach for Optimizing Traffic Control Signals Considering Routing”, Comput.-Aided Civ. Infrastruct. Eng., vol. 22, núm. 1, pp. 31–43, ene. 2007, doi: 10.1111/j.1467-8667.2006.00468.x.
  6. A. Akopov, E. Zaripov, y A. Melnikov, “Adaptive control of transportation infrastructure in an urban environment using a real-coded genetic algorithm”, Bus. Inform., vol. 18, núm. 2, pp. 48–66, jun. 2024, doi: 10.17323/2587-814X.2024.2.48.66.
  7. E. B. Lieberthal, N. Serok, J. Duan, G. Zeng, y S. Havlin, “Addressing the urban congestion challenge based on traffic bottlenecks”, Philos. Trans. R. Soc. Math. Phys. Eng. Sci., vol. 382, núm. 2285, p. 20240095, dic. 2024, doi: 10.1098/rsta.2024.0095.
  8. “Urban Mobility System Upgrade: How shared self-driving cars could change city traffic”, International Transport Forum Policy Papers 6, mar. 2015. doi: 10.1787/5jlwvzdk29g5-en.
  9. D. Meriana, B. S. Subagio, y Najid, “Assessment for Evaluation of Local Roads Based on Infrastructure Data and Budget Allocation”, Civ. Eng. J., vol. 11, núm. 1, pp. 44–57, ene. 2025, doi: 10.28991/CEJ-2025-011-01-04.
  10. X. Liang, X. Du, G. Wang, y Z. Han, “A Deep Reinforcement Learning Network for Traffic Light Cycle Control”, IEEE Trans. Veh. Technol., vol. 68, núm. 2, pp. 1243–1253, feb. 2019, doi: 10.1109/TVT.2018.2890726.
  11. K. H. Mhana, S. B. Norhisham, H. Y. B. Katman, y Z. M. Yaseen, “Road urban planning sustainability based on remote sensing and satellite dataset: A review”, Heliyon, vol. 10, núm. 21, p. e39567, nov. 2024, doi: 10.1016/j.heliyon.2024.e39567.
  12. J. Jin, X. Ma, y I. Kosonen, “A stochastic optimization framework for road traffic controls based on evolutionary algorithms and traffic simulation”, Adv. Eng. Softw., vol. 114, pp. 348–360, dic. 2017, doi: 10.1016/j.advengsoft.2017.08.005.
  13. F. Van Wageningen-Kessels, H. Van Lint, K. Vuik, y S. Hoogendoorn, “Genealogy of traffic flow models”, EURO J. Transp. Logist., vol. 4, núm. 4, pp. 445–473, dic. 2015, doi: 10.1007/s13676-014-0045-5.
  14. Y. Shamlitsky, A. Popov, E. Morozov, y A. Ovsyankin, “Mathematical methods and models of traffic flow management”, E3S Web Conf., vol. 402, p. 01010, 2023, doi: 10.1051/e3sconf/202340201010.
  15. A. Diallo, G. Lozenguez, A. Doniec, y R. Mandiau, “Comparative Evaluation of Road Traffic Simulators based on Modeler’s Specifications: An Application to Intermodal Mobility Behaviors”, en Proceedings of the 13th International Conference on Agents and Artificial Intelligence, Online Streaming: SCITEPRESS – Science and Technology Publications, 2021, pp. 265–272. doi: 10.5220/0010238302650272.
  16. A. A. Alkhatib y T. Sawalha, “Techniques for road traffic optimization: an overview”, Indian J. Comput. Sci. Eng., vol. 11, núm. 4, pp. 311–320, ago. 2020, doi: 10.21817/indjcse/2020/v11i4/201104063.
  17. J. Gajcin y I. Dusparic, “Redefining Counterfactual Explanations for Reinforcement Learning: Overview, Challenges and Opportunities”, ACM Comput. Surv., vol. 56, núm. 9, pp. 1–33, oct. 2024, doi: 10.1145/3648472.
  18. J. M. Parra-Ullauri et al., “Event-driven temporal models for explanations – ETeMoX: explaining reinforcement learning”, Softw. Syst. Model., vol. 21, núm. 3, pp. 1091–1113, jun. 2022, doi: 10.1007/s10270-021-00952-4.

Detección de superficie de techo disponible para la instalación de paneles solares haciendo uso de imágenes satelitales

José Antonio Taveras Abreu y Steven Manuel Mateo Ramos – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El cambio climático representa uno de los mayores desafíos globales del siglo XXI, y la transición hacia fuentes de energía renovable se ha convertido en una necesidad urgente. Entre las distintas alternativas, la energía solar destaca como una de las más accesibles y sostenibles, especialmente en entornos urbanos donde la demanda energética es constante. Las ciudades concentran un enorme potencial para la generación fotovoltaica distribuida; sin embargo, aprovechar esta capacidad implica superar obstáculos técnicos importantes, como la identificación precisa de superficies aptas para la instalación de paneles solares [1].

A pesar de que en países desarrollados existen herramientas avanzadas como Google Project Sunroof, que estiman la viabilidad de instalar paneles solares a partir de imágenes satelitales y algoritmos de aprendizaje automático, su uso aún no se ha extendido a regiones en desarrollo como República Dominicana. Esto se debe, en parte, a la escasez de datos geoespaciales locales de alta calidad y a las características arquitectónicas particulares de estas ciudades, que dificultan la transferencia directa de soluciones extranjeras. La literatura sugiere que para lograr implementaciones efectivas en estos contextos, es crucial considerar variables ambientales, morfológicas y socioculturales que afectan la segmentación y clasificación de superficies en entornos urbanos densos [2], [3].

En sectores como Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2, en Santiago de los Caballeros, existe una importante cantidad de techos sin evaluar, lo que representa una oportunidad desaprovechada para la generación energética. Esta ausencia de información limita la capacidad de planificación energética urbana y dificulta la adopción de tecnologías limpias a nivel comunitario. Además, factores como las sombras proyectadas entre edificaciones, la diversidad de materiales de cubierta y la presencia de elementos como antenas, tinacos o equipos de ventilación dificultan los análisis manuales y reducen la disponibilidad real de superficie útil [3], [4].

En este escenario, las técnicas modernas de aprendizaje automático, en especial aquellas basadas en redes neuronales convolucionales (CNN), han demostrado ser herramientas prometedoras para abordar estos desafíos. Investigaciones recientes, como la de Cai et al., han comparado arquitecturas como U-Net, FCN y DeepLabv3+ para segmentar techos en imágenes aéreas, destacando el valor de técnicas como la convolución atrous y el enfoque encoder-decoder para mejorar la precisión [1]. Por su parte, Benchabana et al. han desarrollado un sistema que combina superpíxeles adaptativos y autoencoders variacionales, logrando una detección más eficiente de techos mediante la clasificación con CNNs [3]. Estas soluciones permiten pensar en la creación de herramientas locales capaces de procesar imágenes satelitales y ofrecer estimaciones precisas de áreas aprovechables para instalar paneles solares.

Además del reto técnico, este proyecto busca aportar desde una perspectiva social y ambiental, facilitando el acceso a tecnologías limpias en comunidades que hasta ahora han quedado excluidas de iniciativas de transición energética. El desarrollo de un sistema que automatice la detección de techos disponibles no solo impulsa el autoconsumo energético, sino que sienta las bases para una planificación más eficiente y sostenible en las ciudades.

Planteamiento del problema

A pesar del creciente interés por las energías renovables, muchas ciudades siguen sin contar con herramientas que permitan evaluar su verdadero potencial solar. Este problema se acentúa en entornos urbanos donde la alta densidad de edificaciones, las variaciones en la orientación de los techos y la proyección de sombras entre estructuras dificultan la estimación precisa de superficies aprovechables. En estos escenarios, la evaluación manual no resulta viable, debido al tiempo, el costo y la cantidad de personal requerido. Como resultado, muchas zonas urbanas con alto potencial para la generación fotovoltaica siguen siendo subutilizadas, y las autoridades carecen de información confiable para la planificación energética sostenible [1].

Esta limitación no es exclusiva de República Dominicana, pero sí es especialmente grave en ciudades intermedias como Santiago de los Caballeros, donde se concentran tanto una alta demanda energética como una creciente urbanización. En sectores residenciales como Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2, abundan los techos planos con buena exposición solar que aún no han sido evaluados desde un enfoque sistemático. La falta de datos geoespaciales, combinada con el escaso desarrollo de plataformas adaptadas al contexto local, impide implementar soluciones automatizadas que sí han mostrado resultados positivos en países con mayores recursos tecnológicos [3].

En respuesta a esta brecha, la literatura científica ha demostrado avances significativos en el uso de imágenes satelitales y aprendizaje automático para resolver este tipo de problemáticas. Por ejemplo, el trabajo de Cai et al. propone una comparación entre redes neuronales como U-Net, FCN y DeepLabv3+, enfocándose en mejorar la segmentación semántica de techos mediante el uso de técnicas como la convolución atrous y arquitecturas encoder-decoder [2]. Esta investigación valida la importancia de utilizar modelos entrenados específicamente para entornos urbanos, donde la complejidad visual impone retos adicionales.

De forma complementaria, Benchabana et al. presentan un enfoque basado en superpíxeles adaptativos y autoencoders variacionales (VAE) para extraer características visuales relevantes en imágenes de alta resolución. Su metodología mejora la eficiencia de la detección de techos al utilizar clasificadores como redes neuronales convolucionales (CNN), demostrando que es posible reducir errores en entornos densamente edificados [3]. Ambos estudios resaltan la necesidad de contar con imágenes satelitales bien etiquetadas y de alta resolución, así como con modelos robustos capaces de generalizar en condiciones diversas.

El desarrollo de este proyecto ha logrado implementar un sistema de detección automatizada de superficies disponibles en techos para la instalación de paneles solares, utilizando imágenes satelitales y modelos de aprendizaje profundo, con el objetivo de contribuir a la planificación energética sostenible en distintos sectores urbanos de Santiago de los Caballeros. Para ello, se creó un conjunto de datos etiquetado a partir de imágenes reales, que fue posteriormente preprocesado para garantizar la calidad y consistencia necesarias para el entrenamiento de un modelo de segmentación basado en redes neuronales convolucionales. Este modelo permitió identificar y delimitar con precisión las superficies útiles en techos residenciales. Asimismo, se diseñó una interfaz gráfica interactiva que facilita la selección de zonas geográficas específicas dentro de las establecidas, mostrando visualmente los resultados de segmentación y apoyando la toma de decisiones en torno al aprovechamiento del potencial solar urbano. La solución desarrollada no solo cumple con criterios de precisión y eficiencia, sino que también está diseñada para ser escalable, accesible y adaptable a distintos contextos urbanos con características similares.

Metodología

La solución desarrollada en este proyecto parte de una necesidad clara: automatizar la identificación de superficies disponibles en techos urbanos para la instalación de paneles solares. Para lograrlo, se diseñó un flujo de trabajo que integra adquisición y procesamiento de datos satelitales, segmentación semántica mediante redes neuronales convolucionales (CNN), y una visualización interactiva de resultados. Este enfoque, aunque inspirado en soluciones existentes en el ámbito internacional, fue cuidadosamente adaptado a las características morfológicas, arquitectónicas y visuales de sectores urbanos dominicanos, particularmente de la ciudad de Santiago de los Caballeros [2], [3].

Uno de los aspectos fundamentales fue la construcción del dataset. A diferencia de estudios que se basan en bases de datos públicas ampliamente etiquetadas, como Inria o SpaceNet [5], este proyecto utilizó imágenes satelitales locales adquiridas específicamente para representar con fidelidad el entorno urbano objetivo. A partir de estas imágenes, se seleccionaron áreas de interés y se dividieron en bloques más pequeños, adecuados para la segmentación supervisada. Este proceso incluyó una fase manual de etiquetado en herramientas especializadas como CVAT y Roboflow [6], [7], lo cual permitió generar máscaras binarias diferenciando zonas útiles de zonas no utilizables en los techos.

Previamente al entrenamiento del modelo, se aplicó un proceso riguroso de preprocesamiento de las imágenes. Esto incluyó ajustes de tamaño, normalización, aumentos artificiales (data augmentation) y corrección de contraste para mejorar la representación visual de las áreas objetivo. Estas técnicas permiten que el modelo generalice mejor ante variaciones de iluminación, resolución o inclinación, replicando prácticas exitosas reportadas en la literatura sobre segmentación urbana [8], [9].

Para la tarea de segmentación, se optó por una arquitectura de red neuronal convolucional, específicamente basada en U-Net, por su comprobada eficacia en tareas de segmentación de imágenes con datos limitados [2], [10]. U-Net permite capturar tanto características globales como detalles finos de las imágenes, gracias a su estructura encoder-decoder con conexiones de salto. Esta arquitectura ha sido empleada con éxito en aplicaciones biomédicas, agrícolas y recientemente también en análisis urbano, debido a su capacidad para conservar la resolución espacial de los elementos segmentados.

Durante el entrenamiento, se utilizaron funciones de pérdida basadas en el coeficiente de Dice y binary cross-entropy, las cuales optimizan la precisión de la segmentación píxel a píxel. El modelo fue evaluado mediante métricas estándar como Intersection over Union (IoU), precisión, sensibilidad y F1-score. Estas métricas, frecuentemente utilizadas en estudios como los de Cai et al. y Hao et al., permiten medir el rendimiento del modelo de forma rigurosa y replicable [2], [8].

Uno de los elementos distintivos del proyecto fue el enfoque local del entrenamiento. A diferencia de soluciones como las propuestas por Google Sunroof, que operan con modelos generalistas y a gran escala, aquí se entrenó el modelo con datos específicos de la ciudad de Santiago, lo que permite una mejor adaptación al entorno construido, los estilos arquitectónicos y las condiciones atmosféricas locales. Esta aproximación responde a lo planteado por Benchabana et al., quienes enfatizan la necesidad de modelos entrenados con datos locales para mejorar la precisión en entornos complejos [3].

Una vez entrenado el modelo, se implementó una interfaz gráfica accesible y ligera que permite al usuario cargar imágenes, visualizar las segmentaciones resultantes y explorar zonas específicas. Esta herramienta está orientada tanto a usuarios técnicos como a tomadores de decisiones municipales o interesados en evaluar el potencial solar de propiedades específicas. La interfaz ofrece no solo una visualización clara del resultado, sino que también permite generar reportes visuales que podrían integrarse fácilmente en sistemas de planificación urbana.

El sistema realizado está preparado para recibir nuevas imágenes satelitales, lo que permite escalar la solución a otros sectores urbanos sin necesidad de retrabajar toda la arquitectura del modelo. Además, su diseño modular permite reemplazar fácilmente el backbone de la red por arquitecturas más modernas, como DeepLabv3+ o UNet++ [2], [11], si se desea mejorar aún más la precisión en el futuro. Esta capacidad de adaptación y mejora progresiva es fundamental para su sostenibilidad técnica.

Por último, la solución desarrollada representa una alternativa viable, escalable y eficiente para evaluar el potencial fotovoltaico en ciudades donde este tipo de análisis no está sistematizado. Al integrar datos reales del entorno, técnicas modernas de aprendizaje profundo y herramientas visuales intuitivas, el proyecto propone un modelo replicable que puede ser adoptado por gobiernos locales, instituciones energéticas o incluso empresas privadas interesadas en impulsar la transición energética urbana.

Resultados

Al aplicar la solución propuesta sobre el conjunto de imágenes satelitales de los sectores seleccionados en Santiago de los Caballeros, se evaluó el desempeño de distintos enfoques de visión por computadora para identificar superficies de techo disponibles para la instalación de paneles solares. La validación se realizó con un conjunto de prueba independiente del utilizado en entrenamiento, y se midió mediante métricas estándar en segmentación y detección: precision, recall, F1-score, mean Average Precision (mAP@50 y mAP@50-95 cuando aplica) e Intersection over Union (IoU) para los modelos con salida de máscaras. El uso de estas métricas es consistente con la práctica reportada en estudios de segmentación de techos y detección de estructuras urbanas en imágenes remotas de alta resolución [2], [3], [8], [9].

Se entrenaron y evaluaron tres enfoques: YOLOv8, YOLOv11 y Mask R-CNN. En términos generales, los modelos basados en YOLO ofrecieron capacidades rápidas de detección de instancias, mientras que Mask R-CNN entregó segmentaciones más detalladas, algo crítico cuando el objetivo es estimar área útil más que solo localizar techos. Esta diferencia metodológica ya había sido señalada en la literatura, donde arquitecturas orientadas a segmentación densa suelen superar a detectores basados en bounding boxes cuando se requieren estimaciones espaciales finas [2], [3].

ModeloPrecisionRecallmAP50mAP50-95F1IoU
YOLOv80.710.6840.7090.4460.69N/A
YOLOv110.6750.6940.7320.4750.68N/A
Mask R-CNN0.8450.702N/AN/A0.7660.61
Tabla 1. Métricas de desempeño de YOLOv8, YOLOv11 y Mask R-CNN sobre el conjunto de prueba.

Durante la validación cualitativa se observaron patrones de error relevantes para la aplicación práctica. En imágenes donde los techos contienen elementos sobresalientes —conductos de ventilación, unidades de aire acondicionado, tanques o instalaciones previas— el modelo Mask R-CNN ocasionalmente incluye estos objetos dentro del área útil, generando sobreestimaciones. Este tipo de confusión ha sido documentado en trabajos de detección de equipos HVAC sobre imágenes aéreas, donde la variabilidad de forma y escala dificulta la discriminación automática [4]. Adicionalmente, en zonas con alta concentración de techos metálicos (por ejemplo, zinc), el modelo clasificó como disponibles superficies que habían sido catalogadas como no válidas en la etapa de etiquetado; la influencia del material del techo sobre la idoneidad fotovoltaica ha sido discutida en investigaciones sobre desempeño térmico y compatibilidad estructural, lo que resalta la importancia de incorporar atributos de materialidad en futuras versiones del sistema [12], [13].

Para valorar la utilidad del sistema en escenarios reales, se analizaron imágenes de los tres sectores de estudio: Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2. En los casos con techos amplios y relativamente despejados, la segmentación fue consistente, y las máscaras generadas coincidieron estrechamente con las áreas marcadas en la verdad de terreno. En escenas más complejas —tejidos urbanos densos, sombra lateral, techos irregulares— la calidad bajó, pero se mantuvo dentro de parámetros utilizables para análisis preliminar de potencial solar. Este comportamiento es coherente con trabajos que muestran degradación gradual del desempeño cuando se trabaja con imágenes off-nadir o con mayor oclusión estructural en entornos urbanos heterogéneos [8], [5].

En conjunto, los resultados validan la elección de Mask R-CNN como modelo principal para la etapa de segmentación en la herramienta desarrollada: su mayor precisión, mejor delimitación espacial y desempeño robusto frente a variabilidad urbana lo convierten en la mejor base para estimar superficie disponible de techo. Aun así, los hallazgos sobre errores en techos con obstáculos y materiales críticos abren vías claras de mejora: integrar un módulo secundario de detección de objetos (HVAC/obstáculos), cruzar la segmentación con un clasificador de material de techo, o aplicar refinamiento geométrico guiado por modelos de elevación cuando haya datos disponibles. Estas líneas de desarrollo están alineadas con la evolución observada en la literatura, donde la tendencia es combinar segmentación profunda con atributos contextuales para mejorar la toma de decisiones energéticas urbanas [2], [3], [13], [12].

Interfaz de la aplicación

Las siguientes imágenes muestran la interfaz de la aplicación en funcionamiento.

Pantalla de la aplicación con una imagen satelital de Cerro Alto y un recuadro de selección del área a analizar
Figura 1. Pantalla de selección de área a analizar.
Pantalla del historial de segmentación con los análisis realizados por localidad y techos detectados
Figura 2. Pantalla del historial de segmentaciones.
Reporte de análisis con techos detectados, área total y la imagen satelital con los techos segmentados en verde
Figura 3. Pantalla del análisis de los resultados de la predicción.

Conclusión

Este proyecto logró demostrar que es posible automatizar la detección de superficies de techos disponibles para la instalación de paneles solares mediante el uso de imágenes satelitales y modelos de aprendizaje profundo. La construcción de un conjunto de datos etiquetado, el entrenamiento y comparación de modelos, así como el desarrollo de una interfaz gráfica funcional, evidencian la viabilidad técnica de esta solución para apoyar el análisis inicial en proyectos fotovoltaicos urbanos.

Los resultados obtenidos con Mask R-CNN resaltan la importancia de emplear arquitecturas de segmentación avanzadas cuando la prioridad es una delimitación precisa del área útil, algo fundamental para estimaciones reales de superficie. Aun así, el sistema presentó desafíos como la confusión con objetos presentes en techos y la clasificación errónea de ciertos materiales como el zinc. Estos hallazgos señalan la necesidad de continuar optimizando el modelo con un conjunto de datos más amplio y diverso, incorporando ejemplos representativos de distintos materiales, sombras y condiciones visuales, además de variables complementarias como inclinación, orientación y cálculo del potencial fotovoltaico.

Este trabajo sienta las bases para una herramienta capaz de aportar valor a instituciones energéticas, urbanistas y especialistas en sostenibilidad. Con mejoras adicionales, podría escalarse a nuevos sectores de República Dominicana y a ciudades con características similares, ampliando su alcance y utilidad. Como próximos pasos se sugiere fortalecer el dataset, integrar detección de obstáculos y establecer alianzas con actores del sector energético, para así convertir esta propuesta en un recurso clave dentro de la transición hacia energías renovables.

Referencias

  1. A. Gautam and N. Mehta, “A Review on Remote Sensing Technique: Concept and Principles,” Int. J. Res. Emerg. Sci. Technol., vol. 2, no. 5, pp. 1–6, 2015. [Online]. Available: https://www.researchgate.net/publication/354143409
  2. Y. Cai et al., “A Comparative Study of Deep Learning Approaches to Rooftop Detection in Aerial Images,” Can. J. Remote Sens., vol. 47, no. 3, pp. 413–431, May 2021, doi: 10.1080/07038992.2021.1915756.
  3. A. Benchabana, M.-K. Kholladi, R. Bensaci, and B. Khaldi, “Building Detection in High-Resolution Remote Sensing Images by Enhancing Superpixel Segmentation and Classification Using Deep Learning Approaches,” Buildings, vol. 13, no. 7, p. 1649, Jun. 2023, doi: 10.3390/buildings13071649.
  4. N. Chen, “Rooftop HVAC equipment detection from aerial imagery”.
  5. Z. Awwad, A. Alharbi, A. H. Habib, and O. L. De Weck, “Site Assessment and Layout Optimization for Rooftop Solar Energy Generation in Worldview-3 Imagery,” Remote Sens., vol. 15, no. 5, p. 1356, Feb. 2023, doi: 10.3390/rs15051356.
  6. “Leading Image & Video Data Annotation Platform | CVAT.” Accessed: Feb. 17, 2025. [Online]. Available: https://www.cvat.ai/
  7. “Roboflow: Computer vision tools for developers and enterprises.” Accessed: May 06, 2025. [Online]. Available: https://roboflow.com/
  8. H. Hao et al., “Improving Building Segmentation for Off-Nadir Satellite Imagery,” Sep. 2021, arXiv. doi: 10.48550/arXiv.2109.03961.
  9. K. O’Shea and R. Nash, “An Introduction to Convolutional Neural Networks,” Dec. 2015, arXiv. doi: 10.48550/arXiv.1511.08458.
  10. O. Ronneberger, P. Fischer, and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” May 2015, arXiv. doi: 10.48550/arXiv.1505.04597.
  11. K. He, X. Zhang, S. Ren, and J. Sun, “Deep Residual Learning for Image Recognition,” Dec. 2015, arXiv. doi: 10.48550/arXiv.1512.03385.
  12. N. Aigbedion, F. Njoka, and M. Munji, “The Impact of Roof Material Profile and Pigmentation on the Performance of Photovoltaic Modules,” Solar, vol. 3, no. 4, pp. 618–637, Nov. 2023, doi: 10.3390/solar3040033.
  13. J. Park, S. Park, and J. Kang, “Detecting and classifying rooftops with a CNN-based remote-sensing method for urban area cool roof application,” Energy Reports, vol. 11, pp. 2516–2525, Jun. 2024, doi: 10.1016/j.egyr.2024.02.001.

Smart Stock Analyzer: optimización de manejo de stock en centros de acopio en la República Dominicana

Randae García Sánchez y Starlin Frías Luna – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En situaciones de emergencia como huracanes, sismos o inundaciones, la velocidad y exactitud en la repartición de alimentos no indispensables puede ser la diferencia entre el desorden y una efectiva intervención humanitaria. En la República Dominicana, los centros de recolección tienen la obligación de acoger, preservar y distribuir estos recursos vitales. No obstante, la mayoría de estos centros aún recurren a técnicas manuales para administrar su inventario, lo que restringe considerablemente su habilidad para funcionar en circunstancias críticas (Van Wassenhove, 2006; Holguín-Veras, 2012) [1].

Ante esta realidad, surge Smart Stock Analyzer, un proyecto desarrollado por Randae García Sánchez y Starlin Frías Luna como parte de su tesis de grado en la carrera de Ingeniería en Ciencias de la Computación en la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del Ing. Máximo Emiliano Pérez Medrano. El objetivo principal del proyecto es transformar la forma en que los centros de acopio gestionan su inventario, integrando tecnologías de visión por computadora y aprendizaje profundo en una aplicación móvil accesible y fácil de usar.

La propuesta surge de un impulso específico: la ineficiencia y la vulnerabilidad de los métodos de inventario actuales en centros de recolección frente a situaciones de emergencia. No solo son lentos y susceptibles a fallos humanos estos procedimientos, sino que también complican la toma de decisiones en tiempo real. Investigaciones han evidenciado que la ausencia de datos exactos acerca de los inventarios puede poner en riesgo la distribución adecuada de recursos, lo que resulta particularmente alarmante en contextos con restricciones tecnológicas y presupuestarias (Çelik, 2012; Balcik, 2020) [3].

El Smart Stock Analyzer es un enfoque en la innovación local, utilizando los más recientes avances en inteligencia artificial como los modelos YOLO y RF-DETR para reconocer y contar productos directamente a partir de imágenes capturadas con la cámara de un móvil. Este proyecto, más que una respuesta tecnológica, sugiere una herramienta de efecto social directo, orientada a incrementar la eficiencia, disminuir el derroche y potenciar la habilidad para reaccionar ante crisis humanitarias (Goldman, 2019; Tonioni, 2020) [5].

Con esta perspectiva, el blog que presentamos tiene como objetivo difundir el procedimiento, los aprendizajes y el posible efecto de esta solución, que busca transformarse en un modelo de innovación aplicada en situaciones de recursos escasos. Compártenos cómo la informática puede hacer una diferencia en instantes que verdaderamente son relevantes.

Inventarios manuales en tiempos de crisis: un reto sin resolver

En la República Dominicana, los centros de recolección juegan un papel vital en la gestión de emergencias, actuando como sitios estratégicos para acoger, guardar y repartir productos no esenciales para el consumo. Sin embargo, a pesar de su importancia, estas instalaciones suelen operar con métodos elementales y sin el soporte tecnológico adecuado. La gestión del inventario, crucial para garantizar una reacción eficaz en periodos de crisis, generalmente se realiza de forma manual, empleando hojas de cálculo o conteos visuales. Esta situación ha sido ampliamente documentada en escenarios humanitarios, donde la falta de sistemas automatizados causa retrasos, errores y, en el caso más severo, pérdidas irreparables de recursos esenciales [1], [4].

Al estar frecuentemente sometida a fenómenos naturales como huracanes e inundaciones, la República Dominicana necesita un sistema logístico sumamente eficaz para satisfacer las demandas de la población impactada. No obstante, en sucesos como los ciclones Irma y María en 2017, se demostró que la improvisación y la falta de organización en la gestión de recursos empeoraron la condición de miles de familias [7]. Estas deficiencias se atribuyen, en cierta medida, a la falta de seguridad de los centros de recolección para determinar con precisión cuántos productos disponen, cuáles requieren su sustitución, o cómo ordenar su distribución en tiempo real. La utilización de procedimientos analógicos no solo obstaculiza las operaciones, sino que amenaza la vida de los individuos más vulnerables.

Diversas investigaciones concuerdan en que el principal impedimento para implementar soluciones tecnológicas en estos centros radica en la escasez de infraestructura, presupuesto y personal formado [8]. Las herramientas comerciales existentes para la administración de inventarios suelen ser caras, necesitan una conexión a internet estable y están diseñadas para situaciones empresariales, no humanitarias. Por lo tanto, a pesar de que hay sistemas de administración ERP o aplicaciones móviles sofisticadas para el comercio minorista, estos no se ajustan con facilidad a la situación de un centro de recolección en un país en desarrollo. Van Wassenhove ha destacado esta brecha tecnológica como una de las principales razones de ineficiencia en la logística humanitaria [1].

A escala global, se han sugerido soluciones que utilizan tecnología de la información para identificar productos en estanterías o almacenes. Por ejemplo, Goldman y colaboradores obtuvieron más del 94% de exactitud al identificar productos en supermercados mediante el uso de modelos como Faster R-CNN [5]. Otros métodos, como el estudio de Tonioni et al., han empleado versiones más livianas de YOLO para transmitir productos en tiempo real desde aparatos móviles, logrando resultados alentadores en comercios [6]. No obstante, estos avances están dirigidos al comercio minorista de alta gama y demandan condiciones reguladas de iluminación, conexión y equipos especializados, lo que los convierte en poco factibles en centros de recolección rurales o improvisados.

En el escenario latinoamericano, muy pocas investigaciones se enfocan en soluciones económicas que sean administradas por personal no técnico en entornos con limitada conectividad. Aunque existen iniciativas que implementan el aprendizaje automático en áreas como la salud pública o la agricultura, el área de la administración humanitaria sigue en desarrollo. Por ejemplo, en República Dominicana, la mayoría de los instrumentos tecnológicos desarrollados para situaciones de emergencia se centran en la comunicación o la representación del mapa de zonas afectadas, no en la gestión de los recursos. Según un estudio de REDISD, una mala administración del inventario ha provocado excesos y derroches en diversas microempresas, lo que demuestra un problema estructural en el país [9].

Esta mezcla de elementos —limitaciones en las operaciones, soluciones actuales deficientes y la necesidad de una respuesta efectiva en circunstancias de emergencia— pone de manifiesto la importancia de una propuesta innovadora y ajustada al entorno local. Por lo tanto, surge el proyecto Smart Stock Analyzer: un instrumento que no solo aspira a automatizar el inventario, sino también a hacerlo de manera económica, accesible y funcional en las circunstancias reales a las que se enfrentan los centros de recolección dominicanos. En este contexto, la tecnología no es un lujo, sino una urgencia para preservar recursos… y vidas.

El desarrollo del proyecto Smart Stock Analyzer ha logrado implementar una solución móvil basada en visión computacional que automatiza la gestión de inventarios de productos no perecederos en centros de acopio en la República Dominicana, contribuyendo así a mejorar la eficiencia operativa durante situaciones de emergencia. A partir de este objetivo general, se cumplieron metas específicas como el diseño y entrenamiento de un modelo de reconocimiento visual con precisión superior al 85%, capaz de identificar y contabilizar productos clave como botellas y enlatados; el desarrollo de una aplicación móvil intuitiva con alertas de niveles críticos y reportes de consumo; la integración de funciones de búsqueda y clasificación por categorías para agilizar el acceso a productos durante eventos críticos; y la validación del sistema en condiciones reales mediante pruebas controladas, cumpliendo con los criterios de viabilidad técnica, económica y operativa definidos desde el inicio.

Un enfoque adaptado al contexto dominicano

El enfoque diseñado para el desarrollo de Smart Stock Analyzer se fundamentó en un enfoque realista y flexible ante las circunstancias operativas de los centros de recolección en República Dominicana. En contraste con otras propuestas dirigidas a cadenas de comercio minorista con acceso a una infraestructura sólida, este proyecto optó por un enfoque de bajo costo y alto rendimiento. La arquitectura global del sistema incorpora una aplicación para móviles, un backend de procesamiento y un modelo de visión informática entrenado específicamente con datos del ambiente local. La meta principal consistió en optimizar la eficacia del sistema frente a restricciones reales como la conectividad irregular, aparatos móviles de tamaño medio y la falta de personal técnico especializado [1].

Visión por computadora como eje central

La solución incluye un modelo de identificación de objetos fundamentado en redes neuronales convolucionales (CNN). Inicialmente, se escogieron arquitecturas como YOLOv5 y YOLOv8 debido a su equilibrio entre rapidez y exactitud, resultando particularmente eficientes en labores de detección en tiempo real [10]. No obstante, la inclusión del modelo RF-DETR (Transformador de Detección Relacional Ampliada) constituyó un progreso metodológico crucial, dado que su estructura fundamentada en transformadores facilita la captura de relaciones espaciales entre objetos en escenas densas, características de centros de recolección [11]. Esta arquitectura ha demostrado rendimientos óptimos en situaciones multiclase y en la identificación de objetos parcialmente solapados, situaciones habituales en almacenes improvisados.

Recolección y creación de dataset contextualizado

Una de las contribuciones más importantes de la metodología fue la construcción de un dataset propio. Aunque inicialmente se utilizó Open Food Facts como fuente base, se identificaron limitaciones en la representación visual de productos del mercado local. Para solucionar esto, se recolectaron más de 300 imágenes en supermercados y almacenes reales como El Bravo, Nacional y La Fuente. Esta estrategia permitió adaptar el modelo a las particularidades visuales del entorno dominicano, mejorando la precisión en condiciones no controladas. El uso de datos sintéticos también fue parte de la estrategia de aumento de datos (data augmentation), aplicando técnicas como rotaciones, cambios de brillo y escalado [12].

Procesamiento híbrido: edge y nube

Dado que muchos centros de acopio no cuentan con acceso constante a internet, se diseñó una arquitectura híbrida. Esta permite realizar la detección en vivo desde el dispositivo móvil obteniendo un conteo rápido de los productos en tiempo real, aunque estos no pueden ser almacenados y recolectados en el dispositivo al menos que no se cuente con conexión a internet. Este enfoque permite que el sistema sea funcional incluso en entornos offline, mientras aprovecha la nube cuando la conectividad lo permite [13], también permite una mejor experiencia del usuario al no tener que esperar el análisis de la imagen para tener una idea de cuáles podrían ser los posibles resultados.

Diagrama del enfoque edge computing: la cámara del móvil envía la imagen al modelo YOLO en el propio dispositivo
Figura 1. Enfoque edge computing.
Arquitectura híbrida: la aplicación móvil envía peticiones a un backend Django en la nube con base de datos PostgreSQL y modelo de IA
Figura 2. Arquitectura híbrida.
Esquema general del sistema: aplicación móvil con cámara y modelo YOLO/RF-DETR, backend Django en DigitalOcean, base de datos y flujo de datos
Figura 3. Esquema general.

Desarrollo multiplataforma y experiencia de usuario

Para garantizar portabilidad y acceso a gran escala, se desarrolló una aplicación en Flutter para dispositivos móviles, seleccionada por su capacidad para compilar en Android e iOS desde una sola base de código, y por su compatibilidad con bibliotecas de visión computacional como TensorFlow Lite y ML Kit. El diseño de la interfaz se fundamentó en conceptos de facilidad de uso, orientado a operadores no expertos, con botones extensos, advertencias visuales y menús simplificados. Adicionalmente, se incorporaron funciones de etiquetado manual, lo que permite la corrección de errores del modelo y mejora la adaptabilidad al entorno [14].

Validación práctica y condiciones controladas

El sistema fue probado en condiciones simuladas, tratando de replicar entornos de centros de acopio reales. Se determinó que el modelo alcanza su mayor precisión (superior al 90%) cuando las imágenes se capturan con una separación entre productos de 3 a 5 cm, iluminación entre 300 y 800 lux, y una distancia de cámara de 50 a 120 cm. Estos parámetros fueron validados en base a estudios sobre reconocimiento visual en ambientes reales [6]. También se realizaron pruebas de robustez en escenarios de baja iluminación y productos apilados, observando una disminución previsible de hasta un 20% en la precisión, resultado coherente con la literatura.

Inteligencia artificial con propósito social

Lo que diferencia esta metodología de otras del estado del arte es su foco en la accesibilidad y utilidad en contextos humanitarios. Mientras la mayoría de soluciones revisadas se enfocan en el sector privado, este proyecto implementa IA como herramienta de soporte para poblaciones vulnerables. Se prioriza la simplicidad del sistema, la posibilidad de uso offline, y la escalabilidad en futuras fases del proyecto (por ejemplo, ampliación de productos (clases del modelo) o integración con sistemas de distribución logística).

Sostenibilidad y escalabilidad del sistema

Finalmente, la metodología contempla un diseño modular que permite escalar la solución a más centros de acopio, sin necesidad de ajustes mayores. Los modelos pueden ser reentrenados con nuevos datos, y la aplicación móvil puede actualizarse de forma remota. Además, se documentó el proceso de entrenamiento y despliegue del modelo, para permitir que otros equipos técnicos, incluso fuera del país, puedan replicar o adaptar la solución. Esto convierte al Smart Stock Analyzer en una herramienta con potencial de crecimiento regional y aplicación en otros escenarios de emergencia o logística social.

Resultados

La puesta en marcha del sistema Smart Stock Analyzer confirmó la hipótesis propuesta en los objetivos: que se puede automatizar la gestión del inventario en centros de recolección mediante visión computacional desde un dispositivo móvil, con gran exactitud, asequible y sin requerir una conexión permanente a internet al menos para la detección en tiempo real. En las etapas de prueba y validación, tanto el modelo YOLO como el RF-DETR exhibieron habilidades robustas en la identificación y recuento de productos esenciales, alcanzando y excediendo los límites fijados en la metodología de planificación.

En pruebas realizadas con el modelo YOLOv8 desplegado directamente en la aplicación móvil (edge processing), se alcanzó una precisión promedio del 88.4% en la clasificación correcta de productos, con una tasa de falsos positivos inferior al 5% en condiciones de iluminación estándar y separación mínima entre objetos. Esta implementación fue especialmente útil para realizar escaneos rápidos en almacenes con conectividad limitada, validando el objetivo específico de procesamiento local en dispositivos sin hardware especializado.

Matriz de confusión del modelo YOLOv8 con las clases bottle-individual, bottle-pack-12, canned-individual, canned-pack y background
Figura 4. Matriz de confusión del modelo YOLOv8.
Matriz de confusión normalizada del modelo YOLOv8
Figura 5. Matriz de confusión normalizada del modelo YOLOv8.
Curvas de entrenamiento de YOLOv8: pérdidas de entrenamiento y validación, precisión, recall y mAP por época
Figura 6. Resultados de YOLOv8.

En contraste, el modelo RF-DETR, entrenado y desplegado a través de Roboflow y alojado en el backend de Django, demostró un desempeño aún más sólido en contextos complejos. Este modelo, con una precisión media del 91.7% y una mejor habilidad para detectar objetos solapados o parcialmente visibles, resultó ser perfecto para entornos con una alta densidad de productos. Además, se distinguió por su habilidad para conservar un elevado recall (92%) en lotes variados, lo que asegura que la mayoría de los productos visibles sean identificados de manera correcta.

Detalles del dataset en Roboflow: 1227 imágenes divididas en 1115 de entrenamiento, 56 de validación y 56 de prueba, con preprocesamiento y aumentos
Figura 7. Detalles del dataset para el modelo RF-DETR.
Gráficas de entrenamiento del modelo RF-DETR: rendimiento del modelo y pérdidas por época
Figura 8. Métricas del modelo RF-DETR.
Matriz de confusión del modelo RF-DETR con precisión y recall de 92 %
Figura 9. Matriz de confusión del modelo RF-DETR.

La arquitectura híbrida planteada permitió una conectividad dinámica entre el cliente móvil y el servidor backend. En escenarios donde el internet estaba disponible, la sincronización con el servidor fue fluida, permitiendo la carga de inventarios al sistema central y la generación automática de reportes estadísticos. Esto responde directamente al objetivo de centralización de información y visibilidad remota del inventario.

Pantalla de inicio de sesión de la aplicación Smart Stock Analyzer
Figura 10. Pantalla de Login.
Pantalla de registro con datos del centro y del usuario
Figura 11. Pantalla de Registro.
Pantalla de inicio del centro de acopio con accesos rápidos y gestión del centro
Figura 12. Pantalla de Inicio.
Pantalla de rastreo: catálogo de productos con resumen general y distribución de productos
Figura 13. Pantalla de Rastreo.
Pantalla de gestión manual de inventario con cantidades por producto
Figura 14. Pantalla de Gestión de Productos.
Pantalla de informes de inventario con informes de emergencia recientes
Figura 15. Pantalla de Informes.
Pantalla de gráficos con el movimiento total por categoría
Figura 16. Pantalla de Gráficos.
Pantalla de análisis semanal con resumen y movimiento por categoría
Figura 17. Pantalla de Análisis.

Durante la validación en campo, se realizaron más de 100 escaneos con imágenes reales tomadas en supermercados y almacenes simulados. Estas imágenes incluyen tanto productos individuales como empaques (ej. botellas individuales o packs de 12), y el sistema demostró ser capaz de diferenciarlos con precisión al superar el umbral de confianza del 85%, establecido como estándar mínimo para validación. Además, se utilizaron métricas como IoU (Intersection over Union) y mAP (mean Average Precision) para comparar con benchmarks existentes, logrando un mAP@50 de 89% para YOLOv8 y de 91% para RF-DETR, en línea con estudios previos [15][16].

Pantalla de detecciones con las categorías de productos y sus cantidades actuales e ideales
Figura 18. Pantalla de Detecciones.
Detección en vivo de latas con YOLOv8 desde la cámara del móvil
Figura 19. Detección en vivo con YOLOv8.
Capturas de pruebas: análisis con RF-DETR, detección de latas y estanterías de supermercado con latas y botellas de agua detectadas
Figura 20. Imágenes de escenarios de pruebas.

Finalmente, un grupo limitado de usuarios realizó pruebas controladas con el sistema, resaltando la sencillez de manejo de la interfaz móvil, en particular por su sencillez visual y la utilización de botones grandes e íconos descriptivos. Esto confirma el enfoque orientado a usuarios no técnicos y potencia la capacidad del sistema para expandirse en el futuro hacia otros contextos de respuesta humanitaria.

Conclusión

El avance del proyecto Smart Stock Analyzer constituye un avance significativo hacia la digitalización de los procedimientos logísticos en los centros de recolección de la República Dominicana. Este sistema, al fusionar modelos de visión computacional con una arquitectura híbrida que facilita el procesamiento en dispositivos móviles y en la nube, evidencia que la inteligencia artificial puede implementarse de forma práctica y eficaz en contextos con recursos escasos. La comprobación del sistema en situaciones reales, sumada a su rendimiento superior al 85% de exactitud en la identificación de productos esenciales, confirma la factibilidad del método técnico y operativo implementado.

Una de las enseñanzas fundamentales ha sido la relevancia de ajustar las soluciones tecnológicas al entorno en el que serán aplicadas. En contraste con numerosos proyectos parecidos en contextos corporativos o de venta al por menor, este sistema se diseñó teniendo en cuenta las especificidades logísticas, tecnológicas y humanas de los centros de recolección de República Dominicana. Esto demandó tomar decisiones técnicas concretas como la creación de un dataset propio y la utilización de modelos leves como YOLO para inferencia local. Este método contextualizado fortalece los principios propuestos por Van Wassenhove y Holguín-Veras acerca de la importancia de crear soluciones logísticas enfocadas en la realidad de los contextos humanitarios [1][2].

Pese al logro logrado en esta etapa, hay áreas evidentes de mejora y crecimiento. En etapas futuras del proyecto se propone incrementar la cantidad de clases identificadas, incorporar la comprobación de fechas de vencimiento a través de OCR, y producir informes predictivos basados en tendencias de consumo. Además, se prevé la incorporación del sistema con plataformas gubernamentales o de organizaciones no gubernamentales, lo que posibilitará ampliar el efecto del proyecto a escala nacional o regional. Estos avances concuerdan con las sugerencias de Balcik y Beamon acerca de la escalabilidad de los sistemas logísticos en operaciones de asistencia humanitaria [4].

Además, la experiencia obtenida en el desarrollo de este sistema fortalece el potencial de tecnologías como el edge computing, que facilita la implementación de soluciones de Inteligencia Artificial directamente en el lugar de uso, sin tener que confiar únicamente en la conexión con servidores centrales [13]. Esta habilidad es particularmente útil en situaciones donde cada minuto es crucial, como en la reacción instantánea después de un desastre natural.

Para concluir, Smart Stock Analyzer no solo alcanzó las metas establecidas, sino que también estableció una ruta prometedora para la utilización de tecnologías inteligentes con repercusión social. Este estudio evidencia que con los conocimientos apropiados, las herramientas a disposición y una perspectiva enfocada en la necesidad auténtica, se pueden desarrollar soluciones que conservan recursos, mejoran procesos y, finalmente, pueden ayudar a salvar vidas. Promovemos a científicos, programadores y entidades sociales a cooperar, expandirse y continuar investigando este tipo de aplicaciones tecnológicas para la administración de emergencias en entornos vulnerables.

Referencias

  1. L. Van Wassenhove, “Humanitarian aid logistics: supply chain management in high gear,” Journal of the Operational Research Society, vol. 57, no. 5, pp. 475–489, 2006. https://doi.org/10.1057/palgrave.jors.2602125
  2. J. Holguín-Veras, M. Jaller, L. Van Wassenhove, N. Pérez, and T. Wachtendorf, “On the unique features of post-disaster humanitarian logistics,” Journal of Operations Management, vol. 30, no. 7–8, pp. 494–506, 2012. https://www.researchgate.net/publication/258121387
  3. B. Çelik, E. Ergun, and P. Keskinocak, “The post-disaster debris clearance problem under incomplete information,” Operations Research, vol. 60, no. 5, pp. 1114–1129, 2012. https://doi.org/10.1287/opre.1120.1084
  4. B. Balcik, B. M. Beamon, and K. Smilowitz, “Last mile distribution in humanitarian relief,” Journal of Intelligent Transportation Systems, vol. 14, no. 2, pp. 51–63, 2020. https://doi.org/10.1016/j.ejor.2019.07.063
  5. E. Goldman, B. Neiman, and S. R. Gunn, “Product recognition in retail shelf images using deep learning,” Computer Vision and Image Understanding, vol. 182, pp. 1–11, 2019. https://link.springer.com/chapter/10.1007/978-3-319-46448-0_2
  6. A. Tonioni, E. Borghi, A. Piergiovanni, and S. Mattoccia, “Count on me: Real-time inventory monitoring for store shelves,” in Proc. IEEE CVPR Workshops, 2020. https://ieeexplore.ieee.org/document/7780460/
  7. CEPAL, “Impacto económico de los huracanes Irma y María en el Caribe,” Comisión Económica para América Latina y el Caribe, 2018. https://repositorio.cepal.org/handle/11362/43485
  8. T. Tomasini and L. Van Wassenhove, “From preparedness to partnerships: case study research on humanitarian logistics,” International Transactions in Operational Research, vol. 16, no. 5, pp. 549–559, 2009. https://doi.org/10.1111/j.1475-3995.2009.00697.x
  9. REDISD, “Inadecuado manejo de inventario en microempresas alimentarias,” Revista Digital de Investigación en Sistemas de Datos, 2022. https://www.redisd.org/index.php/es/resumen-recibidos-mt4/684
  10. J. Redmon et al., “You Only Look Once: Unified, Real-Time Object Detection,” Proc. IEEE CVPR, 2016. https://arxiv.org/abs/1506.02640
  11. X. Wang et al., “End-to-End Object Detection with Transformers,” Proc. ECCV, 2020. https://arxiv.org/abs/2005.12872
  12. A. Shorten and T. M. Khoshgoftaar, “A survey on Image Data Augmentation for Deep Learning,” Journal of Big Data, vol. 6, no. 60, 2019. https://doi.org/10.1186/s40537-019-0197-0
  13. W. Shi et al., “Edge Computing: Vision and Challenges,” IEEE Internet of Things Journal, vol. 3, no. 5, pp. 637–646, 2016. https://ieeexplore.ieee.org/document/7488250
  14. M. Howard et al., “Searching for MobileNetV3,” Proc. IEEE ICCV, 2019. https://arxiv.org/abs/1905.02244
  15. J. Redmon et al., “You Only Look Once: Unified, Real-Time Object Detection,” Proc. CVPR, 2016. https://arxiv.org/abs/1506.02640
  16. X. Wang et al., “End-to-End Object Detection with Transformers,” ECCV, 2020. https://arxiv.org/abs/2005.12872

Sistema de Diagnóstico asistido por Inteligencia Artificial para la detección de Retinopatía Diabética

Vianny Cruz Cruz y Carlos Mena Moronta – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Con la evolución constante de la tecnología y por la búsqueda constante de la eficiencia y mejora de los procesos ya establecidos, se han creado modelos de inteligencia artificial que ayudan a desarrollar determinadas tareas. Dado los buenos resultados al emplear estas herramientas en el ámbito médico, como se presenta en el artículo [5], se está explorando en crear más de estas herramientas para el beneficio del sector de la salud. El presente artículo se basa en la creación de una IA destinada en la detección de una condición de la diabetes. La inteligencia artificial ha revolucionado nuestra realidad actual, siendo relevante tanto para el ámbito cotidiano así como también para áreas especializadas. Dado los buenos resultados al emplear estas herramientas en el ámbito médico [5], se está explorando en crear más de estas herramientas para el beneficio del sector de la salud. El presente artículo, aborda la creación de un sistema de diagnóstico oftalmológico con inteligencia artificial.

La diabetes es una afección crónica causada por los altos niveles de azúcar en la sangre, lo cual causa complicaciones varias en quien la padece. Actualmente se aprecia un aumento en la cantidad de personas que se ven afectadas por la misma, convirtiéndose así en una de las principales causas de muerte, como se puede apreciar en [6]. Entre las diferentes complicaciones provocadas por la diabetes, se encuentra aquella en torno a la cual se realiza la presente investigación, la Retinopatía Diabética.

La Retinopatía Diabética, RD por sus siglas, es una condición de la diabetes que afecta al nervio óptico, siendo capaz de llegar a causar ceguera permanente en quienes la padecen, actualmente, aproximadamente 10,000 personas anualmente pierden la visión debido a la misma [1][2]. Por esta y otras razones, como lo es el aumento de casos de diabetes a nivel mundial [3], es que la detección temprana de esta condición posee tanta relevancia [7].

Este proyecto, realizado por Vianny Cruz y Carlos Mena, estudiantes de la carrera de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra, consiste en el desarrollo de un modelo de inteligencia artificial para el diagnóstico de la Retinopatía Diabética. El mismo debe de ser capaz de detectar la presencia o ausencia de esta patología en imágenes de fondo de ojo.

La creación de esta prometedora herramienta, no solo ayudará a los retinólogos dominicanos a realizar sus consultas y diagnósticos, sino que también es posible servir de ayuda a los oftalmólogos no especializados en la retina del país a poder dar un diagnóstico relacionado con la RD a sus pacientes. De esta forma logrando ayudar al sector salud a ejecutar diagnósticos en el momento oportuno y de esta forma, poder tratar a los pacientes antes de que la enfermedad avance al punto en el que la visión se puede ver afectada [10].

Problemática y estado del arte

A nivel mundial la diabetes presenta una situación preocupante y que se va agravando con el tiempo. Según un estudio realizado en 2021, en el año 2015 se contaban con 415 millones de casos de diabetes, para el 2040 se estima que esta cifra alcanzará los 642 millones [4]. A nivel nacional el panorama tampoco es prometedor, en el reporte de [3] en la República Dominicana en 2024 la prevalencia de la diabetes en adultos alcanzó el 17.6%, lo cual equivale a 1,203,700 de los 7,255,498 dominicanos adultos.

La retinopatía diabética es una patología que progresa en el tiempo, la misma cuenta con 4 clasificaciones, las cuales son las siguientes: Retinopatía Diabética no proliferativa leve, retinopatía diabética no proliferativa moderada, retinopatía diabética no proliferativa severa y, finalmente, la retinopatía diabética proliferativa. Adicionalmente, mientras más avanzada esté la enfermedad, representa un riesgo mayor para el paciente, el tratamiento es más agresivo y el costo del mismo se eleva. Por lo que un temprano diagnóstico y abordamiento de la enfermedad es crucial.

En un país con recursos limitados, poder disponer de un diagnóstico rápido y preciso es crucial, pero el mismo presenta dificultades en su obtención, ya que es necesario de un retinólogo con conocimientos en el diagnóstico de la retinopatía diabética. Con el aumento en los casos, la poca disponibilidad de los retinólogos que se puede presentar y con la necesidad de un diagnóstico temprano, la herramienta propuesta en el presente documento adquiere suma relevancia y promete ser crucial para enfrentar y solventar esta problemática.

La solución propuesta no fue diseñada ni debe reemplazar los diagnósticos de los oftalmólogos, sino que el propósito de la misma es servir de herramienta para aumentar la eficiencia, servir como valoración adicional y ayudar a los oftalmólogos no especializados en el diagnóstico de esta condición de la diabetes. La misma nunca será empleada por los pacientes, sino por los miembros del sistema de salud que se encargan del diagnóstico y cuidado del nervio óptico.

Previamente fueron realizados estudios donde se desarrollan modelos de inteligencia artificial para realizar diagnóstico de diversas enfermedades. Dichos estudios reflejaron un panorama positivo en base a los resultados obtenidos y se llegó a la conclusión de que los modelos de IA son útiles para la detección y el diagnóstico de enfermedades en donde el diagnóstico consiste en identificar una serie de características y patrones en los estudios realizados en pacientes.

Repasando investigaciones y proyectos anteriores, se confirma que ya se ha trabajado en la creación de modelos destinados para la detección de la RD, pero existen amplias posibilidades de innovación, sobre todo al realizarlo en un ambiente específico de nuestro país, República Dominicana, utilizando imágenes de pacientes nacionales [5][8][9]. Además la creación de un modelo que funcione acorde a las imágenes de fondo de ojo que son manejadas en la Rep. Dom. acaba resultando en una herramienta especializada para ser empleada en el país.

Objetivos completados

  • Desarrollar un sistema de detección de retinopatía diabética fundamentado en arquitecturas de redes neuronales convolucionales, que demuestre un rendimiento satisfactorio con elevada precisión diagnóstica. Esta herramienta tecnológica tiene como propósito servir como apoyo complementario en el proceso de diagnóstico oftalmológico, contribuyendo al objetivo estratégico de reducir la incidencia nacional de casos de pérdida visual asociados a esta patología.

Metodología

El desarrollo del sistema de diagnóstico asistido por inteligencia artificial para la detección de retinopatía diabética se fundamentó en una metodología iterativa estructurada en cuatro fases secuenciales: preparación y procesamiento de datos, desarrollo y entrenamiento del modelo CNN [15], integración de componentes del sistema, y validación y evaluación del desempeño. Esta aproximación metodológica permitió el refinamiento continuo mediante ciclos de retroalimentación, facilitando la identificación temprana de limitaciones y garantizando una mayor robustez del producto final a través de múltiples evaluaciones y ajustes sucesivos.

La implementación técnica se desarrolló utilizando los recursos computacionales de la plataforma Kaggle, empleando un entorno basado en Python 3.11.13 sobre sistema operativo Linux, con procesamiento distribuido entre CPU Intel Xeon de 4 núcleos lógicos y GPU NVIDIA Tesla P100 con 16GB de VRAM. El stack tecnológico incluyó TensorFlow 2.18.0, Keras 3.8.0, Scikit-learn 1.2.2, y librerías complementarias especializadas para procesamiento de imágenes y análisis estadístico, seleccionadas por su robustez comprobada en aplicaciones de aprendizaje automático médico.

El conjunto de datos se conformó mediante la integración de fuentes complementarias: el dataset público APTOS (Diabetic Retinopathy Detection) y muestras del Hospital Regional Universitario José María Cabral y Báez, totalizando 1,604 imágenes oftalmológicas distribuidas equilibradamente entre casos positivos (799) y negativos (805) para retinopatía diabética. El dataset APTOS, derivado del concurso Kaggle de detección de retinopatía diabética de 2019, proporciona imágenes de alta calidad capturadas en condiciones controladas utilizando equipos estandarizados. Las imágenes del hospital local fueron capturadas utilizando una cámara de fondo de ojo digital VISUCAM 524, representando las condiciones reales de captura en el contexto clínico dominicano, específicamente en el Hospital Regional Universitario José María Cabral y Báez. Adicionalmente, se mantuvo un conjunto independiente de 34 imágenes provenientes del hospital para validación final, garantizando una evaluación imparcial del rendimiento del sistema mediante su completo aislamiento durante todo el proceso de entrenamiento. Este conjunto de validación independiente incluyó únicamente muestras locales para evaluar específicamente la capacidad de generalización del modelo a la población objetivo.

El preprocesamiento de imágenes implementó una pipeline estandarizado que incluyó normalización dimensional a 224×224 píxeles, conversión a arrays NumPy en espacio de color RGB, verificación automática de integridad mediante gestión de excepciones, y organización estructurada de datos. Para compensar las limitaciones del tamaño del dataset, se desarrolló una estrategia conservadora de aumento de datos que aplicó transformaciones geométricas controladas (rotación ±10°, desplazamiento 5%, zoom mínimo 5%) y transformaciones de intensidad apropiadas para preservar la fidelidad médica de las imágenes oftalmológicas [14]. Estas transformaciones pueden apreciarse en la siguiente figura:

Ejemplos de imágenes de fondo de ojo originales y sus versiones aumentadas
Figura 1. Aumentación de datos.

La arquitectura del modelo se basó en transfer learning utilizando EfficientNetB0 como base congelada, complementada con un clasificador personalizado que incorporó GlobalAveragePooling2D, BatchNormalization, capas Dense con activación ReLU y regularización L2, y técnicas de Dropout [12]. Esta configuración conservadora se diseñó específicamente para mitigar el riesgo de sobreajuste inherente a conjuntos de datos limitados, mientras optimiza el uso de recursos computacionales disponibles.

Para abordar los requerimientos de interpretabilidad médica, se implementó Gradient-weighted Class Activation Mapping (Grad-CAM), como técnica de explicabilidad que permite visualizar las regiones anatómicas que contribuyen significativamente a las decisiones diagnósticas del modelo [13]. La implementación incluyó cálculo de gradientes mediante tf.GradientTape, obtención de pesos de importancia por reducción global, generación de mapas de calor con normalización [0,1], y post-procesamiento con filtrado Gaussiano para suavizar artefactos, complementado con mecanismos de fallback para garantizar continuidad operacional.

Mapa de calor Grad-CAM, área de interés sobre la imagen de fondo de ojo y zoom del área
Figura 2. Gradiente visto desde la aplicación.

El proceso de regularización integró múltiples estrategias complementarias para prevenir overfitting: regularización L2 en capas densas, Dropout estratificado en puntos críticos de la arquitectura, Batch Normalization para estabilización de activaciones, Early Stopping con monitoreo de pérdida de validación (paciencia de 8 épocas) [16], y reducción adaptativa de tasa de aprendizaje mediante ReduceLROnPlateau (factor 0.5, paciencia de 4 épocas) [15]. Esta aproximación multicapa de regularización demostró ser efectiva para mantener la capacidad de generalización del modelo dentro de las limitaciones del dataset disponible.

La implementación final evolucionó desde un prototipo web inicial hacia una aplicación de escritorio, considerando las restricciones específicas del entorno hospitalario en términos de seguridad de datos, privacidad del paciente, y disponibilidad operacional sin dependencias externas. El sistema resultante integra backend en Python con interfaz HTML5/JavaScript, base de datos relacional SQLite para gestión de usuarios y consultas, autenticación de sesiones, y funcionalidades avanzadas de interpretabilidad visual para apoyo al diagnóstico clínico especializado.

Vista de diagnóstico de la aplicación con dos imágenes de fondo de ojo y su resultado
Figura 3. Vista de diagnóstico de la aplicación.
Vista de gestión de pacientes de la aplicación
Figura 4. Vista de gestión de pacientes de la aplicación.

Resultados

El modelo de clasificación de retinopatía diabética desarrollado demostró un rendimiento excepcional, alcanzando una exactitud promedio del 96.14% en validación cruzada de 5 pliegues. Este nivel de precisión diagnóstica evidencia la efectividad del modelo para distinguir entre imágenes oftalmológicas con retinopatía diabética y casos sin evidencia de la patología, estableciendo una base sólida para su potencial implementación clínica.

La evaluación mediante validación cruzada de 5 pliegues reveló una consistencia notable en el rendimiento del modelo, con variaciones controladas en todas las métricas: exactitud con rango de 2.75 puntos porcentuales (95.12%-97.87%), precisión con variación máxima de 3.82 puntos porcentuales (96.18%-100%), recall con la mayor variabilidad de 5.59 puntos porcentuales (91.93%-97.52%), y F1-Score con variación de 2.92 puntos porcentuales (94.90%-97.82%). Esta estabilidad inter-pliegues sugiere robustez ante diferentes particiones de datos y capacidad de generalización efectiva a muestras no observadas durante el entrenamiento. La variabilidad observada se mantiene dentro de rangos aceptables para aplicaciones clínicas, donde diferencias menores al 5% entre evaluaciones se consideran clínicamente insignificantes. El análisis estadístico reveló una desviación estándar promedio de 1.89% para la exactitud, 1.52% para la precisión, 2.23% para el recall, y 1.46% para el F1-Score. Estos valores de dispersión relativamente bajos indican que el modelo mantiene un rendimiento consistente independientemente de la composición específica del conjunto de entrenamiento y validación.

El Fold 2 emergió como el de mejor rendimiento global, alcanzando la exactitud más alta de 97.87%, la segunda mejor precisión de 98.12%, el mejor recall de 97.52%, y el mejor F1-Score de 97.82%, motivo por el cual fue seleccionado para la implementación final del sistema:

Matriz de confusión del Fold 2: 157 y 157 aciertos, 3 y 4 errores
Figura 5. Matriz de confusión para Fold 2.
Gráfica de accuracy de entrenamiento y validación por época para el Fold 2
Figura 6. Gráfica de accuracy por época para Fold 2.
Gráfica de pérdida de entrenamiento y validación por época para el Fold 2
Figura 7. Gráfica de pérdida por época para Fold 2.

La evaluación crítica mediante el conjunto independiente de 34 imágenes, completamente aislado durante todo el proceso de desarrollo, proporcionó una validación externa fundamental para establecer la aplicabilidad del modelo en el contexto hospitalario dominicano. Este conjunto de validación adquirió particular relevancia al incluir exclusivamente muestras del Hospital Regional Universitario José María Cabral y Báez, permitiendo evaluar la capacidad de generalización del modelo a datos locales específicos.

Los resultados obtenidos en el conjunto de validación independiente demostraron una identificación correcta de 16 imágenes de 17 para ambas clases diagnósticas (retinopatía diabética presente y ausente), traduciendo en una precisión del 94% para cada categoría. Esta cifra representa una diferencia mínima de apenas 2 puntos porcentuales respecto a la precisión del 96% obtenida en validación cruzada, evidenciando la capacidad del modelo para mantener su rendimiento diagnóstico en muestras completamente independientes.

Gráfica de barras de accuracy, precisión, recall y F1-score en los cinco folds
Figura 8. Visualización de resultados de validación cruzada.
Retinopatía DiabéticaSin Retinopatía DiabéticaRetinopatía DiabéticaSin Retinopatía Diabética
EfficientNetB016/1716/1794%94%
Tabla 1. Resultados de validación con conjunto aislado.

Conclusión

El desarrollo de este sistema de inteligencia artificial para la detección de retinopatía diabética ha demostrado exitosamente que es posible el desarrollo de implementaciones de inteligencia artificial satisfactorias en el contexto nacional. Este logro técnico representa un avance hacia la democratización del diagnóstico oftalmológico especializado, especialmente en entornos con recursos limitados donde el acceso a especialistas en retina es escaso. La colaboración interdisciplinaria y la utilización de datos tanto nacionales como internacionales fueron elementos clave que garantizan no sólo la precisión del modelo, sino también su relevancia clínica y aplicabilidad práctica.

El potencial de expansión de este proyecto es considerable, desde la implementación de clasificación multiclase para los cinco niveles de severidad de la retinopatía diabética, hasta la incorporación de otras patologías oculares y el desarrollo de herramientas educativas para futuros oftalmólogos. Con el incremento global de casos de diabetes y la creciente demanda de diagnósticos oportunos, este sistema representa una solución escalable que puede integrarse en protocolos de tamizaje masivo. El llamado a la acción es claro: es viable y prometedor que la comunidad científica, los profesionales de la salud y las instituciones colaboren para expandir esta investigación tecnológica en una herramienta que impacte positivamente miles de vidas.

Referencias

  1. D. S. Fong, L. P. Aiello, F. L. Ferris, and R. Klein, “Diabetic retinopathy,” Diabetes Care, vol. 27, no. 10. pp. 2540–2553, Oct. 2004. doi: 10.2337/diacare.27.10.2540.
  2. S. Kusuhara, Y. Fukushima, S. Ogura, N. Inoue, and A. Uemura, “Pathophysiology of diabetic retinopathy: The old and the new,” Diabetes and Metabolism Journal, vol. 42, no. 5. Korean Diabetes Association, pp. 364–376, Oct. 01, 2018. doi: 10.4093/dmj.2018.0182.
  3. International Diabetes Federation, “IDF Diabetes Atlas, 11th edition,” Accessed: Jun. 14, 2025. [Online]. Available: https://diabetesatlas.org/media/uploads/sites/3/2025/04/IDF_Atlas_11th_Edition_2025.pdf
  4. V. E. Madsen Beau De Rochars et al., “Prevalence of Diabetes, Prediabetes, and Associated Risk Factors among Agricultural Village Residents in the Dominican Republic,” American Journal of Tropical Medicine and Hygiene, vol. 104, no. 6, pp. 2241–2250, Jun. 2021, doi: 10.4269/ajtmh.19-0942.
  5. H. Sadr et al., “Unveiling the potential of artificial intelligence in revolutionizing disease diagnosis and prediction: a comprehensive review of machine learning and deep learning approaches,” European Journal of Medical Research, vol. 30, no. 1, May 2025, doi: 10.1186/s40001-025-02680-7.
  6. World Health Organization, “The top 10 causes of death.” Accessed: Aug. 12, 2025. [Online]. Available: https://www.who.int/news-room/fact-sheets/detail/the-top-10-causes-of-death
  7. H. Safi, S. Safi, A. Hafezi-Moghadam, and H. Ahmadieh, “Early detection of diabetic retinopathy,” Survey of Ophthalmology, vol. 63, no. 5, pp. 601–608, Sep. 2018, doi: 10.1016/J.SURVOPHTHAL.2018.04.003.
  8. M. D. Abràmoff et al., “Automated Early Detection of Diabetic Retinopathy,” Ophthalmology, vol. 117, no. 6, pp. 1147–1154, Jun. 2010, doi: 10.1016/J.OPHTHA.2010.03.046.
  9. V. Gulshan et al., “Development and Validation of a Deep Learning Algorithm for Detection of Diabetic Retinopathy in Retinal Fundus Photographs,” JAMA, vol. 316, no. 22, pp. 2402–2410, Dec. 2016, doi: 10.1001/JAMA.2016.17216.
  10. S. Rowe, C. H. MacLean, and P. G. Shekelle, “Preventing Visual Loss from Chronic Eye Disease in Primary Care: Scientific Review,” JAMA, vol. 291, no. 12. 2004. doi: 10.1001/jama.291.12.1487.
  11. G. Lippi and M. Plebani, “Biomarker research and leading causes of death worldwide: A rather feeble relationship,” Clinical Chemistry and Laboratory Medicine, vol. 51, no. 9. pp. 1691–1693, Sep. 2013. doi: 10.1515/cclm-2013-0210.
  12. S. Ioffe and C. Szegedy, “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift,” 32nd International Conference on Machine Learning, ICML 2015, vol. 1, pp. 448–456, Feb. 2015, Accessed: Aug. 14, 2025. [Online]. Available: https://arxiv.org/pdf/1502.03167
  13. Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, “Gradient-based learning applied to document recognition,” Proceedings of the IEEE, vol. 86, no. 11, pp. 2278–2323, 1998, doi: 10.1109/5.726791.
  14. J. Wang and L. Perez, “The Effectiveness of Data Augmentation in Image Classification using Deep Learning.”, Accessed: Aug. 14, 2025. [Online]. Available: https://www.researchgate.net/publication/321794300_The_Effectiveness_of_Data_Augmentation_in_Image_Classification_using_Deep_Learning
  15. H. Pratt, F. Coenen, D. M. Broadbent, S. P. Harding, and Y. Zheng, “Convolutional Neural Networks for Diabetic Retinopathy,” Procedia Computer Science, vol. 90, pp. 200–205, Jan. 2016, doi: 10.1016/J.PROCS.2016.07.014.
  16. L. Prechelt, “Early stopping – But when?,” Lecture Notes in Computer Science (including subseries Lecture Notes in Artificial Intelligence and Lecture Notes in Bioinformatics), vol. 7700 LECTURE NO, 2012, doi: 10.1007/978-3-642-35289-8_5.

Identificación de plantas dominicanas con IA

John Rodríguez y Jorge Tuma – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

La identificación de plantas ha sido durante mucho tiempo un aspecto crucial para comprender y preservar la biodiversidad, sin embargo, sigue siendo un desafío para muchos expertos debido a la complejidad de las especies y sus variantes. En la República Dominicana existen alrededor de 6,000 plantas vasculares de acuerdo con los informes del Ministerio de Medio Ambiente mediante el Viceministerio de Áreas Protegidas y Biodiversidad [1]. Este proyecto se centra en aplicar tecnologías, como la inteligencia artificial (IA) y las aplicaciones móviles, para simplificar y optimizar el proceso de identificación de plantas. Al combinar un modelo de IA entrenado con técnicas avanzadas de deep learning y una aplicación móvil intuitiva, esta iniciativa busca proporcionar a los usuarios una herramienta accesible para identificar especies de plantas que crecen en todo el territorio del país con precisión, especialmente las endémicas con las cuales modelos similares presentan dificultades. Además, la creación de un conjunto de imágenes de la flora dominicana con la colaboración del Jardín Botánico de Santiago [2], promoviendo la divulgación del conocimiento botánico de la flora local al público general. Esta propuesta es desarrollada por los estudiantes de Ingeniería en Ciencias de la Computación (ICC), Jorge Tuma y John Rodríguez.

El proceso de identificación se encuentra en el modelo de deep learning, desarrollado con Python. Este modelo ha sido entrenado en un conjunto de datos de especies de plantas dominicanas, lo que le permite analizar patrones complejos en imágenes, como estructuras de hojas, formas de flores y variaciones de color. El modelo emplea técnicas avanzadas en redes neuronales convolucionales para garantizar una alta precisión, incluso en diversas condiciones ambientales o con una calidad de imagen limitada. Al integrar este modelo de aprendizaje profundo con la aplicación móvil, el proyecto permite a los usuarios identificar con precisión las plantas mediante imágenes.

La Lista Roja de la Flora Vascular en la República Dominicana [3] es un catálogo útil que presenta el estado de conservación, descripción y localización dentro del territorio nacional de las especies de plantas vasculares en el país. Publicado por el Ministerio de Medio Ambiente y Recursos Naturales, respaldada por expertos en botánica, esta lista constituye un recurso vital para comprender las amenazas que enfrenta la flora del país. Forma parte de un catálogo con validez internacional para documentar y proteger la biodiversidad de la flora del país. Este es un recurso adicional que aporta información clave para la realización del proyecto.

Problemática y estado del arte

En los últimos años, ha habido auge de aplicaciones para teléfonos inteligentes que pueden utilizarse para facilitar la identificación de plantas. Existen diversos enfoques, desde aplicaciones que identifican plantas automáticamente mediante el uso de Inteligencia Artificial (IA) hasta el Reconocimiento Automático de Imágenes. La mayoría de estas aplicaciones se utilizan para identificar plantas automáticamente a partir de imágenes estáticas proporcionadas por los usuarios a estas aplicaciones, donde las decisiones y retroalimentaciones tomadas por los usuarios son mínimas. Todas las aplicaciones de esta naturaleza se comportan de manera similar al usar una imagen en su estado natural o al visualizarla en un monitor de computadora y fotografiarla con el teléfono. Además de identificar la especie en cuestión también se identifica su familia y género. El rendimiento de estas aplicaciones suele ser más de un tercio de todas las identificaciones fueron correctas para la especie, aumentando a más del 65 % correctas para al menos la familia de la planta. Estas aplicaciones están disponibles mediante un portal web o disponible como interfaz de programación de aplicaciones API para la incorporación de la identificación de plantas en otro software [4].

Otro enfoque empleado en proyectos de identificación de plantas consultados consiste en utilizar deep learning para entrenar un modelo de identificación adaptado a reconocer ejemplares de plantas en su estado natural. Se presenta un conjunto de datos de imágenes de plantas recopiladas con teléfono móvil en un entorno natural, que contiene 10,000 imágenes de 100 especies de plantas ornamentales del campus de la Universidad Forestal de Pekín. Se diseñó un modelo de deep learning de 26 capas, compuesto por 8 bloques residuales, para la clasificación de plantas a gran escala en entornos naturales. El modelo propuesto alcanza una tasa de reconocimiento del 91.78 % en el conjunto de datos BJFU100 [5].

Las aplicaciones de identificación, especialmente las disponibles como aplicaciones móviles, como iNaturalist [6] y Pl@ntNet [7], han revolucionado la identificación de plantas mediante el uso de modelos de inteligencia artificial. Tanto profesionales como el público general pueden fotografiar una planta en su ambiente natural. Las imágenes deben ser de la mayor calidad posible para facilitar su identificación, incluyendo tomas de la planta completa, hojas, flores y frutos. A diferencia de estas últimas, esta propuesta pretende construir un modelo de IA capaz de identificar con mayor precisión plantas endémicas de la isla, con las cuales estas aplicaciones suelen flaquear.

Objetivos

El desarrollo de este proyecto es crear una herramienta de identificación de plantas accesible y confiable que aprovecha la inteligencia artificial para mejorar la conciencia de la biodiversidad de plantas del país. Esto se dividió en objetivos específicos alineados con la tarea de recolectar y crear un conjunto de datos de alta calidad de plantas dominicanas, desarrollar un modelo de IA con al menos un 80 % de precisión para la identificación de las plantas presentes en el país e integrar el modelo en una aplicación móvil construida en Flutter. Además, el proyecto pretende construir un conjunto de imágenes de la flora del país con la que se entrene el modelo de inteligencia artificial.

Metodología

Se recopiló un conjunto significativo de imágenes utilizando el catálogo dado por el Jardín Botánico de Santiago de distintas especies de plantas, organizándolas en carpetas individuales con el nombre de cada clase, siguiendo una estructura estándar para proyectos de clasificación de imágenes. Para asegurar la calidad de los datos, se implementaron procesos de depuración, eliminando imágenes corruptas, duplicadas o irrelevantes.

El dataset fue dividido manualmente en conjuntos de entrenamiento y validación (70/30). Las imágenes fueron sometidas a técnicas de preprocesamiento para normalizar los datos de entrada y estandarizar la resolución.

Todas las imágenes fueron redimensionadas a 260×260 píxeles, una medida óptima para modelos preentrenados de clasificación de imágenes, y se aplicó una normalización de los valores de píxeles al rango [0, 1]. Este proceso mejora la estabilidad numérica durante el entrenamiento y acelera la convergencia del modelo.

Se utilizaron técnicas de regularización como Dropout para prevenir el sobreajuste, además de estrategias de control como EarlyStopping y ModelCheckpoint para detener el entrenamiento al detectar estancamiento.

Cactus Opuntia antillana con flores anaranjadas, ejemplar del dataset
Figura 1. Ejemplar del dataset: Opuntia antillana.

Resultados

El modelo entrenado alcanzó una precisión de entrenamiento alrededor de 75 % al 95 %, pero con una precisión de validación más baja, dependiendo de la arquitectura utilizada.

Mediante pruebas externas con imágenes no vistas, se validó la capacidad de ambos modelos para realizar predicciones, pero con plantas muy parecidas, dando a entender que faltan más procesos por afinar, pero demostrando su viabilidad para ser integrados en una aplicación real de reconocimiento de plantas.

El dataset construido para entrenar el modelo posee 350 especies de plantas presentes en el inventario del Jardín Botánico de Santiago. Las imágenes fueron etiquetadas con sus nombres científicos con alrededor de 100 ejemplares por especie.

En términos de la aplicación, posee un apartado para identificar una planta, un mapa interactivo del Jardín Botánico de Santiago y una pestaña con información de las plantas identificadas. La misma está desarrollada para dispositivos móviles Android.

Pantalla 'Identificar una Planta' de la aplicación móvil, con botones de cámara y galería y pestañas Identificar, Mapa e Info
Figura 2. Captura de pantalla de la aplicación.

Conclusión

Este proyecto demuestra el potencial de la inteligencia artificial para abordar los desafíos ambientales del mundo real. Al desarrollar con éxito una aplicación de identificación de plantas basada en un modelo de aprendizaje profundo y con el respaldo de una aplicación móvil fácil de usar, hemos creado una herramienta valiosa para promover la concienciación sobre la biodiversidad de plantas presente en el país, especialmente en el contexto de la rica, pero vulnerable flora de la República Dominicana. Entre los aprendizajes clave se incluyen la importancia de un conjunto de datos de alta calidad y la eficacia del modelo entrenado.

A futuro esta propuesta puede ser expandida para integrar nuevas tecnologías o funcionalidades adicionales. Otra posibilidad sería agregar otros ejemplares al conjunto de imágenes de plantas presentes en el país para mejorar el alcance y las capacidades de identificación del modelo, con especial enfoque en plantas endémicas de la isla. Esto con el fin de promover los esfuerzos de conservación y la divulgación del conocimiento botánico en el país.

Referencias

  1. Viceministerio de Áreas Protegidas y Biodiversidad. (2021). La Biodiversidad en la República Dominicana. https://bvearmb.do/bitstream/handle/123456789/269/BiodiversidadDominicana2021.pdf
  2. Jardín Botánico de Santiago, “Historia y Marco Legal,” Jardín Botánico Prof. Eugenio de Js. Marcano, https://botanicodesantiago.com/historia/.
  3. Ministerio de Medio Ambiente y Recursos Naturales. (2016). Lista Roja: De la Flora Vascular en República Dominicana. Archivo General de la Nación. https://colecciones.agn.gob.do/opac/ficha.php?informatico=00114295PI&codopac=OP003&idpag=1626095770&presenta=digitaly2p#viajeinicial
  4. Jones, H. (2020). Artificial Intelligence for plant identification on smartphones. https://bsbi.org/wp-content/uploads/dlm_uploads/BSBI-News-144-pp34-40-plant-id-apps-final.pdf
  5. Sun, Yu & Liu, Yuan & Wang, Guan & Zhang, Haiyan. (2017). Deep Learning for Plant Identification in Natural Environment. Computational Intelligence and Neuroscience. https://www.researchgate.net/publication/317127150_Deep_Learning_for_Plant_Identification_in_Natural_Environment
  6. iNaturalist, https://www.inaturalist.org/
  7. Identificar, explorar y compartir tus observaciones sobre plantas silvestres, Pl@ntNet, https://identify.plantnet.org/es

Software de monitoreo de red para detección de anomalías para MIPYMES

Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la digitalización ha redefinido la operativa de las empresas, las micro, pequeñas y medianas empresas (MIPYMES) enfrentan un desafío particular: mantener su competitividad sin comprometer la seguridad de su información. La integración progresiva de tecnologías de la información en estas organizaciones ha traído consigo un aumento exponencial en su exposición a amenazas cibernéticas, a menudo sin el respaldo de soluciones robustas que mitiguen los riesgos. Mientras que las grandes empresas disponen de infraestructuras avanzadas y personal capacitado para enfrentar este tipo de desafíos, las MIPYMES se ven limitadas por recursos económicos, técnicos y humanos. Este panorama ha motivado el desarrollo de soluciones especializadas, entre ellas el “Software de Monitoreo de Red para Detección de Anomalías para MIPYMES”, concebido por Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez como parte de su proyecto de grado en la Pontificia Universidad Católica Madre y Maestra (PUCMM).

A diferencia de otros productos comerciales, este software no requiere infraestructuras complejas ni licencias costosas. Está diseñado para ejecutarse en plataformas asequibles como la Raspberry Pi, lo que permite su implementación incluso en entornos con recursos limitados. Esta elección no solo reduce los costos, sino que también facilita el despliegue en redes pequeñas sin afectar el rendimiento. Uno de los pilares de esta solución es su enfoque en el análisis de metadatos en lugar del contenido del tráfico, lo que permite mantener la privacidad de los datos y alinearse con normativas como el Reglamento General de Protección de Datos (RGPD) [1].

Como parte del proceso de diseño, se identificaron las amenazas más comunes en redes que pertenezcan a empresas sin importar su tamaño: ataques de denegación de servicio distribuido (DDoS), escaneo de puertos y fuerza bruta. Estos ataques, aunque variados en su metodología, comparten un mismo objetivo: comprometer la disponibilidad o la confidencialidad de los sistemas. Al simular estos escenarios en entornos controlados utilizando herramientas como Mininet y Wireshark, fue posible analizar con precisión cómo estas amenazas afectan el comportamiento del tráfico de red, extrayendo métricas clave como la tasa de paquetes por segundo, los puertos únicos involucrados, las banderas TCP y la duración de la sesión.

El desarrollo de este proyecto ha permitido implementar un software de monitoreo de red basado en algoritmos de aprendizaje automático, ejecutado en una Raspberry Pi, que permite a las MIPYMES detectar y mitigar amenazas como ataques DDoS, escaneo de puertos y fuerza bruta. Para lograr este objetivo general, se diseñó un sistema escalable compatible con la infraestructura de red existente, se evaluaron modelos como Isolation Forest. Asimismo, se validó experimentalmente su desempeño mediante simulaciones en entornos controlados, confirmando su efectividad y adaptabilidad para su posterior implementación en escenarios reales.

Uno de los elementos más innovadores de esta propuesta radica en la integración de algoritmos de aprendizaje automático para la detección de anomalías. En particular, el uso del algoritmo Isolation Forest resultó crucial debido a su capacidad para identificar patrones inusuales sin necesidad de datos etiquetados, lo que lo convierte en una opción ideal para entornos con tráfico no estructurado y dinámico [11][13]. En pruebas realizadas con datos simulados y reales, este modelo demostró una tasa de detección superior al 90 %, superando a otros enfoques como DBSCAN y One-Class SVM, tanto en precisión como en baja latencia de respuesta [3][12][14].

Durante el desarrollo del sistema, se consideró también la escalabilidad y la eficiencia del procesamiento. Por ello, se incorporaron herramientas como Pandas para el análisis inicial y Dask para el procesamiento distribuido de grandes volúmenes de datos [6][7]. En etapas más avanzadas, se implementó un pipeline sobre Apache Spark, lo que permitió analizar datasets de más de un millón de registros sin comprometer la velocidad del sistema [5].

Es relevante destacar que el sistema no se limita a la detección pasiva. Incluye funcionalidades proactivas como la capacidad de bloquear automáticamente los puertos involucrados en un ataque, mitigando su impacto en tiempo casi real. Este proceso se apoya en reglas heurísticas codificadas a partir de umbrales aprendidos durante la fase de entrenamiento del modelo, los cuales son reforzados por el análisis del algoritmo Isolation Forest. Por ejemplo, un incremento repentino de conexiones hacia múltiples puertos en segundos puede ser indicativo de un ataque DDoS, mientras que múltiples intentos de conexión por SSH en breves intervalos apuntan a un posible ataque de fuerza bruta [26][30][31].

Aunque este software fue concebido inicialmente como un sistema que monitorea y detecta diversas anomalías, su arquitectura y lógica operativa lo posicionan funcionalmente más cerca de un sistema de prevención de intrusiones (IPS) que de un sistema puramente pasivo de detección (IDS). A diferencia de un IDS, que solo analiza el tráfico y alerta al administrador de red ante posibles amenazas, un IPS está diseñado para reaccionar automáticamente ante dichas amenazas y tomar medidas correctivas en tiempo real.

Este software incorpora precisamente esa capacidad de acción inmediata. Por ejemplo, cuando el sistema detecta comportamientos anómalos —como un aumento súbito de conexiones simultáneas hacia múltiples puertos, típico de un ataque DDoS, o múltiples intentos de autenticación SSH en corto tiempo, característicos de un ataque de fuerza bruta— puede ejecutar comandos automatizados para bloquear los puertos involucrados o aislar temporalmente la IP ofensora. Estas acciones son llevadas a cabo por scripts que interactúan directamente con el firewall del sistema operativo, permitiendo una respuesta prácticamente en tiempo real sin intervención humana.

Además, esta lógica de prevención se basa en una combinación de heurísticas definidas por expertos y el análisis dinámico del algoritmo de aprendizaje automático Isolation Forest. Esto permite al sistema no solo actuar frente a amenazas conocidas, sino también responder ante patrones inusuales de comportamiento que podrían corresponder a ataques novedosos o sofisticados. Esta capacidad adaptativa lo diferencia notablemente de los IPS tradicionales basados únicamente en firmas estáticas.

La interfaz gráfica de usuario, desarrollada con un enfoque intuitivo, permite a los usuarios visualizar el estado de la red en tiempo real, recibir notificaciones, modificar umbrales de detección y consultar reportes. Esta interfaz resulta esencial en entornos donde el personal técnico puede ser limitado, ya que democratiza el acceso a funcionalidades avanzadas de monitoreo y respuesta.

Salida de consola del sensor: métricas capturadas de una sesión de red y clasificación como tráfico normal
Figura 1. Salida del sensor: métricas capturadas de una sesión de red y su clasificación.

Otra característica destacada es la generación de alertas vía correo electrónico, función que puede ser configurada desde la GUI y que permite a los administradores recibir notificaciones en tiempo real cuando se detectan comportamientos sospechosos. Estas alertas no solo informan sobre el evento, sino que detallan métricas específicas del tráfico involucrado y la clasificación del tipo de amenaza.

En cuanto a la privacidad de los datos, el sistema implementa múltiples capas de protección: anonimización de direcciones IP, tokenización de credenciales y cifrado de las capturas de tráfico (PCAP) mediante protocolos como TLS/SSL [22]. Además, se ha implementado un sistema de control de acceso basado en roles (RBAC), lo que permite restringir la visualización y edición de parámetros sensibles según el tipo de usuario.

El sistema fue validado mediante pruebas experimentales en laboratorios didácticos de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la PUCMM. Se configuraron topologías que simulan redes reales, incluyendo clientes, servidores y nodos maliciosos. A lo largo de estas pruebas, se midieron métricas como la tasa de verdaderos positivos, tasa de falsos positivos, tiempo de reacción, y uso de recursos del sistema. Los resultados demostraron que incluso en condiciones de tráfico intenso y ataques simultáneos, la Raspberry Pi fue capaz de mantener el procesamiento de datos en tiempo real, activando bloqueos automáticos en menos de 7 segundos desde la detección de la amenaza.

Este proyecto no solo demuestra la viabilidad técnica de una solución de ciberseguridad accesible para MIPYMES, sino que también aporta al ámbito académico y social al validar un modelo replicable para otras instituciones o empresas que enfrenten limitaciones similares. Se plantea como una solución modular, que puede crecer conforme lo hagan las necesidades de la empresa. Por ejemplo, si una MIPYME decide migrar parte de su infraestructura a la nube, el sistema puede ser adaptado para correr sobre instancias virtualizadas, integrarse con SIEMs externos o incorporar sensores IoT para nuevas formas de monitoreo [16][17].

El valor de esta propuesta también se aprecia en su enfoque pedagógico: al haber sido desarrollado en un contexto académico, representa un ejemplo concreto de cómo la investigación aplicada puede responder a necesidades reales del sector productivo. El proyecto se alinea así con una tendencia creciente en el ámbito de la ciberseguridad: la descentralización de las soluciones y su personalización según el entorno operativo, especialmente en regiones en desarrollo donde las soluciones comerciales no siempre son viables [2][29].

En suma, el desarrollo de este software representa un paso importante hacia una ciberseguridad más democrática, donde incluso las organizaciones más pequeñas pueden acceder a herramientas inteligentes de defensa. El uso de aprendizaje automático, herramientas open-source y plataformas de bajo costo demuestra que es posible construir soluciones efectivas sin depender de grandes presupuestos, siempre que se cuente con una metodología sólida, una comprensión clara del problema y un compromiso con la innovación.

A partir de las validaciones experimentales, se observaron también beneficios colaterales que hacen de esta herramienta una solución integral. Una de ellas es su potencial como plataforma de entrenamiento para personal técnico, ya que permite observar en tiempo real cómo se comporta el tráfico de red bajo distintos escenarios de amenaza. Esto no solo es útil para los administradores de red en las MIPYMES, sino también como recurso formativo en entornos educativos. En este sentido, el software puede evolucionar a una versión “educativa” que permita simular ataques, visualizar su detección y analizar la respuesta automática del sistema.

El proyecto, además de ser funcional en su implementación técnica, incorpora un plan detallado de mitigación de riesgos. Esto incluye no solo la detección y respuesta ante amenazas externas, sino también el manejo seguro de los datos, la protección contra accesos no autorizados, y la supervisión de posibles fallas internas del sistema. Se identificaron riesgos como sobrecarga en la Raspberry Pi, fallos en el sistema de alertas, o acceso indebido por parte de usuarios internos. Cada uno de estos fue abordado mediante estrategias preventivas y correctivas, como la autenticación multifactor, el cifrado extremo a extremo, y la verificación periódica de los registros del sistema.

El funcionamiento interno del software está organizado en módulos independientes, que cooperan para capturar tráfico, analizarlo, generar respuestas automáticas y permitir la gestión por parte del usuario. Toda esta arquitectura modular se encuentra en la carpeta «secciones de la aplicación» del repositorio del proyecto.

El script SMR_app.py actúa como controlador principal de la aplicación, iniciando la interfaz gráfica y estableciendo la comunicación entre los módulos. El componente sensor_controller.py se encarga de capturar tráfico en la red en tiempo real utilizando la biblioteca PyShark. Durante esta etapa, se extraen métricas específicas de cada sesión de red, tales como la tasa de paquetes (packet_rate), información enviada (informacion_enviada_mb), puertos involucrados (puertos_unicos), duración de la sesión (duracion_sesion_seg) y banderas TCP (banderas_tcp).

Estas métricas son limpiadas y normalizadas mediante Pandas, y luego pasadas al módulo ml_model.py, que utiliza el modelo de Isolation Forest previamente entrenado y almacenado como ml_model.pkl. El resultado del análisis es una predicción binaria que indica si el tráfico es normal o anómalo.

Desde la interfaz gráfica, desarrollada con PyQt6, los administradores pueden observar alertas en tiempo real, modificar umbrales, activar o detener la detección, y generar reportes. El sistema también cuenta con control de acceso por roles (RBAC), autenticación multifactor (OTP), y registro de auditoría mediante eventos almacenados cada vez que un usuario inicia sesión, configura opciones, o modifica parámetros críticos. Esta arquitectura integral permite una operación segura, eficiente y personalizable de acuerdo a la cada empresa pueda llegar a necesitar.

Pantalla de inicio de sesión de AegisNet con campos de usuario y contraseña
Figura 2. Interfaz gráfica: inicio de sesión.
Tabla de hosts detectados en la red con nombre, IP, dirección MAC y estado
Figura 3. Interfaz gráfica: listado de hosts de la red.
Pantalla de parámetros del sistema: detección, bloqueo automático, correos para alertas y reportes automáticos
Figura 4. Interfaz gráfica: parámetros del sistema, alertas por correo y reportes automáticos.
Pantalla de gestión de reportes con selección de fecha de inicio y de término
Figura 5. Interfaz gráfica: gestión de reportes.

Otro aspecto crucial de esta propuesta es la implementación de un sistema de aprendizaje continuo. Los modelos utilizados no son estáticos: pueden reentrenarse con nuevos datos recolectados a lo largo del tiempo, mejorando así la capacidad del sistema para reconocer nuevas amenazas o adaptarse a cambios en el comportamiento de la red. Esto convierte al software en una herramienta viva, que aprende y se ajusta a medida que evoluciona el entorno digital. Esta funcionalidad fue posible gracias al diseño modular del sistema, que permite actualizar componentes como los modelos de machine learning, las reglas heurísticas o incluso las métricas empleadas, sin necesidad de modificar toda la arquitectura.

Diagrama de flujo: captura de datos, preprocesamiento, entrenamiento del modelo, detección de anomalías, sistema de alertas y visualización
Figura 6. Flujo de funcionamiento del sistema, desde la captura de datos hasta la visualización.

Dentro del sistema, el proceso de clasificación del tráfico se realiza en tiempo real gracias a la eficiencia de bibliotecas como Pandas para la limpieza y estructuración de datos, y a la capacidad de Dask y Spark para operar sobre grandes volúmenes de información distribuida [6][5]. La eficiencia de estas herramientas permitió reducir significativamente los tiempos de análisis, lo que se tradujo en una latencia de respuesta inferior a los 5 segundos en la mayoría de los casos, incluso bajo condiciones de carga media-alta.

En el aspecto de interoperabilidad, el sistema fue diseñado para integrarse fácilmente con herramientas externas como sistemas de gestión de eventos (SIEM). Esto permite ampliar las capacidades del sistema según las necesidades específicas de cada organización. De igual modo, el backend se comunica con bases de datos PostgreSQL, que permiten la trazabilidad completa de eventos y la generación de reportes automatizados [23][24].

Interfaz de AegisNet con gráfico circular de puertos de comunicación por host
Figura 7. Reporte gráfico de la aplicación: puertos de comunicación por host.

En la práctica, esta solución también cumple muchas de las funciones clave de un SIEM (Security Information and Event Management), ya que consolida en un solo sistema la recolección, análisis, correlación y presentación de eventos de seguridad en tiempo real. Sin embargo, el valor añadido de esta aplicación radica en que no requiere una configuración manual de reglas de correlación ni un análisis forense posterior para actuar: la inteligencia incorporada mediante el modelo Isolation Forest le permite tomar decisiones autónomas con base en patrones estadísticos y de comportamiento previamente aprendidos.

El algoritmo Isolation Forest es particularmente eficiente en detectar anomalías sin requerir datos etiquetados, lo que lo hace ideal para entornos dinámicos como las redes de MIPYMES, donde el tráfico puede variar sin seguir patrones estrictos. El sistema realiza una evaluación continua de las métricas de tráfico (tasa de paquetes, puertos únicos, información enviada, etc.) y puede detectar variaciones sutiles que escapen a reglas tradicionales. Por tanto, el sistema no solo identifica amenazas activas, sino también condiciones precursoras que podrían derivar en incidentes de seguridad.

A diferencia de SIEMs comerciales que requieren integraciones costosas o mantenimientos continuos, este sistema basado en herramientas open-source permite a las MIPYMES acceder a funcionalidades similares sin comprometer su presupuesto. Además, ofrece trazabilidad total gracias al registro automático de eventos, accesibles desde PostgreSQL y visualizables desde una GUI estilizada. Esta combinación de SIEM funcional, detección inteligente y respuesta inmediata, convierte a este sistema en una herramienta estratégica para entornos donde los recursos técnicos y humanos son limitados.

El software contempla escenarios de prueba físicos y simulados. Por ejemplo, uno de los escenarios evaluados consistió en la inyección de tráfico malicioso mediante ataques de escaneo de puertos (nmap), fuerza bruta SSH (hydra) y denegación de servicio (hping3) en un entorno virtual creado con Mininet. En este entorno, los resultados obtenidos reflejaron una detección exitosa en más del 90 % de los casos para Isolation Forest, manteniendo la tasa de falsos positivos por debajo del 8 %. En comparación, DBSCAN tuvo una mayor sensibilidad, pero también una mayor propensión a detectar falsos positivos, lo que en entornos reales puede derivar en acciones innecesarias o pérdida de confianza en el sistema [14][20].

Otro escenario fue el análisis de archivos de logs provenientes de un SIEM simulado con registros JSON. En este contexto, el sistema fue capaz de identificar patrones categóricos anómalos, como cambios inesperados en reglas de firewall, intentos de acceso fuera del horario habitual, y modificaciones sospechosas en la configuración de red. Para este caso, DBSCAN mostró mejor desempeño que los modelos lineales, aunque su precisión fue superada por Isolation Forest [12][17].

Isolation ForestPrecisiónRecallF1-ScoreSupport (logs analizados)
Normal0.771.000.87600
Anomalía1.000.130.24210
Accuracy0.78810
Macro avg0.880.570.55810
Weighted avg0.830.780.70810
Tabla 1. Resultados de Isolation Forest en el análisis de logs.

Una innovación adicional que se integró en la fase final del desarrollo fue la simulación de tráfico legítimo. Este componente permite generar escenarios normales controlados, como navegación web, consultas DNS, envío de correos o conexión a servidores internos, con el fin de evaluar el rendimiento del sistema ante comportamientos genuinos. Este tipo de validación fue fundamental para ajustar los umbrales de detección y reducir falsos positivos, un aspecto crítico para que el sistema pueda ser adoptado sin generar interrupciones innecesarias en las operaciones cotidianas de la empresa.

En términos de arquitectura, el sistema fue concebido para funcionar bajo un modelo distribuido. Esto significa que, aunque su núcleo puede ejecutarse en una Raspberry Pi, la solución puede extenderse fácilmente a través de una red de dispositivos que colaboren en la recolección y procesamiento de datos. Por ejemplo, en entornos donde la red se encuentra segmentada por departamentos o ubicaciones físicas, cada segmento podría tener su propio nodo de monitoreo, que luego consolida información hacia un servidor central de análisis.

Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software dentro de la red de la MIPYME
Figura 8. Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software en la red de la MIPYME.

Finalmente, uno de los puntos más valiosos del proyecto es su potencial para adaptarse a otros tipos de entornos. Aunque fue diseñado con las MIPYMES en mente, el sistema puede ser útil también en organizaciones no gubernamentales, centros educativos, o startups que requieran una solución de monitoreo de red sin tener que invertir en plataformas comerciales de alto costo. Su diseño modular y su base en herramientas open-source garantizan que pueda ser reutilizado, ampliado o personalizado según cada caso particular [8][15].

Este software de monitoreo representa mucho más que una simple herramienta de detección. Es una propuesta integral de defensa cibernética accesible, construida con visión académica, enfoque práctico y sensibilidad social. Combina lo mejor del aprendizaje automático con buenas prácticas en privacidad y seguridad, empleando recursos tecnológicos sostenibles y reutilizables. La experiencia obtenida durante su desarrollo no solo permitió validar su funcionalidad, sino que también generó conocimientos valiosos para futuros desarrollos de ciberseguridad en contextos similares. Este proyecto marca así un hito en la promoción de una cultura de ciberdefensa proactiva y descentralizada, especialmente en sectores tradicionalmente excluidos de las soluciones tecnológicas avanzadas.

Referencias

  1. Reglamento General de Protección de Datos (RGPD), available at https://eur-lex.europa.eu/
  2. “Incident Response & Computer Forensics, Third Edition” by K. Mandia, C. Prosise, and M. Pepe.
  3. G. Chandola, A. Banerjee, and V. Kumar, “Anomaly Detection: A Survey,” ACM Computing Surveys, vol. 41, no. 3, 2009.
  4. Scikit-learn Documentation, “Model Evaluation,” available at https://scikit-learn.org/stable/model_evaluation.html
  5. O’Reilly Media, “High Performance Spark: Best Practices for Scaling and Optimizing Apache Spark”.
  6. J. Reback et al., “Pandas: powerful Python data analysis toolkit,” available at https://pandas.pydata.org/
  7. Alla, Sridhar, and Suman Kalyan Adari. 2019, doi:10.1007/978-1-4842-5177-5
  8. Ageyev, Dmytro, et al. Lecture Notes on Data Engineering and Communications Technologies, 2022, pp. 287–305, doi:10.1007/978-3-030-95161-0_13
  9. Bency, J. (2017). Network based Anomaly Detection: An ensemble approach. In Dr. Dominic Carr, MSc Research Project [Thesis].
  10. Alaverronen, Sami, and Jussi Pohjola. “Pandas in Action: Analysis of China Related Advanced Persistent Threat Actors’ Tactics, Techniques & Procedures.” JYX, 1970, jyx.jyu.fi/handle/123456789/90108
  11. F. T. Liu, K. M. Ting and Z.-H. Zhou, “Isolation Forest,” 2008 Eighth IEEE International Conference on Data Mining, Pisa, Italy, 2008, pp. 413-422, doi: 10.1109/ICDM.2008.17
  12. M. H. Bhuyan, D. K. Bhattacharyya and J. K. Kalita, “Network Anomaly Detection: Methods, Systems and Tools,” in IEEE Communications Surveys & Tutorials, vol. 16, no. 1, pp. 303-336, First Quarter 2014, doi: 10.1109/SURV.2013.052213.00046
  13. Fei Tony Liu, Kai Ming Ting, and Zhi-Hua Zhou. 2012. Isolation-Based Anomaly Detection. ACM Trans. Knowl. Discov. Data 6, 1, Article 3 (March 2012), 39 pages. https://doi.org/10.1145/2133360.2133363
  14. A. B. Nassif, M. A. Talib, Q. Nasir and F. M. Dakalbab, “Machine learning for Anomaly Detection: A Systematic Review,” in IEEE Access, vol. 9, pp. 78658-78700, 2021, doi: 10.1109/ACCESS.2021.3083060
  15. Taeshik Shon, Jongsub Moon, A hybrid Machine learning approach to network anomaly detection, Information Sciences, Volume 177, Issue 18, 2007, ISSN 0020-0255, https://doi.org/10.1016/j.ins.2007.03.025
  16. Al-amri, Redhwan, et al. “A Review of Machine learning and Deep Learning Techniques for Anomaly Detection in IoT Data.” MDPI, Multidisciplinary Digital Publishing Institute, 8 June 2021, www.mdpi.com/2076-3417/11/12/5320
  17. Pajouh, H.H., Dastghaibyfard, G. & Hashemi, S. Two-tier network anomaly detection model: a Machine learning approach. J Intell Inf Syst 48, 61–74 (2017). https://doi.org/10.1007/s10844-015-0388-x
  18. Schölkopf, B., Platt, J., Shawe-Taylor, J., Smola, A. J., & Williamson, R. C. (2001). Estimating the support of a high-dimensional distribution. Neural Computation, 13(7), 1443-1471.
  19. Kavitha, R., & Kumaravel, N. (2020). Anomaly detection using deep autoencoders for cybersecurity applications. Journal of Information Security and Applications, 54, 102578.
  20. Ester, M., Kriegel, H. P., Sander, J., & Xu, X. (1996). A density-based algorithm for discovering clusters in large spatial databases with noise. Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD-96), 226–231.
  21. C. M. Bishop and N. M. Nasrabadi, Pattern Recognition and Machine Learning, vol. 4, no. 4, p. 738. New York: Springer, 2006.
  22. Internet Engineering Task Force (IETF), “The Transport Layer Security (TLS) Protocol Version 1.3,” RFC 8446, Aug. 2018.
  23. Python Software Foundation, “Python Language Reference,” https://docs.python.org/3/reference/index.html
  24. A. Orebaugh, G. Ramirez, and J. Beale, Wireshark & Ethereal Network Protocol Analyzer Toolkit, Syngress, 2007.
  25. K. Scarfone and P. Mell, “Guide to Intrusion Detection and Prevention Systems (IDPS),” NIST Special Publication 800-94, 2007.

Mapeo Autónomo en Entornos Industriales con Tecnología LiDAR: Una Respuesta a los Desafíos de Seguridad en el mundo de la Construcción

Dave Beon – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El problema de la seguridad en los entornos industriales siempre ha sido un reto constante durante la historia. Mucho más en áreas de construcción donde se está usando maquinaria pesada en terrenos irregulares, lo que genera riesgos para la integridad de los trabajadores, los cuales no se pueden ignorar. Esta situación, empeorada por baja visibilidad, polvo y condiciones climáticas cambiantes, motivó el desarrollo de una variedad de soluciones tecnológicas que no solo reducen los riesgos considerablemente, sino que también refuerzan los procesos de toma de decisiones. De este concepto nació: OBBOT, un robot autónomo capaz de mapear escenarios mediante tecnología LiDAR, desarrollado en la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la dirección del Ing. Jayro Martínez, como proyecto de grado del estudiante Dave Beon.

La iniciativa salió de la necesidad de optimizar la visualización en tiempo real en entornos laborales de alto riesgo. Ciertas soluciones convencionales, como cámaras y sensores ultrasónicos, han demostrado ser ineficaces ante condiciones operativas complejas. Con la tecnología LiDAR, junto con algoritmos SLAM y herramientas IoT, se pudo crear representaciones tridimensionales del ambiente en tiempo real, facilitando la detección de obstáculos y el monitoreo constante vía WebSocket de zonas de peligro. Este proyecto no solo representa un avance tecnológico, sino que también propone una alternativa efectiva y práctica para mejorar la seguridad laboral.

Las estadísticas de accidentes laborales en la industria de la construcción, citadas por la OIT (Organización Internacional del Trabajo), ponen en evidencia la gravedad de la problemática. Más allá de la pérdida humana, los accidentes son las causas de muchas interrupciones operativas, el aumento de costos y una disminución del bienestar de la fuerza laboral. En ese sentido, se vuelve primordial incorporar tecnologías inteligentes que permitan anticiparse a los riesgos. OBBOT responde a este fenómeno desde una visión integradora: un robot móvil, con percepción ambiental avanzada y comunicación en tiempo real hacia una plataforma (WebApp) centralizada accesible por los supervisores.

El diseño del robot se enfocó en tres ejes fundamentales: percepción precisa, navegación autónoma y conectividad eficiente. El prototipo integra un sensor LiDAR para la captura de los datos del ambiente, una arquitectura de procesamiento con ESP32 y un algoritmo SLAM que tiene el rol de autolocalización y de mapeo simultáneo. Además, se incorpora una unidad de medición inercial (IMU), la cual permite estimar la orientación del robot mediante acelerómetros y giroscopios, reforzando la precisión del sistema SLAM durante los desplazamientos y giros. La interfaz (WebSocket, WebApp) desarrollada en React y JavaScript, permite visualizar en tiempo real los mapas generados, brindando a los encargados de seguridad una herramienta visual poderosa y de fácil interpretación. A esto se le agrega una arquitectura IoT que facilita la transmisión continua de datos hacia el backend desarrollado en Node.js para análisis y monitoreo remoto.

Problemática y estado del arte

Los entornos industriales presentan una combinación de variables que dificultan la percepción del entorno en tiempo real, especialmente cuando las condiciones ambientales cambian rápidamente. La alta incidencia de accidentes laborales asociados al desconocimiento espacial inmediato ha sido ampliamente documentada por organismos como la OIT y estudios de seguridad ocupacional.

Las tecnologías tradicionales de monitoreo, como cámaras CCTV, sensores ultrasónicos o infrarrojos, tienen limitaciones frente a obstáculos no lineales, polvo, oscuridad o interferencias electromagnéticas. Por otro lado, los drones o soluciones aéreas pueden resultar ineficaces en espacios cerrados, además de costosos y difíciles de operar en tiempo continuo.

Frente a esto, el uso de sensores LiDAR se presenta como una alternativa robusta: permiten obtener datos de profundidad en alta resolución y en tiempo real, generando nubes de puntos que pueden ser transformadas en mapas del entorno. Sin embargo, el reto está en integrar esos datos con algoritmos eficientes de localización y navegación autónoma, como el SLAM (Simultaneous Localization and Mapping), y combinarlos con plataformas de bajo consumo energético y alta conectividad como el ESP32.

Estudios recientes han demostrado que los sistemas SLAM basados en LiDAR mejoran la autonomía de robots móviles en escenarios desconocidos [1][3][5]. No obstante, muchos de estos sistemas requieren potencias de cómputo elevadas o no integran adecuadamente la transmisión en tiempo real de los datos hacia plataformas externas, lo que limita su aplicación industrial.

Objetivos completados

Desarrollar este proyecto implementó un dispositivo autónomo de adquisición y visualización de datos utilizando tecnología LiDAR y algoritmos SLAM, IMU orientado a resolver los problemas de detección y monitoreo en entornos industriales complejos. El sistema integra una interfaz web intuitiva, conectividad IoT a través de un ESP32, y una arquitectura modular que permite mapeo en tiempo real, validando su utilidad en escenarios simulados y entornos semirreales con condiciones adversas.

Metodología

El diseño del sistema del OBBOT se fundamentó en una arquitectura modular. El sensor LiDAR y la IMU proporcionan datos de percepción del entorno y orientación del robot, los cuales son procesados por el ESP32. Este microcontrolador envía datos al servidor mediante Wi-Fi y WebSocket, donde luego son visualizados en una interfaz desarrollada en React y JavaScript. Simultáneamente, el ESP32 comunica instrucciones a la plataforma TI-RSLK, que coordina el movimiento del prototipo a través de motores y encoders. Esta segmentación funcional permite mejor escalabilidad, mantenimiento eficiente y respuesta en tiempo real.

Diagrama de arquitectura de OBBOT: sensores LiDAR e IMU, ESP32, plataforma TI-RSLK con encoders y ruedas, router Wi-Fi, servidor y página web
Figura 1. Diagrama de arquitectura del sistema OBBOT. Se muestra el flujo de datos desde los sensores LiDAR e IMU, a través del microcontrolador ESP32 y la plataforma TI-RSLK, hacia la interfaz web mediante WebSocket.

Resultados

Durante las pruebas, el sistema registró las posiciones relativas de los obstáculos detectados mediante el sensor LiDAR, generando tanto coordenadas cartesianas como un mapa de ocupación. Como se observa en las siguientes tablas y figuras, el sistema logró identificar y mapear objetos con una alta densidad de puntos, clasificando correctamente los espacios ocupados. La resolución espacial obtenida fue suficiente para construir mapas funcionales en tiempo real, lo que valida el uso del algoritmo SLAM y la precisión del sensor en condiciones simuladas.

PuntoX (mm)Y (mm)Distancia (mm)Ángulo (°)Calidad
132.7-620.64621.5273.0215
248.06-632.68634.5274.3415
362.41-644.49647.5275.5315
476.76-657.79662.25276.6615
591.8-671.76678.0277.7815
6109.79-684.75693.5279.1115
7126.21-697.93709.25280.2515
8143.48-713.21727.5281.3815
9903.47124.46912.07.8415
Tabla 1. Coordenadas captadas por el sensor LiDAR durante el proceso de mapeo.
Coordenadas (x,y)OcupadoLibre
141, -5210
142, -4510
142, -4210
144, -3910
144, -3510
144, -2910
Tabla 2. Fragmento del mapa de ocupación generado por el sistema.
Interfaz web de OBBOT con el lienzo del mapa, los datos del sensor IMU y los controles SLAM
Figura 2. Interfaz web del sistema OBBOT. Se muestra el panel de control SLAM con opciones de mapeo, calibración de sensores y visualización en tiempo real de los datos del sensor IMU.

Conclusión

OBBOT no solo representa un avance en la aplicación de tecnologías como LiDAR, SLAM e IoT en entornos industriales, sino que propone una ruta clara hacia la construcción de espacios laborales más seguros e inteligentes. Los resultados obtenidos en los entornos simulados validan la viabilidad técnica del sistema y su impacto potencial en la prevención de accidentes laborales. La arquitectura modular del sistema, junto con la visualización en tiempo real, facilita la adopción de este tipo de soluciones en industrias de alto riesgo.

A futuro, se planea escalar el prototipo para integrarlo con sistemas de gestión industrial, mejorar la precisión del mapeo SLAM e incorporar visión artificial para la identificación avanzada de elementos en el entorno. El proyecto deja abiertas múltiples posibilidades de evolución tecnológica y adaptación a otros dominios como la minería, logística o respuesta a emergencias.

Referencias

  1. T. Chen, F. Pu, H. Chen y Z. Liu, “WHUVID: A Large-Scale Stereo-IMU Dataset for Visual-Inertial Odometry and Autonomous Driving in Chinese Urban Scenarios,” Remote Sensing, vol. 14, 2022.
  2. D. Lee, S. Lee, P. Choi y D. Park, “Accuracy–Power Controllable LiDAR Sensor System with 3D Object Recognition for Autonomous Vehicle,” Sensors, p. 5706, 2020.
  3. X. Xu et al., “A Review of Multi-Sensor Fusion SLAM Systems Based on 3D LIDAR,” Remote Sensing, p. 2835, 2022.
  4. A. Patron-Perez, S. Lovegrove y G. Sibley, “A Spline-Based Trajectory Representation for Sensor Fusion and Rolling Shutter Cameras,” Int. J. Comput. Vis., pp. 208–219, 2015.
  5. S. H. Abdulredah y D. J. Kadhim, “Developing a real time navigation for mobile robots at unknown environments,” Indones. J. Electr. Eng. Comput. Sci., pp. 500–509, 2020.
  6. Embedded Systems Design with the Texas Instruments MSP432 32-bit Processor, Morgan & Claypool, 2017.
  7. P.-Y. Lajoie et al., “Modeling Perceptual Aliasing in SLAM via Discrete-Continuous Graphical Models.”
  8. A. Al-Hourani y B. Ristic, “MapperBot/iSCAN: open-source integrated robotic platform and algorithm for 2D mapping,” Int. J. Intell. Robot. Appl., pp. 44–56, 2020.
  9. S. Ceriani et al., “Pose Interpolation SLAM for large maps using moving 3D Sensors,” Int. Conf. Intell. Robots Syst., pp. 750–757, 2015.
  10. K. Narang, M. S. Kaushal y M. A. Gambhir, “Realtime Covid19 Tracker Using React,” Int. J. Innov. Res. Comput. Sci. Technol., vol. 8, no. 3, pp. 2347–5552, 2020.
  11. M. Mihálik et al., “The New Method of Active SLAM for Mapping Using LiDAR,” Electronics, p. 1082, 2022.

Jammer SDR

Andrys José Saldaña Marte y Edison de Jesús Paulino Jiménez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

En un contexto donde la conectividad inalámbrica domina nuestras interacciones cotidianas y profesionales, la seguridad en las comunicaciones se ha vuelto un tema crítico, especialmente en entornos donde la información sensible o el control del uso de dispositivos electrónicos resulta esencial. Frente a esta situación, surge el proyecto desarrollado por los estudiantes Andrys José Saldaña Marte y Edison de Jesús Paulino Jiménez, ambos cursantes de término de Ingeniería Telemática en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Este trabajo académico se ha centrado en diseñar un sistema de inhibición de señales inalámbricas basado en tecnología SDR (Software Defined Radio), bajo la dirección académica de la Escuela de Computación y Telecomunicaciones (EICT) de la PUCMM.

La motivación principal del proyecto se fundamenta en las limitaciones observadas en los sistemas tradicionales de inhibición de señales, que comúnmente presentan problemas de interferencia no deseada, alto costo y poca flexibilidad para adaptarse a necesidades específicas (Balzano, 2010). Estos problemas son particularmente evidentes en contextos críticos, como cárceles, instituciones educativas y organizaciones gubernamentales, donde la presencia de dispositivos electrónicos no autorizados puede facilitar actividades ilícitas o poner en riesgo la seguridad operativa (Schneir, 2017). Por ello, se consideró necesario explorar soluciones tecnológicas más innovadoras y económicas que permitieran un control preciso, local y éticamente responsable de las comunicaciones inalámbricas.

Este proyecto es relevante no solo desde una perspectiva técnica, sino también social y ética, dado que propone una solución que equilibra la necesidad de seguridad con el respeto a las normativas legales establecidas por entidades como INDOTEL (López Victoria, 2021). Al enfocarse en una implementación que prescinde del acceso a internet y opera totalmente de manera local mediante una interfaz intuitiva, se asegura un alto nivel de seguridad operativa y facilidad de uso, incluso para usuarios sin formación técnica especializada (Lisbon, 2020). Esta característica es clave para captar la atención de una audiencia amplia, desde profesionales del sector hasta tomadores de decisiones interesados en tecnologías que mejoren la gestión segura del espectro electromagnético.

Finalmente, el desarrollo de esta iniciativa representa un aporte significativo a la formación práctica y teórica de futuros ingenieros en el área de Telemática, fortaleciendo competencias clave como la gestión del espectro radioeléctrico, ciberseguridad y administración responsable de tecnologías emergentes como SDR (Marín, 2016). A través de este trabajo, la PUCMM reafirma su compromiso con la innovación tecnológica aplicada a problemas reales, formando profesionales capaces de liderar soluciones que impacten positivamente en la sociedad dominicana.

Problemática y estado del arte

La proliferación masiva de dispositivos inalámbricos ha transformado significativamente la forma en que las personas se comunican e interactúan, generando un amplio rango de beneficios, pero también múltiples desafíos relacionados con la seguridad y privacidad. Entre estos retos, destaca la presencia creciente de comunicaciones no autorizadas en entornos críticos, tales como centros penitenciarios, instituciones educativas, corporaciones y agencias gubernamentales. En República Dominicana, por ejemplo, se ha evidenciado ampliamente el uso de dispositivos móviles en prisiones para coordinar actividades delictivas desde el interior, lo que ha generado serias preocupaciones sociales y operativas (INDOTEL, 2025).

La problemática principal surge debido a la falta de precisión y selectividad, así como el alto precio en los sistemas tradicionales de inhibición de señales comúnmente conocidos como jammers. Estos dispositivos generalmente bloquean un amplio espectro electromagnético, afectando no solo las señales objetivo, sino también servicios esenciales legítimos. Esto ha derivado en una fuerte resistencia tanto social como regulatoria hacia estas tecnologías, debido a sus efectos colaterales negativos, especialmente en servicios de emergencia y telecomunicaciones autorizadas (Balzano, 2010).

Varios estudios previos han intentado abordar este problema mediante diferentes técnicas tecnológicas. Por ejemplo, en España, un prototipo de inhibidor inteligente basado en tecnología SDR demostró su eficacia al incorporar algoritmos de inteligencia artificial para identificar y bloquear únicamente señales específicas, principalmente en aplicaciones militares (López Victoria, 2021). Sin embargo, estos sistemas suelen estar limitados por su alto costo y la complejidad técnica involucrada, dificultando su implementación a gran escala en contextos menos especializados o con menores recursos económicos.

Otra investigación destacada en Portugal exploró el uso de plataformas SDR de bajo costo para inhibir señales GPS dirigidas específicamente a drones, demostrando que es posible diseñar sistemas económicos y precisos con hardware accesible (Lisbon, 2020). No obstante, estos desarrollos han estado muy enfocados en aplicaciones concretas y especializadas, dejando de lado la generalización hacia otros tipos de señales ampliamente utilizadas, como Wi-Fi, que son críticas en ambientes corporativos y educativos.

En Latinoamérica, proyectos como el realizado en la Universidad Nacional de Colombia (Marín, 2016) analizaron y emularon inhibidores de señales comerciales mediante plataformas económicas como RTL-SDR y GNU Radio. Aunque este estudio demostró la factibilidad técnica de replicar funciones de inhibición a bajo costo, no logró proveer un sistema completamente autónomo, fácil de configurar y seguro desde el punto de vista regulatorio, limitando considerablemente su implementación práctica.

Por otro lado, los sistemas comerciales existentes suelen presentar barreras adicionales de accesibilidad, ya sea por su costo elevado o por restricciones regulatorias y operativas. Los dispositivos disponibles en el mercado frecuentemente requieren infraestructura adicional o condiciones técnicas complejas para operar, lo que impide una adopción amplia y efectiva en sectores como el educativo o corporativo (Schneir, 2017).

Ante estas limitaciones, el presente proyecto de la PUCMM busca una solución tecnológica que combine bajo costo, precisión en la inhibición, facilidad de configuración, operación local segura y cumplimiento estricto de las regulaciones locales. El enfoque propuesto, basado en la integración de SDR con una interfaz web alojada localmente en una Raspberry Pi, ofrece una alternativa prometedora que supera muchas de las deficiencias mencionadas, proporcionando una herramienta efectiva y accesible para controlar comunicaciones no autorizadas de manera precisa y ética.

En resumen, el estado actual del arte muestra claramente que, aunque existen tecnologías capaces de abordar parcialmente estos problemas, aún no se ha desarrollado una solución integral que combine flexibilidad, costo accesible, precisión selectiva y autonomía operativa adaptada a contextos específicos. Este proyecto representa un esfuerzo significativo para cubrir esta brecha tecnológica, proporcionando una solución adaptable que cumpla con estas condiciones esenciales para ser efectiva en contextos reales.

El desarrollo de este proyecto ha logrado implementar un sistema inhibidor selectivo de señales inalámbricas, capaz de bloquear comunicaciones no autorizadas en bandas de frecuencia específicas y dentro de un área controlada. Para alcanzar este objetivo, se cumplió con la implementación de una interfaz sencilla y amigable para el usuario que permite la configuración y selección dinámica de frecuencias a bloquear; se desarrolló un método eficiente para identificar y bloquear dichas señales en tiempo real; se incorporó la gestión de perfiles de usuario y registro detallado de actividades operativas, así como funciones para la generación de alertas. Finalmente, se elaboró documentación técnica y manuales prácticos que facilitan el uso responsable y ético de la solución en distintos contextos críticos, asegurando su cumplimiento con las regulaciones locales.

Diagrama lógico: la Raspberry Pi 5 como servidor web y punto de acceso Wi-Fi alimenta al bladeRF x40, que envía la señal al amplificador y la antena
Figura 1. Diagrama lógico para la implementación del sistema.
Prototipo del inhibidor: Raspberry Pi en su carcasa, SDR, amplificador y dos antenas
Figura 2. Implementación física del esquema.

Metodología

Enfoque general de la solución

Para abordar la problemática descrita, se diseñó una solución tecnológica enfocada en la inhibición selectiva de señales inalámbricas, con la capacidad de operar en múltiples contextos, tales como instituciones educativas, centros penitenciarios, laboratorios académicos y entornos corporativos. Este enfoque fue específicamente concebido para permitir la elección precisa de frecuencias objetivo dentro del rango permitido por el hardware (300 MHz a 3.8 GHz), priorizando frecuencias como Wi-Fi y controles remotos, ampliamente utilizadas y susceptibles de generar riesgos operativos.

Diseño modular e integración de componentes

El diseño del sistema siguió una estructura modular compuesta por hardware y software específicos, incluyendo una plataforma SDR (Software Defined Radio), Raspberry Pi 5, antenas omnidireccionales de 12 dBi, amplificadores TX Nuand BT100 y una fuente de energía de 45 Watts. Esta configuración aseguró no solo una cobertura efectiva en un radio aproximado de 50 metros, sino también el cumplimiento estricto de límites regulatorios nacionales e internacionales de potencia y emisiones electromagnéticas.

Primer plano del amplificador BT-100 conectado al SDR
Figura 3. Amplificador BT-100.

Interfaz de usuario

Un aspecto innovador de la metodología fue el desarrollo de una interfaz web amigable y accesible alojada localmente, que permite gestionar de forma sencilla y rápida el sistema. Entre sus funciones clave se destacan la selección manual de frecuencias, gestión diferenciada de usuarios (administrativos y regulares), generación de reportes operativos, alertas de actividad y seguridad, y visualización gráfica avanzada (waterfalls, dominio de frecuencia, amplitud, constelación). La facilidad y claridad en el manejo de estas funciones han sido esenciales para garantizar que usuarios con diferentes niveles de conocimiento técnico puedan utilizar el sistema eficazmente.

Pantalla de inicio de la interfaz web con selección de provincia, canal Wi-Fi y frecuencia a bloquear
Figura 4. Interfaz gráfica: pantalla de inicio.

Seguridad y control de acceso

Perfiles diferenciados de usuarios. Los usuarios administrativos tienen acceso completo para configurar parámetros críticos, gestionar perfiles, exportar datos completos y administrar alertas, mientras que los usuarios regulares tienen permisos restringidos, limitados principalmente a consultar su propia información y actividades específicas del sistema.

Pantalla de gestión de usuarios de la interfaz web
Figura 5. Interfaz de gestión de usuarios.

Registro y análisis de operaciones

El sistema cuenta con una capacidad robusta para almacenar datos detallados sobre su operación. Se registran fechas y horas exactas de inicio y fin de cada sesión, usuarios responsables del bloqueo, frecuencias utilizadas y eventos de operación. Estos registros se almacenan en un formato CSV fácilmente exportable, permitiendo análisis posteriores que facilitan la evaluación continua del desempeño y cumplimiento normativo.

Validación y pruebas de desempeño

Se ejecutaron pruebas prolongadas en condiciones controladas para validar la estabilidad, efectividad y confiabilidad del sistema. Se logró mantener un bloqueo continuo de señales Wi-Fi durante aproximadamente 8 horas sin interrupciones ni incrementos significativos de temperatura. Adicionalmente, mediante pings extendidos a direcciones específicas como 8.8.8.8 se confirmó la efectividad del bloqueo dentro del área de cobertura establecida, destacando la robustez del sistema en escenarios operativos reales.

Limitaciones técnicas observadas

Durante las pruebas se identificaron limitaciones técnicas clave relacionadas principalmente con la potencia RF efectiva del hardware SDR, la direccionalidad inherente a las antenas utilizadas y las frecuencias específicas manejadas por el equipo. Estas limitaciones fueron consideradas en la configuración y operación del sistema para asegurar una eficacia óptima dentro del marco regulatorio vigente.

Cumplimiento normativo y ético

Para garantizar el uso responsable del sistema, se adoptaron medidas específicas alineadas con la Ley General de Telecomunicaciones (Ley 153-98) establecida por INDOTEL. Se restringieron explícitamente frecuencias asociadas a servicios críticos, informando claramente al usuario sobre restricciones regulatorias al intentar seleccionar frecuencias no autorizadas. Este cumplimiento estricto con las regulaciones asegura la integridad ética y legal del proyecto en su aplicación práctica.

Documentación técnica

Finalmente, se elaboró documentación técnica detallada incluyendo diagramas técnicos y diagramas de flujo para facilitar la replicabilidad y comprensión del sistema. Además, se contempló el desarrollo de manuales prácticos orientados a usuarios no técnicos, lo que permitirá una adopción más amplia y efectiva en diferentes contextos operativos.

Resultados

La implementación y pruebas del sistema inhibidor de señales inalámbricas arrojaron resultados positivos que validan claramente los objetivos planteados al inicio del proyecto. Una de las métricas más relevantes fue el alcance efectivo del sistema, que logró inhibir exitosamente señales Wi-Fi en un radio aproximado de 20 metros. Esta cobertura fue consistentemente comprobada mediante pruebas extensas y prolongadas, destacándose la robustez del sistema en comparación con soluciones existentes menos precisas y con mayor alcance, pero propensas a generar interferencias no deseadas.

El sistema mostró una alta estabilidad operativa durante las pruebas continuas, siendo capaz de mantener la inhibición efectiva de redes Wi-Fi durante aproximadamente 8 horas consecutivas sin interrupciones significativas o incrementos sustanciales de temperatura en los componentes críticos. Esta estabilidad operativa es comparable o superior a soluciones similares documentadas en investigaciones anteriores (López Victoria, 2021).

Además, se validó la capacidad del sistema para mantener una inhibición efectiva mediante técnicas de monitoreo continuo, como la ejecución de pings extendidos hacia direcciones específicas (8.8.8.8), lo que permitió confirmar la pérdida consistente de conectividad dentro del área delimitada mientras el sistema estaba activo. Este método de validación demostró claramente la confiabilidad y precisión del sistema en condiciones reales, siendo una técnica estándar en la evaluación de sistemas de inhibición inalámbrica (Lisbon, 2020). Adicionalmente, se diseñó un script específico que monitoreó continuamente el estado del ping durante todo el período de bloqueo, registrando de manera precisa si la dirección IP objetivo era alcanzable o no en cada instante, asegurando así un registro detallado y confiable del rendimiento del sistema en condiciones operativas prolongadas.

La interfaz de usuario diseñada fue ampliamente valorada durante las pruebas, permitiendo una operación sencilla, efectiva y segura. Las funciones disponibles, tales como la selección manual de frecuencias, gestión diferenciada de usuarios, generación de alertas y reportes gráficos (waterfalls, espectro de frecuencia, constelaciones), mostraron un rendimiento estable y facilitaron la toma rápida de decisiones operativas. Esto representa una mejora significativa frente a sistemas anteriores que carecían de interfaces intuitivas y claras para usuarios no técnicos (Ossmann, 2014).

Finalmente, el sistema demostró eficacia en la generación y exportación de registros operativos en formato CSV, almacenando datos completos sobre usuarios, frecuencias bloqueadas, fechas y horarios exactos de operación. Este aspecto es especialmente valioso, ya que permite realizar análisis posteriores con fines regulatorios y operativos, proporcionando evidencia clara del uso responsable y conforme a normativas del sistema (Schneir, 2017).

Para respaldar estos resultados, se incluyen evidencias visuales como gráficos del dominio de frecuencia, diagramas de constelación y capturas de pantalla de las interfaces y reportes generados, que permiten visualizar claramente el desempeño y eficacia del sistema desarrollado.

Gráficos en vivo de la interfaz: espectro FFT y waterfall en la banda de 2.4 GHz
Figura 6. Diagramas en vivo desde la interfaz gráfica.

Conclusión

El desarrollo de este proyecto permitió validar la posibilidad de implementar un sistema inhibidor selectivo de señales inalámbricas que funcione de forma autónoma y local, reduciendo significativamente el riesgo de interferencias no deseadas y maximizando el control operativo. Los resultados obtenidos reflejan un avance importante hacia soluciones más éticas y responsables, mostrando que es posible ofrecer a instituciones educativas, centros penitenciarios y entornos corporativos una herramienta eficaz para gestionar comunicaciones no autorizadas. Entre los principales aprendizajes destaca la necesidad de diseñar interfaces intuitivas que permitan la operación por usuarios con distintos niveles de conocimiento técnico, así como la importancia de integrar registros detallados que respalden un uso transparente y alineado con normativas regulatorias.

El proyecto también permitió identificar oportunidades de mejora claras, como optimizar el diseño físico para reducir tamaño y consumo energético, reforzar la documentación técnica para facilitar su adopción y entrenamiento de operadores, y explorar mejoras en algoritmos de detección y selección de señales para permitir un bloqueo aún más preciso y dinámico. Además, se propone fortalecer la seguridad del sistema mediante la implementación de protocolos adicionales de autenticación y control de acceso.

Como próximos pasos, se plantea continuar con la investigación y el perfeccionamiento del prototipo, realizar nuevas rondas de pruebas en condiciones más diversas, y buscar colaboraciones con instituciones públicas y privadas interesadas en adoptar esta solución. Asimismo, se recomienda explorar mecanismos de certificación y validación regulatoria para facilitar su uso en escenarios reales. Este proyecto representa solo el inicio de un camino prometedor para el desarrollo de tecnologías que ayuden a garantizar entornos más seguros y controlados, invitando a la comunidad académica y profesional a sumarse al esfuerzo para seguir innovando y contribuyendo al bienestar colectivo.

Referencias

  1. Balzano, Q., “Wireless interference: Issues and solutions,” IEEE Communications Magazine, vol. 48, no. 6, pp. 154–160, 2010.
  2. Schneier, B., Electronic Jamming Techniques and Network Security, Artech House, 2017.
  3. López Victoria, A., “Desarrollo de un prototipo de inhibidor inteligente de comunicaciones basado en tecnología SDR,” Universitat Politècnica de València, España, 2021.
  4. Lisbon, R., “Effective GPS Jamming Techniques for UAVs Using Low-Cost SDR Platforms,” Lisbon University, Portugal, 2020.
  5. Marín, A., “Análisis y emulación de inhibición de señales electromagnéticas usando RTL-SDR y GNU Radio,” Universidad Nacional de Colombia, 2016.
  6. Ossmann, M., Software Defined Radio with HackRF, Great Scott Gadgets, 2014.
  7. Reed, J., Software Defined Radio: Enabling Technologies, Wiley, 2020.
  8. INDOTEL, “Ley General de Telecomunicaciones 153-98,” República Dominicana, 1998.
  9. Tuttlebee, W. H. W., Software Defined Radio: Origins, Drivers, and International Perspectives, Wiley, 2002.
  10. Mitola, J., “Cognitive Radio: An Integrated Agent Architecture for Software Defined Radio,” Ph.D. Dissertation, KTH Royal Institute of Technology, 2000.
  11. Haykin, S., “Cognitive Radio: Brain-Empowered Wireless Communications,” IEEE Journal on Selected Areas in Communications, vol. 23, no. 2, pp. 201–220, 2005.
  12. Ulversøy, T., “Software defined radio: Challenges and opportunities,” IEEE Communications Surveys & Tutorials, vol. 12, no. 4, pp. 531–550, 2010.
  13. Hossein, A., “Wireless Jamming Attacks and Countermeasures,” IEEE Access, vol. 7, pp. 979–999, 2019.
  14. Popescu, A., “Low-Cost SDR-Based Jammers: Architecture and Analysis,” International Journal of Electronics and Communications, vol. 85, pp. 45–53, 2018.
  15. Roy, S., “Security, Privacy, and Jamming in the Internet of Things,” IEEE Wireless Communications, vol. 26, no. 5, pp. 30–37, 2019.
  16. Rondeau, T. W., GNU Radio: The Free & Open Source Radio Ecosystem, 2021.
  17. Ettus Research, “USRP Hardware Driver and SDR Concepts,” 2022.
  18. Nuand, “BladeRF x40 Documentation,” 2023.
  19. Katkar, A., “Analysis of Selective Jamming in Wi-Fi Networks,” International Journal of Wireless Networks, vol. 30, no. 2, 2021.
  20. Council of Europe, “Cybercrime Convention and Wireless Communication Regulation,” 2022.

La inteligencia artificial al servicio del aula: automatizando el seguimiento curricular en la enseñanza de algoritmia

Sara María Contreras Taveras y Higinio Rafael Santos Pérez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un entorno donde la tecnología transforma cada aspecto de nuestra vida, la educación no puede quedarse atrás. Uno de los desafíos más importantes que enfrentan las instituciones académicas es asegurar que los contenidos impartidos en el aula se correspondan fielmente con los programas oficiales. Esto es especialmente relevante en áreas como la programación y la algoritmia, donde cada tema mal impartido puede traducirse en deficiencias significativas en la formación profesional de los estudiantes.

En respuesta a esta problemática, se desarrolló un sistema automatizado de seguimiento y validación de contenidos académicos aplicado a la asignatura Introducción a la Algoritmia (ICC101) en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Este proyecto fue ejecutado por los estudiantes Sara María Contreras Taveras y Higinio Rafael Santos Pérez, como parte de su trabajo final de grado en la carrera de Ingeniería en Ciencias de la Computación, bajo la tutoría del Ing. Brayan Muñoz.

La motivación principal para esta iniciativa surgió al identificar que, a pesar de contar con un plan académico bien estructurado, no existía una herramienta objetiva que permitiera validar su cumplimiento durante el semestre. Las supervisiones académicas eran esporádicas, manuales y basadas en la percepción, lo cual dificultaba la implementación de mejoras fundamentadas en evidencia.

Nuestro objetivo fue desarrollar una solución que, aprovechando tecnologías como el reconocimiento de voz y la inteligencia artificial, permitiera capturar lo que ocurre en clase, analizar su contenido y compararlo con los temas estipulados en el currículo. De esta manera, se buscó no solo monitorear la cobertura temática, sino también ofrecer a los docentes y autoridades académicas una herramienta útil para la mejora continua de la enseñanza.

La falta de mecanismos eficaces para verificar el cumplimiento del programa académico en el aula ha sido identificada como una debilidad estructural en múltiples sistemas educativos, tanto a nivel local como internacional. Según la UNESCO [1], una de las principales causas de la brecha educativa está relacionada con la falta de alineación entre los contenidos enseñados y los contenidos planificados. Esta situación impacta directamente en la formación de los estudiantes, quienes podrían egresar sin haber adquirido los conocimientos fundamentales de sus respectivas áreas.

En el contexto dominicano, este desafío se agudiza. Las instituciones de educación superior carecen de herramientas automatizadas que permitan monitorear de manera sistemática lo que ocurre en el aula. Esto implica que muchas veces se desconoce con exactitud si los objetivos de aprendizaje se están cumpliendo, lo que genera una desventaja tanto para los estudiantes como para los docentes y coordinadores académicos.

La asignatura Introducción a la Algoritmia (ICC101), por su naturaleza formativa y su papel como base para cursos más avanzados, es especialmente sensible a este tipo de desviaciones. Si no se imparte correctamente, se compromete la capacidad del estudiante para enfrentar asignaturas posteriores como estructuras de datos, programación orientada a objetos o diseño de algoritmos.

Diversas investigaciones han abordado esta problemática desde distintas perspectivas. Por ejemplo, Johnson, Boon y Thompson [2] propusieron el uso de sistemas de alineación curricular basados en minería de texto para verificar la cobertura temática. Su propuesta se centraba en analizar materiales de clase como presentaciones o exámenes, pero no abordaba el contenido verbal impartido en el aula.

Por otro lado, Matsane y Ajoodha [3] demostraron que la combinación de reconocimiento automático del habla y procesamiento de lenguaje natural puede ser efectiva para capturar el contenido de clases en tiempo real. Sin embargo, su estudio se enfocaba en contextos de aprendizaje de idiomas, sin una estructura curricular definida que sirviera como referencia para la validación.

En 2020, la UNESCO publicó un informe titulado “AI in Education: Guidance for Policymakers” [1], en el que se destacaba el potencial de la inteligencia artificial para mejorar la supervisión educativa. Entre sus recomendaciones, se encontraba el desarrollo de sistemas automatizados que permitieran comparar lo enseñado con lo planificado, facilitando así intervenciones oportunas. Sin embargo, a pesar de la claridad de estas recomendaciones, su implementación efectiva en países en desarrollo ha sido limitada.

Aunque existen soluciones comerciales para la transcripción automática o el análisis de texto educativo, muchas son costosas, poco adaptables a contextos específicos o requieren grandes volúmenes de datos para su entrenamiento. Además, pocas se integran con el currículo oficial de una asignatura, lo que las hace ineficientes para tareas de validación curricular directa.

Frente a esta situación, el sistema propuesto en este proyecto se diferencia por su enfoque específico en la alineación curricular, su adaptabilidad al contexto local y su diseño modular. Nuestro sistema fue entrenado con el programa oficial de ICC101 y validado con clases reales de la PUCMM, garantizando así su pertinencia y aplicabilidad.

El desarrollo de este proyecto ha culminado exitosamente en la creación de un sistema automatizado capaz de supervisar y validar el contenido impartido en la asignatura ICC101 – Introducción a la Algoritmia, garantizando su alineación con el programa académico oficial. A partir de este objetivo general, se alcanzaron metas específicas como: implementar un sistema de transcripción automatizada de clases mediante tecnologías de reconocimiento de voz; desarrollar un módulo de análisis de contenido utilizando procesamiento de lenguaje natural e inteligencia artificial para comparar las transcripciones con los temas del currículo; y construir un dashboard interactivo que presenta visualmente métricas clave de cumplimiento temático. Cada uno de estos objetivos fue definido con claridad, medible en su funcionalidad, alcanzable dentro del alcance académico, relevante para la mejora de la calidad educativa, y delimitado en un marco temporal definido durante el semestre de desarrollo.

La metodología desarrollada para este proyecto representa un avance significativo respecto a los enfoques tradicionales de supervisión académica, integrando de manera novedosa tecnologías de reconocimiento automático del habla, procesamiento de lenguaje natural y análisis semántico especializado. A diferencia de las soluciones previas que se limitaban a transcribir contenido o analizar materiales estáticos, nuestro enfoque combina la captura en tiempo real del discurso académico con un sistema de validación curricular específicamente entrenado para el dominio de la algoritmia.

Arquitectura modular

Diagrama de despliegue: cliente JavaFX, servidor de aplicaciones Spring Boot, servidor de base de datos PostgreSQL y servidor de procesamiento Python con Silero VAD, Whisper y modelo NLP
Figura 1. Arquitectura del sistema.

El diseño del sistema se fundamenta en una arquitectura de tres capas que garantiza tanto la eficiencia operacional como la escalabilidad futura. La primera capa corresponde al cliente desarrollado en JavaFX, que proporciona una interfaz intuitiva para la captura y carga de audios. La segunda capa constituye el servidor de gestión implementado con Spring Boot, responsable de coordinar los flujos de datos y gestionar la lógica de negocio. La tercera capa integra un servicio especializado de procesamiento desarrollado en Python, que ejecuta las tareas computacionalmente intensivas de transcripción y análisis semántico. Esta separación de responsabilidades permite optimizar el rendimiento del sistema y facilita futuras extensiones o modificaciones [4]. La comunicación entre capas se establece mediante APIs RESTful, asegurando la interoperabilidad y permitiendo que cada componente pueda evolucionar independientemente.

Preprocesamiento inteligente con detección de actividad vocal

Flujo de captura de audio: grabación WAV, conversión a MP3 con FFmpeg, envío al servicio Python, limpieza con Silero VAD y envío del audio limpio al backend
Figura 2. Flujo del módulo Captura y Carga de Audios.

Una de las innovaciones metodológicas más significativas del proyecto radica en la implementación de Silero VAD (Voice Activity Detection) como etapa de preprocesamiento. Esta tecnología, desarrollada específicamente para entornos ruidosos, permite identificar automáticamente segmentos de audio que contienen voz humana, descartando silencios prolongados, ruido ambiente y otras interferencias que podrían afectar la calidad de la transcripción posterior. La integración de esta tecnología representa una mejora sustancial respecto a los métodos tradicionales que procesan el audio completo sin discriminación [5].

El algoritmo de detección implementado utiliza redes neuronales profundas entrenadas en múltiples idiomas, lo que garantiza su efectividad en el contexto del español dominicano. Los resultados experimentales demuestran reducciones promedio del 26% en la duración de las grabaciones procesadas, optimizando significativamente los recursos computacionales necesarios para las etapas posteriores.

Transcripción automatizada

Gráfico de barras que compara la tasa de error por palabra (WER %) de wav2vec2-large y Whisper Large en catorce conjuntos de prueba
Figura 3. Desempeño comparativo de Whisper y wav2vec2 en tareas de reconocimiento de voz.

Para la conversión de audio a texto, el sistema integra Whisper que es un modelo de reconocimiento automático del habla desarrollado por OpenAI. Elegimos esta tecnología por su robustez en entornos académicos y su capacidad para manejar variaciones en la calidad del audio. Radford et al. (2023) documentan que Whisper supera significativamente a modelos anteriores en tareas de transcripción multilingüe, alcanzando niveles de precisión comparables a transcriptores humanos en condiciones controladas [6].

La implementación realizada optimiza el proceso de transcripción mediante la conversión automática de formatos de audio. El sistema procesa archivos en formato MP3 convertidos desde WAV utilizando FFmpeg, garantizando la compatibilidad con diversos dispositivos de grabación mientras mantiene la calidad necesaria para un análisis preciso. Esta aproximación contrasta con soluciones previas que requerían formatos específicos o equipos especializados, aumentando la accesibilidad y usabilidad del sistema.

Análisis semántico multietiqueta con BERT

El enfoque principal del proyecto reside en la implementación de un modelo de clasificación multietiqueta basado en la arquitectura BERT, específicamente adaptado para reconocer los 36 temas oficiales del programa de ICC101. Esta nueva forma de abordar el problema mejora notablemente los métodos anteriores, que se basaban en buscar palabras clave o hacer análisis estadísticos simples. Ahora, el sistema puede entender mejor el significado de lo que se dice, incluso cuando los conceptos se expresan de manera indirecta o con sinónimos.

El modelo implementado utiliza dccuchile/bert-base-spanish-wwm-uncased como base, un modelo preentrenado específicamente para el español que ha demostrado rendimiento superior en tareas de procesamiento de lenguaje natural en contextos hispanohablantes. Koroteev, M. V. (2021) enfatiza que la selección de modelos preentrenados apropiados para el idioma objetivo es crucial para alcanzar resultados óptimos en aplicaciones de análisis de texto especializado [7]. La personalización del modelo mediante fine-tuning con datos específicos de la asignatura permite capturar las particularidades del lenguaje académico utilizado en el contexto de la algoritmia.

MétricaValor
Precisión0.71
Recall0.86
F1-Score0.76
Tabla 1. Resultados del modelo multietiqueta con BERT.

Estrategia de entrenamiento con LLM

Una de las ideas centrales de nuestra metodología fue la implementación de una estrategia de clasificación asistida por GPT-4, un modelo de lenguaje de gran escala (LLM), para organizar y etiquetar datos de entrenamiento con alta calidad. En vez de depender de anotaciones manuales, un proceso lento e incómodo, se optó por un enfoque automatizado que permitió mejorar la eficiencia y coherencia del etiquetado.

Mientras que los datos en sí fueron generados y ampliados utilizando diversas técnicas de data augmentation basadas en herramientas NLP, fue el modelo GPT-4 el que se utilizó específicamente para clasificar y organizar esos datos según temas curriculares. Para lograrlo, diseñamos prompts cuidadosamente orientados, que instruían al modelo a identificar categorías temáticas de forma precisa, evitando sesgos o interpretaciones erróneas.

Este enfoque se enmarca dentro del paradigma de teacher-student learning, donde el modelo generativo actúa como “profesor” para ayudar a entrenar a un clasificador más simple o supervisado. Además, los hallazgos coinciden con lo reportado por Maharana et al. (2022), quienes demostraron que la combinación de aumento de datos con validación humana selectiva puede mejorar sustancialmente el rendimiento en tareas de clasificación especializadas [8].

Análisis de profundidad temática

Además de identificar los temas tratados, el sistema cuenta con un módulo que evalúa qué tan a fondo se aborda cada uno. Este componente combina diferentes métricas como coherencia discursiva, densidad conceptual y similitud semántica para analizar la profundidad con la que se desarrolla cada tema a lo largo de la transcripción.

Para lograrlo, se utilizan técnicas de embeddings semánticos y agrupamiento temático que permiten segmentar el contenido y asignar una puntuación compuesta que refleja el nivel de profundidad académica. Este tipo de enfoque ha demostrado ser más efectivo que los métodos clásicos como TF-IDF o conteo de frecuencia, al capturar matices del lenguaje y relaciones conceptuales más sutiles [9].

La metodología considera varias dimensiones al mismo tiempo: qué tan bien se alinea el contenido con el currículo oficial, la coherencia entre bloques temáticos consecutivos, la complejidad del vocabulario empleado y la concentración de conceptos clave por unidad de tiempo. Con este enfoque se busca ofrecer una evaluación más precisa y real, y no solo centrarse en técnicas que no profundizan verdaderamente en la forma que se aborda cada contenido.

Tema principalProfundidad avanzadaNivel de profundidadCoherencia temática
Parámetros y valores de retorno en subprogramas0.484Medio0.586
Operadores0.532Medio0.568
Utilización de variables banderas, contadoras y acumuladoras0.489Medio0.617
Conversiones de tipo0.526Medio0.564
Tabla 2. Análisis de profundidad realizado por el sistema.

La implementación del sistema de seguimiento y validación de contenidos académicos en la asignatura ICC101 produjo resultados altamente satisfactorios, tanto desde el punto de vista técnico como pedagógico. Al aplicar la solución en entornos reales, se obtuvieron datos cuantitativos y cualitativos que demuestran su efectividad y superioridad frente a enfoques manuales o sistemas genéricos de evaluación.

Uno de los resultados más destacados fue la precisión del 92% en la transcripción automática del audio, incluso en aulas con ruido ambiente moderado. Esto fue posible gracias a la integración del modelo Whisper y al preprocesamiento con Silero VAD, lo que permitió filtrar silencios y fragmentos irrelevantes antes del análisis. En comparación, sistemas anteriores basados en Wav2Vec2 o Google STT presentaban una precisión media inferior al 85% en condiciones similares.

En cuanto al modelo de clasificación temática BERT multietiqueta, se alcanzó un F1-score promedio del 76%, con una precisión del 71% y un recall del 86% al identificar correctamente los temas impartidos en clase según el currículo oficial. Estas métricas superan ampliamente a métodos clásicos de análisis de texto como TF-IDF o conteo de palabras clave, que no sobrepasaban el 50% de precisión en pruebas preliminares.

El sistema también demostró su capacidad para evaluar la profundidad con la que se abordan los temas, algo que rara vez es considerado en herramientas educativas. Por ejemplo, se observó que clases centradas en estructuras repetitivas y funciones lograron una puntuación de profundidad superior al 70%, mientras que temas como “Cadenas de caracteres” tendieron a aparecer de forma superficial en varias sesiones, con una profundidad inferior al 40%. Esto permitió detectar necesidades de refuerzo específicas.

Durante la fase de validación experimental se analizaron más de 20 sesiones reales de clase, correspondientes a distintos docentes y secciones. En todos los casos, el sistema fue capaz de generar análisis completos en menos de 3 minutos, incluyendo visualización, segmentación y generación de reportes automáticos. Este desempeño en tiempo casi real representa una mejora sustancial frente a las auditorías manuales, que pueden tomar horas o incluso días.

Los resultados se presentan en una interfaz clara que ha sido validada por profesores y coordinadores académicos, quienes destacaron especialmente la utilidad de los gráficos comparativos y la posibilidad de identificar desviaciones temáticas de forma visual. Entre las funcionalidades más valoradas se encuentran el gráfico de pastel del cumplimiento temático, el histograma de profundidad por unidad y el timeline de evolución temática, los cuales serán incluidos en la versión extendida del blog con sus respectivas capturas de pantalla.

Además, se logró generar automáticamente un conjunto de reportes PDF por clase, donde se detallan los temas tratados, su coherencia, profundidad, y alertas sobre posibles omisiones. Estos reportes pueden ser archivados, compartidos y utilizados como insumo para procesos de mejora pedagógica o evaluaciones internas.

Pantalla de grabación de audio con cronómetro y botones Guardar y Cancelar
Figura 4. Pantalla de grabación.
Lista de clases analizadas con su estado completado y progreso del 100 %
Figura 5. Lista de las clases analizadas.
Dashboard de análisis con temas detectados y no detectados, gráficos de pastel, profundidad y coherencia por tema y evolución por bloques
Figura 6. Dashboard con los resultados del análisis.

La implementación del sistema ha demostrado su potencial para transformar la supervisión académica mediante la provisión de datos objetivos y procesables sobre el proceso de enseñanza. La capacidad del sistema para generar reportes automáticos que destacan desviaciones del currículo y proporcionan métricas de cobertura temática representa un avance significativo hacia la mejora continua de la calidad educativa.

Los resultados indican que el sistema puede identificar efectivamente patrones en la enseñanza, detectar áreas que requieren mayor atención, y proporcionar retroalimentación valiosa tanto para docentes como para administradores académicos. Esta capacidad de análisis sistemático permite implementar intervenciones oportunas cuando se identifican brechas en la cobertura curricular, asegurando que los estudiantes reciban una formación alineada con los objetivos establecidos.

Para instituciones que consideren adoptar este enfoque, se recomienda implementar desde el inicio estrategias de aumento de datos y balanceo de clases para mitigar sesgos derivados de distribuciones desiguales de temas. La incorporación de modelos de lenguaje avanzados como apoyo en las etapas iniciales de clasificación puede agilizar significativamente la preparación del conjunto de entrenamiento, siempre combinado con validación humana.

Referencias

  1. F. Miao, W. Holmes, R. Huang, H. Zhang, and UNESCO, “AI and education: Guidance for policymakers,” pp. 1–50, 2023. Accessed: Jul. 17, 2025. [Online]. Available: https://books.google.com/books/about/AI_and_education.html?hl=es&id=yyE7EAAAQBAJ
  2. C. E. Johnson, H. J. Boon, and M. D. Thompson, “Curriculum Alignment After Reforms: A Systematic Review with Considerations for Queensland Pre- and In-service Teachers,” Aust. J. Teach. Educ., vol. 45, no. 11, pp. 33–55, 2020, doi: 10.14221/ajte.202v45n11.3.
  3. L. Matsane, A. Jadhav, and R. Ajoodha, “The use of Automatic Speech Recognition in Education for Identifying Attitudes of the Speakers,” 2020 IEEE Asia-Pacific Conf. Comput. Sci. Data Eng. CSDE 2020, Dec. 2020, doi: 10.1109/CSDE50874.2020.9411528.
  4. A. Arora and S. Srinivasan, Artificial Intelligence in Education: Promises and Implications for Teaching and Learning. Springer Nature, 2020. Accessed: Jul. 17, 2025. [Online]. Available: https://discovery.ucl.ac.uk/id/eprint/10139722/
  5. R. Takeda and K. Komatani, “Scale-invariant Online Voice Activity Detection under Various Environments,” APSIPA ASC 2024 – Asia Pacific Signal Inf. Process. Assoc. Annu. Summit Conf. 2024, 2024, doi: 10.1109/APSIPAASC63619.2025.10848584.
  6. A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust Speech Recognition via Large-Scale Weak Supervision,” Jul. 03, 2023, PMLR. Accessed: Jul. 17, 2025. [Online]. Available: https://proceedings.mlr.press/v202/radford23a.html
  7. M. V. Koroteev, “BERT: A Review of Applications in Natural Language Processing and Understanding,” Mar. 2021. Accessed: Jul. 17, 2025. [Online]. Available: https://arxiv.org/pdf/2103.11943
  8. K. Maharana, S. Mondal, and B. Nemade, “A review: Data pre-processing and data augmentation techniques,” Glob. Transitions Proc., vol. 3, no. 1, pp. 91–99, Jun. 2022, doi: 10.1016/j.gltp.2022.04.020.
  9. A. Petukhova, J. P. Matos-Carvalho, and N. Fachada, “Text Clustering with Large Language Model Embeddings,” Dec. 2024, doi: 10.1016/j.ijcce.2024.11.004.

Bot de Asistencia Interactivo en Programas de Algoritmos y Diagramas de Programación para la Asignatura de “Introducción a la Algoritmia”

Natasha María López Concepción y Vladimir Osvaldo Curiel Ovalles – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Durante los últimos años, el mundo ha experimentado uno de los desafíos más grandes del siglo XIX: “La pandemia del COVID-19”. Una emergencia sanitaria que obligó a todo planeta tierra a cambiar radicalmente la forma en que vivían [1]. Asimismo, esta situación llevó a que millones de instituciones académicas cambiaran drásticamente la forma en la que desarrollaban las clases. Forzadas a abandonar sus aulas físicas y migrar a entornos totalmente virtuales, generando así un nuevo paradigma en la educación [2].

Por otro lado, este cambio fue profundamente estructural. Donde, la modalidad virtual, que inicialmente fue una respuesta temporal ante la situación de emergencia, se mantuvo alrededor del mundo incluso tras el retorno parcial y total de las clases presenciales. Lo que antes se consideraba como una alternativa, pasó a ser parte de las metodologías académicas. Sin embargo, esta nueva forma de impartir clases también trajo consigo misma, retos importantes en la vida estudiantil: distracciones, falta de interacción significativa, ansiedad y una dependencia creciente de las herramientas digitales como fuentes principales de información y resolución de tareas [3].

En este contexto, nace la idea de nuestro proyecto, desarrollado por un equipo de dos estudiantes de la carrera de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra. La iniciativa surge como una respuesta directa a una preocupación común entre docentes y estudiantes: “¿Estamos realmente aprendiendo en esta manera nueva de impartir clases? ¿o sólo estamos sobreviviendo académicamente gracias a la tecnología?” [4].

La motivación detrás del desarrollo de este proyecto fue precisamente la anterior mencionada: entender cómo el uso creciente de herramientas de Inteligencia Artificial está transformando el aprendizaje, no sólo como un apoyo, sino como un reemplazo de la figura docente en algunos casos. En ese mismo marco, desarrollamos el Bot de Asistencia Interactivo en Programas de Algoritmos y Diagramas de Programación para la Asignatura de “Introducción a la Algoritmia”, una iniciativa que busca brindar acompañamiento académico continuo a estudiantes de primer año, especialmente en temas donde suelen presentarse mayores dificultades. Además, esta herramienta se enfoca en fortalecer la comprensión de conceptos y figuras claves en la lógica computacional mediante un entorno educativo conversacional accesible, pero sin sustituir el papel pedagógico del docente.

En adición a esto, estudios actuales evidencian que la utilización de chatbots en contextos académicos puede tener efectos positivos en el proceso de formación y crecimiento académico del estudiantado, facilitando procesos educativos innovadores y motivadores [5]. Por lo tanto, creemos con firmeza que la tecnología debe complementar y enriquecer el proceso educativo, no reemplazarlo.

Los retos del aprendizaje virtual

A raíz de la transformación abrupta que creó la pandemia de COVID-19, las instituciones educativas se vieron obligadas a adoptar métodos de enseñanza digital, dando lugar a una transición acelerada hacia las clases virtuales. Esta modalidad, si bien resolvió una necesidad inmediata, también expuso debilidades importantes en el ámbito educativo, especialmente en el área de Ciencias en Computación. La virtualización lejos de desaparecer, con el regreso de la presencialidad, se ha integrado y se ha vuelto un componente híbrido en muchas universidades. Sin embargo, esta incorporación no ha sido del todo equilibrada: los niveles de distracción en el hogar, el aislamiento académico que se presenta y el uso inapropiado de dispositivos, han afectado la calidad del aprendizaje.

Uno de los principales retos que los estudiantes enfrentan, es la comprensión de contenidos como algoritmos y diagramas de programación, los cuales exigen una interpretación visual y lógica que difícilmente puede lograrse de forma pasiva a través de una grabación de clase. Asimismo, la falta de herramientas automatizadas que estructuren, resuma y clarifiquen estos materiales visuales ha generado una barrera significativa, tanto en términos de motivación como en el desarrollo lógico. De la misma forma, diversos estudios muestran que hasta un 95% de los estudiantes utilizan su celular para actividades no académicas durante clases virtuales, en comparación con un 75% en la modalidad presencial y un incremento del 20% en sesiones virtuales [3].

La ansiedad y la falta de comunicación ha generado un impacto en los estudiantes. Se ha observado en los ambientes virtuales, donde el 58% estudiantes tienden a evitar formular preguntas al docente fuera del horario de clases, mientras que, en la modalidad presencial, se puede apreciar que el 43% de estos son los que no interactúan, probando un 15% más de interacción en la presencialidad [6].

Uno de los problemas que radica de este cambio es que al recurrir a estos modelos pierde todo el contexto académico: el programa de la asignatura, las palabras del docente, el libro de texto de la materia e incluso como el profesor interpreta el libro y lo transmite a sus estudiantes. De igual modo, existen pruebas realizadas de rendimiento con diez demostraciones de preguntas que indicaron que, modelos como Chat GPT (modelo de verano 2024) pueden obtener hasta 80% de la puntuación correcta en comparación con el promedio de profesionales en el área, llegando hasta un 96.7%, con una pérdida de conocimiento del 16.7%, además, afirman que existe una pérdida notable al agregar tablas grandes o complejas y lo mismo sucede con preguntas de contenido mostrado en clase, ya que pierde todo el contexto en la que la información fue dada [7].

Esto causa que los estudiantes al final del día se encuentren consumiendo una gran cantidad de contenido generado por IA que no está supervisado, y del mismo modo, realizando sus tareas de esta forma, donde esto baja mucho el desarrollo de sus habilidades, pensamientos lógicos y críticos. Con esto no implica rechazar la usabilidad de la inteligencia artificial en el ambiente educativo, puesto que diversas afirmaciones señalan que la IA proporciona ventajas significativas a los estudiantes, incluyendo la adaptación personalizada del proceso formativo, el fortalecimiento de la motivación académica, la proyección del rendimiento estudiantil y múltiples beneficios adicionales [8].

Por otro lado, se han explorado varios enfoques técnicos para abordar problemas relacionados con la captura, análisis e interpretación de diagramas de flujo y algoritmos. Proyectos como DiagramVoice, han utilizado PySceneDetect y OCR para asistir a personas con discapacidad visual en la comprensión de materiales educativos visuales [9]. Del mismo modo, el proyecto BloSum ha automatizado la generación de descripciones textuales a partir de diagramas mediante detección de formas y relaciones [10]. Diagram Parse Graphs (DPG), utiliza redes neuronales para responder preguntas que están basadas en contenido visual [11].

Aunque estas soluciones muestran gran potencial, la gran mayoría se enfoca en demandas de configuraciones técnicas complejas, haciéndolas difícil de usar para estudiantes con recursos tecnológicos limitados. Por lo mismo, no existen tantas herramientas que prioricen las necesidades del alumno. Por esta razón, nuestra propuesta pretende reducir esa limitación mediante el desarrollo de una herramienta que no únicamente automatice la identificación y extracción de diagramas y códigos, sino que además produzca explicaciones que los estudiantes puedan comprender y que se adapten al contexto pedagógico.

El desarrollo de este proyecto ha implementado la creación de un Bot automatizado integrado en una aplicación web que utiliza herramientas de inteligencia artificial para facilitar la comprensión sobre programas de algoritmos y diagramas de programación explicados en las clases de la asignatura de “Introducción a la Algoritmia” de carácter virtual, mejorando la accesibilidad a los materiales de estudio, la claridad en las explicaciones de conceptos complejos y la eficiencia en el aprendizaje. También, recolectamos sesiones virtuales grabadas de la asignatura, donde contienen códigos y diagramas de programación, pasándolas al Bot donde dio como resultado la esquematización y explicación de los procesos generados en dichas sesiones. Implementamos un sistema que utiliza bibliotecas de IA y se emplearon explicaciones claras y detalladas de los diagramas de programación y programas de algoritmos. Evaluamos el rendimiento del prototipo con el modelo detectando el código y diagrama, obteniendo los resultados más precisos. Por último, creamos una aplicación web para estudiantes y docentes, que permite a los profesores vincular sus perfiles para acceder a las clases, y los alumnos pueden tener acceso al contenido (explicaciones, acercamientos similares, ejercicios) generados por el Bot de forma automatizada basado en el contenido de la sesión.

Un Bot que trabaja sobre clases reales

Como se ha dicho anteriormente, esta herramienta no busca sustituir al docente ni eliminar la necesidad de participación activa en clase, sino brindar un apoyo automatizado para organizar, interpretar y facilitar el acceso a los contenidos más complejos vistos durante la clase. Asimismo, esta solución radica en su capacidad de conectar múltiples tecnologías en un flujo centrado automatizado para el mejoramiento y acompañamiento académico.

El sistema desarrollado es un Bot de asistencia que trabaja sobre videograbaciones de clases reales. Este detecta automáticamente bloques de código y diagramas mediante segmentación de escenas. A partir de esto, se genera el contenido interpretado en lenguaje natural, permitiendo tanto estudiantes como docentes acceder a explicaciones comprensibles sin necesidad de revisar la clase completa.

Este Bot a diferencia de soluciones previas, no depende de contenido preparado, sino que trabaja con grabaciones reales y contenido generado por el docente. Gracias a las técnicas de visión por computadora y procesamiento de lenguaje natural, el sistema es capaz de identificar los fragmentos relevantes, extraer imágenes y texto de ellos, y estructurar explicaciones a partir de lo visualizado en clases. El estudiante con esa herramienta puede retomar un concepto específico visto en clases, repasarlo y reforzarlo en el momento que lo necesite.

La interfaz web que integra el Bot, permite a docentes y estudiantes conectar sus cuentas de Microsoft Teams para poder iniciar con el procedimiento de la creación de reportes. Del mismo modo, el Bot se encarga de procesar el material grabado, y descarta todo el contenido visual que no contenga diagramas de flujo o líneas de código. Esto es muy importante, ya que preserva la privacidad al limitar el alcance del análisis a datos que son necesarios para el aprendizaje del estudiante.

El sistema permite que el usuario pueda navegar por la sesión de manera libre, encontrando lo que el código o diagrama que buscar sin ninguna dificultad. Además, una de las características más valiosas del proyecto es el diseño accesible. El uso de explicaciones generadas a partir de diagramas que permite que estudiantes comprendan y estén conscientes de lo que se muestra. También, el Bot permite aquellos que no se sienten cómodos formulando preguntas en clase, permitiéndoles explorar el contenido a su ritmo.

Por otro lado, este Bot representa un avance frente a otras herramientas que existen. Integrando tecnologías como PySceneDetect [12] para la segmentación de videos, SuryaOCR [13] para el reconocimiento y extracción de texto, y modelos como YOLOv12 [14] para la detección visual.

Aunque el proyecto se enfoca exclusivamente en la asignatura de “Introducción a la Algoritmia”, esta permite pensar en futuras extensiones hacia otras materias, siempre que incluyan elementos visuales similares. Esto permite que el Bot se pueda utilizar en diferentes asignaturas académicas generalizada en carreras técnicas que incluyan diagramas y algoritmos.

Diseño del sistema

Por otro lado, se realizaron diagramas de flujo para mayor entendimiento de cómo se iba a realizar el bot:

Diagrama de procesos: captura del video, filtrado de frames, segmentación y detección, extracción, organización e interpretación del contenido
Figura 1. Diagrama de procesos.

El sistema comienza con la entrada de una videoclase previamente grabada por el docente. A través de un proceso de segmentación de escenas donde el Bot identifica los momentos más relevantes del contenido. Luego, mediante modelos de detección visual, extrae imágenes de diagramas o fragmentos de código. Estos son analizados y convertidos en texto explicativo accesible para el estudiante. El proceso concluye con la visualización de este contenido en la plataforma web.

Diagramas de flujo del Bot (entrada, procesamiento, evaluación, salida, usuarios) y del cliente (usuario, videoconferencia, plataforma web, módulo de reportes, retroalimentación)
Figura 2. Diagrama del Bot y del cliente.

En el Diagrama del Bot, el prototipo utilizará videos de clases pregrabadas así permitiendo el procesamiento automatizado del contenido educativo. Asimismo, usando herramientas de OCR, análisis de código y reconocimiento de diagramas, se extraerán los elementos clave de las clases, garantizando una interpretación precisa de la información presentada en pantalla. Posteriormente, se realizará una validación de los datos extraídos, asegurando su precisión. También, la información procesada se estructurará en reportes organizados y accesibles, facilitando la consulta del material de manera clara y comprensible donde los estudiantes podrán acceder al contenido a través de una plataforma web, brindando una experiencia intuitiva y centralizada para la consulta de los reportes generados. En el Diagrama del Cliente, accede a la plataforma a través de una interfaz web diseñada para ser intuitiva. Desde allí, puede buscar el reporte de la clase si ya se procesó, y visualizar los fragmentos detectados con sus explicaciones correspondientes. El sistema permite navegar fácilmente por diagramas o bloques de código asociados a una sesión, fomentando el aprendizaje autónomo y dirigido.

Además, el sistema está compuesto por distintos servicios desplegados en contenedores, asegurando su escalabilidad y modularidad. Incluye un frontend, servicios de procesamiento de video, OCR, detección visual, y una base de datos para el almacenamiento estructurado del contenido generado. Este diseño permite su implementación tanto en entornos locales como en la nube.

El sistema contempla distintas acciones que puede ejecutar cada tipo de usuario. El estudiante puede visualizar contenidos procesados, realizar búsquedas por tema o clase, y recibir retroalimentación automatizada. Por otro lado, el docente puede subir grabaciones, revisar estadísticas de uso y verificar qué partes de la clase fueron más consultadas.

Resultados: el prototipo LogicMate

A lo largo del desarrollo del prototipo, se obtuvieron resultados sorprendentes y favorables que validan su funcionalidad general y su gestión aplicada para entornos educativos. El proceso de análisis automatizado de clases grabadas demostró ser eficiente, permitiendo identificar y organizar contenidos relevantes sin necesidad de intervención manual constante. Esto representa una mejora significativa respecto a los métodos tradicionales de repaso y consulta de videoclases completas.

Para mejor visualización de lo anteriormente dicho, se le presenta por medio de imágenes, el prototipo finalizado y sus explicaciones detalladas de cada vista de la interfaz web:

Esta representa el punto de interacción directa entre el usuario y la aplicación. El diseño está enfocado en ofrecer una experiencia intuitiva, accesible y visualmente coherente con los objetivos del proyecto al estudiante y docente que lo utilicen.

Página de inicio de LogicMate con el lema Smart summaries code and diagrams y botones de Login y Dashboard
Figura 3. Página de inicio de la interfaz web.

Esta es la pantalla principal al ingresar a la plataforma, donde el usuario puede ver una pequeña introducción de qué tratará el Bot llamado Logic Mate, el Bot desarrollado, incluyendo este una vista previa de su funcionamiento. También, en esta visual el usuario puede iniciar sesión por medio del botón de Login. Además, al hacer clic en el botón Dashboard, este será redirigido a la pantalla de inicio de sesión, donde deberá ingresar sus credenciales para acceder y utilizar las funcionalidades del bot.

El usuario puede ingresar sus credenciales (correo y contraseña) para acceder a las funcionalidades del Bot. En caso de que no esté registrado, la interfaz le da la oportunidad de poder registrarse y luego poder iniciar sesión. Si el usuario no tiene sus credenciales, no podrá hacer uso del Bot y sus funcionalidades que ofrece. Se debe utilizar el mismo correo institucional para que las clases realizadas en Teams luego de ser procesadas salgan de forma automática.

Vista para subir un video y diálogo para agregar participantes al reporte
Figura 4. Página de subir video y para compartir el procesamiento a más participantes.

En esta sección, el usuario puede seleccionar y cargar un video. Esta visual también permite que más participantes puedan acceder al reporte del video y puedan hacer uso del mismo para sus estudios.

Vista del reporte: video de la clase junto a los fragmentos de código detectados con su explicación
Figura 5. Página de visualización del reporte creado.

Aquí se puede visualizar el reporte ya creado. El usuario puede ir viendo la sesión junto al reporte que el Bot realizó. También, puede visionar cada corte de escena donde se está explicando el código y/o diagrama de flujo visto en clases. Puede seguir la explicación del docente junto al reporte creado.

La interfaz también permite que el usuario pueda ver el código generado por el docente en clases y tenerlo a mano para cualquier ocasión donde lo quiera usar para repaso junto al reporte creado por el Bot, o poder probarlo y confirmar con el docente. De forma similar al código, el usuario puede ver el diagrama de flujo empleado en clases.

Vista de chat con el Bot con opciones para explicar el contenido, formas de abordaje, ejercicios prácticos y representación visual
Figura 6. Página para charlar con el Bot directamente.

Se creó un espacio, donde el usuario puede hacerle preguntas sobre la clase procesada al Bot directamente. Este puede explicar el contenido visto en clases, crear ejercicios sobre la misma, hacer una representación visual para mayor entendimiento de lo explicado, y demás.

Vista de enfoques de la clase con una versión optimizada de la serie de Gregory en C
Figura 7. Página de enfoques vistos en la clase.

El usuario puede revisar detenidamente los enfoques vistos en la clase, donde puede ver una opción optimizada o explicada detalladamente, para mayor comprensión.

Vista de ejercicios propuestos con enunciados y solución desplegable
Figura 8. Página de ejercicios propuestos para practicar lo visto en clases.

Se visualiza un apartado para obtener ejercicios generados automáticamente por el bot junto a sus soluciones. Estos basados en el contenido de la clase procesada.

Vista de calendario mensual con las sesiones de Introducción a la Algoritmia
Figura 9. Página del calendario.

Por último, en esta vista se puede ver detalladamente las reuniones de la materia en particular, Introducción a la Algoritmia, donde el usuario puede tener para un día en específico clases o reuniones de estudio con el docente. Este calendario está conectado con la plataforma Teams.

El sistema logró extraer elementos visuales clave como bloques de código y diagramas, y generar explicaciones comprensibles que facilitan el entendimiento por parte del estudiante. Se observaron niveles de precisión y consistencia altos, lo que evidencia el trabajo de los módulos utilizados para segmentar y procesar la información. Además, se redujo considerablemente la cantidad de datos innecesarios, lo que optimizó el tiempo de procesamiento y la experiencia del usuario.

Durante las pruebas de funcionamiento, se identificó que el sistema es capaz de adaptarse a diferentes tipos de contenidos dentro de una misma clase, manteniendo la calidad en la organización y visualización de los resultados. Estas pruebas también mostraron que el sistema puede ser útil tanto para repasar temas específicos como para revisar de forma estructurada toda una sesión académica.

Finalmente, el sistema fue expuesto a situaciones reales de uso en las que se comprobó su utilidad para estudiantes en etapa de formación básica. Los comentarios recogidos destacaron su facilidad de uso y el valor que aporta al momento de estudiar por cuenta propia, especialmente en temas que suelen generar mayor dificultad.

Conclusión

En conclusión, el proyecto desarrollado demuestra que es posible aplicar soluciones tecnológicas de forma efectiva en el contexto educativo para mejorar la experiencia de aprendizaje. Al automatizar la identificación y explicación de contenidos complejos, se ofrece al estudiante una herramienta de apoyo que complementa el trabajo del docente y fomenta el estudio autónomo.

Este enfoque no solo contribuye a la comprensión de materias técnicas, sino que también propone una forma más ordenada y accesible de interactuar con el contenido académico, especialmente útil en ambientes virtuales o híbridos. Esta solución muestra que la tecnología, bien aplicada, puede ayudar en el proceso de enseñanza y aprendizaje.

Referencias

  1. S. Prakash, Ashok Kumar Verma, “IMPACT OF COVID-19 ON ENVIRONMENT AND SOCIETY,” 2020, India, pp. 7352–7363, 2020. Available: www.mutagens.co.in/jgb/vol.09/05/090506.pdf
  2. C. L. Huamán D and C. R, “Virtual education during the pandemic from the perspective of Peruvian teachers in rural schools,” 2022, Perú, pp. 215–242, 2022. doi: 10.21678/apuntes.92.1744.
  3. K. A. Teodorescu Daniel, “College Students’ Distractions from Learning Caused by Multitasking in Online vs. Face-to-Face Classes: A Case Study at a Public University in Romania,” vol. 19, no. 18, p. 11188, 2022, doi: 10.3390/ijerph191811188.
  4. K. Webster, “The COVID-19 Learning Divide: How Demographics Shaped Online Learning Outcomes for High School Students,” September 2024, Northern Illinois University, USA, pp. 427–444, 2024. doi: 10.24059/olj.v28i3.3680.
  5. L. Yudi and R. W. Luis, “Chatbot basado en inteligencia artificial para la educación escolar,” 06-Abr-2023, Lima, Apr. 2023. doi: 10.33996/revistahorizontes.v7i29.614.
  6. CCCSE, “The Online Student: Impact of Course Modality on Engagement,” 2023. doi: 10.26153/TSW/48699.
  7. I. Avramovic, Sanja; Avramovic, “Exploring the Potential Benefits and Limitations of Using an AI Text-Generation Tool in Education: An Examination of ChatGPT’s Performance on Assessments,” 1 march 2024, pp. 193–204, 2024. [Online]. Available: https://www.ingentaconnect.com/contentone/aupha/jhae/2024/00000040/00000002/art00004
  8. P. Svitlana, Lytvynova; Natalya, Rashevska; Svitlana, “The use of artificial intelligence in teaching students programming languages,” pp. 10–29, 2024. [Online]. Available: https://ceur-ws.org/Vol-3781/paper01.pdf
  9. N. Eun and J. Lee, “DiagramVoice: Automatic Lecture Video Commentator for Visually Impaired Students Supporting Diagram Commentary,” 2024, pp. 381–391, 2024. doi: 10.1007/978-981-97-3559-4_31.
  10. L. Shreyanshu, Bhushan; Minho, “Block Diagram-to-Text: Understanding Block Diagram Images by Generating Natural Language Descriptors,” pp. 153–168, 2022. doi: 10.18653/v1/2022.findings-aacl.15.
  11. F. Aniruddha, Kembhavi; Mike, Salvato; Eric, Kolve; Minjoon, Seo; Hannaneh, Hajishirzi; Ali, “A Diagram Is Worth A Dozen Images,” 2016. doi: 10.48550/ARXIV.1603.07396.
  12. B. Castellano, “PySceneDetect,” https://www.scenedetect.com/api/.
  13. “Surya OCR Implementation,” https://lightning.ai/mehta/studios/surya-ocr-implementation?view=public&section=featured.
  14. Y. Tian, Q. Ye, and D. Doermann, “YOLOv12: Attention-Centric Real-Time Object Detectors,” Feb. 2025.

Modelo Predictivo para la Identificación de Fake News en Español sobre la Enfermedad del Cáncer utilizando Machine Learning

José Rafael Jáquez Torres y Brigibel Ysaura Martínez Martínez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La desinformación sobre el cáncer: un reto hispanohablante

El crecimiento del internet y las redes sociales ha cambiado la manera en que se accede y se distribuyen las noticias. No obstante, este crecimiento también ha propiciado la propagación de la desinformación. En ese sentido, uno de los sectores más afectados por esta difusión es el de la salud, particularmente en enfermedades como el cáncer. Conforme a lo señalado por el Instituto Nacional del Cáncer de Estados Unidos [1], existe una gran cantidad de desinformación acerca del cáncer en la red, lo que incluye videos e historias que predican curas milagrosas con tratamientos no comprobados científicamente y en algunos casos dañinos para la salud.

Esta problemática está particularmente presente en las comunidades hispanohablantes, donde las barreras lingüísticas y culturales dificultan el acceso a información verificada. Un artículo de Think Global Health [2] destaca que la difusión de información falsa en el ámbito de la salud representa un desafío significativo creciente en las comunidades de habla hispana, principalmente en Estados Unidos. Además, menciona que los hispanohablantes suelen depender de redes sociales como principal fuente de información, lo que los hace más vulnerables a recibir y compartir contenido con información falsa o inexacta, ya que los algoritmos de estas plataformas no siempre priorizan fuentes verificadas.

Dada esta situación, resulta necesario desarrollar soluciones efectivas capaces de identificar y disminuir la desinformación en español, proporcionando a las comunidades hispanohablantes recursos más confiables para tomar decisiones mejor informadas, lo que puede prevenir acciones que puedan resultar dañinas para la salud de los mismos.

A pesar de los avances en la detección de fake news, la mayoría de los recursos disponibles están en el idioma inglés, dejando un vacío en la comunidad hispanohablante. Los pocos sistemas que existen en español suelen basarse en adaptaciones de modelos monolingües o en traducciones automatizadas, lo cual afecta su precisión y contextualización cultural [2].

En ese orden, los primeros acercamientos técnicos se fundamentan en métodos basados en reglas y heurísticas, que identifican patrones lingüísticos y estructuras típicas de la desinformación [3], [4]. Aunque estos sistemas sentaron las bases de la detección automática, su rigidez y dependencia de reglas manuales limitan su capacidad para adaptarse a la creatividad y la evolución constante del lenguaje en entornos digitales [5].

Con la consolidación del aprendizaje supervisado, se introdujeron clasificadores clásicos como SVM [6], Random Forest [7], XGBoost [8] y Naïve Bayes [9] entrenados sobre vectores TF-IDF [10] y optimizados con técnicas de búsqueda de hiperparámetros. Paralelamente, las redes neuronales densas (DNN) demostraron un rendimiento superior (94.5 % de accuracy) al compararlas directamente con algoritmos tradicionales utilizando el FakeNewsNet dataset [11].

Ahora bien, la llegada de arquitecturas Transformers [12] ha elevado aún más la efectividad de los modelos, permitiendo capturar relaciones contextuales bidireccionales y matices semánticos complejos. Sin embargo, la mayoría están preentrenados en inglés o en múltiples idiomas sin especialización para el español, lo que dificulta su aplicación directa en la detección de noticias sobre cáncer en este idioma.

Finalmente, las estrategias de transferencia cross-lingual y zero-shot [13] ofrecen un camino prometedor para aprovechar recursos en inglés sin sacrificar la contextualización cultural en español. Modelos basados en BERT [14] como mBERT, BETO y XLM-RoBERTa han demostrado viabilidad en escenarios de pocos datos etiquetados, aunque aún requieren validación específica en el dominio del cáncer y ajustes finos para maximizar su precisión en la comunidad hispanohablante. Es por esto que:

El desarrollo de este proyecto ha implementado un modelo predictivo que emplea técnicas de aprendizaje automático para identificar de esta manera noticias falsas en español sobre el cáncer, mediante la recopilación de noticias que son tanto de fuentes verificadas como falsas, aplicando posteriormente técnicas de preprocesamiento de texto para asegurar que este sea de utilidad para el análisis y modelado de los datos. De igual forma, se aplicó la adaptación específica del modelo al idioma español para mejorar el acceso de la comunidad hispanohablante, así como la evaluación rigurosa con métricas estándar de clasificación y el diseño de una interfaz gráfica que integra el modelo, permite realizar pruebas interactivas y verificar su funcionamiento.

Del corpus al prototipo: un flujo modular

La propuesta se basa en un flujo de trabajo modular que integra captura, procesamiento, modelado y despliegue. Partimos de una recolección híbrida de datos (corpus público, artículos científicos y ejemplos manuales/sintéticos) para alimentar tanto modelos tradicionales (SVM, Random Forest, XGBoost) como arquitecturas Transformer (BETO, mBERT). A continuación, cada subsistema se diseñó, implementó y validó por separado antes de su integración final en un prototipo funcional.

1. Recolección de datos

Se utilizó el FakeNewsCorpusSpanish [15], que aporta 1248 noticias (624 reales y 624 falsas). Complementariamente, se extrajeron 1,176 artículos de SciELO [16] (2018-2024) mediante Selenium [17], y se incorporaron 105 declaraciones falsas verificadas manualmente junto a 100 párrafos generados con Grok 3 para simular patrones de desinformación realistas.

2. Preprocesamiento y normalización

El preprocesamiento unificó formatos y limpió el texto: eliminación de caracteres especiales, tokenización con nltk.punkt, eliminación de stopwords y lematización con spaCy. Para modelos basados en BETO se empleó el BertTokenizer (bert-base-spanish-wwm-uncased) con Byte Pair Encoding, ajustando secuencias a 512 tokens. Este pipeline se fundamentó en estudios comparativos de técnicas de preprocesamiento en español, que muestran variaciones significativas en precisión y tiempo de ejecución según la combinación de métodos.

3. Creación y entrenamiento de modelos predictivos

Se evaluaron cinco algoritmos tradicionales sobre vectores TF-IDF con Grid Search CV [18] para ajustar hiperparámetros, y distintas arquitecturas basadas en BETO (Original, BETO+SVM, BETO+LSTM, BETO+BiLSTM). Además, se experimentó con mBERT + SVM para explorar capacidades cross-lingual. Asimismo, la eficiencia de las técnicas de Deep Learning para la detección de noticias falsas en español ha sido validada en trabajos como “Fake News Detection in Spanish Using Deep Learning Techniques”.

4. Validación y métricas

El rendimiento de cada modelo se midió utilizando métricas entre las cuales se encontraban el accuracy, precision, recall, F1-score, ROC-AUC y AUPRC, empleando validación cruzada de 5 folds para estimar estabilidad. En ese sentido, la inclusión de AUPRC, recomendada para clases desbalanceadas, confirmó diferencias mínimas respecto a AUROC [19], reforzando la precisión del sistema en distintos escenarios.

5. Integración del prototipo

El backend se desplegó en Flask sirviendo un servicio REST que recibe texto, lo tokeniza y devuelve la clasificación. La interfaz web, implementada en React/NextJS, admite texto manual, archivos (TXT, PDF) mediante un API en Spring Boot [20] y extracción de enlaces (YouTube, Reddit, webs) mediante Trafilatura, reddit-api y youtube-api-server [21]. Por lo que, esta UI permite la extracción de contenido en distintos formatos como enlaces o archivos, y adicionalmente proporciona feedback inmediato permitiendo al usuario validar la confianza del texto analizado.

Interfaz web del detector: sección para ingresar una URL, el texto de la noticia o un archivo
Figura 1. Interfaz del prototipo: sección de ingreso de información.
Interfaz web del detector: resultado del análisis y formulario de retroalimentación
Figura 2. Interfaz del prototipo: resultado del análisis y sección de retroalimentación.

6. Herramientas y buenas prácticas

Se utilizó Python 3.9 [22], GitHub [23] para versionado, Docker [24] para contenedores reproducibles y GPU NVIDIA RTX 2070 o P100 para entrenamiento acelerado. Así pues, a diferencia de la mayoría de estudios centrados en inglés o en dominios específicos, nuestra metodología incorpora un corpus balanceado en español y explora transferencias cross-lingual sin traducción previa.

A continuación, una breve explicación de cada métrica evaluada en los modelos seleccionados:

  • Accuracy (exactitud): proporción de predicciones correctas (verdaderas + falsas) sobre el total de muestras [62].
    Accuracy = (TP + TN) / (TP + FP + FN + TN)
  • Precisión: de todas las muestras que el modelo etiquetó como positivas (por ejemplo, “fake news”), ¿qué porcentaje lo era realmente? [25]
    Precision = TP / (TP + FP)
  • Recall: de todas las muestras realmente positivas, ¿qué porcentaje el modelo identificó correctamente? [26]
    Recall = TP / (TP + FN)
  • F1-Score: media armónica entre precisión y recall. Es útil cuando existe un desequilibrio de clases [25].
    F1 = 2 · (Precision · Recall) / (Precision + Recall)
  • Specificity: de todas las muestras negativas (“noticias verdaderas”), ¿qué porcentaje se clasificó correctamente como negativas? [26]
  • ROC AUC: área bajo la curva ROC, mide la capacidad de distinguir entre clases en todos los umbrales posibles [25].
  • AUPRC: área bajo la curva Precision–Recall, especialmente relevante cuando las clases están desbalanceadas [19].
  • Cohen’s Kappa: coeficiente de acuerdo entre predicciones y verdad terreno, corregido por el azar [26].
  • MCC (Matthews Correlation Coefficient): métrica balanceada que considera verdaderos y falsos positivos y negativos; toma valores en [–1, +1], donde +1 es predicción perfecta [26].
  • Loss (pérdida): función objetivo optimizada durante el entrenamiento (en los modelos clásicos se muestra como “Loss” del conjunto de validación). Así pues, valores menores indican mejor ajuste [26].
Esquema de la curva ROC con un modelo perfecto, uno aceptable y uno aleatorio
Figura 3. Interpretación de la curva ROC: modelo perfecto, modelo aceptable y modelo aleatorio.

Construyendo confianza: resultados contra las fake news

A continuación, se presenta un análisis descriptivo de los resultados obtenidos con los distintos modelos, tanto los clásicos (SVM, Random Forest, Logistic Regression, XGBoost y Naive Bayes) como los de enfoque deep learning (basados en BETO).

ModeloValidación cruzadaAccuracyPrecisionRecallF1-ScoreSpecificityROC AUCAUPRCCohen’s KappaMCCLoss
SVMCon CV0.81450.8150.80380.80920.80380.89860.90240.62870.62890.4021
Random ForestCon CV0.81820.85080.7610.80320.7610.90780.91150.63520.63890.4397
Logistic RegressionCon CV0.810.80150.81180.80620.81180.90260.90990.61990.62050.3946
XGBoostCon CV0.81380.81410.82550.81970.80150.90270.9070.62730.62740.4088
Naive BayesCon CV0.7710.8170.68430.74380.68430.87260.88910.53980.54750.5836
Tabla 1. Resultados de los modelos clásicos con validación cruzada.

Random Forest sobresale entre los clásicos con 81.82 % de accuracy y AUPRC≈0.91, superando ligeramente a XGBoost y SVM.

Naive Bayes sufre por el desequilibrio de clases y la representación bag-of-words, quedando en 77.10 % de exactitud y MCC≈0.55.

Las pérdidas de validación (“Loss”) se sitúan entre 0.39 y 0.58, indicando que los modelos clásicos requieren más ajuste o datos para igualar al deep learning.

ModeloAccuracyPrecisionRecallF1-ScoreSpecificityROC AUCAUPRCCohen’s KappaMCC
BETO + SVM0.97040.97250.96450.96840.97590.98920.99040.94060.9407
BETO0.96330.96990.95180.96020.97340.99060.9910.92610.9271
mBERT + SVM0.93450.93620.93960.93780.92890.97460.97850.86850.8687
mBERT0.93180.91980.96210.93950.89730.9730.97650.86180.865
Tabla 2. Resultados de los modelos basados en Transformers.

BETO + SVM alcanza el mejor balance, con 97 % de accuracy y AUPRC≈0.99, mostrando que la combinación de embeddings de BETO y un clasificador lineal SVM captura tanto las noticias verdaderas como las falsas de forma casi perfecta.

El modelo BETO queda muy cerca, indicando que el vector pooled de BETO ya codifica suficiente información, pero añadiendo SVM se gana un +0.7 % en accuracy y +0.014 en MCC.

Los enfoques mBERT comparado con BETO son más bajos, debido a su vocabulario multilingüe más genérico: mBERT + SVM logra 93.45 % de accuracy frente al 96.04 % de BETO, y su MCC cae de 0.94 a 0.87.

Hacia un futuro sin desinformación

El proyecto ha demostrado que los modelos basados en Transformers son una buena opción para la detección de desinformación sobre el cáncer. Cabe destacar que, aunque la combinación BETO + SVM alcanzó los puntajes más altos en métricas como accuracy y AUPRC, su rendimiento en pruebas reales resultó menos consistente que en el que se aplicó únicamente BETO. En cambio, BETO logró cerca de un 97 % de precisión tanto en el dataset de entrenamiento como en los escenarios reales, por lo que fue el modelo seleccionado para el despliegue final, garantizando una clasificación estable y confiable.

Como recomendaciones futuras, se plantea ampliar el conjunto de datos colaborando con hospitales y organismos de salud hispanohablantes, así como expandir el alcance del prototipo a otras patologías críticas como la diabetes, enfermedades cardiovasculares, etc. En ese sentido, invitamos a la comunidad académica y a posibles aliados a participar aportando datos, retroalimentación activa y recursos para reentrenar el modelo, mejorar la usabilidad de la interfaz y desplegar esta solución en plataformas de producción. Todo esto, con el objetivo de seguir combatiendo de manera efectiva la creciente ola de desinformación.

Referencias

  1. Equipo del NCI, “La desinformación sobre el cáncer en las redes sociales.” [Online]. Available: https://www.cancer.gov/espanol/noticias/temas-y-relatos-blog/2021/desinformacion-sobre-cancer-redes-sociales
  2. I. Rolz, “Debunking Health Misinformation in Latino Communities.” [Online]. Available: https://www.thinkglobalhealth.org/article/debunking-health-misinformation-latino-communities
  3. M. Choras et al., “Advanced Machine Learning Techniques for Fake News (Online Disinformation) Detection: A Systematic Mapping Study,” 2021, arXiv. doi: 10.48550/ARXIV.2101.01142.
  4. N. Hoy and T. Koulouri, “A Systematic Review on the Detection of Fake News Articles,” 2021, arXiv. doi: 10.48550/ARXIV.2110.11240.
  5. C. Ireton, J. Posetti, and UNESCO, Eds., Journalism, “fake news” & disinformation: handbook for journalism education and training. in UNESCO series on journalism education. Paris: United Nations Educational, Scientific and Cultural Organization, 2018.
  6. N.-I. Galanis, P. Vafiadis, K.-G. Mirzaev, and G. A. Papakostas, “Machine Learning Meets Natural Language Processing — The story so far,” 2021, arXiv. doi: 10.48550/arXiv.2104.10213.
  7. L. Breiman, “Random Forests,” Mach. Learn., vol. 45, no. 1, pp. 5–32, 2001, doi: 10.1023/A:1010933404324.
  8. T. Chen and C. Guestrin, “XGBoost: A Scalable Tree Boosting System,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, San Francisco California USA: ACM, 2016, pp. 785–794. doi: 10.1145/2939672.2939785.
  9. E. Frank and R. R. Bouckaert, “Naive Bayes for Text Classification with Unbalanced Classes,” in Knowledge Discovery in Databases: PKDD 2006, vol. 4213, D. Hutchison et al., Eds., Berlin, Heidelberg: Springer Berlin Heidelberg, 2006, pp. 503–510. doi: 10.1007/11871637_49.
  10. D. E. Cahyani and I. Patasik, “Performance comparison of TF-IDF and Word2Vec models for emotion text classification,” Bull. Electr. Eng. Informatics, vol. 10, no. 5, pp. 2780–2788, 2021, doi: 10.11591/eei.v10i5.3157.
  11. L. Rojas Rubio and C. Meneses Villegas, “Una comparación empírica de algoritmos de aprendizaje automático versus aprendizaje profundo para la detección de noticias falsas en redes sociales,” Ingeniare. Rev. Chil. Ing., vol. 30, no. 2, pp. 403–415, 2022, doi: 10.4067/S0718-33052022000200403.
  12. K. Martínez-Gallego, A. M. Álvarez-Ortiz, and J. D. Arias-Londoño, “Fake News Detection in Spanish Using Deep Learning Techniques,” 2021, arXiv. doi: 10.48550/arXiv.2110.06461.
  13. M. Strong, R. Aly, and A. Vlachos, “Zero-Shot Fact Verification via Natural Logic and Large Language Models,” 2024, arXiv. doi: 10.48550/ARXIV.2410.03341.
  14. S. Kasim, “One True Pairing: Evaluating Effective Language Pairings for Fake News Detection Employing Zero-Shot Cross-Lingual Transfer,” in Soft Computing and Its Engineering Applications, vol. 1788, K. K. Patel, K. C. Santosh, A. Patel, and A. Ghosh, Eds., Cham: Springer Nature Switzerland, 2023, pp. 17–28. doi: 10.1007/978-3-031-27609-5_2.
  15. jpposadas, “jpposadas/FakeNewsCorpusSpanish,” 2024. Accessed: Feb. 07, 2025. [Online]. Available: https://github.com/jpposadas/FakeNewsCorpusSpanish
  16. “Programa SciELO, Modelo de Publicación y Red SciELO | SciELO.org.” Accessed: Mar. 28, 2025. [Online]. Available: https://scielo.org/es/sobre-el-scielo/programa-modelo-de-publicacion-y-red-scielo/
  17. “Selenium.” Accessed: Mar. 28, 2025. [Online]. Available: https://www.selenium.dev/
  18. “GridSearchCV.” Accessed: Mar. 28, 2025. [Online]. Available: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GridSearchCV.html
  19. W. Chen et al., “Commonly used software tools produce conflicting and overly-optimistic AUPRC values,” Genome Biol., vol. 25, no. 1, p. 118, May 2024, doi: 10.1186/s13059-024-03266-y.
  20. “Spring Boot.” Accessed: Mar. 24, 2025. [Online]. Available: https://spring.io/projects/spring-boot
  21. “youtube-transcript-api: This is an python API which allows you to get the transcripts/subtitles for a given YouTube video. It also works for automatically generated subtitles, supports translating subtitles and it does not require a headless browser.” Accessed: Jun. 09, 2025. [Online]. Available: https://github.com/jdepoix/youtube-transcript-api
  22. “Welcome to Python.org,” 2025. Accessed: Mar. 24, 2025. [Online]. Available: https://www.python.org/about/
  23. “Build software better, together.” Accessed: Mar. 24, 2025. [Online]. Available: https://github.com
  24. “What is Docker? | Docker Docs.” Accessed: Mar. 28, 2025. [Online]. Available: https://docs.docker.com/get-started/docker-overview/
  25. A. de la Torre, “Reconocimiento de emociones musicales y generación de un dataset de etiquetado categórico,” E.T.S. de Ingenieros Informáticos (UPM), 2019. Accessed: Feb. 13, 2025. [Online]. Available: https://oa.upm.es/56029/
  26. V. de Dios Domínguez, “Fake news detection with pretrained transformers,” E.T.S. de Ingenieros Informáticos (UPM), 2023. Accessed: Feb. 13, 2025. [Online]. Available: https://oa.upm.es/75835/