José Rafael Jáquez Torres y Brigibel Ysaura Martínez Martínez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)
La desinformación sobre el cáncer: un reto hispanohablante
El crecimiento del internet y las redes sociales ha cambiado la manera en que se accede y se distribuyen las noticias. No obstante, este crecimiento también ha propiciado la propagación de la desinformación. En ese sentido, uno de los sectores más afectados por esta difusión es el de la salud, particularmente en enfermedades como el cáncer. Conforme a lo señalado por el Instituto Nacional del Cáncer de Estados Unidos [1], existe una gran cantidad de desinformación acerca del cáncer en la red, lo que incluye videos e historias que predican curas milagrosas con tratamientos no comprobados científicamente y en algunos casos dañinos para la salud.
Esta problemática está particularmente presente en las comunidades hispanohablantes, donde las barreras lingüísticas y culturales dificultan el acceso a información verificada. Un artículo de Think Global Health [2] destaca que la difusión de información falsa en el ámbito de la salud representa un desafío significativo creciente en las comunidades de habla hispana, principalmente en Estados Unidos. Además, menciona que los hispanohablantes suelen depender de redes sociales como principal fuente de información, lo que los hace más vulnerables a recibir y compartir contenido con información falsa o inexacta, ya que los algoritmos de estas plataformas no siempre priorizan fuentes verificadas.
Dada esta situación, resulta necesario desarrollar soluciones efectivas capaces de identificar y disminuir la desinformación en español, proporcionando a las comunidades hispanohablantes recursos más confiables para tomar decisiones mejor informadas, lo que puede prevenir acciones que puedan resultar dañinas para la salud de los mismos.
A pesar de los avances en la detección de fake news, la mayoría de los recursos disponibles están en el idioma inglés, dejando un vacío en la comunidad hispanohablante. Los pocos sistemas que existen en español suelen basarse en adaptaciones de modelos monolingües o en traducciones automatizadas, lo cual afecta su precisión y contextualización cultural [2].
En ese orden, los primeros acercamientos técnicos se fundamentan en métodos basados en reglas y heurísticas, que identifican patrones lingüísticos y estructuras típicas de la desinformación [3], [4]. Aunque estos sistemas sentaron las bases de la detección automática, su rigidez y dependencia de reglas manuales limitan su capacidad para adaptarse a la creatividad y la evolución constante del lenguaje en entornos digitales [5].
Con la consolidación del aprendizaje supervisado, se introdujeron clasificadores clásicos como SVM [6], Random Forest [7], XGBoost [8] y Naïve Bayes [9] entrenados sobre vectores TF-IDF [10] y optimizados con técnicas de búsqueda de hiperparámetros. Paralelamente, las redes neuronales densas (DNN) demostraron un rendimiento superior (94.5 % de accuracy) al compararlas directamente con algoritmos tradicionales utilizando el FakeNewsNet dataset [11].
Ahora bien, la llegada de arquitecturas Transformers [12] ha elevado aún más la efectividad de los modelos, permitiendo capturar relaciones contextuales bidireccionales y matices semánticos complejos. Sin embargo, la mayoría están preentrenados en inglés o en múltiples idiomas sin especialización para el español, lo que dificulta su aplicación directa en la detección de noticias sobre cáncer en este idioma.
Finalmente, las estrategias de transferencia cross-lingual y zero-shot [13] ofrecen un camino prometedor para aprovechar recursos en inglés sin sacrificar la contextualización cultural en español. Modelos basados en BERT [14] como mBERT, BETO y XLM-RoBERTa han demostrado viabilidad en escenarios de pocos datos etiquetados, aunque aún requieren validación específica en el dominio del cáncer y ajustes finos para maximizar su precisión en la comunidad hispanohablante. Es por esto que:
El desarrollo de este proyecto ha implementado un modelo predictivo que emplea técnicas de aprendizaje automático para identificar de esta manera noticias falsas en español sobre el cáncer, mediante la recopilación de noticias que son tanto de fuentes verificadas como falsas, aplicando posteriormente técnicas de preprocesamiento de texto para asegurar que este sea de utilidad para el análisis y modelado de los datos. De igual forma, se aplicó la adaptación específica del modelo al idioma español para mejorar el acceso de la comunidad hispanohablante, así como la evaluación rigurosa con métricas estándar de clasificación y el diseño de una interfaz gráfica que integra el modelo, permite realizar pruebas interactivas y verificar su funcionamiento.
Del corpus al prototipo: un flujo modular
La propuesta se basa en un flujo de trabajo modular que integra captura, procesamiento, modelado y despliegue. Partimos de una recolección híbrida de datos (corpus público, artículos científicos y ejemplos manuales/sintéticos) para alimentar tanto modelos tradicionales (SVM, Random Forest, XGBoost) como arquitecturas Transformer (BETO, mBERT). A continuación, cada subsistema se diseñó, implementó y validó por separado antes de su integración final en un prototipo funcional.
1. Recolección de datos
Se utilizó el FakeNewsCorpusSpanish [15], que aporta 1248 noticias (624 reales y 624 falsas). Complementariamente, se extrajeron 1,176 artículos de SciELO [16] (2018-2024) mediante Selenium [17], y se incorporaron 105 declaraciones falsas verificadas manualmente junto a 100 párrafos generados con Grok 3 para simular patrones de desinformación realistas.
2. Preprocesamiento y normalización
El preprocesamiento unificó formatos y limpió el texto: eliminación de caracteres especiales, tokenización con nltk.punkt, eliminación de stopwords y lematización con spaCy. Para modelos basados en BETO se empleó el BertTokenizer (bert-base-spanish-wwm-uncased) con Byte Pair Encoding, ajustando secuencias a 512 tokens. Este pipeline se fundamentó en estudios comparativos de técnicas de preprocesamiento en español, que muestran variaciones significativas en precisión y tiempo de ejecución según la combinación de métodos.
3. Creación y entrenamiento de modelos predictivos
Se evaluaron cinco algoritmos tradicionales sobre vectores TF-IDF con Grid Search CV [18] para ajustar hiperparámetros, y distintas arquitecturas basadas en BETO (Original, BETO+SVM, BETO+LSTM, BETO+BiLSTM). Además, se experimentó con mBERT + SVM para explorar capacidades cross-lingual. Asimismo, la eficiencia de las técnicas de Deep Learning para la detección de noticias falsas en español ha sido validada en trabajos como “Fake News Detection in Spanish Using Deep Learning Techniques”.
4. Validación y métricas
El rendimiento de cada modelo se midió utilizando métricas entre las cuales se encontraban el accuracy, precision, recall, F1-score, ROC-AUC y AUPRC, empleando validación cruzada de 5 folds para estimar estabilidad. En ese sentido, la inclusión de AUPRC, recomendada para clases desbalanceadas, confirmó diferencias mínimas respecto a AUROC [19], reforzando la precisión del sistema en distintos escenarios.
5. Integración del prototipo
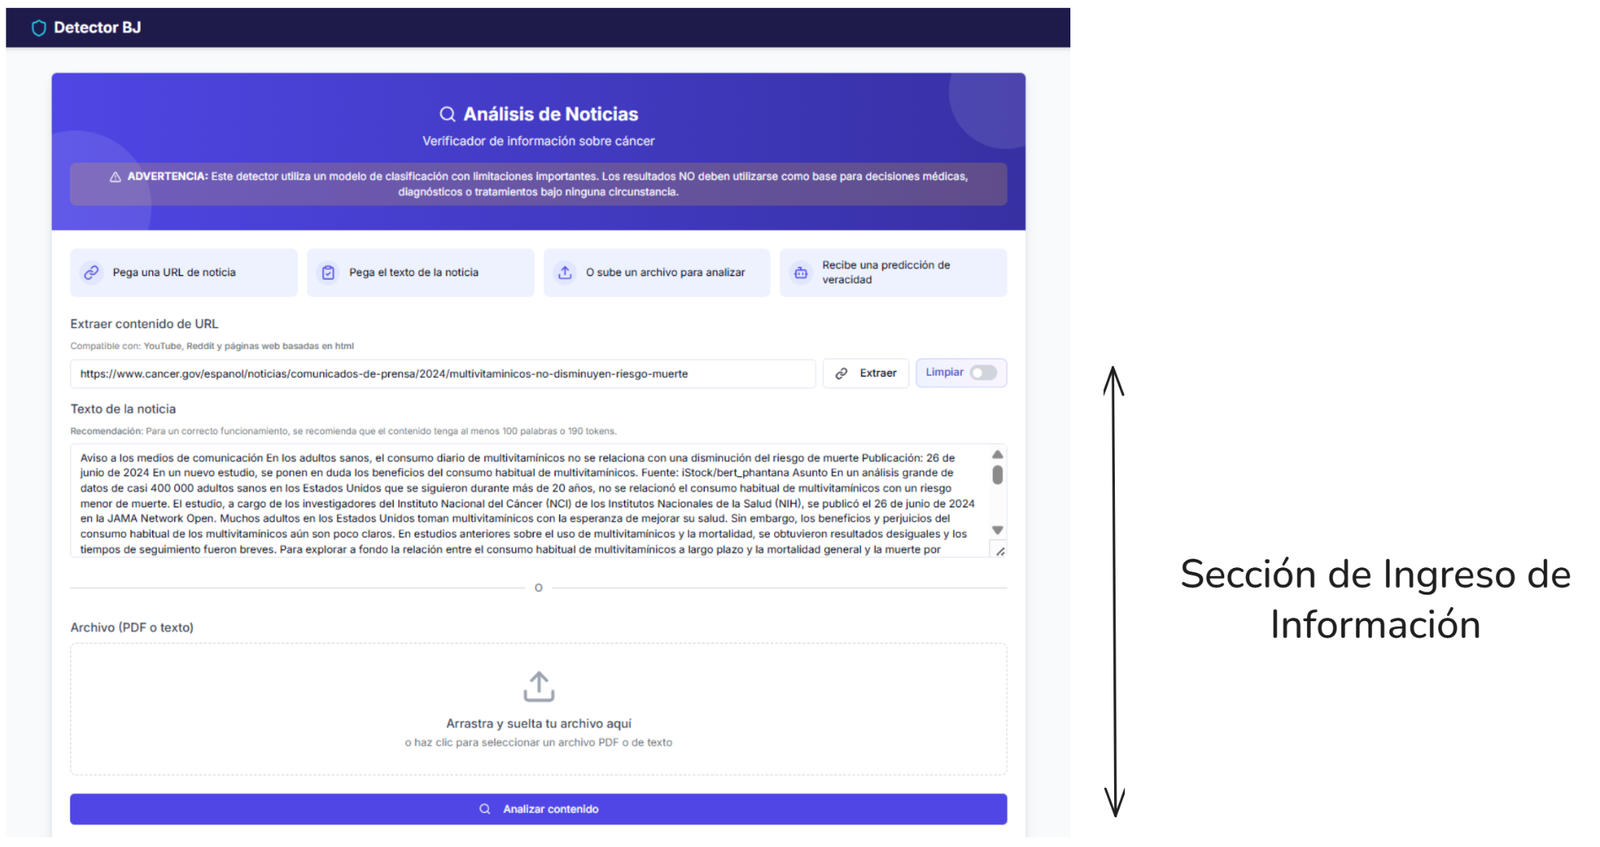
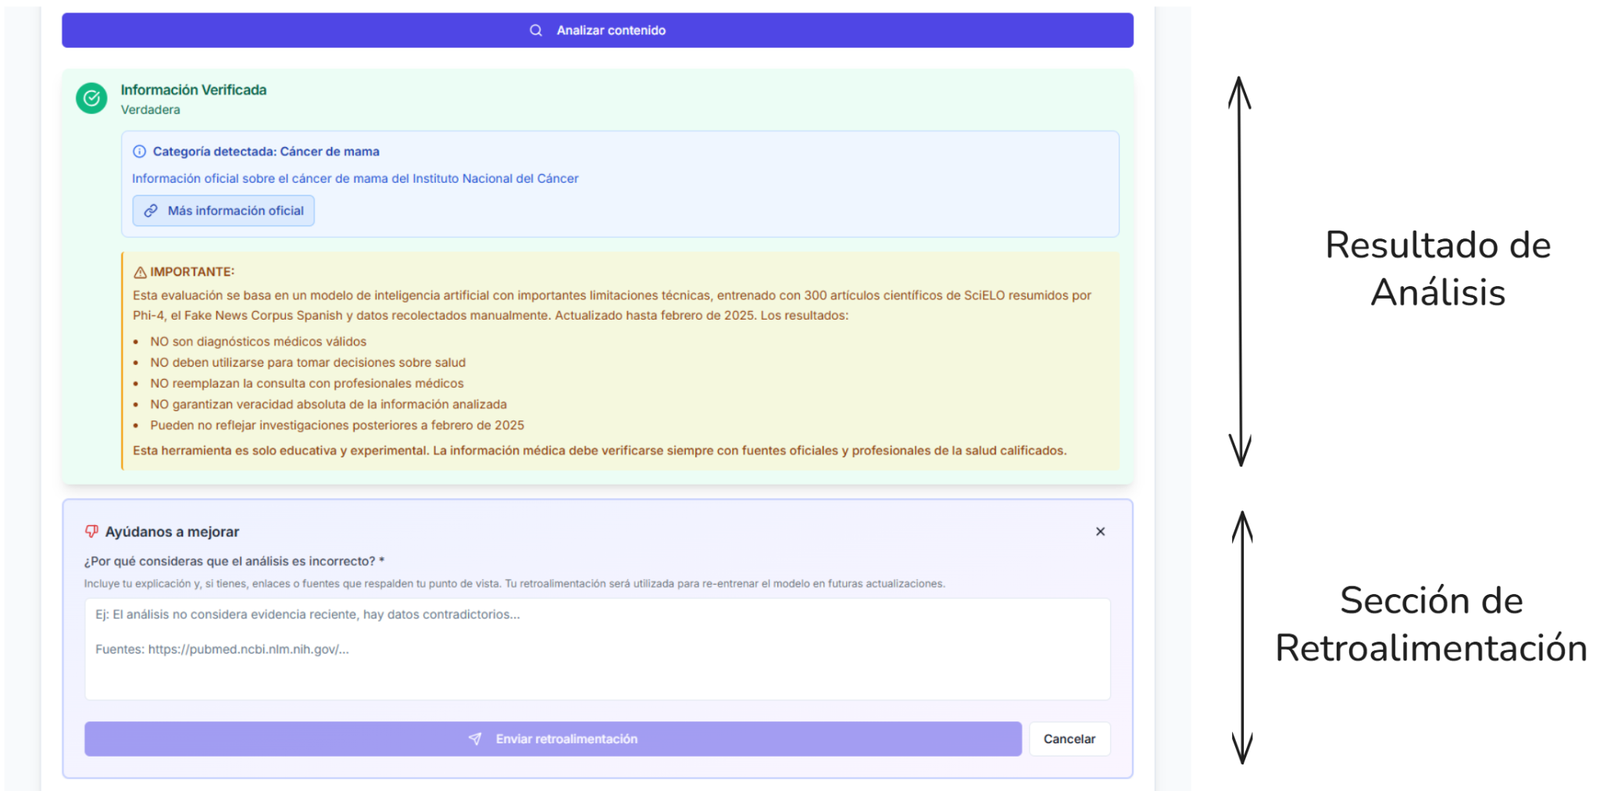
El backend se desplegó en Flask sirviendo un servicio REST que recibe texto, lo tokeniza y devuelve la clasificación. La interfaz web, implementada en React/NextJS, admite texto manual, archivos (TXT, PDF) mediante un API en Spring Boot [20] y extracción de enlaces (YouTube, Reddit, webs) mediante Trafilatura, reddit-api y youtube-api-server [21]. Por lo que, esta UI permite la extracción de contenido en distintos formatos como enlaces o archivos, y adicionalmente proporciona feedback inmediato permitiendo al usuario validar la confianza del texto analizado.
6. Herramientas y buenas prácticas
Se utilizó Python 3.9 [22], GitHub [23] para versionado, Docker [24] para contenedores reproducibles y GPU NVIDIA RTX 2070 o P100 para entrenamiento acelerado. Así pues, a diferencia de la mayoría de estudios centrados en inglés o en dominios específicos, nuestra metodología incorpora un corpus balanceado en español y explora transferencias cross-lingual sin traducción previa.
A continuación, una breve explicación de cada métrica evaluada en los modelos seleccionados:
- Accuracy (exactitud): proporción de predicciones correctas (verdaderas + falsas) sobre el total de muestras [62].
Accuracy = (TP + TN) / (TP + FP + FN + TN) - Precisión: de todas las muestras que el modelo etiquetó como positivas (por ejemplo, “fake news”), ¿qué porcentaje lo era realmente? [25]
Precision = TP / (TP + FP) - Recall: de todas las muestras realmente positivas, ¿qué porcentaje el modelo identificó correctamente? [26]
Recall = TP / (TP + FN) - F1-Score: media armónica entre precisión y recall. Es útil cuando existe un desequilibrio de clases [25].
F1 = 2 · (Precision · Recall) / (Precision + Recall) - Specificity: de todas las muestras negativas (“noticias verdaderas”), ¿qué porcentaje se clasificó correctamente como negativas? [26]
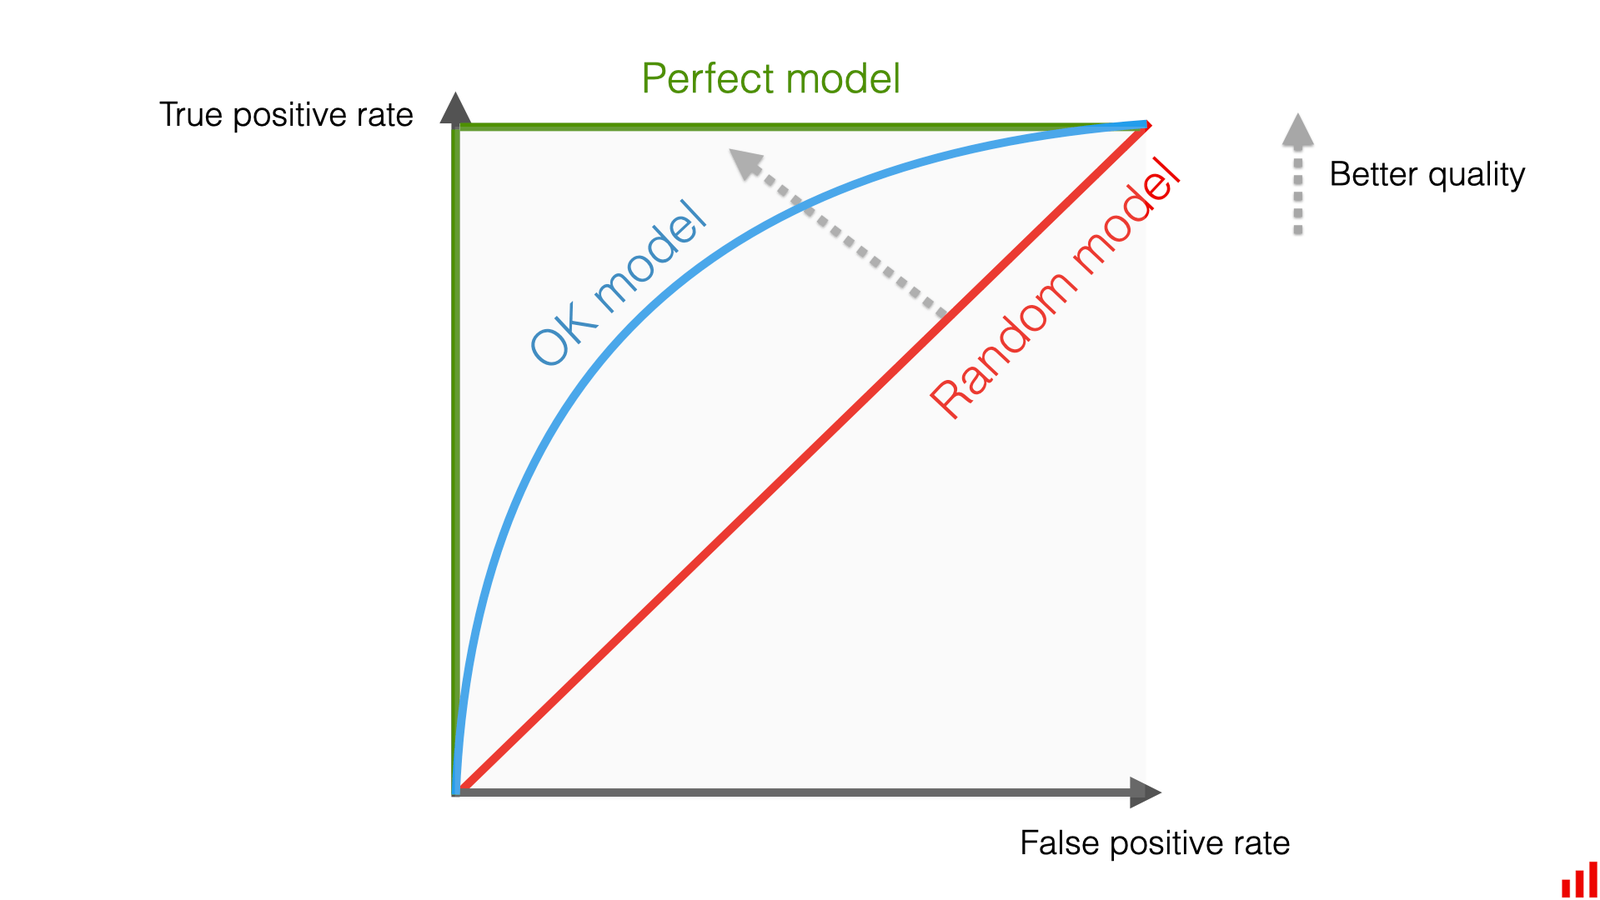
- ROC AUC: área bajo la curva ROC, mide la capacidad de distinguir entre clases en todos los umbrales posibles [25].
- AUPRC: área bajo la curva Precision–Recall, especialmente relevante cuando las clases están desbalanceadas [19].
- Cohen’s Kappa: coeficiente de acuerdo entre predicciones y verdad terreno, corregido por el azar [26].
- MCC (Matthews Correlation Coefficient): métrica balanceada que considera verdaderos y falsos positivos y negativos; toma valores en [–1, +1], donde +1 es predicción perfecta [26].
- Loss (pérdida): función objetivo optimizada durante el entrenamiento (en los modelos clásicos se muestra como “Loss” del conjunto de validación). Así pues, valores menores indican mejor ajuste [26].
Construyendo confianza: resultados contra las fake news
A continuación, se presenta un análisis descriptivo de los resultados obtenidos con los distintos modelos, tanto los clásicos (SVM, Random Forest, Logistic Regression, XGBoost y Naive Bayes) como los de enfoque deep learning (basados en BETO).
| Modelo | Validación cruzada | Accuracy | Precision | Recall | F1-Score | Specificity | ROC AUC | AUPRC | Cohen’s Kappa | MCC | Loss |
|---|---|---|---|---|---|---|---|---|---|---|---|
| SVM | Con CV | 0.8145 | 0.815 | 0.8038 | 0.8092 | 0.8038 | 0.8986 | 0.9024 | 0.6287 | 0.6289 | 0.4021 |
| Random Forest | Con CV | 0.8182 | 0.8508 | 0.761 | 0.8032 | 0.761 | 0.9078 | 0.9115 | 0.6352 | 0.6389 | 0.4397 |
| Logistic Regression | Con CV | 0.81 | 0.8015 | 0.8118 | 0.8062 | 0.8118 | 0.9026 | 0.9099 | 0.6199 | 0.6205 | 0.3946 |
| XGBoost | Con CV | 0.8138 | 0.8141 | 0.8255 | 0.8197 | 0.8015 | 0.9027 | 0.907 | 0.6273 | 0.6274 | 0.4088 |
| Naive Bayes | Con CV | 0.771 | 0.817 | 0.6843 | 0.7438 | 0.6843 | 0.8726 | 0.8891 | 0.5398 | 0.5475 | 0.5836 |
Random Forest sobresale entre los clásicos con 81.82 % de accuracy y AUPRC≈0.91, superando ligeramente a XGBoost y SVM.
Naive Bayes sufre por el desequilibrio de clases y la representación bag-of-words, quedando en 77.10 % de exactitud y MCC≈0.55.
Las pérdidas de validación (“Loss”) se sitúan entre 0.39 y 0.58, indicando que los modelos clásicos requieren más ajuste o datos para igualar al deep learning.
| Modelo | Accuracy | Precision | Recall | F1-Score | Specificity | ROC AUC | AUPRC | Cohen’s Kappa | MCC |
|---|---|---|---|---|---|---|---|---|---|
| BETO + SVM | 0.9704 | 0.9725 | 0.9645 | 0.9684 | 0.9759 | 0.9892 | 0.9904 | 0.9406 | 0.9407 |
| BETO | 0.9633 | 0.9699 | 0.9518 | 0.9602 | 0.9734 | 0.9906 | 0.991 | 0.9261 | 0.9271 |
| mBERT + SVM | 0.9345 | 0.9362 | 0.9396 | 0.9378 | 0.9289 | 0.9746 | 0.9785 | 0.8685 | 0.8687 |
| mBERT | 0.9318 | 0.9198 | 0.9621 | 0.9395 | 0.8973 | 0.973 | 0.9765 | 0.8618 | 0.865 |
BETO + SVM alcanza el mejor balance, con 97 % de accuracy y AUPRC≈0.99, mostrando que la combinación de embeddings de BETO y un clasificador lineal SVM captura tanto las noticias verdaderas como las falsas de forma casi perfecta.
El modelo BETO queda muy cerca, indicando que el vector pooled de BETO ya codifica suficiente información, pero añadiendo SVM se gana un +0.7 % en accuracy y +0.014 en MCC.
Los enfoques mBERT comparado con BETO son más bajos, debido a su vocabulario multilingüe más genérico: mBERT + SVM logra 93.45 % de accuracy frente al 96.04 % de BETO, y su MCC cae de 0.94 a 0.87.
Hacia un futuro sin desinformación
El proyecto ha demostrado que los modelos basados en Transformers son una buena opción para la detección de desinformación sobre el cáncer. Cabe destacar que, aunque la combinación BETO + SVM alcanzó los puntajes más altos en métricas como accuracy y AUPRC, su rendimiento en pruebas reales resultó menos consistente que en el que se aplicó únicamente BETO. En cambio, BETO logró cerca de un 97 % de precisión tanto en el dataset de entrenamiento como en los escenarios reales, por lo que fue el modelo seleccionado para el despliegue final, garantizando una clasificación estable y confiable.
Como recomendaciones futuras, se plantea ampliar el conjunto de datos colaborando con hospitales y organismos de salud hispanohablantes, así como expandir el alcance del prototipo a otras patologías críticas como la diabetes, enfermedades cardiovasculares, etc. En ese sentido, invitamos a la comunidad académica y a posibles aliados a participar aportando datos, retroalimentación activa y recursos para reentrenar el modelo, mejorar la usabilidad de la interfaz y desplegar esta solución en plataformas de producción. Todo esto, con el objetivo de seguir combatiendo de manera efectiva la creciente ola de desinformación.
Referencias
- Equipo del NCI, “La desinformación sobre el cáncer en las redes sociales.” [Online]. Available: https://www.cancer.gov/espanol/noticias/temas-y-relatos-blog/2021/desinformacion-sobre-cancer-redes-sociales
- I. Rolz, “Debunking Health Misinformation in Latino Communities.” [Online]. Available: https://www.thinkglobalhealth.org/article/debunking-health-misinformation-latino-communities
- M. Choras et al., “Advanced Machine Learning Techniques for Fake News (Online Disinformation) Detection: A Systematic Mapping Study,” 2021, arXiv. doi: 10.48550/ARXIV.2101.01142.
- N. Hoy and T. Koulouri, “A Systematic Review on the Detection of Fake News Articles,” 2021, arXiv. doi: 10.48550/ARXIV.2110.11240.
- C. Ireton, J. Posetti, and UNESCO, Eds., Journalism, “fake news” & disinformation: handbook for journalism education and training. in UNESCO series on journalism education. Paris: United Nations Educational, Scientific and Cultural Organization, 2018.
- N.-I. Galanis, P. Vafiadis, K.-G. Mirzaev, and G. A. Papakostas, “Machine Learning Meets Natural Language Processing — The story so far,” 2021, arXiv. doi: 10.48550/arXiv.2104.10213.
- L. Breiman, “Random Forests,” Mach. Learn., vol. 45, no. 1, pp. 5–32, 2001, doi: 10.1023/A:1010933404324.
- T. Chen and C. Guestrin, “XGBoost: A Scalable Tree Boosting System,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, San Francisco California USA: ACM, 2016, pp. 785–794. doi: 10.1145/2939672.2939785.
- E. Frank and R. R. Bouckaert, “Naive Bayes for Text Classification with Unbalanced Classes,” in Knowledge Discovery in Databases: PKDD 2006, vol. 4213, D. Hutchison et al., Eds., Berlin, Heidelberg: Springer Berlin Heidelberg, 2006, pp. 503–510. doi: 10.1007/11871637_49.
- D. E. Cahyani and I. Patasik, “Performance comparison of TF-IDF and Word2Vec models for emotion text classification,” Bull. Electr. Eng. Informatics, vol. 10, no. 5, pp. 2780–2788, 2021, doi: 10.11591/eei.v10i5.3157.
- L. Rojas Rubio and C. Meneses Villegas, “Una comparación empírica de algoritmos de aprendizaje automático versus aprendizaje profundo para la detección de noticias falsas en redes sociales,” Ingeniare. Rev. Chil. Ing., vol. 30, no. 2, pp. 403–415, 2022, doi: 10.4067/S0718-33052022000200403.
- K. Martínez-Gallego, A. M. Álvarez-Ortiz, and J. D. Arias-Londoño, “Fake News Detection in Spanish Using Deep Learning Techniques,” 2021, arXiv. doi: 10.48550/arXiv.2110.06461.
- M. Strong, R. Aly, and A. Vlachos, “Zero-Shot Fact Verification via Natural Logic and Large Language Models,” 2024, arXiv. doi: 10.48550/ARXIV.2410.03341.
- S. Kasim, “One True Pairing: Evaluating Effective Language Pairings for Fake News Detection Employing Zero-Shot Cross-Lingual Transfer,” in Soft Computing and Its Engineering Applications, vol. 1788, K. K. Patel, K. C. Santosh, A. Patel, and A. Ghosh, Eds., Cham: Springer Nature Switzerland, 2023, pp. 17–28. doi: 10.1007/978-3-031-27609-5_2.
- jpposadas, “jpposadas/FakeNewsCorpusSpanish,” 2024. Accessed: Feb. 07, 2025. [Online]. Available: https://github.com/jpposadas/FakeNewsCorpusSpanish
- “Programa SciELO, Modelo de Publicación y Red SciELO | SciELO.org.” Accessed: Mar. 28, 2025. [Online]. Available: https://scielo.org/es/sobre-el-scielo/programa-modelo-de-publicacion-y-red-scielo/
- “Selenium.” Accessed: Mar. 28, 2025. [Online]. Available: https://www.selenium.dev/
- “GridSearchCV.” Accessed: Mar. 28, 2025. [Online]. Available: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GridSearchCV.html
- W. Chen et al., “Commonly used software tools produce conflicting and overly-optimistic AUPRC values,” Genome Biol., vol. 25, no. 1, p. 118, May 2024, doi: 10.1186/s13059-024-03266-y.
- “Spring Boot.” Accessed: Mar. 24, 2025. [Online]. Available: https://spring.io/projects/spring-boot
- “youtube-transcript-api: This is an python API which allows you to get the transcripts/subtitles for a given YouTube video. It also works for automatically generated subtitles, supports translating subtitles and it does not require a headless browser.” Accessed: Jun. 09, 2025. [Online]. Available: https://github.com/jdepoix/youtube-transcript-api
- “Welcome to Python.org,” 2025. Accessed: Mar. 24, 2025. [Online]. Available: https://www.python.org/about/
- “Build software better, together.” Accessed: Mar. 24, 2025. [Online]. Available: https://github.com
- “What is Docker? | Docker Docs.” Accessed: Mar. 28, 2025. [Online]. Available: https://docs.docker.com/get-started/docker-overview/
- A. de la Torre, “Reconocimiento de emociones musicales y generación de un dataset de etiquetado categórico,” E.T.S. de Ingenieros Informáticos (UPM), 2019. Accessed: Feb. 13, 2025. [Online]. Available: https://oa.upm.es/56029/
- V. de Dios Domínguez, “Fake news detection with pretrained transformers,” E.T.S. de Ingenieros Informáticos (UPM), 2023. Accessed: Feb. 13, 2025. [Online]. Available: https://oa.upm.es/75835/