Iván Paul Marcelino y Juan Alfonso Alvarado Batista – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)
La seguridad vial continúa siendo uno de los principales retos asociados a los sistemas de transporte. La forma en que una persona acelera, frena, gira, mantiene la velocidad o reacciona ante una situación inesperada puede influir directamente en el nivel de riesgo de un recorrido. A escala internacional, los siniestros de tránsito continúan generando una elevada cantidad de muertes y lesiones, mientras que factores relacionados con el comportamiento humano permanecen entre los elementos de mayor interés para su prevención [1], [2]. Dentro de este contexto, el análisis del comportamiento del conductor mediante herramientas tecnológicas se ha convertido en una línea de investigación capaz de transformar acciones que tradicionalmente eran observadas de forma subjetiva en información cuantificable que puede ser estudiada mediante técnicas estadísticas y computacionales [6], [9].
En respuesta a esta problemática surge DriveSense, proyecto desarrollado por Iván Paul Marcelino y Juan Alfonso Alvarado Batista, estudiantes de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del ingeniero Rafael Omar Batista Jorge y dentro de la Escuela de Ingeniería en Computación y Telecomunicaciones. DriveSense fue concebido como un sistema para capturar, procesar y analizar datos de conducción generados dentro de un entorno de simulación controlado, con el propósito de identificar patrones y clasificar el comportamiento observado en diferentes perfiles. En lugar de limitarse a registrar una puntuación final, la propuesta integra la adquisición de telemetría, el procesamiento de los datos, el entrenamiento de modelos de aprendizaje automático y la presentación de resultados mediante una plataforma web.
El uso de simuladores ofrece una ventaja importante al estudiar este tipo de comportamiento. Determinadas situaciones que serían difíciles, costosas o inseguras de reproducir intencionalmente en una vía pública pueden ejecutarse de manera controlada dentro de un entorno virtual. Investigaciones previas han demostrado la utilidad de los simuladores para estudiar aspectos relacionados con la velocidad, las curvas y la respuesta de los conductores bajo condiciones repetibles [3]–[5]. Esta característica permite que distintos participantes realicen sesiones bajo condiciones previamente definidas y que los datos obtenidos puedan ser comparados sin exponer a los usuarios ni a terceros a las consecuencias de provocar deliberadamente una situación de riesgo real.
La motivación de DriveSense parte precisamente de combinar esa capacidad experimental con las posibilidades actuales del análisis de datos. Durante una sesión de conducción pueden generarse miles de observaciones relacionadas con velocidad, aceleración, frenado, dirección y otras variables del vehículo. Analizadas de forma aislada, estas señales pueden resultar difíciles de interpretar. Sin embargo, al organizarlas temporalmente y utilizar modelos capaces de reconocer patrones, es posible construir una representación más detallada de la forma en que una persona conduce [6], [12]. DriveSense utiliza este principio para transformar la telemetría producida durante una sesión en información que pueda ser consultada, comparada e interpretada posteriormente.
Del problema vial al análisis inteligente del comportamiento
En la República Dominicana, la seguridad vial constituye una problemática especialmente relevante. El exceso de velocidad, las maniobras imprudentes, las aceleraciones repentinas, las frenadas intensas y diferentes formas de conducción agresiva pueden aumentar tanto la probabilidad de un incidente como la gravedad de sus consecuencias. A esto se agregan situaciones comunes en las que el conductor debe reaccionar rápidamente ante congestión, cambios de carril de otros vehículos, obstáculos o modificaciones inesperadas en el flujo del tránsito. Aunque muchas de estas conductas pueden identificarse mediante observación, convertirlas en información cuantitativa permite analizarlas con un mayor nivel de detalle y conservar un registro de lo ocurrido durante diferentes momentos de un recorrido.
Los métodos convencionales para valorar el desempeño de un conductor dependen en gran medida de la observación directa, de evaluaciones realizadas durante un período limitado o de información obtenida después de un incidente. Estos mecanismos continúan siendo necesarios, pero presentan limitaciones cuando se desea estudiar con precisión cómo cambió el comportamiento durante una sesión. Una evaluación humana puede indicar que una persona condujo de manera insegura, por ejemplo, pero los datos de telemetría permiten complementar esa observación indicando cuándo ocurrió una aceleración brusca, cuál era la velocidad en ese momento, cuánto se utilizó el freno o cómo varió la dirección. Esta posibilidad ha impulsado el desarrollo de investigaciones que utilizan información del vehículo para reconocer diferentes patrones de manejo [6], [12].
La literatura relacionada con el perfilado de conductores ha evolucionado progresivamente desde reglas construidas sobre unas pocas variables hacia métodos capaces de estudiar grandes cantidades de información. La clasificación de comportamientos mediante aprendizaje automático permite encontrar relaciones que pueden resultar difíciles de representar utilizando únicamente límites fijos o promedios generales [9], [11]. Diferentes investigaciones han utilizado telemetría vehicular para estudiar estilos de conducción, mientras que otros trabajos han incorporado métodos de ensemble y aprendizaje profundo con el propósito de representar relaciones más complejas entre las características disponibles [13], [15]. En todos estos casos, la calidad de los resultados depende no solamente del algoritmo utilizado, sino también de la forma en que los datos fueron capturados, organizados y preparados.
Precisamente, uno de los retos encontrados durante el desarrollo de DriveSense fue la ausencia de un conjunto de datos que reuniera exactamente las variables, condiciones experimentales y categorías requeridas por el proyecto. Los datasets disponibles en investigaciones previas fueron construidos bajo vehículos, sensores, poblaciones, carreteras y criterios de clasificación diferentes. Utilizar uno de ellos directamente habría significado adaptar el proyecto a condiciones que no necesariamente correspondían con el experimento propuesto. Por esta razón, se decidió construir un dataset propio mediante sesiones realizadas por participantes dentro del simulador, manteniendo un procedimiento común de captura y criterios previamente establecidos para representar los comportamientos estudiados.
Otro aspecto relevante es la dimensión temporal de la conducción. Un conductor no mantiene necesariamente el mismo comportamiento durante todo un recorrido. Una sesión que globalmente parece normal puede incluir algunos segundos de agresividad, distracción o conducción pasiva. Trabajos recientes han reforzado la importancia de estudiar secuencias y patrones temporales en lugar de representar toda una conducción mediante un único promedio [12], [13]. DriveSense adopta esta idea dividiendo la información en ventanas temporales. Cada ventana resume una parte de la sesión y posteriormente puede ser evaluada de forma independiente, permitiendo reconstruir cómo fue cambiando el comportamiento durante el recorrido completo.
Esta aproximación también responde a una necesidad de interpretabilidad. En una aplicación relacionada con personas y seguridad no resulta suficiente presentar únicamente una etiqueta generada por un algoritmo. Es importante conservar las métricas que dieron origen al análisis y disponer de mecanismos que ayuden a entender por qué el sistema produce determinados resultados. La inteligencia artificial explicable ha adquirido relevancia justamente por la necesidad de comprender la influencia que tienen diferentes características dentro de las predicciones [17], [20]. Por esta razón, DriveSense incorporó SHAP como técnica complementaria para estudiar la participación de las variables en las decisiones del modelo, manteniendo separada la predicción del proceso utilizado para explicarla.
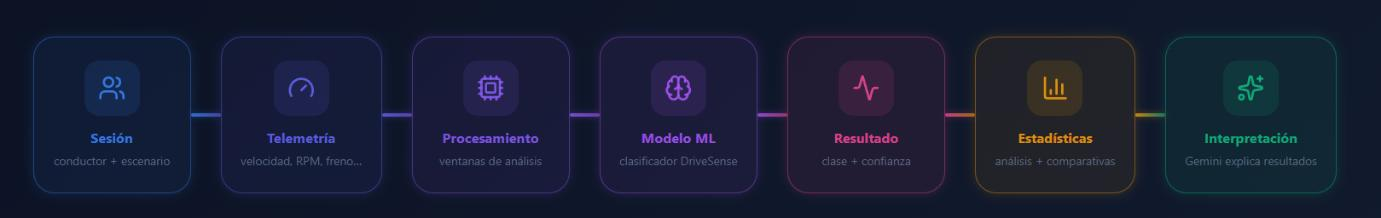
El desarrollo de DriveSense permitió cumplir el objetivo de construir una solución inteligente orientada a la clasificación de perfiles de conducción a partir de datos de telemetría obtenidos en un entorno de simulación controlado. Para lograrlo, se diseñó una arquitectura capaz de capturar, estructurar y almacenar telemetría vehicular a una frecuencia de 20 Hz; se implementaron mecanismos para analizar estadísticamente las variables obtenidas y estudiar sus diferencias entre sesiones y grupos de conductores; se desarrolló un proceso para entrenar y evaluar modelos supervisados de aprendizaje automático; y se incorporaron mecanismos para representar cuantitativamente los resultados, conservar las diferentes versiones de los modelos, analizar la influencia de las características y presentar la información al usuario mediante una plataforma centralizada. De esta manera, el objetivo general se desglosó en componentes medibles y verificables que abarcan el ciclo completo desde la generación del dato hasta la interpretación del resultado.
De una sesión simulada a un sistema completo de datos
El funcionamiento de DriveSense comienza antes de que el conductor inicie el recorrido. Desde la aplicación web se registra o selecciona al participante y se crea una nueva sesión indicando la información necesaria para la prueba, incluyendo el escenario y el vehículo que serán utilizados. Esta sesión queda registrada en el servidor con un estado inicial y puede ser validada posteriormente desde la computadora encargada de ejecutar la simulación. Esta separación permite mantener un registro de cada prueba y relacionar los datos producidos posteriormente con el conductor y las condiciones correspondientes, evitando que los archivos de telemetría queden aislados de su contexto experimental.
En la computadora de simulación se utiliza DriveSense Local Client, componente encargado de validar que la sesión corresponde con la información registrada en el servidor y preparar el entorno necesario para realizarla. Una vez completada la validación, el cliente inicia los componentes requeridos para trabajar con Assetto Corsa y entrega a Logger_BD la configuración asociada a la sesión. Durante este proceso, la sesión puede pasar por distintos estados, permitiendo que la plataforma conozca si se encuentra pendiente, en ejecución o completada. Este mecanismo también disminuye la cantidad de configuraciones que el usuario debe introducir manualmente en la computadora donde se realiza la prueba.
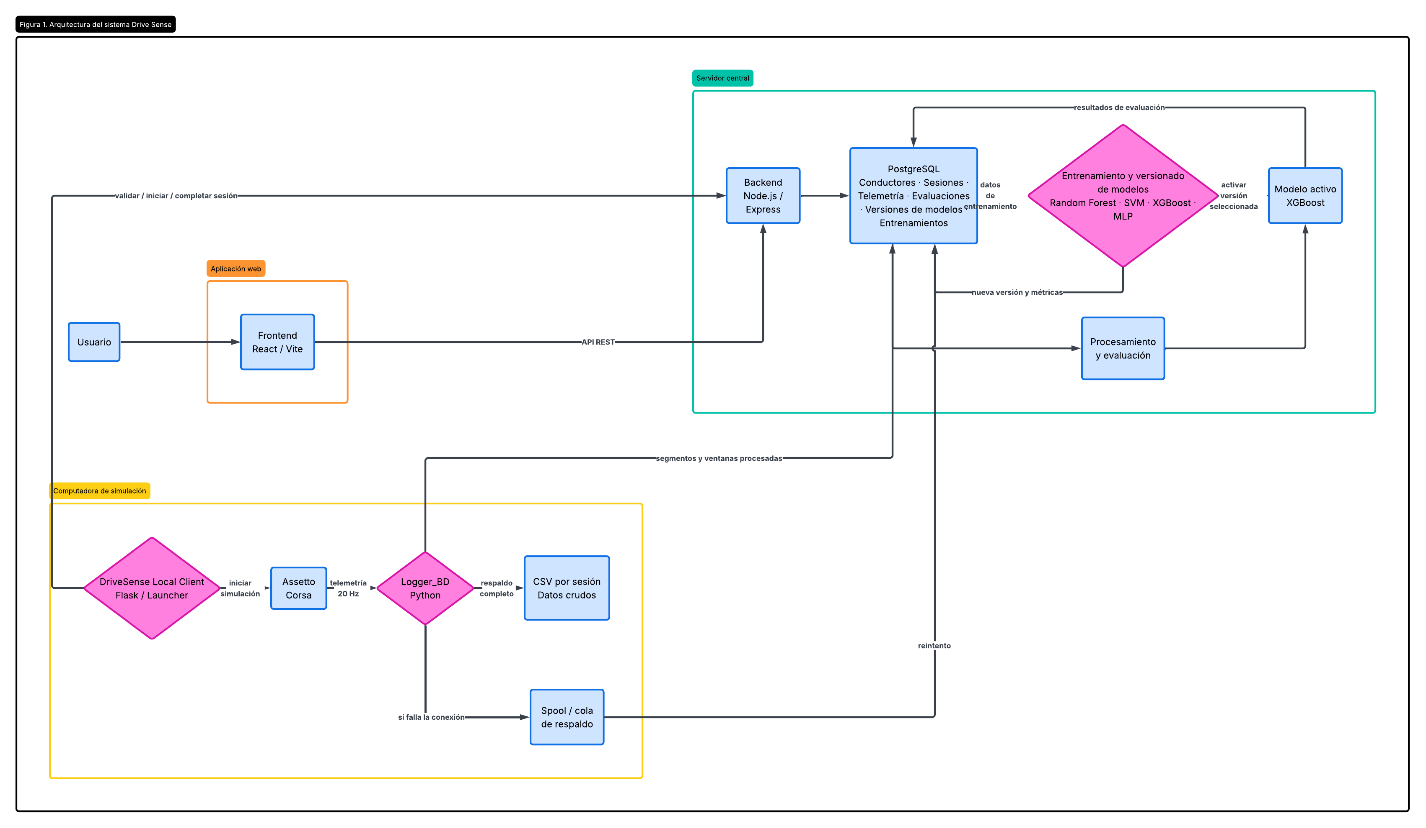
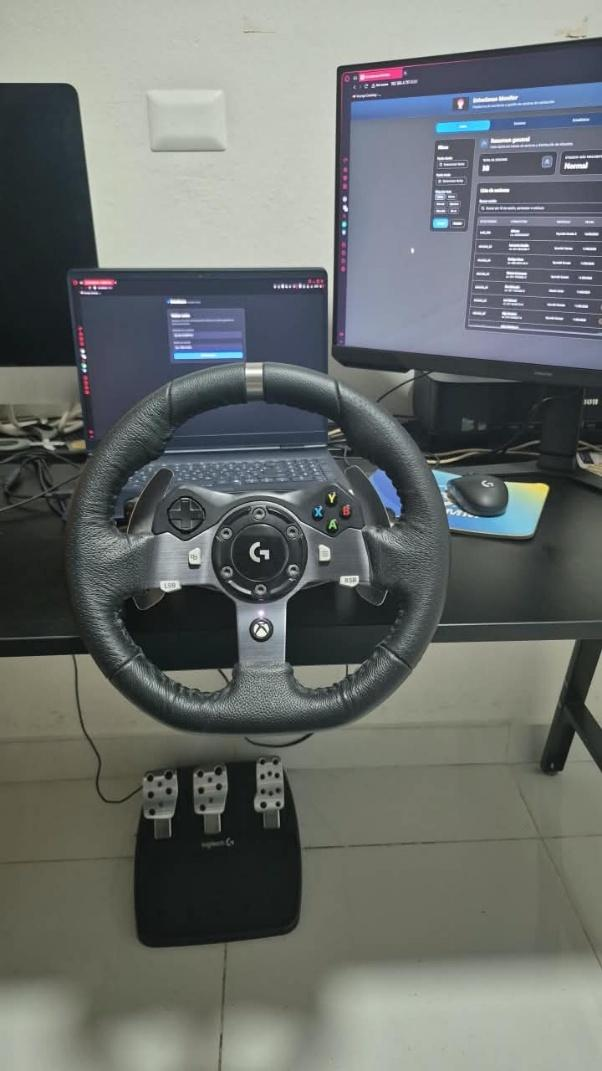
Una vez iniciada la conducción, Logger_BD obtiene información directamente desde la telemetría generada por Assetto Corsa. La captura se realiza a una frecuencia de 20 Hz, equivalente a veinte muestras por segundo. Entre las variables registradas se encuentran velocidad, revoluciones por minuto, acelerador, freno, dirección y valores relacionados con la dinámica del vehículo. Esta frecuencia permite observar variaciones que podrían perderse si únicamente se conservaran valores globales al finalizar la sesión. La telemetría vehicular ha sido utilizada ampliamente como una fuente de información para reconocer comportamientos, ya que permite representar de forma cuantitativa las acciones ejecutadas durante la conducción [6], [12].
Los datos crudos de cada recorrido se conservan en archivos CSV, manteniendo un registro que puede utilizarse posteriormente para revisar una sesión o para construir nuevos conjuntos de entrenamiento. Paralelamente, DriveSense procesa la información y la organiza en segmentos y ventanas temporales que son almacenados en PostgreSQL. Esta combinación responde a dos necesidades diferentes: conservar la telemetría completa y, al mismo tiempo, disponer de una estructura más eficiente para consultas, evaluaciones y visualizaciones. De esta forma, no es necesario procesar nuevamente cada muestra del archivo original cada vez que se quiere consultar un resultado.
La arquitectura fue diseñada además para disminuir el riesgo de pérdida de información ante problemas de conectividad. Si durante una conducción el equipo de simulación no puede comunicarse temporalmente con el servidor, los datos pendientes permanecen almacenados de manera local. Cuando la comunicación vuelve a estar disponible, el sistema intenta enviarlos nuevamente. Esta estrategia permite que una interrupción de red no implique necesariamente perder la sesión completa. Mantener la persistencia de los datos fue considerado especialmente importante debido al esfuerzo requerido para reunir participantes y repetir las condiciones experimentales de una prueba.
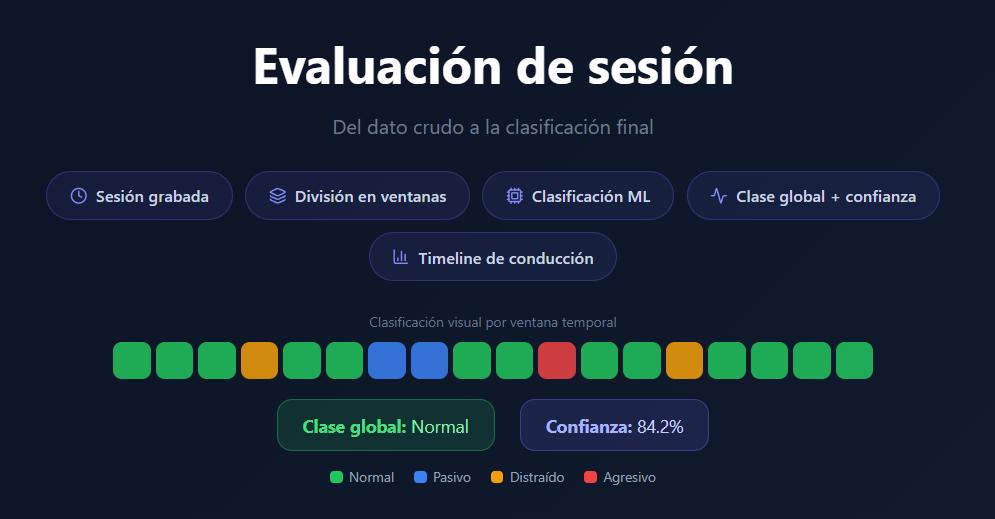
Una vez almacenada la telemetría, la información se transforma en características que puedan utilizarse en el proceso de clasificación. En lugar de introducir directamente una secuencia extensa de muestras individuales al modelo, las ventanas permiten obtener representaciones de intervalos concretos de la sesión. A partir de ellas pueden calcularse valores relacionados con la velocidad, el uso del acelerador y del freno, la dirección, la variabilidad del comportamiento y la presencia de determinados eventos. La ingeniería de características constituye una etapa fundamental en problemas de clasificación porque permite representar los datos originales de una manera adecuada para que los algoritmos puedan identificar diferencias entre clases [9], [12].
Para determinar qué método resultaba más apropiado para el conjunto de datos disponible, durante el proyecto se trabajó con diferentes algoritmos supervisados: Random Forest, Support Vector Machine (SVM), XGBoost y Multi-Layer Perceptron (MLP). Los modelos fueron entrenados utilizando las mismas características de entrada para permitir una comparación bajo condiciones equivalentes. Random Forest representa un método ampliamente utilizado para problemas de clasificación por su capacidad de combinar múltiples árboles de decisión y manejar relaciones no lineales [10]. XGBoost, por su parte, utiliza un enfoque de gradient boosting que ha demostrado un elevado rendimiento en problemas con datos estructurados [19].
El proceso de entrenamiento no se limitó a generar una única partición del dataset. Para evaluar los modelos se utilizó validación cruzada k-fold, dividiendo repetidamente la información disponible entre subconjuntos de entrenamiento y validación. Este procedimiento reduce la dependencia de una sola división de los datos y permite observar la estabilidad del desempeño del modelo. Para realizar la comparación se consideraron métricas como Accuracy, F1-score, ROC-AUC y matrices de confusión. Cada una aporta una perspectiva diferente: mientras Accuracy representa la proporción global de clasificaciones correctas, F1 permite considerar simultáneamente precisión y exhaustividad, y la matriz de confusión permite estudiar en cuáles categorías se producen los errores.
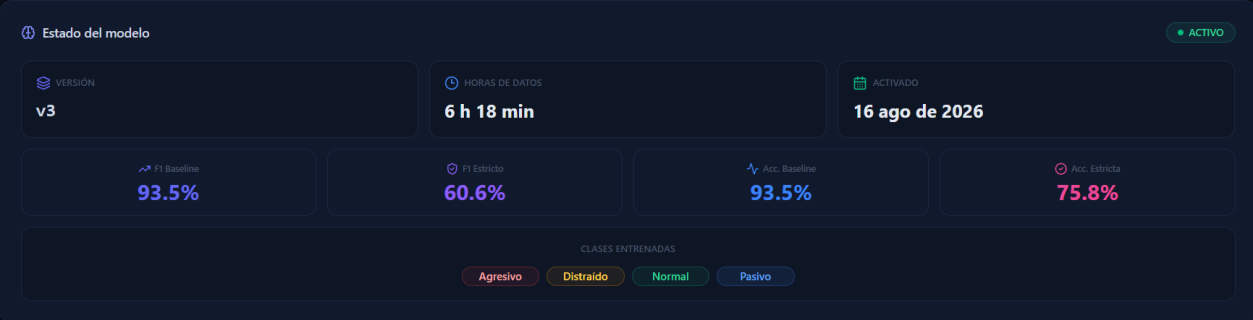
A medida que el proyecto evolucionó también cambió la definición del problema. Las primeras pruebas trabajaban con tres categorías principales, pero posteriormente se incorporó el comportamiento distraído, dando lugar a las cuatro clases finales utilizadas por DriveSense: agresivo, distraído, normal y pasivo. Este cambio implicó volver a entrenar y evaluar los modelos bajo la nueva estructura. Finalmente se seleccionó XGBoost como clasificador principal y se implementó un sistema de versionado que permite conservar los modelos producidos durante diferentes entrenamientos. En lugar de sustituir simplemente un archivo cada vez que se entrena nuevamente, DriveSense registra qué versión fue generada, con qué datos se construyó, cuáles fueron sus métricas y cuál se encuentra activa.
La interpretabilidad complementa este proceso mediante SHAP, técnica que permite estudiar cómo las características utilizadas contribuyen a las predicciones realizadas. La idea no es modificar la clasificación obtenida, sino proporcionar una herramienta adicional para analizar la participación de las variables dentro del modelo. SHAP se apoya en principios de teoría de juegos para asignar valores de contribución a las características y se ha convertido en una técnica reconocida dentro del campo de la inteligencia artificial explicable [20]. En DriveSense, esta información sirve como apoyo al análisis de las decisiones del clasificador y ayuda a evitar que el sistema sea presentado únicamente como una caja negra que produce etiquetas sin contexto.
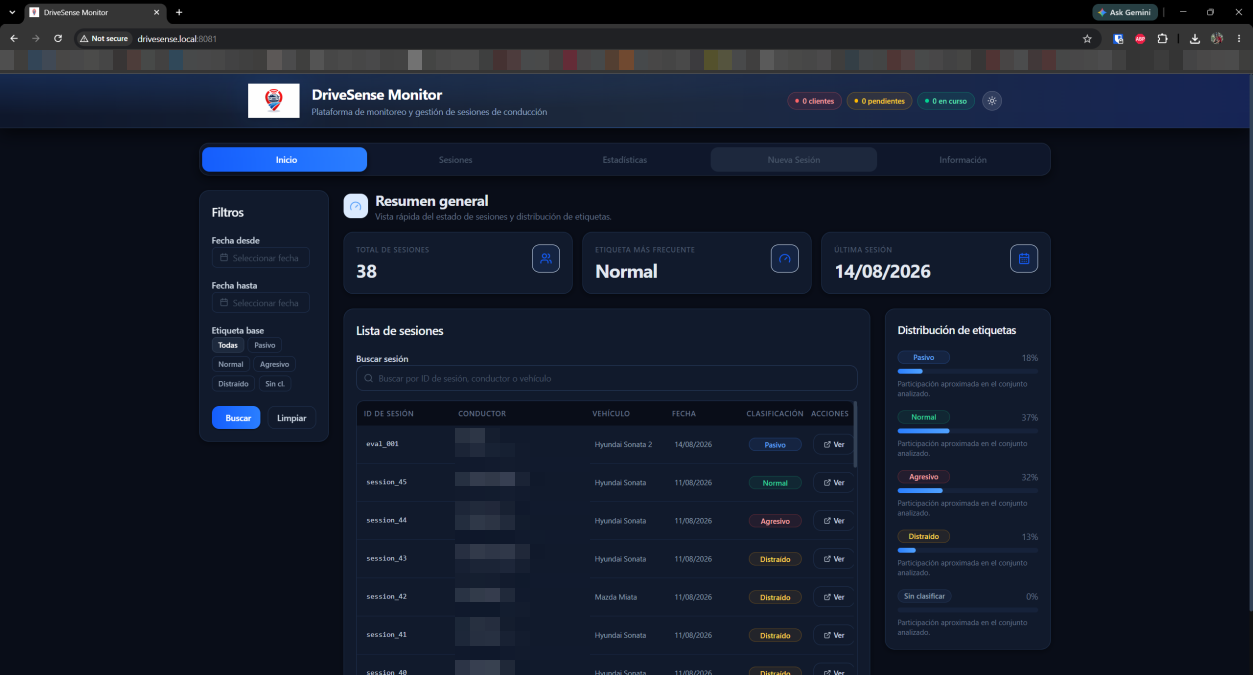
El sistema se completa mediante la plataforma web, desde la cual se pueden registrar conductores, crear nuevas sesiones, consultar recorridos anteriores, visualizar evaluaciones y acceder a estadísticas. La interfaz reúne información que originalmente se encuentra distribuida entre archivos, registros de base de datos, predicciones y métricas. Además, permite realizar comparaciones utilizando características como género y rango de edad, así como consultar las versiones existentes de los modelos y sus procesos de entrenamiento. Esta centralización facilita que DriveSense pueda utilizarse no solamente como un experimento aislado, sino como una plataforma que mantiene la trazabilidad de las pruebas efectuadas.
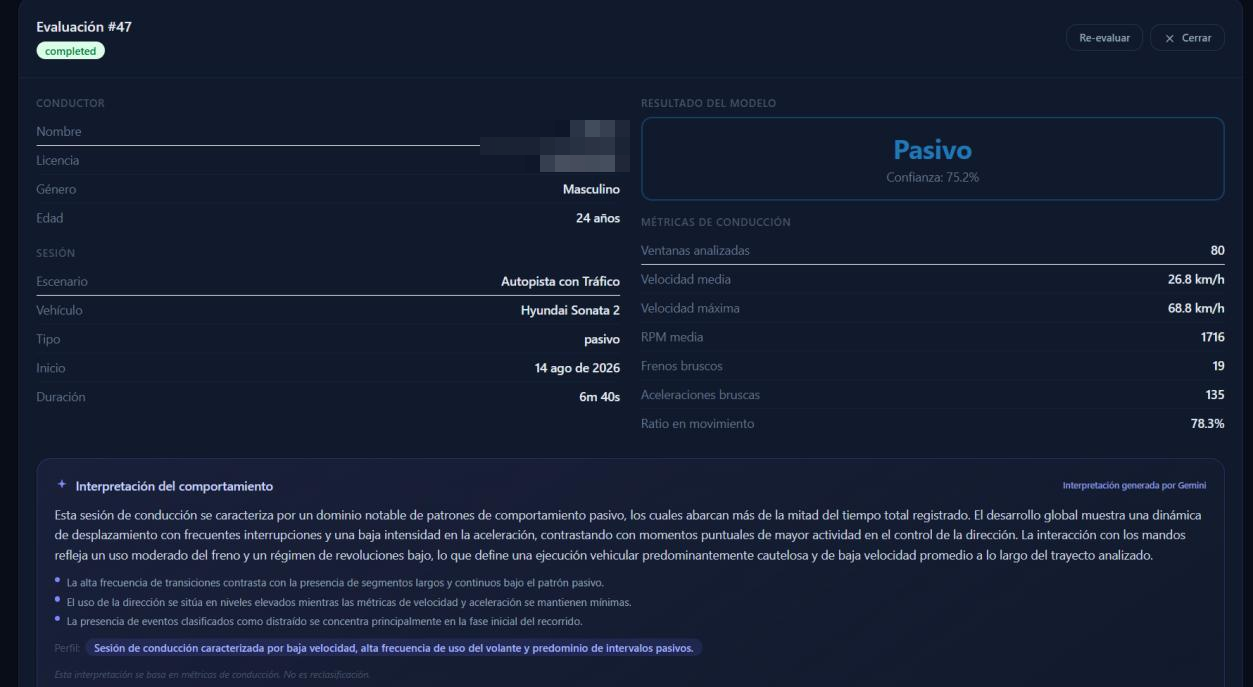
En las fases finales se incorporó adicionalmente una capa de interpretación mediante la API de Gemini. Esta funcionalidad surgió al observar que porcentajes, métricas y gráficas pueden resultar difíciles de comprender para usuarios sin experiencia en ciencia de datos. Es importante diferenciar claramente sus funciones: Gemini no clasifica al conductor, no modifica los resultados del modelo y no participa en el cálculo de las predicciones. DriveSense y XGBoost continúan siendo responsables del procesamiento y la clasificación; la API recibe únicamente resultados ya generados y los transforma en una explicación en lenguaje natural. El backend controla además la información compartida, evitando transmitir identificadores directos como el nombre o el número de licencia del participante.
Resultados que muestran más que una etiqueta
Durante el desarrollo del componente de inteligencia artificial se realizaron distintas iteraciones hasta llegar a la configuración final. En una etapa inicial se evaluó una implementación basada en RAPIDS AI utilizando CPU y GPU. La variante ejecutada mediante CPU obtuvo un Accuracy de 96.66 %, un Macro F1-score de 0.62 y un Weighted F1-score de 0.76, con un tiempo de entrenamiento de aproximadamente 0.3561 segundos. Para el volumen de información utilizado en ese momento, la ejecución mediante GPU presentó un desempeño similar pero requirió un tiempo mayor, por lo que la aceleración mediante GPU no se mantuvo como una necesidad del sistema. Estos resultados también evidenciaron la importancia de analizar múltiples métricas: un valor elevado de Accuracy no implica necesariamente un comportamiento igualmente uniforme entre todas las categorías.
Posteriormente, el problema fue ampliado de tres a cuatro clases y se adoptó XGBoost como modelo principal. La versión activa XGBoost v3 fue entrenada utilizando 23 sesiones, equivalentes a aproximadamente 6 horas y 18 minutos de conducción. Esta versión obtuvo un Accuracy baseline de 93.49 % y un F1-score baseline de 93.45 %. Bajo el criterio de evaluación estricto se obtuvo un Accuracy de 75.82 % y un F1-score de 60.76 %. Adicionalmente, las predicciones del modelo presentan una confianza promedio cercana al 83 %. Las métricas de esta versión no deben compararse directamente con los valores de la etapa inicial, ya que fueron obtenidas utilizando diferente cantidad de clases, distintas configuraciones del conjunto de datos y un procedimiento de evaluación actualizado.
La diferencia entre las métricas baseline y las obtenidas bajo un criterio más estricto constituye un resultado importante del proyecto. Presentar únicamente la cifra más alta habría proporcionado una visión incompleta del rendimiento. La evaluación estricta permite observar que el problema se vuelve considerablemente más exigente cuando se establecen condiciones destinadas a reducir la posibilidad de que información demasiado relacionada aparezca simultáneamente en entrenamiento y validación. Esto ayuda a representar de manera más realista la capacidad de generalización del modelo y demuestra por qué la evaluación de un sistema de aprendizaje automático no debe resumirse exclusivamente mediante una sola métrica.
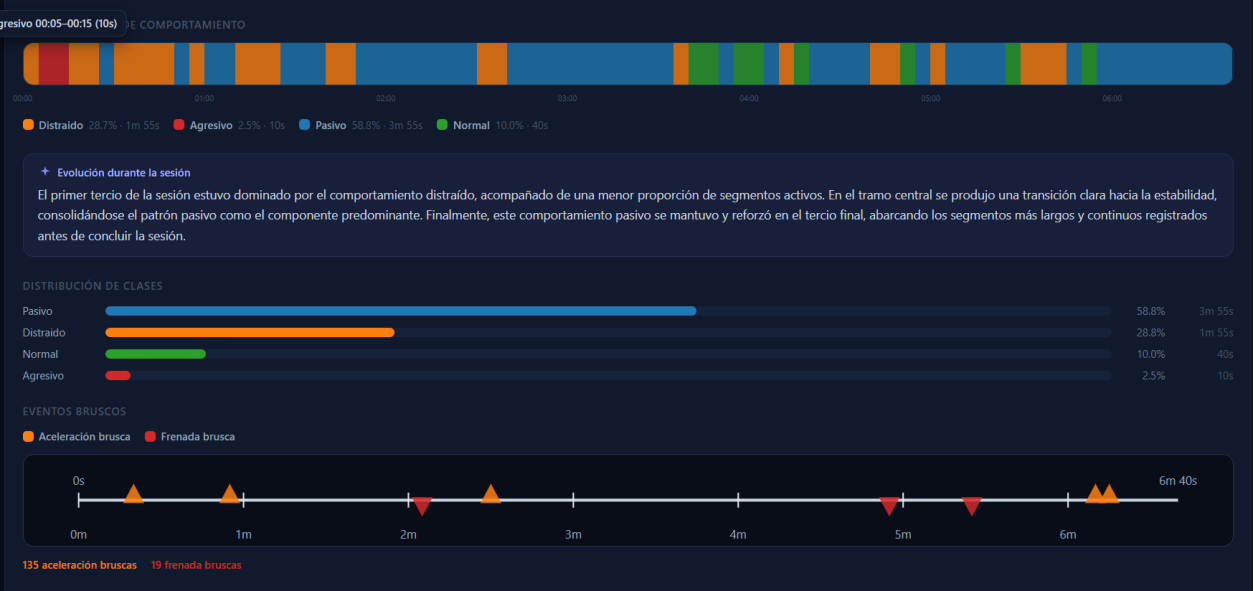
DriveSense tampoco limita el resultado a una única clasificación para toda la sesión. Cada una de las ventanas procesadas conserva su propio resultado, lo que permite construir una línea de tiempo del comportamiento. Como ejemplo, una de las sesiones analizadas fue clasificada globalmente como pasiva con un 75.2 % de confianza. Sin embargo, al estudiar sus 80 ventanas, se observó que el comportamiento pasivo representó el 58.8 % del tiempo evaluado, mientras que el comportamiento distraído correspondió al 28.7 %, el normal al 10.0 % y el agresivo al 2.5 %. La clasificación global resume el patrón predominante, mientras que la línea temporal permite identificar los cambios que ocurrieron durante el recorrido.
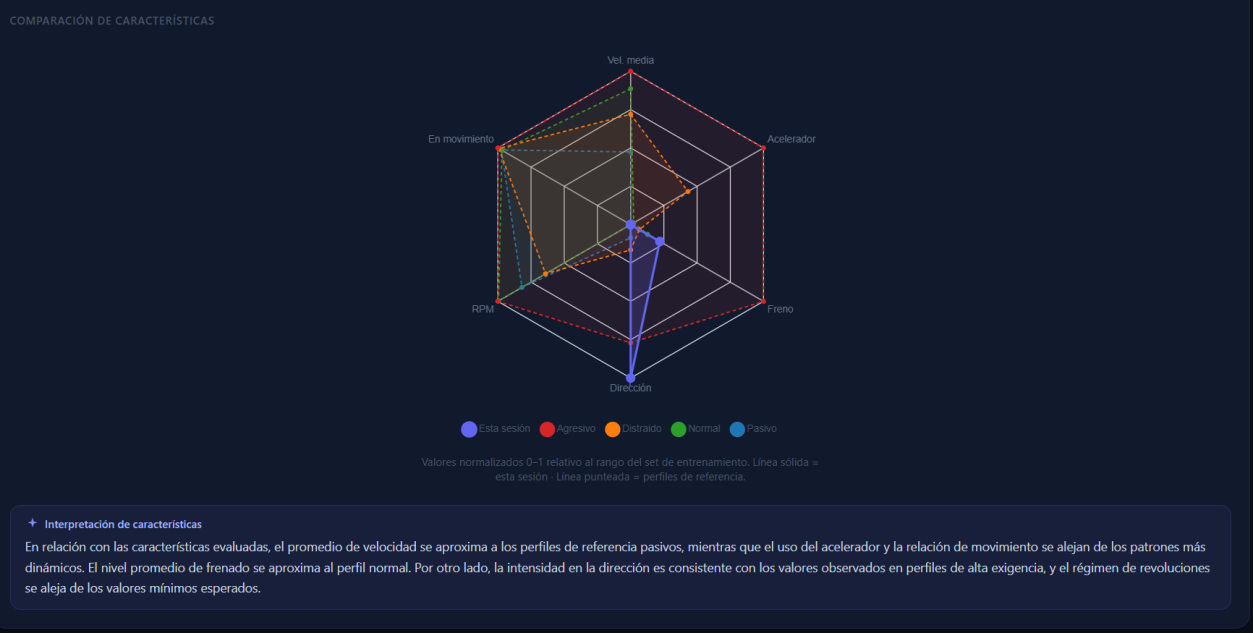
Este nivel de detalle representa una de las características más útiles de la solución. Dos sesiones podrían terminar con la misma clasificación general y, aun así, haber llegado a ese resultado mediante patrones diferentes. Una puede mantener un comportamiento relativamente uniforme y otra alternar repetidamente entre distintas clases. Por esta razón, la plataforma presenta conjuntamente la clasificación global, la confianza, las métricas de conducción, la distribución de comportamientos, los eventos detectados y los intervalos temporales. El propósito es que el resultado pueda examinarse desde diferentes perspectivas y no interpretar al conductor únicamente a partir de una etiqueta aislada.
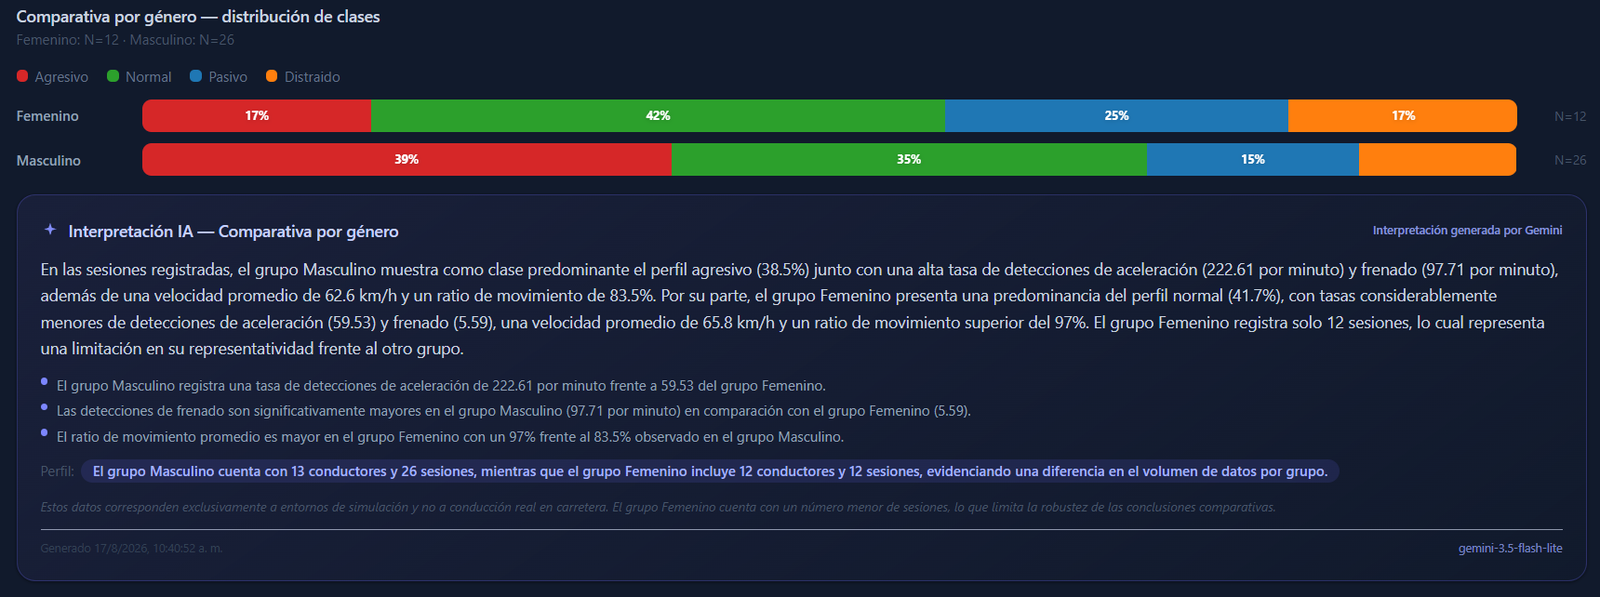
Los datos reunidos también hicieron posible realizar comparaciones descriptivas entre diferentes grupos de la muestra. Para la comparación por género se analizaron 26 sesiones correspondientes a conductores masculinos y 12 sesiones correspondientes a conductores femeninos. Entre las sesiones femeninas, la conducción normal representó aproximadamente el 42 %, seguida de la pasiva con 25 %, mientras que agresiva y distraída representaron alrededor de 17 % cada una. Entre las sesiones masculinas, la categoría agresiva alcanzó aproximadamente 39 %, la normal 35 %, la pasiva 15 % y la distraída alrededor de 11 %. Estos valores describen solamente el comportamiento de las sesiones disponibles y no deben interpretarse como una afirmación general sobre hombres y mujeres.
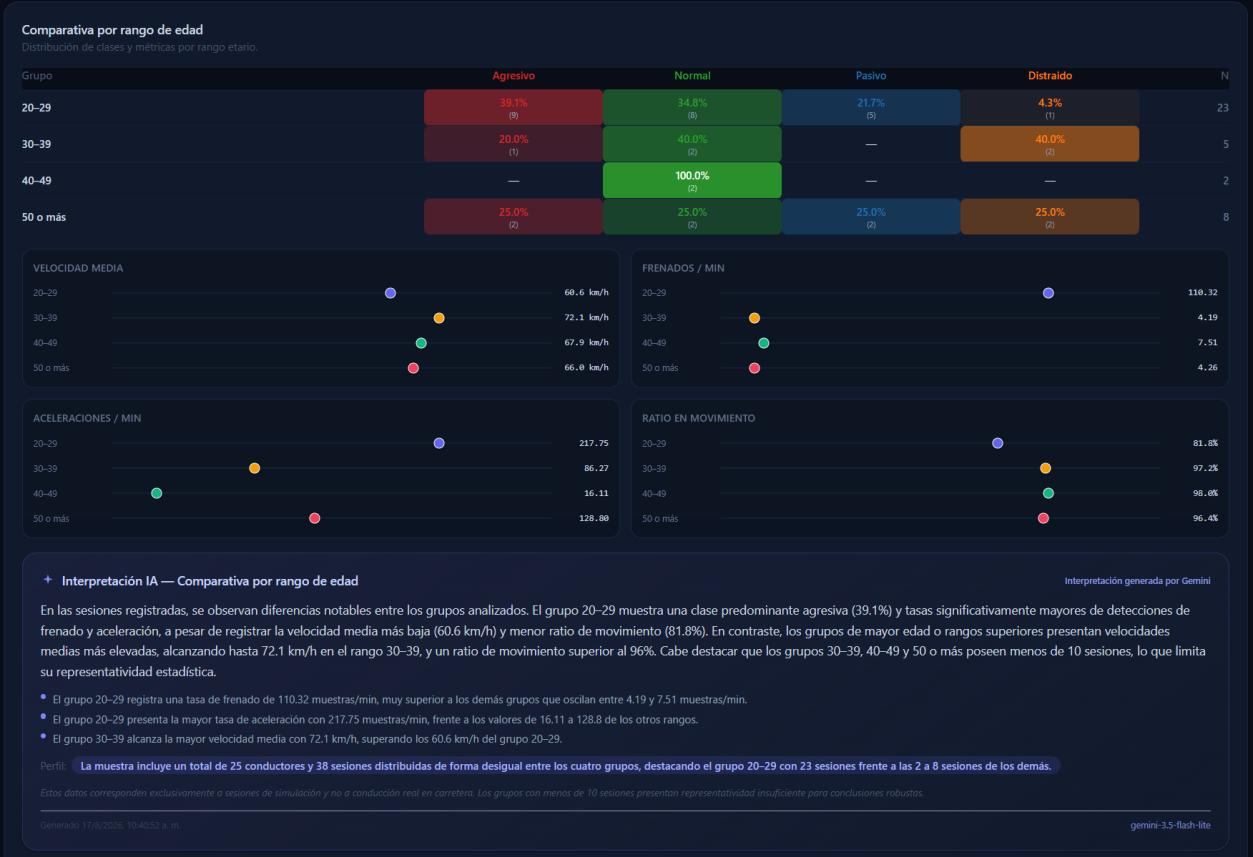
En la comparación por edad, el grupo de 20 a 29 años concentró la mayor cantidad de observaciones, con 23 sesiones. En este rango, el 39.1 % fue clasificado como agresivo, el 34.8 % como normal, el 21.7 % como pasivo y el 4.3 % como distraído. Para el grupo de 30 a 39 años se analizaron cinco sesiones, con un 40 % normal, 40 % distraído y 20 % agresivo. En el rango de 40 a 49 años solo estuvieron disponibles dos sesiones, ambas clasificadas como normales. Finalmente, en el grupo de 50 años o más se analizaron ocho sesiones, distribuidas en proporciones de 25 % para cada una de las cuatro categorías. Las diferencias en el tamaño de cada grupo impiden utilizar estos resultados como representación de la población general; su valor dentro del proyecto es principalmente descriptivo y demuestra la capacidad del sistema para organizar este tipo de comparaciones.
Una base para seguir investigando la conducción
Los resultados obtenidos permiten concluir que es posible integrar un entorno de simulación, captura de telemetría, almacenamiento estructurado y aprendizaje automático dentro de un mismo sistema para analizar perfiles de conducción. DriveSense no se limita al modelo de clasificación, sino que incorpora el proceso completo que permite producir y conservar los datos utilizados por ese modelo. Desde la creación de una sesión hasta la presentación de sus resultados, cada etapa mantiene información que permite posteriormente revisar cómo se obtuvo una determinada clasificación. Esta trazabilidad es especialmente importante en un proyecto experimental, debido a que permite continuar incorporando datos sin perder las versiones y resultados producidos previamente.
Al mismo tiempo, los resultados deben interpretarse dentro de las condiciones bajo las cuales fueron obtenidos. Assetto Corsa permite capturar telemetría detallada y realizar pruebas controladas, pero no fue diseñado específicamente como una plataforma para reproducir absolutamente todas las situaciones presentes en el tránsito cotidiano. El comportamiento del tráfico, determinadas interacciones con otros vehículos, las condiciones ambientales y otros factores de la vía real dependen de las posibilidades ofrecidas por el simulador. A esto se agrega que el dataset fue construido específicamente para esta investigación y que las categorías agresivo, distraído, normal y pasivo responden a los criterios establecidos para las sesiones realizadas. Por tanto, el modelo aprende patrones correspondientes al contexto experimental de DriveSense.
Estas limitaciones también señalan directamente los próximos pasos del proyecto. La incorporación de nuevos participantes permitiría aumentar la diversidad del dataset y mejorar la cantidad de observaciones disponibles en cada grupo de edad y género. Nuevos escenarios aportarían una mayor variedad de situaciones de conducción. También sería posible continuar aumentando la automatización de la interacción con el simulador para disminuir la intervención necesaria durante el inicio y finalización de una sesión. Gracias al sistema de versionado incorporado, estas nuevas sesiones pueden utilizarse para producir modelos posteriores y comparar su rendimiento antes de decidir cuál versión debe mantenerse activa.
Finalmente, una de las líneas de trabajo más relevantes consiste en estudiar DriveSense utilizando otras fuentes de telemetría. La arquitectura no depende conceptualmente de una única categoría de simulador: si otra fuente puede proporcionar las variables requeridas, el proceso de captura puede adaptarse y posteriormente construir un nuevo dataset representativo de ese entorno. Una futura evaluación con vehículos reales permitiría investigar hasta qué punto los patrones identificados mediante simulación se mantienen fuera de Assetto Corsa y qué modificaciones serían necesarias para aplicaciones relacionadas con evaluación, capacitación o análisis de conductores. En este sentido, DriveSense representa no solamente el resultado de un proyecto académico, sino una base tecnológica y metodológica sobre la cual puede continuar desarrollándose investigación relacionada con el comportamiento al volante y la seguridad vial.
Referencias
- World Health Organization, “Global status report on road safety 2023,” WHO, Geneva, Switzerland, 2023.
- National Highway Traffic Safety Administration, “Traffic Safety Facts Annual Report 2022,” U.S. Department of Transportation, 2023.
- A. Bella and A. Calvi, “Effects of simulator training on driver speed behavior in curves,” Accident Analysis & Prevention, vol. 43, no. 3, pp. 1166–1172, 2011.
- S. T. Godley, T. J. Triggs, and B. N. Fildes, “Driving simulator validation for speed research,” Accident Analysis & Prevention, vol. 34, no. 5, pp. 589–600, 2002.
- A. Calvi, “A study on driving performance along horizontal curves using a driving simulator,” Journal of Transportation Safety & Security, vol. 7, no. 3, pp. 243–257, 2015.
- Y. Zhang, X. Wang, and L. Li, “Driving behavior recognition based on vehicle telemetry data,” Sensors, vol. 21, no. 4, pp. 1–18, 2021.
- P. Sun, J. Hu, and Y. Zhang, “Real-time driving risk evaluation based on vehicle dynamics,” IEEE Transactions on Intelligent Transportation Systems, vol. 23, no. 6, pp. 5678–5689, 2022.
- M. Taamneh et al., “Detection of driver stress in real-world driving environments,” IEEE Transactions on Intelligent Transportation Systems, vol. 21, no. 12, pp. 5007–5017, 2020.
- J. Ferreira, J. Carvalho, and J. Fonseca, “Driver behavior profiling: An investigation with machine learning,” Expert Systems with Applications, vol. 123, pp. 1–12, 2019.
- L. Breiman, “Random forests,” Machine Learning, vol. 45, no. 1, pp. 5–32, 2001.
- M. Saeedmanesh and N. Geroliminis, “Dynamic clustering and classification of driving behavior,” Transportation Research Part C, vol. 102, pp. 195–214, 2019.
- S. Wang, C. Li, and R. Fu, “Driver behavior recognition using vehicle data and machine learning,” IEEE Sensors Journal, vol. 20, no. 10, pp. 5674–5683, 2020.
- Y. Li, Z. Chen, and H. Zhang, “Driver behavior classification using deep learning and vehicle telemetry data,” IEEE Access, vol. 10, pp. 112345–112357, 2022.
- J. Kim and S. Lee, “Real-time driver risk assessment using machine learning and vehicle dynamics,” Sensors, vol. 23, no. 2, pp. 1–15, 2023.
- R. Gupta, A. Sharma, and P. Singh, “Driving style analysis using telematics data and ensemble learning methods,” Expert Systems with Applications, vol. 213, 2023.
- T. Nguyen and M. Arif, “A survey on driver behavior analysis using machine learning techniques,” IEEE Access, vol. 11, pp. 45678–45700, 2023.
- L. Zhao et al., “Explainable AI for driver behavior profiling using SHAP and ensemble models,” IEEE Transactions on Intelligent Transportation Systems, 2024.
- H. Eren et al., “Estimating driving behavior by a smartphone,” in Proc. IEEE Intelligent Vehicles Symposium, 2012.
- T. Chen and C. Guestrin, “XGBoost: A scalable tree boosting system,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 785–794, 2016.
- S. M. Lundberg and S.-I. Lee, “A unified approach to interpreting model predictions,” in Advances in Neural Information Processing Systems, vol. 30, 2017.