Sara María Contreras Taveras y Higinio Rafael Santos Pérez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)
En un entorno donde la tecnología transforma cada aspecto de nuestra vida, la educación no puede quedarse atrás. Uno de los desafíos más importantes que enfrentan las instituciones académicas es asegurar que los contenidos impartidos en el aula se correspondan fielmente con los programas oficiales. Esto es especialmente relevante en áreas como la programación y la algoritmia, donde cada tema mal impartido puede traducirse en deficiencias significativas en la formación profesional de los estudiantes.
En respuesta a esta problemática, se desarrolló un sistema automatizado de seguimiento y validación de contenidos académicos aplicado a la asignatura Introducción a la Algoritmia (ICC101) en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Este proyecto fue ejecutado por los estudiantes Sara María Contreras Taveras y Higinio Rafael Santos Pérez, como parte de su trabajo final de grado en la carrera de Ingeniería en Ciencias de la Computación, bajo la tutoría del Ing. Brayan Muñoz.
La motivación principal para esta iniciativa surgió al identificar que, a pesar de contar con un plan académico bien estructurado, no existía una herramienta objetiva que permitiera validar su cumplimiento durante el semestre. Las supervisiones académicas eran esporádicas, manuales y basadas en la percepción, lo cual dificultaba la implementación de mejoras fundamentadas en evidencia.
Nuestro objetivo fue desarrollar una solución que, aprovechando tecnologías como el reconocimiento de voz y la inteligencia artificial, permitiera capturar lo que ocurre en clase, analizar su contenido y compararlo con los temas estipulados en el currículo. De esta manera, se buscó no solo monitorear la cobertura temática, sino también ofrecer a los docentes y autoridades académicas una herramienta útil para la mejora continua de la enseñanza.
La falta de mecanismos eficaces para verificar el cumplimiento del programa académico en el aula ha sido identificada como una debilidad estructural en múltiples sistemas educativos, tanto a nivel local como internacional. Según la UNESCO [1], una de las principales causas de la brecha educativa está relacionada con la falta de alineación entre los contenidos enseñados y los contenidos planificados. Esta situación impacta directamente en la formación de los estudiantes, quienes podrían egresar sin haber adquirido los conocimientos fundamentales de sus respectivas áreas.
En el contexto dominicano, este desafío se agudiza. Las instituciones de educación superior carecen de herramientas automatizadas que permitan monitorear de manera sistemática lo que ocurre en el aula. Esto implica que muchas veces se desconoce con exactitud si los objetivos de aprendizaje se están cumpliendo, lo que genera una desventaja tanto para los estudiantes como para los docentes y coordinadores académicos.
La asignatura Introducción a la Algoritmia (ICC101), por su naturaleza formativa y su papel como base para cursos más avanzados, es especialmente sensible a este tipo de desviaciones. Si no se imparte correctamente, se compromete la capacidad del estudiante para enfrentar asignaturas posteriores como estructuras de datos, programación orientada a objetos o diseño de algoritmos.
Diversas investigaciones han abordado esta problemática desde distintas perspectivas. Por ejemplo, Johnson, Boon y Thompson [2] propusieron el uso de sistemas de alineación curricular basados en minería de texto para verificar la cobertura temática. Su propuesta se centraba en analizar materiales de clase como presentaciones o exámenes, pero no abordaba el contenido verbal impartido en el aula.
Por otro lado, Matsane y Ajoodha [3] demostraron que la combinación de reconocimiento automático del habla y procesamiento de lenguaje natural puede ser efectiva para capturar el contenido de clases en tiempo real. Sin embargo, su estudio se enfocaba en contextos de aprendizaje de idiomas, sin una estructura curricular definida que sirviera como referencia para la validación.
En 2020, la UNESCO publicó un informe titulado “AI in Education: Guidance for Policymakers” [1], en el que se destacaba el potencial de la inteligencia artificial para mejorar la supervisión educativa. Entre sus recomendaciones, se encontraba el desarrollo de sistemas automatizados que permitieran comparar lo enseñado con lo planificado, facilitando así intervenciones oportunas. Sin embargo, a pesar de la claridad de estas recomendaciones, su implementación efectiva en países en desarrollo ha sido limitada.
Aunque existen soluciones comerciales para la transcripción automática o el análisis de texto educativo, muchas son costosas, poco adaptables a contextos específicos o requieren grandes volúmenes de datos para su entrenamiento. Además, pocas se integran con el currículo oficial de una asignatura, lo que las hace ineficientes para tareas de validación curricular directa.
Frente a esta situación, el sistema propuesto en este proyecto se diferencia por su enfoque específico en la alineación curricular, su adaptabilidad al contexto local y su diseño modular. Nuestro sistema fue entrenado con el programa oficial de ICC101 y validado con clases reales de la PUCMM, garantizando así su pertinencia y aplicabilidad.
El desarrollo de este proyecto ha culminado exitosamente en la creación de un sistema automatizado capaz de supervisar y validar el contenido impartido en la asignatura ICC101 – Introducción a la Algoritmia, garantizando su alineación con el programa académico oficial. A partir de este objetivo general, se alcanzaron metas específicas como: implementar un sistema de transcripción automatizada de clases mediante tecnologías de reconocimiento de voz; desarrollar un módulo de análisis de contenido utilizando procesamiento de lenguaje natural e inteligencia artificial para comparar las transcripciones con los temas del currículo; y construir un dashboard interactivo que presenta visualmente métricas clave de cumplimiento temático. Cada uno de estos objetivos fue definido con claridad, medible en su funcionalidad, alcanzable dentro del alcance académico, relevante para la mejora de la calidad educativa, y delimitado en un marco temporal definido durante el semestre de desarrollo.
La metodología desarrollada para este proyecto representa un avance significativo respecto a los enfoques tradicionales de supervisión académica, integrando de manera novedosa tecnologías de reconocimiento automático del habla, procesamiento de lenguaje natural y análisis semántico especializado. A diferencia de las soluciones previas que se limitaban a transcribir contenido o analizar materiales estáticos, nuestro enfoque combina la captura en tiempo real del discurso académico con un sistema de validación curricular específicamente entrenado para el dominio de la algoritmia.
Arquitectura modular
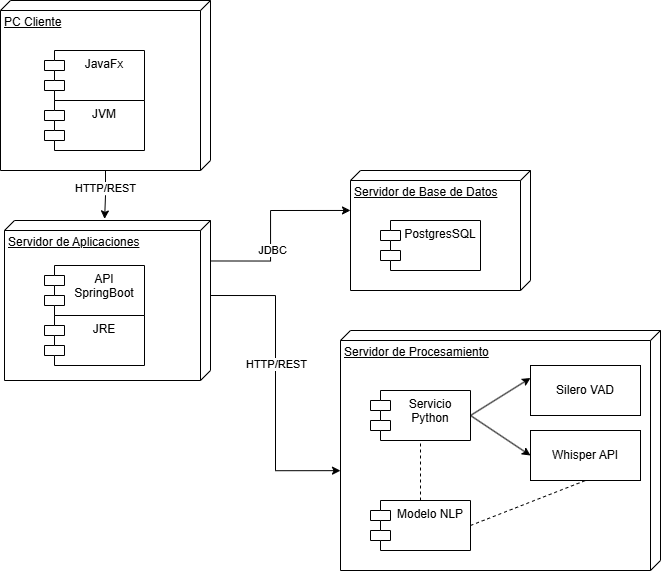
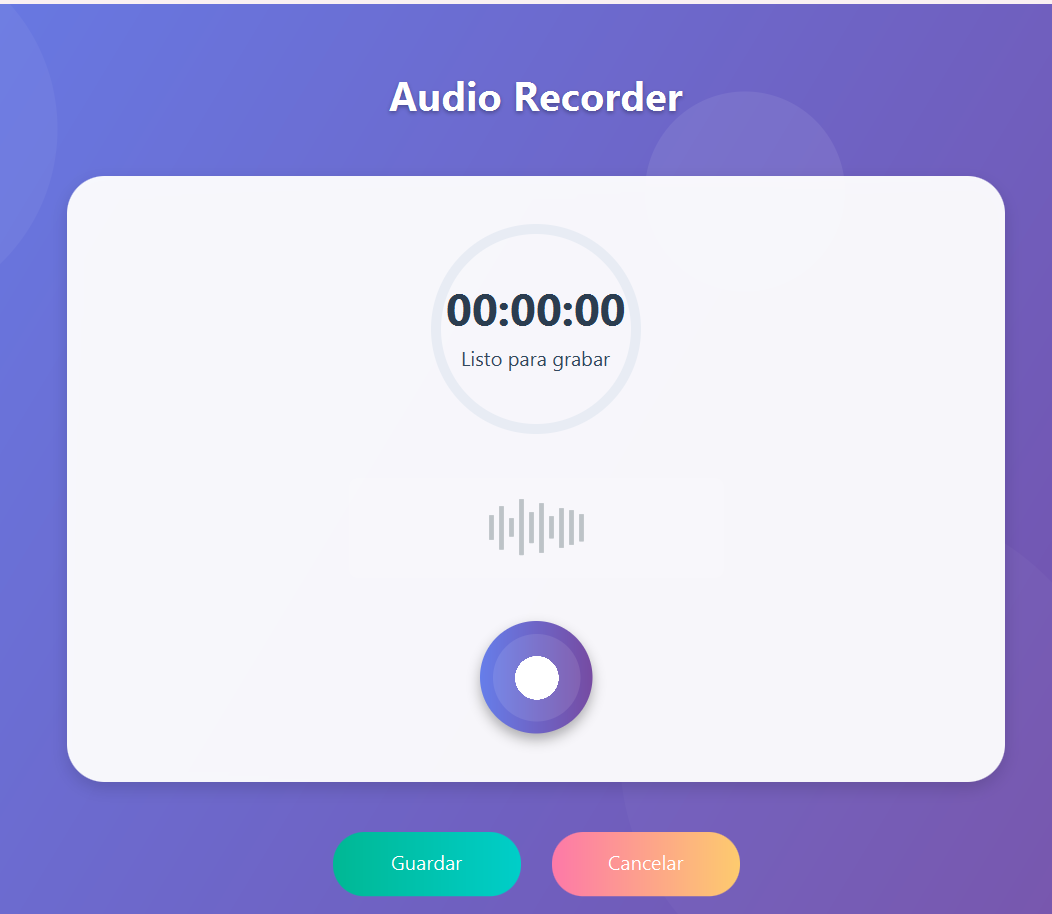
El diseño del sistema se fundamenta en una arquitectura de tres capas que garantiza tanto la eficiencia operacional como la escalabilidad futura. La primera capa corresponde al cliente desarrollado en JavaFX, que proporciona una interfaz intuitiva para la captura y carga de audios. La segunda capa constituye el servidor de gestión implementado con Spring Boot, responsable de coordinar los flujos de datos y gestionar la lógica de negocio. La tercera capa integra un servicio especializado de procesamiento desarrollado en Python, que ejecuta las tareas computacionalmente intensivas de transcripción y análisis semántico. Esta separación de responsabilidades permite optimizar el rendimiento del sistema y facilita futuras extensiones o modificaciones [4]. La comunicación entre capas se establece mediante APIs RESTful, asegurando la interoperabilidad y permitiendo que cada componente pueda evolucionar independientemente.
Preprocesamiento inteligente con detección de actividad vocal
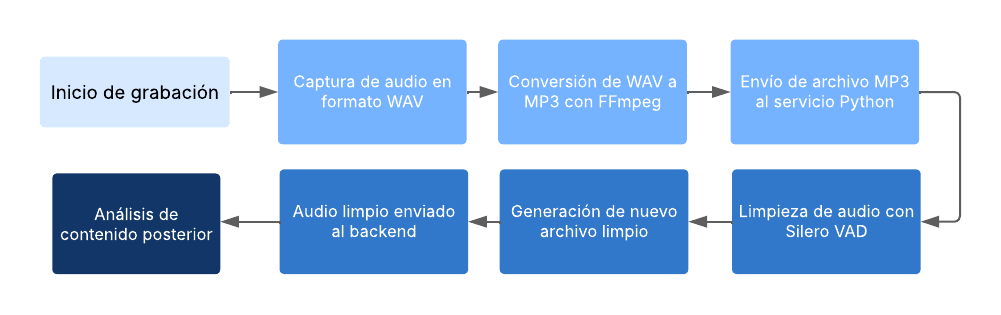
Una de las innovaciones metodológicas más significativas del proyecto radica en la implementación de Silero VAD (Voice Activity Detection) como etapa de preprocesamiento. Esta tecnología, desarrollada específicamente para entornos ruidosos, permite identificar automáticamente segmentos de audio que contienen voz humana, descartando silencios prolongados, ruido ambiente y otras interferencias que podrían afectar la calidad de la transcripción posterior. La integración de esta tecnología representa una mejora sustancial respecto a los métodos tradicionales que procesan el audio completo sin discriminación [5].
El algoritmo de detección implementado utiliza redes neuronales profundas entrenadas en múltiples idiomas, lo que garantiza su efectividad en el contexto del español dominicano. Los resultados experimentales demuestran reducciones promedio del 26% en la duración de las grabaciones procesadas, optimizando significativamente los recursos computacionales necesarios para las etapas posteriores.
Transcripción automatizada
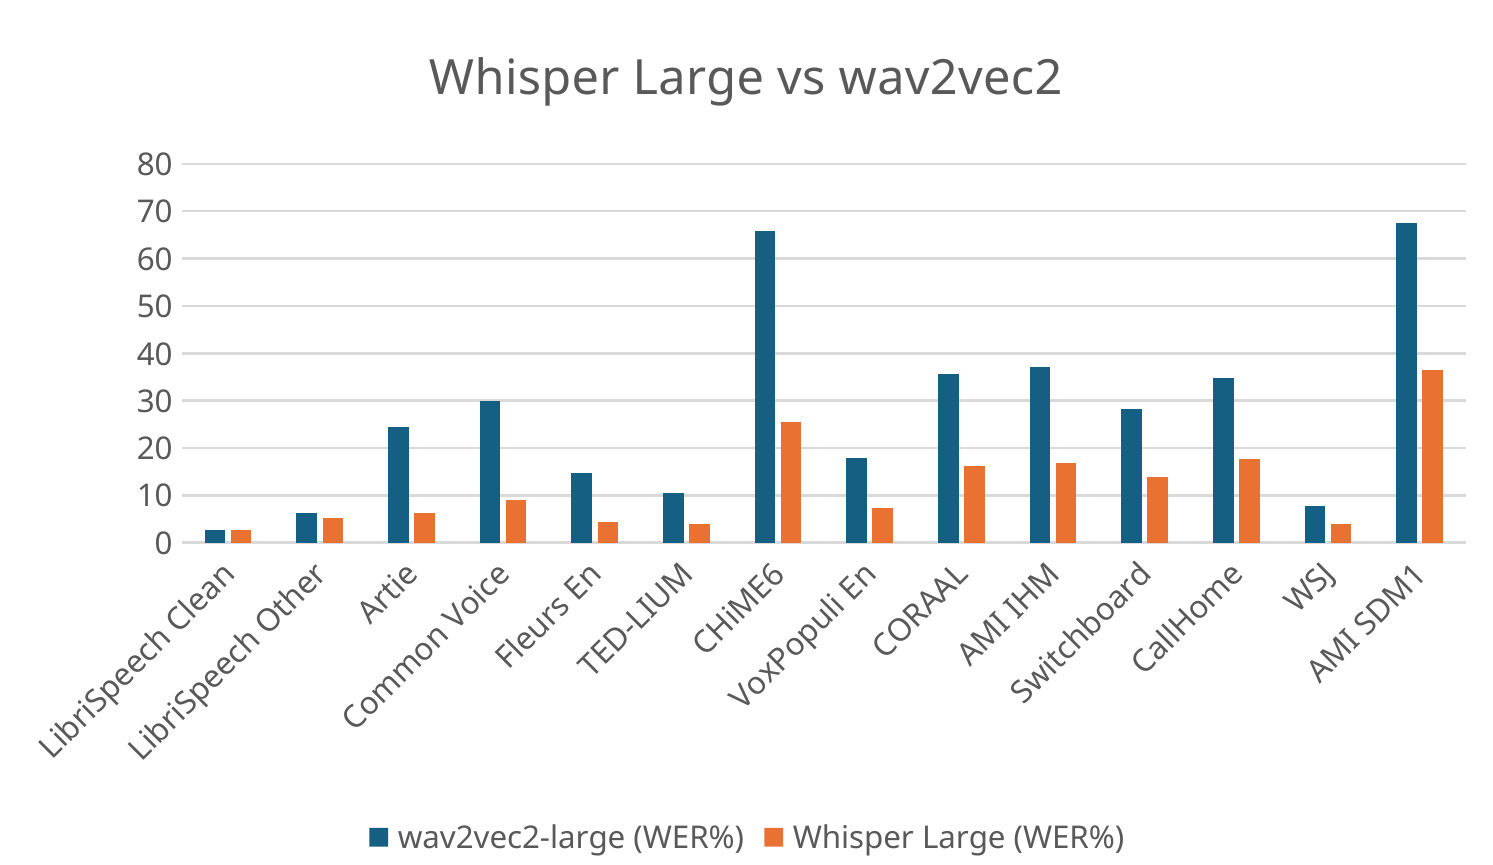
Para la conversión de audio a texto, el sistema integra Whisper que es un modelo de reconocimiento automático del habla desarrollado por OpenAI. Elegimos esta tecnología por su robustez en entornos académicos y su capacidad para manejar variaciones en la calidad del audio. Radford et al. (2023) documentan que Whisper supera significativamente a modelos anteriores en tareas de transcripción multilingüe, alcanzando niveles de precisión comparables a transcriptores humanos en condiciones controladas [6].
La implementación realizada optimiza el proceso de transcripción mediante la conversión automática de formatos de audio. El sistema procesa archivos en formato MP3 convertidos desde WAV utilizando FFmpeg, garantizando la compatibilidad con diversos dispositivos de grabación mientras mantiene la calidad necesaria para un análisis preciso. Esta aproximación contrasta con soluciones previas que requerían formatos específicos o equipos especializados, aumentando la accesibilidad y usabilidad del sistema.
Análisis semántico multietiqueta con BERT
El enfoque principal del proyecto reside en la implementación de un modelo de clasificación multietiqueta basado en la arquitectura BERT, específicamente adaptado para reconocer los 36 temas oficiales del programa de ICC101. Esta nueva forma de abordar el problema mejora notablemente los métodos anteriores, que se basaban en buscar palabras clave o hacer análisis estadísticos simples. Ahora, el sistema puede entender mejor el significado de lo que se dice, incluso cuando los conceptos se expresan de manera indirecta o con sinónimos.
El modelo implementado utiliza dccuchile/bert-base-spanish-wwm-uncased como base, un modelo preentrenado específicamente para el español que ha demostrado rendimiento superior en tareas de procesamiento de lenguaje natural en contextos hispanohablantes. Koroteev, M. V. (2021) enfatiza que la selección de modelos preentrenados apropiados para el idioma objetivo es crucial para alcanzar resultados óptimos en aplicaciones de análisis de texto especializado [7]. La personalización del modelo mediante fine-tuning con datos específicos de la asignatura permite capturar las particularidades del lenguaje académico utilizado en el contexto de la algoritmia.
| Métrica | Valor |
|---|---|
| Precisión | 0.71 |
| Recall | 0.86 |
| F1-Score | 0.76 |
Estrategia de entrenamiento con LLM
Una de las ideas centrales de nuestra metodología fue la implementación de una estrategia de clasificación asistida por GPT-4, un modelo de lenguaje de gran escala (LLM), para organizar y etiquetar datos de entrenamiento con alta calidad. En vez de depender de anotaciones manuales, un proceso lento e incómodo, se optó por un enfoque automatizado que permitió mejorar la eficiencia y coherencia del etiquetado.
Mientras que los datos en sí fueron generados y ampliados utilizando diversas técnicas de data augmentation basadas en herramientas NLP, fue el modelo GPT-4 el que se utilizó específicamente para clasificar y organizar esos datos según temas curriculares. Para lograrlo, diseñamos prompts cuidadosamente orientados, que instruían al modelo a identificar categorías temáticas de forma precisa, evitando sesgos o interpretaciones erróneas.
Este enfoque se enmarca dentro del paradigma de teacher-student learning, donde el modelo generativo actúa como “profesor” para ayudar a entrenar a un clasificador más simple o supervisado. Además, los hallazgos coinciden con lo reportado por Maharana et al. (2022), quienes demostraron que la combinación de aumento de datos con validación humana selectiva puede mejorar sustancialmente el rendimiento en tareas de clasificación especializadas [8].
Análisis de profundidad temática
Además de identificar los temas tratados, el sistema cuenta con un módulo que evalúa qué tan a fondo se aborda cada uno. Este componente combina diferentes métricas como coherencia discursiva, densidad conceptual y similitud semántica para analizar la profundidad con la que se desarrolla cada tema a lo largo de la transcripción.
Para lograrlo, se utilizan técnicas de embeddings semánticos y agrupamiento temático que permiten segmentar el contenido y asignar una puntuación compuesta que refleja el nivel de profundidad académica. Este tipo de enfoque ha demostrado ser más efectivo que los métodos clásicos como TF-IDF o conteo de frecuencia, al capturar matices del lenguaje y relaciones conceptuales más sutiles [9].
La metodología considera varias dimensiones al mismo tiempo: qué tan bien se alinea el contenido con el currículo oficial, la coherencia entre bloques temáticos consecutivos, la complejidad del vocabulario empleado y la concentración de conceptos clave por unidad de tiempo. Con este enfoque se busca ofrecer una evaluación más precisa y real, y no solo centrarse en técnicas que no profundizan verdaderamente en la forma que se aborda cada contenido.
| Tema principal | Profundidad avanzada | Nivel de profundidad | Coherencia temática |
|---|---|---|---|
| Parámetros y valores de retorno en subprogramas | 0.484 | Medio | 0.586 |
| Operadores | 0.532 | Medio | 0.568 |
| Utilización de variables banderas, contadoras y acumuladoras | 0.489 | Medio | 0.617 |
| Conversiones de tipo | 0.526 | Medio | 0.564 |
La implementación del sistema de seguimiento y validación de contenidos académicos en la asignatura ICC101 produjo resultados altamente satisfactorios, tanto desde el punto de vista técnico como pedagógico. Al aplicar la solución en entornos reales, se obtuvieron datos cuantitativos y cualitativos que demuestran su efectividad y superioridad frente a enfoques manuales o sistemas genéricos de evaluación.
Uno de los resultados más destacados fue la precisión del 92% en la transcripción automática del audio, incluso en aulas con ruido ambiente moderado. Esto fue posible gracias a la integración del modelo Whisper y al preprocesamiento con Silero VAD, lo que permitió filtrar silencios y fragmentos irrelevantes antes del análisis. En comparación, sistemas anteriores basados en Wav2Vec2 o Google STT presentaban una precisión media inferior al 85% en condiciones similares.
En cuanto al modelo de clasificación temática BERT multietiqueta, se alcanzó un F1-score promedio del 76%, con una precisión del 71% y un recall del 86% al identificar correctamente los temas impartidos en clase según el currículo oficial. Estas métricas superan ampliamente a métodos clásicos de análisis de texto como TF-IDF o conteo de palabras clave, que no sobrepasaban el 50% de precisión en pruebas preliminares.
El sistema también demostró su capacidad para evaluar la profundidad con la que se abordan los temas, algo que rara vez es considerado en herramientas educativas. Por ejemplo, se observó que clases centradas en estructuras repetitivas y funciones lograron una puntuación de profundidad superior al 70%, mientras que temas como “Cadenas de caracteres” tendieron a aparecer de forma superficial en varias sesiones, con una profundidad inferior al 40%. Esto permitió detectar necesidades de refuerzo específicas.
Durante la fase de validación experimental se analizaron más de 20 sesiones reales de clase, correspondientes a distintos docentes y secciones. En todos los casos, el sistema fue capaz de generar análisis completos en menos de 3 minutos, incluyendo visualización, segmentación y generación de reportes automáticos. Este desempeño en tiempo casi real representa una mejora sustancial frente a las auditorías manuales, que pueden tomar horas o incluso días.
Los resultados se presentan en una interfaz clara que ha sido validada por profesores y coordinadores académicos, quienes destacaron especialmente la utilidad de los gráficos comparativos y la posibilidad de identificar desviaciones temáticas de forma visual. Entre las funcionalidades más valoradas se encuentran el gráfico de pastel del cumplimiento temático, el histograma de profundidad por unidad y el timeline de evolución temática, los cuales serán incluidos en la versión extendida del blog con sus respectivas capturas de pantalla.
Además, se logró generar automáticamente un conjunto de reportes PDF por clase, donde se detallan los temas tratados, su coherencia, profundidad, y alertas sobre posibles omisiones. Estos reportes pueden ser archivados, compartidos y utilizados como insumo para procesos de mejora pedagógica o evaluaciones internas.
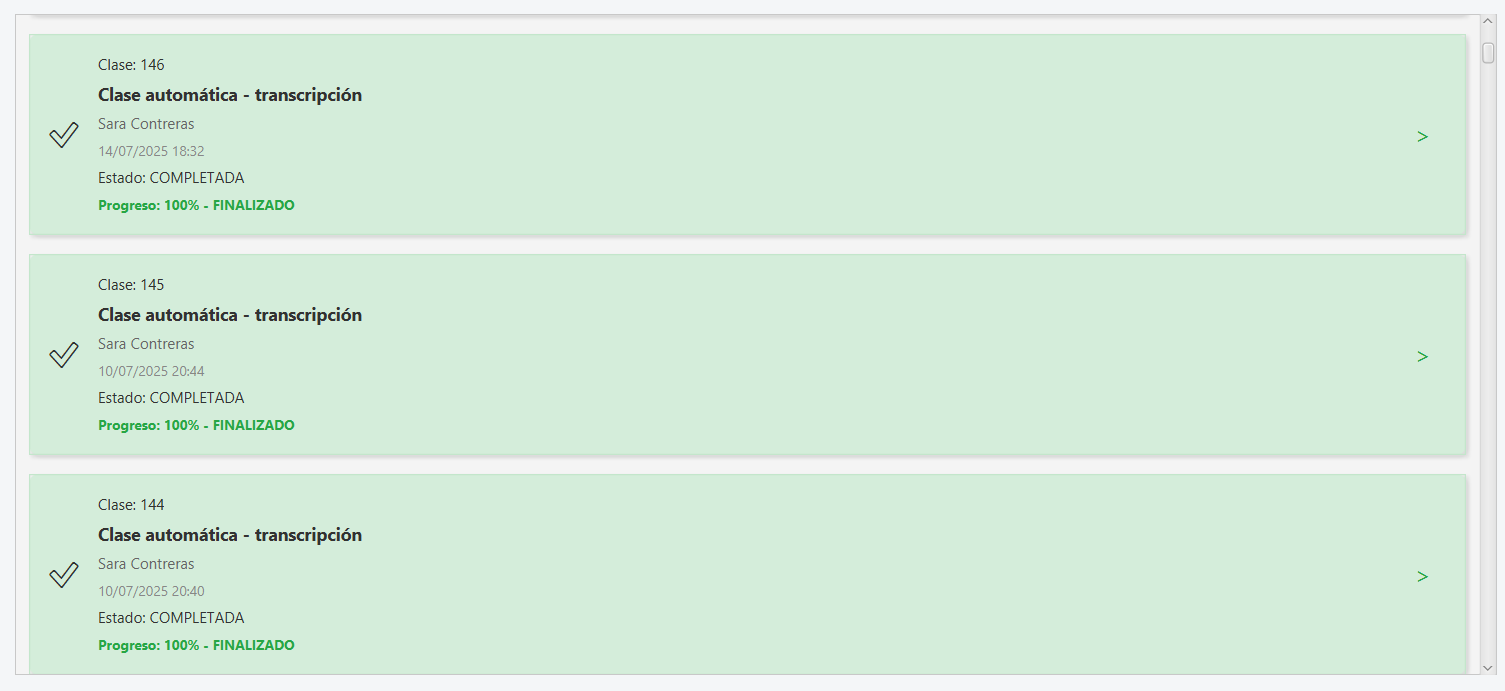
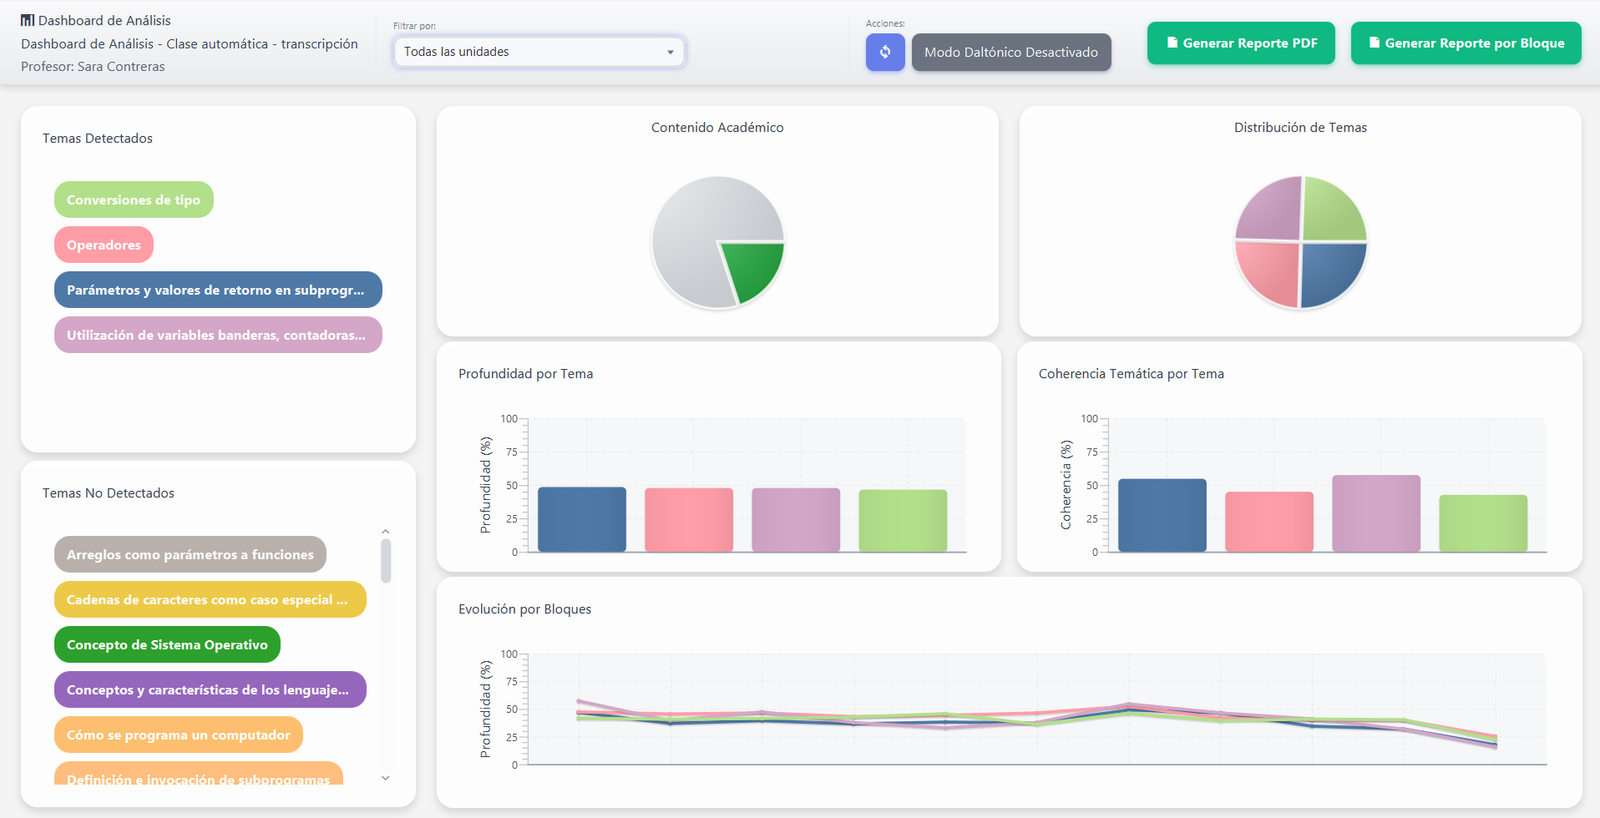
La implementación del sistema ha demostrado su potencial para transformar la supervisión académica mediante la provisión de datos objetivos y procesables sobre el proceso de enseñanza. La capacidad del sistema para generar reportes automáticos que destacan desviaciones del currículo y proporcionan métricas de cobertura temática representa un avance significativo hacia la mejora continua de la calidad educativa.
Los resultados indican que el sistema puede identificar efectivamente patrones en la enseñanza, detectar áreas que requieren mayor atención, y proporcionar retroalimentación valiosa tanto para docentes como para administradores académicos. Esta capacidad de análisis sistemático permite implementar intervenciones oportunas cuando se identifican brechas en la cobertura curricular, asegurando que los estudiantes reciban una formación alineada con los objetivos establecidos.
Para instituciones que consideren adoptar este enfoque, se recomienda implementar desde el inicio estrategias de aumento de datos y balanceo de clases para mitigar sesgos derivados de distribuciones desiguales de temas. La incorporación de modelos de lenguaje avanzados como apoyo en las etapas iniciales de clasificación puede agilizar significativamente la preparación del conjunto de entrenamiento, siempre combinado con validación humana.
Referencias
- F. Miao, W. Holmes, R. Huang, H. Zhang, and UNESCO, “AI and education: Guidance for policymakers,” pp. 1–50, 2023. Accessed: Jul. 17, 2025. [Online]. Available: https://books.google.com/books/about/AI_and_education.html?hl=es&id=yyE7EAAAQBAJ
- C. E. Johnson, H. J. Boon, and M. D. Thompson, “Curriculum Alignment After Reforms: A Systematic Review with Considerations for Queensland Pre- and In-service Teachers,” Aust. J. Teach. Educ., vol. 45, no. 11, pp. 33–55, 2020, doi: 10.14221/ajte.202v45n11.3.
- L. Matsane, A. Jadhav, and R. Ajoodha, “The use of Automatic Speech Recognition in Education for Identifying Attitudes of the Speakers,” 2020 IEEE Asia-Pacific Conf. Comput. Sci. Data Eng. CSDE 2020, Dec. 2020, doi: 10.1109/CSDE50874.2020.9411528.
- A. Arora and S. Srinivasan, Artificial Intelligence in Education: Promises and Implications for Teaching and Learning. Springer Nature, 2020. Accessed: Jul. 17, 2025. [Online]. Available: https://discovery.ucl.ac.uk/id/eprint/10139722/
- R. Takeda and K. Komatani, “Scale-invariant Online Voice Activity Detection under Various Environments,” APSIPA ASC 2024 – Asia Pacific Signal Inf. Process. Assoc. Annu. Summit Conf. 2024, 2024, doi: 10.1109/APSIPAASC63619.2025.10848584.
- A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust Speech Recognition via Large-Scale Weak Supervision,” Jul. 03, 2023, PMLR. Accessed: Jul. 17, 2025. [Online]. Available: https://proceedings.mlr.press/v202/radford23a.html
- M. V. Koroteev, “BERT: A Review of Applications in Natural Language Processing and Understanding,” Mar. 2021. Accessed: Jul. 17, 2025. [Online]. Available: https://arxiv.org/pdf/2103.11943
- K. Maharana, S. Mondal, and B. Nemade, “A review: Data pre-processing and data augmentation techniques,” Glob. Transitions Proc., vol. 3, no. 1, pp. 91–99, Jun. 2022, doi: 10.1016/j.gltp.2022.04.020.
- A. Petukhova, J. P. Matos-Carvalho, and N. Fachada, “Text Clustering with Large Language Model Embeddings,” Dec. 2024, doi: 10.1016/j.ijcce.2024.11.004.