Cristian Ignacio de la Hoz Reyes y Manuel José Rodríguez Cruz – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)
Introducción
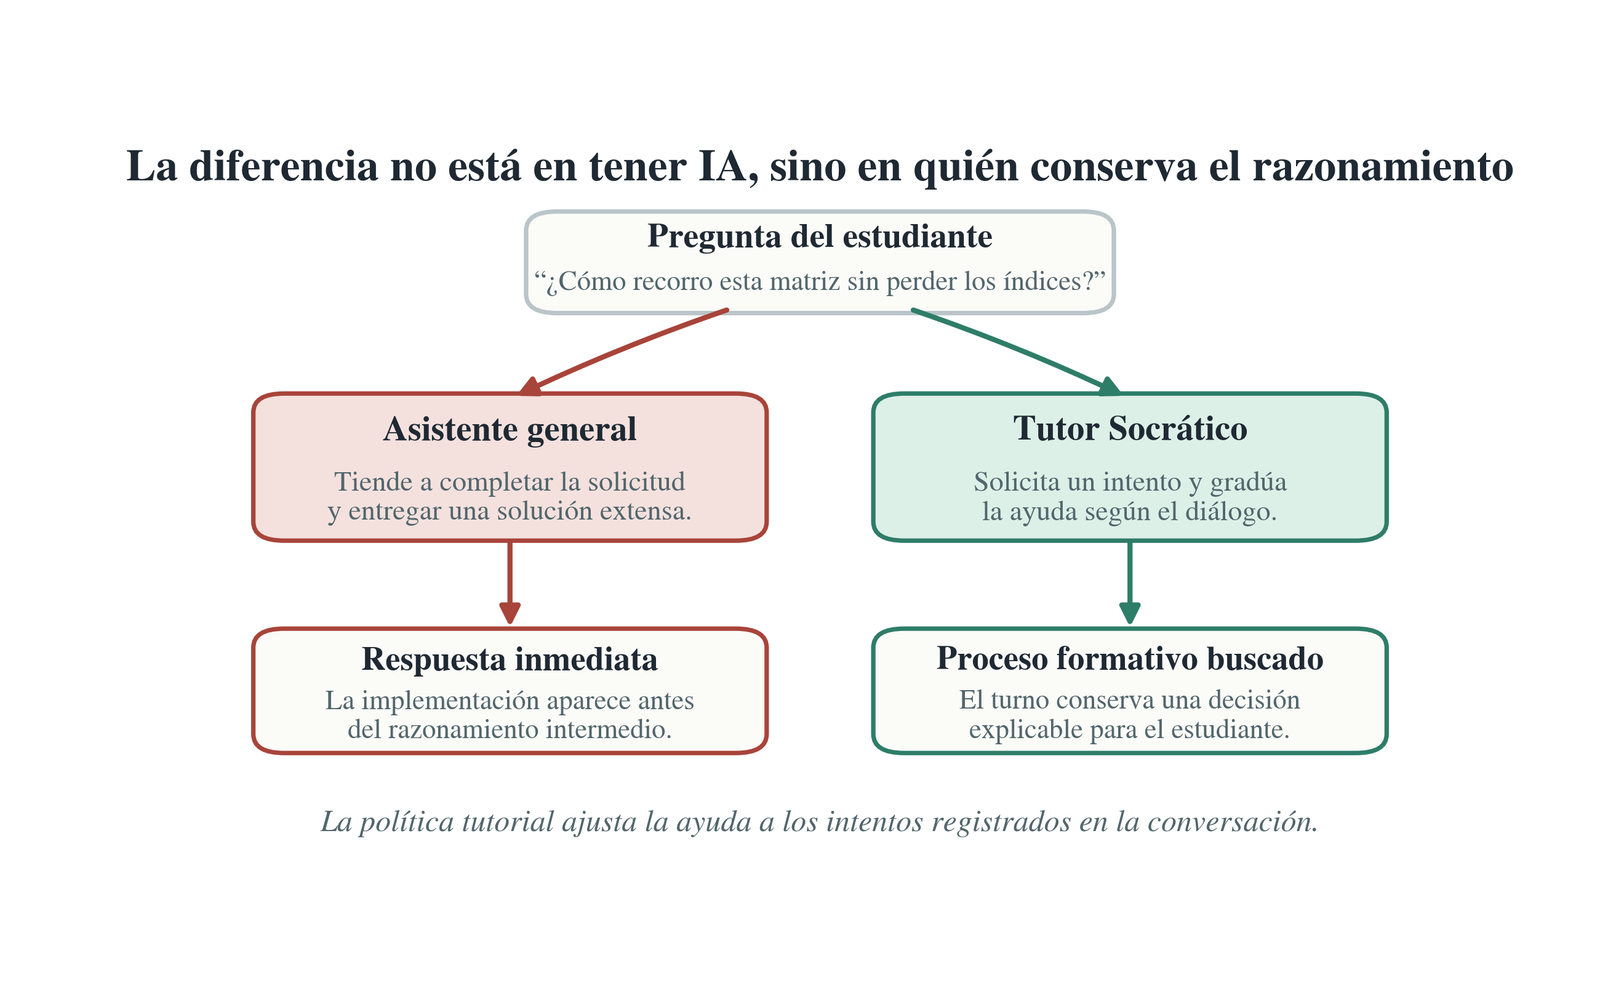
Una respuesta correcta puede ser una mala experiencia de aprendizaje. Cuando un estudiante que comienza a programar recibe en segundos el ciclo, la condición y el arreglo que necesitaba construir, el ejercicio queda resuelto, pero no necesariamente la duda que lo originó. Esa tensión dio forma al Tutor Socrático, un sistema inteligente de tutoría desarrollado por Cristian Ignacio de la Hoz Reyes y Manuel José Rodríguez Cruz en la Escuela de Ingeniería en Computación y Telecomunicaciones de la Pontificia Universidad Católica Madre y Maestra, bajo la asesoría de la profesora Lisibonny Beato Castro. En ICC-101-T, Introducción a la Algoritmia, el proyecto planteó una pregunta educativa: ¿cómo aprovechar la capacidad conversacional de los modelos de lenguaje sin permitir que la rapidez de la respuesta sustituya el proceso de pensar? La propuesta no intenta esconder la inteligencia artificial ni convertirla en un buscador con restricciones. Busca preservar la participación del estudiante, solicitar indicios de lo que comprende, hacer visible el punto de bloqueo y ofrecer apoyo para el siguiente paso. La Figura 1 resume ese contraste.
La programación introductoria es un escenario sensible para esa pregunta. Aprender a programar implica descomponer problemas, representar estados, anticipar el flujo de ejecución, verificar hipótesis y corregir modelos mentales, habilidades del pensamiento computacional que trascienden la sintaxis [1]. En los primeros cursos, los errores conceptuales suelen acumularse: confundir un contador, recorrer incorrectamente una matriz o no distinguir el valor de una variable de su dirección puede afectar ejercicios posteriores aunque el código compile [2]. En el contexto dominicano, las diferencias de experiencia previa y concepciones docentes vuelven necesaria una mediación intencional [3]. Por eso, una herramienta que produce programas completos plantea una paradoja. Puede reducir la fricción y ampliar el acceso a explicaciones, pero también ocultar las operaciones cognitivas que el curso pretende desarrollar. El valor de un tutor no reside, entonces, en escribir más código que el estudiante, sino en ayudarle a construir una explicación que pueda defender, modificar y transferir.
La literatura reciente confirma que la inteligencia artificial generativa no produce un efecto educativo único. Una revisión rápida sobre programación identifica oportunidades para explicar, generar ejemplos y apoyar la depuración, junto con riesgos de inexactitud, dependencia y evaluación superficial [4]. Una revisión sistemática de cuarenta estudios empíricos concluye que los resultados dependen de la integración, las estrategias de interacción y la evaluación [5]. En educación superior, el uso intensivo puede relacionarse con procrastinación, deterioro del desempeño y pérdida de control cuando sustituye el esfuerzo [6]. Al mismo tiempo, una colaboración bien estructurada puede favorecer motivación y desempeño [7]. La conclusión útil no es aceptar o prohibir la IA de forma absoluta. Es diseñar condiciones para que funcione como andamiaje temporal: una ayuda que observa el intento, ajusta la dificultad, solicita evidencia y se retira gradualmente. En ese punto se sitúa el Tutor Socrático, una arquitectura que convierte principios pedagógicos en reglas operativas.
El resultado es una plataforma funcional que integra conversación guiada, memoria, materiales autorizados, preguntas diagnósticas, actividades y un depurador visual de C. Su aporte principal no es un mensaje ingenioso ni un modelo particular. Es una arquitectura replicable que mantiene identidad, permisos, persistencia y evidencia bajo control de la plataforma, mientras el modelo interpreta el contexto y genera una intervención pedagógica. Esa separación responde a un problema conocido: los modelos pueden producir afirmaciones plausibles sin respaldo o variar según el contexto [8]. También recoge que la IA educativa requiere gobernanza, transparencia y participación humana, no solo precisión técnica [9]. El proyecto une dos escalas. En el turno conversacional, pregunta en vez de resolver y ofrece pistas acotadas. En la escala institucional, reconoce clases, docentes, estudiantes, materiales y actividades. Esta doble mirada permite evaluar no solo si el modelo “suena socrático”, sino si el sistema sostiene una tutoría responsable.
Problemática y estado del arte
En ICC-101-T, una solución sintácticamente válida puede dejar intacto el error que importa. Un estudiante puede copiar un recorrido de arreglo sin comprender por qué el índice comienza en cero, ajustar una condición hasta que el programa termine o repetir una función sin reconocer sus entradas y salidas. Estas dificultades exigen retroalimentación oportuna, pero el tiempo docente es limitado. Los asistentes generales parecen llenar el vacío porque están disponibles y producen ejemplos con rapidez. Sin embargo, fueron optimizados para completar instrucciones, no para proteger una secuencia didáctica. Suelen inferir que la mejor ayuda es la solución más acabada. En un entorno profesional eso puede aumentar productividad; en un curso inicial puede saltar desde la confusión hasta el producto final y eliminar la observación del razonamiento intermedio. El desafío no consiste solo en evitar respuestas extensas. Consiste en reconocer el estado del estudiante, decidir qué apoyo es proporcional, mantener continuidad y conservar evidencia que permita al docente interpretar cómo se construyó la respuesta.
Esta diferencia puede entenderse mediante la descarga cognitiva. Las personas usan recursos externos para reducir demandas de memoria, cálculo o atención, algo adaptativo cuando libera capacidad para tareas complejas [10]. El problema aparece cuando el recurso reemplaza la práctica que debía consolidar una habilidad. Un almacén externo puede disminuir el esfuerzo de estudio y cambiar lo recordado [11], e incluso incrementar errores cuando la persona confía en que la información seguirá accesible [12]. Con IA, el costo puede incluir pérdida de confianza para resolver, aceptación sin inspección y debilitamiento de hábitos metacognitivos [13]. Por eso, el Tutor Socrático no trata cada solicitud como una orden. La interpreta como evidencia parcial de un estado cognitivo. “Hazme este ejercicio” puede esconder desconocimiento del enunciado, dificultad para descomponerlo o prisa. Antes de producir código, el sistema debe distinguir esas posibilidades y devolver al estudiante una decisión que todavía le pertenezca.
La evidencia empírica vuelve concreta esa preocupación. En un estudio sobre chatbots en educación de programación, el rendimiento pasó de 48.33 a 74.47 puntos, con un tamaño de efecto reportado de 1.56, pero el beneficio convivió con una señal crítica: ante respuestas incorrectas de la IA, 33 de 36 estudiantes las siguieron y 22 copiaron y pegaron el contenido [14]. El dato muestra que una herramienta puede elevar resultados inmediatos y, simultáneamente, reforzar conductas de dependencia. En otra disciplina, un ensayo a gran escala en matemáticas encontró que el acceso a IA con salvaguardas podía apoyar la práctica, mientras la versión sin guardas podía perjudicar el aprendizaje posterior cuando la herramienta dejaba de estar disponible [15]. No corresponde trasladar esos efectos de manera automática a ICC-101-T, pero sí reconocer el mecanismo de riesgo: si la interfaz recompensa obtener una respuesta y no justificarla, el estudiante aprende a optimizar la conversación, no necesariamente el concepto. De ahí que la seguridad pedagógica deba diseñarse en el flujo del sistema y no quedar como una recomendación escrita al inicio de la sesión.
Los proyectos más próximos al estado del arte han comenzado a responder con guardas y conversación guiada. CodeHelp limita la entrega de soluciones completas y organiza el apoyo para clases de programación a escala [16]. Ruffle & Riley explora un tutor conversacional basado en modelos de lenguaje y documenta las decisiones de diseño necesarias para sostener una interacción pedagógica [17]. Un estudio controlado con 42 participantes comparó un asistente guiado, que evitaba soluciones directas, con uno de uso irrestricto; el grupo guiado mostró mejores mejoras de aprendizaje, aunque los autores también identificaron intentos de eludir las restricciones mediante instrucciones adversarias [18]. Más recientemente, un estudio aleatorizado con 94 estudiantes informó que un agente conversacional socrático superó a una versión no socrática en rendimiento y pensamiento reflexivo, con diferencias particularmente visibles en reflexión y reflexión crítica, pero sin ventaja equivalente en motivación [19]. En conjunto, estas investigaciones apoyan una idea sobria: las restricciones pedagógicas pueden ser valiosas, pero necesitan persistencia, medición y un diseño resistente a la variabilidad de los modelos.
Aun así, una respuesta socrática aislada no constituye un sistema de tutoría. Un chatbot puede formular una buena pregunta y perderla en el turno siguiente, consultar un material que no pertenece a la clase, mostrar información de otro usuario o generar un informe sin trazabilidad. También puede impedir toda ayuda bajo la etiqueta de seguridad, frustrando a quien necesita una explicación legítima. El reto arquitectónico consiste en coordinar elementos con objetivos distintos: control de acceso, contexto académico, memoria, recuperación documental, llamadas a herramientas, transmisión progresiva de la respuesta, registro de eventos y revisión docente. Además, la relación entre usuario y modelo de código no es neutral. Estudios sobre programadores muestran que las personas alternan entre acelerar una tarea y explorar lo que el modelo puede hacer, lo cual modifica la forma de inspeccionar y aceptar sugerencias [20]. Para principiantes, esa asimetría es mayor porque disponen de menos criterios para verificar. La plataforma debe, por tanto, conservar la frontera entre una explicación persuasiva y una evidencia autorizada, entre una sugerencia y una decisión académica, y entre el rol técnico de una cuenta y su pertenencia real a una clase.
El vacío que motivó el proyecto fue precisamente esa integración. Existían asistentes generales con gran capacidad de generación, prototipos con guardas conversacionales y estudios que demostraban el potencial del método socrático, pero faltaba una propuesta local que uniera pedagogía, control institucional y herramientas de programación en una misma cadena verificable. El Tutor Socrático aborda el problema sin asumir que la prohibición es sostenible ni que el acceso irrestricto es educativo. Su tesis de diseño es que la ayuda debe estar delimitada por el propósito de la asignatura y por el progreso expresado en la conversación. Una respuesta útil no se mide solo por su exactitud, sino por lo que permite hacer después sin la herramienta. La recuperación de práctica, por ejemplo, produce más aprendizaje que formas de estudio elaborativo cuando obliga a reconstruir activamente el conocimiento [21]. Trasladado al diálogo, esto significa que el sistema debe pedir al estudiante que prediga, explique, trace o corrija antes de formalizar la solución. Esa regla conecta la literatura con una necesidad concreta de aula y justifica que el proyecto se evalúe como plataforma académica, no como una colección de prompts.
Objetivos completados
El proyecto completó la implementación de un sistema de tutoría inteligente para Introducción a la Algoritmia que orienta mediante apoyo cognitivo progresivo, preguntas reflexivas, pistas y explicaciones graduadas. El sistema se diseñó para promover la descomposición de problemas, el razonamiento algorítmico y la construcción lógica, al tiempo que limita la entrega ordinaria de soluciones completas generadas por herramientas de propósito general. Para cumplir ese objetivo se diseñó y consolidó una arquitectura replicable y se materializó en una plataforma académica funcional; se recopiló y organizó conocimiento pedagógico de la asignatura, incluidos contenidos, ejercicios representativos, materiales autorizados y estrategias de acompañamiento docente; se construyó y evaluó un motor de razonamiento pedagógico basado en modelos de lenguaje y estrategias socráticas; y se implementó una interfaz conversacional que mantiene el registro de las progresiones de razonamiento y permite intervenciones en múltiples etapas. La solución integra, además, identidad académica, permisos contextuales, memoria, recuperación documental, preguntas estructuradas, actividades formativas, informes revisables y depuración visual de código C.
Metodología
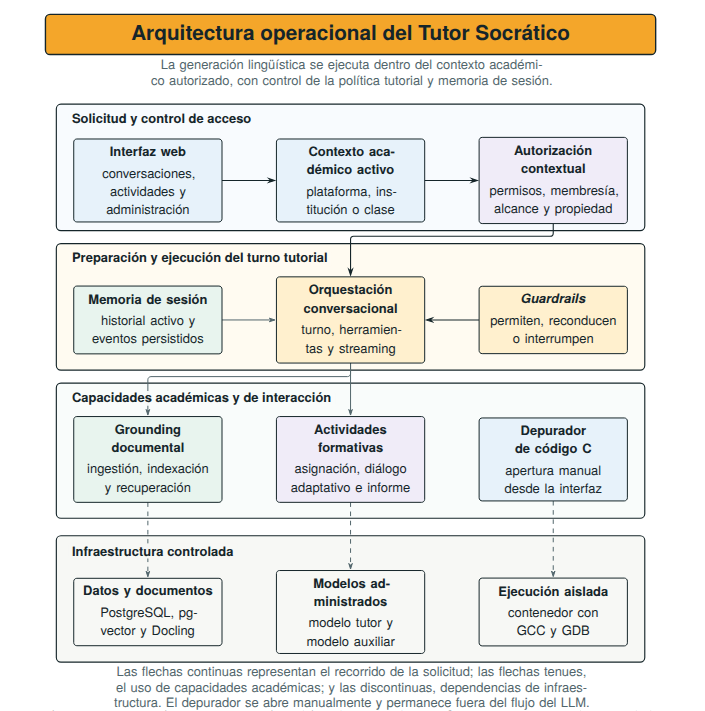
La solución se construyó a partir de una separación explícita entre la plataforma y el modelo de lenguaje. La plataforma autentica a la persona, resuelve el contexto académico activo, comprueba permisos y propiedad, conserva el historial, habilita recursos y registra los eventos del turno. El modelo recibe únicamente el contexto preparado por esos servicios, interpreta las instrucciones tutoriales y produce una intervención o una llamada estructurada a una herramienta disponible. Esta distribución de responsabilidades impide trasladar al texto generado decisiones institucionales como la pertenencia a una clase, la lectura de un material o la modificación de una evidencia. La arquitectura se organiza en una interfaz académica, servicios de dominio autorizados, el harness tutorial, persistencia conversacional, materiales y herramientas, y un servidor de inferencia reemplazable. El harness coordina la guardia, la memoria, el contexto académico y las llamadas a herramientas; no representa un modelo adicional ni una clase aislada. La Figura 2 muestra las fronteras y el sentido del flujo: la autorización ocurre antes de construir el contexto, y las herramientas se ejecutan mediante servicios controlados cuando el modelo las solicita.
La autorización se aplica antes de invocar la inteligencia artificial. El dominio distingue tres niveles: plataforma, institución y clase. Una misma cuenta puede asumir funciones diferentes en espacios distintos, por lo que el sistema separa el rol configurable de la identidad académica expresada por la membresía. Cada operación combina el permiso requerido, la institución, la pertenencia a la clase y la propiedad del recurso cuando corresponde. La protección se repite en la navegación y en los servicios: ocultar una opción de menú mejora la interfaz, pero la decisión efectiva se toma en la capa que consulta o modifica los datos. Los permisos se expresan mediante códigos estables de recurso y acción, mientras las instantáneas de acceso se almacenan temporalmente y se invalidan cuando cambia un rol o una asignación. En consecuencia, una conversación, un material o una actividad se recuperan dentro del espacio autorizado antes de formar el contexto del modelo. Esta estructura permite que el profesor administre los recursos de sus clases y que el estudiante acceda a sus conversaciones y asignaciones sin convertir ninguna identidad académica en una autoridad global.
Cada turno sigue una cadena explícita. La guardia clasifica el mensaje junto con el historial activo relevante y el contexto de la asignatura; así puede interpretar respuestas breves que dependen de una pregunta anterior. Sus acciones son permitir, reconducir o interrumpir. La versión reconducida es la que continúa hacia la memoria, mientras una interrupción detiene la cadena antes de incorporar el contenido a la sesión. Después, el sistema reúne la memoria activa y el contexto académico permitido. El modelo puede generar texto o solicitar una herramienta registrada. Una de ellas, interrogateUser, presenta de una a tres preguntas diagnósticas con opciones o respuesta escrita, conserva los borradores, valida el contenido y devuelve el resultado al mismo turno para que continúe la generación. La salida llega a la interfaz en streaming y se persiste como eventos coherentes de usuario, asistente y herramientas. Esta orquestación responde a la posibilidad de generar información no fundamentada [8] y a los intentos de eludir restricciones conversacionales [18].
La memoria distingue la evidencia persistente del contexto enviado a inferencia. Cada conversación utiliza una sesión basada en eventos ordenados; estos pueden marcarse como reales, sintéticos o archivados. La interfaz conserva la transcripción de los mensajes reales, mientras el modelo recibe la memoria sintética más reciente y los turnos activos que caben dentro del presupuesto configurado. Cuando el historial alcanza el umbral de compactación, la estrategia recorre los eventos desde el más reciente, conserva una ventana de intercambios y resume la parte anterior. El punto de corte se desplaza hasta un evento raíz de usuario para no separar una respuesta o una salida de herramienta de la pregunta que le da sentido. El resumen previo puede incorporarse de manera recursiva, y los eventos antiguos se archivan en lugar de eliminarse. Con ello, la plataforma mantiene dos proyecciones del mismo historial: una transcripción canónica para consulta y trazabilidad, y una memoria sintética para sostener continuidad sin reenviar toda la conversación en cada turno.
Sobre esa base, la política socrática se implementó como una progresión regulada por los indicios del diálogo. El tutor intenta localizar la dificultad mediante una explicación del objetivo, una predicción, un intento de código o la identificación del punto de bloqueo. Después propone una acción abordable, como formular una condición o trazar algunas iteraciones. Si el intento registrado muestra estancamiento, introduce una pista limitada; posteriormente puede formalizar el concepto y plantear una variación para comprobar la continuidad del razonamiento. El nivel de ayuda cambia según las respuestas conservadas en la conversación y el tutor puede corregir una idea cuando el intercambio aporta evidencia suficiente. Este diseño coincide con estudios donde el diálogo socrático se relacionó con mejor rendimiento y pensamiento reflexivo [19], y con propuestas que utilizan la IA como apoyo a la metacognición y la autorregulación [22]. El propósito de la secuencia es mantener una acción intelectual concreta en el siguiente turno, no prolongar una cadena de preguntas sin orientación.
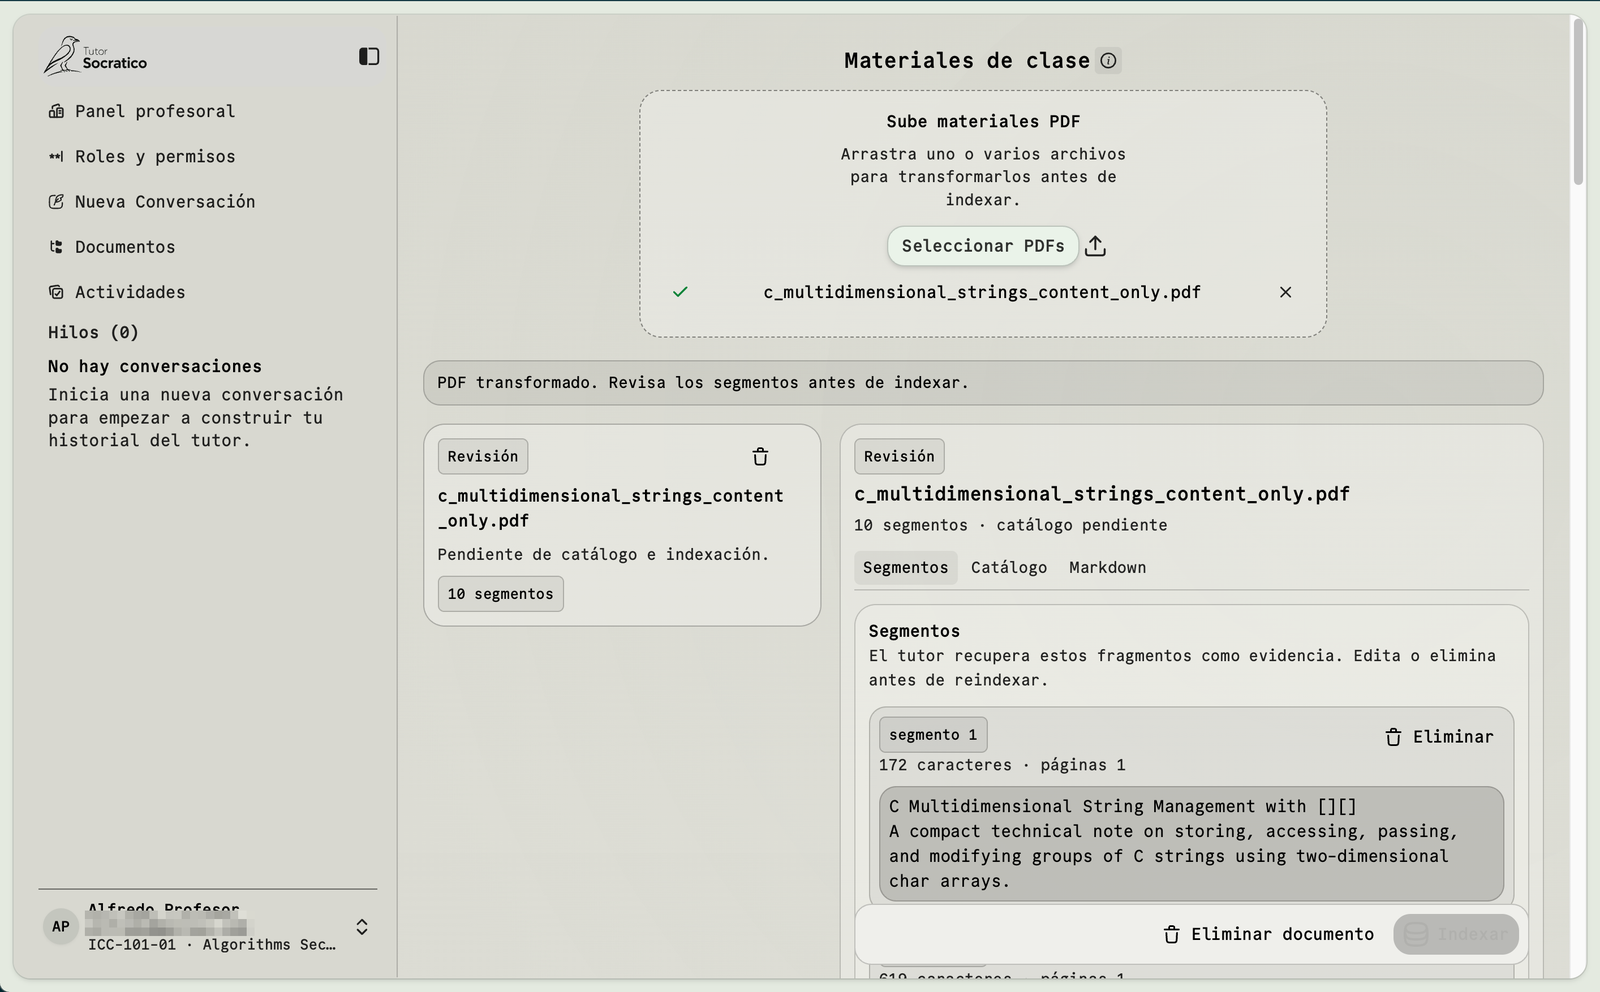
El grounding documental incorpora materiales proporcionados por el profesor mediante un flujo revisable. El documento se asocia con la clase activa, Docling lo transforma a Markdown y segmentos, y la interfaz permite revisar el contenido antes de aprobarlo. Tras la aprobación, el servicio calcula embeddings y almacena los fragmentos con metadatos de procedencia, clase, autor, posición, estado e identificador de ingestión. La recuperación se ofrece al tutor mediante herramientas para buscar materiales y continuar la lectura de un documento. Antes de consultar el índice vectorial, el servicio exige la clase autorizada y filtra por ese contexto y por el estado disponible; el modelo recibe los fragmentos que el sistema ya delimitó. La búsqueda semántica se combina con cursores opacos para avanzar dentro de la misma fuente sin exponer identificadores internos. Este enfoque se relaciona con la generación aumentada por recuperación, que combina el conocimiento paramétrico con evidencia externa [23]. En el Tutor Socrático, su función es vincular la explicación con materiales académicos revisados y conservar la procedencia de lo recuperado. La Figura 3 muestra la carga del PDF transformado y la revisión de sus segmentos antes de la indexación.
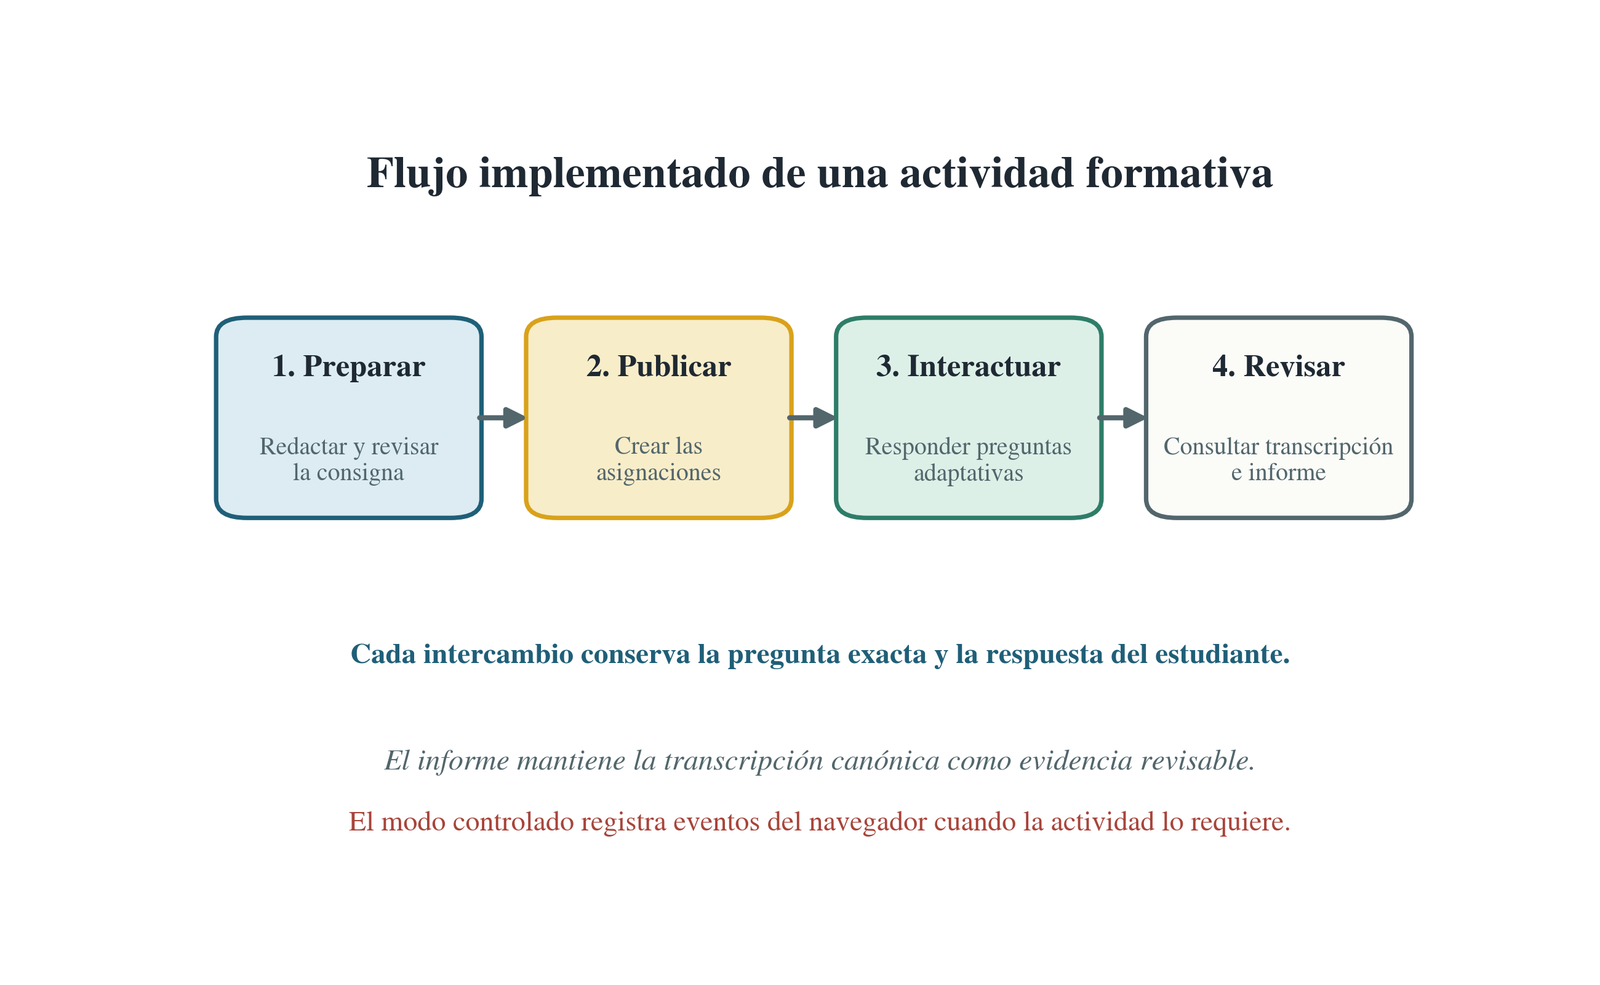
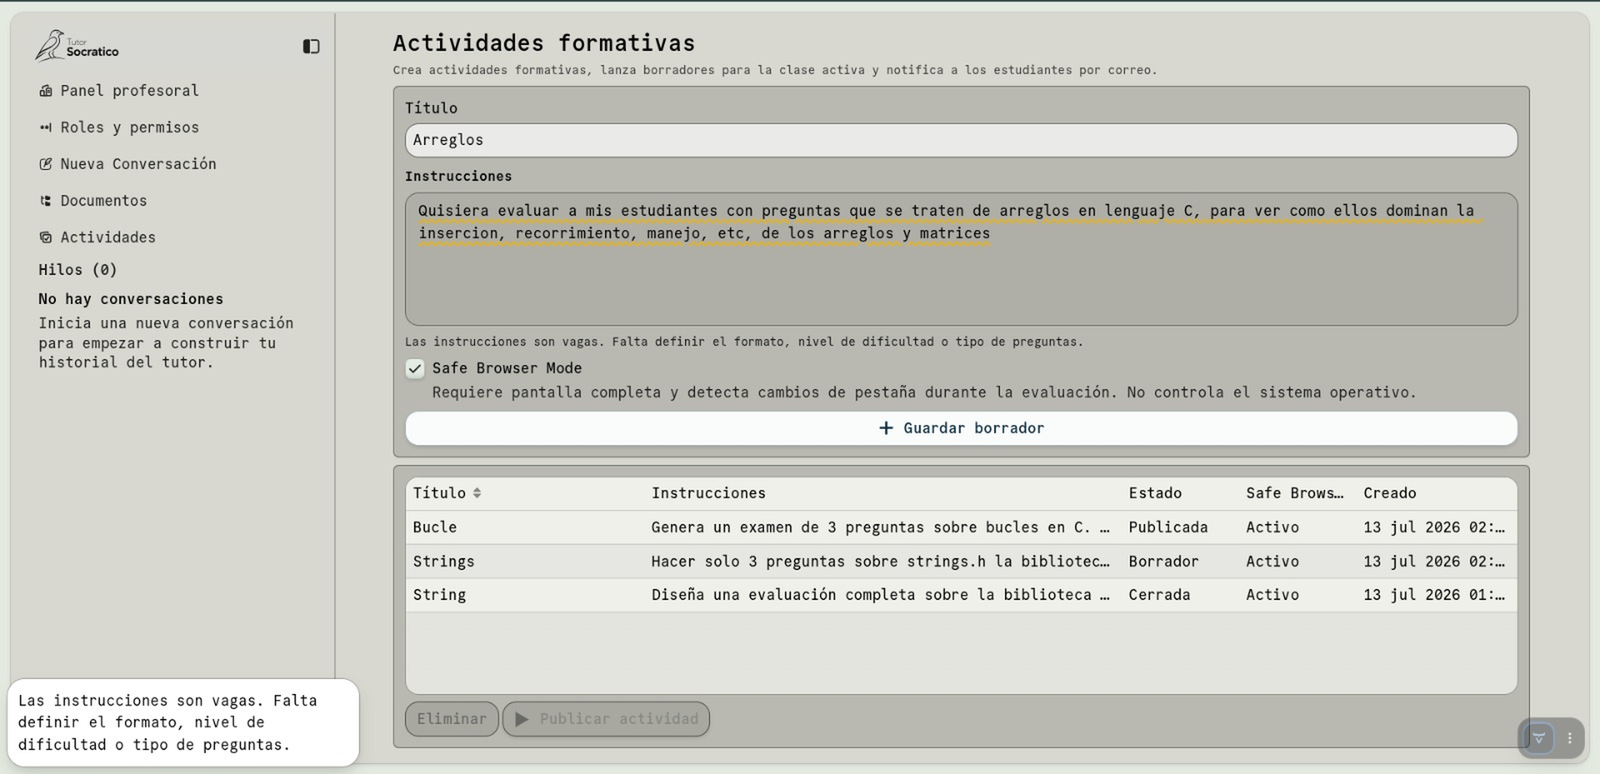
El módulo de actividades formativas amplía la tutoría más allá de una conversación iniciada libremente por el estudiante. El profesor redacta una consigna, la guarda como borrador y puede solicitar una revisión asistida que combina validaciones locales con una salida estructurada del modelo auxiliar. La revisión identifica ambigüedades, ausencia de criterios verificables o condiciones que dificultarían observar el razonamiento; su propuesta queda sujeta a la decisión del docente. Al publicar, el sistema crea las asignaciones correspondientes y comunica su disponibilidad. Durante la realización, un servicio adaptativo genera la primera pregunta y, después de cada respuesta, decide de forma estructurada si debe continuar o completar la actividad según la evidencia reunida. Cada intercambio conserva la pregunta exacta y la respuesta del estudiante. Al finalizar, el sistema genera un informe revisable que mantiene la transcripción canónica como fundamento. El modo de navegación controlada, cuando se habilita, registra eventos como pérdida de visibilidad, salida de pantalla completa, desenfoque o interrupción del latido y puede producir una alerta para revisión. Las Figuras 4 y 5 muestran el flujo y la vista real de preparación de una actividad.
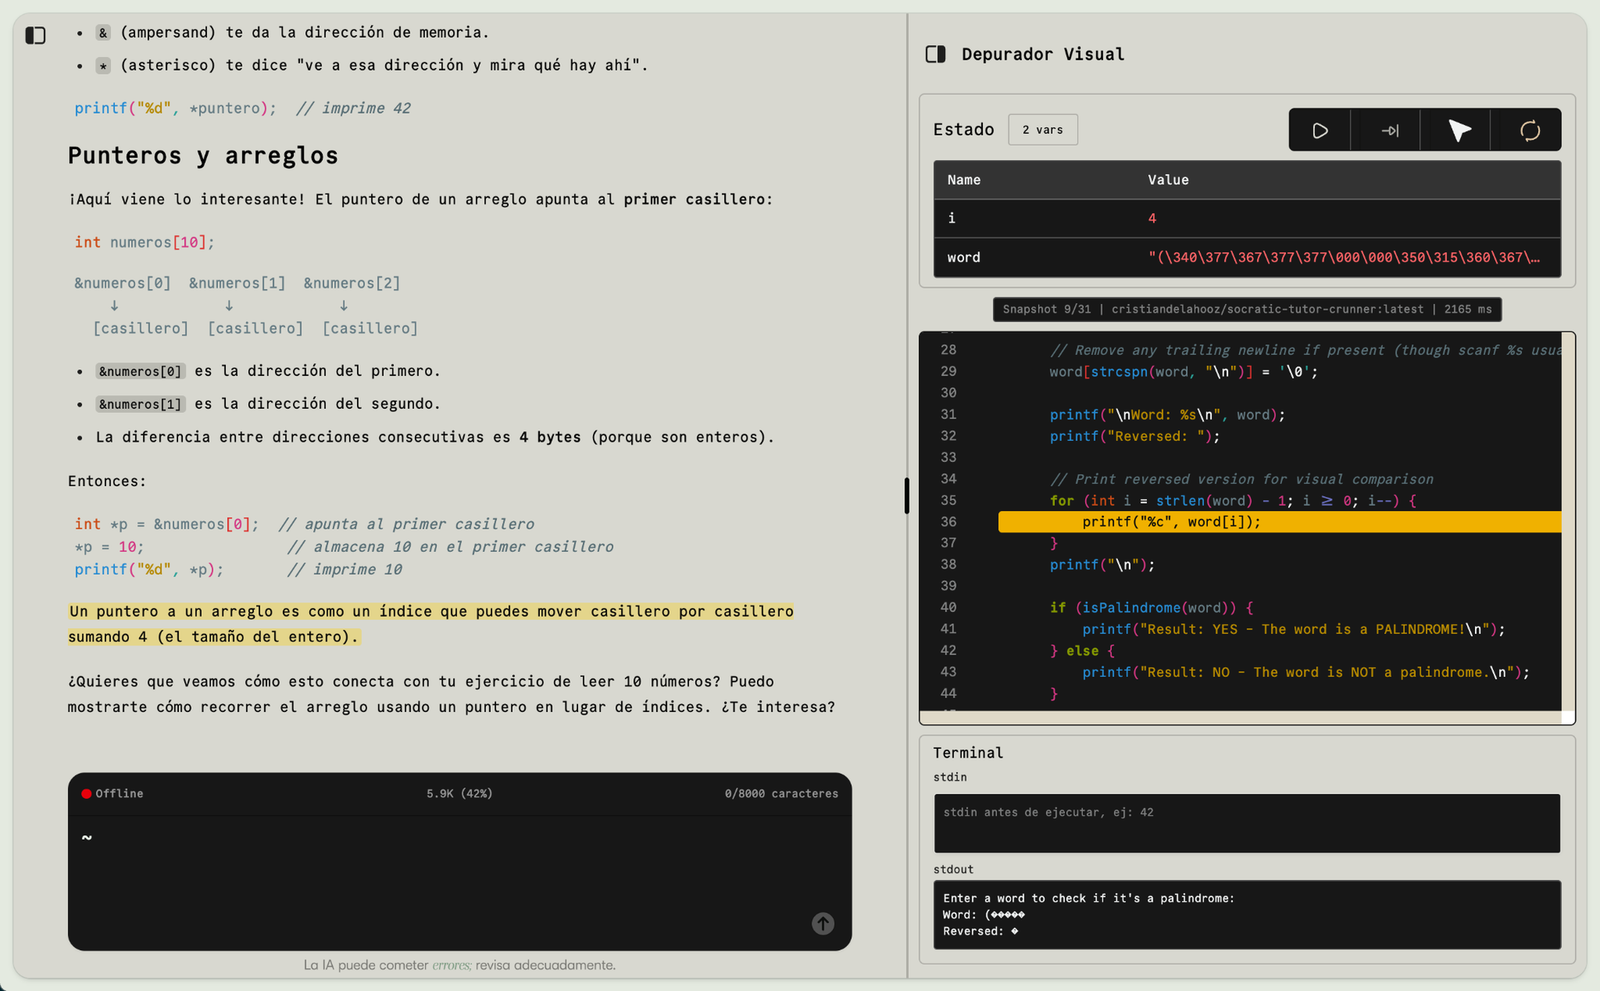
El depurador visual constituye una herramienta propia de la plataforma y se abre manualmente desde un bloque de código; el modelo no la activa dentro de la cadena de herramientas. El servidor crea un espacio temporal y ejecuta GCC o GDB en un contenedor con límites de tiempo, memoria, CPU, procesos y salida. La comunicación con GDB utiliza su interfaz de máquina, y el analizador convierte la traza real en una secuencia de instantáneas con la línea activa, las variables, la salida estándar y las líneas ejecutables. En la interfaz, el estudiante puede iniciar, avanzar una instrucción, desplazarse hasta una línea ejecutable y reiniciar el recorrido. El editor muestra el código y los diagnósticos de compilación; la tabla de variables presenta valores simples, arreglos, matrices y direcciones cuando GDB las expone; y la terminal reúne entrada y salida. Esta representación permite relacionar una instrucción de C con el cambio de estado que produce. La Figura 6 documenta la vista integrada del depurador, con los controles, las variables, la línea resaltada, el código fuente y la terminal dentro del espacio de trabajo del tutor.
El ajuste supervisado se desarrolló como un experimento complementario de especialización conversacional. Cinco conversaciones docentes sobre ciclos, funciones, arreglos, matrices y cadenas sirvieron para extraer patrones de intervención: localizar la dificultad, formular una pregunta contestable, ofrecer una pista limitada, formalizar después del intento y comprobar la continuidad del razonamiento. Esos patrones se expandieron en diálogos sintéticos multivuelta sometidos a curación manual, con prioridad en la calidad y diversidad de las demostraciones [24], [25]. El entrenamiento utilizó Qwen3-8B cuantizado a cuatro bits y QLoRA, técnica que mantiene congelado el modelo base y actualiza adaptadores de bajo rango para reducir el uso de memoria [26]. La comparación cualitativa examinó cadenas, una operación de cajero y el recorrido de matrices. Después, el artefacto se probó dentro del harness, donde debía coordinar memoria, contexto recuperado y herramientas. Para la plataforma integrada se seleccionó Ornith 9B por la continuidad observada en esas pruebas, mientras el ajuste de Qwen3 se conservó como evidencia experimental del cambio en el patrón de respuesta.
Resultados
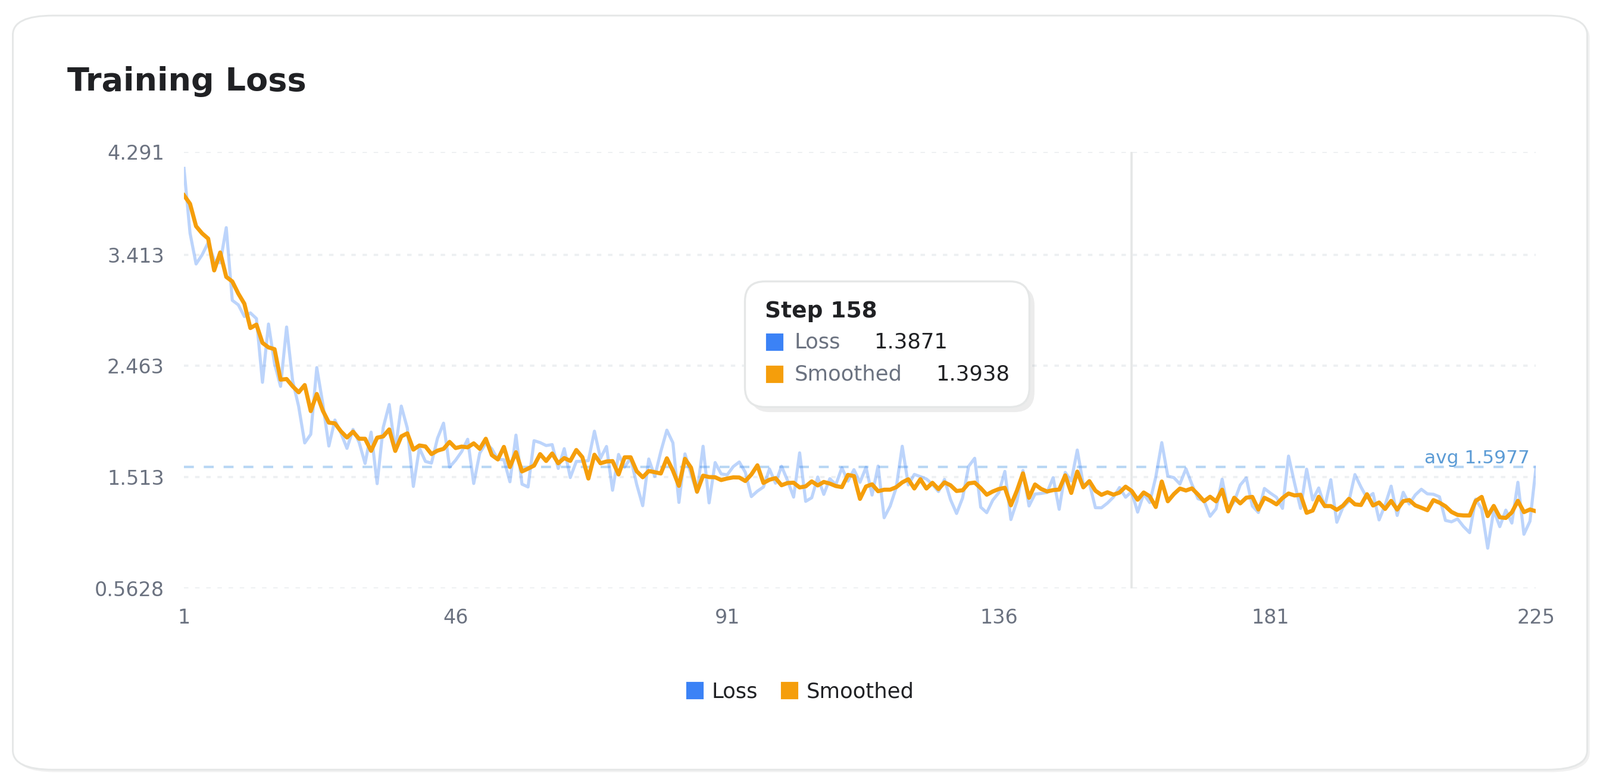
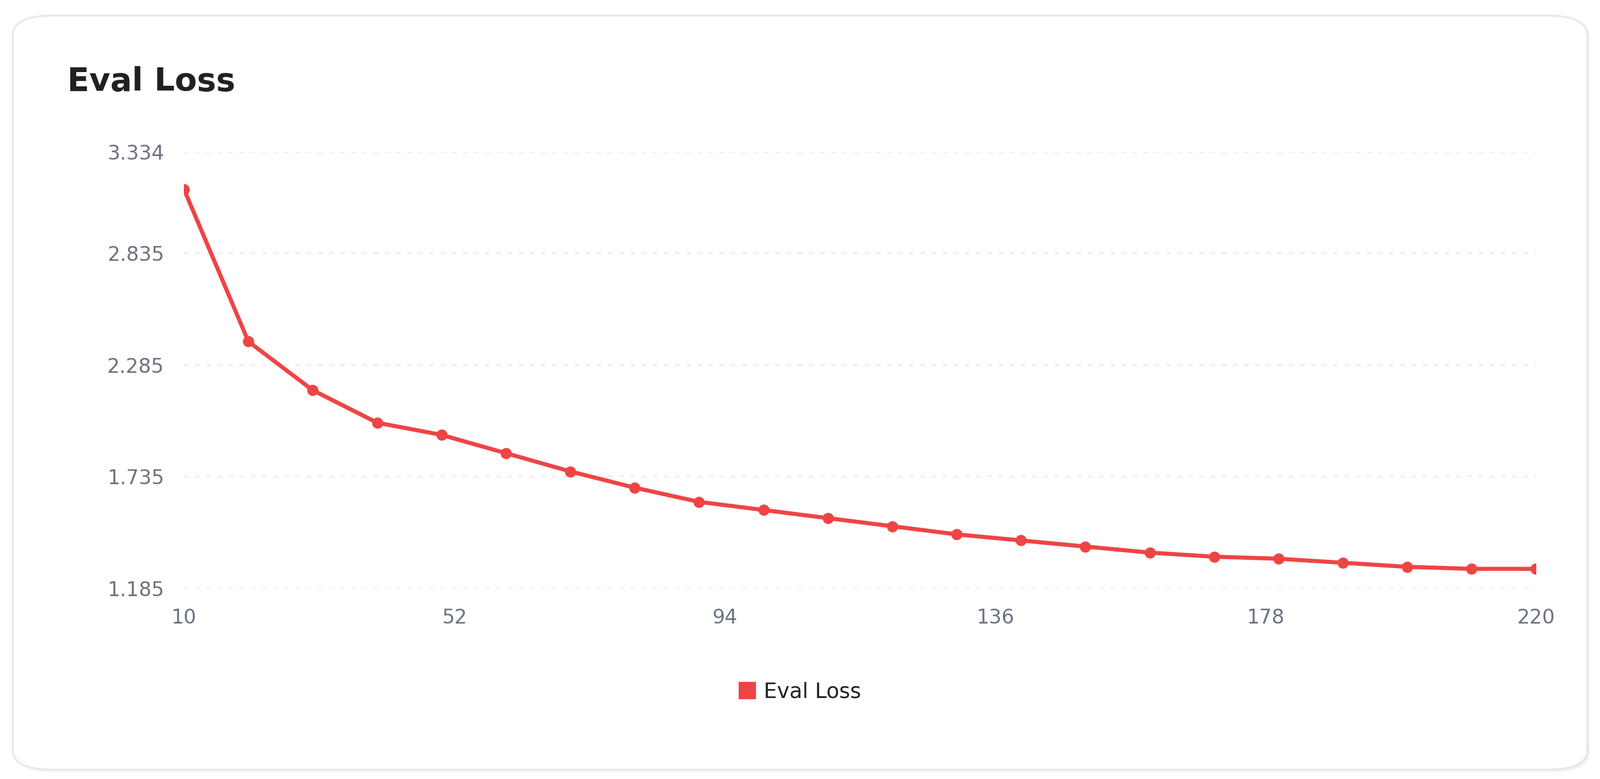
Las métricas de la corrida documentada muestran que los adaptadores se aproximaron al patrón conversacional utilizado en el ajuste. La pérdida de entrenamiento descendió con rapidez al inicio y continuó bajando de manera gradual durante las épocas registradas. La pérdida de evaluación, calculada sobre conversaciones retenidas, pasó aproximadamente de 3.1 a 1.3 y mantuvo una tendencia descendente hasta el último punto visible. La norma del gradiente permaneció en un rango finito mientras la tasa de aprendizaje siguió el calentamiento y el decaimiento configurados. Leídas en conjunto, estas señales documentan una optimización estable del objetivo supervisado: respuestas en español para programación introductoria en C, con diagnóstico, ayuda parcial y continuidad entre turnos. Las Figuras 7 y 8 reproducen las capturas originales utilizadas en el capítulo de resultados del proyecto. La primera muestra la pérdida de entrenamiento y su tendencia suavizada; la segunda presenta la pérdida de evaluación obtenida periódicamente durante la misma ejecución. El análisis conductual posterior permitió observar cómo ese cambio estadístico se manifestaba en las conversaciones comparadas.
En los tres escenarios ilustrativos, el cambio de comportamiento buscado apareció de forma reconocible. Qwen3 base comenzaba con implementaciones extensas o asumía decisiones del ejercicio; el modelo ajustado iniciaba con preguntas de diagnóstico, dividía el problema y ofrecía fragmentos de ayuda. En cadenas distinguió la dificultad antes de presentar código; en el escenario de cajero separó las operaciones y los datos necesarios; y en matrices pidió identificar el recorrido, el valor conservado y la condición de parada. Al incorporar el checkpoint al harness, el equipo observó respuestas breves o repetitivas en intercambios multivuelta y menor estabilidad al coordinar herramientas. Ornith 9B mantuvo mayor continuidad dentro del flujo completo, que combina instrucciones, historial, evidencia recuperada y resultados de herramientas, y por ello se eligió como modelo tutorial operativo. El resultado de ingeniería quedó así dividido en dos artefactos con funciones documentadas: Qwen3 ajustado como experimento de cambio conductual y Ornith como modelo servido durante la evaluación de la plataforma integrada.
La evaluación final examinó la versión integrada de la plataforma con Ornith, la conversación guiada, el depurador y los flujos académicos implementados. El instrumento estudiantil se organizó alrededor de dos escenarios de uso, arreglos unidimensionales y matrices, junto con un bloque de percepción general. Sus ítems recogieron claridad, apoyo para comprender la lógica, utilidad de las explicaciones y experiencia con las herramientas. El instrumento docente revisó por separado el tutor conversacional, el depurador paso a paso, las actividades formativas y el reporte disponible para el profesor; también incluyó observaciones abiertas, banderas críticas y un dictamen global. El análisis mantuvo separadas ambas poblaciones porque cada instrumento responde a una pregunta diferente: la experiencia de uso en los escenarios estudiantiles y la alineación técnica y pedagógica observada por docentes. Para cada bloque se calcularon media, mediana y proporción de valoraciones situadas en los niveles 4 y 5. Esta estructura permite leer los agregados junto con los comentarios asociados a componentes concretos del sistema.
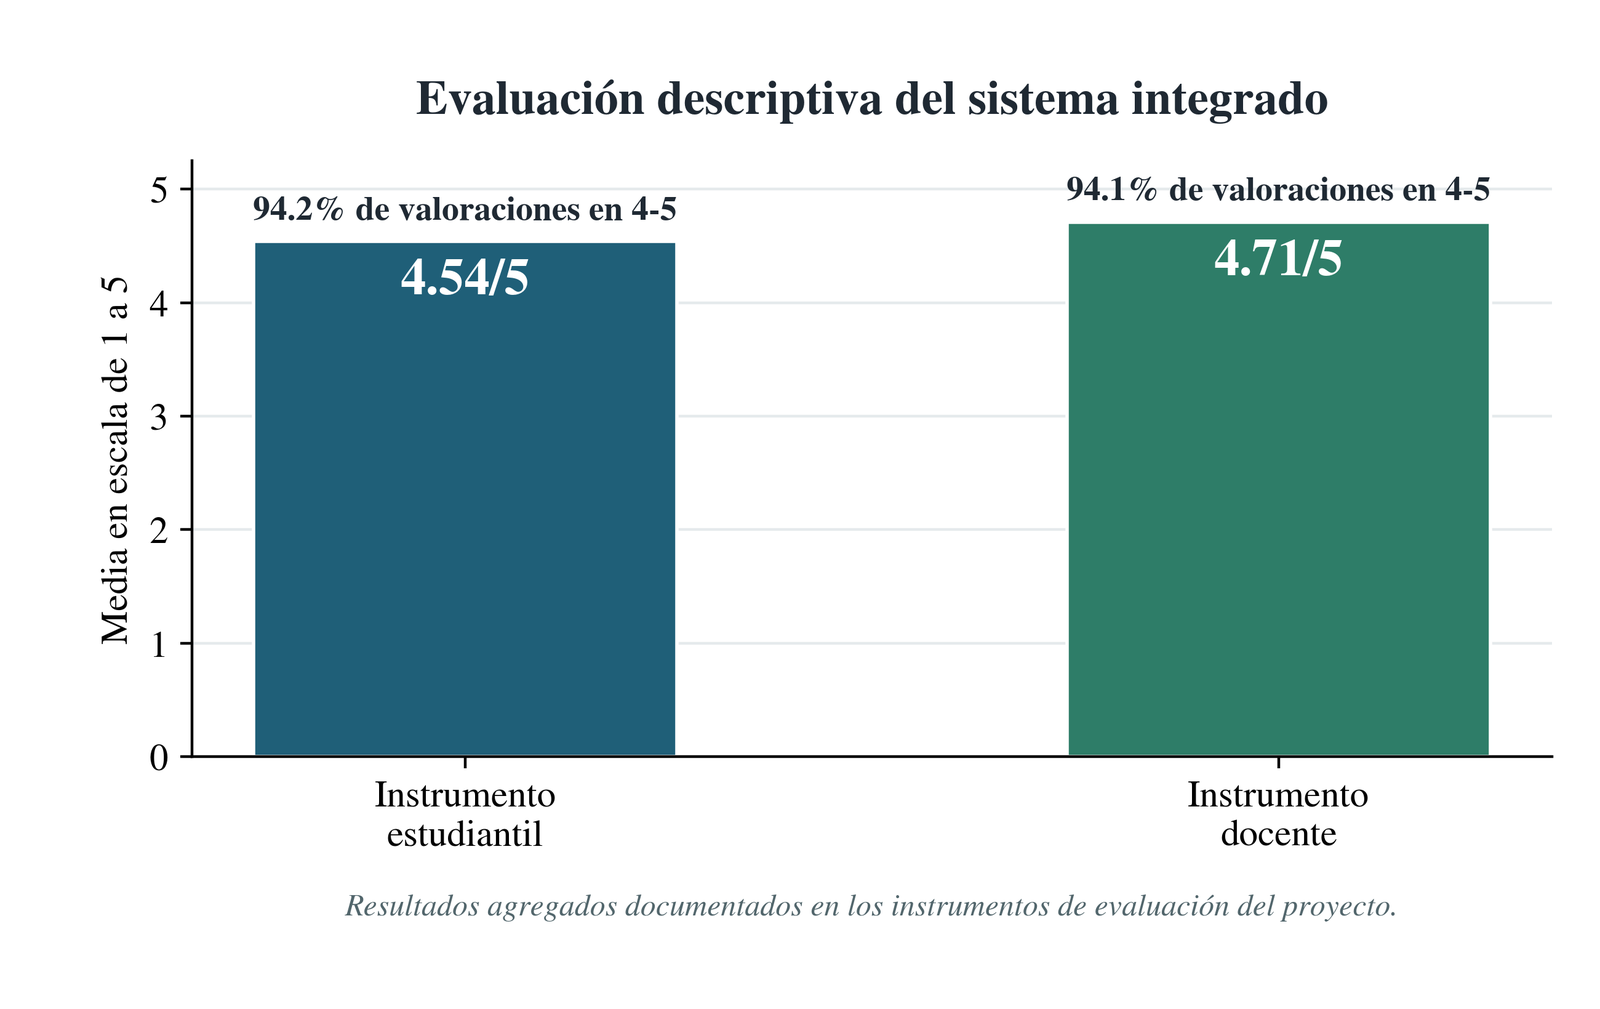
El instrumento estudiantil alcanzó una media global de 4.54 sobre 5, una mediana de 5 y un 94.2 % de valoraciones en los niveles 4 y 5. El escenario de arreglos unidimensionales obtuvo una media de 4.60; el escenario de matrices, 4.45; y el bloque de percepción general, 4.58. Los valores muestran una concentración favorable en los tres bloques y, al mismo tiempo, permiten localizar interacciones con menor claridad percibida. Las puntuaciones más bajas aparecieron en el apoyo sobre contadores y acumuladores, en el diagnóstico inicial del escenario de matrices y en una tarea de copia entre matrices. Las respuestas abiertas destacaron los ejemplos y la posibilidad de recibir explicaciones desde los fundamentos. También señalaron que el depurador era fácil de comprender y ayudaba a seguir el comportamiento del programa. Un comentario indicó que todavía no se dominaba el uso de punteros, lo que aporta contexto para interpretar esa parte de la experiencia sin convertir el promedio global en una descripción uniforme de cada concepto trabajado.
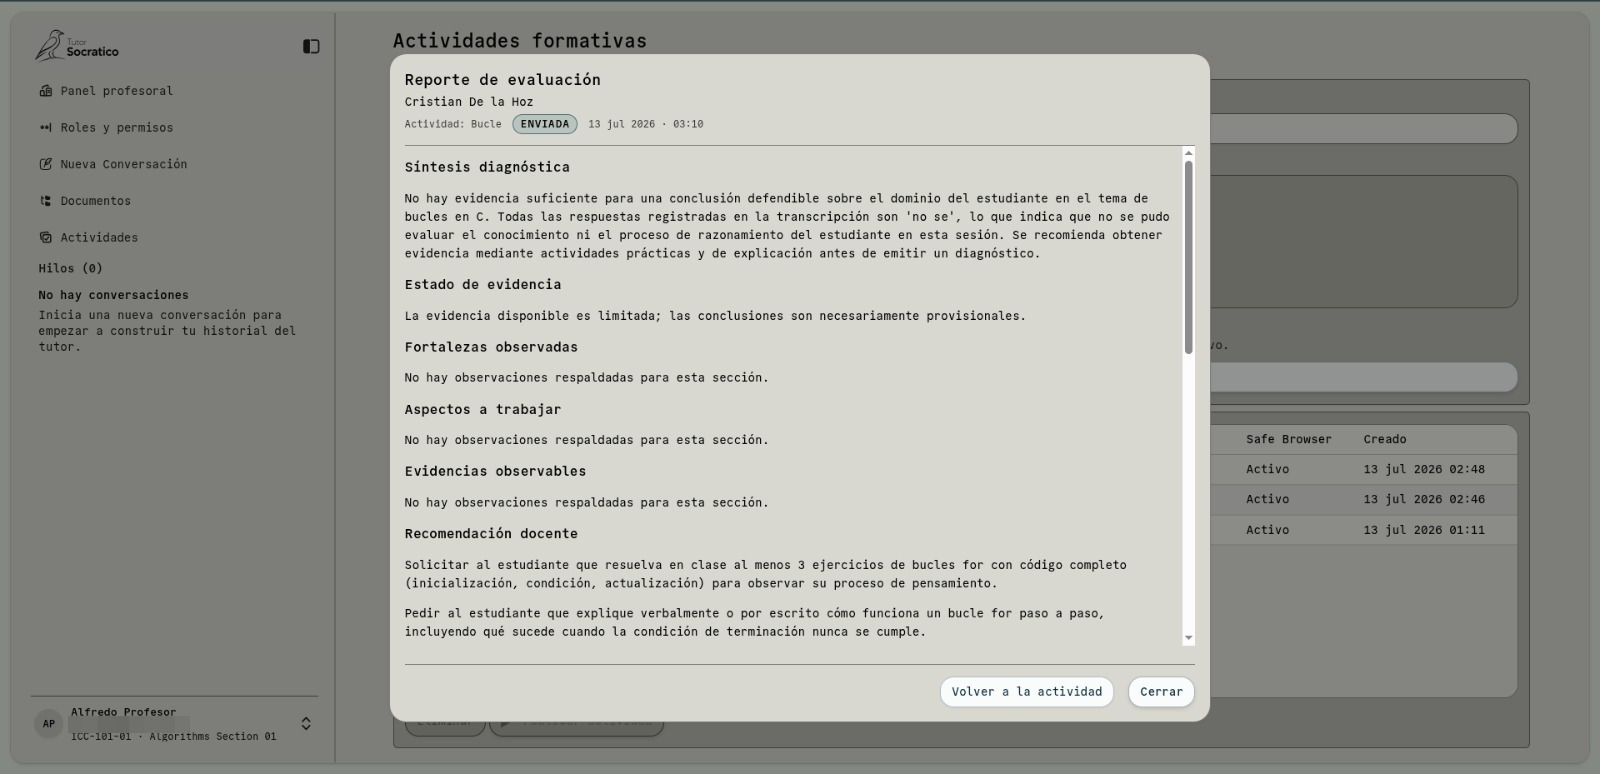
La síntesis docente documentó una media global de 4.71 sobre 5, mediana de 5 y 94.1 % de valoraciones en los niveles 4 y 5. El tutor conversacional obtuvo una media de 4.60 y el reporte al profesor, 4.50. El depurador paso a paso alcanzó 5.00 y concentró todas sus valoraciones válidas en el nivel máximo, el respaldo más uniforme entre los componentes examinados. Los comentarios docentes destacaron la ejecución por líneas, la visualización de variables y memoria y la posibilidad de seguir el flujo del programa. Ese resultado coincide con las menciones estudiantiles y respalda la decisión de integrar la depuración al espacio del tutor. Los dictámenes globales registrados utilizaron la categoría “Alineación suficiente para validación controlada”. La Figura 9 muestra el reporte revisable disponible para el profesor después de una actividad formativa. La Figura 10 conserva el diseño comparativo de la síntesis final y presenta únicamente los agregados globales documentados para estudiantes y docentes; los porcentajes corresponden a valoraciones de ítems ubicadas en los niveles superiores de sus respectivas escalas.
Los comentarios abiertos precisaron las prioridades de la siguiente iteración. En la experiencia estudiantil aparecieron solicitudes de mayor rapidez, una observación sobre la rigidez del tutor al aplicar sus restricciones y la preferencia por una apariencia clara o modo blanco. En la revisión docente se propuso incorporar un resumen de temas y un control para solicitar una explicación adicional. También se activó una alerta de posible error conceptual, conservada como caso para revisión. Estas observaciones se relacionan con componentes distintos y, por tanto, conducen a acciones de ingeniería separables: medir el tiempo hasta el primer fragmento y la duración total de la respuesta; calibrar la guardia con mensajes que dependan del turno anterior; ampliar las opciones de visualización; mantener el vínculo entre el informe y la transcripción; y facilitar la revisión de respuestas específicas. La estructura modular permite atender cada punto sin trasladar permisos, memoria o decisiones académicas al modelo de lenguaje.
La lectura conjunta de la evidencia sitúa el aporte principal en el sistema integrado. La conversación organiza preguntas, pistas y explicaciones; la guardia aplica la política antes de la memoria; la compactación conserva una transcripción real y prepara otra proyección para inferencia; el grounding entrega fragmentos revisados dentro de la clase autorizada; las actividades mantienen consignas, respuestas e informes vinculados; y el depurador convierte una ejecución real en instantáneas observables. El ajuste de Qwen3 documenta un cambio complementario en la forma de responder, mientras Ornith sostiene la operación evaluada dentro del harness. Los resultados globales y los dictámenes docentes respaldan la viabilidad funcional y la pertinencia académica de esta combinación para una validación controlada. Dentro de esa síntesis, el depurador sobresale por la uniformidad de su valoración y las actividades muestran cómo la inteligencia artificial puede incorporarse a un flujo preparado y revisado por el profesor, en lugar de quedar limitada a intercambios privados sin una evidencia organizada.
Conclusión
El proyecto alcanzó su objetivo de implementar un sistema de tutoría inteligente que orienta el razonamiento algorítmico mediante diálogo guiado y limita la generación de código como respuesta ordinaria. La solución final no depende exclusivamente de una instrucción socrática. Integra identidad académica, autorización contextual, guardia, memoria basada en eventos, compactación, recuperación documental, actividades formativas, informes y depuración visual de C dentro de un flujo coherente. Esta integración materializa el aporte técnico central: una arquitectura replicable cuyas responsabilidades permanecen separadas del modelo de lenguaje. Los servicios determinan el acceso y preparan el contexto; el modelo interpreta ese contexto y genera la intervención; las herramientas ejecutan operaciones delimitadas; y la persistencia conserva la evidencia asociada con la clase y la persona autorizada. La organización permite sustituir el artefacto de inferencia o adaptar el dominio académico sin reconstruir los límites de autorización, memoria y trazabilidad que sostienen la plataforma.
La memoria y las actividades muestran cómo esa arquitectura se traduce en operación académica. La primera conserva la transcripción real y construye una memoria sintética para el modelo, de modo que la continuidad conversacional no sustituya la evidencia literal del intercambio. Las actividades permiten al profesor redactar y revisar consignas, publicarlas, observar preguntas adaptativas y consultar un informe enlazado con la transcripción canónica. El depurador completa el acompañamiento con una representación ejecutable de líneas, variables, arreglos, matrices, memoria y salida del programa. Fue el componente con el respaldo más uniforme en el instrumento docente, con una media de 5.00, y también apareció en los comentarios estudiantiles como una herramienta fácil de comprender. En conjunto, la evaluación registró una media estudiantil de 4.54 sobre 5 y una media docente de 4.71, con medianas de 5 y una concentración de valoraciones en los niveles superiores de ambas escalas.
El ajuste de Qwen3 aportó un resultado complementario: en los escenarios examinados, el modelo pasó de iniciar con implementaciones extensas a diagnosticar, dividir el problema y ofrecer ayudas parciales. La selección posterior de Ornith reforzó una exigencia de la arquitectura: el modelo operativo debe sostener esa orientación mientras trabaja con memoria, materiales recuperados y herramientas. La evidencia reunida respalda el funcionamiento, la utilidad percibida y la alineación pedagógica del Tutor Socrático en una aplicación controlada. Las siguientes iteraciones tienen una ruta concreta: conservar el depurador como capacidad central, medir y reducir la latencia percibida, calibrar la guardia con mensajes dependientes del contexto, reforzar la revisión de respuestas y ampliar los informes de actividades sin perder su vínculo con la transcripción. Con estas prioridades, el proyecto establece una base técnica y académica para continuar validando una tutoría en la que la inteligencia artificial participa dentro de límites institucionales verificables y el razonamiento del estudiante permanece como objeto principal del acompañamiento.
Referencias
- J. M. Wing, “Computational thinking,” Communications of the ACM, vol. 49, no. 3, pp. 33-35, 2006, doi: 10.1145/1118178.1118215.
- J. Insuasti Portilla, “Problemas de enseñanza y aprendizaje de los fundamentos de programación,” Educación y Desarrollo Social, vol. 10, no. 2, pp. 234-246, 2016, doi: 10.18359/reds.1701.
- L. Beato-Castro, C. Hevia, L. Lehoux y L. A. Fermín-Genao, “Formación inicial y permanente de los docentes en pensamiento computacional: percepciones y preconcepciones en el contexto dominicano,” Cuaderno de Pedagogía Universitaria, vol. 20, no. 39, pp. 158-176, 2023, doi: 10.29197/cpu.v20i39.494.
- M. B. Garcia, “Teaching and learning computer programming using ChatGPT: A rapid review of literature amid the rise of generative AI technologies,” Education and Information Technologies, vol. 30, no. 12, pp. 16721-16745, 2025, doi: 10.1007/s10639-025-13452-5.
- J. Nathaniel, S. S. Oyelere, J. Suhonen y M. Tedre, “Literature review on the integration of generative AI in programming education,” International Journal of Artificial Intelligence in Education, vol. 35, no. 5, pp. 2724-2755, 2025, doi: 10.1007/s40593-025-00524-3.
- M. Abbas, F. A. Jam y T. I. Khan, “Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students,” International Journal of Educational Technology in Higher Education, vol. 21, art. 10, 2024, doi: 10.1186/s41239-024-00444-7.
- G. Fan, D. Liu, R. Zhang y L. Pan, “The impact of AI-assisted pair programming on student motivation, programming anxiety, collaborative learning, and programming performance,” International Journal of STEM Education, vol. 12, art. 16, 2025, doi: 10.1186/s40594-025-00537-3.
- Z. Ji et al., “Survey of hallucination in natural language generation,” ACM Computing Surveys, vol. 55, no. 12, 2023, doi: 10.1145/3571730.
- J. Yang y D.-M. Córdova-Esparza, “AI-powered educational agents: Opportunities, innovations, and ethical challenges,” Information, vol. 16, no. 6, art. 469, 2025, doi: 10.3390/info16060469.
- E. F. Risko y S. J. Gilbert, “Cognitive offloading,” Trends in Cognitive Sciences, vol. 20, no. 9, pp. 676-688, 2016, doi: 10.1016/j.tics.2016.07.002.
- M. O. Kelly y E. F. Risko, “Study effort and the memory cost of external store availability,” Cognition, vol. 228, art. 105228, 2022, doi: 10.1016/j.cognition.2022.105228.
- X. Lu, M. O. Kelly y E. F. Risko, “Offloading information to an external store increases false recall,” Cognition, vol. 205, art. 104428, 2020, doi: 10.1016/j.cognition.2020.104428.
- B. Jose, D. Joseph, V. Mohan, E. Alexander, S. K. Varghese y A. Roy, “Outsourcing cognition: The psychological costs of AI-era convenience,” Frontiers in Psychology, vol. 16, art. 1645237, 2025, doi: 10.3389/fpsyg.2025.1645237.
- G. Akçapınar y E. Sidan, “AI chatbots in programming education: Guiding success or encouraging plagiarism,” Discover Artificial Intelligence, vol. 4, art. 87, 2024, doi: 10.1007/s44163-024-00203-7.
- H. Bastani, O. Bastani, A. Sungu, H. Ge, Ö. Kabakcı y R. Mariman, “Generative AI without guardrails can harm learning: Evidence from high school mathematics,” Proceedings of the National Academy of Sciences, vol. 122, no. 26, 2025, doi: 10.1073/pnas.2422633122.
- M. Liffiton, B. Sheese, J. Savelka y P. Denny, “CodeHelp: Using large language models with guardrails for scalable support in programming classes,” in Proc. 23rd Koli Calling International Conf. Computing Education Research, art. 8, 2023, doi: 10.1145/3631802.3631830.
- R. Schmucker, M. Xia, A. Azaria y T. Mitchell, “Ruffle & Riley: Insights from designing and evaluating a large language model-based conversational tutoring system,” in Artificial Intelligence in Education, LNCS 14829, pp. 75-90, 2024, doi: 10.1007/978-3-031-64302-6_6.
- T. Noraset, A. Supratak, C. Ragkhitwetsagul, N. Worathong y S. Tuarob, “Evaluating lab assistant chatbot on student learning and behaviors in a programming short course,” Computers and Education: Artificial Intelligence, vol. 10, art. 100527, 2026, doi: 10.1016/j.caeai.2025.100527.
- L. Xi, Y. Zhang y Q. Wang, “Investigating the effects of an LLM-based Socratic conversational agent on students’ academic performance and reflective thinking in higher education,” Computers & Education, vol. 241, art. 105494, 2026, doi: 10.1016/j.compedu.2025.105494.
- S. Barke, M. B. James y N. Polikarpova, “Grounded Copilot: How programmers interact with code-generating models,” Proceedings of the ACM on Programming Languages, vol. 7, no. OOPSLA1, 2023, doi: 10.1145/3586030.
- J. D. Karpicke y J. R. Blunt, “Retrieval practice produces more learning than elaborative studying with concept mapping,” Science, vol. 331, no. 6018, pp. 772-775, 2011, doi: 10.1126/science.1199327.
- H. Tomisu, J. Ueda y T. Yamanaka, “The cognitive mirror: A framework for AI-powered metacognition and self-regulated learning,” Frontiers in Education, vol. 10, art. 1697554, 2025, doi: 10.3389/feduc.2025.1697554.
- P. Lewis et al., “Retrieval-augmented generation for knowledge-intensive NLP tasks,” in Advances in Neural Information Processing Systems, vol. 33, pp. 9459-9474, 2020.
- C. Zhou et al., “LIMA: Less is more for alignment,” in Advances in Neural Information Processing Systems, vol. 36, 2023.
- L. Chen et al., “AlpaGasus: Training a better Alpaca with fewer data,” in Proc. International Conference on Learning Representations, 2024.
- T. Dettmers, A. Pagnoni, A. Holtzman y L. Zettlemoyer, “QLoRA: Efficient finetuning of quantized LLMs,” in Advances in Neural Information Processing Systems, vol. 36, pp. 10088-10115, 2023.