Wilfrido Guillermo Perdomo Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)
Introducción
El sonido en espacios cerrados raramente se conforma de manera uniforme. En espacios como auditorios, aulas universitarias y salas de conferencias, la distribución acústica puede ser afectada por múltiples factores como son: la arquitectura del espacio, como su geometría, los materiales utilizados en las superficies, el ruido en el ambiente generado por sistemas de ventilación y la ubicación de fuentes sonoras con respecto a los oyentes.
Este proyecto propone la creación de un sistema de ecualización acústica inteligente que opera de forma autónoma y en tiempo real capaz de ser ajustada al ambiente de uso. De esta forma creando un cambio de vista hacia la ecualización adaptiva, en donde los sensores monitorean el entorno constantemente y ajustan el audio de forma dinámica.
Problemática y estado del arte
En un espacio cerrado como salas de conferencias o aulas, al hacer uso de sistemas de climatización, se genera un ruido constante que mientras de vez en cuando no es detrimental a la experiencia auditiva, termina causando problemas al oyente ya que es un ruido constante que termina enmascarando otros sonidos en el mismo rango de frecuencias. También, al hacer uso de bocinas u otros sistemas reproductores, es posible que, en espacios alejados a la fuente, el sonido no se llegue a percibir correctamente debido a la cercanía o distancia del oyente a estas fuentes.
Es por esto que normalmente la solución a algunos de estos problemas es el aumento del volumen general del sistema de audio, lo que termina siendo contraproducente al generar mayor malestar físico y reverberación al oyente, no logrando así resolver el desbalance espectral que causa el ruido ambiental.
A través de las pruebas hechas a través del desarrollo se encontró que el ruido ambiental en ciertas aulas universitarias no es uniforme, sino que se concentra en la banda de frecuencias graves, con niveles que pueden alcanzar incluso a valores como 123 dB, donde si se sigue las soluciones tradicionales de simplemente subir el volumen, las frecuencias se saturan y no se resuelve el problema principal de la saturación de la banda de frecuencias grave, creando así una experiencia sonora físicamente molesta.
Aunque actualmente existan diversos métodos para mitigar los problemas acústicos que se generan ocasionalmente, la mayoría de estas soluciones se encuentran detrás de barreras como lo que es la accesibilidad, la necesidad de un experto en el tema, o el conocimiento previo de cómo funciona el audio en su totalidad.
Muchos acercamientos utilizan el procesamiento en la nube para el control de los sistemas, pero se enfrentan a los problemas como la latencia y la saturación de red, que son aspectos que no pueden ser ignorados por lo delicado que es la transmisión de audio, en donde incluso un detenimiento de un fragmento de segundo puede ser detectado y alertado por el oído humano.
Para la realización de un sistema que cumpla con todos los requerimientos que se tienen, es necesario usar la Transformada Rápida de Fourier (FFT) que permite la caracterización de señales acústicas en tiempo real utilizando la escala logarítmica. Reduciendo la complejidad computacional del análisis espectral y haciendo posible el procesamiento en tiempo real del sonido de un espacio.
Además de esto, al hacer uso de la ecualización adaptiva podemos responder a cambios en el entorno acústico, haciendo cambios a los coeficientes de ecualización y eficientizando el uso de los recursos disponibles. Haciendo uso de filtros IIR se permite implementar ecualizadores paramétricos, dando la posibilidad de modificar los coeficientes de la banda de frecuencias mientras se ejecuta.
Para superar estas limitaciones de latencia y congestión de red, este proyecto adopta un enfoque en donde se ejecuta la Transformada Rápida de Fourier (FFT) de forma local en nodos sensores, evitando así que el sistema transmita flujos de audio pesados y, en su lugar, envía únicamente metadatos espectrales procesados a un servidor central. Esta arquitectura no solo garantiza la privacidad de los usuarios al no retransmitir audio crudo, sino que permite una capacidad de respuesta inmediata ante variaciones acústicas, logrando un sistema de ecualización verdaderamente adaptativo y eficiente en el uso de recursos de red.
Objetivos completados
El desarrollo de este proyecto ha logrado implementar un sistema de ecualización acústica inteligente mediante el uso de procesamiento digital de señales para resolver la degradación de la inteligibilidad en ambientes cerrados. El sistema integra nodos de captura basados en ESP32 que ejecutan localmente la Transformada Rápida de Fourier (FFT), permitiendo la extracción y envío de metadatos espectrales precisos hacia un servidor central de manera eficiente. Asimismo, se desarrolló e implementó un algoritmo de control proporcional capaz de ajustar hasta 10 bandas de frecuencia de forma independiente, garantizando una alta velocidad de estabilización acústica. Finalmente, mediante la integración de GStreamer, el sistema provee una salida de audio continua con 0 ms de interrupción durante los cambios dinámicos de coeficientes, asegurando una experiencia de uso fluida y profesional frente a condiciones de ruido ambiental variable.
Metodología
La metodología adoptada para este proyecto se fundamenta en un diseño de hardware y software distribuido, enfocado en la eficiencia de cómputo y la respuesta en tiempo real. A diferencia de los acercamientos tradicionales que requieren una conexión física compleja, esta solución propone un ecosistema inalámbrico modular capaz de adaptarse a diferentes geometrías arquitectónicas sin necesidad de reconfiguraciones profundas en el código base.
Arquitectura de adquisición y procesamiento de datos
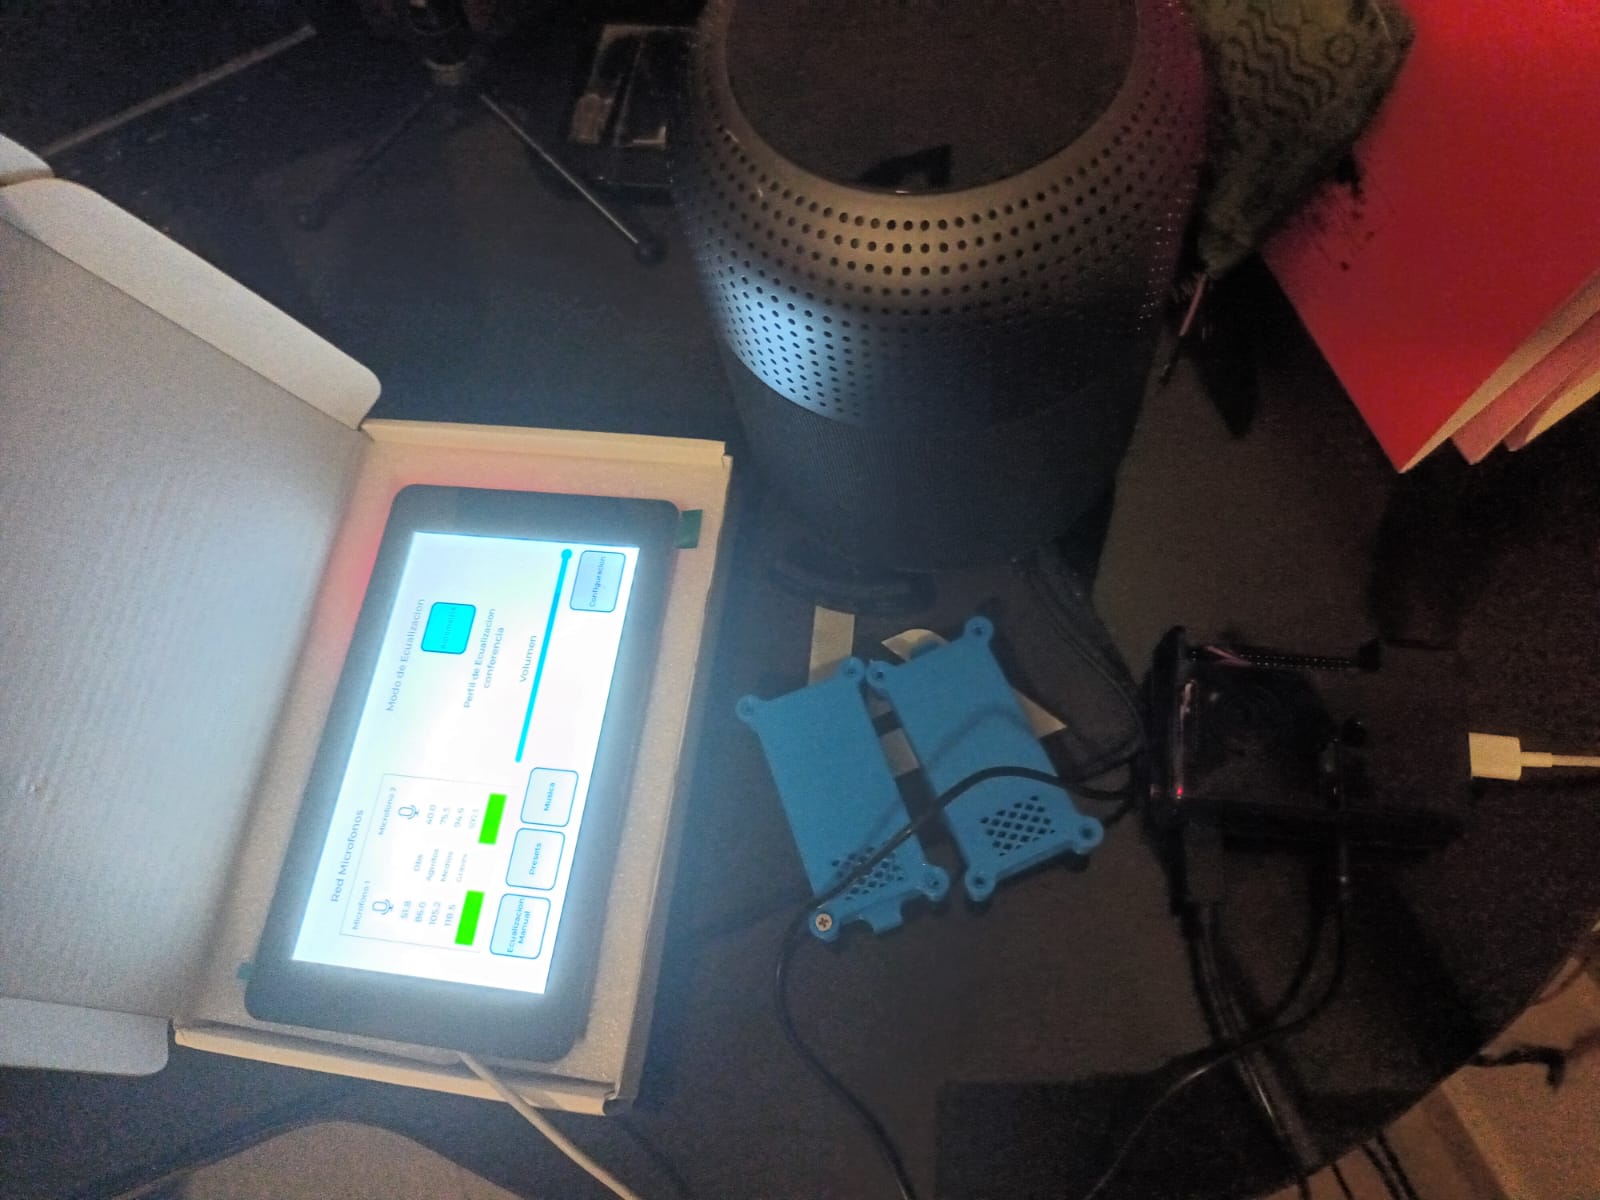
El primer pilar de la solución es la red de nodos sensores de bajo costo. Cada nodo está integrado por un microcontrolador ESP32 y un micrófono digital INMP441 con interfaz I2S. La elección de una interfaz digital es crítica, ya que permite mantener la integridad de la señal acústica desde la captura, evitando las interferencias electromagnéticas comunes en las señales analógicas. Lo novedoso de esta etapa reside en que el ESP32 no actúa como un simple transmisor, este ejecuta localmente una Transformada Rápida de Fourier (FFT) para descomponer el sonido ambiente en sus componentes espectrales.
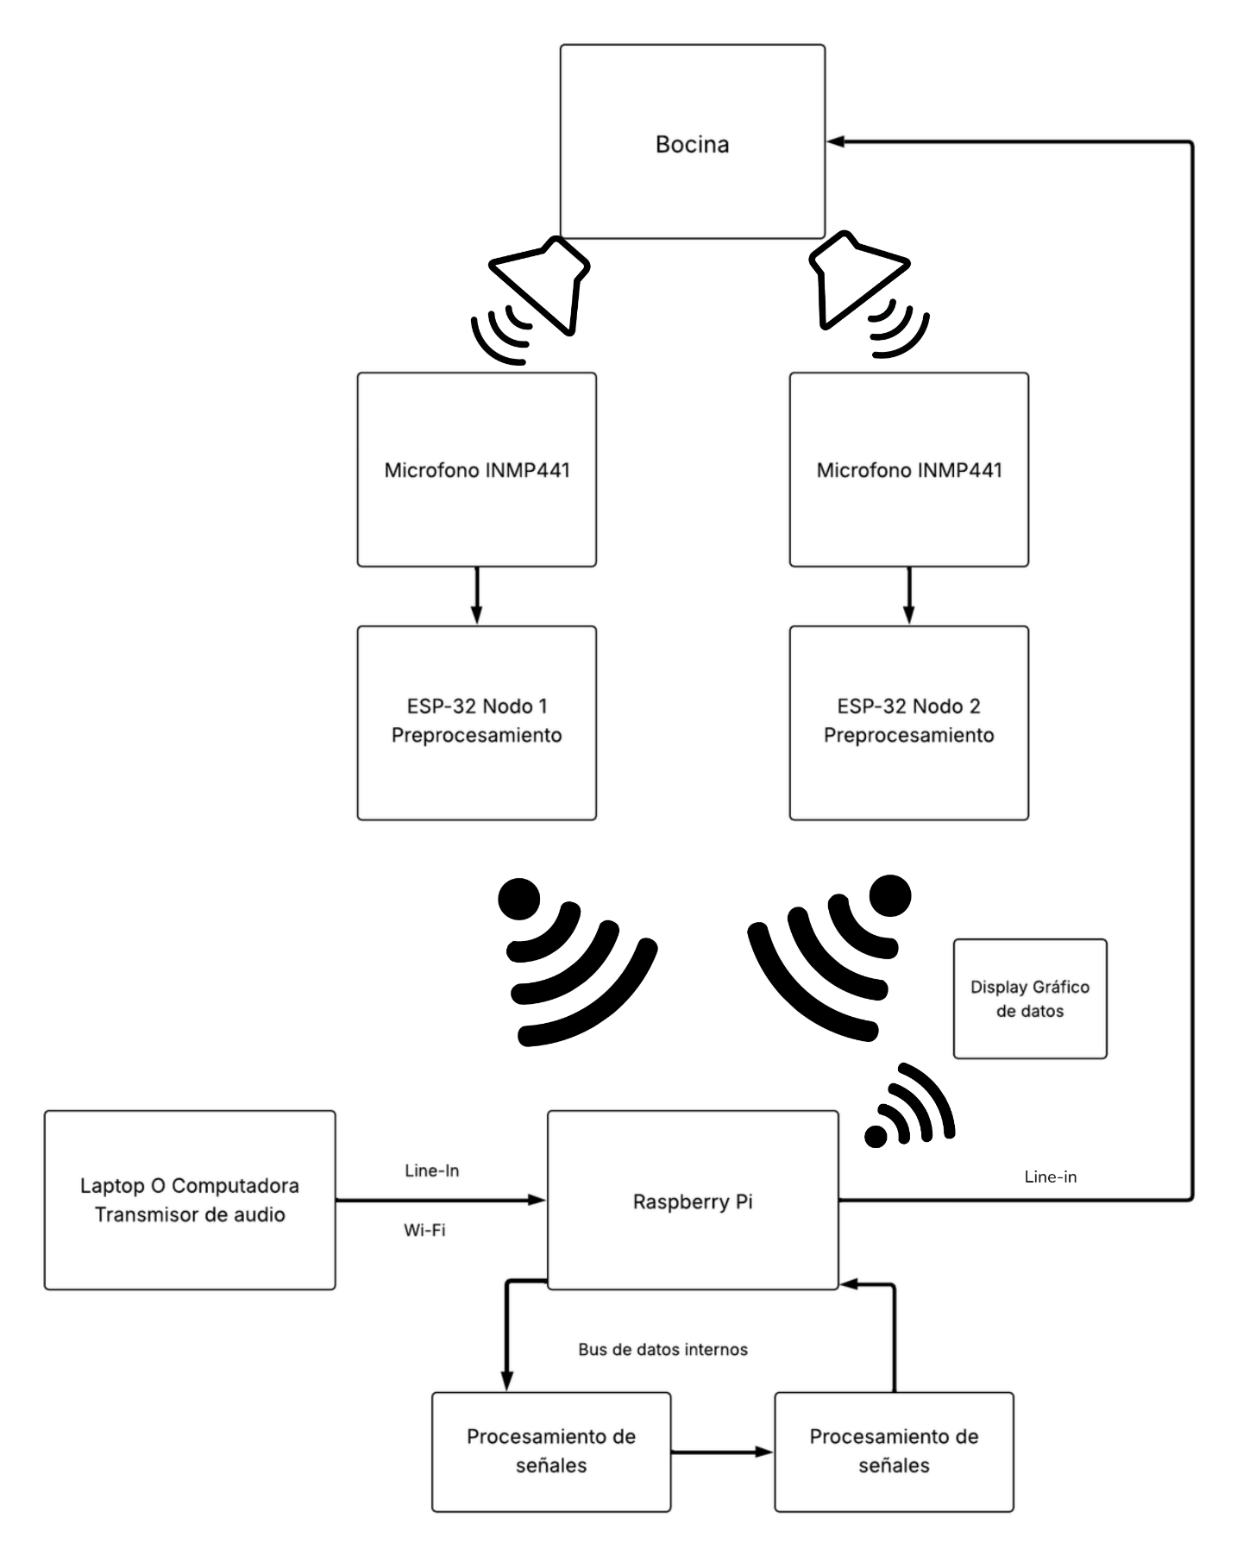
Al procesar la FFT, el sistema solo transmite vectores de datos que representan la energía de las frecuencias detectadas. Este enfoque reduce drásticamente el uso del ancho de banda y mitiga los problemas de congestión de red mencionados anteriormente. Además, al no transmitir el audio crudo, se garantiza una capa de privacidad intrínseca, ya que el servidor central nunca recibe ni almacena grabaciones de voz, sino únicamente metadatos matemáticos de la acústica del salón.
Servidor central y gestión de audio con GStreamer
La unidad de procesamiento central, basada en una Raspberry Pi 4, actúa como el integrador de la inteligencia del sistema. Aquí se recibe la información espectral de todos los nodos de la red AudioNet y se gestiona el flujo de audio mediante la librería GStreamer. Esta herramienta permite la creación de pipelines de procesamiento multihilo, donde se insertan filtros de respuesta al impulso infinito (IIR) para cada una de las 10 bandas de frecuencia configuradas.
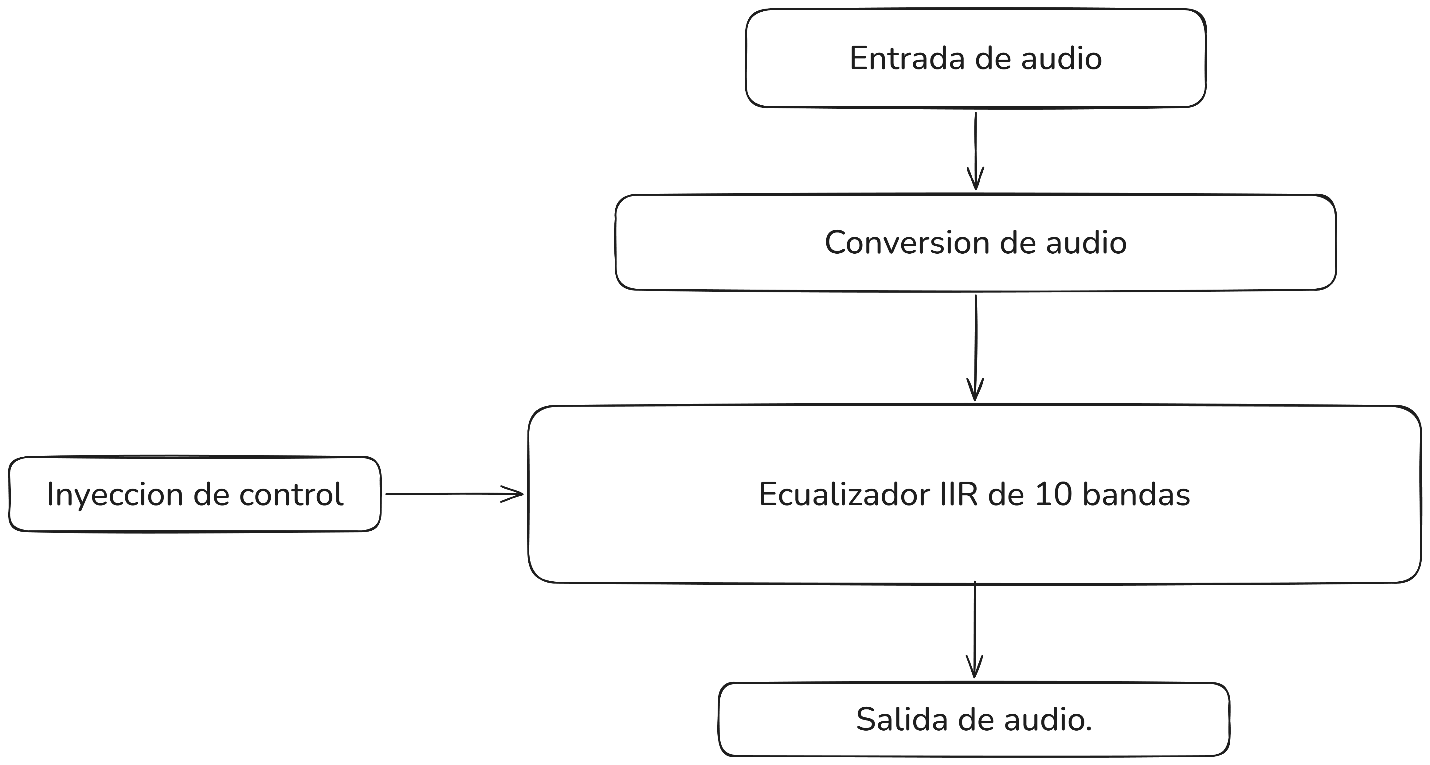
La ventaja de utilizar GStreamer frente a otras soluciones de software es su capacidad para manipular propiedades de los filtros mientras se reproduce audio. Mientras que otros sistemas presentan latencias audibles al actualizar el pipeline de uso, ya sea reiniciándolo al mismo tiempo, o creando otro sub-pipeline. El pipeline implementado permite modificar los coeficientes de ecualización de forma síncrona, logrando que el ajuste sea imperceptible para el oído humano, manteniendo una salida de audio constante y libre de artefactos sonoros.
Algoritmo de control y calibración dinámica
Para la toma de decisiones, se implementó un algoritmo de control proporcional que opera de manera cíclica. El proceso inicia con una fase de calibración dinámica donde el sistema mide el “piso de ruido” del ambiente durante 10 segundos. Una vez establecido este umbral, el algoritmo compara en tiempo real las variaciones energéticas reportadas por los nodos. Si se detecta un incremento sostenido en una banda específica, el sistema calcula automáticamente una ganancia negativa proporcional para compensar dicho ruido.
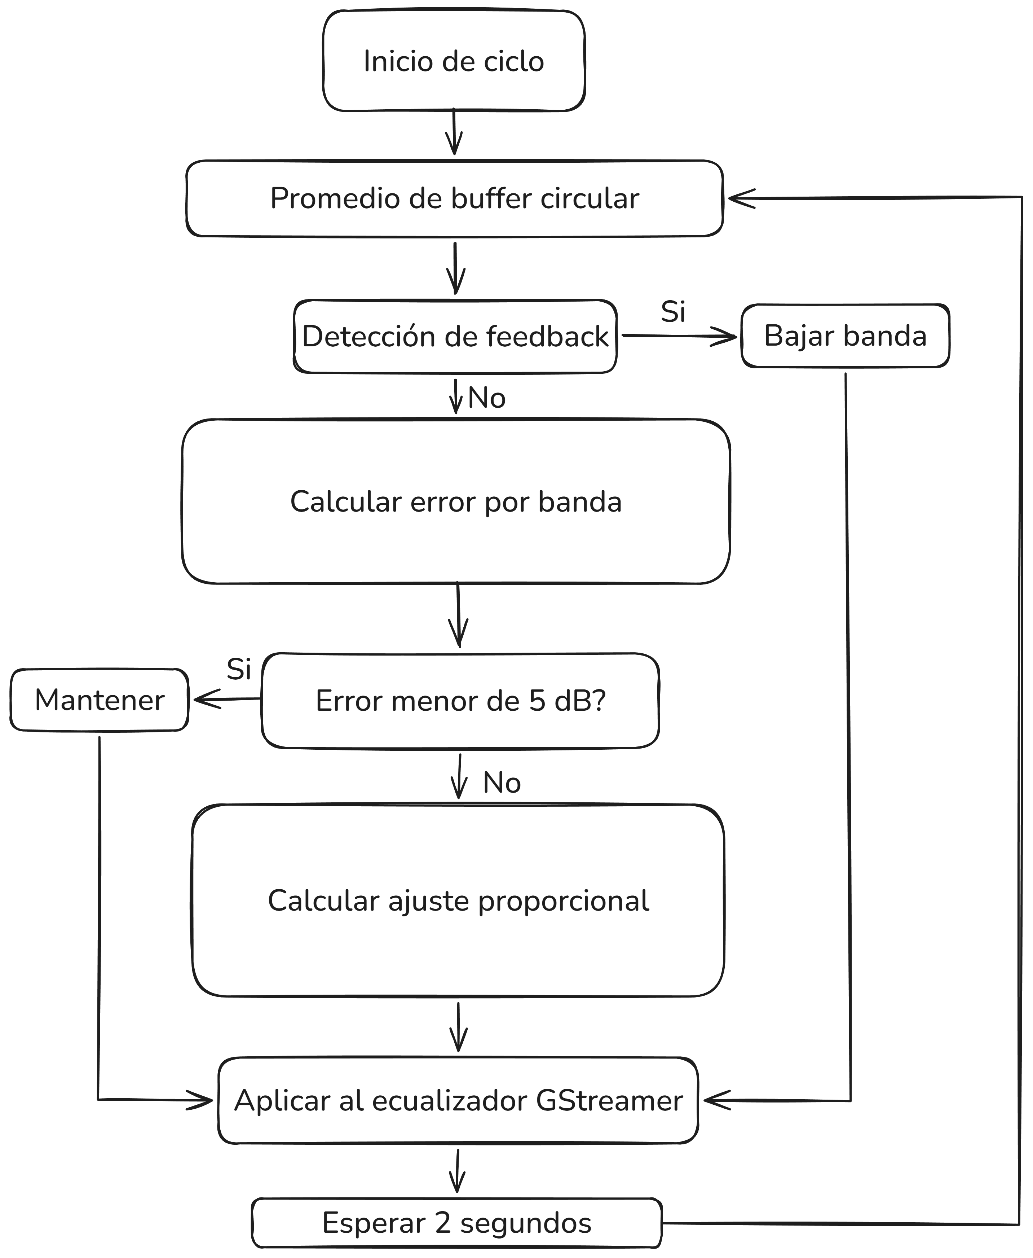
Para garantizar la estabilidad del sistema, se incorporó una “zona muerta”. Permitiendo evitar que el sistema reaccione de forma errática ante ruidos transitorios o picos de señal insignificantes, asegurando que la ecualización solo cambie ante variaciones reales y persistentes de la acústica del entorno. Este enfoque preventivo garantiza que el audio se mantenga estable y confortable para el usuario final.
Interfaz visual y modos de operación
Finalmente, el sistema se complementa con una interfaz táctil basada en el ESP32-S3-Touch-LCD-7. Esta permite al usuario observar de manera gráfica y en tiempo real el comportamiento del espectro en las diferentes zonas del recinto. La metodología de diseño de la interfaz se centró en la usabilidad, ofreciendo al usuario la posibilidad de elegir entre una operación totalmente autónoma o una modalidad de recomendación manual, donde el operador toma las decisiones de cómo manipular el sistema.
Resultados
Durante el desarrollo del proyecto, se ha podido observar el cumplimiento de ciertas facetas de los objetivos propuestos, validando así el funcionamiento del sistema, obteniendo resultados como los siguientes:
- Precisión en la detección espectral. El sistema logró identificar con éxito los niveles críticos de ruido en espacios reales de la universidad, registrando hasta picos de 123.3 dB en salones universitarios frente a picos de 107 dB en entornos residenciales, permitiendo una compensación precisa al enmascaramiento sonoro.
- Latencia de procesamiento. A través del proyecto se estaba haciendo uso de librerías específicas para la transmisión y el control del audio saliente, luego de una transición hacia GStreamer se ha logrado eliminar todos los cortes de audio existentes en el sistema, logrando así un procesamiento y cambio de bandas que se asemejan a sistemas profesionales.
- El algoritmo ha demostrado ser capaz de adaptarse rápidamente a las variaciones del ruido en el ambiente, consiguiendo alcanzar la convergencia y estabilidad en un promedio de 16 segundos.
Conclusiones
El desarrollo del proyecto confirma que la integración de hardware utilizando nodos de procesamiento y algoritmos de control proporcional eficaces permiten resolver problemas acústicos con una eficiencia comparable a sistemas profesionales. La investigación y las pruebas realizadas permiten extraer las siguientes conclusiones:
Continuidad y calidad de uso: la transición técnica a mejores tecnologías fue un aspecto clave para el éxito de todo el sistema, reduciendo la latencia de la conmutación de filtros y validando la posibilidad de realizar ajustes dinámicos de ecualización de forma no audible al oído humano.
Innovación en el procesamiento: la capacidad de ejecutar procesos complicados como lo es la Transformada Rápida de Fourier (FFT) en los nodos sensores de audio representa un avance para el procesamiento eficaz de datos en comparación de sistemas centralizados convencionales.
Visualización y control táctil: la interfaz desarrollada utilizando una pantalla touch con un ESP32 integrado permite que el usuario tenga acceso a diferentes opciones, no técnicas y técnicas. Como es la visualización del comportamiento espectral y poder elegir entre dos modos de ecualización, autónomo o asistido, permitiendo que el usuario pueda tomar decisiones operativas según su parecer.
Referencias
- Widrow, B., Glover, J. R., McCool, J. M., Kaunitz, J., Williams, C. S., Hearn, R. H., … & Goodlin, R. C. (1975). Adaptive noise cancelling: Principles and applications. Proceedings of the IEEE, 63(12), 1692-1716. https://ieeexplore.ieee.org/document/1451965
- Cecchi, S., Bruschi, V., Peretti, P., & Bettarelli, F. (2024). Real Time System for Sound Enhancement in Noisy Environment. 27th International Conference on Digital Audio Effects (DAFx24), Guildford, UK, pp. 381–387. https://www.dafx.de/paper-archive/2024/papers/DAFx24_paper_70.pdf
- Avargel, Y., & Cohen, I. (2007). On multiplicative transfer function approximation in the short-time Fourier transform domain. IEEE Signal Processing Letters, 14(5), 337-340. https://ieeexplore.ieee.org/document/4154719
- Abhayapala, T. D., & Ward, D. B. (2002). Theory and design of high order sound field microphones using spherical microphone array. IEEE International Conference on Acoustics, Speech, and Signal Processing, 2, 1949–1952. https://researchportalplus.anu.edu.au/en/publications/theory-and-design-of-high-order-sound-field-microphones-using-sph-2
- Espressif Systems. (2023). ESP32 Technical Reference Manual. https://www.espressif.com/sites/default/files/documentation/esp32_technical_reference_manual_en.pdf
- Sebastià V., & Malte Kob. (2016). Real-time auralization of room acoustics for the study of live music performance. https://www.researchgate.net/publication/299560219_Real-time_auralization_of_room_acoustics_for_the_study_of_live_music_performance
- Mignot et al. (2023). “Reconstruction of transient acoustic field using sparse real-time near-field acoustic holography.” Journal of the Acoustical Society of America, 154(4), 2023. https://www.sciencedirect.com/science/article/abs/pii/S0022460X23004224
- Corey, R. M., Skarha, M. D., & Singer, A. C. (2019). Cooperative Audio Source Separation and Enhancement Using Distributed Microphone Arrays and Wearable Devices. arXiv preprint arXiv:1912.05038. https://arxiv.org/abs/1912.05038