SIEMIA: Sistema para la Interpretación de Electrocardiogramas Mediante Machine Learning para la Detección Temprana de Arritmias

María Isabel Tiburcio Arias y Fernando Elías Rodríguez Bueno – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Las enfermedades cardiovasculares continúan siendo, año tras año, una de las principales causas de muerte a nivel mundial, y dentro de ellas las arritmias cardíacas ocupan un lugar de especial relevancia por su capacidad de manifestarse de forma silenciosa, intermitente o súbita. Desde la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la Pontificia Universidad Católica Madre y Maestra (PUCMM), un equipo conformado por María Isabel Tiburcio Arias y Fernando Elías Rodríguez Bueno, desarrolla SIEMIA: un Sistema para la Interpretación de Electrocardiogramas Mediante Machine Learning para la Detección Temprana de Arritmias.

La motivación detrás de este proyecto surge de una realidad muy concreta dentro de los centros de salud dominicanos y latinoamericanos: la lectura del electrocardiograma (ECG) aún depende, en gran medida, de las experiencias del especialista. En una entrevista realizada como parte de la investigación, el cardiólogo Dr. Samuel Ramos señaló que, en horas de mayor demanda, puede llegar a recibir entre 20 y 40 electrocardiogramas diarios, un volumen que naturalmente incrementa la presión diagnóstica y el riesgo de pasar por alto hallazgos relevantes. Esta necesidad de apoyo tecnológico, y no de reemplazo del criterio médico, es el punto de partida de SIEMIA.

El proyecto propone el desarrollo de un sistema basado en técnicas de Machine Learning y Deep Learning capaz de analizar señales de electrocardiograma y aprender los patrones asociados a distintas anomalías del ritmo cardíaco. Puntualmente, el sistema se apoya en una red neuronal convolucional (CNN) entrenada para diferenciar, a partir de datos digitales de ECG, entre cuatro ritmos cardíacos: el ritmo sinusal normal, la fibrilación auricular, la bradicardia sinusal y la taquicardia sinusal. La visión a más largo plazo contempla, además, extender el análisis a imágenes de electrocardiogramas y aplicar técnicas de Inteligencia Artificial Explicable (XAI) como Grad-CAM, de manera que el sistema no solo clasifique, sino que también pueda mostrar qué porciones de la señal influyeron en su predicción.

El peso de las arritmias y los límites de la lectura manual

Según cifras de la Organización Mundial de la Salud (OMS), un estimado de 19.8 millones de personas murieron a causa de enfermedades cardiovasculares en 2022, lo que representa aproximadamente un 32% de todas las muertes registradas este año a nivel global.[1] Una proporción considerable de estos casos ocurre en países de bajos y medianos ingresos, una tendencia que se confirma en un estudio centrado específicamente en el cuidado de arritmias en América Latina, el cual señala que buena parte de los países de la región carece de la disponibilidad de tecnología y de personal especializado suficiente para identificar y tratar estas alteraciones del ritmo cardíaco.[2]

Dentro del grupo de enfermedades cardiovasculares, las arritmias ocupan un lugar particular, ya que alteran el ritmo normal del corazón y pueden manifestarse de forma silenciosa, intermitente o súbita, lo que dificulta su detección temprana. Un diagnóstico tardío puede traducirse en complicaciones serias como mareos, desmayos, falta de oxígeno o incluso muerte súbita. El electrocardiograma continúa siendo la herramienta más utilizada para detectar estas alteraciones, ya que registra la actividad eléctrica del corazón y permite observar patrones asociados a distintas anomalías del ritmo. Sin embargo, su interpretación sigue dependiendo en gran medida de la experiencia del profesional que la analiza[2], lo que convierte al proceso diagnóstico en una tarea sensible a factores humanos como la fatiga, la sobrecarga laboral o la variabilidad entre especialistas.

En gran parte de los centros médicos de la República Dominicana y Latinoamérica, la lectura manual del ECG es lo común, especialmente en contextos donde no siempre hay un cardiólogo disponible de forma inmediata. Esta dependencia puede derivar en errores humanos, reportes tardíos y dificultades para dar seguimiento de largo plazo a pacientes crónicos. El problema radica en la necesidad de construir soluciones que ayuden a interpretar los electrocardiogramas de forma más rápida, consistente y accesible, particularmente en escenarios donde el tiempo y los recursos humanos son limitados.

La comunidad científica ha respondido a este reto desde hace varios años. Ribeiro et al. demostraron que un modelo de redes neuronales profundas puede diagnosticar múltiples condiciones cardíacas a partir de ECG de 12 derivaciones con aplicabilidad clínica real[3], mientras que Kachuee et al. desarrollaron un modelo de clasificación de latidos cardíacos a partir de señales de ECG crudas, evidenciando que trabajar directamente sobre la señal permite capturar patrones más complejos que los métodos tradicionales.[4] En una línea similar, Narotamo et al. compararon representaciones 1D y 2D de la señal de ECG, así como enfoques de fusión multimodal, encontrando diferencias relevantes en la precisión final de los modelos según la forma en que se representan los datos.[5]

Un aporte particularmente útil proviene de la revisión de Saber y Abotaleb, quienes recopilaron las técnicas modernas de clasificación de arritmias más utilizadas junto con sus porcentajes de precisión, destacando a las redes neuronales convolucionales (CNN) como una de las arquitecturas más frecuentes y efectivas en proyectos similares, con precisiones reportadas entre el 95% y el 99%.[6] Esta revisión, sumada al análisis de conjuntos de datos públicos como PTB-XL[7] y la base de datos de 12 derivaciones para estudio de arritmias publicada por Zheng et al.[8] (también conocida como el dataset de Chapman), da la base necesaria para justificar tanto la arquitectura del modelo como la selección de los datos de entrenamiento.

Actualmente, el diagnóstico a partir del ECG en la República Dominicana se basa principalmente en la experiencia clínica manual. Si bien existen equipos con interpretación automática incorporada, muchos presentan limitaciones significativas: baja precisión en modelos que no fueron adaptados a poblaciones locales, poca explicabilidad de sus resultados y un costo de implementación elevado para centros de salud con recursos limitados. Frente a este panorama, el Dr. Ramos ha señalado el valor que tendría un sistema como SIEMIA no solo para agilizar diagnósticos en casos de emergencia y reducir errores de lectura, sino también para brindar soporte en la identificación de patrones complejos, ahorrar tiempo en interpretaciones repetitivas, ayudar a organizar mejor los casos prioritarios y dar mayor autonomía a los centros de salud que no cuentan con un cardiólogo residente.

Para poder construir un sistema de este tipo era necesario, primero, comprender con precisión qué es lo que se está tratando de clasificar.

Un electrocardiograma (ECG) es una herramienta no invasiva que registra los latidos del corazón y su actividad eléctrica a lo largo de un período determinado, comúnmente entre 10 a 12 segundos, mediante electrodos colocados sobre la piel.[9] En la figura 1 se representa de forma gráfica los tres componentes principales: la onda P, que representa la despolarización auricular y marca el inicio del latido; el complejo QRS, asociado a la despolarización ventricular y a la contracción del músculo cardíaco; y la onda T, que representa la repolarización ventricular, es decir, la recuperación eléctrica del corazón tras la contracción.[18]
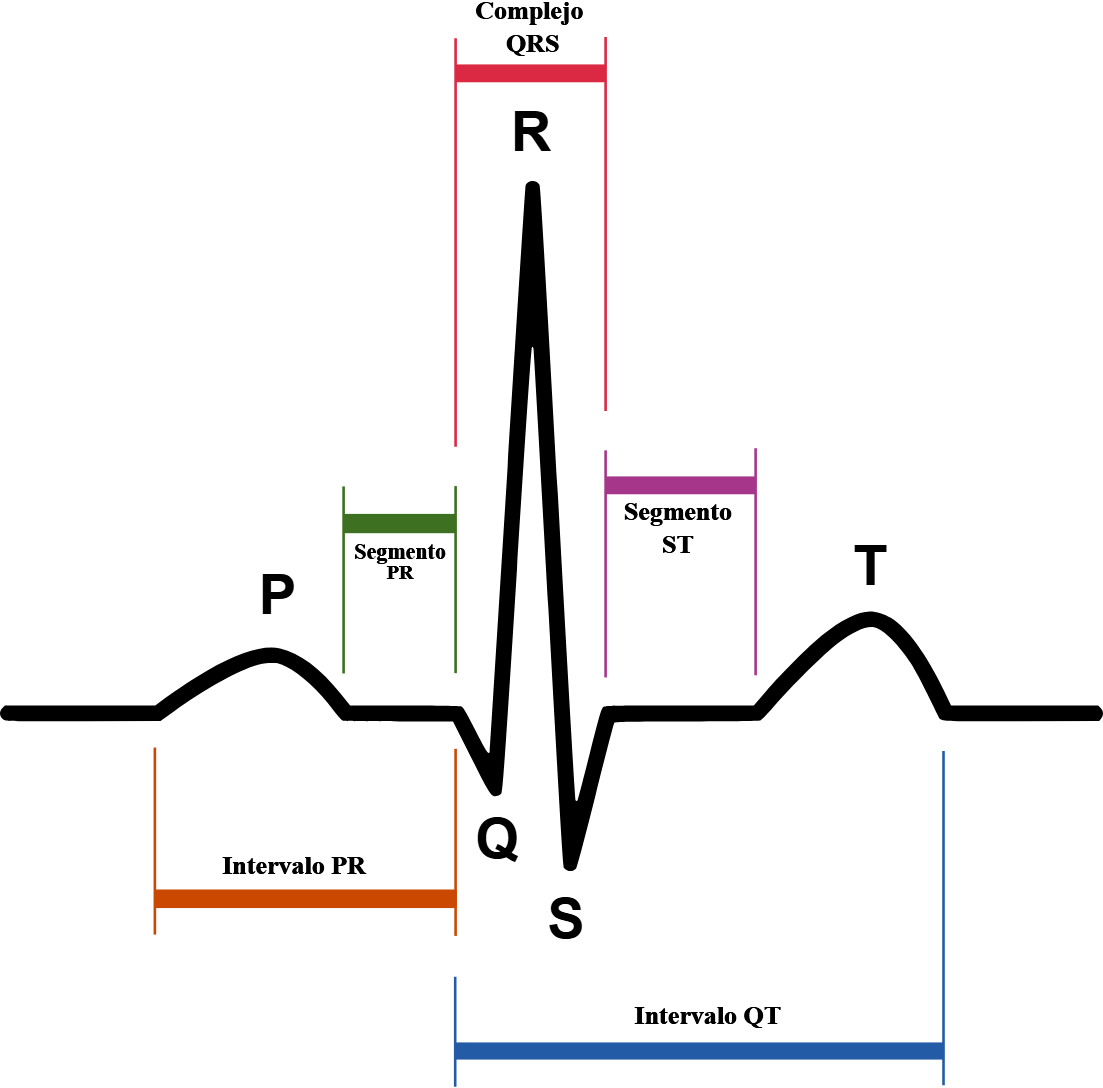
Onda de electrocardiograma con la onda P, el complejo QRS, la onda T, segmentos e intervalos
Figura 1. Componentes principales de una onda de electrocardiograma: onda P, complejo QRS y onda T.

Una arritmia cardíaca, en términos simples, es cualquier alteración del ritmo normal del corazón.[10] Este proyecto se enfoca en diferenciar cuatro de los ritmos más comunes dentro de la práctica clínica.

El ritmo sinusal (SR) es el patrón normal, originado en el nodo sinoauricular, con una frecuencia habitual de entre 60 y 100 latidos por minuto (lpm), y sirve como referencia frente a la cual se comparan las demás alteraciones.[11]

La fibrilación auricular (AFIB), por su parte, se caracteriza por una actividad eléctrica desorganizada en las aurículas que produce un ritmo irregular y, frecuentemente, una frecuencia cardíaca elevada; debido a esta irregularidad, el flujo sanguíneo dentro del corazón se vuelve turbulento, lo que incrementa el riesgo de formación de coágulos que pueden desplazarse hacia otras partes del cuerpo y ocasionar complicaciones graves como un accidente cerebrovascular; en el ECG, su patrón suele describirse como “irregularmente irregular”, con ausencia de ondas P distinguibles.[12]

La bradicardia sinusal (SB) mantiene el origen sinusal del impulso, pero con una frecuencia inferior a 60 lpm, y puede ser un hallazgo normal en atletas o durante el sueño, o bien estar asociada a alteraciones que afectan la perfusión sanguínea.[13]

Finalmente, la taquicardia sinusal (ST) conserva igualmente el patrón sinusal, pero con una frecuencia superior a 100 lpm en reposo, y puede ser tanto una respuesta fisiológica al ejercicio o al estrés como un signo temprano de un proceso patológico subyacente.[14]
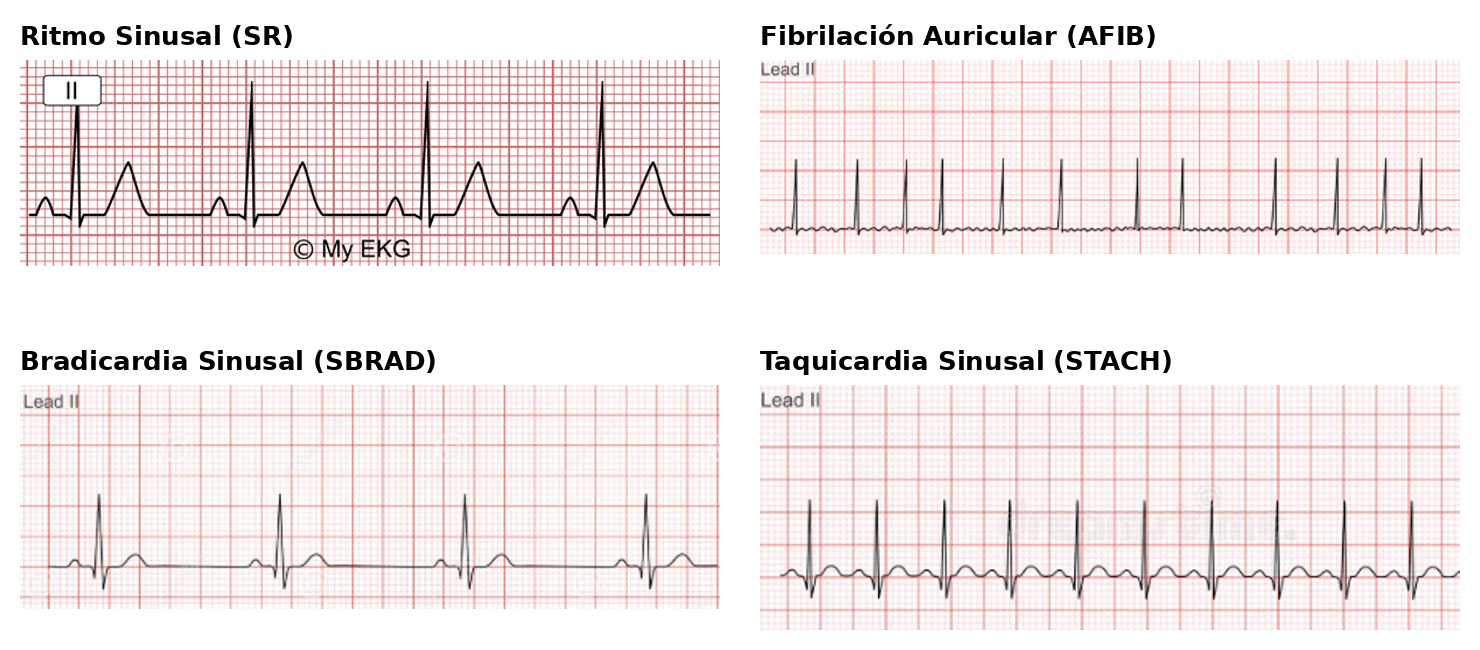
Trazos de ECG de ritmo sinusal, fibrilación auricular, bradicardia sinusal y taquicardia sinusal
Figura 2. Los 4 tipos de arritmias que se trabajan en este proyecto.

Objetivos completados

Hemos logrado implementar y entrenar un modelo de clasificación basado en redes neuronales convolucionales (CNN) capaz de interpretar electrocardiogramas digitales y diferenciar entre cuatro ritmos cardíacos clínicamente relevantes, evaluando su desempeño mediante métricas de precisión, sensibilidad, especificidad y F1-score sobre un conjunto de datos balanceado de cerca de 30,000 registros, alcanzando una exactitud global del 96% en la clasificación de los cuatro ritmos evaluados. Este resultado valida el enfoque metodológico planteado y sienta las bases técnicas necesarias para las siguientes fases del proyecto: la incorporación de técnicas de explicabilidad (XAI) y el desarrollo de la interfaz clínica que permitirá a los médicos visualizar el ECG junto al análisis automático del sistema.

Metodología

Para este proyecto nos estamos enfocando en incorporar técnicas de aprendizaje automático o Machine Learning (ML), que permite que un sistema aprenda a partir de datos en lugar de depender de reglas programadas explícitamente[15], y, un nivel más profundo, el aprendizaje profundo o Deep Learning (DL), que utiliza redes neuronales de múltiples capas para aprender representaciones directamente a partir de datos crudos, sin necesidad de que un humano seleccione manualmente qué atributos son relevantes.[16]

Las redes neuronales convolucionales (CNN), en particular, sobresalen en el reconocimiento de patrones espaciales dentro de los datos, lo que las ha convertido en una arquitectura de referencia tanto para el reconocimiento de imágenes como para el análisis de señales fisiológicas como el ECG.[17]

La elección de CNN como clasificador principal de SIEMIA no fue arbitraria. Además del respaldo que ofrece la revisión de Saber y Abotaleb en cuanto a su desempeño frente a otras arquitecturas,[6] se consideraron alternativas como Random Forest o Support Vector Machine (SVM), comúnmente utilizadas sobre características tabulares extraídas manualmente de la señal. Sin embargo, ese tipo de modelos depende en buena medida de variables diseñadas a mano, mientras que una CNN puede aprender directamente a partir de la forma de la señal cruda, sin ese paso intermedio de extracción manual de atributos, lo que resulta especialmente conveniente para una señal tan rica en matices morfológicos como el ECG.
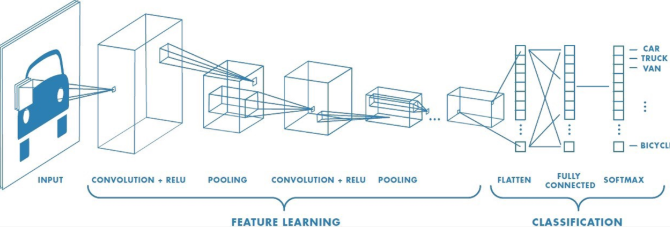
Esquema de una red neuronal convolucional con capas de convolución, pooling y clasificación
Figura 3. Funcionamiento general de una red neuronal convolucional: extracción de características por capas de convolución y clasificación final.

Con la arquitectura definida, el siguiente reto fue construir un banco de datos suficientemente robusto para entrenarla. El conjunto final, denominado balanced_dataset_v3.csv, resulta de la fusión de dos bases de datos públicas de ECG ampliamente reconocidas en la literatura: PTB-XL[7], una de las bases clínicas de electrocardiografía de 12 derivaciones más extensas y mejor documentadas disponibles a través de PhysioNet, con 21,837 registros de 18,885 pacientes; y la base publicada por Zheng et al. (2022), conocida como el dataset de Chapman[8], con 45,152 registros centrados específicamente en la variabilidad del ritmo cardíaco. La combinación de ambos conjuntos permitió reunir alrededor de 65,000 registros médicos con más de 100 anomalías o condiciones cardíacas distintas.

A partir de ese conjunto fusionado, el equipo filtró únicamente las condiciones de tipo rítmico y seleccionó las cuatro con mayor relevancia clínica y volumen de datos: ritmo sinusal, fibrilación auricular, bradicardia sinusal y taquicardia sinusal. Dado que estas categorías no estaban distribuidas de forma pareja, se aplicó un proceso de undersampling, reduciendo cada clase a la cantidad de la categoría más pequeña —7,339 registros—, para obtener así un conjunto balanceado final de 29,356 registros. Este balance es clave en un problema de clasificación médica, ya que evita que el modelo aprenda a favorecer las clases mayoritarias en detrimento de aquellas con menor representación, pero de igual o mayor relevancia clínica.
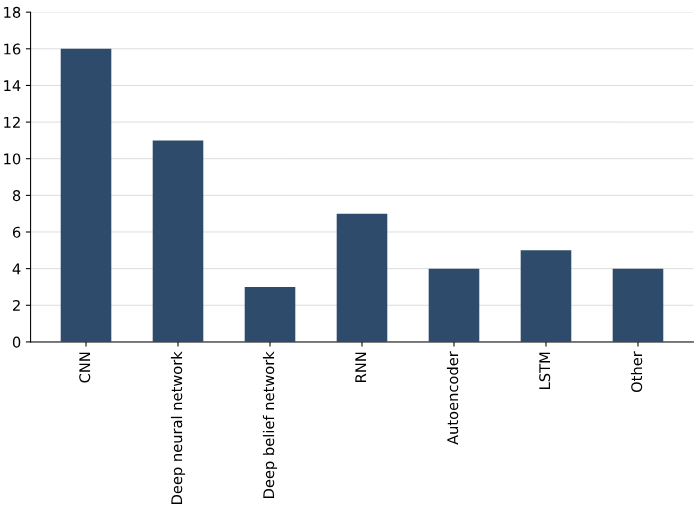
Gráfico de barras con la frecuencia de uso de técnicas de clasificación de arritmias, encabezado por CNN
Figura 4. Técnicas de clasificación más utilizadas en la literatura de arritmias, según Saber y Abotaleb [6].

Una vez definido el conjunto de datos, se aplicó un protocolo de preprocesamiento orientado a preservar la integridad del entrenamiento. Todos los registros fueron estandarizados a una frecuencia de muestreo de 100 Hz y normalizados mediante z-score, de manera que cada señal quedara representada por 1,000 muestras, favoreciendo un entrenamiento más ligero y consistente. Adicionalmente, se implementó un pipeline de control de calidad para descartar registros corruptos, con picos de voltaje fuera de rangos biológicos razonables (superiores a 20 milivoltios), valores no numéricos (NaN) o rutas de acceso inválidas. Finalmente, el conjunto de datos depurado fue pre-calculado y almacenado en formato tensor de PyTorch (.pt), lo que reduce cuellos de botella durante el entrenamiento y asegura un formato de datos único y consistente.

La arquitectura de la red se implementó como una CNN unidimensional (1D-CNN) bajo el ecosistema de PyTorch, organizada en capas de convolución para la extracción de rasgos, funciones de activación no lineales, capas de pooling para reducir la dimensionalidad y capas densas para la clasificación final entre las cuatro categorías de ritmo.

El entrenamiento se gestionó mediante el algoritmo de optimización Adam junto con Data Loaders para el procesamiento eficiente por lotes, dividiendo el conjunto de datos en subconjuntos de entrenamiento y validación mediante un train-test split convencional, lo que permite evaluar el modelo sobre datos que no ha visto durante el aprendizaje.

A nivel de gestión del proyecto, el desarrollo del software se organizó bajo una metodología ágil basada en Scrum, complementada con un seguimiento visual tipo Kanban. En lugar de construir el sistema completo en una sola fase extensa, el trabajo se dividió en bloques de avance que permitieron levantar primero una versión funcional básica (centrada en el análisis de señales digitales de ECG) para luego mejorarla progresivamente hacia una solución más completa, con visualización de resultados y preparación para futuras funciones de explicabilidad.

En general, el sistema recibe electrocardiogramas en formato digital, procesa la señal, extrae los patrones relevantes y genera una clasificación preliminar entre las cuatro categorías de ritmo definidas, presentando el resultado junto a la visualización del propio ECG. En cambio, no clasifica arritmias fuera de esas cuatro categorías en esta etapa, no reemplaza el criterio médico ni emite diagnósticos definitivos, no prescribe tratamientos y no realiza monitoreo cardíaco en tiempo real, ya que podría afectar negativamente métricas como la precisión que resultan fundamentales para que la herramienta tenga utilidad real como apoyo clínico.

Resultados

Tras entrenar el clasificador sobre el conjunto de datos balanceado, la validación del modelo se realizó utilizando un marco de métricas de precision, recall, F1-score y matrices de confusión. Esta decisión responde a que, en un entorno clínico, el costo de un falso negativo, no detectar una arritmia maligna, puede ser considerablemente más alto que el de un falso positivo, por lo que resulta indispensable observar el comportamiento del modelo clase por clase y no solo su desempeño promedio.

Sobre un conjunto de validación de 4,403 registros, el modelo alcanzó una exactitud (accuracy) global del 96%. Al desglosar el desempeño por clase, la fibrilación auricular (AFIB) obtuvo un F1-score de 0.97 (precision 0.96, recall 0.98), la taquicardia sinusal (STACH) un F1-score de 0.97 (precision 0.98, recall 0.96), la bradicardia sinusal (SBRAD) un F1-score de 0.96 (precision 0.95, recall 0.98) y el ritmo sinusal (SR) un F1-score de 0.94 (precision 0.96, recall 0.93), tal como se resume en la tabla 1.

ClasePrecisionRecallF1-scoreSoporte
Ritmo sinusal (SR)0.960.930.941098
Fibrilación auricular (AFIB)0.960.980.971074
Taquicardia sinusal (STACH)0.980.960.971119
Bradicardia sinusal (SBRAD)0.950.980.961112
Accuracy global0.964403
Macro avg0.960.960.964403
Weighted avg0.960.960.964403
Tabla 1. Reporte de clasificación del modelo CNN sobre el conjunto de validación (4,403 registros).

La matriz de confusión permite observar con más detalle dónde se concentran los errores del modelo. El ritmo sinusal (SR) es la clase con más confusiones: de 1,098 casos reales, pero el modelo tiende a confundir el ritmo sinusal normal con sus variantes de frecuencia (más lenta o más rápida) en los casos límite, un comportamiento razonable considerando que la diferencia entre estas clases depende principalmente de la frecuencia cardíaca y no de un cambio morfológico marcado en la señal. En contraste, la fibrilación auricular y la bradicardia sinusal presentan muy pocas confusiones con las demás clases (recall de 0.98 en ambas), ya que estas dos condiciones se encuentran entre las de mayor relevancia clínica dentro del alcance del proyecto.
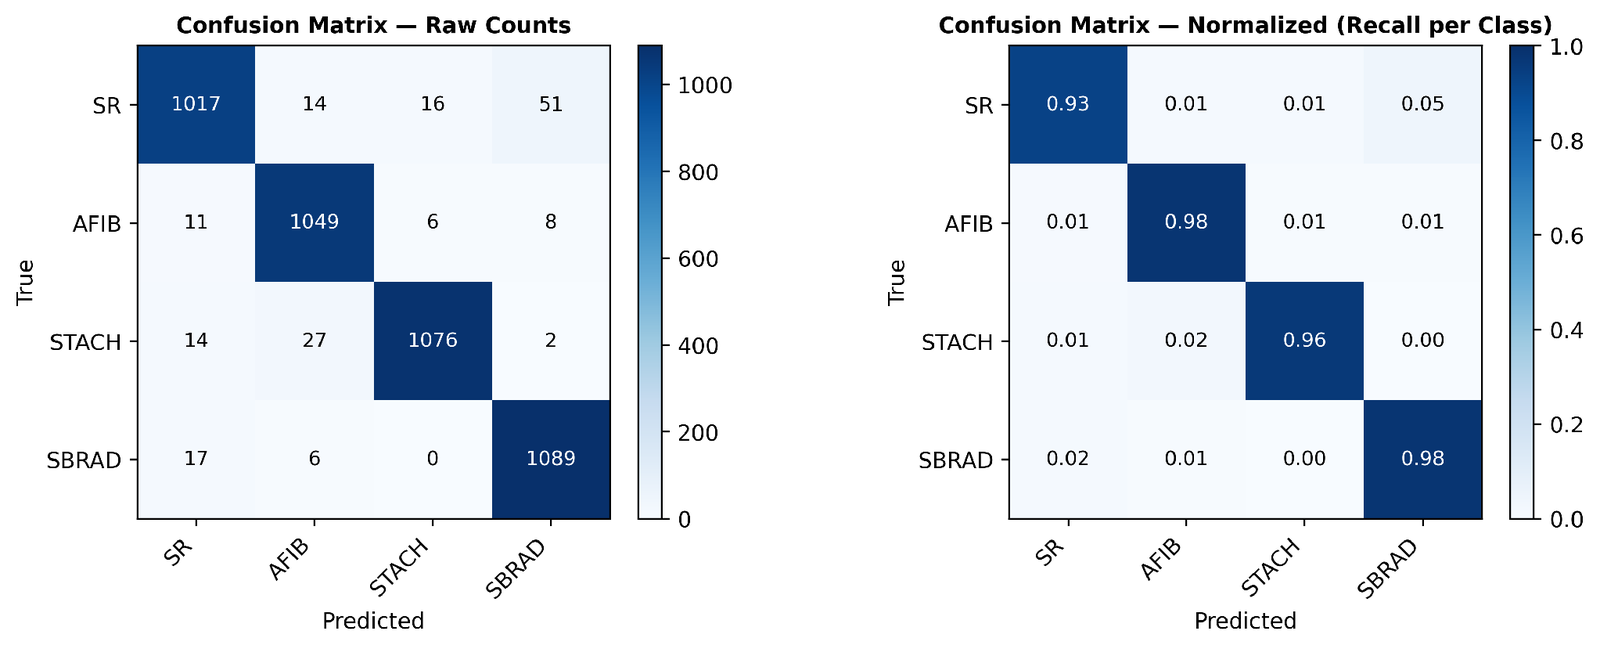
Matrices de confusión del modelo en conteos absolutos y normalizadas por clase
Figura 5. Matrices de confusión del modelo: conteos absolutos (izquierda) y valores normalizados por clase real (derecha).

Estos resultados son consistentes con lo reportado en la literatura para arquitecturas CNN aplicadas a la clasificación de arritmias, donde se documentan precisiones de entre 95% y 99%[6], y validan la hipótesis planteada al inicio del proyecto: que un modelo de redes neuronales convolucionales, entrenado con datos de ECG adecuadamente preprocesados y balanceados, puede clasificar patrones arrítmicos con métricas de desempeño clínicamente útiles.

Más allá del modelo en sí, el equipo ha avanzado también en el diseño de la experiencia de usuario del sistema, con un mockup preliminar de la interfaz que el personal médico utilizará para insertar un electrocardiograma, visualizar la señal y recibir el resultado del análisis, así como el diagrama de flujo que describe el recorrido completo desde que se inserta un ECG hasta que se muestra el resultado preliminar.
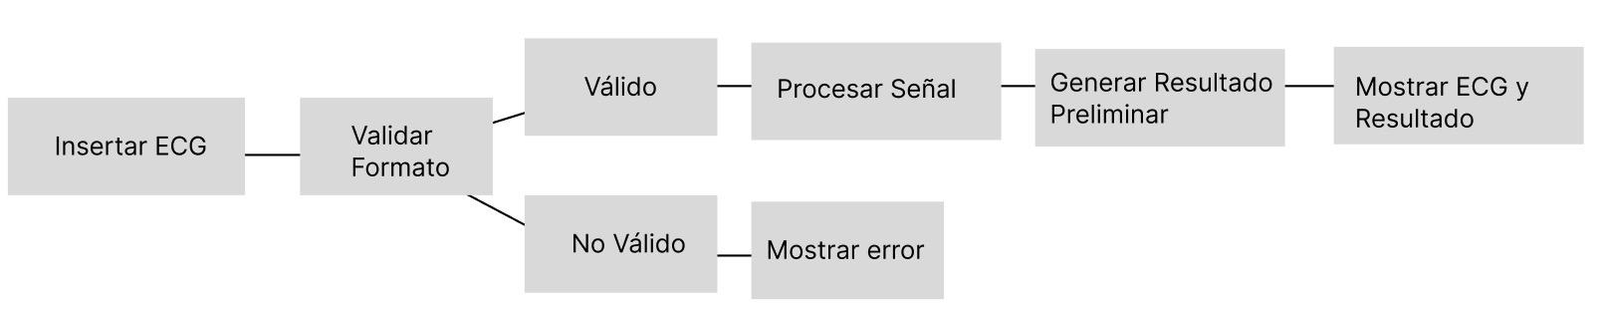
Diagrama de flujo: insertar ECG, validar formato, procesar señal y mostrar resultado o error
Figura 6. Diagrama de flujo del proceso de inserción y análisis de un electrocardiograma en la interfaz.

Conclusión

Los resultados obtenidos hasta el momento confirman que un modelo de aprendizaje profundo, entrenado sobre una base de datos suficientemente grande y balanceada, puede aprender a distinguir con alta precisión entre distintos ritmos cardíacos a partir de la señal cruda del electrocardiograma. Para un equipo de tesis, alcanzar un 96% de exactitud global, con métricas por clase que se mantienen consistentemente altas incluso en la categoría más difícil de diferenciar, es una validación fuerte de que el enfoque técnico elegido (CNN 1D, entrenada sobre datos fusionados de PTB-XL y Chapman) es el adecuado para este problema.

El propio alcance del proyecto limita, de forma deliberada, la clasificación a cuatro tipos de ritmo, dejando fuera un número considerable de arritmias que también requieren atención clínica; ampliar esa cobertura implica un proceso de entrenamiento, validación y ajuste más exigente. De igual forma, el sistema aún no incorpora las técnicas de explicabilidad (XAI) contempladas desde el planteamiento inicial, un componente que resulta especialmente importante en el ámbito médico, donde un modelo que sólo entrega una etiqueta sin justificación difícilmente genera la confianza necesaria para ser adoptado por profesionales de la salud.

En un país donde la transformación digital del sector salud continúa en proceso, este proyecto aspira a convertirse en una herramienta de apoyo accesible que ayude a los profesionales de la salud dominicanos a detectar arritmias con mayor rapidez, consistencia y respaldo tecnológico, sin pretender jamás sustituir el criterio clínico que solo un especialista puede ofrecer.

Fusionar y balancear dos conjuntos de datos de procedencias distintas, depurar registros corruptos y decidir qué arritmias priorizar dentro de un alcance realista fueron, en la práctica, tareas tan determinantes para el resultado final como la propia arquitectura de la red neuronal. Los hallazgos recolectados hasta la fecha no solo confirman la eficiencia del modelo desarrollado, sino que además sientan los cimientos para su posterior evolución hacia una solución de soporte tecnológico cada vez más robusta e integral para el diagnóstico cardiovascular.

Referencias

  1. World Health Organization, “Cardiovascular diseases (CVDs),” 2025. Available: https://www.who.int/news-room/fact-sheets/detail/cardiovascular-diseases-(cvds)
  2. U. Rojel et al., “Current state of arrhythmia care in Latin America: A statement from the Latin American Heart Rhythm Society,” Heart Rhythm O2, 2024. DOI: 10.1016/j.hroo.2024.11.010
  3. A. Ribeiro et al., “Automatic diagnosis of the 12-lead ECG using deep neural networks,” Nature Communications, 2020. https://pubmed.ncbi.nlm.nih.gov/32273514/
  4. M. Kachuee et al., “ECG heartbeat classification using deep neural networks,” IEEE EMBC, 2023. https://pmc.ncbi.nlm.nih.gov/articles/PMC10128986/
  5. H. Narotamo et al., “Deep learning for ECG classification: A comparative study of 1D and 2D representations and multimodal fusion approaches,” ScienceDirect, 2024. DOI: 10.1016/j.bspc.2024.106141
  6. M. Saber and M. Abotaleb, “Arrhythmia Modern Classification Techniques: A Review,” Journal of Artificial Intelligence and Metaheuristics, vol. 1, no. 2, pp. 42-53, 2022. DOI: 10.54216/JAIM.010205
  7. P. Wagner et al., “PTB-XL: A large publicly available ECG dataset,” PhysioNet, 2020. DOI: 10.13026/x4td-x982
  8. J. Zheng et al., “A large scale 12-lead electrocardiogram database for arrhythmia study,” PhysioNet, 2022. DOI: 10.13026/92ks-sq55
  9. Y. Sattar and L. Chhabra, “Electrocardiogram,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK549803/
  10. S. Dhaval, “Arrhythmias,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK558923/
  11. B. Rogoff et al., “EKG Rhythm,” StatPearls, 2022. Available: https://www.ncbi.nlm.nih.gov/books/NBK555952/
  12. Z. Nesheiwat et al., “Atrial Fibrillation,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK526072/
  13. Y. Hafeez et al., “Sinus Bradycardia,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK493201/
  14. A. Henning et al., “Sinus Tachycardia,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK553128/
  15. N. Maslej et al., “Artificial Intelligence Index Report 2025,” arXiv, 2025. Available: https://arxiv.org/pdf/2504.07139
  16. M. Liakat et al., “Deep Learning vs. Machine Learning for Intrusion Detection in Computer Networks: A Comparative Study,” Applied Sciences, 2025. DOI: 10.3390/app15041903
  17. M. Krichen, “Convolutional Neural Networks: A Survey,” Computers, 2023. DOI: 10.3390/computers12080151
  18. “Cómo interpretar un ECG: guía para profesionales de la salud,” Feb. 2026. Available: https://mesimedical.com/es/noticias/como-interpretar-el-ecg
Arquitectura analítica de datos para mejorar las decisiones en la universidad: un prototipo de lakehouse académico

Carolina Bencosme Gómez y Jean Carlos Pérez Ortega – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Las universidades no carecen de datos. Carecen de un lugar común, gobernado y reutilizable donde esos datos dejen de ser un extracto de fin de cuatrimestre y pasen a ser un insumo de decisión. Matrícula, rendimiento, ayuda económica y trayectoria ocurren todos los días en el sistema académico. Lo que suele faltar es una capa analítica que no compita con el sistema transaccional ni dependa de un único proveedor comercial para almacenar, curar y consultar. Este artículo resume un proyecto de grado de Ingeniería en Ciencias de la Computación desarrollado en la Pontificia Universidad Católica Madre y Maestra. Carolina Bencosme Gómez y Jean Carlos Pérez Ortega diseñaron e implementaron un prototipo de arquitectura de datos de código abierto, tipo lakehouse, con el fin de mostrar cómo una institución de educación superior puede integrar extractos académicos y alimentar, desde el mismo suelo, proyección de matrícula y predicción de retención.

La motivación no fue adornar el expediente con un dashboard. Fue una brecha concreta: planificación y acompañamiento piden series y segmentos de riesgo, y el ERP responde con pantallas de trámite. La literatura de analítica institucional describe ese desajuste desde hace años. El valor no aparece por acumular registros, sino por alinear dato, modelo y decisión [1], [2], [5]. En América Latina la adopción de inteligencia artificial en educación ha crecido, pero con evidencia desigual y con poca infraestructura de datos que sostenga el modelo después del artículo [3], [6]. La transformación digital de una universidad no es comprar una licencia de reportes. Es cambiar dónde vive la verdad analítica y quién puede consultarla sin copiar tablas a un correo [4], [16].

El recorte fue deliberado. No se pretendió el almacén de toda la institución ni un conector permanente al sistema académico de producción. Se pretendió demostrar que un lago con propiedades transaccionales, un modelo dimensional y dos preguntas de negocio bastan para un ciclo completo: aterrizar, curar, modelar y consumir. Eso importa para otras instituciones de educación superior porque el beneficio no está en una nube hipotética. Está en poder empezar con extractos tabulares, hardware modesto y software abierto, sin hipotecar el dato a un formato propietario [8], [9], [14]. Si el prototipo funciona en un computador portátil con contenedores reproducibles, el argumento deja de ser de catálogo y pasa a ser de ingeniería. Por indicación de la dirección del proyecto, las series, volúmenes y capturas de dashboard de este artículo son un banco sintético de demostración, generado en local. Los extractos canónicos del prototipo se depositaron en custodia de la asesora y no se reproducen aquí.

El lector de este blog no necesita ser ingeniero de plataformas. Sí necesita una tesis clara. Una IES puede implementar una arquitectura abierta que separe almacenamiento de cómputo, que publique marts legibles por inteligencia de negocios y que deje al científico de datos trabajar sobre vistas ya unidas. El precio de esa promesa es honesto: el prototipo no opera veinticuatro horas, no sustituye al ERP y no afirma política de cupos ni de expulsión. Afirma un método exportable, con métricas de holdout del experimento y con límites que se dicen en voz alta. Esas métricas no son los puntos dibujados en las figuras de demostración.
El ERP resuelve la operación. No resuelve la pregunta analítica

En la PUCMM, como en otras universidades dominicanas, los portales de matrícula y de aula cumplen su trabajo: inscribir, publicar notas, entregar evidencias. Eso no equivale a disponer de un repositorio analítico con grano explícito, calidad medible y linaje. El analista pide un recuento por plan y campus. El sistema responde con una transacción de inscripción. Entre ambas capas alguien exporta, une y olvida de qué período era el archivo. Esa práctica no es negligencia personal. Es el síntoma de una arquitectura que nunca contempló el consumo analítico como un producto [1], [7], [13].

El patrón se repite fuera del país. Universidades que construyen plataformas de datos educativos reportan las mismas fricciones: fuentes heterogéneas, calidad irregular y ausencia de un contrato estable entre quien produce el dato y quien lo modela [8]. Las revisiones sobre inteligencia artificial en educación superior insisten en que los modelos aparecen más rápido que las condiciones para usarlos con justicia y con contexto pedagógico [6]. Un clasificador de abandono sin dashboard que llegue a orientación es un ejercicio de laboratorio. Un dashboard sin capa curada es un dibujo sobre un CSV semanal. El problema no es la falta de algoritmos. Es la falta de una capa intermedia gobernada [11], [12].

El almacén de datos clásico y el lago de archivos resuelven mitades. El primero ofrece esquema y SQL, pero se vuelve rígido cuando llega un dominio nuevo. El segundo admite cualquier archivo, pero entrega caos en cuanto dos cuadernos leen versiones distintas. El lakehouse surge para no escoger entre esos dos males. Unifica el almacenamiento de objetos con tablas que admiten transacciones, evolución de esquema y consulta SQL [9], [14], [17]. No es magia. Es un pacto de formato abierto: el motor de consultas, el cuaderno y el dashboard hablan de tablas, no de carpetas con fecha en el nombre.

Hay un segundo vacío local. Las estrategias nacionales de datos e inteligencia artificial hablan de infraestructuras compartidas y de incorporar analítica en educación. El documento de política no construye el catálogo ni el mart. Si una universidad espera el hub nacional para empezar, seguirá pegando hojas en cada ciclo lectivo. Si empieza con extractos propios y software abierto, gana soberanía sobre el dato y una base sobre la cual, más adelante, sí podrá conectar el sistema transaccional con ventanas controladas [4], [16]. Ese orden importa: primero el contrato interno, después el conector.

Las suites comerciales de inteligencia de negocios tampoco cierran solas la brecha. Un dashboard pegado al ERP hereda la carga operativa y la semántica del trámite. Un dashboard pegado a un archivo plano hereda la caducidad del archivo. El beneficio de una arquitectura abierta no es ahorrar la licencia del visor, que la institución puede seguir usando. El beneficio es que el visor deje de ser el lugar donde se limpia el dato. Limpieza, grano y calidad viven abajo. El dashboard solo consume. Esa inversión de responsabilidades es la que la literatura de inteligencia de negocios describió cuando distinguió almacenamiento de impacto [5]. Aquí se traduce a un campus que no puede, o no debe, saturar Oracle con consultas de exploración.

La comparación internacional no debe leerse como receta. Las plataformas documentadas en acceso abierto suelen asumir nube institucional, equipos de datos y convenios estables con el sistema académico [8]. Una IES dominicana de tamaño medio suele tener otra realidad: hardware personal de los tesistas, restricciones de privacidad, y un acceso a producción que no es un servicio, sino una ventana. Experiencias de campus que montan una arquitectura de datos abierta para servicios institucionales muestran que el patrón es viable, siempre que el dato no se confunda con el trámite cotidiano [18]. El estado del arte dice qué arquitectura es razonable. No dice cómo bajarla a un prototipo que quepa en laptops y que, aun así, entregue métricas reproducibles. Ese hueco es el que este proyecto intentó ocupar, sin pretender que el resultado sea ya política institucional.

En retención, además, el debate ya no es si se puede predecir el abandono. Es si la predicción llega a quien interviene y si el dashboard se entiende [11]. Revisiones regionales recuerdan que la deserción es un fenómeno con causas académicas, económicas y de trayectoria, y que un único indicador suele mentir [12]. Una arquitectura abierta no “resuelve” la deserción. Permite publicar un scoring con linaje, un segmento de riesgo y una vista individual sin reconstruir el análisis en una hoja privada. El beneficio institucional es de gobierno del dato, no de milagro pedagógico.
Qué se dio por cumplido

El desarrollo de este proyecto implementó un prototipo de arquitectura analítica tipo lakehouse, de componentes abiertos, adaptada a las restricciones de una institución de educación superior dominicana, con el propósito de integrar extractos académicos y habilitar decisiones basadas en datos. El objetivo general se desglosó en tres resultados verificables. Primero, un análisis de brechas entre el enfoque transaccional local y las arquitecturas lakehouse y de analítica institucional descritas en la literatura. Segundo, el diseño e implementación de un flujo por capas de aterrizaje, curación dimensional y mart de consumo, desplegable de forma reproducible en contenedores, con consulta SQL unificada y entornos de exploración para el científico de datos. Tercero, dos casos de uso académicos, cerrados hasta dashboard, que proyectan matrícula por carrera y campus con modelos de series temporales y priorizan riesgo de retención con un clasificador evaluado en un holdout temporal. El alcance es una prueba de concepto operable, no un sistema institucional continuo ni un conector de producción al ERP. La conexión permanente al sistema académico, la migración a servidores de la universidad y la operación continua del orquestador quedan explícitamente como trabajo futuro.

Un flujo, dos preguntas de negocio

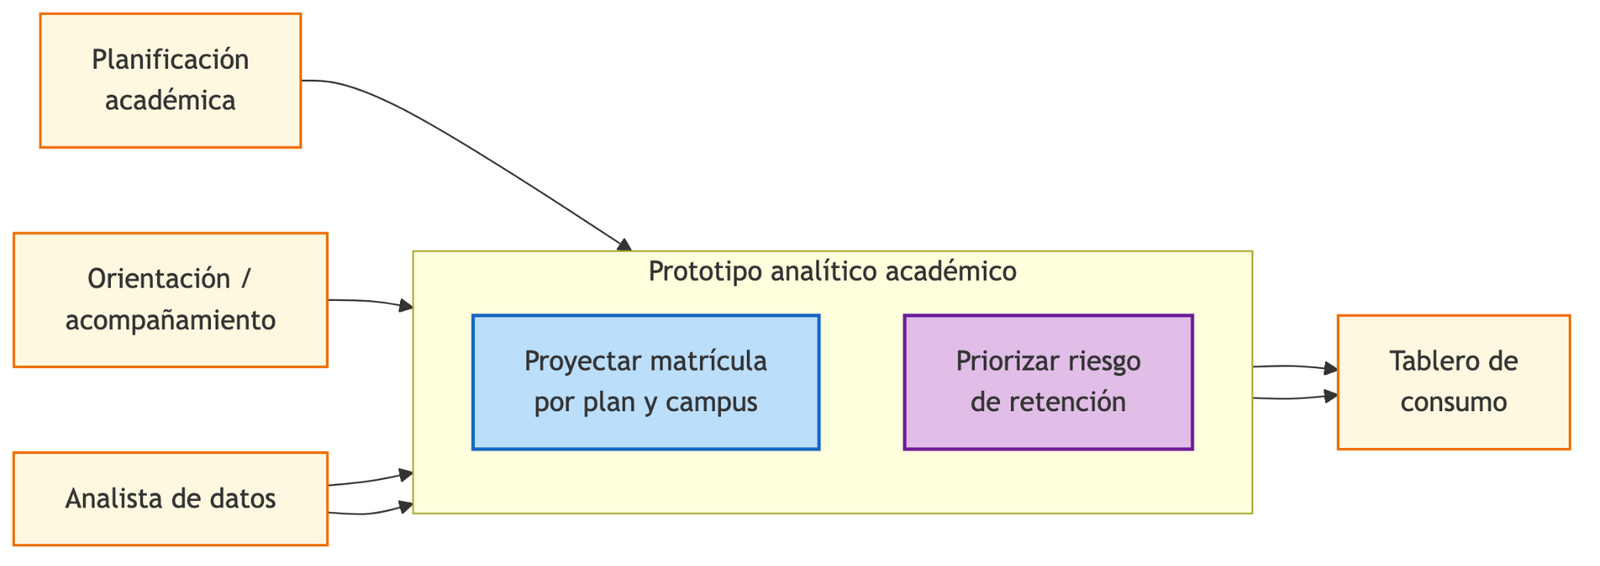
La metodología partió de un recorte de producto, no de un catálogo de herramientas. Si el lakehouse no respondía a una decisión existente, se convertía en infraestructura sin dueño. Se eligieron dos preguntas que ya viven en la universidad. Cuántos alumnos esperar por plan y campus en los siguientes ciclos. A quién priorizar en acompañamiento si el riesgo de no retener se estima con historial académico. La primera sirve para la planificación. La segunda, la orientación. El analista interviene en ambas. El dashboard es el contrato de consumo, no el lugar donde se inventa el modelo [5], [11].

Diagrama de casos de uso: planificación, orientación y analista de datos usan el prototipo para proyectar matrícula y priorizar riesgo de retención
Figura 1. Casos de uso del prototipo: proyección de matrícula y predicción de retención.

Esa división no es cosmética. Matrícula y retención no comparten el mismo grano. La primera es una serie por plan, campus y período: una celda, una cuenta de alumnos. La segunda, en el modelo publicado, es estudiante por carrera y año de observación, con señales de carga, índice y ayuda. Forzar ambos dominios en una sola tabla ancha habría sido más rápido de dibujar y más caro de mantener. El modelado dimensional clásico sigue siendo el antídoto contra ese atajo [10]. Dos espacios de trabajo sobre la misma plataforma, con catálogos distintos, fue el trade-off: más orquestación, menos contaminación de semántica.

Capas, no un único servidor con todos los roles

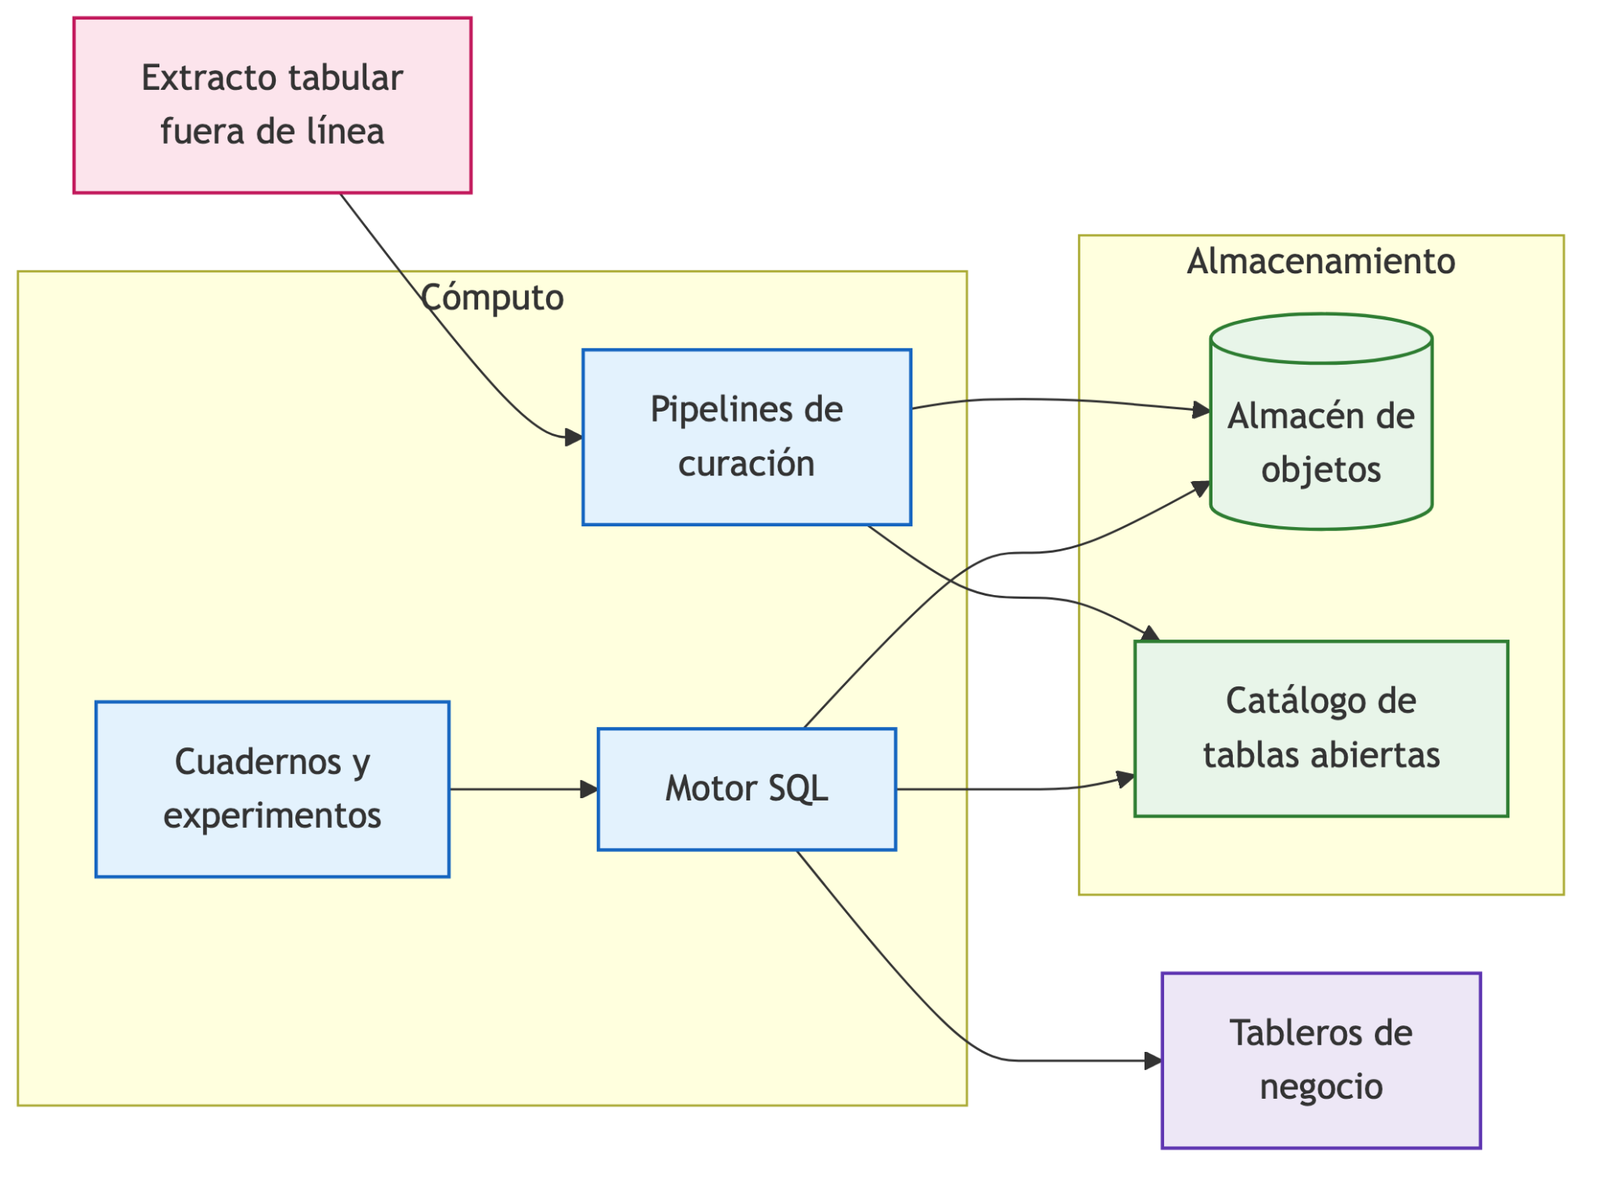
El diseño lógico separa fuente, flujo gobernado, exploración y consumo. La fuente canónica sigue siendo el sistema académico institucional. En el prototipo, sin embargo, no se consulta en vivo de forma permanente. Las consultas pesadas se materializaron como archivos planos de respaldo. Las conexiones seguras de red se usaron solo para diagnóstico. El túnel no se sostuvo como camino diario, y eso se aceptó como hallazgo de implementación, no como nota al pie. Una IES que copie el método debe planear el extracto offline como camino realista mientras no exista un conector de solo lectura con ventana controlada [8], [14].

Diagrama de bloques: extracto tabular, pipelines de curación, almacén de objetos, catálogo de tablas abiertas, motor SQL, cuadernos y tableros de negocio
Figura 2. Diagrama de bloques del prototipo: extracto tabular, curación, almacén de objetos, catálogo de tablas abiertas, motor SQL y dashboards.

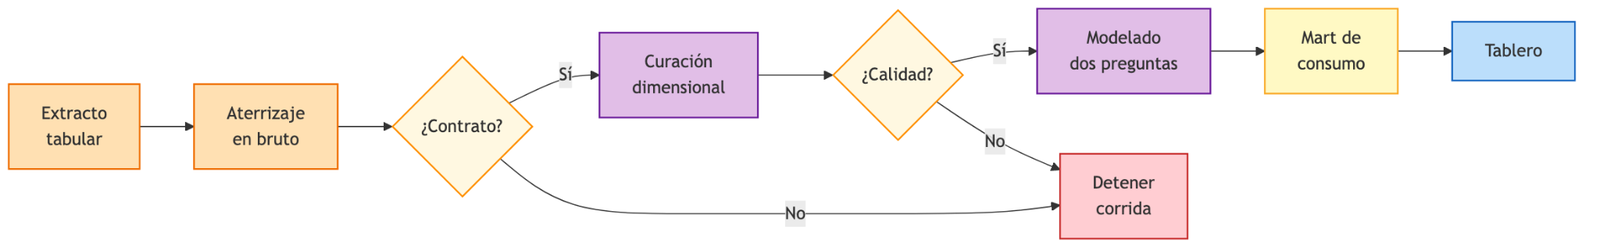
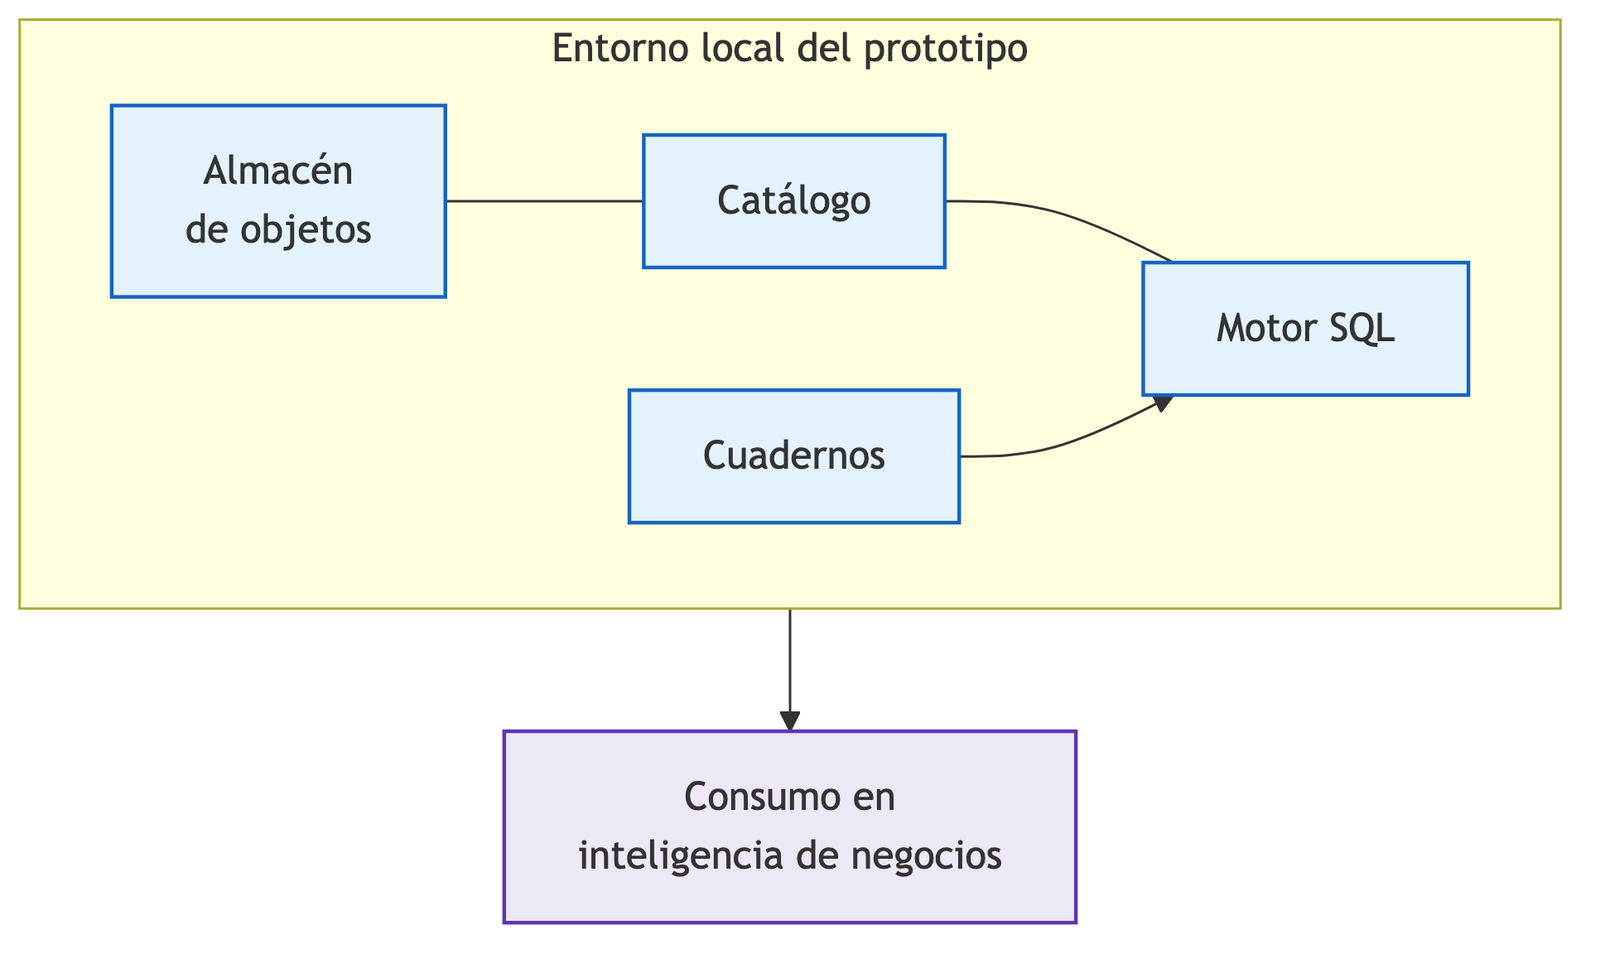
Sobre el almacén de objetos se montaron tablas de formato abierto y catálogo, de modo que el motor SQL y los cuadernos hablen el mismo lenguaje de tablas [9], [14]. El flujo productivo recorre aterrizaje en bruto, curación dimensional y publicación del mart. En paralelo, el analista explora la capa curada en un entorno acotado y solo promueve a consumo lo validado. Esa es la decisión que más beneficio institucional produce y la que más disciplina exige. Si el científico escribe el mart desde el cuaderno, el dashboard vuelve a ser un silo. Si el dashboard escribe reglas de negocio que el modelo no versiona, el scoring deja de ser auditable.

Diagrama de flujo: extracto tabular, aterrizaje en bruto, verificación de contrato, curación dimensional, verificación de calidad, modelado y mart de consumo
Figura 3. Flujo gobernado: aterrizaje, curación dimensional, modelado de las dos preguntas y mart de consumo. Si falla el contrato o la calidad, la corrida se detiene.

Distribuir componentes evita saturar un solo servidor con todos los roles. El almacenamiento masivo no es el motor de consultas. El motor no es el cuaderno. El cuaderno no es el dashboard. En hardware de laptop esa separación también es una defensa contra la memoria agotada. El prototipo no demostró escalamiento a miles de usuarios concurrentes. Demostró que el patrón no obliga a copiar el lago dentro de la herramienta de reportes. Para una IES, eso es el beneficio práctico de lo abierto: se puede cambiar el visor o el motor sin rehacer el contrato de tablas [9], [17].

La orquestación se pensó como dependencias estrictas, no como un reloj que afirma disponibilidad continua. Una corrida tiene identificador, recorre aterrizaje, calidad, transformación y publicación, y deja un resumen auditable. Si falla la ingesta, no avanza la curación. Si falla la calidad, no se publica el mart. El formato de tablas abiertas fue el que otorgó propiedades transaccionales al lago: no se trata de “archivos más ordenados”, sino de poder volver a un estado coherente [14]. Afirmar operación continua sería adelantar un resultado que no se midió. El beneficio medido es reproducibilidad de la evidencia, no un acuerdo de nivel de servicio.

Entorno local del prototipo: almacén de objetos, catálogo, cuadernos y motor SQL, con consumo en inteligencia de negocios
Figura 4. Entorno local del prototipo: almacén, catálogo, cuadernos y motor SQL.

El empaquetado en contenedores fue, además, una decisión de metodología de equipo. El hardware del proyecto no es un clúster. Son computadores portátiles con arquitecturas distintas. Sin imágenes compartidas, cada integrante instala a mano el almacén, el catálogo, el motor SQL y el seguimiento de experimentos, con versiones que no coinciden y resultados que un tercero no puede auditar. Lo abierto aquí no es un eslogan. Es la única forma razonable de que dos estudiantes y una asesora vean el mismo prototipo. Una IES que adopte el patrón puede, más adelante, mover esos mismos contratos a servidores institucionales. El prototipo no hizo esa migración. La deja como futuro explícito [8].

Cómo se modeló sin reescribir la limpieza en cada cuaderno

Para matrícula se construyó una vista compacta: el hecho ya unido a nombres de dimensión, lista para series temporales. El científico no arma la unión de planes y periodos en el cuaderno. Lee la compacta y entrena. Eso parece menor hasta que se cuenta cuántas veces un proyecto estudiantil vuelve a limpiar el mismo extracto [2], [10]. El candidato usado en el piloto reconoce estacionalidad de tres periodos académicos por año, coherente con el calendario de la institución y con la práctica estándar de series temporales [15].

Para retención se evitó entrenar sobre el detalle crudo de cada inscripción. El panel canónico agrega al año de observación señales de asignaturas, créditos, índice, ayuda económica, campus, sexo y facultad. La transición normal entre programas equivalentes de ciencias de la salud no entra al scoring de riesgo: confundirla con abandono habría inflado el drama y mentido al dashboard. El holdout fue temporal, no aleatorio. En datos académicos, barajar filas mezcla el futuro con el pasado y produce una precisión que no se puede gastar [6], [12]. El trade-off es una prueba más honesta y, a veces, un número menos lisonjero.

El consumo se diseñó para no crear un tercer silo. El mart se consulta con el motor SQL del lakehouse. Los dashboards leen ese mart. Los experimentos de series temporales y de clasificación se registran con identificadores de corrida. Las compuertas de calidad se colocaron donde duele: contrato de columnas al aterrizar, consistencia semántica al curar, y no publicar si el mart no cumple el umbral acordado. No se usaron identificadores más allá de los necesarios para el grano. No se trajo correo ni texto libre de plataformas de aula. No se prometió personalización clínica. El beneficio de lo abierto no incluye, en este prototipo, un producto de bienestar estudiantil con datos de salud [3], [11].

Lo que el prototipo llegó a medir

Las métricas de holdout que siguen describen el experimento de evaluación del prototipo. Las figuras de este apartado, en cambio, muestran un banco sintético de demostración: mismas formas de análisis, volúmenes distintos, leyendas etiquetadas como sintéticas. No se afirma que el error de matrícula se mantenga en producción ni que el clasificador sustituya al criterio de orientación [1], [5]. El prototipo corre en local. Eso limita la generalización y, a la vez, obliga a un contrato repetible: si se refresca el extracto, se puede volver a publicar el mart y comparar.

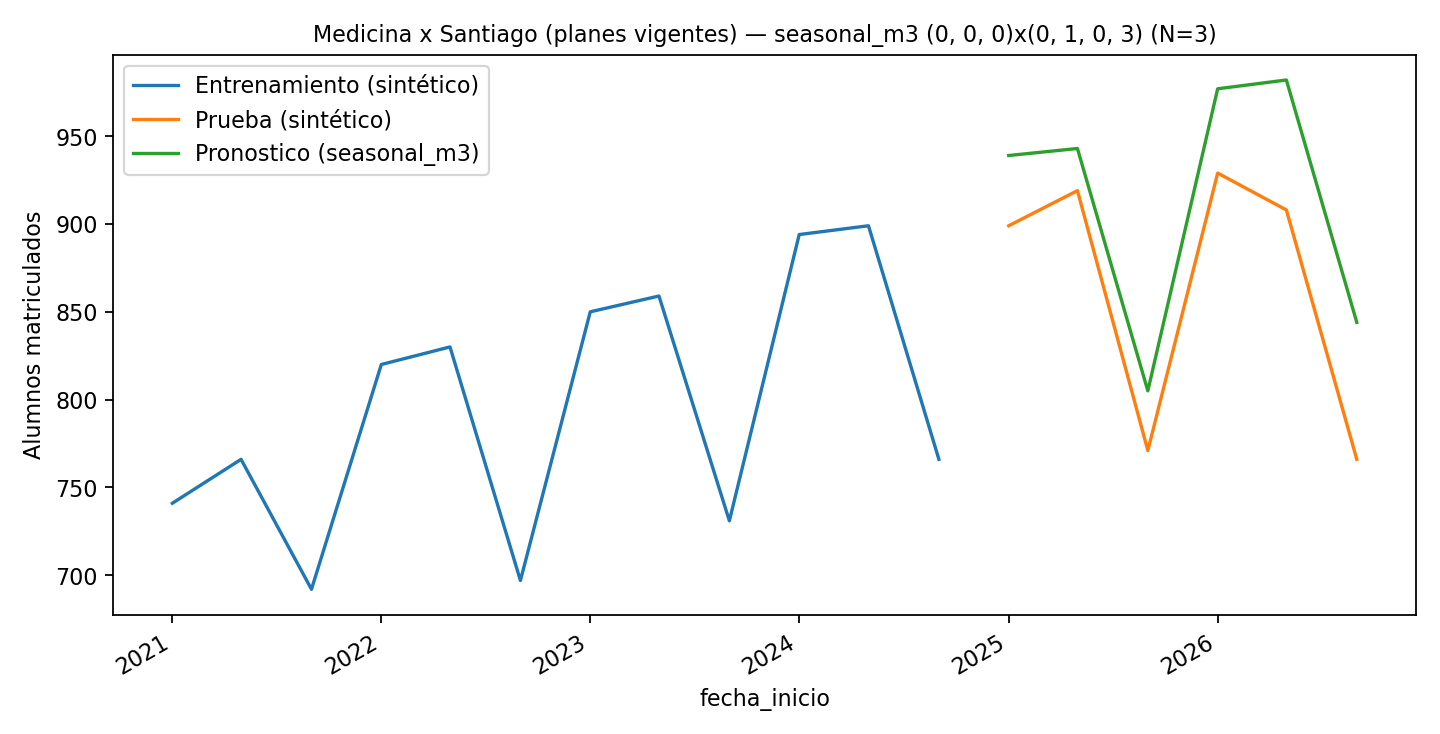
En Medicina, campus Santiago, el candidato estacional de tres periodos replicó el ritmo de inscripción en la prueba. El error absoluto medio fue de 32 alumnos y el error porcentual absoluto medio, de 3,0 por ciento. El historial de entrenamiento, el holdout y la proyección se leen en la misma gráfica. El ciclo académico se ve. Eso es lo que la planificación puede usar como insumo, no como oráculo [15].

Gráfica de matrícula de Medicina en Santiago: entrenamiento, prueba y pronóstico estacional
Figura 5. Proyección de matrícula, Medicina, campus Santiago. Banco sintético de demostración.

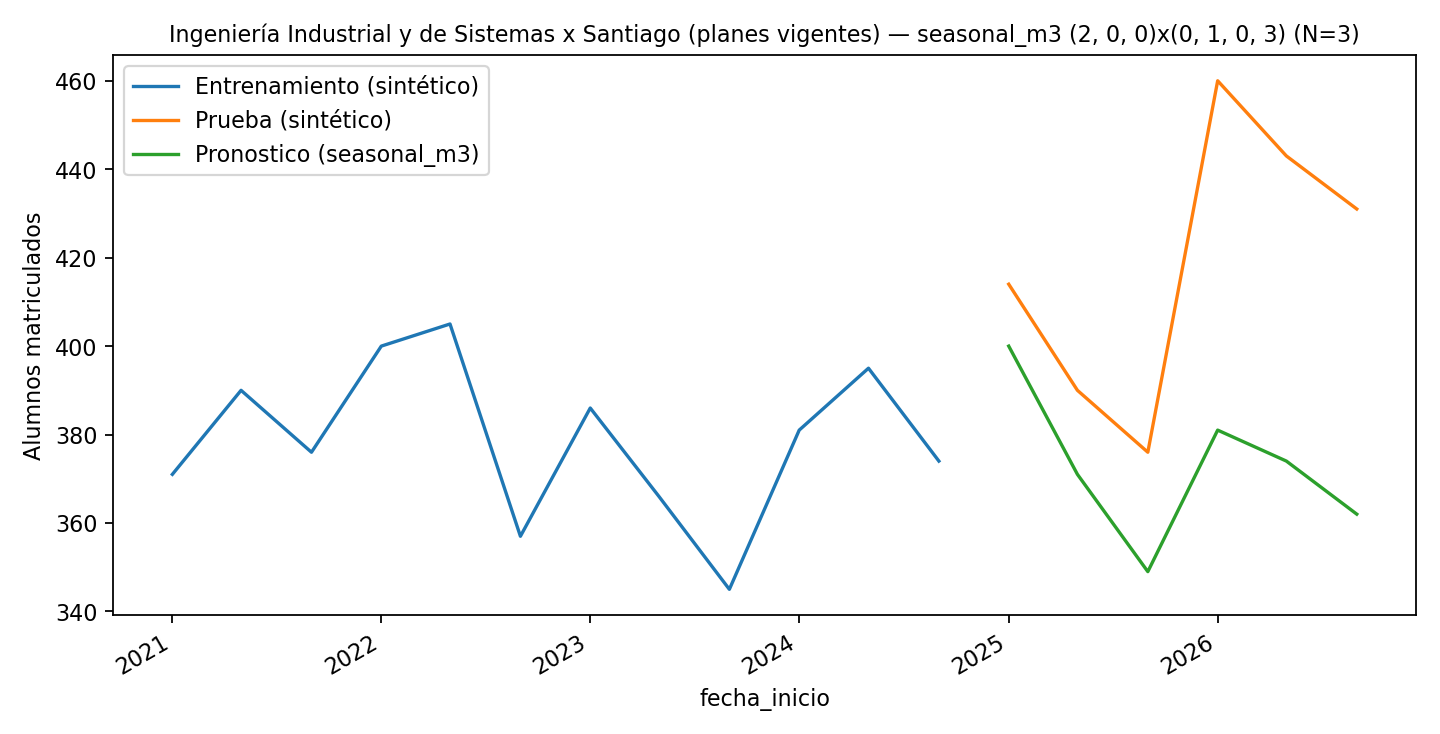
Ingeniería Industrial y de Sistemas, en el mismo campus, usó el mismo tipo de modelo estacional. El pronóstico sigue el diente de sierra académico, pero en el tramo final de la prueba la matrícula de holdout se separó al alza. El error porcentual absoluto medio subió a 8,5 por ciento y el error absoluto medio, a 21,1 alumnos. El modelo no “falló el calendario”. Falló el nivel en un tramo. Esa distinción importa si alguien pretende dimensionar la oferta con una serie frágil. En Santo Domingo, Medicina marcó 1,7 por ciento de error porcentual absoluto medio e Ingeniería Industrial y de Sistemas, 14,8 por ciento con candidato no estacional.

Gráfica de matrícula de Ingeniería Industrial y de Sistemas en Santiago: entrenamiento, prueba y pronóstico estacional
Figura 6. Proyección de matrícula, Ingeniería Industrial y de Sistemas, campus Santiago. Banco sintético de demostración.

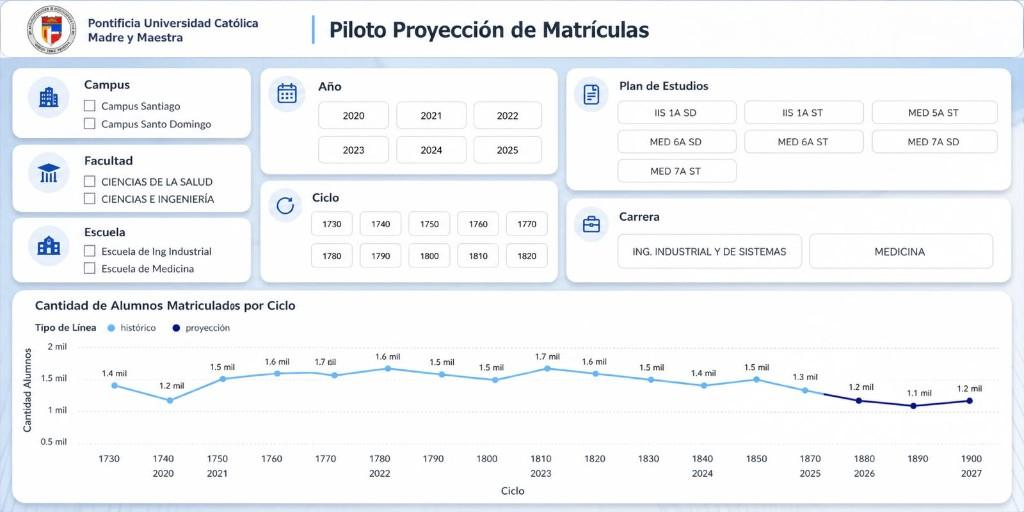
El mayor logro técnico de este caso no es el número más bajo. Es que ambos algoritmos leyeron la compacta de la capa curada. El científico no reescribió la limpieza. El dashboard de proyección, conectado al mart mediante el motor SQL, concentra histórico y proyección de las dos carreras del piloto. El beneficio institucional es poder ver demanda sin interrogar el sistema de matrícula en vivo [5], [8].

Dashboard de proyección de matrículas con filtros de campus, año, plan de estudios y la serie histórica y proyectada por ciclo
Figura 7. Dashboard de proyección de matrícula. Captura de demostración con volúmenes sintéticos.

En clasificación, el holdout temporal eligió aumento de gradiente. Exactitud 0,857, medida F1 0,909 y área bajo la curva ROC 0,867. El bosque aleatorio quedó cerca en área bajo la curva, 0,860. La regresión logística alcanzó precisión 0,939 a costa de un recall de 0,650. No se eligió el modelo más “preciso” en un cartel. Se eligió el que mejor equilibró discriminación y exhaustividad sobre datos no vistos en el tiempo. Ese criterio es más aburrido y más usable que coronar un campeón por una sola métrica [6], [11]. El área bajo la curva indica discriminación útil en prueba. No indica el umbral de intervención. Ese umbral es política de orientación, no un parámetro que el prototipo imponga.

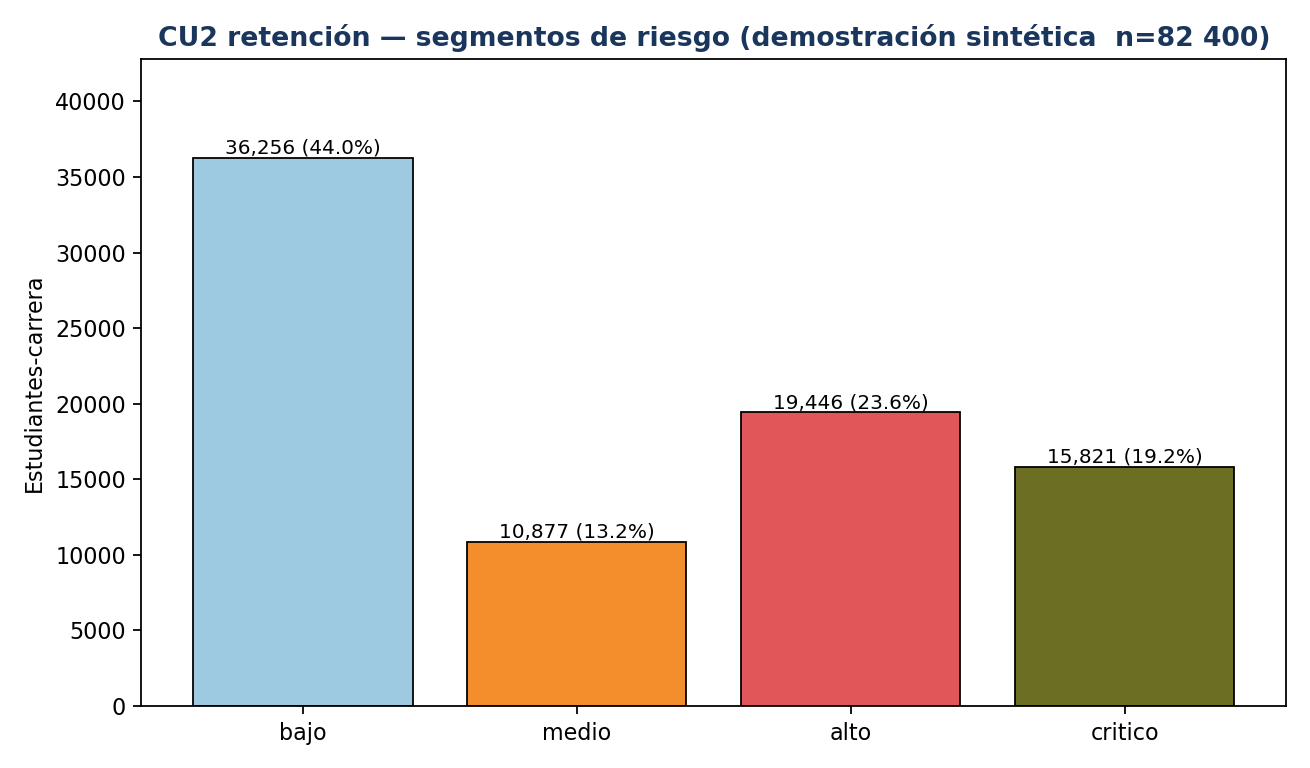
El scoring publicado es otro objeto. En el banco de demostración son 82 400 filas estudiante-carrera, con 44,0 por ciento en riesgo bajo, 13,2 por ciento medio, 23,6 por ciento alto y 19,2 por ciento crítico. Alto y crítico suman 42,8 por ciento. Mezclar ese universo con el holdout sería deshonesto [11], [12].

Gráfico de barras con los segmentos de riesgo bajo, medio, alto y crítico del scoring de retención
Figura 8. Segmentos de riesgo del scoring publicado.

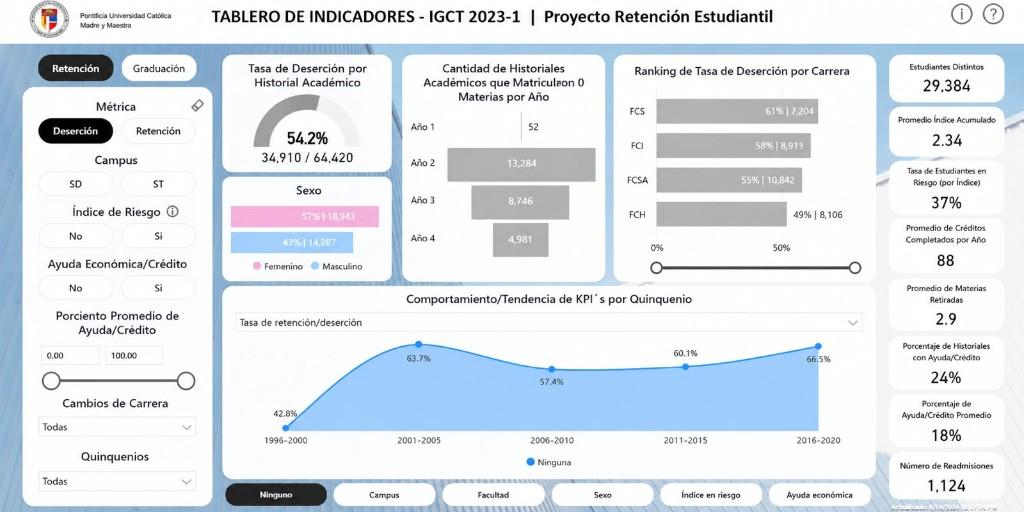
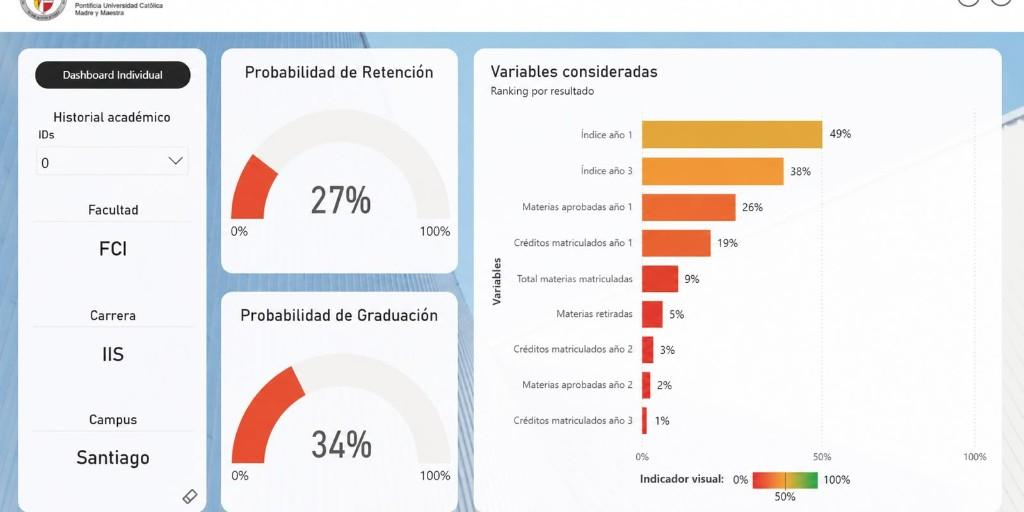
El dashboard de retención tiene dos caras, y conviene no mezclarlas. La vista agregada diagnostica deserción descriptiva por sexo, facultad y quinquenio. La vista individual prioriza un historial de ejemplo. Juntas, cierran el ciclo de consumo: el mart se lee en inteligencia de negocios, no se reanaliza en una hoja suelta. Los KPI del dashboard descriptivo no son las métricas del clasificador. Las capturas que siguen son de demostración: no deben citarse como deserción institucional [1], [11].

Dashboard de retención estudiantil con tasa de deserción, distribución por sexo y facultad y tendencia por quinquenio
Figura 9. Dashboard de retención, vista general. Captura de demostración con indicadores sintéticos.
Dashboard individual con probabilidad de retención, probabilidad de graduación y variables consideradas
Figura 10. Dashboard de retención, vista individual.

Ejemplo sintético (IIS, FCI, Santiago): retención 27 por ciento y graduación 34 por ciento. El indicador de graduación es un proxy de dashboard, no el target k a k+1 del clasificador.

Lo que no salió como se pensó

Tres resultados no estaban en el plan. El acceso seguro al sistema académico no se sostuvo: quedó como prueba de diagnóstico y el extracto fuera de línea cargó con el piloto. El dominio clínico del anteproyecto dejó de aportar en cuanto los historiales académicos bastaron para cerrar los dos casos. Y en el dashboard de riesgo hubo que calibrar por índice académico; sin esa regla, el scoring subestima la exigencia de la prueba y distorsionaba la cola de acompañamiento. Ninguno de los tres es un fracaso de la arquitectura abierta. Son el tipo de hallazgo que solo aparece cuando se implementa, no cuando se dibuja la lámina.

Qué gana una institución si copia el método, no la etiqueta

El prototipo demuestra algo más modestamente útil que declarar a la universidad “orientada por datos”. Demuestra que extractos académicos pueden aterrizar, curarse en un modelo dimensional y alimentar, sin rehacer la limpieza, un modelo de matrícula y un clasificador de retención, con dashboards que leen el mart. La separación de almacenamiento y cómputo evitó saturar el sistema transaccional con analítica. La separación de espacios de trabajo evitó el monolito en el que matrícula y deserción se pisan el esquema. Las métricas, imperfectas y desiguales entre series, son suficientes para una prueba de concepto e insuficientes para fijar política de cupos o de expulsión [5], [14], [15].

Los beneficios concretos, si otra IES adopta el patrón, se pueden enumerar sin inflar el lenguaje. Primero, soberanía del dato: el formato abierto y el aterrizaje propio reducen la hipoteca a un único fabricante [9], [17]. Segundo, no competir con el ERP: la consulta pesada vive fuera del trámite [8]. Tercero, reproducibilidad en hardware heterogéneo, gracias a contenedores y a corridas con identificador. Cuarto, un contrato de consumo: el científico lee compactas, el dashboard lee el mart, y el linaje explica de dónde salió el número. Quinto, dos productos de decisión sobre la misma plataforma, lo que abarata el segundo dominio respecto de empezar de cero. Sexto, evidencia de calidad por corrida, no una foto de un dashboard sin fecha. Nada de eso requiere declarar una transformación digital nacional. Requiere disciplina de grano y de capas [4], [10], [16].

El aprendizaje más exportable no es el nombre de un contenedor. Es ese contrato. Donde no existe, el siguiente estudiante volverá a unir archivos planos. Donde existe, se puede cambiar el modelo y conservar el linaje. Esa es la diferencia entre un cuaderno brillante y una plataforma, aunque la plataforma aún quepa en un computador portátil [5], [14]. Hay un límite de honestidad que conviene no cruzar. El prototipo no demostró que integrar todas las fuentes de la universidad aumente la precisión de los modelos. Demostró dos dominios académicos con extractos definidos. Tampoco demostró políticas de seguridad de acceso en un directorio institucional. El aislamiento fue el del equipo local. Quien cite este trabajo como si ya hubiera un hub nacional de datos universitarios estará leyendo la estrategia, no el entregable [16].

Como trabajo futuro, el prototipo pide un conector de solo lectura al sistema académico, con ventanas controladas, sin abandonar el aterrizaje. Pide una historia más larga antes de usar series frágiles para dimensionar la oferta. Pide promover el espacio de exploración al mart con contratos automáticos, y versionar las reglas de negocio de retención junto al modelo. Un piloto de agendado del orquestador puede venir después. Afirmar hoy operación continua sería adelantar un resultado que no se midió. Migrar a servidores institucionales, con roles de acceso y sin identificadores personales de más, es el paso que convierte esta prueba en capacidad de la universidad, no en un entregable de curso.

Quien administra tecnología en una institución suele preguntar, con razón, cuánto cuesta y quién lo opera. Este prototipo no cotiza un contrato de soporte. Cotiza una lección de diseño: el costo de no tener capa analítica ya se paga, en horas de extractos y en decisiones tomadas con el archivo del cuatrimestre anterior. Lo abierto desplaza ese costo hacia un contrato interno que se puede auditar. El personal mínimo no es un equipo de veinte. Es alguien que defienda el grano, alguien que publique el mart y alguien de negocio que lea el dashboard sin pedir una nueva unión. Si esa tríada no existe, ninguna pila, abierta o cerrada, sostiene el beneficio [1], [5], [16].

Quien lea esto desde otra institución de educación superior no necesita copiar la pila. Necesita copiar la disciplina: una fuente, un grano por pregunta, una capa que no se reescribe en el dashboard, y métricas que se atreven a ser malas en una serie si eso es lo que el holdout mostró. El llamado es prosaico y, por eso, viable. Repetir el piloto en un siguiente ciclo lectivo, con un extracto fresco y un usuario de planificación sentado al lado del dashboard, antes de hablar de inteligencia artificial oficial.

Referencias

  1. S. Gaftandzhieva, S. Hussain, S. Hilcenko, R. Doneva, y K. Boykova, «Data-driven Decision Making in Higher Education Institutions: State-of-play», Int. J. Adv. Comput. Sci. Appl., vol. 14, n.º 6, pp. 400–411, 2023, doi: 10.14569/IJACSA.2023.0140645.
  2. B. Daniel, «Big Data and analytics in higher education: Opportunities and challenges», Br. J. Educ. Technol., vol. 46, n.º 5, pp. 904–920, 2015, doi: 10.1111/bjet.12230.
  3. S. Z. Salas-Pilco y Y. Yang, «Artificial intelligence applications in Latin American higher education: a systematic review», Int. J. Educ. Technol. High. Educ., vol. 19, n.º 1, p. 21, 2022, doi: 10.1186/s41239-022-00326-w.
  4. G. Vial, «Understanding digital transformation: A review and a research agenda», J. Strateg. Inf. Syst., vol. 28, n.º 2, pp. 118–144, 2019, doi: 10.1016/j.jsis.2019.01.003.
  5. H. Chen, R. H. L. Chiang, y V. C. Storey, «Business Intelligence and Analytics: From Big Data to Big Impact», MIS Q., vol. 36, n.º 4, pp. 1165–1188, 2012, doi: 10.2307/41703503.
  6. O. Zawacki-Richter, V. I. Marín, M. Bond, y F. Gouverneur, «Systematic review of research on artificial intelligence applications in higher education – where are the educators?», Int. J. Educ. Technol. High. Educ., vol. 16, n.º 1, p. 39, 2019, doi: 10.1186/s41239-019-0171-0.
  7. L. E. Contreras Bravo, J. I. Rodríguez Molano, y H. J. Fuentes López, «Analítica académica: nuevas herramientas aplicadas a la educación», Rev. Bol. Redipe, vol. 10, n.º 3, pp. 137–158, 2021, doi: 10.36260/rbr.v10i3.1228.
  8. A. A. Munshi y A. Alhindi, «Big Data Platform for Educational Analytics», IEEE Access, vol. 9, pp. 52883–52890, 2021, doi: 10.1109/ACCESS.2021.3070737.
  9. N. Janssen, T. Ilayperuma, J. Jayasinghe, F. Bukhsh, y M. Daneva, «The evolution of data storage architectures: examining the secure value of the Data Lakehouse», J. Data Inf. Manag., vol. 6, 2024.
  10. R. Kimball y M. Ross, The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling, 3.ª ed. Indianapolis, IN, EE. UU.: Wiley, 2013.
  11. J. Guerra et al., «Adaptation and evaluation of a learning analytics dashboard to improve academic support at three Latin American universities», Br. J. Educ. Technol., vol. 51, n.º 4, pp. 973–1004, 2020, doi: 10.1111/bjet.12935.
  12. G. B. N. Silva, «Deserción estudiantil en Institutos Superiores Tecnológicos de Ecuador: Una revisión de la literatura», Rev. Latinoam. Ogmios, vol. 3, n.º 8, pp. 25–32, 2023, doi: 10.53595/rlo.v3.i8.084.
  13. B. Williamson, «Policy networks, performance metrics and platform markets: Charting the expanding data infrastructure of higher education», Br. J. Educ. Technol., vol. 50, n.º 6, pp. 2794–2809, 2019, doi: 10.1111/bjet.12861.
  14. M. Armbrust et al., «Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics», en Proc. 11th Conf. Innovative Data Syst. Res. (CIDR), 2021.
  15. R. J. Hyndman y G. Athanasopoulos, Forecasting: Principles and Practice, 3.ª ed. Melbourne, Australia: OTexts, 2021.
  16. J. Komljenovic, S. Sellar, y K. Birch, «Turning universities into data-driven organisations: seven dimensions of change», High. Educ., vol. 89, n.º 5, pp. 1369–1386, 2025, doi: 10.1007/s10734-024-01277-z.
  17. P. Dubey, «The Data Lakehouse: An Evolving Paradigm in Data Architecture», Int. J. Comput. Eng., vol. 7, n.º 10, pp. 30–47, 2025, doi: 10.47941/ijce.2958.
  18. W. Villegas-Ch, X. Palacios-Pacheco, y S. Luján-Mora, «Application of a Smart City Model to a Traditional University Campus with a Big Data Architecture: A Sustainable Smart Campus», Sustainability, vol. 11, n.º 10, p. 2857, 2019, doi: 10.3390/su11102857.

DriveSense: Sistema Inteligente para la Clasificación de Perfiles de Conducción mediante Inteligencia Artificial

Iván Paul Marcelino y Juan Alfonso Alvarado Batista – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La seguridad vial continúa siendo uno de los principales retos asociados a los sistemas de transporte. La forma en que una persona acelera, frena, gira, mantiene la velocidad o reacciona ante una situación inesperada puede influir directamente en el nivel de riesgo de un recorrido. A escala internacional, los siniestros de tránsito continúan generando una elevada cantidad de muertes y lesiones, mientras que factores relacionados con el comportamiento humano permanecen entre los elementos de mayor interés para su prevención [1], [2]. Dentro de este contexto, el análisis del comportamiento del conductor mediante herramientas tecnológicas se ha convertido en una línea de investigación capaz de transformar acciones que tradicionalmente eran observadas de forma subjetiva en información cuantificable que puede ser estudiada mediante técnicas estadísticas y computacionales [6], [9].

En respuesta a esta problemática surge DriveSense, proyecto desarrollado por Iván Paul Marcelino y Juan Alfonso Alvarado Batista, estudiantes de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del ingeniero Rafael Omar Batista Jorge y dentro de la Escuela de Ingeniería en Computación y Telecomunicaciones. DriveSense fue concebido como un sistema para capturar, procesar y analizar datos de conducción generados dentro de un entorno de simulación controlado, con el propósito de identificar patrones y clasificar el comportamiento observado en diferentes perfiles. En lugar de limitarse a registrar una puntuación final, la propuesta integra la adquisición de telemetría, el procesamiento de los datos, el entrenamiento de modelos de aprendizaje automático y la presentación de resultados mediante una plataforma web.

El uso de simuladores ofrece una ventaja importante al estudiar este tipo de comportamiento. Determinadas situaciones que serían difíciles, costosas o inseguras de reproducir intencionalmente en una vía pública pueden ejecutarse de manera controlada dentro de un entorno virtual. Investigaciones previas han demostrado la utilidad de los simuladores para estudiar aspectos relacionados con la velocidad, las curvas y la respuesta de los conductores bajo condiciones repetibles [3]–[5]. Esta característica permite que distintos participantes realicen sesiones bajo condiciones previamente definidas y que los datos obtenidos puedan ser comparados sin exponer a los usuarios ni a terceros a las consecuencias de provocar deliberadamente una situación de riesgo real.

La motivación de DriveSense parte precisamente de combinar esa capacidad experimental con las posibilidades actuales del análisis de datos. Durante una sesión de conducción pueden generarse miles de observaciones relacionadas con velocidad, aceleración, frenado, dirección y otras variables del vehículo. Analizadas de forma aislada, estas señales pueden resultar difíciles de interpretar. Sin embargo, al organizarlas temporalmente y utilizar modelos capaces de reconocer patrones, es posible construir una representación más detallada de la forma en que una persona conduce [6], [12]. DriveSense utiliza este principio para transformar la telemetría producida durante una sesión en información que pueda ser consultada, comparada e interpretada posteriormente.

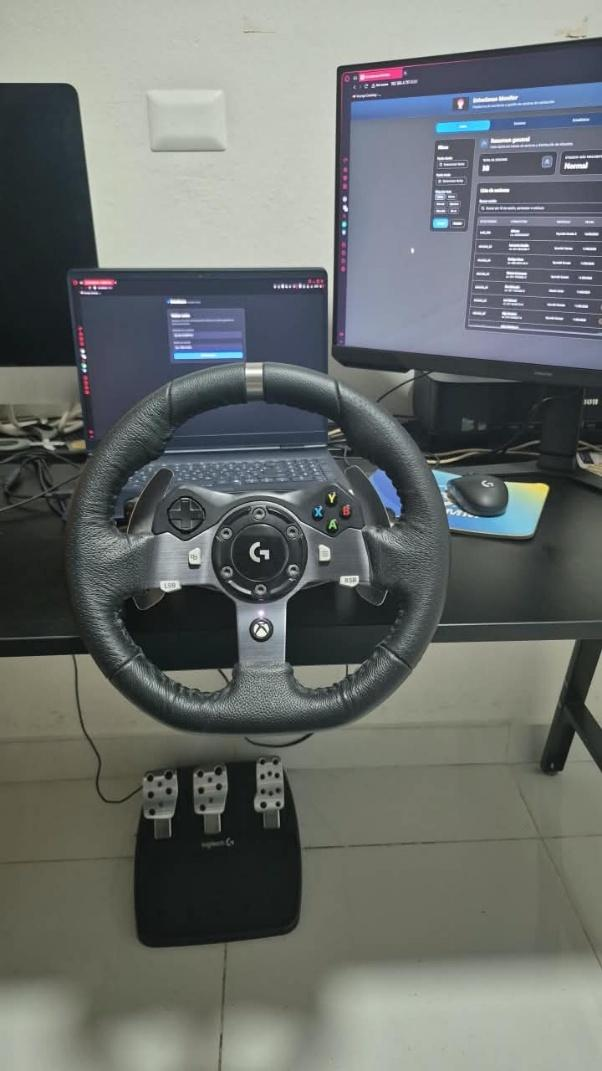
Puesto de simulación con volante, pedales y monitores que muestran el simulador y la plataforma DriveSense
Figura 1. Entorno utilizado para realizar una sesión de conducción con DriveSense, mostrando el simulador y la plataforma desarrollada.

Del problema vial al análisis inteligente del comportamiento

En la República Dominicana, la seguridad vial constituye una problemática especialmente relevante. El exceso de velocidad, las maniobras imprudentes, las aceleraciones repentinas, las frenadas intensas y diferentes formas de conducción agresiva pueden aumentar tanto la probabilidad de un incidente como la gravedad de sus consecuencias. A esto se agregan situaciones comunes en las que el conductor debe reaccionar rápidamente ante congestión, cambios de carril de otros vehículos, obstáculos o modificaciones inesperadas en el flujo del tránsito. Aunque muchas de estas conductas pueden identificarse mediante observación, convertirlas en información cuantitativa permite analizarlas con un mayor nivel de detalle y conservar un registro de lo ocurrido durante diferentes momentos de un recorrido.

Los métodos convencionales para valorar el desempeño de un conductor dependen en gran medida de la observación directa, de evaluaciones realizadas durante un período limitado o de información obtenida después de un incidente. Estos mecanismos continúan siendo necesarios, pero presentan limitaciones cuando se desea estudiar con precisión cómo cambió el comportamiento durante una sesión. Una evaluación humana puede indicar que una persona condujo de manera insegura, por ejemplo, pero los datos de telemetría permiten complementar esa observación indicando cuándo ocurrió una aceleración brusca, cuál era la velocidad en ese momento, cuánto se utilizó el freno o cómo varió la dirección. Esta posibilidad ha impulsado el desarrollo de investigaciones que utilizan información del vehículo para reconocer diferentes patrones de manejo [6], [12].

La literatura relacionada con el perfilado de conductores ha evolucionado progresivamente desde reglas construidas sobre unas pocas variables hacia métodos capaces de estudiar grandes cantidades de información. La clasificación de comportamientos mediante aprendizaje automático permite encontrar relaciones que pueden resultar difíciles de representar utilizando únicamente límites fijos o promedios generales [9], [11]. Diferentes investigaciones han utilizado telemetría vehicular para estudiar estilos de conducción, mientras que otros trabajos han incorporado métodos de ensemble y aprendizaje profundo con el propósito de representar relaciones más complejas entre las características disponibles [13], [15]. En todos estos casos, la calidad de los resultados depende no solamente del algoritmo utilizado, sino también de la forma en que los datos fueron capturados, organizados y preparados.

Precisamente, uno de los retos encontrados durante el desarrollo de DriveSense fue la ausencia de un conjunto de datos que reuniera exactamente las variables, condiciones experimentales y categorías requeridas por el proyecto. Los datasets disponibles en investigaciones previas fueron construidos bajo vehículos, sensores, poblaciones, carreteras y criterios de clasificación diferentes. Utilizar uno de ellos directamente habría significado adaptar el proyecto a condiciones que no necesariamente correspondían con el experimento propuesto. Por esta razón, se decidió construir un dataset propio mediante sesiones realizadas por participantes dentro del simulador, manteniendo un procedimiento común de captura y criterios previamente establecidos para representar los comportamientos estudiados.

Otro aspecto relevante es la dimensión temporal de la conducción. Un conductor no mantiene necesariamente el mismo comportamiento durante todo un recorrido. Una sesión que globalmente parece normal puede incluir algunos segundos de agresividad, distracción o conducción pasiva. Trabajos recientes han reforzado la importancia de estudiar secuencias y patrones temporales en lugar de representar toda una conducción mediante un único promedio [12], [13]. DriveSense adopta esta idea dividiendo la información en ventanas temporales. Cada ventana resume una parte de la sesión y posteriormente puede ser evaluada de forma independiente, permitiendo reconstruir cómo fue cambiando el comportamiento durante el recorrido completo.

Esta aproximación también responde a una necesidad de interpretabilidad. En una aplicación relacionada con personas y seguridad no resulta suficiente presentar únicamente una etiqueta generada por un algoritmo. Es importante conservar las métricas que dieron origen al análisis y disponer de mecanismos que ayuden a entender por qué el sistema produce determinados resultados. La inteligencia artificial explicable ha adquirido relevancia justamente por la necesidad de comprender la influencia que tienen diferentes características dentro de las predicciones [17], [20]. Por esta razón, DriveSense incorporó SHAP como técnica complementaria para estudiar la participación de las variables en las decisiones del modelo, manteniendo separada la predicción del proceso utilizado para explicarla.

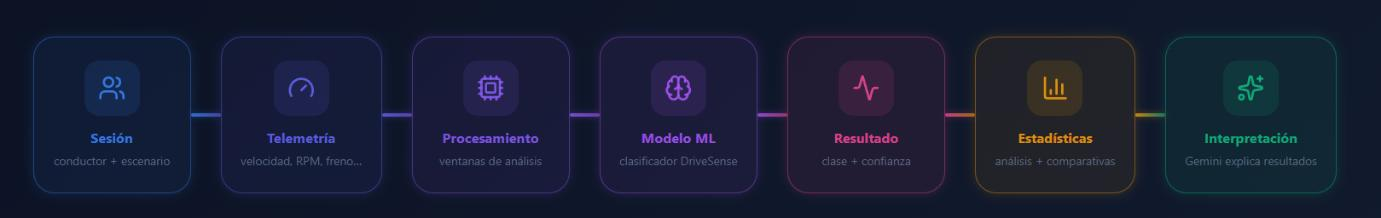
Esquema en etapas: sesión, telemetría, procesamiento, modelo ML, resultado, estadísticas e interpretación
Figura 2. Esquema general del problema abordado: comportamiento del conductor, generación de telemetría, procesamiento de los datos y clasificación del perfil.

El desarrollo de DriveSense permitió cumplir el objetivo de construir una solución inteligente orientada a la clasificación de perfiles de conducción a partir de datos de telemetría obtenidos en un entorno de simulación controlado. Para lograrlo, se diseñó una arquitectura capaz de capturar, estructurar y almacenar telemetría vehicular a una frecuencia de 20 Hz; se implementaron mecanismos para analizar estadísticamente las variables obtenidas y estudiar sus diferencias entre sesiones y grupos de conductores; se desarrolló un proceso para entrenar y evaluar modelos supervisados de aprendizaje automático; y se incorporaron mecanismos para representar cuantitativamente los resultados, conservar las diferentes versiones de los modelos, analizar la influencia de las características y presentar la información al usuario mediante una plataforma centralizada. De esta manera, el objetivo general se desglosó en componentes medibles y verificables que abarcan el ciclo completo desde la generación del dato hasta la interpretación del resultado.

De una sesión simulada a un sistema completo de datos

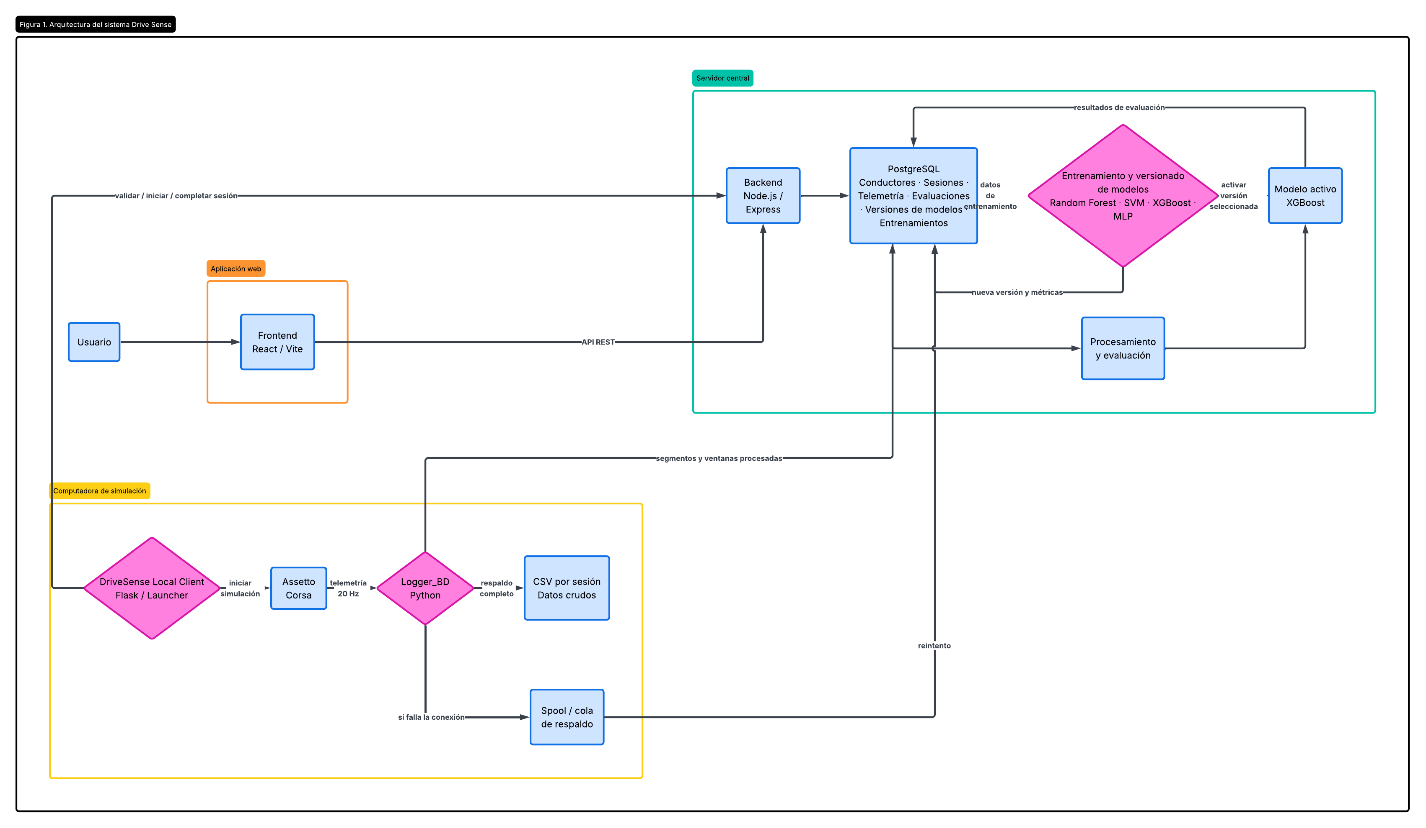
El funcionamiento de DriveSense comienza antes de que el conductor inicie el recorrido. Desde la aplicación web se registra o selecciona al participante y se crea una nueva sesión indicando la información necesaria para la prueba, incluyendo el escenario y el vehículo que serán utilizados. Esta sesión queda registrada en el servidor con un estado inicial y puede ser validada posteriormente desde la computadora encargada de ejecutar la simulación. Esta separación permite mantener un registro de cada prueba y relacionar los datos producidos posteriormente con el conductor y las condiciones correspondientes, evitando que los archivos de telemetría queden aislados de su contexto experimental.

En la computadora de simulación se utiliza DriveSense Local Client, componente encargado de validar que la sesión corresponde con la información registrada en el servidor y preparar el entorno necesario para realizarla. Una vez completada la validación, el cliente inicia los componentes requeridos para trabajar con Assetto Corsa y entrega a Logger_BD la configuración asociada a la sesión. Durante este proceso, la sesión puede pasar por distintos estados, permitiendo que la plataforma conozca si se encuentra pendiente, en ejecución o completada. Este mecanismo también disminuye la cantidad de configuraciones que el usuario debe introducir manualmente en la computadora donde se realiza la prueba.

Diagrama de arquitectura de DriveSense: aplicación web, servidor, Local Client, Assetto Corsa, Logger_BD, almacenamiento y clasificación
Figura 3. Arquitectura general de DriveSense y comunicación entre la aplicación web, el servidor, DriveSense Local Client, Assetto Corsa, Logger_BD, el almacenamiento y el componente de clasificación.

Una vez iniciada la conducción, Logger_BD obtiene información directamente desde la telemetría generada por Assetto Corsa. La captura se realiza a una frecuencia de 20 Hz, equivalente a veinte muestras por segundo. Entre las variables registradas se encuentran velocidad, revoluciones por minuto, acelerador, freno, dirección y valores relacionados con la dinámica del vehículo. Esta frecuencia permite observar variaciones que podrían perderse si únicamente se conservaran valores globales al finalizar la sesión. La telemetría vehicular ha sido utilizada ampliamente como una fuente de información para reconocer comportamientos, ya que permite representar de forma cuantitativa las acciones ejecutadas durante la conducción [6], [12].

Los datos crudos de cada recorrido se conservan en archivos CSV, manteniendo un registro que puede utilizarse posteriormente para revisar una sesión o para construir nuevos conjuntos de entrenamiento. Paralelamente, DriveSense procesa la información y la organiza en segmentos y ventanas temporales que son almacenados en PostgreSQL. Esta combinación responde a dos necesidades diferentes: conservar la telemetría completa y, al mismo tiempo, disponer de una estructura más eficiente para consultas, evaluaciones y visualizaciones. De esta forma, no es necesario procesar nuevamente cada muestra del archivo original cada vez que se quiere consultar un resultado.

La arquitectura fue diseñada además para disminuir el riesgo de pérdida de información ante problemas de conectividad. Si durante una conducción el equipo de simulación no puede comunicarse temporalmente con el servidor, los datos pendientes permanecen almacenados de manera local. Cuando la comunicación vuelve a estar disponible, el sistema intenta enviarlos nuevamente. Esta estrategia permite que una interrupción de red no implique necesariamente perder la sesión completa. Mantener la persistencia de los datos fue considerado especialmente importante debido al esfuerzo requerido para reunir participantes y repetir las condiciones experimentales de una prueba.

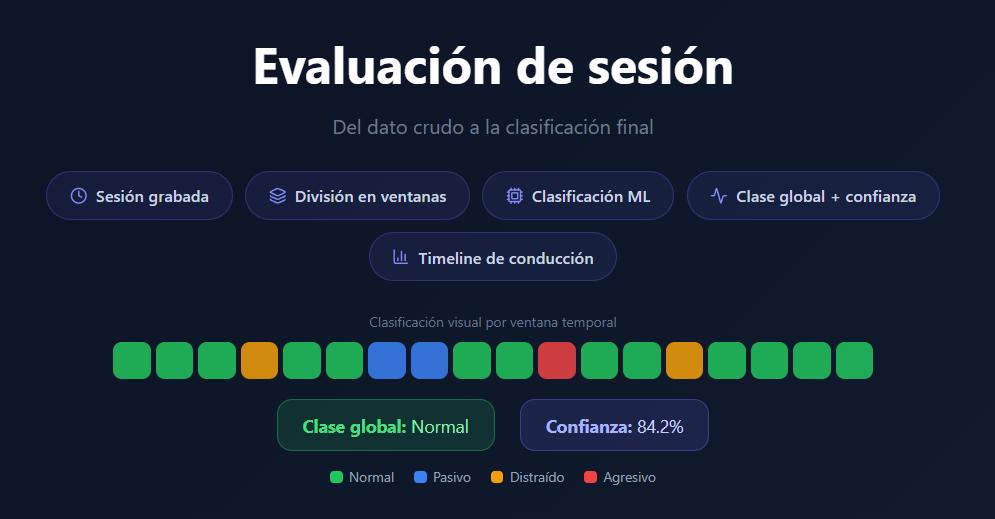
Evaluación de sesión: sesión grabada, división en ventanas, clasificación ML, clase global con confianza y línea de tiempo por ventana
Figura 4. Flujo de los datos desde la captura de telemetría hasta su almacenamiento, procesamiento, clasificación y presentación de resultados.

Una vez almacenada la telemetría, la información se transforma en características que puedan utilizarse en el proceso de clasificación. En lugar de introducir directamente una secuencia extensa de muestras individuales al modelo, las ventanas permiten obtener representaciones de intervalos concretos de la sesión. A partir de ellas pueden calcularse valores relacionados con la velocidad, el uso del acelerador y del freno, la dirección, la variabilidad del comportamiento y la presencia de determinados eventos. La ingeniería de características constituye una etapa fundamental en problemas de clasificación porque permite representar los datos originales de una manera adecuada para que los algoritmos puedan identificar diferencias entre clases [9], [12].

Para determinar qué método resultaba más apropiado para el conjunto de datos disponible, durante el proyecto se trabajó con diferentes algoritmos supervisados: Random Forest, Support Vector Machine (SVM), XGBoost y Multi-Layer Perceptron (MLP). Los modelos fueron entrenados utilizando las mismas características de entrada para permitir una comparación bajo condiciones equivalentes. Random Forest representa un método ampliamente utilizado para problemas de clasificación por su capacidad de combinar múltiples árboles de decisión y manejar relaciones no lineales [10]. XGBoost, por su parte, utiliza un enfoque de gradient boosting que ha demostrado un elevado rendimiento en problemas con datos estructurados [19].

El proceso de entrenamiento no se limitó a generar una única partición del dataset. Para evaluar los modelos se utilizó validación cruzada k-fold, dividiendo repetidamente la información disponible entre subconjuntos de entrenamiento y validación. Este procedimiento reduce la dependencia de una sola división de los datos y permite observar la estabilidad del desempeño del modelo. Para realizar la comparación se consideraron métricas como Accuracy, F1-score, ROC-AUC y matrices de confusión. Cada una aporta una perspectiva diferente: mientras Accuracy representa la proporción global de clasificaciones correctas, F1 permite considerar simultáneamente precisión y exhaustividad, y la matriz de confusión permite estudiar en cuáles categorías se producen los errores.

A medida que el proyecto evolucionó también cambió la definición del problema. Las primeras pruebas trabajaban con tres categorías principales, pero posteriormente se incorporó el comportamiento distraído, dando lugar a las cuatro clases finales utilizadas por DriveSense: agresivo, distraído, normal y pasivo. Este cambio implicó volver a entrenar y evaluar los modelos bajo la nueva estructura. Finalmente se seleccionó XGBoost como clasificador principal y se implementó un sistema de versionado que permite conservar los modelos producidos durante diferentes entrenamientos. En lugar de sustituir simplemente un archivo cada vez que se entrena nuevamente, DriveSense registra qué versión fue generada, con qué datos se construyó, cuáles fueron sus métricas y cuál se encuentra activa.

La interpretabilidad complementa este proceso mediante SHAP, técnica que permite estudiar cómo las características utilizadas contribuyen a las predicciones realizadas. La idea no es modificar la clasificación obtenida, sino proporcionar una herramienta adicional para analizar la participación de las variables dentro del modelo. SHAP se apoya en principios de teoría de juegos para asignar valores de contribución a las características y se ha convertido en una técnica reconocida dentro del campo de la inteligencia artificial explicable [20]. En DriveSense, esta información sirve como apoyo al análisis de las decisiones del clasificador y ayuda a evitar que el sistema sea presentado únicamente como una caja negra que produce etiquetas sin contexto.

Tarjeta de estado del modelo activo XGBoost v3 con horas de entrenamiento y métricas
Figura 5. Flujo metodológico empleado para la preparación de los datos, entrenamiento, validación, selección y versionado de los modelos de clasificación.

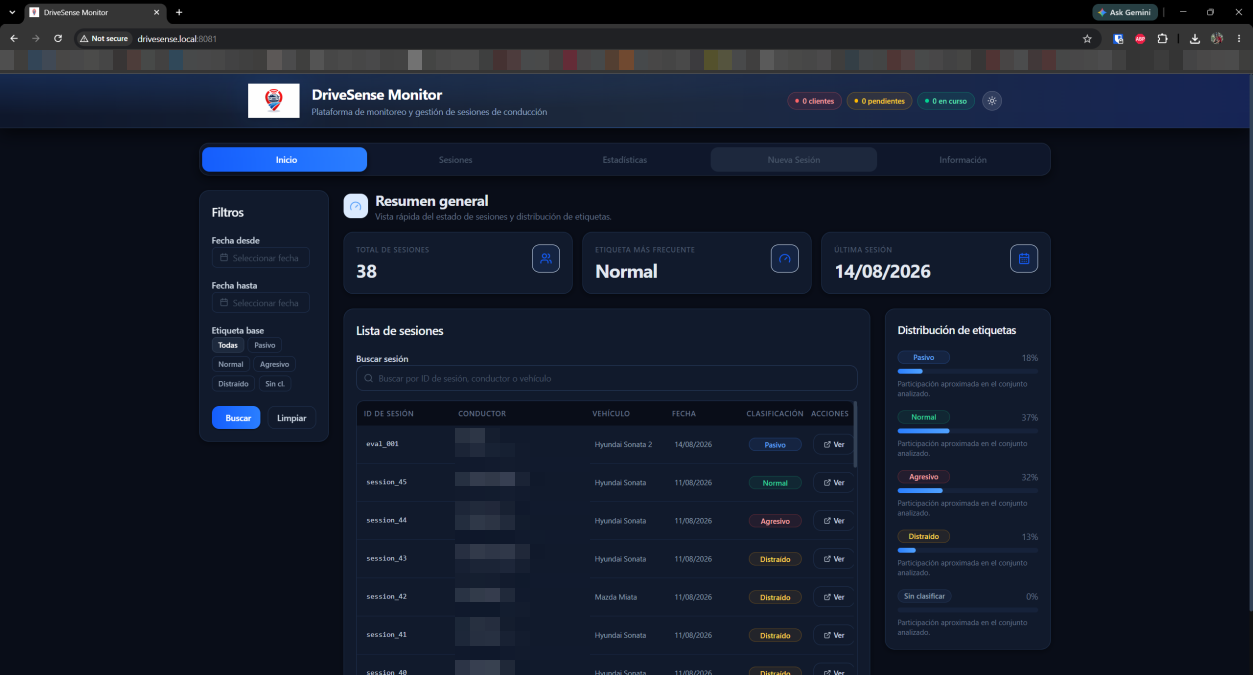
El sistema se completa mediante la plataforma web, desde la cual se pueden registrar conductores, crear nuevas sesiones, consultar recorridos anteriores, visualizar evaluaciones y acceder a estadísticas. La interfaz reúne información que originalmente se encuentra distribuida entre archivos, registros de base de datos, predicciones y métricas. Además, permite realizar comparaciones utilizando características como género y rango de edad, así como consultar las versiones existentes de los modelos y sus procesos de entrenamiento. Esta centralización facilita que DriveSense pueda utilizarse no solamente como un experimento aislado, sino como una plataforma que mantiene la trazabilidad de las pruebas efectuadas.

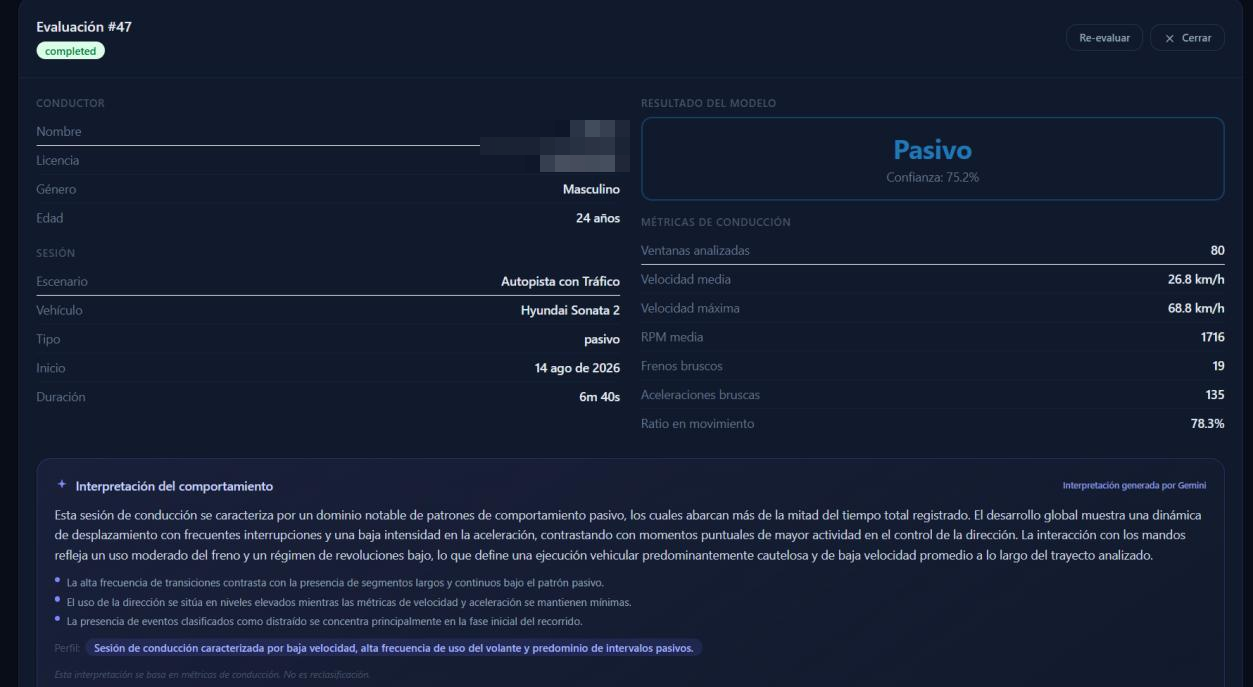
En las fases finales se incorporó adicionalmente una capa de interpretación mediante la API de Gemini. Esta funcionalidad surgió al observar que porcentajes, métricas y gráficas pueden resultar difíciles de comprender para usuarios sin experiencia en ciencia de datos. Es importante diferenciar claramente sus funciones: Gemini no clasifica al conductor, no modifica los resultados del modelo y no participa en el cálculo de las predicciones. DriveSense y XGBoost continúan siendo responsables del procesamiento y la clasificación; la API recibe únicamente resultados ya generados y los transforma en una explicación en lenguaje natural. El backend controla además la información compartida, evitando transmitir identificadores directos como el nombre o el número de licencia del participante.

Interfaz web DriveSense Monitor con el resumen general, la lista de sesiones y la distribución de etiquetas
Figura 6. Ejemplo de la interfaz web de DriveSense para la gestión de sesiones, consulta del modelo activo y visualización de información del sistema.

Resultados que muestran más que una etiqueta

Durante el desarrollo del componente de inteligencia artificial se realizaron distintas iteraciones hasta llegar a la configuración final. En una etapa inicial se evaluó una implementación basada en RAPIDS AI utilizando CPU y GPU. La variante ejecutada mediante CPU obtuvo un Accuracy de 96.66 %, un Macro F1-score de 0.62 y un Weighted F1-score de 0.76, con un tiempo de entrenamiento de aproximadamente 0.3561 segundos. Para el volumen de información utilizado en ese momento, la ejecución mediante GPU presentó un desempeño similar pero requirió un tiempo mayor, por lo que la aceleración mediante GPU no se mantuvo como una necesidad del sistema. Estos resultados también evidenciaron la importancia de analizar múltiples métricas: un valor elevado de Accuracy no implica necesariamente un comportamiento igualmente uniforme entre todas las categorías.

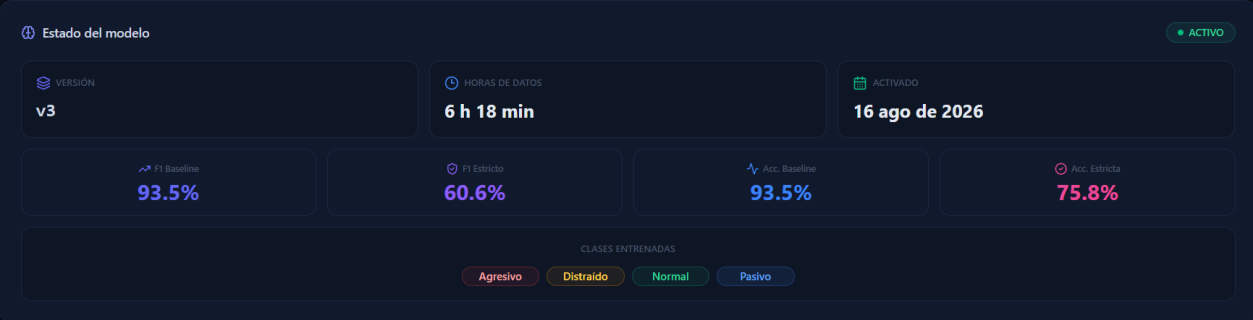
Posteriormente, el problema fue ampliado de tres a cuatro clases y se adoptó XGBoost como modelo principal. La versión activa XGBoost v3 fue entrenada utilizando 23 sesiones, equivalentes a aproximadamente 6 horas y 18 minutos de conducción. Esta versión obtuvo un Accuracy baseline de 93.49 % y un F1-score baseline de 93.45 %. Bajo el criterio de evaluación estricto se obtuvo un Accuracy de 75.82 % y un F1-score de 60.76 %. Adicionalmente, las predicciones del modelo presentan una confianza promedio cercana al 83 %. Las métricas de esta versión no deben compararse directamente con los valores de la etapa inicial, ya que fueron obtenidas utilizando diferente cantidad de clases, distintas configuraciones del conjunto de datos y un procedimiento de evaluación actualizado.

La diferencia entre las métricas baseline y las obtenidas bajo un criterio más estricto constituye un resultado importante del proyecto. Presentar únicamente la cifra más alta habría proporcionado una visión incompleta del rendimiento. La evaluación estricta permite observar que el problema se vuelve considerablemente más exigente cuando se establecen condiciones destinadas a reducir la posibilidad de que información demasiado relacionada aparezca simultáneamente en entrenamiento y validación. Esto ayuda a representar de manera más realista la capacidad de generalización del modelo y demuestra por qué la evaluación de un sistema de aprendizaje automático no debe resumirse exclusivamente mediante una sola métrica.

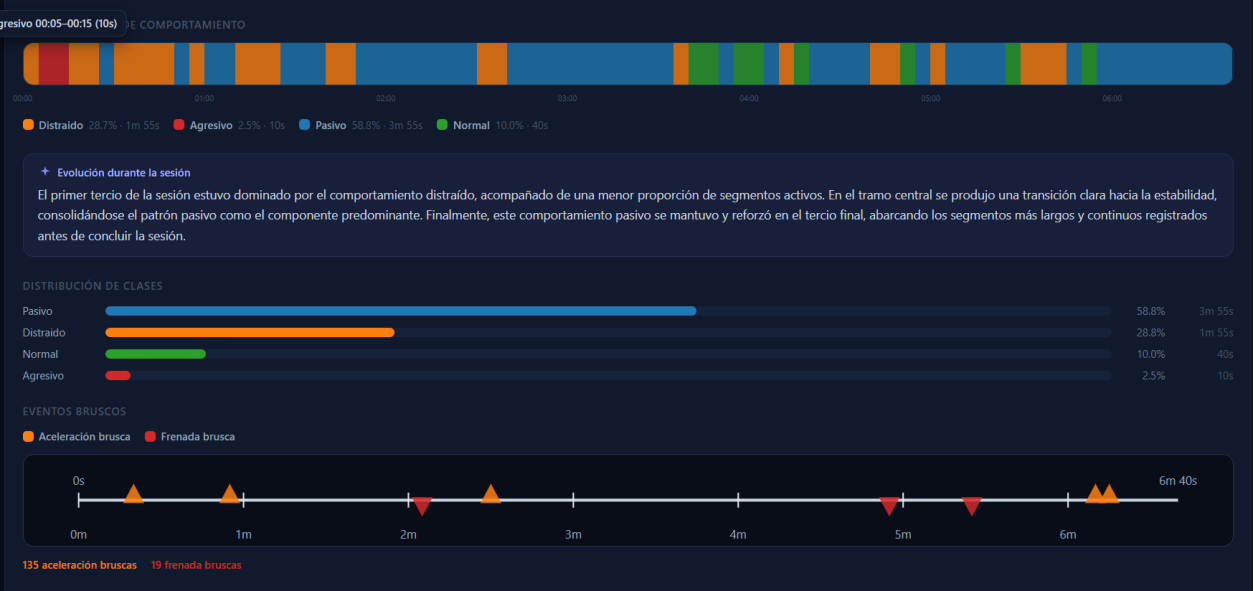
DriveSense tampoco limita el resultado a una única clasificación para toda la sesión. Cada una de las ventanas procesadas conserva su propio resultado, lo que permite construir una línea de tiempo del comportamiento. Como ejemplo, una de las sesiones analizadas fue clasificada globalmente como pasiva con un 75.2 % de confianza. Sin embargo, al estudiar sus 80 ventanas, se observó que el comportamiento pasivo representó el 58.8 % del tiempo evaluado, mientras que el comportamiento distraído correspondió al 28.7 %, el normal al 10.0 % y el agresivo al 2.5 %. La clasificación global resume el patrón predominante, mientras que la línea temporal permite identificar los cambios que ocurrieron durante el recorrido.

Este nivel de detalle representa una de las características más útiles de la solución. Dos sesiones podrían terminar con la misma clasificación general y, aun así, haber llegado a ese resultado mediante patrones diferentes. Una puede mantener un comportamiento relativamente uniforme y otra alternar repetidamente entre distintas clases. Por esta razón, la plataforma presenta conjuntamente la clasificación global, la confianza, las métricas de conducción, la distribución de comportamientos, los eventos detectados y los intervalos temporales. El propósito es que el resultado pueda examinarse desde diferentes perspectivas y no interpretar al conductor únicamente a partir de una etiqueta aislada.

Evaluación de una sesión clasificada como pasiva con 75.2 % de confianza, métricas de conducción e interpretación del comportamiento
Figura 7. Clasificación general y nivel de confianza de la sesión evaluada.
Línea de tiempo de la sesión por ventanas, distribución de comportamientos y eventos bruscos detectados
Figura 8. Evolución temporal, distribución de comportamientos y eventos detectados durante la sesión.
Gráfico radar que compara las características de conducción de la sesión con los perfiles de referencia
Figura 9. Comparación de las características de conducción e interpretación de sus valores respecto a los perfiles de referencia.

Los datos reunidos también hicieron posible realizar comparaciones descriptivas entre diferentes grupos de la muestra. Para la comparación por género se analizaron 26 sesiones correspondientes a conductores masculinos y 12 sesiones correspondientes a conductores femeninos. Entre las sesiones femeninas, la conducción normal representó aproximadamente el 42 %, seguida de la pasiva con 25 %, mientras que agresiva y distraída representaron alrededor de 17 % cada una. Entre las sesiones masculinas, la categoría agresiva alcanzó aproximadamente 39 %, la normal 35 %, la pasiva 15 % y la distraída alrededor de 11 %. Estos valores describen solamente el comportamiento de las sesiones disponibles y no deben interpretarse como una afirmación general sobre hombres y mujeres.

En la comparación por edad, el grupo de 20 a 29 años concentró la mayor cantidad de observaciones, con 23 sesiones. En este rango, el 39.1 % fue clasificado como agresivo, el 34.8 % como normal, el 21.7 % como pasivo y el 4.3 % como distraído. Para el grupo de 30 a 39 años se analizaron cinco sesiones, con un 40 % normal, 40 % distraído y 20 % agresivo. En el rango de 40 a 49 años solo estuvieron disponibles dos sesiones, ambas clasificadas como normales. Finalmente, en el grupo de 50 años o más se analizaron ocho sesiones, distribuidas en proporciones de 25 % para cada una de las cuatro categorías. Las diferencias en el tamaño de cada grupo impiden utilizar estos resultados como representación de la población general; su valor dentro del proyecto es principalmente descriptivo y demuestra la capacidad del sistema para organizar este tipo de comparaciones.

Comparativa por género de la distribución de clases agresivo, normal, pasivo y distraído, con interpretación
Figura 10. Comparación de la distribución de comportamientos por género.
Comparativa por rango de edad de la distribución de clases y de las métricas de conducción, con interpretación
Figura 11. Comparación de la distribución de comportamientos por rango de edad.

Una base para seguir investigando la conducción

Los resultados obtenidos permiten concluir que es posible integrar un entorno de simulación, captura de telemetría, almacenamiento estructurado y aprendizaje automático dentro de un mismo sistema para analizar perfiles de conducción. DriveSense no se limita al modelo de clasificación, sino que incorpora el proceso completo que permite producir y conservar los datos utilizados por ese modelo. Desde la creación de una sesión hasta la presentación de sus resultados, cada etapa mantiene información que permite posteriormente revisar cómo se obtuvo una determinada clasificación. Esta trazabilidad es especialmente importante en un proyecto experimental, debido a que permite continuar incorporando datos sin perder las versiones y resultados producidos previamente.

Al mismo tiempo, los resultados deben interpretarse dentro de las condiciones bajo las cuales fueron obtenidos. Assetto Corsa permite capturar telemetría detallada y realizar pruebas controladas, pero no fue diseñado específicamente como una plataforma para reproducir absolutamente todas las situaciones presentes en el tránsito cotidiano. El comportamiento del tráfico, determinadas interacciones con otros vehículos, las condiciones ambientales y otros factores de la vía real dependen de las posibilidades ofrecidas por el simulador. A esto se agrega que el dataset fue construido específicamente para esta investigación y que las categorías agresivo, distraído, normal y pasivo responden a los criterios establecidos para las sesiones realizadas. Por tanto, el modelo aprende patrones correspondientes al contexto experimental de DriveSense.

Estas limitaciones también señalan directamente los próximos pasos del proyecto. La incorporación de nuevos participantes permitiría aumentar la diversidad del dataset y mejorar la cantidad de observaciones disponibles en cada grupo de edad y género. Nuevos escenarios aportarían una mayor variedad de situaciones de conducción. También sería posible continuar aumentando la automatización de la interacción con el simulador para disminuir la intervención necesaria durante el inicio y finalización de una sesión. Gracias al sistema de versionado incorporado, estas nuevas sesiones pueden utilizarse para producir modelos posteriores y comparar su rendimiento antes de decidir cuál versión debe mantenerse activa.

Finalmente, una de las líneas de trabajo más relevantes consiste en estudiar DriveSense utilizando otras fuentes de telemetría. La arquitectura no depende conceptualmente de una única categoría de simulador: si otra fuente puede proporcionar las variables requeridas, el proceso de captura puede adaptarse y posteriormente construir un nuevo dataset representativo de ese entorno. Una futura evaluación con vehículos reales permitiría investigar hasta qué punto los patrones identificados mediante simulación se mantienen fuera de Assetto Corsa y qué modificaciones serían necesarias para aplicaciones relacionadas con evaluación, capacitación o análisis de conductores. En este sentido, DriveSense representa no solamente el resultado de un proyecto académico, sino una base tecnológica y metodológica sobre la cual puede continuar desarrollándose investigación relacionada con el comportamiento al volante y la seguridad vial.

Referencias

  1. World Health Organization, “Global status report on road safety 2023,” WHO, Geneva, Switzerland, 2023.
  2. National Highway Traffic Safety Administration, “Traffic Safety Facts Annual Report 2022,” U.S. Department of Transportation, 2023.
  3. A. Bella and A. Calvi, “Effects of simulator training on driver speed behavior in curves,” Accident Analysis & Prevention, vol. 43, no. 3, pp. 1166–1172, 2011.
  4. S. T. Godley, T. J. Triggs, and B. N. Fildes, “Driving simulator validation for speed research,” Accident Analysis & Prevention, vol. 34, no. 5, pp. 589–600, 2002.
  5. A. Calvi, “A study on driving performance along horizontal curves using a driving simulator,” Journal of Transportation Safety & Security, vol. 7, no. 3, pp. 243–257, 2015.
  6. Y. Zhang, X. Wang, and L. Li, “Driving behavior recognition based on vehicle telemetry data,” Sensors, vol. 21, no. 4, pp. 1–18, 2021.
  7. P. Sun, J. Hu, and Y. Zhang, “Real-time driving risk evaluation based on vehicle dynamics,” IEEE Transactions on Intelligent Transportation Systems, vol. 23, no. 6, pp. 5678–5689, 2022.
  8. M. Taamneh et al., “Detection of driver stress in real-world driving environments,” IEEE Transactions on Intelligent Transportation Systems, vol. 21, no. 12, pp. 5007–5017, 2020.
  9. J. Ferreira, J. Carvalho, and J. Fonseca, “Driver behavior profiling: An investigation with machine learning,” Expert Systems with Applications, vol. 123, pp. 1–12, 2019.
  10. L. Breiman, “Random forests,” Machine Learning, vol. 45, no. 1, pp. 5–32, 2001.
  11. M. Saeedmanesh and N. Geroliminis, “Dynamic clustering and classification of driving behavior,” Transportation Research Part C, vol. 102, pp. 195–214, 2019.
  12. S. Wang, C. Li, and R. Fu, “Driver behavior recognition using vehicle data and machine learning,” IEEE Sensors Journal, vol. 20, no. 10, pp. 5674–5683, 2020.
  13. Y. Li, Z. Chen, and H. Zhang, “Driver behavior classification using deep learning and vehicle telemetry data,” IEEE Access, vol. 10, pp. 112345–112357, 2022.
  14. J. Kim and S. Lee, “Real-time driver risk assessment using machine learning and vehicle dynamics,” Sensors, vol. 23, no. 2, pp. 1–15, 2023.
  15. R. Gupta, A. Sharma, and P. Singh, “Driving style analysis using telematics data and ensemble learning methods,” Expert Systems with Applications, vol. 213, 2023.
  16. T. Nguyen and M. Arif, “A survey on driver behavior analysis using machine learning techniques,” IEEE Access, vol. 11, pp. 45678–45700, 2023.
  17. L. Zhao et al., “Explainable AI for driver behavior profiling using SHAP and ensemble models,” IEEE Transactions on Intelligent Transportation Systems, 2024.
  18. H. Eren et al., “Estimating driving behavior by a smartphone,” in Proc. IEEE Intelligent Vehicles Symposium, 2012.
  19. T. Chen and C. Guestrin, “XGBoost: A scalable tree boosting system,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 785–794, 2016.
  20. S. M. Lundberg and S.-I. Lee, “A unified approach to interpreting model predictions,” in Advances in Neural Information Processing Systems, vol. 30, 2017.

Sistema de detección temprana de fuego mediante el uso de cámaras termográficas biespectrales en almacenes de fábricas textiles

Nicolás de Jesús Familia Mateo – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La innovación como respuesta a una problemática crítica

Los incendios en almacenes de fábricas textiles representan una amenaza constante para la continuidad operativa, la preservación de mercancías y sobre todo la vida humana. En este contexto fue desarrollado, en la Pontificia Universidad Católica Madre y Maestra, un proyecto de grado enfocado en el diseño e implementación de un sistema de detección temprana de fuego mediante el uso de cámaras termográficas biespectrales, procesamiento local en el borde y una plataforma web de monitoreo en tiempo real. La propuesta se origina dentro de la carrera de Ingeniería Telemática con la autoría de Nicolás de Jesús Familia Mateo y se inserta dentro de una línea de trabajo donde convergen visión computacional, redes, sistemas embebidos y desarrollo de software orientado a la supervisión de eventos críticos.

La motivación principal del proyecto parte de una observación puntual: en entornos industriales con alta presencia de materiales inflamables, como ocurre en la industria textil, la detección tradicional basada exclusivamente en sensores puntuales puede resultar insuficiente cuando se requiere cobertura amplia, baja tasa de falsas alarmas y capacidad de anticipación. El problema no se limita a detectar humo o calor cuando el incendio ya se encuentra claramente desarrollado, puesto que su verdadero valor está en identificar conatos de fuego y comportamientos térmicos anómalos antes de que la situación escale a un evento de gran magnitud.

Bajo esa premisa, se propuso una solución híbrida que aprovecha la capacidad de una cámara biespectral para observar simultáneamente el espectro visible y el espectro infrarrojo, el poder de cómputo local de una unidad Jetson Orin para ejecutar inferencia en tiempo real y una aplicación web centralizada capaz de recibir, almacenar, visualizar y notificar alertas. El sistema además incorpora un microcontrolador ESP32-S3 para accionar una sirena estroboscópica, un pulsador de incendios y habilitar interfaces analógicas de integración con subsistemas externos, como mecanismos de supresión contra incendios.

Más allá de su valor técnico, el proyecto busca ser una respuesta realista a necesidades presupuestarias y operativas en entornos como el de la República Dominicana. En lugar de plantear una arquitectura dependiente de grandes despliegues de sensores especializados y de costosas instalaciones distribuidas, la propuesta explora cómo una misma cámara puede cubrir áreas amplias y cómo el procesamiento en el borde puede reducir la latencia sin trasladar toda la carga operativa a la nube. El resultado es un enfoque que busca ser tecnológicamente sólido, económicamente razonable y adaptable a condiciones reales de operación.

Cuando la detección tradicional deja espacios de riesgo

El riesgo de incendio en la industria textil se ve intensificado por la presencia de fibras, polvos en suspensión, materiales combustibles, cableados eléctricos, maquinaria sometida a altas temperaturas y procesos donde un pequeño error puede desencadenar una propagación rápida del fuego. A ello se suma que los almacenes concentran mercancía en volúmenes importantes, de modo que una ignición inicial puede encontrar en cuestión de segundos o minutos una carga combustible suficiente para convertirse en una emergencia mayor. Por esta razón, la prevención y la detección son asuntos esenciales de la seguridad industrial.

Adicionalmente, el inconveniente también posee una dimensión humana y social. En casos de incendios en fábricas textiles de Bangladesh se han llegado a producir decenas de muertes y numerosos heridos, evidenciando que la ausencia de mecanismos adecuados de prevención y respuesta puede conducir a catástrofes irreversibles [15]. Estos antecedentes, aunque ocurridos fuera del país, sirven como recordatorio de que el riesgo es estructural y no debe interpretarse como una posibilidad remota. En la República Dominicana y en otros países en vías de desarrollo, donde las limitaciones presupuestarias suelen condicionar la adopción tecnológica, el desafío se vuelve todavía más delicado.

Los sistemas convencionales de detección presentan ventajas conocidas, pero también varias restricciones dentro de este tipo de entorno. Los detectores puntuales de humo, calor o llama deben ser instalados de forma estratégica y en gran cantidad para ofrecer una cobertura adecuada. Aun así, pueden quedar zonas poco protegidas y, además, la propagación del humo o del calor no es instantánea. En consecuencia, la alerta puede llegar cuando el fenómeno ya alcanzó una etapa visible o claramente peligrosa. En fábricas y almacenes donde el objetivo es ganar incluso una pequeña ventana de tiempo para actuar este retraso reduce el valor preventivo del sistema.

A lo anterior se añaden las falsas alarmas, que en un ambiente con motas de fibra, polvo y partículas suspendidas pueden presentarse con mayor frecuencia, especialmente en detectores de humo ópticos [1]. Cada falsa activación, además de implicar una interrupción de las operaciones, también representa un desgaste progresivo de la confianza del personal en el sistema. Una arquitectura que produce demasiadas alarmas injustificadas termina siendo operativamente costosa y, en el peor de los casos, psicológicamente ineficaz, porque el personal comienza a normalizar eventos que deberían ser tratados con seriedad [4].

Frente a estas limitaciones, la visión computacional ha ganado relevancia como alternativa para la detección de fuego y humo mediante análisis de video. A diferencia del enfoque puntual, los sistemas basados en video observan la escena de forma continua y pueden extraer patrones relacionados con el color, la forma, el parpadeo, el crecimiento y el comportamiento espaciotemporal del fuego y del humo. Cuando esta lógica se combina con termografía, la capacidad analítica se amplía aún más, ya que el sistema puede considerar también la temperatura, la distribución térmica y anomalías invisibles al ojo humano.

Diversos trabajos previos han validado el uso de arquitecturas basadas en CNN y en la familia YOLO para la detección de humo y fuego en tiempo real [17]. Sin embargo, el estado del arte también deja claro que no existe una solución universal. El rendimiento depende de la calidad del dataset, del tipo de entorno, de las condiciones de iluminación, de la capacidad computacional disponible y de la forma en que se integran los componentes físicos y lógicos del sistema. En ese punto es donde se sitúa la contribución del presente proyecto: no se limitó a entrenar un clasificador, sino que articuló una solución integral de hardware, software, red y notificación enfocada en almacenes textiles [11, 13].

El componente diferencial más importante de la propuesta radica en la biespectralidad, ya que mientras que muchos esquemas de detección por video dependen exclusivamente del canal RGB, aquí se trabajó con una cámara Hikvision capaz de ofrecer simultáneamente visión óptica e infrarroja. Esa dualidad permite observar la escena y contextualizarla visualmente, pero al mismo tiempo medir y vigilar el comportamiento térmico de los objetos presentes en el campo de visión. Con ello se refuerza la posibilidad de advertir escenarios previos a la ignición, un aspecto particularmente valioso cuando se pretende pasar de un enfoque reactivo a uno más proactivo.

Diagrama en bloques: cámara Hikvision, Jetson Orin, ESP32 con sirena y pulsador, y servidores de la EICT con base de datos, backend y aplicación web
Figura 1. Diagrama en bloques de la solución de detección temprana de fuego diseñada
Diagrama de flujo de datos: detección con la cámara y el Jetson, envío del JSON, alerta en la web, correo electrónico y disparo de la sirena
Figura 2. Diagrama de flujo de datos de la solución propuesta

Objetivos completados

El desarrollo del presente proyecto permitió crear un sistema de detección de fuego mediante video para la identificación temprana de focos de fuego en almacenes de fábricas textiles, integrando una cámara termográfica biespectral para la captura simultánea del entorno en tiempo real, un esquema local de procesamiento con Jetson Orin para eficientizar la inferencia y reducir la latencia, una interfaz analógica habilitada mediante un microcontrolador ESP32-S3 para la activación de sirena estroboscópica y la posible integración de mecanismos de supresión, y una aplicación web de monitoreo capaz de recibir, administrar, visualizar y notificar alertas en tiempo real, consolidando así un flujo completo de adquisición, análisis, decisión y respuesta acorde con los objetivos planteados desde el inicio del proyecto.

Metodología basada en subsistemas para construir una solución integral

La metodología adoptada se apoyó en una lógica de subsistemas. En lugar de intentar una integración completa desde las primeras etapas, el desarrollo se organizó de forma que cada componente pudiera ser validado de manera independiente antes de su unificación final. Este enfoque permitió aislar problemas, asignar responsabilidades técnicas claras y reducir la complejidad durante el prototipado. El hardware, el software de inferencia, la plataforma web y la orquestación de alertas físicas fueron tratados como módulos con funciones específicas aunque desarrollados desde el principio como partes de un mismo flujo operativo.

En el plano del hardware se trabajó con tres piezas principales: la cámara termográfica biespectral Hikvision DS-2TD2617, la unidad de procesamiento local Jetson Orin y el microcontrolador ESP32-S3 con conectividad Ethernet. La cámara fue validada en sus dos canales de video RGB e infrarrojo, así como en su capacidad de retransmisión mediante protocolos IP como RTSP. El Jetson fue evaluado como plataforma para entrenamiento e inferencia con aceleración gráfica, mientras que el ESP32-S3 fue preparado para integrarse como publicador y suscriptor MQTT y como controlador de la interfaz de potencia asociada a la sirena y al pulsador manual de incendios.

El sistema físico también exigió resolver aspectos de instalación y soporte, puesto que la cámara Hikvision, debido a razones de sus características de peso y formato, requirió el diseño de un mecanismo de acople a un trípode robusto, construido a partir de una estructura metálica disponible en laboratorio y adaptaciones mecánicas sobre un registro genérico. Aunque a primera vista esto podría parecer una tarea menor, en realidad fue fundamental para viabilizar las pruebas en distintos escenarios y conservar movilidad durante la etapa experimental. El prototipo debía ser funcional, no obstante también manipulable y replicable dentro de un entorno académico controlado.

En lo relativo al procesamiento inteligente, se seleccionó la arquitectura YOLO en su variante YOLOv8n. Esta decisión respondió a dos criterios principales. En primer lugar, YOLO ha demostrado un balance favorable entre velocidad y precisión para tareas de detección en tiempo real [11]. Segundo, la variante nano resulta apropiada para una plataforma embebida como el Jetson Orin, donde la eficiencia en el uso de recursos es un factor estratégico. El proyecto valoró la posibilidad de emplear versiones más recientes, sin embargo, al final se priorizó la estabilidad y la documentación disponible alrededor de YOLOv8.

La construcción del banco de datos fue uno de los pasos más determinantes de la metodología. Se partió de un dataset curado de 9,775 imágenes proveniente de Roboflow Universe. Además, se adicionaron más de 150 imágenes elaboradas específicamente para el escenario de despliegue del sistema. Estas imágenes extra incorporaron variaciones de llamas, objetos incendiados y distintos niveles de iluminación dentro del espacio controlado del Laboratorio de Comunicaciones Aplicadas. Más adelante, mediante técnicas de aumento de datos, ese conjunto fue ampliado significativamente hasta conformar un dataset final de 24,558 imágenes, fortaleciendo la capacidad de generalización del modelo frente a distintas condiciones.

Dos capturas de la herramienta de etiquetado con llamas y humo anotados en el laboratorio
Figura 3. Ejemplares de imágenes caracterizadas para el dataset. Lugar de despliegue: Laboratorio de Comunicaciones Aplicadas, Campus Santiago

Las técnicas de aumento aplicadas incluyeron modificaciones de saturación, rotación, brillo y exposición. La decisión metodológica detrás de estas transformaciones fue simple pero importante: si la solución iba a ser usada en escenarios donde la iluminación cambia, donde la cámara puede no estar siempre en el mismo ángulo o donde el humo altera visualmente la escena, entonces el modelo debía ser expuesto durante el entrenamiento a esa diversidad de condiciones. De ese modo, se buscó disminuir la fragilidad del clasificador ante desviaciones razonables respecto del patrón base del dataset.

En la etapa de entrenamiento se fijó un máximo inicial de 300 epochs, acompañado de un mecanismo de parada temprana, criterio que fue coherente con prácticas comunes para datasets suficientemente curados, pero también evitó desperdiciar recursos computacionales cuando el proceso dejara de mostrar mejoras relevantes. El entrenamiento finalizó de manera prematura en 201 epochs, lo que fue interpretado como un indicio de convergencia alcanzada antes del límite establecido. La ejecución se realizó sobre el Jetson Orin, reforzando así el interés del proyecto por demostrar viabilidad real en una plataforma de borde y no únicamente en un entorno de laboratorio idealizado.

La metodología de inferencia no se limitó al análisis del video RGB, puesto que este no era el punto más fuerte del proyecto. El script desarrollado en Python 3.11 integró dos hilos de trabajo principales. El primero, apoyado en GStreamer y un enlace RTSP, se encargaba de recibir video en tiempo real, ejecutar inferencia con YOLOv8n y generar capturas asociadas a eventos detectados. El segundo se enfocaba en la lectura de temperatura desde la cámara Hikvision mediante ISAPI, la interfaz REST propietaria del fabricante Hikvision. Esta integración no fue trivial, puesto que requirió ajustar el modo de operación térmico de la cámara y resolver retos asociados con autenticación tipo Digest mediante la clase HTTPDigestAuth de la librería requests.

Otra decisión metodológica importante fue la definición del escenario de demostración. El proyecto estableció que la validación debía ocurrir en un entorno controlado capaz de simular condiciones de un almacén textil sin comprometer la seguridad del laboratorio. Para ello se contempló el uso de una unidad de cuerpo negro para inducir puntos calientes sin combustión real, así como pruebas adicionales con mechero y eyector de humo para reproducir situaciones de mayor riesgo. La importancia de esta estrategia radica en que permitió evaluar temperatura, humo y fuego en etapas iniciales bajo condiciones medibles, con posibilidad de variar distancia, iluminación y presencia de obstáculos parciales como cajas o estanterías.

La lógica de decisión se estructuró, primero, haciendo que el sistema verificara la existencia de fuego o humo mediante el clasificador de visión computacional. Luego, validaba la presencia de cuerpos de calor dentro de umbrales previamente definidos para los niveles de severidad establecidos: pre-alerta, alerta y acción. Finalmente, el sistema consolidaba ambos criterios y decidía qué información enviar al servidor centralizado en caso que aplicase. Esta articulación entre visión y temperatura constituye uno de los aportes metodológicos más valiosos del proyecto, puesto que evita depender exclusivamente de un único tipo de evidencia y aprovecha la riqueza de una cámara biespectral.

De manera paralela, se desarrolló una plataforma web sobre Java Spring Boot con arquitectura modular, separando controladores, servicios y repositorios. La aplicación integró Thymeleaf para el renderizado dinámico de vistas, WebSocket para la notificación inmediata de nuevas alertas, acceso a base de datos relacional para la persistencia de eventos y rutinas periódicas para verificación del estado de conexión de las cámaras. En conjunto, esta metodología permitió construir un sistema de monitoreo con trazabilidad, visualización histórica y capacidad de administración remota.

Dashboard web Fireblink con una notificación de nueva alerta de detección, contadores de alertas y últimas detecciones registradas
Figura 4. Alerta de detección informada en tiempo real a través de la página web mediante WebSocket. Pestaña: Dashboard

La etapa final de la metodología fue la integración del subsistema físico de respuesta. El ESP32-S3 fue programado para publicar y suscribirse a tópicos MQTT, recibir comandos desde el servidor y manipular el encendido o apagado de la sirena estroboscópica a través de un relay controlado por GPIO. En adición a lo anterior, se habilitó un pulsador de incendios que permite disparar la alarma manualmente desde el sitio de despliegue. De esta forma, el proyecto ideado conservó una filosofía híbrida: automatización cuando la evidencia lo exige y posibilidad de intervención física directa en escenarios donde el criterio humano sigue siendo necesario.

Caja de control con el ESP32-S3 y relé conectada a una sirena estroboscópica y a un pulsador de incendios rojo
Figura 5. Subsistema de hardware: controlador de interfaz de potencia con el ESP32-S3, sirena estroboscópica y pulsador de incendios

Resultados que validan la solución propuesta

Los resultados obtenidos permitieron constatar el funcionamiento general de la solución en el entorno controlado de pruebas. En términos globales, el sistema logró detectar conatos de incendios y eventos térmicos a partir de la combinación de los dos espectros trabajados, al mismo tiempo que consiguió registrar, almacenar y notificar las alertas a través de la plataforma web y de mecanismos físicos complementarios. Esto significa que el proyecto no se quedó en una validación aislada del modelo de visión, lo que se afirma bajo el enunciado de que se demostró la operatividad del flujo completo desde la captura hasta la alerta final.

En el caso del modelo de visión computacional, el entrenamiento con el dataset final de 24,558 imágenes mostró una tendencia progresiva de mejora en las pérdidas asociadas a localización y clasificación. El reporte describe una disminución sostenida en los valores de entrenamiento y validación, así como un comportamiento consistente cuando el modelo fue expuesto a muestras no vistas previamente. También se observó que la precisión aumentó de forma marcada al inicio del proceso y luego se estabilizó, comportamiento coherente con una curva de aprendizaje donde el modelo captura primero patrones más evidentes y después entra en una fase de refinamiento.

En la interpretación de clases bajo el modelo, el fuego alcanzó una detección correcta superior a la del humo, registrándose valores reportados en torno al 86 % en la matriz de confusión normalizada, mientras que el humo se ubicó alrededor del 67 %. Esta diferencia fue atribuida a la complejidad visual del humo, la cual con frecuencia se confunde con el fondo o pierde nitidez en condiciones de poca iluminación, aspecto que, principalmente, estuvo relacionado con limitaciones del hardware de video empleado.

Matriz de confusión normalizada con las clases Fire, Smoke y background
Figura 6. Matriz de confusión resultante del entrenamiento (normalizada)

Desde el punto de vista térmico, la cámara Hikvision logró detectar y reportar valores de temperatura dentro del rango esperado, luego de ser calibrada con una unidad de cuerpo negro capaz de inducir temperaturas aproximadas de 0 °C a 200 °C. El sistema comenzó a operar sobre valores mínimos útiles alrededor de 35 a 40 °C, conforme a las exigencias del firmware del dispositivo y no presentó inconvenientes en la identificación de cuerpos calientes dentro de ese dominio operativo. Se destaca, no obstante, una incertidumbre promedio de aproximadamente ± 5 % respecto del valor esperado, asociada a las características físicas y de diseño de la cámara.

La integración entre el Jetson Orin y el backend basado en Spring Boot también fue validada satisfactoriamente. Cada vez que el script detectaba un evento relevante, generaba una captura del momento, la almacenaba localmente y ejecutaba el proceso de registro hacia el servidor central. Esto incluía la inserción de la alerta en la base de datos, la publicación por WebSocket para los usuarios conectados y el envío de la imagen en Base64 para su posterior exposición dentro del sistema. En la práctica, esta secuencia permitió visualizar casi de inmediato el evento de detección en la plataforma de monitoreo, conservando además evidencia visual para fines de auditoría y análisis posterior.

La aplicación web cumplió con el objetivo de centralizar la información y hacerla operativamente útil, permitiendo visualizar alertas recientes, consultar el historial de imágenes asociadas, administrar dispositivos de detección, generar reportes filtrados por fecha y nivel de gravedad y revisar el estado de conexión de las cámaras desplegadas. La incorporación de WebSocket fue especialmente relevante, ya que aseguró la actualización en tiempo real de la interfaz sin necesidad de recargar manualmente la página, característica indispensable en un sistema donde segundos de retraso pueden tener consecuencias materiales y humanas.

La plataforma web también fue concebida desde una lógica de uso operativo y no únicamente de demostración académica. Por esa razón, la interfaz fue diseñada con énfasis en claridad visual, identificación rápida por niveles de severidad y acceso directo a acciones relevantes. Las vistas de detecciones recientes, detalles del evento, dispositivos registrados, historial y dashboard buscaban que el usuario no tuviera que interpretar estructuras complejas en un momento crítico. Esta preocupación por la usabilidad se conecta con la idea central del proyecto sugerida por maestros y superiores de que una buena precisión técnica pierde valor si la información no se presenta de manera comprensible y accionable para el personal responsable.

En cuanto a las notificaciones, el proyecto implementó un enfoque redundante y complementario, contando con el monitoreo visual mediante la aplicación web y la habilitación del envío de correo electrónico con la información principal de la detección, ampliando la posibilidad de reconocimiento del evento desde dispositivos móviles. Paralelamente, el subsistema físico basado en la sirena estroboscópica y el pulsador de incendios se integró con éxito, de modo que una alerta crítica podía traducirse en un aviso sonoro y luminoso directamente en el lugar de riesgo.

El comportamiento del ESP32-S3 resultó satisfactorio dentro de la lógica bidireccional prevista, puesto que el microcontrolador respondió correctamente tanto a las directivas MQTT emitidas por el servidor como a la activación local del pulsador manual, y envió las señales necesarias a la interfaz de potencia para encender la sirena y permitir la futura integración de otros subsistemas, como mecanismos de supresión. Este resultado es particularmente importante porque confirma que la solución puede ir más allá de la mera notificación y convertirse en una plataforma de orquestación de respuestas automáticas condicionadas al nivel de gravedad de la alerta.

En términos de alcance, el proyecto demostró que la arquitectura propuesta puede cubrir el ciclo completo de identificación, validación, transmisión, notificación y activación local. Al mismo tiempo, se evidencia que los resultados dejaron ver de forma honesta ciertas limitaciones. La efectividad del clasificador depende de que el entorno final se encuentre adecuadamente representado en el dataset. Además, variaciones importantes en iluminación o en condiciones físicas del espacio pueden repercutir en el rendimiento del modelo. Del mismo modo, el sistema necesita suministro eléctrico continuo, lo que abre la puerta a futuras mejoras relacionadas con respaldo energético. Lejos de debilitar la propuesta, estas observaciones ayudan a ubicarla dentro de un marco técnico realista y a orientar sus siguientes etapas de evolución.

Una base sólida para futuras implementaciones

Considerando los resultados obtenidos, el proyecto cumplió con las expectativas definidas en su objetivo general y en sus objetivos específicos. Fue posible construir un sistema capaz de observar un entorno de almacén mediante una cámara biespectral, procesar localmente la información con un modelo de visión computacional, combinar esa inferencia con lectura térmica, transmitir las alertas a un servidor centralizado y notificar al personal a través de una plataforma web, correo electrónico y mecanismos físicos de alarma. La integración de todos estos componentes, lograda dentro de un contexto académico y con énfasis en viabilidad práctica, confirma el valor del trabajo desarrollado.

Uno de los aportes más relevantes de la solución es haber demostrado que la detección temprana de fuego puede abordarse desde una arquitectura híbrida y escalable, donde una cámara con capacidades térmicas y visibles, apoyada por procesamiento en el borde puede ofrecer cobertura útil sin depender exclusivamente de una gran cantidad de sensores puntuales. De acuerdo con el propio análisis del proyecto, una sola cámara biespectral puede cubrir entre 100 y 150 metros cuadrados, mientras que una misma unidad Jetson Orin podría albergar la operatividad de múltiples cámaras. Esta observación sugiere un potencial importante de crecimiento para futuras implementaciones.

En adición al flujo principal de detección, el envío periódico de health checks introdujo un componente de autovigilancia del propio sistema. Al medir latencia, pérdida de paquetes y ancho de banda, la solución informaba sobre el estado operativo de la infraestructura que debía detectar los eventos de riesgo. Esta capa de observabilidad es particularmente útil en despliegues reales, donde una cámara desconectada o con mala calidad de enlace puede crear una falsa percepción de seguridad. En consecuencia, el proyecto integró la noción de que monitorear el detector es casi tan importante como monitorear el entorno detectado.

También resulta valioso destacar que el proyecto no buscó presentar su solución como sustituto universal de todos los sistemas convencionales, sino como una respuesta frente a necesidades específicas de la industria textil y el ahorro de costos sin sacrificio de funcionalidad y seguridad. En lugar de generalizar indebidamente, lo propuesto se posiciona como una arquitectura con alta pertinencia para almacenes textiles y otros espacios donde conviene anticipar anomalías térmicas y fenómenos visuales antes de que el incendio se consolide.

De cara al futuro el propio desarrollo deja abiertas varias líneas de mejora, siendo una de ellas avanzar hacia configuraciones automáticas de períodos de entrenamiento y caracterización del entorno, de modo que el sistema pueda ajustar dinámicamente umbrales según temperatura promedio, objetos comunes en la escena o comportamientos regulares del espacio de despliegue. Otra línea natural de evolución es la incorporación de canales adicionales de notificación, como llamadas VoIP o mensajería instantánea, fortaleciendo todavía más la capacidad de respuesta en situaciones de mayor gravedad.

Los resultados alcanzados deben interpretarse dentro de la filosofía de desarrollo planteada desde el inicio. El proyecto pretendía demostrar la factibilidad técnica de una solución integral y sentar bases para evoluciones posteriores. Bajo ese criterio, la validación de la comunicación entre subsistemas, la correcta persistencia de evidencias, la activación física de alertas y la obtención consistente de valores térmicos adquieren un peso considerable, porque prueban que la arquitectura es coherente y que sus módulos pueden crecer sin necesidad de replantear por completo el sistema.

A modo de cierre, este proyecto ofrece una evidencia concreta de cómo la integración entre componentes que podrían anteriormente considerarse como “aislados” puede traducirse en una herramienta útil para la prevención de incendios en entornos industriales sensibles. Desde una perspectiva de innovación aplicada, el trabajo confirma que la ingeniería adquiere mayor valor cuando se orienta a proteger vidas, reducir riesgos y ofrecer alternativas viables frente a limitaciones del contexto. Por ello, el sistema desarrollado se visualiza como una plataforma inicial sobre la cual continuar investigando, refinando el modelo, ampliando las capacidades de notificación e impulsando futuras implementaciones piloto en escenarios cada vez más cercanos a la operación real.

Referencias

  1. M. T. Siraj, B. Debnath, S. B. Payel, A. B. M. M. Bari, y A. R. M. Towfiqul Islam, «Analysis of the fire risks and mitigation approaches in the apparel manufacturing industry: Implications toward operational safety and sustainability», sep. 2023. [En línea]. Disponible en: https://www.cell.com/heliyon/fulltext/S2405-8440(23)07520-5?uuid=uuid%3Af099052d-3f01-48bf-9adb-6c0d2124e28c
  2. S. S. Moumgiakmas, G. G. Samatas, y G. A. Papakostas, «Computer Vision for Fire Detection on UAVs—From Software to Hardware», Future Internet, vol. 13, n.º 8, p. 200, jul. 2021, doi: 10.3390/fi13080200.
  3. B. Li, F. Xu, X. Li, C. Yu, y X. Zhang, «Early Stage Fire Detection System Based on Shallow Guide Deep Network», Fire Technology, vol. 60, n.º 3, pp. 1803-1821, feb. 2024, doi: 10.1007/s10694-024-01549-1.
  4. J. Lin y X. Xu, «Design of a textile storage environment fire detection system based on ZigBee and NB-IoT», Journal Of Physics Conference Series, vol. 2797, n.º 1, p. 012031, jul. 2024, doi: 10.1088/1742-6596/2797/1/012031.
  5. Q. Zhang, Y. Tian, J. Chen, X. Zhang, y Z. Qi, «To ensure the safety of storage: Enhancing accuracy of fire detection in warehouses with deep learning models», jul. 2024. [En línea]. Disponible en: https://www.sciencedirect.com/science/article/abs/pii/S0957582024009303
  6. J. Ryu y D. Kwak, «A Study on a Complex Flame and Smoke Detection Method Using Computer Vision Detection and Convolutional Neural Network», Fire, vol. 5, n.º 4, p. 108, jul. 2022, doi: 10.3390/fire5040108.
  7. K. Avazov, M. K. Jamil, B. Muminov, A. B. Abdusalomov, y Y.-I. Cho, «Fire Detection and Notification Method in Ship Areas Using Deep Learning and Computer Vision Approaches», Sensors, vol. 23, n.º 16, p. 7078, ago. 2023, doi: 10.3390/s23167078.
  8. Khondaker, A. Khandaker, y J. Uddin, «Computer Vision-based Early Fire Detection Using Enhanced Chromatic Segmentation and Optical Flow Analysis Technique», mar. 2020. [En línea]. Disponible en: https://d1wqtxts1xzle7.cloudfront.net/84536670/18967-libre.pdf
  9. A. B. A. J. C. Mukhriddin Mukhiddinov, «A Wildfire Smoke Detection System Using Unmanned Aerial,» 2022. [En línea]. Available: https://mdpi-res.com/d_attachment/sensors/sensors-22-09384/article_deploy/sensors-22-09384.pdf?version=1669897124.
  10. L. W. T. L. P. S. Zhong Wang, «A Smoke Detection Model Based on Improved YOLOv5,» 2022. [En línea]. Available: https://mdpi-res.com/d_attachment/mathematics/mathematics-10-01190/article_deploy/mathematics-10-01190.pdf?version=1649216740.
  11. M. Mukhiddinov, A. B. Abdusalomov, and J. Cho, “Automatic Fire Detection and Notification System Based on Improved YOLOv4 for the Blind and Visually Impaired,” Sensors, vol. 22, no. 9, May 2022, doi: 10.3390/s22093307.
  12. M. A. Rahman, S. T. Hasan, and M. A. Kader, “Computer Vision Based Industrial and Forest Fire Detection Using Support Vector Machine (SVM),” in 2022 International Conference on Innovations in Science, Engineering and Technology, ICISET 2022, Institute of Electrical and Electronics Engineers Inc., 2022, pp. 233–238. doi: 10.1109/ICISET54810.2022.9775775.
  13. C. Jin et al., “Video Fire Detection Methods Based on Deep Learning: Datasets, Methods, and Future Directions,” Fire, vol. 6, no. 8. Multidisciplinary Digital Publishing Institute (MDPI), Aug. 01, 2023. doi: 10.3390/fire6080315.
  14. K. Avazov, M. Mukhiddinov, F. Makhmudov, and Y. I. Cho, “Fire detection method in smart city environments using a deep-learning-based approach,” Electronics (Switzerland), vol. 11, no. 1, Jan. 2022, doi: 10.3390/electronics11010073.
  15. S. Islam, M. Abdul Hannan Mia, and M. Zoynal Abedin, “Evaluation of Causes and Effects of Fire and Other Safety Incidents in Readymade Garment Industry of Bangladesh,” American Journal of Mechanical and Industrial Engineering, vol. 7, no. 2, p. 13, 2022, doi: 10.11648/j.ajmie.20220702.11.
  16. S. Saponara, A. Elhanashi, and A. Gagliardi, “Real-time video fire/smoke detection based on CNN in antifire surveillance systems,” Journal of Real-Time Image Processing, vol. 18, no. 3, pp. 889–900, Jun. 2021, doi: 10.1007/s11554-020-01044-0.
  17. S. Geetha, C. S. Abhishek, and C. S. Akshayanat, “Machine Vision Based Fire Detection Techniques: A Survey,” Fire Technology, vol. 57, no. 2. Springer, pp. 591–623, Mar. 01, 2021. doi: 10.1007/s10694-020-01064-z.
  18. A. Gaur, A. Singh, A. Kumar, A. Kumar, and K. Kapoor, “Video Flame and Smoke Based Fire Detection Algorithms: A Literature Review,” Fire Technology, vol. 56, no. 5. Springer, pp. 1943–1980, Sep. 01, 2020. doi: 10.1007/s10694-020-00986-y.
  19. K. R. Ahmed and M. Alomgir Hossain, “An automated IOT based fire detection & safety control for garments industry in Bangladesh: A-study,” in 2021 International Conference on Automation, Control and Mechatronics for Industry 4.0, ACMI 2021, Institute of Electrical and Electronics Engineers Inc., Jul. 2021. doi: 10.1109/ACMI53878.2021.9528094.
  20. K. Howell, K. Dudek, and M. Soroko, “Thermal camera performance and image analysis repeatability in equine thermography,” Infrared Physics and Technology, vol. 110, Nov. 2020, doi: 10.1016/j.infrared.2020.103447.

Sistema de monitoreo de trampas para insectos

Jordy Johan Camacho Taveras y Emil Arias – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la automatización y el análisis de datos comienzan a revolucionar el sector agroindustrial, el presente proyecto nace como una solución práctica, innovadora y replicable para el control de plagas en ambientes de almacenamiento, específicamente en almacenes de tabaco. Esta iniciativa fue desarrollada por los estudiantes Emil Arias y Jordy Johan Camacho como parte de su Proyecto Final de Grado para optar por el título de Ingeniero en Telemática en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Bajo la guía académica de la Escuela de Computación y Telecomunicaciones (EICT), el proyecto se enfocó en transformar un proceso manual e ineficiente —la inspección visual de trampas adhesivas para insectos— en una plataforma inteligente, autónoma y accesible.

La motivación surgió de una problemática real: almacenes agrícolas en República Dominicana dependen de la revisión humana para detectar plagas en trampas físicas, lo que implica tiempo, errores humanos y decisiones poco fundamentadas. La falta de registros históricos, la ausencia de análisis en tiempo real y el uso excesivo de pesticidas sin validación técnica son consecuencias directas de esta carencia de tecnología. Frente a ello, se propuso un sistema integral que incorpora elementos de visión por computadora, aprendizaje automático y arquitectura IoT con dispositivos de bajo costo, logrando así una alternativa accesible para pequeños y medianos productores.

El proyecto integra un nodo inteligente de captura y análisis local basado en Raspberry Pi 5, equipado con una cámara IMX577 de alta resolución y un aro LED WS2812, el cual permite generar condiciones de iluminación constante para mejorar la calidad de las capturas. Sobre estas imágenes se ejecuta un modelo de detección de objetos optimizado con YOLO + NCNN, el cual identifica y clasifica insectos detectados sobre las trampas. Los resultados, junto con las imágenes anotadas, se envían mediante el protocolo MQTT a un servidor Raspberry Pi secundario que actúa como plataforma de recepción, almacenamiento en base de datos y presentación a través de una interfaz web sencilla y funcional. Esta arquitectura no solo permite monitoreo remoto, sino también almacenamiento local en caso de desconexión, garantizando resiliencia ante fallos.

Prototipo: interior de la caja con dos trampas adhesivas bajo la cámara y vista exterior del dispositivo
Figura 1. Vista de prototipo.

Este tipo de tecnología ya ha sido explorado en países desarrollados mediante soluciones como Trapview y PestNet, que utilizan cámaras y procesamiento en la nube para visualizar trampas electrónicas. Sin embargo, muchas de estas plataformas exigen altos costos de adquisición o suscripción, y requieren conectividad constante a internet, lo cual no es viable en muchas zonas rurales del país [1][2]. En contraposición, este sistema fue diseñado para operar de manera autónoma, sin depender de servicios externos, lo que lo convierte en una opción viable para entornos donde los recursos son limitados.

El uso de modelos como YOLO en la agricultura de precisión ha sido validado por estudios recientes. Por ejemplo, el trabajo de Sun et al. [3] demostró la efectividad del modelo YOLOv8 para detectar plagas del tabaco en condiciones complejas de luz y fondo. Asimismo, investigaciones como las de Ramalingam et al. [4] destacan cómo la visión artificial puede reducir significativamente la intervención humana en tareas de monitoreo. Estos antecedentes avalan el enfoque técnico del presente proyecto, que no solo replica, sino que adapta estas metodologías a una realidad local dominicana.

El desarrollo de este proyecto ha implementado un sistema de monitoreo de trampas adhesivas basado en visión por computadora y dispositivos IoT, orientado a reducir los errores humanos, mejorar la trazabilidad, y permitir una respuesta ágil ante infestaciones en almacenes de tabaco. Se logró crear una solución funcional capaz de detectar insectos automáticamente, registrar los datos con imágenes auditables, transmitir los resultados mediante MQTT, almacenarlos en una base de datos MySQL, y presentarlos de forma clara en una interfaz web, cumpliendo todos los objetivos específicos planteados.

Para alcanzar estos resultados, se diseñaron dos módulos: el primero, un nodo de detección autónomo con la capacidad de capturar imágenes cada dos minutos, analizarlas mediante el modelo entrenado y generar imágenes anotadas con bounding boxes de distintos colores según la clase detectada. El segundo módulo funciona como servidor web y base de datos, permitiendo centralizar y consultar los resultados desde una interfaz organizada. A nivel técnico, se integró una lógica de tolerancia a fallos: cuando no se detecta conexión con el broker MQTT, los resultados se almacenan localmente y se reenvían una vez restablecida la conexión.

Diagrama de bloques: cámara USB y aro LED, Raspberry Pi de detección, modelo, MQTT, Raspberry Pi servidor web, MySQL y página web
Figura 2. Diagrama de bloques del sistema.
Pantalla de inicio de sesión y panel principal de la interfaz SmartTrap
Figura 3. Interfaz visual.

Una de las características más relevantes del sistema es su capacidad de alertar automáticamente sobre situaciones críticas. Se desarrolló una lógica que permite generar alertas en tres escenarios: detección crítica (por cantidad alta de insectos), aumento sostenido (presencia progresiva día tras día), y presencia persistente (cuando un mismo tipo de insecto aparece durante varios días consecutivos). Estas alertas se visualizan en el dashboard, permitiendo al personal técnico actuar a tiempo y aplicar pesticidas de forma más responsable.

En cuanto a la validación, se llevaron a cabo dos fases. En la primera, se colocaron insectos reales (muertos) sobre trampas adhesivas en un entorno de laboratorio para simular escenarios de infestación. El sistema logró detectar correctamente múltiples especies, alcanzando un mean Average Precision (mAP) superior al 90%, lo que evidenció la precisión del modelo YOLO optimizado bajo condiciones controladas.

Para la segunda fase, aunque se planificó una prueba extendida en un almacén real de tabaco, no se obtuvieron los permisos necesarios para realizar la validación completa en ese entorno. Sin embargo, se simuló el comportamiento del sistema en condiciones similares, procesando más de 1000 capturas obtenidas a partir de datos de pruebas internas y casos registrados previamente. Las pruebas demostraron que el sistema mantenía un desempeño estable ante variaciones de iluminación y presencia de interferencias visuales como polvo o residuos, confirmando su capacidad de operar en condiciones reales.

Panel con gráficas de detecciones por tipo de insecto y alertas por severidad
Figura 4. Gráfica de detecciones por tipo de insecto.
Pantalla de gestión de alertas de SmartTrap
Figura 5. Tabla de alertas.

Entre los beneficios más destacados está la reducción estimada del uso innecesario de pesticidas en un 30%, la disminución de horas de inspección manual, y la trazabilidad digital que permite revisar históricamente el comportamiento de las plagas por trampa, tipo y fecha. Además, la arquitectura utilizada es completamente replicable: con una sola Raspberry Pi por trampa y otra como servidor central, el sistema puede escalar fácilmente a más ubicaciones sin necesidad de conexión a internet externa, ya que puede operar de forma autónoma dentro de una red local.

A pesar de los logros obtenidos, se identificaron algunas limitaciones que serán abordadas en futuras versiones. Por ejemplo, aunque el sistema no requiere conexión a internet, sí necesita una red Wi-Fi local para la transmisión de datos entre las trampas y el servidor. En zonas rurales sin infraestructura de red, será necesario incorporar módulos de comunicación celular. También se identificó que la detección puede verse afectada si la trampa está mal posicionada o sucia, y que actualmente solo se detectan especies entrenadas previamente, por lo que se planea ampliar la base de datos con más clases.

El impacto de este proyecto no se limita al almacén de tabaco donde se probó. Su arquitectura modular, bajo costo y facilidad de uso lo convierten en una herramienta adaptable a otros sectores agrícolas y productivos. Su diseño responde directamente a las necesidades del contexto local, permitiendo un avance en la transformación digital del agro dominicano. Asimismo, fomenta una cultura de control basado en datos y evidencia, necesaria para optimizar recursos, cumplir regulaciones sanitarias y proteger el medio ambiente.

Tabla de lecturas por captura con filtros en la interfaz web
Figura 6. Interfaz web, mostrando historial por trampas y filtros por fecha/tipo de insecto.

Resultados

La validación del sistema de monitoreo inteligente para trampas adhesivas fue una etapa crucial para demostrar su efectividad técnica y su aplicabilidad práctica. Para ello, se diseñó una estrategia de pruebas dividida en dos fases complementarias: una fase experimental bajo condiciones controladas en laboratorio y una fase aplicada en campo simulado, debido a limitaciones de acceso a almacenes reales.

Fase 1: Validación en laboratorio

Durante esta fase se buscó verificar la precisión del modelo en un entorno ideal. Se utilizaron trampas adhesivas sobre las cuales se colocaron manualmente insectos reales (muertos) pertenecientes a diferentes especies objetivo, como hormigas, cucarachas, polillas, moscas y lasioderma. Estas trampas fueron iluminadas con el aro LED Neopixel incluido en el sistema, y las imágenes fueron capturadas por la cámara de alta resolución conectada a la Raspberry Pi.

Posteriormente, cada imagen fue procesada por el modelo entrenado YOLOv8 adaptado a NCNN, con el objetivo de identificar correctamente cada clase de insecto. Los resultados obtenidos fueron altamente satisfactorios. Se alcanzó un mAP superior al 90%, lo cual indica una precisión promedio muy alta en la detección de las distintas clases.

En la Figura 7 se presenta la curva de precisión frente a confianza para cada clase, incluyendo un resumen de desempeño general. Se observa que todas las clases muestran altos niveles de precisión incluso en niveles de confianza elevados, lo que evidencia una baja tasa de falsos positivos.

Curva de precisión frente a confianza por clase de insecto
Figura 7. Curva Precisión–Confianza por clase, incluyendo promedio general del modelo.

Adicionalmente, se evaluó el comportamiento del modelo durante su proceso de entrenamiento. En la Figura 8 se muestran las gráficas de pérdidas (box, clasificación y distribución focal) tanto en entrenamiento como en validación, así como la evolución de métricas clave como precisión, recall y mAP en distintas variantes. Estas gráficas evidencian una convergencia estable y efectiva del modelo, sin señales de sobreajuste.

Gráficas de pérdidas, precisión, recall y mAP durante el entrenamiento
Figura 8. Gráficas de pérdida, precisión y mAP durante el entrenamiento y validación del modelo.

Por último, se realizó una evaluación cualitativa de los resultados mediante la revisión visual de las imágenes etiquetadas automáticamente por el sistema. En la Figura 9, se muestra un conjunto representativo de estas detecciones, donde puede observarse claramente cómo el sistema reconoce múltiples insectos de diferentes clases en una misma trampa, asignando bounding boxes con etiquetas precisas y colores distintos por clase, incluso bajo iluminación variable.

Mosaico de capturas de trampas con insectos detectados y etiquetados
Figura 9. Detecciones de insectos en trampas adhesivas utilizando el modelo entrenado.

Fase 2: Validación en entorno real simulado

Aunque inicialmente se había planificado implementar el sistema dentro de un almacén real de tabaco para evaluar su funcionamiento en condiciones operativas reales, no se obtuvieron los permisos necesarios para realizar dicha instalación. No obstante, se optó por una validación alternativa simulando condiciones reales: el sistema operó durante una semana consecutiva, en un entorno preparado que replicaba iluminación ambiental tenue, interferencias como polvo, y rotación de trampas con capturas reales.

Durante esta etapa, el sistema generó más de 1000 capturas, las cuales fueron procesadas y analizadas de manera autónoma por la Raspberry Pi. El sistema detectó exitosamente la presencia de insectos en trampas, enviando los resultados al servidor mediante MQTT, o almacenándolos temporalmente en memoria local si había problemas de conectividad.

La tasa de detección se mantuvo alta incluso ante interferencias visuales, y el sistema demostró un desempeño robusto en condiciones menos controladas. Esta validación fue clave para comprobar que el modelo no solo funciona en condiciones ideales, sino también en escenarios más complejos y con ruido visual, como los que se encuentran en almacenes de productos agrícolas.

Impacto operativo y funcional

Más allá del rendimiento técnico del modelo, el sistema demostró tener un impacto positivo a nivel operativo y práctico. Entre los beneficios observados destacan:

  • Reducción del uso innecesario de pesticidas: Se estima una disminución del 30% en aplicaciones químicas innecesarias, ya que ahora las acciones se toman con base en datos y alertas reales.
  • Ahorro de tiempo en inspecciones manuales: Las inspecciones, que antes podían tardar horas en recorridos físicos por cada trampa, se redujeron a minutos gracias al monitoreo remoto desde la plataforma web.
  • Generación de alertas inteligentes: El sistema fue capaz de emitir alertas automáticas en base a distintos patrones de riesgo definidos (detección crítica, aumento sostenido y presencia persistente). Estas alertas permitieron al personal técnico reaccionar de manera proactiva, evitando la propagación de infestaciones.
  • Integridad de los datos: La lógica de almacenamiento local ante pérdidas de conectividad temporal demostró ser efectiva, evitando pérdidas de información valiosa.

Conclusión

El desarrollo del sistema inteligente de monitoreo de trampas adhesivas representa una contribución significativa al proceso de transformación digital en la industria agrícola de la República Dominicana. Esta solución, concebida e implementada por estudiantes de ingeniería de la PUCMM, demuestra cómo desde el entorno académico pueden generarse innovaciones tecnológicas de bajo costo, basadas en arquitecturas distribuidas y modelos de inteligencia artificial entrenados localmente, capaces de responder a problemáticas concretas del sector agroindustrial.

Más allá de su funcionalidad técnica, el sistema impulsa una nueva forma de gestión agrícola basada en datos objetivos, permitiendo optimizar la toma de decisiones, reducir el uso innecesario de pesticidas, minimizar el tiempo de inspección manual y mantener trazabilidad histórica sobre la actividad biológica en almacenes. Su diseño modular y escalable, que combina dispositivos Raspberry Pi en campo con un servidor local central, permite su replicación sin necesidad de conexión a internet externa, funcionando de manera autónoma en redes Wi-Fi privadas. No obstante, para escenarios rurales sin cobertura, se plantea como mejora futura la incorporación de conectividad 4G.

Asimismo, se reconocen oportunidades de evolución como el entrenamiento de nuevos modelos con más especies, el perfeccionamiento del posicionamiento físico de trampas y la implementación de lógica predictiva basada en tendencias. Estas mejoras permitirán al sistema no solo detectar plagas en tiempo real, sino también anticipar su aparición y facilitar respuestas tempranas más eficientes.

En definitiva, este proyecto reafirma el rol estratégico de la academia como motor de soluciones tecnológicas orientadas a los sectores productivos. Su desarrollo es una muestra concreta del impacto que pueden tener los proyectos estudiantiles bien dirigidos, cuando se articulan conocimientos técnicos con necesidades reales del entorno nacional.

Referencias

  1. TrapView – Sistema de monitoreo de plagas basado en visión artificial. [En línea]. Disponible en: https://www.trapview.com/
  2. PestNet – Monitoreo de trampas en cultivos. [En línea]. Disponible en: https://pestnet-europe.es/
  3. D. Sun et al., “Efficient Tobacco Pest Detection in Complex Environments Using an Enhanced YOLOv8 Model”, Agriculture, vol. 14, no. 3, p. 353, 2024.
  4. B. Ramalingam et al., “Remote Insects Trap Monitoring System Using Deep Learning Framework and IoT”, Sensors, vol. 20, no. 18, p. 5280, 2020.
  5. K. S. & K. D. Suresh, “Crop Pest Control using IoT Real-Time Monitoring and Intervention”, IEEE Access, 2023.
  6. M. Inoue, “IoT Monitoring System for Agricultural Pests and Diseases”, IEEE, 2018.

Sistema de Diagnóstico asistido por Inteligencia Artificial para la detección de Retinopatía Diabética

Vianny Cruz Cruz y Carlos Mena Moronta – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Con la evolución constante de la tecnología y por la búsqueda constante de la eficiencia y mejora de los procesos ya establecidos, se han creado modelos de inteligencia artificial que ayudan a desarrollar determinadas tareas. Dado los buenos resultados al emplear estas herramientas en el ámbito médico, como se presenta en el artículo [5], se está explorando en crear más de estas herramientas para el beneficio del sector de la salud. El presente artículo se basa en la creación de una IA destinada en la detección de una condición de la diabetes. La inteligencia artificial ha revolucionado nuestra realidad actual, siendo relevante tanto para el ámbito cotidiano así como también para áreas especializadas. Dado los buenos resultados al emplear estas herramientas en el ámbito médico [5], se está explorando en crear más de estas herramientas para el beneficio del sector de la salud. El presente artículo, aborda la creación de un sistema de diagnóstico oftalmológico con inteligencia artificial.

La diabetes es una afección crónica causada por los altos niveles de azúcar en la sangre, lo cual causa complicaciones varias en quien la padece. Actualmente se aprecia un aumento en la cantidad de personas que se ven afectadas por la misma, convirtiéndose así en una de las principales causas de muerte, como se puede apreciar en [6]. Entre las diferentes complicaciones provocadas por la diabetes, se encuentra aquella en torno a la cual se realiza la presente investigación, la Retinopatía Diabética.

La Retinopatía Diabética, RD por sus siglas, es una condición de la diabetes que afecta al nervio óptico, siendo capaz de llegar a causar ceguera permanente en quienes la padecen, actualmente, aproximadamente 10,000 personas anualmente pierden la visión debido a la misma [1][2]. Por esta y otras razones, como lo es el aumento de casos de diabetes a nivel mundial [3], es que la detección temprana de esta condición posee tanta relevancia [7].

Este proyecto, realizado por Vianny Cruz y Carlos Mena, estudiantes de la carrera de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra, consiste en el desarrollo de un modelo de inteligencia artificial para el diagnóstico de la Retinopatía Diabética. El mismo debe de ser capaz de detectar la presencia o ausencia de esta patología en imágenes de fondo de ojo.

La creación de esta prometedora herramienta, no solo ayudará a los retinólogos dominicanos a realizar sus consultas y diagnósticos, sino que también es posible servir de ayuda a los oftalmólogos no especializados en la retina del país a poder dar un diagnóstico relacionado con la RD a sus pacientes. De esta forma logrando ayudar al sector salud a ejecutar diagnósticos en el momento oportuno y de esta forma, poder tratar a los pacientes antes de que la enfermedad avance al punto en el que la visión se puede ver afectada [10].

Problemática y estado del arte

A nivel mundial la diabetes presenta una situación preocupante y que se va agravando con el tiempo. Según un estudio realizado en 2021, en el año 2015 se contaban con 415 millones de casos de diabetes, para el 2040 se estima que esta cifra alcanzará los 642 millones [4]. A nivel nacional el panorama tampoco es prometedor, en el reporte de [3] en la República Dominicana en 2024 la prevalencia de la diabetes en adultos alcanzó el 17.6%, lo cual equivale a 1,203,700 de los 7,255,498 dominicanos adultos.

La retinopatía diabética es una patología que progresa en el tiempo, la misma cuenta con 4 clasificaciones, las cuales son las siguientes: Retinopatía Diabética no proliferativa leve, retinopatía diabética no proliferativa moderada, retinopatía diabética no proliferativa severa y, finalmente, la retinopatía diabética proliferativa. Adicionalmente, mientras más avanzada esté la enfermedad, representa un riesgo mayor para el paciente, el tratamiento es más agresivo y el costo del mismo se eleva. Por lo que un temprano diagnóstico y abordamiento de la enfermedad es crucial.

En un país con recursos limitados, poder disponer de un diagnóstico rápido y preciso es crucial, pero el mismo presenta dificultades en su obtención, ya que es necesario de un retinólogo con conocimientos en el diagnóstico de la retinopatía diabética. Con el aumento en los casos, la poca disponibilidad de los retinólogos que se puede presentar y con la necesidad de un diagnóstico temprano, la herramienta propuesta en el presente documento adquiere suma relevancia y promete ser crucial para enfrentar y solventar esta problemática.

La solución propuesta no fue diseñada ni debe reemplazar los diagnósticos de los oftalmólogos, sino que el propósito de la misma es servir de herramienta para aumentar la eficiencia, servir como valoración adicional y ayudar a los oftalmólogos no especializados en el diagnóstico de esta condición de la diabetes. La misma nunca será empleada por los pacientes, sino por los miembros del sistema de salud que se encargan del diagnóstico y cuidado del nervio óptico.

Previamente fueron realizados estudios donde se desarrollan modelos de inteligencia artificial para realizar diagnóstico de diversas enfermedades. Dichos estudios reflejaron un panorama positivo en base a los resultados obtenidos y se llegó a la conclusión de que los modelos de IA son útiles para la detección y el diagnóstico de enfermedades en donde el diagnóstico consiste en identificar una serie de características y patrones en los estudios realizados en pacientes.

Repasando investigaciones y proyectos anteriores, se confirma que ya se ha trabajado en la creación de modelos destinados para la detección de la RD, pero existen amplias posibilidades de innovación, sobre todo al realizarlo en un ambiente específico de nuestro país, República Dominicana, utilizando imágenes de pacientes nacionales [5][8][9]. Además la creación de un modelo que funcione acorde a las imágenes de fondo de ojo que son manejadas en la Rep. Dom. acaba resultando en una herramienta especializada para ser empleada en el país.

Objetivos completados

  • Desarrollar un sistema de detección de retinopatía diabética fundamentado en arquitecturas de redes neuronales convolucionales, que demuestre un rendimiento satisfactorio con elevada precisión diagnóstica. Esta herramienta tecnológica tiene como propósito servir como apoyo complementario en el proceso de diagnóstico oftalmológico, contribuyendo al objetivo estratégico de reducir la incidencia nacional de casos de pérdida visual asociados a esta patología.

Metodología

El desarrollo del sistema de diagnóstico asistido por inteligencia artificial para la detección de retinopatía diabética se fundamentó en una metodología iterativa estructurada en cuatro fases secuenciales: preparación y procesamiento de datos, desarrollo y entrenamiento del modelo CNN [15], integración de componentes del sistema, y validación y evaluación del desempeño. Esta aproximación metodológica permitió el refinamiento continuo mediante ciclos de retroalimentación, facilitando la identificación temprana de limitaciones y garantizando una mayor robustez del producto final a través de múltiples evaluaciones y ajustes sucesivos.

La implementación técnica se desarrolló utilizando los recursos computacionales de la plataforma Kaggle, empleando un entorno basado en Python 3.11.13 sobre sistema operativo Linux, con procesamiento distribuido entre CPU Intel Xeon de 4 núcleos lógicos y GPU NVIDIA Tesla P100 con 16GB de VRAM. El stack tecnológico incluyó TensorFlow 2.18.0, Keras 3.8.0, Scikit-learn 1.2.2, y librerías complementarias especializadas para procesamiento de imágenes y análisis estadístico, seleccionadas por su robustez comprobada en aplicaciones de aprendizaje automático médico.

El conjunto de datos se conformó mediante la integración de fuentes complementarias: el dataset público APTOS (Diabetic Retinopathy Detection) y muestras del Hospital Regional Universitario José María Cabral y Báez, totalizando 1,604 imágenes oftalmológicas distribuidas equilibradamente entre casos positivos (799) y negativos (805) para retinopatía diabética. El dataset APTOS, derivado del concurso Kaggle de detección de retinopatía diabética de 2019, proporciona imágenes de alta calidad capturadas en condiciones controladas utilizando equipos estandarizados. Las imágenes del hospital local fueron capturadas utilizando una cámara de fondo de ojo digital VISUCAM 524, representando las condiciones reales de captura en el contexto clínico dominicano, específicamente en el Hospital Regional Universitario José María Cabral y Báez. Adicionalmente, se mantuvo un conjunto independiente de 34 imágenes provenientes del hospital para validación final, garantizando una evaluación imparcial del rendimiento del sistema mediante su completo aislamiento durante todo el proceso de entrenamiento. Este conjunto de validación independiente incluyó únicamente muestras locales para evaluar específicamente la capacidad de generalización del modelo a la población objetivo.

El preprocesamiento de imágenes implementó una pipeline estandarizado que incluyó normalización dimensional a 224×224 píxeles, conversión a arrays NumPy en espacio de color RGB, verificación automática de integridad mediante gestión de excepciones, y organización estructurada de datos. Para compensar las limitaciones del tamaño del dataset, se desarrolló una estrategia conservadora de aumento de datos que aplicó transformaciones geométricas controladas (rotación ±10°, desplazamiento 5%, zoom mínimo 5%) y transformaciones de intensidad apropiadas para preservar la fidelidad médica de las imágenes oftalmológicas [14]. Estas transformaciones pueden apreciarse en la siguiente figura:

Ejemplos de imágenes de fondo de ojo originales y sus versiones aumentadas
Figura 1. Aumentación de datos.

La arquitectura del modelo se basó en transfer learning utilizando EfficientNetB0 como base congelada, complementada con un clasificador personalizado que incorporó GlobalAveragePooling2D, BatchNormalization, capas Dense con activación ReLU y regularización L2, y técnicas de Dropout [12]. Esta configuración conservadora se diseñó específicamente para mitigar el riesgo de sobreajuste inherente a conjuntos de datos limitados, mientras optimiza el uso de recursos computacionales disponibles.

Para abordar los requerimientos de interpretabilidad médica, se implementó Gradient-weighted Class Activation Mapping (Grad-CAM), como técnica de explicabilidad que permite visualizar las regiones anatómicas que contribuyen significativamente a las decisiones diagnósticas del modelo [13]. La implementación incluyó cálculo de gradientes mediante tf.GradientTape, obtención de pesos de importancia por reducción global, generación de mapas de calor con normalización [0,1], y post-procesamiento con filtrado Gaussiano para suavizar artefactos, complementado con mecanismos de fallback para garantizar continuidad operacional.

Mapa de calor Grad-CAM, área de interés sobre la imagen de fondo de ojo y zoom del área
Figura 2. Gradiente visto desde la aplicación.

El proceso de regularización integró múltiples estrategias complementarias para prevenir overfitting: regularización L2 en capas densas, Dropout estratificado en puntos críticos de la arquitectura, Batch Normalization para estabilización de activaciones, Early Stopping con monitoreo de pérdida de validación (paciencia de 8 épocas) [16], y reducción adaptativa de tasa de aprendizaje mediante ReduceLROnPlateau (factor 0.5, paciencia de 4 épocas) [15]. Esta aproximación multicapa de regularización demostró ser efectiva para mantener la capacidad de generalización del modelo dentro de las limitaciones del dataset disponible.

La implementación final evolucionó desde un prototipo web inicial hacia una aplicación de escritorio, considerando las restricciones específicas del entorno hospitalario en términos de seguridad de datos, privacidad del paciente, y disponibilidad operacional sin dependencias externas. El sistema resultante integra backend en Python con interfaz HTML5/JavaScript, base de datos relacional SQLite para gestión de usuarios y consultas, autenticación de sesiones, y funcionalidades avanzadas de interpretabilidad visual para apoyo al diagnóstico clínico especializado.

Vista de diagnóstico de la aplicación con dos imágenes de fondo de ojo y su resultado
Figura 3. Vista de diagnóstico de la aplicación.
Vista de gestión de pacientes de la aplicación
Figura 4. Vista de gestión de pacientes de la aplicación.

Resultados

El modelo de clasificación de retinopatía diabética desarrollado demostró un rendimiento excepcional, alcanzando una exactitud promedio del 96.14% en validación cruzada de 5 pliegues. Este nivel de precisión diagnóstica evidencia la efectividad del modelo para distinguir entre imágenes oftalmológicas con retinopatía diabética y casos sin evidencia de la patología, estableciendo una base sólida para su potencial implementación clínica.

La evaluación mediante validación cruzada de 5 pliegues reveló una consistencia notable en el rendimiento del modelo, con variaciones controladas en todas las métricas: exactitud con rango de 2.75 puntos porcentuales (95.12%-97.87%), precisión con variación máxima de 3.82 puntos porcentuales (96.18%-100%), recall con la mayor variabilidad de 5.59 puntos porcentuales (91.93%-97.52%), y F1-Score con variación de 2.92 puntos porcentuales (94.90%-97.82%). Esta estabilidad inter-pliegues sugiere robustez ante diferentes particiones de datos y capacidad de generalización efectiva a muestras no observadas durante el entrenamiento. La variabilidad observada se mantiene dentro de rangos aceptables para aplicaciones clínicas, donde diferencias menores al 5% entre evaluaciones se consideran clínicamente insignificantes. El análisis estadístico reveló una desviación estándar promedio de 1.89% para la exactitud, 1.52% para la precisión, 2.23% para el recall, y 1.46% para el F1-Score. Estos valores de dispersión relativamente bajos indican que el modelo mantiene un rendimiento consistente independientemente de la composición específica del conjunto de entrenamiento y validación.

El Fold 2 emergió como el de mejor rendimiento global, alcanzando la exactitud más alta de 97.87%, la segunda mejor precisión de 98.12%, el mejor recall de 97.52%, y el mejor F1-Score de 97.82%, motivo por el cual fue seleccionado para la implementación final del sistema:

Matriz de confusión del Fold 2: 157 y 157 aciertos, 3 y 4 errores
Figura 5. Matriz de confusión para Fold 2.
Gráfica de accuracy de entrenamiento y validación por época para el Fold 2
Figura 6. Gráfica de accuracy por época para Fold 2.
Gráfica de pérdida de entrenamiento y validación por época para el Fold 2
Figura 7. Gráfica de pérdida por época para Fold 2.

La evaluación crítica mediante el conjunto independiente de 34 imágenes, completamente aislado durante todo el proceso de desarrollo, proporcionó una validación externa fundamental para establecer la aplicabilidad del modelo en el contexto hospitalario dominicano. Este conjunto de validación adquirió particular relevancia al incluir exclusivamente muestras del Hospital Regional Universitario José María Cabral y Báez, permitiendo evaluar la capacidad de generalización del modelo a datos locales específicos.

Los resultados obtenidos en el conjunto de validación independiente demostraron una identificación correcta de 16 imágenes de 17 para ambas clases diagnósticas (retinopatía diabética presente y ausente), traduciendo en una precisión del 94% para cada categoría. Esta cifra representa una diferencia mínima de apenas 2 puntos porcentuales respecto a la precisión del 96% obtenida en validación cruzada, evidenciando la capacidad del modelo para mantener su rendimiento diagnóstico en muestras completamente independientes.

Gráfica de barras de accuracy, precisión, recall y F1-score en los cinco folds
Figura 8. Visualización de resultados de validación cruzada.
Retinopatía DiabéticaSin Retinopatía DiabéticaRetinopatía DiabéticaSin Retinopatía Diabética
EfficientNetB016/1716/1794%94%
Tabla 1. Resultados de validación con conjunto aislado.

Conclusión

El desarrollo de este sistema de inteligencia artificial para la detección de retinopatía diabética ha demostrado exitosamente que es posible el desarrollo de implementaciones de inteligencia artificial satisfactorias en el contexto nacional. Este logro técnico representa un avance hacia la democratización del diagnóstico oftalmológico especializado, especialmente en entornos con recursos limitados donde el acceso a especialistas en retina es escaso. La colaboración interdisciplinaria y la utilización de datos tanto nacionales como internacionales fueron elementos clave que garantizan no sólo la precisión del modelo, sino también su relevancia clínica y aplicabilidad práctica.

El potencial de expansión de este proyecto es considerable, desde la implementación de clasificación multiclase para los cinco niveles de severidad de la retinopatía diabética, hasta la incorporación de otras patologías oculares y el desarrollo de herramientas educativas para futuros oftalmólogos. Con el incremento global de casos de diabetes y la creciente demanda de diagnósticos oportunos, este sistema representa una solución escalable que puede integrarse en protocolos de tamizaje masivo. El llamado a la acción es claro: es viable y prometedor que la comunidad científica, los profesionales de la salud y las instituciones colaboren para expandir esta investigación tecnológica en una herramienta que impacte positivamente miles de vidas.

Referencias

  1. D. S. Fong, L. P. Aiello, F. L. Ferris, and R. Klein, “Diabetic retinopathy,” Diabetes Care, vol. 27, no. 10. pp. 2540–2553, Oct. 2004. doi: 10.2337/diacare.27.10.2540.
  2. S. Kusuhara, Y. Fukushima, S. Ogura, N. Inoue, and A. Uemura, “Pathophysiology of diabetic retinopathy: The old and the new,” Diabetes and Metabolism Journal, vol. 42, no. 5. Korean Diabetes Association, pp. 364–376, Oct. 01, 2018. doi: 10.4093/dmj.2018.0182.
  3. International Diabetes Federation, “IDF Diabetes Atlas, 11th edition,” Accessed: Jun. 14, 2025. [Online]. Available: https://diabetesatlas.org/media/uploads/sites/3/2025/04/IDF_Atlas_11th_Edition_2025.pdf
  4. V. E. Madsen Beau De Rochars et al., “Prevalence of Diabetes, Prediabetes, and Associated Risk Factors among Agricultural Village Residents in the Dominican Republic,” American Journal of Tropical Medicine and Hygiene, vol. 104, no. 6, pp. 2241–2250, Jun. 2021, doi: 10.4269/ajtmh.19-0942.
  5. H. Sadr et al., “Unveiling the potential of artificial intelligence in revolutionizing disease diagnosis and prediction: a comprehensive review of machine learning and deep learning approaches,” European Journal of Medical Research, vol. 30, no. 1, May 2025, doi: 10.1186/s40001-025-02680-7.
  6. World Health Organization, “The top 10 causes of death.” Accessed: Aug. 12, 2025. [Online]. Available: https://www.who.int/news-room/fact-sheets/detail/the-top-10-causes-of-death
  7. H. Safi, S. Safi, A. Hafezi-Moghadam, and H. Ahmadieh, “Early detection of diabetic retinopathy,” Survey of Ophthalmology, vol. 63, no. 5, pp. 601–608, Sep. 2018, doi: 10.1016/J.SURVOPHTHAL.2018.04.003.
  8. M. D. Abràmoff et al., “Automated Early Detection of Diabetic Retinopathy,” Ophthalmology, vol. 117, no. 6, pp. 1147–1154, Jun. 2010, doi: 10.1016/J.OPHTHA.2010.03.046.
  9. V. Gulshan et al., “Development and Validation of a Deep Learning Algorithm for Detection of Diabetic Retinopathy in Retinal Fundus Photographs,” JAMA, vol. 316, no. 22, pp. 2402–2410, Dec. 2016, doi: 10.1001/JAMA.2016.17216.
  10. S. Rowe, C. H. MacLean, and P. G. Shekelle, “Preventing Visual Loss from Chronic Eye Disease in Primary Care: Scientific Review,” JAMA, vol. 291, no. 12. 2004. doi: 10.1001/jama.291.12.1487.
  11. G. Lippi and M. Plebani, “Biomarker research and leading causes of death worldwide: A rather feeble relationship,” Clinical Chemistry and Laboratory Medicine, vol. 51, no. 9. pp. 1691–1693, Sep. 2013. doi: 10.1515/cclm-2013-0210.
  12. S. Ioffe and C. Szegedy, “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift,” 32nd International Conference on Machine Learning, ICML 2015, vol. 1, pp. 448–456, Feb. 2015, Accessed: Aug. 14, 2025. [Online]. Available: https://arxiv.org/pdf/1502.03167
  13. Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, “Gradient-based learning applied to document recognition,” Proceedings of the IEEE, vol. 86, no. 11, pp. 2278–2323, 1998, doi: 10.1109/5.726791.
  14. J. Wang and L. Perez, “The Effectiveness of Data Augmentation in Image Classification using Deep Learning.”, Accessed: Aug. 14, 2025. [Online]. Available: https://www.researchgate.net/publication/321794300_The_Effectiveness_of_Data_Augmentation_in_Image_Classification_using_Deep_Learning
  15. H. Pratt, F. Coenen, D. M. Broadbent, S. P. Harding, and Y. Zheng, “Convolutional Neural Networks for Diabetic Retinopathy,” Procedia Computer Science, vol. 90, pp. 200–205, Jan. 2016, doi: 10.1016/J.PROCS.2016.07.014.
  16. L. Prechelt, “Early stopping – But when?,” Lecture Notes in Computer Science (including subseries Lecture Notes in Artificial Intelligence and Lecture Notes in Bioinformatics), vol. 7700 LECTURE NO, 2012, doi: 10.1007/978-3-642-35289-8_5.

Identificación de plantas dominicanas con IA

John Rodríguez y Jorge Tuma – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

La identificación de plantas ha sido durante mucho tiempo un aspecto crucial para comprender y preservar la biodiversidad, sin embargo, sigue siendo un desafío para muchos expertos debido a la complejidad de las especies y sus variantes. En la República Dominicana existen alrededor de 6,000 plantas vasculares de acuerdo con los informes del Ministerio de Medio Ambiente mediante el Viceministerio de Áreas Protegidas y Biodiversidad [1]. Este proyecto se centra en aplicar tecnologías, como la inteligencia artificial (IA) y las aplicaciones móviles, para simplificar y optimizar el proceso de identificación de plantas. Al combinar un modelo de IA entrenado con técnicas avanzadas de deep learning y una aplicación móvil intuitiva, esta iniciativa busca proporcionar a los usuarios una herramienta accesible para identificar especies de plantas que crecen en todo el territorio del país con precisión, especialmente las endémicas con las cuales modelos similares presentan dificultades. Además, la creación de un conjunto de imágenes de la flora dominicana con la colaboración del Jardín Botánico de Santiago [2], promoviendo la divulgación del conocimiento botánico de la flora local al público general. Esta propuesta es desarrollada por los estudiantes de Ingeniería en Ciencias de la Computación (ICC), Jorge Tuma y John Rodríguez.

El proceso de identificación se encuentra en el modelo de deep learning, desarrollado con Python. Este modelo ha sido entrenado en un conjunto de datos de especies de plantas dominicanas, lo que le permite analizar patrones complejos en imágenes, como estructuras de hojas, formas de flores y variaciones de color. El modelo emplea técnicas avanzadas en redes neuronales convolucionales para garantizar una alta precisión, incluso en diversas condiciones ambientales o con una calidad de imagen limitada. Al integrar este modelo de aprendizaje profundo con la aplicación móvil, el proyecto permite a los usuarios identificar con precisión las plantas mediante imágenes.

La Lista Roja de la Flora Vascular en la República Dominicana [3] es un catálogo útil que presenta el estado de conservación, descripción y localización dentro del territorio nacional de las especies de plantas vasculares en el país. Publicado por el Ministerio de Medio Ambiente y Recursos Naturales, respaldada por expertos en botánica, esta lista constituye un recurso vital para comprender las amenazas que enfrenta la flora del país. Forma parte de un catálogo con validez internacional para documentar y proteger la biodiversidad de la flora del país. Este es un recurso adicional que aporta información clave para la realización del proyecto.

Problemática y estado del arte

En los últimos años, ha habido auge de aplicaciones para teléfonos inteligentes que pueden utilizarse para facilitar la identificación de plantas. Existen diversos enfoques, desde aplicaciones que identifican plantas automáticamente mediante el uso de Inteligencia Artificial (IA) hasta el Reconocimiento Automático de Imágenes. La mayoría de estas aplicaciones se utilizan para identificar plantas automáticamente a partir de imágenes estáticas proporcionadas por los usuarios a estas aplicaciones, donde las decisiones y retroalimentaciones tomadas por los usuarios son mínimas. Todas las aplicaciones de esta naturaleza se comportan de manera similar al usar una imagen en su estado natural o al visualizarla en un monitor de computadora y fotografiarla con el teléfono. Además de identificar la especie en cuestión también se identifica su familia y género. El rendimiento de estas aplicaciones suele ser más de un tercio de todas las identificaciones fueron correctas para la especie, aumentando a más del 65 % correctas para al menos la familia de la planta. Estas aplicaciones están disponibles mediante un portal web o disponible como interfaz de programación de aplicaciones API para la incorporación de la identificación de plantas en otro software [4].

Otro enfoque empleado en proyectos de identificación de plantas consultados consiste en utilizar deep learning para entrenar un modelo de identificación adaptado a reconocer ejemplares de plantas en su estado natural. Se presenta un conjunto de datos de imágenes de plantas recopiladas con teléfono móvil en un entorno natural, que contiene 10,000 imágenes de 100 especies de plantas ornamentales del campus de la Universidad Forestal de Pekín. Se diseñó un modelo de deep learning de 26 capas, compuesto por 8 bloques residuales, para la clasificación de plantas a gran escala en entornos naturales. El modelo propuesto alcanza una tasa de reconocimiento del 91.78 % en el conjunto de datos BJFU100 [5].

Las aplicaciones de identificación, especialmente las disponibles como aplicaciones móviles, como iNaturalist [6] y Pl@ntNet [7], han revolucionado la identificación de plantas mediante el uso de modelos de inteligencia artificial. Tanto profesionales como el público general pueden fotografiar una planta en su ambiente natural. Las imágenes deben ser de la mayor calidad posible para facilitar su identificación, incluyendo tomas de la planta completa, hojas, flores y frutos. A diferencia de estas últimas, esta propuesta pretende construir un modelo de IA capaz de identificar con mayor precisión plantas endémicas de la isla, con las cuales estas aplicaciones suelen flaquear.

Objetivos

El desarrollo de este proyecto es crear una herramienta de identificación de plantas accesible y confiable que aprovecha la inteligencia artificial para mejorar la conciencia de la biodiversidad de plantas del país. Esto se dividió en objetivos específicos alineados con la tarea de recolectar y crear un conjunto de datos de alta calidad de plantas dominicanas, desarrollar un modelo de IA con al menos un 80 % de precisión para la identificación de las plantas presentes en el país e integrar el modelo en una aplicación móvil construida en Flutter. Además, el proyecto pretende construir un conjunto de imágenes de la flora del país con la que se entrene el modelo de inteligencia artificial.

Metodología

Se recopiló un conjunto significativo de imágenes utilizando el catálogo dado por el Jardín Botánico de Santiago de distintas especies de plantas, organizándolas en carpetas individuales con el nombre de cada clase, siguiendo una estructura estándar para proyectos de clasificación de imágenes. Para asegurar la calidad de los datos, se implementaron procesos de depuración, eliminando imágenes corruptas, duplicadas o irrelevantes.

El dataset fue dividido manualmente en conjuntos de entrenamiento y validación (70/30). Las imágenes fueron sometidas a técnicas de preprocesamiento para normalizar los datos de entrada y estandarizar la resolución.

Todas las imágenes fueron redimensionadas a 260×260 píxeles, una medida óptima para modelos preentrenados de clasificación de imágenes, y se aplicó una normalización de los valores de píxeles al rango [0, 1]. Este proceso mejora la estabilidad numérica durante el entrenamiento y acelera la convergencia del modelo.

Se utilizaron técnicas de regularización como Dropout para prevenir el sobreajuste, además de estrategias de control como EarlyStopping y ModelCheckpoint para detener el entrenamiento al detectar estancamiento.

Cactus Opuntia antillana con flores anaranjadas, ejemplar del dataset
Figura 1. Ejemplar del dataset: Opuntia antillana.

Resultados

El modelo entrenado alcanzó una precisión de entrenamiento alrededor de 75 % al 95 %, pero con una precisión de validación más baja, dependiendo de la arquitectura utilizada.

Mediante pruebas externas con imágenes no vistas, se validó la capacidad de ambos modelos para realizar predicciones, pero con plantas muy parecidas, dando a entender que faltan más procesos por afinar, pero demostrando su viabilidad para ser integrados en una aplicación real de reconocimiento de plantas.

El dataset construido para entrenar el modelo posee 350 especies de plantas presentes en el inventario del Jardín Botánico de Santiago. Las imágenes fueron etiquetadas con sus nombres científicos con alrededor de 100 ejemplares por especie.

En términos de la aplicación, posee un apartado para identificar una planta, un mapa interactivo del Jardín Botánico de Santiago y una pestaña con información de las plantas identificadas. La misma está desarrollada para dispositivos móviles Android.

Pantalla 'Identificar una Planta' de la aplicación móvil, con botones de cámara y galería y pestañas Identificar, Mapa e Info
Figura 2. Captura de pantalla de la aplicación.

Conclusión

Este proyecto demuestra el potencial de la inteligencia artificial para abordar los desafíos ambientales del mundo real. Al desarrollar con éxito una aplicación de identificación de plantas basada en un modelo de aprendizaje profundo y con el respaldo de una aplicación móvil fácil de usar, hemos creado una herramienta valiosa para promover la concienciación sobre la biodiversidad de plantas presente en el país, especialmente en el contexto de la rica, pero vulnerable flora de la República Dominicana. Entre los aprendizajes clave se incluyen la importancia de un conjunto de datos de alta calidad y la eficacia del modelo entrenado.

A futuro esta propuesta puede ser expandida para integrar nuevas tecnologías o funcionalidades adicionales. Otra posibilidad sería agregar otros ejemplares al conjunto de imágenes de plantas presentes en el país para mejorar el alcance y las capacidades de identificación del modelo, con especial enfoque en plantas endémicas de la isla. Esto con el fin de promover los esfuerzos de conservación y la divulgación del conocimiento botánico en el país.

Referencias

  1. Viceministerio de Áreas Protegidas y Biodiversidad. (2021). La Biodiversidad en la República Dominicana. https://bvearmb.do/bitstream/handle/123456789/269/BiodiversidadDominicana2021.pdf
  2. Jardín Botánico de Santiago, “Historia y Marco Legal,” Jardín Botánico Prof. Eugenio de Js. Marcano, https://botanicodesantiago.com/historia/.
  3. Ministerio de Medio Ambiente y Recursos Naturales. (2016). Lista Roja: De la Flora Vascular en República Dominicana. Archivo General de la Nación. https://colecciones.agn.gob.do/opac/ficha.php?informatico=00114295PI&codopac=OP003&idpag=1626095770&presenta=digitaly2p#viajeinicial
  4. Jones, H. (2020). Artificial Intelligence for plant identification on smartphones. https://bsbi.org/wp-content/uploads/dlm_uploads/BSBI-News-144-pp34-40-plant-id-apps-final.pdf
  5. Sun, Yu & Liu, Yuan & Wang, Guan & Zhang, Haiyan. (2017). Deep Learning for Plant Identification in Natural Environment. Computational Intelligence and Neuroscience. https://www.researchgate.net/publication/317127150_Deep_Learning_for_Plant_Identification_in_Natural_Environment
  6. iNaturalist, https://www.inaturalist.org/
  7. Identificar, explorar y compartir tus observaciones sobre plantas silvestres, Pl@ntNet, https://identify.plantnet.org/es

Software de monitoreo de red para detección de anomalías para MIPYMES

Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la digitalización ha redefinido la operativa de las empresas, las micro, pequeñas y medianas empresas (MIPYMES) enfrentan un desafío particular: mantener su competitividad sin comprometer la seguridad de su información. La integración progresiva de tecnologías de la información en estas organizaciones ha traído consigo un aumento exponencial en su exposición a amenazas cibernéticas, a menudo sin el respaldo de soluciones robustas que mitiguen los riesgos. Mientras que las grandes empresas disponen de infraestructuras avanzadas y personal capacitado para enfrentar este tipo de desafíos, las MIPYMES se ven limitadas por recursos económicos, técnicos y humanos. Este panorama ha motivado el desarrollo de soluciones especializadas, entre ellas el “Software de Monitoreo de Red para Detección de Anomalías para MIPYMES”, concebido por Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez como parte de su proyecto de grado en la Pontificia Universidad Católica Madre y Maestra (PUCMM).

A diferencia de otros productos comerciales, este software no requiere infraestructuras complejas ni licencias costosas. Está diseñado para ejecutarse en plataformas asequibles como la Raspberry Pi, lo que permite su implementación incluso en entornos con recursos limitados. Esta elección no solo reduce los costos, sino que también facilita el despliegue en redes pequeñas sin afectar el rendimiento. Uno de los pilares de esta solución es su enfoque en el análisis de metadatos en lugar del contenido del tráfico, lo que permite mantener la privacidad de los datos y alinearse con normativas como el Reglamento General de Protección de Datos (RGPD) [1].

Como parte del proceso de diseño, se identificaron las amenazas más comunes en redes que pertenezcan a empresas sin importar su tamaño: ataques de denegación de servicio distribuido (DDoS), escaneo de puertos y fuerza bruta. Estos ataques, aunque variados en su metodología, comparten un mismo objetivo: comprometer la disponibilidad o la confidencialidad de los sistemas. Al simular estos escenarios en entornos controlados utilizando herramientas como Mininet y Wireshark, fue posible analizar con precisión cómo estas amenazas afectan el comportamiento del tráfico de red, extrayendo métricas clave como la tasa de paquetes por segundo, los puertos únicos involucrados, las banderas TCP y la duración de la sesión.

El desarrollo de este proyecto ha permitido implementar un software de monitoreo de red basado en algoritmos de aprendizaje automático, ejecutado en una Raspberry Pi, que permite a las MIPYMES detectar y mitigar amenazas como ataques DDoS, escaneo de puertos y fuerza bruta. Para lograr este objetivo general, se diseñó un sistema escalable compatible con la infraestructura de red existente, se evaluaron modelos como Isolation Forest. Asimismo, se validó experimentalmente su desempeño mediante simulaciones en entornos controlados, confirmando su efectividad y adaptabilidad para su posterior implementación en escenarios reales.

Uno de los elementos más innovadores de esta propuesta radica en la integración de algoritmos de aprendizaje automático para la detección de anomalías. En particular, el uso del algoritmo Isolation Forest resultó crucial debido a su capacidad para identificar patrones inusuales sin necesidad de datos etiquetados, lo que lo convierte en una opción ideal para entornos con tráfico no estructurado y dinámico [11][13]. En pruebas realizadas con datos simulados y reales, este modelo demostró una tasa de detección superior al 90 %, superando a otros enfoques como DBSCAN y One-Class SVM, tanto en precisión como en baja latencia de respuesta [3][12][14].

Durante el desarrollo del sistema, se consideró también la escalabilidad y la eficiencia del procesamiento. Por ello, se incorporaron herramientas como Pandas para el análisis inicial y Dask para el procesamiento distribuido de grandes volúmenes de datos [6][7]. En etapas más avanzadas, se implementó un pipeline sobre Apache Spark, lo que permitió analizar datasets de más de un millón de registros sin comprometer la velocidad del sistema [5].

Es relevante destacar que el sistema no se limita a la detección pasiva. Incluye funcionalidades proactivas como la capacidad de bloquear automáticamente los puertos involucrados en un ataque, mitigando su impacto en tiempo casi real. Este proceso se apoya en reglas heurísticas codificadas a partir de umbrales aprendidos durante la fase de entrenamiento del modelo, los cuales son reforzados por el análisis del algoritmo Isolation Forest. Por ejemplo, un incremento repentino de conexiones hacia múltiples puertos en segundos puede ser indicativo de un ataque DDoS, mientras que múltiples intentos de conexión por SSH en breves intervalos apuntan a un posible ataque de fuerza bruta [26][30][31].

Aunque este software fue concebido inicialmente como un sistema que monitorea y detecta diversas anomalías, su arquitectura y lógica operativa lo posicionan funcionalmente más cerca de un sistema de prevención de intrusiones (IPS) que de un sistema puramente pasivo de detección (IDS). A diferencia de un IDS, que solo analiza el tráfico y alerta al administrador de red ante posibles amenazas, un IPS está diseñado para reaccionar automáticamente ante dichas amenazas y tomar medidas correctivas en tiempo real.

Este software incorpora precisamente esa capacidad de acción inmediata. Por ejemplo, cuando el sistema detecta comportamientos anómalos —como un aumento súbito de conexiones simultáneas hacia múltiples puertos, típico de un ataque DDoS, o múltiples intentos de autenticación SSH en corto tiempo, característicos de un ataque de fuerza bruta— puede ejecutar comandos automatizados para bloquear los puertos involucrados o aislar temporalmente la IP ofensora. Estas acciones son llevadas a cabo por scripts que interactúan directamente con el firewall del sistema operativo, permitiendo una respuesta prácticamente en tiempo real sin intervención humana.

Además, esta lógica de prevención se basa en una combinación de heurísticas definidas por expertos y el análisis dinámico del algoritmo de aprendizaje automático Isolation Forest. Esto permite al sistema no solo actuar frente a amenazas conocidas, sino también responder ante patrones inusuales de comportamiento que podrían corresponder a ataques novedosos o sofisticados. Esta capacidad adaptativa lo diferencia notablemente de los IPS tradicionales basados únicamente en firmas estáticas.

La interfaz gráfica de usuario, desarrollada con un enfoque intuitivo, permite a los usuarios visualizar el estado de la red en tiempo real, recibir notificaciones, modificar umbrales de detección y consultar reportes. Esta interfaz resulta esencial en entornos donde el personal técnico puede ser limitado, ya que democratiza el acceso a funcionalidades avanzadas de monitoreo y respuesta.

Salida de consola del sensor: métricas capturadas de una sesión de red y clasificación como tráfico normal
Figura 1. Salida del sensor: métricas capturadas de una sesión de red y su clasificación.

Otra característica destacada es la generación de alertas vía correo electrónico, función que puede ser configurada desde la GUI y que permite a los administradores recibir notificaciones en tiempo real cuando se detectan comportamientos sospechosos. Estas alertas no solo informan sobre el evento, sino que detallan métricas específicas del tráfico involucrado y la clasificación del tipo de amenaza.

En cuanto a la privacidad de los datos, el sistema implementa múltiples capas de protección: anonimización de direcciones IP, tokenización de credenciales y cifrado de las capturas de tráfico (PCAP) mediante protocolos como TLS/SSL [22]. Además, se ha implementado un sistema de control de acceso basado en roles (RBAC), lo que permite restringir la visualización y edición de parámetros sensibles según el tipo de usuario.

El sistema fue validado mediante pruebas experimentales en laboratorios didácticos de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la PUCMM. Se configuraron topologías que simulan redes reales, incluyendo clientes, servidores y nodos maliciosos. A lo largo de estas pruebas, se midieron métricas como la tasa de verdaderos positivos, tasa de falsos positivos, tiempo de reacción, y uso de recursos del sistema. Los resultados demostraron que incluso en condiciones de tráfico intenso y ataques simultáneos, la Raspberry Pi fue capaz de mantener el procesamiento de datos en tiempo real, activando bloqueos automáticos en menos de 7 segundos desde la detección de la amenaza.

Este proyecto no solo demuestra la viabilidad técnica de una solución de ciberseguridad accesible para MIPYMES, sino que también aporta al ámbito académico y social al validar un modelo replicable para otras instituciones o empresas que enfrenten limitaciones similares. Se plantea como una solución modular, que puede crecer conforme lo hagan las necesidades de la empresa. Por ejemplo, si una MIPYME decide migrar parte de su infraestructura a la nube, el sistema puede ser adaptado para correr sobre instancias virtualizadas, integrarse con SIEMs externos o incorporar sensores IoT para nuevas formas de monitoreo [16][17].

El valor de esta propuesta también se aprecia en su enfoque pedagógico: al haber sido desarrollado en un contexto académico, representa un ejemplo concreto de cómo la investigación aplicada puede responder a necesidades reales del sector productivo. El proyecto se alinea así con una tendencia creciente en el ámbito de la ciberseguridad: la descentralización de las soluciones y su personalización según el entorno operativo, especialmente en regiones en desarrollo donde las soluciones comerciales no siempre son viables [2][29].

En suma, el desarrollo de este software representa un paso importante hacia una ciberseguridad más democrática, donde incluso las organizaciones más pequeñas pueden acceder a herramientas inteligentes de defensa. El uso de aprendizaje automático, herramientas open-source y plataformas de bajo costo demuestra que es posible construir soluciones efectivas sin depender de grandes presupuestos, siempre que se cuente con una metodología sólida, una comprensión clara del problema y un compromiso con la innovación.

A partir de las validaciones experimentales, se observaron también beneficios colaterales que hacen de esta herramienta una solución integral. Una de ellas es su potencial como plataforma de entrenamiento para personal técnico, ya que permite observar en tiempo real cómo se comporta el tráfico de red bajo distintos escenarios de amenaza. Esto no solo es útil para los administradores de red en las MIPYMES, sino también como recurso formativo en entornos educativos. En este sentido, el software puede evolucionar a una versión “educativa” que permita simular ataques, visualizar su detección y analizar la respuesta automática del sistema.

El proyecto, además de ser funcional en su implementación técnica, incorpora un plan detallado de mitigación de riesgos. Esto incluye no solo la detección y respuesta ante amenazas externas, sino también el manejo seguro de los datos, la protección contra accesos no autorizados, y la supervisión de posibles fallas internas del sistema. Se identificaron riesgos como sobrecarga en la Raspberry Pi, fallos en el sistema de alertas, o acceso indebido por parte de usuarios internos. Cada uno de estos fue abordado mediante estrategias preventivas y correctivas, como la autenticación multifactor, el cifrado extremo a extremo, y la verificación periódica de los registros del sistema.

El funcionamiento interno del software está organizado en módulos independientes, que cooperan para capturar tráfico, analizarlo, generar respuestas automáticas y permitir la gestión por parte del usuario. Toda esta arquitectura modular se encuentra en la carpeta «secciones de la aplicación» del repositorio del proyecto.

El script SMR_app.py actúa como controlador principal de la aplicación, iniciando la interfaz gráfica y estableciendo la comunicación entre los módulos. El componente sensor_controller.py se encarga de capturar tráfico en la red en tiempo real utilizando la biblioteca PyShark. Durante esta etapa, se extraen métricas específicas de cada sesión de red, tales como la tasa de paquetes (packet_rate), información enviada (informacion_enviada_mb), puertos involucrados (puertos_unicos), duración de la sesión (duracion_sesion_seg) y banderas TCP (banderas_tcp).

Estas métricas son limpiadas y normalizadas mediante Pandas, y luego pasadas al módulo ml_model.py, que utiliza el modelo de Isolation Forest previamente entrenado y almacenado como ml_model.pkl. El resultado del análisis es una predicción binaria que indica si el tráfico es normal o anómalo.

Desde la interfaz gráfica, desarrollada con PyQt6, los administradores pueden observar alertas en tiempo real, modificar umbrales, activar o detener la detección, y generar reportes. El sistema también cuenta con control de acceso por roles (RBAC), autenticación multifactor (OTP), y registro de auditoría mediante eventos almacenados cada vez que un usuario inicia sesión, configura opciones, o modifica parámetros críticos. Esta arquitectura integral permite una operación segura, eficiente y personalizable de acuerdo a la cada empresa pueda llegar a necesitar.

Pantalla de inicio de sesión de AegisNet con campos de usuario y contraseña
Figura 2. Interfaz gráfica: inicio de sesión.
Tabla de hosts detectados en la red con nombre, IP, dirección MAC y estado
Figura 3. Interfaz gráfica: listado de hosts de la red.
Pantalla de parámetros del sistema: detección, bloqueo automático, correos para alertas y reportes automáticos
Figura 4. Interfaz gráfica: parámetros del sistema, alertas por correo y reportes automáticos.
Pantalla de gestión de reportes con selección de fecha de inicio y de término
Figura 5. Interfaz gráfica: gestión de reportes.

Otro aspecto crucial de esta propuesta es la implementación de un sistema de aprendizaje continuo. Los modelos utilizados no son estáticos: pueden reentrenarse con nuevos datos recolectados a lo largo del tiempo, mejorando así la capacidad del sistema para reconocer nuevas amenazas o adaptarse a cambios en el comportamiento de la red. Esto convierte al software en una herramienta viva, que aprende y se ajusta a medida que evoluciona el entorno digital. Esta funcionalidad fue posible gracias al diseño modular del sistema, que permite actualizar componentes como los modelos de machine learning, las reglas heurísticas o incluso las métricas empleadas, sin necesidad de modificar toda la arquitectura.

Diagrama de flujo: captura de datos, preprocesamiento, entrenamiento del modelo, detección de anomalías, sistema de alertas y visualización
Figura 6. Flujo de funcionamiento del sistema, desde la captura de datos hasta la visualización.

Dentro del sistema, el proceso de clasificación del tráfico se realiza en tiempo real gracias a la eficiencia de bibliotecas como Pandas para la limpieza y estructuración de datos, y a la capacidad de Dask y Spark para operar sobre grandes volúmenes de información distribuida [6][5]. La eficiencia de estas herramientas permitió reducir significativamente los tiempos de análisis, lo que se tradujo en una latencia de respuesta inferior a los 5 segundos en la mayoría de los casos, incluso bajo condiciones de carga media-alta.

En el aspecto de interoperabilidad, el sistema fue diseñado para integrarse fácilmente con herramientas externas como sistemas de gestión de eventos (SIEM). Esto permite ampliar las capacidades del sistema según las necesidades específicas de cada organización. De igual modo, el backend se comunica con bases de datos PostgreSQL, que permiten la trazabilidad completa de eventos y la generación de reportes automatizados [23][24].

Interfaz de AegisNet con gráfico circular de puertos de comunicación por host
Figura 7. Reporte gráfico de la aplicación: puertos de comunicación por host.

En la práctica, esta solución también cumple muchas de las funciones clave de un SIEM (Security Information and Event Management), ya que consolida en un solo sistema la recolección, análisis, correlación y presentación de eventos de seguridad en tiempo real. Sin embargo, el valor añadido de esta aplicación radica en que no requiere una configuración manual de reglas de correlación ni un análisis forense posterior para actuar: la inteligencia incorporada mediante el modelo Isolation Forest le permite tomar decisiones autónomas con base en patrones estadísticos y de comportamiento previamente aprendidos.

El algoritmo Isolation Forest es particularmente eficiente en detectar anomalías sin requerir datos etiquetados, lo que lo hace ideal para entornos dinámicos como las redes de MIPYMES, donde el tráfico puede variar sin seguir patrones estrictos. El sistema realiza una evaluación continua de las métricas de tráfico (tasa de paquetes, puertos únicos, información enviada, etc.) y puede detectar variaciones sutiles que escapen a reglas tradicionales. Por tanto, el sistema no solo identifica amenazas activas, sino también condiciones precursoras que podrían derivar en incidentes de seguridad.

A diferencia de SIEMs comerciales que requieren integraciones costosas o mantenimientos continuos, este sistema basado en herramientas open-source permite a las MIPYMES acceder a funcionalidades similares sin comprometer su presupuesto. Además, ofrece trazabilidad total gracias al registro automático de eventos, accesibles desde PostgreSQL y visualizables desde una GUI estilizada. Esta combinación de SIEM funcional, detección inteligente y respuesta inmediata, convierte a este sistema en una herramienta estratégica para entornos donde los recursos técnicos y humanos son limitados.

El software contempla escenarios de prueba físicos y simulados. Por ejemplo, uno de los escenarios evaluados consistió en la inyección de tráfico malicioso mediante ataques de escaneo de puertos (nmap), fuerza bruta SSH (hydra) y denegación de servicio (hping3) en un entorno virtual creado con Mininet. En este entorno, los resultados obtenidos reflejaron una detección exitosa en más del 90 % de los casos para Isolation Forest, manteniendo la tasa de falsos positivos por debajo del 8 %. En comparación, DBSCAN tuvo una mayor sensibilidad, pero también una mayor propensión a detectar falsos positivos, lo que en entornos reales puede derivar en acciones innecesarias o pérdida de confianza en el sistema [14][20].

Otro escenario fue el análisis de archivos de logs provenientes de un SIEM simulado con registros JSON. En este contexto, el sistema fue capaz de identificar patrones categóricos anómalos, como cambios inesperados en reglas de firewall, intentos de acceso fuera del horario habitual, y modificaciones sospechosas en la configuración de red. Para este caso, DBSCAN mostró mejor desempeño que los modelos lineales, aunque su precisión fue superada por Isolation Forest [12][17].

Isolation ForestPrecisiónRecallF1-ScoreSupport (logs analizados)
Normal0.771.000.87600
Anomalía1.000.130.24210
Accuracy0.78810
Macro avg0.880.570.55810
Weighted avg0.830.780.70810
Tabla 1. Resultados de Isolation Forest en el análisis de logs.

Una innovación adicional que se integró en la fase final del desarrollo fue la simulación de tráfico legítimo. Este componente permite generar escenarios normales controlados, como navegación web, consultas DNS, envío de correos o conexión a servidores internos, con el fin de evaluar el rendimiento del sistema ante comportamientos genuinos. Este tipo de validación fue fundamental para ajustar los umbrales de detección y reducir falsos positivos, un aspecto crítico para que el sistema pueda ser adoptado sin generar interrupciones innecesarias en las operaciones cotidianas de la empresa.

En términos de arquitectura, el sistema fue concebido para funcionar bajo un modelo distribuido. Esto significa que, aunque su núcleo puede ejecutarse en una Raspberry Pi, la solución puede extenderse fácilmente a través de una red de dispositivos que colaboren en la recolección y procesamiento de datos. Por ejemplo, en entornos donde la red se encuentra segmentada por departamentos o ubicaciones físicas, cada segmento podría tener su propio nodo de monitoreo, que luego consolida información hacia un servidor central de análisis.

Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software dentro de la red de la MIPYME
Figura 8. Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software en la red de la MIPYME.

Finalmente, uno de los puntos más valiosos del proyecto es su potencial para adaptarse a otros tipos de entornos. Aunque fue diseñado con las MIPYMES en mente, el sistema puede ser útil también en organizaciones no gubernamentales, centros educativos, o startups que requieran una solución de monitoreo de red sin tener que invertir en plataformas comerciales de alto costo. Su diseño modular y su base en herramientas open-source garantizan que pueda ser reutilizado, ampliado o personalizado según cada caso particular [8][15].

Este software de monitoreo representa mucho más que una simple herramienta de detección. Es una propuesta integral de defensa cibernética accesible, construida con visión académica, enfoque práctico y sensibilidad social. Combina lo mejor del aprendizaje automático con buenas prácticas en privacidad y seguridad, empleando recursos tecnológicos sostenibles y reutilizables. La experiencia obtenida durante su desarrollo no solo permitió validar su funcionalidad, sino que también generó conocimientos valiosos para futuros desarrollos de ciberseguridad en contextos similares. Este proyecto marca así un hito en la promoción de una cultura de ciberdefensa proactiva y descentralizada, especialmente en sectores tradicionalmente excluidos de las soluciones tecnológicas avanzadas.

Referencias

  1. Reglamento General de Protección de Datos (RGPD), available at https://eur-lex.europa.eu/
  2. “Incident Response & Computer Forensics, Third Edition” by K. Mandia, C. Prosise, and M. Pepe.
  3. G. Chandola, A. Banerjee, and V. Kumar, “Anomaly Detection: A Survey,” ACM Computing Surveys, vol. 41, no. 3, 2009.
  4. Scikit-learn Documentation, “Model Evaluation,” available at https://scikit-learn.org/stable/model_evaluation.html
  5. O’Reilly Media, “High Performance Spark: Best Practices for Scaling and Optimizing Apache Spark”.
  6. J. Reback et al., “Pandas: powerful Python data analysis toolkit,” available at https://pandas.pydata.org/
  7. Alla, Sridhar, and Suman Kalyan Adari. 2019, doi:10.1007/978-1-4842-5177-5
  8. Ageyev, Dmytro, et al. Lecture Notes on Data Engineering and Communications Technologies, 2022, pp. 287–305, doi:10.1007/978-3-030-95161-0_13
  9. Bency, J. (2017). Network based Anomaly Detection: An ensemble approach. In Dr. Dominic Carr, MSc Research Project [Thesis].
  10. Alaverronen, Sami, and Jussi Pohjola. “Pandas in Action: Analysis of China Related Advanced Persistent Threat Actors’ Tactics, Techniques & Procedures.” JYX, 1970, jyx.jyu.fi/handle/123456789/90108
  11. F. T. Liu, K. M. Ting and Z.-H. Zhou, “Isolation Forest,” 2008 Eighth IEEE International Conference on Data Mining, Pisa, Italy, 2008, pp. 413-422, doi: 10.1109/ICDM.2008.17
  12. M. H. Bhuyan, D. K. Bhattacharyya and J. K. Kalita, “Network Anomaly Detection: Methods, Systems and Tools,” in IEEE Communications Surveys & Tutorials, vol. 16, no. 1, pp. 303-336, First Quarter 2014, doi: 10.1109/SURV.2013.052213.00046
  13. Fei Tony Liu, Kai Ming Ting, and Zhi-Hua Zhou. 2012. Isolation-Based Anomaly Detection. ACM Trans. Knowl. Discov. Data 6, 1, Article 3 (March 2012), 39 pages. https://doi.org/10.1145/2133360.2133363
  14. A. B. Nassif, M. A. Talib, Q. Nasir and F. M. Dakalbab, “Machine learning for Anomaly Detection: A Systematic Review,” in IEEE Access, vol. 9, pp. 78658-78700, 2021, doi: 10.1109/ACCESS.2021.3083060
  15. Taeshik Shon, Jongsub Moon, A hybrid Machine learning approach to network anomaly detection, Information Sciences, Volume 177, Issue 18, 2007, ISSN 0020-0255, https://doi.org/10.1016/j.ins.2007.03.025
  16. Al-amri, Redhwan, et al. “A Review of Machine learning and Deep Learning Techniques for Anomaly Detection in IoT Data.” MDPI, Multidisciplinary Digital Publishing Institute, 8 June 2021, www.mdpi.com/2076-3417/11/12/5320
  17. Pajouh, H.H., Dastghaibyfard, G. & Hashemi, S. Two-tier network anomaly detection model: a Machine learning approach. J Intell Inf Syst 48, 61–74 (2017). https://doi.org/10.1007/s10844-015-0388-x
  18. Schölkopf, B., Platt, J., Shawe-Taylor, J., Smola, A. J., & Williamson, R. C. (2001). Estimating the support of a high-dimensional distribution. Neural Computation, 13(7), 1443-1471.
  19. Kavitha, R., & Kumaravel, N. (2020). Anomaly detection using deep autoencoders for cybersecurity applications. Journal of Information Security and Applications, 54, 102578.
  20. Ester, M., Kriegel, H. P., Sander, J., & Xu, X. (1996). A density-based algorithm for discovering clusters in large spatial databases with noise. Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD-96), 226–231.
  21. C. M. Bishop and N. M. Nasrabadi, Pattern Recognition and Machine Learning, vol. 4, no. 4, p. 738. New York: Springer, 2006.
  22. Internet Engineering Task Force (IETF), “The Transport Layer Security (TLS) Protocol Version 1.3,” RFC 8446, Aug. 2018.
  23. Python Software Foundation, “Python Language Reference,” https://docs.python.org/3/reference/index.html
  24. A. Orebaugh, G. Ramirez, and J. Beale, Wireshark & Ethereal Network Protocol Analyzer Toolkit, Syngress, 2007.
  25. K. Scarfone and P. Mell, “Guide to Intrusion Detection and Prevention Systems (IDPS),” NIST Special Publication 800-94, 2007.

Modelo Predictivo para la Identificación de Fake News en Español sobre la Enfermedad del Cáncer utilizando Machine Learning

José Rafael Jáquez Torres y Brigibel Ysaura Martínez Martínez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La desinformación sobre el cáncer: un reto hispanohablante

El crecimiento del internet y las redes sociales ha cambiado la manera en que se accede y se distribuyen las noticias. No obstante, este crecimiento también ha propiciado la propagación de la desinformación. En ese sentido, uno de los sectores más afectados por esta difusión es el de la salud, particularmente en enfermedades como el cáncer. Conforme a lo señalado por el Instituto Nacional del Cáncer de Estados Unidos [1], existe una gran cantidad de desinformación acerca del cáncer en la red, lo que incluye videos e historias que predican curas milagrosas con tratamientos no comprobados científicamente y en algunos casos dañinos para la salud.

Esta problemática está particularmente presente en las comunidades hispanohablantes, donde las barreras lingüísticas y culturales dificultan el acceso a información verificada. Un artículo de Think Global Health [2] destaca que la difusión de información falsa en el ámbito de la salud representa un desafío significativo creciente en las comunidades de habla hispana, principalmente en Estados Unidos. Además, menciona que los hispanohablantes suelen depender de redes sociales como principal fuente de información, lo que los hace más vulnerables a recibir y compartir contenido con información falsa o inexacta, ya que los algoritmos de estas plataformas no siempre priorizan fuentes verificadas.

Dada esta situación, resulta necesario desarrollar soluciones efectivas capaces de identificar y disminuir la desinformación en español, proporcionando a las comunidades hispanohablantes recursos más confiables para tomar decisiones mejor informadas, lo que puede prevenir acciones que puedan resultar dañinas para la salud de los mismos.

A pesar de los avances en la detección de fake news, la mayoría de los recursos disponibles están en el idioma inglés, dejando un vacío en la comunidad hispanohablante. Los pocos sistemas que existen en español suelen basarse en adaptaciones de modelos monolingües o en traducciones automatizadas, lo cual afecta su precisión y contextualización cultural [2].

En ese orden, los primeros acercamientos técnicos se fundamentan en métodos basados en reglas y heurísticas, que identifican patrones lingüísticos y estructuras típicas de la desinformación [3], [4]. Aunque estos sistemas sentaron las bases de la detección automática, su rigidez y dependencia de reglas manuales limitan su capacidad para adaptarse a la creatividad y la evolución constante del lenguaje en entornos digitales [5].

Con la consolidación del aprendizaje supervisado, se introdujeron clasificadores clásicos como SVM [6], Random Forest [7], XGBoost [8] y Naïve Bayes [9] entrenados sobre vectores TF-IDF [10] y optimizados con técnicas de búsqueda de hiperparámetros. Paralelamente, las redes neuronales densas (DNN) demostraron un rendimiento superior (94.5 % de accuracy) al compararlas directamente con algoritmos tradicionales utilizando el FakeNewsNet dataset [11].

Ahora bien, la llegada de arquitecturas Transformers [12] ha elevado aún más la efectividad de los modelos, permitiendo capturar relaciones contextuales bidireccionales y matices semánticos complejos. Sin embargo, la mayoría están preentrenados en inglés o en múltiples idiomas sin especialización para el español, lo que dificulta su aplicación directa en la detección de noticias sobre cáncer en este idioma.

Finalmente, las estrategias de transferencia cross-lingual y zero-shot [13] ofrecen un camino prometedor para aprovechar recursos en inglés sin sacrificar la contextualización cultural en español. Modelos basados en BERT [14] como mBERT, BETO y XLM-RoBERTa han demostrado viabilidad en escenarios de pocos datos etiquetados, aunque aún requieren validación específica en el dominio del cáncer y ajustes finos para maximizar su precisión en la comunidad hispanohablante. Es por esto que:

El desarrollo de este proyecto ha implementado un modelo predictivo que emplea técnicas de aprendizaje automático para identificar de esta manera noticias falsas en español sobre el cáncer, mediante la recopilación de noticias que son tanto de fuentes verificadas como falsas, aplicando posteriormente técnicas de preprocesamiento de texto para asegurar que este sea de utilidad para el análisis y modelado de los datos. De igual forma, se aplicó la adaptación específica del modelo al idioma español para mejorar el acceso de la comunidad hispanohablante, así como la evaluación rigurosa con métricas estándar de clasificación y el diseño de una interfaz gráfica que integra el modelo, permite realizar pruebas interactivas y verificar su funcionamiento.

Del corpus al prototipo: un flujo modular

La propuesta se basa en un flujo de trabajo modular que integra captura, procesamiento, modelado y despliegue. Partimos de una recolección híbrida de datos (corpus público, artículos científicos y ejemplos manuales/sintéticos) para alimentar tanto modelos tradicionales (SVM, Random Forest, XGBoost) como arquitecturas Transformer (BETO, mBERT). A continuación, cada subsistema se diseñó, implementó y validó por separado antes de su integración final en un prototipo funcional.

1. Recolección de datos

Se utilizó el FakeNewsCorpusSpanish [15], que aporta 1248 noticias (624 reales y 624 falsas). Complementariamente, se extrajeron 1,176 artículos de SciELO [16] (2018-2024) mediante Selenium [17], y se incorporaron 105 declaraciones falsas verificadas manualmente junto a 100 párrafos generados con Grok 3 para simular patrones de desinformación realistas.

2. Preprocesamiento y normalización

El preprocesamiento unificó formatos y limpió el texto: eliminación de caracteres especiales, tokenización con nltk.punkt, eliminación de stopwords y lematización con spaCy. Para modelos basados en BETO se empleó el BertTokenizer (bert-base-spanish-wwm-uncased) con Byte Pair Encoding, ajustando secuencias a 512 tokens. Este pipeline se fundamentó en estudios comparativos de técnicas de preprocesamiento en español, que muestran variaciones significativas en precisión y tiempo de ejecución según la combinación de métodos.

3. Creación y entrenamiento de modelos predictivos

Se evaluaron cinco algoritmos tradicionales sobre vectores TF-IDF con Grid Search CV [18] para ajustar hiperparámetros, y distintas arquitecturas basadas en BETO (Original, BETO+SVM, BETO+LSTM, BETO+BiLSTM). Además, se experimentó con mBERT + SVM para explorar capacidades cross-lingual. Asimismo, la eficiencia de las técnicas de Deep Learning para la detección de noticias falsas en español ha sido validada en trabajos como “Fake News Detection in Spanish Using Deep Learning Techniques”.

4. Validación y métricas

El rendimiento de cada modelo se midió utilizando métricas entre las cuales se encontraban el accuracy, precision, recall, F1-score, ROC-AUC y AUPRC, empleando validación cruzada de 5 folds para estimar estabilidad. En ese sentido, la inclusión de AUPRC, recomendada para clases desbalanceadas, confirmó diferencias mínimas respecto a AUROC [19], reforzando la precisión del sistema en distintos escenarios.

5. Integración del prototipo

El backend se desplegó en Flask sirviendo un servicio REST que recibe texto, lo tokeniza y devuelve la clasificación. La interfaz web, implementada en React/NextJS, admite texto manual, archivos (TXT, PDF) mediante un API en Spring Boot [20] y extracción de enlaces (YouTube, Reddit, webs) mediante Trafilatura, reddit-api y youtube-api-server [21]. Por lo que, esta UI permite la extracción de contenido en distintos formatos como enlaces o archivos, y adicionalmente proporciona feedback inmediato permitiendo al usuario validar la confianza del texto analizado.

Interfaz web del detector: sección para ingresar una URL, el texto de la noticia o un archivo
Figura 1. Interfaz del prototipo: sección de ingreso de información.
Interfaz web del detector: resultado del análisis y formulario de retroalimentación
Figura 2. Interfaz del prototipo: resultado del análisis y sección de retroalimentación.

6. Herramientas y buenas prácticas

Se utilizó Python 3.9 [22], GitHub [23] para versionado, Docker [24] para contenedores reproducibles y GPU NVIDIA RTX 2070 o P100 para entrenamiento acelerado. Así pues, a diferencia de la mayoría de estudios centrados en inglés o en dominios específicos, nuestra metodología incorpora un corpus balanceado en español y explora transferencias cross-lingual sin traducción previa.

A continuación, una breve explicación de cada métrica evaluada en los modelos seleccionados:

  • Accuracy (exactitud): proporción de predicciones correctas (verdaderas + falsas) sobre el total de muestras [62].
    Accuracy = (TP + TN) / (TP + FP + FN + TN)
  • Precisión: de todas las muestras que el modelo etiquetó como positivas (por ejemplo, “fake news”), ¿qué porcentaje lo era realmente? [25]
    Precision = TP / (TP + FP)
  • Recall: de todas las muestras realmente positivas, ¿qué porcentaje el modelo identificó correctamente? [26]
    Recall = TP / (TP + FN)
  • F1-Score: media armónica entre precisión y recall. Es útil cuando existe un desequilibrio de clases [25].
    F1 = 2 · (Precision · Recall) / (Precision + Recall)
  • Specificity: de todas las muestras negativas (“noticias verdaderas”), ¿qué porcentaje se clasificó correctamente como negativas? [26]
  • ROC AUC: área bajo la curva ROC, mide la capacidad de distinguir entre clases en todos los umbrales posibles [25].
  • AUPRC: área bajo la curva Precision–Recall, especialmente relevante cuando las clases están desbalanceadas [19].
  • Cohen’s Kappa: coeficiente de acuerdo entre predicciones y verdad terreno, corregido por el azar [26].
  • MCC (Matthews Correlation Coefficient): métrica balanceada que considera verdaderos y falsos positivos y negativos; toma valores en [–1, +1], donde +1 es predicción perfecta [26].
  • Loss (pérdida): función objetivo optimizada durante el entrenamiento (en los modelos clásicos se muestra como “Loss” del conjunto de validación). Así pues, valores menores indican mejor ajuste [26].
Esquema de la curva ROC con un modelo perfecto, uno aceptable y uno aleatorio
Figura 3. Interpretación de la curva ROC: modelo perfecto, modelo aceptable y modelo aleatorio.

Construyendo confianza: resultados contra las fake news

A continuación, se presenta un análisis descriptivo de los resultados obtenidos con los distintos modelos, tanto los clásicos (SVM, Random Forest, Logistic Regression, XGBoost y Naive Bayes) como los de enfoque deep learning (basados en BETO).

ModeloValidación cruzadaAccuracyPrecisionRecallF1-ScoreSpecificityROC AUCAUPRCCohen’s KappaMCCLoss
SVMCon CV0.81450.8150.80380.80920.80380.89860.90240.62870.62890.4021
Random ForestCon CV0.81820.85080.7610.80320.7610.90780.91150.63520.63890.4397
Logistic RegressionCon CV0.810.80150.81180.80620.81180.90260.90990.61990.62050.3946
XGBoostCon CV0.81380.81410.82550.81970.80150.90270.9070.62730.62740.4088
Naive BayesCon CV0.7710.8170.68430.74380.68430.87260.88910.53980.54750.5836
Tabla 1. Resultados de los modelos clásicos con validación cruzada.

Random Forest sobresale entre los clásicos con 81.82 % de accuracy y AUPRC≈0.91, superando ligeramente a XGBoost y SVM.

Naive Bayes sufre por el desequilibrio de clases y la representación bag-of-words, quedando en 77.10 % de exactitud y MCC≈0.55.

Las pérdidas de validación (“Loss”) se sitúan entre 0.39 y 0.58, indicando que los modelos clásicos requieren más ajuste o datos para igualar al deep learning.

ModeloAccuracyPrecisionRecallF1-ScoreSpecificityROC AUCAUPRCCohen’s KappaMCC
BETO + SVM0.97040.97250.96450.96840.97590.98920.99040.94060.9407
BETO0.96330.96990.95180.96020.97340.99060.9910.92610.9271
mBERT + SVM0.93450.93620.93960.93780.92890.97460.97850.86850.8687
mBERT0.93180.91980.96210.93950.89730.9730.97650.86180.865
Tabla 2. Resultados de los modelos basados en Transformers.

BETO + SVM alcanza el mejor balance, con 97 % de accuracy y AUPRC≈0.99, mostrando que la combinación de embeddings de BETO y un clasificador lineal SVM captura tanto las noticias verdaderas como las falsas de forma casi perfecta.

El modelo BETO queda muy cerca, indicando que el vector pooled de BETO ya codifica suficiente información, pero añadiendo SVM se gana un +0.7 % en accuracy y +0.014 en MCC.

Los enfoques mBERT comparado con BETO son más bajos, debido a su vocabulario multilingüe más genérico: mBERT + SVM logra 93.45 % de accuracy frente al 96.04 % de BETO, y su MCC cae de 0.94 a 0.87.

Hacia un futuro sin desinformación

El proyecto ha demostrado que los modelos basados en Transformers son una buena opción para la detección de desinformación sobre el cáncer. Cabe destacar que, aunque la combinación BETO + SVM alcanzó los puntajes más altos en métricas como accuracy y AUPRC, su rendimiento en pruebas reales resultó menos consistente que en el que se aplicó únicamente BETO. En cambio, BETO logró cerca de un 97 % de precisión tanto en el dataset de entrenamiento como en los escenarios reales, por lo que fue el modelo seleccionado para el despliegue final, garantizando una clasificación estable y confiable.

Como recomendaciones futuras, se plantea ampliar el conjunto de datos colaborando con hospitales y organismos de salud hispanohablantes, así como expandir el alcance del prototipo a otras patologías críticas como la diabetes, enfermedades cardiovasculares, etc. En ese sentido, invitamos a la comunidad académica y a posibles aliados a participar aportando datos, retroalimentación activa y recursos para reentrenar el modelo, mejorar la usabilidad de la interfaz y desplegar esta solución en plataformas de producción. Todo esto, con el objetivo de seguir combatiendo de manera efectiva la creciente ola de desinformación.

Referencias

  1. Equipo del NCI, “La desinformación sobre el cáncer en las redes sociales.” [Online]. Available: https://www.cancer.gov/espanol/noticias/temas-y-relatos-blog/2021/desinformacion-sobre-cancer-redes-sociales
  2. I. Rolz, “Debunking Health Misinformation in Latino Communities.” [Online]. Available: https://www.thinkglobalhealth.org/article/debunking-health-misinformation-latino-communities
  3. M. Choras et al., “Advanced Machine Learning Techniques for Fake News (Online Disinformation) Detection: A Systematic Mapping Study,” 2021, arXiv. doi: 10.48550/ARXIV.2101.01142.
  4. N. Hoy and T. Koulouri, “A Systematic Review on the Detection of Fake News Articles,” 2021, arXiv. doi: 10.48550/ARXIV.2110.11240.
  5. C. Ireton, J. Posetti, and UNESCO, Eds., Journalism, “fake news” & disinformation: handbook for journalism education and training. in UNESCO series on journalism education. Paris: United Nations Educational, Scientific and Cultural Organization, 2018.
  6. N.-I. Galanis, P. Vafiadis, K.-G. Mirzaev, and G. A. Papakostas, “Machine Learning Meets Natural Language Processing — The story so far,” 2021, arXiv. doi: 10.48550/arXiv.2104.10213.
  7. L. Breiman, “Random Forests,” Mach. Learn., vol. 45, no. 1, pp. 5–32, 2001, doi: 10.1023/A:1010933404324.
  8. T. Chen and C. Guestrin, “XGBoost: A Scalable Tree Boosting System,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, San Francisco California USA: ACM, 2016, pp. 785–794. doi: 10.1145/2939672.2939785.
  9. E. Frank and R. R. Bouckaert, “Naive Bayes for Text Classification with Unbalanced Classes,” in Knowledge Discovery in Databases: PKDD 2006, vol. 4213, D. Hutchison et al., Eds., Berlin, Heidelberg: Springer Berlin Heidelberg, 2006, pp. 503–510. doi: 10.1007/11871637_49.
  10. D. E. Cahyani and I. Patasik, “Performance comparison of TF-IDF and Word2Vec models for emotion text classification,” Bull. Electr. Eng. Informatics, vol. 10, no. 5, pp. 2780–2788, 2021, doi: 10.11591/eei.v10i5.3157.
  11. L. Rojas Rubio and C. Meneses Villegas, “Una comparación empírica de algoritmos de aprendizaje automático versus aprendizaje profundo para la detección de noticias falsas en redes sociales,” Ingeniare. Rev. Chil. Ing., vol. 30, no. 2, pp. 403–415, 2022, doi: 10.4067/S0718-33052022000200403.
  12. K. Martínez-Gallego, A. M. Álvarez-Ortiz, and J. D. Arias-Londoño, “Fake News Detection in Spanish Using Deep Learning Techniques,” 2021, arXiv. doi: 10.48550/arXiv.2110.06461.
  13. M. Strong, R. Aly, and A. Vlachos, “Zero-Shot Fact Verification via Natural Logic and Large Language Models,” 2024, arXiv. doi: 10.48550/ARXIV.2410.03341.
  14. S. Kasim, “One True Pairing: Evaluating Effective Language Pairings for Fake News Detection Employing Zero-Shot Cross-Lingual Transfer,” in Soft Computing and Its Engineering Applications, vol. 1788, K. K. Patel, K. C. Santosh, A. Patel, and A. Ghosh, Eds., Cham: Springer Nature Switzerland, 2023, pp. 17–28. doi: 10.1007/978-3-031-27609-5_2.
  15. jpposadas, “jpposadas/FakeNewsCorpusSpanish,” 2024. Accessed: Feb. 07, 2025. [Online]. Available: https://github.com/jpposadas/FakeNewsCorpusSpanish
  16. “Programa SciELO, Modelo de Publicación y Red SciELO | SciELO.org.” Accessed: Mar. 28, 2025. [Online]. Available: https://scielo.org/es/sobre-el-scielo/programa-modelo-de-publicacion-y-red-scielo/
  17. “Selenium.” Accessed: Mar. 28, 2025. [Online]. Available: https://www.selenium.dev/
  18. “GridSearchCV.” Accessed: Mar. 28, 2025. [Online]. Available: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GridSearchCV.html
  19. W. Chen et al., “Commonly used software tools produce conflicting and overly-optimistic AUPRC values,” Genome Biol., vol. 25, no. 1, p. 118, May 2024, doi: 10.1186/s13059-024-03266-y.
  20. “Spring Boot.” Accessed: Mar. 24, 2025. [Online]. Available: https://spring.io/projects/spring-boot
  21. “youtube-transcript-api: This is an python API which allows you to get the transcripts/subtitles for a given YouTube video. It also works for automatically generated subtitles, supports translating subtitles and it does not require a headless browser.” Accessed: Jun. 09, 2025. [Online]. Available: https://github.com/jdepoix/youtube-transcript-api
  22. “Welcome to Python.org,” 2025. Accessed: Mar. 24, 2025. [Online]. Available: https://www.python.org/about/
  23. “Build software better, together.” Accessed: Mar. 24, 2025. [Online]. Available: https://github.com
  24. “What is Docker? | Docker Docs.” Accessed: Mar. 28, 2025. [Online]. Available: https://docs.docker.com/get-started/docker-overview/
  25. A. de la Torre, “Reconocimiento de emociones musicales y generación de un dataset de etiquetado categórico,” E.T.S. de Ingenieros Informáticos (UPM), 2019. Accessed: Feb. 13, 2025. [Online]. Available: https://oa.upm.es/56029/
  26. V. de Dios Domínguez, “Fake news detection with pretrained transformers,” E.T.S. de Ingenieros Informáticos (UPM), 2023. Accessed: Feb. 13, 2025. [Online]. Available: https://oa.upm.es/75835/

Sistema de apuestas de gallos descentralizado

Figura ilustrativa relacionada al tema.

Dominigel Rodriguez Peña

Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

Las peleas de gallos consisten en un combate entre dos gallos de un mismo género, las cuales se realizan dentro de una gallera o coliseo. (Pelea de Gallos) Las apuestas de gallos son una actividad popular en muchas partes del mundo. A pesar ser consideradas ilegales en ciertos países, en la República Dominicana las apuestas de gallos son una actividad legal y regulada por el gobierno. (Decreto N.º 250-99. Decreto que aprueba El Reglamento de la Comisión Nacional de Lidias de Gallos. 1999).

Mas allá de esto, las peleas de gallos en la República Dominicana son un evento tradicional, en donde se suelen atraer a muchos espectadores y a menudo se realizan apuestas sobre el resultado de la pelea. Aunque es una práctica arraigada culturalmente y considerada un deporte en el país, existe una falta de mecanismos que formalicen este deporte, estancando su expansión y posible internacionalización de juegos dominicanos, lo que, a la larga, podría favorecer a la economía dominicana.

Es crucial abordar estas deficiencias para mejorar la credibilidad de las apuestas, lo que impacta directamente a los participantes y a la sociedad en general al promover apuestas más justas y seguras.

Contexto

En las peleas de gallos se tiene una gran informalidad, en estas ha habido históricamente una falta de transparencia, confianza y seguridad para los participantes quedando esta última en base a la palabra de cada individuo como coloquialmente se llama “palabra de gallero”. Estos problemas se derivan de la ausencia de mecanismos que garanticen la equidad e integridad de las apuestas.

El sistema de apuestas de gallos en República Dominicana tiene distintas formas. Una de ellas consiste en tener un intermediario llamado “juez de malla”, el cual recibe todas las apuestas apostadas por ambas partes (en este caso, un jugador A y un jugador B) que deseen apostar en contrariedad para posteriormente entregarle los fondos al ganador y actuando como testigo de la promesa realizada.

El sistema tradicional genera 70 mil millones de pesos dominicanos anualmente entre todas las bancas de apuestas, esto sin contar lo generado por las galleras siendo parte importante de los 100 millones de pesos que se mueven diariamente en los juegos de azar en República Dominicana. (Diario, Bancas de Apuestas Tienen Ganancias de RD$70 mil mm Al Año 2015) (El Nacional, Juegos Azar rd mueven $100 Millones Diarios 2013)

Proyectos Relacionados

El mercado de los juegos de azar en internet y con la integración con criptomonedas ha permitido mover más de 50 billones solo en la plataforma de Stake.com, siendo un sitio de apuestas en línea. (Danckert, The secret australian origins of the world’s biggest crypto casino 2021).

En el artículo presentado en la conferencia International Conference on Blockchain Applications «Smart Contracts for Sports Betting: A Decentralized Approach» por M. Chen, S. Shen, y Z. Guo (2017), se propone un sistema de apuestas deportivas descentralizado basado en contratos inteligentes. Los autores describen cómo los contratos inteligentes pueden ser utilizados para automatizar el proceso de apuestas, eliminar la necesidad de intermediarios y garantizar la transparencia de las transacciones. El artículo también analiza los desafíos técnicos y legales asociados con la implementación de este tipo de sistema.

En el informe «Decentralized Gambling: A Survey of Blockchain-Based Applications» por A. Narayanan (2017), publicado por el Centro de Estudios Monetarios Internacionales, se proporciona una descripción general de las aplicaciones de blockchain para el juego descentralizado. El autor analiza diferentes tipos de aplicaciones, incluyendo plataformas de apuestas, juegos de azar y loterías. El informe también identifica los principales desafíos y oportunidades asociados con la descentralización del juego, y concluye que la tecnología blockchain tiene el potencial de revolucionar esta industria.

Solución Propuesta

Por esta razón, se desarrolló una aplicación que determina mediante visión computacional si el usuario ejecuta de manera ópt

Como solución a dicho problema, se propone la creación de una plataforma que permita gestionar el proceso de creación y finalización de peleas de gallos, permitiendo la apuesta de los participantes en cada pelea y la visualización de estas en vivo. Todo esto utilizando contratos inteligentes que sirven como reglas automáticas que se activaran cuando una de las reglas fijadas entre una de las dos partes realice alguna acción.

La adopción de tecnología emergente como el uso de criptomonedas representa una oportunidad para innovar en este campo, atrayendo nuevos participantes y modernizando esta práctica tradicional. En conclusión, se busca lograr atraer nuevos participantes y el crecimiento del mercado local, buscando nuevas personas que se integren sin necesidad de ir de forma presencial a la gallera.

Metodología

Para facilitar la lógica dentro de la plataforma web, se va a implementar cadena de bloques o “blockchain”. Este es un libro de contabilidad que permite el registro de transacciones, seguimiento y creación de reglas que se ejecutan de forma automática.  Mas específicamente dentro de este término, los contratos inteligentes se deben de ver como un conjunto de reglas definidas que están almacenadas en una cadena de bloques, se ejecutan cuando se cumplen las condiciones definidas, y que no son modificables y son autónomos. Estas condiciones se establecen utilizando una cadena de bloques o blockchain, la cual nos permite distribuir nuestro contrato a través de la red, asegurando que no se pueda modificar.

Resultados Obtenidos

Se realizó un desarrollo de un cliente web, basado en el tipo de implementación web SPA utilizando Vue3.js. Para el desarrollo de los contratos inteligentes, como se puede observar en la figura 19, se desarrollaron basándose RoostApp 49 en el patrón de diseño Factory. Este patrón nos permite generar otros contratos a partir de un contrato existente.

De esta manera se llego a obtener una aplicación móvil totalmente funcional, preparada para registrar galleras, registrar jugadas, ser transparente en la repartición de beneficios y segura e intuitiva.

Además, se entiende que se cuenta con una interfaz cómoda e intuitiva para nuevos usuarios como para veteranos y con una recopilación de datos fiable y eficiente para el análisis temporal como para posterior evaluación.

Conclusiones

Esto culminó en el desarrollo e implementación de una aplicación web funcional que permitía transacciones para múltiples usuarios y el uso eficiente de contratos inteligentes.

Se encontraron algunos desafíos inesperados, como el uso excesivo de gas para las transacciones, lo que nos llevó a optimizar los contratos para reducir costos operativos.

Una limitación importante fue la negativa de algunas de las plataformas que tienen los derechos de la mayoría de los coliseos en el país, a transmitir sus peleas en la plataforma. La colaboración con ellos sería crucial para la viabilidad económica del proyecto, ya que las galleras tradicionales carecen de la infraestructura necesaria.

Recomendaciones

Para mejorar la viabilidad y desarrollo de la aplicación, se recomienda integrar mejoras no contempladas inicialmente, como el uso de stablecoins para evitar la volatilidad del Ether y proteger las ganancias de los usuarios. Además, sería beneficioso montar un nodo de Ethereum propio para no depender de servicios de terceros, y utilizar herramientas como Truffle o Hardhat para el desarrollo, pruebas y despliegue de contratos inteligentes, lo que aumentaría la velocidad y eficiencia del desarrollo. Finalmente, se sugiere explorar nuevas formas de colaboración con GalleroSoy o entidades similares para asegurar la viabilidad económica y la disponibilidad de contenido relevante para la plataforma.

Referencias


  • Material design (no date) Material Design. Available at: https://m3.material.io (Accessed: 29 November 2023).


Dispositivo asistencial orientado a personas con discapacidades visuales implementando visión computacional

Andrés Mauricio Estrella Espejo y John Harold Peña Acosta

Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

Los sentidos corporales son nuestros interpretadores del mundo que nos rodea. Los seres humanos tenemos cinco sentidos: la vista, el gusto, el olfato, el oído y el tacto que percibimos a través de ojos, lengua, nariz, oídos y piel, respectivamente. Según los investigadores Dr. L.D. Rosenblum y el Dr. Harold Stolovitch, La cantidad de información que cada uno de nuestros sentidos procesa al mismo tiempo en comparación con nuestros otros sentidos es la siguiente; 83% Vista, 11% Oído, 3.5% Olfato, 1.5% Tacto y 1% Gusto. Esto nos permite inferir que las personas con discapacidad visual son más propensas a tener dificultades para la percepción de información y además tienden a tener mayor dificultad en su vida cotidiana.

Por esto y otras razones, este proyecto se limitará a brindar solución a las problemáticas de identificación de dinero e identificación de obstáculos.

Contexto

En la República Dominicana (2014) se estima que “hay unas 33 mil personas, en edades comprendidas entre los 18 y 65 años, totalmente ciegas de ambos ojos, quienes representan el 0.34% de la población” (ver referencia 3, sección de referencias). Muchas de estas personas se enfrentan a diario a los retos identificados anteriormente.

Proyectos Relacionados

Para la solución de la problemática planteada, Robert K. Katzschmann desarrolló su propio sistema de equipos electrónicos denominado ALVU (Array of Lidars and Vibrotactile Units). Su dispositivo consta de 2 cinturones, uno con motores vibratorios que brindan retroalimentación y otro compuesto por un conjunto de 7 sensores LIDAR apuntando en todas direcciones.

Este producto también contiene un conjunto de sensores, en este caso ultrasónicos y sensores ToF (Time of Flight) y brinda retroalimentación de manera háptica mediante vibraciones. Otra clase de este tipo de proyectos buscan rediseñar el clásico bastón blanco y mejorarlo con sensores y motores que guían al usuario fuera de los obstáculos.

B. Li et al., en “Vision-Based Mobile Indoor Assistive Navigation Aid for Blind People,” detecta obstáculos dinámicos y ajusta la ruta planeada en tiempo real. Primero toma información geométrica de planos arquitectónicos y genera un mapa semántico formado por una capa global transitable en 2D y capas sensibles al contexto. Logra localizar al usuario diseñando un algoritmo de alineación de mapas para unir el archivo de descripción del área visual (ADF) y el mapa semántico. Usando la cámara RGB-D integrada, desarrolla un detector de obstáculos eficiente basado en un algoritmo de filtro Kalman de mapa con marca de tiempo (TSM-KF).

Solución Propuesta

La solución consiste en un dispositivo vestible, llevado en el pecho mediante un arnés. Contiene el hardware adecuado para poder ejecutar un repertorio de software que aumente la calidad de vida de las personas con discapacidades visuales haciendo uso de visión computacional.

El repertorio de software consta de una multitud de aplicaciones que asisten en tareas cotidianas, a modo de ejemplo, algunas de estas aplicaciones serían: lector de textos, desde etiqueta de alimentos hasta libros, navegador GPS, videollamada con una persona para asistencia al usuario en situaciones que requieran de una ayuda más minuciosa, identificador de cartas para juegos de mesa, entre algunos otros.

El proyecto se centra en soluciones con enfoque visual, apoyándose únicamente de sensores de imágenes. Se capturan imágenes del ambiente del usuario, el sistema procesa dichas imágenes y se brinda retroalimentación auditiva en base a los resultados.

El algoritmo extractor de características implementado en el proyecto es conocido como “Oriented FAST and Rotated BRIEF” (ORB), este fue elegido tras investigar comparativas de algoritmos de la misma categoría ya que brindaba el mejor rendimiento en la mayoría de los casos y también está bajo licencia de software libre.

El resultado del proyecto será un producto completamente funcional, que se describe como prototipo debido a que no tendrá un diseño industrial, listo para la venta en el mercado. Por igual, tampoco tendrá una distribución de energía eficiente que le permita estar encendido por muchas horas, si no lo necesario para desarrollo y pruebas.

Metodología

Este proyecto es en fundamento un proyecto de visión computacional. Muchos problemas pueden ser abordados por la visión computacional, por ejemplo: reconocimiento facial, lectura de caracteres, clasificación de imágenes, etc.

Por eso, como primer paso del modelo, las imágenes capturadas son tomadas como entrada inicial del sistema. Posteriormente, la imagen capturada se procesa para obtener como salida la denominación de algún billete o la identificación de algún obstáculo. Posteriormente, la conversión de las imágenes de color a escala de grises es útil porque simplifica la cantidad de información contenida en una imagen, permitiendo al sistema realizar más operaciones complejas en menos tiempo, para después implementar en el sistema la detección de bordes es a través de Canny Edge Detection, ya que este proporciona mejores resultados en comparación con otros métodos. La detección de bordes se utiliza en complemento con segmentación de imágenes para extraer un área de interés al cual se le realizan varias operaciones en etapas posteriores.

Resultados Obtenidos

En la figura superior se encuentra diagramado el flujo de operaciones que ejecuta el sistema cada ciclo. Algunos puntos que valen la pena destacar son los siguientes: es posible el cambio de modo de funcionamiento o el apagado del sistema de manera asíncrona. No es necesario esperar que algún audio se termine de reproducir para empezar a procesar la próxima imagen, ya que esta tarea es ejecutada en hilos distintos.

El usuario interactúa con el dispositivo mediante un solo botón físico y unos auriculares que se conectan automáticamente por bluetooth (si ya se habían conectado manualmente previamente) o se podrían conectar mediante la salida de audio de la Raspberry Pi. El botón se utiliza para encender el dispositivo (si el dispositivo esta apagado), cambiar de modo de funcionamiento y para apagar el dispositivo si se deja presionado por tres o más segundos. Toda la retroalimentación se le brinda al usuario de manera auditiva.

 En las pruebas de detección de billetes determinamos que el rendimiento bajo las mejores condiciones resulta en un tiempo promedio de respuesta de 4 segundos. Esta cantidad acomoda el tiempo que le toma al usuario posicionar el billete frente al sensor y el tiempo que podría tomarle al sensor enfocar la imagen al objetivo. A medida que empeora la iluminación del ambiente el rendimiento se torna inconsistente y el tiempo promedio de respuesta aumenta.

En las pruebas de distancia descubrimos que el sensor logra detectar y estimar con un margen de error de +-0.1m la distancia de objetos que se encuentran entre 0 y 15 metros de distancia del sensor. En la prueba de multitud obtuvimos un resultado inesperado, donde el rendimiento fue mejor en el ambiente de alta iluminación que en el de iluminación regular.

Conclusiones

Este proyecto ha demostrado ser eficaz en la implementación de soluciones de visión computacional para las tareas descritas en los objetivos del proyecto. La funcionalidad de detección de billetes funciona consistentemente y en tiempo real bajo condiciones ideales de iluminación, permitiendo a los usuarios identificar la denominación de los billetes dominicanos sin asistencia. La detección de obstáculos amplía el rango de detección de un invidente hasta 14 metros más allá de las dimensiones de su bastón, mejorando su percepción del entorno. El dispositivo es fácil de usar, tiene una curva de aprendizaje mínima y componentes pequeños que permiten su portabilidad.

Un resultado inesperado fue la mayor consistencia en la detección de billetes cuando están orientados por el anverso en lugar del reverso. Esto puede deberse a que los diseños de los billetes anversos contienen más elementos gráficos, facilitando la detección. En condiciones de iluminación inadecuadas, el desempeño del dispositivo disminuye, y la detección de obstáculos se ve afectada cuando los objetos se solapan. Además, el dispositivo no puede determinar la legitimidad de los billetes, y el estado físico de los billetes también afecta la precisión de la detección.

Recomendaciones

Para futuras mejoras del proyecto, se sugiere agregar una linterna para mejorar la detección de billetes en condiciones de poca iluminación y considerar la integración de un sensor IR o un sensor binocular con IR para mejorar la detección de obstáculos en baja iluminación. Incluir comandos por voz y rediseñar el sistema de retroalimentación para el módulo de detección de obstáculos también serían beneficiosos. Además, sería útil mejorar la distribución de calor de los componentes o agregar métodos de refrigeración, así como idear y desarrollar más modos de funcionalidad para el dispositivo.

Referencias

  • Rosenblum, See What I’m Saying: The Extraordinary Powers of Our Five Senses. Los Angeles, 2010.
  • A. Semary, S. M. Fadl, M. S. Essa, and A. F. Gad, “Currency recognition system for visually impaired: Egyptian banknote as a study case,” in 2015 5th International Conference on Information & Communication Technology and Accessibility (ICTA), 2015, pp. 1–6. doi: 10.1109/ICTA.2015.7426896.
  • “Ciegos no detectan marcas para no videntes en billetes dominicanos,” Diario Libre, Santo Domingo, Apr. 23, 2014. Accessed: Jul. 23, 2022. [Online]. Available: https://www.diariolibre.com/actualidad/ciegos-no-detectan-marcas-para-novidentes-en-billetes-dominicanos-JKDL577781
  • Zhang, W. Yan, and M. Kankanhalli, “Overview of currency recognition using deep learning,” Journal of Banking and Financial Technology, vol. 3, Jan. 2019, doi: 10.1007/s42786-018-00007-1.
  • Katzschmann, B. Araki, and D. Rus, “Safe Local Navigation for Visually Impaired Users With a Time-of-Flight and Haptic Feedback Device,” IEEE Transactions on Neural Systems and Rehabilitation Engineering, vol. PP, p. 1, Jan. 2018, doi: 10.1109/TNSRE.2018.2800665.
  • Katzschmann, B. Araki, and D. Rus, “Safe Local Navigation for Visually Impaired Users With a Time-of-Flight and Haptic Feedback Device,” IEEE Transactions on Neural Systems and Rehabilitation Engineering, vol. PP, p. 1, Jan. 2018, doi: 10.1109/TNSRE.2018.2800665.

Sistema de ayuda para la identificación de las patologias de la piel

Leslie Nicole Rodriguez Nuñez

Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

La prevalencia de enfermedades de la piel demuestra lo comunes que son las patologías en la dermis y lo costoso que puede resultar el tratamiento en la industria. Desde condiciones leves como el acné hasta enfermedades más graves como el melanoma, los problemas dermatológicos afectan a millones de personas en todo el mundo, incrementando la demanda de atención médica especializada y de tratamientos efectivos. Además de los costos directos del tratamiento, estas enfermedades pueden tener un impacto significativo en la calidad de vida de los pacientes, afectando su bienestar físico, emocional y social. Por estas razones, se necesitan técnicas multifacéticas para abordar el aumento de los problemas de la piel y para implementar un tratamiento temprano que no solo mejore los resultados de salud, sino que también reduzca los costos asociados a tratamientos prolongados y complicaciones avanzadas.

Contexto

La prevalencia de enfermedades de la piel ha aumentado notablemente en los últimos años a escala mundial. Esta escalada ha atraído una atención significativa de investigadores, médicos y legisladores debido a su impacto en el bienestar general de las personas y la salud pública. Según la World Health Organization, en “Radiation: Ultraviolet (UV) radiation and skin cancer,” la incidencia de melanoma maligno desde principios de la década de 1970, ha aumentado considerablemente; por ejemplo, en promedio incrementó un 4% anual en los Estados Unidos. Numerosos estudios muestran una correlación entre los hábitos de exposición a los rayos UV de una persona, cambios climáticos, los rasgos genéticos y personales y su probabilidad de desarrollar un melanoma maligno. De acuerdo con la exposición del sol y los cambios climáticos en N. Balato, M. Megna, F. Ayala, A. Balato, M. Napolitano, and C. Patruno, en “Effects of climate changes on skin diseases,” se expone que el factor primario que influye en el proceso de fotocarcinogénesis es la cantidad de rayos UV recibidos en la superficie terrestre.

Proyectos Relacionados

Uno de los primeros artículos relacionados corresponde a Y. N. Fu’adah, N. C. Pratiwi, M. A. Pramudito, and N. Ibrahim, quienes realizaron el estudio titulado: “Convolutional Neural Network (CNN) for Automatic Skin Cancer Classification System”, en el cual se justifica el objetivo de la investigación debido a que el melanoma maligno es una afección provocada por modificaciones en las características de las células sanas de la piel para que se vuelvan malignas, lo que hace que las células se dividan sin control en formas anormales como resultado del daño en el ADN, además de que aborda los distintos pasos de integración en su red neuronal.

Por otra parte, en su reporte científico titulado “Skin cancer diagnosis using convolutional neural networks for smartphone images: A comparative study” de S. Medhat, H. Abdel-Galil, A. E. Aboutabl, and H. Saleh, compara diferentes técnicas de redes neuronales con imágenes tomadas por teléfono celular. En este, expone que los sistemas de diagnóstico ayudados por computadora para imágenes de cáncer de piel tomadas con teléfonos inteligentes pueden servir como un sistema de alerta para casos graves, mostrando la relevancia que tienen las lesiones de la piel y el uso de la tecnología que poseemos.

Por último, W. Gouda, N. U. Sama, G. Al-Waakid, M. Humayun, and N. Z. Jhanjhi en su artículo “Detection of skin cancer based on skin lesion images using deep learning” expone el uso de diferentes fuentes de datos comparando con el modelo de red neuronal empleando imágenes tomadas por teléfonos celulares.

Solución Propuesta

La solución que se plantea es crear un mecanismo que haga uso de una red neuronal para poder identificar lesiones de la piel. Este mecanismo sería un portal web donde el especialista de la piel sea capaz de subir la imagen que desea evaluar y como resultado se muestre el porcentaje de probabilidad de las lesiones.

Con relación al modelo, las lesiones que se proponen analizar son Melanoma, que es la clase a la cual se le piensa colocar más enfoque, Nevus (Lunares o verrugas) por su naturaleza común entre los seres humanos y carcinoma de células basales porque puede representar un objeto de confusión a la hora del diagnóstico.

Con el propósito de proporcionarle al usuario una interfaz gráfica comprensible, se creará un portal web, en el que el mecanismo deberá ser capaz de mostrar de una manera sencilla los porcentajes de las diferentes lesiones propuestas para que el especialista tome la decisión de los pasos a seguir con el paciente. En este portal, el paciente subirá las imágenes que desea evaluar y el dermatólogo decidirá aquellas que desea que sean evaluadas por el modelo.

Metodología

La composición del proyecto se divide en dos partes principales, la implementación del modelo de clasificación utilizando CNN para las patologías de la piel y la aplicación de este en un portal web para que pueda ser utilizado. En la primera parte, se plantea que el modelo se entrene con datos de diversas fuentes de información utilizando regularizadores, aumento de datos, funciones de activación, callbacks y técnicas para evitar el sobreajuste del modelo, para luego ser validado y testeado por una porción de los mismos datos y efectividad de este a través de métricas de evaluación.

Se plantea que el portal web reciba la imagen que se quiera evaluar, y luego de utilizar el modelo previamente creado, muestre las probabilidades de las diferentes patologías que el modelo es capaz de pronosticar en términos de porcentajes.


Resultados Obtenidos

Se estructuro una aplicación web capaz de, a través del entrenamiento pronfundo explicado, clasificar hasta cinco patologías de la piel que afectan a la población dominicana. Aplicando técnicas de overfitting y dropping, se asegura la exactitud y precisión del modelo para imágenes fuera del dataset.


Conclusiones

Debido al aumento de incidencias patológicas, la contaminación mundial y el incremento de la desinformación en las redes sociales en la República Dominicana, este proyecto ofrece una solución conveniente para pacientes con discapacidad, vida ajetreada o como preconsulta para determinar la necesidad de una consulta presencial.

Este sistema permite procesar imágenes de patologías de la piel, permitiendo a los expertos verificar y ofrecer los pasos que el paciente debe seguir, tomando medidas tempranas para evitar que las situaciones se agraven. Además, el sistema tiene potencial como herramienta de apoyo en centros médicos y establecimientos especializados en el cuidado de la piel, proporcionando retroalimentación a los pacientes a través de un portal accesible sin necesidad de una visita presencial, a menos que sea requerida por el profesional.

La solución propuesta también puede contribuir al avance de metodologías de preprocesamiento de información en la industria médica, utilizando visión computacional para la extracción y categorización de imágenes. Mediante una red neuronal convolucional y librerías como TensorFlow.

Un resultado inesperado fue la mayor consistencia en la detección de billetes cuando están orientados por el anverso en lugar del reverso. Esto puede deberse a que los diseños de los billetes anversos contienen más elementos gráficos, facilitando la detección. En condiciones de iluminación inadecuadas, el desempeño del dispositivo disminuye, y la detección de obstáculos se ve afectada cuando los objetos se solapan. Además, el dispositivo no puede determinar la legitimidad de los billetes, y el estado físico de los billetes también afecta la precisión de la detección.

Recomendaciones

A pesar de los grandes beneficios del sistema, todavía existen oportunidades de mejora de este para ofrecer una mejor calidad y presión del modelo. Un ejemplo 68 de esto es referente a la iluminación y calidad de las imágenes el cuál puede afectar considerablemente el desempeño del modelo y la predicción de las patologías en las que está entrenado, por lo tanto, podría ser necesario realizar varias pruebas o información sobre la iluminación y calidad de esta al usuario o en cambio, implementar algoritmos de corrección de imagen para poder asegurar una mayor calidad de las probabilidades.

Cabe recalcar que el sistema no pretende reemplazar el criterio profesional sino en ser una colaboración de este, por lo tanto, para colaborar con el crecimiento y apoyo mutuo entre la industria médica y el aprendizaje automático se recomienda agregar secciones de pago seguras que permitan al paciente saldar el costo correspondiente de la consulta y del mismo modo, que el profesional experto reciba remuneración por el trabajo que está realizando.

Tomando en cuenta que el sistema no utiliza ningún mecanismo para mejorar la calidad de la imágen, las probabilidades pueden verse afectadas por el mismo. Por consiguiente, por lo que se recomienda implementar un sistema para mejorar y manejar la calidad y resolución de las imágenes para que luego se sometan a evaluación y poder asegurar mejores resultados.

Referencias

  • World Health Organization, “Radiation: Ultraviolet (UV) radiation and skin cancer,” www.who.int, Oct. 16, 2017. https://www.who.int/news-room/questions-and-answers/item/radiation-ultraviolet-(uv )-radiation-and-skin-cancer
  • Y. N. Fu’adah, N. C. Pratiwi, M. A. Pramudito, and N. Ibrahim, “Convolutional Neural Network (CNN) for Automatic Skin Cancer Classification System,” IOP Conference Series: Materials Science and Engineering, vol. 982, p. 012005, Dec. 2020, doi: https://doi.org/10.1088/1757-899x/982/1/012005.
  • S. Medhat, H. Abdel-Galil, A. E. Aboutabl, and H. Saleh, “Skin cancer diagnosis using convolutional neural networks for smartphone images: A comparative study,” 72 Journal of Radiation Research and Applied Sciences, vol. 15, no. 1, pp. 262–267, Mar. 2022, doi: https://doi.org/10.1016/j.jrras.2022.03.008.
  • W. Gouda, N. U. Sama, G. Al-Waakid, M. Humayun, and N. Z. Jhanjhi, “Detection of Skin Cancer Based on Skin Lesion Images Using Deep Learning,” Healthcare, vol. 10, no. 7, p. 1183, Jun. 2022, doi: https://doi.org/10.3390/healthcare10071183.
  • Listín Diario, “Las enfermedades de la piel más comunes en el país; cómo prevenirlas y tratarlas,” Listindiario.com, Apr. 21, 2022. https://listindiario.com/la-republica/2022/04/21/718251/las-enfermedades-de-la-pielmas-comunes-en-el-pais-como-prevenirlas-y-tratarlas.html (accessed Jul. 27, 2023).

Sistema de supervisión para ejercicios de pesas libres con visión computacional

Jeferson Rosa Tejada y Luis Manuel Castro Herrera
Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

El problema de las lesiones en los gimnasios es algo que ocurre frecuentemente alrededor del mundo, debido a la inexperiencia de los afiliados y muchas veces al desconocimiento o desinformación de cómo realizar el ejercicio apropiadamente.

Hay que recalcar que la incorrecta elaboración y el mal uso de esta conlleva un sinnúmero de problemas, que afectan a las personas de manera negativa, de una duración corta, mediana o hasta larga en el peor de los casos. Y aunque en la mayoría de las ocasiones se cuenta con una supervisión directa por un entrenador que ha de corregir la mala ejecución de los ejercicios, estas correcciones pueden llegar a ser subjetivas y escasas debido al personal limitado de las instalaciones.

Por eso es tan importante tercializar la corrección de la técnica, buscando avanzar hacia un futuro mas autónomo, correcto y seguro a través de, por ejemplo, un sistema de sistema de supervisión para ejercicios de pesas libres con visión computacional, como el que estaremos discutiendo en el presente artículo.

Contexto

Las lesiones en los gimnasios son más frecuentes que lo que nos damos cuenta. En todo el mundo, gracias a la ignorancia y falta de información muchas veces los ejecutores resultan realizando ejercicios inapropiadamente, desde aficionados en el gimnasio hasta incluso profesionales deportistas y fisicoculturistas. Es vital para todos involucrados evitar a toda costa las lesiones y malas prácticas de los ejercicios que fortalecen a estos atletas.

El cuerpo humano se mueve gracias a los músculos y las contracciones y relajaciones constantes de estos músculos. Algunos músculos pueden tirar de huesos para moverlos, pero no pueden hacer el movimiento contrario, por ello se cuenta de un par y trabajan en conjunto, estos son llamados extensores y flexores. Por ejemplo, el bíceps es un musculo flexor y se encuentra en la parte frontal del brazo permitiéndonos cierto movimiento y el tríceps se encuentra en la parte posterior o codo y es un extensor. Para doblar el brazo el bíceps se contrae, y cuando el bíceps se relaja y se contrae el tríceps entonces se endereza el brazo.

Las lesiones musculares son una de las más comunes causas que llevan a deportistas y otros profesionales a disminuir o incluso a interrumpir su entrenamiento y participación competitiva, ya que, estas lesiones y sus consecuencias pueden repetirse y empeorarse con la actividad motriz constante.

De acuerdo con un estudio y seguimiento realizado en República Dominicana en la ciudad de Santo Domingo, el medico ortopeda Marcelo Puello concuerda que un 50% de los practicantes de ejercitación física no realizaron una evaluación médica previa y terminaron por acudir a una consulta por lesiones. De entre estos también confirma Puello que diariamente cerca de la mitad de los lesionados son jóvenes deportistas de entre 15 a 30 años. Ortopedas especifican que las lesiones de rodilla, muñeca, espalda baja y tobillo son algunas de las más frecuentes y que la desinformación y el desconocimiento de las técnicas son su causa directa.  A falta de supervisión directa, lo mejor que se le puede ofrecer a esta generación tecnológica es una solución digital, por esto la necesidad de desarrollar un sistema con retroalimentación que sea de fácil utilización para el público.

Proyectos Relacionados

Un estudio estadounidense publicado en National Health Statistics Reports midió la incidencia de accidentes en un periodo de 3 años y descubrió que las actividades que más lesiones ocasionaron fueron, sorpresivamente, ejercicios generales (involucrando levantamiento de pesas en gimnasios).

En 2021, se identificó que al ejecutar el ejercicio de la sentadilla con frecuencia las personas no estaban conscientes de qué parte del cuerpo les molestaba o dolía y desarrollaron una propuesta recurriendo a la visión artificial y modelos matemáticos para analizar el movimiento de todo el ejercicio para así dar una valoración sobre si este se realiza correctamente comparándolo con modelos ejecutados por profesionales en el área.

Solución Propuesta

Funcionamiento ilustrativo del sistema

Por esta razón, se desarrolló una aplicación que determina mediante visión computacional si el usuario ejecuta de manera óptima el ejercicio de pesas libres evitando lesiones.

El proyecto estará dividido en varias partes principales: el área amplia para ejercitarse la cual idealmente contará con buena iluminación, espejo y una forma de retroalimentación donde la persona podrá realizar los ejercicios propuestos. Un sistema de procesamiento computacional de imágenes que funcionará para analizar a la persona en el área de ejercicios y evaluará su postura y ejecución del ejercicio. Finalmente, una base de datos de la persona la cual servirá no solo para almacenamiento de los datos personales y progreso de las personas que tengan acceso, pero también servirá para almacenamiento de los parámetros ideales de los ejercicios disponibles.

Metodología

Modelo interactivo del sistema.

Para llevar a cabo el proyecto en el estado actual contamos con tres trípodes a una altura de 1.3m, separados a una distancia de 2.5m del área de ejercicio donde el usuario se colocará. Cada trípode se encuentra a cada lado del usuario y uno de estos de frente. Montados en los trípodes se hallan las cámaras web que servirán de entrada de datos para el análisis computacional, las cámaras son rotadas 90 grados para finalizar en una posición vertical en la que favorece la captura más amplia del usuario, pero a la vez reduce el ruido visual. Las cámaras transmiten la información a través de extensores USB de alrededor de 4.5m directamente conectadas al computador personal que ejecuta las técnicas de procesamiento computacional de imágenes. Estas técnicas son ejecutadas gracias a un programa en lenguaje de alto nivel Python. Utilizando librerías como Mediapipe para poder realizar el seguimiento del cuerpo a partir de la información recibida de la cámara y mediante este poder analizar con los parámetros ideales como se realiza correctamente el ejercicio.

A la misma vez se toma información valiosa para registrar en la base de datos de lenguaje de consulta estructurada (SQL). También en esta base de datos se identifica el usuario inicialmente con un acceso único y se le da seguimiento a este. Con la información anterior analizada y registrada se devuelve al usuario retroalimentación visual y sugerencias para la ejecución exitosa del ejercicio de sentadillas. Si el usuario desea en cualquier momento puede consultar cómo debe ejecutar el ejercicio óptimamente gracias a videos pregrabados con profesionales e instrucciones textuales.

Resultados Obtenidos

En un ambiente controlado, hemos probado y evaluado el sistema, logrando una precisión media en el seguimiento de los movimientos del usuario. Aunque el sistema puede rastrear las posiciones y movimientos de un solo usuario con facilidad, presenta dificultades cuando hay múltiples usuarios en la escena. Dado que el sistema no está diseñado para múltiples usuarios, estamos trabajando en una solución más robusta para mantener el enfoque en el usuario objetivo.

Mapa de puntos del programa.

La retroalimentación e instrucciones de los movimientos del usuario se ha demostrado eficiente. Contando con instrucciones textuales y demostraciones visuales previas a la ejecución, así como retroalimentación visual en tiempo real precisa y respuesta del ejercicio recién realizado se ha demostrado más que suficiente ayuda para el usuario familiarizarse con el ejercicio y corregir su postura. 

Ejercicios disponibles.

Además, se entiende que se cuenta con una interfaz cómoda e intuitiva para nuevos usuarios como para veteranos y con una recopilación de datos fiable y eficiente para el análisis temporal como para posterior evaluación.

Conclusiones

El proyecto ha demostrado ser una solución efectiva para la corrección de técnicas y la prevención de lesiones en gimnasios pues la precisión en la detección de errores y la capacidad de proporcionar retroalimentación en tiempo real posicionan al sistema como una herramienta valiosa para los usuarios de gimnasios, independientemente de su nivel de experiencia. Proyectando una reducción significativa en el número de lesiones reportadas lo que valida la importancia de la correcta supervisión de ejercicios y el potencial de la tecnología de visión computacional para mitigar riesgos asociados con la mala ejecución de ejercicios.

Recomendaciones

El almacenamiento y análisis de datos de los usuarios no solo facilita un seguimiento personalizado, sino que también permite la mejora continua del sistema. Esta adaptabilidad es crucial para mantener la relevancia y efectividad del sistema a medida que evoluciona la tecnología y cambian las necesidades de los usuarios.

Dado el éxito del proyecto piloto, se recomienda la expansión del sistema a otros ejercicios y la integración con dispositivos móviles para aumentar la accesibilidad y facilidad de uso. Además, la incorporación de funciones adicionales, como la personalización de rutinas de ejercicio basadas en el análisis de datos históricos del usuario, podría mejorar aún más la experiencia del usuario.

Es importante recalcar que el programa esta pensado solo para 1 persona, sin interferencia de demás cuerpos. Esto, a la larga, se podría estructurar para seguir a un individuo a pesar de su entorno, aunque otras técnicas deben ser aplicadas.

Referencias

 P. Smith, «How to measure, report and verify soil carbon change to realise the potential of soil carbon sequestration for atmospheric greenhouse gas removal,» INSTITUTE FOR CARBON REMOVAL LAW AND POLICY, USA, 2019.


 A. S. Susanto B. Sulistyo, «Design and performance test of portable spectrometer using AS7265x multispectral sensor for detection of adulterated cane sugar in granulated coconut sugar,» AIP Conference Proceedings, USA, 2023.


 M. J.-L. F. R. J.-L. Andrés Fernando Jiménez-López, «Multispectral analysis of vegetation for remote sensing applications,» Iteckne, Colombia, 2015.

[1] T. Taylor, Muscular System, 2021 [En línea] Disponible: https://www.innerbody.com/image/musfov.html [Ultimo acceso: 2 abril 2023] [2] L. Hirsch, Huesos, Músculos y Articulaciones, 2019. [En línea] Disponible: https://kidshealth.org/en/parents/bones-muscles-joints.html [Ultimo acceso: 2 abril 2023] [3] N. M. .. P. P. d. L. Infante Ruiz, La resolución de problemas de Biomecánica Deportiva como actividad investigativa, Luz, vol. XX, nº 3, 2021.

[9] A. I. Dibujes Félix, Sistema electrónico de evaluación de postura de la espalda al realizar el ejercicio de sentadillas con barra libre usando algoritmos de aprendizaje autónomo en miembros del club de físico culturismo de la Universidad Técnica del Norte, 2018. [En línea]. Disponible: http://repositorio.utn.edu.ec/handle/123456789/8275. [Último acceso: 28 noviembre 2022].


Sistema para la detección enfermedades en cultivos de Arroz

Ilka Hernández y Patricia DiMassimo
Estudiantes Escuela de Ingeniería en Eléctrica, Campus Santiago
PUCMM

El arroz en República Dominicana

El cultivo del arroz es una actividad agrícola fundamental en muchos países del mundo, especialmente en República Dominicana, donde se consume en grandes cantidades y se cultiva extensamente. Sin embargo, la presencia de enfermedades y condiciones de estrés puede afectar significativamente la producción y calidad de los cultivos de arroz, lo que a su vez afecta la economía y la seguridad alimentaria las regiones donde se distribuye este producto. Por lo que, la detección temprana de estas enfermedades y condiciones de estrés es un desafío para los agricultores, ya que a menudo son difíciles de detectar a simple vista.

Para abordar este problema, se propone la implementación de un sistema de procesamiento de mapas multiespectrales e imágenes para la detección temprana de enfermedades y condiciones de estrés en cultivos de arroz.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la detección temprana de enfermedades en cultivos de arroz. El sistema desarrollado combina técnicas de visión computacional y aprendizaje de máquinas. Fue desarrollado un esquema de fusión de datos para la creación de modelos de naturaleza heterogénea.

La Digitalización en la Agricultura

La creciente intersección entre la tecnología y la agricultura ha revolucionado la manera en que se aborda los desafíos agrícolas en la actualidad. Uno de los avances más notables ha sido la aplicación de la inteligencia artificial (IA) en este campo. La capacidad de procesar grandes volúmenes de datos y extraer patrones significativos ha permitido optimizar la producción y la toma de decisiones agrícolas. La integración de sensores avanzados y microcontroladores como el ESP32, ha facilitado la recolección y el análisis de información crítica para el diagnóstico y prevención de enfermedades en cultivos, como el arroz. Esta revisión se enfoca en la evaluación de cómo la tecnología, especialmente la inteligencia artificial, ha impactado en la agricultura, con énfasis en la aplicación de sensores multiespectrales y microcontroladores en el reconocimiento temprano de enfermedades en hojas de arroz.

La combinación de tecnologías de medición multiespectral e inteligencia artificial ha dado lugar a soluciones novedosas en la detección de adulteración en productos agrícolas. Un ejemplo destacado es el desarrollo de un espectrómetro portátil que utiliza este sensor para evaluar la pureza del azúcar de coco y detectar la adulteración con azúcar de caña. La implementación de redes neuronales permitió una clasificación precisa de muestras adulteradas y puras, con una tasa de éxito del 100% en casos de azúcar de coco y un promedio superior al 90% para estimar la intensidad de la adulteración.

Diversos proyectos relacionados han abordado problemáticas similares en la detección y diagnóstico de enfermedades en cultivos, lo que amplía la comprensión de las aplicaciones y desafíos de la tecnología. Por ejemplo, un estudio se centró en la detección de malezas y la estimación de la salud de las vides utilizando el NDVI en combinación con el sensor multiespectral. Aunque enfrentaron desafíos de calibración y sesgos, estos proyectos reflejan la creciente importancia de las herramientas tecnológicas en la agricultura de precisión y subrayan la necesidad de investigación continua para superar obstáculos técnicos.

Solución Propuesta

La implementación del presente proyecto tiene como objetivo mejorar la producción de arroz al reducir los efectos negativos de las enfermedades y condiciones de estrés en los cultivos. En cuanto a la composición, las imágenes multiespectrales se obtendrían mediante la utilización del sensor multiespectral seleccionado que puede capturar la luz en diferentes longitudes de onda. Las mediciones multiespectrales capturadas por este sensor proporcionaron información detallada sobre el estado de salud de los cultivos de arroz.

Además, se utilizaron técnicas de procesamiento de imágenes para mejorar la calidad y precisión de los datos obtenidos de las mediciones multiespectrales. Estas técnicas incluyen la corrección de distorsiones en las imágenes, la eliminación de ruido y la normalización de los datos para garantizar una representación precisa de la salud de los cultivos. Este sistema combina la ciencia de la agricultura con la tecnología de la información y el aprendizaje automático, para proporcionar una solución integral y efectiva para la detección temprana de enfermedades y condiciones de estrés en los cultivos de arroz.

Para la creación del sistema físico, se utilizó la herramienta de CAD SolidWorks para diseñar dos cajas negras. Ambas cajas tienen las mismas dimensiones, pero con propósitos diferentes. La caja mostrada en la siguiente está diseñada para trabajar con el sensor multiespectral seleccionado y dos arreglos de LEDs. Su función es proporcionar un espectro de emisión que abarca un rango desde los 400 nm (ultravioleta) hasta los 750 nm (infrarrojo cercano). El objetivo de este diseño es captar el espectro reflejado por las hojas de arroz y utilizar esta información para determinar ciertas condiciones relacionadas con los niveles de hidratación de las hojas.

Se empleó un microcontrolador ESP32 para gestionar la activación y desactivación de los LEDs que emiten diversas frecuencias espectrales y que son dirigidos a las hojas de arroz. El ESP32 es una opción ligera pero altamente confiable para esta tarea. Con este microcontrolador, se estableció una comunicación con el sensor multiespectral utilizando el protocolo I2C. En la siguiente figura se muestra una imagen con la configuración de entrada y salida del microcontrolador elegido.

En la carcasa diseñada fueron acomodadas tanto la cámara como el sensor multiespectral seleccionado, permitiendo las capturas de hojas individuales de arroz para su caracterización. Se seleccionó el color negro para evitar el efecto de la reflexión y se colocaron LEDs específicos para las distintas frecuencias del espectro electromagnético que se deseaban caracterizar. En la siguiente imagen podemos ver un ejemplo de una imagen capturada.

Se analizó cada hoja en términos de valores de reflectancia y absorción en cada una de las 18 bandas del sensor (410nm, 435nm, 460nm, 485nm, 510nm, 535nm, 560nm, 585nm, 610nm, 645nm, 680nm, 705nm, 730nm, 760nm, 810nm, 860nm, 900nm, 940nm). Para lograrlo fue colocado un arreglo de 6 LEDs capaces de proporcionar las longitudes de onda mostradas con dirección a la hoja. En la siguiente figura se observa la respuesta capturada a partir del sensor multiespectral.

Metodología para el entrenamiento de los algoritmos de aprendizaje de máquina

A partir de estas imágenes se procedió a entrenar un modelo de clasificación basado en las redes neuronales convolucionales. AlexNet es un modelo de red neuronal convolucional considerado uno de los modelos más influyentes en el campo del aprendizaje profundo y fue uno de los primeros en demostrar un rendimiento notable en la tarea de clasificación de imágenes a gran escala. Las técnicas de aprendizaje por transferencia han permitido aprovechar las arquitecturas de estas redes neuronales convolucionales y adaptarla a una diversidad de aplicaciones. En nuestro caso, a la clasificación de enfermedades en hojas de arroz. Debajo se muestra la estructura de la red AlexNet entrenada usando el ambiente Matlab.

Resultados Obtenidos

La estrategia de procesamiento de imágenes en el dominio espacial para identificar manchas en hojas de arroz ha arrojado resultados sumamente prometedores. La elección de la técnica de segmentación basada en el color, combinada con operaciones de preprocesamiento como la conversión a escala de grises y la aplicación de operaciones de apertura, ha demostrado su capacidad para resaltar de manera excepcional las áreas de interés, es decir, las manchas en las hojas. La aplicación consecutiva del método de Otsu y su transformación inversa ha afinado aún más la precisión de la segmentación, contribuyendo a una separación nítida entre las manchas y el fondo de las hojas. Este enfoque en el dominio espacial ha culminado en una detección de enfermedades en las hojas de arroz más confiable y definida, al mismo tiempo que ha minimizado cualquier distorsión o ruido no deseado en las imágenes. La inherente flexibilidad de esta metodología ha permitido ajustar los parámetros de segmentación en función de las variaciones en las características de las manchas y los requisitos específicos del proyecto. En la figura siguiente se muestran los resultados del procesamiento utilizado.

A continuación se muestran los resultados del mejor modelo obtenido. Es importante recalcar que se utilizó una estrategia de entrenamiento cruzado, para evitar introducir sesgo al modelo planteado. La precisión promedio para todas las clases fue del 91.44%.

En el caso del sensor multiespectral, fue elegido un modelo basado en árboles aleatorios, donde se observa una capacidad importante del modelo de distinguir de las tres clases asignadas para la clasificación multiespectral. En la siguiente figura se muestra la matriz de confusión del modelo.

El desempeño obtenido por la estación de inspección mostró su viabilidad para cumplir los objetivos planteados para el presente proyecto, ofreciendo la posibilidad de implementar estrategias similares en distintos tipos de cultivos, y adicionalmente, la importancia que puede presentar la aplicación de técnicas de aprendizaje de máquina en la implementación de la agricultura de precisión.

Conclusiones

La elección de modelos y estrategias de entrenamiento es crucial para la clasificación de imágenes RGB y datos multiespectrales para aplicaciones de agricultura de precisión. La adaptabilidad del sistema desarrollado y su capacidad para detectar patrones anómalos pueden ser una herramienta de importancia en optimizar los procesos de gestión de cultivos.

Referencias

 P. Smith, «How to measure, report and verify soil carbon change to realise the potential of soil carbon sequestration for atmospheric greenhouse gas removal,» INSTITUTE FOR CARBON REMOVAL LAW AND POLICY, USA, 2019.


 A. S. Susanto B. Sulistyo, «Design and performance test of portable spectrometer using AS7265x multispectral sensor for detection of adulterated cane sugar in granulated coconut sugar,» AIP Conference Proceedings, USA, 2023.


 M. J.-L. F. R. J.-L. Andrés Fernando Jiménez-López, «Multispectral analysis of vegetation for remote sensing applications,» Iteckne, Colombia, 2015.


Interfaz Cerebro Computador para el control de un DRON tipo Cuatrimotor

James di Giacomo Rodríguez y Darío Ezequiel Núñez
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

Tendencias del futuro: Interfaz Cerebro-Computador

En la década de 1970, el profesor Jacques Vidal introdujo el término «interfaz cerebro-computadora» (BCI, por sus siglas en inglés), planteando la idea de utilizar patrones de ondas cerebrales para controlar dispositivos externos, como computadoras. El control de drones a través de BCI es una extensión natural de esta investigación y ofrece nuevas oportunidades en términos de accesibilidad y control preciso de estos dispositivos.

El uso de interfaz cerebro-dron podría permitir a los operadores controlar drones de manera remota y precisa sin necesidad de una interfaz física, lo que reduciría el riesgo de exposición a peligros físicos, además, la interfaz cerebro-dron podría acelerar la prestación de ayuda en áreas afectadas por desastres naturales o conflictos, permitiendo una respuesta más rápida y precisa. De igual forma, este tipo de tecnología proporciona una alternativa de control para personas con dificultades físicas, lo que les permite superar sus limitaciones y tener mayor autonomía en el manejo de drones.

Sin embargo, a pesar de los beneficios potenciales, existen desafíos técnicos y prácticos que deben abordarse para una implementación efectiva y segura de esta tecnología. Estos desafíos incluyen la precisión y confiabilidad del control de drones a través de BCI, la seguridad cibernética para evitar intrusiones maliciosas y la protección de la privacidad y los derechos humanos de las personas afectadas por el uso de esta tecnología.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la creación de una interfaz cerebro-computador para el control de un DRON cuatrimotor. El sistema desarrollado muestra las interesantes posibilidades que ofrecen este tipo de interfases para simplificar la operación de dispositivos complejos y el acceso al uso de estos por personas con algún tipo de discapacidad motora. El sistema fue entrenado con diversos comandos y se validó su uso con un DRON de uso académico.

Desarrollo de los sistemas BCI

En la tesis titulada “Desarrollo de una interfaz cerebral utilizando herramientas IoT para el control de dispositivos ON-OFF orientado a personas con capacidades limitadas”, presentada por Luis Alberto Montalván Tandazo y Christian Fernando Quinte Caiza, en julio del año 2021, se aborda el tema del control de dispositivos electrónicos vía ondas cerebrales utilizando la diadema EMOTIV Insight 2.0, donde se le quiere facilitar el estilo de vida a las personas con ciertas limitaciones físicas, y por ende, brindarles comodidad y mejorar su modus vivendi en su día a día.

En ese mismo año, también se llevó a cabo un proyecto muy similar, titulado: “Desarrollo de un sistema BCI basado en redes neuronales y movimientos de la cabeza para el manejo de un ordenador”, el cual lleva por autor a Eddy Fabian Corrales Bastidas, donde se abarca esta idea, la cual se enfoca en el manejo de un ordenador en personas con movimiento reducido en sus extremidades superiores.

Por otro lado, en la tesis titulada “Implementación de un sistema de control para el manipulador Mitsubishi RV-2AJ, mediante ondas cerebrales empleando el sensor EMOTIV Insight”, presentada por Francisco Andrés Gómez Pineda y Stalin Gabriel Yaguana Torres, en julio del año 2018, se discute la problemática sobre la exclusión o limitación de acceso a tecnologías innovadoras de manipulación de robots para personas que no tienen conocimientos de programación de estos dispositivos o que tienen alguna discapacidad motriz. Por tanto, los autores plantean como solución a esta problemática, la implementación de un sistema que permita controlar los movimientos del brazo robótico Mitsubishi RV-2AJ de la marca Festo, utilizando señales cerebrales, mediante la interpretación de señales cerebrales recopiladas por la diadema EEG EMOTIV Insight 1.0, las cuales serán procesadas y analizadas a través de una tarjeta LattePanda, un dispositivo con capacidades de microcomputador y conectividad inalámbrica.

Descripción del Sistema Propuesto

El proyecto consiste en integrar un sistema de electroencefalograma (EEG) junto a un DRON, para que este sea manejado por medio de las ondas cerebrales que los seres humanos generamos cuando pensamos en una acción. Este sistema muestra un alternativa para ayudar al desarrollo de los sistemas BCI junto su interacción con los dispositivos IoT, vehículos aéreos no tripulados y cualquier dispositivo que sirva para facilitar la interacción de los humanos con los medios de transporte por interfaces cerebro–computador.

Por esto, el enfoque principal es emplear la tecnología del dispositivo EEG EMOTIV Insight 2.0 para contribuir a resolver el problema de la complejidad en la operación de drones. Se busca integrar el EMOTIV Insight 2.0 con el sistema de control del dron, estableciendo una conexión confiable y estable para permitir un control más intuitivo y preciso basado en las señales cerebrales del usuario. Debajo se muestra una imágen del EMOTIV Insight 2.0

Para la integración del DRON se eligió el sistema de BITCRAZ, el Crazyflie 2.1. Este es un pequeño DRON de código abierto desarrollado por Bitcraze. Es una versión mejorada y más avanzada de su predecesor, el Crazyflie 2.1 original. A pesar de su diminuto tamaño, el Crazyflie 2.1 está repleto de características y capacidades impresionantes. Este se puede programar utilizando lenguajes como Python y C, lo que brinda una gran flexibilidad para personalizar su comportamiento y desarrollar nuevas funciones. Debajo se muestra una imagen del DRON elegido.

El EMOTIVBCI es el software que permite enviar los datos de las señales tomadas por la diadema, para que así sean procesadas por la BCI y luego ser programadas para que el dispositivo ejecute la acción pensada. Se realizó una interfaz basada en Python para el tratamiento de los comandos de operación clasificados por el EMOTIVBCI y crear la interfaz con el API de control del DRON CrazyFlie 2.1.

Estructura del Sistema y Modo de Funcionamiento

En primera instancia, se conecta el Insight 2.0 mediante Bluetooth 5.0 al computador, luego el sujeto se coloca la diadema, se realiza una calibración de los sensores, de tal modo que la medidas de calidad para el software EMOTIVBCI sean 95% o mayor. Luego, mediante el EMOTIV Launcher, se inicia el software EMOTIVBCI , el cual es el encargado de los entrenamientos de los comandos mentales. Mediante la API de Cortex, se adquieren los datos EEG, utilizando las credenciales otorgadas por EMOTIV. Por otro lado, dentro de la API de Bitcraze, se programan las instrucciones necesarias para que el DRON Crazyflie 2.1 ejecute los comandos recibidos de la manera deseada. Ya teniendo esto listo, para comunicar ambas APIs, y enviar los comandos mentales generados por el Insight 2.0, se implementa un websocket en cada API. Por último, el aplicativo local, registra y muestra los comandos mentales que se están ejecutando en tiempo real por el sujeto, y los va mostrando en el computador. En la siguiente figura se muestra el diagrama en bloques del sistema.

La diadema Insight 2.0 utiliza Bluetooth 5.0 y software EMOTIV para controlarla. Para trabajar con el Cortex SDK y la API de Python, se necesita instalar dependencias. El DRON Crazyflie 2.1 también requiere un controlador y una máquina virtual . Un dongle de radio USB permite la conexión entre el DRON y la computadora, y el accesorio FlowDeck v2 asegura un vuelo estable con su sensor óptico de flujo. Las APIs se conectan a través de un socket IP y puerto. El dispositivo Insight 2.0 promedia comandos cada 0.125 segundos y envía la palabra más repetida. El código maneja la recepción y procesamiento de comandos, envía comandos a través del socket y utiliza hilos para la conexión y procesamiento. La comunicación a través del socket es esencial para la interacción entre el dispositivo Insight 2.0 y el DRON.

Resultados y limitaciones

Las pruebas realizadas mostraron que el sistema logró una precisión global del 85.3%. Para esto fueron realizados 68 ensayos, dando como resultado un total de 10 falsos negativos y 58 sesiones con comando detectados correctamente. Los resultados mostraron que el DRON fue capaz de recibir y ejecutar los comandos mentales enviados y generados por el Insight 2.0, según lo deseado por el usuario, demostrando así el cumplimiento total de los objetivos planteados.

En cuanto al desempeño del sistema, se observó que el tiempo de respuesta del DRON ante un comando mental fue en promedio de doce (12) segundos. Durante las pruebas de vuelo, se observó que el dron es altamente sensible a interferencias y cambios bruscos en el terreno. El Crazyradio 2.0 de Bitcraze opera en la frecuencia de 2,4GHz, compartida por muchos dispositivos de la red de la universidad, lo que provoca pérdida de control y colisiones del dron. Se reemplazaron varias hélices dañadas y se adquirieron repuestos adicionales para prevenir contratiempos.  Al integrar el Insight 2.0 con el Crazyflie 2.1, se notó un retraso de al menos tres segundos entre los comandos mentales y su ejecución debido a múltiples saltos entre APIs y procesamiento, así como la distancia al router.

Resultados Obtenidos

Después del desarrollo preliminar, se llevaron a cabo extensas pruebas y análisis para evaluar la efectividad de los métodos y algoritmos empleados en el análisis de las deficiencias en la caminata de los pacientes. Estos se centraron en la verificación y validación de los resultados obtenidos para garantizar la precisión y confiabilidad del sistema. Además, se realizaron ajustes y optimizaciones para adaptar el sistema a diferentes perfiles de pacientes y condiciones.

Se diseñó una interfaz de usuario para la visualización de datos, que incluía gráficos y tablas para presentar resultados de manera clara. Se realizaron pruebas exhaustivas para validar la precisión y confiabilidad del sistema, ajustando según fuera necesario para mejorar la exactitud del análisis. En la siguiente figura se muestra la interfaz del aplicativo WEB, este permite la configuración de umbrales para los procesos de detección y la visualización de la reportería por paciente. Debajo se muestra una secuencia de imágenes en el que el DRON sigue un comando a partir de la interfaz BCI, trasladándose desde la izquierda hacia la derecha.

Conclusiones

Este trabajo ha demostrado las funcionalidades que ofrecen las interfaz BCI para expandir la integración del control de distintos tipos de dispositivos tanto con aplicaciones civiles como de asistencia médica. Es importante destacar los retos que debieron ser superados para la integración de los distintos esquemas temporales de respuesta del sistema BCI frente a la recepción de comandos por parte de la API del DRON. Todo esto demuestra que es necesario el seguir explorando el desarrollo de estas interfaces BCI para su aprovechamiento en aplicaciones futuras.

Referencias

J. Wolpaw y E. W. Wolpaw, Brain-Computer Interfaces: Principles and Practice. Oxford University Press, 2012.


G. Pfurtscheller, B. Graimann y B. Allison, Brain-computer interfaces: Revolutionizing human-computer interaction. Heidelberg: Springer, 2010.


Millán, J.R., Rupp, R., Müller-Putz, G.R., Murray-Smith, R., Giugliemma, C., Tangermann, M., Vidaurre, C., Cincotti, F., Kübler, A., Leeb, R., Neuper, C., Müller, K.R. (2010). Combining Brain-Computer Interfaces and Assistive Technologies: State-of-the-Art and Challenges. Frontiers in Neuroscience, 4, 161. doi: 10.3389/fnins.2010.00161


Lebedev, M.A., Nicolelis, M.A.L. (2006). Brain-Machine Interfaces: Past, Present, and Future. Trends in Neurosciences, 29(9), 536-546. doi: 10.1016/j.tins.2006.07.004


McFarland, D.J., Wolpaw, J.R. (2011). Brain-Computer Interfaces for Communication and Control. Communications of the ACM, 54(5), 60-66. doi: 10.1145/1941487.1941506


Sistema para el análisis de la Caminata en procesos de Terapia Física

Albert Jerez y Diana Diplán
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

Ser físicamente funcional

Las lesiones musculoesqueléticas representan una carga considerable para la salud y el bienestar global. Desde atletas de élite hasta individuos con estilos de vida activos, estas lesiones tienen un impacto devastador en la calidad de vida y la funcionalidad. Más allá del dolor físico, las lesiones podrían conducir a discapacidades a largo plazo, limitando la capacidad para trabajar, participar en actividades diarias e incluso disfrutar de recreaciones normales a nivel social.

Ante este desafío identificado y con el apoyo del departamento de Terapia Física de la Pontificia Universidad Católica Madre y Maestra (PUCMM) se busca abordar la necesidad de desarrollar herramientas y tecnologías innovadoras para una evaluación precisa y una intervención temprana en el análisis de la caminata. El objetivo siendo prevenir lesiones, mejorar los resultados del tratamiento y fomentar la salud y calidad de vida de las personas.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la el análisis de la caminata en procesos de terapia física. El sistema desarrollado cuenta con técnicas de visión computacional que permiten crear toda una reportería que asista al especialista en la evaluación del proceso de caminata de un paciente. El sistema agrega la data de sensores inerciales así como el uso de cámaras para la obtención de los reportes propuestos.

Integración de Tecnología en los procesos de Terapia Física

De acuerdo con F.R. Andrea Ramos, en «La importancia de una valoración en Fisioterapia», una de las áreas más afectadas por las lesiones musculoesqueléticas es la caminata. La capacidad de caminar eficientemente y sin dolor era fundamental para la movilidad y la independencia. Sin embargo, las lesiones en pies, tobillos y piernas alteran significativamente la biomecánica de la marcha, resultando en dolor crónico, discapacidad y una disminución de la calidad de vida. Además, las lesiones relacionadas con la marcha aumentan el riesgo de desarrollar problemas de salud más graves, como osteoartritis y enfermedades cardiovasculares, lo que podría tener consecuencias devastadoras a largo plazo para la salud y el bienestar general.

Sabiendo esto, en el estudio realizado por E. BV. llamado “Evaluación del control postural a través de Microsoft Azure Kinect DK: Un estudio de evaluación”, se compararon las trayectorias de movimiento del Kit Kinect utilizado con un sistema 3D estándar de seguimiento de alta precisión, relacionándolo a una posible solución. Veintiséis sujetos realizaron ejercicios específicos para su evaluación. El Kit Kinect demostró un seguimiento preciso de las articulaciones principales durante movimientos laterales, con un Error Cuadrático Medio (RMSE) de aproximadamente 0.2cm para ejercicios laterales y hacia adelante, y de 0.47cm para equilibrio. El Error Absoluto Medio angular osciló entre 5 y 15 grados para articulaciones superiores, mientras que las inferiores mostraron mayores errores. Se observaron mejores resultados en movimientos lentos. El estudio destaca el potencial del enfoque en base al Kit Kinect para la rehabilitación en el hogar, especialmente en la evaluación del control postural.

Otro bajo que busca analizar el proceso de movimiento del cuerpo humano es el presentado por  Y. Wang, S. Liu. Y S. Zhang. En el mismo se propone un algoritmo eficiente de reconocimiento de gestos manuales (HGR) para aplicaciones de interfaz humano-máquina (HMI) basados en el sensor BNO055. Utilizando datos de este sensor y considera su naturaleza temporal, lo que mejora el rendimiento de reconocimiento. La técnica de transformadas discretas de ondículas (DTW) es aplicada, mostrando que ofrece buenos resultados, pero su complejidad dificulta el aprendizaje en tiempo real. El algoritmo que implementaron el HGR, se basa en una red neuronal de energía de columna restringida (RCE) con un esquema de aprendizaje simple. Al reemplazar la métrica de la RCE con la distancia DTW mejora el reconocimiento de gestos con datos temporales y admite el aprendizaje en tiempo real. En pruebas con una FPGA, alcanzaron una precisión del 98.6% y soportaron operaciones en tiempo real a 150 MHz, lo que son resultados prometedores en el contexto del desarrollo del sistema.

Estos trabajos ponen el relieve dos puntos importantes: la importancia de la analítica del movimiento humano y la dificultad en procesar este tipo de datos. Por lo que el presente trabajo es un aporte importante en el desarrollo de este tipo de sistemas y en el estudio de diversas metodologías que puedan apoyar en el desarrollo de los procesos de fisioterapia.

Solución Propuesta

La solución propuesta para el análisis de la marcha en terapia física implicó el uso de tecnología de seguimiento de movimiento y un software de análisis de datos. Mediante el empleo de microcontroladores como el ESP32 (Lolin32) y un acelerómetro BNO055, colocados en diversas partes del cuerpo del paciente se busca poder medir el movimiento y la posición tridimensional durante la el proceso de caminata (marcha). El software de análisis procesó y visualiza los datos recopilados para mostrar patrones de movimiento precisos y objetivos durante la caminata. Esto buscando proporcionar a los fisioterapeutas una evaluación detallada y objetiva de la marcha de cada paciente, permitiéndoles diseñar un tratamiento personalizado y efectivo. En la siguiente figura se muestra el diagrama en bloque para la integración de todos los elementos a ser utilizados en el sistema propuesto.

Para la parte de visión computacional, se desarrolló un sistema automático de análisis de la marcha utilizando la librería MediaPipe. Esta herramienta permitiría una evaluación más eficiente y precisa de la marcha de los pacientes en terapia física. Al automatizar este proceso, se busca reducir el tiempo necesario para la evaluación inicial y mejorar la precisión de los diagnósticos, lo que a su vez conduciría a tratamientos más efectivos y una recuperación más rápida y completa para los pacientes en fisioterapia. En última instancia, se espera que este proyecto contribuya significativamente al bienestar y la calidad de vida de los pacientes en rehabilitación.

MediaPipe es una biblioteca de código abierto desarrollada por Google, especializada en análisis y procesamiento de datos de visión por computadora, ofreciendo seguimiento de movimientos y detección de objetos en tiempo real, así como mediciones precisas de velocidad, longitud del paso, cadencia y equilibrio durante la caminata. Luego de implementada, esta librería permitió capturar imágenes precisas y detalladas del movimiento del paciente durante la marcha, con la capacidad de capturar imágenes en 3D utilizando sensores de profundidad avanzados. En la siguiente imágen se aprecia la capacidad de MediaPipe de capturar puntos específicos del cuerpo, en este caso los hombros.

Metodología

El desarrollo del sistema de análisis de deficiencias en la marcha se llevó a cabo mediante un enfoque metodológico que abarcó desde la configuración inicial hasta la implementación práctica. Se inició con la configuración de los componentes hardware y la instalación del software de análisis de datos, seguido de pruebas preliminares para calibrar los sensores y ajustar su sensibilidad y precisión. El desarrollo del software implicó la configuración de algoritmos de seguimiento de movimiento y la visualización de datos en tiempo real. Esta metodología queda esquematizada en la siguiente imagen.

Se integraron  un total de tres cámaras de alta resolución para capturar imágenes en 3D del movimiento del paciente, estableciendo protocolos para la sincronización y captura de datos en tiempo real. Adicionalmente, se hizo uso de unos guantes para integrar los sensores del tipo acelerómetro seleccionados junto con el microcontrolador. Esto permitió obtener la medición de la aceleración en las cuatros extremidades del paciente, lo que brinda posibilidad de aplicar técnicas de análisis basadas en fusión de datos de distinta naturaleza. En la figura siguiente se muestra el sensor utilizado para la creación de este sistema de captura.

Resultados Obtenidos

Después del desarrollo preliminar, se llevaron a cabo extensas pruebas y análisis para evaluar la efectividad de los métodos y algoritmos empleados en el análisis de las deficiencias en la caminata de los pacientes. Estos se centraron en la verificación y validación de los resultados obtenidos para garantizar la precisión y confiabilidad del sistema. Además, se realizaron ajustes y optimizaciones para adaptar el sistema a diferentes perfiles de pacientes y condiciones.

Se diseñó una interfaz de usuario para la visualización de datos, que incluía gráficos y tablas para presentar resultados de manera clara. Se realizaron pruebas exhaustivas para validar la precisión y confiabilidad del sistema, ajustando según fuera necesario para mejorar la exactitud del análisis. En la siguiente figura se muestra la interfaz del aplicativo WEB, este permite la configuración de umbrales para los procesos de detección y la visualización de la reportería por paciente. 

Se llevaron a cabo pruebas simuladas y estudios con pacientes reales, bajo la supervisión de profesionales de la salud. Los resultados obtenidos fueron analizados y comparados con evaluaciones manuales realizadas por fisioterapeutas experimentados, demostrando la capacidad del sistema para detectar y cuantificar deficiencias específicas en la marcha. Debajo se muestra un ejemplo de una gráfica de captura de movimiento.

El sistema fue configurado para detectar las siguientes anomalía:

  • Inclinación excesiva de hombros
  • Declive de los codos
  • Diferencia de alineación entre las muñecas
  • Diferencia de alineación entre las rodillas
  • Desalineación en la cadera
  • Separación anormal de rodillas
  • Inclinación de la columna

Conclusiones

El sistema ofrece varias ventajas clínicas, incluida su capacidad para detectar patrones anómalos en la marcha de los pacientes y su potencial en la monitorización continua en entornos clínicos. Además, su adaptabilidad y facilidad de uso lo hacen una herramienta prometedora para la evaluación y el seguimiento de pacientes en rehabilitación. Las perspectivas futuras incluyen la aplicación del sistema en investigaciones adicionales para mejorar aún más su precisión y funcionalidad, así como su integración en entornos clínicos para mejorar la calidad de vida y el bienestar de los pacientes con deficiencias de movimiento.

La adaptabilidad del sistema, su capacidad para detectar patrones anómalos y su potencial en la monitorización continua de pacientes en entornos clínicos, junto con su aplicabilidad en investigaciones futuras, destacan como aspectos prometedores para su utilización.

Referencias

Antico, M., Balletti, N., Laudato, G., Lazich, A., Notarantonio, M., Oliveto, R., Ricciardi, S., Scalabrino, S., & Simeone, J. (2021). Postural Control Assessment via Microsoft Azure Kinect DK: An evaluation study. Computer Methods and Programs in Biomedicine, 209, 106324. https://doi.org/10.1016/j.cmpb.2021.106324


Sistema de Monitoreo Industrial de Temperatura (SMIT)

Starlyn Peña
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

Desastres en Tiempos de Pandemia: Origen de SMIT

A finales del año 2019 se identificó un nuevo virus en Wuhan, China, marcando un acontecimiento sin precedentes en la historia moderna humana. La subsiguiente pandemia, conocida como Covid-19, mantuvo al mundo en vilo durante casi dos años y, aún en la actualidad, se siguen tomando medidas preventivas para frenar su propagación en ambientes laborales. Esto ha llevado a que muchas empresas tengan protocolos establecidos para detectar síntomas de enfermedades contagiosas entre sus empleados que puedan afectar tanto la salud del personal como la productividad de la empresas. Debido a su alto grado de contagio el Covid-19 marcó un hito importante en el establecimiento de estos protocolos sanitarios, pero enfermedades como el dengue, la gripe estacional u otras infecciones pueden de igual manera presentar un impacto importante para el personal de una empresa.

Estas enfermedades comparten un síntoma común: la posibilidad de presentar fiebre. La fiebre queda definida como el síntoma que se produce cuando la temperatura corporal supera los 38 °C. Esto abre la posibilidad de aplicar  diversas técnicas y tecnologías para tomar las medidas preventivas adecuadas en caso de que una persona posea síntomas febriles y sea portadora de alguna enfermedad contagiosa. Sin embargo, algunas de estos métodos no son muy precisos en el resultado. Por lo tanto, aunque el COVID19 actualmente no nos azote tan de lleno, es necesario en el entorno industrial un método eficiente para cuando se necesita obtener la temperatura de los trabajadores, contribuyendo a la seguridad y salud generales. Debido a esto, se desarrolla SMIT, nuestro tema de discusión en el presente artículo.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la detección de síntomas febriles mediante el uso de visión computacional y algoritmos de aprendizaje de máquina. El sistema desarrollado cuenta con los aplicativos administrativos necesarios para la identificación de los empleados y el manejo de notificaciones de detección. Adicionalmente, se considera el uso de un sistema de calibración interno de referencia para aumentar la precisión del sistema propuesto.

Marco conceptual: Detección de Síntomas Febriles en entornos industriales

En su artículo (H. D. Septama, M. Komarudin, A. Yudamson, T. Yulianti, M. Pratama and T. P. Zuhelmi, 2021), señala el hecho de que múltiples lugares utilizan personal equipado con pistolas termómetro para medir la temperatura corporal de los visitantes, pese a que esta práctica tiene inconvenientes, ya que implica contacto cercano entre el personal y los visitantes, lo que puede propiciar la propagación del virus. Como solución presenta un sistema de bajo costo para la medición rápida de la temperatura corporal sin contacto, utilizando una cámara térmica integrada con una barrera. Por lo tanto, no se necesita personal para medir la temperatura corporal, ya que los visitantes pueden verificarla de manera independiente, teniendo una precisión en la temperatura del personal de un 98.75%.

En adición, en el artículo de (S. D. Khirade and A. B. Patil, 2015) se discute el hecho de que el procesamiento de imágenes se emplea en la detección de enfermedades en plantas, abarcando pasos como la adquisición de imágenes, preprocesamiento de imágenes, segmentación de imágenes, extracción de características y clasificación. Se exploran los métodos utilizados para detectar enfermedades en plantas mediante imágenes de sus hojas. Además, en nuestro provecho, se profundiza en algunos algoritmos de segmentación y extracción de características.

Siguiendo la misma línea de procesamiento, en el escrito de los autores (Ragavesh Dhandapani1 y Sara Marhoon Humaid Al-Ghafri, 2022) se utiliza un sistema de detección de objetos basado en visión por computadora para reconocer mascarillas faciales y autenticar certificados de vacunación en tiempo real a través de un kit Jetson Xavier. El proceso comprende la captura de video en tiempo real y su posterior procesamiento, que implica la detección facial mediante un clasificador Haar-Cascade y la codificación facial. Luego, se emplea un modelo de aprendizaje profundo pre-entrenado para ubicar la clase objetivo (mascarilla) en el fotograma.

Todos estos trabajos resaltan la oportunidad de mejora en los sistemas de monitoreo de temperatura si se integran tecnologías referentes a procesamiento en el borde, reconocimiento facial, seguimiento de objetos y técnicas estadísticas para robustecer la medición de los sistemas de medición de temperatura sin contacto.

Descripción del Sistema Propuesto

A partir del diagrama mostrado se evidencia la integración de los distintos componentes que brindan el acercamiento basado en computación en el borde para el sistema propuesto. Siendo el corazón del sistema el sistema de procesamiento Jetson AGX Xavier. Este dispositivo en un dispositivo heterogéneo de procesamiento que incluye procesadores de la familia ARM junto con un núcleo de procesamiento gráfico de propósito general (GPGPU, por sus siglas en inglés) pensado para acelerar la ejecución de algoritmos de aprendizaje de máquina y procesos de visión computacional. Adicionalmente, una cámara termográfica de alta precisión Hikvision DS-2TD2617-10/QA. 

La Implementación de técnicas de procesamiento de imágenes constituye un paso crucial en la operación del sistema. Utilizando técnicas avanzadas como segmentación e identificación, se busca extraer información pertinente al separar las áreas de interés de las no deseadas. Como se puede ver en la imagen, la computadora en el borde elegida presenta un tamaño reducido y su consumo de potencia (menos de 65W) hace que sea idónea para este tipo de aplicaciones. Cuenta con una capacidad teórica máxima de procesamiento de 11 TFLOPS.

En el procesamiento de imágenes, se capturan los frames de la cámara IP termográfica y se procesan para adaptar los algoritmos. Se convierten del espacio de color BGR al RGB y se implementa un algoritmo de detección de rostros. Se obtienen los puntos de referencia, como la ubicación de los ojos y la boca, y se escala la resolución de los videos para ajustarlos. Luego, se localiza el rostro detectado en el STREAM de la cámara termográfica para inicializar el algoritmo de seguimiento y se estiman las temperaturas corporales utilizando un Black Body Calibrator (BBC) y la intensidad del píxel correspondiente al punto identificado del canal lagrimal del ojo. En la figura siguiente se muestra la metodología propuesta para el SMIT.

En cuanto al sensor de temperatura, se utiliza un sensor del tipo resistivo para la medición de la temperatura (RTD) con un amplificador MAX31865 y un ESP32. La RTD se conecta al MAX38165 según las especificaciones del fabricante y se establece la comunicación entre el sensor y la ESP32 mediante el protocolo SPI. Luego, se programa la comunicación utilizando una librería proporcionada por el fabricante.

Resultados Obtenidos

La Implementación de Técnicas de Procesamiento constituye un paso crucial en la operación del sistema. Utilizando técnicas avanzadas como segmentación e identificación, se busca extraer información pertinente al separar las áreas de interés de las no deseadas. El poder detectar marcadores fiduciarios es un punto clave para este proyecto, porque permite identificar las regiones en donde es necesario evaluar la intensidad de los pixeles y compararlo con el punto de referencia provisto por el BBC. En la siguiente imagen se muestra la capacidad del algoritmo, al ser ejecutado en la Jetson AGX Xavier, de detectar un rostro y construir la malla de referencia con los marcadores fiduciarios.

La Aplicación de Monitoreo (Web) representa la interfaz donde la información procesada cobra relevancia práctica. Al recibir y analizar la información, esta aplicación determina si una persona supera la temperatura establecida. En caso afirmativo, emite notificaciones al personal de seguridad, permitiendo la implementación de medidas adecuadas. La misma fue desarrollada bajo el framework minimalista Flask en PYTHON, lo que permite que la ejecución del aplicativo también quede en el mismo equipo para computación en el borde.

Una funcionalidad que fue agregada al sistema es la capacidad de asociar un ID de empleado a un rostro. Adicionalmente, se detecta un estado de ERROR en caso de que el empleado no pueda ser identificado por llevar una mascarilla o en caso de que lleve gafas oscuras. Es importante recalcar que este sistema está pensado para ser utilizado en un ambiente post pandemia, por lo que se puede aplicar el sistema en zonas donde los empleados deban bajar sus mascarillas antes de cruzar, creando la relación ID de empleado con temperatura.

Esta plataforma WEB implementa un sistema de login para acceder al sistema y permite visualizar información relevante como el monitoreo del personal, el estado del sistema y reportes de datos. Se pueden configurar límites de temperatura, escala de visualización, cantidad máxima de rostros detectados, entre otros parámetros. También se pueden crear, modificar y eliminar empleados y usuarios según los permisos correspondientes.

Conclusiones

El sistema exhibe un buen desempeño durante la noche o en entornos con iluminación reducida, donde aun con ausencia de luz de fondo el algoritmo de detección facial logra funcionar adecuadamente. Además, se destaca por su excepcional precisión, con un margen de error mínimo de tan solo 0.5 °C, una cifra notablemente inferior en comparación con otros sistemas. Es crucial destacar la importancia de considerar cuidadosamente el entorno de aplicación en donde sea instalado el sistema, especialmente en ambientes donde la iluminación pueda saturar la imagen, ya que este factor puede influir significativamente en los resultados.

Este sistema SMIT emerge como un proyecto innovador, preciso, fácil de utilizar y seguro. Su desarrollo responde a la necesidad crítica de monitorear la salud en entornos industriales, ofreciendo una herramienta eficaz y de utilidad.

Referencias

 M. K. A. Y. T. Y. M. P. T. Z. H. Septama, «Low Cost Non-Contact Rapid Body Temperature Screening using Thermal Camera for Early Detection of Covid-19 Suspect,» Bandung, 2021.

Gelir, «Image processing for quantitative measurement of e/m in the undergraduate laboratory,» 2019. NVIDIA, «NVIDIA,» 25 Marzo 2019. [En línea]. Available: https://www.nvidia.com/enus/autonomous-machines/embedded-systems/jetson-agx-xavier. [Último acceso: 22 Noviembre 2022].

Alonso, V., Dacal-Nieto, A., Barreto, L., Amaral, A., & Rivero, E. (2019). Industry 4.0 implications in machine vision metrology: An overview. Procedia Manufacturing, 41, 359–366. https://doi.org/10.1016/j.promfg.2019.09.020

Sharma, K. Shanmugasundaram and S. K. Ramasamy, «FAREC — CNN based efficient face recognition technique using Dlib,» 2016 International Conference on Advanced Communication Control and Computing Technologies (ICACCCT), Ramanathapuram, India, 2016, pp. 192-195, doi: 10.1109/ICACCCT.2016.7831628.