AgroSat IoT: Integración de Sensores y Teledetección para la Agricultura 4.0 en República Dominicana

Carlos García Núñez y Dariel Alexander Vargas Francisco – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

La agricultura constituye uno de los ejes fundamentales para el desarrollo económico y la seguridad alimentaria a nivel global. En la República Dominicana, el sector agrícola se destaca por su gran capacidad exportadora, siendo el cultivo de banano (Musa paradisiaca) un pilar estratégico que representa aproximadamente el 30% de las exportaciones agropecuarias del país [1]. Estas cifras consolidan al banano como un generador indispensable de divisas, con una presencia notable en mercados internacionales de alta exigencia, como la Unión Europea y el Reino Unido. Gran parte de esta competitividad se basa en la producción orgánica, una modalidad que añade un enorme valor comercial al producto dominicano, pero que simultáneamente impone restricciones severas en el uso de insumos químicos para el manejo fitosanitario de las plantaciones.

Esta restricción en el manejo sintético subraya una vulnerabilidad crítica: la exposición de los cultivos a amenazas bióticas y abióticas fluctuantes. Ante esta realidad, surge la necesidad apremiante de modernizar los métodos de supervisión en campo, transitando desde modelos reactivos hacia la adopción de la denominada Agricultura 4.0 [2]. Esta transición implica la incorporación de tecnologías de monitoreo continuo que aporten una capa de inteligencia basada en datos concretos y localizados, lo que permite la anticipación de escenarios de estrés en el cultivo, garantizando así la sostenibilidad y el rendimiento de las fincas agrícolas.

En este contexto de innovación tecnológica, estudiantes de la Facultad de Ciencia de la Ingeniería, pertenecientes al Departamento de Ingeniería Telemática y Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), han desarrollado una iniciativa pionera. Bajo el liderazgo de Carlos García Núñez y Dariel Vargas, y con la asesoría del Ing. Jorge Alejandro Luna Martínez, nace el proyecto AgroSat IoT. Esta propuesta fusiona el potencial de las redes de telemetría de largo alcance con el análisis de imágenes satelitales, creando un entorno de supervisión integral que redefine la toma de decisiones en el ámbito agrario.

La motivación principal detrás de AgroSat IoT radica en empoderar a los productores bananeros con herramientas tecnológicas accesibles y de alta precisión. A través de la recolección de datos microclimáticos in situ y la superposición de metadatos macroespaciales, la solución no solo aspira a diagnosticar problemas de forma oportuna, sino a establecer una metodología replicable que promueva el uso eficiente de recursos hídricos y nutricionales, salvaguardando así el liderazgo de la producción orgánica nacional.

Problemática y estado del arte

A pesar de su evidente relevancia económica, la cadena de producción del banano enfrenta desafíos de naturaleza sistémica y fisiológica, especialmente pronunciados en la etapa de poscosecha. Entre las amenazas más destructivas destaca la pudrición de la corona, una patología fúngica asociada a microorganismos como Fusarium spp. y Colletotrichum musae [3].

Esta enfermedad suele desarrollarse de manera latente en el campo, manifestándose únicamente durante el proceso de empaque o transporte, lo que resulta en rechazos masivos de lotes en el mercado internacional y pérdidas económicas devastadoras. En el entorno de la producción orgánica, donde los fungicidas de síntesis química están estrictamente prohibidos, la gestión de esta enfermedad depende casi por completo de un control preventivo fundamentado en la excelente salud fisiológica de la planta desde su fase de desarrollo temprano.

Paralelamente, el banano es una especie botánica con una elevada demanda hídrica, lo que lo vuelve excepcionalmente sensible a las fluctuaciones en la humedad del suelo [4]. Un déficit hídrico sostenido provoca el cierre de los estomas, reduciendo drásticamente las tasas fotosintéticas y afectando el llenado del fruto. Por otro lado, un escenario de anegamiento promueve la hipoxia radicular y crea un microclima ideal para la proliferación de fitopatógenos del suelo. Esta delicada ventana de homeostasis hídrica exige un escrutinio meticuloso, el cual es inalcanzable utilizando únicamente métodos empíricos de observación visual.

Actualmente, el principal agravante de esta problemática en la región es la dependencia histórica de la gestión agraria tradicional. Las anomalías nutricionales y el estrés hídrico ocurren de forma silenciosa, y para el momento en que los síntomas se vuelven visibles en el follaje o en el racimo, el daño celular y la merma en la productividad ya son irreversibles. Los productores carecen de medios tecnológicos continuos para monitorear el subsuelo en tiempo real, favoreciendo así un ciclo crónico de ineficiencia donde los recursos como el agua y los biofertilizantes se aplican a ciegas, basándose en calendarios estáticos en lugar de necesidades fisiológicas reales.

En el estado del arte internacional, se han propuesto diversas aproximaciones para mitigar este desfase informativo. Huamán Correa (2023) introdujo un sistema de monitoreo en Perú orientado a la correlación de datos ambientales para la predicción de plagas en bananeras, subrayando la utilidad de la telemetría en tiempo real [5]. De manera similar, Rincón Vargas y Vargas Romero (2023) desarrollaron un prototipo de medición localizada de temperatura y humedad edáfica, demostrando que la vigilancia constante optimiza notablemente las estrategias de riego [6].

Por otra parte, desde la perspectiva de la teledetección macroscópica, Castillo Idrovo (2021) validó la viabilidad del uso de constelaciones satelitales para analizar el vigor vegetal mediante índices espectrales, lo que permite localizar zonas de bajo rendimiento en extensiones vastas que serían inviables de inspeccionar a pie [7]. Estas investigaciones ratifican que tanto el enfoque micro (sensores de campo) como el enfoque macro (satélites) poseen un valor innegable para la gestión agrícola moderna.

Sin embargo, a pesar de los avances documentados, las soluciones actuales presentan una fragmentación operativa. Los agricultores dominicanos no cuentan con plataformas unificadas que correlacionen de manera fluida y nativa los datos químicos del sustrato (como el pH, la conductividad eléctrica y los niveles de macronutrientes NPK) con la perspectiva radiométrica satelital a gran escala. Esta desconexión impide un diagnóstico agronómico verdaderamente holístico, limitando la adopción de una agricultura de precisión adaptada a la topografía y climatología específicas de los valles productivos de la República Dominicana.

Objetivos completados

El desarrollo de este proyecto ha implementado un sistema de diagnóstico agrícola integral y en tiempo real para cultivos de banano, estructurado sobre una arquitectura híbrida que combina el despliegue de redes de sensores IoT (LoRa) de bajo consumo para la captura in situ de variables edáficas (humedad, pH, NPK, conductividad eléctrica) y el procesamiento automatizado de imágenes satelitales (Sentinel-2) para la extracción de índices espectrales (NDVI, NDWI). El sistema proporciona una plataforma web centralizada capaz de correlacionar estos datos, generando reportes analíticos y alertas tempranas, lo que garantiza a los productores una herramienta de apoyo crítico para optimizar el uso de recursos, anticipar escenarios de estrés hídrico o nutricional, y mejorar sustancialmente el manejo preventivo de enfermedades en la producción bananera.

Metodología

Para materializar esta solución integral, se implementó una metodología de desarrollo concurrente, dividiendo el trabajo en subsistemas aislados pero altamente interdependientes: adquisición de hardware, procesamiento geoespacial y desarrollo de la arquitectura backend/frontend. El diseño de este ecosistema tecnológico se enfocó en garantizar estabilidad en entornos remotos, escalabilidad de la red de telemetría y una presentación de la información que fuera inmediatamente procesable por el usuario final, todo ello apoyado en protocolos de transmisión de bajo consumo energético.
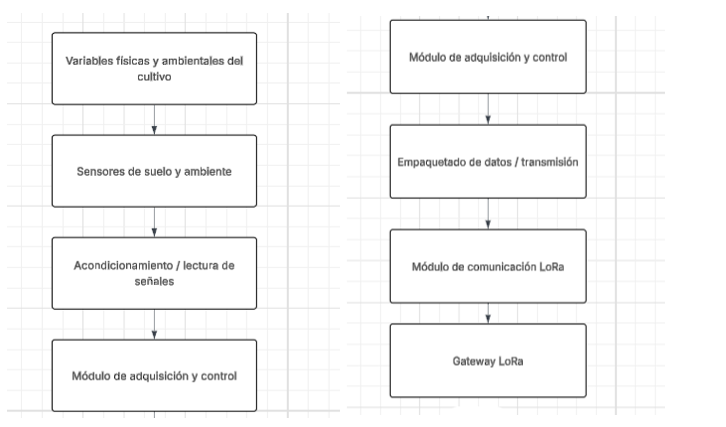
Diagrama de bloques del flujo desde las variables del cultivo y los sensores hasta el módulo LoRa y el gateway
Figura 1. Diagrama esquemático del flujo de telemetría desde los nodos en campo hasta el panel de visualización en la nube.

Adquisición de datos a través de nodos IoT en el borde

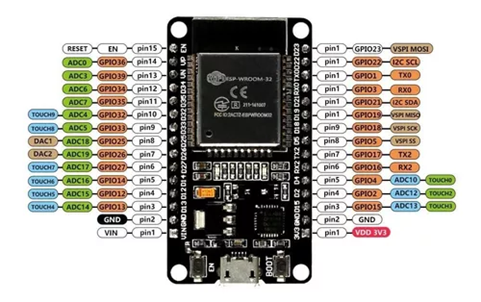
El núcleo de la recolección de campo se basó en el diseño de estaciones de monitoreo equipadas con microcontroladores ESP32 que integran módulos transceptores LoRa V3 (SX1262 a 915 MHz). Esta selección de hardware obedece a las estrictas demandas topológicas de las áreas de cultivo, donde la conectividad celular (GSM/LTE) suele ser inestable y el consumo energético debe ser minimizado para permitir la operación autónoma. Cada nodo fue dotado de un conjunto robusto de sensores diseñados para medir variables críticas: humedad del suelo (mediante sensores capacitivos resistentes a la oxidación), temperatura y humedad relativa (BME280), radiación solar, así como electrodos especializados para la medición continua de pH, conductividad eléctrica y concentración de macronutrientes (Nitrógeno, Fósforo y Potasio).

La lógica embebida en estos nodos se encarga del acondicionamiento de las señales analógicas, su conversión digital y el empaquetado estructurado de las tramas de datos. Esta telemetría es enviada periódicamente a través de enlaces de radiofrecuencia de largo alcance hacia un Gateway centralizador, el cual actúa como puente (bridge) utilizando el protocolo MQTT para derivar la información de forma segura hacia los servidores en la nube. Este esquema asegura una alta tolerancia a fallos y permite la expansión futura de la red mediante la adición de nuevos nodos sin saturar el espectro de comunicación.
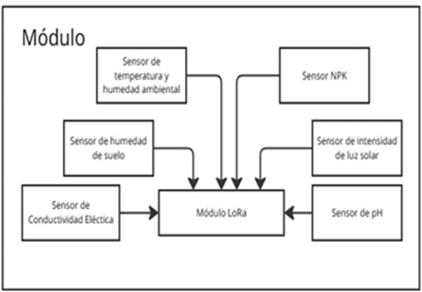
Diagrama del módulo: sensores de temperatura y humedad, NPK, humedad de suelo, luz solar, conductividad eléctrica y pH conectados al módulo LoRa
Figura 2. Diagrama de bloques del nodo IoT: sensores conectados al módulo LoRa para la transmisión de telemetría.

Análisis satelital automatizado con Google Earth Engine

Para superar las limitaciones de la observación estrictamente puntual, la metodología incorporó un motor de procesamiento de imágenes satelitales fundamentado en la plataforma Google Earth Engine (GEE). A través de scripts automatizados en Python, el sistema consulta periódicamente el catálogo Harmonized de la misión Copernicus Sentinel-2 de la Agencia Espacial Europea. Este proceso incluye un filtrado algorítmico riguroso para discriminar la cobertura nubosa, un fenómeno meteorológico muy frecuente en las zonas tropicales, garantizando que los análisis radiométricos se realicen únicamente sobre píxeles de alta pureza visual.
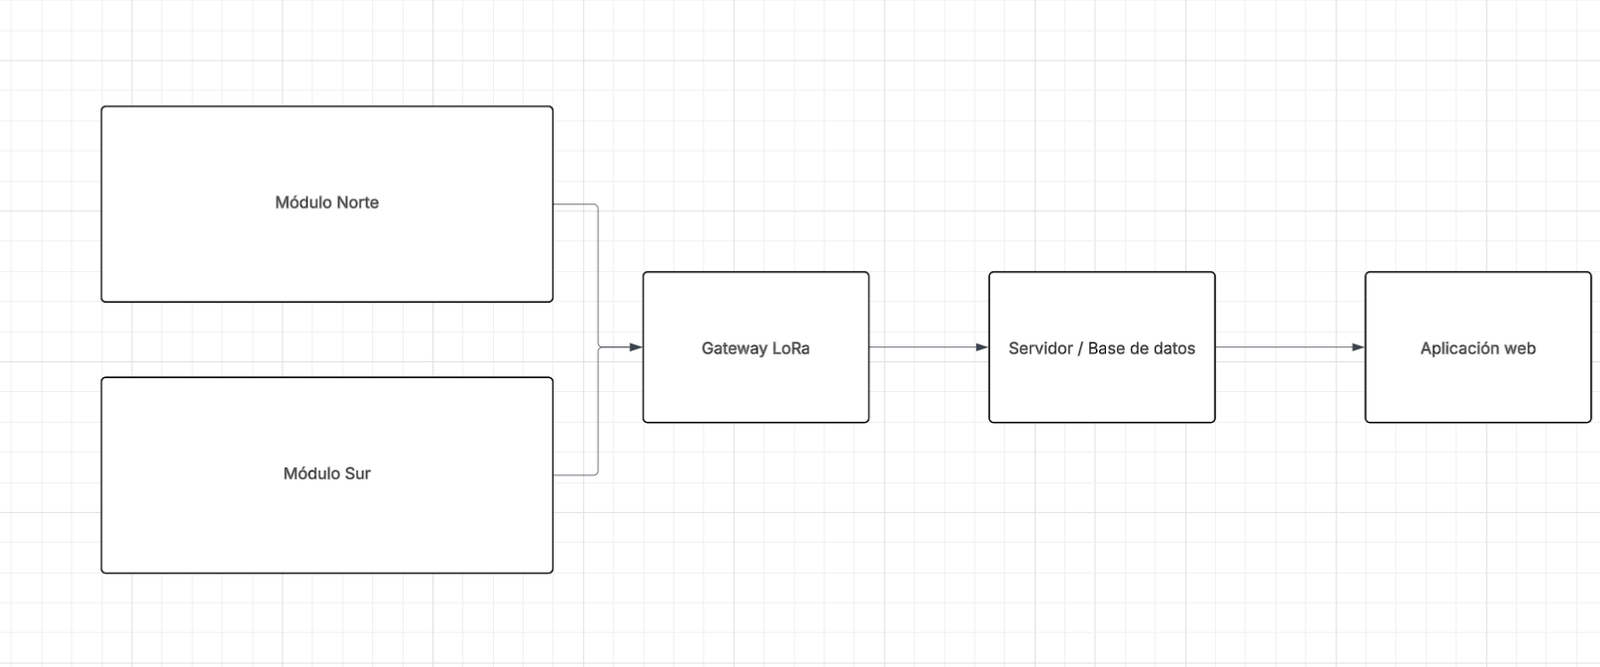
Topología de red: módulos Norte y Sur conectados al gateway LoRa, al servidor y base de datos, y a la aplicación web
Figura 3. Arquitectura centralizada de la topología de red, ilustrando la convergencia de datos desde el borde hacia el servidor central.

El núcleo analítico de esta sección calcula dos métricas fundamentales: el Índice de Vegetación de Diferencia Normalizada (NDVI) para cuantificar la actividad fotosintética y el vigor de la biomasa, y el Índice de Agua de Diferencia Normalizada (NDWI), el cual revela el estado del dosel foliar respecto a su contenido hídrico.

El sistema no solo extrae estos valores promedios para los polígonos correspondientes a la finca, sino que aplica una lógica de clasificación basada en umbrales (ej. NDVI ≥ 0.6 clasificado como ‘Saludable’), traduciendo metadatos crudos en evaluaciones comprensibles para el manejo agronómico.

Los resultados son inyectados al servidor mediante APIs REST, evitando el almacenamiento local pesado de archivos de imagen (rasters).

Arquitectura backend y plataforma web interactiva

La gestión integral de la información se orquestó sobre una arquitectura de software empresarial multicapa utilizando Java 17 y el ecosistema Spring Boot. Este backend MVC gestiona la persistencia de datos relacionales en MariaDB, estructurando historiales complejos de mediciones, configuración de sensores y registros de eventos. Para asegurar que la latencia entre un evento de campo y la notificación al productor fuera mínima, se implementaron túneles bidireccionales mediante WebSockets, dotando al frontend de capacidades reactivas sin la necesidad de recargar el navegador [8].
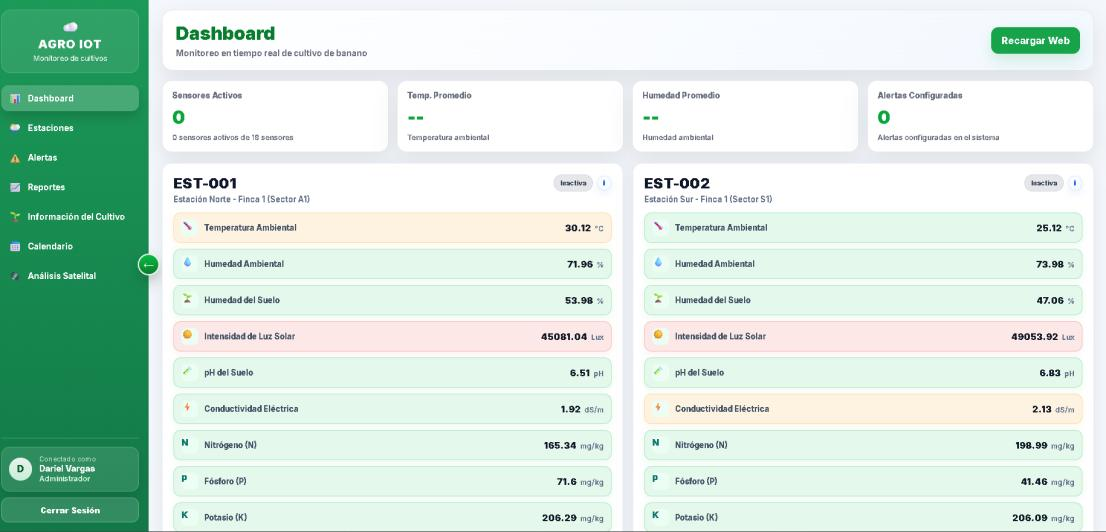
Dashboard web de monitoreo con las lecturas de las estaciones Norte y Sur: temperatura, humedad, luz, pH, conductividad y NPK
Figura 4. Dashboard interactivo de la plataforma web, presentando indicadores consolidados de sensores y alertas del sistema.

El diseño de la interfaz de usuario se realizó bajo principios de usabilidad orientados a perfiles no técnicos. El entorno web permite la administración de estaciones, la generación de reportes en PDF, el seguimiento de labores mediante un calendario agrícola interactivo, y de manera crucial, la configuración de un motor de alertas lógicas. Este motor evalúa cada paquete de datos entrante contra umbrales personalizados; si, por ejemplo, la tensión matricial del suelo indica deshidratación, el sistema detona una notificación inmediata y altera los indicadores visuales en el panel principal.

Resultados

La validación de AgroSat IoT en un entorno controlado arrojó resultados altamente satisfactorios, confirmando la resiliencia de la arquitectura técnica y la viabilidad de la propuesta para su posterior escalado comercial. En términos de conectividad en el nivel físico, los nodos basados en el transceptor SX1262 demostraron una confiabilidad sobresaliente en la propagación de señales a través de obstáculos típicos del cultivo bananero. La tasa de éxito en la entrega de paquetes de datos (Packet Delivery Ratio) hacia el gateway superó el 95% bajo condiciones de línea de vista parcial, demostrando que la tecnología LoRaWAN es perfectamente adecuada para superar la densidad foliar que caracteriza a este tipo de plantaciones.

A nivel de software, el backend en Spring Boot procesó eficientemente los flujos de telemetría entrantes, registrando y estructurando correctamente las variables en la base de datos MariaDB. Esto permitió la generación de historiales densos y consistentes. La interfaz de usuario respondió de manera fluida a las actualizaciones impulsadas por WebSockets; durante las pruebas, cualquier fluctuación anómala provocada deliberadamente en el entorno de los sensores se reflejó en el panel de control web en un tiempo inferior a los 3 segundos, validando la naturaleza ‘en tiempo real’ de la solución.
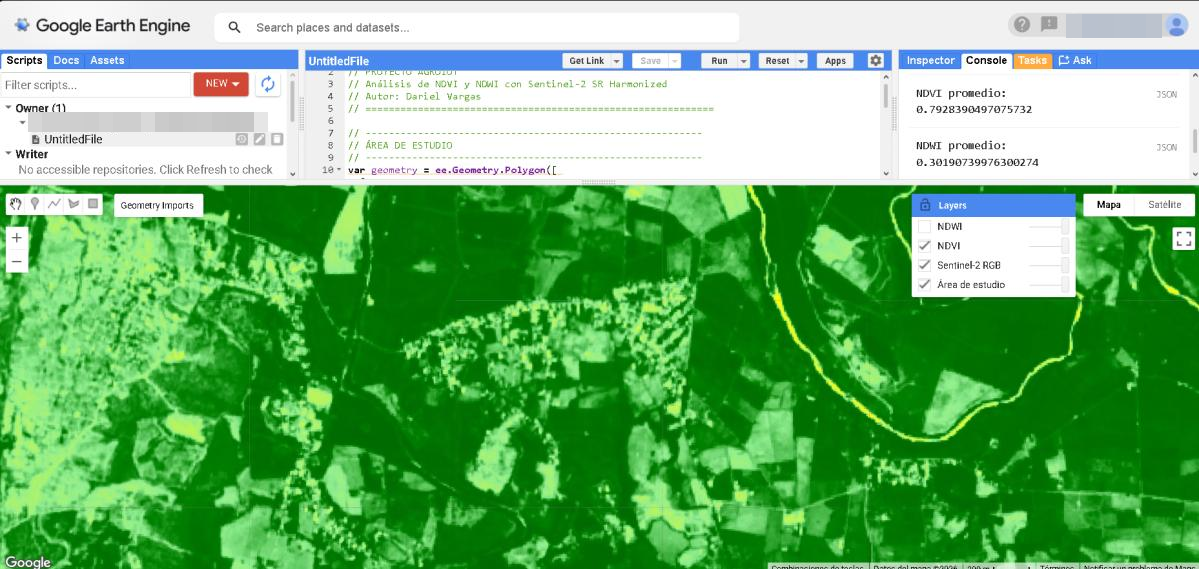
Google Earth Engine mostrando el mapa NDVI del área de estudio y los valores promedio de NDVI y NDWI en la consola
Figura 5. Análisis de NDVI y NDWI con Sentinel-2 en Google Earth Engine sobre el área de estudio.

El subsistema de teledetección probó ser un complemento excepcional. El script de automatización en Python interactuó exitosamente con la API de Google Earth Engine, mitigando el ruido causado por la cobertura de nubes y extrayendo los índices NDVI y NDWI con precisión espacial. La correlación observada entre una caída del índice NDWI satelital y la disminución de la capacitancia reportada por los sensores de humedad del suelo corroboró la robustez de combinar enfoques macro y micro para la toma de decisiones, brindando un mapa de calor virtual de las zonas de estrés en la finca.

Finalmente, el motor de alertas evidenció su eficacia operativa. Al exceder los límites predefinidos de salinidad (conductividad eléctrica) o de temperatura crítica, el sistema generó correctamente las advertencias visuales y registró las entradas en el historial de auditoría. Adicionalmente, el mecanismo de comprobación de estado (heartbeat) de los nodos fue validado exitosamente: al desconectar la alimentación de un módulo, la plataforma detectó la caída del enlace en el margen de tiempo estipulado y notificó al usuario la inactividad de la estación, lo cual es vital para el mantenimiento de la red.

Conclusión

La culminación de este proyecto marca un hito significativo en la modernización de la gestión agrícola en la República Dominicana. AgroSat IoT demuestra de manera concluyente que la barrera de entrada para la Agricultura 4.0 puede ser superada mediante el diseño ingenieril inteligente. Al integrar exitosamente arquitecturas de microcontroladores de bajo costo, protocolos inalámbricos de amplia cobertura como LoRa, y plataformas de análisis satelital de acceso abierto, se ha logrado materializar una herramienta de diagnóstico agronómico de primer nivel, capaz de sustituir la intuición empírica por certezas científicas basadas en telemetría continua y espacial.

El impacto a largo plazo de este desarrollo no se limita únicamente a la prevención de patógenos como la pudrición de la corona o a la mitigación del estrés hídrico; radica en la habilitación de una trazabilidad química e hídrica profunda, la cual es la piedra angular para maximizar el rendimiento en nichos de alto valor como lo es la producción de banano orgánico de exportación. Las lecciones aprendidas durante la fase de despliegue reafirman que la infraestructura tecnológica debe ser tan resistente como las plantas que monitorea, y que las interfaces de software deben decodificar la complejidad de los datos en directrices accionables y simples para el productor.

Como próximos pasos, se vislumbra la evolución de esta plataforma hacia esquemas predictivos más agresivos. La inmensa cantidad de datos recabados sienta las bases ideales para la futura implementación de modelos de aprendizaje automático (Machine Learning), los cuales podrán predecir curvas de degradación del suelo o brotes epidemiológicos días antes de que ocurran. Es el momento de que el sector agroindustrial, la academia y el Estado unan fuerzas para escalar estos prototipos hacia mallas de sensores a nivel nacional, transformando definitivamente el paisaje agrícola hacia una matriz de producción resiliente, tecnificada e hiperconectada.

Referencias

  1. Ministerio de Economía, Planificación y Desarrollo (MEPYD), “Ministerio de Economía pondera importancia del sector bananero y oportunidades para su revitalización,” Oct. 19, 2023.
  2. J. Tovar-Quiroz, “Agricultura 4.0: uso de tecnologías de precisión y aplicación para pequeños productores,” Informador Técnico, vol. 87, no. 1, 2023.
  3. D. Toribio-Flórez, F. Carreel, C. Jenny, y J. Carlier, “Crown rot disease in bananas: A review of current knowledge,” Postharvest Biology and Technology, vol. 116, pp. 34–40, 2016.
  4. Y. Barrera-Pardo et al., “Respuesta fisiológica al estrés hídrico de plantas de banano cv. ‘Pineo gigante’ (Musa AAA),” Biotecnología Vegetal, vol. 14, no. 3, pp. 155-162, 2014.
  5. J. A. Huamán Correa, Sistema IoT para el monitoreo climático y detección temprana de plagas en cultivos de banano mediante inteligencia artificial en la región de Piura, Tesis de Maestría, Universidad de Piura, Perú, 2023.
  6. M. F. Rincón Vargas y C. J. Vargas Romero, Diseño e implementación de un prototipo de sistema de monitoreo de temperatura y humedad del suelo en cultivos de banano. Bogotá, Colombia: UNAD, 2023.
  7. J. P. Castillo Idrovo, Aplicación de índices de vegetación NDVI a partir de imágenes Sentinel-2 para el monitoreo de cultivos de banano. Cuenca, Ecuador: Universidad de Cuenca, 2021.
  8. A. Augustin, J. Yi, T. Clausen, y W. M. Townsley, “A Study of LoRa: Long Range & Low Power Networks for the Internet of Things,” Sensors, vol. 16, no. 9, p. 1466, 2016.
Detección de superficie de techo disponible para la instalación de paneles solares haciendo uso de imágenes satelitales

José Antonio Taveras Abreu y Steven Manuel Mateo Ramos – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El cambio climático representa uno de los mayores desafíos globales del siglo XXI, y la transición hacia fuentes de energía renovable se ha convertido en una necesidad urgente. Entre las distintas alternativas, la energía solar destaca como una de las más accesibles y sostenibles, especialmente en entornos urbanos donde la demanda energética es constante. Las ciudades concentran un enorme potencial para la generación fotovoltaica distribuida; sin embargo, aprovechar esta capacidad implica superar obstáculos técnicos importantes, como la identificación precisa de superficies aptas para la instalación de paneles solares [1].

A pesar de que en países desarrollados existen herramientas avanzadas como Google Project Sunroof, que estiman la viabilidad de instalar paneles solares a partir de imágenes satelitales y algoritmos de aprendizaje automático, su uso aún no se ha extendido a regiones en desarrollo como República Dominicana. Esto se debe, en parte, a la escasez de datos geoespaciales locales de alta calidad y a las características arquitectónicas particulares de estas ciudades, que dificultan la transferencia directa de soluciones extranjeras. La literatura sugiere que para lograr implementaciones efectivas en estos contextos, es crucial considerar variables ambientales, morfológicas y socioculturales que afectan la segmentación y clasificación de superficies en entornos urbanos densos [2], [3].

En sectores como Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2, en Santiago de los Caballeros, existe una importante cantidad de techos sin evaluar, lo que representa una oportunidad desaprovechada para la generación energética. Esta ausencia de información limita la capacidad de planificación energética urbana y dificulta la adopción de tecnologías limpias a nivel comunitario. Además, factores como las sombras proyectadas entre edificaciones, la diversidad de materiales de cubierta y la presencia de elementos como antenas, tinacos o equipos de ventilación dificultan los análisis manuales y reducen la disponibilidad real de superficie útil [3], [4].

En este escenario, las técnicas modernas de aprendizaje automático, en especial aquellas basadas en redes neuronales convolucionales (CNN), han demostrado ser herramientas prometedoras para abordar estos desafíos. Investigaciones recientes, como la de Cai et al., han comparado arquitecturas como U-Net, FCN y DeepLabv3+ para segmentar techos en imágenes aéreas, destacando el valor de técnicas como la convolución atrous y el enfoque encoder-decoder para mejorar la precisión [1]. Por su parte, Benchabana et al. han desarrollado un sistema que combina superpíxeles adaptativos y autoencoders variacionales, logrando una detección más eficiente de techos mediante la clasificación con CNNs [3]. Estas soluciones permiten pensar en la creación de herramientas locales capaces de procesar imágenes satelitales y ofrecer estimaciones precisas de áreas aprovechables para instalar paneles solares.

Además del reto técnico, este proyecto busca aportar desde una perspectiva social y ambiental, facilitando el acceso a tecnologías limpias en comunidades que hasta ahora han quedado excluidas de iniciativas de transición energética. El desarrollo de un sistema que automatice la detección de techos disponibles no solo impulsa el autoconsumo energético, sino que sienta las bases para una planificación más eficiente y sostenible en las ciudades.

Planteamiento del problema

A pesar del creciente interés por las energías renovables, muchas ciudades siguen sin contar con herramientas que permitan evaluar su verdadero potencial solar. Este problema se acentúa en entornos urbanos donde la alta densidad de edificaciones, las variaciones en la orientación de los techos y la proyección de sombras entre estructuras dificultan la estimación precisa de superficies aprovechables. En estos escenarios, la evaluación manual no resulta viable, debido al tiempo, el costo y la cantidad de personal requerido. Como resultado, muchas zonas urbanas con alto potencial para la generación fotovoltaica siguen siendo subutilizadas, y las autoridades carecen de información confiable para la planificación energética sostenible [1].

Esta limitación no es exclusiva de República Dominicana, pero sí es especialmente grave en ciudades intermedias como Santiago de los Caballeros, donde se concentran tanto una alta demanda energética como una creciente urbanización. En sectores residenciales como Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2, abundan los techos planos con buena exposición solar que aún no han sido evaluados desde un enfoque sistemático. La falta de datos geoespaciales, combinada con el escaso desarrollo de plataformas adaptadas al contexto local, impide implementar soluciones automatizadas que sí han mostrado resultados positivos en países con mayores recursos tecnológicos [3].

En respuesta a esta brecha, la literatura científica ha demostrado avances significativos en el uso de imágenes satelitales y aprendizaje automático para resolver este tipo de problemáticas. Por ejemplo, el trabajo de Cai et al. propone una comparación entre redes neuronales como U-Net, FCN y DeepLabv3+, enfocándose en mejorar la segmentación semántica de techos mediante el uso de técnicas como la convolución atrous y arquitecturas encoder-decoder [2]. Esta investigación valida la importancia de utilizar modelos entrenados específicamente para entornos urbanos, donde la complejidad visual impone retos adicionales.

De forma complementaria, Benchabana et al. presentan un enfoque basado en superpíxeles adaptativos y autoencoders variacionales (VAE) para extraer características visuales relevantes en imágenes de alta resolución. Su metodología mejora la eficiencia de la detección de techos al utilizar clasificadores como redes neuronales convolucionales (CNN), demostrando que es posible reducir errores en entornos densamente edificados [3]. Ambos estudios resaltan la necesidad de contar con imágenes satelitales bien etiquetadas y de alta resolución, así como con modelos robustos capaces de generalizar en condiciones diversas.

El desarrollo de este proyecto ha logrado implementar un sistema de detección automatizada de superficies disponibles en techos para la instalación de paneles solares, utilizando imágenes satelitales y modelos de aprendizaje profundo, con el objetivo de contribuir a la planificación energética sostenible en distintos sectores urbanos de Santiago de los Caballeros. Para ello, se creó un conjunto de datos etiquetado a partir de imágenes reales, que fue posteriormente preprocesado para garantizar la calidad y consistencia necesarias para el entrenamiento de un modelo de segmentación basado en redes neuronales convolucionales. Este modelo permitió identificar y delimitar con precisión las superficies útiles en techos residenciales. Asimismo, se diseñó una interfaz gráfica interactiva que facilita la selección de zonas geográficas específicas dentro de las establecidas, mostrando visualmente los resultados de segmentación y apoyando la toma de decisiones en torno al aprovechamiento del potencial solar urbano. La solución desarrollada no solo cumple con criterios de precisión y eficiencia, sino que también está diseñada para ser escalable, accesible y adaptable a distintos contextos urbanos con características similares.

Metodología

La solución desarrollada en este proyecto parte de una necesidad clara: automatizar la identificación de superficies disponibles en techos urbanos para la instalación de paneles solares. Para lograrlo, se diseñó un flujo de trabajo que integra adquisición y procesamiento de datos satelitales, segmentación semántica mediante redes neuronales convolucionales (CNN), y una visualización interactiva de resultados. Este enfoque, aunque inspirado en soluciones existentes en el ámbito internacional, fue cuidadosamente adaptado a las características morfológicas, arquitectónicas y visuales de sectores urbanos dominicanos, particularmente de la ciudad de Santiago de los Caballeros [2], [3].

Uno de los aspectos fundamentales fue la construcción del dataset. A diferencia de estudios que se basan en bases de datos públicas ampliamente etiquetadas, como Inria o SpaceNet [5], este proyecto utilizó imágenes satelitales locales adquiridas específicamente para representar con fidelidad el entorno urbano objetivo. A partir de estas imágenes, se seleccionaron áreas de interés y se dividieron en bloques más pequeños, adecuados para la segmentación supervisada. Este proceso incluyó una fase manual de etiquetado en herramientas especializadas como CVAT y Roboflow [6], [7], lo cual permitió generar máscaras binarias diferenciando zonas útiles de zonas no utilizables en los techos.

Previamente al entrenamiento del modelo, se aplicó un proceso riguroso de preprocesamiento de las imágenes. Esto incluyó ajustes de tamaño, normalización, aumentos artificiales (data augmentation) y corrección de contraste para mejorar la representación visual de las áreas objetivo. Estas técnicas permiten que el modelo generalice mejor ante variaciones de iluminación, resolución o inclinación, replicando prácticas exitosas reportadas en la literatura sobre segmentación urbana [8], [9].

Para la tarea de segmentación, se optó por una arquitectura de red neuronal convolucional, específicamente basada en U-Net, por su comprobada eficacia en tareas de segmentación de imágenes con datos limitados [2], [10]. U-Net permite capturar tanto características globales como detalles finos de las imágenes, gracias a su estructura encoder-decoder con conexiones de salto. Esta arquitectura ha sido empleada con éxito en aplicaciones biomédicas, agrícolas y recientemente también en análisis urbano, debido a su capacidad para conservar la resolución espacial de los elementos segmentados.

Durante el entrenamiento, se utilizaron funciones de pérdida basadas en el coeficiente de Dice y binary cross-entropy, las cuales optimizan la precisión de la segmentación píxel a píxel. El modelo fue evaluado mediante métricas estándar como Intersection over Union (IoU), precisión, sensibilidad y F1-score. Estas métricas, frecuentemente utilizadas en estudios como los de Cai et al. y Hao et al., permiten medir el rendimiento del modelo de forma rigurosa y replicable [2], [8].

Uno de los elementos distintivos del proyecto fue el enfoque local del entrenamiento. A diferencia de soluciones como las propuestas por Google Sunroof, que operan con modelos generalistas y a gran escala, aquí se entrenó el modelo con datos específicos de la ciudad de Santiago, lo que permite una mejor adaptación al entorno construido, los estilos arquitectónicos y las condiciones atmosféricas locales. Esta aproximación responde a lo planteado por Benchabana et al., quienes enfatizan la necesidad de modelos entrenados con datos locales para mejorar la precisión en entornos complejos [3].

Una vez entrenado el modelo, se implementó una interfaz gráfica accesible y ligera que permite al usuario cargar imágenes, visualizar las segmentaciones resultantes y explorar zonas específicas. Esta herramienta está orientada tanto a usuarios técnicos como a tomadores de decisiones municipales o interesados en evaluar el potencial solar de propiedades específicas. La interfaz ofrece no solo una visualización clara del resultado, sino que también permite generar reportes visuales que podrían integrarse fácilmente en sistemas de planificación urbana.

El sistema realizado está preparado para recibir nuevas imágenes satelitales, lo que permite escalar la solución a otros sectores urbanos sin necesidad de retrabajar toda la arquitectura del modelo. Además, su diseño modular permite reemplazar fácilmente el backbone de la red por arquitecturas más modernas, como DeepLabv3+ o UNet++ [2], [11], si se desea mejorar aún más la precisión en el futuro. Esta capacidad de adaptación y mejora progresiva es fundamental para su sostenibilidad técnica.

Por último, la solución desarrollada representa una alternativa viable, escalable y eficiente para evaluar el potencial fotovoltaico en ciudades donde este tipo de análisis no está sistematizado. Al integrar datos reales del entorno, técnicas modernas de aprendizaje profundo y herramientas visuales intuitivas, el proyecto propone un modelo replicable que puede ser adoptado por gobiernos locales, instituciones energéticas o incluso empresas privadas interesadas en impulsar la transición energética urbana.

Resultados

Al aplicar la solución propuesta sobre el conjunto de imágenes satelitales de los sectores seleccionados en Santiago de los Caballeros, se evaluó el desempeño de distintos enfoques de visión por computadora para identificar superficies de techo disponibles para la instalación de paneles solares. La validación se realizó con un conjunto de prueba independiente del utilizado en entrenamiento, y se midió mediante métricas estándar en segmentación y detección: precision, recall, F1-score, mean Average Precision (mAP@50 y mAP@50-95 cuando aplica) e Intersection over Union (IoU) para los modelos con salida de máscaras. El uso de estas métricas es consistente con la práctica reportada en estudios de segmentación de techos y detección de estructuras urbanas en imágenes remotas de alta resolución [2], [3], [8], [9].

Se entrenaron y evaluaron tres enfoques: YOLOv8, YOLOv11 y Mask R-CNN. En términos generales, los modelos basados en YOLO ofrecieron capacidades rápidas de detección de instancias, mientras que Mask R-CNN entregó segmentaciones más detalladas, algo crítico cuando el objetivo es estimar área útil más que solo localizar techos. Esta diferencia metodológica ya había sido señalada en la literatura, donde arquitecturas orientadas a segmentación densa suelen superar a detectores basados en bounding boxes cuando se requieren estimaciones espaciales finas [2], [3].

ModeloPrecisionRecallmAP50mAP50-95F1IoU
YOLOv80.710.6840.7090.4460.69N/A
YOLOv110.6750.6940.7320.4750.68N/A
Mask R-CNN0.8450.702N/AN/A0.7660.61
Tabla 1. Métricas de desempeño de YOLOv8, YOLOv11 y Mask R-CNN sobre el conjunto de prueba.

Durante la validación cualitativa se observaron patrones de error relevantes para la aplicación práctica. En imágenes donde los techos contienen elementos sobresalientes —conductos de ventilación, unidades de aire acondicionado, tanques o instalaciones previas— el modelo Mask R-CNN ocasionalmente incluye estos objetos dentro del área útil, generando sobreestimaciones. Este tipo de confusión ha sido documentado en trabajos de detección de equipos HVAC sobre imágenes aéreas, donde la variabilidad de forma y escala dificulta la discriminación automática [4]. Adicionalmente, en zonas con alta concentración de techos metálicos (por ejemplo, zinc), el modelo clasificó como disponibles superficies que habían sido catalogadas como no válidas en la etapa de etiquetado; la influencia del material del techo sobre la idoneidad fotovoltaica ha sido discutida en investigaciones sobre desempeño térmico y compatibilidad estructural, lo que resalta la importancia de incorporar atributos de materialidad en futuras versiones del sistema [12], [13].

Para valorar la utilidad del sistema en escenarios reales, se analizaron imágenes de los tres sectores de estudio: Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2. En los casos con techos amplios y relativamente despejados, la segmentación fue consistente, y las máscaras generadas coincidieron estrechamente con las áreas marcadas en la verdad de terreno. En escenas más complejas —tejidos urbanos densos, sombra lateral, techos irregulares— la calidad bajó, pero se mantuvo dentro de parámetros utilizables para análisis preliminar de potencial solar. Este comportamiento es coherente con trabajos que muestran degradación gradual del desempeño cuando se trabaja con imágenes off-nadir o con mayor oclusión estructural en entornos urbanos heterogéneos [8], [5].

En conjunto, los resultados validan la elección de Mask R-CNN como modelo principal para la etapa de segmentación en la herramienta desarrollada: su mayor precisión, mejor delimitación espacial y desempeño robusto frente a variabilidad urbana lo convierten en la mejor base para estimar superficie disponible de techo. Aun así, los hallazgos sobre errores en techos con obstáculos y materiales críticos abren vías claras de mejora: integrar un módulo secundario de detección de objetos (HVAC/obstáculos), cruzar la segmentación con un clasificador de material de techo, o aplicar refinamiento geométrico guiado por modelos de elevación cuando haya datos disponibles. Estas líneas de desarrollo están alineadas con la evolución observada en la literatura, donde la tendencia es combinar segmentación profunda con atributos contextuales para mejorar la toma de decisiones energéticas urbanas [2], [3], [13], [12].

Interfaz de la aplicación

Las siguientes imágenes muestran la interfaz de la aplicación en funcionamiento.

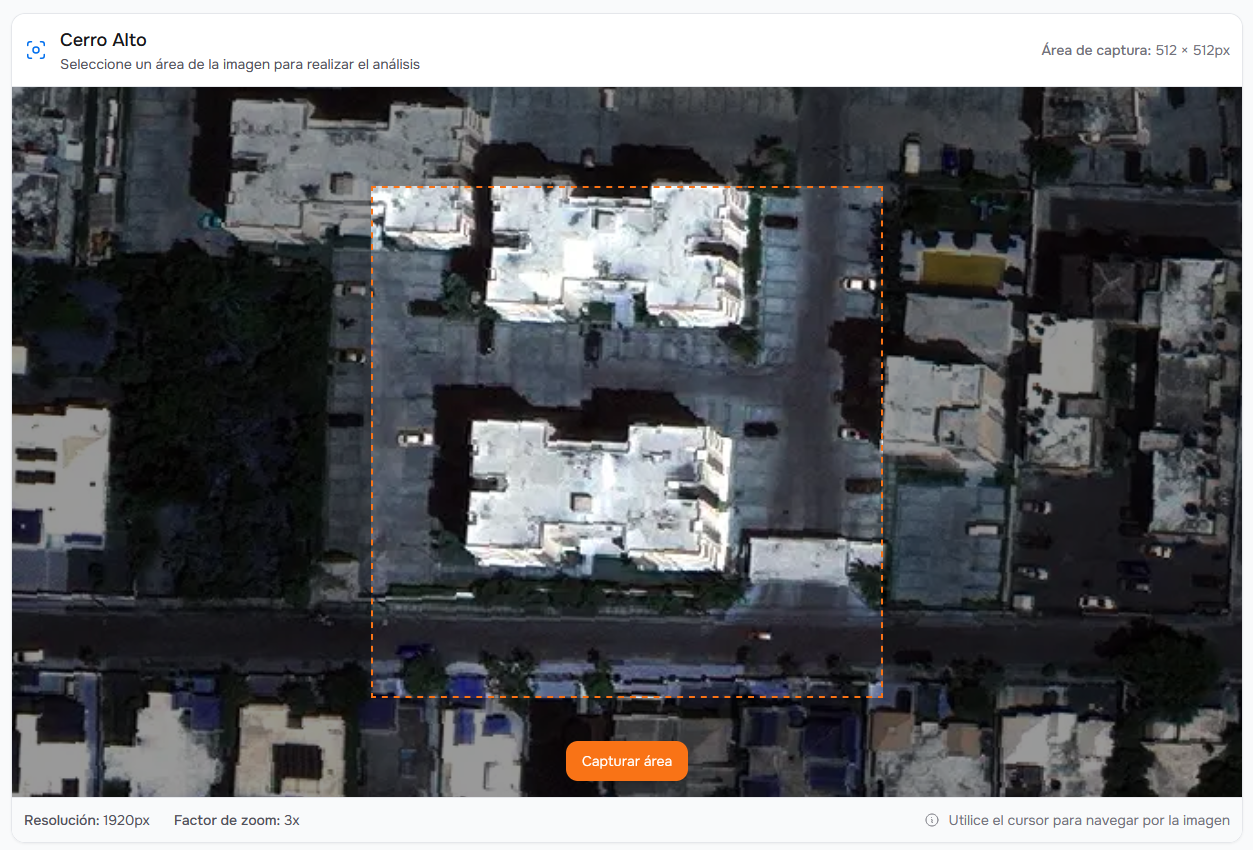
Pantalla de la aplicación con una imagen satelital de Cerro Alto y un recuadro de selección del área a analizar
Figura 1. Pantalla de selección de área a analizar.
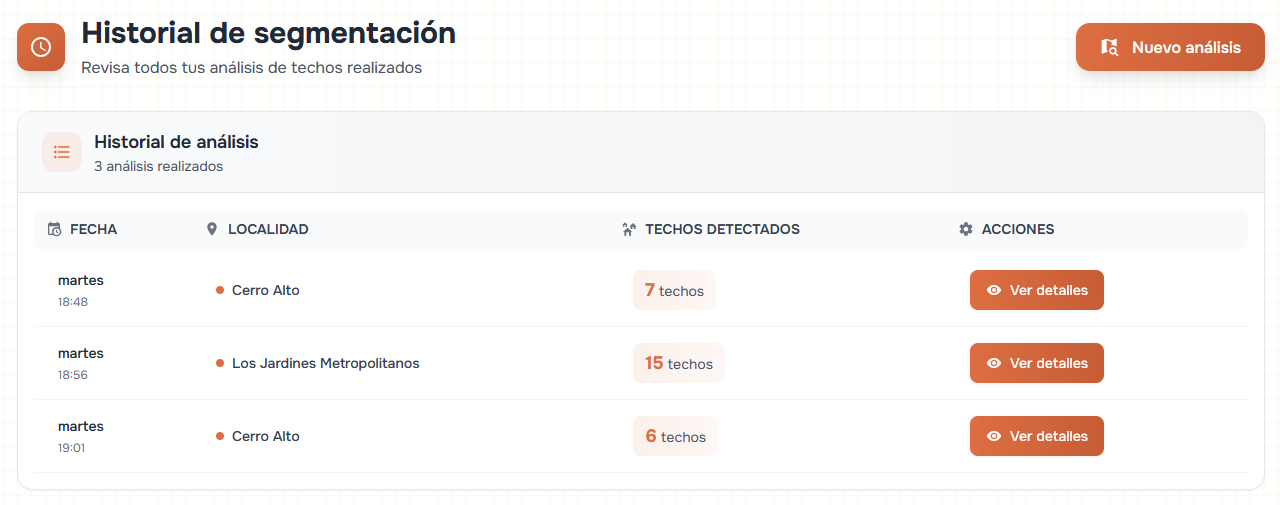
Pantalla del historial de segmentación con los análisis realizados por localidad y techos detectados
Figura 2. Pantalla del historial de segmentaciones.
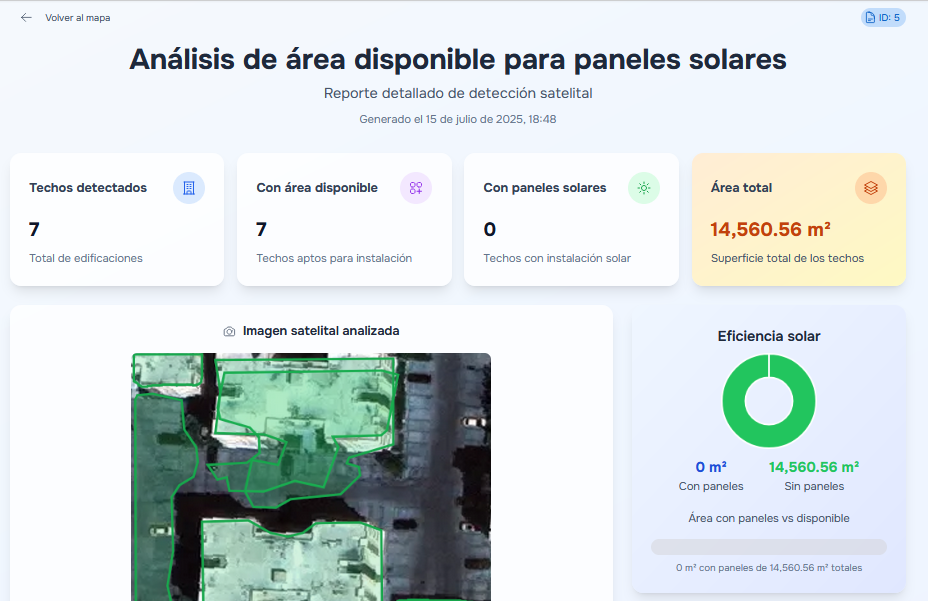
Reporte de análisis con techos detectados, área total y la imagen satelital con los techos segmentados en verde
Figura 3. Pantalla del análisis de los resultados de la predicción.

Conclusión

Este proyecto logró demostrar que es posible automatizar la detección de superficies de techos disponibles para la instalación de paneles solares mediante el uso de imágenes satelitales y modelos de aprendizaje profundo. La construcción de un conjunto de datos etiquetado, el entrenamiento y comparación de modelos, así como el desarrollo de una interfaz gráfica funcional, evidencian la viabilidad técnica de esta solución para apoyar el análisis inicial en proyectos fotovoltaicos urbanos.

Los resultados obtenidos con Mask R-CNN resaltan la importancia de emplear arquitecturas de segmentación avanzadas cuando la prioridad es una delimitación precisa del área útil, algo fundamental para estimaciones reales de superficie. Aun así, el sistema presentó desafíos como la confusión con objetos presentes en techos y la clasificación errónea de ciertos materiales como el zinc. Estos hallazgos señalan la necesidad de continuar optimizando el modelo con un conjunto de datos más amplio y diverso, incorporando ejemplos representativos de distintos materiales, sombras y condiciones visuales, además de variables complementarias como inclinación, orientación y cálculo del potencial fotovoltaico.

Este trabajo sienta las bases para una herramienta capaz de aportar valor a instituciones energéticas, urbanistas y especialistas en sostenibilidad. Con mejoras adicionales, podría escalarse a nuevos sectores de República Dominicana y a ciudades con características similares, ampliando su alcance y utilidad. Como próximos pasos se sugiere fortalecer el dataset, integrar detección de obstáculos y establecer alianzas con actores del sector energético, para así convertir esta propuesta en un recurso clave dentro de la transición hacia energías renovables.

Referencias

  1. A. Gautam and N. Mehta, “A Review on Remote Sensing Technique: Concept and Principles,” Int. J. Res. Emerg. Sci. Technol., vol. 2, no. 5, pp. 1–6, 2015. [Online]. Available: https://www.researchgate.net/publication/354143409
  2. Y. Cai et al., “A Comparative Study of Deep Learning Approaches to Rooftop Detection in Aerial Images,” Can. J. Remote Sens., vol. 47, no. 3, pp. 413–431, May 2021, doi: 10.1080/07038992.2021.1915756.
  3. A. Benchabana, M.-K. Kholladi, R. Bensaci, and B. Khaldi, “Building Detection in High-Resolution Remote Sensing Images by Enhancing Superpixel Segmentation and Classification Using Deep Learning Approaches,” Buildings, vol. 13, no. 7, p. 1649, Jun. 2023, doi: 10.3390/buildings13071649.
  4. N. Chen, “Rooftop HVAC equipment detection from aerial imagery”.
  5. Z. Awwad, A. Alharbi, A. H. Habib, and O. L. De Weck, “Site Assessment and Layout Optimization for Rooftop Solar Energy Generation in Worldview-3 Imagery,” Remote Sens., vol. 15, no. 5, p. 1356, Feb. 2023, doi: 10.3390/rs15051356.
  6. “Leading Image & Video Data Annotation Platform | CVAT.” Accessed: Feb. 17, 2025. [Online]. Available: https://www.cvat.ai/
  7. “Roboflow: Computer vision tools for developers and enterprises.” Accessed: May 06, 2025. [Online]. Available: https://roboflow.com/
  8. H. Hao et al., “Improving Building Segmentation for Off-Nadir Satellite Imagery,” Sep. 2021, arXiv. doi: 10.48550/arXiv.2109.03961.
  9. K. O’Shea and R. Nash, “An Introduction to Convolutional Neural Networks,” Dec. 2015, arXiv. doi: 10.48550/arXiv.1511.08458.
  10. O. Ronneberger, P. Fischer, and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” May 2015, arXiv. doi: 10.48550/arXiv.1505.04597.
  11. K. He, X. Zhang, S. Ren, and J. Sun, “Deep Residual Learning for Image Recognition,” Dec. 2015, arXiv. doi: 10.48550/arXiv.1512.03385.
  12. N. Aigbedion, F. Njoka, and M. Munji, “The Impact of Roof Material Profile and Pigmentation on the Performance of Photovoltaic Modules,” Solar, vol. 3, no. 4, pp. 618–637, Nov. 2023, doi: 10.3390/solar3040033.
  13. J. Park, S. Park, and J. Kang, “Detecting and classifying rooftops with a CNN-based remote-sensing method for urban area cool roof application,” Energy Reports, vol. 11, pp. 2516–2525, Jun. 2024, doi: 10.1016/j.egyr.2024.02.001.

Sistema de Diagnóstico asistido por Inteligencia Artificial para la detección de Retinopatía Diabética

Vianny Cruz Cruz y Carlos Mena Moronta – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Con la evolución constante de la tecnología y por la búsqueda constante de la eficiencia y mejora de los procesos ya establecidos, se han creado modelos de inteligencia artificial que ayudan a desarrollar determinadas tareas. Dado los buenos resultados al emplear estas herramientas en el ámbito médico, como se presenta en el artículo [5], se está explorando en crear más de estas herramientas para el beneficio del sector de la salud. El presente artículo se basa en la creación de una IA destinada en la detección de una condición de la diabetes. La inteligencia artificial ha revolucionado nuestra realidad actual, siendo relevante tanto para el ámbito cotidiano así como también para áreas especializadas. Dado los buenos resultados al emplear estas herramientas en el ámbito médico [5], se está explorando en crear más de estas herramientas para el beneficio del sector de la salud. El presente artículo, aborda la creación de un sistema de diagnóstico oftalmológico con inteligencia artificial.

La diabetes es una afección crónica causada por los altos niveles de azúcar en la sangre, lo cual causa complicaciones varias en quien la padece. Actualmente se aprecia un aumento en la cantidad de personas que se ven afectadas por la misma, convirtiéndose así en una de las principales causas de muerte, como se puede apreciar en [6]. Entre las diferentes complicaciones provocadas por la diabetes, se encuentra aquella en torno a la cual se realiza la presente investigación, la Retinopatía Diabética.

La Retinopatía Diabética, RD por sus siglas, es una condición de la diabetes que afecta al nervio óptico, siendo capaz de llegar a causar ceguera permanente en quienes la padecen, actualmente, aproximadamente 10,000 personas anualmente pierden la visión debido a la misma [1][2]. Por esta y otras razones, como lo es el aumento de casos de diabetes a nivel mundial [3], es que la detección temprana de esta condición posee tanta relevancia [7].

Este proyecto, realizado por Vianny Cruz y Carlos Mena, estudiantes de la carrera de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra, consiste en el desarrollo de un modelo de inteligencia artificial para el diagnóstico de la Retinopatía Diabética. El mismo debe de ser capaz de detectar la presencia o ausencia de esta patología en imágenes de fondo de ojo.

La creación de esta prometedora herramienta, no solo ayudará a los retinólogos dominicanos a realizar sus consultas y diagnósticos, sino que también es posible servir de ayuda a los oftalmólogos no especializados en la retina del país a poder dar un diagnóstico relacionado con la RD a sus pacientes. De esta forma logrando ayudar al sector salud a ejecutar diagnósticos en el momento oportuno y de esta forma, poder tratar a los pacientes antes de que la enfermedad avance al punto en el que la visión se puede ver afectada [10].

Problemática y estado del arte

A nivel mundial la diabetes presenta una situación preocupante y que se va agravando con el tiempo. Según un estudio realizado en 2021, en el año 2015 se contaban con 415 millones de casos de diabetes, para el 2040 se estima que esta cifra alcanzará los 642 millones [4]. A nivel nacional el panorama tampoco es prometedor, en el reporte de [3] en la República Dominicana en 2024 la prevalencia de la diabetes en adultos alcanzó el 17.6%, lo cual equivale a 1,203,700 de los 7,255,498 dominicanos adultos.

La retinopatía diabética es una patología que progresa en el tiempo, la misma cuenta con 4 clasificaciones, las cuales son las siguientes: Retinopatía Diabética no proliferativa leve, retinopatía diabética no proliferativa moderada, retinopatía diabética no proliferativa severa y, finalmente, la retinopatía diabética proliferativa. Adicionalmente, mientras más avanzada esté la enfermedad, representa un riesgo mayor para el paciente, el tratamiento es más agresivo y el costo del mismo se eleva. Por lo que un temprano diagnóstico y abordamiento de la enfermedad es crucial.

En un país con recursos limitados, poder disponer de un diagnóstico rápido y preciso es crucial, pero el mismo presenta dificultades en su obtención, ya que es necesario de un retinólogo con conocimientos en el diagnóstico de la retinopatía diabética. Con el aumento en los casos, la poca disponibilidad de los retinólogos que se puede presentar y con la necesidad de un diagnóstico temprano, la herramienta propuesta en el presente documento adquiere suma relevancia y promete ser crucial para enfrentar y solventar esta problemática.

La solución propuesta no fue diseñada ni debe reemplazar los diagnósticos de los oftalmólogos, sino que el propósito de la misma es servir de herramienta para aumentar la eficiencia, servir como valoración adicional y ayudar a los oftalmólogos no especializados en el diagnóstico de esta condición de la diabetes. La misma nunca será empleada por los pacientes, sino por los miembros del sistema de salud que se encargan del diagnóstico y cuidado del nervio óptico.

Previamente fueron realizados estudios donde se desarrollan modelos de inteligencia artificial para realizar diagnóstico de diversas enfermedades. Dichos estudios reflejaron un panorama positivo en base a los resultados obtenidos y se llegó a la conclusión de que los modelos de IA son útiles para la detección y el diagnóstico de enfermedades en donde el diagnóstico consiste en identificar una serie de características y patrones en los estudios realizados en pacientes.

Repasando investigaciones y proyectos anteriores, se confirma que ya se ha trabajado en la creación de modelos destinados para la detección de la RD, pero existen amplias posibilidades de innovación, sobre todo al realizarlo en un ambiente específico de nuestro país, República Dominicana, utilizando imágenes de pacientes nacionales [5][8][9]. Además la creación de un modelo que funcione acorde a las imágenes de fondo de ojo que son manejadas en la Rep. Dom. acaba resultando en una herramienta especializada para ser empleada en el país.

Objetivos completados

  • Desarrollar un sistema de detección de retinopatía diabética fundamentado en arquitecturas de redes neuronales convolucionales, que demuestre un rendimiento satisfactorio con elevada precisión diagnóstica. Esta herramienta tecnológica tiene como propósito servir como apoyo complementario en el proceso de diagnóstico oftalmológico, contribuyendo al objetivo estratégico de reducir la incidencia nacional de casos de pérdida visual asociados a esta patología.

Metodología

El desarrollo del sistema de diagnóstico asistido por inteligencia artificial para la detección de retinopatía diabética se fundamentó en una metodología iterativa estructurada en cuatro fases secuenciales: preparación y procesamiento de datos, desarrollo y entrenamiento del modelo CNN [15], integración de componentes del sistema, y validación y evaluación del desempeño. Esta aproximación metodológica permitió el refinamiento continuo mediante ciclos de retroalimentación, facilitando la identificación temprana de limitaciones y garantizando una mayor robustez del producto final a través de múltiples evaluaciones y ajustes sucesivos.

La implementación técnica se desarrolló utilizando los recursos computacionales de la plataforma Kaggle, empleando un entorno basado en Python 3.11.13 sobre sistema operativo Linux, con procesamiento distribuido entre CPU Intel Xeon de 4 núcleos lógicos y GPU NVIDIA Tesla P100 con 16GB de VRAM. El stack tecnológico incluyó TensorFlow 2.18.0, Keras 3.8.0, Scikit-learn 1.2.2, y librerías complementarias especializadas para procesamiento de imágenes y análisis estadístico, seleccionadas por su robustez comprobada en aplicaciones de aprendizaje automático médico.

El conjunto de datos se conformó mediante la integración de fuentes complementarias: el dataset público APTOS (Diabetic Retinopathy Detection) y muestras del Hospital Regional Universitario José María Cabral y Báez, totalizando 1,604 imágenes oftalmológicas distribuidas equilibradamente entre casos positivos (799) y negativos (805) para retinopatía diabética. El dataset APTOS, derivado del concurso Kaggle de detección de retinopatía diabética de 2019, proporciona imágenes de alta calidad capturadas en condiciones controladas utilizando equipos estandarizados. Las imágenes del hospital local fueron capturadas utilizando una cámara de fondo de ojo digital VISUCAM 524, representando las condiciones reales de captura en el contexto clínico dominicano, específicamente en el Hospital Regional Universitario José María Cabral y Báez. Adicionalmente, se mantuvo un conjunto independiente de 34 imágenes provenientes del hospital para validación final, garantizando una evaluación imparcial del rendimiento del sistema mediante su completo aislamiento durante todo el proceso de entrenamiento. Este conjunto de validación independiente incluyó únicamente muestras locales para evaluar específicamente la capacidad de generalización del modelo a la población objetivo.

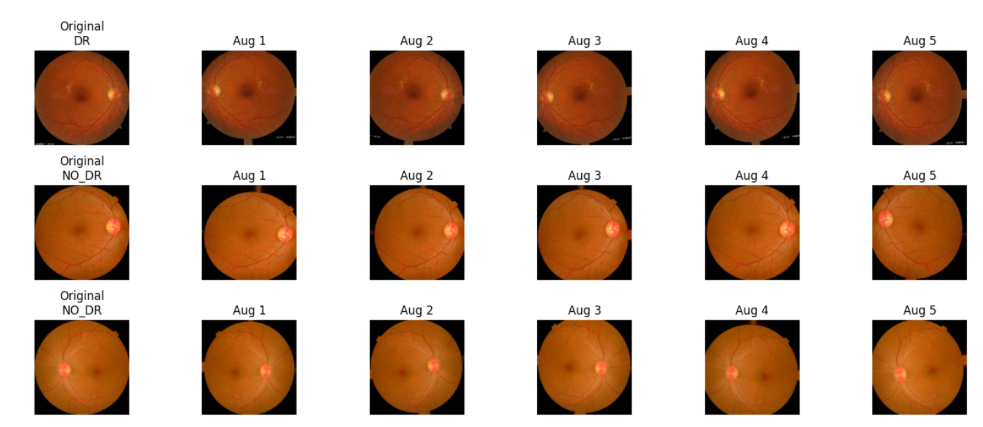
El preprocesamiento de imágenes implementó una pipeline estandarizado que incluyó normalización dimensional a 224×224 píxeles, conversión a arrays NumPy en espacio de color RGB, verificación automática de integridad mediante gestión de excepciones, y organización estructurada de datos. Para compensar las limitaciones del tamaño del dataset, se desarrolló una estrategia conservadora de aumento de datos que aplicó transformaciones geométricas controladas (rotación ±10°, desplazamiento 5%, zoom mínimo 5%) y transformaciones de intensidad apropiadas para preservar la fidelidad médica de las imágenes oftalmológicas [14]. Estas transformaciones pueden apreciarse en la siguiente figura:

Ejemplos de imágenes de fondo de ojo originales y sus versiones aumentadas
Figura 1. Aumentación de datos.

La arquitectura del modelo se basó en transfer learning utilizando EfficientNetB0 como base congelada, complementada con un clasificador personalizado que incorporó GlobalAveragePooling2D, BatchNormalization, capas Dense con activación ReLU y regularización L2, y técnicas de Dropout [12]. Esta configuración conservadora se diseñó específicamente para mitigar el riesgo de sobreajuste inherente a conjuntos de datos limitados, mientras optimiza el uso de recursos computacionales disponibles.

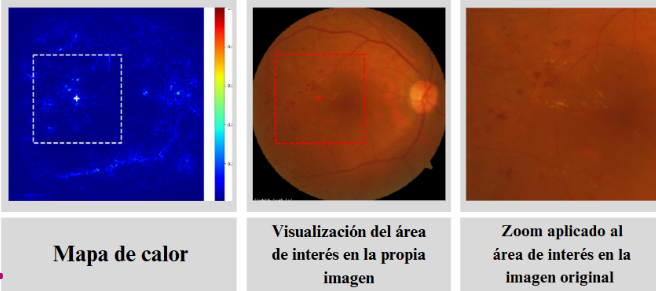
Para abordar los requerimientos de interpretabilidad médica, se implementó Gradient-weighted Class Activation Mapping (Grad-CAM), como técnica de explicabilidad que permite visualizar las regiones anatómicas que contribuyen significativamente a las decisiones diagnósticas del modelo [13]. La implementación incluyó cálculo de gradientes mediante tf.GradientTape, obtención de pesos de importancia por reducción global, generación de mapas de calor con normalización [0,1], y post-procesamiento con filtrado Gaussiano para suavizar artefactos, complementado con mecanismos de fallback para garantizar continuidad operacional.

Mapa de calor Grad-CAM, área de interés sobre la imagen de fondo de ojo y zoom del área
Figura 2. Gradiente visto desde la aplicación.

El proceso de regularización integró múltiples estrategias complementarias para prevenir overfitting: regularización L2 en capas densas, Dropout estratificado en puntos críticos de la arquitectura, Batch Normalization para estabilización de activaciones, Early Stopping con monitoreo de pérdida de validación (paciencia de 8 épocas) [16], y reducción adaptativa de tasa de aprendizaje mediante ReduceLROnPlateau (factor 0.5, paciencia de 4 épocas) [15]. Esta aproximación multicapa de regularización demostró ser efectiva para mantener la capacidad de generalización del modelo dentro de las limitaciones del dataset disponible.

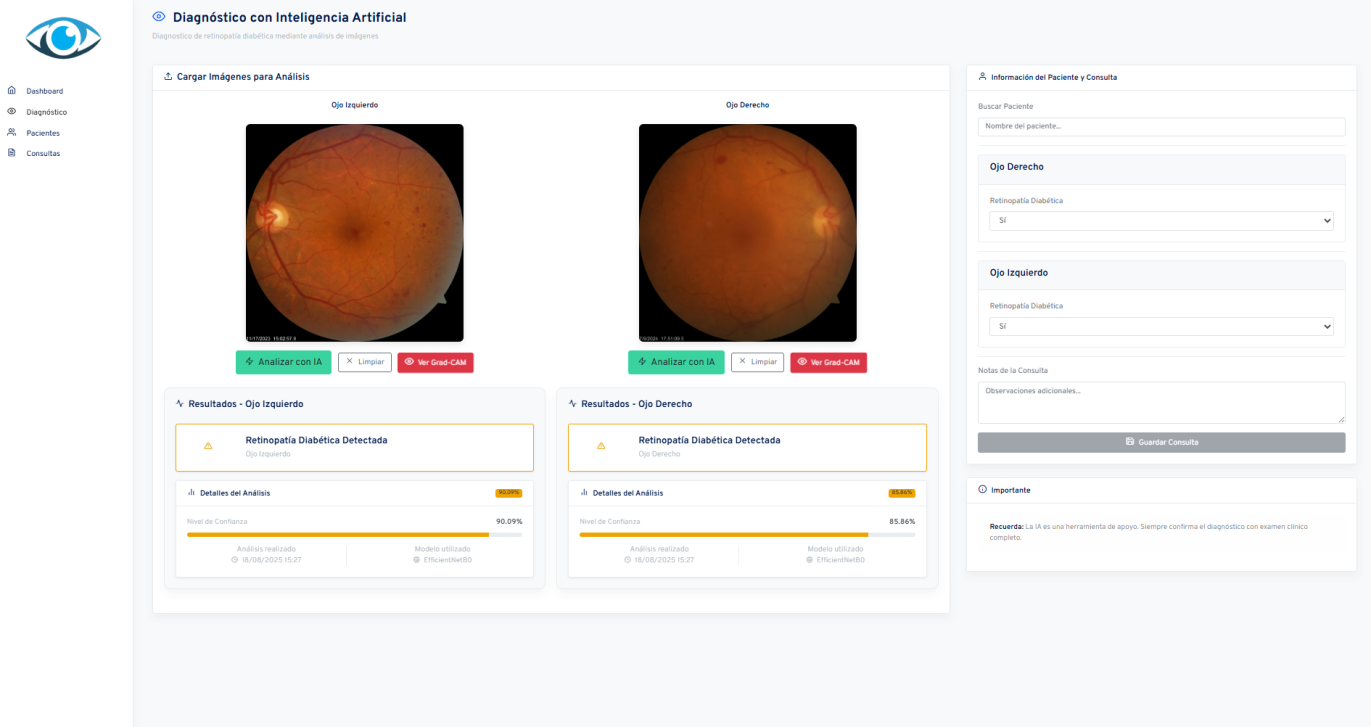
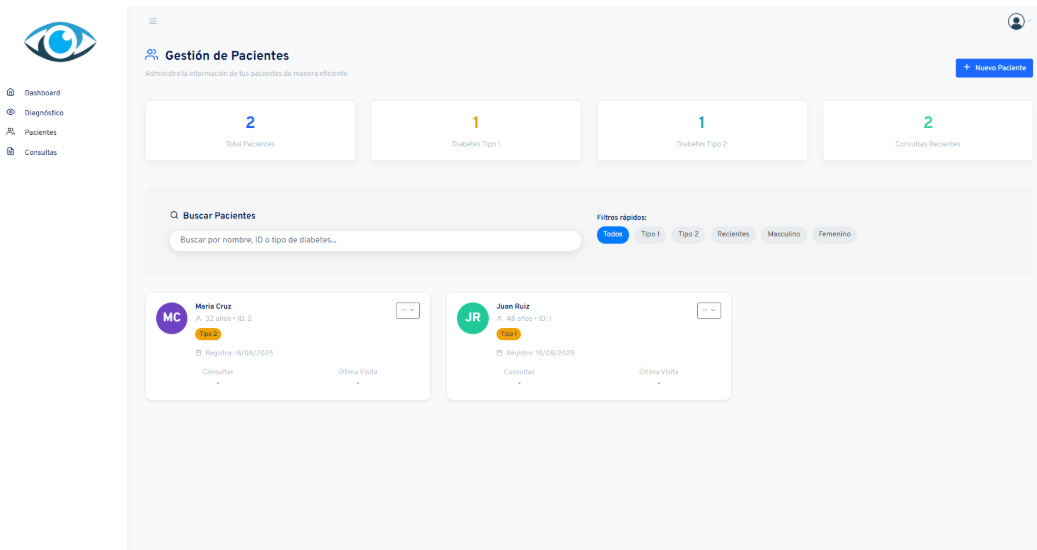
La implementación final evolucionó desde un prototipo web inicial hacia una aplicación de escritorio, considerando las restricciones específicas del entorno hospitalario en términos de seguridad de datos, privacidad del paciente, y disponibilidad operacional sin dependencias externas. El sistema resultante integra backend en Python con interfaz HTML5/JavaScript, base de datos relacional SQLite para gestión de usuarios y consultas, autenticación de sesiones, y funcionalidades avanzadas de interpretabilidad visual para apoyo al diagnóstico clínico especializado.

Vista de diagnóstico de la aplicación con dos imágenes de fondo de ojo y su resultado
Figura 3. Vista de diagnóstico de la aplicación.
Vista de gestión de pacientes de la aplicación
Figura 4. Vista de gestión de pacientes de la aplicación.

Resultados

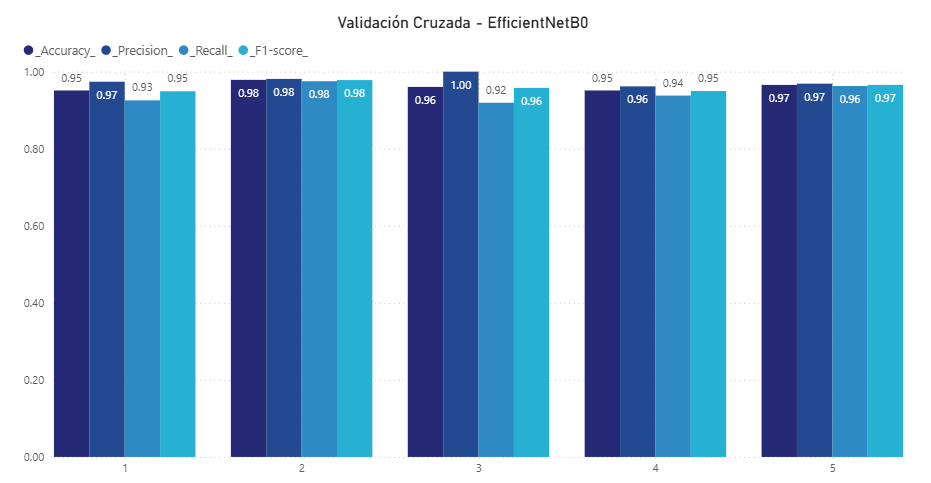
El modelo de clasificación de retinopatía diabética desarrollado demostró un rendimiento excepcional, alcanzando una exactitud promedio del 96.14% en validación cruzada de 5 pliegues. Este nivel de precisión diagnóstica evidencia la efectividad del modelo para distinguir entre imágenes oftalmológicas con retinopatía diabética y casos sin evidencia de la patología, estableciendo una base sólida para su potencial implementación clínica.

La evaluación mediante validación cruzada de 5 pliegues reveló una consistencia notable en el rendimiento del modelo, con variaciones controladas en todas las métricas: exactitud con rango de 2.75 puntos porcentuales (95.12%-97.87%), precisión con variación máxima de 3.82 puntos porcentuales (96.18%-100%), recall con la mayor variabilidad de 5.59 puntos porcentuales (91.93%-97.52%), y F1-Score con variación de 2.92 puntos porcentuales (94.90%-97.82%). Esta estabilidad inter-pliegues sugiere robustez ante diferentes particiones de datos y capacidad de generalización efectiva a muestras no observadas durante el entrenamiento. La variabilidad observada se mantiene dentro de rangos aceptables para aplicaciones clínicas, donde diferencias menores al 5% entre evaluaciones se consideran clínicamente insignificantes. El análisis estadístico reveló una desviación estándar promedio de 1.89% para la exactitud, 1.52% para la precisión, 2.23% para el recall, y 1.46% para el F1-Score. Estos valores de dispersión relativamente bajos indican que el modelo mantiene un rendimiento consistente independientemente de la composición específica del conjunto de entrenamiento y validación.

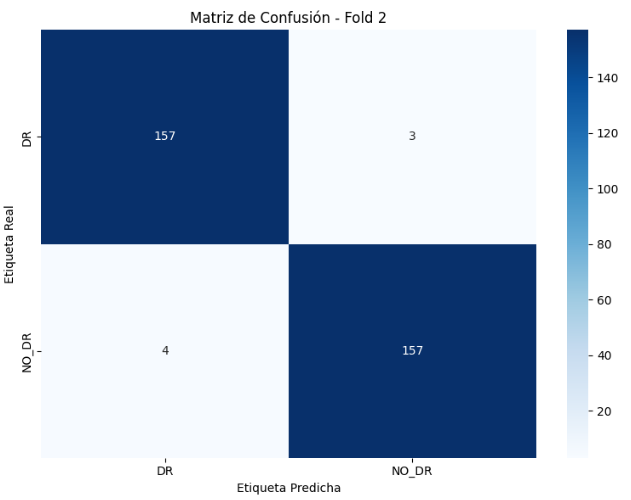
El Fold 2 emergió como el de mejor rendimiento global, alcanzando la exactitud más alta de 97.87%, la segunda mejor precisión de 98.12%, el mejor recall de 97.52%, y el mejor F1-Score de 97.82%, motivo por el cual fue seleccionado para la implementación final del sistema:

Matriz de confusión del Fold 2: 157 y 157 aciertos, 3 y 4 errores
Figura 5. Matriz de confusión para Fold 2.
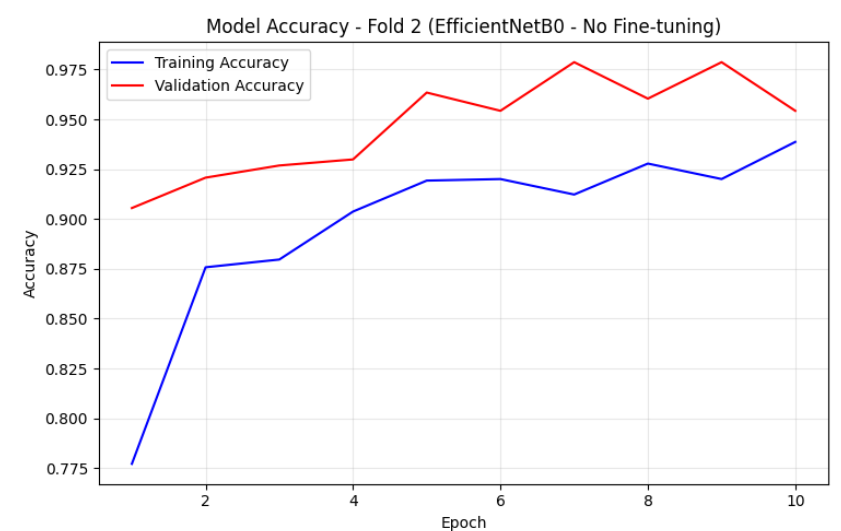
Gráfica de accuracy de entrenamiento y validación por época para el Fold 2
Figura 6. Gráfica de accuracy por época para Fold 2.
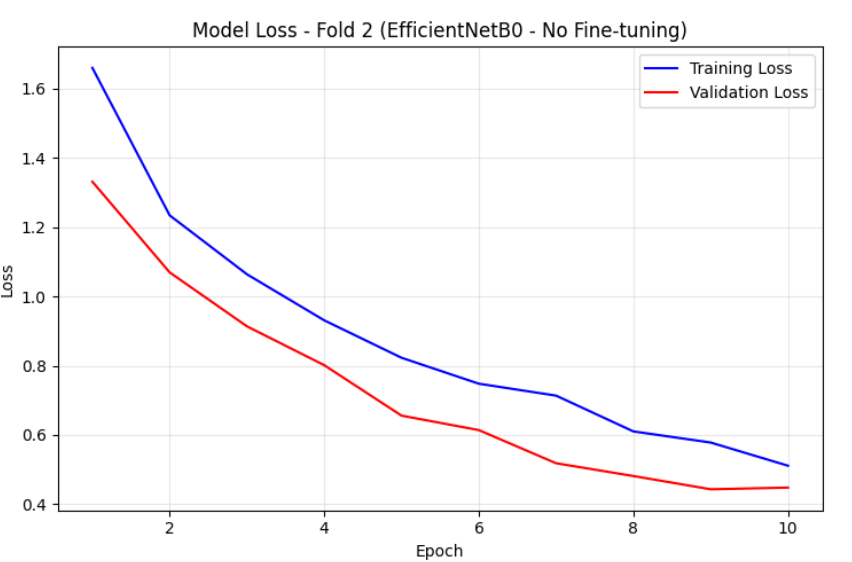
Gráfica de pérdida de entrenamiento y validación por época para el Fold 2
Figura 7. Gráfica de pérdida por época para Fold 2.

La evaluación crítica mediante el conjunto independiente de 34 imágenes, completamente aislado durante todo el proceso de desarrollo, proporcionó una validación externa fundamental para establecer la aplicabilidad del modelo en el contexto hospitalario dominicano. Este conjunto de validación adquirió particular relevancia al incluir exclusivamente muestras del Hospital Regional Universitario José María Cabral y Báez, permitiendo evaluar la capacidad de generalización del modelo a datos locales específicos.

Los resultados obtenidos en el conjunto de validación independiente demostraron una identificación correcta de 16 imágenes de 17 para ambas clases diagnósticas (retinopatía diabética presente y ausente), traduciendo en una precisión del 94% para cada categoría. Esta cifra representa una diferencia mínima de apenas 2 puntos porcentuales respecto a la precisión del 96% obtenida en validación cruzada, evidenciando la capacidad del modelo para mantener su rendimiento diagnóstico en muestras completamente independientes.

Gráfica de barras de accuracy, precisión, recall y F1-score en los cinco folds
Figura 8. Visualización de resultados de validación cruzada.
Retinopatía DiabéticaSin Retinopatía DiabéticaRetinopatía DiabéticaSin Retinopatía Diabética
EfficientNetB016/1716/1794%94%
Tabla 1. Resultados de validación con conjunto aislado.

Conclusión

El desarrollo de este sistema de inteligencia artificial para la detección de retinopatía diabética ha demostrado exitosamente que es posible el desarrollo de implementaciones de inteligencia artificial satisfactorias en el contexto nacional. Este logro técnico representa un avance hacia la democratización del diagnóstico oftalmológico especializado, especialmente en entornos con recursos limitados donde el acceso a especialistas en retina es escaso. La colaboración interdisciplinaria y la utilización de datos tanto nacionales como internacionales fueron elementos clave que garantizan no sólo la precisión del modelo, sino también su relevancia clínica y aplicabilidad práctica.

El potencial de expansión de este proyecto es considerable, desde la implementación de clasificación multiclase para los cinco niveles de severidad de la retinopatía diabética, hasta la incorporación de otras patologías oculares y el desarrollo de herramientas educativas para futuros oftalmólogos. Con el incremento global de casos de diabetes y la creciente demanda de diagnósticos oportunos, este sistema representa una solución escalable que puede integrarse en protocolos de tamizaje masivo. El llamado a la acción es claro: es viable y prometedor que la comunidad científica, los profesionales de la salud y las instituciones colaboren para expandir esta investigación tecnológica en una herramienta que impacte positivamente miles de vidas.

Referencias

  1. D. S. Fong, L. P. Aiello, F. L. Ferris, and R. Klein, “Diabetic retinopathy,” Diabetes Care, vol. 27, no. 10. pp. 2540–2553, Oct. 2004. doi: 10.2337/diacare.27.10.2540.
  2. S. Kusuhara, Y. Fukushima, S. Ogura, N. Inoue, and A. Uemura, “Pathophysiology of diabetic retinopathy: The old and the new,” Diabetes and Metabolism Journal, vol. 42, no. 5. Korean Diabetes Association, pp. 364–376, Oct. 01, 2018. doi: 10.4093/dmj.2018.0182.
  3. International Diabetes Federation, “IDF Diabetes Atlas, 11th edition,” Accessed: Jun. 14, 2025. [Online]. Available: https://diabetesatlas.org/media/uploads/sites/3/2025/04/IDF_Atlas_11th_Edition_2025.pdf
  4. V. E. Madsen Beau De Rochars et al., “Prevalence of Diabetes, Prediabetes, and Associated Risk Factors among Agricultural Village Residents in the Dominican Republic,” American Journal of Tropical Medicine and Hygiene, vol. 104, no. 6, pp. 2241–2250, Jun. 2021, doi: 10.4269/ajtmh.19-0942.
  5. H. Sadr et al., “Unveiling the potential of artificial intelligence in revolutionizing disease diagnosis and prediction: a comprehensive review of machine learning and deep learning approaches,” European Journal of Medical Research, vol. 30, no. 1, May 2025, doi: 10.1186/s40001-025-02680-7.
  6. World Health Organization, “The top 10 causes of death.” Accessed: Aug. 12, 2025. [Online]. Available: https://www.who.int/news-room/fact-sheets/detail/the-top-10-causes-of-death
  7. H. Safi, S. Safi, A. Hafezi-Moghadam, and H. Ahmadieh, “Early detection of diabetic retinopathy,” Survey of Ophthalmology, vol. 63, no. 5, pp. 601–608, Sep. 2018, doi: 10.1016/J.SURVOPHTHAL.2018.04.003.
  8. M. D. Abràmoff et al., “Automated Early Detection of Diabetic Retinopathy,” Ophthalmology, vol. 117, no. 6, pp. 1147–1154, Jun. 2010, doi: 10.1016/J.OPHTHA.2010.03.046.
  9. V. Gulshan et al., “Development and Validation of a Deep Learning Algorithm for Detection of Diabetic Retinopathy in Retinal Fundus Photographs,” JAMA, vol. 316, no. 22, pp. 2402–2410, Dec. 2016, doi: 10.1001/JAMA.2016.17216.
  10. S. Rowe, C. H. MacLean, and P. G. Shekelle, “Preventing Visual Loss from Chronic Eye Disease in Primary Care: Scientific Review,” JAMA, vol. 291, no. 12. 2004. doi: 10.1001/jama.291.12.1487.
  11. G. Lippi and M. Plebani, “Biomarker research and leading causes of death worldwide: A rather feeble relationship,” Clinical Chemistry and Laboratory Medicine, vol. 51, no. 9. pp. 1691–1693, Sep. 2013. doi: 10.1515/cclm-2013-0210.
  12. S. Ioffe and C. Szegedy, “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift,” 32nd International Conference on Machine Learning, ICML 2015, vol. 1, pp. 448–456, Feb. 2015, Accessed: Aug. 14, 2025. [Online]. Available: https://arxiv.org/pdf/1502.03167
  13. Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, “Gradient-based learning applied to document recognition,” Proceedings of the IEEE, vol. 86, no. 11, pp. 2278–2323, 1998, doi: 10.1109/5.726791.
  14. J. Wang and L. Perez, “The Effectiveness of Data Augmentation in Image Classification using Deep Learning.”, Accessed: Aug. 14, 2025. [Online]. Available: https://www.researchgate.net/publication/321794300_The_Effectiveness_of_Data_Augmentation_in_Image_Classification_using_Deep_Learning
  15. H. Pratt, F. Coenen, D. M. Broadbent, S. P. Harding, and Y. Zheng, “Convolutional Neural Networks for Diabetic Retinopathy,” Procedia Computer Science, vol. 90, pp. 200–205, Jan. 2016, doi: 10.1016/J.PROCS.2016.07.014.
  16. L. Prechelt, “Early stopping – But when?,” Lecture Notes in Computer Science (including subseries Lecture Notes in Artificial Intelligence and Lecture Notes in Bioinformatics), vol. 7700 LECTURE NO, 2012, doi: 10.1007/978-3-642-35289-8_5.

Identificación de plantas dominicanas con IA

John Rodríguez y Jorge Tuma – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

La identificación de plantas ha sido durante mucho tiempo un aspecto crucial para comprender y preservar la biodiversidad, sin embargo, sigue siendo un desafío para muchos expertos debido a la complejidad de las especies y sus variantes. En la República Dominicana existen alrededor de 6,000 plantas vasculares de acuerdo con los informes del Ministerio de Medio Ambiente mediante el Viceministerio de Áreas Protegidas y Biodiversidad [1]. Este proyecto se centra en aplicar tecnologías, como la inteligencia artificial (IA) y las aplicaciones móviles, para simplificar y optimizar el proceso de identificación de plantas. Al combinar un modelo de IA entrenado con técnicas avanzadas de deep learning y una aplicación móvil intuitiva, esta iniciativa busca proporcionar a los usuarios una herramienta accesible para identificar especies de plantas que crecen en todo el territorio del país con precisión, especialmente las endémicas con las cuales modelos similares presentan dificultades. Además, la creación de un conjunto de imágenes de la flora dominicana con la colaboración del Jardín Botánico de Santiago [2], promoviendo la divulgación del conocimiento botánico de la flora local al público general. Esta propuesta es desarrollada por los estudiantes de Ingeniería en Ciencias de la Computación (ICC), Jorge Tuma y John Rodríguez.

El proceso de identificación se encuentra en el modelo de deep learning, desarrollado con Python. Este modelo ha sido entrenado en un conjunto de datos de especies de plantas dominicanas, lo que le permite analizar patrones complejos en imágenes, como estructuras de hojas, formas de flores y variaciones de color. El modelo emplea técnicas avanzadas en redes neuronales convolucionales para garantizar una alta precisión, incluso en diversas condiciones ambientales o con una calidad de imagen limitada. Al integrar este modelo de aprendizaje profundo con la aplicación móvil, el proyecto permite a los usuarios identificar con precisión las plantas mediante imágenes.

La Lista Roja de la Flora Vascular en la República Dominicana [3] es un catálogo útil que presenta el estado de conservación, descripción y localización dentro del territorio nacional de las especies de plantas vasculares en el país. Publicado por el Ministerio de Medio Ambiente y Recursos Naturales, respaldada por expertos en botánica, esta lista constituye un recurso vital para comprender las amenazas que enfrenta la flora del país. Forma parte de un catálogo con validez internacional para documentar y proteger la biodiversidad de la flora del país. Este es un recurso adicional que aporta información clave para la realización del proyecto.

Problemática y estado del arte

En los últimos años, ha habido auge de aplicaciones para teléfonos inteligentes que pueden utilizarse para facilitar la identificación de plantas. Existen diversos enfoques, desde aplicaciones que identifican plantas automáticamente mediante el uso de Inteligencia Artificial (IA) hasta el Reconocimiento Automático de Imágenes. La mayoría de estas aplicaciones se utilizan para identificar plantas automáticamente a partir de imágenes estáticas proporcionadas por los usuarios a estas aplicaciones, donde las decisiones y retroalimentaciones tomadas por los usuarios son mínimas. Todas las aplicaciones de esta naturaleza se comportan de manera similar al usar una imagen en su estado natural o al visualizarla en un monitor de computadora y fotografiarla con el teléfono. Además de identificar la especie en cuestión también se identifica su familia y género. El rendimiento de estas aplicaciones suele ser más de un tercio de todas las identificaciones fueron correctas para la especie, aumentando a más del 65 % correctas para al menos la familia de la planta. Estas aplicaciones están disponibles mediante un portal web o disponible como interfaz de programación de aplicaciones API para la incorporación de la identificación de plantas en otro software [4].

Otro enfoque empleado en proyectos de identificación de plantas consultados consiste en utilizar deep learning para entrenar un modelo de identificación adaptado a reconocer ejemplares de plantas en su estado natural. Se presenta un conjunto de datos de imágenes de plantas recopiladas con teléfono móvil en un entorno natural, que contiene 10,000 imágenes de 100 especies de plantas ornamentales del campus de la Universidad Forestal de Pekín. Se diseñó un modelo de deep learning de 26 capas, compuesto por 8 bloques residuales, para la clasificación de plantas a gran escala en entornos naturales. El modelo propuesto alcanza una tasa de reconocimiento del 91.78 % en el conjunto de datos BJFU100 [5].

Las aplicaciones de identificación, especialmente las disponibles como aplicaciones móviles, como iNaturalist [6] y Pl@ntNet [7], han revolucionado la identificación de plantas mediante el uso de modelos de inteligencia artificial. Tanto profesionales como el público general pueden fotografiar una planta en su ambiente natural. Las imágenes deben ser de la mayor calidad posible para facilitar su identificación, incluyendo tomas de la planta completa, hojas, flores y frutos. A diferencia de estas últimas, esta propuesta pretende construir un modelo de IA capaz de identificar con mayor precisión plantas endémicas de la isla, con las cuales estas aplicaciones suelen flaquear.

Objetivos

El desarrollo de este proyecto es crear una herramienta de identificación de plantas accesible y confiable que aprovecha la inteligencia artificial para mejorar la conciencia de la biodiversidad de plantas del país. Esto se dividió en objetivos específicos alineados con la tarea de recolectar y crear un conjunto de datos de alta calidad de plantas dominicanas, desarrollar un modelo de IA con al menos un 80 % de precisión para la identificación de las plantas presentes en el país e integrar el modelo en una aplicación móvil construida en Flutter. Además, el proyecto pretende construir un conjunto de imágenes de la flora del país con la que se entrene el modelo de inteligencia artificial.

Metodología

Se recopiló un conjunto significativo de imágenes utilizando el catálogo dado por el Jardín Botánico de Santiago de distintas especies de plantas, organizándolas en carpetas individuales con el nombre de cada clase, siguiendo una estructura estándar para proyectos de clasificación de imágenes. Para asegurar la calidad de los datos, se implementaron procesos de depuración, eliminando imágenes corruptas, duplicadas o irrelevantes.

El dataset fue dividido manualmente en conjuntos de entrenamiento y validación (70/30). Las imágenes fueron sometidas a técnicas de preprocesamiento para normalizar los datos de entrada y estandarizar la resolución.

Todas las imágenes fueron redimensionadas a 260×260 píxeles, una medida óptima para modelos preentrenados de clasificación de imágenes, y se aplicó una normalización de los valores de píxeles al rango [0, 1]. Este proceso mejora la estabilidad numérica durante el entrenamiento y acelera la convergencia del modelo.

Se utilizaron técnicas de regularización como Dropout para prevenir el sobreajuste, además de estrategias de control como EarlyStopping y ModelCheckpoint para detener el entrenamiento al detectar estancamiento.

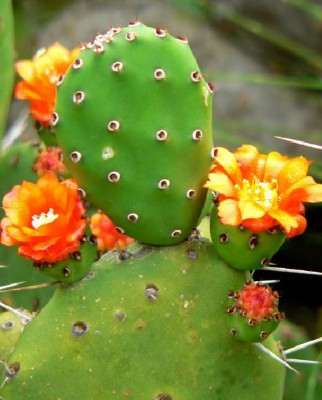
Cactus Opuntia antillana con flores anaranjadas, ejemplar del dataset
Figura 1. Ejemplar del dataset: Opuntia antillana.

Resultados

El modelo entrenado alcanzó una precisión de entrenamiento alrededor de 75 % al 95 %, pero con una precisión de validación más baja, dependiendo de la arquitectura utilizada.

Mediante pruebas externas con imágenes no vistas, se validó la capacidad de ambos modelos para realizar predicciones, pero con plantas muy parecidas, dando a entender que faltan más procesos por afinar, pero demostrando su viabilidad para ser integrados en una aplicación real de reconocimiento de plantas.

El dataset construido para entrenar el modelo posee 350 especies de plantas presentes en el inventario del Jardín Botánico de Santiago. Las imágenes fueron etiquetadas con sus nombres científicos con alrededor de 100 ejemplares por especie.

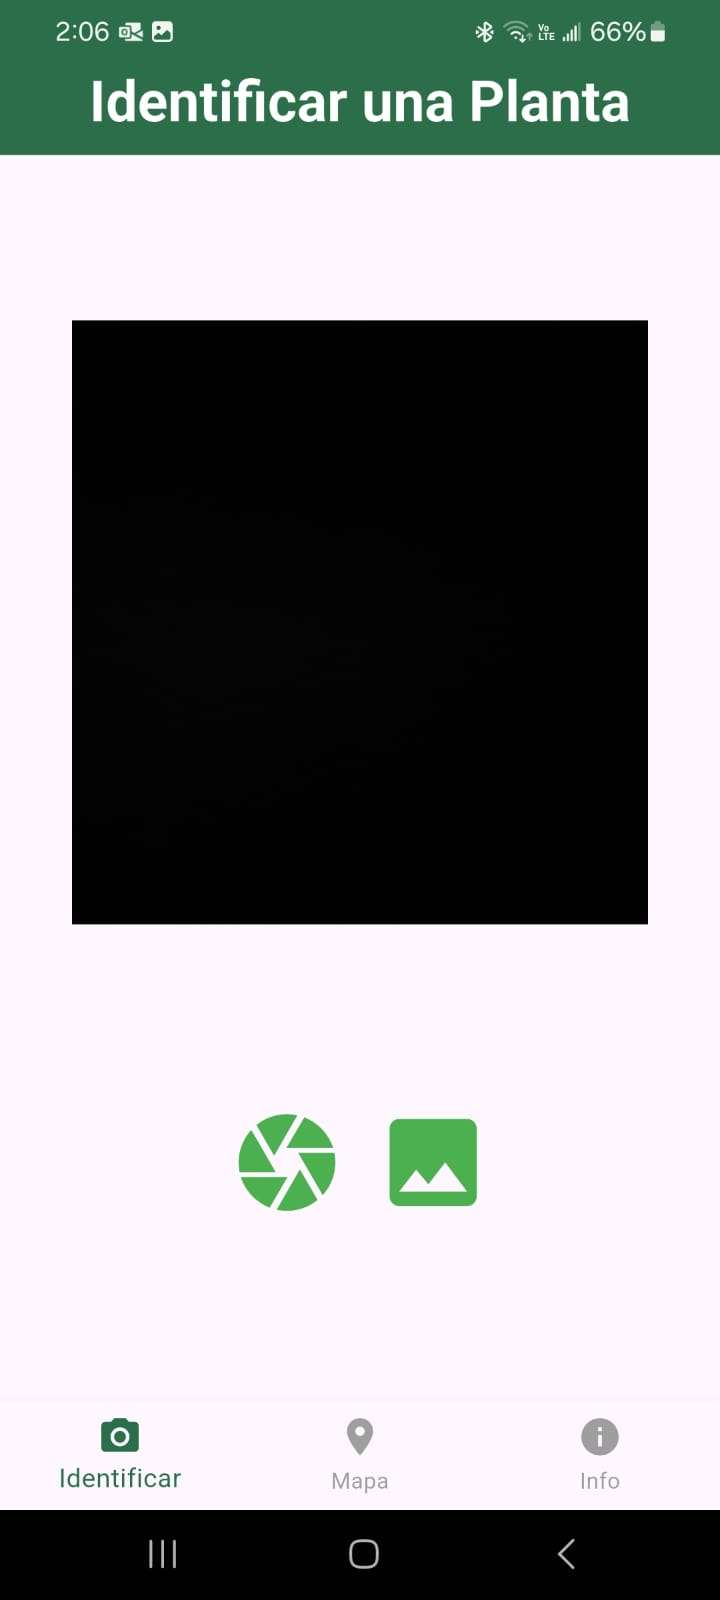
En términos de la aplicación, posee un apartado para identificar una planta, un mapa interactivo del Jardín Botánico de Santiago y una pestaña con información de las plantas identificadas. La misma está desarrollada para dispositivos móviles Android.

Pantalla 'Identificar una Planta' de la aplicación móvil, con botones de cámara y galería y pestañas Identificar, Mapa e Info
Figura 2. Captura de pantalla de la aplicación.

Conclusión

Este proyecto demuestra el potencial de la inteligencia artificial para abordar los desafíos ambientales del mundo real. Al desarrollar con éxito una aplicación de identificación de plantas basada en un modelo de aprendizaje profundo y con el respaldo de una aplicación móvil fácil de usar, hemos creado una herramienta valiosa para promover la concienciación sobre la biodiversidad de plantas presente en el país, especialmente en el contexto de la rica, pero vulnerable flora de la República Dominicana. Entre los aprendizajes clave se incluyen la importancia de un conjunto de datos de alta calidad y la eficacia del modelo entrenado.

A futuro esta propuesta puede ser expandida para integrar nuevas tecnologías o funcionalidades adicionales. Otra posibilidad sería agregar otros ejemplares al conjunto de imágenes de plantas presentes en el país para mejorar el alcance y las capacidades de identificación del modelo, con especial enfoque en plantas endémicas de la isla. Esto con el fin de promover los esfuerzos de conservación y la divulgación del conocimiento botánico en el país.

Referencias

  1. Viceministerio de Áreas Protegidas y Biodiversidad. (2021). La Biodiversidad en la República Dominicana. https://bvearmb.do/bitstream/handle/123456789/269/BiodiversidadDominicana2021.pdf
  2. Jardín Botánico de Santiago, “Historia y Marco Legal,” Jardín Botánico Prof. Eugenio de Js. Marcano, https://botanicodesantiago.com/historia/.
  3. Ministerio de Medio Ambiente y Recursos Naturales. (2016). Lista Roja: De la Flora Vascular en República Dominicana. Archivo General de la Nación. https://colecciones.agn.gob.do/opac/ficha.php?informatico=00114295PI&codopac=OP003&idpag=1626095770&presenta=digitaly2p#viajeinicial
  4. Jones, H. (2020). Artificial Intelligence for plant identification on smartphones. https://bsbi.org/wp-content/uploads/dlm_uploads/BSBI-News-144-pp34-40-plant-id-apps-final.pdf
  5. Sun, Yu & Liu, Yuan & Wang, Guan & Zhang, Haiyan. (2017). Deep Learning for Plant Identification in Natural Environment. Computational Intelligence and Neuroscience. https://www.researchgate.net/publication/317127150_Deep_Learning_for_Plant_Identification_in_Natural_Environment
  6. iNaturalist, https://www.inaturalist.org/
  7. Identificar, explorar y compartir tus observaciones sobre plantas silvestres, Pl@ntNet, https://identify.plantnet.org/es

Sistema para la detección enfermedades en cultivos de Arroz

Ilka Hernández y Patricia DiMassimo
Estudiantes Escuela de Ingeniería en Eléctrica, Campus Santiago
PUCMM

El arroz en República Dominicana

El cultivo del arroz es una actividad agrícola fundamental en muchos países del mundo, especialmente en República Dominicana, donde se consume en grandes cantidades y se cultiva extensamente. Sin embargo, la presencia de enfermedades y condiciones de estrés puede afectar significativamente la producción y calidad de los cultivos de arroz, lo que a su vez afecta la economía y la seguridad alimentaria las regiones donde se distribuye este producto. Por lo que, la detección temprana de estas enfermedades y condiciones de estrés es un desafío para los agricultores, ya que a menudo son difíciles de detectar a simple vista.

Para abordar este problema, se propone la implementación de un sistema de procesamiento de mapas multiespectrales e imágenes para la detección temprana de enfermedades y condiciones de estrés en cultivos de arroz.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la detección temprana de enfermedades en cultivos de arroz. El sistema desarrollado combina técnicas de visión computacional y aprendizaje de máquinas. Fue desarrollado un esquema de fusión de datos para la creación de modelos de naturaleza heterogénea.

La Digitalización en la Agricultura

La creciente intersección entre la tecnología y la agricultura ha revolucionado la manera en que se aborda los desafíos agrícolas en la actualidad. Uno de los avances más notables ha sido la aplicación de la inteligencia artificial (IA) en este campo. La capacidad de procesar grandes volúmenes de datos y extraer patrones significativos ha permitido optimizar la producción y la toma de decisiones agrícolas. La integración de sensores avanzados y microcontroladores como el ESP32, ha facilitado la recolección y el análisis de información crítica para el diagnóstico y prevención de enfermedades en cultivos, como el arroz. Esta revisión se enfoca en la evaluación de cómo la tecnología, especialmente la inteligencia artificial, ha impactado en la agricultura, con énfasis en la aplicación de sensores multiespectrales y microcontroladores en el reconocimiento temprano de enfermedades en hojas de arroz.

La combinación de tecnologías de medición multiespectral e inteligencia artificial ha dado lugar a soluciones novedosas en la detección de adulteración en productos agrícolas. Un ejemplo destacado es el desarrollo de un espectrómetro portátil que utiliza este sensor para evaluar la pureza del azúcar de coco y detectar la adulteración con azúcar de caña. La implementación de redes neuronales permitió una clasificación precisa de muestras adulteradas y puras, con una tasa de éxito del 100% en casos de azúcar de coco y un promedio superior al 90% para estimar la intensidad de la adulteración.

Diversos proyectos relacionados han abordado problemáticas similares en la detección y diagnóstico de enfermedades en cultivos, lo que amplía la comprensión de las aplicaciones y desafíos de la tecnología. Por ejemplo, un estudio se centró en la detección de malezas y la estimación de la salud de las vides utilizando el NDVI en combinación con el sensor multiespectral. Aunque enfrentaron desafíos de calibración y sesgos, estos proyectos reflejan la creciente importancia de las herramientas tecnológicas en la agricultura de precisión y subrayan la necesidad de investigación continua para superar obstáculos técnicos.

Solución Propuesta

La implementación del presente proyecto tiene como objetivo mejorar la producción de arroz al reducir los efectos negativos de las enfermedades y condiciones de estrés en los cultivos. En cuanto a la composición, las imágenes multiespectrales se obtendrían mediante la utilización del sensor multiespectral seleccionado que puede capturar la luz en diferentes longitudes de onda. Las mediciones multiespectrales capturadas por este sensor proporcionaron información detallada sobre el estado de salud de los cultivos de arroz.

Además, se utilizaron técnicas de procesamiento de imágenes para mejorar la calidad y precisión de los datos obtenidos de las mediciones multiespectrales. Estas técnicas incluyen la corrección de distorsiones en las imágenes, la eliminación de ruido y la normalización de los datos para garantizar una representación precisa de la salud de los cultivos. Este sistema combina la ciencia de la agricultura con la tecnología de la información y el aprendizaje automático, para proporcionar una solución integral y efectiva para la detección temprana de enfermedades y condiciones de estrés en los cultivos de arroz.

Para la creación del sistema físico, se utilizó la herramienta de CAD SolidWorks para diseñar dos cajas negras. Ambas cajas tienen las mismas dimensiones, pero con propósitos diferentes. La caja mostrada en la siguiente está diseñada para trabajar con el sensor multiespectral seleccionado y dos arreglos de LEDs. Su función es proporcionar un espectro de emisión que abarca un rango desde los 400 nm (ultravioleta) hasta los 750 nm (infrarrojo cercano). El objetivo de este diseño es captar el espectro reflejado por las hojas de arroz y utilizar esta información para determinar ciertas condiciones relacionadas con los niveles de hidratación de las hojas.

Se empleó un microcontrolador ESP32 para gestionar la activación y desactivación de los LEDs que emiten diversas frecuencias espectrales y que son dirigidos a las hojas de arroz. El ESP32 es una opción ligera pero altamente confiable para esta tarea. Con este microcontrolador, se estableció una comunicación con el sensor multiespectral utilizando el protocolo I2C. En la siguiente figura se muestra una imagen con la configuración de entrada y salida del microcontrolador elegido.

En la carcasa diseñada fueron acomodadas tanto la cámara como el sensor multiespectral seleccionado, permitiendo las capturas de hojas individuales de arroz para su caracterización. Se seleccionó el color negro para evitar el efecto de la reflexión y se colocaron LEDs específicos para las distintas frecuencias del espectro electromagnético que se deseaban caracterizar. En la siguiente imagen podemos ver un ejemplo de una imagen capturada.

Se analizó cada hoja en términos de valores de reflectancia y absorción en cada una de las 18 bandas del sensor (410nm, 435nm, 460nm, 485nm, 510nm, 535nm, 560nm, 585nm, 610nm, 645nm, 680nm, 705nm, 730nm, 760nm, 810nm, 860nm, 900nm, 940nm). Para lograrlo fue colocado un arreglo de 6 LEDs capaces de proporcionar las longitudes de onda mostradas con dirección a la hoja. En la siguiente figura se observa la respuesta capturada a partir del sensor multiespectral.

Metodología para el entrenamiento de los algoritmos de aprendizaje de máquina

A partir de estas imágenes se procedió a entrenar un modelo de clasificación basado en las redes neuronales convolucionales. AlexNet es un modelo de red neuronal convolucional considerado uno de los modelos más influyentes en el campo del aprendizaje profundo y fue uno de los primeros en demostrar un rendimiento notable en la tarea de clasificación de imágenes a gran escala. Las técnicas de aprendizaje por transferencia han permitido aprovechar las arquitecturas de estas redes neuronales convolucionales y adaptarla a una diversidad de aplicaciones. En nuestro caso, a la clasificación de enfermedades en hojas de arroz. Debajo se muestra la estructura de la red AlexNet entrenada usando el ambiente Matlab.

Resultados Obtenidos

La estrategia de procesamiento de imágenes en el dominio espacial para identificar manchas en hojas de arroz ha arrojado resultados sumamente prometedores. La elección de la técnica de segmentación basada en el color, combinada con operaciones de preprocesamiento como la conversión a escala de grises y la aplicación de operaciones de apertura, ha demostrado su capacidad para resaltar de manera excepcional las áreas de interés, es decir, las manchas en las hojas. La aplicación consecutiva del método de Otsu y su transformación inversa ha afinado aún más la precisión de la segmentación, contribuyendo a una separación nítida entre las manchas y el fondo de las hojas. Este enfoque en el dominio espacial ha culminado en una detección de enfermedades en las hojas de arroz más confiable y definida, al mismo tiempo que ha minimizado cualquier distorsión o ruido no deseado en las imágenes. La inherente flexibilidad de esta metodología ha permitido ajustar los parámetros de segmentación en función de las variaciones en las características de las manchas y los requisitos específicos del proyecto. En la figura siguiente se muestran los resultados del procesamiento utilizado.

A continuación se muestran los resultados del mejor modelo obtenido. Es importante recalcar que se utilizó una estrategia de entrenamiento cruzado, para evitar introducir sesgo al modelo planteado. La precisión promedio para todas las clases fue del 91.44%.

En el caso del sensor multiespectral, fue elegido un modelo basado en árboles aleatorios, donde se observa una capacidad importante del modelo de distinguir de las tres clases asignadas para la clasificación multiespectral. En la siguiente figura se muestra la matriz de confusión del modelo.

El desempeño obtenido por la estación de inspección mostró su viabilidad para cumplir los objetivos planteados para el presente proyecto, ofreciendo la posibilidad de implementar estrategias similares en distintos tipos de cultivos, y adicionalmente, la importancia que puede presentar la aplicación de técnicas de aprendizaje de máquina en la implementación de la agricultura de precisión.

Conclusiones

La elección de modelos y estrategias de entrenamiento es crucial para la clasificación de imágenes RGB y datos multiespectrales para aplicaciones de agricultura de precisión. La adaptabilidad del sistema desarrollado y su capacidad para detectar patrones anómalos pueden ser una herramienta de importancia en optimizar los procesos de gestión de cultivos.

Referencias

 P. Smith, «How to measure, report and verify soil carbon change to realise the potential of soil carbon sequestration for atmospheric greenhouse gas removal,» INSTITUTE FOR CARBON REMOVAL LAW AND POLICY, USA, 2019.


 A. S. Susanto B. Sulistyo, «Design and performance test of portable spectrometer using AS7265x multispectral sensor for detection of adulterated cane sugar in granulated coconut sugar,» AIP Conference Proceedings, USA, 2023.


 M. J.-L. F. R. J.-L. Andrés Fernando Jiménez-López, «Multispectral analysis of vegetation for remote sensing applications,» Iteckne, Colombia, 2015.