Carolina Bencosme Gómez y Jean Carlos Pérez Ortega – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)
Las universidades no carecen de datos. Carecen de un lugar común, gobernado y reutilizable donde esos datos dejen de ser un extracto de fin de cuatrimestre y pasen a ser un insumo de decisión. Matrícula, rendimiento, ayuda económica y trayectoria ocurren todos los días en el sistema académico. Lo que suele faltar es una capa analítica que no compita con el sistema transaccional ni dependa de un único proveedor comercial para almacenar, curar y consultar. Este artículo resume un proyecto de grado de Ingeniería en Ciencias de la Computación desarrollado en la Pontificia Universidad Católica Madre y Maestra. Carolina Bencosme Gómez y Jean Carlos Pérez Ortega diseñaron e implementaron un prototipo de arquitectura de datos de código abierto, tipo lakehouse, con el fin de mostrar cómo una institución de educación superior puede integrar extractos académicos y alimentar, desde el mismo suelo, proyección de matrícula y predicción de retención.
La motivación no fue adornar el expediente con un dashboard. Fue una brecha concreta: planificación y acompañamiento piden series y segmentos de riesgo, y el ERP responde con pantallas de trámite. La literatura de analítica institucional describe ese desajuste desde hace años. El valor no aparece por acumular registros, sino por alinear dato, modelo y decisión [1], [2], [5]. En América Latina la adopción de inteligencia artificial en educación ha crecido, pero con evidencia desigual y con poca infraestructura de datos que sostenga el modelo después del artículo [3], [6]. La transformación digital de una universidad no es comprar una licencia de reportes. Es cambiar dónde vive la verdad analítica y quién puede consultarla sin copiar tablas a un correo [4], [16].
El recorte fue deliberado. No se pretendió el almacén de toda la institución ni un conector permanente al sistema académico de producción. Se pretendió demostrar que un lago con propiedades transaccionales, un modelo dimensional y dos preguntas de negocio bastan para un ciclo completo: aterrizar, curar, modelar y consumir. Eso importa para otras instituciones de educación superior porque el beneficio no está en una nube hipotética. Está en poder empezar con extractos tabulares, hardware modesto y software abierto, sin hipotecar el dato a un formato propietario [8], [9], [14]. Si el prototipo funciona en un computador portátil con contenedores reproducibles, el argumento deja de ser de catálogo y pasa a ser de ingeniería. Por indicación de la dirección del proyecto, las series, volúmenes y capturas de dashboard de este artículo son un banco sintético de demostración, generado en local. Los extractos canónicos del prototipo se depositaron en custodia de la asesora y no se reproducen aquí.
El lector de este blog no necesita ser ingeniero de plataformas. Sí necesita una tesis clara. Una IES puede implementar una arquitectura abierta que separe almacenamiento de cómputo, que publique marts legibles por inteligencia de negocios y que deje al científico de datos trabajar sobre vistas ya unidas. El precio de esa promesa es honesto: el prototipo no opera veinticuatro horas, no sustituye al ERP y no afirma política de cupos ni de expulsión. Afirma un método exportable, con métricas de holdout del experimento y con límites que se dicen en voz alta. Esas métricas no son los puntos dibujados en las figuras de demostración.
El ERP resuelve la operación. No resuelve la pregunta analítica
En la PUCMM, como en otras universidades dominicanas, los portales de matrícula y de aula cumplen su trabajo: inscribir, publicar notas, entregar evidencias. Eso no equivale a disponer de un repositorio analítico con grano explícito, calidad medible y linaje. El analista pide un recuento por plan y campus. El sistema responde con una transacción de inscripción. Entre ambas capas alguien exporta, une y olvida de qué período era el archivo. Esa práctica no es negligencia personal. Es el síntoma de una arquitectura que nunca contempló el consumo analítico como un producto [1], [7], [13].
El patrón se repite fuera del país. Universidades que construyen plataformas de datos educativos reportan las mismas fricciones: fuentes heterogéneas, calidad irregular y ausencia de un contrato estable entre quien produce el dato y quien lo modela [8]. Las revisiones sobre inteligencia artificial en educación superior insisten en que los modelos aparecen más rápido que las condiciones para usarlos con justicia y con contexto pedagógico [6]. Un clasificador de abandono sin dashboard que llegue a orientación es un ejercicio de laboratorio. Un dashboard sin capa curada es un dibujo sobre un CSV semanal. El problema no es la falta de algoritmos. Es la falta de una capa intermedia gobernada [11], [12].
El almacén de datos clásico y el lago de archivos resuelven mitades. El primero ofrece esquema y SQL, pero se vuelve rígido cuando llega un dominio nuevo. El segundo admite cualquier archivo, pero entrega caos en cuanto dos cuadernos leen versiones distintas. El lakehouse surge para no escoger entre esos dos males. Unifica el almacenamiento de objetos con tablas que admiten transacciones, evolución de esquema y consulta SQL [9], [14], [17]. No es magia. Es un pacto de formato abierto: el motor de consultas, el cuaderno y el dashboard hablan de tablas, no de carpetas con fecha en el nombre.
Hay un segundo vacío local. Las estrategias nacionales de datos e inteligencia artificial hablan de infraestructuras compartidas y de incorporar analítica en educación. El documento de política no construye el catálogo ni el mart. Si una universidad espera el hub nacional para empezar, seguirá pegando hojas en cada ciclo lectivo. Si empieza con extractos propios y software abierto, gana soberanía sobre el dato y una base sobre la cual, más adelante, sí podrá conectar el sistema transaccional con ventanas controladas [4], [16]. Ese orden importa: primero el contrato interno, después el conector.
Las suites comerciales de inteligencia de negocios tampoco cierran solas la brecha. Un dashboard pegado al ERP hereda la carga operativa y la semántica del trámite. Un dashboard pegado a un archivo plano hereda la caducidad del archivo. El beneficio de una arquitectura abierta no es ahorrar la licencia del visor, que la institución puede seguir usando. El beneficio es que el visor deje de ser el lugar donde se limpia el dato. Limpieza, grano y calidad viven abajo. El dashboard solo consume. Esa inversión de responsabilidades es la que la literatura de inteligencia de negocios describió cuando distinguió almacenamiento de impacto [5]. Aquí se traduce a un campus que no puede, o no debe, saturar Oracle con consultas de exploración.
La comparación internacional no debe leerse como receta. Las plataformas documentadas en acceso abierto suelen asumir nube institucional, equipos de datos y convenios estables con el sistema académico [8]. Una IES dominicana de tamaño medio suele tener otra realidad: hardware personal de los tesistas, restricciones de privacidad, y un acceso a producción que no es un servicio, sino una ventana. Experiencias de campus que montan una arquitectura de datos abierta para servicios institucionales muestran que el patrón es viable, siempre que el dato no se confunda con el trámite cotidiano [18]. El estado del arte dice qué arquitectura es razonable. No dice cómo bajarla a un prototipo que quepa en laptops y que, aun así, entregue métricas reproducibles. Ese hueco es el que este proyecto intentó ocupar, sin pretender que el resultado sea ya política institucional.
En retención, además, el debate ya no es si se puede predecir el abandono. Es si la predicción llega a quien interviene y si el dashboard se entiende [11]. Revisiones regionales recuerdan que la deserción es un fenómeno con causas académicas, económicas y de trayectoria, y que un único indicador suele mentir [12]. Una arquitectura abierta no “resuelve” la deserción. Permite publicar un scoring con linaje, un segmento de riesgo y una vista individual sin reconstruir el análisis en una hoja privada. El beneficio institucional es de gobierno del dato, no de milagro pedagógico.
Qué se dio por cumplido
El desarrollo de este proyecto implementó un prototipo de arquitectura analítica tipo lakehouse, de componentes abiertos, adaptada a las restricciones de una institución de educación superior dominicana, con el propósito de integrar extractos académicos y habilitar decisiones basadas en datos. El objetivo general se desglosó en tres resultados verificables. Primero, un análisis de brechas entre el enfoque transaccional local y las arquitecturas lakehouse y de analítica institucional descritas en la literatura. Segundo, el diseño e implementación de un flujo por capas de aterrizaje, curación dimensional y mart de consumo, desplegable de forma reproducible en contenedores, con consulta SQL unificada y entornos de exploración para el científico de datos. Tercero, dos casos de uso académicos, cerrados hasta dashboard, que proyectan matrícula por carrera y campus con modelos de series temporales y priorizan riesgo de retención con un clasificador evaluado en un holdout temporal. El alcance es una prueba de concepto operable, no un sistema institucional continuo ni un conector de producción al ERP. La conexión permanente al sistema académico, la migración a servidores de la universidad y la operación continua del orquestador quedan explícitamente como trabajo futuro.
Un flujo, dos preguntas de negocio
La metodología partió de un recorte de producto, no de un catálogo de herramientas. Si el lakehouse no respondía a una decisión existente, se convertía en infraestructura sin dueño. Se eligieron dos preguntas que ya viven en la universidad. Cuántos alumnos esperar por plan y campus en los siguientes ciclos. A quién priorizar en acompañamiento si el riesgo de no retener se estima con historial académico. La primera sirve para la planificación. La segunda, la orientación. El analista interviene en ambas. El dashboard es el contrato de consumo, no el lugar donde se inventa el modelo [5], [11].
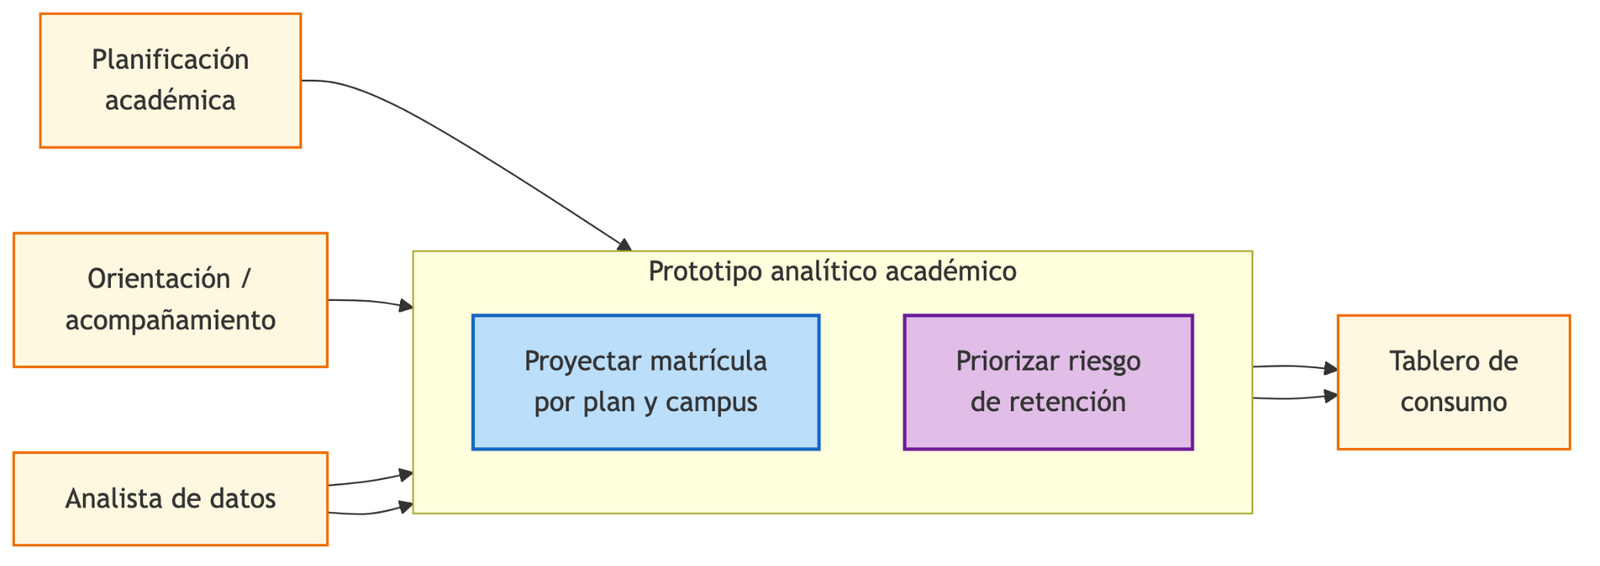
Esa división no es cosmética. Matrícula y retención no comparten el mismo grano. La primera es una serie por plan, campus y período: una celda, una cuenta de alumnos. La segunda, en el modelo publicado, es estudiante por carrera y año de observación, con señales de carga, índice y ayuda. Forzar ambos dominios en una sola tabla ancha habría sido más rápido de dibujar y más caro de mantener. El modelado dimensional clásico sigue siendo el antídoto contra ese atajo [10]. Dos espacios de trabajo sobre la misma plataforma, con catálogos distintos, fue el trade-off: más orquestación, menos contaminación de semántica.
Capas, no un único servidor con todos los roles
El diseño lógico separa fuente, flujo gobernado, exploración y consumo. La fuente canónica sigue siendo el sistema académico institucional. En el prototipo, sin embargo, no se consulta en vivo de forma permanente. Las consultas pesadas se materializaron como archivos planos de respaldo. Las conexiones seguras de red se usaron solo para diagnóstico. El túnel no se sostuvo como camino diario, y eso se aceptó como hallazgo de implementación, no como nota al pie. Una IES que copie el método debe planear el extracto offline como camino realista mientras no exista un conector de solo lectura con ventana controlada [8], [14].
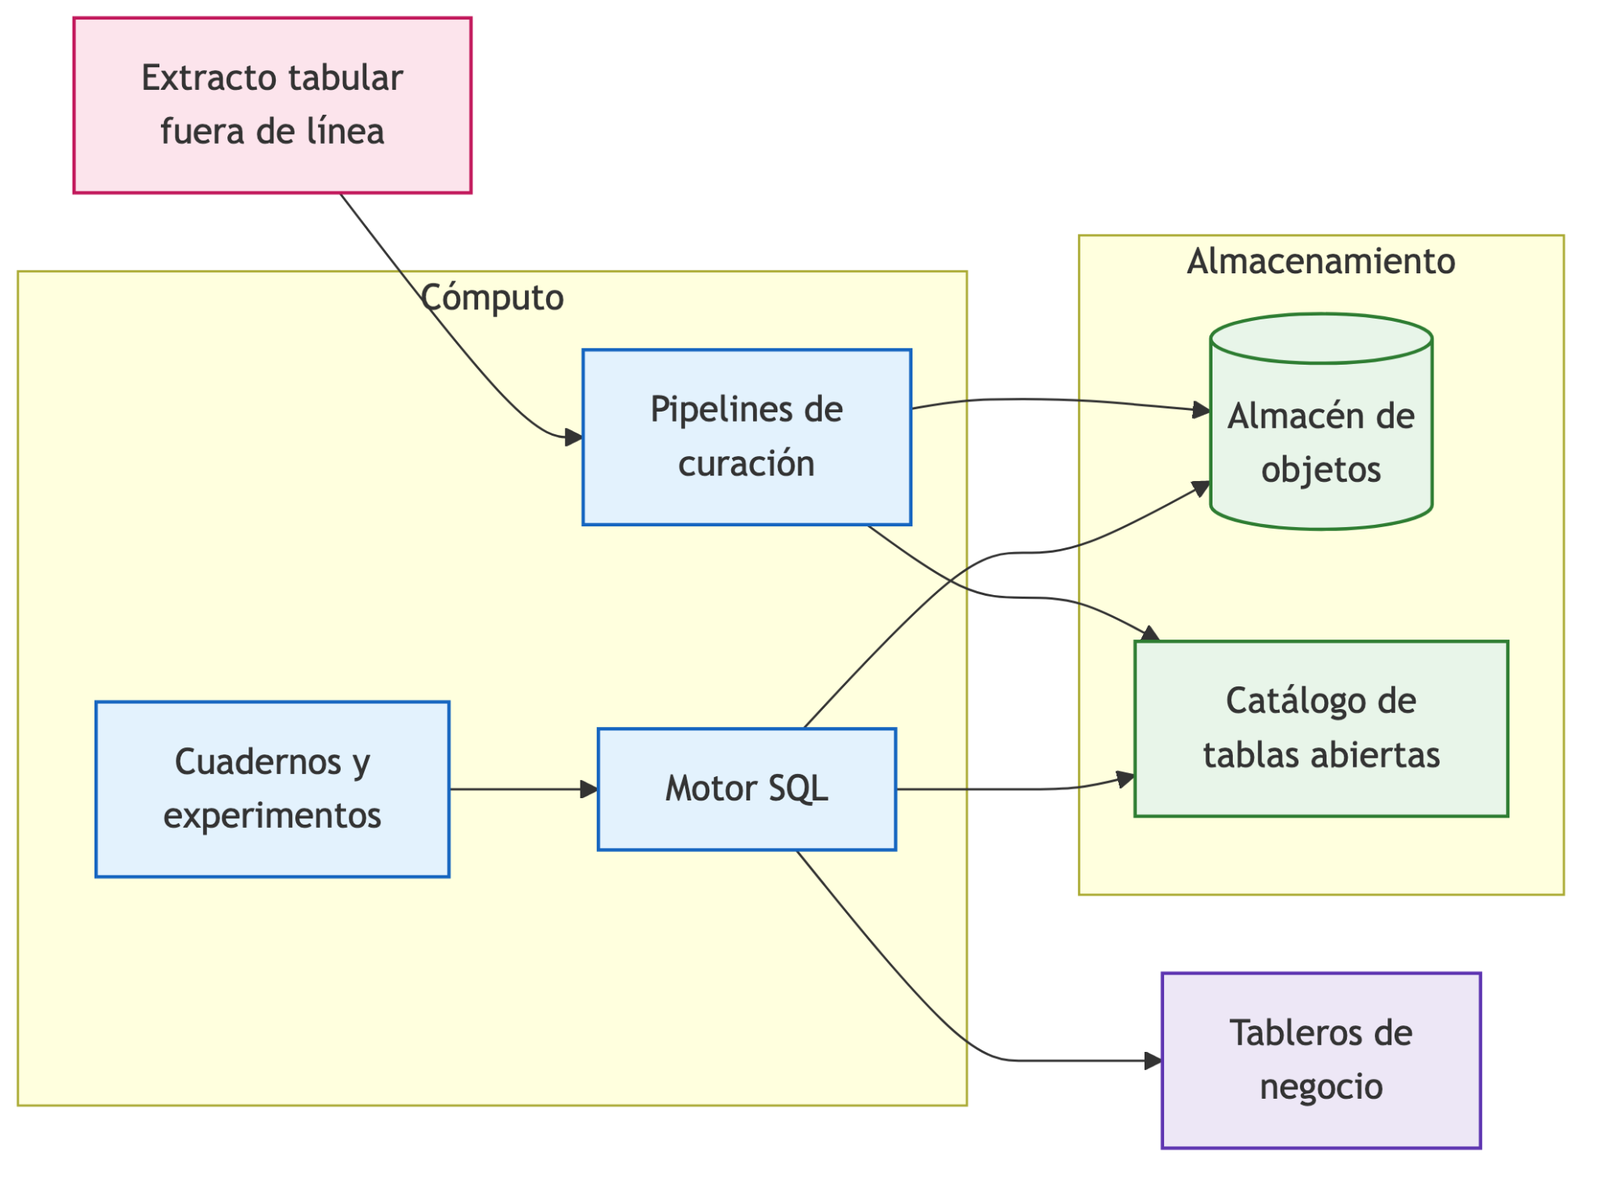
Sobre el almacén de objetos se montaron tablas de formato abierto y catálogo, de modo que el motor SQL y los cuadernos hablen el mismo lenguaje de tablas [9], [14]. El flujo productivo recorre aterrizaje en bruto, curación dimensional y publicación del mart. En paralelo, el analista explora la capa curada en un entorno acotado y solo promueve a consumo lo validado. Esa es la decisión que más beneficio institucional produce y la que más disciplina exige. Si el científico escribe el mart desde el cuaderno, el dashboard vuelve a ser un silo. Si el dashboard escribe reglas de negocio que el modelo no versiona, el scoring deja de ser auditable.
Distribuir componentes evita saturar un solo servidor con todos los roles. El almacenamiento masivo no es el motor de consultas. El motor no es el cuaderno. El cuaderno no es el dashboard. En hardware de laptop esa separación también es una defensa contra la memoria agotada. El prototipo no demostró escalamiento a miles de usuarios concurrentes. Demostró que el patrón no obliga a copiar el lago dentro de la herramienta de reportes. Para una IES, eso es el beneficio práctico de lo abierto: se puede cambiar el visor o el motor sin rehacer el contrato de tablas [9], [17].
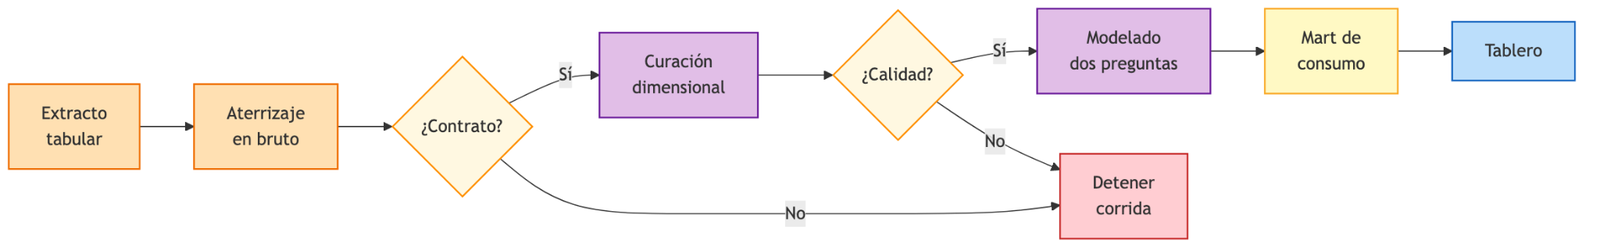
La orquestación se pensó como dependencias estrictas, no como un reloj que afirma disponibilidad continua. Una corrida tiene identificador, recorre aterrizaje, calidad, transformación y publicación, y deja un resumen auditable. Si falla la ingesta, no avanza la curación. Si falla la calidad, no se publica el mart. El formato de tablas abiertas fue el que otorgó propiedades transaccionales al lago: no se trata de “archivos más ordenados”, sino de poder volver a un estado coherente [14]. Afirmar operación continua sería adelantar un resultado que no se midió. El beneficio medido es reproducibilidad de la evidencia, no un acuerdo de nivel de servicio.
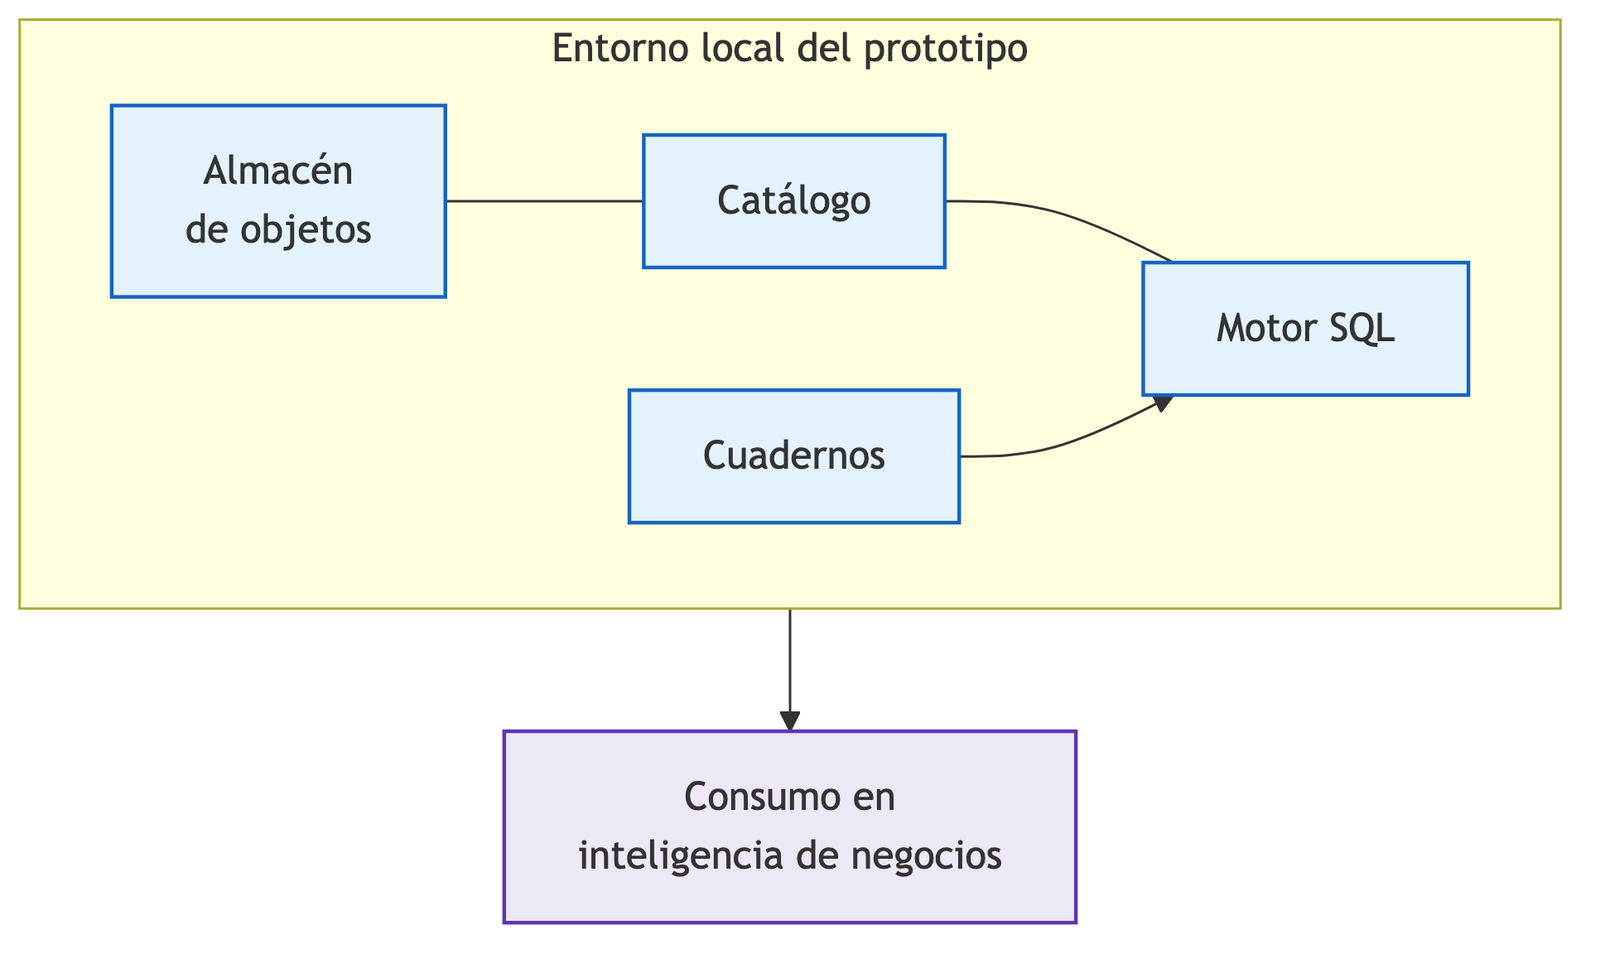
El empaquetado en contenedores fue, además, una decisión de metodología de equipo. El hardware del proyecto no es un clúster. Son computadores portátiles con arquitecturas distintas. Sin imágenes compartidas, cada integrante instala a mano el almacén, el catálogo, el motor SQL y el seguimiento de experimentos, con versiones que no coinciden y resultados que un tercero no puede auditar. Lo abierto aquí no es un eslogan. Es la única forma razonable de que dos estudiantes y una asesora vean el mismo prototipo. Una IES que adopte el patrón puede, más adelante, mover esos mismos contratos a servidores institucionales. El prototipo no hizo esa migración. La deja como futuro explícito [8].
Cómo se modeló sin reescribir la limpieza en cada cuaderno
Para matrícula se construyó una vista compacta: el hecho ya unido a nombres de dimensión, lista para series temporales. El científico no arma la unión de planes y periodos en el cuaderno. Lee la compacta y entrena. Eso parece menor hasta que se cuenta cuántas veces un proyecto estudiantil vuelve a limpiar el mismo extracto [2], [10]. El candidato usado en el piloto reconoce estacionalidad de tres periodos académicos por año, coherente con el calendario de la institución y con la práctica estándar de series temporales [15].
Para retención se evitó entrenar sobre el detalle crudo de cada inscripción. El panel canónico agrega al año de observación señales de asignaturas, créditos, índice, ayuda económica, campus, sexo y facultad. La transición normal entre programas equivalentes de ciencias de la salud no entra al scoring de riesgo: confundirla con abandono habría inflado el drama y mentido al dashboard. El holdout fue temporal, no aleatorio. En datos académicos, barajar filas mezcla el futuro con el pasado y produce una precisión que no se puede gastar [6], [12]. El trade-off es una prueba más honesta y, a veces, un número menos lisonjero.
El consumo se diseñó para no crear un tercer silo. El mart se consulta con el motor SQL del lakehouse. Los dashboards leen ese mart. Los experimentos de series temporales y de clasificación se registran con identificadores de corrida. Las compuertas de calidad se colocaron donde duele: contrato de columnas al aterrizar, consistencia semántica al curar, y no publicar si el mart no cumple el umbral acordado. No se usaron identificadores más allá de los necesarios para el grano. No se trajo correo ni texto libre de plataformas de aula. No se prometió personalización clínica. El beneficio de lo abierto no incluye, en este prototipo, un producto de bienestar estudiantil con datos de salud [3], [11].
Lo que el prototipo llegó a medir
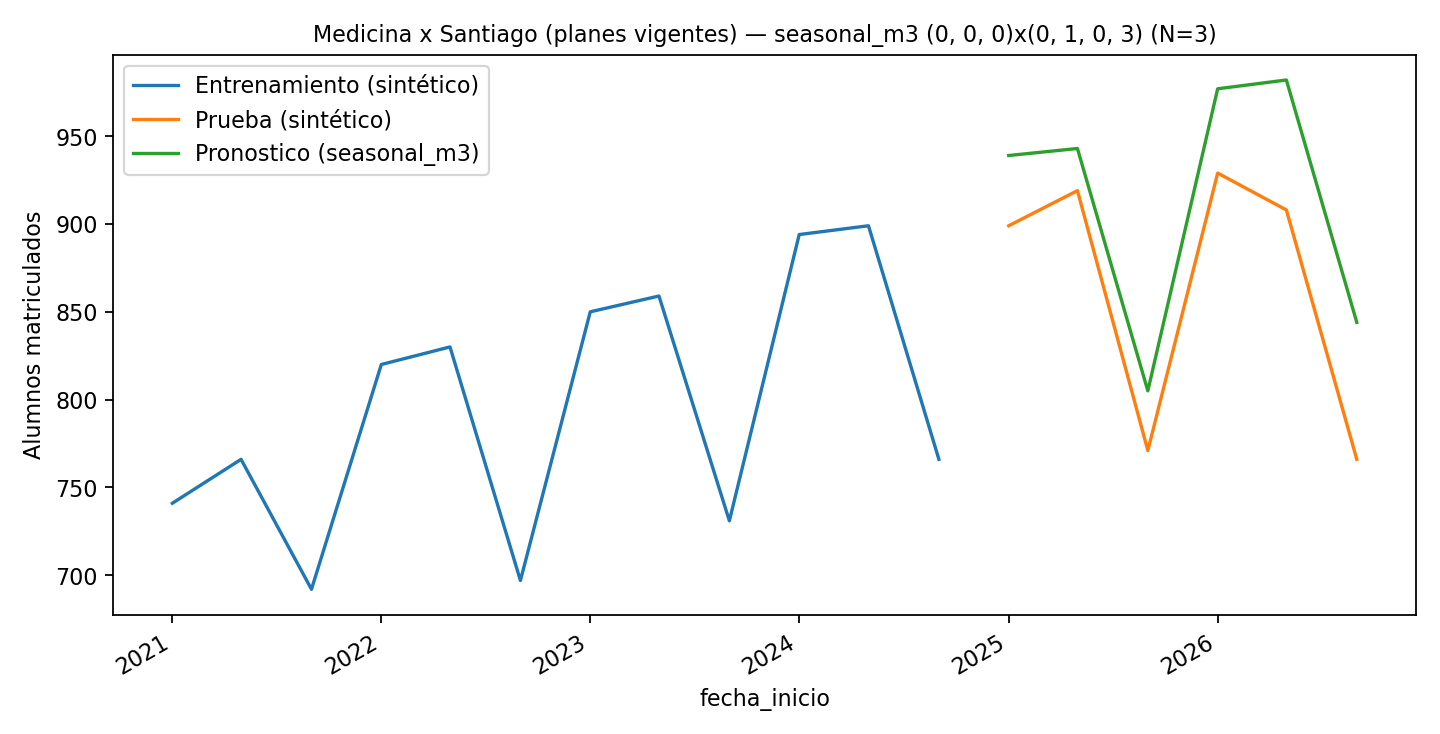
Las métricas de holdout que siguen describen el experimento de evaluación del prototipo. Las figuras de este apartado, en cambio, muestran un banco sintético de demostración: mismas formas de análisis, volúmenes distintos, leyendas etiquetadas como sintéticas. No se afirma que el error de matrícula se mantenga en producción ni que el clasificador sustituya al criterio de orientación [1], [5]. El prototipo corre en local. Eso limita la generalización y, a la vez, obliga a un contrato repetible: si se refresca el extracto, se puede volver a publicar el mart y comparar.
En Medicina, campus Santiago, el candidato estacional de tres periodos replicó el ritmo de inscripción en la prueba. El error absoluto medio fue de 32 alumnos y el error porcentual absoluto medio, de 3,0 por ciento. El historial de entrenamiento, el holdout y la proyección se leen en la misma gráfica. El ciclo académico se ve. Eso es lo que la planificación puede usar como insumo, no como oráculo [15].
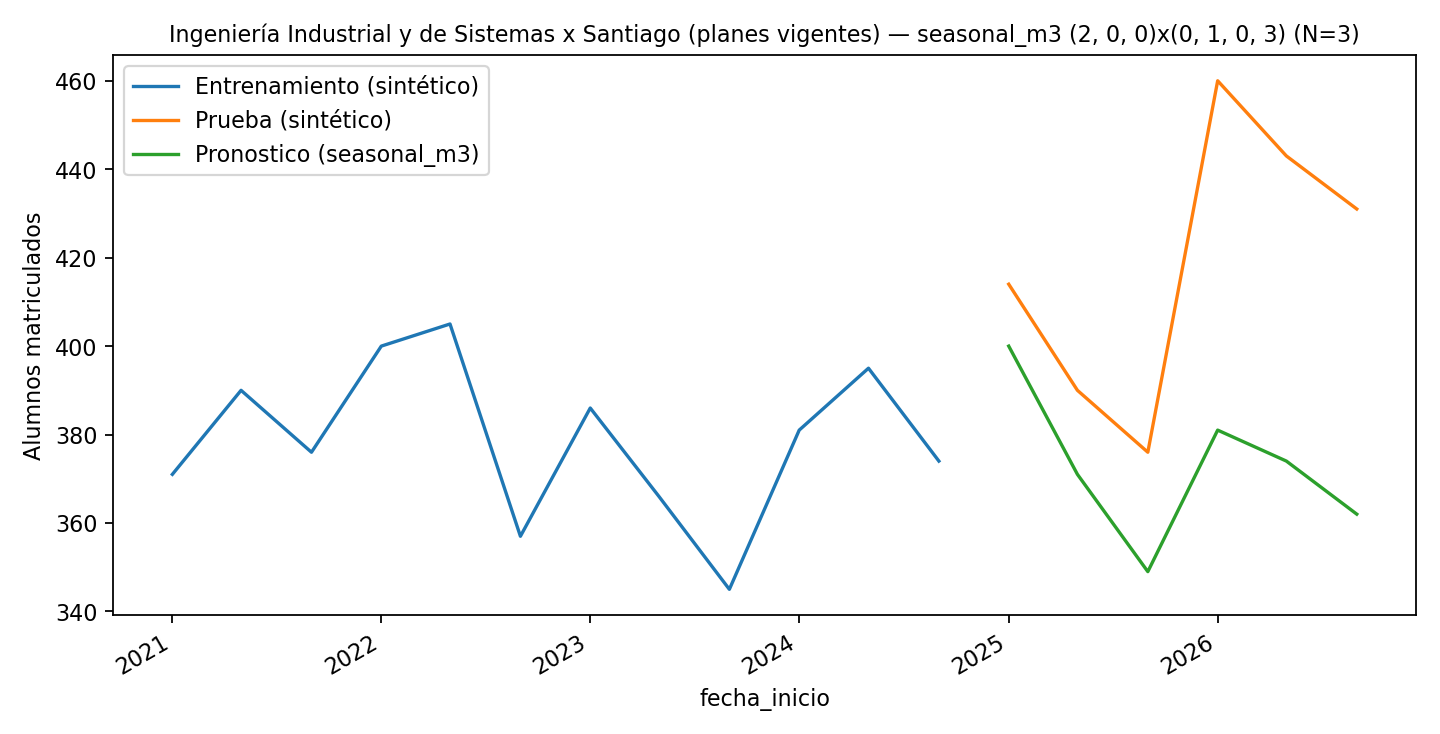
Ingeniería Industrial y de Sistemas, en el mismo campus, usó el mismo tipo de modelo estacional. El pronóstico sigue el diente de sierra académico, pero en el tramo final de la prueba la matrícula de holdout se separó al alza. El error porcentual absoluto medio subió a 8,5 por ciento y el error absoluto medio, a 21,1 alumnos. El modelo no “falló el calendario”. Falló el nivel en un tramo. Esa distinción importa si alguien pretende dimensionar la oferta con una serie frágil. En Santo Domingo, Medicina marcó 1,7 por ciento de error porcentual absoluto medio e Ingeniería Industrial y de Sistemas, 14,8 por ciento con candidato no estacional.
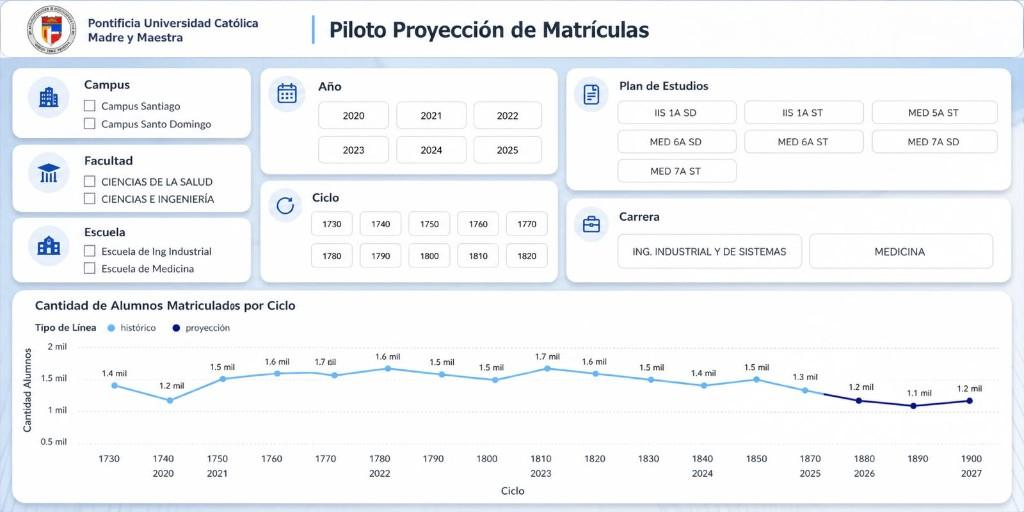
El mayor logro técnico de este caso no es el número más bajo. Es que ambos algoritmos leyeron la compacta de la capa curada. El científico no reescribió la limpieza. El dashboard de proyección, conectado al mart mediante el motor SQL, concentra histórico y proyección de las dos carreras del piloto. El beneficio institucional es poder ver demanda sin interrogar el sistema de matrícula en vivo [5], [8].
En clasificación, el holdout temporal eligió aumento de gradiente. Exactitud 0,857, medida F1 0,909 y área bajo la curva ROC 0,867. El bosque aleatorio quedó cerca en área bajo la curva, 0,860. La regresión logística alcanzó precisión 0,939 a costa de un recall de 0,650. No se eligió el modelo más “preciso” en un cartel. Se eligió el que mejor equilibró discriminación y exhaustividad sobre datos no vistos en el tiempo. Ese criterio es más aburrido y más usable que coronar un campeón por una sola métrica [6], [11]. El área bajo la curva indica discriminación útil en prueba. No indica el umbral de intervención. Ese umbral es política de orientación, no un parámetro que el prototipo imponga.
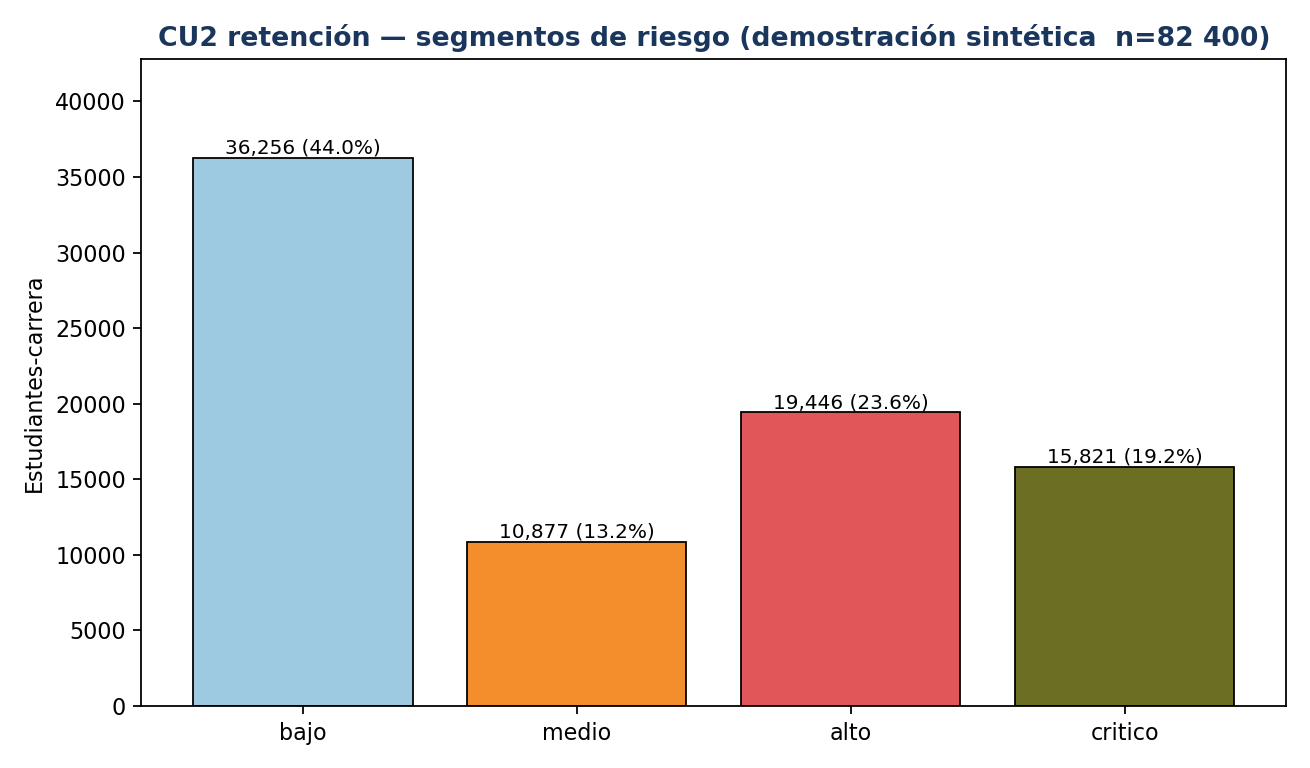
El scoring publicado es otro objeto. En el banco de demostración son 82 400 filas estudiante-carrera, con 44,0 por ciento en riesgo bajo, 13,2 por ciento medio, 23,6 por ciento alto y 19,2 por ciento crítico. Alto y crítico suman 42,8 por ciento. Mezclar ese universo con el holdout sería deshonesto [11], [12].
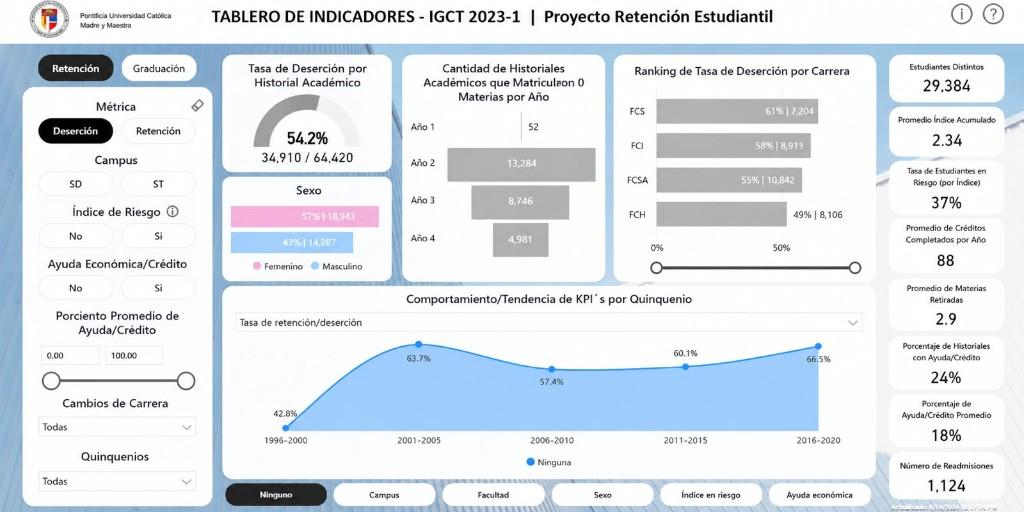
El dashboard de retención tiene dos caras, y conviene no mezclarlas. La vista agregada diagnostica deserción descriptiva por sexo, facultad y quinquenio. La vista individual prioriza un historial de ejemplo. Juntas, cierran el ciclo de consumo: el mart se lee en inteligencia de negocios, no se reanaliza en una hoja suelta. Los KPI del dashboard descriptivo no son las métricas del clasificador. Las capturas que siguen son de demostración: no deben citarse como deserción institucional [1], [11].
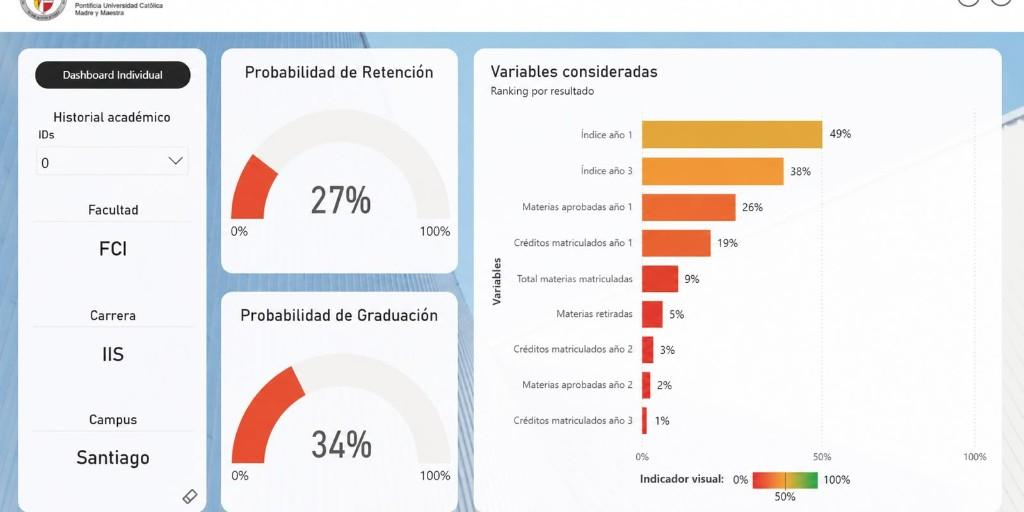
Ejemplo sintético (IIS, FCI, Santiago): retención 27 por ciento y graduación 34 por ciento. El indicador de graduación es un proxy de dashboard, no el target k a k+1 del clasificador.
Lo que no salió como se pensó
Tres resultados no estaban en el plan. El acceso seguro al sistema académico no se sostuvo: quedó como prueba de diagnóstico y el extracto fuera de línea cargó con el piloto. El dominio clínico del anteproyecto dejó de aportar en cuanto los historiales académicos bastaron para cerrar los dos casos. Y en el dashboard de riesgo hubo que calibrar por índice académico; sin esa regla, el scoring subestima la exigencia de la prueba y distorsionaba la cola de acompañamiento. Ninguno de los tres es un fracaso de la arquitectura abierta. Son el tipo de hallazgo que solo aparece cuando se implementa, no cuando se dibuja la lámina.
Qué gana una institución si copia el método, no la etiqueta
El prototipo demuestra algo más modestamente útil que declarar a la universidad “orientada por datos”. Demuestra que extractos académicos pueden aterrizar, curarse en un modelo dimensional y alimentar, sin rehacer la limpieza, un modelo de matrícula y un clasificador de retención, con dashboards que leen el mart. La separación de almacenamiento y cómputo evitó saturar el sistema transaccional con analítica. La separación de espacios de trabajo evitó el monolito en el que matrícula y deserción se pisan el esquema. Las métricas, imperfectas y desiguales entre series, son suficientes para una prueba de concepto e insuficientes para fijar política de cupos o de expulsión [5], [14], [15].
Los beneficios concretos, si otra IES adopta el patrón, se pueden enumerar sin inflar el lenguaje. Primero, soberanía del dato: el formato abierto y el aterrizaje propio reducen la hipoteca a un único fabricante [9], [17]. Segundo, no competir con el ERP: la consulta pesada vive fuera del trámite [8]. Tercero, reproducibilidad en hardware heterogéneo, gracias a contenedores y a corridas con identificador. Cuarto, un contrato de consumo: el científico lee compactas, el dashboard lee el mart, y el linaje explica de dónde salió el número. Quinto, dos productos de decisión sobre la misma plataforma, lo que abarata el segundo dominio respecto de empezar de cero. Sexto, evidencia de calidad por corrida, no una foto de un dashboard sin fecha. Nada de eso requiere declarar una transformación digital nacional. Requiere disciplina de grano y de capas [4], [10], [16].
El aprendizaje más exportable no es el nombre de un contenedor. Es ese contrato. Donde no existe, el siguiente estudiante volverá a unir archivos planos. Donde existe, se puede cambiar el modelo y conservar el linaje. Esa es la diferencia entre un cuaderno brillante y una plataforma, aunque la plataforma aún quepa en un computador portátil [5], [14]. Hay un límite de honestidad que conviene no cruzar. El prototipo no demostró que integrar todas las fuentes de la universidad aumente la precisión de los modelos. Demostró dos dominios académicos con extractos definidos. Tampoco demostró políticas de seguridad de acceso en un directorio institucional. El aislamiento fue el del equipo local. Quien cite este trabajo como si ya hubiera un hub nacional de datos universitarios estará leyendo la estrategia, no el entregable [16].
Como trabajo futuro, el prototipo pide un conector de solo lectura al sistema académico, con ventanas controladas, sin abandonar el aterrizaje. Pide una historia más larga antes de usar series frágiles para dimensionar la oferta. Pide promover el espacio de exploración al mart con contratos automáticos, y versionar las reglas de negocio de retención junto al modelo. Un piloto de agendado del orquestador puede venir después. Afirmar hoy operación continua sería adelantar un resultado que no se midió. Migrar a servidores institucionales, con roles de acceso y sin identificadores personales de más, es el paso que convierte esta prueba en capacidad de la universidad, no en un entregable de curso.
Quien administra tecnología en una institución suele preguntar, con razón, cuánto cuesta y quién lo opera. Este prototipo no cotiza un contrato de soporte. Cotiza una lección de diseño: el costo de no tener capa analítica ya se paga, en horas de extractos y en decisiones tomadas con el archivo del cuatrimestre anterior. Lo abierto desplaza ese costo hacia un contrato interno que se puede auditar. El personal mínimo no es un equipo de veinte. Es alguien que defienda el grano, alguien que publique el mart y alguien de negocio que lea el dashboard sin pedir una nueva unión. Si esa tríada no existe, ninguna pila, abierta o cerrada, sostiene el beneficio [1], [5], [16].
Quien lea esto desde otra institución de educación superior no necesita copiar la pila. Necesita copiar la disciplina: una fuente, un grano por pregunta, una capa que no se reescribe en el dashboard, y métricas que se atreven a ser malas en una serie si eso es lo que el holdout mostró. El llamado es prosaico y, por eso, viable. Repetir el piloto en un siguiente ciclo lectivo, con un extracto fresco y un usuario de planificación sentado al lado del dashboard, antes de hablar de inteligencia artificial oficial.
Referencias
- S. Gaftandzhieva, S. Hussain, S. Hilcenko, R. Doneva, y K. Boykova, «Data-driven Decision Making in Higher Education Institutions: State-of-play», Int. J. Adv. Comput. Sci. Appl., vol. 14, n.º 6, pp. 400–411, 2023, doi: 10.14569/IJACSA.2023.0140645.
- B. Daniel, «Big Data and analytics in higher education: Opportunities and challenges», Br. J. Educ. Technol., vol. 46, n.º 5, pp. 904–920, 2015, doi: 10.1111/bjet.12230.
- S. Z. Salas-Pilco y Y. Yang, «Artificial intelligence applications in Latin American higher education: a systematic review», Int. J. Educ. Technol. High. Educ., vol. 19, n.º 1, p. 21, 2022, doi: 10.1186/s41239-022-00326-w.
- G. Vial, «Understanding digital transformation: A review and a research agenda», J. Strateg. Inf. Syst., vol. 28, n.º 2, pp. 118–144, 2019, doi: 10.1016/j.jsis.2019.01.003.
- H. Chen, R. H. L. Chiang, y V. C. Storey, «Business Intelligence and Analytics: From Big Data to Big Impact», MIS Q., vol. 36, n.º 4, pp. 1165–1188, 2012, doi: 10.2307/41703503.
- O. Zawacki-Richter, V. I. Marín, M. Bond, y F. Gouverneur, «Systematic review of research on artificial intelligence applications in higher education – where are the educators?», Int. J. Educ. Technol. High. Educ., vol. 16, n.º 1, p. 39, 2019, doi: 10.1186/s41239-019-0171-0.
- L. E. Contreras Bravo, J. I. Rodríguez Molano, y H. J. Fuentes López, «Analítica académica: nuevas herramientas aplicadas a la educación», Rev. Bol. Redipe, vol. 10, n.º 3, pp. 137–158, 2021, doi: 10.36260/rbr.v10i3.1228.
- A. A. Munshi y A. Alhindi, «Big Data Platform for Educational Analytics», IEEE Access, vol. 9, pp. 52883–52890, 2021, doi: 10.1109/ACCESS.2021.3070737.
- N. Janssen, T. Ilayperuma, J. Jayasinghe, F. Bukhsh, y M. Daneva, «The evolution of data storage architectures: examining the secure value of the Data Lakehouse», J. Data Inf. Manag., vol. 6, 2024.
- R. Kimball y M. Ross, The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling, 3.ª ed. Indianapolis, IN, EE. UU.: Wiley, 2013.
- J. Guerra et al., «Adaptation and evaluation of a learning analytics dashboard to improve academic support at three Latin American universities», Br. J. Educ. Technol., vol. 51, n.º 4, pp. 973–1004, 2020, doi: 10.1111/bjet.12935.
- G. B. N. Silva, «Deserción estudiantil en Institutos Superiores Tecnológicos de Ecuador: Una revisión de la literatura», Rev. Latinoam. Ogmios, vol. 3, n.º 8, pp. 25–32, 2023, doi: 10.53595/rlo.v3.i8.084.
- B. Williamson, «Policy networks, performance metrics and platform markets: Charting the expanding data infrastructure of higher education», Br. J. Educ. Technol., vol. 50, n.º 6, pp. 2794–2809, 2019, doi: 10.1111/bjet.12861.
- M. Armbrust et al., «Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics», en Proc. 11th Conf. Innovative Data Syst. Res. (CIDR), 2021.
- R. J. Hyndman y G. Athanasopoulos, Forecasting: Principles and Practice, 3.ª ed. Melbourne, Australia: OTexts, 2021.
- J. Komljenovic, S. Sellar, y K. Birch, «Turning universities into data-driven organisations: seven dimensions of change», High. Educ., vol. 89, n.º 5, pp. 1369–1386, 2025, doi: 10.1007/s10734-024-01277-z.
- P. Dubey, «The Data Lakehouse: An Evolving Paradigm in Data Architecture», Int. J. Comput. Eng., vol. 7, n.º 10, pp. 30–47, 2025, doi: 10.47941/ijce.2958.
- W. Villegas-Ch, X. Palacios-Pacheco, y S. Luján-Mora, «Application of a Smart City Model to a Traditional University Campus with a Big Data Architecture: A Sustainable Smart Campus», Sustainability, vol. 11, n.º 10, p. 2857, 2019, doi: 10.3390/su11102857.