Cuando la inteligencia artificial no responde por ti

Cristian Ignacio de la Hoz Reyes y Manuel José Rodríguez Cruz – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Una respuesta correcta puede ser una mala experiencia de aprendizaje. Cuando un estudiante que comienza a programar recibe en segundos el ciclo, la condición y el arreglo que necesitaba construir, el ejercicio queda resuelto, pero no necesariamente la duda que lo originó. Esa tensión dio forma al Tutor Socrático, un sistema inteligente de tutoría desarrollado por Cristian Ignacio de la Hoz Reyes y Manuel José Rodríguez Cruz en la Escuela de Ingeniería en Computación y Telecomunicaciones de la Pontificia Universidad Católica Madre y Maestra, bajo la asesoría de la profesora Lisibonny Beato Castro. En ICC-101-T, Introducción a la Algoritmia, el proyecto planteó una pregunta educativa: ¿cómo aprovechar la capacidad conversacional de los modelos de lenguaje sin permitir que la rapidez de la respuesta sustituya el proceso de pensar? La propuesta no intenta esconder la inteligencia artificial ni convertirla en un buscador con restricciones. Busca preservar la participación del estudiante, solicitar indicios de lo que comprende, hacer visible el punto de bloqueo y ofrecer apoyo para el siguiente paso. La Figura 1 resume ese contraste.

La programación introductoria es un escenario sensible para esa pregunta. Aprender a programar implica descomponer problemas, representar estados, anticipar el flujo de ejecución, verificar hipótesis y corregir modelos mentales, habilidades del pensamiento computacional que trascienden la sintaxis [1]. En los primeros cursos, los errores conceptuales suelen acumularse: confundir un contador, recorrer incorrectamente una matriz o no distinguir el valor de una variable de su dirección puede afectar ejercicios posteriores aunque el código compile [2]. En el contexto dominicano, las diferencias de experiencia previa y concepciones docentes vuelven necesaria una mediación intencional [3]. Por eso, una herramienta que produce programas completos plantea una paradoja. Puede reducir la fricción y ampliar el acceso a explicaciones, pero también ocultar las operaciones cognitivas que el curso pretende desarrollar. El valor de un tutor no reside, entonces, en escribir más código que el estudiante, sino en ayudarle a construir una explicación que pueda defender, modificar y transferir.

La literatura reciente confirma que la inteligencia artificial generativa no produce un efecto educativo único. Una revisión rápida sobre programación identifica oportunidades para explicar, generar ejemplos y apoyar la depuración, junto con riesgos de inexactitud, dependencia y evaluación superficial [4]. Una revisión sistemática de cuarenta estudios empíricos concluye que los resultados dependen de la integración, las estrategias de interacción y la evaluación [5]. En educación superior, el uso intensivo puede relacionarse con procrastinación, deterioro del desempeño y pérdida de control cuando sustituye el esfuerzo [6]. Al mismo tiempo, una colaboración bien estructurada puede favorecer motivación y desempeño [7]. La conclusión útil no es aceptar o prohibir la IA de forma absoluta. Es diseñar condiciones para que funcione como andamiaje temporal: una ayuda que observa el intento, ajusta la dificultad, solicita evidencia y se retira gradualmente. En ese punto se sitúa el Tutor Socrático, una arquitectura que convierte principios pedagógicos en reglas operativas.

El resultado es una plataforma funcional que integra conversación guiada, memoria, materiales autorizados, preguntas diagnósticas, actividades y un depurador visual de C. Su aporte principal no es un mensaje ingenioso ni un modelo particular. Es una arquitectura replicable que mantiene identidad, permisos, persistencia y evidencia bajo control de la plataforma, mientras el modelo interpreta el contexto y genera una intervención pedagógica. Esa separación responde a un problema conocido: los modelos pueden producir afirmaciones plausibles sin respaldo o variar según el contexto [8]. También recoge que la IA educativa requiere gobernanza, transparencia y participación humana, no solo precisión técnica [9]. El proyecto une dos escalas. En el turno conversacional, pregunta en vez de resolver y ofrece pistas acotadas. En la escala institucional, reconoce clases, docentes, estudiantes, materiales y actividades. Esta doble mirada permite evaluar no solo si el modelo “suena socrático”, sino si el sistema sostiene una tutoría responsable.
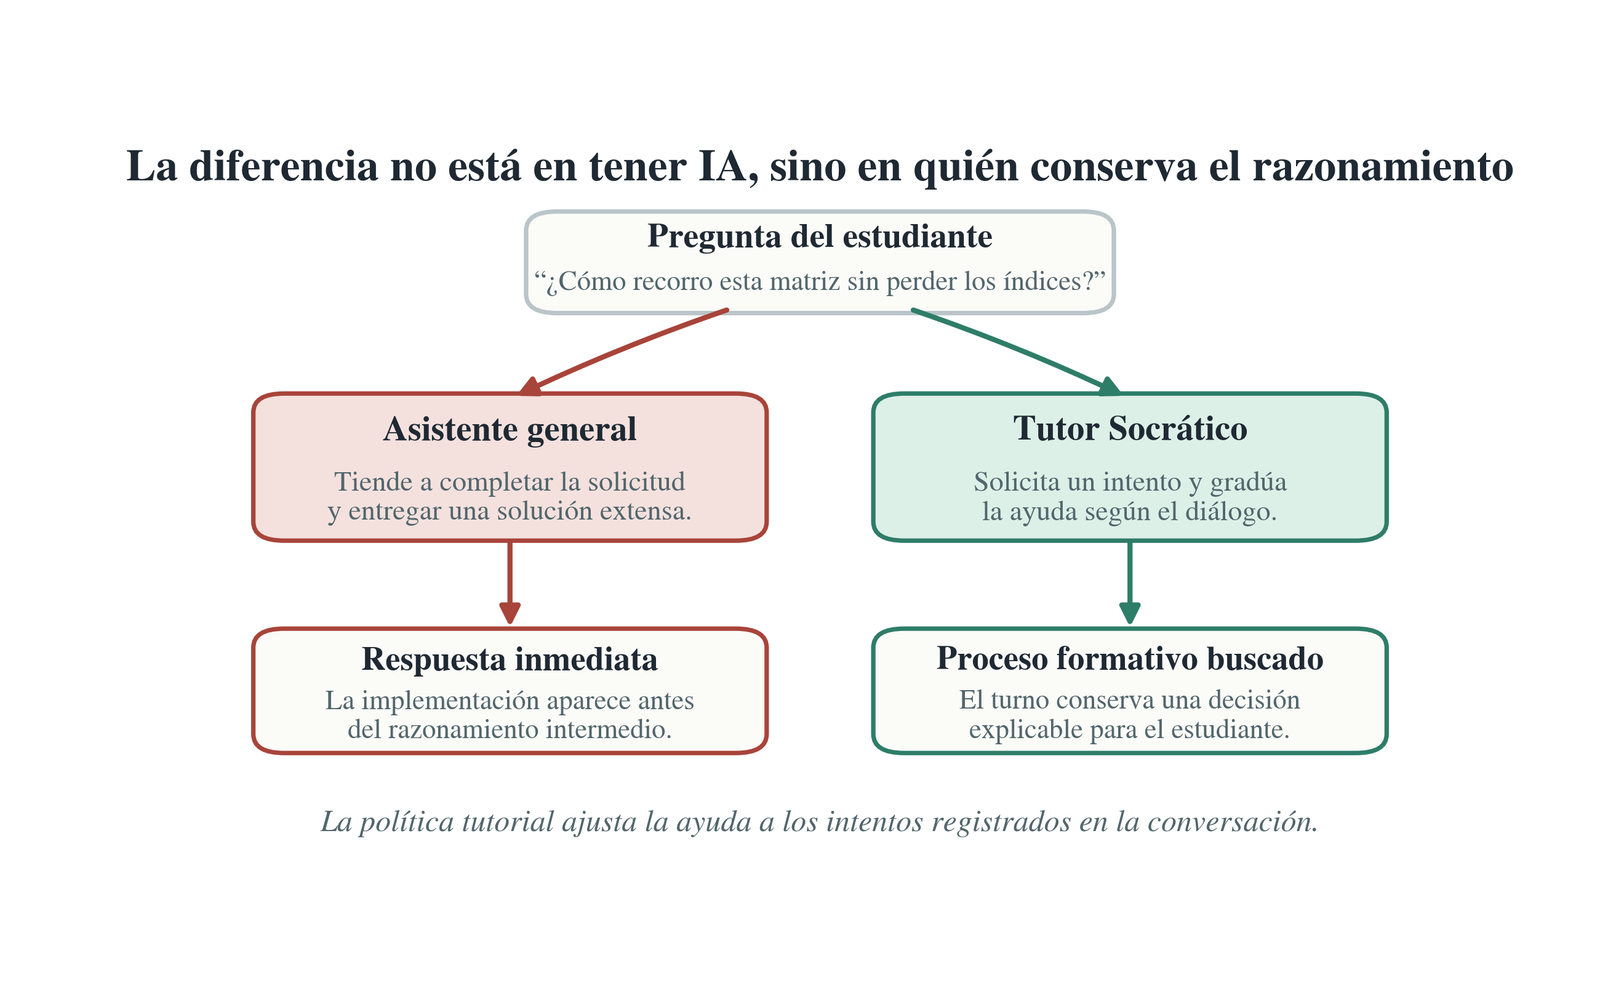
De la respuesta inmediata al andamiaje cognitivo: el asistente general completa, mientras el Tutor Socrático conserva decisiones esenciales en manos del estudiante
Figura 1. De la respuesta inmediata al andamiaje cognitivo: el asistente general completa, mientras el Tutor Socrático conserva decisiones esenciales en manos del estudiante. Fuente: Elaboración propia.

Problemática y estado del arte

En ICC-101-T, una solución sintácticamente válida puede dejar intacto el error que importa. Un estudiante puede copiar un recorrido de arreglo sin comprender por qué el índice comienza en cero, ajustar una condición hasta que el programa termine o repetir una función sin reconocer sus entradas y salidas. Estas dificultades exigen retroalimentación oportuna, pero el tiempo docente es limitado. Los asistentes generales parecen llenar el vacío porque están disponibles y producen ejemplos con rapidez. Sin embargo, fueron optimizados para completar instrucciones, no para proteger una secuencia didáctica. Suelen inferir que la mejor ayuda es la solución más acabada. En un entorno profesional eso puede aumentar productividad; en un curso inicial puede saltar desde la confusión hasta el producto final y eliminar la observación del razonamiento intermedio. El desafío no consiste solo en evitar respuestas extensas. Consiste en reconocer el estado del estudiante, decidir qué apoyo es proporcional, mantener continuidad y conservar evidencia que permita al docente interpretar cómo se construyó la respuesta.

Esta diferencia puede entenderse mediante la descarga cognitiva. Las personas usan recursos externos para reducir demandas de memoria, cálculo o atención, algo adaptativo cuando libera capacidad para tareas complejas [10]. El problema aparece cuando el recurso reemplaza la práctica que debía consolidar una habilidad. Un almacén externo puede disminuir el esfuerzo de estudio y cambiar lo recordado [11], e incluso incrementar errores cuando la persona confía en que la información seguirá accesible [12]. Con IA, el costo puede incluir pérdida de confianza para resolver, aceptación sin inspección y debilitamiento de hábitos metacognitivos [13]. Por eso, el Tutor Socrático no trata cada solicitud como una orden. La interpreta como evidencia parcial de un estado cognitivo. “Hazme este ejercicio” puede esconder desconocimiento del enunciado, dificultad para descomponerlo o prisa. Antes de producir código, el sistema debe distinguir esas posibilidades y devolver al estudiante una decisión que todavía le pertenezca.

La evidencia empírica vuelve concreta esa preocupación. En un estudio sobre chatbots en educación de programación, el rendimiento pasó de 48.33 a 74.47 puntos, con un tamaño de efecto reportado de 1.56, pero el beneficio convivió con una señal crítica: ante respuestas incorrectas de la IA, 33 de 36 estudiantes las siguieron y 22 copiaron y pegaron el contenido [14]. El dato muestra que una herramienta puede elevar resultados inmediatos y, simultáneamente, reforzar conductas de dependencia. En otra disciplina, un ensayo a gran escala en matemáticas encontró que el acceso a IA con salvaguardas podía apoyar la práctica, mientras la versión sin guardas podía perjudicar el aprendizaje posterior cuando la herramienta dejaba de estar disponible [15]. No corresponde trasladar esos efectos de manera automática a ICC-101-T, pero sí reconocer el mecanismo de riesgo: si la interfaz recompensa obtener una respuesta y no justificarla, el estudiante aprende a optimizar la conversación, no necesariamente el concepto. De ahí que la seguridad pedagógica deba diseñarse en el flujo del sistema y no quedar como una recomendación escrita al inicio de la sesión.

Los proyectos más próximos al estado del arte han comenzado a responder con guardas y conversación guiada. CodeHelp limita la entrega de soluciones completas y organiza el apoyo para clases de programación a escala [16]. Ruffle & Riley explora un tutor conversacional basado en modelos de lenguaje y documenta las decisiones de diseño necesarias para sostener una interacción pedagógica [17]. Un estudio controlado con 42 participantes comparó un asistente guiado, que evitaba soluciones directas, con uno de uso irrestricto; el grupo guiado mostró mejores mejoras de aprendizaje, aunque los autores también identificaron intentos de eludir las restricciones mediante instrucciones adversarias [18]. Más recientemente, un estudio aleatorizado con 94 estudiantes informó que un agente conversacional socrático superó a una versión no socrática en rendimiento y pensamiento reflexivo, con diferencias particularmente visibles en reflexión y reflexión crítica, pero sin ventaja equivalente en motivación [19]. En conjunto, estas investigaciones apoyan una idea sobria: las restricciones pedagógicas pueden ser valiosas, pero necesitan persistencia, medición y un diseño resistente a la variabilidad de los modelos.

Aun así, una respuesta socrática aislada no constituye un sistema de tutoría. Un chatbot puede formular una buena pregunta y perderla en el turno siguiente, consultar un material que no pertenece a la clase, mostrar información de otro usuario o generar un informe sin trazabilidad. También puede impedir toda ayuda bajo la etiqueta de seguridad, frustrando a quien necesita una explicación legítima. El reto arquitectónico consiste en coordinar elementos con objetivos distintos: control de acceso, contexto académico, memoria, recuperación documental, llamadas a herramientas, transmisión progresiva de la respuesta, registro de eventos y revisión docente. Además, la relación entre usuario y modelo de código no es neutral. Estudios sobre programadores muestran que las personas alternan entre acelerar una tarea y explorar lo que el modelo puede hacer, lo cual modifica la forma de inspeccionar y aceptar sugerencias [20]. Para principiantes, esa asimetría es mayor porque disponen de menos criterios para verificar. La plataforma debe, por tanto, conservar la frontera entre una explicación persuasiva y una evidencia autorizada, entre una sugerencia y una decisión académica, y entre el rol técnico de una cuenta y su pertenencia real a una clase.

El vacío que motivó el proyecto fue precisamente esa integración. Existían asistentes generales con gran capacidad de generación, prototipos con guardas conversacionales y estudios que demostraban el potencial del método socrático, pero faltaba una propuesta local que uniera pedagogía, control institucional y herramientas de programación en una misma cadena verificable. El Tutor Socrático aborda el problema sin asumir que la prohibición es sostenible ni que el acceso irrestricto es educativo. Su tesis de diseño es que la ayuda debe estar delimitada por el propósito de la asignatura y por el progreso expresado en la conversación. Una respuesta útil no se mide solo por su exactitud, sino por lo que permite hacer después sin la herramienta. La recuperación de práctica, por ejemplo, produce más aprendizaje que formas de estudio elaborativo cuando obliga a reconstruir activamente el conocimiento [21]. Trasladado al diálogo, esto significa que el sistema debe pedir al estudiante que prediga, explique, trace o corrija antes de formalizar la solución. Esa regla conecta la literatura con una necesidad concreta de aula y justifica que el proyecto se evalúe como plataforma académica, no como una colección de prompts.

Objetivos completados

El proyecto completó la implementación de un sistema de tutoría inteligente para Introducción a la Algoritmia que orienta mediante apoyo cognitivo progresivo, preguntas reflexivas, pistas y explicaciones graduadas. El sistema se diseñó para promover la descomposición de problemas, el razonamiento algorítmico y la construcción lógica, al tiempo que limita la entrega ordinaria de soluciones completas generadas por herramientas de propósito general. Para cumplir ese objetivo se diseñó y consolidó una arquitectura replicable y se materializó en una plataforma académica funcional; se recopiló y organizó conocimiento pedagógico de la asignatura, incluidos contenidos, ejercicios representativos, materiales autorizados y estrategias de acompañamiento docente; se construyó y evaluó un motor de razonamiento pedagógico basado en modelos de lenguaje y estrategias socráticas; y se implementó una interfaz conversacional que mantiene el registro de las progresiones de razonamiento y permite intervenciones en múltiples etapas. La solución integra, además, identidad académica, permisos contextuales, memoria, recuperación documental, preguntas estructuradas, actividades formativas, informes revisables y depuración visual de código C.

Metodología
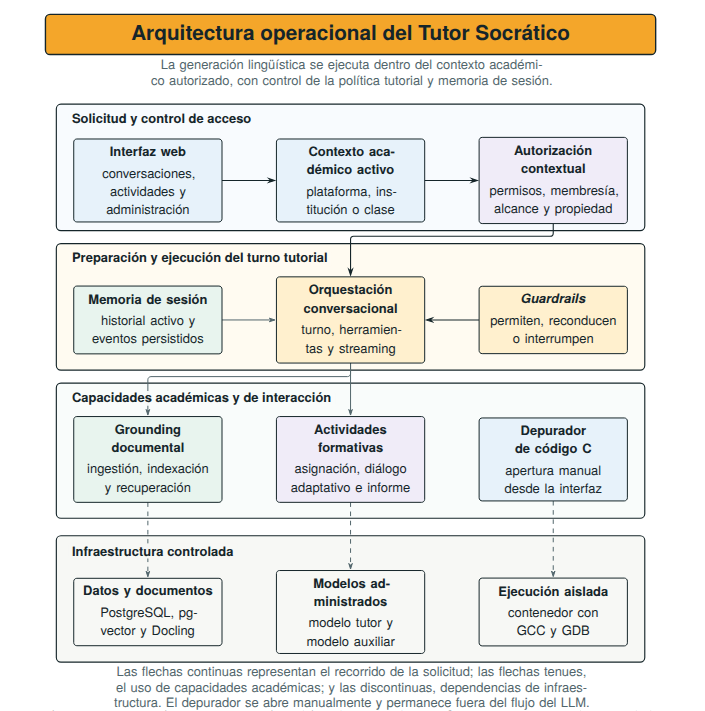
Arquitectura operacional implementada del Tutor Socrático
Figura 2. Arquitectura operacional implementada del Tutor Socrático. Fuente: Reproducción íntegra de la figura documentada en el proyecto.

La solución se construyó a partir de una separación explícita entre la plataforma y el modelo de lenguaje. La plataforma autentica a la persona, resuelve el contexto académico activo, comprueba permisos y propiedad, conserva el historial, habilita recursos y registra los eventos del turno. El modelo recibe únicamente el contexto preparado por esos servicios, interpreta las instrucciones tutoriales y produce una intervención o una llamada estructurada a una herramienta disponible. Esta distribución de responsabilidades impide trasladar al texto generado decisiones institucionales como la pertenencia a una clase, la lectura de un material o la modificación de una evidencia. La arquitectura se organiza en una interfaz académica, servicios de dominio autorizados, el harness tutorial, persistencia conversacional, materiales y herramientas, y un servidor de inferencia reemplazable. El harness coordina la guardia, la memoria, el contexto académico y las llamadas a herramientas; no representa un modelo adicional ni una clase aislada. La Figura 2 muestra las fronteras y el sentido del flujo: la autorización ocurre antes de construir el contexto, y las herramientas se ejecutan mediante servicios controlados cuando el modelo las solicita.

La autorización se aplica antes de invocar la inteligencia artificial. El dominio distingue tres niveles: plataforma, institución y clase. Una misma cuenta puede asumir funciones diferentes en espacios distintos, por lo que el sistema separa el rol configurable de la identidad académica expresada por la membresía. Cada operación combina el permiso requerido, la institución, la pertenencia a la clase y la propiedad del recurso cuando corresponde. La protección se repite en la navegación y en los servicios: ocultar una opción de menú mejora la interfaz, pero la decisión efectiva se toma en la capa que consulta o modifica los datos. Los permisos se expresan mediante códigos estables de recurso y acción, mientras las instantáneas de acceso se almacenan temporalmente y se invalidan cuando cambia un rol o una asignación. En consecuencia, una conversación, un material o una actividad se recuperan dentro del espacio autorizado antes de formar el contexto del modelo. Esta estructura permite que el profesor administre los recursos de sus clases y que el estudiante acceda a sus conversaciones y asignaciones sin convertir ninguna identidad académica en una autoridad global.

Cada turno sigue una cadena explícita. La guardia clasifica el mensaje junto con el historial activo relevante y el contexto de la asignatura; así puede interpretar respuestas breves que dependen de una pregunta anterior. Sus acciones son permitir, reconducir o interrumpir. La versión reconducida es la que continúa hacia la memoria, mientras una interrupción detiene la cadena antes de incorporar el contenido a la sesión. Después, el sistema reúne la memoria activa y el contexto académico permitido. El modelo puede generar texto o solicitar una herramienta registrada. Una de ellas, interrogateUser, presenta de una a tres preguntas diagnósticas con opciones o respuesta escrita, conserva los borradores, valida el contenido y devuelve el resultado al mismo turno para que continúe la generación. La salida llega a la interfaz en streaming y se persiste como eventos coherentes de usuario, asistente y herramientas. Esta orquestación responde a la posibilidad de generar información no fundamentada [8] y a los intentos de eludir restricciones conversacionales [18].

La memoria distingue la evidencia persistente del contexto enviado a inferencia. Cada conversación utiliza una sesión basada en eventos ordenados; estos pueden marcarse como reales, sintéticos o archivados. La interfaz conserva la transcripción de los mensajes reales, mientras el modelo recibe la memoria sintética más reciente y los turnos activos que caben dentro del presupuesto configurado. Cuando el historial alcanza el umbral de compactación, la estrategia recorre los eventos desde el más reciente, conserva una ventana de intercambios y resume la parte anterior. El punto de corte se desplaza hasta un evento raíz de usuario para no separar una respuesta o una salida de herramienta de la pregunta que le da sentido. El resumen previo puede incorporarse de manera recursiva, y los eventos antiguos se archivan en lugar de eliminarse. Con ello, la plataforma mantiene dos proyecciones del mismo historial: una transcripción canónica para consulta y trazabilidad, y una memoria sintética para sostener continuidad sin reenviar toda la conversación en cada turno.

Sobre esa base, la política socrática se implementó como una progresión regulada por los indicios del diálogo. El tutor intenta localizar la dificultad mediante una explicación del objetivo, una predicción, un intento de código o la identificación del punto de bloqueo. Después propone una acción abordable, como formular una condición o trazar algunas iteraciones. Si el intento registrado muestra estancamiento, introduce una pista limitada; posteriormente puede formalizar el concepto y plantear una variación para comprobar la continuidad del razonamiento. El nivel de ayuda cambia según las respuestas conservadas en la conversación y el tutor puede corregir una idea cuando el intercambio aporta evidencia suficiente. Este diseño coincide con estudios donde el diálogo socrático se relacionó con mejor rendimiento y pensamiento reflexivo [19], y con propuestas que utilizan la IA como apoyo a la metacognición y la autorregulación [22]. El propósito de la secuencia es mantener una acción intelectual concreta en el siguiente turno, no prolongar una cadena de preguntas sin orientación.

El grounding documental incorpora materiales proporcionados por el profesor mediante un flujo revisable. El documento se asocia con la clase activa, Docling lo transforma a Markdown y segmentos, y la interfaz permite revisar el contenido antes de aprobarlo. Tras la aprobación, el servicio calcula embeddings y almacena los fragmentos con metadatos de procedencia, clase, autor, posición, estado e identificador de ingestión. La recuperación se ofrece al tutor mediante herramientas para buscar materiales y continuar la lectura de un documento. Antes de consultar el índice vectorial, el servicio exige la clase autorizada y filtra por ese contexto y por el estado disponible; el modelo recibe los fragmentos que el sistema ya delimitó. La búsqueda semántica se combina con cursores opacos para avanzar dentro de la misma fuente sin exponer identificadores internos. Este enfoque se relaciona con la generación aumentada por recuperación, que combina el conocimiento paramétrico con evidencia externa [23]. En el Tutor Socrático, su función es vincular la explicación con materiales académicos revisados y conservar la procedencia de lo recuperado. La Figura 3 muestra la carga del PDF transformado y la revisión de sus segmentos antes de la indexación.
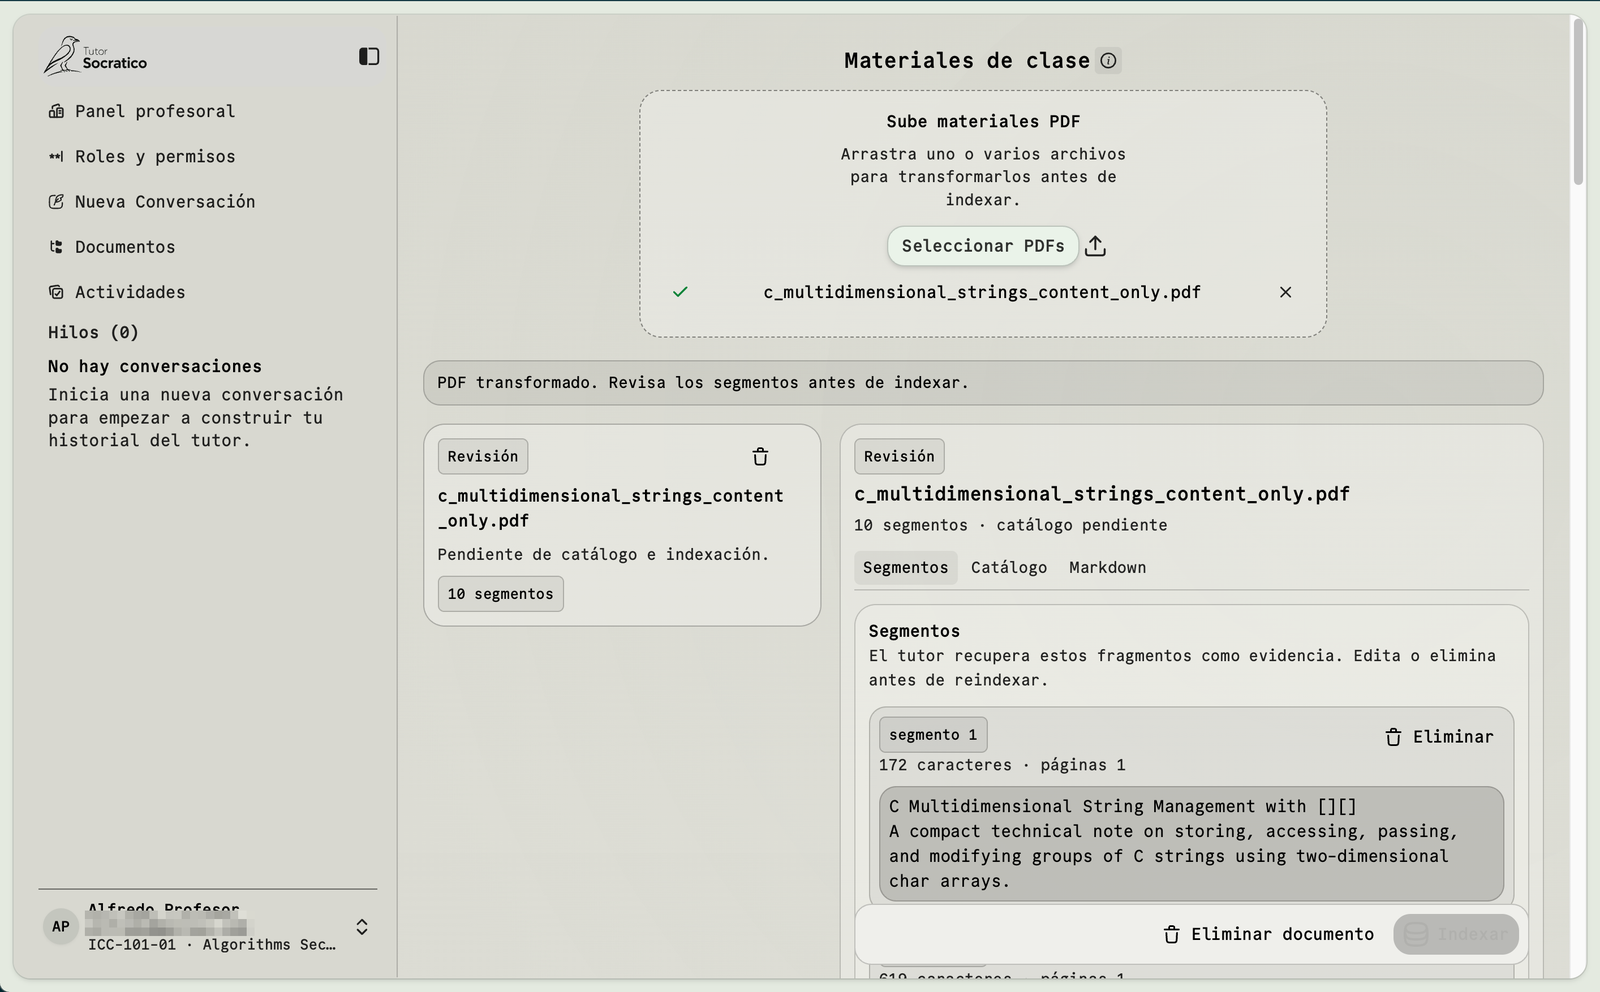
Vista docente para cargar un material PDF y revisar los segmentos transformados antes de su indexación
Figura 3. Vista docente para cargar un material PDF y revisar los segmentos transformados antes de su indexación. Fuente: Captura original del flujo de grounding documental conservada en la versión actualizada del proyecto.

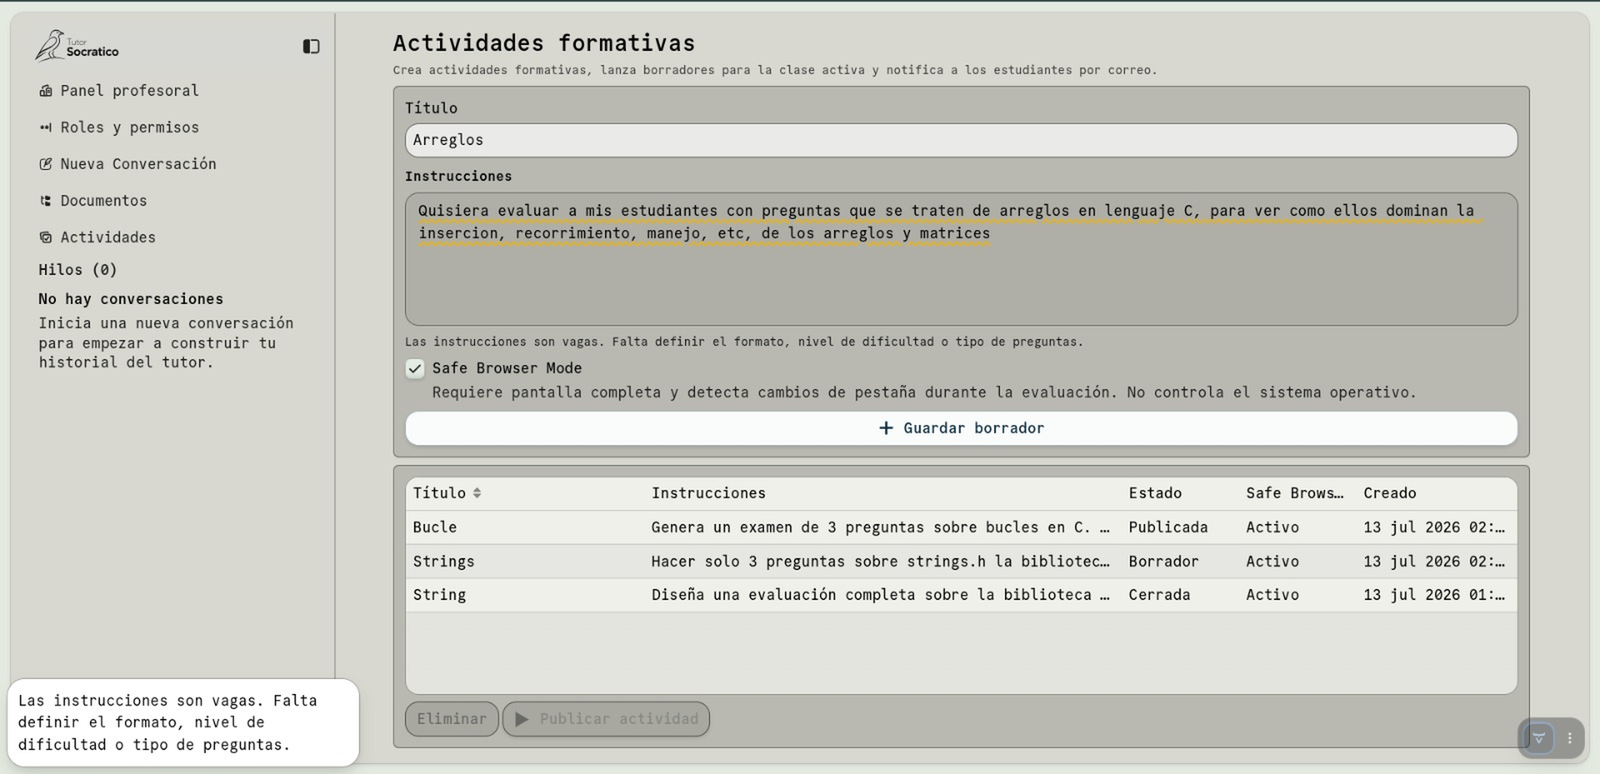
El módulo de actividades formativas amplía la tutoría más allá de una conversación iniciada libremente por el estudiante. El profesor redacta una consigna, la guarda como borrador y puede solicitar una revisión asistida que combina validaciones locales con una salida estructurada del modelo auxiliar. La revisión identifica ambigüedades, ausencia de criterios verificables o condiciones que dificultarían observar el razonamiento; su propuesta queda sujeta a la decisión del docente. Al publicar, el sistema crea las asignaciones correspondientes y comunica su disponibilidad. Durante la realización, un servicio adaptativo genera la primera pregunta y, después de cada respuesta, decide de forma estructurada si debe continuar o completar la actividad según la evidencia reunida. Cada intercambio conserva la pregunta exacta y la respuesta del estudiante. Al finalizar, el sistema genera un informe revisable que mantiene la transcripción canónica como fundamento. El modo de navegación controlada, cuando se habilita, registra eventos como pérdida de visibilidad, salida de pantalla completa, desenfoque o interrupción del latido y puede producir una alerta para revisión. Las Figuras 4 y 5 muestran el flujo y la vista real de preparación de una actividad.
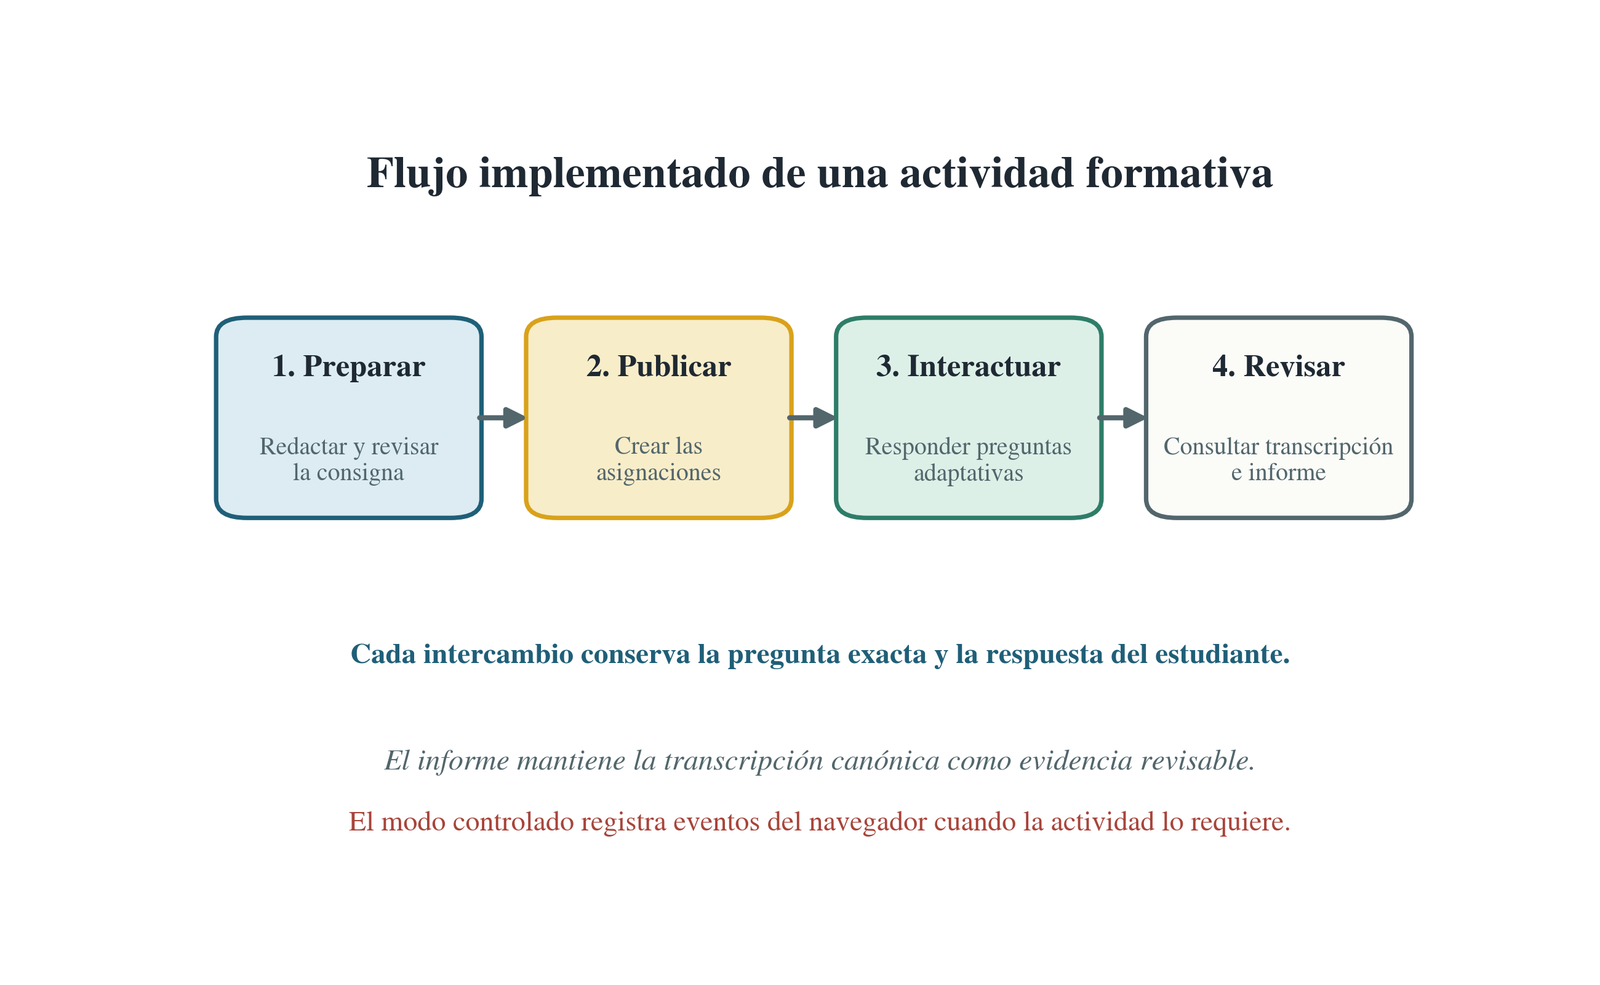
Flujo de una actividad formativa: preparación y revisión de la consigna, publicación, interacción adaptativa y consulta de la transcripción y del informe
Figura 4. Flujo de una actividad formativa: preparación y revisión de la consigna, publicación, interacción adaptativa y consulta de la transcripción y del informe. Fuente: Elaboración propia a partir del módulo implementado.
Vista docente para redactar una actividad, revisar la calidad de la consigna, configurar el modo de navegación y conservarla como borrador
Figura 5. Vista docente para redactar una actividad, revisar la calidad de la consigna, configurar el modo de navegación y conservarla como borrador. Fuente: Captura original del prototipo final conservada en el proyecto.

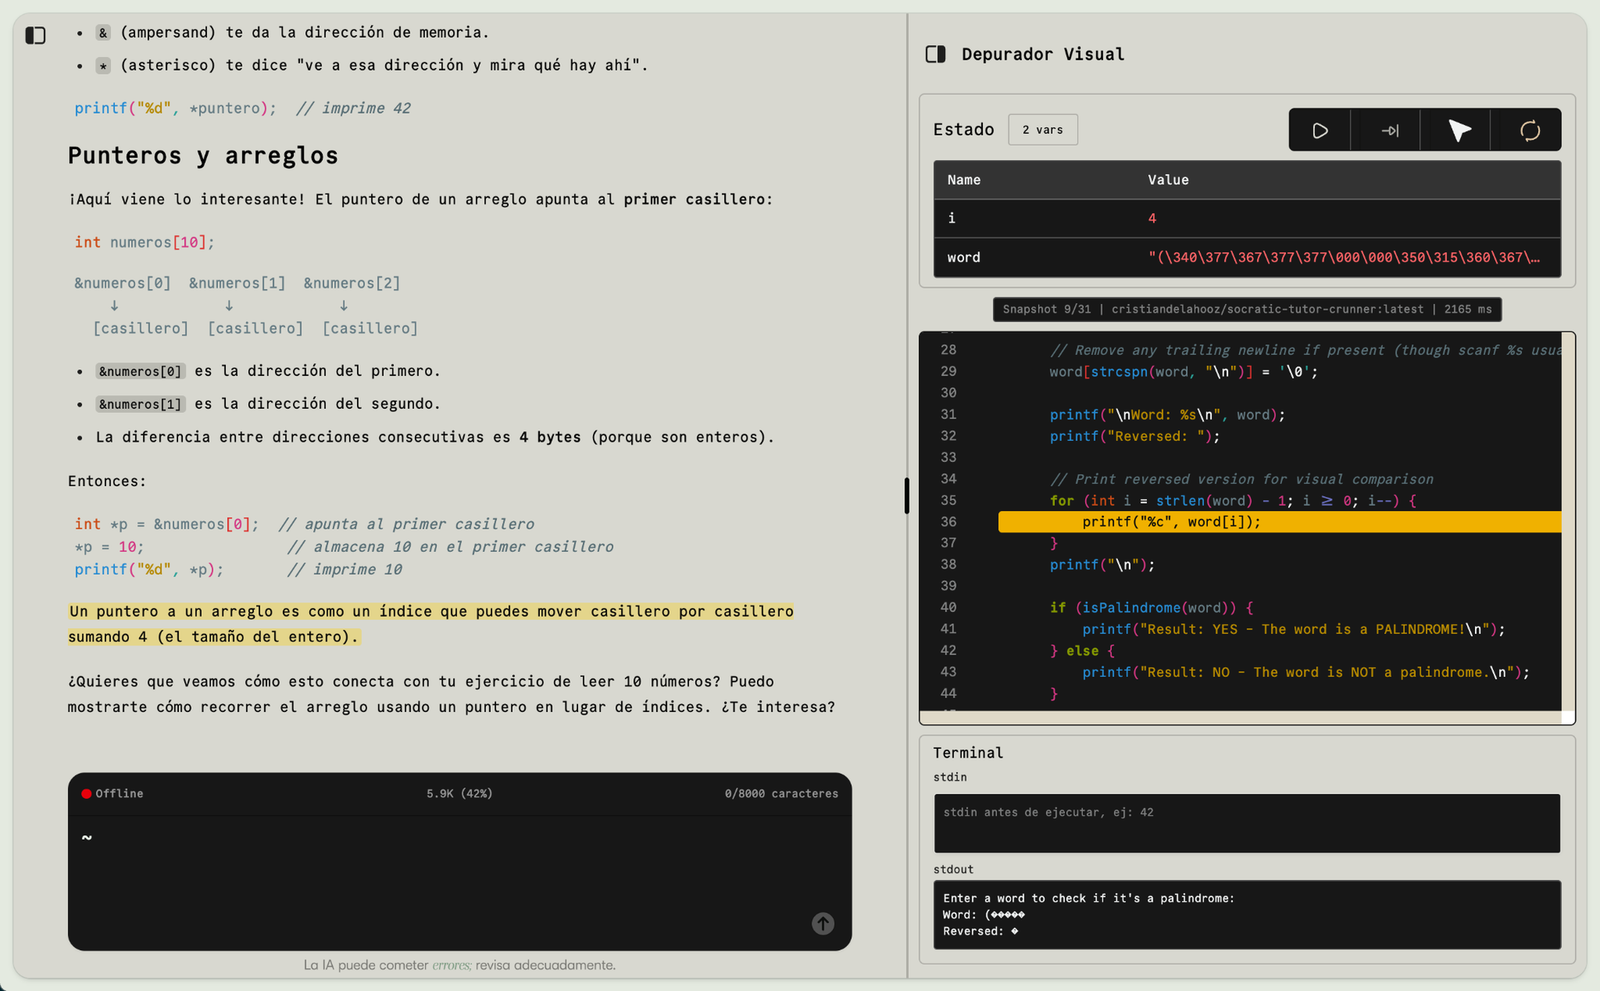
El depurador visual constituye una herramienta propia de la plataforma y se abre manualmente desde un bloque de código; el modelo no la activa dentro de la cadena de herramientas. El servidor crea un espacio temporal y ejecuta GCC o GDB en un contenedor con límites de tiempo, memoria, CPU, procesos y salida. La comunicación con GDB utiliza su interfaz de máquina, y el analizador convierte la traza real en una secuencia de instantáneas con la línea activa, las variables, la salida estándar y las líneas ejecutables. En la interfaz, el estudiante puede iniciar, avanzar una instrucción, desplazarse hasta una línea ejecutable y reiniciar el recorrido. El editor muestra el código y los diagnósticos de compilación; la tabla de variables presenta valores simples, arreglos, matrices y direcciones cuando GDB las expone; y la terminal reúne entrada y salida. Esta representación permite relacionar una instrucción de C con el cambio de estado que produce. La Figura 6 documenta la vista integrada del depurador, con los controles, las variables, la línea resaltada, el código fuente y la terminal dentro del espacio de trabajo del tutor.
Vista integrada del depurador de C con controles de recorrido, variables, línea activa, código fuente y terminal
Figura 6. Vista integrada del depurador de C con controles de recorrido, variables, línea activa, código fuente y terminal. Fuente: Captura original del sistema integrado conservada en el proyecto.

El ajuste supervisado se desarrolló como un experimento complementario de especialización conversacional. Cinco conversaciones docentes sobre ciclos, funciones, arreglos, matrices y cadenas sirvieron para extraer patrones de intervención: localizar la dificultad, formular una pregunta contestable, ofrecer una pista limitada, formalizar después del intento y comprobar la continuidad del razonamiento. Esos patrones se expandieron en diálogos sintéticos multivuelta sometidos a curación manual, con prioridad en la calidad y diversidad de las demostraciones [24], [25]. El entrenamiento utilizó Qwen3-8B cuantizado a cuatro bits y QLoRA, técnica que mantiene congelado el modelo base y actualiza adaptadores de bajo rango para reducir el uso de memoria [26]. La comparación cualitativa examinó cadenas, una operación de cajero y el recorrido de matrices. Después, el artefacto se probó dentro del harness, donde debía coordinar memoria, contexto recuperado y herramientas. Para la plataforma integrada se seleccionó Ornith 9B por la continuidad observada en esas pruebas, mientras el ajuste de Qwen3 se conservó como evidencia experimental del cambio en el patrón de respuesta.

Resultados

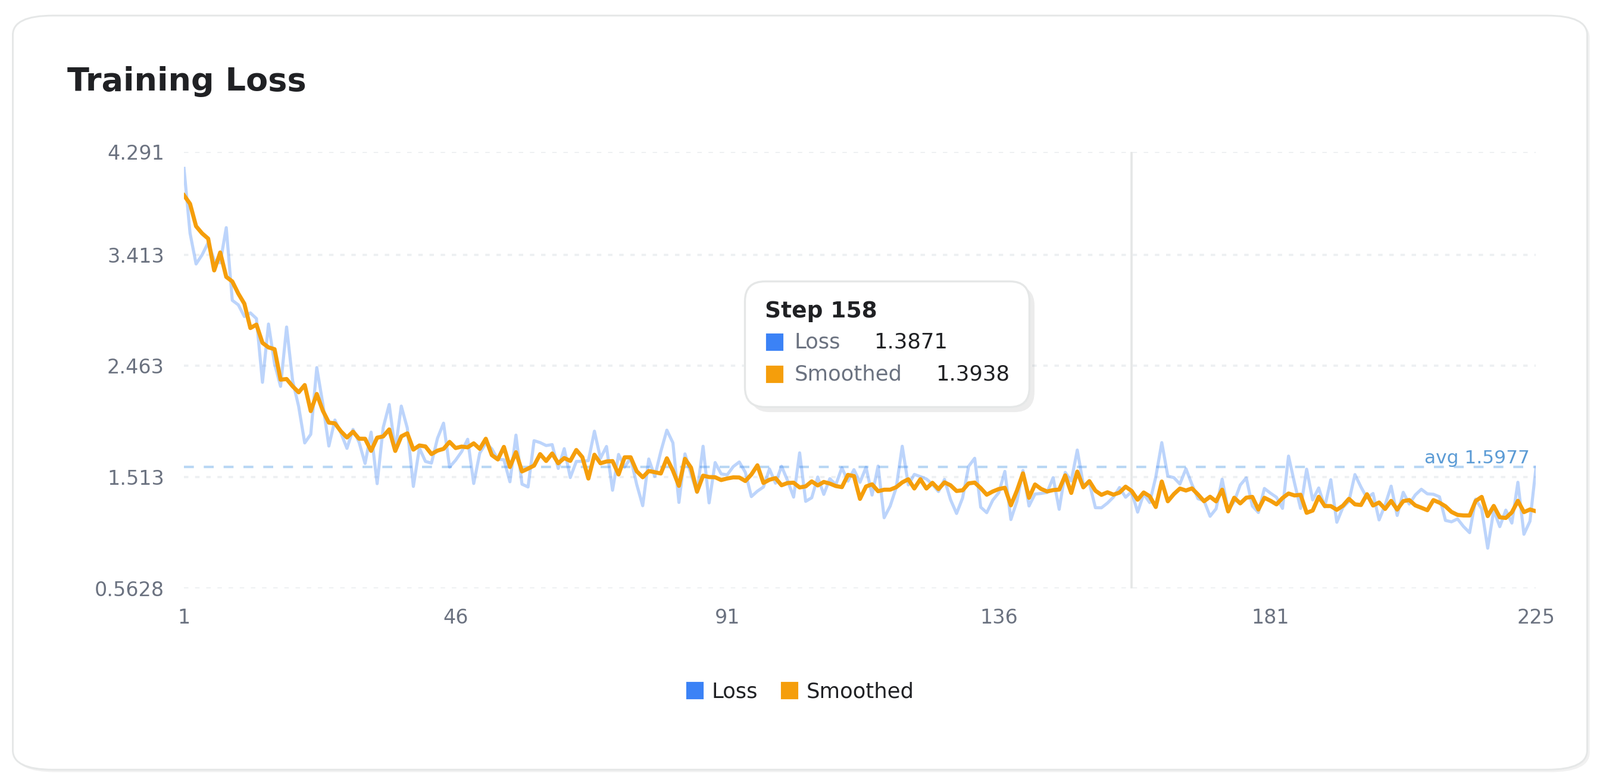
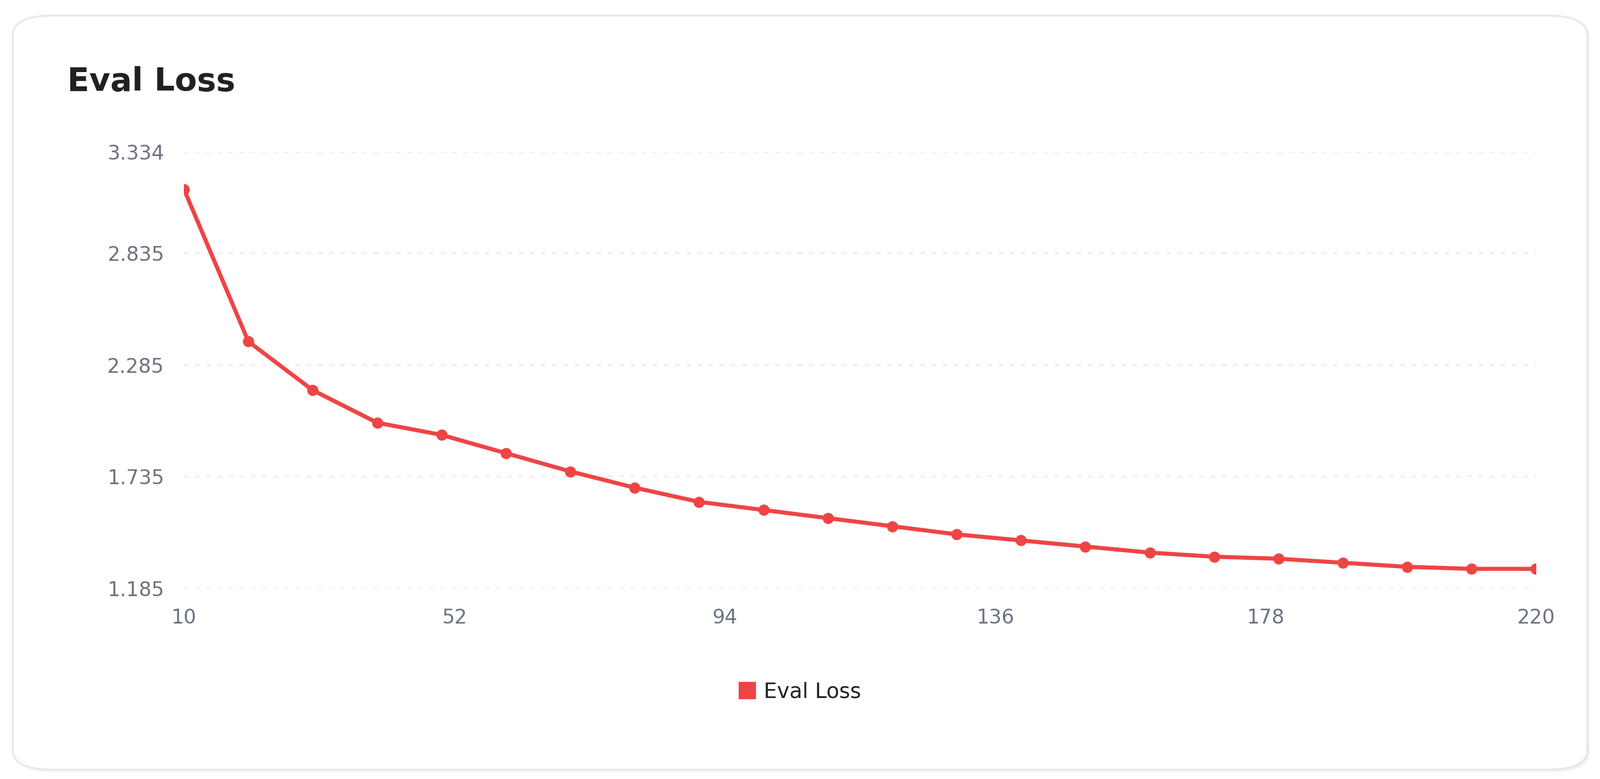
Las métricas de la corrida documentada muestran que los adaptadores se aproximaron al patrón conversacional utilizado en el ajuste. La pérdida de entrenamiento descendió con rapidez al inicio y continuó bajando de manera gradual durante las épocas registradas. La pérdida de evaluación, calculada sobre conversaciones retenidas, pasó aproximadamente de 3.1 a 1.3 y mantuvo una tendencia descendente hasta el último punto visible. La norma del gradiente permaneció en un rango finito mientras la tasa de aprendizaje siguió el calentamiento y el decaimiento configurados. Leídas en conjunto, estas señales documentan una optimización estable del objetivo supervisado: respuestas en español para programación introductoria en C, con diagnóstico, ayuda parcial y continuidad entre turnos. Las Figuras 7 y 8 reproducen las capturas originales utilizadas en el capítulo de resultados del proyecto. La primera muestra la pérdida de entrenamiento y su tendencia suavizada; la segunda presenta la pérdida de evaluación obtenida periódicamente durante la misma ejecución. El análisis conductual posterior permitió observar cómo ese cambio estadístico se manifestaba en las conversaciones comparadas.
Pérdida de entrenamiento por paso y tendencia suavizada durante la corrida QLoRA documentada
Figura 7. Pérdida de entrenamiento por paso y tendencia suavizada durante la corrida QLoRA documentada. Fuente: Captura original utilizada en el capítulo de resultados del proyecto.
Pérdida de evaluación sobre las conversaciones retenidas, calculada periódicamente durante la corrida documentada
Figura 8. Pérdida de evaluación sobre las conversaciones retenidas, calculada periódicamente durante la corrida documentada. Fuente: Captura original utilizada en el capítulo de resultados del proyecto.

En los tres escenarios ilustrativos, el cambio de comportamiento buscado apareció de forma reconocible. Qwen3 base comenzaba con implementaciones extensas o asumía decisiones del ejercicio; el modelo ajustado iniciaba con preguntas de diagnóstico, dividía el problema y ofrecía fragmentos de ayuda. En cadenas distinguió la dificultad antes de presentar código; en el escenario de cajero separó las operaciones y los datos necesarios; y en matrices pidió identificar el recorrido, el valor conservado y la condición de parada. Al incorporar el checkpoint al harness, el equipo observó respuestas breves o repetitivas en intercambios multivuelta y menor estabilidad al coordinar herramientas. Ornith 9B mantuvo mayor continuidad dentro del flujo completo, que combina instrucciones, historial, evidencia recuperada y resultados de herramientas, y por ello se eligió como modelo tutorial operativo. El resultado de ingeniería quedó así dividido en dos artefactos con funciones documentadas: Qwen3 ajustado como experimento de cambio conductual y Ornith como modelo servido durante la evaluación de la plataforma integrada.

La evaluación final examinó la versión integrada de la plataforma con Ornith, la conversación guiada, el depurador y los flujos académicos implementados. El instrumento estudiantil se organizó alrededor de dos escenarios de uso, arreglos unidimensionales y matrices, junto con un bloque de percepción general. Sus ítems recogieron claridad, apoyo para comprender la lógica, utilidad de las explicaciones y experiencia con las herramientas. El instrumento docente revisó por separado el tutor conversacional, el depurador paso a paso, las actividades formativas y el reporte disponible para el profesor; también incluyó observaciones abiertas, banderas críticas y un dictamen global. El análisis mantuvo separadas ambas poblaciones porque cada instrumento responde a una pregunta diferente: la experiencia de uso en los escenarios estudiantiles y la alineación técnica y pedagógica observada por docentes. Para cada bloque se calcularon media, mediana y proporción de valoraciones situadas en los niveles 4 y 5. Esta estructura permite leer los agregados junto con los comentarios asociados a componentes concretos del sistema.

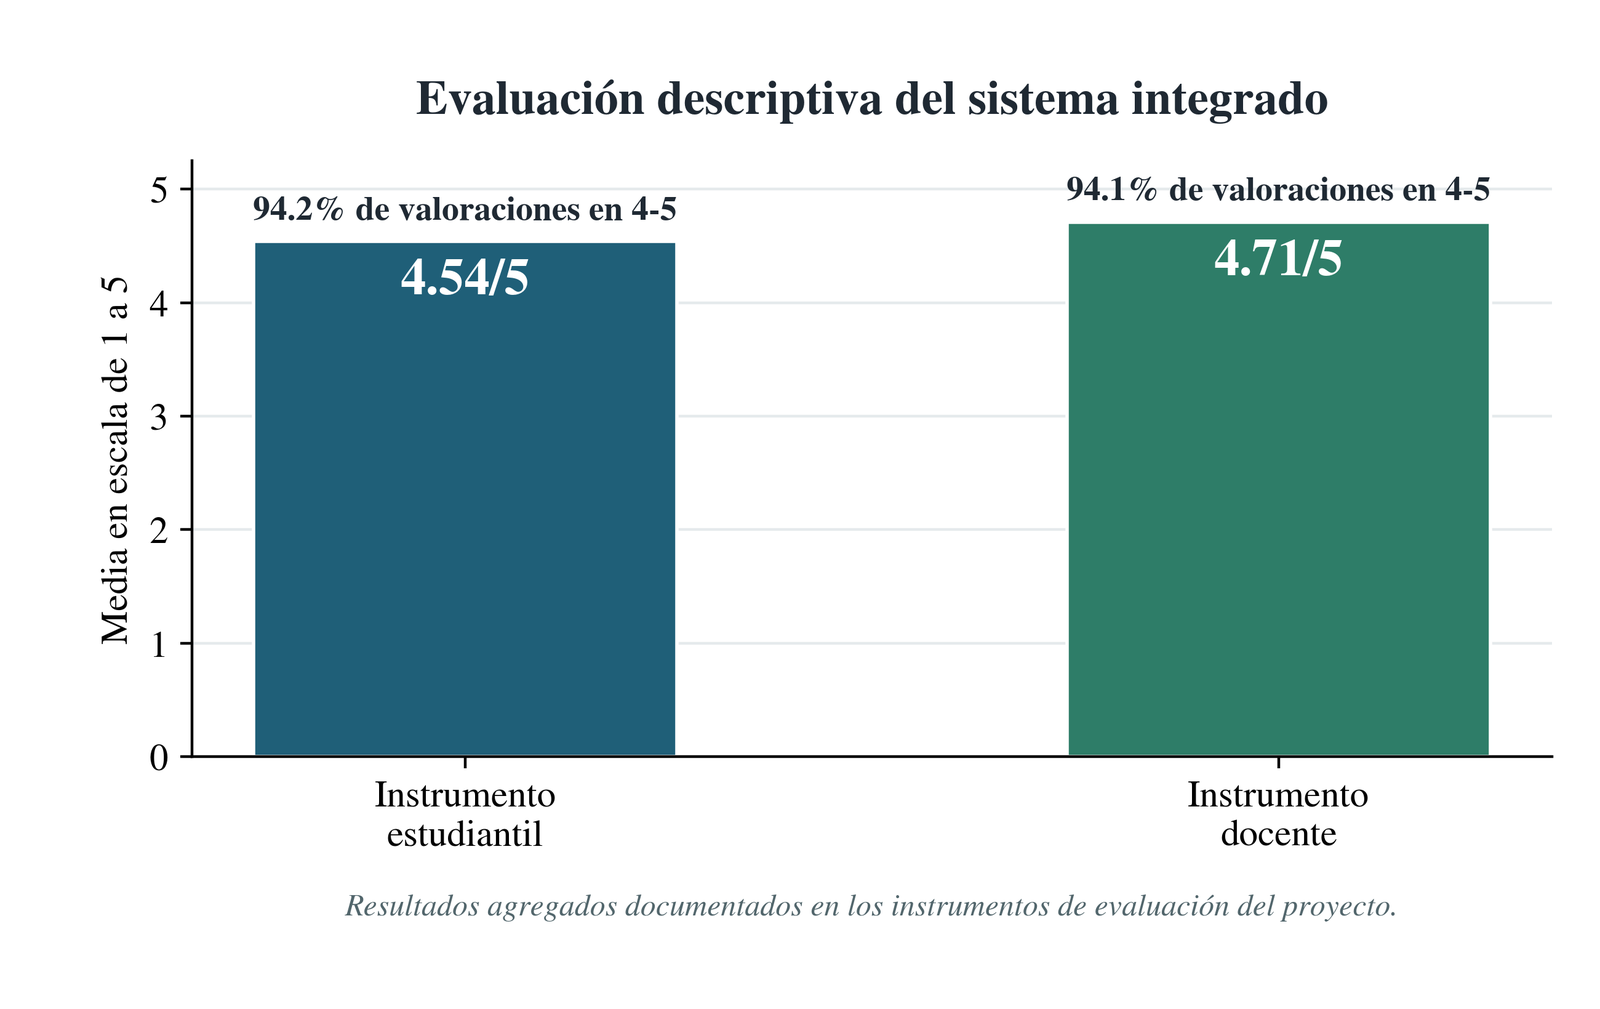
El instrumento estudiantil alcanzó una media global de 4.54 sobre 5, una mediana de 5 y un 94.2 % de valoraciones en los niveles 4 y 5. El escenario de arreglos unidimensionales obtuvo una media de 4.60; el escenario de matrices, 4.45; y el bloque de percepción general, 4.58. Los valores muestran una concentración favorable en los tres bloques y, al mismo tiempo, permiten localizar interacciones con menor claridad percibida. Las puntuaciones más bajas aparecieron en el apoyo sobre contadores y acumuladores, en el diagnóstico inicial del escenario de matrices y en una tarea de copia entre matrices. Las respuestas abiertas destacaron los ejemplos y la posibilidad de recibir explicaciones desde los fundamentos. También señalaron que el depurador era fácil de comprender y ayudaba a seguir el comportamiento del programa. Un comentario indicó que todavía no se dominaba el uso de punteros, lo que aporta contexto para interpretar esa parte de la experiencia sin convertir el promedio global en una descripción uniforme de cada concepto trabajado.

La síntesis docente documentó una media global de 4.71 sobre 5, mediana de 5 y 94.1 % de valoraciones en los niveles 4 y 5. El tutor conversacional obtuvo una media de 4.60 y el reporte al profesor, 4.50. El depurador paso a paso alcanzó 5.00 y concentró todas sus valoraciones válidas en el nivel máximo, el respaldo más uniforme entre los componentes examinados. Los comentarios docentes destacaron la ejecución por líneas, la visualización de variables y memoria y la posibilidad de seguir el flujo del programa. Ese resultado coincide con las menciones estudiantiles y respalda la decisión de integrar la depuración al espacio del tutor. Los dictámenes globales registrados utilizaron la categoría “Alineación suficiente para validación controlada”. La Figura 9 muestra el reporte revisable disponible para el profesor después de una actividad formativa. La Figura 10 conserva el diseño comparativo de la síntesis final y presenta únicamente los agregados globales documentados para estudiantes y docentes; los porcentajes corresponden a valoraciones de ítems ubicadas en los niveles superiores de sus respectivas escalas.
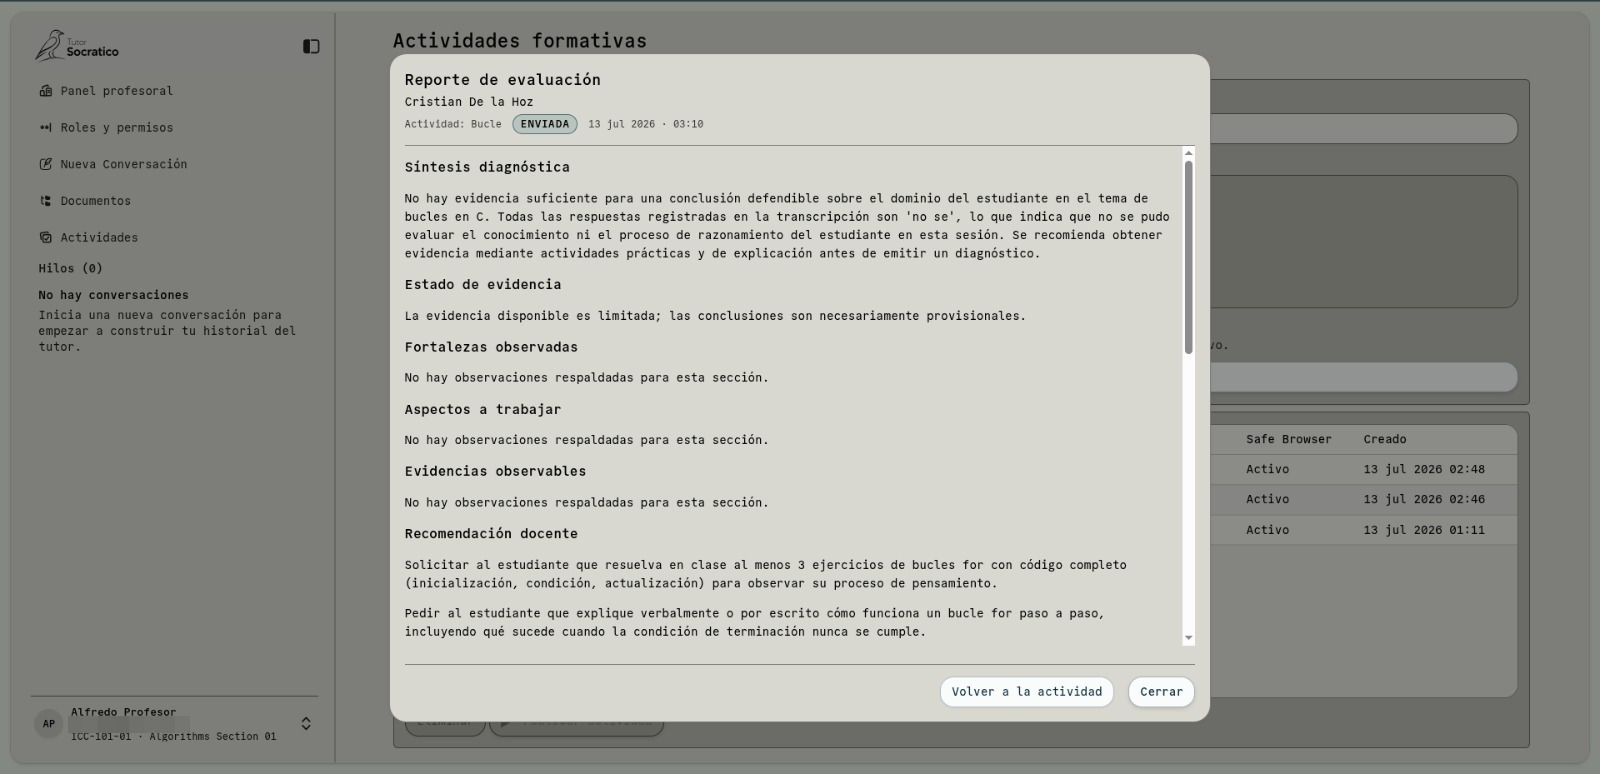
Reporte de evaluación disponible para el profesor después de una actividad formativa, con síntesis diagnóstica, estado de evidencia, observaciones y recomendación docente
Figura 9. Reporte de evaluación disponible para el profesor después de una actividad formativa, con síntesis diagnóstica, estado de evidencia, observaciones y recomendación docente. Fuente: Captura original del prototipo final conservada en el proyecto.
Síntesis de las medias globales y de la proporción de valoraciones ubicadas en los niveles 4 y 5 de cada instrumento
Figura 10. Síntesis de las medias globales y de la proporción de valoraciones ubicadas en los niveles 4 y 5 de cada instrumento. Fuente: Elaboración propia a partir de los resultados agregados documentados en el proyecto.

Los comentarios abiertos precisaron las prioridades de la siguiente iteración. En la experiencia estudiantil aparecieron solicitudes de mayor rapidez, una observación sobre la rigidez del tutor al aplicar sus restricciones y la preferencia por una apariencia clara o modo blanco. En la revisión docente se propuso incorporar un resumen de temas y un control para solicitar una explicación adicional. También se activó una alerta de posible error conceptual, conservada como caso para revisión. Estas observaciones se relacionan con componentes distintos y, por tanto, conducen a acciones de ingeniería separables: medir el tiempo hasta el primer fragmento y la duración total de la respuesta; calibrar la guardia con mensajes que dependan del turno anterior; ampliar las opciones de visualización; mantener el vínculo entre el informe y la transcripción; y facilitar la revisión de respuestas específicas. La estructura modular permite atender cada punto sin trasladar permisos, memoria o decisiones académicas al modelo de lenguaje.

La lectura conjunta de la evidencia sitúa el aporte principal en el sistema integrado. La conversación organiza preguntas, pistas y explicaciones; la guardia aplica la política antes de la memoria; la compactación conserva una transcripción real y prepara otra proyección para inferencia; el grounding entrega fragmentos revisados dentro de la clase autorizada; las actividades mantienen consignas, respuestas e informes vinculados; y el depurador convierte una ejecución real en instantáneas observables. El ajuste de Qwen3 documenta un cambio complementario en la forma de responder, mientras Ornith sostiene la operación evaluada dentro del harness. Los resultados globales y los dictámenes docentes respaldan la viabilidad funcional y la pertinencia académica de esta combinación para una validación controlada. Dentro de esa síntesis, el depurador sobresale por la uniformidad de su valoración y las actividades muestran cómo la inteligencia artificial puede incorporarse a un flujo preparado y revisado por el profesor, en lugar de quedar limitada a intercambios privados sin una evidencia organizada.

Conclusión

El proyecto alcanzó su objetivo de implementar un sistema de tutoría inteligente que orienta el razonamiento algorítmico mediante diálogo guiado y limita la generación de código como respuesta ordinaria. La solución final no depende exclusivamente de una instrucción socrática. Integra identidad académica, autorización contextual, guardia, memoria basada en eventos, compactación, recuperación documental, actividades formativas, informes y depuración visual de C dentro de un flujo coherente. Esta integración materializa el aporte técnico central: una arquitectura replicable cuyas responsabilidades permanecen separadas del modelo de lenguaje. Los servicios determinan el acceso y preparan el contexto; el modelo interpreta ese contexto y genera la intervención; las herramientas ejecutan operaciones delimitadas; y la persistencia conserva la evidencia asociada con la clase y la persona autorizada. La organización permite sustituir el artefacto de inferencia o adaptar el dominio académico sin reconstruir los límites de autorización, memoria y trazabilidad que sostienen la plataforma.

La memoria y las actividades muestran cómo esa arquitectura se traduce en operación académica. La primera conserva la transcripción real y construye una memoria sintética para el modelo, de modo que la continuidad conversacional no sustituya la evidencia literal del intercambio. Las actividades permiten al profesor redactar y revisar consignas, publicarlas, observar preguntas adaptativas y consultar un informe enlazado con la transcripción canónica. El depurador completa el acompañamiento con una representación ejecutable de líneas, variables, arreglos, matrices, memoria y salida del programa. Fue el componente con el respaldo más uniforme en el instrumento docente, con una media de 5.00, y también apareció en los comentarios estudiantiles como una herramienta fácil de comprender. En conjunto, la evaluación registró una media estudiantil de 4.54 sobre 5 y una media docente de 4.71, con medianas de 5 y una concentración de valoraciones en los niveles superiores de ambas escalas.

El ajuste de Qwen3 aportó un resultado complementario: en los escenarios examinados, el modelo pasó de iniciar con implementaciones extensas a diagnosticar, dividir el problema y ofrecer ayudas parciales. La selección posterior de Ornith reforzó una exigencia de la arquitectura: el modelo operativo debe sostener esa orientación mientras trabaja con memoria, materiales recuperados y herramientas. La evidencia reunida respalda el funcionamiento, la utilidad percibida y la alineación pedagógica del Tutor Socrático en una aplicación controlada. Las siguientes iteraciones tienen una ruta concreta: conservar el depurador como capacidad central, medir y reducir la latencia percibida, calibrar la guardia con mensajes dependientes del contexto, reforzar la revisión de respuestas y ampliar los informes de actividades sin perder su vínculo con la transcripción. Con estas prioridades, el proyecto establece una base técnica y académica para continuar validando una tutoría en la que la inteligencia artificial participa dentro de límites institucionales verificables y el razonamiento del estudiante permanece como objeto principal del acompañamiento.

Referencias

  1. J. M. Wing, “Computational thinking,” Communications of the ACM, vol. 49, no. 3, pp. 33-35, 2006, doi: 10.1145/1118178.1118215.
  2. J. Insuasti Portilla, “Problemas de enseñanza y aprendizaje de los fundamentos de programación,” Educación y Desarrollo Social, vol. 10, no. 2, pp. 234-246, 2016, doi: 10.18359/reds.1701.
  3. L. Beato-Castro, C. Hevia, L. Lehoux y L. A. Fermín-Genao, “Formación inicial y permanente de los docentes en pensamiento computacional: percepciones y preconcepciones en el contexto dominicano,” Cuaderno de Pedagogía Universitaria, vol. 20, no. 39, pp. 158-176, 2023, doi: 10.29197/cpu.v20i39.494.
  4. M. B. Garcia, “Teaching and learning computer programming using ChatGPT: A rapid review of literature amid the rise of generative AI technologies,” Education and Information Technologies, vol. 30, no. 12, pp. 16721-16745, 2025, doi: 10.1007/s10639-025-13452-5.
  5. J. Nathaniel, S. S. Oyelere, J. Suhonen y M. Tedre, “Literature review on the integration of generative AI in programming education,” International Journal of Artificial Intelligence in Education, vol. 35, no. 5, pp. 2724-2755, 2025, doi: 10.1007/s40593-025-00524-3.
  6. M. Abbas, F. A. Jam y T. I. Khan, “Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students,” International Journal of Educational Technology in Higher Education, vol. 21, art. 10, 2024, doi: 10.1186/s41239-024-00444-7.
  7. G. Fan, D. Liu, R. Zhang y L. Pan, “The impact of AI-assisted pair programming on student motivation, programming anxiety, collaborative learning, and programming performance,” International Journal of STEM Education, vol. 12, art. 16, 2025, doi: 10.1186/s40594-025-00537-3.
  8. Z. Ji et al., “Survey of hallucination in natural language generation,” ACM Computing Surveys, vol. 55, no. 12, 2023, doi: 10.1145/3571730.
  9. J. Yang y D.-M. Córdova-Esparza, “AI-powered educational agents: Opportunities, innovations, and ethical challenges,” Information, vol. 16, no. 6, art. 469, 2025, doi: 10.3390/info16060469.
  10. E. F. Risko y S. J. Gilbert, “Cognitive offloading,” Trends in Cognitive Sciences, vol. 20, no. 9, pp. 676-688, 2016, doi: 10.1016/j.tics.2016.07.002.
  11. M. O. Kelly y E. F. Risko, “Study effort and the memory cost of external store availability,” Cognition, vol. 228, art. 105228, 2022, doi: 10.1016/j.cognition.2022.105228.
  12. X. Lu, M. O. Kelly y E. F. Risko, “Offloading information to an external store increases false recall,” Cognition, vol. 205, art. 104428, 2020, doi: 10.1016/j.cognition.2020.104428.
  13. B. Jose, D. Joseph, V. Mohan, E. Alexander, S. K. Varghese y A. Roy, “Outsourcing cognition: The psychological costs of AI-era convenience,” Frontiers in Psychology, vol. 16, art. 1645237, 2025, doi: 10.3389/fpsyg.2025.1645237.
  14. G. Akçapınar y E. Sidan, “AI chatbots in programming education: Guiding success or encouraging plagiarism,” Discover Artificial Intelligence, vol. 4, art. 87, 2024, doi: 10.1007/s44163-024-00203-7.
  15. H. Bastani, O. Bastani, A. Sungu, H. Ge, Ö. Kabakcı y R. Mariman, “Generative AI without guardrails can harm learning: Evidence from high school mathematics,” Proceedings of the National Academy of Sciences, vol. 122, no. 26, 2025, doi: 10.1073/pnas.2422633122.
  16. M. Liffiton, B. Sheese, J. Savelka y P. Denny, “CodeHelp: Using large language models with guardrails for scalable support in programming classes,” in Proc. 23rd Koli Calling International Conf. Computing Education Research, art. 8, 2023, doi: 10.1145/3631802.3631830.
  17. R. Schmucker, M. Xia, A. Azaria y T. Mitchell, “Ruffle & Riley: Insights from designing and evaluating a large language model-based conversational tutoring system,” in Artificial Intelligence in Education, LNCS 14829, pp. 75-90, 2024, doi: 10.1007/978-3-031-64302-6_6.
  18. T. Noraset, A. Supratak, C. Ragkhitwetsagul, N. Worathong y S. Tuarob, “Evaluating lab assistant chatbot on student learning and behaviors in a programming short course,” Computers and Education: Artificial Intelligence, vol. 10, art. 100527, 2026, doi: 10.1016/j.caeai.2025.100527.
  19. L. Xi, Y. Zhang y Q. Wang, “Investigating the effects of an LLM-based Socratic conversational agent on students’ academic performance and reflective thinking in higher education,” Computers & Education, vol. 241, art. 105494, 2026, doi: 10.1016/j.compedu.2025.105494.
  20. S. Barke, M. B. James y N. Polikarpova, “Grounded Copilot: How programmers interact with code-generating models,” Proceedings of the ACM on Programming Languages, vol. 7, no. OOPSLA1, 2023, doi: 10.1145/3586030.
  21. J. D. Karpicke y J. R. Blunt, “Retrieval practice produces more learning than elaborative studying with concept mapping,” Science, vol. 331, no. 6018, pp. 772-775, 2011, doi: 10.1126/science.1199327.
  22. H. Tomisu, J. Ueda y T. Yamanaka, “The cognitive mirror: A framework for AI-powered metacognition and self-regulated learning,” Frontiers in Education, vol. 10, art. 1697554, 2025, doi: 10.3389/feduc.2025.1697554.
  23. P. Lewis et al., “Retrieval-augmented generation for knowledge-intensive NLP tasks,” in Advances in Neural Information Processing Systems, vol. 33, pp. 9459-9474, 2020.
  24. C. Zhou et al., “LIMA: Less is more for alignment,” in Advances in Neural Information Processing Systems, vol. 36, 2023.
  25. L. Chen et al., “AlpaGasus: Training a better Alpaca with fewer data,” in Proc. International Conference on Learning Representations, 2024.
  26. T. Dettmers, A. Pagnoni, A. Holtzman y L. Zettlemoyer, “QLoRA: Efficient finetuning of quantized LLMs,” in Advances in Neural Information Processing Systems, vol. 36, pp. 10088-10115, 2023.
SIGA: Una solución inteligente para la gestión del agua en viviendas dominicanas

Scarlett Betania Rodríguez Bravo y Alam Emilio Cordero – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La urgencia de modernizar la gestión del agua: un reto global y nacional

La gestión eficiente del agua constituye uno de los principales desafíos para el desarrollo sostenible debido al crecimiento de la población, el aumento del consumo y los efectos asociados al cambio climático [2]. La disponibilidad del recurso no depende únicamente de la existencia de fuentes naturales, sino también de la capacidad de administrarlas responsablemente, reducir las pérdidas y aprovechar fuentes alternativas. Esta situación ha impulsado el desarrollo de estrategias orientadas a modernizar los procesos de almacenamiento, distribución y consumo mediante tecnologías capaces de proporcionar información en tiempo real y facilitar una gestión basada en datos.

A esta problemática se suma la necesidad de considerar la relación entre el desarrollo tecnológico y el medio ambiente. Desde la perspectiva de la ecología humana, se plantea que las acciones y desarrollos humanos deben analizarse considerando su interacción con el entorno natural [3]. Bajo este enfoque, la tecnología puede representar un desafío cuando sus efectos ambientales no son considerados, pero también puede convertirse en una herramienta para favorecer el aprovechamiento responsable de los recursos naturales. En el ámbito hídrico, esto implica desarrollar soluciones que, además de automatizar procesos, contribuyan a reducir el desperdicio, aprovechar fuentes alternativas y promover una gestión sostenible del agua.

En la República Dominicana, esta necesidad adquiere especial importancia debido a las deficiencias existentes en la administración y distribución del recurso hídrico. A pesar de iniciativas como el Compromiso Nacional para un Pacto por el Agua 2021-2036, investigaciones han señalado problemas relacionados con la gestión de los consumos y las pérdidas en las redes de distribución, factores que pueden comprometer la sostenibilidad hídrica del país a largo plazo [1]. En numerosos hogares y establecimientos, además, la administración del agua almacenada continúa realizándose de manera manual, dificultando conocer con precisión la cantidad disponible, el consumo realizado y las condiciones de las diferentes fuentes de abastecimiento.

Otro aspecto relevante es el limitado aprovechamiento del agua de lluvia como fuente complementaria. La captación pluvial puede utilizarse para determinadas actividades secundarias, como limpieza o riego, reduciendo el uso innecesario del suministro público. Sin embargo, su incorporación requiere mecanismos capaces de conocer la disponibilidad del recurso y determinar cuándo resulta conveniente utilizar una fuente u otra. La ausencia de esta integración limita las posibilidades de administrar de manera conjunta el suministro público, el almacenamiento y la captación pluvial.

Frente a estas necesidades, diferentes investigaciones han explorado la automatización como alternativa para mejorar la gestión hídrica. Sharma [4], por ejemplo, propuso un sistema basado en Arduino orientado a la recolección, almacenamiento y distribución automática del agua de lluvia. Asimismo, sistemas de supervisión como SCADA permiten monitorear variables hidráulicas, detectar determinadas condiciones anormales y mejorar el control de procesos relacionados con el agua [5]. Estos antecedentes evidencian el potencial de integrar electrónica, comunicaciones y automatización para responder a problemas relacionados con la administración del recurso.

Dentro de este contexto, el Internet de las Cosas (IoT) proporciona herramientas que permiten conectar sensores, actuadores, microcontroladores y plataformas digitales para recopilar información y ejecutar acciones de manera automatizada. Variables como el nivel de almacenamiento, la presión y el caudal pueden ser supervisadas continuamente, mientras que protocolos de comunicación como MQTT permiten transmitir los datos entre dispositivos y sistemas de gestión. Microcontroladores como el ESP32 facilitan además la implementación de estas arquitecturas mediante capacidades de procesamiento y conectividad inalámbrica.

A partir de esta problemática surge el Sistema Inteligente de Gestión del Agua (SIGA), desarrollado por Scarlett Betania Rodríguez Bravo y Alam Emilio Cordero, estudiantes de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del Ing. Víctor Manuel Mancebo de León. El proyecto propone integrar diferentes fuentes de suministro de agua mediante una arquitectura IoT compuesta por sensores, actuadores, microcontroladores y una plataforma digital, con el propósito de monitorear las condiciones del sistema y gestionar el recurso de manera automatizada.

SIGA integra el suministro público y la captación pluvial mediante una lógica de control que permite tomar decisiones según la disponibilidad y las condiciones detectadas. El sistema monitorea variables como nivel, presión, caudal y consumo, establece comunicación en tiempo real entre los dispositivos, el servidor y la plataforma de gestión, y proporciona al usuario herramientas para visualizar el comportamiento de la infraestructura y configurar sus parámetros operativos. Además, incorpora información histórica y meteorológica como apoyo para el análisis y la gestión del recurso.

De esta manera, SIGA no se limita a automatizar una infraestructura hidráulica, sino que busca utilizar la tecnología como una herramienta para responder simultáneamente a una necesidad práctica y ambiental. El aprovechamiento del agua de lluvia, la supervisión del consumo, la detección de condiciones anormales y la gestión automatizada de las fuentes buscan contribuir a la reducción del desperdicio y a un uso más responsable del agua. El proyecto demuestra así cómo la integración de hardware, software y telecomunicaciones puede aplicarse al desarrollo de soluciones orientadas hacia una gestión hídrica más eficiente y sostenible.

Finalmente, la propuesta constituye un prototipo funcional que puede servir como referencia para futuras implementaciones en hogares, instituciones educativas, comercios y otros establecimientos que dispongan de sistemas de almacenamiento y distribución de agua. Aunque una implementación a mayor escala requiere adaptar la infraestructura hidráulica y dimensionar adecuadamente sus componentes, SIGA presenta un modelo tecnológico que evidencia el potencial del IoT para contribuir al desarrollo de edificaciones y ciudades inteligentes, utilizando la innovación tecnológica no solo para automatizar procesos, sino también para favorecer una relación más responsable con los recursos naturales.

Desconexión estructural: problemática en la gestión hídrica y límites del estado del arte

A pesar de los avances tecnológicos en el sector hídrico, la gestión del agua en viviendas y pequeños establecimientos continúa realizándose, en muchos casos, mediante mecanismos manuales o sistemas de automatización básicos que ofrecen escasa información sobre el estado del recurso. Esta situación dificulta conocer en tiempo real el nivel de almacenamiento, el consumo de agua y las condiciones de operación del sistema, limitando la capacidad de prevenir desperdicios y optimizar el uso de fuentes alternativas como la captación de agua de lluvia [1], [5].

En la República Dominicana, esta realidad se acentúa debido a las variaciones en el suministro de agua potable y a la dependencia de depósitos de almacenamiento para garantizar la disponibilidad del servicio. Aunque el agua de lluvia representa un recurso con un importante potencial de aprovechamiento, en la mayoría de las edificaciones no existen mecanismos que permitan administrarla de forma automática junto con la red pública. Como resultado, el agua potable continúa utilizándose en actividades que no requieren calidad para consumo humano, como el riego de jardines, la limpieza de patios o el lavado de vehículos, reduciendo la eficiencia en el aprovechamiento del recurso [5], [6].

La falta de monitoreo también dificulta la detección temprana de fugas, fallos en bombas o problemas de abastecimiento. En muchos casos, los usuarios desconocen el estado real de sus reservas de agua hasta que ocurre una interrupción del servicio o se presenta una avería en el sistema hidráulico. La ausencia de información en tiempo real limita la toma de decisiones y favorece el desperdicio de agua y energía, especialmente en instalaciones donde el llenado y el cambio entre fuentes de suministro continúan dependiendo de la intervención humana [1].

Además de afectar la disponibilidad del recurso, esta forma tradicional de administración incrementa la dependencia de la supervisión constante por parte del usuario. Es frecuente que las personas deban verificar manualmente el nivel de los depósitos, activar bombas de agua o cambiar el suministro entre distintas fuentes según su experiencia o percepción del estado del sistema. Estas actividades, aunque sencillas, pueden provocar errores humanos que derivan en reboses de depósitos, funcionamiento en seco de las bombas, consumo innecesario de energía eléctrica o interrupciones inesperadas en el abastecimiento. La automatización de estos procesos representa una oportunidad para mejorar tanto la eficiencia operativa como la comodidad del usuario final.

Por otra parte, el crecimiento de las tecnologías inteligentes ha impulsado una transformación significativa en la forma en que se diseñan los sistemas de monitoreo y control. La disponibilidad de sensores electrónicos de bajo costo, redes inalámbricas y plataformas de desarrollo abiertas ha permitido que soluciones anteriormente reservadas para aplicaciones industriales puedan implementarse también en viviendas y pequeñas empresas. Este cambio ha favorecido el desarrollo de sistemas IoT capaces de recopilar información continuamente y transmitirla a plataformas digitales para facilitar la supervisión remota y la toma de decisiones basada en datos [1], [2].

Diversas investigaciones han demostrado que el Internet de las Cosas constituye una alternativa viable para modernizar la gestión hídrica mediante el uso de sensores, actuadores y plataformas de monitoreo remoto. Sistemas basados en ESP32, Arduino y protocolos de comunicación ligeros como MQTT permiten supervisar variables hidráulicas y automatizar procesos de forma más eficiente que los mecanismos tradicionales, además de ofrecer acceso remoto a la información del sistema [1], [2], [3], [6].

La literatura científica también destaca la importancia de utilizar arquitecturas de comunicación ligeras y escalables para garantizar el intercambio eficiente de información entre dispositivos conectados. Protocolos como MQTT han demostrado ofrecer un excelente desempeño en aplicaciones donde múltiples sensores deben transmitir información de forma continua utilizando un ancho de banda reducido. Asimismo, el empleo de plataformas de desarrollo modernas facilita la integración entre el hardware instalado en campo y aplicaciones web o móviles que permiten visualizar el estado del sistema desde cualquier ubicación con acceso autorizado [2], [3].

En cuanto a la instrumentación, los avances recientes han permitido incorporar sensores de nivel, presión y caudal con mayor precisión y confiabilidad, ampliando considerablemente las posibilidades de supervisión. La combinación de estas variables proporciona una visión más completa del comportamiento hidráulico del sistema, permitiendo identificar anomalías operativas, verificar el correcto funcionamiento de bombas y válvulas, y conocer el consumo de agua con un mayor nivel de detalle. La integración de múltiples sensores también incrementa la confiabilidad de la información obtenida, ya que permite validar el comportamiento del sistema a partir de diferentes mediciones físicas [4].

Sin embargo, gran parte de las soluciones reportadas en la literatura se enfocan únicamente en la supervisión del nivel del agua o en la automatización del llenado de depósitos, sin integrar múltiples variables hidráulicas dentro de un mismo sistema de decisión. Asimismo, muchos desarrollos funcionan como prototipos experimentales y no incorporan una plataforma de monitoreo integral que permita visualizar el estado del sistema, generar alertas y facilitar la interacción del usuario con la infraestructura instalada [1], [2].

De igual forma, numerosas soluciones existentes fueron diseñadas para resolver problemas específicos y presentan limitaciones cuando se pretende ampliar sus funcionalidades. Algunos sistemas carecen de interfaces gráficas que faciliten la interpretación de los datos por parte del usuario, mientras que otros no permiten integrar nuevas fuentes de información ni modificar fácilmente las reglas de operación. Esta falta de flexibilidad dificulta su adaptación a distintos escenarios de uso y limita su aplicación en proyectos de mayor alcance orientados a la gestión inteligente del agua.

En este contexto, surge la necesidad de desarrollar una solución que combine monitoreo en tiempo real, automatización, conectividad y facilidad de uso dentro de una arquitectura de bajo costo y adaptable a entornos residenciales. El proyecto SIGA responde a esta necesidad mediante la integración de sensores, dispositivos de control, comunicaciones IoT y una plataforma web que permite administrar de forma inteligente el uso del agua proveniente tanto de la red pública como de la captación pluvial, contribuyendo a una gestión más eficiente y sostenible del recurso hídrico [1], [2], [5].

Más allá del desarrollo de un prototipo funcional, SIGA busca demostrar que la integración de tecnologías ampliamente disponibles puede convertirse en una alternativa viable para promover un uso más racional del agua en el contexto dominicano. La combinación de monitoreo continuo, automatización de procesos y visualización de información en tiempo real proporciona a los usuarios herramientas que favorecen una administración más eficiente del recurso, reducen la dependencia de operaciones manuales y contribuyen a la adopción de prácticas sostenibles. De esta manera, el proyecto se posiciona como una propuesta que integra los avances reportados en la literatura con las necesidades específicas de los hogares y pequeñas edificaciones, ofreciendo una solución tecnológica adaptable, escalable y orientada a mejorar la gestión hídrica mediante el uso del Internet de las Cosas.

Objetivos completados

El desarrollo del Sistema Inteligente de Gestión del Agua (SIGA) permitió cumplir el objetivo general de diseñar e implementar una solución inteligente orientada a optimizar la administración del agua en entornos residenciales mediante la integración de tecnologías de Internet de las Cosas (IoT), automatización y monitoreo en tiempo real. Este objetivo respondió a la necesidad de ofrecer una alternativa tecnológica que permitiera mejorar el aprovechamiento del recurso hídrico, reducir la dependencia de procesos manuales y facilitar la toma de decisiones relacionadas con el abastecimiento de agua. Para alcanzar este propósito se diseñó e implementó una infraestructura instrumentada con sensores ultrasónicos para la medición del nivel de agua, sensores de presión para supervisar las condiciones de suministro, caudalímetros para registrar el flujo de agua, válvulas solenoides para controlar automáticamente la distribución entre las diferentes fuentes y bombas de agua controladas mediante microcontroladores ESP32, permitiendo la integración de todos los dispositivos dentro de una misma arquitectura inteligente. Asimismo, se desarrolló una lógica de control encargada de gestionar automáticamente la conmutación entre la red pública y el sistema de captación pluvial de acuerdo con las condiciones detectadas por los sensores, priorizando la utilización del agua almacenada cuando las condiciones del sistema lo permitieran y garantizando la continuidad del suministro cuando fuera necesario recurrir al acueducto. De igual manera, se implementó una arquitectura de comunicaciones basada en el protocolo MQTT para la transmisión eficiente de información entre los dispositivos IoT y la plataforma de monitoreo, permitiendo la actualización continua de las variables hidráulicas y facilitando la supervisión remota del sistema. Como complemento, se desarrolló una plataforma web que permite visualizar en tiempo real el nivel de los depósitos, el estado de los dispositivos, los valores registrados por los sensores y las principales variables hidráulicas, además de ofrecer herramientas para la administración del sistema y la generación de notificaciones ante eventos relevantes. La integración de estos componentes permitió validar el funcionamiento del prototipo bajo diferentes escenarios de operación, demostrando que es posible implementar una solución de bajo costo, escalable y adaptable para optimizar la gestión del agua en viviendas y pequeñas edificaciones. En conjunto, los objetivos específicos alcanzados evidencian la viabilidad técnica de combinar automatización, comunicaciones inalámbricas y monitoreo inteligente en una única plataforma capaz de contribuir al uso más eficiente del recurso hídrico y de servir como base para futuras investigaciones y desarrollos orientados a la construcción de infraestructuras residenciales más sostenibles e inteligentes.

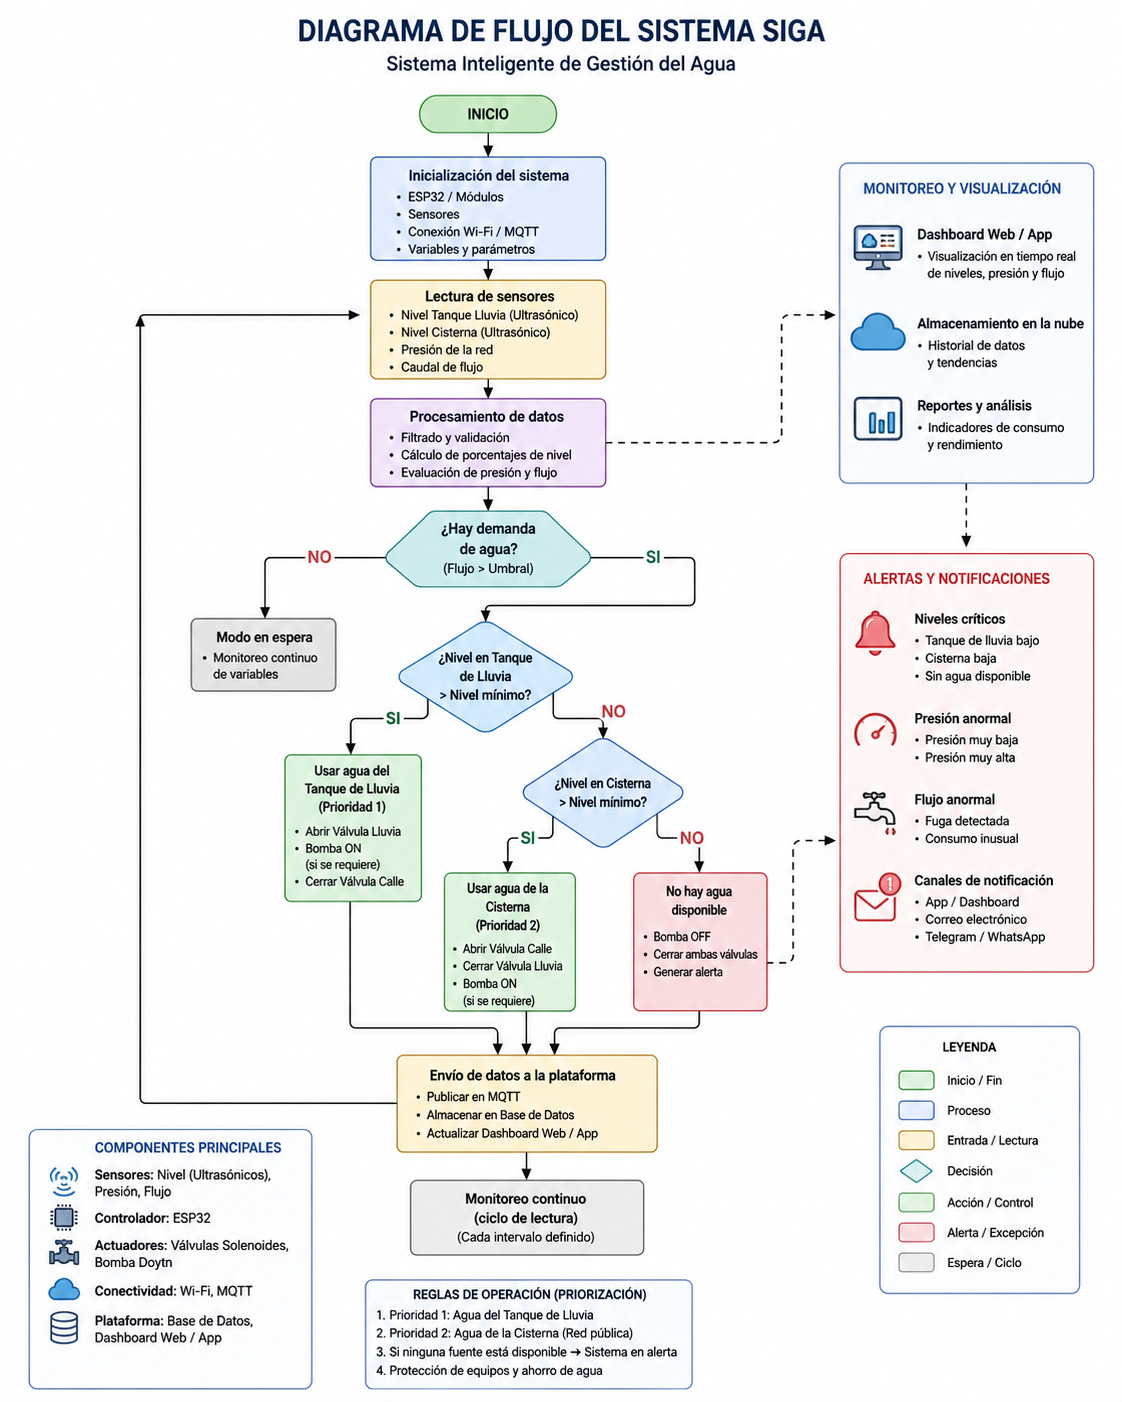
Diagrama de flujo del sistema SIGA: lectura de sensores, decisión entre tanque de lluvia y cisterna, envío de datos y alertas
Figura 1. Diagrama de funcionamiento.

Metodología y arquitectura técnica: hardware en el borde y lógica algorítmica

La construcción del sistema SIGA se desarrolló siguiendo una metodología de trabajo organizada por etapas, lo que permitió avanzar de manera progresiva en el diseño, la integración y las pruebas de cada uno de sus componentes. Este enfoque facilitó realizar mejoras continuas durante el desarrollo, corrigiendo errores y agregando nuevas funciones conforme el sistema evolucionaba. Gracias a ello, fue posible obtener una solución más estable y adaptada a las necesidades planteadas desde el inicio del proyecto.

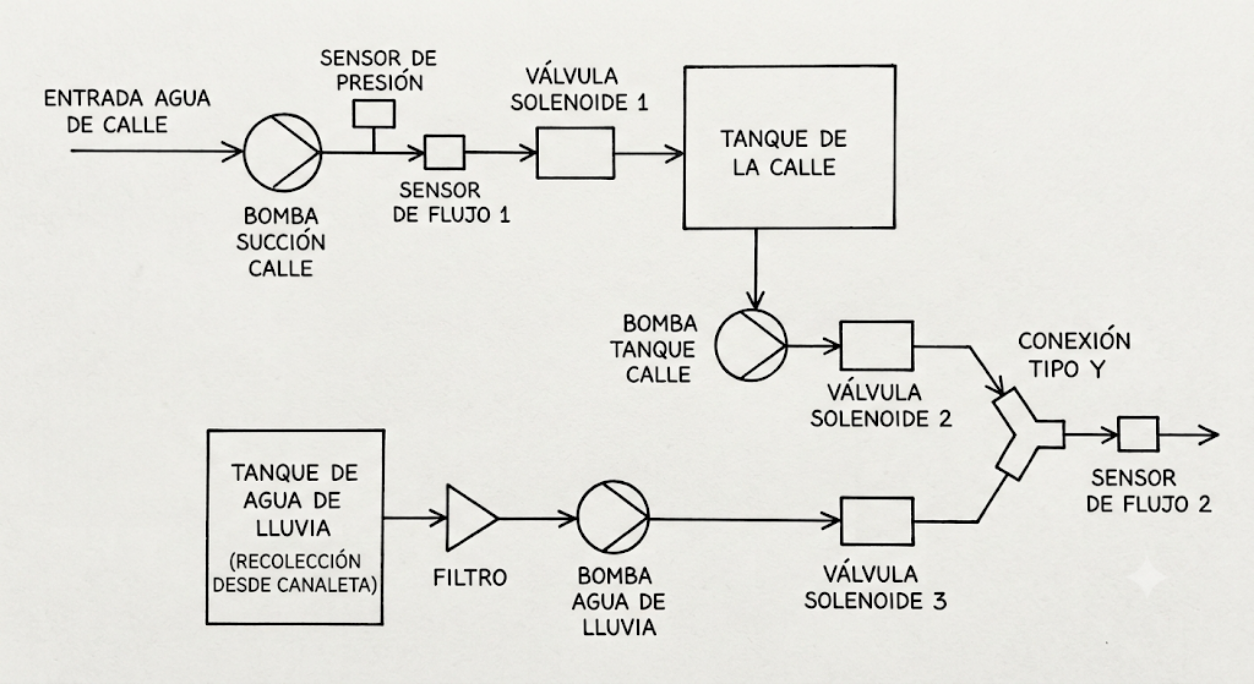
Diagrama hidráulico: bombas, sensores de presión y flujo, válvulas solenoides, tanque de la calle y tanque de agua de lluvia
Figura 2. Arquitectura del sistema.

El sistema fue diseñado para supervisar de forma constante el estado de los depósitos de agua mediante sensores que permiten conocer el nivel disponible sin necesidad de contacto directo. Esta mejora sustituyó métodos tradicionales que presentaban limitaciones por desgaste o menor precisión con el paso del tiempo. De esta manera, se obtuvo un monitoreo más confiable y con menor necesidad de mantenimiento, contribuyendo a una mejor administración del recurso hídrico.

Además del nivel del agua, SIGA también registra información relacionada con el flujo y la presión del suministro. Estos datos permiten identificar situaciones como una disminución en el abastecimiento, un consumo fuera de lo habitual o posibles fallas en la distribución. Al disponer de esta información en tiempo real, el sistema puede tomar decisiones más acertadas para garantizar la continuidad del servicio y optimizar el uso del agua.

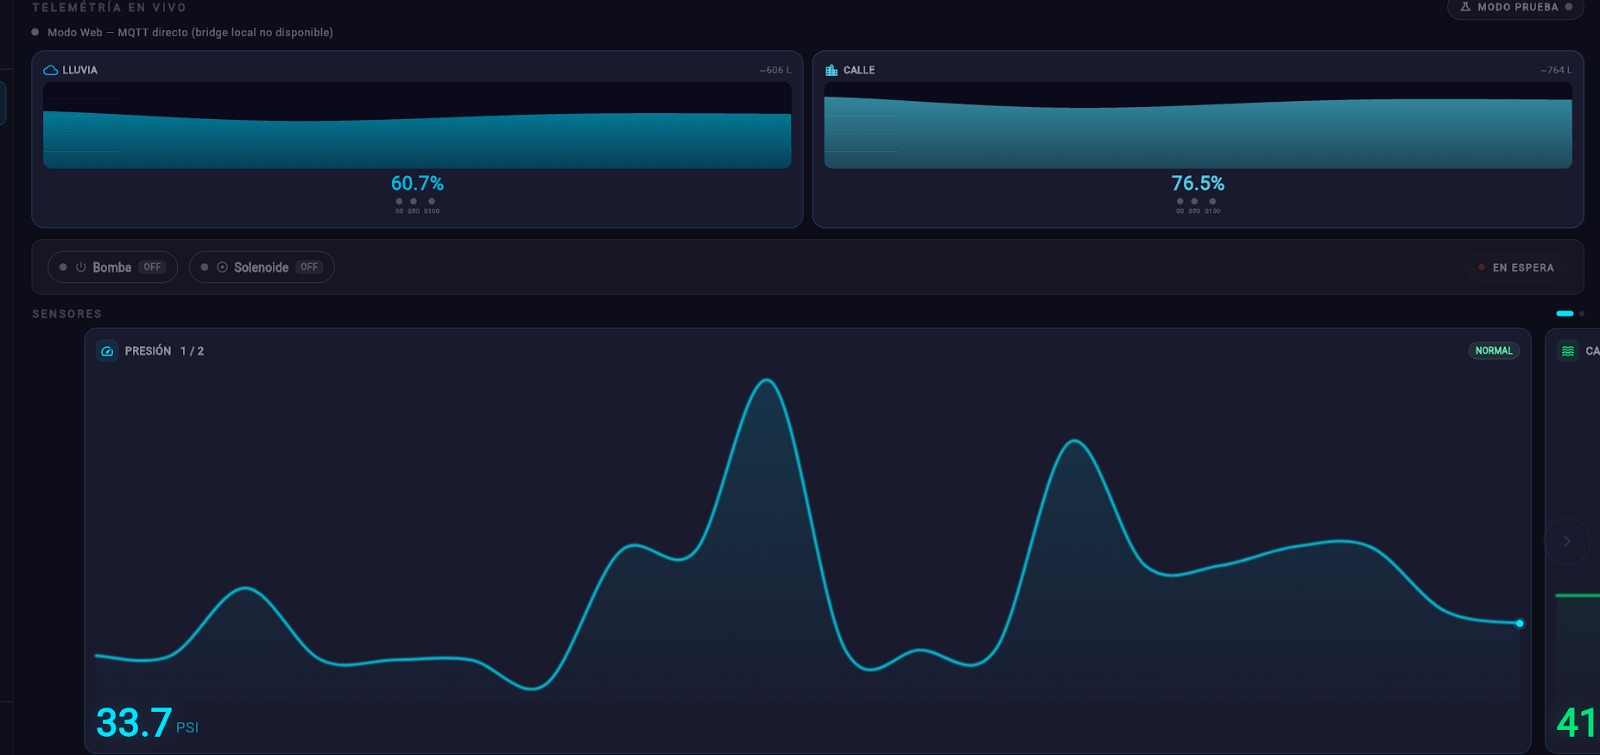
Dashboard web con el nivel de los tanques de lluvia y calle, estado de bomba y solenoide y gráfica de presión
Figura 3. Dashboard de la web.

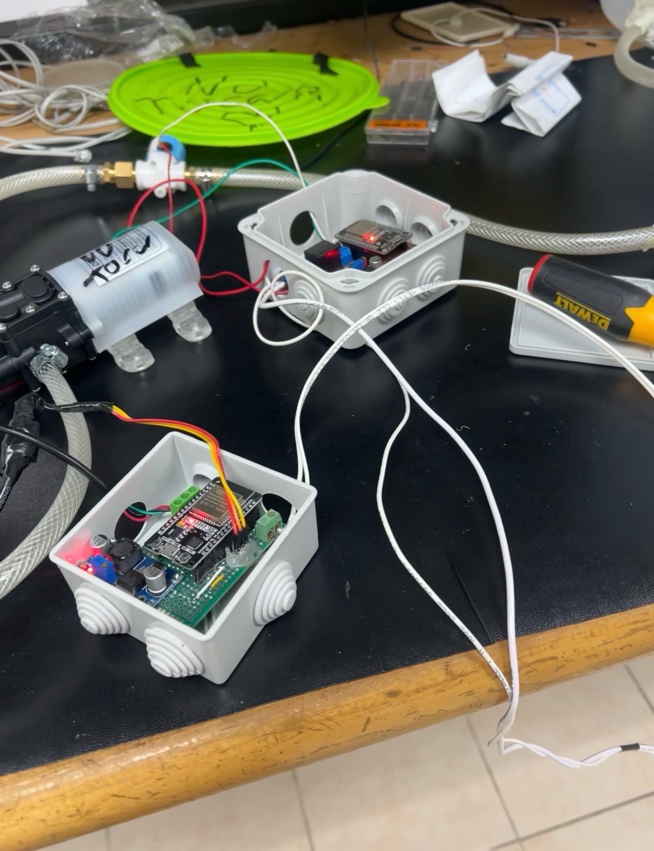
Para controlar el paso del agua entre las diferentes fuentes de abastecimiento, el sistema incorpora válvulas y bombas que se activan automáticamente cuando las condiciones lo requieren. Este funcionamiento evita la intervención constante del usuario y permite que el cambio entre las distintas fuentes se realice de manera ordenada y segura. Asimismo, se implementaron mecanismos de protección para asegurar el funcionamiento continuo de los equipos y prolongar su vida útil.

Prototipo: cajas de conexión con ESP32 y placas de control junto a una bomba de agua y mangueras
Figura 4. Circuitos protegidos de la bomba y la válvula.

Todos los dispositivos del sistema se encuentran conectados entre sí y envían la información recopilada hacia un servidor central, donde los datos son organizados y procesados. Esta comunicación permite que el estado del sistema esté disponible en todo momento y que las acciones necesarias puedan ejecutarse de forma rápida cuando se detecta algún cambio importante [3].

La información recopilada también se almacena para mantener un historial del comportamiento del sistema. Este registro facilita consultar el consumo de agua, revisar eventos anteriores y analizar el funcionamiento general de la instalación. Además, los usuarios pueden acceder a esta información desde una aplicación web o móvil, donde es posible visualizar el estado del sistema de forma sencilla y en tiempo real [6].

Uno de los aspectos más innovadores de SIGA es su capacidad para tomar decisiones automáticamente a partir de la información que recibe. En lugar de limitarse únicamente a mostrar datos, el sistema analiza las condiciones existentes y determina cuándo utilizar cada fuente de agua, cuándo activar las bombas y cuándo generar alertas para el usuario. Esta característica reduce el desperdicio de agua y mejora la eficiencia del proceso de distribución.

Como complemento, el sistema considera el comportamiento histórico del consumo para adaptar su funcionamiento con el paso del tiempo. También consulta información sobre las condiciones climáticas para anticipar posibles lluvias y recomendar estrategias que permitan aprovechar mejor el agua disponible. Esta capacidad de adaptación representa una diferencia importante respecto a los sistemas convencionales, ya que convierte a SIGA en una herramienta que no solo supervisa el recurso hídrico, sino que también contribuye a una gestión más eficiente, preventiva e inteligente del agua.

Resultados

Con el objetivo de validar el funcionamiento del Sistema Inteligente de Gestión del Agua (SIGA), se realizaron diferentes pruebas en un prototipo instalado en un ambiente controlado que simuló el funcionamiento de una vivienda. Durante estas pruebas se evaluó el monitoreo del nivel de agua, el cambio automático entre las fuentes de abastecimiento, el envío de alertas, el registro de información y el funcionamiento de la plataforma web.

Los resultados obtenidos demostraron que el sistema cumplió con los objetivos planteados durante el desarrollo. Los sensores registraron correctamente el nivel de agua de ambas cisternas, mientras que el sistema respondió automáticamente cuando fue necesario cambiar entre el agua de lluvia y la red pública. Además, toda la información fue visualizada en tiempo real desde la plataforma web.

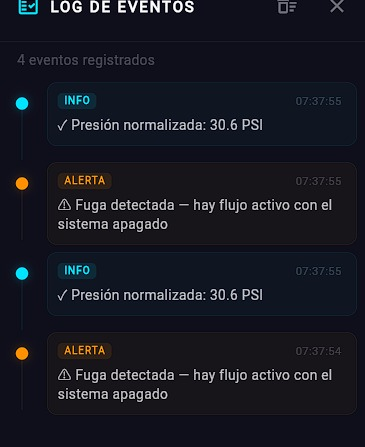
Log de eventos de la plataforma con alertas de fuga detectada y avisos de presión normalizada
Figura 5. Plataforma web mostrando las alertas del sistema.

Durante las pruebas de monitoreo se verificó que las mediciones realizadas por los sensores ultrasónicos fueron consistentes y permitieron conocer el nivel de agua de forma continua. La aplicación web actualizó la información pocos segundos después de producirse cualquier cambio en el sistema, permitiendo al usuario supervisar el estado de las cisternas desde cualquier dispositivo conectado.

En las pruebas de conmutación automática se simuló el vaciado de la cisterna de agua de lluvia. Una vez alcanzado el nivel mínimo establecido, el sistema cerró automáticamente esa fuente de suministro y habilitó la alimentación desde la red pública, manteniendo el flujo de agua sin intervención del usuario.

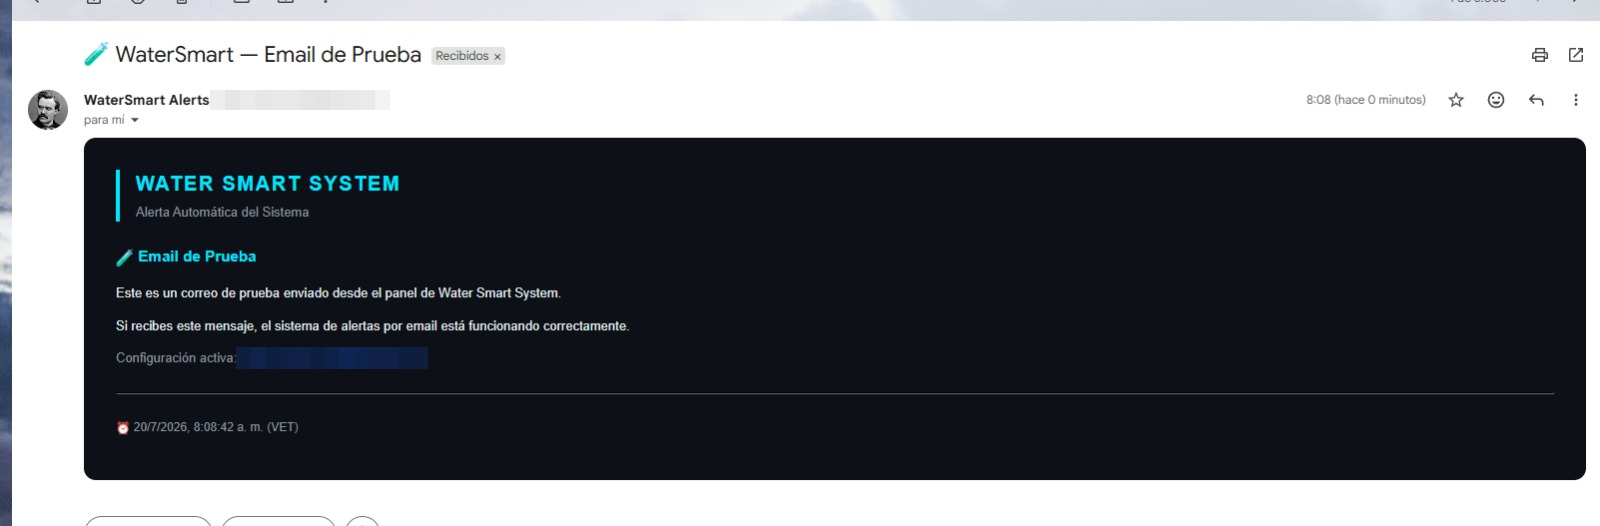
También se evaluó el sistema de alertas. Cuando se simuló una condición anormal, como la ausencia de flujo de agua o una posible fuga, la plataforma registró el evento y envió una notificación al usuario mediante correo electrónico. Esto permitió comprobar que el sistema puede informar oportunamente situaciones que requieren atención.

Correo electrónico de prueba enviado por el sistema de alertas
Figura 6. Notificación enviada por correo electrónico.

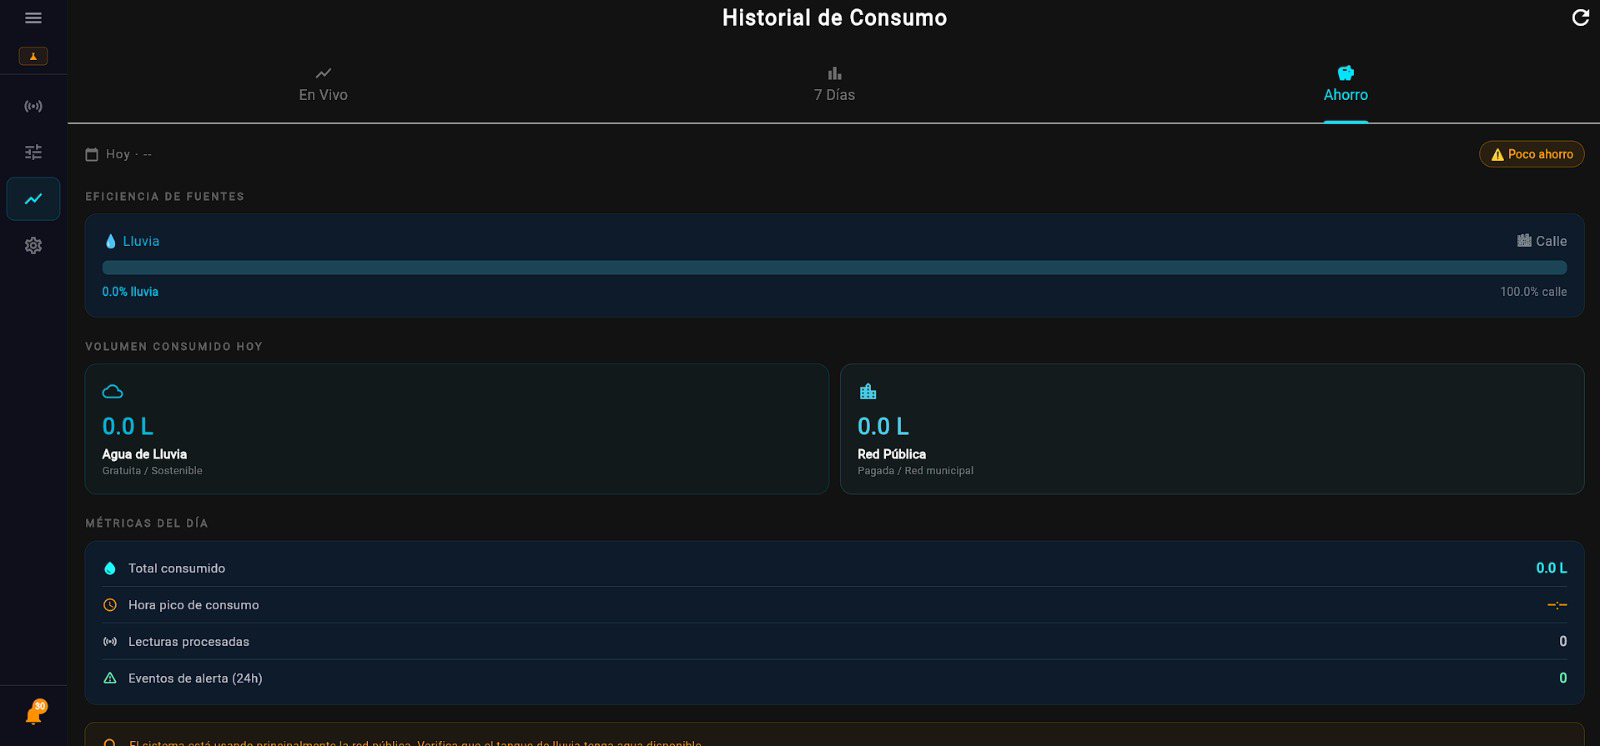
Otro aspecto evaluado fue el registro histórico de la información. Todas las mediciones generadas por los sensores fueron almacenadas en la base de datos y posteriormente representadas mediante gráficos dentro de la plataforma web. Esto facilita el seguimiento del consumo de agua y permite identificar tendencias de uso con el paso del tiempo.

Pantalla de historial de consumo con eficiencia de fuentes, volumen consumido y métricas del día
Figura 7. Historial de consumo en la plataforma web.

Finalmente, se realizaron pruebas desconectando temporalmente la conexión a Internet. Durante este período el sistema continuó controlando las bombas y válvulas utilizando la información disponible en los sensores. Una vez restablecida la conexión, los datos fueron sincronizados nuevamente con la plataforma, demostrando que el sistema puede seguir funcionando incluso cuando no existe comunicación con el servidor.

Área evaluadaPrueba realizadaResultado obtenido
Monitoreo del nivelMedición continua de ambas cisternasLecturas estables y actualización correcta en la plataforma
Cambio de fuenteVaciado de la cisterna de lluviaCambio automático hacia la red pública
Plataforma webVisualización de datosInformación mostrada en tiempo real
Sistema de alertasSimulación de fuga y ausencia de flujoNotificación enviada al usuario por correo electrónico
HistorialRegistro continuo de medicionesDatos almacenados correctamente en la base de datos
Funcionamiento sin InternetDesconexión temporal de la redEl sistema continuó operando y sincronizó la información al reconectarse
Tabla 1. Resultados obtenidos durante las pruebas.

En comparación con otros proyectos de monitoreo de agua reportados en la literatura, SIGA incorpora en una sola plataforma el monitoreo del nivel de agua, el cambio automático entre dos fuentes de abastecimiento, el almacenamiento del historial, el envío de alertas y la consulta desde una aplicación web. Esta integración permite ofrecer una solución más completa para la gestión del agua en viviendas.

Conclusión

El desarrollo del Sistema Inteligente de Gestión del Agua (SIGA) permitió demostrar que es posible administrar de manera automática dos fuentes de abastecimiento de agua mediante el uso de sensores, dispositivos electrónicos y una plataforma web de monitoreo. Los resultados obtenidos durante las pruebas confirmaron que el sistema cumple con los objetivos propuestos, ofreciendo una solución que facilita el aprovechamiento del agua de lluvia y reduce la dependencia de la red pública.

Uno de los principales aprendizajes obtenidos durante el desarrollo fue la importancia de integrar el hardware y el software de manera coordinada para lograr un funcionamiento confiable. La sustitución de los sensores de nivel inicialmente considerados por sensores ultrasónicos permitió mejorar la estabilidad de las mediciones, mientras que la implementación de un sistema de monitoreo en tiempo real facilitó el seguimiento del comportamiento de todo el sistema.

El proyecto también demuestra que un sistema puede considerarse inteligente sin utilizar modelos avanzados de inteligencia artificial. En el caso de SIGA, la toma de decisiones se basa en reglas previamente definidas, información proporcionada por los sensores y el análisis de las condiciones del sistema, permitiendo automatizar tareas que normalmente requerirían la intervención del usuario.

Como trabajo futuro, se propone incorporar sensores que permitan evaluar la calidad del agua, integrar una fuente de alimentación mediante paneles solares para aumentar la autonomía del sistema y desarrollar modelos predictivos que ayuden a estimar el consumo de agua según el comportamiento histórico y las condiciones climáticas.

En conclusión, SIGA representa una alternativa tecnológica para mejorar la gestión del agua en viviendas, promoviendo un uso más eficiente de este recurso. Se espera que este proyecto pueda continuar evolucionando mediante futuras investigaciones y pruebas en escenarios reales, contribuyendo al desarrollo de soluciones sostenibles para el aprovechamiento del agua en la República Dominicana.

Referencias

  1. J. A. P. Al-Shurman, B. A. M. Abdullah, and M. I. I. A. Ahmed, “A comprehensive review of IoT-based smart water management systems,” IEEE Access, vol. 9, pp. 112111–112130, 2021.
  2. K. Hassan, “Development of a real-time monitoring system using Flutter and MQTT protocol for IoT applications,” J. Sensors, vol. 2022, pp. 1–12, 2022.
  3. S. Kumar, “Low-cost smart home automation using ESP32 and MQTT,” Int. J. Comput. Sci. Eng., vol. 18, no. 5, pp. 202–210, 2020.
  4. A. S. Morris and R. Langari, Measurement and Instrumentation: Theory and Application, 3rd ed. Oxford, UK: Elsevier, 2020.
  5. E. Rodríguez, A. L. Peña, and J. M. García, “An IoT-enabled architecture for efficient urban water distribution in developing economies,” Int. J. Eng. Telematics, vol. 5, no. 2, pp. 45–56, 2022.
  6. V. Sharma, “Arduino Based Smart Water Management,” International Journal of Engineering Research and Technology, vol. 9, Sep. 2020, doi: 10.17577/IJERTV9IS080239.

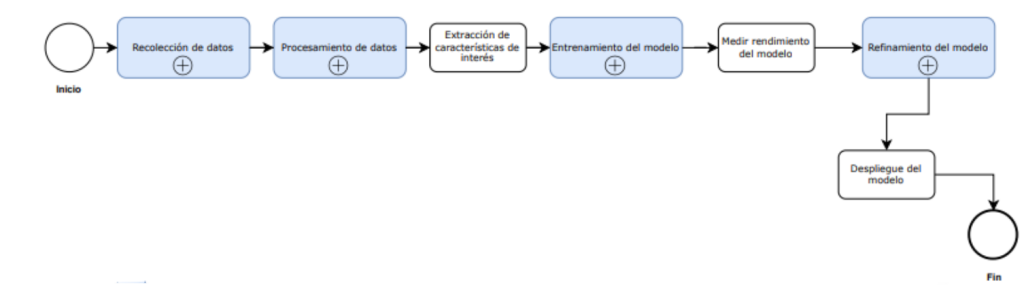
SIEMIA: Sistema para la Interpretación de Electrocardiogramas Mediante Machine Learning para la Detección Temprana de Arritmias

María Isabel Tiburcio Arias y Fernando Elías Rodríguez Bueno – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Las enfermedades cardiovasculares continúan siendo, año tras año, una de las principales causas de muerte a nivel mundial, y dentro de ellas las arritmias cardíacas ocupan un lugar de especial relevancia por su capacidad de manifestarse de forma silenciosa, intermitente o súbita. Desde la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la Pontificia Universidad Católica Madre y Maestra (PUCMM), un equipo conformado por María Isabel Tiburcio Arias y Fernando Elías Rodríguez Bueno, desarrolla SIEMIA: un Sistema para la Interpretación de Electrocardiogramas Mediante Machine Learning para la Detección Temprana de Arritmias.

La motivación detrás de este proyecto surge de una realidad muy concreta dentro de los centros de salud dominicanos y latinoamericanos: la lectura del electrocardiograma (ECG) aún depende, en gran medida, de las experiencias del especialista. En una entrevista realizada como parte de la investigación, el cardiólogo Dr. Samuel Ramos señaló que, en horas de mayor demanda, puede llegar a recibir entre 20 y 40 electrocardiogramas diarios, un volumen que naturalmente incrementa la presión diagnóstica y el riesgo de pasar por alto hallazgos relevantes. Esta necesidad de apoyo tecnológico, y no de reemplazo del criterio médico, es el punto de partida de SIEMIA.

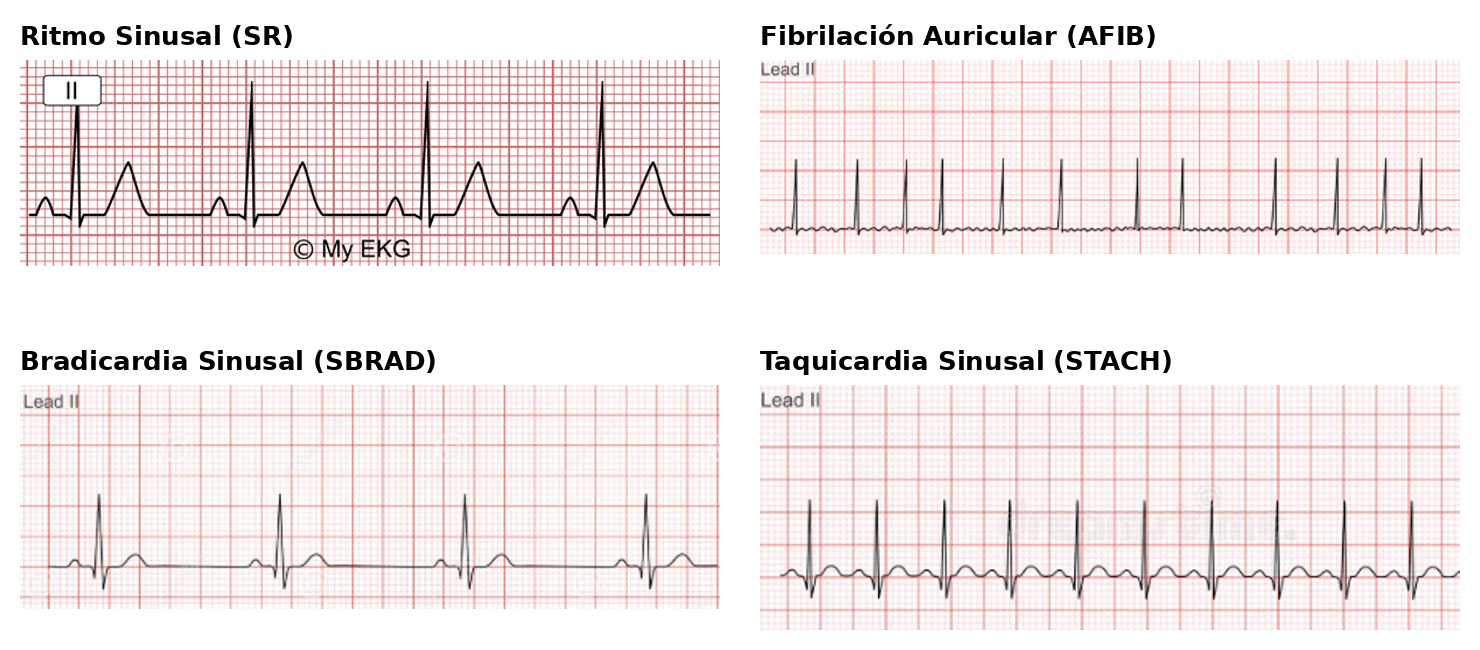
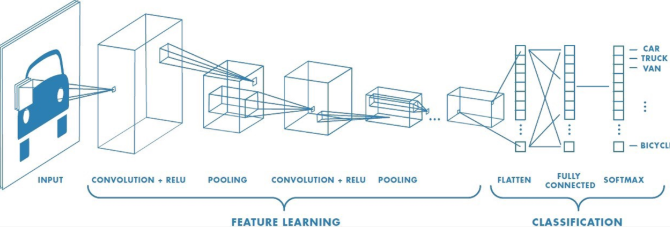
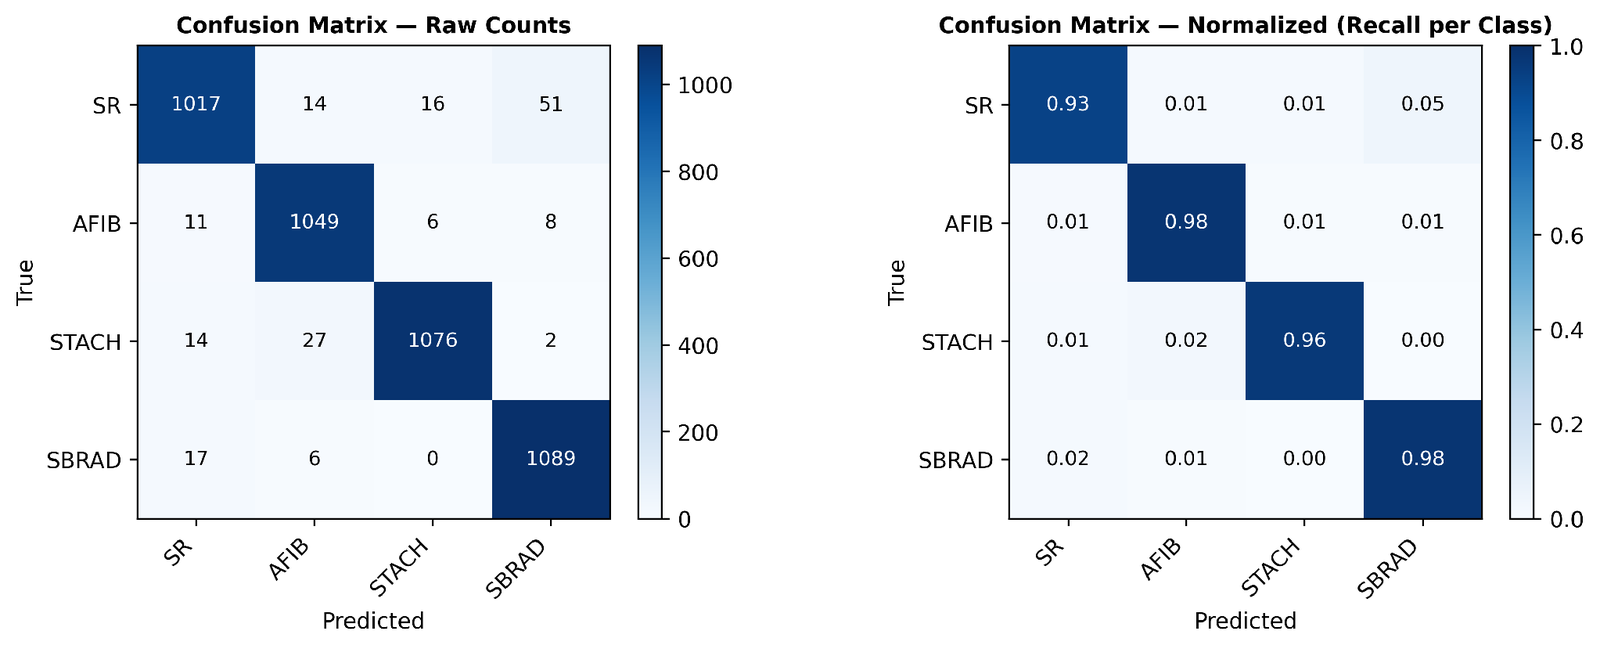
El proyecto propone el desarrollo de un sistema basado en técnicas de Machine Learning y Deep Learning capaz de analizar señales de electrocardiograma y aprender los patrones asociados a distintas anomalías del ritmo cardíaco. Puntualmente, el sistema se apoya en una red neuronal convolucional (CNN) entrenada para diferenciar, a partir de datos digitales de ECG, entre cuatro ritmos cardíacos: el ritmo sinusal normal, la fibrilación auricular, la bradicardia sinusal y la taquicardia sinusal. La visión a más largo plazo contempla, además, extender el análisis a imágenes de electrocardiogramas y aplicar técnicas de Inteligencia Artificial Explicable (XAI) como Grad-CAM, de manera que el sistema no solo clasifique, sino que también pueda mostrar qué porciones de la señal influyeron en su predicción.

El peso de las arritmias y los límites de la lectura manual

Según cifras de la Organización Mundial de la Salud (OMS), un estimado de 19.8 millones de personas murieron a causa de enfermedades cardiovasculares en 2022, lo que representa aproximadamente un 32% de todas las muertes registradas este año a nivel global.[1] Una proporción considerable de estos casos ocurre en países de bajos y medianos ingresos, una tendencia que se confirma en un estudio centrado específicamente en el cuidado de arritmias en América Latina, el cual señala que buena parte de los países de la región carece de la disponibilidad de tecnología y de personal especializado suficiente para identificar y tratar estas alteraciones del ritmo cardíaco.[2]

Dentro del grupo de enfermedades cardiovasculares, las arritmias ocupan un lugar particular, ya que alteran el ritmo normal del corazón y pueden manifestarse de forma silenciosa, intermitente o súbita, lo que dificulta su detección temprana. Un diagnóstico tardío puede traducirse en complicaciones serias como mareos, desmayos, falta de oxígeno o incluso muerte súbita. El electrocardiograma continúa siendo la herramienta más utilizada para detectar estas alteraciones, ya que registra la actividad eléctrica del corazón y permite observar patrones asociados a distintas anomalías del ritmo. Sin embargo, su interpretación sigue dependiendo en gran medida de la experiencia del profesional que la analiza[2], lo que convierte al proceso diagnóstico en una tarea sensible a factores humanos como la fatiga, la sobrecarga laboral o la variabilidad entre especialistas.

En gran parte de los centros médicos de la República Dominicana y Latinoamérica, la lectura manual del ECG es lo común, especialmente en contextos donde no siempre hay un cardiólogo disponible de forma inmediata. Esta dependencia puede derivar en errores humanos, reportes tardíos y dificultades para dar seguimiento de largo plazo a pacientes crónicos. El problema radica en la necesidad de construir soluciones que ayuden a interpretar los electrocardiogramas de forma más rápida, consistente y accesible, particularmente en escenarios donde el tiempo y los recursos humanos son limitados.

La comunidad científica ha respondido a este reto desde hace varios años. Ribeiro et al. demostraron que un modelo de redes neuronales profundas puede diagnosticar múltiples condiciones cardíacas a partir de ECG de 12 derivaciones con aplicabilidad clínica real[3], mientras que Kachuee et al. desarrollaron un modelo de clasificación de latidos cardíacos a partir de señales de ECG crudas, evidenciando que trabajar directamente sobre la señal permite capturar patrones más complejos que los métodos tradicionales.[4] En una línea similar, Narotamo et al. compararon representaciones 1D y 2D de la señal de ECG, así como enfoques de fusión multimodal, encontrando diferencias relevantes en la precisión final de los modelos según la forma en que se representan los datos.[5]

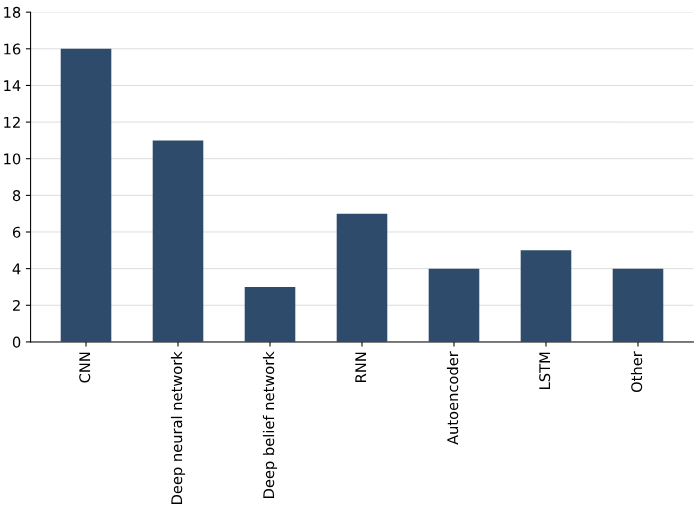
Un aporte particularmente útil proviene de la revisión de Saber y Abotaleb, quienes recopilaron las técnicas modernas de clasificación de arritmias más utilizadas junto con sus porcentajes de precisión, destacando a las redes neuronales convolucionales (CNN) como una de las arquitecturas más frecuentes y efectivas en proyectos similares, con precisiones reportadas entre el 95% y el 99%.[6] Esta revisión, sumada al análisis de conjuntos de datos públicos como PTB-XL[7] y la base de datos de 12 derivaciones para estudio de arritmias publicada por Zheng et al.[8] (también conocida como el dataset de Chapman), da la base necesaria para justificar tanto la arquitectura del modelo como la selección de los datos de entrenamiento.

Actualmente, el diagnóstico a partir del ECG en la República Dominicana se basa principalmente en la experiencia clínica manual. Si bien existen equipos con interpretación automática incorporada, muchos presentan limitaciones significativas: baja precisión en modelos que no fueron adaptados a poblaciones locales, poca explicabilidad de sus resultados y un costo de implementación elevado para centros de salud con recursos limitados. Frente a este panorama, el Dr. Ramos ha señalado el valor que tendría un sistema como SIEMIA no solo para agilizar diagnósticos en casos de emergencia y reducir errores de lectura, sino también para brindar soporte en la identificación de patrones complejos, ahorrar tiempo en interpretaciones repetitivas, ayudar a organizar mejor los casos prioritarios y dar mayor autonomía a los centros de salud que no cuentan con un cardiólogo residente.

Para poder construir un sistema de este tipo era necesario, primero, comprender con precisión qué es lo que se está tratando de clasificar.

Un electrocardiograma (ECG) es una herramienta no invasiva que registra los latidos del corazón y su actividad eléctrica a lo largo de un período determinado, comúnmente entre 10 a 12 segundos, mediante electrodos colocados sobre la piel.[9] En la figura 1 se representa de forma gráfica los tres componentes principales: la onda P, que representa la despolarización auricular y marca el inicio del latido; el complejo QRS, asociado a la despolarización ventricular y a la contracción del músculo cardíaco; y la onda T, que representa la repolarización ventricular, es decir, la recuperación eléctrica del corazón tras la contracción.[18]

Onda de electrocardiograma con la onda P, el complejo QRS, la onda T, segmentos e intervalos
Figura 1. Componentes principales de una onda de electrocardiograma: onda P, complejo QRS y onda T.

Una arritmia cardíaca, en términos simples, es cualquier alteración del ritmo normal del corazón.[10] Este proyecto se enfoca en diferenciar cuatro de los ritmos más comunes dentro de la práctica clínica.

El ritmo sinusal (SR) es el patrón normal, originado en el nodo sinoauricular, con una frecuencia habitual de entre 60 y 100 latidos por minuto (lpm), y sirve como referencia frente a la cual se comparan las demás alteraciones.[11]

La fibrilación auricular (AFIB), por su parte, se caracteriza por una actividad eléctrica desorganizada en las aurículas que produce un ritmo irregular y, frecuentemente, una frecuencia cardíaca elevada; debido a esta irregularidad, el flujo sanguíneo dentro del corazón se vuelve turbulento, lo que incrementa el riesgo de formación de coágulos que pueden desplazarse hacia otras partes del cuerpo y ocasionar complicaciones graves como un accidente cerebrovascular; en el ECG, su patrón suele describirse como “irregularmente irregular”, con ausencia de ondas P distinguibles.[12]

La bradicardia sinusal (SB) mantiene el origen sinusal del impulso, pero con una frecuencia inferior a 60 lpm, y puede ser un hallazgo normal en atletas o durante el sueño, o bien estar asociada a alteraciones que afectan la perfusión sanguínea.[13]

Finalmente, la taquicardia sinusal (ST) conserva igualmente el patrón sinusal, pero con una frecuencia superior a 100 lpm en reposo, y puede ser tanto una respuesta fisiológica al ejercicio o al estrés como un signo temprano de un proceso patológico subyacente.[14]

Trazos de ECG de ritmo sinusal, fibrilación auricular, bradicardia sinusal y taquicardia sinusal
Figura 2. Los 4 tipos de arritmias que se trabajan en este proyecto.

Objetivos completados

Hemos logrado implementar y entrenar un modelo de clasificación basado en redes neuronales convolucionales (CNN) capaz de interpretar electrocardiogramas digitales y diferenciar entre cuatro ritmos cardíacos clínicamente relevantes, evaluando su desempeño mediante métricas de precisión, sensibilidad, especificidad y F1-score sobre un conjunto de datos balanceado de cerca de 30,000 registros, alcanzando una exactitud global del 96% en la clasificación de los cuatro ritmos evaluados. Este resultado valida el enfoque metodológico planteado y sienta las bases técnicas necesarias para las siguientes fases del proyecto: la incorporación de técnicas de explicabilidad (XAI) y el desarrollo de la interfaz clínica que permitirá a los médicos visualizar el ECG junto al análisis automático del sistema.

Metodología

Para este proyecto nos estamos enfocando en incorporar técnicas de aprendizaje automático o Machine Learning (ML), que permite que un sistema aprenda a partir de datos en lugar de depender de reglas programadas explícitamente[15], y, un nivel más profundo, el aprendizaje profundo o Deep Learning (DL), que utiliza redes neuronales de múltiples capas para aprender representaciones directamente a partir de datos crudos, sin necesidad de que un humano seleccione manualmente qué atributos son relevantes.[16]

Las redes neuronales convolucionales (CNN), en particular, sobresalen en el reconocimiento de patrones espaciales dentro de los datos, lo que las ha convertido en una arquitectura de referencia tanto para el reconocimiento de imágenes como para el análisis de señales fisiológicas como el ECG.[17]

La elección de CNN como clasificador principal de SIEMIA no fue arbitraria. Además del respaldo que ofrece la revisión de Saber y Abotaleb en cuanto a su desempeño frente a otras arquitecturas,[6] se consideraron alternativas como Random Forest o Support Vector Machine (SVM), comúnmente utilizadas sobre características tabulares extraídas manualmente de la señal. Sin embargo, ese tipo de modelos depende en buena medida de variables diseñadas a mano, mientras que una CNN puede aprender directamente a partir de la forma de la señal cruda, sin ese paso intermedio de extracción manual de atributos, lo que resulta especialmente conveniente para una señal tan rica en matices morfológicos como el ECG.

Esquema de una red neuronal convolucional con capas de convolución, pooling y clasificación
Figura 3. Funcionamiento general de una red neuronal convolucional: extracción de características por capas de convolución y clasificación final.

Con la arquitectura definida, el siguiente reto fue construir un banco de datos suficientemente robusto para entrenarla. El conjunto final, denominado balanced_dataset_v3.csv, resulta de la fusión de dos bases de datos públicas de ECG ampliamente reconocidas en la literatura: PTB-XL[7], una de las bases clínicas de electrocardiografía de 12 derivaciones más extensas y mejor documentadas disponibles a través de PhysioNet, con 21,837 registros de 18,885 pacientes; y la base publicada por Zheng et al. (2022), conocida como el dataset de Chapman[8], con 45,152 registros centrados específicamente en la variabilidad del ritmo cardíaco. La combinación de ambos conjuntos permitió reunir alrededor de 65,000 registros médicos con más de 100 anomalías o condiciones cardíacas distintas.

A partir de ese conjunto fusionado, el equipo filtró únicamente las condiciones de tipo rítmico y seleccionó las cuatro con mayor relevancia clínica y volumen de datos: ritmo sinusal, fibrilación auricular, bradicardia sinusal y taquicardia sinusal. Dado que estas categorías no estaban distribuidas de forma pareja, se aplicó un proceso de undersampling, reduciendo cada clase a la cantidad de la categoría más pequeña —7,339 registros—, para obtener así un conjunto balanceado final de 29,356 registros. Este balance es clave en un problema de clasificación médica, ya que evita que el modelo aprenda a favorecer las clases mayoritarias en detrimento de aquellas con menor representación, pero de igual o mayor relevancia clínica.

Gráfico de barras con la frecuencia de uso de técnicas de clasificación de arritmias, encabezado por CNN
Figura 4. Técnicas de clasificación más utilizadas en la literatura de arritmias, según Saber y Abotaleb [6].

Una vez definido el conjunto de datos, se aplicó un protocolo de preprocesamiento orientado a preservar la integridad del entrenamiento. Todos los registros fueron estandarizados a una frecuencia de muestreo de 100 Hz y normalizados mediante z-score, de manera que cada señal quedara representada por 1,000 muestras, favoreciendo un entrenamiento más ligero y consistente. Adicionalmente, se implementó un pipeline de control de calidad para descartar registros corruptos, con picos de voltaje fuera de rangos biológicos razonables (superiores a 20 milivoltios), valores no numéricos (NaN) o rutas de acceso inválidas. Finalmente, el conjunto de datos depurado fue pre-calculado y almacenado en formato tensor de PyTorch (.pt), lo que reduce cuellos de botella durante el entrenamiento y asegura un formato de datos único y consistente.

La arquitectura de la red se implementó como una CNN unidimensional (1D-CNN) bajo el ecosistema de PyTorch, organizada en capas de convolución para la extracción de rasgos, funciones de activación no lineales, capas de pooling para reducir la dimensionalidad y capas densas para la clasificación final entre las cuatro categorías de ritmo.

El entrenamiento se gestionó mediante el algoritmo de optimización Adam junto con Data Loaders para el procesamiento eficiente por lotes, dividiendo el conjunto de datos en subconjuntos de entrenamiento y validación mediante un train-test split convencional, lo que permite evaluar el modelo sobre datos que no ha visto durante el aprendizaje.

A nivel de gestión del proyecto, el desarrollo del software se organizó bajo una metodología ágil basada en Scrum, complementada con un seguimiento visual tipo Kanban. En lugar de construir el sistema completo en una sola fase extensa, el trabajo se dividió en bloques de avance que permitieron levantar primero una versión funcional básica (centrada en el análisis de señales digitales de ECG) para luego mejorarla progresivamente hacia una solución más completa, con visualización de resultados y preparación para futuras funciones de explicabilidad.

En general, el sistema recibe electrocardiogramas en formato digital, procesa la señal, extrae los patrones relevantes y genera una clasificación preliminar entre las cuatro categorías de ritmo definidas, presentando el resultado junto a la visualización del propio ECG. En cambio, no clasifica arritmias fuera de esas cuatro categorías en esta etapa, no reemplaza el criterio médico ni emite diagnósticos definitivos, no prescribe tratamientos y no realiza monitoreo cardíaco en tiempo real, ya que podría afectar negativamente métricas como la precisión que resultan fundamentales para que la herramienta tenga utilidad real como apoyo clínico.

Resultados

Tras entrenar el clasificador sobre el conjunto de datos balanceado, la validación del modelo se realizó utilizando un marco de métricas de precision, recall, F1-score y matrices de confusión. Esta decisión responde a que, en un entorno clínico, el costo de un falso negativo, no detectar una arritmia maligna, puede ser considerablemente más alto que el de un falso positivo, por lo que resulta indispensable observar el comportamiento del modelo clase por clase y no solo su desempeño promedio.

Sobre un conjunto de validación de 4,403 registros, el modelo alcanzó una exactitud (accuracy) global del 96%. Al desglosar el desempeño por clase, la fibrilación auricular (AFIB) obtuvo un F1-score de 0.97 (precision 0.96, recall 0.98), la taquicardia sinusal (STACH) un F1-score de 0.97 (precision 0.98, recall 0.96), la bradicardia sinusal (SBRAD) un F1-score de 0.96 (precision 0.95, recall 0.98) y el ritmo sinusal (SR) un F1-score de 0.94 (precision 0.96, recall 0.93), tal como se resume en la tabla 1.

ClasePrecisionRecallF1-scoreSoporte
Ritmo sinusal (SR)0.960.930.941098
Fibrilación auricular (AFIB)0.960.980.971074
Taquicardia sinusal (STACH)0.980.960.971119
Bradicardia sinusal (SBRAD)0.950.980.961112
Accuracy global0.964403
Macro avg0.960.960.964403
Weighted avg0.960.960.964403
Tabla 1. Reporte de clasificación del modelo CNN sobre el conjunto de validación (4,403 registros).

La matriz de confusión permite observar con más detalle dónde se concentran los errores del modelo. El ritmo sinusal (SR) es la clase con más confusiones: de 1,098 casos reales, pero el modelo tiende a confundir el ritmo sinusal normal con sus variantes de frecuencia (más lenta o más rápida) en los casos límite, un comportamiento razonable considerando que la diferencia entre estas clases depende principalmente de la frecuencia cardíaca y no de un cambio morfológico marcado en la señal. En contraste, la fibrilación auricular y la bradicardia sinusal presentan muy pocas confusiones con las demás clases (recall de 0.98 en ambas), ya que estas dos condiciones se encuentran entre las de mayor relevancia clínica dentro del alcance del proyecto.

Matrices de confusión del modelo en conteos absolutos y normalizadas por clase
Figura 5. Matrices de confusión del modelo: conteos absolutos (izquierda) y valores normalizados por clase real (derecha).

Estos resultados son consistentes con lo reportado en la literatura para arquitecturas CNN aplicadas a la clasificación de arritmias, donde se documentan precisiones de entre 95% y 99%[6], y validan la hipótesis planteada al inicio del proyecto: que un modelo de redes neuronales convolucionales, entrenado con datos de ECG adecuadamente preprocesados y balanceados, puede clasificar patrones arrítmicos con métricas de desempeño clínicamente útiles.

Más allá del modelo en sí, el equipo ha avanzado también en el diseño de la experiencia de usuario del sistema, con un mockup preliminar de la interfaz que el personal médico utilizará para insertar un electrocardiograma, visualizar la señal y recibir el resultado del análisis, así como el diagrama de flujo que describe el recorrido completo desde que se inserta un ECG hasta que se muestra el resultado preliminar.

Diagrama de flujo: insertar ECG, validar formato, procesar señal y mostrar resultado o error
Figura 6. Diagrama de flujo del proceso de inserción y análisis de un electrocardiograma en la interfaz.

Conclusión

Los resultados obtenidos hasta el momento confirman que un modelo de aprendizaje profundo, entrenado sobre una base de datos suficientemente grande y balanceada, puede aprender a distinguir con alta precisión entre distintos ritmos cardíacos a partir de la señal cruda del electrocardiograma. Para un equipo de tesis, alcanzar un 96% de exactitud global, con métricas por clase que se mantienen consistentemente altas incluso en la categoría más difícil de diferenciar, es una validación fuerte de que el enfoque técnico elegido (CNN 1D, entrenada sobre datos fusionados de PTB-XL y Chapman) es el adecuado para este problema.

El propio alcance del proyecto limita, de forma deliberada, la clasificación a cuatro tipos de ritmo, dejando fuera un número considerable de arritmias que también requieren atención clínica; ampliar esa cobertura implica un proceso de entrenamiento, validación y ajuste más exigente. De igual forma, el sistema aún no incorpora las técnicas de explicabilidad (XAI) contempladas desde el planteamiento inicial, un componente que resulta especialmente importante en el ámbito médico, donde un modelo que sólo entrega una etiqueta sin justificación difícilmente genera la confianza necesaria para ser adoptado por profesionales de la salud.

En un país donde la transformación digital del sector salud continúa en proceso, este proyecto aspira a convertirse en una herramienta de apoyo accesible que ayude a los profesionales de la salud dominicanos a detectar arritmias con mayor rapidez, consistencia y respaldo tecnológico, sin pretender jamás sustituir el criterio clínico que solo un especialista puede ofrecer.

Fusionar y balancear dos conjuntos de datos de procedencias distintas, depurar registros corruptos y decidir qué arritmias priorizar dentro de un alcance realista fueron, en la práctica, tareas tan determinantes para el resultado final como la propia arquitectura de la red neuronal. Los hallazgos recolectados hasta la fecha no solo confirman la eficiencia del modelo desarrollado, sino que además sientan los cimientos para su posterior evolución hacia una solución de soporte tecnológico cada vez más robusta e integral para el diagnóstico cardiovascular.

Referencias

  1. World Health Organization, “Cardiovascular diseases (CVDs),” 2025. Available: https://www.who.int/news-room/fact-sheets/detail/cardiovascular-diseases-(cvds)
  2. U. Rojel et al., “Current state of arrhythmia care in Latin America: A statement from the Latin American Heart Rhythm Society,” Heart Rhythm O2, 2024. DOI: 10.1016/j.hroo.2024.11.010
  3. A. Ribeiro et al., “Automatic diagnosis of the 12-lead ECG using deep neural networks,” Nature Communications, 2020. https://pubmed.ncbi.nlm.nih.gov/32273514/
  4. M. Kachuee et al., “ECG heartbeat classification using deep neural networks,” IEEE EMBC, 2023. https://pmc.ncbi.nlm.nih.gov/articles/PMC10128986/
  5. H. Narotamo et al., “Deep learning for ECG classification: A comparative study of 1D and 2D representations and multimodal fusion approaches,” ScienceDirect, 2024. DOI: 10.1016/j.bspc.2024.106141
  6. M. Saber and M. Abotaleb, “Arrhythmia Modern Classification Techniques: A Review,” Journal of Artificial Intelligence and Metaheuristics, vol. 1, no. 2, pp. 42-53, 2022. DOI: 10.54216/JAIM.010205
  7. P. Wagner et al., “PTB-XL: A large publicly available ECG dataset,” PhysioNet, 2020. DOI: 10.13026/x4td-x982
  8. J. Zheng et al., “A large scale 12-lead electrocardiogram database for arrhythmia study,” PhysioNet, 2022. DOI: 10.13026/92ks-sq55
  9. Y. Sattar and L. Chhabra, “Electrocardiogram,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK549803/
  10. S. Dhaval, “Arrhythmias,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK558923/
  11. B. Rogoff et al., “EKG Rhythm,” StatPearls, 2022. Available: https://www.ncbi.nlm.nih.gov/books/NBK555952/
  12. Z. Nesheiwat et al., “Atrial Fibrillation,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK526072/
  13. Y. Hafeez et al., “Sinus Bradycardia,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK493201/
  14. A. Henning et al., “Sinus Tachycardia,” StatPearls, 2023. Available: https://www.ncbi.nlm.nih.gov/books/NBK553128/
  15. N. Maslej et al., “Artificial Intelligence Index Report 2025,” arXiv, 2025. Available: https://arxiv.org/pdf/2504.07139
  16. M. Liakat et al., “Deep Learning vs. Machine Learning for Intrusion Detection in Computer Networks: A Comparative Study,” Applied Sciences, 2025. DOI: 10.3390/app15041903
  17. M. Krichen, “Convolutional Neural Networks: A Survey,” Computers, 2023. DOI: 10.3390/computers12080151
  18. “Cómo interpretar un ECG: guía para profesionales de la salud,” Feb. 2026. Available: https://mesimedical.com/es/noticias/como-interpretar-el-ecg

MOSAIC: una plataforma híbrida para construir, evaluar y explicar horarios universitarios

Josvier Rodríguez y Emilio José George Rodríguez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Un proyecto final de grado que integra calidad de datos, optimización combinatoria, trazabilidad y apoyo a la toma de decisiones académicas.

En una universidad, un horario no es una simple cuadrícula de días y horas. Detrás de cada casilla existe una decisión que compromete la disponibilidad de un docente, la capacidad de un aula, la continuidad de una asignatura, la carga de una sección y la experiencia de cientos de estudiantes. Cuando esas decisiones se realizan con archivos dispersos, reglas implícitas y correcciones manuales, un cambio aparentemente pequeño puede producir choques de recursos, sobreocupaciones o secuencias académicas difíciles de justificar. La programación de horarios pertenece, por esa razón, a una familia de problemas combinatorios en la que la cantidad de alternativas crece con rapidez y donde obtener una propuesta válida requiere mucho más que acomodar materias en una semana [1]. En la práctica, una corrección tardía rara vez afecta una sola clase: puede obligar a mover otra sección, cambiar de espacio, alterar la jornada de un docente y comunicar una nueva versión a estudiantes y coordinadores. Esa propagación explica por qué la planificación necesita mecanismos preventivos, no únicamente capacidad de reaccionar cuando el conflicto ya fue publicado.

MOSAIC nació para responder a ese escenario desde la Escuela de Ingeniería en Computación y Telecomunicaciones de la Pontificia Universidad Católica Madre y Maestra. El proyecto fue desarrollado por Josvier Rodríguez y Emilio José George Rodríguez, bajo la asesoría de Rafael Omar Batista, como trabajo final de grado en Ciencias de la Computación. Su propósito no fue reemplazar a quienes planifican la oferta académica, sino construir una herramienta capaz de convertir datos institucionales en propuestas de horario verificables, comparables y explicables. El nombre identifica un motor analítico para propuestas de horarios universitarios: una plataforma que recibe archivos CSV o XLSX, prepara su estructura, mide el estado inicial, ejecuta un proceso de optimización y conserva evidencia de cada corrida. El desarrollo se situó en la intersección entre investigación operativa e ingeniería de software. Esa combinación permitió que las decisiones matemáticas no quedaran aisladas en un experimento, sino integradas a un flujo de carga, validación, ejecución, historial y exportación. El resultado es un artefacto académico que puede discutirse desde el algoritmo, la arquitectura y la utilidad institucional.

La pertinencia del proyecto se relaciona con la transformación digital que atraviesa la educación superior. Las universidades generan cada vez más datos sobre matrícula, asignaturas, infraestructura, modalidades y disponibilidad docente, pero disponer de información no garantiza que esta se convierta en una decisión útil. La literatura sobre instituciones universitarias digitales y analítica académica insiste en que el valor aparece cuando los registros se integran, se validan y se presentan de forma que apoyen el juicio humano [13]-[16]. MOSAIC adopta precisamente esa perspectiva: el algoritmo es importante, pero también lo son la calidad de entrada, la trazabilidad del proceso y la capacidad de explicar por qué una alternativa resulta factible o por qué no puede corregirse sin modificar una condición institucional. Este enfoque también responde a una necesidad regional: muchas instituciones latinoamericanas modernizan sus procesos mientras conviven con exportaciones tabulares, plataformas no interoperables y políticas que se aplican mediante conocimiento tácito. Una herramienta de apoyo debe tolerar esa realidad sin normalizarla de manera silenciosa; debe indicar qué datos faltan, cuáles fueron transformados y qué supuestos sostienen cada resultado [13], [16].

Cuando construir un horario deja de ser una cuadrícula

Este artículo presenta el recorrido del proyecto con una redacción orientada tanto a lectores técnicos como a personas vinculadas con la gestión académica. Primero se explica por qué la programación universitaria continúa siendo un problema abierto; luego se describe la metodología híbrida utilizada, la arquitectura del sistema y la forma en que se protegen la factibilidad y la reproducibilidad. Finalmente, se analizan los resultados con el mismo criterio utilizado en el informe final: separar lo que está implementado y verificado de aquello que todavía necesita validación institucional. Esa distinción es esencial porque un prototipo de investigación puede demostrar una base tecnológica sólida sin afirmar, de manera prematura, que ya está listo para operar a escala de campus. La promesa editorial y técnica es, por tanto, deliberadamente moderada. El artículo no presenta la automatización como una respuesta universal ni convierte una demostración en una adopción institucional. Expone cómo se construyó la solución, qué evidencia respalda cada afirmación y cuáles decisiones todavía pertenecen a las autoridades académicas. Esa honestidad fortalece, en lugar de debilitar, el aporte del proyecto.

Diagrama: el horario universitario en el centro, rodeado por docentes, pensum y ciclo, aulas, secciones, modalidades, demanda, calidad de datos y políticas
Figura 1. Variables que convergen en la programación de un horario universitario. Fuente: elaboración propia a partir del modelo conceptual de MOSAIC.

La dificultad del problema comienza por la cantidad de actores y recursos que deben coordinarse al mismo tiempo. Dos clases no pueden utilizar la misma aula en intervalos solapados; un profesor no puede impartir sesiones simultáneas; una sección debe respetar sus horas semanales, su continuidad y su relación con el pensum; una clase presencial necesita un espacio compatible con su matrícula, mientras una sesión virtual no debería reservar infraestructura física. A esas condiciones se agregan franjas institucionales, aulas obligatorias para laboratorios, límites de carga docente y días lectivos permitidos. En la literatura, estas condiciones se distinguen entre restricciones duras, cuya violación invalida la propuesta, y criterios blandos, que permiten comparar la calidad de horarios ya factibles [1], [3], [6]. Esta separación evita comparar como equivalentes situaciones de naturaleza distinta. Un hueco entre clases puede ser inconveniente, pero no tiene el mismo impacto que asignar simultáneamente al mismo docente o exceder la capacidad de un laboratorio. Al modelar prioridades explícitas, el sistema refleja que la calidad se optimiza después de asegurar que la propuesta pueda operar en la realidad universitaria.

El problema se vuelve aún más complejo cuando la información de partida no está preparada para un optimizador. Un archivo puede contener encabezados desplazados, columnas con nombres diferentes, horarios escritos con convenciones incompatibles, capacidades vacías o modalidades registradas de forma contradictoria. Si un valor de aula se interpreta mal, el sistema puede creer que existe un recurso disponible; si una hora no puede convertirse a un intervalo, no será posible detectar un solapamiento; si falta el identificador de un profesor, una doble asignación puede pasar inadvertida. Por eso, MOSAIC trata la preparación de datos como parte del problema de ingeniería y no como una actividad secundaria. La calidad de la solución depende de la fidelidad con la que la instancia represente la realidad institucional. La dificultad no se resuelve eliminando filas problemáticas sin dejar rastro. MOSAIC conserva un checklist de ingestión y comunica las columnas detectadas, las ausentes y las conversiones realizadas. Esta conducta es importante para el gobierno del dato: permite corregir la fuente, repetir el análisis y evitar que una aparente mejora sea solo consecuencia de haber ignorado registros que no pudieron interpretarse.

Los enfoques exactos, como la programación entera y la programación por restricciones, ofrecen formulaciones rigurosas y pueden demostrar optimalidad o infactibilidad dentro del modelo construido. Sin embargo, su costo puede aumentar cuando se combinan cientos de sesiones, aulas y candidatos temporales. Trabajos recientes han mostrado que la programación universitaria real contiene variantes multiphase, currículos, asignaciones de docentes y objetivos que dificultan una formulación única [4], [7], [17]. Esto no significa que los modelos exactos sean inadecuados; significa que deben utilizarse con un alcance cuidadosamente definido, límites de tiempo y mecanismos que permitan continuar cuando la instancia crece o incluye reglas difíciles de expresar en una formulación compacta. En MOSAIC, esa tensión se administra reduciendo el dominio de la fase exacta y estableciendo rutas de respaldo. El solucionador puede concentrarse en aulas compatibles y candidatos de tiempo permitidos, mientras otras reglas se verifican o reparan en etapas posteriores. La arquitectura acepta que una formulación técnicamente elegante no siempre es la alternativa más operativa cuando la instancia llega incompleta o cambia durante el ciclo.

Las metaheurísticas, por su parte, exploran el espacio de soluciones mediante movimientos y estrategias que buscan mejorar progresivamente un horario. La Búsqueda Tabú es especialmente útil porque incorpora memoria: evita regresar de inmediato a movimientos recientes, permite escapar de óptimos locales y puede aceptar una transición que no sea mejor en el corto plazo si abre una ruta hacia una solución superior [11]. Su flexibilidad resulta valiosa cuando las preferencias institucionales son numerosas o cambian con frecuencia. No obstante, una metaheurística pura necesita una solución inicial y puede dedicar gran parte de su esfuerzo a corregir factibilidad. Si las restricciones obligatorias no están controladas, el algoritmo podría encontrar un horario cómodo o equilibrado que siga siendo operacionalmente imposible. Su utilización también exige disciplina experimental. La semilla, el tamaño del vecindario, el número máximo de iteraciones y el criterio de estancamiento deben quedar registrados, porque dos ejecuciones con parámetros distintos no constituyen la misma prueba. MOSAIC incorpora esos metadatos para que la búsqueda no funcione como una caja negra y para que la comparación pueda reconstruirse posteriormente.

La tendencia de investigación ha favorecido, por ello, métodos híbridos que distribuyen responsabilidades entre varias técnicas. Una fase exacta puede construir una base factible; operadores especializados pueden reparar reglas de dominio; y una búsqueda local puede refinar preferencias sin comprometer condiciones críticas [5], [12]. Las revisiones sobre el University Course Timetabling Problem señalan que no existe un único método dominante para todas las instituciones, porque cada universidad combina políticas, estructuras curriculares y recursos distintos [3], [6]. MOSAIC se ubica en esa línea, pero añade una preocupación de producto: además de producir una propuesta, debe conservar los parámetros, desglosar las violaciones y permitir que un comité compare el estado original con la salida. La hibridación no consiste en encadenar algoritmos de manera decorativa. Cada componente responde a una limitación concreta: CP-SAT organiza una parte de la factibilidad, los reparadores incorporan conocimiento institucional y Tabú explora calidad. El valor surge de la coordinación entre fases y de una función de evaluación común que permite observar cómo cambia el horario sin perder el vínculo con sus restricciones.

Los estudios recientes también han ampliado el problema hacia modalidades híbridas, trayectorias curriculares personalizadas y asignaciones orientadas por demanda. Estas investigaciones muestran que una solución puede ser matemáticamente atractiva y, aun así, requerir mecanismos adicionales para responder a cambios de matrícula, indisponibilidad de recursos o secuencias de estudio no convencionales [8]-[10]. De esta evidencia surge una idea central del proyecto: evaluar un horario solo en condiciones nominales no basta. Dos propuestas pueden tener cero conflictos en el momento de su generación, pero reaccionar de manera diferente cuando aumenta la demanda o se bloquea un aula. La robustez debe observarse como una dimensión posterior y distinta de la optimización. La robustez adquiere especial relevancia porque la planificación se realiza antes de que todas las condiciones permanezcan estables. La matrícula puede variar, un profesor puede quedar indisponible o un aula puede salir de servicio. Incorporar escenarios no elimina la incertidumbre, pero permite identificar propuestas demasiado dependientes de recursos críticos y ofrecer al comité una señal temprana antes de aprobar la versión definitiva.

Una meta concreta: convertir datos dispersos en decisiones comparables

Otra brecha aparece entre los modelos publicados y las herramientas que usan las personas responsables de la planificación. Muchos trabajos comparan algoritmos sobre conjuntos de datos previamente estructurados, mientras las oficinas académicas deben resolver primero inconsistencias de archivos, reglas no documentadas y cambios de última hora. Además, una puntuación única no siempre explica por qué una propuesta es mejor. Los sistemas de apoyo a decisiones deben combinar automatización con transparencia, conservar la posibilidad de intervención y evitar que el usuario confunda una recomendación con una decisión obligatoria [2], [14]. MOSAIC se diseñó como una ayuda para el análisis: genera evidencia y alternativas, pero mantiene la aprobación final en manos del comité académico. También existe una diferencia entre demostrar un algoritmo y entregar una experiencia de uso. Una coordinación necesita cargar archivos, entender advertencias, revisar indicadores, localizar la causa de una violación y descargar resultados. Si el sistema solo devuelve un número final, obliga a confiar sin comprender. Por eso, la interfaz y la persistencia forman parte de la solución científica: convierten el cálculo en evidencia examinable.

Del archivo institucional a una representación confiable

El objetivo completado fue desarrollar una herramienta de apoyo a la toma de decisiones para generar y mejorar horarios universitarios a partir de datos académicos institucionales, permitiendo comparar la factibilidad y la calidad entre una programación base y una alternativa procesada. Para alcanzarlo, el proyecto implementó la carga, validación y normalización de archivos CSV y XLSX; construyó un modelo híbrido con CP-SAT, reparadores y Búsqueda Tabú; definió indicadores de restricciones duras, criterios blandos, puntuación global y robustez; y desarrolló una interfaz web conectada a servicios de ejecución, historial, persistencia y exportación. El cumplimiento se evaluó dentro del alcance de tesis, sin presentar la plataforma como una integración productiva con el sistema de gestión académica. El cumplimiento se materializó en cuatro capacidades observables: ingesta y normalización de CSV/XLSX; un modelo híbrido con restricciones y criterios de calidad; indicadores para factibilidad, calidad y estabilidad; y una interfaz conectada a servicios de ejecución, persistencia y exportación. El objetivo se considera completado dentro del alcance de tesis, sin extender esa afirmación a una integración productiva con sistemas institucionales.

La metodología comienza con una arquitectura por capas que separa la experiencia del usuario, los servicios y el núcleo analítico. La interfaz final se desarrolló con Next.js y TypeScript; FastAPI expone validación, creación de corridas, historial, detalle, horario, indicadores y exportaciones; el motor Python contiene la lógica de ingesta, evaluación y optimización; y SQLite, junto con archivos organizados por corrida, conserva el estado. Esta separación evita que una regla exista solo en la pantalla o que una exportación calcule resultados distintos. El mismo pipeline puede ejecutarse desde la interfaz, la API o la línea de comandos, lo que favorece las pruebas y reduce el acoplamiento entre la lógica matemática y la presentación. La separación evita duplicar lógica entre pantallas y exportaciones. El mismo núcleo analítico puede ser invocado desde línea de comandos, API o interfaz web, de modo que la cifra mostrada al usuario proviene del mismo cálculo que se conserva en los artefactos. Esta decisión reduce inconsistencias, facilita las pruebas y permite evolucionar la experiencia visual sin reescribir las reglas académicas.

Arquitectura por capas de MOSAIC: experiencia y acceso, servicios, núcleo analítico y datos y persistencia, desplegados con Docker Compose
Figura 2. Arquitectura final de MOSAIC por capas. Fuente: elaboración propia a partir de la arquitectura documentada del proyecto.

La entrada se organiza mediante un contrato extendido de veintiséis columnas que incluye ciclo, código y nombre de asignatura, número de clase, estado, cupo, matriculados, créditos, modalidad, profesor, aula, capacidad, días, horas, campus, tipo de clase, requisitos y observaciones, entre otros atributos. El sistema admite aliases y puede recuperar encabezados que no aparecen en la primera fila. También convierte valores vacíos, normaliza nombres, interpreta horarios y preserva columnas aparentemente anónimas cuando contienen información. El objetivo no es aceptar cualquier archivo sin advertencia, sino tolerar variaciones comunes y devolver un checklist claro de lo detectado, lo ausente y lo que debe corregirse antes de ejecutar el modelo. La tolerancia de entrada se combina con límites explícitos. El flujo reconoce alias y variaciones comunes, pero no inventa valores necesarios para decidir. Campos como matrícula, modalidad, aula, profesor, días y horas deben alcanzar un nivel mínimo de interpretabilidad. De esa forma, la flexibilidad sirve para incorporar exportaciones reales sin convertir datos ambiguos en certezas artificiales para el solucionador.

Flujo de datos de MOSAIC: CSV/XLSX, detección, normalización, validación, baseline, solver y salida, con compuertas de calidad
Figura 3. Flujo de datos y compuertas de calidad antes de la optimización. Fuente: elaboración propia a partir del proceso de ingesta de MOSAIC.

Después de la normalización, MOSAIC construye un baseline: una representación medible del horario recibido. Sobre ese estado calcula H, la suma de veinte restricciones duras, y F, la combinación ponderada de trece criterios blandos. La puntuación global se expresa como Φ(x) = M·H(x) + F(x), donde M vale 1 000 000. Esa constante establece una jerarquía operativa: una diferencia de factibilidad domina cualquier mejora razonable de calidad. El sistema no se limita a mostrar Φ; también presenta el desglose de H y F, porque dos valores globales similares pueden ocultar causas completamente distintas. Esta trazabilidad permite distinguir un choque de profesor de una capacidad insuficiente o de una regla de pensum. El baseline cumple una función metodológica y comunicativa. Permite responder qué problemas existían antes de intervenir y evita atribuir al algoritmo mejoras que ya estaban presentes en el archivo original. Cada fase se compara contra ese punto de partida mediante H, F y Φ, con desgloses por regla. Así, una reducción puede vincularse con choques, capacidad, modalidad o preferencias específicas.

La política hard-first protege el propósito institucional de la solución. Mientras existan violaciones duras, el proceso prioriza reducirlas. Una vez que H llega a cero, un movimiento que vuelva a crear un conflicto obligatorio se rechaza aunque disminuya F. Esta decisión evita que una preferencia, como reducir huecos o minimizar cambios de aula, compense una condición que haría inviable el horario. El principio se relaciona con la optimización lexicográfica utilizada en problemas de asignación, donde los objetivos se ordenan por niveles de prioridad [1], [17]. En términos prácticos, MOSAIC intenta primero producir una propuesta que pueda operar; solo entonces busca que esa propuesta sea más conveniente, equilibrada o estable. La constante M se configuró en 1,000,000 como separación de órdenes de magnitud, no como costo monetario. La consecuencia es equivalente a una prioridad lexicográfica: primero se comparan las violaciones obligatorias y solo cuando H es igual se utiliza F para ordenar la conveniencia. Esta decisión hace visible una política que, en procesos manuales, suele quedar implícita en la experiencia del planificador.

Esquema de la función objetivo Φ(x) = M·H(x) + F(x): restricciones duras H(x) ponderadas por M = 1 000 000 y criterios de calidad F(x)
Figura 4. Jerarquía hard-first de la función objetivo. Fuente: elaboración propia a partir de la formulación Φ(x) = M·H(x) + F(x).

La fase A utiliza CP-SAT para estructurar la asignación inicial. Para cada sesión presencial se construyen aulas cuya capacidad cubre la matrícula y candidatos temporales dentro del dominio institucional. Las variables binarias representan la asignación de una sesión a un aula y, cuando corresponde, a un candidato de tiempo. Las restricciones lineales impiden solapamientos de aula, profesor y sección. El solver opera con un límite temporal y reporta su estado, modelo utilizado y violaciones residuales. Para controlar el crecimiento, la reasignación temporal completa se aplica a instancias de hasta cuatrocientas sesiones presenciales; en archivos mayores se utiliza un modelo reducido centrado en aulas y mecanismos de respaldo. El modelo devuelve estados como OPTIMAL o FEASIBLE dentro de la formulación ejecutada y un límite temporal controla el costo. En instancias mayores, la reasignación temporal completa se reduce y puede utilizarse un constructor de respaldo antes de la reparación. Es importante subrayar que un estado del solver describe el modelo compacto, no certifica por sí solo toda la realidad institucional.

La fase B incorpora reparadores especializados. Algunos atienden inconsistencias básicas, como una sesión virtual con aula, una clase presencial sin espacio, una capacidad insuficiente o un choque de profesor. Otros utilizan configuraciones institucionales para revisar horas semanales, continuidad, máximo de sesiones por día, dominio de horarios, límites de carga docente, días lectivos, aulas obligatorias, franjas reservadas y coherencia con el pensum por ciclo. Un reparador no fuerza una corrección imposible. Si no existe un aula con capacidad suficiente o una franja permitida, la violación se conserva y se acompaña de contexto. Esa decisión es importante: modificar datos institucionales para fabricar factibilidad sería menos transparente que reportar un límite estructural. La reparación no fuerza resultados imposibles. Si ninguna aula disponible satisface la matrícula o si todas las franjas válidas están bloqueadas, el sistema preserva la violación y aporta contexto. Esta conducta protege la integridad del dato: es preferible presentar un conflicto residual explicado que modificar capacidades, disponibilidades o reglas sin autorización para producir una apariencia artificial de factibilidad.

La fase C ejecuta Búsqueda Tabú sobre la solución reparada. Los vecindarios se forman mediante cambios e intercambios de aula y tiempo; cada candidato se evalúa con Φ; la lista tabú evita ciclos inmediatos; y un criterio de aspiración permite aceptar un movimiento prohibido cuando produce una mejora global. Cada iteración registra fase, número, H, F, Φ y una nota, de modo que el usuario pueda observar cómo evolucionó la propuesta. En archivos muy grandes, el sistema reduce automáticamente iteraciones, tamaño de vecindario y estancamiento, porque cada vecino requiere copiar y evaluar una estructura tabular. La prioridad es conservar la estabilidad de la aplicación antes que simular una búsqueda profunda que agote memoria. Cada iteración registra la fase, H, su desglose, F, Φ y una nota del movimiento. El resultado incluye la razón de parada y la cantidad de iteraciones ejecutadas. En modo ligero, la plataforma declara que Tabú fue omitida, en vez de presentar la salida como si hubiese atravesado todas las fases. Esa transparencia impide confundir validación rápida con optimización completa.

Después de la optimización, el componente Ω evalúa la propuesta bajo escenarios. La demanda puede aumentar o disminuir y determinados docentes o aulas pueden marcarse como no disponibles. MOSAIC no modifica el horario en esta etapa: vuelve a calcular H y F sobre la asignación fija y produce una tasa de factibilidad, media, desviación, varianza, mejor y peor valor de F y coeficiente de variación. Esta separación evita confundir robustez con reoptimización. Ω responde a una pregunta preventiva: si las condiciones cambian después de seleccionar una propuesta, ¿cuánto depende su factibilidad de recursos sin margen o de aulas cercanas a su capacidad? El resumen de Ω contempla tasa de factibilidad, media, desviación, varianza, mejor y peor F y coeficiente de variación. La asignación se mantiene fija para medir sensibilidad, por lo que el componente no debe describirse como una reoptimización automática. Su propósito es comparar margen operativo: revelar si una propuesta nominalmente válida depende de capacidades o disponibilidades con poca holgura.

Pipeline híbrido en cuatro fases: A CP-SAT, B reparación, C Búsqueda Tabú y Ω robustez
Figura 5. Fases del solver híbrido y evaluación de robustez. Fuente: elaboración propia a partir del orquestador final de MOSAIC.

La metodología se completa con persistencia y reproducibilidad. Cada corrida puede conservar un manifiesto, parámetros, resúmenes, desgloses, horario base, horario procesado y exportaciones. El índice SQLite permite reconstruir el historial después de reiniciar el backend, mientras Docker Compose coordina los servicios en un entorno reproducible. La semilla, la versión, el límite de tiempo y los parámetros de búsqueda forman parte de los metadatos. El repositorio incluye pruebas segmentadas para ingesta, API, pensum, restricciones, CP-SAT, reparación, CLI y construcción del frontend. No se reporta un porcentaje agregado de cobertura que no esté respaldado por un artefacto; la evidencia se expresa como flujos y subsistemas comprobados. La reproducibilidad requiere más que guardar el archivo final. Para repetir una corrida deben conservarse la entrada o su huella, las tablas auxiliares, la versión del sistema, la semilla y los parámetros de ejecución. MOSAIC estructura esa evidencia alrededor de cada identificador de corrida, lo que facilita auditoría, comparación y recuperación incluso después de reiniciar el servicio.

De prototipo exploratorio a plataforma trazable

La evolución desde el anteproyecto fue cuantificable. El prototipo inicial registraba ocho restricciones duras y siete criterios blandos; la versión final incorporó veinte restricciones y trece criterios, equivalentes a incrementos de 150 % y aproximadamente 85.7 %, respectivamente. Los canales de ejecución pasaron de CLI y Streamlit a CLI, API, Next.js y Streamlit conservado como legado. También se incorporaron CP-SAT, la evaluación Ω y la persistencia durable de corridas. Estos cambios no fueron una ampliación decorativa: surgieron de problemas observados con archivos institucionales, navegación entre ejecuciones, historial, reglas académicas y necesidad de separar la robustez de la mejora del horario. El cambio cuantitativo se acompañó de una transformación arquitectónica. Streamlit fue útil para validar la idea, pero el historial y la navegación entre corridas justificaron una interfaz Next.js conectada a FastAPI. SQLite y los directorios de artefactos sustituyeron la dependencia de una sesión activa. El prototipo anterior se conservó como evidencia de evolución, no como interfaz oficial final.

El caso de calibración final utiliza un fixture de seis sesiones y se ejecutó en modo ligero, sin Búsqueda Tabú, con semilla 42. El baseline y la salida A+B conservaron cinco aulas asignadas, una tasa de 83.33 %, cero conflictos de aula, profesor y sección, cero excesos de capacidad, H igual a cero, F igual a 4.7776 y Φ igual a 4.78. Este resultado no demuestra una mejora, porque la instancia ya era factible. Su valor es otro: confirma que las fases de construcción y reparación no degradaron una propuesta válida ni alteraron su costo suave. En ingeniería de optimización, preservar una solución correcta es tan importante como mejorar una defectuosa. La estabilidad es un resultado válido aunque no implique una reducción. En este caso, A+B recibió una instancia ya factible y mantuvo intactos sus indicadores, demostrando que el pipeline no introdujo conflictos al procesarla. La prueba también establece un límite interpretativo: al no ejecutarse Tabú y utilizar solo seis sesiones, no sirve para afirmar rendimiento, escalabilidad ni superioridad algorítmica.

Gráfico de barras: restricciones duras de 8 a 20, criterios blandos de 7 a 13 y canales de ejecución de 2 a 4 entre el anteproyecto y la versión final
Figura 6. Evolución cuantitativa del alcance implementado. Fuente: elaboración propia a partir del registro final del proyecto.

El proyecto también conserva evidencia histórica del prototipo Streamlit. En una corrida de una configuración anterior, la interfaz mostró una reducción de noventa violaciones duras a cero y de veinticuatro choques de profesor a cero, con una tasa final de aulas asignadas de 91.67 % y una puntuación global de 135.52. Estos números no se utilizan como benchmark del modelo final H1-H20 porque cambiaron las reglas, los pesos y la implementación. Mantener la captura, en lugar de mezclarla con la calibración actual, fortalece la honestidad experimental: permite observar la evolución del producto y, al mismo tiempo, evita presentar resultados incompatibles como si pertenecieran a una sola evaluación. La corrida histórica conserva valor como prueba de concepto porque evidencia que el flujo anterior podía eliminar conflictos concretos. Sin embargo, sus pesos, reglas y arquitectura eran distintos. Presentarla separadamente evita una comparación engañosa con el modelo final H1-H20. Esta distinción entre evidencia histórica y benchmark reproducible es necesaria para que el análisis no convierta resultados de etapas diferentes en una sola narrativa cuantitativa.

Gráfico de barras: costo suave F igual a 4.7776 en el baseline y en la salida A+B, con H igual a cero en ambos estados
Figura 7. Caso de calibración: estabilidad de una instancia factible. Fuente: elaboración propia a partir de calibration_baseline_kpis.json.

En la arquitectura final, una ejecución puede iniciarse, persistirse, consultarse y exportarse a través de capas separadas. La API dispone de rutas para validar archivos, crear corridas, consultar historial, recuperar el horario, revisar indicadores y generar exportaciones. Los artefactos por corrida incluyen manifest.json, parameters.json, summary.json, counts.json, baseline_schedule.csv, optimized_schedule.csv y, bajo demanda, un PDF institucional. La interfaz Next.js organiza el flujo alrededor de carga, ejecución, historial y detalle, con vistas de indicadores, comparación, evolución, horario y robustez. La evidencia técnica es cualitativamente amplia, aunque el proyecto reconoce que no se conservó un reporte agregado de cobertura asociado al corte final. La API organiza rutas para validar, crear corridas, listar historial, consultar detalle, paginar el horario, recuperar KPIs y exportar CSV, JSON o PDF. Docker Compose coordina frontend y backend en un entorno reproducible. Las pruebas verifican flujos de ingesta, modelo, optimización e interfaces, aunque el corte analizado no conserva un porcentaje agregado de cobertura que permita resumir toda la suite en una cifra.

Captura del dashboard Streamlit del prototipo con el resumen del resultado y la comparación antes y después de la optimización
Figura 8. Captura histórica del dashboard Streamlit conservada como evidencia del prototipo. Fuente: evidencia visual incluida en el informe final de MOSAIC; corresponde a una configuración legacy.

La robustez aporta una lectura que no aparece en una comparación nominal. H igual a cero es una condición necesaria, pero no suficiente para afirmar que una propuesta soportará cambios. Una tasa de factibilidad baja bajo escenarios indicaría que el horario depende de recursos sin alternativas; una dispersión alta de F revelaría sensibilidad de la calidad aunque no aparezcan nuevos conflictos. En el corte analizado, Ω está integrado y sus métricas están definidas, pero no existe un archivo institucional publicable con resultados finales de escenarios. Por eso, el artículo presenta esta capacidad como una función implementada y no como una mejora cuantitativa ya demostrada. La distinción protege la validez del proyecto y señala con claridad el experimento que falta. Esta lectura preventiva ayuda a elegir entre horarios aparentemente equivalentes. Una solución que utiliza aulas al límite o concentra sesiones en pocos recursos puede ser más frágil que otra con igual H y un margen mayor. El componente permite formular esa discusión con métricas, aunque todavía falta una corrida Ω sobre una instancia institucional publicable para demostrar una mejora cuantitativa en condiciones reales.

Los resultados deben leerse con límites explícitos. MOSAIC no certifica un óptimo global para todo un campus; la reasignación temporal CP-SAT se reduce en instancias grandes; los pesos de los trece criterios blandos necesitan calibración con responsables académicos; y las reglas H9-H20 dependen de tablas auxiliares completas y vigentes. Tampoco se realizó una prueba controlada con usuarios institucionales ni una integración con el sistema de gestión académica. En seguridad, el aislamiento local es adecuado para una tesis, pero una adopción real requiere autenticación, roles, auditoría, cifrado de respaldos, observabilidad y controles de descarga. Estas limitaciones no invalidan el trabajo; delimitan lo que puede afirmarse y orientan la siguiente etapa. Las limitaciones no invalidan el trabajo, sino que definen el significado de sus resultados. La evidencia es fuerte en trazabilidad, arquitectura y cobertura funcional; es más limitada en benchmarks de gran escala, validación con usuarios y seguridad productiva. Reconocer esa distribución impide extrapolar una prueba controlada a un campus completo y orienta de manera concreta las actividades de una siguiente fase.

Diagrama conceptual de escenarios de robustez Ω según la demanda y la indisponibilidad de recursos
Figura 9. Espacio conceptual de escenarios para la evaluación Ω. Fuente: elaboración propia a partir del componente de robustez de MOSAIC.

Lo que MOSAIC demuestra y lo que todavía debe demostrar

La principal contribución de MOSAIC no es prometer un horario perfecto, sino demostrar una forma más rigurosa de construir, medir y discutir propuestas. El proyecto integra datos imperfectos, reglas institucionales, optimización híbrida y una capa de producto capaz de conservar el historial. La estrategia hard-first resulta coherente con el dominio: primero se protege la operación académica y luego se mejoran preferencias. La trazabilidad entre modelo, código, pruebas y artefactos permite explicar qué ocurrió en cada fase y evita que la salida dependa de una sesión efímera o de una captura aislada. Esta combinación aproxima el trabajo a los sistemas de apoyo a decisiones descritos en la literatura, donde la utilidad depende tanto del cálculo como de la comprensión del resultado [2], [14]. Ese enfoque es relevante porque la programación académica contiene excepciones legítimas que no siempre deben automatizarse. La herramienta puede señalar el costo y la consecuencia de una decisión, pero la aprobación final permanece en el comité. La explicabilidad, entonces, no es un complemento visual: es el mecanismo que permite combinar capacidad computacional con responsabilidad institucional y documentar por qué se aceptó una alternativa.

El paso siguiente debe ser un piloto institucional paralelo al proceso actual. Antes de integrar registros de producción, conviene construir un benchmark anonimizado y versionado con tamaños crecientes, múltiples semillas y métricas H, F, Φ, tiempo y FeasRate. Los pesos deben calibrarse mediante sesiones con coordinación académica y un comité responsable de reglas. El piloto debería comparar la línea base con propuestas de MOSAIC, registrar excepciones y medir no solo la calidad del horario, sino el tiempo de revisión, la claridad de las explicaciones y la confianza de los usuarios. Solo después de validar datos, políticas y experiencia de uso sería razonable avanzar hacia una integración gradual con el sistema institucional. Un diseño de evaluación riguroso debería incluir casos nominales y perturbados, comparaciones por tamaño y sesiones de revisión con usuarios. También conviene registrar cuántas advertencias requieren intervención, qué reglas producen más conflictos y cuánto tiempo se reduce en la preparación y verificación. Estas medidas conectarían el rendimiento técnico con el impacto organizacional que justifica la adopción de la plataforma.

También será necesario fortalecer el gobierno tecnológico. Las configuraciones de pensum, límites docentes, franjas reservadas y aulas especializadas deben tener responsables, fechas de vigencia y procedimientos de actualización. Un solver puede ejecutar correctamente una regla obsoleta y producir un resultado difícil de detectar; por eso, la mantenibilidad no depende únicamente del código. En el plano técnico, lint y formato deben convertirse en controles bloqueantes de integración continua, las pruebas de rendimiento deben cubrir instancias mayores y Ω puede evolucionar desde la evaluación hacia mecanismos de recuperación o reoptimización. En el plano de seguridad, la autenticación institucional, la autorización por roles y la auditoría de exportaciones son condiciones previas para utilizar información real. La sostenibilidad exige además documentación que sobreviva al equipo desarrollador. Las reglas, contratos, endpoints y decisiones de arquitectura deben mantenerse alineados con el código y con el ciclo académico vigente. Un proceso de control de cambios permitiría saber quién modificó una política, desde cuándo aplica y qué corridas deben repetirse. Esa disciplina convierte la trazabilidad técnica en gobierno institucional.

El impacto potencial se extiende más allá de la construcción de un horario. Una planificación mejor documentada puede reducir correcciones tardías, facilitar la coordinación entre escuelas, hacer más transparente el uso de aulas y ofrecer evidencia para discutir inversiones en infraestructura. También puede convertir los conflictos recurrentes en conocimiento institucional: si determinadas franjas, capacidades o asignaturas concentran problemas en varios ciclos, la universidad puede actuar sobre la causa y no únicamente sobre cada incidencia. Este horizonte requiere colaboración entre ingeniería, registro, coordinaciones, docentes y autoridades. MOSAIC propone un lenguaje común basado en datos, restricciones y métricas, pero su evolución dependerá de que esas áreas validen las reglas y definan qué significa calidad en su contexto. El siguiente paso no es automatizarlo todo, sino abrir un piloto controlado donde el sistema pueda ser cuestionado, corregido y medido antes de asumir responsabilidades operativas mayores.

MOSAIC muestra cómo un proyecto final de grado puede conectar investigación operativa, ingeniería de software y necesidades concretas de la gestión universitaria. Su valor está en convertir un proceso frecuentemente manual en una secuencia observable: recibir, validar, medir, construir, reparar, mejorar, someter a escenarios y conservar evidencia. La plataforma todavía necesita validación externa y madurez productiva, pero deja una base clara para continuar investigando y colaborando con las áreas académicas. En lugar de presentar la automatización como sustituto del criterio humano, propone una relación más responsable: que los algoritmos reduzcan el trabajo repetitivo, expongan conflictos y permitan que las decisiones finales se tomen con información verificable, contexto institucional y capacidad de rendir cuentas. El proyecto aporta también una experiencia formativa: obligó a traducir políticas académicas a modelos comprobables, distinguir factibilidad de preferencia y comunicar incertidumbre sin ocultarla. En un contexto donde se promueven universidades inteligentes, este tipo de trabajo muestra que la innovación no consiste solo en agregar inteligencia artificial, sino en construir sistemas confiables, auditables y coherentes con las responsabilidades de sus usuarios.

Referencias

  1. S. Ceschia, L. Di Gaspero, and A. Schaerf, “Educational timetabling: Problems, benchmarks, and state-of-the-art results,” European Journal of Operational Research, vol. 308, no. 1, pp. 1-18, 2023, doi: 10.1016/j.ejor.2022.07.011.
  2. G. Xue, O. F. Offodile, R. Razavi, D.-H. Kwak, and J. Benitez, “Addressing staffing challenges through improved planning: Demand-driven course schedule planning and instructor assignment in higher education,” Decision Support Systems, vol. 187, Art. no. 114345, 2024.
  3. S. Abdipoor, R. Yaakob, S. L. Goh, and S. Abdullah, “Meta-heuristic approaches for the University Course Timetabling Problem,” Intelligent Systems with Applications, vol. 19, Art. no. 200253, 2023, doi: 10.1016/j.iswa.2023.200253.
  4. R. Esmaeilbeigi, V. Mak-Hau, J. Yearwood, and V. Nguyen, “The multiphase course timetabling problem,” European Journal of Operational Research, vol. 300, no. 3, pp. 1098-1119, 2022, doi: 10.1016/j.ejor.2021.10.014.
  5. F. Dunke and S. Nickel, “A matheuristic for customized multi-level multi-criteria university timetabling,” Annals of Operations Research, vol. 328, no. 2, pp. 1313-1348, 2023, doi: 10.1007/s10479-023-05325-2.
  6. A. Bashab et al., “Optimization Techniques in University Timetabling Problem: Constraints, Methodologies, Benchmarks, and Open Issues,” Computers, Materials & Continua, vol. 74, no. 3, pp. 6461-6484, 2023, doi: 10.32604/cmc.2023.034051.
  7. C. B. Mallari, J. L. San Juan, and R. Li, “The University Coursework Timetabling Problem: An Optimization Approach to Synchronizing Course Calendars,” Computers & Industrial Engineering, vol. 184, Art. no. 109561, 2023, doi: 10.1016/j.cie.2023.109561.
  8. T. Müller, H. Rudová, and Z. Müllerová, “Real-world university course timetabling at the International Timetabling Competition 2019,” Journal of Scheduling, vol. 28, pp. 247-267, 2025, doi: 10.1007/s10951-023-00801-w.
  9. E. Steiner, U. Pferschy, and A. Schaerf, “Curriculum-based university course timetabling considering individual course of studies,” Central European Journal of Operations Research, vol. 33, pp. 277-314, 2025, doi: 10.1007/s10100-024-00923-2.
  10. M. Davison, A. Kheiri, and K. G. Zografos, “Modelling and solving the university course timetabling problem with hybrid teaching considerations,” Journal of Scheduling, vol. 28, pp. 195-215, 2025, doi: 10.1007/s10951-024-00817-w.
  11. M. Chen et al., “A randomized tabu search for university course timetabling,” Computers & Operations Research, vol. 123, Art. no. 105007, 2020, doi: 10.1016/j.cor.2020.105007.
  12. M. Chiarandini, K. Socha, M. Birattari, and O. Rossi-Doria, “An effective hybrid algorithm for university course timetabling,” Journal of Scheduling, vol. 9, pp. 403-432, 2006, doi: 10.1007/s10951-006-8495-8.
  13. K. Okoye et al., “Impact of digital technologies upon teaching and learning in higher education in Latin America: An outlook on the reach, barriers, and bottlenecks,” Education and Information Technologies, vol. 28, no. 2, pp. 2291-2360, 2023, doi: 10.1007/s10639-022-11214-1.
  14. A. Stojanov and B. K. Daniel, “A decade of research into the application of big data and analytics in higher education: A systematic review of the literature,” Education and Information Technologies, vol. 29, no. 5, pp. 5807-5831, 2024, doi: 10.1007/s10639-023-12033-8.
  15. K. Polin, T. Yigitcanlar, M. Limb, and T. Washington, “The Making of Smart Campus: A Review and Conceptual Framework,” Buildings, vol. 13, no. 4, Art. no. 891, 2023, doi: 10.3390/buildings13040891.
  16. R. Sequeira, A. Reis, P. Alves, and F. Branco, “Roadmap for Implementing Business Intelligence Systems in Higher Education Institutions: Systematic Literature Review,” Information, vol. 15, no. 4, Art. no. 208, 2024, doi: 10.3390/info15040208.
  17. E. Rappos, E. Thiémard, S. Robert, and J.-F. Hêche, “A mixed-integer programming approach for solving university course timetabling problems,” Journal of Scheduling, vol. 25, no. 4, pp. 391-404, 2022.

Arquitectura analítica de datos para mejorar las decisiones en la universidad: un prototipo de lakehouse académico

Carolina Bencosme Gómez y Jean Carlos Pérez Ortega – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Las universidades no carecen de datos. Carecen de un lugar común, gobernado y reutilizable donde esos datos dejen de ser un extracto de fin de cuatrimestre y pasen a ser un insumo de decisión. Matrícula, rendimiento, ayuda económica y trayectoria ocurren todos los días en el sistema académico. Lo que suele faltar es una capa analítica que no compita con el sistema transaccional ni dependa de un único proveedor comercial para almacenar, curar y consultar. Este artículo resume un proyecto de grado de Ingeniería en Ciencias de la Computación desarrollado en la Pontificia Universidad Católica Madre y Maestra. Carolina Bencosme Gómez y Jean Carlos Pérez Ortega diseñaron e implementaron un prototipo de arquitectura de datos de código abierto, tipo lakehouse, con el fin de mostrar cómo una institución de educación superior puede integrar extractos académicos y alimentar, desde el mismo suelo, proyección de matrícula y predicción de retención.

La motivación no fue adornar el expediente con un dashboard. Fue una brecha concreta: planificación y acompañamiento piden series y segmentos de riesgo, y el ERP responde con pantallas de trámite. La literatura de analítica institucional describe ese desajuste desde hace años. El valor no aparece por acumular registros, sino por alinear dato, modelo y decisión [1], [2], [5]. En América Latina la adopción de inteligencia artificial en educación ha crecido, pero con evidencia desigual y con poca infraestructura de datos que sostenga el modelo después del artículo [3], [6]. La transformación digital de una universidad no es comprar una licencia de reportes. Es cambiar dónde vive la verdad analítica y quién puede consultarla sin copiar tablas a un correo [4], [16].

El recorte fue deliberado. No se pretendió el almacén de toda la institución ni un conector permanente al sistema académico de producción. Se pretendió demostrar que un lago con propiedades transaccionales, un modelo dimensional y dos preguntas de negocio bastan para un ciclo completo: aterrizar, curar, modelar y consumir. Eso importa para otras instituciones de educación superior porque el beneficio no está en una nube hipotética. Está en poder empezar con extractos tabulares, hardware modesto y software abierto, sin hipotecar el dato a un formato propietario [8], [9], [14]. Si el prototipo funciona en un computador portátil con contenedores reproducibles, el argumento deja de ser de catálogo y pasa a ser de ingeniería. Por indicación de la dirección del proyecto, las series, volúmenes y capturas de dashboard de este artículo son un banco sintético de demostración, generado en local. Los extractos canónicos del prototipo se depositaron en custodia de la asesora y no se reproducen aquí.

El lector de este blog no necesita ser ingeniero de plataformas. Sí necesita una tesis clara. Una IES puede implementar una arquitectura abierta que separe almacenamiento de cómputo, que publique marts legibles por inteligencia de negocios y que deje al científico de datos trabajar sobre vistas ya unidas. El precio de esa promesa es honesto: el prototipo no opera veinticuatro horas, no sustituye al ERP y no afirma política de cupos ni de expulsión. Afirma un método exportable, con métricas de holdout del experimento y con límites que se dicen en voz alta. Esas métricas no son los puntos dibujados en las figuras de demostración.

El ERP resuelve la operación. No resuelve la pregunta analítica

En la PUCMM, como en otras universidades dominicanas, los portales de matrícula y de aula cumplen su trabajo: inscribir, publicar notas, entregar evidencias. Eso no equivale a disponer de un repositorio analítico con grano explícito, calidad medible y linaje. El analista pide un recuento por plan y campus. El sistema responde con una transacción de inscripción. Entre ambas capas alguien exporta, une y olvida de qué período era el archivo. Esa práctica no es negligencia personal. Es el síntoma de una arquitectura que nunca contempló el consumo analítico como un producto [1], [7], [13].

El patrón se repite fuera del país. Universidades que construyen plataformas de datos educativos reportan las mismas fricciones: fuentes heterogéneas, calidad irregular y ausencia de un contrato estable entre quien produce el dato y quien lo modela [8]. Las revisiones sobre inteligencia artificial en educación superior insisten en que los modelos aparecen más rápido que las condiciones para usarlos con justicia y con contexto pedagógico [6]. Un clasificador de abandono sin dashboard que llegue a orientación es un ejercicio de laboratorio. Un dashboard sin capa curada es un dibujo sobre un CSV semanal. El problema no es la falta de algoritmos. Es la falta de una capa intermedia gobernada [11], [12].

El almacén de datos clásico y el lago de archivos resuelven mitades. El primero ofrece esquema y SQL, pero se vuelve rígido cuando llega un dominio nuevo. El segundo admite cualquier archivo, pero entrega caos en cuanto dos cuadernos leen versiones distintas. El lakehouse surge para no escoger entre esos dos males. Unifica el almacenamiento de objetos con tablas que admiten transacciones, evolución de esquema y consulta SQL [9], [14], [17]. No es magia. Es un pacto de formato abierto: el motor de consultas, el cuaderno y el dashboard hablan de tablas, no de carpetas con fecha en el nombre.

Hay un segundo vacío local. Las estrategias nacionales de datos e inteligencia artificial hablan de infraestructuras compartidas y de incorporar analítica en educación. El documento de política no construye el catálogo ni el mart. Si una universidad espera el hub nacional para empezar, seguirá pegando hojas en cada ciclo lectivo. Si empieza con extractos propios y software abierto, gana soberanía sobre el dato y una base sobre la cual, más adelante, sí podrá conectar el sistema transaccional con ventanas controladas [4], [16]. Ese orden importa: primero el contrato interno, después el conector.

Las suites comerciales de inteligencia de negocios tampoco cierran solas la brecha. Un dashboard pegado al ERP hereda la carga operativa y la semántica del trámite. Un dashboard pegado a un archivo plano hereda la caducidad del archivo. El beneficio de una arquitectura abierta no es ahorrar la licencia del visor, que la institución puede seguir usando. El beneficio es que el visor deje de ser el lugar donde se limpia el dato. Limpieza, grano y calidad viven abajo. El dashboard solo consume. Esa inversión de responsabilidades es la que la literatura de inteligencia de negocios describió cuando distinguió almacenamiento de impacto [5]. Aquí se traduce a un campus que no puede, o no debe, saturar Oracle con consultas de exploración.

La comparación internacional no debe leerse como receta. Las plataformas documentadas en acceso abierto suelen asumir nube institucional, equipos de datos y convenios estables con el sistema académico [8]. Una IES dominicana de tamaño medio suele tener otra realidad: hardware personal de los tesistas, restricciones de privacidad, y un acceso a producción que no es un servicio, sino una ventana. Experiencias de campus que montan una arquitectura de datos abierta para servicios institucionales muestran que el patrón es viable, siempre que el dato no se confunda con el trámite cotidiano [18]. El estado del arte dice qué arquitectura es razonable. No dice cómo bajarla a un prototipo que quepa en laptops y que, aun así, entregue métricas reproducibles. Ese hueco es el que este proyecto intentó ocupar, sin pretender que el resultado sea ya política institucional.

En retención, además, el debate ya no es si se puede predecir el abandono. Es si la predicción llega a quien interviene y si el dashboard se entiende [11]. Revisiones regionales recuerdan que la deserción es un fenómeno con causas académicas, económicas y de trayectoria, y que un único indicador suele mentir [12]. Una arquitectura abierta no “resuelve” la deserción. Permite publicar un scoring con linaje, un segmento de riesgo y una vista individual sin reconstruir el análisis en una hoja privada. El beneficio institucional es de gobierno del dato, no de milagro pedagógico.

Qué se dio por cumplido

El desarrollo de este proyecto implementó un prototipo de arquitectura analítica tipo lakehouse, de componentes abiertos, adaptada a las restricciones de una institución de educación superior dominicana, con el propósito de integrar extractos académicos y habilitar decisiones basadas en datos. El objetivo general se desglosó en tres resultados verificables. Primero, un análisis de brechas entre el enfoque transaccional local y las arquitecturas lakehouse y de analítica institucional descritas en la literatura. Segundo, el diseño e implementación de un flujo por capas de aterrizaje, curación dimensional y mart de consumo, desplegable de forma reproducible en contenedores, con consulta SQL unificada y entornos de exploración para el científico de datos. Tercero, dos casos de uso académicos, cerrados hasta dashboard, que proyectan matrícula por carrera y campus con modelos de series temporales y priorizan riesgo de retención con un clasificador evaluado en un holdout temporal. El alcance es una prueba de concepto operable, no un sistema institucional continuo ni un conector de producción al ERP. La conexión permanente al sistema académico, la migración a servidores de la universidad y la operación continua del orquestador quedan explícitamente como trabajo futuro.

Un flujo, dos preguntas de negocio

La metodología partió de un recorte de producto, no de un catálogo de herramientas. Si el lakehouse no respondía a una decisión existente, se convertía en infraestructura sin dueño. Se eligieron dos preguntas que ya viven en la universidad. Cuántos alumnos esperar por plan y campus en los siguientes ciclos. A quién priorizar en acompañamiento si el riesgo de no retener se estima con historial académico. La primera sirve para la planificación. La segunda, la orientación. El analista interviene en ambas. El dashboard es el contrato de consumo, no el lugar donde se inventa el modelo [5], [11].

Diagrama de casos de uso: planificación, orientación y analista de datos usan el prototipo para proyectar matrícula y priorizar riesgo de retención
Figura 1. Casos de uso del prototipo: proyección de matrícula y predicción de retención.

Esa división no es cosmética. Matrícula y retención no comparten el mismo grano. La primera es una serie por plan, campus y período: una celda, una cuenta de alumnos. La segunda, en el modelo publicado, es estudiante por carrera y año de observación, con señales de carga, índice y ayuda. Forzar ambos dominios en una sola tabla ancha habría sido más rápido de dibujar y más caro de mantener. El modelado dimensional clásico sigue siendo el antídoto contra ese atajo [10]. Dos espacios de trabajo sobre la misma plataforma, con catálogos distintos, fue el trade-off: más orquestación, menos contaminación de semántica.

Capas, no un único servidor con todos los roles

El diseño lógico separa fuente, flujo gobernado, exploración y consumo. La fuente canónica sigue siendo el sistema académico institucional. En el prototipo, sin embargo, no se consulta en vivo de forma permanente. Las consultas pesadas se materializaron como archivos planos de respaldo. Las conexiones seguras de red se usaron solo para diagnóstico. El túnel no se sostuvo como camino diario, y eso se aceptó como hallazgo de implementación, no como nota al pie. Una IES que copie el método debe planear el extracto offline como camino realista mientras no exista un conector de solo lectura con ventana controlada [8], [14].

Diagrama de bloques: extracto tabular, pipelines de curación, almacén de objetos, catálogo de tablas abiertas, motor SQL, cuadernos y tableros de negocio
Figura 2. Diagrama de bloques del prototipo: extracto tabular, curación, almacén de objetos, catálogo de tablas abiertas, motor SQL y dashboards.

Sobre el almacén de objetos se montaron tablas de formato abierto y catálogo, de modo que el motor SQL y los cuadernos hablen el mismo lenguaje de tablas [9], [14]. El flujo productivo recorre aterrizaje en bruto, curación dimensional y publicación del mart. En paralelo, el analista explora la capa curada en un entorno acotado y solo promueve a consumo lo validado. Esa es la decisión que más beneficio institucional produce y la que más disciplina exige. Si el científico escribe el mart desde el cuaderno, el dashboard vuelve a ser un silo. Si el dashboard escribe reglas de negocio que el modelo no versiona, el scoring deja de ser auditable.

Diagrama de flujo: extracto tabular, aterrizaje en bruto, verificación de contrato, curación dimensional, verificación de calidad, modelado y mart de consumo
Figura 3. Flujo gobernado: aterrizaje, curación dimensional, modelado de las dos preguntas y mart de consumo. Si falla el contrato o la calidad, la corrida se detiene.

Distribuir componentes evita saturar un solo servidor con todos los roles. El almacenamiento masivo no es el motor de consultas. El motor no es el cuaderno. El cuaderno no es el dashboard. En hardware de laptop esa separación también es una defensa contra la memoria agotada. El prototipo no demostró escalamiento a miles de usuarios concurrentes. Demostró que el patrón no obliga a copiar el lago dentro de la herramienta de reportes. Para una IES, eso es el beneficio práctico de lo abierto: se puede cambiar el visor o el motor sin rehacer el contrato de tablas [9], [17].

La orquestación se pensó como dependencias estrictas, no como un reloj que afirma disponibilidad continua. Una corrida tiene identificador, recorre aterrizaje, calidad, transformación y publicación, y deja un resumen auditable. Si falla la ingesta, no avanza la curación. Si falla la calidad, no se publica el mart. El formato de tablas abiertas fue el que otorgó propiedades transaccionales al lago: no se trata de “archivos más ordenados”, sino de poder volver a un estado coherente [14]. Afirmar operación continua sería adelantar un resultado que no se midió. El beneficio medido es reproducibilidad de la evidencia, no un acuerdo de nivel de servicio.

Entorno local del prototipo: almacén de objetos, catálogo, cuadernos y motor SQL, con consumo en inteligencia de negocios
Figura 4. Entorno local del prototipo: almacén, catálogo, cuadernos y motor SQL.

El empaquetado en contenedores fue, además, una decisión de metodología de equipo. El hardware del proyecto no es un clúster. Son computadores portátiles con arquitecturas distintas. Sin imágenes compartidas, cada integrante instala a mano el almacén, el catálogo, el motor SQL y el seguimiento de experimentos, con versiones que no coinciden y resultados que un tercero no puede auditar. Lo abierto aquí no es un eslogan. Es la única forma razonable de que dos estudiantes y una asesora vean el mismo prototipo. Una IES que adopte el patrón puede, más adelante, mover esos mismos contratos a servidores institucionales. El prototipo no hizo esa migración. La deja como futuro explícito [8].

Cómo se modeló sin reescribir la limpieza en cada cuaderno

Para matrícula se construyó una vista compacta: el hecho ya unido a nombres de dimensión, lista para series temporales. El científico no arma la unión de planes y periodos en el cuaderno. Lee la compacta y entrena. Eso parece menor hasta que se cuenta cuántas veces un proyecto estudiantil vuelve a limpiar el mismo extracto [2], [10]. El candidato usado en el piloto reconoce estacionalidad de tres periodos académicos por año, coherente con el calendario de la institución y con la práctica estándar de series temporales [15].

Para retención se evitó entrenar sobre el detalle crudo de cada inscripción. El panel canónico agrega al año de observación señales de asignaturas, créditos, índice, ayuda económica, campus, sexo y facultad. La transición normal entre programas equivalentes de ciencias de la salud no entra al scoring de riesgo: confundirla con abandono habría inflado el drama y mentido al dashboard. El holdout fue temporal, no aleatorio. En datos académicos, barajar filas mezcla el futuro con el pasado y produce una precisión que no se puede gastar [6], [12]. El trade-off es una prueba más honesta y, a veces, un número menos lisonjero.

El consumo se diseñó para no crear un tercer silo. El mart se consulta con el motor SQL del lakehouse. Los dashboards leen ese mart. Los experimentos de series temporales y de clasificación se registran con identificadores de corrida. Las compuertas de calidad se colocaron donde duele: contrato de columnas al aterrizar, consistencia semántica al curar, y no publicar si el mart no cumple el umbral acordado. No se usaron identificadores más allá de los necesarios para el grano. No se trajo correo ni texto libre de plataformas de aula. No se prometió personalización clínica. El beneficio de lo abierto no incluye, en este prototipo, un producto de bienestar estudiantil con datos de salud [3], [11].

Lo que el prototipo llegó a medir

Las métricas de holdout que siguen describen el experimento de evaluación del prototipo. Las figuras de este apartado, en cambio, muestran un banco sintético de demostración: mismas formas de análisis, volúmenes distintos, leyendas etiquetadas como sintéticas. No se afirma que el error de matrícula se mantenga en producción ni que el clasificador sustituya al criterio de orientación [1], [5]. El prototipo corre en local. Eso limita la generalización y, a la vez, obliga a un contrato repetible: si se refresca el extracto, se puede volver a publicar el mart y comparar.

En Medicina, campus Santiago, el candidato estacional de tres periodos replicó el ritmo de inscripción en la prueba. El error absoluto medio fue de 32 alumnos y el error porcentual absoluto medio, de 3,0 por ciento. El historial de entrenamiento, el holdout y la proyección se leen en la misma gráfica. El ciclo académico se ve. Eso es lo que la planificación puede usar como insumo, no como oráculo [15].

Gráfica de matrícula de Medicina en Santiago: entrenamiento, prueba y pronóstico estacional
Figura 5. Proyección de matrícula, Medicina, campus Santiago. Banco sintético de demostración.

Ingeniería Industrial y de Sistemas, en el mismo campus, usó el mismo tipo de modelo estacional. El pronóstico sigue el diente de sierra académico, pero en el tramo final de la prueba la matrícula de holdout se separó al alza. El error porcentual absoluto medio subió a 8,5 por ciento y el error absoluto medio, a 21,1 alumnos. El modelo no “falló el calendario”. Falló el nivel en un tramo. Esa distinción importa si alguien pretende dimensionar la oferta con una serie frágil. En Santo Domingo, Medicina marcó 1,7 por ciento de error porcentual absoluto medio e Ingeniería Industrial y de Sistemas, 14,8 por ciento con candidato no estacional.

Gráfica de matrícula de Ingeniería Industrial y de Sistemas en Santiago: entrenamiento, prueba y pronóstico estacional
Figura 6. Proyección de matrícula, Ingeniería Industrial y de Sistemas, campus Santiago. Banco sintético de demostración.

El mayor logro técnico de este caso no es el número más bajo. Es que ambos algoritmos leyeron la compacta de la capa curada. El científico no reescribió la limpieza. El dashboard de proyección, conectado al mart mediante el motor SQL, concentra histórico y proyección de las dos carreras del piloto. El beneficio institucional es poder ver demanda sin interrogar el sistema de matrícula en vivo [5], [8].

Dashboard de proyección de matrículas con filtros de campus, año, plan de estudios y la serie histórica y proyectada por ciclo
Figura 7. Dashboard de proyección de matrícula. Captura de demostración con volúmenes sintéticos.

En clasificación, el holdout temporal eligió aumento de gradiente. Exactitud 0,857, medida F1 0,909 y área bajo la curva ROC 0,867. El bosque aleatorio quedó cerca en área bajo la curva, 0,860. La regresión logística alcanzó precisión 0,939 a costa de un recall de 0,650. No se eligió el modelo más “preciso” en un cartel. Se eligió el que mejor equilibró discriminación y exhaustividad sobre datos no vistos en el tiempo. Ese criterio es más aburrido y más usable que coronar un campeón por una sola métrica [6], [11]. El área bajo la curva indica discriminación útil en prueba. No indica el umbral de intervención. Ese umbral es política de orientación, no un parámetro que el prototipo imponga.

El scoring publicado es otro objeto. En el banco de demostración son 82 400 filas estudiante-carrera, con 44,0 por ciento en riesgo bajo, 13,2 por ciento medio, 23,6 por ciento alto y 19,2 por ciento crítico. Alto y crítico suman 42,8 por ciento. Mezclar ese universo con el holdout sería deshonesto [11], [12].

Gráfico de barras con los segmentos de riesgo bajo, medio, alto y crítico del scoring de retención
Figura 8. Segmentos de riesgo del scoring publicado.

El dashboard de retención tiene dos caras, y conviene no mezclarlas. La vista agregada diagnostica deserción descriptiva por sexo, facultad y quinquenio. La vista individual prioriza un historial de ejemplo. Juntas, cierran el ciclo de consumo: el mart se lee en inteligencia de negocios, no se reanaliza en una hoja suelta. Los KPI del dashboard descriptivo no son las métricas del clasificador. Las capturas que siguen son de demostración: no deben citarse como deserción institucional [1], [11].

Dashboard de retención estudiantil con tasa de deserción, distribución por sexo y facultad y tendencia por quinquenio
Figura 9. Dashboard de retención, vista general. Captura de demostración con indicadores sintéticos.
Dashboard individual con probabilidad de retención, probabilidad de graduación y variables consideradas
Figura 10. Dashboard de retención, vista individual.

Ejemplo sintético (IIS, FCI, Santiago): retención 27 por ciento y graduación 34 por ciento. El indicador de graduación es un proxy de dashboard, no el target k a k+1 del clasificador.

Lo que no salió como se pensó

Tres resultados no estaban en el plan. El acceso seguro al sistema académico no se sostuvo: quedó como prueba de diagnóstico y el extracto fuera de línea cargó con el piloto. El dominio clínico del anteproyecto dejó de aportar en cuanto los historiales académicos bastaron para cerrar los dos casos. Y en el dashboard de riesgo hubo que calibrar por índice académico; sin esa regla, el scoring subestima la exigencia de la prueba y distorsionaba la cola de acompañamiento. Ninguno de los tres es un fracaso de la arquitectura abierta. Son el tipo de hallazgo que solo aparece cuando se implementa, no cuando se dibuja la lámina.

Qué gana una institución si copia el método, no la etiqueta

El prototipo demuestra algo más modestamente útil que declarar a la universidad “orientada por datos”. Demuestra que extractos académicos pueden aterrizar, curarse en un modelo dimensional y alimentar, sin rehacer la limpieza, un modelo de matrícula y un clasificador de retención, con dashboards que leen el mart. La separación de almacenamiento y cómputo evitó saturar el sistema transaccional con analítica. La separación de espacios de trabajo evitó el monolito en el que matrícula y deserción se pisan el esquema. Las métricas, imperfectas y desiguales entre series, son suficientes para una prueba de concepto e insuficientes para fijar política de cupos o de expulsión [5], [14], [15].

Los beneficios concretos, si otra IES adopta el patrón, se pueden enumerar sin inflar el lenguaje. Primero, soberanía del dato: el formato abierto y el aterrizaje propio reducen la hipoteca a un único fabricante [9], [17]. Segundo, no competir con el ERP: la consulta pesada vive fuera del trámite [8]. Tercero, reproducibilidad en hardware heterogéneo, gracias a contenedores y a corridas con identificador. Cuarto, un contrato de consumo: el científico lee compactas, el dashboard lee el mart, y el linaje explica de dónde salió el número. Quinto, dos productos de decisión sobre la misma plataforma, lo que abarata el segundo dominio respecto de empezar de cero. Sexto, evidencia de calidad por corrida, no una foto de un dashboard sin fecha. Nada de eso requiere declarar una transformación digital nacional. Requiere disciplina de grano y de capas [4], [10], [16].

El aprendizaje más exportable no es el nombre de un contenedor. Es ese contrato. Donde no existe, el siguiente estudiante volverá a unir archivos planos. Donde existe, se puede cambiar el modelo y conservar el linaje. Esa es la diferencia entre un cuaderno brillante y una plataforma, aunque la plataforma aún quepa en un computador portátil [5], [14]. Hay un límite de honestidad que conviene no cruzar. El prototipo no demostró que integrar todas las fuentes de la universidad aumente la precisión de los modelos. Demostró dos dominios académicos con extractos definidos. Tampoco demostró políticas de seguridad de acceso en un directorio institucional. El aislamiento fue el del equipo local. Quien cite este trabajo como si ya hubiera un hub nacional de datos universitarios estará leyendo la estrategia, no el entregable [16].

Como trabajo futuro, el prototipo pide un conector de solo lectura al sistema académico, con ventanas controladas, sin abandonar el aterrizaje. Pide una historia más larga antes de usar series frágiles para dimensionar la oferta. Pide promover el espacio de exploración al mart con contratos automáticos, y versionar las reglas de negocio de retención junto al modelo. Un piloto de agendado del orquestador puede venir después. Afirmar hoy operación continua sería adelantar un resultado que no se midió. Migrar a servidores institucionales, con roles de acceso y sin identificadores personales de más, es el paso que convierte esta prueba en capacidad de la universidad, no en un entregable de curso.

Quien administra tecnología en una institución suele preguntar, con razón, cuánto cuesta y quién lo opera. Este prototipo no cotiza un contrato de soporte. Cotiza una lección de diseño: el costo de no tener capa analítica ya se paga, en horas de extractos y en decisiones tomadas con el archivo del cuatrimestre anterior. Lo abierto desplaza ese costo hacia un contrato interno que se puede auditar. El personal mínimo no es un equipo de veinte. Es alguien que defienda el grano, alguien que publique el mart y alguien de negocio que lea el dashboard sin pedir una nueva unión. Si esa tríada no existe, ninguna pila, abierta o cerrada, sostiene el beneficio [1], [5], [16].

Quien lea esto desde otra institución de educación superior no necesita copiar la pila. Necesita copiar la disciplina: una fuente, un grano por pregunta, una capa que no se reescribe en el dashboard, y métricas que se atreven a ser malas en una serie si eso es lo que el holdout mostró. El llamado es prosaico y, por eso, viable. Repetir el piloto en un siguiente ciclo lectivo, con un extracto fresco y un usuario de planificación sentado al lado del dashboard, antes de hablar de inteligencia artificial oficial.

Referencias

  1. S. Gaftandzhieva, S. Hussain, S. Hilcenko, R. Doneva, y K. Boykova, «Data-driven Decision Making in Higher Education Institutions: State-of-play», Int. J. Adv. Comput. Sci. Appl., vol. 14, n.º 6, pp. 400–411, 2023, doi: 10.14569/IJACSA.2023.0140645.
  2. B. Daniel, «Big Data and analytics in higher education: Opportunities and challenges», Br. J. Educ. Technol., vol. 46, n.º 5, pp. 904–920, 2015, doi: 10.1111/bjet.12230.
  3. S. Z. Salas-Pilco y Y. Yang, «Artificial intelligence applications in Latin American higher education: a systematic review», Int. J. Educ. Technol. High. Educ., vol. 19, n.º 1, p. 21, 2022, doi: 10.1186/s41239-022-00326-w.
  4. G. Vial, «Understanding digital transformation: A review and a research agenda», J. Strateg. Inf. Syst., vol. 28, n.º 2, pp. 118–144, 2019, doi: 10.1016/j.jsis.2019.01.003.
  5. H. Chen, R. H. L. Chiang, y V. C. Storey, «Business Intelligence and Analytics: From Big Data to Big Impact», MIS Q., vol. 36, n.º 4, pp. 1165–1188, 2012, doi: 10.2307/41703503.
  6. O. Zawacki-Richter, V. I. Marín, M. Bond, y F. Gouverneur, «Systematic review of research on artificial intelligence applications in higher education – where are the educators?», Int. J. Educ. Technol. High. Educ., vol. 16, n.º 1, p. 39, 2019, doi: 10.1186/s41239-019-0171-0.
  7. L. E. Contreras Bravo, J. I. Rodríguez Molano, y H. J. Fuentes López, «Analítica académica: nuevas herramientas aplicadas a la educación», Rev. Bol. Redipe, vol. 10, n.º 3, pp. 137–158, 2021, doi: 10.36260/rbr.v10i3.1228.
  8. A. A. Munshi y A. Alhindi, «Big Data Platform for Educational Analytics», IEEE Access, vol. 9, pp. 52883–52890, 2021, doi: 10.1109/ACCESS.2021.3070737.
  9. N. Janssen, T. Ilayperuma, J. Jayasinghe, F. Bukhsh, y M. Daneva, «The evolution of data storage architectures: examining the secure value of the Data Lakehouse», J. Data Inf. Manag., vol. 6, 2024.
  10. R. Kimball y M. Ross, The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling, 3.ª ed. Indianapolis, IN, EE. UU.: Wiley, 2013.
  11. J. Guerra et al., «Adaptation and evaluation of a learning analytics dashboard to improve academic support at three Latin American universities», Br. J. Educ. Technol., vol. 51, n.º 4, pp. 973–1004, 2020, doi: 10.1111/bjet.12935.
  12. G. B. N. Silva, «Deserción estudiantil en Institutos Superiores Tecnológicos de Ecuador: Una revisión de la literatura», Rev. Latinoam. Ogmios, vol. 3, n.º 8, pp. 25–32, 2023, doi: 10.53595/rlo.v3.i8.084.
  13. B. Williamson, «Policy networks, performance metrics and platform markets: Charting the expanding data infrastructure of higher education», Br. J. Educ. Technol., vol. 50, n.º 6, pp. 2794–2809, 2019, doi: 10.1111/bjet.12861.
  14. M. Armbrust et al., «Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics», en Proc. 11th Conf. Innovative Data Syst. Res. (CIDR), 2021.
  15. R. J. Hyndman y G. Athanasopoulos, Forecasting: Principles and Practice, 3.ª ed. Melbourne, Australia: OTexts, 2021.
  16. J. Komljenovic, S. Sellar, y K. Birch, «Turning universities into data-driven organisations: seven dimensions of change», High. Educ., vol. 89, n.º 5, pp. 1369–1386, 2025, doi: 10.1007/s10734-024-01277-z.
  17. P. Dubey, «The Data Lakehouse: An Evolving Paradigm in Data Architecture», Int. J. Comput. Eng., vol. 7, n.º 10, pp. 30–47, 2025, doi: 10.47941/ijce.2958.
  18. W. Villegas-Ch, X. Palacios-Pacheco, y S. Luján-Mora, «Application of a Smart City Model to a Traditional University Campus with a Big Data Architecture: A Sustainable Smart Campus», Sustainability, vol. 11, n.º 10, p. 2857, 2019, doi: 10.3390/su11102857.

DriveSense: Sistema Inteligente para la Clasificación de Perfiles de Conducción mediante Inteligencia Artificial

Iván Paul Marcelino y Juan Alfonso Alvarado Batista – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La seguridad vial continúa siendo uno de los principales retos asociados a los sistemas de transporte. La forma en que una persona acelera, frena, gira, mantiene la velocidad o reacciona ante una situación inesperada puede influir directamente en el nivel de riesgo de un recorrido. A escala internacional, los siniestros de tránsito continúan generando una elevada cantidad de muertes y lesiones, mientras que factores relacionados con el comportamiento humano permanecen entre los elementos de mayor interés para su prevención [1], [2]. Dentro de este contexto, el análisis del comportamiento del conductor mediante herramientas tecnológicas se ha convertido en una línea de investigación capaz de transformar acciones que tradicionalmente eran observadas de forma subjetiva en información cuantificable que puede ser estudiada mediante técnicas estadísticas y computacionales [6], [9].

En respuesta a esta problemática surge DriveSense, proyecto desarrollado por Iván Paul Marcelino y Juan Alfonso Alvarado Batista, estudiantes de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del ingeniero Rafael Omar Batista Jorge y dentro de la Escuela de Ingeniería en Computación y Telecomunicaciones. DriveSense fue concebido como un sistema para capturar, procesar y analizar datos de conducción generados dentro de un entorno de simulación controlado, con el propósito de identificar patrones y clasificar el comportamiento observado en diferentes perfiles. En lugar de limitarse a registrar una puntuación final, la propuesta integra la adquisición de telemetría, el procesamiento de los datos, el entrenamiento de modelos de aprendizaje automático y la presentación de resultados mediante una plataforma web.

El uso de simuladores ofrece una ventaja importante al estudiar este tipo de comportamiento. Determinadas situaciones que serían difíciles, costosas o inseguras de reproducir intencionalmente en una vía pública pueden ejecutarse de manera controlada dentro de un entorno virtual. Investigaciones previas han demostrado la utilidad de los simuladores para estudiar aspectos relacionados con la velocidad, las curvas y la respuesta de los conductores bajo condiciones repetibles [3]–[5]. Esta característica permite que distintos participantes realicen sesiones bajo condiciones previamente definidas y que los datos obtenidos puedan ser comparados sin exponer a los usuarios ni a terceros a las consecuencias de provocar deliberadamente una situación de riesgo real.

La motivación de DriveSense parte precisamente de combinar esa capacidad experimental con las posibilidades actuales del análisis de datos. Durante una sesión de conducción pueden generarse miles de observaciones relacionadas con velocidad, aceleración, frenado, dirección y otras variables del vehículo. Analizadas de forma aislada, estas señales pueden resultar difíciles de interpretar. Sin embargo, al organizarlas temporalmente y utilizar modelos capaces de reconocer patrones, es posible construir una representación más detallada de la forma en que una persona conduce [6], [12]. DriveSense utiliza este principio para transformar la telemetría producida durante una sesión en información que pueda ser consultada, comparada e interpretada posteriormente.

Puesto de simulación con volante, pedales y monitores que muestran el simulador y la plataforma DriveSense
Figura 1. Entorno utilizado para realizar una sesión de conducción con DriveSense, mostrando el simulador y la plataforma desarrollada.

Del problema vial al análisis inteligente del comportamiento

En la República Dominicana, la seguridad vial constituye una problemática especialmente relevante. El exceso de velocidad, las maniobras imprudentes, las aceleraciones repentinas, las frenadas intensas y diferentes formas de conducción agresiva pueden aumentar tanto la probabilidad de un incidente como la gravedad de sus consecuencias. A esto se agregan situaciones comunes en las que el conductor debe reaccionar rápidamente ante congestión, cambios de carril de otros vehículos, obstáculos o modificaciones inesperadas en el flujo del tránsito. Aunque muchas de estas conductas pueden identificarse mediante observación, convertirlas en información cuantitativa permite analizarlas con un mayor nivel de detalle y conservar un registro de lo ocurrido durante diferentes momentos de un recorrido.

Los métodos convencionales para valorar el desempeño de un conductor dependen en gran medida de la observación directa, de evaluaciones realizadas durante un período limitado o de información obtenida después de un incidente. Estos mecanismos continúan siendo necesarios, pero presentan limitaciones cuando se desea estudiar con precisión cómo cambió el comportamiento durante una sesión. Una evaluación humana puede indicar que una persona condujo de manera insegura, por ejemplo, pero los datos de telemetría permiten complementar esa observación indicando cuándo ocurrió una aceleración brusca, cuál era la velocidad en ese momento, cuánto se utilizó el freno o cómo varió la dirección. Esta posibilidad ha impulsado el desarrollo de investigaciones que utilizan información del vehículo para reconocer diferentes patrones de manejo [6], [12].

La literatura relacionada con el perfilado de conductores ha evolucionado progresivamente desde reglas construidas sobre unas pocas variables hacia métodos capaces de estudiar grandes cantidades de información. La clasificación de comportamientos mediante aprendizaje automático permite encontrar relaciones que pueden resultar difíciles de representar utilizando únicamente límites fijos o promedios generales [9], [11]. Diferentes investigaciones han utilizado telemetría vehicular para estudiar estilos de conducción, mientras que otros trabajos han incorporado métodos de ensemble y aprendizaje profundo con el propósito de representar relaciones más complejas entre las características disponibles [13], [15]. En todos estos casos, la calidad de los resultados depende no solamente del algoritmo utilizado, sino también de la forma en que los datos fueron capturados, organizados y preparados.

Precisamente, uno de los retos encontrados durante el desarrollo de DriveSense fue la ausencia de un conjunto de datos que reuniera exactamente las variables, condiciones experimentales y categorías requeridas por el proyecto. Los datasets disponibles en investigaciones previas fueron construidos bajo vehículos, sensores, poblaciones, carreteras y criterios de clasificación diferentes. Utilizar uno de ellos directamente habría significado adaptar el proyecto a condiciones que no necesariamente correspondían con el experimento propuesto. Por esta razón, se decidió construir un dataset propio mediante sesiones realizadas por participantes dentro del simulador, manteniendo un procedimiento común de captura y criterios previamente establecidos para representar los comportamientos estudiados.

Otro aspecto relevante es la dimensión temporal de la conducción. Un conductor no mantiene necesariamente el mismo comportamiento durante todo un recorrido. Una sesión que globalmente parece normal puede incluir algunos segundos de agresividad, distracción o conducción pasiva. Trabajos recientes han reforzado la importancia de estudiar secuencias y patrones temporales en lugar de representar toda una conducción mediante un único promedio [12], [13]. DriveSense adopta esta idea dividiendo la información en ventanas temporales. Cada ventana resume una parte de la sesión y posteriormente puede ser evaluada de forma independiente, permitiendo reconstruir cómo fue cambiando el comportamiento durante el recorrido completo.

Esta aproximación también responde a una necesidad de interpretabilidad. En una aplicación relacionada con personas y seguridad no resulta suficiente presentar únicamente una etiqueta generada por un algoritmo. Es importante conservar las métricas que dieron origen al análisis y disponer de mecanismos que ayuden a entender por qué el sistema produce determinados resultados. La inteligencia artificial explicable ha adquirido relevancia justamente por la necesidad de comprender la influencia que tienen diferentes características dentro de las predicciones [17], [20]. Por esta razón, DriveSense incorporó SHAP como técnica complementaria para estudiar la participación de las variables en las decisiones del modelo, manteniendo separada la predicción del proceso utilizado para explicarla.

Esquema en etapas: sesión, telemetría, procesamiento, modelo ML, resultado, estadísticas e interpretación
Figura 2. Esquema general del problema abordado: comportamiento del conductor, generación de telemetría, procesamiento de los datos y clasificación del perfil.

El desarrollo de DriveSense permitió cumplir el objetivo de construir una solución inteligente orientada a la clasificación de perfiles de conducción a partir de datos de telemetría obtenidos en un entorno de simulación controlado. Para lograrlo, se diseñó una arquitectura capaz de capturar, estructurar y almacenar telemetría vehicular a una frecuencia de 20 Hz; se implementaron mecanismos para analizar estadísticamente las variables obtenidas y estudiar sus diferencias entre sesiones y grupos de conductores; se desarrolló un proceso para entrenar y evaluar modelos supervisados de aprendizaje automático; y se incorporaron mecanismos para representar cuantitativamente los resultados, conservar las diferentes versiones de los modelos, analizar la influencia de las características y presentar la información al usuario mediante una plataforma centralizada. De esta manera, el objetivo general se desglosó en componentes medibles y verificables que abarcan el ciclo completo desde la generación del dato hasta la interpretación del resultado.

De una sesión simulada a un sistema completo de datos

El funcionamiento de DriveSense comienza antes de que el conductor inicie el recorrido. Desde la aplicación web se registra o selecciona al participante y se crea una nueva sesión indicando la información necesaria para la prueba, incluyendo el escenario y el vehículo que serán utilizados. Esta sesión queda registrada en el servidor con un estado inicial y puede ser validada posteriormente desde la computadora encargada de ejecutar la simulación. Esta separación permite mantener un registro de cada prueba y relacionar los datos producidos posteriormente con el conductor y las condiciones correspondientes, evitando que los archivos de telemetría queden aislados de su contexto experimental.

En la computadora de simulación se utiliza DriveSense Local Client, componente encargado de validar que la sesión corresponde con la información registrada en el servidor y preparar el entorno necesario para realizarla. Una vez completada la validación, el cliente inicia los componentes requeridos para trabajar con Assetto Corsa y entrega a Logger_BD la configuración asociada a la sesión. Durante este proceso, la sesión puede pasar por distintos estados, permitiendo que la plataforma conozca si se encuentra pendiente, en ejecución o completada. Este mecanismo también disminuye la cantidad de configuraciones que el usuario debe introducir manualmente en la computadora donde se realiza la prueba.

Diagrama de arquitectura de DriveSense: aplicación web, servidor, Local Client, Assetto Corsa, Logger_BD, almacenamiento y clasificación
Figura 3. Arquitectura general de DriveSense y comunicación entre la aplicación web, el servidor, DriveSense Local Client, Assetto Corsa, Logger_BD, el almacenamiento y el componente de clasificación.

Una vez iniciada la conducción, Logger_BD obtiene información directamente desde la telemetría generada por Assetto Corsa. La captura se realiza a una frecuencia de 20 Hz, equivalente a veinte muestras por segundo. Entre las variables registradas se encuentran velocidad, revoluciones por minuto, acelerador, freno, dirección y valores relacionados con la dinámica del vehículo. Esta frecuencia permite observar variaciones que podrían perderse si únicamente se conservaran valores globales al finalizar la sesión. La telemetría vehicular ha sido utilizada ampliamente como una fuente de información para reconocer comportamientos, ya que permite representar de forma cuantitativa las acciones ejecutadas durante la conducción [6], [12].

Los datos crudos de cada recorrido se conservan en archivos CSV, manteniendo un registro que puede utilizarse posteriormente para revisar una sesión o para construir nuevos conjuntos de entrenamiento. Paralelamente, DriveSense procesa la información y la organiza en segmentos y ventanas temporales que son almacenados en PostgreSQL. Esta combinación responde a dos necesidades diferentes: conservar la telemetría completa y, al mismo tiempo, disponer de una estructura más eficiente para consultas, evaluaciones y visualizaciones. De esta forma, no es necesario procesar nuevamente cada muestra del archivo original cada vez que se quiere consultar un resultado.

La arquitectura fue diseñada además para disminuir el riesgo de pérdida de información ante problemas de conectividad. Si durante una conducción el equipo de simulación no puede comunicarse temporalmente con el servidor, los datos pendientes permanecen almacenados de manera local. Cuando la comunicación vuelve a estar disponible, el sistema intenta enviarlos nuevamente. Esta estrategia permite que una interrupción de red no implique necesariamente perder la sesión completa. Mantener la persistencia de los datos fue considerado especialmente importante debido al esfuerzo requerido para reunir participantes y repetir las condiciones experimentales de una prueba.

Evaluación de sesión: sesión grabada, división en ventanas, clasificación ML, clase global con confianza y línea de tiempo por ventana
Figura 4. Flujo de los datos desde la captura de telemetría hasta su almacenamiento, procesamiento, clasificación y presentación de resultados.

Una vez almacenada la telemetría, la información se transforma en características que puedan utilizarse en el proceso de clasificación. En lugar de introducir directamente una secuencia extensa de muestras individuales al modelo, las ventanas permiten obtener representaciones de intervalos concretos de la sesión. A partir de ellas pueden calcularse valores relacionados con la velocidad, el uso del acelerador y del freno, la dirección, la variabilidad del comportamiento y la presencia de determinados eventos. La ingeniería de características constituye una etapa fundamental en problemas de clasificación porque permite representar los datos originales de una manera adecuada para que los algoritmos puedan identificar diferencias entre clases [9], [12].

Para determinar qué método resultaba más apropiado para el conjunto de datos disponible, durante el proyecto se trabajó con diferentes algoritmos supervisados: Random Forest, Support Vector Machine (SVM), XGBoost y Multi-Layer Perceptron (MLP). Los modelos fueron entrenados utilizando las mismas características de entrada para permitir una comparación bajo condiciones equivalentes. Random Forest representa un método ampliamente utilizado para problemas de clasificación por su capacidad de combinar múltiples árboles de decisión y manejar relaciones no lineales [10]. XGBoost, por su parte, utiliza un enfoque de gradient boosting que ha demostrado un elevado rendimiento en problemas con datos estructurados [19].

El proceso de entrenamiento no se limitó a generar una única partición del dataset. Para evaluar los modelos se utilizó validación cruzada k-fold, dividiendo repetidamente la información disponible entre subconjuntos de entrenamiento y validación. Este procedimiento reduce la dependencia de una sola división de los datos y permite observar la estabilidad del desempeño del modelo. Para realizar la comparación se consideraron métricas como Accuracy, F1-score, ROC-AUC y matrices de confusión. Cada una aporta una perspectiva diferente: mientras Accuracy representa la proporción global de clasificaciones correctas, F1 permite considerar simultáneamente precisión y exhaustividad, y la matriz de confusión permite estudiar en cuáles categorías se producen los errores.

A medida que el proyecto evolucionó también cambió la definición del problema. Las primeras pruebas trabajaban con tres categorías principales, pero posteriormente se incorporó el comportamiento distraído, dando lugar a las cuatro clases finales utilizadas por DriveSense: agresivo, distraído, normal y pasivo. Este cambio implicó volver a entrenar y evaluar los modelos bajo la nueva estructura. Finalmente se seleccionó XGBoost como clasificador principal y se implementó un sistema de versionado que permite conservar los modelos producidos durante diferentes entrenamientos. En lugar de sustituir simplemente un archivo cada vez que se entrena nuevamente, DriveSense registra qué versión fue generada, con qué datos se construyó, cuáles fueron sus métricas y cuál se encuentra activa.

La interpretabilidad complementa este proceso mediante SHAP, técnica que permite estudiar cómo las características utilizadas contribuyen a las predicciones realizadas. La idea no es modificar la clasificación obtenida, sino proporcionar una herramienta adicional para analizar la participación de las variables dentro del modelo. SHAP se apoya en principios de teoría de juegos para asignar valores de contribución a las características y se ha convertido en una técnica reconocida dentro del campo de la inteligencia artificial explicable [20]. En DriveSense, esta información sirve como apoyo al análisis de las decisiones del clasificador y ayuda a evitar que el sistema sea presentado únicamente como una caja negra que produce etiquetas sin contexto.

Tarjeta de estado del modelo activo XGBoost v3 con horas de entrenamiento y métricas
Figura 5. Flujo metodológico empleado para la preparación de los datos, entrenamiento, validación, selección y versionado de los modelos de clasificación.

El sistema se completa mediante la plataforma web, desde la cual se pueden registrar conductores, crear nuevas sesiones, consultar recorridos anteriores, visualizar evaluaciones y acceder a estadísticas. La interfaz reúne información que originalmente se encuentra distribuida entre archivos, registros de base de datos, predicciones y métricas. Además, permite realizar comparaciones utilizando características como género y rango de edad, así como consultar las versiones existentes de los modelos y sus procesos de entrenamiento. Esta centralización facilita que DriveSense pueda utilizarse no solamente como un experimento aislado, sino como una plataforma que mantiene la trazabilidad de las pruebas efectuadas.

En las fases finales se incorporó adicionalmente una capa de interpretación mediante la API de Gemini. Esta funcionalidad surgió al observar que porcentajes, métricas y gráficas pueden resultar difíciles de comprender para usuarios sin experiencia en ciencia de datos. Es importante diferenciar claramente sus funciones: Gemini no clasifica al conductor, no modifica los resultados del modelo y no participa en el cálculo de las predicciones. DriveSense y XGBoost continúan siendo responsables del procesamiento y la clasificación; la API recibe únicamente resultados ya generados y los transforma en una explicación en lenguaje natural. El backend controla además la información compartida, evitando transmitir identificadores directos como el nombre o el número de licencia del participante.

Interfaz web DriveSense Monitor con el resumen general, la lista de sesiones y la distribución de etiquetas
Figura 6. Ejemplo de la interfaz web de DriveSense para la gestión de sesiones, consulta del modelo activo y visualización de información del sistema.

Resultados que muestran más que una etiqueta

Durante el desarrollo del componente de inteligencia artificial se realizaron distintas iteraciones hasta llegar a la configuración final. En una etapa inicial se evaluó una implementación basada en RAPIDS AI utilizando CPU y GPU. La variante ejecutada mediante CPU obtuvo un Accuracy de 96.66 %, un Macro F1-score de 0.62 y un Weighted F1-score de 0.76, con un tiempo de entrenamiento de aproximadamente 0.3561 segundos. Para el volumen de información utilizado en ese momento, la ejecución mediante GPU presentó un desempeño similar pero requirió un tiempo mayor, por lo que la aceleración mediante GPU no se mantuvo como una necesidad del sistema. Estos resultados también evidenciaron la importancia de analizar múltiples métricas: un valor elevado de Accuracy no implica necesariamente un comportamiento igualmente uniforme entre todas las categorías.

Posteriormente, el problema fue ampliado de tres a cuatro clases y se adoptó XGBoost como modelo principal. La versión activa XGBoost v3 fue entrenada utilizando 23 sesiones, equivalentes a aproximadamente 6 horas y 18 minutos de conducción. Esta versión obtuvo un Accuracy baseline de 93.49 % y un F1-score baseline de 93.45 %. Bajo el criterio de evaluación estricto se obtuvo un Accuracy de 75.82 % y un F1-score de 60.76 %. Adicionalmente, las predicciones del modelo presentan una confianza promedio cercana al 83 %. Las métricas de esta versión no deben compararse directamente con los valores de la etapa inicial, ya que fueron obtenidas utilizando diferente cantidad de clases, distintas configuraciones del conjunto de datos y un procedimiento de evaluación actualizado.

La diferencia entre las métricas baseline y las obtenidas bajo un criterio más estricto constituye un resultado importante del proyecto. Presentar únicamente la cifra más alta habría proporcionado una visión incompleta del rendimiento. La evaluación estricta permite observar que el problema se vuelve considerablemente más exigente cuando se establecen condiciones destinadas a reducir la posibilidad de que información demasiado relacionada aparezca simultáneamente en entrenamiento y validación. Esto ayuda a representar de manera más realista la capacidad de generalización del modelo y demuestra por qué la evaluación de un sistema de aprendizaje automático no debe resumirse exclusivamente mediante una sola métrica.

DriveSense tampoco limita el resultado a una única clasificación para toda la sesión. Cada una de las ventanas procesadas conserva su propio resultado, lo que permite construir una línea de tiempo del comportamiento. Como ejemplo, una de las sesiones analizadas fue clasificada globalmente como pasiva con un 75.2 % de confianza. Sin embargo, al estudiar sus 80 ventanas, se observó que el comportamiento pasivo representó el 58.8 % del tiempo evaluado, mientras que el comportamiento distraído correspondió al 28.7 %, el normal al 10.0 % y el agresivo al 2.5 %. La clasificación global resume el patrón predominante, mientras que la línea temporal permite identificar los cambios que ocurrieron durante el recorrido.

Este nivel de detalle representa una de las características más útiles de la solución. Dos sesiones podrían terminar con la misma clasificación general y, aun así, haber llegado a ese resultado mediante patrones diferentes. Una puede mantener un comportamiento relativamente uniforme y otra alternar repetidamente entre distintas clases. Por esta razón, la plataforma presenta conjuntamente la clasificación global, la confianza, las métricas de conducción, la distribución de comportamientos, los eventos detectados y los intervalos temporales. El propósito es que el resultado pueda examinarse desde diferentes perspectivas y no interpretar al conductor únicamente a partir de una etiqueta aislada.

Evaluación de una sesión clasificada como pasiva con 75.2 % de confianza, métricas de conducción e interpretación del comportamiento
Figura 7. Clasificación general y nivel de confianza de la sesión evaluada.
Línea de tiempo de la sesión por ventanas, distribución de comportamientos y eventos bruscos detectados
Figura 8. Evolución temporal, distribución de comportamientos y eventos detectados durante la sesión.
Gráfico radar que compara las características de conducción de la sesión con los perfiles de referencia
Figura 9. Comparación de las características de conducción e interpretación de sus valores respecto a los perfiles de referencia.

Los datos reunidos también hicieron posible realizar comparaciones descriptivas entre diferentes grupos de la muestra. Para la comparación por género se analizaron 26 sesiones correspondientes a conductores masculinos y 12 sesiones correspondientes a conductores femeninos. Entre las sesiones femeninas, la conducción normal representó aproximadamente el 42 %, seguida de la pasiva con 25 %, mientras que agresiva y distraída representaron alrededor de 17 % cada una. Entre las sesiones masculinas, la categoría agresiva alcanzó aproximadamente 39 %, la normal 35 %, la pasiva 15 % y la distraída alrededor de 11 %. Estos valores describen solamente el comportamiento de las sesiones disponibles y no deben interpretarse como una afirmación general sobre hombres y mujeres.

En la comparación por edad, el grupo de 20 a 29 años concentró la mayor cantidad de observaciones, con 23 sesiones. En este rango, el 39.1 % fue clasificado como agresivo, el 34.8 % como normal, el 21.7 % como pasivo y el 4.3 % como distraído. Para el grupo de 30 a 39 años se analizaron cinco sesiones, con un 40 % normal, 40 % distraído y 20 % agresivo. En el rango de 40 a 49 años solo estuvieron disponibles dos sesiones, ambas clasificadas como normales. Finalmente, en el grupo de 50 años o más se analizaron ocho sesiones, distribuidas en proporciones de 25 % para cada una de las cuatro categorías. Las diferencias en el tamaño de cada grupo impiden utilizar estos resultados como representación de la población general; su valor dentro del proyecto es principalmente descriptivo y demuestra la capacidad del sistema para organizar este tipo de comparaciones.

Comparativa por género de la distribución de clases agresivo, normal, pasivo y distraído, con interpretación
Figura 10. Comparación de la distribución de comportamientos por género.
Comparativa por rango de edad de la distribución de clases y de las métricas de conducción, con interpretación
Figura 11. Comparación de la distribución de comportamientos por rango de edad.

Una base para seguir investigando la conducción

Los resultados obtenidos permiten concluir que es posible integrar un entorno de simulación, captura de telemetría, almacenamiento estructurado y aprendizaje automático dentro de un mismo sistema para analizar perfiles de conducción. DriveSense no se limita al modelo de clasificación, sino que incorpora el proceso completo que permite producir y conservar los datos utilizados por ese modelo. Desde la creación de una sesión hasta la presentación de sus resultados, cada etapa mantiene información que permite posteriormente revisar cómo se obtuvo una determinada clasificación. Esta trazabilidad es especialmente importante en un proyecto experimental, debido a que permite continuar incorporando datos sin perder las versiones y resultados producidos previamente.

Al mismo tiempo, los resultados deben interpretarse dentro de las condiciones bajo las cuales fueron obtenidos. Assetto Corsa permite capturar telemetría detallada y realizar pruebas controladas, pero no fue diseñado específicamente como una plataforma para reproducir absolutamente todas las situaciones presentes en el tránsito cotidiano. El comportamiento del tráfico, determinadas interacciones con otros vehículos, las condiciones ambientales y otros factores de la vía real dependen de las posibilidades ofrecidas por el simulador. A esto se agrega que el dataset fue construido específicamente para esta investigación y que las categorías agresivo, distraído, normal y pasivo responden a los criterios establecidos para las sesiones realizadas. Por tanto, el modelo aprende patrones correspondientes al contexto experimental de DriveSense.

Estas limitaciones también señalan directamente los próximos pasos del proyecto. La incorporación de nuevos participantes permitiría aumentar la diversidad del dataset y mejorar la cantidad de observaciones disponibles en cada grupo de edad y género. Nuevos escenarios aportarían una mayor variedad de situaciones de conducción. También sería posible continuar aumentando la automatización de la interacción con el simulador para disminuir la intervención necesaria durante el inicio y finalización de una sesión. Gracias al sistema de versionado incorporado, estas nuevas sesiones pueden utilizarse para producir modelos posteriores y comparar su rendimiento antes de decidir cuál versión debe mantenerse activa.

Finalmente, una de las líneas de trabajo más relevantes consiste en estudiar DriveSense utilizando otras fuentes de telemetría. La arquitectura no depende conceptualmente de una única categoría de simulador: si otra fuente puede proporcionar las variables requeridas, el proceso de captura puede adaptarse y posteriormente construir un nuevo dataset representativo de ese entorno. Una futura evaluación con vehículos reales permitiría investigar hasta qué punto los patrones identificados mediante simulación se mantienen fuera de Assetto Corsa y qué modificaciones serían necesarias para aplicaciones relacionadas con evaluación, capacitación o análisis de conductores. En este sentido, DriveSense representa no solamente el resultado de un proyecto académico, sino una base tecnológica y metodológica sobre la cual puede continuar desarrollándose investigación relacionada con el comportamiento al volante y la seguridad vial.

Referencias

  1. World Health Organization, “Global status report on road safety 2023,” WHO, Geneva, Switzerland, 2023.
  2. National Highway Traffic Safety Administration, “Traffic Safety Facts Annual Report 2022,” U.S. Department of Transportation, 2023.
  3. A. Bella and A. Calvi, “Effects of simulator training on driver speed behavior in curves,” Accident Analysis & Prevention, vol. 43, no. 3, pp. 1166–1172, 2011.
  4. S. T. Godley, T. J. Triggs, and B. N. Fildes, “Driving simulator validation for speed research,” Accident Analysis & Prevention, vol. 34, no. 5, pp. 589–600, 2002.
  5. A. Calvi, “A study on driving performance along horizontal curves using a driving simulator,” Journal of Transportation Safety & Security, vol. 7, no. 3, pp. 243–257, 2015.
  6. Y. Zhang, X. Wang, and L. Li, “Driving behavior recognition based on vehicle telemetry data,” Sensors, vol. 21, no. 4, pp. 1–18, 2021.
  7. P. Sun, J. Hu, and Y. Zhang, “Real-time driving risk evaluation based on vehicle dynamics,” IEEE Transactions on Intelligent Transportation Systems, vol. 23, no. 6, pp. 5678–5689, 2022.
  8. M. Taamneh et al., “Detection of driver stress in real-world driving environments,” IEEE Transactions on Intelligent Transportation Systems, vol. 21, no. 12, pp. 5007–5017, 2020.
  9. J. Ferreira, J. Carvalho, and J. Fonseca, “Driver behavior profiling: An investigation with machine learning,” Expert Systems with Applications, vol. 123, pp. 1–12, 2019.
  10. L. Breiman, “Random forests,” Machine Learning, vol. 45, no. 1, pp. 5–32, 2001.
  11. M. Saeedmanesh and N. Geroliminis, “Dynamic clustering and classification of driving behavior,” Transportation Research Part C, vol. 102, pp. 195–214, 2019.
  12. S. Wang, C. Li, and R. Fu, “Driver behavior recognition using vehicle data and machine learning,” IEEE Sensors Journal, vol. 20, no. 10, pp. 5674–5683, 2020.
  13. Y. Li, Z. Chen, and H. Zhang, “Driver behavior classification using deep learning and vehicle telemetry data,” IEEE Access, vol. 10, pp. 112345–112357, 2022.
  14. J. Kim and S. Lee, “Real-time driver risk assessment using machine learning and vehicle dynamics,” Sensors, vol. 23, no. 2, pp. 1–15, 2023.
  15. R. Gupta, A. Sharma, and P. Singh, “Driving style analysis using telematics data and ensemble learning methods,” Expert Systems with Applications, vol. 213, 2023.
  16. T. Nguyen and M. Arif, “A survey on driver behavior analysis using machine learning techniques,” IEEE Access, vol. 11, pp. 45678–45700, 2023.
  17. L. Zhao et al., “Explainable AI for driver behavior profiling using SHAP and ensemble models,” IEEE Transactions on Intelligent Transportation Systems, 2024.
  18. H. Eren et al., “Estimating driving behavior by a smartphone,” in Proc. IEEE Intelligent Vehicles Symposium, 2012.
  19. T. Chen and C. Guestrin, “XGBoost: A scalable tree boosting system,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 785–794, 2016.
  20. S. M. Lundberg and S.-I. Lee, “A unified approach to interpreting model predictions,” in Advances in Neural Information Processing Systems, vol. 30, 2017.

AgroSat IoT: Integración de Sensores y Teledetección para la Agricultura 4.0 en República Dominicana

Carlos García Núñez y Dariel Alexander Vargas Francisco – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

La agricultura constituye uno de los ejes fundamentales para el desarrollo económico y la seguridad alimentaria a nivel global. En la República Dominicana, el sector agrícola se destaca por su gran capacidad exportadora, siendo el cultivo de banano (Musa paradisiaca) un pilar estratégico que representa aproximadamente el 30% de las exportaciones agropecuarias del país [1]. Estas cifras consolidan al banano como un generador indispensable de divisas, con una presencia notable en mercados internacionales de alta exigencia, como la Unión Europea y el Reino Unido. Gran parte de esta competitividad se basa en la producción orgánica, una modalidad que añade un enorme valor comercial al producto dominicano, pero que simultáneamente impone restricciones severas en el uso de insumos químicos para el manejo fitosanitario de las plantaciones.

Esta restricción en el manejo sintético subraya una vulnerabilidad crítica: la exposición de los cultivos a amenazas bióticas y abióticas fluctuantes. Ante esta realidad, surge la necesidad apremiante de modernizar los métodos de supervisión en campo, transitando desde modelos reactivos hacia la adopción de la denominada Agricultura 4.0 [2]. Esta transición implica la incorporación de tecnologías de monitoreo continuo que aporten una capa de inteligencia basada en datos concretos y localizados, lo que permite la anticipación de escenarios de estrés en el cultivo, garantizando así la sostenibilidad y el rendimiento de las fincas agrícolas.

En este contexto de innovación tecnológica, estudiantes de la Facultad de Ciencia de la Ingeniería, pertenecientes al Departamento de Ingeniería Telemática y Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), han desarrollado una iniciativa pionera. Bajo el liderazgo de Carlos García Núñez y Dariel Vargas, y con la asesoría del Ing. Jorge Alejandro Luna Martínez, nace el proyecto AgroSat IoT. Esta propuesta fusiona el potencial de las redes de telemetría de largo alcance con el análisis de imágenes satelitales, creando un entorno de supervisión integral que redefine la toma de decisiones en el ámbito agrario.

La motivación principal detrás de AgroSat IoT radica en empoderar a los productores bananeros con herramientas tecnológicas accesibles y de alta precisión. A través de la recolección de datos microclimáticos in situ y la superposición de metadatos macroespaciales, la solución no solo aspira a diagnosticar problemas de forma oportuna, sino a establecer una metodología replicable que promueva el uso eficiente de recursos hídricos y nutricionales, salvaguardando así el liderazgo de la producción orgánica nacional.

Problemática y estado del arte

A pesar de su evidente relevancia económica, la cadena de producción del banano enfrenta desafíos de naturaleza sistémica y fisiológica, especialmente pronunciados en la etapa de poscosecha. Entre las amenazas más destructivas destaca la pudrición de la corona, una patología fúngica asociada a microorganismos como Fusarium spp. y Colletotrichum musae [3].

Esta enfermedad suele desarrollarse de manera latente en el campo, manifestándose únicamente durante el proceso de empaque o transporte, lo que resulta en rechazos masivos de lotes en el mercado internacional y pérdidas económicas devastadoras. En el entorno de la producción orgánica, donde los fungicidas de síntesis química están estrictamente prohibidos, la gestión de esta enfermedad depende casi por completo de un control preventivo fundamentado en la excelente salud fisiológica de la planta desde su fase de desarrollo temprano.

Paralelamente, el banano es una especie botánica con una elevada demanda hídrica, lo que lo vuelve excepcionalmente sensible a las fluctuaciones en la humedad del suelo [4]. Un déficit hídrico sostenido provoca el cierre de los estomas, reduciendo drásticamente las tasas fotosintéticas y afectando el llenado del fruto. Por otro lado, un escenario de anegamiento promueve la hipoxia radicular y crea un microclima ideal para la proliferación de fitopatógenos del suelo. Esta delicada ventana de homeostasis hídrica exige un escrutinio meticuloso, el cual es inalcanzable utilizando únicamente métodos empíricos de observación visual.

Actualmente, el principal agravante de esta problemática en la región es la dependencia histórica de la gestión agraria tradicional. Las anomalías nutricionales y el estrés hídrico ocurren de forma silenciosa, y para el momento en que los síntomas se vuelven visibles en el follaje o en el racimo, el daño celular y la merma en la productividad ya son irreversibles. Los productores carecen de medios tecnológicos continuos para monitorear el subsuelo en tiempo real, favoreciendo así un ciclo crónico de ineficiencia donde los recursos como el agua y los biofertilizantes se aplican a ciegas, basándose en calendarios estáticos en lugar de necesidades fisiológicas reales.

En el estado del arte internacional, se han propuesto diversas aproximaciones para mitigar este desfase informativo. Huamán Correa (2023) introdujo un sistema de monitoreo en Perú orientado a la correlación de datos ambientales para la predicción de plagas en bananeras, subrayando la utilidad de la telemetría en tiempo real [5]. De manera similar, Rincón Vargas y Vargas Romero (2023) desarrollaron un prototipo de medición localizada de temperatura y humedad edáfica, demostrando que la vigilancia constante optimiza notablemente las estrategias de riego [6].

Por otra parte, desde la perspectiva de la teledetección macroscópica, Castillo Idrovo (2021) validó la viabilidad del uso de constelaciones satelitales para analizar el vigor vegetal mediante índices espectrales, lo que permite localizar zonas de bajo rendimiento en extensiones vastas que serían inviables de inspeccionar a pie [7]. Estas investigaciones ratifican que tanto el enfoque micro (sensores de campo) como el enfoque macro (satélites) poseen un valor innegable para la gestión agrícola moderna.

Sin embargo, a pesar de los avances documentados, las soluciones actuales presentan una fragmentación operativa. Los agricultores dominicanos no cuentan con plataformas unificadas que correlacionen de manera fluida y nativa los datos químicos del sustrato (como el pH, la conductividad eléctrica y los niveles de macronutrientes NPK) con la perspectiva radiométrica satelital a gran escala. Esta desconexión impide un diagnóstico agronómico verdaderamente holístico, limitando la adopción de una agricultura de precisión adaptada a la topografía y climatología específicas de los valles productivos de la República Dominicana.

Objetivos completados

El desarrollo de este proyecto ha implementado un sistema de diagnóstico agrícola integral y en tiempo real para cultivos de banano, estructurado sobre una arquitectura híbrida que combina el despliegue de redes de sensores IoT (LoRa) de bajo consumo para la captura in situ de variables edáficas (humedad, pH, NPK, conductividad eléctrica) y el procesamiento automatizado de imágenes satelitales (Sentinel-2) para la extracción de índices espectrales (NDVI, NDWI). El sistema proporciona una plataforma web centralizada capaz de correlacionar estos datos, generando reportes analíticos y alertas tempranas, lo que garantiza a los productores una herramienta de apoyo crítico para optimizar el uso de recursos, anticipar escenarios de estrés hídrico o nutricional, y mejorar sustancialmente el manejo preventivo de enfermedades en la producción bananera.

Metodología

Para materializar esta solución integral, se implementó una metodología de desarrollo concurrente, dividiendo el trabajo en subsistemas aislados pero altamente interdependientes: adquisición de hardware, procesamiento geoespacial y desarrollo de la arquitectura backend/frontend. El diseño de este ecosistema tecnológico se enfocó en garantizar estabilidad en entornos remotos, escalabilidad de la red de telemetría y una presentación de la información que fuera inmediatamente procesable por el usuario final, todo ello apoyado en protocolos de transmisión de bajo consumo energético.

Diagrama de bloques del flujo desde las variables del cultivo y los sensores hasta el módulo LoRa y el gateway
Figura 1. Diagrama esquemático del flujo de telemetría desde los nodos en campo hasta el panel de visualización en la nube.

Adquisición de datos a través de nodos IoT en el borde

El núcleo de la recolección de campo se basó en el diseño de estaciones de monitoreo equipadas con microcontroladores ESP32 que integran módulos transceptores LoRa V3 (SX1262 a 915 MHz). Esta selección de hardware obedece a las estrictas demandas topológicas de las áreas de cultivo, donde la conectividad celular (GSM/LTE) suele ser inestable y el consumo energético debe ser minimizado para permitir la operación autónoma. Cada nodo fue dotado de un conjunto robusto de sensores diseñados para medir variables críticas: humedad del suelo (mediante sensores capacitivos resistentes a la oxidación), temperatura y humedad relativa (BME280), radiación solar, así como electrodos especializados para la medición continua de pH, conductividad eléctrica y concentración de macronutrientes (Nitrógeno, Fósforo y Potasio).

La lógica embebida en estos nodos se encarga del acondicionamiento de las señales analógicas, su conversión digital y el empaquetado estructurado de las tramas de datos. Esta telemetría es enviada periódicamente a través de enlaces de radiofrecuencia de largo alcance hacia un Gateway centralizador, el cual actúa como puente (bridge) utilizando el protocolo MQTT para derivar la información de forma segura hacia los servidores en la nube. Este esquema asegura una alta tolerancia a fallos y permite la expansión futura de la red mediante la adición de nuevos nodos sin saturar el espectro de comunicación.

Diagrama del módulo: sensores de temperatura y humedad, NPK, humedad de suelo, luz solar, conductividad eléctrica y pH conectados al módulo LoRa
Figura 2. Diagrama de bloques del nodo IoT: sensores conectados al módulo LoRa para la transmisión de telemetría.

Análisis satelital automatizado con Google Earth Engine

Para superar las limitaciones de la observación estrictamente puntual, la metodología incorporó un motor de procesamiento de imágenes satelitales fundamentado en la plataforma Google Earth Engine (GEE). A través de scripts automatizados en Python, el sistema consulta periódicamente el catálogo Harmonized de la misión Copernicus Sentinel-2 de la Agencia Espacial Europea. Este proceso incluye un filtrado algorítmico riguroso para discriminar la cobertura nubosa, un fenómeno meteorológico muy frecuente en las zonas tropicales, garantizando que los análisis radiométricos se realicen únicamente sobre píxeles de alta pureza visual.

Topología de red: módulos Norte y Sur conectados al gateway LoRa, al servidor y base de datos, y a la aplicación web
Figura 3. Arquitectura centralizada de la topología de red, ilustrando la convergencia de datos desde el borde hacia el servidor central.

El núcleo analítico de esta sección calcula dos métricas fundamentales: el Índice de Vegetación de Diferencia Normalizada (NDVI) para cuantificar la actividad fotosintética y el vigor de la biomasa, y el Índice de Agua de Diferencia Normalizada (NDWI), el cual revela el estado del dosel foliar respecto a su contenido hídrico.

El sistema no solo extrae estos valores promedios para los polígonos correspondientes a la finca, sino que aplica una lógica de clasificación basada en umbrales (ej. NDVI ≥ 0.6 clasificado como ‘Saludable’), traduciendo metadatos crudos en evaluaciones comprensibles para el manejo agronómico.

Los resultados son inyectados al servidor mediante APIs REST, evitando el almacenamiento local pesado de archivos de imagen (rasters).

Arquitectura backend y plataforma web interactiva

La gestión integral de la información se orquestó sobre una arquitectura de software empresarial multicapa utilizando Java 17 y el ecosistema Spring Boot. Este backend MVC gestiona la persistencia de datos relacionales en MariaDB, estructurando historiales complejos de mediciones, configuración de sensores y registros de eventos. Para asegurar que la latencia entre un evento de campo y la notificación al productor fuera mínima, se implementaron túneles bidireccionales mediante WebSockets, dotando al frontend de capacidades reactivas sin la necesidad de recargar el navegador [8].

Dashboard web de monitoreo con las lecturas de las estaciones Norte y Sur: temperatura, humedad, luz, pH, conductividad y NPK
Figura 4. Dashboard interactivo de la plataforma web, presentando indicadores consolidados de sensores y alertas del sistema.

El diseño de la interfaz de usuario se realizó bajo principios de usabilidad orientados a perfiles no técnicos. El entorno web permite la administración de estaciones, la generación de reportes en PDF, el seguimiento de labores mediante un calendario agrícola interactivo, y de manera crucial, la configuración de un motor de alertas lógicas. Este motor evalúa cada paquete de datos entrante contra umbrales personalizados; si, por ejemplo, la tensión matricial del suelo indica deshidratación, el sistema detona una notificación inmediata y altera los indicadores visuales en el panel principal.

Resultados

La validación de AgroSat IoT en un entorno controlado arrojó resultados altamente satisfactorios, confirmando la resiliencia de la arquitectura técnica y la viabilidad de la propuesta para su posterior escalado comercial. En términos de conectividad en el nivel físico, los nodos basados en el transceptor SX1262 demostraron una confiabilidad sobresaliente en la propagación de señales a través de obstáculos típicos del cultivo bananero. La tasa de éxito en la entrega de paquetes de datos (Packet Delivery Ratio) hacia el gateway superó el 95% bajo condiciones de línea de vista parcial, demostrando que la tecnología LoRaWAN es perfectamente adecuada para superar la densidad foliar que caracteriza a este tipo de plantaciones.

A nivel de software, el backend en Spring Boot procesó eficientemente los flujos de telemetría entrantes, registrando y estructurando correctamente las variables en la base de datos MariaDB. Esto permitió la generación de historiales densos y consistentes. La interfaz de usuario respondió de manera fluida a las actualizaciones impulsadas por WebSockets; durante las pruebas, cualquier fluctuación anómala provocada deliberadamente en el entorno de los sensores se reflejó en el panel de control web en un tiempo inferior a los 3 segundos, validando la naturaleza ‘en tiempo real’ de la solución.

Google Earth Engine mostrando el mapa NDVI del área de estudio y los valores promedio de NDVI y NDWI en la consola
Figura 5. Análisis de NDVI y NDWI con Sentinel-2 en Google Earth Engine sobre el área de estudio.

El subsistema de teledetección probó ser un complemento excepcional. El script de automatización en Python interactuó exitosamente con la API de Google Earth Engine, mitigando el ruido causado por la cobertura de nubes y extrayendo los índices NDVI y NDWI con precisión espacial. La correlación observada entre una caída del índice NDWI satelital y la disminución de la capacitancia reportada por los sensores de humedad del suelo corroboró la robustez de combinar enfoques macro y micro para la toma de decisiones, brindando un mapa de calor virtual de las zonas de estrés en la finca.

Finalmente, el motor de alertas evidenció su eficacia operativa. Al exceder los límites predefinidos de salinidad (conductividad eléctrica) o de temperatura crítica, el sistema generó correctamente las advertencias visuales y registró las entradas en el historial de auditoría. Adicionalmente, el mecanismo de comprobación de estado (heartbeat) de los nodos fue validado exitosamente: al desconectar la alimentación de un módulo, la plataforma detectó la caída del enlace en el margen de tiempo estipulado y notificó al usuario la inactividad de la estación, lo cual es vital para el mantenimiento de la red.

Conclusión

La culminación de este proyecto marca un hito significativo en la modernización de la gestión agrícola en la República Dominicana. AgroSat IoT demuestra de manera concluyente que la barrera de entrada para la Agricultura 4.0 puede ser superada mediante el diseño ingenieril inteligente. Al integrar exitosamente arquitecturas de microcontroladores de bajo costo, protocolos inalámbricos de amplia cobertura como LoRa, y plataformas de análisis satelital de acceso abierto, se ha logrado materializar una herramienta de diagnóstico agronómico de primer nivel, capaz de sustituir la intuición empírica por certezas científicas basadas en telemetría continua y espacial.

El impacto a largo plazo de este desarrollo no se limita únicamente a la prevención de patógenos como la pudrición de la corona o a la mitigación del estrés hídrico; radica en la habilitación de una trazabilidad química e hídrica profunda, la cual es la piedra angular para maximizar el rendimiento en nichos de alto valor como lo es la producción de banano orgánico de exportación. Las lecciones aprendidas durante la fase de despliegue reafirman que la infraestructura tecnológica debe ser tan resistente como las plantas que monitorea, y que las interfaces de software deben decodificar la complejidad de los datos en directrices accionables y simples para el productor.

Como próximos pasos, se vislumbra la evolución de esta plataforma hacia esquemas predictivos más agresivos. La inmensa cantidad de datos recabados sienta las bases ideales para la futura implementación de modelos de aprendizaje automático (Machine Learning), los cuales podrán predecir curvas de degradación del suelo o brotes epidemiológicos días antes de que ocurran. Es el momento de que el sector agroindustrial, la academia y el Estado unan fuerzas para escalar estos prototipos hacia mallas de sensores a nivel nacional, transformando definitivamente el paisaje agrícola hacia una matriz de producción resiliente, tecnificada e hiperconectada.

Referencias

  1. Ministerio de Economía, Planificación y Desarrollo (MEPYD), “Ministerio de Economía pondera importancia del sector bananero y oportunidades para su revitalización,” Oct. 19, 2023.
  2. J. Tovar-Quiroz, “Agricultura 4.0: uso de tecnologías de precisión y aplicación para pequeños productores,” Informador Técnico, vol. 87, no. 1, 2023.
  3. D. Toribio-Flórez, F. Carreel, C. Jenny, y J. Carlier, “Crown rot disease in bananas: A review of current knowledge,” Postharvest Biology and Technology, vol. 116, pp. 34–40, 2016.
  4. Y. Barrera-Pardo et al., “Respuesta fisiológica al estrés hídrico de plantas de banano cv. ‘Pineo gigante’ (Musa AAA),” Biotecnología Vegetal, vol. 14, no. 3, pp. 155-162, 2014.
  5. J. A. Huamán Correa, Sistema IoT para el monitoreo climático y detección temprana de plagas en cultivos de banano mediante inteligencia artificial en la región de Piura, Tesis de Maestría, Universidad de Piura, Perú, 2023.
  6. M. F. Rincón Vargas y C. J. Vargas Romero, Diseño e implementación de un prototipo de sistema de monitoreo de temperatura y humedad del suelo en cultivos de banano. Bogotá, Colombia: UNAD, 2023.
  7. J. P. Castillo Idrovo, Aplicación de índices de vegetación NDVI a partir de imágenes Sentinel-2 para el monitoreo de cultivos de banano. Cuenca, Ecuador: Universidad de Cuenca, 2021.
  8. A. Augustin, J. Yi, T. Clausen, y W. M. Townsley, “A Study of LoRa: Long Range & Low Power Networks for the Internet of Things,” Sensors, vol. 16, no. 9, p. 1466, 2016.

AURORA SDR: cómo dos estudiantes de la PUCMM construyeron un radiotelescopio con una lata de salsa y equipo reciclado

Ismael Ricardo Ortega Almonte y Fernando José Espinal Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

En Santiago de los Caballeros, en la Escuela de Ingeniería en Computación y Telecomunicaciones de la PUCMM, dos estudiantes de Ingeniería Telemática se propusieron construir algo que casi no existe en el país: un radiotelescopio que funcione de verdad. El proyecto se llama AURORA SDR. Lo hicieron Ismael Ricardo Ortega Almonte y Fernando José Espinal Rodríguez, con la profesora Arlene Estévez como asesora. La meta: captar, procesar y mostrar en tiempo real señales de radio que vienen del espacio, específicamente la línea de emisión del hidrógeno neutro a 1420 MHz [1].

En las universidades dominicanas casi no hay forma de trabajar con radiofrecuencia real conectada a algo astronómico. Los laboratorios se quedan en simulaciones o en equipos de frecuencias bajas, y ahí se acaba la cosa. Un radiotelescopio educativo comercial arranca en 19,450 dólares. Uno profesional pasa fácilmente de los 100,000 [2]. Con esos precios, y sin infraestructura dedicada en ninguna universidad del país, a los estudiantes no les queda otra que aprender la teoría sin tocar nunca el equipo real.

El equipo no empezó de cero, eso ayudó bastante. Ya tenían acceso a un transceptor bladeRF 2.0 micro xA9 y una Raspberry Pi 4 en los laboratorios de la PUCMM. A eso le agregaron una antena parabólica reciclada, de esas que las compañías de televisión satelital retiran cuando un cliente cancela el servicio, y un alimentador (feedhorn) que armaron a mano con una lata de acero galvanizado. Meses de pruebas y ajustes después, el sistema logró detectar la señal del hidrógeno galáctico de forma repetible, algo que hasta ese momento nadie había documentado con este nivel de detalle en un proyecto académico del país.

La línea de hidrógeno neutro no se escogió al azar. Ocurre cuando el electrón de un átomo de hidrógeno invierte su espín y suelta un fotón con una longitud de onda de 21 centímetros. El hidrógeno es el elemento más abundante del universo, así que esta señal funciona casi como un mapa: con ella se ha trazado la forma espiral de la Vía Láctea, se ha calculado su curva de rotación, y se ha encontrado evidencia sobre la materia oscura [3].

De eso trata este artículo: del problema que empujó a Ismael y Fernando a meterse en esto, de lo que ya se había hecho antes en otros países, de cómo fueron armando cada pieza del sistema, y de lo que encontraron al apuntar, finalmente, su antena artesanal hacia el centro de la Vía Láctea.

Problemática y estado del arte

Escuchar el espacio sin gastar una fortuna

Las señales que llegan del espacio son débiles, muy débiles. Y cualquier ciudad moderna está llena de ruido electromagnético que las tapa. El campus de la PUCMM no es la excepción: ahí conviven señales de telefonía celular, redes Wi-Fi y transmisiones de FM que caen cerca de la frecuencia astronómica que interesa. Sin algo que filtre ese ruido, un estudiante dominicano no tiene forma real de observar el cosmos [4].

Para tener una idea del tamaño del problema: la señal de hidrógeno que Aurora buscaba llega a la Tierra con apenas -145 dBm, miles de veces más débil que cualquier señal de comunicación normal. Cualquier ruido cercano, sea térmico, industrial o de otra transmisión de radiofrecuencia, la puede sepultar si no se filtra bien [1]. En un campus rodeado de antenas celulares, routers Wi-Fi y transmisores de FM, eso pesa más que en un observatorio profesional, que de entrada se construye lejos de cualquier ciudad.

Un ingeniero de telecomunicaciones puede pasar la carrera entera estudiando cómo se propaga una onda de radio, cómo se diseña un amplificador de bajo ruido o cómo funciona la transformada rápida de Fourier. Y graduarse sin haber capturado jamás una señal que venga de fuera de la atmósfera terrestre [5]. Ese es el hueco que Aurora quiso llenar.

La respuesta del equipo fue construir un radiotelescopio barato y fácil de operar. Uno que capturara señales astronómicas reales, las procesara para sacar su contenido espectral, y mostrara los resultados en una página web accesible desde cualquier dispositivo conectado a la red de la universidad. La meta no era solo probar que se podía hacer una vez. Era dejar un instrumento instalado, funcionando, para las próximas generaciones de estudiantes.

Lo que otros ya habían intentado

El equipo no partió en un vacío total de conocimiento previo. A nivel internacional existen varios antecedentes de radiotelescopios de bajo costo basados en Radio Definida por Software (SDR) que sirvieron como referencia directa. Phelps (2024) documentó la construcción de un radiotelescopio para la línea de hidrógeno usando un dongle RTL-SDR, de apenas unos 20 dólares, junto a una antena parabólica económica, y logró detectar la emisión galáctica con un presupuesto total inferior a 300 USD [6]. Es un antecedente valioso, pero limitado: el conversor analógico-digital de 8 bits del RTL-SDR reduce considerablemente el rango dinámico del sistema, lo que dificulta distinguir señales débiles cuando hay interferencias fuertes cerca.

Otros proyectos apuntaron a mayor escala y precisión. Almutairi et al. (2025) presentaron el diseño optimizado de un radiotelescopio de 5 metros de diámetro, que también trabaja en la banda de 1.4 GHz, con especial atención a la relación ganancia-temperatura del sistema (G/T), una métrica que determina qué tan bien un receptor distingue la señal deseada del ruido térmico propio [7]. De Silva et al. (2024), por su parte, implementaron una arquitectura SDR más avanzada, con calibración espectral y corrección Doppler realizada completamente en software, lo que eliminó la necesidad de osciladores locales analógicos costosos [8].

También existen iniciativas centradas en la simplicidad educativa más que en la precisión radiométrica. El Canadian Centre for Experimental Radio Astronomy (CCERA) propone diseños específicos para la banda de 21 centímetros que reutilizan platos satelitales de televisión ya dados de baja, un enfoque que resultó directamente inspirador para Aurora [2]. Y Campbell-Wilson et al. (2025) construyeron un radiotelescopio de 2.4 metros que también reutiliza un plato satelital, y lograron incluso detectar púlsares con un desembolso inferior a 200 USD [9].

Vale la pena recordar, además, que la radioastronomía como disciplina nació prácticamente por accidente: en 1931, el ingeniero Karl Jansky detectó por primera vez radiación de origen cósmico mientras investigaba interferencias en comunicaciones de radio para los Laboratorios Bell, y descubrió, sin buscarlo, que el centro de la Vía Láctea emitía en frecuencias de radio [10]. Casi un siglo después, la posibilidad de repetir observaciones de ese tipo, aunque a una escala infinitamente más modesta, ya no depende de instalaciones estatales multimillonarias, sino de una combinación accesible de hardware SDR, procesamiento digital y software libre. Ese es, más o menos, el terreno donde se mueve el proyecto Aurora.

Lo que el equipo de Aurora notó al revisar estos antecedentes es que, aunque casi todos lograban la detección básica de la señal, ninguno integraba una arquitectura de transmisión telemática en tiempo real. La mayoría opera en modo de «grabación local», donde los datos se guardan en un archivo y se analizan después, sin visualización remota ni acceso simultáneo de múltiples usuarios. Aurora buscó cerrar esa brecha al incorporar protocolos como ZeroMQ y WebSocket para desacoplar la adquisición de la visualización, lo que permite que varios estudiantes puedan observar el mismo espectro en tiempo real desde sus propios dispositivos, algo poco común en implementaciones de bajo costo [11]. Esa combinación de hardware reciclado, procesamiento digital adaptativo para entornos urbanos con alta interferencia, y una capa de conectividad tipo Internet de las Cosas, es lo que el equipo identifica como el aporte diferencial de su proyecto frente a la literatura existente.

Objetivos completados

El equipo desarrolló un dispositivo de captación radioastronómica basado en tecnología SDR

El objetivo era capturar, procesar digitalmente y visualizar en tiempo casi real señales astronómicas reales en la banda de 1420 MHz. Con eso se buscaba resolver la falta de plataformas prácticas de radiofrecuencia en la formación universitaria dominicana. Ese objetivo general se dividió en seis objetivos específicos, cada uno pensado como una meta concreta y medible por sí sola: Implementar una cadena de adquisición RF estable en la banda de interés. Desarrollar el procesamiento digital de señales mediante FFT. Diseñar un sistema de transmisión de datos en tiempo casi real hacia un servidor. Construir una interfaz gráfica web accesible de forma remota. Integrar almacenamiento y generación de reportes automáticos. Y validar todo el sistema con pruebas experimentales que midieran su estabilidad y la calidad de los datos en un entorno urbano con alta interferencia radioeléctrica.

Metodología

De una lata de salsa a un radiotelescopio

La arquitectura de Aurora tiene cuatro etapas, y entre todas se encargan de que la señal llegue intacta desde su origen cósmico hasta la pantalla. La primera es la captación. Ahí es donde el proyecto se ve más artesanal: en vez de comprar un alimentador de antena (feedhorn) comercial, el equipo construyó el suyo con una lata de acero galvanizado, sin pintura por dentro. Las dimensiones no salieron al azar. El cilindro se cortó con un diámetro interior de 15 centímetros, lo que sitúa la frecuencia de corte del modo de propagación fundamental cerca de 1.84 GHz, y una longitud total de 18 centímetros, dentro del rango que se recomienda para que las ondas se estabilicen antes de llegar al punto de captura. Dentro del cilindro, a 5.2 centímetros del fondo cerrado (una distancia que corresponde a un cuarto de la longitud de onda guiada), soldaron una sonda de cobre sólido que convierte la onda electromagnética capturada en una señal eléctrica utilizable.

Lata metálica con un conector SMA en su costado, usada como feedhorn artesanal
Figura 1. El feedhorn artesanal, construido con una lata de acero galvanizado sin pintura interior, con la sonda de cobre soldada al conector SMA.

Ese feedhorn artesanal se acopló al punto focal de una antena parabólica comercial reutilizada, del tipo que instalan compañías de televisión satelital como Altice o Claro. Justo después del feedhorn, la señal, todavía muy débil, pasa por un amplificador de bajo ruido: un Nooelec SAWbird+ H1. Este da una ganancia de entre 40 y 45 dB, con una figura de ruido de apenas 0.6 a 0.8 dB en la banda de interés. Y hace doble trabajo: amplifica la señal sin sumarle mucho ruido propio, y de paso filtra buena parte de la interferencia urbana común (redes 4G, Wi-Fi de 2.4 GHz, señales de FM), gracias a un filtro SAW integrado centrado entre 1.35 y 1.50 GHz.

Antena parabólica sobre un marco de madera con el feedhorn de lata en el foco
Figura 2. Prototipo integrado: parábola, feedhorn y amplificador de bajo ruido (LNA) montados como una sola unidad de observación.

De ahí, la señal viaja por un cable coaxial de baja pérdida hasta el bladeRF 2.0 micro xA9, un transceptor de radio definida por software que hace el trabajo pesado del sistema. Este convierte la señal analógica en muestras digitales complejas (I/Q) mediante un convertidor analógico-digital de 12 bits, lo que da un rango dinámico teórico cercano a 74 dB. Es suficiente para trabajar con señales astronómicas que están muy por debajo del ruido térmico ambiental. El bladeRF, eso sí, no entrega corriente por su puerto de radiofrecuencia. Por eso el equipo integró un inyector Bias-T en la línea coaxial, para alimentar el LNA sin necesitar una fuente externa adicional en la azotea.

El cerebro digital detrás de la antena

Todo este flujo de datos converge en una Raspberry Pi 4. Aquí no funciona como una computadora de escritorio, sino como un controlador embebido dedicado: gestiona la cadena de radiofrecuencia y mantiene el enlace con el servidor remoto [12]. Está conectada al bladeRF por USB 3.0, un puerto necesario porque el volumen de datos entre ambos dispositivos supera los 320 Mbps cuando se trabaja a una tasa de muestreo de 10 megamuestras por segundo con 16 bits de profundidad [13]. Sobre esa placa corre GNU Radio, el software que arma visualmente todo el pipeline de procesamiento: desde la fuente de muestras hasta el cálculo de la transformada rápida de Fourier (FFT), pasando por bloques de integración temporal que promedian cientos de capturas para reducir el ruido aleatorio y dejar visible la señal astronómica, que es miles de veces más débil que el piso de ruido del propio receptor [14].

El pipeline de procesamiento cambió bastante durante el desarrollo. La primera versión usaba un esquema de retardo y suma (delay-and-sum), sin ningún mecanismo de calibración de temperatura del sistema ni referencia de tiempo estable. Eso hacía que la línea base del espectro se moviera de forma errática entre una sesión y otra, según la ganancia y la temperatura ambiental del receptor en cada momento. Esa inestabilidad, sumada a horarios de prueba limitados, interrupciones por lluvia y bastante ruido de fondo confundible con la señal buscada, llevó al equipo a rediseñar el esquema por completo.

El modelo final se bautizó internamente como spectrometer_w_cal. Incorporó un oscilador de referencia GPSDO para estabilizar la frecuencia, subió la tasa de muestreo de 4 a 10 megamuestras por segundo, y agregó un bloque de calibración de temperatura de sistema que permite alternar entre una vista sin filtrar, una vista calibrada, y modos de referencia caliente (hot) y fría (cold) para contrastar el ruido del propio instrumento contra el del cielo. También sumaron un promedio móvil configurable y salidas más completas: exportación a CSV, generación automática de imágenes del espectro, y una interfaz gráfica propia bautizada AURORA_SDR, con pestañas separadas para el espectro y para el monitoreo de temperatura del sistema y ganancia.

Del lado del software de transmisión, el sistema quedó organizado en cuatro capas desacopladas. GNU Radio controla el bladeRF, calcula la FFT de 4096 puntos y publica los vectores de potencia resultantes mediante ZeroMQ, un protocolo de mensajería liviano que no necesita un intermediario (broker) central, a diferencia de opciones como MQTT [15]. Un script puente en Python recibe esos datos y los reenvía a un servidor backend construido en Spring Boot mediante WebSocket, que mantiene una conexión persistente y de baja latencia con los clientes conectados [16]. Ese backend distribuye la información a todos los navegadores conectados y guarda instantáneas periódicas. Mientras tanto, en el navegador, una interfaz construida con Chart.js actualiza en vivo tanto el espectro como una gráfica tipo cascada (waterfall) que muestra la evolución temporal de la señal. Todo el recorrido, desde que la antena capta la onda hasta que aparece en pantalla, se completa en menos de 500 milisegundos, lo que da una experiencia de observación prácticamente en tiempo real [16].

Diseñar esta capa de comunicación no fue trivial. Transmitir las muestras crudas I/Q capturadas por el bladeRF directamente por la red hubiera sido inviable: a una tasa de muestreo de 6 megamuestras por segundo con resolución compleja de 16 bits, ese flujo bruto llega a cerca de 192 Mbps, suficiente para saturar cualquier red Wi-Fi convencional del campus. Por eso el procesamiento se hace en el borde (edge computing): la Raspberry Pi calcula la densidad espectral de potencia localmente y solo transmite el vector ya reducido. Para una FFT de 2048 puntos enviada 20 veces por segundo con precisión de coma flotante, el ancho de banda necesario cae a apenas 1.3 Mbps. Esa reducción de más de cien veces es lo que finalmente permite mantener una latencia menor a 500 milisegundos incluso en una red universitaria compartida. El sistema se diseñó, además, con objetivos concretos de calidad de servicio: disponibilidad igual o superior al 95% durante las sesiones de observación, pérdida de paquetes menor al 1%, y una relación señal-ruido mínima de 10 dB tras 60 minutos de integración continua. Esas métricas sirvieron como referencia para validar que el prototipo fuera realmente utilizable en un entorno educativo, y no solo una prueba de concepto de laboratorio.

Del lado de la experiencia de usuario, la interfaz web se pensó simple a propósito: un panel superior con el gráfico de espectro de potencia en tiempo real, centrado en la banda de 1420.4 MHz con un marcador vertical en esa frecuencia exacta, y valores numéricos en vivo como la frecuencia central en curso, el tamaño de la FFT, la tasa de muestreo y el estado del inyector Bias-T del LNA. Debajo, un panel inferior muestra el gráfico tipo cascada (waterfall), que representa la evolución temporal del espectro con una escala de color pensada para resaltar los picos de interés. Todo el diseño usa un tema oscuro, tanto para facilitar la lectura en un proyector de salón de clases como para reducir la fatiga visual durante observaciones nocturnas, que es cuando suele haber menos interferencia electromagnética en el campus. El sistema contempla también la generación de reportes automáticos y alertas configurables ante eventos inusuales, como picos de actividad solar.

Tres intentos hasta encontrar el diseño correcto

El equipo probó tres configuraciones de antena en paralelo, mientras seguía refinando el procesamiento de señal, y cada una les dejó una lección concreta para el diseño final.

La primera fue la antena parabólica pequeña reciclada de Altice, montada sobre un marco de madera con el LNA puesto directamente en el foco. Con esta no lograron detectar la línea de hidrógeno. El plato estaba diseñado originalmente para otra frecuencia y tenía un área útil reducida, así que la ganancia en 1420 MHz no alcanzó para distinguir la señal del ruido, ni siquiera con el procesamiento ya mejorado. Esa primera derrota les dejó clara una lección: no basta con reciclar cualquier plato disponible, hace falta un alimentador diseñado específicamente para la frecuencia de trabajo.

Dos vistas de la antena parabólica de Altice sobre un marco de madera en el césped
Figura 3. Modelo 1: antena parabólica de Altice reutilizada, con el LNA montado en el foco. No se logró detectar la línea de hidrógeno con esta configuración.

El segundo modelo abandonó por completo la parábola. Fue un feedhorn cónico construido enteramente por el equipo, pensado para funcionar solo, sin ningún reflector, con el LNA Nooelec SAWbird+ H1 conectado directamente en su base. Probaron dos variantes de este diseño. Y fue justo esta configuración la que dio los primeros resultados sólidos: captó la línea de hidrógeno con buena calidad, funcionando sola, sin parábola. Ahí el equipo entendió algo importante: el feed cónico, diseñado a la medida de la frecuencia de trabajo, era lo que le había faltado al Modelo 1.

Feedhorn cónico de lámina metálica sobre una mesa, de noche
Figura 4. Modelo 2: feedhorn cónico construido por el equipo, funcionando de forma independiente (sin parábola), con el LNA conectado directamente en su base.

El tercer y último modelo combinó el feedhorn cónico que ya había funcionado bien por sí solo con la parábola grande: lo montaron en el foco de un plato de malla de 2 metros de diámetro. Así aprovecharon a la vez la mayor área de captación del plato y el buen patrón de radiación del feed. Apuntando a mano hacia distintas zonas de la Vía Láctea, con ayuda de una aplicación de mapa celeste, llegó la detección clara y repetible que se documenta más adelante en este artículo. Las capturas finales de la interfaz AURORA_SDR, con el pico en 1420.57 MHz y que se muestran en la siguiente sección, corresponden exactamente a esta configuración: el feed cónico sobre la parábola de 2 metros.

Dos vistas de la parábola de malla de 2 metros en una azotea, con el feedhorn en el foco y una laptop
Figura 5. Modelo 3 (final): feedhorn cónico montado en el foco de una parábola de malla de 2 metros de diámetro. Con esta configuración se obtuvo la detección clara y repetible de la línea de hidrógeno en 1420.57 MHz.

Resultados

Un fantasma en el espectro

Antes de poder confiar en cualquier resultado, el equipo tuvo que resolver un problema que al principio parecía ser justo la señal que buscaban. En las primeras capturas de prueba, el espectro mostraba un pico angosto, de apenas uno o dos píxeles de ancho, ubicado exactamente en el centro de la banda observada. Por un momento se pudo confundir con la señal de hidrógeno. No lo era. La emisión real de hidrógeno galáctico, producto del movimiento y colisión del gas en el espacio, genera un perfil ancho por efecto Doppler, típicamente de 100 a 500 kHz de ancho, no un pico tan estrecho.

Captura de GNU Radio con un espectro plano y un pico angosto en el centro de la banda
Figura 6. Espectro con el pico anómalo (DC spike) antes del ajuste de frecuencia: un pico angosto justo en el centro de la banda, que en un principio pudo confundirse con la señal de hidrógeno.

Tras analizarlo, el equipo dio con la causa: era un «DC spike», un artefacto que producen casi todos los receptores SDR por culpa de su propio oscilador local, y que siempre aparece justo en la frecuencia exacta a la que se sintoniza el equipo. Es un fenómeno bien documentado en la radioastronomía amateur, y la solución también se conoce: aplicar una técnica de sintonía desplazada (LO offset). El equipo movió la frecuencia central de captura de 1420.405 MHz a 1420.000 MHz, y así sacó el artefacto 405 kHz fuera de la ventana de observación que les interesaba. Las pruebas posteriores confirmaron que, con este ajuste, la banda de interés quedaba completamente libre de ese ruido fantasma generado por el propio hardware.

Gráfica del espectro calibrado HI entre 1419.5 y 1421.5 MHz con la frecuencia de reposo del hidrógeno marcada
Figura 7. Espectro calibrado tras aplicar el offset de oscilador local de 405 kHz: la banda de interés queda libre del artefacto de hardware.

La señal que confirmó que el sistema funciona

Para comprobar que toda la cadena, desde la antena hasta el software, era capaz de aislar una señal astronómica real del ruido del propio instrumento, el equipo aplicó el método de calibración Hot/Cold, el procedimiento estándar en radioastronomía para convertir las lecturas relativas del receptor en valores de temperatura de antena reales. Consiste en comparar dos referencias: una “caliente”, bloqueando por completo la apertura del feedhorn con un material opaco a la señal para que el receptor vea únicamente su propia temperatura ambiente, y una “fría”, destapando el feedhorn para que observe el cielo despejado. Al contrastar ambas capturas, el sistema puede distinguir el ruido que genera el propio instrumento del que realmente proviene del espacio, dejando visible la señal astronómica sobre una línea base calibrada. Fue precisamente con este esquema de calibración Hot/Cold, aplicado sobre el Modelo 3 (feed cónico montado en la parábola de 2 metros), que el equipo obtuvo las dos capturas finales que se muestran a continuación, con el pico de hidrógeno en 1420.57 MHz.

Uno de los estudiantes sostiene el feedhorn cónico apuntándolo hacia el cielo nocturno
Figura 8. Antena en posición COLD, apuntando hacia el plano galáctico durante las pruebas de conmutación HOT/COLD.
Uno de los estudiantes coloca el feedhorn cónico en el suelo, fuera del plano galáctico
Figura 9. Antena en posición HOT, desplazada fuera del plano galáctico.

Los primeros intentos de calibración Hot/Cold, hechos antes de corregir el artefacto del oscilador, arrastraban el mismo pico angosto del DC spike. Costaba distinguir la referencia caliente de la fría con ese ruido de por medio. Ya con el ajuste de frecuencia aplicado, las sesiones siguientes (de madrugada, para evitar la interferencia del campus) mostraron una diferencia limpia entre ambas referencias. El sistema por fin se enfocaba en la zona espectral que interesaba, sin ruido propio del hardware de por medio.

Con el esquema de calibración final ya funcionando, y usando el Modelo 3 (feed cónico montado sobre la parábola de malla de 2 metros), el equipo caracterizó primero el espectro base del sistema: una FFT de 4096 bins, una tasa de muestreo de 10 megamuestras por segundo, una resolución espectral cercana a 2.44 kHz por bin, y un ancho de banda observado de ±2.5 MHz alrededor de la frecuencia central. Con esta configuración, el equipo obtuvo un pico definido y repetible en distintas sesiones de observación, centrado en 1420.57 MHz, cercano a la frecuencia de referencia de la línea de hidrógeno neutro (1420.406 MHz), sobre una línea base notablemente más estable que la del diseño inicial. El indicador de estabilidad del sistema, denominado internamente “System Heartbeat”, mostró durante estas capturas valores concentrados cerca de cero: no hubo saturación de ganancia, y la calibración funcionó como debía.

Interfaz AURORA_SDR con controles de calibración, el indicador System Heartbeat y el espectro con la línea de hidrógeno
Figura 10. Interfaz AURORA_SDR mostrando la línea de hidrógeno detectada con el esquema calibrado: pico en 1420.57 MHz sobre una línea base estable.
Segunda captura de la interfaz AURORA_SDR con un espectro de forma similar
Figura 11. Segunda observación con el esquema calibrado, mostrando que la forma de la línea base y la posición del pico se mantienen consistentes entre sesiones.

Vale la pena comparar estos resultados con los antecedentes internacionales que se revisaron antes. Phelps (2024) logró una detección básica con un RTL-SDR de 8 bits por menos de 300 USD [6]. Campbell-Wilson et al. (2025) detectaron púlsares con una inversión inferior a 200 USD usando un plato de 2.4 metros [9]. Aurora llegó a una detección repetible y calibrada de la línea de hidrógeno con un gasto real de apenas 5,050 pesos dominicanos, poco más de 84 USD. Eso fue posible porque la mayor parte del hardware crítico (el bladeRF, la Raspberry Pi 4 y las antenas) ya era de la universidad. El costo teórico de replicar el sistema completo desde cero, sin reutilizar nada, se estima en 1,292.79 USD. Aun así, esa cifra queda muy por debajo de los sistemas comerciales educativos, que arrancan en 19,450 USD [2].

Aplicar el método de calibración Hot/Cold no fue sencillo, porque el procedimiento tradicional exige mover físicamente la antena entre una referencia “caliente” a temperatura ambiente y una referencia “fría” de cielo despejado, y la antena de la universidad quedó instalada en un montaje fijo, sin esa posibilidad de movimiento. En lugar de forzar una solución que el hardware disponible no podía soportar, el equipo diseñó una alternativa práctica: bloquear por completo la apertura del feedhorn con un material opaco a la señal para simular la referencia caliente, y luego destaparlo para dejar que observara el cielo normalmente como referencia fría. Esa adaptación fue precisamente la que permitió obtener la calibración estable detrás de la detección mostrada en la sección anterior, aunque el equipo reconoce que un sistema de apuntado motorizado, capaz de mover físicamente la antena entre ambas referencias, sigue siendo una mejora pendiente para ganar todavía más precisión radiométrica.

Es importante ser igual de honestos sobre las limitaciones generales del sistema en su estado actual. La interferencia de otras señales de radiofrecuencia presentes en el campus sigue dificultando la recepción de la señal débil de hidrógeno, incluso con todo el filtrado aplicado. La antena depende de ajuste completamente manual, lo que limita tanto la precisión como la duración práctica de cada sesión de observación. El feedhorn artesanal, aunque funcional, ofrece un rendimiento inferior al de un modelo comercial optimizado. Y como cualquier sistema de observación radioastronómica en superficie, la calidad de los datos capturados depende de condiciones ambientales que el equipo no puede controlar. Ninguna de estas limitaciones invalida lo logrado, pero mapear con claridad hasta dónde llega el sistema actual es lo que permite planificar con seriedad los próximos pasos.

Conclusión

Lo que sigue para Aurora

Más allá del logro técnico puntual, el proyecto deja varias lecciones que probablemente sean tan valiosas como la propia detección de la señal. La primera es que un artefacto de hardware, lejos de ser un fracaso, terminó siendo una oportunidad de aprendizaje: identificar y corregir el DC spike obligó al equipo a entender a fondo el comportamiento interno de un receptor SDR, algo que ningún curso teórico enseña con la misma claridad que un problema real en el laboratorio. La segunda es que la calibración tradicional de referencia caliente/fría, pensada para antenas móviles, tuvo que adaptarse a las limitaciones físicas de un montaje fijo, una solución práctica ante una restricción real de infraestructura.

De cara al futuro, el equipo ya identificó mejoras concretas para la siguiente etapa del proyecto: sustituir el plato reflector actual por una antena parabólica simétrica de mayor tamaño, reemplazar el feedhorn artesanal por uno cónico diseñado específicamente para esas nuevas dimensiones, y automatizar el apuntado del radiotelescopio con motores paso a paso controlados desde la Raspberry Pi, de forma que el sistema pueda seguir el movimiento de la Vía Láctea sin intervención manual constante. También se contempla mejorar la organización del código fuente y respaldarlo en el repositorio institucional de la Escuela, para que el proyecto pueda ser retomado, auditado o replicado por otros estudiantes en ciclos académicos posteriores.

Aurora demuestra algo que va más allá de la radioastronomía: que es posible construir instrumentación científica funcional en un contexto universitario con recursos limitados, siempre que exista disposición para experimentar, fallar, entender por qué se falló, y volver a intentarlo. Para un país como República Dominicana, sin plataformas accesibles de este tipo, ese es quizás el aporte más importante del proyecto: mostrar que escuchar el universo no tiene por qué ser un privilegio reservado a observatorios con presupuestos millonarios, y que ese primer paso puede darse, literalmente, con una lata de salsa y equipo que otros ya habían dado por obsoleto.

Referencias

  1. J. D. Kraus, Radio Astronomy, 2nd ed. Powell, OH, USA: Cygnus-Quasar Books, 1986.
  2. Canadian Centre for Experimental Radio Astronomy (CCERA), “A 21cm radio telescope for the cost-conscious,” [Online]. Available: http://www.ccera.ca/papers/a-21cm-radio-telescope-for-the-cost-conscious/
  3. “Línea de hidrógeno,” AcademiaLab. [Online]. Available: https://academia-lab.com/enciclopedia/linea-de-hidrogeno/. Accessed: Feb. 11, 2026.
  4. Observatorio Astronómico UTP, “Radioastronomía,” Universidad Tecnológica de Pereira. [Online]. Available: https://observatorioastronomico.utp.edu.co/radioastronomia/
  5. C. V. Niño Rondón et al., “Radio definida por software: una mirada a las tendencias y aplicaciones,” Revista Ingenierías USBMed, vol. 14, no. 1, 2023. [Online]. Available: https://portal.amelica.org/ameli/journal/536/5364250007/html/. Accessed: Feb. 11, 2026.
  6. J. Phelps, “Paper on building a low cost RTL-SDR based hydrogen line radio telescope,” RTL-SDR Blog, 2024. [Online]. Available: https://www.rtl-sdr.com/paper-on-building-a-low-cost-rtl-sdr-based-hydrogen-line-radiotelescope/
  7. N. Almutairi et al., “Design and optimization of a low-cost 5-m radio telescope at 1.4 GHz,” Radio Science, vol. 59, no. 2, 2025. doi: 10.1029/2024RS008170.
  8. B. A. De Silva et al., “Design and implementation of a software defined radio-based radio telescope for hydrogen line observation at 1.42 GHz,” TechRxiv, 2024. doi: 10.36227/techrxiv.722721.v1.
  9. D. Campbell-Wilson, C. Flynn, and T. Bateman, “Observations of the Vela pulsar with a low-cost, 2.4m radio telescope at Woodchester Observatory,” Publications of the Astronomical Society of Australia, vol. 42, 2025. doi: 10.1017/pasa.2025.12.
  10. Astromía, “Historia de la radioastronomía,” n.d. [Online]. Available: https://www.astromia.com/astronomia/radiohistoria.html
  11. A. Banks and R. Gupta, “MQTT Version 5.0,” OASIS Standard, Oct. 2019. [Online]. Available: https://docs.oasis-open.org/mqtt/mqtt/v5.0/mqtt-v5.0.html
  12. Raspberry Pi Foundation, “Raspberry Pi 4 technical datasheet,” 2024. [Online]. Available: https://www.raspberrypi.com/products/raspberry-pi-4-model-b/specifications/
  13. GNU Radio Project, “GNU Radio manual and documentation,” 2024. [Online]. Available: https://wiki.gnuradio.org/index.php/Tutorials
  14. “WebSocket protocol,” RFC 6455, Dec. 2011. [Online]. Available: https://datatracker.ietf.org/doc/html/rfc6455
  15. R. T. Fielding, “Architectural styles and the design of network-based software architectures,” Ph.D. dissertation, Univ. California, Irvine, 2000.
  16. E. A. Lee and S. A. Seshia, Introduction to Embedded Systems: A Cyber-Physical Systems Approach, 2nd ed. MIT Press, 2017.

Sistema Inteligente de Ecualización Acústica mediante Procesamiento Digital de Señales

Wilfrido Guillermo Perdomo Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El sonido en espacios cerrados raramente se conforma de manera uniforme. En espacios como auditorios, aulas universitarias y salas de conferencias, la distribución acústica puede ser afectada por múltiples factores como son: la arquitectura del espacio, como su geometría, los materiales utilizados en las superficies, el ruido en el ambiente generado por sistemas de ventilación y la ubicación de fuentes sonoras con respecto a los oyentes.

Este proyecto propone la creación de un sistema de ecualización acústica inteligente que opera de forma autónoma y en tiempo real capaz de ser ajustada al ambiente de uso. De esta forma creando un cambio de vista hacia la ecualización adaptiva, en donde los sensores monitorean el entorno constantemente y ajustan el audio de forma dinámica.

Problemática y estado del arte

En un espacio cerrado como salas de conferencias o aulas, al hacer uso de sistemas de climatización, se genera un ruido constante que mientras de vez en cuando no es detrimental a la experiencia auditiva, termina causando problemas al oyente ya que es un ruido constante que termina enmascarando otros sonidos en el mismo rango de frecuencias. También, al hacer uso de bocinas u otros sistemas reproductores, es posible que, en espacios alejados a la fuente, el sonido no se llegue a percibir correctamente debido a la cercanía o distancia del oyente a estas fuentes.

Es por esto que normalmente la solución a algunos de estos problemas es el aumento del volumen general del sistema de audio, lo que termina siendo contraproducente al generar mayor malestar físico y reverberación al oyente, no logrando así resolver el desbalance espectral que causa el ruido ambiental.

A través de las pruebas hechas a través del desarrollo se encontró que el ruido ambiental en ciertas aulas universitarias no es uniforme, sino que se concentra en la banda de frecuencias graves, con niveles que pueden alcanzar incluso a valores como 123 dB, donde si se sigue las soluciones tradicionales de simplemente subir el volumen, las frecuencias se saturan y no se resuelve el problema principal de la saturación de la banda de frecuencias grave, creando así una experiencia sonora físicamente molesta.

Aunque actualmente existan diversos métodos para mitigar los problemas acústicos que se generan ocasionalmente, la mayoría de estas soluciones se encuentran detrás de barreras como lo que es la accesibilidad, la necesidad de un experto en el tema, o el conocimiento previo de cómo funciona el audio en su totalidad.

Muchos acercamientos utilizan el procesamiento en la nube para el control de los sistemas, pero se enfrentan a los problemas como la latencia y la saturación de red, que son aspectos que no pueden ser ignorados por lo delicado que es la transmisión de audio, en donde incluso un detenimiento de un fragmento de segundo puede ser detectado y alertado por el oído humano.

Para la realización de un sistema que cumpla con todos los requerimientos que se tienen, es necesario usar la Transformada Rápida de Fourier (FFT) que permite la caracterización de señales acústicas en tiempo real utilizando la escala logarítmica. Reduciendo la complejidad computacional del análisis espectral y haciendo posible el procesamiento en tiempo real del sonido de un espacio.

Además de esto, al hacer uso de la ecualización adaptiva podemos responder a cambios en el entorno acústico, haciendo cambios a los coeficientes de ecualización y eficientizando el uso de los recursos disponibles. Haciendo uso de filtros IIR se permite implementar ecualizadores paramétricos, dando la posibilidad de modificar los coeficientes de la banda de frecuencias mientras se ejecuta.

Para superar estas limitaciones de latencia y congestión de red, este proyecto adopta un enfoque en donde se ejecuta la Transformada Rápida de Fourier (FFT) de forma local en nodos sensores, evitando así que el sistema transmita flujos de audio pesados y, en su lugar, envía únicamente metadatos espectrales procesados a un servidor central. Esta arquitectura no solo garantiza la privacidad de los usuarios al no retransmitir audio crudo, sino que permite una capacidad de respuesta inmediata ante variaciones acústicas, logrando un sistema de ecualización verdaderamente adaptativo y eficiente en el uso de recursos de red.

Objetivos completados

El desarrollo de este proyecto ha logrado implementar un sistema de ecualización acústica inteligente mediante el uso de procesamiento digital de señales para resolver la degradación de la inteligibilidad en ambientes cerrados. El sistema integra nodos de captura basados en ESP32 que ejecutan localmente la Transformada Rápida de Fourier (FFT), permitiendo la extracción y envío de metadatos espectrales precisos hacia un servidor central de manera eficiente. Asimismo, se desarrolló e implementó un algoritmo de control proporcional capaz de ajustar hasta 10 bandas de frecuencia de forma independiente, garantizando una alta velocidad de estabilización acústica. Finalmente, mediante la integración de GStreamer, el sistema provee una salida de audio continua con 0 ms de interrupción durante los cambios dinámicos de coeficientes, asegurando una experiencia de uso fluida y profesional frente a condiciones de ruido ambiental variable.

Metodología

La metodología adoptada para este proyecto se fundamenta en un diseño de hardware y software distribuido, enfocado en la eficiencia de cómputo y la respuesta en tiempo real. A diferencia de los acercamientos tradicionales que requieren una conexión física compleja, esta solución propone un ecosistema inalámbrico modular capaz de adaptarse a diferentes geometrías arquitectónicas sin necesidad de reconfiguraciones profundas en el código base.

Arquitectura de adquisición y procesamiento de datos

El primer pilar de la solución es la red de nodos sensores de bajo costo. Cada nodo está integrado por un microcontrolador ESP32 y un micrófono digital INMP441 con interfaz I2S. La elección de una interfaz digital es crítica, ya que permite mantener la integridad de la señal acústica desde la captura, evitando las interferencias electromagnéticas comunes en las señales analógicas. Lo novedoso de esta etapa reside en que el ESP32 no actúa como un simple transmisor, este ejecuta localmente una Transformada Rápida de Fourier (FFT) para descomponer el sonido ambiente en sus componentes espectrales.

Diagrama de la arquitectura: bocina, dos micrófonos INMP441 con nodos ESP32, Raspberry Pi, computadora transmisora y display gráfico
Figura 1. Esquema general de la arquitectura distribuida del sistema.

Al procesar la FFT, el sistema solo transmite vectores de datos que representan la energía de las frecuencias detectadas. Este enfoque reduce drásticamente el uso del ancho de banda y mitiga los problemas de congestión de red mencionados anteriormente. Además, al no transmitir el audio crudo, se garantiza una capa de privacidad intrínseca, ya que el servidor central nunca recibe ni almacena grabaciones de voz, sino únicamente metadatos matemáticos de la acústica del salón.

Servidor central y gestión de audio con GStreamer

La unidad de procesamiento central, basada en una Raspberry Pi 4, actúa como el integrador de la inteligencia del sistema. Aquí se recibe la información espectral de todos los nodos de la red AudioNet y se gestiona el flujo de audio mediante la librería GStreamer. Esta herramienta permite la creación de pipelines de procesamiento multihilo, donde se insertan filtros de respuesta al impulso infinito (IIR) para cada una de las 10 bandas de frecuencia configuradas.

Diagrama del pipeline de audio: entrada, conversión, ecualizador IIR de 10 bandas con inyección de control y salida
Figura 2. Visualización del procesamiento dinámico de filtros sin interrupción de señal.

La ventaja de utilizar GStreamer frente a otras soluciones de software es su capacidad para manipular propiedades de los filtros mientras se reproduce audio. Mientras que otros sistemas presentan latencias audibles al actualizar el pipeline de uso, ya sea reiniciándolo al mismo tiempo, o creando otro sub-pipeline. El pipeline implementado permite modificar los coeficientes de ecualización de forma síncrona, logrando que el ajuste sea imperceptible para el oído humano, manteniendo una salida de audio constante y libre de artefactos sonoros.

Algoritmo de control y calibración dinámica

Para la toma de decisiones, se implementó un algoritmo de control proporcional que opera de manera cíclica. El proceso inicia con una fase de calibración dinámica donde el sistema mide el “piso de ruido” del ambiente durante 10 segundos. Una vez establecido este umbral, el algoritmo compara en tiempo real las variaciones energéticas reportadas por los nodos. Si se detecta un incremento sostenido en una banda específica, el sistema calcula automáticamente una ganancia negativa proporcional para compensar dicho ruido.

Diagrama de flujo del algoritmo de control: detección de feedback, cálculo del error por banda, ajuste proporcional y aplicación en GStreamer
Figura 3. Lógica de decisión para el ajuste automático de bandas de frecuencia.

Para garantizar la estabilidad del sistema, se incorporó una “zona muerta”. Permitiendo evitar que el sistema reaccione de forma errática ante ruidos transitorios o picos de señal insignificantes, asegurando que la ecualización solo cambie ante variaciones reales y persistentes de la acústica del entorno. Este enfoque preventivo garantiza que el audio se mantenga estable y confortable para el usuario final.

Interfaz visual y modos de operación

Finalmente, el sistema se complementa con una interfaz táctil basada en el ESP32-S3-Touch-LCD-7. Esta permite al usuario observar de manera gráfica y en tiempo real el comportamiento del espectro en las diferentes zonas del recinto. La metodología de diseño de la interfaz se centró en la usabilidad, ofreciendo al usuario la posibilidad de elegir entre una operación totalmente autónoma o una modalidad de recomendación manual, donde el operador toma las decisiones de cómo manipular el sistema.

Prototipo del sistema: pantalla táctil con la interfaz de la red de micrófonos, nodos sensores en carcasas impresas y bocina
Figura 4. Implementación final del centro de control táctil del sistema.

Resultados

Durante el desarrollo del proyecto, se ha podido observar el cumplimiento de ciertas facetas de los objetivos propuestos, validando así el funcionamiento del sistema, obteniendo resultados como los siguientes:

  • Precisión en la detección espectral. El sistema logró identificar con éxito los niveles críticos de ruido en espacios reales de la universidad, registrando hasta picos de 123.3 dB en salones universitarios frente a picos de 107 dB en entornos residenciales, permitiendo una compensación precisa al enmascaramiento sonoro.
  • Latencia de procesamiento. A través del proyecto se estaba haciendo uso de librerías específicas para la transmisión y el control del audio saliente, luego de una transición hacia GStreamer se ha logrado eliminar todos los cortes de audio existentes en el sistema, logrando así un procesamiento y cambio de bandas que se asemejan a sistemas profesionales.
  • El algoritmo ha demostrado ser capaz de adaptarse rápidamente a las variaciones del ruido en el ambiente, consiguiendo alcanzar la convergencia y estabilidad en un promedio de 16 segundos.

Conclusiones

El desarrollo del proyecto confirma que la integración de hardware utilizando nodos de procesamiento y algoritmos de control proporcional eficaces permiten resolver problemas acústicos con una eficiencia comparable a sistemas profesionales. La investigación y las pruebas realizadas permiten extraer las siguientes conclusiones:

Continuidad y calidad de uso: la transición técnica a mejores tecnologías fue un aspecto clave para el éxito de todo el sistema, reduciendo la latencia de la conmutación de filtros y validando la posibilidad de realizar ajustes dinámicos de ecualización de forma no audible al oído humano.

Innovación en el procesamiento: la capacidad de ejecutar procesos complicados como lo es la Transformada Rápida de Fourier (FFT) en los nodos sensores de audio representa un avance para el procesamiento eficaz de datos en comparación de sistemas centralizados convencionales.

Visualización y control táctil: la interfaz desarrollada utilizando una pantalla touch con un ESP32 integrado permite que el usuario tenga acceso a diferentes opciones, no técnicas y técnicas. Como es la visualización del comportamiento espectral y poder elegir entre dos modos de ecualización, autónomo o asistido, permitiendo que el usuario pueda tomar decisiones operativas según su parecer.

Referencias

  1. Widrow, B., Glover, J. R., McCool, J. M., Kaunitz, J., Williams, C. S., Hearn, R. H., … & Goodlin, R. C. (1975). Adaptive noise cancelling: Principles and applications. Proceedings of the IEEE, 63(12), 1692-1716. https://ieeexplore.ieee.org/document/1451965
  2. Cecchi, S., Bruschi, V., Peretti, P., & Bettarelli, F. (2024). Real Time System for Sound Enhancement in Noisy Environment. 27th International Conference on Digital Audio Effects (DAFx24), Guildford, UK, pp. 381–387. https://www.dafx.de/paper-archive/2024/papers/DAFx24_paper_70.pdf
  3. Avargel, Y., & Cohen, I. (2007). On multiplicative transfer function approximation in the short-time Fourier transform domain. IEEE Signal Processing Letters, 14(5), 337-340. https://ieeexplore.ieee.org/document/4154719
  4. Abhayapala, T. D., & Ward, D. B. (2002). Theory and design of high order sound field microphones using spherical microphone array. IEEE International Conference on Acoustics, Speech, and Signal Processing, 2, 1949–1952. https://researchportalplus.anu.edu.au/en/publications/theory-and-design-of-high-order-sound-field-microphones-using-sph-2
  5. Espressif Systems. (2023). ESP32 Technical Reference Manual. https://www.espressif.com/sites/default/files/documentation/esp32_technical_reference_manual_en.pdf
  6. Sebastià V., & Malte Kob. (2016). Real-time auralization of room acoustics for the study of live music performance. https://www.researchgate.net/publication/299560219_Real-time_auralization_of_room_acoustics_for_the_study_of_live_music_performance
  7. Mignot et al. (2023). “Reconstruction of transient acoustic field using sparse real-time near-field acoustic holography.” Journal of the Acoustical Society of America, 154(4), 2023. https://www.sciencedirect.com/science/article/abs/pii/S0022460X23004224
  8. Corey, R. M., Skarha, M. D., & Singer, A. C. (2019). Cooperative Audio Source Separation and Enhancement Using Distributed Microphone Arrays and Wearable Devices. arXiv preprint arXiv:1912.05038. https://arxiv.org/abs/1912.05038

Sistema de detección temprana de fuego mediante el uso de cámaras termográficas biespectrales en almacenes de fábricas textiles

Nicolás de Jesús Familia Mateo – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La innovación como respuesta a una problemática crítica

Los incendios en almacenes de fábricas textiles representan una amenaza constante para la continuidad operativa, la preservación de mercancías y sobre todo la vida humana. En este contexto fue desarrollado, en la Pontificia Universidad Católica Madre y Maestra, un proyecto de grado enfocado en el diseño e implementación de un sistema de detección temprana de fuego mediante el uso de cámaras termográficas biespectrales, procesamiento local en el borde y una plataforma web de monitoreo en tiempo real. La propuesta se origina dentro de la carrera de Ingeniería Telemática con la autoría de Nicolás de Jesús Familia Mateo y se inserta dentro de una línea de trabajo donde convergen visión computacional, redes, sistemas embebidos y desarrollo de software orientado a la supervisión de eventos críticos.

La motivación principal del proyecto parte de una observación puntual: en entornos industriales con alta presencia de materiales inflamables, como ocurre en la industria textil, la detección tradicional basada exclusivamente en sensores puntuales puede resultar insuficiente cuando se requiere cobertura amplia, baja tasa de falsas alarmas y capacidad de anticipación. El problema no se limita a detectar humo o calor cuando el incendio ya se encuentra claramente desarrollado, puesto que su verdadero valor está en identificar conatos de fuego y comportamientos térmicos anómalos antes de que la situación escale a un evento de gran magnitud.

Bajo esa premisa, se propuso una solución híbrida que aprovecha la capacidad de una cámara biespectral para observar simultáneamente el espectro visible y el espectro infrarrojo, el poder de cómputo local de una unidad Jetson Orin para ejecutar inferencia en tiempo real y una aplicación web centralizada capaz de recibir, almacenar, visualizar y notificar alertas. El sistema además incorpora un microcontrolador ESP32-S3 para accionar una sirena estroboscópica, un pulsador de incendios y habilitar interfaces analógicas de integración con subsistemas externos, como mecanismos de supresión contra incendios.

Más allá de su valor técnico, el proyecto busca ser una respuesta realista a necesidades presupuestarias y operativas en entornos como el de la República Dominicana. En lugar de plantear una arquitectura dependiente de grandes despliegues de sensores especializados y de costosas instalaciones distribuidas, la propuesta explora cómo una misma cámara puede cubrir áreas amplias y cómo el procesamiento en el borde puede reducir la latencia sin trasladar toda la carga operativa a la nube. El resultado es un enfoque que busca ser tecnológicamente sólido, económicamente razonable y adaptable a condiciones reales de operación.

Cuando la detección tradicional deja espacios de riesgo

El riesgo de incendio en la industria textil se ve intensificado por la presencia de fibras, polvos en suspensión, materiales combustibles, cableados eléctricos, maquinaria sometida a altas temperaturas y procesos donde un pequeño error puede desencadenar una propagación rápida del fuego. A ello se suma que los almacenes concentran mercancía en volúmenes importantes, de modo que una ignición inicial puede encontrar en cuestión de segundos o minutos una carga combustible suficiente para convertirse en una emergencia mayor. Por esta razón, la prevención y la detección son asuntos esenciales de la seguridad industrial.

Adicionalmente, el inconveniente también posee una dimensión humana y social. En casos de incendios en fábricas textiles de Bangladesh se han llegado a producir decenas de muertes y numerosos heridos, evidenciando que la ausencia de mecanismos adecuados de prevención y respuesta puede conducir a catástrofes irreversibles [15]. Estos antecedentes, aunque ocurridos fuera del país, sirven como recordatorio de que el riesgo es estructural y no debe interpretarse como una posibilidad remota. En la República Dominicana y en otros países en vías de desarrollo, donde las limitaciones presupuestarias suelen condicionar la adopción tecnológica, el desafío se vuelve todavía más delicado.

Los sistemas convencionales de detección presentan ventajas conocidas, pero también varias restricciones dentro de este tipo de entorno. Los detectores puntuales de humo, calor o llama deben ser instalados de forma estratégica y en gran cantidad para ofrecer una cobertura adecuada. Aun así, pueden quedar zonas poco protegidas y, además, la propagación del humo o del calor no es instantánea. En consecuencia, la alerta puede llegar cuando el fenómeno ya alcanzó una etapa visible o claramente peligrosa. En fábricas y almacenes donde el objetivo es ganar incluso una pequeña ventana de tiempo para actuar este retraso reduce el valor preventivo del sistema.

A lo anterior se añaden las falsas alarmas, que en un ambiente con motas de fibra, polvo y partículas suspendidas pueden presentarse con mayor frecuencia, especialmente en detectores de humo ópticos [1]. Cada falsa activación, además de implicar una interrupción de las operaciones, también representa un desgaste progresivo de la confianza del personal en el sistema. Una arquitectura que produce demasiadas alarmas injustificadas termina siendo operativamente costosa y, en el peor de los casos, psicológicamente ineficaz, porque el personal comienza a normalizar eventos que deberían ser tratados con seriedad [4].

Frente a estas limitaciones, la visión computacional ha ganado relevancia como alternativa para la detección de fuego y humo mediante análisis de video. A diferencia del enfoque puntual, los sistemas basados en video observan la escena de forma continua y pueden extraer patrones relacionados con el color, la forma, el parpadeo, el crecimiento y el comportamiento espaciotemporal del fuego y del humo. Cuando esta lógica se combina con termografía, la capacidad analítica se amplía aún más, ya que el sistema puede considerar también la temperatura, la distribución térmica y anomalías invisibles al ojo humano.

Diversos trabajos previos han validado el uso de arquitecturas basadas en CNN y en la familia YOLO para la detección de humo y fuego en tiempo real [17]. Sin embargo, el estado del arte también deja claro que no existe una solución universal. El rendimiento depende de la calidad del dataset, del tipo de entorno, de las condiciones de iluminación, de la capacidad computacional disponible y de la forma en que se integran los componentes físicos y lógicos del sistema. En ese punto es donde se sitúa la contribución del presente proyecto: no se limitó a entrenar un clasificador, sino que articuló una solución integral de hardware, software, red y notificación enfocada en almacenes textiles [11, 13].

El componente diferencial más importante de la propuesta radica en la biespectralidad, ya que mientras que muchos esquemas de detección por video dependen exclusivamente del canal RGB, aquí se trabajó con una cámara Hikvision capaz de ofrecer simultáneamente visión óptica e infrarroja. Esa dualidad permite observar la escena y contextualizarla visualmente, pero al mismo tiempo medir y vigilar el comportamiento térmico de los objetos presentes en el campo de visión. Con ello se refuerza la posibilidad de advertir escenarios previos a la ignición, un aspecto particularmente valioso cuando se pretende pasar de un enfoque reactivo a uno más proactivo.

Diagrama en bloques: cámara Hikvision, Jetson Orin, ESP32 con sirena y pulsador, y servidores de la EICT con base de datos, backend y aplicación web
Figura 1. Diagrama en bloques de la solución de detección temprana de fuego diseñada
Diagrama de flujo de datos: detección con la cámara y el Jetson, envío del JSON, alerta en la web, correo electrónico y disparo de la sirena
Figura 2. Diagrama de flujo de datos de la solución propuesta

Objetivos completados

El desarrollo del presente proyecto permitió crear un sistema de detección de fuego mediante video para la identificación temprana de focos de fuego en almacenes de fábricas textiles, integrando una cámara termográfica biespectral para la captura simultánea del entorno en tiempo real, un esquema local de procesamiento con Jetson Orin para eficientizar la inferencia y reducir la latencia, una interfaz analógica habilitada mediante un microcontrolador ESP32-S3 para la activación de sirena estroboscópica y la posible integración de mecanismos de supresión, y una aplicación web de monitoreo capaz de recibir, administrar, visualizar y notificar alertas en tiempo real, consolidando así un flujo completo de adquisición, análisis, decisión y respuesta acorde con los objetivos planteados desde el inicio del proyecto.

Metodología basada en subsistemas para construir una solución integral

La metodología adoptada se apoyó en una lógica de subsistemas. En lugar de intentar una integración completa desde las primeras etapas, el desarrollo se organizó de forma que cada componente pudiera ser validado de manera independiente antes de su unificación final. Este enfoque permitió aislar problemas, asignar responsabilidades técnicas claras y reducir la complejidad durante el prototipado. El hardware, el software de inferencia, la plataforma web y la orquestación de alertas físicas fueron tratados como módulos con funciones específicas aunque desarrollados desde el principio como partes de un mismo flujo operativo.

En el plano del hardware se trabajó con tres piezas principales: la cámara termográfica biespectral Hikvision DS-2TD2617, la unidad de procesamiento local Jetson Orin y el microcontrolador ESP32-S3 con conectividad Ethernet. La cámara fue validada en sus dos canales de video RGB e infrarrojo, así como en su capacidad de retransmisión mediante protocolos IP como RTSP. El Jetson fue evaluado como plataforma para entrenamiento e inferencia con aceleración gráfica, mientras que el ESP32-S3 fue preparado para integrarse como publicador y suscriptor MQTT y como controlador de la interfaz de potencia asociada a la sirena y al pulsador manual de incendios.

El sistema físico también exigió resolver aspectos de instalación y soporte, puesto que la cámara Hikvision, debido a razones de sus características de peso y formato, requirió el diseño de un mecanismo de acople a un trípode robusto, construido a partir de una estructura metálica disponible en laboratorio y adaptaciones mecánicas sobre un registro genérico. Aunque a primera vista esto podría parecer una tarea menor, en realidad fue fundamental para viabilizar las pruebas en distintos escenarios y conservar movilidad durante la etapa experimental. El prototipo debía ser funcional, no obstante también manipulable y replicable dentro de un entorno académico controlado.

En lo relativo al procesamiento inteligente, se seleccionó la arquitectura YOLO en su variante YOLOv8n. Esta decisión respondió a dos criterios principales. En primer lugar, YOLO ha demostrado un balance favorable entre velocidad y precisión para tareas de detección en tiempo real [11]. Segundo, la variante nano resulta apropiada para una plataforma embebida como el Jetson Orin, donde la eficiencia en el uso de recursos es un factor estratégico. El proyecto valoró la posibilidad de emplear versiones más recientes, sin embargo, al final se priorizó la estabilidad y la documentación disponible alrededor de YOLOv8.

La construcción del banco de datos fue uno de los pasos más determinantes de la metodología. Se partió de un dataset curado de 9,775 imágenes proveniente de Roboflow Universe. Además, se adicionaron más de 150 imágenes elaboradas específicamente para el escenario de despliegue del sistema. Estas imágenes extra incorporaron variaciones de llamas, objetos incendiados y distintos niveles de iluminación dentro del espacio controlado del Laboratorio de Comunicaciones Aplicadas. Más adelante, mediante técnicas de aumento de datos, ese conjunto fue ampliado significativamente hasta conformar un dataset final de 24,558 imágenes, fortaleciendo la capacidad de generalización del modelo frente a distintas condiciones.

Dos capturas de la herramienta de etiquetado con llamas y humo anotados en el laboratorio
Figura 3. Ejemplares de imágenes caracterizadas para el dataset. Lugar de despliegue: Laboratorio de Comunicaciones Aplicadas, Campus Santiago

Las técnicas de aumento aplicadas incluyeron modificaciones de saturación, rotación, brillo y exposición. La decisión metodológica detrás de estas transformaciones fue simple pero importante: si la solución iba a ser usada en escenarios donde la iluminación cambia, donde la cámara puede no estar siempre en el mismo ángulo o donde el humo altera visualmente la escena, entonces el modelo debía ser expuesto durante el entrenamiento a esa diversidad de condiciones. De ese modo, se buscó disminuir la fragilidad del clasificador ante desviaciones razonables respecto del patrón base del dataset.

En la etapa de entrenamiento se fijó un máximo inicial de 300 epochs, acompañado de un mecanismo de parada temprana, criterio que fue coherente con prácticas comunes para datasets suficientemente curados, pero también evitó desperdiciar recursos computacionales cuando el proceso dejara de mostrar mejoras relevantes. El entrenamiento finalizó de manera prematura en 201 epochs, lo que fue interpretado como un indicio de convergencia alcanzada antes del límite establecido. La ejecución se realizó sobre el Jetson Orin, reforzando así el interés del proyecto por demostrar viabilidad real en una plataforma de borde y no únicamente en un entorno de laboratorio idealizado.

La metodología de inferencia no se limitó al análisis del video RGB, puesto que este no era el punto más fuerte del proyecto. El script desarrollado en Python 3.11 integró dos hilos de trabajo principales. El primero, apoyado en GStreamer y un enlace RTSP, se encargaba de recibir video en tiempo real, ejecutar inferencia con YOLOv8n y generar capturas asociadas a eventos detectados. El segundo se enfocaba en la lectura de temperatura desde la cámara Hikvision mediante ISAPI, la interfaz REST propietaria del fabricante Hikvision. Esta integración no fue trivial, puesto que requirió ajustar el modo de operación térmico de la cámara y resolver retos asociados con autenticación tipo Digest mediante la clase HTTPDigestAuth de la librería requests.

Otra decisión metodológica importante fue la definición del escenario de demostración. El proyecto estableció que la validación debía ocurrir en un entorno controlado capaz de simular condiciones de un almacén textil sin comprometer la seguridad del laboratorio. Para ello se contempló el uso de una unidad de cuerpo negro para inducir puntos calientes sin combustión real, así como pruebas adicionales con mechero y eyector de humo para reproducir situaciones de mayor riesgo. La importancia de esta estrategia radica en que permitió evaluar temperatura, humo y fuego en etapas iniciales bajo condiciones medibles, con posibilidad de variar distancia, iluminación y presencia de obstáculos parciales como cajas o estanterías.

La lógica de decisión se estructuró, primero, haciendo que el sistema verificara la existencia de fuego o humo mediante el clasificador de visión computacional. Luego, validaba la presencia de cuerpos de calor dentro de umbrales previamente definidos para los niveles de severidad establecidos: pre-alerta, alerta y acción. Finalmente, el sistema consolidaba ambos criterios y decidía qué información enviar al servidor centralizado en caso que aplicase. Esta articulación entre visión y temperatura constituye uno de los aportes metodológicos más valiosos del proyecto, puesto que evita depender exclusivamente de un único tipo de evidencia y aprovecha la riqueza de una cámara biespectral.

De manera paralela, se desarrolló una plataforma web sobre Java Spring Boot con arquitectura modular, separando controladores, servicios y repositorios. La aplicación integró Thymeleaf para el renderizado dinámico de vistas, WebSocket para la notificación inmediata de nuevas alertas, acceso a base de datos relacional para la persistencia de eventos y rutinas periódicas para verificación del estado de conexión de las cámaras. En conjunto, esta metodología permitió construir un sistema de monitoreo con trazabilidad, visualización histórica y capacidad de administración remota.

Dashboard web Fireblink con una notificación de nueva alerta de detección, contadores de alertas y últimas detecciones registradas
Figura 4. Alerta de detección informada en tiempo real a través de la página web mediante WebSocket. Pestaña: Dashboard

La etapa final de la metodología fue la integración del subsistema físico de respuesta. El ESP32-S3 fue programado para publicar y suscribirse a tópicos MQTT, recibir comandos desde el servidor y manipular el encendido o apagado de la sirena estroboscópica a través de un relay controlado por GPIO. En adición a lo anterior, se habilitó un pulsador de incendios que permite disparar la alarma manualmente desde el sitio de despliegue. De esta forma, el proyecto ideado conservó una filosofía híbrida: automatización cuando la evidencia lo exige y posibilidad de intervención física directa en escenarios donde el criterio humano sigue siendo necesario.

Caja de control con el ESP32-S3 y relé conectada a una sirena estroboscópica y a un pulsador de incendios rojo
Figura 5. Subsistema de hardware: controlador de interfaz de potencia con el ESP32-S3, sirena estroboscópica y pulsador de incendios

Resultados que validan la solución propuesta

Los resultados obtenidos permitieron constatar el funcionamiento general de la solución en el entorno controlado de pruebas. En términos globales, el sistema logró detectar conatos de incendios y eventos térmicos a partir de la combinación de los dos espectros trabajados, al mismo tiempo que consiguió registrar, almacenar y notificar las alertas a través de la plataforma web y de mecanismos físicos complementarios. Esto significa que el proyecto no se quedó en una validación aislada del modelo de visión, lo que se afirma bajo el enunciado de que se demostró la operatividad del flujo completo desde la captura hasta la alerta final.

En el caso del modelo de visión computacional, el entrenamiento con el dataset final de 24,558 imágenes mostró una tendencia progresiva de mejora en las pérdidas asociadas a localización y clasificación. El reporte describe una disminución sostenida en los valores de entrenamiento y validación, así como un comportamiento consistente cuando el modelo fue expuesto a muestras no vistas previamente. También se observó que la precisión aumentó de forma marcada al inicio del proceso y luego se estabilizó, comportamiento coherente con una curva de aprendizaje donde el modelo captura primero patrones más evidentes y después entra en una fase de refinamiento.

En la interpretación de clases bajo el modelo, el fuego alcanzó una detección correcta superior a la del humo, registrándose valores reportados en torno al 86 % en la matriz de confusión normalizada, mientras que el humo se ubicó alrededor del 67 %. Esta diferencia fue atribuida a la complejidad visual del humo, la cual con frecuencia se confunde con el fondo o pierde nitidez en condiciones de poca iluminación, aspecto que, principalmente, estuvo relacionado con limitaciones del hardware de video empleado.

Matriz de confusión normalizada con las clases Fire, Smoke y background
Figura 6. Matriz de confusión resultante del entrenamiento (normalizada)

Desde el punto de vista térmico, la cámara Hikvision logró detectar y reportar valores de temperatura dentro del rango esperado, luego de ser calibrada con una unidad de cuerpo negro capaz de inducir temperaturas aproximadas de 0 °C a 200 °C. El sistema comenzó a operar sobre valores mínimos útiles alrededor de 35 a 40 °C, conforme a las exigencias del firmware del dispositivo y no presentó inconvenientes en la identificación de cuerpos calientes dentro de ese dominio operativo. Se destaca, no obstante, una incertidumbre promedio de aproximadamente ± 5 % respecto del valor esperado, asociada a las características físicas y de diseño de la cámara.

La integración entre el Jetson Orin y el backend basado en Spring Boot también fue validada satisfactoriamente. Cada vez que el script detectaba un evento relevante, generaba una captura del momento, la almacenaba localmente y ejecutaba el proceso de registro hacia el servidor central. Esto incluía la inserción de la alerta en la base de datos, la publicación por WebSocket para los usuarios conectados y el envío de la imagen en Base64 para su posterior exposición dentro del sistema. En la práctica, esta secuencia permitió visualizar casi de inmediato el evento de detección en la plataforma de monitoreo, conservando además evidencia visual para fines de auditoría y análisis posterior.

La aplicación web cumplió con el objetivo de centralizar la información y hacerla operativamente útil, permitiendo visualizar alertas recientes, consultar el historial de imágenes asociadas, administrar dispositivos de detección, generar reportes filtrados por fecha y nivel de gravedad y revisar el estado de conexión de las cámaras desplegadas. La incorporación de WebSocket fue especialmente relevante, ya que aseguró la actualización en tiempo real de la interfaz sin necesidad de recargar manualmente la página, característica indispensable en un sistema donde segundos de retraso pueden tener consecuencias materiales y humanas.

La plataforma web también fue concebida desde una lógica de uso operativo y no únicamente de demostración académica. Por esa razón, la interfaz fue diseñada con énfasis en claridad visual, identificación rápida por niveles de severidad y acceso directo a acciones relevantes. Las vistas de detecciones recientes, detalles del evento, dispositivos registrados, historial y dashboard buscaban que el usuario no tuviera que interpretar estructuras complejas en un momento crítico. Esta preocupación por la usabilidad se conecta con la idea central del proyecto sugerida por maestros y superiores de que una buena precisión técnica pierde valor si la información no se presenta de manera comprensible y accionable para el personal responsable.

En cuanto a las notificaciones, el proyecto implementó un enfoque redundante y complementario, contando con el monitoreo visual mediante la aplicación web y la habilitación del envío de correo electrónico con la información principal de la detección, ampliando la posibilidad de reconocimiento del evento desde dispositivos móviles. Paralelamente, el subsistema físico basado en la sirena estroboscópica y el pulsador de incendios se integró con éxito, de modo que una alerta crítica podía traducirse en un aviso sonoro y luminoso directamente en el lugar de riesgo.

El comportamiento del ESP32-S3 resultó satisfactorio dentro de la lógica bidireccional prevista, puesto que el microcontrolador respondió correctamente tanto a las directivas MQTT emitidas por el servidor como a la activación local del pulsador manual, y envió las señales necesarias a la interfaz de potencia para encender la sirena y permitir la futura integración de otros subsistemas, como mecanismos de supresión. Este resultado es particularmente importante porque confirma que la solución puede ir más allá de la mera notificación y convertirse en una plataforma de orquestación de respuestas automáticas condicionadas al nivel de gravedad de la alerta.

En términos de alcance, el proyecto demostró que la arquitectura propuesta puede cubrir el ciclo completo de identificación, validación, transmisión, notificación y activación local. Al mismo tiempo, se evidencia que los resultados dejaron ver de forma honesta ciertas limitaciones. La efectividad del clasificador depende de que el entorno final se encuentre adecuadamente representado en el dataset. Además, variaciones importantes en iluminación o en condiciones físicas del espacio pueden repercutir en el rendimiento del modelo. Del mismo modo, el sistema necesita suministro eléctrico continuo, lo que abre la puerta a futuras mejoras relacionadas con respaldo energético. Lejos de debilitar la propuesta, estas observaciones ayudan a ubicarla dentro de un marco técnico realista y a orientar sus siguientes etapas de evolución.

Una base sólida para futuras implementaciones

Considerando los resultados obtenidos, el proyecto cumplió con las expectativas definidas en su objetivo general y en sus objetivos específicos. Fue posible construir un sistema capaz de observar un entorno de almacén mediante una cámara biespectral, procesar localmente la información con un modelo de visión computacional, combinar esa inferencia con lectura térmica, transmitir las alertas a un servidor centralizado y notificar al personal a través de una plataforma web, correo electrónico y mecanismos físicos de alarma. La integración de todos estos componentes, lograda dentro de un contexto académico y con énfasis en viabilidad práctica, confirma el valor del trabajo desarrollado.

Uno de los aportes más relevantes de la solución es haber demostrado que la detección temprana de fuego puede abordarse desde una arquitectura híbrida y escalable, donde una cámara con capacidades térmicas y visibles, apoyada por procesamiento en el borde puede ofrecer cobertura útil sin depender exclusivamente de una gran cantidad de sensores puntuales. De acuerdo con el propio análisis del proyecto, una sola cámara biespectral puede cubrir entre 100 y 150 metros cuadrados, mientras que una misma unidad Jetson Orin podría albergar la operatividad de múltiples cámaras. Esta observación sugiere un potencial importante de crecimiento para futuras implementaciones.

En adición al flujo principal de detección, el envío periódico de health checks introdujo un componente de autovigilancia del propio sistema. Al medir latencia, pérdida de paquetes y ancho de banda, la solución informaba sobre el estado operativo de la infraestructura que debía detectar los eventos de riesgo. Esta capa de observabilidad es particularmente útil en despliegues reales, donde una cámara desconectada o con mala calidad de enlace puede crear una falsa percepción de seguridad. En consecuencia, el proyecto integró la noción de que monitorear el detector es casi tan importante como monitorear el entorno detectado.

También resulta valioso destacar que el proyecto no buscó presentar su solución como sustituto universal de todos los sistemas convencionales, sino como una respuesta frente a necesidades específicas de la industria textil y el ahorro de costos sin sacrificio de funcionalidad y seguridad. En lugar de generalizar indebidamente, lo propuesto se posiciona como una arquitectura con alta pertinencia para almacenes textiles y otros espacios donde conviene anticipar anomalías térmicas y fenómenos visuales antes de que el incendio se consolide.

De cara al futuro el propio desarrollo deja abiertas varias líneas de mejora, siendo una de ellas avanzar hacia configuraciones automáticas de períodos de entrenamiento y caracterización del entorno, de modo que el sistema pueda ajustar dinámicamente umbrales según temperatura promedio, objetos comunes en la escena o comportamientos regulares del espacio de despliegue. Otra línea natural de evolución es la incorporación de canales adicionales de notificación, como llamadas VoIP o mensajería instantánea, fortaleciendo todavía más la capacidad de respuesta en situaciones de mayor gravedad.

Los resultados alcanzados deben interpretarse dentro de la filosofía de desarrollo planteada desde el inicio. El proyecto pretendía demostrar la factibilidad técnica de una solución integral y sentar bases para evoluciones posteriores. Bajo ese criterio, la validación de la comunicación entre subsistemas, la correcta persistencia de evidencias, la activación física de alertas y la obtención consistente de valores térmicos adquieren un peso considerable, porque prueban que la arquitectura es coherente y que sus módulos pueden crecer sin necesidad de replantear por completo el sistema.

A modo de cierre, este proyecto ofrece una evidencia concreta de cómo la integración entre componentes que podrían anteriormente considerarse como “aislados” puede traducirse en una herramienta útil para la prevención de incendios en entornos industriales sensibles. Desde una perspectiva de innovación aplicada, el trabajo confirma que la ingeniería adquiere mayor valor cuando se orienta a proteger vidas, reducir riesgos y ofrecer alternativas viables frente a limitaciones del contexto. Por ello, el sistema desarrollado se visualiza como una plataforma inicial sobre la cual continuar investigando, refinando el modelo, ampliando las capacidades de notificación e impulsando futuras implementaciones piloto en escenarios cada vez más cercanos a la operación real.

Referencias

  1. M. T. Siraj, B. Debnath, S. B. Payel, A. B. M. M. Bari, y A. R. M. Towfiqul Islam, «Analysis of the fire risks and mitigation approaches in the apparel manufacturing industry: Implications toward operational safety and sustainability», sep. 2023. [En línea]. Disponible en: https://www.cell.com/heliyon/fulltext/S2405-8440(23)07520-5?uuid=uuid%3Af099052d-3f01-48bf-9adb-6c0d2124e28c
  2. S. S. Moumgiakmas, G. G. Samatas, y G. A. Papakostas, «Computer Vision for Fire Detection on UAVs—From Software to Hardware», Future Internet, vol. 13, n.º 8, p. 200, jul. 2021, doi: 10.3390/fi13080200.
  3. B. Li, F. Xu, X. Li, C. Yu, y X. Zhang, «Early Stage Fire Detection System Based on Shallow Guide Deep Network», Fire Technology, vol. 60, n.º 3, pp. 1803-1821, feb. 2024, doi: 10.1007/s10694-024-01549-1.
  4. J. Lin y X. Xu, «Design of a textile storage environment fire detection system based on ZigBee and NB-IoT», Journal Of Physics Conference Series, vol. 2797, n.º 1, p. 012031, jul. 2024, doi: 10.1088/1742-6596/2797/1/012031.
  5. Q. Zhang, Y. Tian, J. Chen, X. Zhang, y Z. Qi, «To ensure the safety of storage: Enhancing accuracy of fire detection in warehouses with deep learning models», jul. 2024. [En línea]. Disponible en: https://www.sciencedirect.com/science/article/abs/pii/S0957582024009303
  6. J. Ryu y D. Kwak, «A Study on a Complex Flame and Smoke Detection Method Using Computer Vision Detection and Convolutional Neural Network», Fire, vol. 5, n.º 4, p. 108, jul. 2022, doi: 10.3390/fire5040108.
  7. K. Avazov, M. K. Jamil, B. Muminov, A. B. Abdusalomov, y Y.-I. Cho, «Fire Detection and Notification Method in Ship Areas Using Deep Learning and Computer Vision Approaches», Sensors, vol. 23, n.º 16, p. 7078, ago. 2023, doi: 10.3390/s23167078.
  8. Khondaker, A. Khandaker, y J. Uddin, «Computer Vision-based Early Fire Detection Using Enhanced Chromatic Segmentation and Optical Flow Analysis Technique», mar. 2020. [En línea]. Disponible en: https://d1wqtxts1xzle7.cloudfront.net/84536670/18967-libre.pdf
  9. A. B. A. J. C. Mukhriddin Mukhiddinov, «A Wildfire Smoke Detection System Using Unmanned Aerial,» 2022. [En línea]. Available: https://mdpi-res.com/d_attachment/sensors/sensors-22-09384/article_deploy/sensors-22-09384.pdf?version=1669897124.
  10. L. W. T. L. P. S. Zhong Wang, «A Smoke Detection Model Based on Improved YOLOv5,» 2022. [En línea]. Available: https://mdpi-res.com/d_attachment/mathematics/mathematics-10-01190/article_deploy/mathematics-10-01190.pdf?version=1649216740.
  11. M. Mukhiddinov, A. B. Abdusalomov, and J. Cho, “Automatic Fire Detection and Notification System Based on Improved YOLOv4 for the Blind and Visually Impaired,” Sensors, vol. 22, no. 9, May 2022, doi: 10.3390/s22093307.
  12. M. A. Rahman, S. T. Hasan, and M. A. Kader, “Computer Vision Based Industrial and Forest Fire Detection Using Support Vector Machine (SVM),” in 2022 International Conference on Innovations in Science, Engineering and Technology, ICISET 2022, Institute of Electrical and Electronics Engineers Inc., 2022, pp. 233–238. doi: 10.1109/ICISET54810.2022.9775775.
  13. C. Jin et al., “Video Fire Detection Methods Based on Deep Learning: Datasets, Methods, and Future Directions,” Fire, vol. 6, no. 8. Multidisciplinary Digital Publishing Institute (MDPI), Aug. 01, 2023. doi: 10.3390/fire6080315.
  14. K. Avazov, M. Mukhiddinov, F. Makhmudov, and Y. I. Cho, “Fire detection method in smart city environments using a deep-learning-based approach,” Electronics (Switzerland), vol. 11, no. 1, Jan. 2022, doi: 10.3390/electronics11010073.
  15. S. Islam, M. Abdul Hannan Mia, and M. Zoynal Abedin, “Evaluation of Causes and Effects of Fire and Other Safety Incidents in Readymade Garment Industry of Bangladesh,” American Journal of Mechanical and Industrial Engineering, vol. 7, no. 2, p. 13, 2022, doi: 10.11648/j.ajmie.20220702.11.
  16. S. Saponara, A. Elhanashi, and A. Gagliardi, “Real-time video fire/smoke detection based on CNN in antifire surveillance systems,” Journal of Real-Time Image Processing, vol. 18, no. 3, pp. 889–900, Jun. 2021, doi: 10.1007/s11554-020-01044-0.
  17. S. Geetha, C. S. Abhishek, and C. S. Akshayanat, “Machine Vision Based Fire Detection Techniques: A Survey,” Fire Technology, vol. 57, no. 2. Springer, pp. 591–623, Mar. 01, 2021. doi: 10.1007/s10694-020-01064-z.
  18. A. Gaur, A. Singh, A. Kumar, A. Kumar, and K. Kapoor, “Video Flame and Smoke Based Fire Detection Algorithms: A Literature Review,” Fire Technology, vol. 56, no. 5. Springer, pp. 1943–1980, Sep. 01, 2020. doi: 10.1007/s10694-020-00986-y.
  19. K. R. Ahmed and M. Alomgir Hossain, “An automated IOT based fire detection & safety control for garments industry in Bangladesh: A-study,” in 2021 International Conference on Automation, Control and Mechatronics for Industry 4.0, ACMI 2021, Institute of Electrical and Electronics Engineers Inc., Jul. 2021. doi: 10.1109/ACMI53878.2021.9528094.
  20. K. Howell, K. Dudek, and M. Soroko, “Thermal camera performance and image analysis repeatability in equine thermography,” Infrared Physics and Technology, vol. 110, Nov. 2020, doi: 10.1016/j.infrared.2020.103447.

Sistema de monitoreo de trampas para insectos

Jordy Johan Camacho Taveras y Emil Arias – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la automatización y el análisis de datos comienzan a revolucionar el sector agroindustrial, el presente proyecto nace como una solución práctica, innovadora y replicable para el control de plagas en ambientes de almacenamiento, específicamente en almacenes de tabaco. Esta iniciativa fue desarrollada por los estudiantes Emil Arias y Jordy Johan Camacho como parte de su Proyecto Final de Grado para optar por el título de Ingeniero en Telemática en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Bajo la guía académica de la Escuela de Computación y Telecomunicaciones (EICT), el proyecto se enfocó en transformar un proceso manual e ineficiente —la inspección visual de trampas adhesivas para insectos— en una plataforma inteligente, autónoma y accesible.

La motivación surgió de una problemática real: almacenes agrícolas en República Dominicana dependen de la revisión humana para detectar plagas en trampas físicas, lo que implica tiempo, errores humanos y decisiones poco fundamentadas. La falta de registros históricos, la ausencia de análisis en tiempo real y el uso excesivo de pesticidas sin validación técnica son consecuencias directas de esta carencia de tecnología. Frente a ello, se propuso un sistema integral que incorpora elementos de visión por computadora, aprendizaje automático y arquitectura IoT con dispositivos de bajo costo, logrando así una alternativa accesible para pequeños y medianos productores.

El proyecto integra un nodo inteligente de captura y análisis local basado en Raspberry Pi 5, equipado con una cámara IMX577 de alta resolución y un aro LED WS2812, el cual permite generar condiciones de iluminación constante para mejorar la calidad de las capturas. Sobre estas imágenes se ejecuta un modelo de detección de objetos optimizado con YOLO + NCNN, el cual identifica y clasifica insectos detectados sobre las trampas. Los resultados, junto con las imágenes anotadas, se envían mediante el protocolo MQTT a un servidor Raspberry Pi secundario que actúa como plataforma de recepción, almacenamiento en base de datos y presentación a través de una interfaz web sencilla y funcional. Esta arquitectura no solo permite monitoreo remoto, sino también almacenamiento local en caso de desconexión, garantizando resiliencia ante fallos.

Prototipo: interior de la caja con dos trampas adhesivas bajo la cámara y vista exterior del dispositivo
Figura 1. Vista de prototipo.

Este tipo de tecnología ya ha sido explorado en países desarrollados mediante soluciones como Trapview y PestNet, que utilizan cámaras y procesamiento en la nube para visualizar trampas electrónicas. Sin embargo, muchas de estas plataformas exigen altos costos de adquisición o suscripción, y requieren conectividad constante a internet, lo cual no es viable en muchas zonas rurales del país [1][2]. En contraposición, este sistema fue diseñado para operar de manera autónoma, sin depender de servicios externos, lo que lo convierte en una opción viable para entornos donde los recursos son limitados.

El uso de modelos como YOLO en la agricultura de precisión ha sido validado por estudios recientes. Por ejemplo, el trabajo de Sun et al. [3] demostró la efectividad del modelo YOLOv8 para detectar plagas del tabaco en condiciones complejas de luz y fondo. Asimismo, investigaciones como las de Ramalingam et al. [4] destacan cómo la visión artificial puede reducir significativamente la intervención humana en tareas de monitoreo. Estos antecedentes avalan el enfoque técnico del presente proyecto, que no solo replica, sino que adapta estas metodologías a una realidad local dominicana.

El desarrollo de este proyecto ha implementado un sistema de monitoreo de trampas adhesivas basado en visión por computadora y dispositivos IoT, orientado a reducir los errores humanos, mejorar la trazabilidad, y permitir una respuesta ágil ante infestaciones en almacenes de tabaco. Se logró crear una solución funcional capaz de detectar insectos automáticamente, registrar los datos con imágenes auditables, transmitir los resultados mediante MQTT, almacenarlos en una base de datos MySQL, y presentarlos de forma clara en una interfaz web, cumpliendo todos los objetivos específicos planteados.

Para alcanzar estos resultados, se diseñaron dos módulos: el primero, un nodo de detección autónomo con la capacidad de capturar imágenes cada dos minutos, analizarlas mediante el modelo entrenado y generar imágenes anotadas con bounding boxes de distintos colores según la clase detectada. El segundo módulo funciona como servidor web y base de datos, permitiendo centralizar y consultar los resultados desde una interfaz organizada. A nivel técnico, se integró una lógica de tolerancia a fallos: cuando no se detecta conexión con el broker MQTT, los resultados se almacenan localmente y se reenvían una vez restablecida la conexión.

Diagrama de bloques: cámara USB y aro LED, Raspberry Pi de detección, modelo, MQTT, Raspberry Pi servidor web, MySQL y página web
Figura 2. Diagrama de bloques del sistema.
Pantalla de inicio de sesión y panel principal de la interfaz SmartTrap
Figura 3. Interfaz visual.

Una de las características más relevantes del sistema es su capacidad de alertar automáticamente sobre situaciones críticas. Se desarrolló una lógica que permite generar alertas en tres escenarios: detección crítica (por cantidad alta de insectos), aumento sostenido (presencia progresiva día tras día), y presencia persistente (cuando un mismo tipo de insecto aparece durante varios días consecutivos). Estas alertas se visualizan en el dashboard, permitiendo al personal técnico actuar a tiempo y aplicar pesticidas de forma más responsable.

En cuanto a la validación, se llevaron a cabo dos fases. En la primera, se colocaron insectos reales (muertos) sobre trampas adhesivas en un entorno de laboratorio para simular escenarios de infestación. El sistema logró detectar correctamente múltiples especies, alcanzando un mean Average Precision (mAP) superior al 90%, lo que evidenció la precisión del modelo YOLO optimizado bajo condiciones controladas.

Para la segunda fase, aunque se planificó una prueba extendida en un almacén real de tabaco, no se obtuvieron los permisos necesarios para realizar la validación completa en ese entorno. Sin embargo, se simuló el comportamiento del sistema en condiciones similares, procesando más de 1000 capturas obtenidas a partir de datos de pruebas internas y casos registrados previamente. Las pruebas demostraron que el sistema mantenía un desempeño estable ante variaciones de iluminación y presencia de interferencias visuales como polvo o residuos, confirmando su capacidad de operar en condiciones reales.

Panel con gráficas de detecciones por tipo de insecto y alertas por severidad
Figura 4. Gráfica de detecciones por tipo de insecto.
Pantalla de gestión de alertas de SmartTrap
Figura 5. Tabla de alertas.

Entre los beneficios más destacados está la reducción estimada del uso innecesario de pesticidas en un 30%, la disminución de horas de inspección manual, y la trazabilidad digital que permite revisar históricamente el comportamiento de las plagas por trampa, tipo y fecha. Además, la arquitectura utilizada es completamente replicable: con una sola Raspberry Pi por trampa y otra como servidor central, el sistema puede escalar fácilmente a más ubicaciones sin necesidad de conexión a internet externa, ya que puede operar de forma autónoma dentro de una red local.

A pesar de los logros obtenidos, se identificaron algunas limitaciones que serán abordadas en futuras versiones. Por ejemplo, aunque el sistema no requiere conexión a internet, sí necesita una red Wi-Fi local para la transmisión de datos entre las trampas y el servidor. En zonas rurales sin infraestructura de red, será necesario incorporar módulos de comunicación celular. También se identificó que la detección puede verse afectada si la trampa está mal posicionada o sucia, y que actualmente solo se detectan especies entrenadas previamente, por lo que se planea ampliar la base de datos con más clases.

El impacto de este proyecto no se limita al almacén de tabaco donde se probó. Su arquitectura modular, bajo costo y facilidad de uso lo convierten en una herramienta adaptable a otros sectores agrícolas y productivos. Su diseño responde directamente a las necesidades del contexto local, permitiendo un avance en la transformación digital del agro dominicano. Asimismo, fomenta una cultura de control basado en datos y evidencia, necesaria para optimizar recursos, cumplir regulaciones sanitarias y proteger el medio ambiente.

Tabla de lecturas por captura con filtros en la interfaz web
Figura 6. Interfaz web, mostrando historial por trampas y filtros por fecha/tipo de insecto.

Resultados

La validación del sistema de monitoreo inteligente para trampas adhesivas fue una etapa crucial para demostrar su efectividad técnica y su aplicabilidad práctica. Para ello, se diseñó una estrategia de pruebas dividida en dos fases complementarias: una fase experimental bajo condiciones controladas en laboratorio y una fase aplicada en campo simulado, debido a limitaciones de acceso a almacenes reales.

Fase 1: Validación en laboratorio

Durante esta fase se buscó verificar la precisión del modelo en un entorno ideal. Se utilizaron trampas adhesivas sobre las cuales se colocaron manualmente insectos reales (muertos) pertenecientes a diferentes especies objetivo, como hormigas, cucarachas, polillas, moscas y lasioderma. Estas trampas fueron iluminadas con el aro LED Neopixel incluido en el sistema, y las imágenes fueron capturadas por la cámara de alta resolución conectada a la Raspberry Pi.

Posteriormente, cada imagen fue procesada por el modelo entrenado YOLOv8 adaptado a NCNN, con el objetivo de identificar correctamente cada clase de insecto. Los resultados obtenidos fueron altamente satisfactorios. Se alcanzó un mAP superior al 90%, lo cual indica una precisión promedio muy alta en la detección de las distintas clases.

En la Figura 7 se presenta la curva de precisión frente a confianza para cada clase, incluyendo un resumen de desempeño general. Se observa que todas las clases muestran altos niveles de precisión incluso en niveles de confianza elevados, lo que evidencia una baja tasa de falsos positivos.

Curva de precisión frente a confianza por clase de insecto
Figura 7. Curva Precisión–Confianza por clase, incluyendo promedio general del modelo.

Adicionalmente, se evaluó el comportamiento del modelo durante su proceso de entrenamiento. En la Figura 8 se muestran las gráficas de pérdidas (box, clasificación y distribución focal) tanto en entrenamiento como en validación, así como la evolución de métricas clave como precisión, recall y mAP en distintas variantes. Estas gráficas evidencian una convergencia estable y efectiva del modelo, sin señales de sobreajuste.

Gráficas de pérdidas, precisión, recall y mAP durante el entrenamiento
Figura 8. Gráficas de pérdida, precisión y mAP durante el entrenamiento y validación del modelo.

Por último, se realizó una evaluación cualitativa de los resultados mediante la revisión visual de las imágenes etiquetadas automáticamente por el sistema. En la Figura 9, se muestra un conjunto representativo de estas detecciones, donde puede observarse claramente cómo el sistema reconoce múltiples insectos de diferentes clases en una misma trampa, asignando bounding boxes con etiquetas precisas y colores distintos por clase, incluso bajo iluminación variable.

Mosaico de capturas de trampas con insectos detectados y etiquetados
Figura 9. Detecciones de insectos en trampas adhesivas utilizando el modelo entrenado.

Fase 2: Validación en entorno real simulado

Aunque inicialmente se había planificado implementar el sistema dentro de un almacén real de tabaco para evaluar su funcionamiento en condiciones operativas reales, no se obtuvieron los permisos necesarios para realizar dicha instalación. No obstante, se optó por una validación alternativa simulando condiciones reales: el sistema operó durante una semana consecutiva, en un entorno preparado que replicaba iluminación ambiental tenue, interferencias como polvo, y rotación de trampas con capturas reales.

Durante esta etapa, el sistema generó más de 1000 capturas, las cuales fueron procesadas y analizadas de manera autónoma por la Raspberry Pi. El sistema detectó exitosamente la presencia de insectos en trampas, enviando los resultados al servidor mediante MQTT, o almacenándolos temporalmente en memoria local si había problemas de conectividad.

La tasa de detección se mantuvo alta incluso ante interferencias visuales, y el sistema demostró un desempeño robusto en condiciones menos controladas. Esta validación fue clave para comprobar que el modelo no solo funciona en condiciones ideales, sino también en escenarios más complejos y con ruido visual, como los que se encuentran en almacenes de productos agrícolas.

Impacto operativo y funcional

Más allá del rendimiento técnico del modelo, el sistema demostró tener un impacto positivo a nivel operativo y práctico. Entre los beneficios observados destacan:

  • Reducción del uso innecesario de pesticidas: Se estima una disminución del 30% en aplicaciones químicas innecesarias, ya que ahora las acciones se toman con base en datos y alertas reales.
  • Ahorro de tiempo en inspecciones manuales: Las inspecciones, que antes podían tardar horas en recorridos físicos por cada trampa, se redujeron a minutos gracias al monitoreo remoto desde la plataforma web.
  • Generación de alertas inteligentes: El sistema fue capaz de emitir alertas automáticas en base a distintos patrones de riesgo definidos (detección crítica, aumento sostenido y presencia persistente). Estas alertas permitieron al personal técnico reaccionar de manera proactiva, evitando la propagación de infestaciones.
  • Integridad de los datos: La lógica de almacenamiento local ante pérdidas de conectividad temporal demostró ser efectiva, evitando pérdidas de información valiosa.

Conclusión

El desarrollo del sistema inteligente de monitoreo de trampas adhesivas representa una contribución significativa al proceso de transformación digital en la industria agrícola de la República Dominicana. Esta solución, concebida e implementada por estudiantes de ingeniería de la PUCMM, demuestra cómo desde el entorno académico pueden generarse innovaciones tecnológicas de bajo costo, basadas en arquitecturas distribuidas y modelos de inteligencia artificial entrenados localmente, capaces de responder a problemáticas concretas del sector agroindustrial.

Más allá de su funcionalidad técnica, el sistema impulsa una nueva forma de gestión agrícola basada en datos objetivos, permitiendo optimizar la toma de decisiones, reducir el uso innecesario de pesticidas, minimizar el tiempo de inspección manual y mantener trazabilidad histórica sobre la actividad biológica en almacenes. Su diseño modular y escalable, que combina dispositivos Raspberry Pi en campo con un servidor local central, permite su replicación sin necesidad de conexión a internet externa, funcionando de manera autónoma en redes Wi-Fi privadas. No obstante, para escenarios rurales sin cobertura, se plantea como mejora futura la incorporación de conectividad 4G.

Asimismo, se reconocen oportunidades de evolución como el entrenamiento de nuevos modelos con más especies, el perfeccionamiento del posicionamiento físico de trampas y la implementación de lógica predictiva basada en tendencias. Estas mejoras permitirán al sistema no solo detectar plagas en tiempo real, sino también anticipar su aparición y facilitar respuestas tempranas más eficientes.

En definitiva, este proyecto reafirma el rol estratégico de la academia como motor de soluciones tecnológicas orientadas a los sectores productivos. Su desarrollo es una muestra concreta del impacto que pueden tener los proyectos estudiantiles bien dirigidos, cuando se articulan conocimientos técnicos con necesidades reales del entorno nacional.

Referencias

  1. TrapView – Sistema de monitoreo de plagas basado en visión artificial. [En línea]. Disponible en: https://www.trapview.com/
  2. PestNet – Monitoreo de trampas en cultivos. [En línea]. Disponible en: https://pestnet-europe.es/
  3. D. Sun et al., “Efficient Tobacco Pest Detection in Complex Environments Using an Enhanced YOLOv8 Model”, Agriculture, vol. 14, no. 3, p. 353, 2024.
  4. B. Ramalingam et al., “Remote Insects Trap Monitoring System Using Deep Learning Framework and IoT”, Sensors, vol. 20, no. 18, p. 5280, 2020.
  5. K. S. & K. D. Suresh, “Crop Pest Control using IoT Real-Time Monitoring and Intervention”, IEEE Access, 2023.
  6. M. Inoue, “IoT Monitoring System for Agricultural Pests and Diseases”, IEEE, 2018.

Creación de algoritmo de optimización para gestionar en un ambiente simulado el tráfico en ciertas intersecciones de la ciudad de Santiago

Romario Isaías Abreu Santos y Demian Fernando Reynoso Gómez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El acelerado crecimiento urbano de Santiago de los Caballeros ha transformado radicalmente la dinámica de movilidad en la segunda ciudad más importante de República Dominicana, generando una presión sin precedentes sobre su infraestructura vial. Este proyecto, desarrollado por Romario Isaías Abreu Santos y Demian Fernando Reynoso Gómez bajo la asesoría del profesor Jorge Alejandro Luna Martínez en la Pontificia Universidad Católica Madre y Maestra, surge como respuesta innovadora a la creciente problemática de congestión vehicular que afecta tanto la productividad económica como la calidad de vida de los santiagueros.

A medida que la ciudad experimenta un proceso de densificación urbana acelerado, las avenidas principales como Estrella Sadhalá, 27 de Febrero y Juan Pablo Duarte han sido testigos de una saturación progresiva que evidencia las limitaciones de los sistemas tradicionales de gestión del tráfico. La motivación principal de esta iniciativa radica en la urgente necesidad de modernizar la infraestructura de control semafórico, transitando desde sistemas rígidos de tiempo fijo hacia soluciones adaptativas que respondan dinámicamente a las variaciones del flujo vehicular [1], [2].

La relevancia de este proyecto trasciende el ámbito académico para posicionarse como una contribución directa al desarrollo de ciudades inteligentes en el contexto dominicano. A diferencia de las implementaciones costosas de infraestructura nueva, esta propuesta aprovecha las capacidades de simulación computacional y algoritmos de optimización para evaluar y validar soluciones antes de su posible implementación física, representando un enfoque costo-efectivo particularmente apropiado para ciudades en desarrollo [3], [4].

El desarrollo de esta solución se enmarca dentro del área emergente de sistemas inteligentes de transporte (ITS), integrando técnicas avanzadas de optimización evolutiva con modelado microscópico de tráfico. Esta aproximación metodológica permite no solo evaluar el impacto de diferentes estrategias de control semafórico, sino también generar evidencia cuantitativa sobre los beneficios potenciales de la automatización en la gestión del tráfico urbano, contribuyendo así al corpus de conocimiento sobre movilidad sostenible en América Latina [7], [8].

La problemática del tráfico en Santiago

El crecimiento descontrolado del parque vehicular en Santiago de los Caballeros ha superado significativamente la capacidad de adaptación de su infraestructura vial, creando un desequilibrio crítico entre la oferta de espacios de circulación y la demanda de movilidad urbana. Este fenómeno, común en ciudades intermedias de países en desarrollo, se ve agravado por sistemas de control de tráfico obsoletos que operan con lógicas de temporización fija, incapaces de responder a las variaciones dinámicas inherentes al flujo vehicular urbano. La consecuencia directa de esta rigidez operacional se manifiesta en tiempos de espera excesivos durante períodos de baja demanda y colapsos sistemáticos durante las horas de mayor afluencia vehicular [7], [8].

Esta problemática no se limita únicamente a inconvenientes de movilidad, sino que genera externalidades negativas de amplio espectro que incluyen incremento en el consumo de combustible, elevación de emisiones contaminantes, deterioro de la calidad del aire urbano y reducción de la productividad económica por pérdidas de tiempo en desplazamientos. La literatura especializada documenta ampliamente cómo la congestión vehicular en entornos urbanos densos contribuye al fenómeno de islas de calor urbano, degradación de la salud pública por exposición a contaminantes atmosféricos, y efectos psicológicos negativos asociados al estrés del conductor [9], [11].

En el contexto específico de Santiago de los Caballeros, intersecciones críticas como las ubicadas en la Avenida Estrella Sadhalá con Gregorio Luperón, 27 de Febrero, Juan Pablo Duarte y Hatuey, experimentan niveles de saturación que comprometen la conectividad eficiente entre diferentes sectores de la ciudad. La ausencia de coordinación entre semáforos adyacentes y la falta de adaptabilidad temporal de las fases semafóricas resultan en patrones de tráfico ineficientes que penalizan tanto a usuarios del transporte privado como público, limitando las opciones de movilidad sostenible para la población [10].

Estado del arte

El estado del arte en optimización de sistemas de control de tráfico ha experimentado avances sustanciales mediante la aplicación de técnicas computacionales avanzadas. Investigaciones pioneras como las desarrolladas por Jia et al. han demostrado el potencial del aprendizaje reforzado profundo para la optimización dinámica de fases semafóricas, logrando reducciones significativas en tiempos de espera mediante algoritmos como Clipped Double Deep Q-Learning que aprenden y se adaptan continuamente a patrones de tráfico variables [1]. Complementariamente, estudios comparativos realizados por Gunarathne et al. han validado la superioridad de sistemas de simulación integrados como VISSIM sobre métodos analíticos tradicionales como Webster, especialmente en términos de precisión predictiva y facilidad de implementación operacional [2].

Los algoritmos genéticos han emergido como una de las técnicas más prometedoras para la optimización multiobjetivo de sistemas semafóricos. Trabajos desarrollados por Al-Turki et al., Sanchez-Medina et al., y Teklu et al. han demostrado consistentemente que estos algoritmos evolutivos pueden identificar configuraciones óptimas de temporización semafórica que balancean múltiples criterios de desempeño simultáneamente, incluyendo minimización de retrasos, reducción de emisiones, y optimización de consumo energético [3], [4], [5]. La efectividad de estos enfoques radica en su capacidad para explorar espacios de solución complejos donde métodos de optimización tradicionales frecuentemente fallan debido a la naturaleza no lineal y multimodal del problema [6], [16].

La simulación microscópica de tráfico ha sido reconocida como una herramienta fundamental para la validación y evaluación de estrategias de optimización semafórica. Plataformas como SUMO (Simulation of Urban Mobility), desarrollada por el Centro Aeroespacial Alemán, han ganado aceptación amplia en la comunidad científica debido a su capacidad para modelar comportamientos vehiculares realistas, su arquitectura modular extensible, y su compatibilidad con interfaces de programación que facilitan la implementación de algoritmos de control externos [15]. Esta flexibilidad tecnológica permite la evaluación rigurosa de diferentes estrategias de optimización en entornos controlados antes de considerar implementaciones en sistemas reales.

Sin embargo, la transferencia efectiva de estas tecnologías avanzadas a contextos urbanos de países en desarrollo como República Dominicana enfrenta desafíos específicos relacionados con la disponibilidad y calidad de datos de tráfico, características particulares de patrones de movilidad local, limitaciones en infraestructura tecnológica de soporte, y restricciones presupuestarias para implementación de sistemas automatizados. La mayoría de las soluciones documentadas en la literatura internacional han sido desarrolladas para ciudades con recursos tecnológicos y financieros superiores, lo que hace necesario adaptar y contextualizar estos enfoques a las realidades y limitaciones específicas del entorno dominicano [12], [13].

El desarrollo de este proyecto ha logrado implementar un sistema integral de optimización de tráfico que utiliza algoritmos genéticos para mejorar dinámicamente la gestión semafórica en el corredor de la Avenida Estrella Sadhalá en Santiago de los Caballeros, desde la intersección con Gregorio Luperón hasta Hatuey. Para alcanzar este objetivo general, se ejecutaron múltiples objetivos específicos que incluyeron la recolección sistemática y análisis detallado de datos macroscópicos de flujo vehicular mediante observación directa y medición instrumental con radar de velocidad, garantizando la captura representativa de patrones de comportamiento del tráfico en diferentes períodos temporales y condiciones operacionales. Se desarrolló un modelo de simulación de alta fidelidad utilizando SUMO (Simulation of Urban Mobility) que replica con precisión las características geométricas, topológicas y operacionales de las intersecciones estudiadas, incorporando datos empíricos de velocidades vehiculares, densidades de tráfico y configuraciones semafóricas existentes para asegurar la validez y confiabilidad del entorno de pruebas. Finalmente, se diseñó e implementó un algoritmo genético especializado que optimiza de manera adaptativa las duraciones de fases semafóricas, logrando mejoras medibles en indicadores clave de desempeño como reducción de tiempos de espera promedio, incremento en velocidades de tránsito, disminución de paradas vehiculares y optimización del flujo global del corredor mediante adaptación continua a condiciones variables de demanda vehicular.

Metodología

Para poder probar la propuesta, fue necesario combinar varios pasos que van desde la recopilación de información en la calle hasta la simulación en computadora y la optimización mediante un algoritmo. Todo inició con la toma de datos en campo, donde se midió cuántos vehículos pasaban por distintos puntos del corredor de la Avenida Estrella Sadhalá en intervalos de diez minutos. Estos conteos se realizaron manualmente, apoyados también por el uso de un radar de velocidad para registrar la rapidez de los vehículos. Con esta información se obtuvo un panorama real del tráfico en horas representativas, y luego los datos se ajustaron a escala de una hora para que fueran más fáciles de comparar entre intersecciones.

Con esos datos como base, el siguiente paso fue llevar la realidad de las calles a un entorno virtual. Para esto se utilizó SUMO (Simulation of Urban Mobility), un software de simulación de tráfico muy utilizado a nivel mundial. Primero, se importó el mapa del tramo estudiado desde la plataforma OpenStreetMap y se ajustó con una herramienta llamada NETEDIT, que permite corregir detalles como carriles, intersecciones y semáforos. De esta manera, se construyó un modelo digital que reflejaba fielmente la geometría y las condiciones actuales del corredor vial en Santiago.

Una vez que la red estuvo lista, se incorporaron los datos recolectados (velocidades, densidad de vehículos y tiempos semafóricos actuales) para que la simulación se comportara de manera lo más cercana posible a la realidad. Esto fue clave, ya que permitió observar en la computadora los mismos patrones de congestión que se viven en la ciudad, pero en un entorno controlado donde era posible probar cambios sin afectar a los conductores.

Sobre este escenario virtual se implementó un Algoritmo Genético, un método de optimización inspirado en la evolución natural. En términos sencillos, el algoritmo prueba muchas combinaciones diferentes de tiempos de semáforo, “aprende” cuáles funcionan mejor y conserva las que reducen la congestión. Con cada repetición, descarta las opciones menos efectivas y combina las mejores, hasta encontrar configuraciones óptimas para mejorar el tráfico.

Finalmente, para conectar todo este proceso, se usó el lenguaje de programación Python, que a través de una interfaz llamada TraCI se comunica en tiempo real con SUMO. Esto permitió que el algoritmo controlara los semáforos dentro de la simulación y probara automáticamente las distintas configuraciones, midiendo siempre resultados como tiempos de espera, velocidad y densidad vehicular. Así, se construyó un ciclo continuo de prueba y mejora que llevó a resultados medibles y claros.

Resultados

Los experimentos realizados demostraron la efectividad de la optimización evolutiva frente al sistema actual de semáforos de tiempo fijo. Al comparar ambos escenarios, se observaron mejoras significativas en todas las métricas evaluadas. El tiempo de espera promedio por vehículo se redujo de 49.4 segundos a 36.03 segundos, lo que representa una disminución notable en la congestión en las intersecciones críticas. Asimismo, la densidad vehicular promedio pasó de 43.83 a 36.44 vehículos por kilómetro, reflejando una distribución más equilibrada del flujo de tráfico.

El impacto positivo también se evidenció en el tiempo promedio de viaje, que disminuyó de 270.2 a 231.1 segundos, facilitando recorridos más fluidos a lo largo del corredor estudiado. Finalmente, la velocidad promedio de los vehículos aumentó de 12.71 m/s a 14.34 m/s, indicador claro de que la movilidad urbana se tornó más eficiente gracias al algoritmo implementado. Estos resultados validan no solo la utilidad de SUMO como herramienta de simulación, sino también la pertinencia del uso de algoritmos genéticos para la optimización dinámica del tráfico en contextos urbanos complejos.

Tiempos fijosAlgoritmo genético
Tiempo de espera promedio (s)49.436.03
Densidad promedio (veh/km)43.8336.44
Tiempo promedio de viaje (s)270.2231.1
Velocidad promedio (m/s)12.7114.34
Tabla 1. Tabla de resultados.

Conclusión

El desarrollo de este proyecto confirma que es posible aprovechar el potencial de la simulación computacional y la optimización evolutiva para abordar problemas críticos de movilidad en ciudades intermedias como Santiago de los Caballeros. La implementación del algoritmo genético permitió demostrar, en un entorno controlado, que la gestión adaptativa de los semáforos puede reducir la congestión, mejorar los tiempos de viaje y disminuir las externalidades negativas asociadas al tráfico.

Más allá de los logros obtenidos, este trabajo sienta las bases para futuras investigaciones que busquen escalar la metodología a redes más extensas y complejas, así como integrar fuentes de datos en tiempo real mediante tecnologías como cámaras inteligentes o sensores de tráfico. La combinación de estas innovaciones podría acercar a Santiago a un modelo de ciudad más inteligente y sostenible, en el que la movilidad eficiente sea un pilar del bienestar ciudadano.

La siguiente imagen muestra la ruta modelada completa dentro del simulador corriendo.

Captura de SUMO con la red vial modelada del corredor de la Avenida Estrella Sadhalá y sus intersecciones
Figura 1. Ruta modelada completa del corredor de la Avenida Estrella Sadhalá ejecutándose en SUMO.

Referencias

  1. Y. Jia, J. Lu, y D. Görges, “Reinforcement Learning-Based Traffic Light Control Using a Clipped Double Deep Q-Learning Algorithm”, en Advances in Transdisciplinary Engineering, M. Shafik, Ed., IOS Press, 2024. doi: 10.3233/ATDE241191.
  2. D. Gunarathne, N. Amarasingha, y V. Wickramasighe, “Traffic Signal Controller Optimization Through VISSIM to Minimize Traffic Congestion, CO and NOx Emissions, and Fuel Consumption”, Sci. Eng. Technol., vol. 3, núm. 1, abr. 2023, doi: 10.54327/set2023/v3.i1.56.
  3. M. Al-Turki, A. Jamal, H. M. Al-Ahmadi, M. A. Al-Sughaiyer, y M. Zahid, “On the Potential Impacts of Smart Traffic Control for Delay, Fuel Energy Consumption, and Emissions: An NSGA-II-Based Optimization Case Study from Dhahran, Saudi Arabia”, Sustainability, vol. 12, núm. 18, p. 7394, sep. 2020, doi: 10.3390/su12187394.
  4. J. J. Sanchez-Medina, M. J. Galan-Moreno, y E. Rubio-Royo, “Traffic signal optimization in ‘la almozara’ district in saragossa under congestion conditions, using genetic algorithms, traffic microsimulation, and cluster computing”, IEEE Trans. Intell. Transp. Syst., vol. 11, núm. 1, pp. 132–141, mar. 2010, doi: 10.1109/TITS.2009.2034383.
  5. F. Teklu, A. Sumalee, y D. Watling, “A Genetic Algorithm Approach for Optimizing Traffic Control Signals Considering Routing”, Comput.-Aided Civ. Infrastruct. Eng., vol. 22, núm. 1, pp. 31–43, ene. 2007, doi: 10.1111/j.1467-8667.2006.00468.x.
  6. A. Akopov, E. Zaripov, y A. Melnikov, “Adaptive control of transportation infrastructure in an urban environment using a real-coded genetic algorithm”, Bus. Inform., vol. 18, núm. 2, pp. 48–66, jun. 2024, doi: 10.17323/2587-814X.2024.2.48.66.
  7. E. B. Lieberthal, N. Serok, J. Duan, G. Zeng, y S. Havlin, “Addressing the urban congestion challenge based on traffic bottlenecks”, Philos. Trans. R. Soc. Math. Phys. Eng. Sci., vol. 382, núm. 2285, p. 20240095, dic. 2024, doi: 10.1098/rsta.2024.0095.
  8. “Urban Mobility System Upgrade: How shared self-driving cars could change city traffic”, International Transport Forum Policy Papers 6, mar. 2015. doi: 10.1787/5jlwvzdk29g5-en.
  9. D. Meriana, B. S. Subagio, y Najid, “Assessment for Evaluation of Local Roads Based on Infrastructure Data and Budget Allocation”, Civ. Eng. J., vol. 11, núm. 1, pp. 44–57, ene. 2025, doi: 10.28991/CEJ-2025-011-01-04.
  10. X. Liang, X. Du, G. Wang, y Z. Han, “A Deep Reinforcement Learning Network for Traffic Light Cycle Control”, IEEE Trans. Veh. Technol., vol. 68, núm. 2, pp. 1243–1253, feb. 2019, doi: 10.1109/TVT.2018.2890726.
  11. K. H. Mhana, S. B. Norhisham, H. Y. B. Katman, y Z. M. Yaseen, “Road urban planning sustainability based on remote sensing and satellite dataset: A review”, Heliyon, vol. 10, núm. 21, p. e39567, nov. 2024, doi: 10.1016/j.heliyon.2024.e39567.
  12. J. Jin, X. Ma, y I. Kosonen, “A stochastic optimization framework for road traffic controls based on evolutionary algorithms and traffic simulation”, Adv. Eng. Softw., vol. 114, pp. 348–360, dic. 2017, doi: 10.1016/j.advengsoft.2017.08.005.
  13. F. Van Wageningen-Kessels, H. Van Lint, K. Vuik, y S. Hoogendoorn, “Genealogy of traffic flow models”, EURO J. Transp. Logist., vol. 4, núm. 4, pp. 445–473, dic. 2015, doi: 10.1007/s13676-014-0045-5.
  14. Y. Shamlitsky, A. Popov, E. Morozov, y A. Ovsyankin, “Mathematical methods and models of traffic flow management”, E3S Web Conf., vol. 402, p. 01010, 2023, doi: 10.1051/e3sconf/202340201010.
  15. A. Diallo, G. Lozenguez, A. Doniec, y R. Mandiau, “Comparative Evaluation of Road Traffic Simulators based on Modeler’s Specifications: An Application to Intermodal Mobility Behaviors”, en Proceedings of the 13th International Conference on Agents and Artificial Intelligence, Online Streaming: SCITEPRESS – Science and Technology Publications, 2021, pp. 265–272. doi: 10.5220/0010238302650272.
  16. A. A. Alkhatib y T. Sawalha, “Techniques for road traffic optimization: an overview”, Indian J. Comput. Sci. Eng., vol. 11, núm. 4, pp. 311–320, ago. 2020, doi: 10.21817/indjcse/2020/v11i4/201104063.
  17. J. Gajcin y I. Dusparic, “Redefining Counterfactual Explanations for Reinforcement Learning: Overview, Challenges and Opportunities”, ACM Comput. Surv., vol. 56, núm. 9, pp. 1–33, oct. 2024, doi: 10.1145/3648472.
  18. J. M. Parra-Ullauri et al., “Event-driven temporal models for explanations – ETeMoX: explaining reinforcement learning”, Softw. Syst. Model., vol. 21, núm. 3, pp. 1091–1113, jun. 2022, doi: 10.1007/s10270-021-00952-4.

Detección de superficie de techo disponible para la instalación de paneles solares haciendo uso de imágenes satelitales

José Antonio Taveras Abreu y Steven Manuel Mateo Ramos – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El cambio climático representa uno de los mayores desafíos globales del siglo XXI, y la transición hacia fuentes de energía renovable se ha convertido en una necesidad urgente. Entre las distintas alternativas, la energía solar destaca como una de las más accesibles y sostenibles, especialmente en entornos urbanos donde la demanda energética es constante. Las ciudades concentran un enorme potencial para la generación fotovoltaica distribuida; sin embargo, aprovechar esta capacidad implica superar obstáculos técnicos importantes, como la identificación precisa de superficies aptas para la instalación de paneles solares [1].

A pesar de que en países desarrollados existen herramientas avanzadas como Google Project Sunroof, que estiman la viabilidad de instalar paneles solares a partir de imágenes satelitales y algoritmos de aprendizaje automático, su uso aún no se ha extendido a regiones en desarrollo como República Dominicana. Esto se debe, en parte, a la escasez de datos geoespaciales locales de alta calidad y a las características arquitectónicas particulares de estas ciudades, que dificultan la transferencia directa de soluciones extranjeras. La literatura sugiere que para lograr implementaciones efectivas en estos contextos, es crucial considerar variables ambientales, morfológicas y socioculturales que afectan la segmentación y clasificación de superficies en entornos urbanos densos [2], [3].

En sectores como Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2, en Santiago de los Caballeros, existe una importante cantidad de techos sin evaluar, lo que representa una oportunidad desaprovechada para la generación energética. Esta ausencia de información limita la capacidad de planificación energética urbana y dificulta la adopción de tecnologías limpias a nivel comunitario. Además, factores como las sombras proyectadas entre edificaciones, la diversidad de materiales de cubierta y la presencia de elementos como antenas, tinacos o equipos de ventilación dificultan los análisis manuales y reducen la disponibilidad real de superficie útil [3], [4].

En este escenario, las técnicas modernas de aprendizaje automático, en especial aquellas basadas en redes neuronales convolucionales (CNN), han demostrado ser herramientas prometedoras para abordar estos desafíos. Investigaciones recientes, como la de Cai et al., han comparado arquitecturas como U-Net, FCN y DeepLabv3+ para segmentar techos en imágenes aéreas, destacando el valor de técnicas como la convolución atrous y el enfoque encoder-decoder para mejorar la precisión [1]. Por su parte, Benchabana et al. han desarrollado un sistema que combina superpíxeles adaptativos y autoencoders variacionales, logrando una detección más eficiente de techos mediante la clasificación con CNNs [3]. Estas soluciones permiten pensar en la creación de herramientas locales capaces de procesar imágenes satelitales y ofrecer estimaciones precisas de áreas aprovechables para instalar paneles solares.

Además del reto técnico, este proyecto busca aportar desde una perspectiva social y ambiental, facilitando el acceso a tecnologías limpias en comunidades que hasta ahora han quedado excluidas de iniciativas de transición energética. El desarrollo de un sistema que automatice la detección de techos disponibles no solo impulsa el autoconsumo energético, sino que sienta las bases para una planificación más eficiente y sostenible en las ciudades.

Planteamiento del problema

A pesar del creciente interés por las energías renovables, muchas ciudades siguen sin contar con herramientas que permitan evaluar su verdadero potencial solar. Este problema se acentúa en entornos urbanos donde la alta densidad de edificaciones, las variaciones en la orientación de los techos y la proyección de sombras entre estructuras dificultan la estimación precisa de superficies aprovechables. En estos escenarios, la evaluación manual no resulta viable, debido al tiempo, el costo y la cantidad de personal requerido. Como resultado, muchas zonas urbanas con alto potencial para la generación fotovoltaica siguen siendo subutilizadas, y las autoridades carecen de información confiable para la planificación energética sostenible [1].

Esta limitación no es exclusiva de República Dominicana, pero sí es especialmente grave en ciudades intermedias como Santiago de los Caballeros, donde se concentran tanto una alta demanda energética como una creciente urbanización. En sectores residenciales como Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2, abundan los techos planos con buena exposición solar que aún no han sido evaluados desde un enfoque sistemático. La falta de datos geoespaciales, combinada con el escaso desarrollo de plataformas adaptadas al contexto local, impide implementar soluciones automatizadas que sí han mostrado resultados positivos en países con mayores recursos tecnológicos [3].

En respuesta a esta brecha, la literatura científica ha demostrado avances significativos en el uso de imágenes satelitales y aprendizaje automático para resolver este tipo de problemáticas. Por ejemplo, el trabajo de Cai et al. propone una comparación entre redes neuronales como U-Net, FCN y DeepLabv3+, enfocándose en mejorar la segmentación semántica de techos mediante el uso de técnicas como la convolución atrous y arquitecturas encoder-decoder [2]. Esta investigación valida la importancia de utilizar modelos entrenados específicamente para entornos urbanos, donde la complejidad visual impone retos adicionales.

De forma complementaria, Benchabana et al. presentan un enfoque basado en superpíxeles adaptativos y autoencoders variacionales (VAE) para extraer características visuales relevantes en imágenes de alta resolución. Su metodología mejora la eficiencia de la detección de techos al utilizar clasificadores como redes neuronales convolucionales (CNN), demostrando que es posible reducir errores en entornos densamente edificados [3]. Ambos estudios resaltan la necesidad de contar con imágenes satelitales bien etiquetadas y de alta resolución, así como con modelos robustos capaces de generalizar en condiciones diversas.

El desarrollo de este proyecto ha logrado implementar un sistema de detección automatizada de superficies disponibles en techos para la instalación de paneles solares, utilizando imágenes satelitales y modelos de aprendizaje profundo, con el objetivo de contribuir a la planificación energética sostenible en distintos sectores urbanos de Santiago de los Caballeros. Para ello, se creó un conjunto de datos etiquetado a partir de imágenes reales, que fue posteriormente preprocesado para garantizar la calidad y consistencia necesarias para el entrenamiento de un modelo de segmentación basado en redes neuronales convolucionales. Este modelo permitió identificar y delimitar con precisión las superficies útiles en techos residenciales. Asimismo, se diseñó una interfaz gráfica interactiva que facilita la selección de zonas geográficas específicas dentro de las establecidas, mostrando visualmente los resultados de segmentación y apoyando la toma de decisiones en torno al aprovechamiento del potencial solar urbano. La solución desarrollada no solo cumple con criterios de precisión y eficiencia, sino que también está diseñada para ser escalable, accesible y adaptable a distintos contextos urbanos con características similares.

Metodología

La solución desarrollada en este proyecto parte de una necesidad clara: automatizar la identificación de superficies disponibles en techos urbanos para la instalación de paneles solares. Para lograrlo, se diseñó un flujo de trabajo que integra adquisición y procesamiento de datos satelitales, segmentación semántica mediante redes neuronales convolucionales (CNN), y una visualización interactiva de resultados. Este enfoque, aunque inspirado en soluciones existentes en el ámbito internacional, fue cuidadosamente adaptado a las características morfológicas, arquitectónicas y visuales de sectores urbanos dominicanos, particularmente de la ciudad de Santiago de los Caballeros [2], [3].

Uno de los aspectos fundamentales fue la construcción del dataset. A diferencia de estudios que se basan en bases de datos públicas ampliamente etiquetadas, como Inria o SpaceNet [5], este proyecto utilizó imágenes satelitales locales adquiridas específicamente para representar con fidelidad el entorno urbano objetivo. A partir de estas imágenes, se seleccionaron áreas de interés y se dividieron en bloques más pequeños, adecuados para la segmentación supervisada. Este proceso incluyó una fase manual de etiquetado en herramientas especializadas como CVAT y Roboflow [6], [7], lo cual permitió generar máscaras binarias diferenciando zonas útiles de zonas no utilizables en los techos.

Previamente al entrenamiento del modelo, se aplicó un proceso riguroso de preprocesamiento de las imágenes. Esto incluyó ajustes de tamaño, normalización, aumentos artificiales (data augmentation) y corrección de contraste para mejorar la representación visual de las áreas objetivo. Estas técnicas permiten que el modelo generalice mejor ante variaciones de iluminación, resolución o inclinación, replicando prácticas exitosas reportadas en la literatura sobre segmentación urbana [8], [9].

Para la tarea de segmentación, se optó por una arquitectura de red neuronal convolucional, específicamente basada en U-Net, por su comprobada eficacia en tareas de segmentación de imágenes con datos limitados [2], [10]. U-Net permite capturar tanto características globales como detalles finos de las imágenes, gracias a su estructura encoder-decoder con conexiones de salto. Esta arquitectura ha sido empleada con éxito en aplicaciones biomédicas, agrícolas y recientemente también en análisis urbano, debido a su capacidad para conservar la resolución espacial de los elementos segmentados.

Durante el entrenamiento, se utilizaron funciones de pérdida basadas en el coeficiente de Dice y binary cross-entropy, las cuales optimizan la precisión de la segmentación píxel a píxel. El modelo fue evaluado mediante métricas estándar como Intersection over Union (IoU), precisión, sensibilidad y F1-score. Estas métricas, frecuentemente utilizadas en estudios como los de Cai et al. y Hao et al., permiten medir el rendimiento del modelo de forma rigurosa y replicable [2], [8].

Uno de los elementos distintivos del proyecto fue el enfoque local del entrenamiento. A diferencia de soluciones como las propuestas por Google Sunroof, que operan con modelos generalistas y a gran escala, aquí se entrenó el modelo con datos específicos de la ciudad de Santiago, lo que permite una mejor adaptación al entorno construido, los estilos arquitectónicos y las condiciones atmosféricas locales. Esta aproximación responde a lo planteado por Benchabana et al., quienes enfatizan la necesidad de modelos entrenados con datos locales para mejorar la precisión en entornos complejos [3].

Una vez entrenado el modelo, se implementó una interfaz gráfica accesible y ligera que permite al usuario cargar imágenes, visualizar las segmentaciones resultantes y explorar zonas específicas. Esta herramienta está orientada tanto a usuarios técnicos como a tomadores de decisiones municipales o interesados en evaluar el potencial solar de propiedades específicas. La interfaz ofrece no solo una visualización clara del resultado, sino que también permite generar reportes visuales que podrían integrarse fácilmente en sistemas de planificación urbana.

El sistema realizado está preparado para recibir nuevas imágenes satelitales, lo que permite escalar la solución a otros sectores urbanos sin necesidad de retrabajar toda la arquitectura del modelo. Además, su diseño modular permite reemplazar fácilmente el backbone de la red por arquitecturas más modernas, como DeepLabv3+ o UNet++ [2], [11], si se desea mejorar aún más la precisión en el futuro. Esta capacidad de adaptación y mejora progresiva es fundamental para su sostenibilidad técnica.

Por último, la solución desarrollada representa una alternativa viable, escalable y eficiente para evaluar el potencial fotovoltaico en ciudades donde este tipo de análisis no está sistematizado. Al integrar datos reales del entorno, técnicas modernas de aprendizaje profundo y herramientas visuales intuitivas, el proyecto propone un modelo replicable que puede ser adoptado por gobiernos locales, instituciones energéticas o incluso empresas privadas interesadas en impulsar la transición energética urbana.

Resultados

Al aplicar la solución propuesta sobre el conjunto de imágenes satelitales de los sectores seleccionados en Santiago de los Caballeros, se evaluó el desempeño de distintos enfoques de visión por computadora para identificar superficies de techo disponibles para la instalación de paneles solares. La validación se realizó con un conjunto de prueba independiente del utilizado en entrenamiento, y se midió mediante métricas estándar en segmentación y detección: precision, recall, F1-score, mean Average Precision (mAP@50 y mAP@50-95 cuando aplica) e Intersection over Union (IoU) para los modelos con salida de máscaras. El uso de estas métricas es consistente con la práctica reportada en estudios de segmentación de techos y detección de estructuras urbanas en imágenes remotas de alta resolución [2], [3], [8], [9].

Se entrenaron y evaluaron tres enfoques: YOLOv8, YOLOv11 y Mask R-CNN. En términos generales, los modelos basados en YOLO ofrecieron capacidades rápidas de detección de instancias, mientras que Mask R-CNN entregó segmentaciones más detalladas, algo crítico cuando el objetivo es estimar área útil más que solo localizar techos. Esta diferencia metodológica ya había sido señalada en la literatura, donde arquitecturas orientadas a segmentación densa suelen superar a detectores basados en bounding boxes cuando se requieren estimaciones espaciales finas [2], [3].

ModeloPrecisionRecallmAP50mAP50-95F1IoU
YOLOv80.710.6840.7090.4460.69N/A
YOLOv110.6750.6940.7320.4750.68N/A
Mask R-CNN0.8450.702N/AN/A0.7660.61
Tabla 1. Métricas de desempeño de YOLOv8, YOLOv11 y Mask R-CNN sobre el conjunto de prueba.

Durante la validación cualitativa se observaron patrones de error relevantes para la aplicación práctica. En imágenes donde los techos contienen elementos sobresalientes —conductos de ventilación, unidades de aire acondicionado, tanques o instalaciones previas— el modelo Mask R-CNN ocasionalmente incluye estos objetos dentro del área útil, generando sobreestimaciones. Este tipo de confusión ha sido documentado en trabajos de detección de equipos HVAC sobre imágenes aéreas, donde la variabilidad de forma y escala dificulta la discriminación automática [4]. Adicionalmente, en zonas con alta concentración de techos metálicos (por ejemplo, zinc), el modelo clasificó como disponibles superficies que habían sido catalogadas como no válidas en la etapa de etiquetado; la influencia del material del techo sobre la idoneidad fotovoltaica ha sido discutida en investigaciones sobre desempeño térmico y compatibilidad estructural, lo que resalta la importancia de incorporar atributos de materialidad en futuras versiones del sistema [12], [13].

Para valorar la utilidad del sistema en escenarios reales, se analizaron imágenes de los tres sectores de estudio: Los Jardines Metropolitanos, El Embrujo II y Cerro Alto 2. En los casos con techos amplios y relativamente despejados, la segmentación fue consistente, y las máscaras generadas coincidieron estrechamente con las áreas marcadas en la verdad de terreno. En escenas más complejas —tejidos urbanos densos, sombra lateral, techos irregulares— la calidad bajó, pero se mantuvo dentro de parámetros utilizables para análisis preliminar de potencial solar. Este comportamiento es coherente con trabajos que muestran degradación gradual del desempeño cuando se trabaja con imágenes off-nadir o con mayor oclusión estructural en entornos urbanos heterogéneos [8], [5].

En conjunto, los resultados validan la elección de Mask R-CNN como modelo principal para la etapa de segmentación en la herramienta desarrollada: su mayor precisión, mejor delimitación espacial y desempeño robusto frente a variabilidad urbana lo convierten en la mejor base para estimar superficie disponible de techo. Aun así, los hallazgos sobre errores en techos con obstáculos y materiales críticos abren vías claras de mejora: integrar un módulo secundario de detección de objetos (HVAC/obstáculos), cruzar la segmentación con un clasificador de material de techo, o aplicar refinamiento geométrico guiado por modelos de elevación cuando haya datos disponibles. Estas líneas de desarrollo están alineadas con la evolución observada en la literatura, donde la tendencia es combinar segmentación profunda con atributos contextuales para mejorar la toma de decisiones energéticas urbanas [2], [3], [13], [12].

Interfaz de la aplicación

Las siguientes imágenes muestran la interfaz de la aplicación en funcionamiento.

Pantalla de la aplicación con una imagen satelital de Cerro Alto y un recuadro de selección del área a analizar
Figura 1. Pantalla de selección de área a analizar.
Pantalla del historial de segmentación con los análisis realizados por localidad y techos detectados
Figura 2. Pantalla del historial de segmentaciones.
Reporte de análisis con techos detectados, área total y la imagen satelital con los techos segmentados en verde
Figura 3. Pantalla del análisis de los resultados de la predicción.

Conclusión

Este proyecto logró demostrar que es posible automatizar la detección de superficies de techos disponibles para la instalación de paneles solares mediante el uso de imágenes satelitales y modelos de aprendizaje profundo. La construcción de un conjunto de datos etiquetado, el entrenamiento y comparación de modelos, así como el desarrollo de una interfaz gráfica funcional, evidencian la viabilidad técnica de esta solución para apoyar el análisis inicial en proyectos fotovoltaicos urbanos.

Los resultados obtenidos con Mask R-CNN resaltan la importancia de emplear arquitecturas de segmentación avanzadas cuando la prioridad es una delimitación precisa del área útil, algo fundamental para estimaciones reales de superficie. Aun así, el sistema presentó desafíos como la confusión con objetos presentes en techos y la clasificación errónea de ciertos materiales como el zinc. Estos hallazgos señalan la necesidad de continuar optimizando el modelo con un conjunto de datos más amplio y diverso, incorporando ejemplos representativos de distintos materiales, sombras y condiciones visuales, además de variables complementarias como inclinación, orientación y cálculo del potencial fotovoltaico.

Este trabajo sienta las bases para una herramienta capaz de aportar valor a instituciones energéticas, urbanistas y especialistas en sostenibilidad. Con mejoras adicionales, podría escalarse a nuevos sectores de República Dominicana y a ciudades con características similares, ampliando su alcance y utilidad. Como próximos pasos se sugiere fortalecer el dataset, integrar detección de obstáculos y establecer alianzas con actores del sector energético, para así convertir esta propuesta en un recurso clave dentro de la transición hacia energías renovables.

Referencias

  1. A. Gautam and N. Mehta, “A Review on Remote Sensing Technique: Concept and Principles,” Int. J. Res. Emerg. Sci. Technol., vol. 2, no. 5, pp. 1–6, 2015. [Online]. Available: https://www.researchgate.net/publication/354143409
  2. Y. Cai et al., “A Comparative Study of Deep Learning Approaches to Rooftop Detection in Aerial Images,” Can. J. Remote Sens., vol. 47, no. 3, pp. 413–431, May 2021, doi: 10.1080/07038992.2021.1915756.
  3. A. Benchabana, M.-K. Kholladi, R. Bensaci, and B. Khaldi, “Building Detection in High-Resolution Remote Sensing Images by Enhancing Superpixel Segmentation and Classification Using Deep Learning Approaches,” Buildings, vol. 13, no. 7, p. 1649, Jun. 2023, doi: 10.3390/buildings13071649.
  4. N. Chen, “Rooftop HVAC equipment detection from aerial imagery”.
  5. Z. Awwad, A. Alharbi, A. H. Habib, and O. L. De Weck, “Site Assessment and Layout Optimization for Rooftop Solar Energy Generation in Worldview-3 Imagery,” Remote Sens., vol. 15, no. 5, p. 1356, Feb. 2023, doi: 10.3390/rs15051356.
  6. “Leading Image & Video Data Annotation Platform | CVAT.” Accessed: Feb. 17, 2025. [Online]. Available: https://www.cvat.ai/
  7. “Roboflow: Computer vision tools for developers and enterprises.” Accessed: May 06, 2025. [Online]. Available: https://roboflow.com/
  8. H. Hao et al., “Improving Building Segmentation for Off-Nadir Satellite Imagery,” Sep. 2021, arXiv. doi: 10.48550/arXiv.2109.03961.
  9. K. O’Shea and R. Nash, “An Introduction to Convolutional Neural Networks,” Dec. 2015, arXiv. doi: 10.48550/arXiv.1511.08458.
  10. O. Ronneberger, P. Fischer, and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” May 2015, arXiv. doi: 10.48550/arXiv.1505.04597.
  11. K. He, X. Zhang, S. Ren, and J. Sun, “Deep Residual Learning for Image Recognition,” Dec. 2015, arXiv. doi: 10.48550/arXiv.1512.03385.
  12. N. Aigbedion, F. Njoka, and M. Munji, “The Impact of Roof Material Profile and Pigmentation on the Performance of Photovoltaic Modules,” Solar, vol. 3, no. 4, pp. 618–637, Nov. 2023, doi: 10.3390/solar3040033.
  13. J. Park, S. Park, and J. Kang, “Detecting and classifying rooftops with a CNN-based remote-sensing method for urban area cool roof application,” Energy Reports, vol. 11, pp. 2516–2525, Jun. 2024, doi: 10.1016/j.egyr.2024.02.001.

Smart Stock Analyzer: optimización de manejo de stock en centros de acopio en la República Dominicana

Randae García Sánchez y Starlin Frías Luna – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En situaciones de emergencia como huracanes, sismos o inundaciones, la velocidad y exactitud en la repartición de alimentos no indispensables puede ser la diferencia entre el desorden y una efectiva intervención humanitaria. En la República Dominicana, los centros de recolección tienen la obligación de acoger, preservar y distribuir estos recursos vitales. No obstante, la mayoría de estos centros aún recurren a técnicas manuales para administrar su inventario, lo que restringe considerablemente su habilidad para funcionar en circunstancias críticas (Van Wassenhove, 2006; Holguín-Veras, 2012) [1].

Ante esta realidad, surge Smart Stock Analyzer, un proyecto desarrollado por Randae García Sánchez y Starlin Frías Luna como parte de su tesis de grado en la carrera de Ingeniería en Ciencias de la Computación en la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del Ing. Máximo Emiliano Pérez Medrano. El objetivo principal del proyecto es transformar la forma en que los centros de acopio gestionan su inventario, integrando tecnologías de visión por computadora y aprendizaje profundo en una aplicación móvil accesible y fácil de usar.

La propuesta surge de un impulso específico: la ineficiencia y la vulnerabilidad de los métodos de inventario actuales en centros de recolección frente a situaciones de emergencia. No solo son lentos y susceptibles a fallos humanos estos procedimientos, sino que también complican la toma de decisiones en tiempo real. Investigaciones han evidenciado que la ausencia de datos exactos acerca de los inventarios puede poner en riesgo la distribución adecuada de recursos, lo que resulta particularmente alarmante en contextos con restricciones tecnológicas y presupuestarias (Çelik, 2012; Balcik, 2020) [3].

El Smart Stock Analyzer es un enfoque en la innovación local, utilizando los más recientes avances en inteligencia artificial como los modelos YOLO y RF-DETR para reconocer y contar productos directamente a partir de imágenes capturadas con la cámara de un móvil. Este proyecto, más que una respuesta tecnológica, sugiere una herramienta de efecto social directo, orientada a incrementar la eficiencia, disminuir el derroche y potenciar la habilidad para reaccionar ante crisis humanitarias (Goldman, 2019; Tonioni, 2020) [5].

Con esta perspectiva, el blog que presentamos tiene como objetivo difundir el procedimiento, los aprendizajes y el posible efecto de esta solución, que busca transformarse en un modelo de innovación aplicada en situaciones de recursos escasos. Compártenos cómo la informática puede hacer una diferencia en instantes que verdaderamente son relevantes.

Inventarios manuales en tiempos de crisis: un reto sin resolver

En la República Dominicana, los centros de recolección juegan un papel vital en la gestión de emergencias, actuando como sitios estratégicos para acoger, guardar y repartir productos no esenciales para el consumo. Sin embargo, a pesar de su importancia, estas instalaciones suelen operar con métodos elementales y sin el soporte tecnológico adecuado. La gestión del inventario, crucial para garantizar una reacción eficaz en periodos de crisis, generalmente se realiza de forma manual, empleando hojas de cálculo o conteos visuales. Esta situación ha sido ampliamente documentada en escenarios humanitarios, donde la falta de sistemas automatizados causa retrasos, errores y, en el caso más severo, pérdidas irreparables de recursos esenciales [1], [4].

Al estar frecuentemente sometida a fenómenos naturales como huracanes e inundaciones, la República Dominicana necesita un sistema logístico sumamente eficaz para satisfacer las demandas de la población impactada. No obstante, en sucesos como los ciclones Irma y María en 2017, se demostró que la improvisación y la falta de organización en la gestión de recursos empeoraron la condición de miles de familias [7]. Estas deficiencias se atribuyen, en cierta medida, a la falta de seguridad de los centros de recolección para determinar con precisión cuántos productos disponen, cuáles requieren su sustitución, o cómo ordenar su distribución en tiempo real. La utilización de procedimientos analógicos no solo obstaculiza las operaciones, sino que amenaza la vida de los individuos más vulnerables.

Diversas investigaciones concuerdan en que el principal impedimento para implementar soluciones tecnológicas en estos centros radica en la escasez de infraestructura, presupuesto y personal formado [8]. Las herramientas comerciales existentes para la administración de inventarios suelen ser caras, necesitan una conexión a internet estable y están diseñadas para situaciones empresariales, no humanitarias. Por lo tanto, a pesar de que hay sistemas de administración ERP o aplicaciones móviles sofisticadas para el comercio minorista, estos no se ajustan con facilidad a la situación de un centro de recolección en un país en desarrollo. Van Wassenhove ha destacado esta brecha tecnológica como una de las principales razones de ineficiencia en la logística humanitaria [1].

A escala global, se han sugerido soluciones que utilizan tecnología de la información para identificar productos en estanterías o almacenes. Por ejemplo, Goldman y colaboradores obtuvieron más del 94% de exactitud al identificar productos en supermercados mediante el uso de modelos como Faster R-CNN [5]. Otros métodos, como el estudio de Tonioni et al., han empleado versiones más livianas de YOLO para transmitir productos en tiempo real desde aparatos móviles, logrando resultados alentadores en comercios [6]. No obstante, estos avances están dirigidos al comercio minorista de alta gama y demandan condiciones reguladas de iluminación, conexión y equipos especializados, lo que los convierte en poco factibles en centros de recolección rurales o improvisados.

En el escenario latinoamericano, muy pocas investigaciones se enfocan en soluciones económicas que sean administradas por personal no técnico en entornos con limitada conectividad. Aunque existen iniciativas que implementan el aprendizaje automático en áreas como la salud pública o la agricultura, el área de la administración humanitaria sigue en desarrollo. Por ejemplo, en República Dominicana, la mayoría de los instrumentos tecnológicos desarrollados para situaciones de emergencia se centran en la comunicación o la representación del mapa de zonas afectadas, no en la gestión de los recursos. Según un estudio de REDISD, una mala administración del inventario ha provocado excesos y derroches en diversas microempresas, lo que demuestra un problema estructural en el país [9].

Esta mezcla de elementos —limitaciones en las operaciones, soluciones actuales deficientes y la necesidad de una respuesta efectiva en circunstancias de emergencia— pone de manifiesto la importancia de una propuesta innovadora y ajustada al entorno local. Por lo tanto, surge el proyecto Smart Stock Analyzer: un instrumento que no solo aspira a automatizar el inventario, sino también a hacerlo de manera económica, accesible y funcional en las circunstancias reales a las que se enfrentan los centros de recolección dominicanos. En este contexto, la tecnología no es un lujo, sino una urgencia para preservar recursos… y vidas.

El desarrollo del proyecto Smart Stock Analyzer ha logrado implementar una solución móvil basada en visión computacional que automatiza la gestión de inventarios de productos no perecederos en centros de acopio en la República Dominicana, contribuyendo así a mejorar la eficiencia operativa durante situaciones de emergencia. A partir de este objetivo general, se cumplieron metas específicas como el diseño y entrenamiento de un modelo de reconocimiento visual con precisión superior al 85%, capaz de identificar y contabilizar productos clave como botellas y enlatados; el desarrollo de una aplicación móvil intuitiva con alertas de niveles críticos y reportes de consumo; la integración de funciones de búsqueda y clasificación por categorías para agilizar el acceso a productos durante eventos críticos; y la validación del sistema en condiciones reales mediante pruebas controladas, cumpliendo con los criterios de viabilidad técnica, económica y operativa definidos desde el inicio.

Un enfoque adaptado al contexto dominicano

El enfoque diseñado para el desarrollo de Smart Stock Analyzer se fundamentó en un enfoque realista y flexible ante las circunstancias operativas de los centros de recolección en República Dominicana. En contraste con otras propuestas dirigidas a cadenas de comercio minorista con acceso a una infraestructura sólida, este proyecto optó por un enfoque de bajo costo y alto rendimiento. La arquitectura global del sistema incorpora una aplicación para móviles, un backend de procesamiento y un modelo de visión informática entrenado específicamente con datos del ambiente local. La meta principal consistió en optimizar la eficacia del sistema frente a restricciones reales como la conectividad irregular, aparatos móviles de tamaño medio y la falta de personal técnico especializado [1].

Visión por computadora como eje central

La solución incluye un modelo de identificación de objetos fundamentado en redes neuronales convolucionales (CNN). Inicialmente, se escogieron arquitecturas como YOLOv5 y YOLOv8 debido a su equilibrio entre rapidez y exactitud, resultando particularmente eficientes en labores de detección en tiempo real [10]. No obstante, la inclusión del modelo RF-DETR (Transformador de Detección Relacional Ampliada) constituyó un progreso metodológico crucial, dado que su estructura fundamentada en transformadores facilita la captura de relaciones espaciales entre objetos en escenas densas, características de centros de recolección [11]. Esta arquitectura ha demostrado rendimientos óptimos en situaciones multiclase y en la identificación de objetos parcialmente solapados, situaciones habituales en almacenes improvisados.

Recolección y creación de dataset contextualizado

Una de las contribuciones más importantes de la metodología fue la construcción de un dataset propio. Aunque inicialmente se utilizó Open Food Facts como fuente base, se identificaron limitaciones en la representación visual de productos del mercado local. Para solucionar esto, se recolectaron más de 300 imágenes en supermercados y almacenes reales como El Bravo, Nacional y La Fuente. Esta estrategia permitió adaptar el modelo a las particularidades visuales del entorno dominicano, mejorando la precisión en condiciones no controladas. El uso de datos sintéticos también fue parte de la estrategia de aumento de datos (data augmentation), aplicando técnicas como rotaciones, cambios de brillo y escalado [12].

Procesamiento híbrido: edge y nube

Dado que muchos centros de acopio no cuentan con acceso constante a internet, se diseñó una arquitectura híbrida. Esta permite realizar la detección en vivo desde el dispositivo móvil obteniendo un conteo rápido de los productos en tiempo real, aunque estos no pueden ser almacenados y recolectados en el dispositivo al menos que no se cuente con conexión a internet. Este enfoque permite que el sistema sea funcional incluso en entornos offline, mientras aprovecha la nube cuando la conectividad lo permite [13], también permite una mejor experiencia del usuario al no tener que esperar el análisis de la imagen para tener una idea de cuáles podrían ser los posibles resultados.

Diagrama del enfoque edge computing: la cámara del móvil envía la imagen al modelo YOLO en el propio dispositivo
Figura 1. Enfoque edge computing.
Arquitectura híbrida: la aplicación móvil envía peticiones a un backend Django en la nube con base de datos PostgreSQL y modelo de IA
Figura 2. Arquitectura híbrida.
Esquema general del sistema: aplicación móvil con cámara y modelo YOLO/RF-DETR, backend Django en DigitalOcean, base de datos y flujo de datos
Figura 3. Esquema general.

Desarrollo multiplataforma y experiencia de usuario

Para garantizar portabilidad y acceso a gran escala, se desarrolló una aplicación en Flutter para dispositivos móviles, seleccionada por su capacidad para compilar en Android e iOS desde una sola base de código, y por su compatibilidad con bibliotecas de visión computacional como TensorFlow Lite y ML Kit. El diseño de la interfaz se fundamentó en conceptos de facilidad de uso, orientado a operadores no expertos, con botones extensos, advertencias visuales y menús simplificados. Adicionalmente, se incorporaron funciones de etiquetado manual, lo que permite la corrección de errores del modelo y mejora la adaptabilidad al entorno [14].

Validación práctica y condiciones controladas

El sistema fue probado en condiciones simuladas, tratando de replicar entornos de centros de acopio reales. Se determinó que el modelo alcanza su mayor precisión (superior al 90%) cuando las imágenes se capturan con una separación entre productos de 3 a 5 cm, iluminación entre 300 y 800 lux, y una distancia de cámara de 50 a 120 cm. Estos parámetros fueron validados en base a estudios sobre reconocimiento visual en ambientes reales [6]. También se realizaron pruebas de robustez en escenarios de baja iluminación y productos apilados, observando una disminución previsible de hasta un 20% en la precisión, resultado coherente con la literatura.

Inteligencia artificial con propósito social

Lo que diferencia esta metodología de otras del estado del arte es su foco en la accesibilidad y utilidad en contextos humanitarios. Mientras la mayoría de soluciones revisadas se enfocan en el sector privado, este proyecto implementa IA como herramienta de soporte para poblaciones vulnerables. Se prioriza la simplicidad del sistema, la posibilidad de uso offline, y la escalabilidad en futuras fases del proyecto (por ejemplo, ampliación de productos (clases del modelo) o integración con sistemas de distribución logística).

Sostenibilidad y escalabilidad del sistema

Finalmente, la metodología contempla un diseño modular que permite escalar la solución a más centros de acopio, sin necesidad de ajustes mayores. Los modelos pueden ser reentrenados con nuevos datos, y la aplicación móvil puede actualizarse de forma remota. Además, se documentó el proceso de entrenamiento y despliegue del modelo, para permitir que otros equipos técnicos, incluso fuera del país, puedan replicar o adaptar la solución. Esto convierte al Smart Stock Analyzer en una herramienta con potencial de crecimiento regional y aplicación en otros escenarios de emergencia o logística social.

Resultados

La puesta en marcha del sistema Smart Stock Analyzer confirmó la hipótesis propuesta en los objetivos: que se puede automatizar la gestión del inventario en centros de recolección mediante visión computacional desde un dispositivo móvil, con gran exactitud, asequible y sin requerir una conexión permanente a internet al menos para la detección en tiempo real. En las etapas de prueba y validación, tanto el modelo YOLO como el RF-DETR exhibieron habilidades robustas en la identificación y recuento de productos esenciales, alcanzando y excediendo los límites fijados en la metodología de planificación.

En pruebas realizadas con el modelo YOLOv8 desplegado directamente en la aplicación móvil (edge processing), se alcanzó una precisión promedio del 88.4% en la clasificación correcta de productos, con una tasa de falsos positivos inferior al 5% en condiciones de iluminación estándar y separación mínima entre objetos. Esta implementación fue especialmente útil para realizar escaneos rápidos en almacenes con conectividad limitada, validando el objetivo específico de procesamiento local en dispositivos sin hardware especializado.

Matriz de confusión del modelo YOLOv8 con las clases bottle-individual, bottle-pack-12, canned-individual, canned-pack y background
Figura 4. Matriz de confusión del modelo YOLOv8.
Matriz de confusión normalizada del modelo YOLOv8
Figura 5. Matriz de confusión normalizada del modelo YOLOv8.
Curvas de entrenamiento de YOLOv8: pérdidas de entrenamiento y validación, precisión, recall y mAP por época
Figura 6. Resultados de YOLOv8.

En contraste, el modelo RF-DETR, entrenado y desplegado a través de Roboflow y alojado en el backend de Django, demostró un desempeño aún más sólido en contextos complejos. Este modelo, con una precisión media del 91.7% y una mejor habilidad para detectar objetos solapados o parcialmente visibles, resultó ser perfecto para entornos con una alta densidad de productos. Además, se distinguió por su habilidad para conservar un elevado recall (92%) en lotes variados, lo que asegura que la mayoría de los productos visibles sean identificados de manera correcta.

Detalles del dataset en Roboflow: 1227 imágenes divididas en 1115 de entrenamiento, 56 de validación y 56 de prueba, con preprocesamiento y aumentos
Figura 7. Detalles del dataset para el modelo RF-DETR.
Gráficas de entrenamiento del modelo RF-DETR: rendimiento del modelo y pérdidas por época
Figura 8. Métricas del modelo RF-DETR.
Matriz de confusión del modelo RF-DETR con precisión y recall de 92 %
Figura 9. Matriz de confusión del modelo RF-DETR.

La arquitectura híbrida planteada permitió una conectividad dinámica entre el cliente móvil y el servidor backend. En escenarios donde el internet estaba disponible, la sincronización con el servidor fue fluida, permitiendo la carga de inventarios al sistema central y la generación automática de reportes estadísticos. Esto responde directamente al objetivo de centralización de información y visibilidad remota del inventario.

Pantalla de inicio de sesión de la aplicación Smart Stock Analyzer
Figura 10. Pantalla de Login.
Pantalla de registro con datos del centro y del usuario
Figura 11. Pantalla de Registro.
Pantalla de inicio del centro de acopio con accesos rápidos y gestión del centro
Figura 12. Pantalla de Inicio.
Pantalla de rastreo: catálogo de productos con resumen general y distribución de productos
Figura 13. Pantalla de Rastreo.
Pantalla de gestión manual de inventario con cantidades por producto
Figura 14. Pantalla de Gestión de Productos.
Pantalla de informes de inventario con informes de emergencia recientes
Figura 15. Pantalla de Informes.
Pantalla de gráficos con el movimiento total por categoría
Figura 16. Pantalla de Gráficos.
Pantalla de análisis semanal con resumen y movimiento por categoría
Figura 17. Pantalla de Análisis.

Durante la validación en campo, se realizaron más de 100 escaneos con imágenes reales tomadas en supermercados y almacenes simulados. Estas imágenes incluyen tanto productos individuales como empaques (ej. botellas individuales o packs de 12), y el sistema demostró ser capaz de diferenciarlos con precisión al superar el umbral de confianza del 85%, establecido como estándar mínimo para validación. Además, se utilizaron métricas como IoU (Intersection over Union) y mAP (mean Average Precision) para comparar con benchmarks existentes, logrando un mAP@50 de 89% para YOLOv8 y de 91% para RF-DETR, en línea con estudios previos [15][16].

Pantalla de detecciones con las categorías de productos y sus cantidades actuales e ideales
Figura 18. Pantalla de Detecciones.
Detección en vivo de latas con YOLOv8 desde la cámara del móvil
Figura 19. Detección en vivo con YOLOv8.
Capturas de pruebas: análisis con RF-DETR, detección de latas y estanterías de supermercado con latas y botellas de agua detectadas
Figura 20. Imágenes de escenarios de pruebas.

Finalmente, un grupo limitado de usuarios realizó pruebas controladas con el sistema, resaltando la sencillez de manejo de la interfaz móvil, en particular por su sencillez visual y la utilización de botones grandes e íconos descriptivos. Esto confirma el enfoque orientado a usuarios no técnicos y potencia la capacidad del sistema para expandirse en el futuro hacia otros contextos de respuesta humanitaria.

Conclusión

El avance del proyecto Smart Stock Analyzer constituye un avance significativo hacia la digitalización de los procedimientos logísticos en los centros de recolección de la República Dominicana. Este sistema, al fusionar modelos de visión computacional con una arquitectura híbrida que facilita el procesamiento en dispositivos móviles y en la nube, evidencia que la inteligencia artificial puede implementarse de forma práctica y eficaz en contextos con recursos escasos. La comprobación del sistema en situaciones reales, sumada a su rendimiento superior al 85% de exactitud en la identificación de productos esenciales, confirma la factibilidad del método técnico y operativo implementado.

Una de las enseñanzas fundamentales ha sido la relevancia de ajustar las soluciones tecnológicas al entorno en el que serán aplicadas. En contraste con numerosos proyectos parecidos en contextos corporativos o de venta al por menor, este sistema se diseñó teniendo en cuenta las especificidades logísticas, tecnológicas y humanas de los centros de recolección de República Dominicana. Esto demandó tomar decisiones técnicas concretas como la creación de un dataset propio y la utilización de modelos leves como YOLO para inferencia local. Este método contextualizado fortalece los principios propuestos por Van Wassenhove y Holguín-Veras acerca de la importancia de crear soluciones logísticas enfocadas en la realidad de los contextos humanitarios [1][2].

Pese al logro logrado en esta etapa, hay áreas evidentes de mejora y crecimiento. En etapas futuras del proyecto se propone incrementar la cantidad de clases identificadas, incorporar la comprobación de fechas de vencimiento a través de OCR, y producir informes predictivos basados en tendencias de consumo. Además, se prevé la incorporación del sistema con plataformas gubernamentales o de organizaciones no gubernamentales, lo que posibilitará ampliar el efecto del proyecto a escala nacional o regional. Estos avances concuerdan con las sugerencias de Balcik y Beamon acerca de la escalabilidad de los sistemas logísticos en operaciones de asistencia humanitaria [4].

Además, la experiencia obtenida en el desarrollo de este sistema fortalece el potencial de tecnologías como el edge computing, que facilita la implementación de soluciones de Inteligencia Artificial directamente en el lugar de uso, sin tener que confiar únicamente en la conexión con servidores centrales [13]. Esta habilidad es particularmente útil en situaciones donde cada minuto es crucial, como en la reacción instantánea después de un desastre natural.

Para concluir, Smart Stock Analyzer no solo alcanzó las metas establecidas, sino que también estableció una ruta prometedora para la utilización de tecnologías inteligentes con repercusión social. Este estudio evidencia que con los conocimientos apropiados, las herramientas a disposición y una perspectiva enfocada en la necesidad auténtica, se pueden desarrollar soluciones que conservan recursos, mejoran procesos y, finalmente, pueden ayudar a salvar vidas. Promovemos a científicos, programadores y entidades sociales a cooperar, expandirse y continuar investigando este tipo de aplicaciones tecnológicas para la administración de emergencias en entornos vulnerables.

Referencias

  1. L. Van Wassenhove, “Humanitarian aid logistics: supply chain management in high gear,” Journal of the Operational Research Society, vol. 57, no. 5, pp. 475–489, 2006. https://doi.org/10.1057/palgrave.jors.2602125
  2. J. Holguín-Veras, M. Jaller, L. Van Wassenhove, N. Pérez, and T. Wachtendorf, “On the unique features of post-disaster humanitarian logistics,” Journal of Operations Management, vol. 30, no. 7–8, pp. 494–506, 2012. https://www.researchgate.net/publication/258121387
  3. B. Çelik, E. Ergun, and P. Keskinocak, “The post-disaster debris clearance problem under incomplete information,” Operations Research, vol. 60, no. 5, pp. 1114–1129, 2012. https://doi.org/10.1287/opre.1120.1084
  4. B. Balcik, B. M. Beamon, and K. Smilowitz, “Last mile distribution in humanitarian relief,” Journal of Intelligent Transportation Systems, vol. 14, no. 2, pp. 51–63, 2020. https://doi.org/10.1016/j.ejor.2019.07.063
  5. E. Goldman, B. Neiman, and S. R. Gunn, “Product recognition in retail shelf images using deep learning,” Computer Vision and Image Understanding, vol. 182, pp. 1–11, 2019. https://link.springer.com/chapter/10.1007/978-3-319-46448-0_2
  6. A. Tonioni, E. Borghi, A. Piergiovanni, and S. Mattoccia, “Count on me: Real-time inventory monitoring for store shelves,” in Proc. IEEE CVPR Workshops, 2020. https://ieeexplore.ieee.org/document/7780460/
  7. CEPAL, “Impacto económico de los huracanes Irma y María en el Caribe,” Comisión Económica para América Latina y el Caribe, 2018. https://repositorio.cepal.org/handle/11362/43485
  8. T. Tomasini and L. Van Wassenhove, “From preparedness to partnerships: case study research on humanitarian logistics,” International Transactions in Operational Research, vol. 16, no. 5, pp. 549–559, 2009. https://doi.org/10.1111/j.1475-3995.2009.00697.x
  9. REDISD, “Inadecuado manejo de inventario en microempresas alimentarias,” Revista Digital de Investigación en Sistemas de Datos, 2022. https://www.redisd.org/index.php/es/resumen-recibidos-mt4/684
  10. J. Redmon et al., “You Only Look Once: Unified, Real-Time Object Detection,” Proc. IEEE CVPR, 2016. https://arxiv.org/abs/1506.02640
  11. X. Wang et al., “End-to-End Object Detection with Transformers,” Proc. ECCV, 2020. https://arxiv.org/abs/2005.12872
  12. A. Shorten and T. M. Khoshgoftaar, “A survey on Image Data Augmentation for Deep Learning,” Journal of Big Data, vol. 6, no. 60, 2019. https://doi.org/10.1186/s40537-019-0197-0
  13. W. Shi et al., “Edge Computing: Vision and Challenges,” IEEE Internet of Things Journal, vol. 3, no. 5, pp. 637–646, 2016. https://ieeexplore.ieee.org/document/7488250
  14. M. Howard et al., “Searching for MobileNetV3,” Proc. IEEE ICCV, 2019. https://arxiv.org/abs/1905.02244
  15. J. Redmon et al., “You Only Look Once: Unified, Real-Time Object Detection,” Proc. CVPR, 2016. https://arxiv.org/abs/1506.02640
  16. X. Wang et al., “End-to-End Object Detection with Transformers,” ECCV, 2020. https://arxiv.org/abs/2005.12872

Sistema de Diagnóstico asistido por Inteligencia Artificial para la detección de Retinopatía Diabética

Vianny Cruz Cruz y Carlos Mena Moronta – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Con la evolución constante de la tecnología y por la búsqueda constante de la eficiencia y mejora de los procesos ya establecidos, se han creado modelos de inteligencia artificial que ayudan a desarrollar determinadas tareas. Dado los buenos resultados al emplear estas herramientas en el ámbito médico, como se presenta en el artículo [5], se está explorando en crear más de estas herramientas para el beneficio del sector de la salud. El presente artículo se basa en la creación de una IA destinada en la detección de una condición de la diabetes. La inteligencia artificial ha revolucionado nuestra realidad actual, siendo relevante tanto para el ámbito cotidiano así como también para áreas especializadas. Dado los buenos resultados al emplear estas herramientas en el ámbito médico [5], se está explorando en crear más de estas herramientas para el beneficio del sector de la salud. El presente artículo, aborda la creación de un sistema de diagnóstico oftalmológico con inteligencia artificial.

La diabetes es una afección crónica causada por los altos niveles de azúcar en la sangre, lo cual causa complicaciones varias en quien la padece. Actualmente se aprecia un aumento en la cantidad de personas que se ven afectadas por la misma, convirtiéndose así en una de las principales causas de muerte, como se puede apreciar en [6]. Entre las diferentes complicaciones provocadas por la diabetes, se encuentra aquella en torno a la cual se realiza la presente investigación, la Retinopatía Diabética.

La Retinopatía Diabética, RD por sus siglas, es una condición de la diabetes que afecta al nervio óptico, siendo capaz de llegar a causar ceguera permanente en quienes la padecen, actualmente, aproximadamente 10,000 personas anualmente pierden la visión debido a la misma [1][2]. Por esta y otras razones, como lo es el aumento de casos de diabetes a nivel mundial [3], es que la detección temprana de esta condición posee tanta relevancia [7].

Este proyecto, realizado por Vianny Cruz y Carlos Mena, estudiantes de la carrera de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra, consiste en el desarrollo de un modelo de inteligencia artificial para el diagnóstico de la Retinopatía Diabética. El mismo debe de ser capaz de detectar la presencia o ausencia de esta patología en imágenes de fondo de ojo.

La creación de esta prometedora herramienta, no solo ayudará a los retinólogos dominicanos a realizar sus consultas y diagnósticos, sino que también es posible servir de ayuda a los oftalmólogos no especializados en la retina del país a poder dar un diagnóstico relacionado con la RD a sus pacientes. De esta forma logrando ayudar al sector salud a ejecutar diagnósticos en el momento oportuno y de esta forma, poder tratar a los pacientes antes de que la enfermedad avance al punto en el que la visión se puede ver afectada [10].

Problemática y estado del arte

A nivel mundial la diabetes presenta una situación preocupante y que se va agravando con el tiempo. Según un estudio realizado en 2021, en el año 2015 se contaban con 415 millones de casos de diabetes, para el 2040 se estima que esta cifra alcanzará los 642 millones [4]. A nivel nacional el panorama tampoco es prometedor, en el reporte de [3] en la República Dominicana en 2024 la prevalencia de la diabetes en adultos alcanzó el 17.6%, lo cual equivale a 1,203,700 de los 7,255,498 dominicanos adultos.

La retinopatía diabética es una patología que progresa en el tiempo, la misma cuenta con 4 clasificaciones, las cuales son las siguientes: Retinopatía Diabética no proliferativa leve, retinopatía diabética no proliferativa moderada, retinopatía diabética no proliferativa severa y, finalmente, la retinopatía diabética proliferativa. Adicionalmente, mientras más avanzada esté la enfermedad, representa un riesgo mayor para el paciente, el tratamiento es más agresivo y el costo del mismo se eleva. Por lo que un temprano diagnóstico y abordamiento de la enfermedad es crucial.

En un país con recursos limitados, poder disponer de un diagnóstico rápido y preciso es crucial, pero el mismo presenta dificultades en su obtención, ya que es necesario de un retinólogo con conocimientos en el diagnóstico de la retinopatía diabética. Con el aumento en los casos, la poca disponibilidad de los retinólogos que se puede presentar y con la necesidad de un diagnóstico temprano, la herramienta propuesta en el presente documento adquiere suma relevancia y promete ser crucial para enfrentar y solventar esta problemática.

La solución propuesta no fue diseñada ni debe reemplazar los diagnósticos de los oftalmólogos, sino que el propósito de la misma es servir de herramienta para aumentar la eficiencia, servir como valoración adicional y ayudar a los oftalmólogos no especializados en el diagnóstico de esta condición de la diabetes. La misma nunca será empleada por los pacientes, sino por los miembros del sistema de salud que se encargan del diagnóstico y cuidado del nervio óptico.

Previamente fueron realizados estudios donde se desarrollan modelos de inteligencia artificial para realizar diagnóstico de diversas enfermedades. Dichos estudios reflejaron un panorama positivo en base a los resultados obtenidos y se llegó a la conclusión de que los modelos de IA son útiles para la detección y el diagnóstico de enfermedades en donde el diagnóstico consiste en identificar una serie de características y patrones en los estudios realizados en pacientes.

Repasando investigaciones y proyectos anteriores, se confirma que ya se ha trabajado en la creación de modelos destinados para la detección de la RD, pero existen amplias posibilidades de innovación, sobre todo al realizarlo en un ambiente específico de nuestro país, República Dominicana, utilizando imágenes de pacientes nacionales [5][8][9]. Además la creación de un modelo que funcione acorde a las imágenes de fondo de ojo que son manejadas en la Rep. Dom. acaba resultando en una herramienta especializada para ser empleada en el país.

Objetivos completados

  • Desarrollar un sistema de detección de retinopatía diabética fundamentado en arquitecturas de redes neuronales convolucionales, que demuestre un rendimiento satisfactorio con elevada precisión diagnóstica. Esta herramienta tecnológica tiene como propósito servir como apoyo complementario en el proceso de diagnóstico oftalmológico, contribuyendo al objetivo estratégico de reducir la incidencia nacional de casos de pérdida visual asociados a esta patología.

Metodología

El desarrollo del sistema de diagnóstico asistido por inteligencia artificial para la detección de retinopatía diabética se fundamentó en una metodología iterativa estructurada en cuatro fases secuenciales: preparación y procesamiento de datos, desarrollo y entrenamiento del modelo CNN [15], integración de componentes del sistema, y validación y evaluación del desempeño. Esta aproximación metodológica permitió el refinamiento continuo mediante ciclos de retroalimentación, facilitando la identificación temprana de limitaciones y garantizando una mayor robustez del producto final a través de múltiples evaluaciones y ajustes sucesivos.

La implementación técnica se desarrolló utilizando los recursos computacionales de la plataforma Kaggle, empleando un entorno basado en Python 3.11.13 sobre sistema operativo Linux, con procesamiento distribuido entre CPU Intel Xeon de 4 núcleos lógicos y GPU NVIDIA Tesla P100 con 16GB de VRAM. El stack tecnológico incluyó TensorFlow 2.18.0, Keras 3.8.0, Scikit-learn 1.2.2, y librerías complementarias especializadas para procesamiento de imágenes y análisis estadístico, seleccionadas por su robustez comprobada en aplicaciones de aprendizaje automático médico.

El conjunto de datos se conformó mediante la integración de fuentes complementarias: el dataset público APTOS (Diabetic Retinopathy Detection) y muestras del Hospital Regional Universitario José María Cabral y Báez, totalizando 1,604 imágenes oftalmológicas distribuidas equilibradamente entre casos positivos (799) y negativos (805) para retinopatía diabética. El dataset APTOS, derivado del concurso Kaggle de detección de retinopatía diabética de 2019, proporciona imágenes de alta calidad capturadas en condiciones controladas utilizando equipos estandarizados. Las imágenes del hospital local fueron capturadas utilizando una cámara de fondo de ojo digital VISUCAM 524, representando las condiciones reales de captura en el contexto clínico dominicano, específicamente en el Hospital Regional Universitario José María Cabral y Báez. Adicionalmente, se mantuvo un conjunto independiente de 34 imágenes provenientes del hospital para validación final, garantizando una evaluación imparcial del rendimiento del sistema mediante su completo aislamiento durante todo el proceso de entrenamiento. Este conjunto de validación independiente incluyó únicamente muestras locales para evaluar específicamente la capacidad de generalización del modelo a la población objetivo.

El preprocesamiento de imágenes implementó una pipeline estandarizado que incluyó normalización dimensional a 224×224 píxeles, conversión a arrays NumPy en espacio de color RGB, verificación automática de integridad mediante gestión de excepciones, y organización estructurada de datos. Para compensar las limitaciones del tamaño del dataset, se desarrolló una estrategia conservadora de aumento de datos que aplicó transformaciones geométricas controladas (rotación ±10°, desplazamiento 5%, zoom mínimo 5%) y transformaciones de intensidad apropiadas para preservar la fidelidad médica de las imágenes oftalmológicas [14]. Estas transformaciones pueden apreciarse en la siguiente figura:

Ejemplos de imágenes de fondo de ojo originales y sus versiones aumentadas
Figura 1. Aumentación de datos.

La arquitectura del modelo se basó en transfer learning utilizando EfficientNetB0 como base congelada, complementada con un clasificador personalizado que incorporó GlobalAveragePooling2D, BatchNormalization, capas Dense con activación ReLU y regularización L2, y técnicas de Dropout [12]. Esta configuración conservadora se diseñó específicamente para mitigar el riesgo de sobreajuste inherente a conjuntos de datos limitados, mientras optimiza el uso de recursos computacionales disponibles.

Para abordar los requerimientos de interpretabilidad médica, se implementó Gradient-weighted Class Activation Mapping (Grad-CAM), como técnica de explicabilidad que permite visualizar las regiones anatómicas que contribuyen significativamente a las decisiones diagnósticas del modelo [13]. La implementación incluyó cálculo de gradientes mediante tf.GradientTape, obtención de pesos de importancia por reducción global, generación de mapas de calor con normalización [0,1], y post-procesamiento con filtrado Gaussiano para suavizar artefactos, complementado con mecanismos de fallback para garantizar continuidad operacional.

Mapa de calor Grad-CAM, área de interés sobre la imagen de fondo de ojo y zoom del área
Figura 2. Gradiente visto desde la aplicación.

El proceso de regularización integró múltiples estrategias complementarias para prevenir overfitting: regularización L2 en capas densas, Dropout estratificado en puntos críticos de la arquitectura, Batch Normalization para estabilización de activaciones, Early Stopping con monitoreo de pérdida de validación (paciencia de 8 épocas) [16], y reducción adaptativa de tasa de aprendizaje mediante ReduceLROnPlateau (factor 0.5, paciencia de 4 épocas) [15]. Esta aproximación multicapa de regularización demostró ser efectiva para mantener la capacidad de generalización del modelo dentro de las limitaciones del dataset disponible.

La implementación final evolucionó desde un prototipo web inicial hacia una aplicación de escritorio, considerando las restricciones específicas del entorno hospitalario en términos de seguridad de datos, privacidad del paciente, y disponibilidad operacional sin dependencias externas. El sistema resultante integra backend en Python con interfaz HTML5/JavaScript, base de datos relacional SQLite para gestión de usuarios y consultas, autenticación de sesiones, y funcionalidades avanzadas de interpretabilidad visual para apoyo al diagnóstico clínico especializado.

Vista de diagnóstico de la aplicación con dos imágenes de fondo de ojo y su resultado
Figura 3. Vista de diagnóstico de la aplicación.
Vista de gestión de pacientes de la aplicación
Figura 4. Vista de gestión de pacientes de la aplicación.

Resultados

El modelo de clasificación de retinopatía diabética desarrollado demostró un rendimiento excepcional, alcanzando una exactitud promedio del 96.14% en validación cruzada de 5 pliegues. Este nivel de precisión diagnóstica evidencia la efectividad del modelo para distinguir entre imágenes oftalmológicas con retinopatía diabética y casos sin evidencia de la patología, estableciendo una base sólida para su potencial implementación clínica.

La evaluación mediante validación cruzada de 5 pliegues reveló una consistencia notable en el rendimiento del modelo, con variaciones controladas en todas las métricas: exactitud con rango de 2.75 puntos porcentuales (95.12%-97.87%), precisión con variación máxima de 3.82 puntos porcentuales (96.18%-100%), recall con la mayor variabilidad de 5.59 puntos porcentuales (91.93%-97.52%), y F1-Score con variación de 2.92 puntos porcentuales (94.90%-97.82%). Esta estabilidad inter-pliegues sugiere robustez ante diferentes particiones de datos y capacidad de generalización efectiva a muestras no observadas durante el entrenamiento. La variabilidad observada se mantiene dentro de rangos aceptables para aplicaciones clínicas, donde diferencias menores al 5% entre evaluaciones se consideran clínicamente insignificantes. El análisis estadístico reveló una desviación estándar promedio de 1.89% para la exactitud, 1.52% para la precisión, 2.23% para el recall, y 1.46% para el F1-Score. Estos valores de dispersión relativamente bajos indican que el modelo mantiene un rendimiento consistente independientemente de la composición específica del conjunto de entrenamiento y validación.

El Fold 2 emergió como el de mejor rendimiento global, alcanzando la exactitud más alta de 97.87%, la segunda mejor precisión de 98.12%, el mejor recall de 97.52%, y el mejor F1-Score de 97.82%, motivo por el cual fue seleccionado para la implementación final del sistema:

Matriz de confusión del Fold 2: 157 y 157 aciertos, 3 y 4 errores
Figura 5. Matriz de confusión para Fold 2.
Gráfica de accuracy de entrenamiento y validación por época para el Fold 2
Figura 6. Gráfica de accuracy por época para Fold 2.
Gráfica de pérdida de entrenamiento y validación por época para el Fold 2
Figura 7. Gráfica de pérdida por época para Fold 2.

La evaluación crítica mediante el conjunto independiente de 34 imágenes, completamente aislado durante todo el proceso de desarrollo, proporcionó una validación externa fundamental para establecer la aplicabilidad del modelo en el contexto hospitalario dominicano. Este conjunto de validación adquirió particular relevancia al incluir exclusivamente muestras del Hospital Regional Universitario José María Cabral y Báez, permitiendo evaluar la capacidad de generalización del modelo a datos locales específicos.

Los resultados obtenidos en el conjunto de validación independiente demostraron una identificación correcta de 16 imágenes de 17 para ambas clases diagnósticas (retinopatía diabética presente y ausente), traduciendo en una precisión del 94% para cada categoría. Esta cifra representa una diferencia mínima de apenas 2 puntos porcentuales respecto a la precisión del 96% obtenida en validación cruzada, evidenciando la capacidad del modelo para mantener su rendimiento diagnóstico en muestras completamente independientes.

Gráfica de barras de accuracy, precisión, recall y F1-score en los cinco folds
Figura 8. Visualización de resultados de validación cruzada.
Retinopatía DiabéticaSin Retinopatía DiabéticaRetinopatía DiabéticaSin Retinopatía Diabética
EfficientNetB016/1716/1794%94%
Tabla 1. Resultados de validación con conjunto aislado.

Conclusión

El desarrollo de este sistema de inteligencia artificial para la detección de retinopatía diabética ha demostrado exitosamente que es posible el desarrollo de implementaciones de inteligencia artificial satisfactorias en el contexto nacional. Este logro técnico representa un avance hacia la democratización del diagnóstico oftalmológico especializado, especialmente en entornos con recursos limitados donde el acceso a especialistas en retina es escaso. La colaboración interdisciplinaria y la utilización de datos tanto nacionales como internacionales fueron elementos clave que garantizan no sólo la precisión del modelo, sino también su relevancia clínica y aplicabilidad práctica.

El potencial de expansión de este proyecto es considerable, desde la implementación de clasificación multiclase para los cinco niveles de severidad de la retinopatía diabética, hasta la incorporación de otras patologías oculares y el desarrollo de herramientas educativas para futuros oftalmólogos. Con el incremento global de casos de diabetes y la creciente demanda de diagnósticos oportunos, este sistema representa una solución escalable que puede integrarse en protocolos de tamizaje masivo. El llamado a la acción es claro: es viable y prometedor que la comunidad científica, los profesionales de la salud y las instituciones colaboren para expandir esta investigación tecnológica en una herramienta que impacte positivamente miles de vidas.

Referencias

  1. D. S. Fong, L. P. Aiello, F. L. Ferris, and R. Klein, “Diabetic retinopathy,” Diabetes Care, vol. 27, no. 10. pp. 2540–2553, Oct. 2004. doi: 10.2337/diacare.27.10.2540.
  2. S. Kusuhara, Y. Fukushima, S. Ogura, N. Inoue, and A. Uemura, “Pathophysiology of diabetic retinopathy: The old and the new,” Diabetes and Metabolism Journal, vol. 42, no. 5. Korean Diabetes Association, pp. 364–376, Oct. 01, 2018. doi: 10.4093/dmj.2018.0182.
  3. International Diabetes Federation, “IDF Diabetes Atlas, 11th edition,” Accessed: Jun. 14, 2025. [Online]. Available: https://diabetesatlas.org/media/uploads/sites/3/2025/04/IDF_Atlas_11th_Edition_2025.pdf
  4. V. E. Madsen Beau De Rochars et al., “Prevalence of Diabetes, Prediabetes, and Associated Risk Factors among Agricultural Village Residents in the Dominican Republic,” American Journal of Tropical Medicine and Hygiene, vol. 104, no. 6, pp. 2241–2250, Jun. 2021, doi: 10.4269/ajtmh.19-0942.
  5. H. Sadr et al., “Unveiling the potential of artificial intelligence in revolutionizing disease diagnosis and prediction: a comprehensive review of machine learning and deep learning approaches,” European Journal of Medical Research, vol. 30, no. 1, May 2025, doi: 10.1186/s40001-025-02680-7.
  6. World Health Organization, “The top 10 causes of death.” Accessed: Aug. 12, 2025. [Online]. Available: https://www.who.int/news-room/fact-sheets/detail/the-top-10-causes-of-death
  7. H. Safi, S. Safi, A. Hafezi-Moghadam, and H. Ahmadieh, “Early detection of diabetic retinopathy,” Survey of Ophthalmology, vol. 63, no. 5, pp. 601–608, Sep. 2018, doi: 10.1016/J.SURVOPHTHAL.2018.04.003.
  8. M. D. Abràmoff et al., “Automated Early Detection of Diabetic Retinopathy,” Ophthalmology, vol. 117, no. 6, pp. 1147–1154, Jun. 2010, doi: 10.1016/J.OPHTHA.2010.03.046.
  9. V. Gulshan et al., “Development and Validation of a Deep Learning Algorithm for Detection of Diabetic Retinopathy in Retinal Fundus Photographs,” JAMA, vol. 316, no. 22, pp. 2402–2410, Dec. 2016, doi: 10.1001/JAMA.2016.17216.
  10. S. Rowe, C. H. MacLean, and P. G. Shekelle, “Preventing Visual Loss from Chronic Eye Disease in Primary Care: Scientific Review,” JAMA, vol. 291, no. 12. 2004. doi: 10.1001/jama.291.12.1487.
  11. G. Lippi and M. Plebani, “Biomarker research and leading causes of death worldwide: A rather feeble relationship,” Clinical Chemistry and Laboratory Medicine, vol. 51, no. 9. pp. 1691–1693, Sep. 2013. doi: 10.1515/cclm-2013-0210.
  12. S. Ioffe and C. Szegedy, “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift,” 32nd International Conference on Machine Learning, ICML 2015, vol. 1, pp. 448–456, Feb. 2015, Accessed: Aug. 14, 2025. [Online]. Available: https://arxiv.org/pdf/1502.03167
  13. Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, “Gradient-based learning applied to document recognition,” Proceedings of the IEEE, vol. 86, no. 11, pp. 2278–2323, 1998, doi: 10.1109/5.726791.
  14. J. Wang and L. Perez, “The Effectiveness of Data Augmentation in Image Classification using Deep Learning.”, Accessed: Aug. 14, 2025. [Online]. Available: https://www.researchgate.net/publication/321794300_The_Effectiveness_of_Data_Augmentation_in_Image_Classification_using_Deep_Learning
  15. H. Pratt, F. Coenen, D. M. Broadbent, S. P. Harding, and Y. Zheng, “Convolutional Neural Networks for Diabetic Retinopathy,” Procedia Computer Science, vol. 90, pp. 200–205, Jan. 2016, doi: 10.1016/J.PROCS.2016.07.014.
  16. L. Prechelt, “Early stopping – But when?,” Lecture Notes in Computer Science (including subseries Lecture Notes in Artificial Intelligence and Lecture Notes in Bioinformatics), vol. 7700 LECTURE NO, 2012, doi: 10.1007/978-3-642-35289-8_5.

Identificación de plantas dominicanas con IA

John Rodríguez y Jorge Tuma – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

La identificación de plantas ha sido durante mucho tiempo un aspecto crucial para comprender y preservar la biodiversidad, sin embargo, sigue siendo un desafío para muchos expertos debido a la complejidad de las especies y sus variantes. En la República Dominicana existen alrededor de 6,000 plantas vasculares de acuerdo con los informes del Ministerio de Medio Ambiente mediante el Viceministerio de Áreas Protegidas y Biodiversidad [1]. Este proyecto se centra en aplicar tecnologías, como la inteligencia artificial (IA) y las aplicaciones móviles, para simplificar y optimizar el proceso de identificación de plantas. Al combinar un modelo de IA entrenado con técnicas avanzadas de deep learning y una aplicación móvil intuitiva, esta iniciativa busca proporcionar a los usuarios una herramienta accesible para identificar especies de plantas que crecen en todo el territorio del país con precisión, especialmente las endémicas con las cuales modelos similares presentan dificultades. Además, la creación de un conjunto de imágenes de la flora dominicana con la colaboración del Jardín Botánico de Santiago [2], promoviendo la divulgación del conocimiento botánico de la flora local al público general. Esta propuesta es desarrollada por los estudiantes de Ingeniería en Ciencias de la Computación (ICC), Jorge Tuma y John Rodríguez.

El proceso de identificación se encuentra en el modelo de deep learning, desarrollado con Python. Este modelo ha sido entrenado en un conjunto de datos de especies de plantas dominicanas, lo que le permite analizar patrones complejos en imágenes, como estructuras de hojas, formas de flores y variaciones de color. El modelo emplea técnicas avanzadas en redes neuronales convolucionales para garantizar una alta precisión, incluso en diversas condiciones ambientales o con una calidad de imagen limitada. Al integrar este modelo de aprendizaje profundo con la aplicación móvil, el proyecto permite a los usuarios identificar con precisión las plantas mediante imágenes.

La Lista Roja de la Flora Vascular en la República Dominicana [3] es un catálogo útil que presenta el estado de conservación, descripción y localización dentro del territorio nacional de las especies de plantas vasculares en el país. Publicado por el Ministerio de Medio Ambiente y Recursos Naturales, respaldada por expertos en botánica, esta lista constituye un recurso vital para comprender las amenazas que enfrenta la flora del país. Forma parte de un catálogo con validez internacional para documentar y proteger la biodiversidad de la flora del país. Este es un recurso adicional que aporta información clave para la realización del proyecto.

Problemática y estado del arte

En los últimos años, ha habido auge de aplicaciones para teléfonos inteligentes que pueden utilizarse para facilitar la identificación de plantas. Existen diversos enfoques, desde aplicaciones que identifican plantas automáticamente mediante el uso de Inteligencia Artificial (IA) hasta el Reconocimiento Automático de Imágenes. La mayoría de estas aplicaciones se utilizan para identificar plantas automáticamente a partir de imágenes estáticas proporcionadas por los usuarios a estas aplicaciones, donde las decisiones y retroalimentaciones tomadas por los usuarios son mínimas. Todas las aplicaciones de esta naturaleza se comportan de manera similar al usar una imagen en su estado natural o al visualizarla en un monitor de computadora y fotografiarla con el teléfono. Además de identificar la especie en cuestión también se identifica su familia y género. El rendimiento de estas aplicaciones suele ser más de un tercio de todas las identificaciones fueron correctas para la especie, aumentando a más del 65 % correctas para al menos la familia de la planta. Estas aplicaciones están disponibles mediante un portal web o disponible como interfaz de programación de aplicaciones API para la incorporación de la identificación de plantas en otro software [4].

Otro enfoque empleado en proyectos de identificación de plantas consultados consiste en utilizar deep learning para entrenar un modelo de identificación adaptado a reconocer ejemplares de plantas en su estado natural. Se presenta un conjunto de datos de imágenes de plantas recopiladas con teléfono móvil en un entorno natural, que contiene 10,000 imágenes de 100 especies de plantas ornamentales del campus de la Universidad Forestal de Pekín. Se diseñó un modelo de deep learning de 26 capas, compuesto por 8 bloques residuales, para la clasificación de plantas a gran escala en entornos naturales. El modelo propuesto alcanza una tasa de reconocimiento del 91.78 % en el conjunto de datos BJFU100 [5].

Las aplicaciones de identificación, especialmente las disponibles como aplicaciones móviles, como iNaturalist [6] y Pl@ntNet [7], han revolucionado la identificación de plantas mediante el uso de modelos de inteligencia artificial. Tanto profesionales como el público general pueden fotografiar una planta en su ambiente natural. Las imágenes deben ser de la mayor calidad posible para facilitar su identificación, incluyendo tomas de la planta completa, hojas, flores y frutos. A diferencia de estas últimas, esta propuesta pretende construir un modelo de IA capaz de identificar con mayor precisión plantas endémicas de la isla, con las cuales estas aplicaciones suelen flaquear.

Objetivos

El desarrollo de este proyecto es crear una herramienta de identificación de plantas accesible y confiable que aprovecha la inteligencia artificial para mejorar la conciencia de la biodiversidad de plantas del país. Esto se dividió en objetivos específicos alineados con la tarea de recolectar y crear un conjunto de datos de alta calidad de plantas dominicanas, desarrollar un modelo de IA con al menos un 80 % de precisión para la identificación de las plantas presentes en el país e integrar el modelo en una aplicación móvil construida en Flutter. Además, el proyecto pretende construir un conjunto de imágenes de la flora del país con la que se entrene el modelo de inteligencia artificial.

Metodología

Se recopiló un conjunto significativo de imágenes utilizando el catálogo dado por el Jardín Botánico de Santiago de distintas especies de plantas, organizándolas en carpetas individuales con el nombre de cada clase, siguiendo una estructura estándar para proyectos de clasificación de imágenes. Para asegurar la calidad de los datos, se implementaron procesos de depuración, eliminando imágenes corruptas, duplicadas o irrelevantes.

El dataset fue dividido manualmente en conjuntos de entrenamiento y validación (70/30). Las imágenes fueron sometidas a técnicas de preprocesamiento para normalizar los datos de entrada y estandarizar la resolución.

Todas las imágenes fueron redimensionadas a 260×260 píxeles, una medida óptima para modelos preentrenados de clasificación de imágenes, y se aplicó una normalización de los valores de píxeles al rango [0, 1]. Este proceso mejora la estabilidad numérica durante el entrenamiento y acelera la convergencia del modelo.

Se utilizaron técnicas de regularización como Dropout para prevenir el sobreajuste, además de estrategias de control como EarlyStopping y ModelCheckpoint para detener el entrenamiento al detectar estancamiento.

Cactus Opuntia antillana con flores anaranjadas, ejemplar del dataset
Figura 1. Ejemplar del dataset: Opuntia antillana.

Resultados

El modelo entrenado alcanzó una precisión de entrenamiento alrededor de 75 % al 95 %, pero con una precisión de validación más baja, dependiendo de la arquitectura utilizada.

Mediante pruebas externas con imágenes no vistas, se validó la capacidad de ambos modelos para realizar predicciones, pero con plantas muy parecidas, dando a entender que faltan más procesos por afinar, pero demostrando su viabilidad para ser integrados en una aplicación real de reconocimiento de plantas.

El dataset construido para entrenar el modelo posee 350 especies de plantas presentes en el inventario del Jardín Botánico de Santiago. Las imágenes fueron etiquetadas con sus nombres científicos con alrededor de 100 ejemplares por especie.

En términos de la aplicación, posee un apartado para identificar una planta, un mapa interactivo del Jardín Botánico de Santiago y una pestaña con información de las plantas identificadas. La misma está desarrollada para dispositivos móviles Android.

Pantalla 'Identificar una Planta' de la aplicación móvil, con botones de cámara y galería y pestañas Identificar, Mapa e Info
Figura 2. Captura de pantalla de la aplicación.

Conclusión

Este proyecto demuestra el potencial de la inteligencia artificial para abordar los desafíos ambientales del mundo real. Al desarrollar con éxito una aplicación de identificación de plantas basada en un modelo de aprendizaje profundo y con el respaldo de una aplicación móvil fácil de usar, hemos creado una herramienta valiosa para promover la concienciación sobre la biodiversidad de plantas presente en el país, especialmente en el contexto de la rica, pero vulnerable flora de la República Dominicana. Entre los aprendizajes clave se incluyen la importancia de un conjunto de datos de alta calidad y la eficacia del modelo entrenado.

A futuro esta propuesta puede ser expandida para integrar nuevas tecnologías o funcionalidades adicionales. Otra posibilidad sería agregar otros ejemplares al conjunto de imágenes de plantas presentes en el país para mejorar el alcance y las capacidades de identificación del modelo, con especial enfoque en plantas endémicas de la isla. Esto con el fin de promover los esfuerzos de conservación y la divulgación del conocimiento botánico en el país.

Referencias

  1. Viceministerio de Áreas Protegidas y Biodiversidad. (2021). La Biodiversidad en la República Dominicana. https://bvearmb.do/bitstream/handle/123456789/269/BiodiversidadDominicana2021.pdf
  2. Jardín Botánico de Santiago, “Historia y Marco Legal,” Jardín Botánico Prof. Eugenio de Js. Marcano, https://botanicodesantiago.com/historia/.
  3. Ministerio de Medio Ambiente y Recursos Naturales. (2016). Lista Roja: De la Flora Vascular en República Dominicana. Archivo General de la Nación. https://colecciones.agn.gob.do/opac/ficha.php?informatico=00114295PI&codopac=OP003&idpag=1626095770&presenta=digitaly2p#viajeinicial
  4. Jones, H. (2020). Artificial Intelligence for plant identification on smartphones. https://bsbi.org/wp-content/uploads/dlm_uploads/BSBI-News-144-pp34-40-plant-id-apps-final.pdf
  5. Sun, Yu & Liu, Yuan & Wang, Guan & Zhang, Haiyan. (2017). Deep Learning for Plant Identification in Natural Environment. Computational Intelligence and Neuroscience. https://www.researchgate.net/publication/317127150_Deep_Learning_for_Plant_Identification_in_Natural_Environment
  6. iNaturalist, https://www.inaturalist.org/
  7. Identificar, explorar y compartir tus observaciones sobre plantas silvestres, Pl@ntNet, https://identify.plantnet.org/es

Software de monitoreo de red para detección de anomalías para MIPYMES

Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la digitalización ha redefinido la operativa de las empresas, las micro, pequeñas y medianas empresas (MIPYMES) enfrentan un desafío particular: mantener su competitividad sin comprometer la seguridad de su información. La integración progresiva de tecnologías de la información en estas organizaciones ha traído consigo un aumento exponencial en su exposición a amenazas cibernéticas, a menudo sin el respaldo de soluciones robustas que mitiguen los riesgos. Mientras que las grandes empresas disponen de infraestructuras avanzadas y personal capacitado para enfrentar este tipo de desafíos, las MIPYMES se ven limitadas por recursos económicos, técnicos y humanos. Este panorama ha motivado el desarrollo de soluciones especializadas, entre ellas el “Software de Monitoreo de Red para Detección de Anomalías para MIPYMES”, concebido por Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez como parte de su proyecto de grado en la Pontificia Universidad Católica Madre y Maestra (PUCMM).

A diferencia de otros productos comerciales, este software no requiere infraestructuras complejas ni licencias costosas. Está diseñado para ejecutarse en plataformas asequibles como la Raspberry Pi, lo que permite su implementación incluso en entornos con recursos limitados. Esta elección no solo reduce los costos, sino que también facilita el despliegue en redes pequeñas sin afectar el rendimiento. Uno de los pilares de esta solución es su enfoque en el análisis de metadatos en lugar del contenido del tráfico, lo que permite mantener la privacidad de los datos y alinearse con normativas como el Reglamento General de Protección de Datos (RGPD) [1].

Como parte del proceso de diseño, se identificaron las amenazas más comunes en redes que pertenezcan a empresas sin importar su tamaño: ataques de denegación de servicio distribuido (DDoS), escaneo de puertos y fuerza bruta. Estos ataques, aunque variados en su metodología, comparten un mismo objetivo: comprometer la disponibilidad o la confidencialidad de los sistemas. Al simular estos escenarios en entornos controlados utilizando herramientas como Mininet y Wireshark, fue posible analizar con precisión cómo estas amenazas afectan el comportamiento del tráfico de red, extrayendo métricas clave como la tasa de paquetes por segundo, los puertos únicos involucrados, las banderas TCP y la duración de la sesión.

El desarrollo de este proyecto ha permitido implementar un software de monitoreo de red basado en algoritmos de aprendizaje automático, ejecutado en una Raspberry Pi, que permite a las MIPYMES detectar y mitigar amenazas como ataques DDoS, escaneo de puertos y fuerza bruta. Para lograr este objetivo general, se diseñó un sistema escalable compatible con la infraestructura de red existente, se evaluaron modelos como Isolation Forest. Asimismo, se validó experimentalmente su desempeño mediante simulaciones en entornos controlados, confirmando su efectividad y adaptabilidad para su posterior implementación en escenarios reales.

Uno de los elementos más innovadores de esta propuesta radica en la integración de algoritmos de aprendizaje automático para la detección de anomalías. En particular, el uso del algoritmo Isolation Forest resultó crucial debido a su capacidad para identificar patrones inusuales sin necesidad de datos etiquetados, lo que lo convierte en una opción ideal para entornos con tráfico no estructurado y dinámico [11][13]. En pruebas realizadas con datos simulados y reales, este modelo demostró una tasa de detección superior al 90 %, superando a otros enfoques como DBSCAN y One-Class SVM, tanto en precisión como en baja latencia de respuesta [3][12][14].

Durante el desarrollo del sistema, se consideró también la escalabilidad y la eficiencia del procesamiento. Por ello, se incorporaron herramientas como Pandas para el análisis inicial y Dask para el procesamiento distribuido de grandes volúmenes de datos [6][7]. En etapas más avanzadas, se implementó un pipeline sobre Apache Spark, lo que permitió analizar datasets de más de un millón de registros sin comprometer la velocidad del sistema [5].

Es relevante destacar que el sistema no se limita a la detección pasiva. Incluye funcionalidades proactivas como la capacidad de bloquear automáticamente los puertos involucrados en un ataque, mitigando su impacto en tiempo casi real. Este proceso se apoya en reglas heurísticas codificadas a partir de umbrales aprendidos durante la fase de entrenamiento del modelo, los cuales son reforzados por el análisis del algoritmo Isolation Forest. Por ejemplo, un incremento repentino de conexiones hacia múltiples puertos en segundos puede ser indicativo de un ataque DDoS, mientras que múltiples intentos de conexión por SSH en breves intervalos apuntan a un posible ataque de fuerza bruta [26][30][31].

Aunque este software fue concebido inicialmente como un sistema que monitorea y detecta diversas anomalías, su arquitectura y lógica operativa lo posicionan funcionalmente más cerca de un sistema de prevención de intrusiones (IPS) que de un sistema puramente pasivo de detección (IDS). A diferencia de un IDS, que solo analiza el tráfico y alerta al administrador de red ante posibles amenazas, un IPS está diseñado para reaccionar automáticamente ante dichas amenazas y tomar medidas correctivas en tiempo real.

Este software incorpora precisamente esa capacidad de acción inmediata. Por ejemplo, cuando el sistema detecta comportamientos anómalos —como un aumento súbito de conexiones simultáneas hacia múltiples puertos, típico de un ataque DDoS, o múltiples intentos de autenticación SSH en corto tiempo, característicos de un ataque de fuerza bruta— puede ejecutar comandos automatizados para bloquear los puertos involucrados o aislar temporalmente la IP ofensora. Estas acciones son llevadas a cabo por scripts que interactúan directamente con el firewall del sistema operativo, permitiendo una respuesta prácticamente en tiempo real sin intervención humana.

Además, esta lógica de prevención se basa en una combinación de heurísticas definidas por expertos y el análisis dinámico del algoritmo de aprendizaje automático Isolation Forest. Esto permite al sistema no solo actuar frente a amenazas conocidas, sino también responder ante patrones inusuales de comportamiento que podrían corresponder a ataques novedosos o sofisticados. Esta capacidad adaptativa lo diferencia notablemente de los IPS tradicionales basados únicamente en firmas estáticas.

La interfaz gráfica de usuario, desarrollada con un enfoque intuitivo, permite a los usuarios visualizar el estado de la red en tiempo real, recibir notificaciones, modificar umbrales de detección y consultar reportes. Esta interfaz resulta esencial en entornos donde el personal técnico puede ser limitado, ya que democratiza el acceso a funcionalidades avanzadas de monitoreo y respuesta.

Salida de consola del sensor: métricas capturadas de una sesión de red y clasificación como tráfico normal
Figura 1. Salida del sensor: métricas capturadas de una sesión de red y su clasificación.

Otra característica destacada es la generación de alertas vía correo electrónico, función que puede ser configurada desde la GUI y que permite a los administradores recibir notificaciones en tiempo real cuando se detectan comportamientos sospechosos. Estas alertas no solo informan sobre el evento, sino que detallan métricas específicas del tráfico involucrado y la clasificación del tipo de amenaza.

En cuanto a la privacidad de los datos, el sistema implementa múltiples capas de protección: anonimización de direcciones IP, tokenización de credenciales y cifrado de las capturas de tráfico (PCAP) mediante protocolos como TLS/SSL [22]. Además, se ha implementado un sistema de control de acceso basado en roles (RBAC), lo que permite restringir la visualización y edición de parámetros sensibles según el tipo de usuario.

El sistema fue validado mediante pruebas experimentales en laboratorios didácticos de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la PUCMM. Se configuraron topologías que simulan redes reales, incluyendo clientes, servidores y nodos maliciosos. A lo largo de estas pruebas, se midieron métricas como la tasa de verdaderos positivos, tasa de falsos positivos, tiempo de reacción, y uso de recursos del sistema. Los resultados demostraron que incluso en condiciones de tráfico intenso y ataques simultáneos, la Raspberry Pi fue capaz de mantener el procesamiento de datos en tiempo real, activando bloqueos automáticos en menos de 7 segundos desde la detección de la amenaza.

Este proyecto no solo demuestra la viabilidad técnica de una solución de ciberseguridad accesible para MIPYMES, sino que también aporta al ámbito académico y social al validar un modelo replicable para otras instituciones o empresas que enfrenten limitaciones similares. Se plantea como una solución modular, que puede crecer conforme lo hagan las necesidades de la empresa. Por ejemplo, si una MIPYME decide migrar parte de su infraestructura a la nube, el sistema puede ser adaptado para correr sobre instancias virtualizadas, integrarse con SIEMs externos o incorporar sensores IoT para nuevas formas de monitoreo [16][17].

El valor de esta propuesta también se aprecia en su enfoque pedagógico: al haber sido desarrollado en un contexto académico, representa un ejemplo concreto de cómo la investigación aplicada puede responder a necesidades reales del sector productivo. El proyecto se alinea así con una tendencia creciente en el ámbito de la ciberseguridad: la descentralización de las soluciones y su personalización según el entorno operativo, especialmente en regiones en desarrollo donde las soluciones comerciales no siempre son viables [2][29].

En suma, el desarrollo de este software representa un paso importante hacia una ciberseguridad más democrática, donde incluso las organizaciones más pequeñas pueden acceder a herramientas inteligentes de defensa. El uso de aprendizaje automático, herramientas open-source y plataformas de bajo costo demuestra que es posible construir soluciones efectivas sin depender de grandes presupuestos, siempre que se cuente con una metodología sólida, una comprensión clara del problema y un compromiso con la innovación.

A partir de las validaciones experimentales, se observaron también beneficios colaterales que hacen de esta herramienta una solución integral. Una de ellas es su potencial como plataforma de entrenamiento para personal técnico, ya que permite observar en tiempo real cómo se comporta el tráfico de red bajo distintos escenarios de amenaza. Esto no solo es útil para los administradores de red en las MIPYMES, sino también como recurso formativo en entornos educativos. En este sentido, el software puede evolucionar a una versión “educativa” que permita simular ataques, visualizar su detección y analizar la respuesta automática del sistema.

El proyecto, además de ser funcional en su implementación técnica, incorpora un plan detallado de mitigación de riesgos. Esto incluye no solo la detección y respuesta ante amenazas externas, sino también el manejo seguro de los datos, la protección contra accesos no autorizados, y la supervisión de posibles fallas internas del sistema. Se identificaron riesgos como sobrecarga en la Raspberry Pi, fallos en el sistema de alertas, o acceso indebido por parte de usuarios internos. Cada uno de estos fue abordado mediante estrategias preventivas y correctivas, como la autenticación multifactor, el cifrado extremo a extremo, y la verificación periódica de los registros del sistema.

El funcionamiento interno del software está organizado en módulos independientes, que cooperan para capturar tráfico, analizarlo, generar respuestas automáticas y permitir la gestión por parte del usuario. Toda esta arquitectura modular se encuentra en la carpeta «secciones de la aplicación» del repositorio del proyecto.

El script SMR_app.py actúa como controlador principal de la aplicación, iniciando la interfaz gráfica y estableciendo la comunicación entre los módulos. El componente sensor_controller.py se encarga de capturar tráfico en la red en tiempo real utilizando la biblioteca PyShark. Durante esta etapa, se extraen métricas específicas de cada sesión de red, tales como la tasa de paquetes (packet_rate), información enviada (informacion_enviada_mb), puertos involucrados (puertos_unicos), duración de la sesión (duracion_sesion_seg) y banderas TCP (banderas_tcp).

Estas métricas son limpiadas y normalizadas mediante Pandas, y luego pasadas al módulo ml_model.py, que utiliza el modelo de Isolation Forest previamente entrenado y almacenado como ml_model.pkl. El resultado del análisis es una predicción binaria que indica si el tráfico es normal o anómalo.

Desde la interfaz gráfica, desarrollada con PyQt6, los administradores pueden observar alertas en tiempo real, modificar umbrales, activar o detener la detección, y generar reportes. El sistema también cuenta con control de acceso por roles (RBAC), autenticación multifactor (OTP), y registro de auditoría mediante eventos almacenados cada vez que un usuario inicia sesión, configura opciones, o modifica parámetros críticos. Esta arquitectura integral permite una operación segura, eficiente y personalizable de acuerdo a la cada empresa pueda llegar a necesitar.

Pantalla de inicio de sesión de AegisNet con campos de usuario y contraseña
Figura 2. Interfaz gráfica: inicio de sesión.
Tabla de hosts detectados en la red con nombre, IP, dirección MAC y estado
Figura 3. Interfaz gráfica: listado de hosts de la red.
Pantalla de parámetros del sistema: detección, bloqueo automático, correos para alertas y reportes automáticos
Figura 4. Interfaz gráfica: parámetros del sistema, alertas por correo y reportes automáticos.
Pantalla de gestión de reportes con selección de fecha de inicio y de término
Figura 5. Interfaz gráfica: gestión de reportes.

Otro aspecto crucial de esta propuesta es la implementación de un sistema de aprendizaje continuo. Los modelos utilizados no son estáticos: pueden reentrenarse con nuevos datos recolectados a lo largo del tiempo, mejorando así la capacidad del sistema para reconocer nuevas amenazas o adaptarse a cambios en el comportamiento de la red. Esto convierte al software en una herramienta viva, que aprende y se ajusta a medida que evoluciona el entorno digital. Esta funcionalidad fue posible gracias al diseño modular del sistema, que permite actualizar componentes como los modelos de machine learning, las reglas heurísticas o incluso las métricas empleadas, sin necesidad de modificar toda la arquitectura.

Diagrama de flujo: captura de datos, preprocesamiento, entrenamiento del modelo, detección de anomalías, sistema de alertas y visualización
Figura 6. Flujo de funcionamiento del sistema, desde la captura de datos hasta la visualización.

Dentro del sistema, el proceso de clasificación del tráfico se realiza en tiempo real gracias a la eficiencia de bibliotecas como Pandas para la limpieza y estructuración de datos, y a la capacidad de Dask y Spark para operar sobre grandes volúmenes de información distribuida [6][5]. La eficiencia de estas herramientas permitió reducir significativamente los tiempos de análisis, lo que se tradujo en una latencia de respuesta inferior a los 5 segundos en la mayoría de los casos, incluso bajo condiciones de carga media-alta.

En el aspecto de interoperabilidad, el sistema fue diseñado para integrarse fácilmente con herramientas externas como sistemas de gestión de eventos (SIEM). Esto permite ampliar las capacidades del sistema según las necesidades específicas de cada organización. De igual modo, el backend se comunica con bases de datos PostgreSQL, que permiten la trazabilidad completa de eventos y la generación de reportes automatizados [23][24].

Interfaz de AegisNet con gráfico circular de puertos de comunicación por host
Figura 7. Reporte gráfico de la aplicación: puertos de comunicación por host.

En la práctica, esta solución también cumple muchas de las funciones clave de un SIEM (Security Information and Event Management), ya que consolida en un solo sistema la recolección, análisis, correlación y presentación de eventos de seguridad en tiempo real. Sin embargo, el valor añadido de esta aplicación radica en que no requiere una configuración manual de reglas de correlación ni un análisis forense posterior para actuar: la inteligencia incorporada mediante el modelo Isolation Forest le permite tomar decisiones autónomas con base en patrones estadísticos y de comportamiento previamente aprendidos.

El algoritmo Isolation Forest es particularmente eficiente en detectar anomalías sin requerir datos etiquetados, lo que lo hace ideal para entornos dinámicos como las redes de MIPYMES, donde el tráfico puede variar sin seguir patrones estrictos. El sistema realiza una evaluación continua de las métricas de tráfico (tasa de paquetes, puertos únicos, información enviada, etc.) y puede detectar variaciones sutiles que escapen a reglas tradicionales. Por tanto, el sistema no solo identifica amenazas activas, sino también condiciones precursoras que podrían derivar en incidentes de seguridad.

A diferencia de SIEMs comerciales que requieren integraciones costosas o mantenimientos continuos, este sistema basado en herramientas open-source permite a las MIPYMES acceder a funcionalidades similares sin comprometer su presupuesto. Además, ofrece trazabilidad total gracias al registro automático de eventos, accesibles desde PostgreSQL y visualizables desde una GUI estilizada. Esta combinación de SIEM funcional, detección inteligente y respuesta inmediata, convierte a este sistema en una herramienta estratégica para entornos donde los recursos técnicos y humanos son limitados.

El software contempla escenarios de prueba físicos y simulados. Por ejemplo, uno de los escenarios evaluados consistió en la inyección de tráfico malicioso mediante ataques de escaneo de puertos (nmap), fuerza bruta SSH (hydra) y denegación de servicio (hping3) en un entorno virtual creado con Mininet. En este entorno, los resultados obtenidos reflejaron una detección exitosa en más del 90 % de los casos para Isolation Forest, manteniendo la tasa de falsos positivos por debajo del 8 %. En comparación, DBSCAN tuvo una mayor sensibilidad, pero también una mayor propensión a detectar falsos positivos, lo que en entornos reales puede derivar en acciones innecesarias o pérdida de confianza en el sistema [14][20].

Otro escenario fue el análisis de archivos de logs provenientes de un SIEM simulado con registros JSON. En este contexto, el sistema fue capaz de identificar patrones categóricos anómalos, como cambios inesperados en reglas de firewall, intentos de acceso fuera del horario habitual, y modificaciones sospechosas en la configuración de red. Para este caso, DBSCAN mostró mejor desempeño que los modelos lineales, aunque su precisión fue superada por Isolation Forest [12][17].

Isolation ForestPrecisiónRecallF1-ScoreSupport (logs analizados)
Normal0.771.000.87600
Anomalía1.000.130.24210
Accuracy0.78810
Macro avg0.880.570.55810
Weighted avg0.830.780.70810
Tabla 1. Resultados de Isolation Forest en el análisis de logs.

Una innovación adicional que se integró en la fase final del desarrollo fue la simulación de tráfico legítimo. Este componente permite generar escenarios normales controlados, como navegación web, consultas DNS, envío de correos o conexión a servidores internos, con el fin de evaluar el rendimiento del sistema ante comportamientos genuinos. Este tipo de validación fue fundamental para ajustar los umbrales de detección y reducir falsos positivos, un aspecto crítico para que el sistema pueda ser adoptado sin generar interrupciones innecesarias en las operaciones cotidianas de la empresa.

En términos de arquitectura, el sistema fue concebido para funcionar bajo un modelo distribuido. Esto significa que, aunque su núcleo puede ejecutarse en una Raspberry Pi, la solución puede extenderse fácilmente a través de una red de dispositivos que colaboren en la recolección y procesamiento de datos. Por ejemplo, en entornos donde la red se encuentra segmentada por departamentos o ubicaciones físicas, cada segmento podría tener su propio nodo de monitoreo, que luego consolida información hacia un servidor central de análisis.

Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software dentro de la red de la MIPYME
Figura 8. Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software en la red de la MIPYME.

Finalmente, uno de los puntos más valiosos del proyecto es su potencial para adaptarse a otros tipos de entornos. Aunque fue diseñado con las MIPYMES en mente, el sistema puede ser útil también en organizaciones no gubernamentales, centros educativos, o startups que requieran una solución de monitoreo de red sin tener que invertir en plataformas comerciales de alto costo. Su diseño modular y su base en herramientas open-source garantizan que pueda ser reutilizado, ampliado o personalizado según cada caso particular [8][15].

Este software de monitoreo representa mucho más que una simple herramienta de detección. Es una propuesta integral de defensa cibernética accesible, construida con visión académica, enfoque práctico y sensibilidad social. Combina lo mejor del aprendizaje automático con buenas prácticas en privacidad y seguridad, empleando recursos tecnológicos sostenibles y reutilizables. La experiencia obtenida durante su desarrollo no solo permitió validar su funcionalidad, sino que también generó conocimientos valiosos para futuros desarrollos de ciberseguridad en contextos similares. Este proyecto marca así un hito en la promoción de una cultura de ciberdefensa proactiva y descentralizada, especialmente en sectores tradicionalmente excluidos de las soluciones tecnológicas avanzadas.

Referencias

  1. Reglamento General de Protección de Datos (RGPD), available at https://eur-lex.europa.eu/
  2. “Incident Response & Computer Forensics, Third Edition” by K. Mandia, C. Prosise, and M. Pepe.
  3. G. Chandola, A. Banerjee, and V. Kumar, “Anomaly Detection: A Survey,” ACM Computing Surveys, vol. 41, no. 3, 2009.
  4. Scikit-learn Documentation, “Model Evaluation,” available at https://scikit-learn.org/stable/model_evaluation.html
  5. O’Reilly Media, “High Performance Spark: Best Practices for Scaling and Optimizing Apache Spark”.
  6. J. Reback et al., “Pandas: powerful Python data analysis toolkit,” available at https://pandas.pydata.org/
  7. Alla, Sridhar, and Suman Kalyan Adari. 2019, doi:10.1007/978-1-4842-5177-5
  8. Ageyev, Dmytro, et al. Lecture Notes on Data Engineering and Communications Technologies, 2022, pp. 287–305, doi:10.1007/978-3-030-95161-0_13
  9. Bency, J. (2017). Network based Anomaly Detection: An ensemble approach. In Dr. Dominic Carr, MSc Research Project [Thesis].
  10. Alaverronen, Sami, and Jussi Pohjola. “Pandas in Action: Analysis of China Related Advanced Persistent Threat Actors’ Tactics, Techniques & Procedures.” JYX, 1970, jyx.jyu.fi/handle/123456789/90108
  11. F. T. Liu, K. M. Ting and Z.-H. Zhou, “Isolation Forest,” 2008 Eighth IEEE International Conference on Data Mining, Pisa, Italy, 2008, pp. 413-422, doi: 10.1109/ICDM.2008.17
  12. M. H. Bhuyan, D. K. Bhattacharyya and J. K. Kalita, “Network Anomaly Detection: Methods, Systems and Tools,” in IEEE Communications Surveys & Tutorials, vol. 16, no. 1, pp. 303-336, First Quarter 2014, doi: 10.1109/SURV.2013.052213.00046
  13. Fei Tony Liu, Kai Ming Ting, and Zhi-Hua Zhou. 2012. Isolation-Based Anomaly Detection. ACM Trans. Knowl. Discov. Data 6, 1, Article 3 (March 2012), 39 pages. https://doi.org/10.1145/2133360.2133363
  14. A. B. Nassif, M. A. Talib, Q. Nasir and F. M. Dakalbab, “Machine learning for Anomaly Detection: A Systematic Review,” in IEEE Access, vol. 9, pp. 78658-78700, 2021, doi: 10.1109/ACCESS.2021.3083060
  15. Taeshik Shon, Jongsub Moon, A hybrid Machine learning approach to network anomaly detection, Information Sciences, Volume 177, Issue 18, 2007, ISSN 0020-0255, https://doi.org/10.1016/j.ins.2007.03.025
  16. Al-amri, Redhwan, et al. “A Review of Machine learning and Deep Learning Techniques for Anomaly Detection in IoT Data.” MDPI, Multidisciplinary Digital Publishing Institute, 8 June 2021, www.mdpi.com/2076-3417/11/12/5320
  17. Pajouh, H.H., Dastghaibyfard, G. & Hashemi, S. Two-tier network anomaly detection model: a Machine learning approach. J Intell Inf Syst 48, 61–74 (2017). https://doi.org/10.1007/s10844-015-0388-x
  18. Schölkopf, B., Platt, J., Shawe-Taylor, J., Smola, A. J., & Williamson, R. C. (2001). Estimating the support of a high-dimensional distribution. Neural Computation, 13(7), 1443-1471.
  19. Kavitha, R., & Kumaravel, N. (2020). Anomaly detection using deep autoencoders for cybersecurity applications. Journal of Information Security and Applications, 54, 102578.
  20. Ester, M., Kriegel, H. P., Sander, J., & Xu, X. (1996). A density-based algorithm for discovering clusters in large spatial databases with noise. Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD-96), 226–231.
  21. C. M. Bishop and N. M. Nasrabadi, Pattern Recognition and Machine Learning, vol. 4, no. 4, p. 738. New York: Springer, 2006.
  22. Internet Engineering Task Force (IETF), “The Transport Layer Security (TLS) Protocol Version 1.3,” RFC 8446, Aug. 2018.
  23. Python Software Foundation, “Python Language Reference,” https://docs.python.org/3/reference/index.html
  24. A. Orebaugh, G. Ramirez, and J. Beale, Wireshark & Ethereal Network Protocol Analyzer Toolkit, Syngress, 2007.
  25. K. Scarfone and P. Mell, “Guide to Intrusion Detection and Prevention Systems (IDPS),” NIST Special Publication 800-94, 2007.

Mapeo Autónomo en Entornos Industriales con Tecnología LiDAR: Una Respuesta a los Desafíos de Seguridad en el mundo de la Construcción

Dave Beon – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El problema de la seguridad en los entornos industriales siempre ha sido un reto constante durante la historia. Mucho más en áreas de construcción donde se está usando maquinaria pesada en terrenos irregulares, lo que genera riesgos para la integridad de los trabajadores, los cuales no se pueden ignorar. Esta situación, empeorada por baja visibilidad, polvo y condiciones climáticas cambiantes, motivó el desarrollo de una variedad de soluciones tecnológicas que no solo reducen los riesgos considerablemente, sino que también refuerzan los procesos de toma de decisiones. De este concepto nació: OBBOT, un robot autónomo capaz de mapear escenarios mediante tecnología LiDAR, desarrollado en la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la dirección del Ing. Jayro Martínez, como proyecto de grado del estudiante Dave Beon.

La iniciativa salió de la necesidad de optimizar la visualización en tiempo real en entornos laborales de alto riesgo. Ciertas soluciones convencionales, como cámaras y sensores ultrasónicos, han demostrado ser ineficaces ante condiciones operativas complejas. Con la tecnología LiDAR, junto con algoritmos SLAM y herramientas IoT, se pudo crear representaciones tridimensionales del ambiente en tiempo real, facilitando la detección de obstáculos y el monitoreo constante vía WebSocket de zonas de peligro. Este proyecto no solo representa un avance tecnológico, sino que también propone una alternativa efectiva y práctica para mejorar la seguridad laboral.

Las estadísticas de accidentes laborales en la industria de la construcción, citadas por la OIT (Organización Internacional del Trabajo), ponen en evidencia la gravedad de la problemática. Más allá de la pérdida humana, los accidentes son las causas de muchas interrupciones operativas, el aumento de costos y una disminución del bienestar de la fuerza laboral. En ese sentido, se vuelve primordial incorporar tecnologías inteligentes que permitan anticiparse a los riesgos. OBBOT responde a este fenómeno desde una visión integradora: un robot móvil, con percepción ambiental avanzada y comunicación en tiempo real hacia una plataforma (WebApp) centralizada accesible por los supervisores.

El diseño del robot se enfocó en tres ejes fundamentales: percepción precisa, navegación autónoma y conectividad eficiente. El prototipo integra un sensor LiDAR para la captura de los datos del ambiente, una arquitectura de procesamiento con ESP32 y un algoritmo SLAM que tiene el rol de autolocalización y de mapeo simultáneo. Además, se incorpora una unidad de medición inercial (IMU), la cual permite estimar la orientación del robot mediante acelerómetros y giroscopios, reforzando la precisión del sistema SLAM durante los desplazamientos y giros. La interfaz (WebSocket, WebApp) desarrollada en React y JavaScript, permite visualizar en tiempo real los mapas generados, brindando a los encargados de seguridad una herramienta visual poderosa y de fácil interpretación. A esto se le agrega una arquitectura IoT que facilita la transmisión continua de datos hacia el backend desarrollado en Node.js para análisis y monitoreo remoto.

Problemática y estado del arte

Los entornos industriales presentan una combinación de variables que dificultan la percepción del entorno en tiempo real, especialmente cuando las condiciones ambientales cambian rápidamente. La alta incidencia de accidentes laborales asociados al desconocimiento espacial inmediato ha sido ampliamente documentada por organismos como la OIT y estudios de seguridad ocupacional.

Las tecnologías tradicionales de monitoreo, como cámaras CCTV, sensores ultrasónicos o infrarrojos, tienen limitaciones frente a obstáculos no lineales, polvo, oscuridad o interferencias electromagnéticas. Por otro lado, los drones o soluciones aéreas pueden resultar ineficaces en espacios cerrados, además de costosos y difíciles de operar en tiempo continuo.

Frente a esto, el uso de sensores LiDAR se presenta como una alternativa robusta: permiten obtener datos de profundidad en alta resolución y en tiempo real, generando nubes de puntos que pueden ser transformadas en mapas del entorno. Sin embargo, el reto está en integrar esos datos con algoritmos eficientes de localización y navegación autónoma, como el SLAM (Simultaneous Localization and Mapping), y combinarlos con plataformas de bajo consumo energético y alta conectividad como el ESP32.

Estudios recientes han demostrado que los sistemas SLAM basados en LiDAR mejoran la autonomía de robots móviles en escenarios desconocidos [1][3][5]. No obstante, muchos de estos sistemas requieren potencias de cómputo elevadas o no integran adecuadamente la transmisión en tiempo real de los datos hacia plataformas externas, lo que limita su aplicación industrial.

Objetivos completados

Desarrollar este proyecto implementó un dispositivo autónomo de adquisición y visualización de datos utilizando tecnología LiDAR y algoritmos SLAM, IMU orientado a resolver los problemas de detección y monitoreo en entornos industriales complejos. El sistema integra una interfaz web intuitiva, conectividad IoT a través de un ESP32, y una arquitectura modular que permite mapeo en tiempo real, validando su utilidad en escenarios simulados y entornos semirreales con condiciones adversas.

Metodología

El diseño del sistema del OBBOT se fundamentó en una arquitectura modular. El sensor LiDAR y la IMU proporcionan datos de percepción del entorno y orientación del robot, los cuales son procesados por el ESP32. Este microcontrolador envía datos al servidor mediante Wi-Fi y WebSocket, donde luego son visualizados en una interfaz desarrollada en React y JavaScript. Simultáneamente, el ESP32 comunica instrucciones a la plataforma TI-RSLK, que coordina el movimiento del prototipo a través de motores y encoders. Esta segmentación funcional permite mejor escalabilidad, mantenimiento eficiente y respuesta en tiempo real.

Diagrama de arquitectura de OBBOT: sensores LiDAR e IMU, ESP32, plataforma TI-RSLK con encoders y ruedas, router Wi-Fi, servidor y página web
Figura 1. Diagrama de arquitectura del sistema OBBOT. Se muestra el flujo de datos desde los sensores LiDAR e IMU, a través del microcontrolador ESP32 y la plataforma TI-RSLK, hacia la interfaz web mediante WebSocket.

Resultados

Durante las pruebas, el sistema registró las posiciones relativas de los obstáculos detectados mediante el sensor LiDAR, generando tanto coordenadas cartesianas como un mapa de ocupación. Como se observa en las siguientes tablas y figuras, el sistema logró identificar y mapear objetos con una alta densidad de puntos, clasificando correctamente los espacios ocupados. La resolución espacial obtenida fue suficiente para construir mapas funcionales en tiempo real, lo que valida el uso del algoritmo SLAM y la precisión del sensor en condiciones simuladas.

PuntoX (mm)Y (mm)Distancia (mm)Ángulo (°)Calidad
132.7-620.64621.5273.0215
248.06-632.68634.5274.3415
362.41-644.49647.5275.5315
476.76-657.79662.25276.6615
591.8-671.76678.0277.7815
6109.79-684.75693.5279.1115
7126.21-697.93709.25280.2515
8143.48-713.21727.5281.3815
9903.47124.46912.07.8415
Tabla 1. Coordenadas captadas por el sensor LiDAR durante el proceso de mapeo.
Coordenadas (x,y)OcupadoLibre
141, -5210
142, -4510
142, -4210
144, -3910
144, -3510
144, -2910
Tabla 2. Fragmento del mapa de ocupación generado por el sistema.
Interfaz web de OBBOT con el lienzo del mapa, los datos del sensor IMU y los controles SLAM
Figura 2. Interfaz web del sistema OBBOT. Se muestra el panel de control SLAM con opciones de mapeo, calibración de sensores y visualización en tiempo real de los datos del sensor IMU.

Conclusión

OBBOT no solo representa un avance en la aplicación de tecnologías como LiDAR, SLAM e IoT en entornos industriales, sino que propone una ruta clara hacia la construcción de espacios laborales más seguros e inteligentes. Los resultados obtenidos en los entornos simulados validan la viabilidad técnica del sistema y su impacto potencial en la prevención de accidentes laborales. La arquitectura modular del sistema, junto con la visualización en tiempo real, facilita la adopción de este tipo de soluciones en industrias de alto riesgo.

A futuro, se planea escalar el prototipo para integrarlo con sistemas de gestión industrial, mejorar la precisión del mapeo SLAM e incorporar visión artificial para la identificación avanzada de elementos en el entorno. El proyecto deja abiertas múltiples posibilidades de evolución tecnológica y adaptación a otros dominios como la minería, logística o respuesta a emergencias.

Referencias

  1. T. Chen, F. Pu, H. Chen y Z. Liu, “WHUVID: A Large-Scale Stereo-IMU Dataset for Visual-Inertial Odometry and Autonomous Driving in Chinese Urban Scenarios,” Remote Sensing, vol. 14, 2022.
  2. D. Lee, S. Lee, P. Choi y D. Park, “Accuracy–Power Controllable LiDAR Sensor System with 3D Object Recognition for Autonomous Vehicle,” Sensors, p. 5706, 2020.
  3. X. Xu et al., “A Review of Multi-Sensor Fusion SLAM Systems Based on 3D LIDAR,” Remote Sensing, p. 2835, 2022.
  4. A. Patron-Perez, S. Lovegrove y G. Sibley, “A Spline-Based Trajectory Representation for Sensor Fusion and Rolling Shutter Cameras,” Int. J. Comput. Vis., pp. 208–219, 2015.
  5. S. H. Abdulredah y D. J. Kadhim, “Developing a real time navigation for mobile robots at unknown environments,” Indones. J. Electr. Eng. Comput. Sci., pp. 500–509, 2020.
  6. Embedded Systems Design with the Texas Instruments MSP432 32-bit Processor, Morgan & Claypool, 2017.
  7. P.-Y. Lajoie et al., “Modeling Perceptual Aliasing in SLAM via Discrete-Continuous Graphical Models.”
  8. A. Al-Hourani y B. Ristic, “MapperBot/iSCAN: open-source integrated robotic platform and algorithm for 2D mapping,” Int. J. Intell. Robot. Appl., pp. 44–56, 2020.
  9. S. Ceriani et al., “Pose Interpolation SLAM for large maps using moving 3D Sensors,” Int. Conf. Intell. Robots Syst., pp. 750–757, 2015.
  10. K. Narang, M. S. Kaushal y M. A. Gambhir, “Realtime Covid19 Tracker Using React,” Int. J. Innov. Res. Comput. Sci. Technol., vol. 8, no. 3, pp. 2347–5552, 2020.
  11. M. Mihálik et al., “The New Method of Active SLAM for Mapping Using LiDAR,” Electronics, p. 1082, 2022.

Jammer SDR

Andrys José Saldaña Marte y Edison de Jesús Paulino Jiménez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

En un contexto donde la conectividad inalámbrica domina nuestras interacciones cotidianas y profesionales, la seguridad en las comunicaciones se ha vuelto un tema crítico, especialmente en entornos donde la información sensible o el control del uso de dispositivos electrónicos resulta esencial. Frente a esta situación, surge el proyecto desarrollado por los estudiantes Andrys José Saldaña Marte y Edison de Jesús Paulino Jiménez, ambos cursantes de término de Ingeniería Telemática en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Este trabajo académico se ha centrado en diseñar un sistema de inhibición de señales inalámbricas basado en tecnología SDR (Software Defined Radio), bajo la dirección académica de la Escuela de Computación y Telecomunicaciones (EICT) de la PUCMM.

La motivación principal del proyecto se fundamenta en las limitaciones observadas en los sistemas tradicionales de inhibición de señales, que comúnmente presentan problemas de interferencia no deseada, alto costo y poca flexibilidad para adaptarse a necesidades específicas (Balzano, 2010). Estos problemas son particularmente evidentes en contextos críticos, como cárceles, instituciones educativas y organizaciones gubernamentales, donde la presencia de dispositivos electrónicos no autorizados puede facilitar actividades ilícitas o poner en riesgo la seguridad operativa (Schneir, 2017). Por ello, se consideró necesario explorar soluciones tecnológicas más innovadoras y económicas que permitieran un control preciso, local y éticamente responsable de las comunicaciones inalámbricas.

Este proyecto es relevante no solo desde una perspectiva técnica, sino también social y ética, dado que propone una solución que equilibra la necesidad de seguridad con el respeto a las normativas legales establecidas por entidades como INDOTEL (López Victoria, 2021). Al enfocarse en una implementación que prescinde del acceso a internet y opera totalmente de manera local mediante una interfaz intuitiva, se asegura un alto nivel de seguridad operativa y facilidad de uso, incluso para usuarios sin formación técnica especializada (Lisbon, 2020). Esta característica es clave para captar la atención de una audiencia amplia, desde profesionales del sector hasta tomadores de decisiones interesados en tecnologías que mejoren la gestión segura del espectro electromagnético.

Finalmente, el desarrollo de esta iniciativa representa un aporte significativo a la formación práctica y teórica de futuros ingenieros en el área de Telemática, fortaleciendo competencias clave como la gestión del espectro radioeléctrico, ciberseguridad y administración responsable de tecnologías emergentes como SDR (Marín, 2016). A través de este trabajo, la PUCMM reafirma su compromiso con la innovación tecnológica aplicada a problemas reales, formando profesionales capaces de liderar soluciones que impacten positivamente en la sociedad dominicana.

Problemática y estado del arte

La proliferación masiva de dispositivos inalámbricos ha transformado significativamente la forma en que las personas se comunican e interactúan, generando un amplio rango de beneficios, pero también múltiples desafíos relacionados con la seguridad y privacidad. Entre estos retos, destaca la presencia creciente de comunicaciones no autorizadas en entornos críticos, tales como centros penitenciarios, instituciones educativas, corporaciones y agencias gubernamentales. En República Dominicana, por ejemplo, se ha evidenciado ampliamente el uso de dispositivos móviles en prisiones para coordinar actividades delictivas desde el interior, lo que ha generado serias preocupaciones sociales y operativas (INDOTEL, 2025).

La problemática principal surge debido a la falta de precisión y selectividad, así como el alto precio en los sistemas tradicionales de inhibición de señales comúnmente conocidos como jammers. Estos dispositivos generalmente bloquean un amplio espectro electromagnético, afectando no solo las señales objetivo, sino también servicios esenciales legítimos. Esto ha derivado en una fuerte resistencia tanto social como regulatoria hacia estas tecnologías, debido a sus efectos colaterales negativos, especialmente en servicios de emergencia y telecomunicaciones autorizadas (Balzano, 2010).

Varios estudios previos han intentado abordar este problema mediante diferentes técnicas tecnológicas. Por ejemplo, en España, un prototipo de inhibidor inteligente basado en tecnología SDR demostró su eficacia al incorporar algoritmos de inteligencia artificial para identificar y bloquear únicamente señales específicas, principalmente en aplicaciones militares (López Victoria, 2021). Sin embargo, estos sistemas suelen estar limitados por su alto costo y la complejidad técnica involucrada, dificultando su implementación a gran escala en contextos menos especializados o con menores recursos económicos.

Otra investigación destacada en Portugal exploró el uso de plataformas SDR de bajo costo para inhibir señales GPS dirigidas específicamente a drones, demostrando que es posible diseñar sistemas económicos y precisos con hardware accesible (Lisbon, 2020). No obstante, estos desarrollos han estado muy enfocados en aplicaciones concretas y especializadas, dejando de lado la generalización hacia otros tipos de señales ampliamente utilizadas, como Wi-Fi, que son críticas en ambientes corporativos y educativos.

En Latinoamérica, proyectos como el realizado en la Universidad Nacional de Colombia (Marín, 2016) analizaron y emularon inhibidores de señales comerciales mediante plataformas económicas como RTL-SDR y GNU Radio. Aunque este estudio demostró la factibilidad técnica de replicar funciones de inhibición a bajo costo, no logró proveer un sistema completamente autónomo, fácil de configurar y seguro desde el punto de vista regulatorio, limitando considerablemente su implementación práctica.

Por otro lado, los sistemas comerciales existentes suelen presentar barreras adicionales de accesibilidad, ya sea por su costo elevado o por restricciones regulatorias y operativas. Los dispositivos disponibles en el mercado frecuentemente requieren infraestructura adicional o condiciones técnicas complejas para operar, lo que impide una adopción amplia y efectiva en sectores como el educativo o corporativo (Schneir, 2017).

Ante estas limitaciones, el presente proyecto de la PUCMM busca una solución tecnológica que combine bajo costo, precisión en la inhibición, facilidad de configuración, operación local segura y cumplimiento estricto de las regulaciones locales. El enfoque propuesto, basado en la integración de SDR con una interfaz web alojada localmente en una Raspberry Pi, ofrece una alternativa prometedora que supera muchas de las deficiencias mencionadas, proporcionando una herramienta efectiva y accesible para controlar comunicaciones no autorizadas de manera precisa y ética.

En resumen, el estado actual del arte muestra claramente que, aunque existen tecnologías capaces de abordar parcialmente estos problemas, aún no se ha desarrollado una solución integral que combine flexibilidad, costo accesible, precisión selectiva y autonomía operativa adaptada a contextos específicos. Este proyecto representa un esfuerzo significativo para cubrir esta brecha tecnológica, proporcionando una solución adaptable que cumpla con estas condiciones esenciales para ser efectiva en contextos reales.

El desarrollo de este proyecto ha logrado implementar un sistema inhibidor selectivo de señales inalámbricas, capaz de bloquear comunicaciones no autorizadas en bandas de frecuencia específicas y dentro de un área controlada. Para alcanzar este objetivo, se cumplió con la implementación de una interfaz sencilla y amigable para el usuario que permite la configuración y selección dinámica de frecuencias a bloquear; se desarrolló un método eficiente para identificar y bloquear dichas señales en tiempo real; se incorporó la gestión de perfiles de usuario y registro detallado de actividades operativas, así como funciones para la generación de alertas. Finalmente, se elaboró documentación técnica y manuales prácticos que facilitan el uso responsable y ético de la solución en distintos contextos críticos, asegurando su cumplimiento con las regulaciones locales.

Diagrama lógico: la Raspberry Pi 5 como servidor web y punto de acceso Wi-Fi alimenta al bladeRF x40, que envía la señal al amplificador y la antena
Figura 1. Diagrama lógico para la implementación del sistema.
Prototipo del inhibidor: Raspberry Pi en su carcasa, SDR, amplificador y dos antenas
Figura 2. Implementación física del esquema.

Metodología

Enfoque general de la solución

Para abordar la problemática descrita, se diseñó una solución tecnológica enfocada en la inhibición selectiva de señales inalámbricas, con la capacidad de operar en múltiples contextos, tales como instituciones educativas, centros penitenciarios, laboratorios académicos y entornos corporativos. Este enfoque fue específicamente concebido para permitir la elección precisa de frecuencias objetivo dentro del rango permitido por el hardware (300 MHz a 3.8 GHz), priorizando frecuencias como Wi-Fi y controles remotos, ampliamente utilizadas y susceptibles de generar riesgos operativos.

Diseño modular e integración de componentes

El diseño del sistema siguió una estructura modular compuesta por hardware y software específicos, incluyendo una plataforma SDR (Software Defined Radio), Raspberry Pi 5, antenas omnidireccionales de 12 dBi, amplificadores TX Nuand BT100 y una fuente de energía de 45 Watts. Esta configuración aseguró no solo una cobertura efectiva en un radio aproximado de 50 metros, sino también el cumplimiento estricto de límites regulatorios nacionales e internacionales de potencia y emisiones electromagnéticas.

Primer plano del amplificador BT-100 conectado al SDR
Figura 3. Amplificador BT-100.

Interfaz de usuario

Un aspecto innovador de la metodología fue el desarrollo de una interfaz web amigable y accesible alojada localmente, que permite gestionar de forma sencilla y rápida el sistema. Entre sus funciones clave se destacan la selección manual de frecuencias, gestión diferenciada de usuarios (administrativos y regulares), generación de reportes operativos, alertas de actividad y seguridad, y visualización gráfica avanzada (waterfalls, dominio de frecuencia, amplitud, constelación). La facilidad y claridad en el manejo de estas funciones han sido esenciales para garantizar que usuarios con diferentes niveles de conocimiento técnico puedan utilizar el sistema eficazmente.

Pantalla de inicio de la interfaz web con selección de provincia, canal Wi-Fi y frecuencia a bloquear
Figura 4. Interfaz gráfica: pantalla de inicio.

Seguridad y control de acceso

Perfiles diferenciados de usuarios. Los usuarios administrativos tienen acceso completo para configurar parámetros críticos, gestionar perfiles, exportar datos completos y administrar alertas, mientras que los usuarios regulares tienen permisos restringidos, limitados principalmente a consultar su propia información y actividades específicas del sistema.

Pantalla de gestión de usuarios de la interfaz web
Figura 5. Interfaz de gestión de usuarios.

Registro y análisis de operaciones

El sistema cuenta con una capacidad robusta para almacenar datos detallados sobre su operación. Se registran fechas y horas exactas de inicio y fin de cada sesión, usuarios responsables del bloqueo, frecuencias utilizadas y eventos de operación. Estos registros se almacenan en un formato CSV fácilmente exportable, permitiendo análisis posteriores que facilitan la evaluación continua del desempeño y cumplimiento normativo.

Validación y pruebas de desempeño

Se ejecutaron pruebas prolongadas en condiciones controladas para validar la estabilidad, efectividad y confiabilidad del sistema. Se logró mantener un bloqueo continuo de señales Wi-Fi durante aproximadamente 8 horas sin interrupciones ni incrementos significativos de temperatura. Adicionalmente, mediante pings extendidos a direcciones específicas como 8.8.8.8 se confirmó la efectividad del bloqueo dentro del área de cobertura establecida, destacando la robustez del sistema en escenarios operativos reales.

Limitaciones técnicas observadas

Durante las pruebas se identificaron limitaciones técnicas clave relacionadas principalmente con la potencia RF efectiva del hardware SDR, la direccionalidad inherente a las antenas utilizadas y las frecuencias específicas manejadas por el equipo. Estas limitaciones fueron consideradas en la configuración y operación del sistema para asegurar una eficacia óptima dentro del marco regulatorio vigente.

Cumplimiento normativo y ético

Para garantizar el uso responsable del sistema, se adoptaron medidas específicas alineadas con la Ley General de Telecomunicaciones (Ley 153-98) establecida por INDOTEL. Se restringieron explícitamente frecuencias asociadas a servicios críticos, informando claramente al usuario sobre restricciones regulatorias al intentar seleccionar frecuencias no autorizadas. Este cumplimiento estricto con las regulaciones asegura la integridad ética y legal del proyecto en su aplicación práctica.

Documentación técnica

Finalmente, se elaboró documentación técnica detallada incluyendo diagramas técnicos y diagramas de flujo para facilitar la replicabilidad y comprensión del sistema. Además, se contempló el desarrollo de manuales prácticos orientados a usuarios no técnicos, lo que permitirá una adopción más amplia y efectiva en diferentes contextos operativos.

Resultados

La implementación y pruebas del sistema inhibidor de señales inalámbricas arrojaron resultados positivos que validan claramente los objetivos planteados al inicio del proyecto. Una de las métricas más relevantes fue el alcance efectivo del sistema, que logró inhibir exitosamente señales Wi-Fi en un radio aproximado de 20 metros. Esta cobertura fue consistentemente comprobada mediante pruebas extensas y prolongadas, destacándose la robustez del sistema en comparación con soluciones existentes menos precisas y con mayor alcance, pero propensas a generar interferencias no deseadas.

El sistema mostró una alta estabilidad operativa durante las pruebas continuas, siendo capaz de mantener la inhibición efectiva de redes Wi-Fi durante aproximadamente 8 horas consecutivas sin interrupciones significativas o incrementos sustanciales de temperatura en los componentes críticos. Esta estabilidad operativa es comparable o superior a soluciones similares documentadas en investigaciones anteriores (López Victoria, 2021).

Además, se validó la capacidad del sistema para mantener una inhibición efectiva mediante técnicas de monitoreo continuo, como la ejecución de pings extendidos hacia direcciones específicas (8.8.8.8), lo que permitió confirmar la pérdida consistente de conectividad dentro del área delimitada mientras el sistema estaba activo. Este método de validación demostró claramente la confiabilidad y precisión del sistema en condiciones reales, siendo una técnica estándar en la evaluación de sistemas de inhibición inalámbrica (Lisbon, 2020). Adicionalmente, se diseñó un script específico que monitoreó continuamente el estado del ping durante todo el período de bloqueo, registrando de manera precisa si la dirección IP objetivo era alcanzable o no en cada instante, asegurando así un registro detallado y confiable del rendimiento del sistema en condiciones operativas prolongadas.

La interfaz de usuario diseñada fue ampliamente valorada durante las pruebas, permitiendo una operación sencilla, efectiva y segura. Las funciones disponibles, tales como la selección manual de frecuencias, gestión diferenciada de usuarios, generación de alertas y reportes gráficos (waterfalls, espectro de frecuencia, constelaciones), mostraron un rendimiento estable y facilitaron la toma rápida de decisiones operativas. Esto representa una mejora significativa frente a sistemas anteriores que carecían de interfaces intuitivas y claras para usuarios no técnicos (Ossmann, 2014).

Finalmente, el sistema demostró eficacia en la generación y exportación de registros operativos en formato CSV, almacenando datos completos sobre usuarios, frecuencias bloqueadas, fechas y horarios exactos de operación. Este aspecto es especialmente valioso, ya que permite realizar análisis posteriores con fines regulatorios y operativos, proporcionando evidencia clara del uso responsable y conforme a normativas del sistema (Schneir, 2017).

Para respaldar estos resultados, se incluyen evidencias visuales como gráficos del dominio de frecuencia, diagramas de constelación y capturas de pantalla de las interfaces y reportes generados, que permiten visualizar claramente el desempeño y eficacia del sistema desarrollado.

Gráficos en vivo de la interfaz: espectro FFT y waterfall en la banda de 2.4 GHz
Figura 6. Diagramas en vivo desde la interfaz gráfica.

Conclusión

El desarrollo de este proyecto permitió validar la posibilidad de implementar un sistema inhibidor selectivo de señales inalámbricas que funcione de forma autónoma y local, reduciendo significativamente el riesgo de interferencias no deseadas y maximizando el control operativo. Los resultados obtenidos reflejan un avance importante hacia soluciones más éticas y responsables, mostrando que es posible ofrecer a instituciones educativas, centros penitenciarios y entornos corporativos una herramienta eficaz para gestionar comunicaciones no autorizadas. Entre los principales aprendizajes destaca la necesidad de diseñar interfaces intuitivas que permitan la operación por usuarios con distintos niveles de conocimiento técnico, así como la importancia de integrar registros detallados que respalden un uso transparente y alineado con normativas regulatorias.

El proyecto también permitió identificar oportunidades de mejora claras, como optimizar el diseño físico para reducir tamaño y consumo energético, reforzar la documentación técnica para facilitar su adopción y entrenamiento de operadores, y explorar mejoras en algoritmos de detección y selección de señales para permitir un bloqueo aún más preciso y dinámico. Además, se propone fortalecer la seguridad del sistema mediante la implementación de protocolos adicionales de autenticación y control de acceso.

Como próximos pasos, se plantea continuar con la investigación y el perfeccionamiento del prototipo, realizar nuevas rondas de pruebas en condiciones más diversas, y buscar colaboraciones con instituciones públicas y privadas interesadas en adoptar esta solución. Asimismo, se recomienda explorar mecanismos de certificación y validación regulatoria para facilitar su uso en escenarios reales. Este proyecto representa solo el inicio de un camino prometedor para el desarrollo de tecnologías que ayuden a garantizar entornos más seguros y controlados, invitando a la comunidad académica y profesional a sumarse al esfuerzo para seguir innovando y contribuyendo al bienestar colectivo.

Referencias

  1. Balzano, Q., “Wireless interference: Issues and solutions,” IEEE Communications Magazine, vol. 48, no. 6, pp. 154–160, 2010.
  2. Schneier, B., Electronic Jamming Techniques and Network Security, Artech House, 2017.
  3. López Victoria, A., “Desarrollo de un prototipo de inhibidor inteligente de comunicaciones basado en tecnología SDR,” Universitat Politècnica de València, España, 2021.
  4. Lisbon, R., “Effective GPS Jamming Techniques for UAVs Using Low-Cost SDR Platforms,” Lisbon University, Portugal, 2020.
  5. Marín, A., “Análisis y emulación de inhibición de señales electromagnéticas usando RTL-SDR y GNU Radio,” Universidad Nacional de Colombia, 2016.
  6. Ossmann, M., Software Defined Radio with HackRF, Great Scott Gadgets, 2014.
  7. Reed, J., Software Defined Radio: Enabling Technologies, Wiley, 2020.
  8. INDOTEL, “Ley General de Telecomunicaciones 153-98,” República Dominicana, 1998.
  9. Tuttlebee, W. H. W., Software Defined Radio: Origins, Drivers, and International Perspectives, Wiley, 2002.
  10. Mitola, J., “Cognitive Radio: An Integrated Agent Architecture for Software Defined Radio,” Ph.D. Dissertation, KTH Royal Institute of Technology, 2000.
  11. Haykin, S., “Cognitive Radio: Brain-Empowered Wireless Communications,” IEEE Journal on Selected Areas in Communications, vol. 23, no. 2, pp. 201–220, 2005.
  12. Ulversøy, T., “Software defined radio: Challenges and opportunities,” IEEE Communications Surveys & Tutorials, vol. 12, no. 4, pp. 531–550, 2010.
  13. Hossein, A., “Wireless Jamming Attacks and Countermeasures,” IEEE Access, vol. 7, pp. 979–999, 2019.
  14. Popescu, A., “Low-Cost SDR-Based Jammers: Architecture and Analysis,” International Journal of Electronics and Communications, vol. 85, pp. 45–53, 2018.
  15. Roy, S., “Security, Privacy, and Jamming in the Internet of Things,” IEEE Wireless Communications, vol. 26, no. 5, pp. 30–37, 2019.
  16. Rondeau, T. W., GNU Radio: The Free & Open Source Radio Ecosystem, 2021.
  17. Ettus Research, “USRP Hardware Driver and SDR Concepts,” 2022.
  18. Nuand, “BladeRF x40 Documentation,” 2023.
  19. Katkar, A., “Analysis of Selective Jamming in Wi-Fi Networks,” International Journal of Wireless Networks, vol. 30, no. 2, 2021.
  20. Council of Europe, “Cybercrime Convention and Wireless Communication Regulation,” 2022.

La inteligencia artificial al servicio del aula: automatizando el seguimiento curricular en la enseñanza de algoritmia

Sara María Contreras Taveras y Higinio Rafael Santos Pérez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un entorno donde la tecnología transforma cada aspecto de nuestra vida, la educación no puede quedarse atrás. Uno de los desafíos más importantes que enfrentan las instituciones académicas es asegurar que los contenidos impartidos en el aula se correspondan fielmente con los programas oficiales. Esto es especialmente relevante en áreas como la programación y la algoritmia, donde cada tema mal impartido puede traducirse en deficiencias significativas en la formación profesional de los estudiantes.

En respuesta a esta problemática, se desarrolló un sistema automatizado de seguimiento y validación de contenidos académicos aplicado a la asignatura Introducción a la Algoritmia (ICC101) en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Este proyecto fue ejecutado por los estudiantes Sara María Contreras Taveras y Higinio Rafael Santos Pérez, como parte de su trabajo final de grado en la carrera de Ingeniería en Ciencias de la Computación, bajo la tutoría del Ing. Brayan Muñoz.

La motivación principal para esta iniciativa surgió al identificar que, a pesar de contar con un plan académico bien estructurado, no existía una herramienta objetiva que permitiera validar su cumplimiento durante el semestre. Las supervisiones académicas eran esporádicas, manuales y basadas en la percepción, lo cual dificultaba la implementación de mejoras fundamentadas en evidencia.

Nuestro objetivo fue desarrollar una solución que, aprovechando tecnologías como el reconocimiento de voz y la inteligencia artificial, permitiera capturar lo que ocurre en clase, analizar su contenido y compararlo con los temas estipulados en el currículo. De esta manera, se buscó no solo monitorear la cobertura temática, sino también ofrecer a los docentes y autoridades académicas una herramienta útil para la mejora continua de la enseñanza.

La falta de mecanismos eficaces para verificar el cumplimiento del programa académico en el aula ha sido identificada como una debilidad estructural en múltiples sistemas educativos, tanto a nivel local como internacional. Según la UNESCO [1], una de las principales causas de la brecha educativa está relacionada con la falta de alineación entre los contenidos enseñados y los contenidos planificados. Esta situación impacta directamente en la formación de los estudiantes, quienes podrían egresar sin haber adquirido los conocimientos fundamentales de sus respectivas áreas.

En el contexto dominicano, este desafío se agudiza. Las instituciones de educación superior carecen de herramientas automatizadas que permitan monitorear de manera sistemática lo que ocurre en el aula. Esto implica que muchas veces se desconoce con exactitud si los objetivos de aprendizaje se están cumpliendo, lo que genera una desventaja tanto para los estudiantes como para los docentes y coordinadores académicos.

La asignatura Introducción a la Algoritmia (ICC101), por su naturaleza formativa y su papel como base para cursos más avanzados, es especialmente sensible a este tipo de desviaciones. Si no se imparte correctamente, se compromete la capacidad del estudiante para enfrentar asignaturas posteriores como estructuras de datos, programación orientada a objetos o diseño de algoritmos.

Diversas investigaciones han abordado esta problemática desde distintas perspectivas. Por ejemplo, Johnson, Boon y Thompson [2] propusieron el uso de sistemas de alineación curricular basados en minería de texto para verificar la cobertura temática. Su propuesta se centraba en analizar materiales de clase como presentaciones o exámenes, pero no abordaba el contenido verbal impartido en el aula.

Por otro lado, Matsane y Ajoodha [3] demostraron que la combinación de reconocimiento automático del habla y procesamiento de lenguaje natural puede ser efectiva para capturar el contenido de clases en tiempo real. Sin embargo, su estudio se enfocaba en contextos de aprendizaje de idiomas, sin una estructura curricular definida que sirviera como referencia para la validación.

En 2020, la UNESCO publicó un informe titulado “AI in Education: Guidance for Policymakers” [1], en el que se destacaba el potencial de la inteligencia artificial para mejorar la supervisión educativa. Entre sus recomendaciones, se encontraba el desarrollo de sistemas automatizados que permitieran comparar lo enseñado con lo planificado, facilitando así intervenciones oportunas. Sin embargo, a pesar de la claridad de estas recomendaciones, su implementación efectiva en países en desarrollo ha sido limitada.

Aunque existen soluciones comerciales para la transcripción automática o el análisis de texto educativo, muchas son costosas, poco adaptables a contextos específicos o requieren grandes volúmenes de datos para su entrenamiento. Además, pocas se integran con el currículo oficial de una asignatura, lo que las hace ineficientes para tareas de validación curricular directa.

Frente a esta situación, el sistema propuesto en este proyecto se diferencia por su enfoque específico en la alineación curricular, su adaptabilidad al contexto local y su diseño modular. Nuestro sistema fue entrenado con el programa oficial de ICC101 y validado con clases reales de la PUCMM, garantizando así su pertinencia y aplicabilidad.

El desarrollo de este proyecto ha culminado exitosamente en la creación de un sistema automatizado capaz de supervisar y validar el contenido impartido en la asignatura ICC101 – Introducción a la Algoritmia, garantizando su alineación con el programa académico oficial. A partir de este objetivo general, se alcanzaron metas específicas como: implementar un sistema de transcripción automatizada de clases mediante tecnologías de reconocimiento de voz; desarrollar un módulo de análisis de contenido utilizando procesamiento de lenguaje natural e inteligencia artificial para comparar las transcripciones con los temas del currículo; y construir un dashboard interactivo que presenta visualmente métricas clave de cumplimiento temático. Cada uno de estos objetivos fue definido con claridad, medible en su funcionalidad, alcanzable dentro del alcance académico, relevante para la mejora de la calidad educativa, y delimitado en un marco temporal definido durante el semestre de desarrollo.

La metodología desarrollada para este proyecto representa un avance significativo respecto a los enfoques tradicionales de supervisión académica, integrando de manera novedosa tecnologías de reconocimiento automático del habla, procesamiento de lenguaje natural y análisis semántico especializado. A diferencia de las soluciones previas que se limitaban a transcribir contenido o analizar materiales estáticos, nuestro enfoque combina la captura en tiempo real del discurso académico con un sistema de validación curricular específicamente entrenado para el dominio de la algoritmia.

Arquitectura modular

Diagrama de despliegue: cliente JavaFX, servidor de aplicaciones Spring Boot, servidor de base de datos PostgreSQL y servidor de procesamiento Python con Silero VAD, Whisper y modelo NLP
Figura 1. Arquitectura del sistema.

El diseño del sistema se fundamenta en una arquitectura de tres capas que garantiza tanto la eficiencia operacional como la escalabilidad futura. La primera capa corresponde al cliente desarrollado en JavaFX, que proporciona una interfaz intuitiva para la captura y carga de audios. La segunda capa constituye el servidor de gestión implementado con Spring Boot, responsable de coordinar los flujos de datos y gestionar la lógica de negocio. La tercera capa integra un servicio especializado de procesamiento desarrollado en Python, que ejecuta las tareas computacionalmente intensivas de transcripción y análisis semántico. Esta separación de responsabilidades permite optimizar el rendimiento del sistema y facilita futuras extensiones o modificaciones [4]. La comunicación entre capas se establece mediante APIs RESTful, asegurando la interoperabilidad y permitiendo que cada componente pueda evolucionar independientemente.

Preprocesamiento inteligente con detección de actividad vocal

Flujo de captura de audio: grabación WAV, conversión a MP3 con FFmpeg, envío al servicio Python, limpieza con Silero VAD y envío del audio limpio al backend
Figura 2. Flujo del módulo Captura y Carga de Audios.

Una de las innovaciones metodológicas más significativas del proyecto radica en la implementación de Silero VAD (Voice Activity Detection) como etapa de preprocesamiento. Esta tecnología, desarrollada específicamente para entornos ruidosos, permite identificar automáticamente segmentos de audio que contienen voz humana, descartando silencios prolongados, ruido ambiente y otras interferencias que podrían afectar la calidad de la transcripción posterior. La integración de esta tecnología representa una mejora sustancial respecto a los métodos tradicionales que procesan el audio completo sin discriminación [5].

El algoritmo de detección implementado utiliza redes neuronales profundas entrenadas en múltiples idiomas, lo que garantiza su efectividad en el contexto del español dominicano. Los resultados experimentales demuestran reducciones promedio del 26% en la duración de las grabaciones procesadas, optimizando significativamente los recursos computacionales necesarios para las etapas posteriores.

Transcripción automatizada

Gráfico de barras que compara la tasa de error por palabra (WER %) de wav2vec2-large y Whisper Large en catorce conjuntos de prueba
Figura 3. Desempeño comparativo de Whisper y wav2vec2 en tareas de reconocimiento de voz.

Para la conversión de audio a texto, el sistema integra Whisper que es un modelo de reconocimiento automático del habla desarrollado por OpenAI. Elegimos esta tecnología por su robustez en entornos académicos y su capacidad para manejar variaciones en la calidad del audio. Radford et al. (2023) documentan que Whisper supera significativamente a modelos anteriores en tareas de transcripción multilingüe, alcanzando niveles de precisión comparables a transcriptores humanos en condiciones controladas [6].

La implementación realizada optimiza el proceso de transcripción mediante la conversión automática de formatos de audio. El sistema procesa archivos en formato MP3 convertidos desde WAV utilizando FFmpeg, garantizando la compatibilidad con diversos dispositivos de grabación mientras mantiene la calidad necesaria para un análisis preciso. Esta aproximación contrasta con soluciones previas que requerían formatos específicos o equipos especializados, aumentando la accesibilidad y usabilidad del sistema.

Análisis semántico multietiqueta con BERT

El enfoque principal del proyecto reside en la implementación de un modelo de clasificación multietiqueta basado en la arquitectura BERT, específicamente adaptado para reconocer los 36 temas oficiales del programa de ICC101. Esta nueva forma de abordar el problema mejora notablemente los métodos anteriores, que se basaban en buscar palabras clave o hacer análisis estadísticos simples. Ahora, el sistema puede entender mejor el significado de lo que se dice, incluso cuando los conceptos se expresan de manera indirecta o con sinónimos.

El modelo implementado utiliza dccuchile/bert-base-spanish-wwm-uncased como base, un modelo preentrenado específicamente para el español que ha demostrado rendimiento superior en tareas de procesamiento de lenguaje natural en contextos hispanohablantes. Koroteev, M. V. (2021) enfatiza que la selección de modelos preentrenados apropiados para el idioma objetivo es crucial para alcanzar resultados óptimos en aplicaciones de análisis de texto especializado [7]. La personalización del modelo mediante fine-tuning con datos específicos de la asignatura permite capturar las particularidades del lenguaje académico utilizado en el contexto de la algoritmia.

MétricaValor
Precisión0.71
Recall0.86
F1-Score0.76
Tabla 1. Resultados del modelo multietiqueta con BERT.

Estrategia de entrenamiento con LLM

Una de las ideas centrales de nuestra metodología fue la implementación de una estrategia de clasificación asistida por GPT-4, un modelo de lenguaje de gran escala (LLM), para organizar y etiquetar datos de entrenamiento con alta calidad. En vez de depender de anotaciones manuales, un proceso lento e incómodo, se optó por un enfoque automatizado que permitió mejorar la eficiencia y coherencia del etiquetado.

Mientras que los datos en sí fueron generados y ampliados utilizando diversas técnicas de data augmentation basadas en herramientas NLP, fue el modelo GPT-4 el que se utilizó específicamente para clasificar y organizar esos datos según temas curriculares. Para lograrlo, diseñamos prompts cuidadosamente orientados, que instruían al modelo a identificar categorías temáticas de forma precisa, evitando sesgos o interpretaciones erróneas.

Este enfoque se enmarca dentro del paradigma de teacher-student learning, donde el modelo generativo actúa como “profesor” para ayudar a entrenar a un clasificador más simple o supervisado. Además, los hallazgos coinciden con lo reportado por Maharana et al. (2022), quienes demostraron que la combinación de aumento de datos con validación humana selectiva puede mejorar sustancialmente el rendimiento en tareas de clasificación especializadas [8].

Análisis de profundidad temática

Además de identificar los temas tratados, el sistema cuenta con un módulo que evalúa qué tan a fondo se aborda cada uno. Este componente combina diferentes métricas como coherencia discursiva, densidad conceptual y similitud semántica para analizar la profundidad con la que se desarrolla cada tema a lo largo de la transcripción.

Para lograrlo, se utilizan técnicas de embeddings semánticos y agrupamiento temático que permiten segmentar el contenido y asignar una puntuación compuesta que refleja el nivel de profundidad académica. Este tipo de enfoque ha demostrado ser más efectivo que los métodos clásicos como TF-IDF o conteo de frecuencia, al capturar matices del lenguaje y relaciones conceptuales más sutiles [9].

La metodología considera varias dimensiones al mismo tiempo: qué tan bien se alinea el contenido con el currículo oficial, la coherencia entre bloques temáticos consecutivos, la complejidad del vocabulario empleado y la concentración de conceptos clave por unidad de tiempo. Con este enfoque se busca ofrecer una evaluación más precisa y real, y no solo centrarse en técnicas que no profundizan verdaderamente en la forma que se aborda cada contenido.

Tema principalProfundidad avanzadaNivel de profundidadCoherencia temática
Parámetros y valores de retorno en subprogramas0.484Medio0.586
Operadores0.532Medio0.568
Utilización de variables banderas, contadoras y acumuladoras0.489Medio0.617
Conversiones de tipo0.526Medio0.564
Tabla 2. Análisis de profundidad realizado por el sistema.

La implementación del sistema de seguimiento y validación de contenidos académicos en la asignatura ICC101 produjo resultados altamente satisfactorios, tanto desde el punto de vista técnico como pedagógico. Al aplicar la solución en entornos reales, se obtuvieron datos cuantitativos y cualitativos que demuestran su efectividad y superioridad frente a enfoques manuales o sistemas genéricos de evaluación.

Uno de los resultados más destacados fue la precisión del 92% en la transcripción automática del audio, incluso en aulas con ruido ambiente moderado. Esto fue posible gracias a la integración del modelo Whisper y al preprocesamiento con Silero VAD, lo que permitió filtrar silencios y fragmentos irrelevantes antes del análisis. En comparación, sistemas anteriores basados en Wav2Vec2 o Google STT presentaban una precisión media inferior al 85% en condiciones similares.

En cuanto al modelo de clasificación temática BERT multietiqueta, se alcanzó un F1-score promedio del 76%, con una precisión del 71% y un recall del 86% al identificar correctamente los temas impartidos en clase según el currículo oficial. Estas métricas superan ampliamente a métodos clásicos de análisis de texto como TF-IDF o conteo de palabras clave, que no sobrepasaban el 50% de precisión en pruebas preliminares.

El sistema también demostró su capacidad para evaluar la profundidad con la que se abordan los temas, algo que rara vez es considerado en herramientas educativas. Por ejemplo, se observó que clases centradas en estructuras repetitivas y funciones lograron una puntuación de profundidad superior al 70%, mientras que temas como “Cadenas de caracteres” tendieron a aparecer de forma superficial en varias sesiones, con una profundidad inferior al 40%. Esto permitió detectar necesidades de refuerzo específicas.

Durante la fase de validación experimental se analizaron más de 20 sesiones reales de clase, correspondientes a distintos docentes y secciones. En todos los casos, el sistema fue capaz de generar análisis completos en menos de 3 minutos, incluyendo visualización, segmentación y generación de reportes automáticos. Este desempeño en tiempo casi real representa una mejora sustancial frente a las auditorías manuales, que pueden tomar horas o incluso días.

Los resultados se presentan en una interfaz clara que ha sido validada por profesores y coordinadores académicos, quienes destacaron especialmente la utilidad de los gráficos comparativos y la posibilidad de identificar desviaciones temáticas de forma visual. Entre las funcionalidades más valoradas se encuentran el gráfico de pastel del cumplimiento temático, el histograma de profundidad por unidad y el timeline de evolución temática, los cuales serán incluidos en la versión extendida del blog con sus respectivas capturas de pantalla.

Además, se logró generar automáticamente un conjunto de reportes PDF por clase, donde se detallan los temas tratados, su coherencia, profundidad, y alertas sobre posibles omisiones. Estos reportes pueden ser archivados, compartidos y utilizados como insumo para procesos de mejora pedagógica o evaluaciones internas.

Pantalla de grabación de audio con cronómetro y botones Guardar y Cancelar
Figura 4. Pantalla de grabación.
Lista de clases analizadas con su estado completado y progreso del 100 %
Figura 5. Lista de las clases analizadas.
Dashboard de análisis con temas detectados y no detectados, gráficos de pastel, profundidad y coherencia por tema y evolución por bloques
Figura 6. Dashboard con los resultados del análisis.

La implementación del sistema ha demostrado su potencial para transformar la supervisión académica mediante la provisión de datos objetivos y procesables sobre el proceso de enseñanza. La capacidad del sistema para generar reportes automáticos que destacan desviaciones del currículo y proporcionan métricas de cobertura temática representa un avance significativo hacia la mejora continua de la calidad educativa.

Los resultados indican que el sistema puede identificar efectivamente patrones en la enseñanza, detectar áreas que requieren mayor atención, y proporcionar retroalimentación valiosa tanto para docentes como para administradores académicos. Esta capacidad de análisis sistemático permite implementar intervenciones oportunas cuando se identifican brechas en la cobertura curricular, asegurando que los estudiantes reciban una formación alineada con los objetivos establecidos.

Para instituciones que consideren adoptar este enfoque, se recomienda implementar desde el inicio estrategias de aumento de datos y balanceo de clases para mitigar sesgos derivados de distribuciones desiguales de temas. La incorporación de modelos de lenguaje avanzados como apoyo en las etapas iniciales de clasificación puede agilizar significativamente la preparación del conjunto de entrenamiento, siempre combinado con validación humana.

Referencias

  1. F. Miao, W. Holmes, R. Huang, H. Zhang, and UNESCO, “AI and education: Guidance for policymakers,” pp. 1–50, 2023. Accessed: Jul. 17, 2025. [Online]. Available: https://books.google.com/books/about/AI_and_education.html?hl=es&id=yyE7EAAAQBAJ
  2. C. E. Johnson, H. J. Boon, and M. D. Thompson, “Curriculum Alignment After Reforms: A Systematic Review with Considerations for Queensland Pre- and In-service Teachers,” Aust. J. Teach. Educ., vol. 45, no. 11, pp. 33–55, 2020, doi: 10.14221/ajte.202v45n11.3.
  3. L. Matsane, A. Jadhav, and R. Ajoodha, “The use of Automatic Speech Recognition in Education for Identifying Attitudes of the Speakers,” 2020 IEEE Asia-Pacific Conf. Comput. Sci. Data Eng. CSDE 2020, Dec. 2020, doi: 10.1109/CSDE50874.2020.9411528.
  4. A. Arora and S. Srinivasan, Artificial Intelligence in Education: Promises and Implications for Teaching and Learning. Springer Nature, 2020. Accessed: Jul. 17, 2025. [Online]. Available: https://discovery.ucl.ac.uk/id/eprint/10139722/
  5. R. Takeda and K. Komatani, “Scale-invariant Online Voice Activity Detection under Various Environments,” APSIPA ASC 2024 – Asia Pacific Signal Inf. Process. Assoc. Annu. Summit Conf. 2024, 2024, doi: 10.1109/APSIPAASC63619.2025.10848584.
  6. A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust Speech Recognition via Large-Scale Weak Supervision,” Jul. 03, 2023, PMLR. Accessed: Jul. 17, 2025. [Online]. Available: https://proceedings.mlr.press/v202/radford23a.html
  7. M. V. Koroteev, “BERT: A Review of Applications in Natural Language Processing and Understanding,” Mar. 2021. Accessed: Jul. 17, 2025. [Online]. Available: https://arxiv.org/pdf/2103.11943
  8. K. Maharana, S. Mondal, and B. Nemade, “A review: Data pre-processing and data augmentation techniques,” Glob. Transitions Proc., vol. 3, no. 1, pp. 91–99, Jun. 2022, doi: 10.1016/j.gltp.2022.04.020.
  9. A. Petukhova, J. P. Matos-Carvalho, and N. Fachada, “Text Clustering with Large Language Model Embeddings,” Dec. 2024, doi: 10.1016/j.ijcce.2024.11.004.

Bot de Asistencia Interactivo en Programas de Algoritmos y Diagramas de Programación para la Asignatura de “Introducción a la Algoritmia”

Natasha María López Concepción y Vladimir Osvaldo Curiel Ovalles – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

Durante los últimos años, el mundo ha experimentado uno de los desafíos más grandes del siglo XIX: “La pandemia del COVID-19”. Una emergencia sanitaria que obligó a todo planeta tierra a cambiar radicalmente la forma en que vivían [1]. Asimismo, esta situación llevó a que millones de instituciones académicas cambiaran drásticamente la forma en la que desarrollaban las clases. Forzadas a abandonar sus aulas físicas y migrar a entornos totalmente virtuales, generando así un nuevo paradigma en la educación [2].

Por otro lado, este cambio fue profundamente estructural. Donde, la modalidad virtual, que inicialmente fue una respuesta temporal ante la situación de emergencia, se mantuvo alrededor del mundo incluso tras el retorno parcial y total de las clases presenciales. Lo que antes se consideraba como una alternativa, pasó a ser parte de las metodologías académicas. Sin embargo, esta nueva forma de impartir clases también trajo consigo misma, retos importantes en la vida estudiantil: distracciones, falta de interacción significativa, ansiedad y una dependencia creciente de las herramientas digitales como fuentes principales de información y resolución de tareas [3].

En este contexto, nace la idea de nuestro proyecto, desarrollado por un equipo de dos estudiantes de la carrera de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra. La iniciativa surge como una respuesta directa a una preocupación común entre docentes y estudiantes: “¿Estamos realmente aprendiendo en esta manera nueva de impartir clases? ¿o sólo estamos sobreviviendo académicamente gracias a la tecnología?” [4].

La motivación detrás del desarrollo de este proyecto fue precisamente la anterior mencionada: entender cómo el uso creciente de herramientas de Inteligencia Artificial está transformando el aprendizaje, no sólo como un apoyo, sino como un reemplazo de la figura docente en algunos casos. En ese mismo marco, desarrollamos el Bot de Asistencia Interactivo en Programas de Algoritmos y Diagramas de Programación para la Asignatura de “Introducción a la Algoritmia”, una iniciativa que busca brindar acompañamiento académico continuo a estudiantes de primer año, especialmente en temas donde suelen presentarse mayores dificultades. Además, esta herramienta se enfoca en fortalecer la comprensión de conceptos y figuras claves en la lógica computacional mediante un entorno educativo conversacional accesible, pero sin sustituir el papel pedagógico del docente.

En adición a esto, estudios actuales evidencian que la utilización de chatbots en contextos académicos puede tener efectos positivos en el proceso de formación y crecimiento académico del estudiantado, facilitando procesos educativos innovadores y motivadores [5]. Por lo tanto, creemos con firmeza que la tecnología debe complementar y enriquecer el proceso educativo, no reemplazarlo.

Los retos del aprendizaje virtual

A raíz de la transformación abrupta que creó la pandemia de COVID-19, las instituciones educativas se vieron obligadas a adoptar métodos de enseñanza digital, dando lugar a una transición acelerada hacia las clases virtuales. Esta modalidad, si bien resolvió una necesidad inmediata, también expuso debilidades importantes en el ámbito educativo, especialmente en el área de Ciencias en Computación. La virtualización lejos de desaparecer, con el regreso de la presencialidad, se ha integrado y se ha vuelto un componente híbrido en muchas universidades. Sin embargo, esta incorporación no ha sido del todo equilibrada: los niveles de distracción en el hogar, el aislamiento académico que se presenta y el uso inapropiado de dispositivos, han afectado la calidad del aprendizaje.

Uno de los principales retos que los estudiantes enfrentan, es la comprensión de contenidos como algoritmos y diagramas de programación, los cuales exigen una interpretación visual y lógica que difícilmente puede lograrse de forma pasiva a través de una grabación de clase. Asimismo, la falta de herramientas automatizadas que estructuren, resuma y clarifiquen estos materiales visuales ha generado una barrera significativa, tanto en términos de motivación como en el desarrollo lógico. De la misma forma, diversos estudios muestran que hasta un 95% de los estudiantes utilizan su celular para actividades no académicas durante clases virtuales, en comparación con un 75% en la modalidad presencial y un incremento del 20% en sesiones virtuales [3].

La ansiedad y la falta de comunicación ha generado un impacto en los estudiantes. Se ha observado en los ambientes virtuales, donde el 58% estudiantes tienden a evitar formular preguntas al docente fuera del horario de clases, mientras que, en la modalidad presencial, se puede apreciar que el 43% de estos son los que no interactúan, probando un 15% más de interacción en la presencialidad [6].

Uno de los problemas que radica de este cambio es que al recurrir a estos modelos pierde todo el contexto académico: el programa de la asignatura, las palabras del docente, el libro de texto de la materia e incluso como el profesor interpreta el libro y lo transmite a sus estudiantes. De igual modo, existen pruebas realizadas de rendimiento con diez demostraciones de preguntas que indicaron que, modelos como Chat GPT (modelo de verano 2024) pueden obtener hasta 80% de la puntuación correcta en comparación con el promedio de profesionales en el área, llegando hasta un 96.7%, con una pérdida de conocimiento del 16.7%, además, afirman que existe una pérdida notable al agregar tablas grandes o complejas y lo mismo sucede con preguntas de contenido mostrado en clase, ya que pierde todo el contexto en la que la información fue dada [7].

Esto causa que los estudiantes al final del día se encuentren consumiendo una gran cantidad de contenido generado por IA que no está supervisado, y del mismo modo, realizando sus tareas de esta forma, donde esto baja mucho el desarrollo de sus habilidades, pensamientos lógicos y críticos. Con esto no implica rechazar la usabilidad de la inteligencia artificial en el ambiente educativo, puesto que diversas afirmaciones señalan que la IA proporciona ventajas significativas a los estudiantes, incluyendo la adaptación personalizada del proceso formativo, el fortalecimiento de la motivación académica, la proyección del rendimiento estudiantil y múltiples beneficios adicionales [8].

Por otro lado, se han explorado varios enfoques técnicos para abordar problemas relacionados con la captura, análisis e interpretación de diagramas de flujo y algoritmos. Proyectos como DiagramVoice, han utilizado PySceneDetect y OCR para asistir a personas con discapacidad visual en la comprensión de materiales educativos visuales [9]. Del mismo modo, el proyecto BloSum ha automatizado la generación de descripciones textuales a partir de diagramas mediante detección de formas y relaciones [10]. Diagram Parse Graphs (DPG), utiliza redes neuronales para responder preguntas que están basadas en contenido visual [11].

Aunque estas soluciones muestran gran potencial, la gran mayoría se enfoca en demandas de configuraciones técnicas complejas, haciéndolas difícil de usar para estudiantes con recursos tecnológicos limitados. Por lo mismo, no existen tantas herramientas que prioricen las necesidades del alumno. Por esta razón, nuestra propuesta pretende reducir esa limitación mediante el desarrollo de una herramienta que no únicamente automatice la identificación y extracción de diagramas y códigos, sino que además produzca explicaciones que los estudiantes puedan comprender y que se adapten al contexto pedagógico.

El desarrollo de este proyecto ha implementado la creación de un Bot automatizado integrado en una aplicación web que utiliza herramientas de inteligencia artificial para facilitar la comprensión sobre programas de algoritmos y diagramas de programación explicados en las clases de la asignatura de “Introducción a la Algoritmia” de carácter virtual, mejorando la accesibilidad a los materiales de estudio, la claridad en las explicaciones de conceptos complejos y la eficiencia en el aprendizaje. También, recolectamos sesiones virtuales grabadas de la asignatura, donde contienen códigos y diagramas de programación, pasándolas al Bot donde dio como resultado la esquematización y explicación de los procesos generados en dichas sesiones. Implementamos un sistema que utiliza bibliotecas de IA y se emplearon explicaciones claras y detalladas de los diagramas de programación y programas de algoritmos. Evaluamos el rendimiento del prototipo con el modelo detectando el código y diagrama, obteniendo los resultados más precisos. Por último, creamos una aplicación web para estudiantes y docentes, que permite a los profesores vincular sus perfiles para acceder a las clases, y los alumnos pueden tener acceso al contenido (explicaciones, acercamientos similares, ejercicios) generados por el Bot de forma automatizada basado en el contenido de la sesión.

Un Bot que trabaja sobre clases reales

Como se ha dicho anteriormente, esta herramienta no busca sustituir al docente ni eliminar la necesidad de participación activa en clase, sino brindar un apoyo automatizado para organizar, interpretar y facilitar el acceso a los contenidos más complejos vistos durante la clase. Asimismo, esta solución radica en su capacidad de conectar múltiples tecnologías en un flujo centrado automatizado para el mejoramiento y acompañamiento académico.

El sistema desarrollado es un Bot de asistencia que trabaja sobre videograbaciones de clases reales. Este detecta automáticamente bloques de código y diagramas mediante segmentación de escenas. A partir de esto, se genera el contenido interpretado en lenguaje natural, permitiendo tanto estudiantes como docentes acceder a explicaciones comprensibles sin necesidad de revisar la clase completa.

Este Bot a diferencia de soluciones previas, no depende de contenido preparado, sino que trabaja con grabaciones reales y contenido generado por el docente. Gracias a las técnicas de visión por computadora y procesamiento de lenguaje natural, el sistema es capaz de identificar los fragmentos relevantes, extraer imágenes y texto de ellos, y estructurar explicaciones a partir de lo visualizado en clases. El estudiante con esa herramienta puede retomar un concepto específico visto en clases, repasarlo y reforzarlo en el momento que lo necesite.

La interfaz web que integra el Bot, permite a docentes y estudiantes conectar sus cuentas de Microsoft Teams para poder iniciar con el procedimiento de la creación de reportes. Del mismo modo, el Bot se encarga de procesar el material grabado, y descarta todo el contenido visual que no contenga diagramas de flujo o líneas de código. Esto es muy importante, ya que preserva la privacidad al limitar el alcance del análisis a datos que son necesarios para el aprendizaje del estudiante.

El sistema permite que el usuario pueda navegar por la sesión de manera libre, encontrando lo que el código o diagrama que buscar sin ninguna dificultad. Además, una de las características más valiosas del proyecto es el diseño accesible. El uso de explicaciones generadas a partir de diagramas que permite que estudiantes comprendan y estén conscientes de lo que se muestra. También, el Bot permite aquellos que no se sienten cómodos formulando preguntas en clase, permitiéndoles explorar el contenido a su ritmo.

Por otro lado, este Bot representa un avance frente a otras herramientas que existen. Integrando tecnologías como PySceneDetect [12] para la segmentación de videos, SuryaOCR [13] para el reconocimiento y extracción de texto, y modelos como YOLOv12 [14] para la detección visual.

Aunque el proyecto se enfoca exclusivamente en la asignatura de “Introducción a la Algoritmia”, esta permite pensar en futuras extensiones hacia otras materias, siempre que incluyan elementos visuales similares. Esto permite que el Bot se pueda utilizar en diferentes asignaturas académicas generalizada en carreras técnicas que incluyan diagramas y algoritmos.

Diseño del sistema

Por otro lado, se realizaron diagramas de flujo para mayor entendimiento de cómo se iba a realizar el bot:

Diagrama de procesos: captura del video, filtrado de frames, segmentación y detección, extracción, organización e interpretación del contenido
Figura 1. Diagrama de procesos.

El sistema comienza con la entrada de una videoclase previamente grabada por el docente. A través de un proceso de segmentación de escenas donde el Bot identifica los momentos más relevantes del contenido. Luego, mediante modelos de detección visual, extrae imágenes de diagramas o fragmentos de código. Estos son analizados y convertidos en texto explicativo accesible para el estudiante. El proceso concluye con la visualización de este contenido en la plataforma web.

Diagramas de flujo del Bot (entrada, procesamiento, evaluación, salida, usuarios) y del cliente (usuario, videoconferencia, plataforma web, módulo de reportes, retroalimentación)
Figura 2. Diagrama del Bot y del cliente.

En el Diagrama del Bot, el prototipo utilizará videos de clases pregrabadas así permitiendo el procesamiento automatizado del contenido educativo. Asimismo, usando herramientas de OCR, análisis de código y reconocimiento de diagramas, se extraerán los elementos clave de las clases, garantizando una interpretación precisa de la información presentada en pantalla. Posteriormente, se realizará una validación de los datos extraídos, asegurando su precisión. También, la información procesada se estructurará en reportes organizados y accesibles, facilitando la consulta del material de manera clara y comprensible donde los estudiantes podrán acceder al contenido a través de una plataforma web, brindando una experiencia intuitiva y centralizada para la consulta de los reportes generados. En el Diagrama del Cliente, accede a la plataforma a través de una interfaz web diseñada para ser intuitiva. Desde allí, puede buscar el reporte de la clase si ya se procesó, y visualizar los fragmentos detectados con sus explicaciones correspondientes. El sistema permite navegar fácilmente por diagramas o bloques de código asociados a una sesión, fomentando el aprendizaje autónomo y dirigido.

Además, el sistema está compuesto por distintos servicios desplegados en contenedores, asegurando su escalabilidad y modularidad. Incluye un frontend, servicios de procesamiento de video, OCR, detección visual, y una base de datos para el almacenamiento estructurado del contenido generado. Este diseño permite su implementación tanto en entornos locales como en la nube.

El sistema contempla distintas acciones que puede ejecutar cada tipo de usuario. El estudiante puede visualizar contenidos procesados, realizar búsquedas por tema o clase, y recibir retroalimentación automatizada. Por otro lado, el docente puede subir grabaciones, revisar estadísticas de uso y verificar qué partes de la clase fueron más consultadas.

Resultados: el prototipo LogicMate

A lo largo del desarrollo del prototipo, se obtuvieron resultados sorprendentes y favorables que validan su funcionalidad general y su gestión aplicada para entornos educativos. El proceso de análisis automatizado de clases grabadas demostró ser eficiente, permitiendo identificar y organizar contenidos relevantes sin necesidad de intervención manual constante. Esto representa una mejora significativa respecto a los métodos tradicionales de repaso y consulta de videoclases completas.

Para mejor visualización de lo anteriormente dicho, se le presenta por medio de imágenes, el prototipo finalizado y sus explicaciones detalladas de cada vista de la interfaz web:

Esta representa el punto de interacción directa entre el usuario y la aplicación. El diseño está enfocado en ofrecer una experiencia intuitiva, accesible y visualmente coherente con los objetivos del proyecto al estudiante y docente que lo utilicen.

Página de inicio de LogicMate con el lema Smart summaries code and diagrams y botones de Login y Dashboard
Figura 3. Página de inicio de la interfaz web.

Esta es la pantalla principal al ingresar a la plataforma, donde el usuario puede ver una pequeña introducción de qué tratará el Bot llamado Logic Mate, el Bot desarrollado, incluyendo este una vista previa de su funcionamiento. También, en esta visual el usuario puede iniciar sesión por medio del botón de Login. Además, al hacer clic en el botón Dashboard, este será redirigido a la pantalla de inicio de sesión, donde deberá ingresar sus credenciales para acceder y utilizar las funcionalidades del bot.

El usuario puede ingresar sus credenciales (correo y contraseña) para acceder a las funcionalidades del Bot. En caso de que no esté registrado, la interfaz le da la oportunidad de poder registrarse y luego poder iniciar sesión. Si el usuario no tiene sus credenciales, no podrá hacer uso del Bot y sus funcionalidades que ofrece. Se debe utilizar el mismo correo institucional para que las clases realizadas en Teams luego de ser procesadas salgan de forma automática.

Vista para subir un video y diálogo para agregar participantes al reporte
Figura 4. Página de subir video y para compartir el procesamiento a más participantes.

En esta sección, el usuario puede seleccionar y cargar un video. Esta visual también permite que más participantes puedan acceder al reporte del video y puedan hacer uso del mismo para sus estudios.

Vista del reporte: video de la clase junto a los fragmentos de código detectados con su explicación
Figura 5. Página de visualización del reporte creado.

Aquí se puede visualizar el reporte ya creado. El usuario puede ir viendo la sesión junto al reporte que el Bot realizó. También, puede visionar cada corte de escena donde se está explicando el código y/o diagrama de flujo visto en clases. Puede seguir la explicación del docente junto al reporte creado.

La interfaz también permite que el usuario pueda ver el código generado por el docente en clases y tenerlo a mano para cualquier ocasión donde lo quiera usar para repaso junto al reporte creado por el Bot, o poder probarlo y confirmar con el docente. De forma similar al código, el usuario puede ver el diagrama de flujo empleado en clases.

Vista de chat con el Bot con opciones para explicar el contenido, formas de abordaje, ejercicios prácticos y representación visual
Figura 6. Página para charlar con el Bot directamente.

Se creó un espacio, donde el usuario puede hacerle preguntas sobre la clase procesada al Bot directamente. Este puede explicar el contenido visto en clases, crear ejercicios sobre la misma, hacer una representación visual para mayor entendimiento de lo explicado, y demás.

Vista de enfoques de la clase con una versión optimizada de la serie de Gregory en C
Figura 7. Página de enfoques vistos en la clase.

El usuario puede revisar detenidamente los enfoques vistos en la clase, donde puede ver una opción optimizada o explicada detalladamente, para mayor comprensión.

Vista de ejercicios propuestos con enunciados y solución desplegable
Figura 8. Página de ejercicios propuestos para practicar lo visto en clases.

Se visualiza un apartado para obtener ejercicios generados automáticamente por el bot junto a sus soluciones. Estos basados en el contenido de la clase procesada.

Vista de calendario mensual con las sesiones de Introducción a la Algoritmia
Figura 9. Página del calendario.

Por último, en esta vista se puede ver detalladamente las reuniones de la materia en particular, Introducción a la Algoritmia, donde el usuario puede tener para un día en específico clases o reuniones de estudio con el docente. Este calendario está conectado con la plataforma Teams.

El sistema logró extraer elementos visuales clave como bloques de código y diagramas, y generar explicaciones comprensibles que facilitan el entendimiento por parte del estudiante. Se observaron niveles de precisión y consistencia altos, lo que evidencia el trabajo de los módulos utilizados para segmentar y procesar la información. Además, se redujo considerablemente la cantidad de datos innecesarios, lo que optimizó el tiempo de procesamiento y la experiencia del usuario.

Durante las pruebas de funcionamiento, se identificó que el sistema es capaz de adaptarse a diferentes tipos de contenidos dentro de una misma clase, manteniendo la calidad en la organización y visualización de los resultados. Estas pruebas también mostraron que el sistema puede ser útil tanto para repasar temas específicos como para revisar de forma estructurada toda una sesión académica.

Finalmente, el sistema fue expuesto a situaciones reales de uso en las que se comprobó su utilidad para estudiantes en etapa de formación básica. Los comentarios recogidos destacaron su facilidad de uso y el valor que aporta al momento de estudiar por cuenta propia, especialmente en temas que suelen generar mayor dificultad.

Conclusión

En conclusión, el proyecto desarrollado demuestra que es posible aplicar soluciones tecnológicas de forma efectiva en el contexto educativo para mejorar la experiencia de aprendizaje. Al automatizar la identificación y explicación de contenidos complejos, se ofrece al estudiante una herramienta de apoyo que complementa el trabajo del docente y fomenta el estudio autónomo.

Este enfoque no solo contribuye a la comprensión de materias técnicas, sino que también propone una forma más ordenada y accesible de interactuar con el contenido académico, especialmente útil en ambientes virtuales o híbridos. Esta solución muestra que la tecnología, bien aplicada, puede ayudar en el proceso de enseñanza y aprendizaje.

Referencias

  1. S. Prakash, Ashok Kumar Verma, “IMPACT OF COVID-19 ON ENVIRONMENT AND SOCIETY,” 2020, India, pp. 7352–7363, 2020. Available: www.mutagens.co.in/jgb/vol.09/05/090506.pdf
  2. C. L. Huamán D and C. R, “Virtual education during the pandemic from the perspective of Peruvian teachers in rural schools,” 2022, Perú, pp. 215–242, 2022. doi: 10.21678/apuntes.92.1744.
  3. K. A. Teodorescu Daniel, “College Students’ Distractions from Learning Caused by Multitasking in Online vs. Face-to-Face Classes: A Case Study at a Public University in Romania,” vol. 19, no. 18, p. 11188, 2022, doi: 10.3390/ijerph191811188.
  4. K. Webster, “The COVID-19 Learning Divide: How Demographics Shaped Online Learning Outcomes for High School Students,” September 2024, Northern Illinois University, USA, pp. 427–444, 2024. doi: 10.24059/olj.v28i3.3680.
  5. L. Yudi and R. W. Luis, “Chatbot basado en inteligencia artificial para la educación escolar,” 06-Abr-2023, Lima, Apr. 2023. doi: 10.33996/revistahorizontes.v7i29.614.
  6. CCCSE, “The Online Student: Impact of Course Modality on Engagement,” 2023. doi: 10.26153/TSW/48699.
  7. I. Avramovic, Sanja; Avramovic, “Exploring the Potential Benefits and Limitations of Using an AI Text-Generation Tool in Education: An Examination of ChatGPT’s Performance on Assessments,” 1 march 2024, pp. 193–204, 2024. [Online]. Available: https://www.ingentaconnect.com/contentone/aupha/jhae/2024/00000040/00000002/art00004
  8. P. Svitlana, Lytvynova; Natalya, Rashevska; Svitlana, “The use of artificial intelligence in teaching students programming languages,” pp. 10–29, 2024. [Online]. Available: https://ceur-ws.org/Vol-3781/paper01.pdf
  9. N. Eun and J. Lee, “DiagramVoice: Automatic Lecture Video Commentator for Visually Impaired Students Supporting Diagram Commentary,” 2024, pp. 381–391, 2024. doi: 10.1007/978-981-97-3559-4_31.
  10. L. Shreyanshu, Bhushan; Minho, “Block Diagram-to-Text: Understanding Block Diagram Images by Generating Natural Language Descriptors,” pp. 153–168, 2022. doi: 10.18653/v1/2022.findings-aacl.15.
  11. F. Aniruddha, Kembhavi; Mike, Salvato; Eric, Kolve; Minjoon, Seo; Hannaneh, Hajishirzi; Ali, “A Diagram Is Worth A Dozen Images,” 2016. doi: 10.48550/ARXIV.1603.07396.
  12. B. Castellano, “PySceneDetect,” https://www.scenedetect.com/api/.
  13. “Surya OCR Implementation,” https://lightning.ai/mehta/studios/surya-ocr-implementation?view=public&section=featured.
  14. Y. Tian, Q. Ye, and D. Doermann, “YOLOv12: Attention-Centric Real-Time Object Detectors,” Feb. 2025.

Modelo Predictivo para la Identificación de Fake News en Español sobre la Enfermedad del Cáncer utilizando Machine Learning

José Rafael Jáquez Torres y Brigibel Ysaura Martínez Martínez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La desinformación sobre el cáncer: un reto hispanohablante

El crecimiento del internet y las redes sociales ha cambiado la manera en que se accede y se distribuyen las noticias. No obstante, este crecimiento también ha propiciado la propagación de la desinformación. En ese sentido, uno de los sectores más afectados por esta difusión es el de la salud, particularmente en enfermedades como el cáncer. Conforme a lo señalado por el Instituto Nacional del Cáncer de Estados Unidos [1], existe una gran cantidad de desinformación acerca del cáncer en la red, lo que incluye videos e historias que predican curas milagrosas con tratamientos no comprobados científicamente y en algunos casos dañinos para la salud.

Esta problemática está particularmente presente en las comunidades hispanohablantes, donde las barreras lingüísticas y culturales dificultan el acceso a información verificada. Un artículo de Think Global Health [2] destaca que la difusión de información falsa en el ámbito de la salud representa un desafío significativo creciente en las comunidades de habla hispana, principalmente en Estados Unidos. Además, menciona que los hispanohablantes suelen depender de redes sociales como principal fuente de información, lo que los hace más vulnerables a recibir y compartir contenido con información falsa o inexacta, ya que los algoritmos de estas plataformas no siempre priorizan fuentes verificadas.

Dada esta situación, resulta necesario desarrollar soluciones efectivas capaces de identificar y disminuir la desinformación en español, proporcionando a las comunidades hispanohablantes recursos más confiables para tomar decisiones mejor informadas, lo que puede prevenir acciones que puedan resultar dañinas para la salud de los mismos.

A pesar de los avances en la detección de fake news, la mayoría de los recursos disponibles están en el idioma inglés, dejando un vacío en la comunidad hispanohablante. Los pocos sistemas que existen en español suelen basarse en adaptaciones de modelos monolingües o en traducciones automatizadas, lo cual afecta su precisión y contextualización cultural [2].

En ese orden, los primeros acercamientos técnicos se fundamentan en métodos basados en reglas y heurísticas, que identifican patrones lingüísticos y estructuras típicas de la desinformación [3], [4]. Aunque estos sistemas sentaron las bases de la detección automática, su rigidez y dependencia de reglas manuales limitan su capacidad para adaptarse a la creatividad y la evolución constante del lenguaje en entornos digitales [5].

Con la consolidación del aprendizaje supervisado, se introdujeron clasificadores clásicos como SVM [6], Random Forest [7], XGBoost [8] y Naïve Bayes [9] entrenados sobre vectores TF-IDF [10] y optimizados con técnicas de búsqueda de hiperparámetros. Paralelamente, las redes neuronales densas (DNN) demostraron un rendimiento superior (94.5 % de accuracy) al compararlas directamente con algoritmos tradicionales utilizando el FakeNewsNet dataset [11].

Ahora bien, la llegada de arquitecturas Transformers [12] ha elevado aún más la efectividad de los modelos, permitiendo capturar relaciones contextuales bidireccionales y matices semánticos complejos. Sin embargo, la mayoría están preentrenados en inglés o en múltiples idiomas sin especialización para el español, lo que dificulta su aplicación directa en la detección de noticias sobre cáncer en este idioma.

Finalmente, las estrategias de transferencia cross-lingual y zero-shot [13] ofrecen un camino prometedor para aprovechar recursos en inglés sin sacrificar la contextualización cultural en español. Modelos basados en BERT [14] como mBERT, BETO y XLM-RoBERTa han demostrado viabilidad en escenarios de pocos datos etiquetados, aunque aún requieren validación específica en el dominio del cáncer y ajustes finos para maximizar su precisión en la comunidad hispanohablante. Es por esto que:

El desarrollo de este proyecto ha implementado un modelo predictivo que emplea técnicas de aprendizaje automático para identificar de esta manera noticias falsas en español sobre el cáncer, mediante la recopilación de noticias que son tanto de fuentes verificadas como falsas, aplicando posteriormente técnicas de preprocesamiento de texto para asegurar que este sea de utilidad para el análisis y modelado de los datos. De igual forma, se aplicó la adaptación específica del modelo al idioma español para mejorar el acceso de la comunidad hispanohablante, así como la evaluación rigurosa con métricas estándar de clasificación y el diseño de una interfaz gráfica que integra el modelo, permite realizar pruebas interactivas y verificar su funcionamiento.

Del corpus al prototipo: un flujo modular

La propuesta se basa en un flujo de trabajo modular que integra captura, procesamiento, modelado y despliegue. Partimos de una recolección híbrida de datos (corpus público, artículos científicos y ejemplos manuales/sintéticos) para alimentar tanto modelos tradicionales (SVM, Random Forest, XGBoost) como arquitecturas Transformer (BETO, mBERT). A continuación, cada subsistema se diseñó, implementó y validó por separado antes de su integración final en un prototipo funcional.

1. Recolección de datos

Se utilizó el FakeNewsCorpusSpanish [15], que aporta 1248 noticias (624 reales y 624 falsas). Complementariamente, se extrajeron 1,176 artículos de SciELO [16] (2018-2024) mediante Selenium [17], y se incorporaron 105 declaraciones falsas verificadas manualmente junto a 100 párrafos generados con Grok 3 para simular patrones de desinformación realistas.

2. Preprocesamiento y normalización

El preprocesamiento unificó formatos y limpió el texto: eliminación de caracteres especiales, tokenización con nltk.punkt, eliminación de stopwords y lematización con spaCy. Para modelos basados en BETO se empleó el BertTokenizer (bert-base-spanish-wwm-uncased) con Byte Pair Encoding, ajustando secuencias a 512 tokens. Este pipeline se fundamentó en estudios comparativos de técnicas de preprocesamiento en español, que muestran variaciones significativas en precisión y tiempo de ejecución según la combinación de métodos.

3. Creación y entrenamiento de modelos predictivos

Se evaluaron cinco algoritmos tradicionales sobre vectores TF-IDF con Grid Search CV [18] para ajustar hiperparámetros, y distintas arquitecturas basadas en BETO (Original, BETO+SVM, BETO+LSTM, BETO+BiLSTM). Además, se experimentó con mBERT + SVM para explorar capacidades cross-lingual. Asimismo, la eficiencia de las técnicas de Deep Learning para la detección de noticias falsas en español ha sido validada en trabajos como “Fake News Detection in Spanish Using Deep Learning Techniques”.

4. Validación y métricas

El rendimiento de cada modelo se midió utilizando métricas entre las cuales se encontraban el accuracy, precision, recall, F1-score, ROC-AUC y AUPRC, empleando validación cruzada de 5 folds para estimar estabilidad. En ese sentido, la inclusión de AUPRC, recomendada para clases desbalanceadas, confirmó diferencias mínimas respecto a AUROC [19], reforzando la precisión del sistema en distintos escenarios.

5. Integración del prototipo

El backend se desplegó en Flask sirviendo un servicio REST que recibe texto, lo tokeniza y devuelve la clasificación. La interfaz web, implementada en React/NextJS, admite texto manual, archivos (TXT, PDF) mediante un API en Spring Boot [20] y extracción de enlaces (YouTube, Reddit, webs) mediante Trafilatura, reddit-api y youtube-api-server [21]. Por lo que, esta UI permite la extracción de contenido en distintos formatos como enlaces o archivos, y adicionalmente proporciona feedback inmediato permitiendo al usuario validar la confianza del texto analizado.

Interfaz web del detector: sección para ingresar una URL, el texto de la noticia o un archivo
Figura 1. Interfaz del prototipo: sección de ingreso de información.
Interfaz web del detector: resultado del análisis y formulario de retroalimentación
Figura 2. Interfaz del prototipo: resultado del análisis y sección de retroalimentación.

6. Herramientas y buenas prácticas

Se utilizó Python 3.9 [22], GitHub [23] para versionado, Docker [24] para contenedores reproducibles y GPU NVIDIA RTX 2070 o P100 para entrenamiento acelerado. Así pues, a diferencia de la mayoría de estudios centrados en inglés o en dominios específicos, nuestra metodología incorpora un corpus balanceado en español y explora transferencias cross-lingual sin traducción previa.

A continuación, una breve explicación de cada métrica evaluada en los modelos seleccionados:

  • Accuracy (exactitud): proporción de predicciones correctas (verdaderas + falsas) sobre el total de muestras [62].
    Accuracy = (TP + TN) / (TP + FP + FN + TN)
  • Precisión: de todas las muestras que el modelo etiquetó como positivas (por ejemplo, “fake news”), ¿qué porcentaje lo era realmente? [25]
    Precision = TP / (TP + FP)
  • Recall: de todas las muestras realmente positivas, ¿qué porcentaje el modelo identificó correctamente? [26]
    Recall = TP / (TP + FN)
  • F1-Score: media armónica entre precisión y recall. Es útil cuando existe un desequilibrio de clases [25].
    F1 = 2 · (Precision · Recall) / (Precision + Recall)
  • Specificity: de todas las muestras negativas (“noticias verdaderas”), ¿qué porcentaje se clasificó correctamente como negativas? [26]
  • ROC AUC: área bajo la curva ROC, mide la capacidad de distinguir entre clases en todos los umbrales posibles [25].
  • AUPRC: área bajo la curva Precision–Recall, especialmente relevante cuando las clases están desbalanceadas [19].
  • Cohen’s Kappa: coeficiente de acuerdo entre predicciones y verdad terreno, corregido por el azar [26].
  • MCC (Matthews Correlation Coefficient): métrica balanceada que considera verdaderos y falsos positivos y negativos; toma valores en [–1, +1], donde +1 es predicción perfecta [26].
  • Loss (pérdida): función objetivo optimizada durante el entrenamiento (en los modelos clásicos se muestra como “Loss” del conjunto de validación). Así pues, valores menores indican mejor ajuste [26].
Esquema de la curva ROC con un modelo perfecto, uno aceptable y uno aleatorio
Figura 3. Interpretación de la curva ROC: modelo perfecto, modelo aceptable y modelo aleatorio.

Construyendo confianza: resultados contra las fake news

A continuación, se presenta un análisis descriptivo de los resultados obtenidos con los distintos modelos, tanto los clásicos (SVM, Random Forest, Logistic Regression, XGBoost y Naive Bayes) como los de enfoque deep learning (basados en BETO).

ModeloValidación cruzadaAccuracyPrecisionRecallF1-ScoreSpecificityROC AUCAUPRCCohen’s KappaMCCLoss
SVMCon CV0.81450.8150.80380.80920.80380.89860.90240.62870.62890.4021
Random ForestCon CV0.81820.85080.7610.80320.7610.90780.91150.63520.63890.4397
Logistic RegressionCon CV0.810.80150.81180.80620.81180.90260.90990.61990.62050.3946
XGBoostCon CV0.81380.81410.82550.81970.80150.90270.9070.62730.62740.4088
Naive BayesCon CV0.7710.8170.68430.74380.68430.87260.88910.53980.54750.5836
Tabla 1. Resultados de los modelos clásicos con validación cruzada.

Random Forest sobresale entre los clásicos con 81.82 % de accuracy y AUPRC≈0.91, superando ligeramente a XGBoost y SVM.

Naive Bayes sufre por el desequilibrio de clases y la representación bag-of-words, quedando en 77.10 % de exactitud y MCC≈0.55.

Las pérdidas de validación (“Loss”) se sitúan entre 0.39 y 0.58, indicando que los modelos clásicos requieren más ajuste o datos para igualar al deep learning.

ModeloAccuracyPrecisionRecallF1-ScoreSpecificityROC AUCAUPRCCohen’s KappaMCC
BETO + SVM0.97040.97250.96450.96840.97590.98920.99040.94060.9407
BETO0.96330.96990.95180.96020.97340.99060.9910.92610.9271
mBERT + SVM0.93450.93620.93960.93780.92890.97460.97850.86850.8687
mBERT0.93180.91980.96210.93950.89730.9730.97650.86180.865
Tabla 2. Resultados de los modelos basados en Transformers.

BETO + SVM alcanza el mejor balance, con 97 % de accuracy y AUPRC≈0.99, mostrando que la combinación de embeddings de BETO y un clasificador lineal SVM captura tanto las noticias verdaderas como las falsas de forma casi perfecta.

El modelo BETO queda muy cerca, indicando que el vector pooled de BETO ya codifica suficiente información, pero añadiendo SVM se gana un +0.7 % en accuracy y +0.014 en MCC.

Los enfoques mBERT comparado con BETO son más bajos, debido a su vocabulario multilingüe más genérico: mBERT + SVM logra 93.45 % de accuracy frente al 96.04 % de BETO, y su MCC cae de 0.94 a 0.87.

Hacia un futuro sin desinformación

El proyecto ha demostrado que los modelos basados en Transformers son una buena opción para la detección de desinformación sobre el cáncer. Cabe destacar que, aunque la combinación BETO + SVM alcanzó los puntajes más altos en métricas como accuracy y AUPRC, su rendimiento en pruebas reales resultó menos consistente que en el que se aplicó únicamente BETO. En cambio, BETO logró cerca de un 97 % de precisión tanto en el dataset de entrenamiento como en los escenarios reales, por lo que fue el modelo seleccionado para el despliegue final, garantizando una clasificación estable y confiable.

Como recomendaciones futuras, se plantea ampliar el conjunto de datos colaborando con hospitales y organismos de salud hispanohablantes, así como expandir el alcance del prototipo a otras patologías críticas como la diabetes, enfermedades cardiovasculares, etc. En ese sentido, invitamos a la comunidad académica y a posibles aliados a participar aportando datos, retroalimentación activa y recursos para reentrenar el modelo, mejorar la usabilidad de la interfaz y desplegar esta solución en plataformas de producción. Todo esto, con el objetivo de seguir combatiendo de manera efectiva la creciente ola de desinformación.

Referencias

  1. Equipo del NCI, “La desinformación sobre el cáncer en las redes sociales.” [Online]. Available: https://www.cancer.gov/espanol/noticias/temas-y-relatos-blog/2021/desinformacion-sobre-cancer-redes-sociales
  2. I. Rolz, “Debunking Health Misinformation in Latino Communities.” [Online]. Available: https://www.thinkglobalhealth.org/article/debunking-health-misinformation-latino-communities
  3. M. Choras et al., “Advanced Machine Learning Techniques for Fake News (Online Disinformation) Detection: A Systematic Mapping Study,” 2021, arXiv. doi: 10.48550/ARXIV.2101.01142.
  4. N. Hoy and T. Koulouri, “A Systematic Review on the Detection of Fake News Articles,” 2021, arXiv. doi: 10.48550/ARXIV.2110.11240.
  5. C. Ireton, J. Posetti, and UNESCO, Eds., Journalism, “fake news” & disinformation: handbook for journalism education and training. in UNESCO series on journalism education. Paris: United Nations Educational, Scientific and Cultural Organization, 2018.
  6. N.-I. Galanis, P. Vafiadis, K.-G. Mirzaev, and G. A. Papakostas, “Machine Learning Meets Natural Language Processing — The story so far,” 2021, arXiv. doi: 10.48550/arXiv.2104.10213.
  7. L. Breiman, “Random Forests,” Mach. Learn., vol. 45, no. 1, pp. 5–32, 2001, doi: 10.1023/A:1010933404324.
  8. T. Chen and C. Guestrin, “XGBoost: A Scalable Tree Boosting System,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, San Francisco California USA: ACM, 2016, pp. 785–794. doi: 10.1145/2939672.2939785.
  9. E. Frank and R. R. Bouckaert, “Naive Bayes for Text Classification with Unbalanced Classes,” in Knowledge Discovery in Databases: PKDD 2006, vol. 4213, D. Hutchison et al., Eds., Berlin, Heidelberg: Springer Berlin Heidelberg, 2006, pp. 503–510. doi: 10.1007/11871637_49.
  10. D. E. Cahyani and I. Patasik, “Performance comparison of TF-IDF and Word2Vec models for emotion text classification,” Bull. Electr. Eng. Informatics, vol. 10, no. 5, pp. 2780–2788, 2021, doi: 10.11591/eei.v10i5.3157.
  11. L. Rojas Rubio and C. Meneses Villegas, “Una comparación empírica de algoritmos de aprendizaje automático versus aprendizaje profundo para la detección de noticias falsas en redes sociales,” Ingeniare. Rev. Chil. Ing., vol. 30, no. 2, pp. 403–415, 2022, doi: 10.4067/S0718-33052022000200403.
  12. K. Martínez-Gallego, A. M. Álvarez-Ortiz, and J. D. Arias-Londoño, “Fake News Detection in Spanish Using Deep Learning Techniques,” 2021, arXiv. doi: 10.48550/arXiv.2110.06461.
  13. M. Strong, R. Aly, and A. Vlachos, “Zero-Shot Fact Verification via Natural Logic and Large Language Models,” 2024, arXiv. doi: 10.48550/ARXIV.2410.03341.
  14. S. Kasim, “One True Pairing: Evaluating Effective Language Pairings for Fake News Detection Employing Zero-Shot Cross-Lingual Transfer,” in Soft Computing and Its Engineering Applications, vol. 1788, K. K. Patel, K. C. Santosh, A. Patel, and A. Ghosh, Eds., Cham: Springer Nature Switzerland, 2023, pp. 17–28. doi: 10.1007/978-3-031-27609-5_2.
  15. jpposadas, “jpposadas/FakeNewsCorpusSpanish,” 2024. Accessed: Feb. 07, 2025. [Online]. Available: https://github.com/jpposadas/FakeNewsCorpusSpanish
  16. “Programa SciELO, Modelo de Publicación y Red SciELO | SciELO.org.” Accessed: Mar. 28, 2025. [Online]. Available: https://scielo.org/es/sobre-el-scielo/programa-modelo-de-publicacion-y-red-scielo/
  17. “Selenium.” Accessed: Mar. 28, 2025. [Online]. Available: https://www.selenium.dev/
  18. “GridSearchCV.” Accessed: Mar. 28, 2025. [Online]. Available: https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GridSearchCV.html
  19. W. Chen et al., “Commonly used software tools produce conflicting and overly-optimistic AUPRC values,” Genome Biol., vol. 25, no. 1, p. 118, May 2024, doi: 10.1186/s13059-024-03266-y.
  20. “Spring Boot.” Accessed: Mar. 24, 2025. [Online]. Available: https://spring.io/projects/spring-boot
  21. “youtube-transcript-api: This is an python API which allows you to get the transcripts/subtitles for a given YouTube video. It also works for automatically generated subtitles, supports translating subtitles and it does not require a headless browser.” Accessed: Jun. 09, 2025. [Online]. Available: https://github.com/jdepoix/youtube-transcript-api
  22. “Welcome to Python.org,” 2025. Accessed: Mar. 24, 2025. [Online]. Available: https://www.python.org/about/
  23. “Build software better, together.” Accessed: Mar. 24, 2025. [Online]. Available: https://github.com
  24. “What is Docker? | Docker Docs.” Accessed: Mar. 28, 2025. [Online]. Available: https://docs.docker.com/get-started/docker-overview/
  25. A. de la Torre, “Reconocimiento de emociones musicales y generación de un dataset de etiquetado categórico,” E.T.S. de Ingenieros Informáticos (UPM), 2019. Accessed: Feb. 13, 2025. [Online]. Available: https://oa.upm.es/56029/
  26. V. de Dios Domínguez, “Fake news detection with pretrained transformers,” E.T.S. de Ingenieros Informáticos (UPM), 2023. Accessed: Feb. 13, 2025. [Online]. Available: https://oa.upm.es/75835/

Predicción de variaciones de precios de productos básicos en República Dominicana mediante series temporales

Ramón Del Villar & Gilbert García – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

En la República Dominicana se han observado fluctuaciones significativas en los precios de productos básicos de la canasta familiar. Estos vaivenes de precios generan preocupación en consumidores y autoridades, ya que afectan el poder adquisitivo de los hogares y crean incertidumbre en productores y comerciantes. Diversos factores contribuyen a estas variaciones: la estacionalidad (por ejemplo, ciertas cosechas agrícolas encarecen fuera de temporada), factores macroeconómicos como la inflación general y los cambios en la tasa de cambio del dólar, además de dinámicas de mercado (oferta, demanda e incluso especulación). En conjunto, estos elementos dificultan predecir los precios futuros de alimentos esenciales, complicando la planificación financiera de las familias y la toma de decisiones de las autoridades regulatorias.

Frente a esta problemática, surge la necesidad de una solución proactiva que permita anticipar las variaciones de precios de productos básicos de forma eficiente. Actualmente, las instituciones locales (por ejemplo, Pro Consumidor y el Ministerio de Industria y Comercio) monitorean y publican precios de alimentos en tiempo real mediante plataformas digitales; sin embargo, dichas iniciativas se enfocan en la transparencia del precio actual más que en la predicción de su comportamiento futuro. Es decir, los consumidores pueden consultar en línea los precios vigentes de una gran variedad de productos (a través de herramientas como el Sistema Dominicano de Información de Precios, SIDIP), lo que mejora la información disponible, pero no se cuenta con alertas ni pronósticos sobre cómo podrían evolucionar esos precios en las próximas semanas. Este proyecto de investigación se enfoca precisamente en cubrir ese vacío, desarrollando un modelo predictivo de precios empleando análisis de series temporales para reducir la incertidumbre y fomentar una mayor anticipación en el mercado de alimentos básicos.

El trabajo ha sido realizado como proyecto de grado por estudiantes de Ingeniería en Ciencias de la Computación de la PUCMM. El objetivo general es claro y de alto impacto social: crear un sistema capaz de pronosticar los precios futuros de productos esenciales de la canasta básica dominicana a partir de datos históricos, de manera que distintos actores puedan tomar decisiones informadas. En términos sencillos, se busca dotar a los consumidores de una herramienta que les indique si un producto tenderá a subir de precio (para adelantarse en la compra) o bajar (para planificar sus gastos), al mismo tiempo que las autoridades podrían detectar con anticipación alzas anómalas y los comerciantes ajustar sus inventarios con menor riesgo. A continuación, se presentan los detalles del problema abordado, la metodología seguida y los resultados obtenidos en el desarrollo de este sistema predictivo.

Problemática y Estado del Arte

La volatilidad en los precios de alimentos básicos –como el arroz, las habichuelas, los huevos o el pollo– es un desafío persistente en la economía dominicana. Los consumidores de ingresos medios y bajos son especialmente vulnerables a cambios abruptos de precios, ya que dificultan la organización de presupuestos familiares y pueden traducirse en menor acceso a productos de primera necesidad. Por ejemplo, incrementos repentinos en el precio del arroz o las habichuelas impactan de inmediato la canasta básica, obligando a las familias a reasignar gastos o incluso a prescindir de ciertos alimentos. A nivel de mercado, los comerciantes y pequeños productores también enfrentan incertidumbre: la falta de previsibilidad en los precios complica decisiones sobre cuánto stock comprar o producir, y puede ocasionar pérdidas si los precios caen inesperadamente luego de haber almacenado producto costoso. Estudios a nivel internacional han confirmado que este tipo de volatilidad de precios de alimentos puede amenazar la seguridad alimentaria y la estabilidad económica en países en desarrollo. En particular, se han observado patrones de alta volatilidad asociada a factores externos (clima, mercados globales) y periodos inflacionarios, los cuales afectan negativamente tanto a consumidores como a productores [1]. Resolver esta problemática permitiría aliviar la carga económica en los hogares y mejorar la eficiencia en la regulación del mercado interno.

En respuesta a la volatilidad de precios, diversos países de Latinoamérica han implementado iniciativas orientadas a la transparencia del mercado. Por ejemplo, en México la Procuraduría Federal del Consumidor lanzó la plataforma “Quién es Quién en los Precios” para informar diariamente el costo de la canasta básica en distintos establecimientos, mientras que en Chile existen observatorios de precios en línea para monitorear productos de primera necesidad. En República Dominicana, Pro Consumidor puso en marcha el SIDIP, un sistema en línea que permite comparar precios en tiempo real de una amplia variedad de alimentos en supermercados y mercados del país. Estas plataformas gubernamentales brindan a los ciudadanos información actualizada y fomentan la competencia, al permitir identificar dónde comprar más barato. Sin embargo, la mayoría de estas soluciones no incorporan modelos de predicción para estimar valores futuros; se limitan a informar los precios actuales o históricos. Esto deja una brecha importante: la disponibilidad de datos abiertos ha mejorado la visibilidad del mercado, pero aún hace falta dar el salto hacia la analítica predictiva para convertir esos datos en alertas o proyecciones útiles a futuro. Es aquí donde nuestro proyecto se posiciona, al proponer una herramienta que no solo muestre el precio de hoy, sino que anticipe el de mañana.

En cuanto a enfoques técnicos para predecir precios, la literatura especializada ofrece varios caminos. Un método estadístico tradicional ampliamente utilizado es el ARIMA (AutoRegressive Integrated Moving Average), propuesto originalmente por Box y Jenkins en la década de 1970. Modelos ARIMA y sus variantes han sido aplicados con éxito en la predicción de precios agrícolas y alimenticios en diversos estudios clásicos, logrando capturar patrones estacionales y tendencias cíclicas presentes en las series temporales de precios. Por ejemplo, Jadhav et al. (2017) demostraron la utilidad del modelo ARIMA para pronosticar los precios de cultivos básicos (arroz, mijo, maíz) en mercados locales de la India [4]. Estos enfoques puramente estadísticos brindan una línea base sólida al capturar componentes históricos recurrentes en las series de tiempo, y resultan especialmente relevantes cuando la dinámica de precios es relativamente estable y lineal. De hecho, en contextos donde las variaciones de

precios siguen patrones regulares (por ejemplo, incrementos estacionales predecibles), modelos lineales como ARIMA o su extensión estacional SARIMA pueden alcanzar una precisión competitiva con métodos más complejos [7]. Es importante mencionar también que la evaluación de supuestos, como la estacionariedad de la serie, es crucial al emplear ARIMA; pruebas estadísticas como Dickey-Fuller se utilizan para verificar la presencia de raíces unitarias y garantizar la validez del modelo [9].

Paralelamente, los avances en aprendizaje automático y técnicas de inteligencia artificial han abierto nuevas posibilidades para la predicción de series temporales complejas. En años recientes han cobrado protagonismo las redes neuronales recurrentes, en particular las de tipo LSTM (Long Short-Term Memory). Las redes LSTM fueron introducidas por Hochreiter y Schmidhuber en 1997 como una arquitectura capaz de aprender dependencias de largo plazo en secuencias, superando el problema de desvanecimiento del gradiente presente en las redes recurrentes simples [8]. Aplicadas a series de precios, las LSTM pueden en teoría capturar relaciones no lineales y efectos retardados que los modelos estadísticos tradicionales no consiguen modelar fácilmente [6]. Investigaciones recientes indican que los modelos basados en LSTM logran un desempeño muy competitivo –e incluso superior– en escenarios de alta volatilidad o con datos muy ruidosos [5]. Por ejemplo, Yang et al. (2023) emplearon una LSTM para predecir el precio de la carne de cerdo durante periodos de alta incertidumbre (pandemia de COVID-19) y hallaron que este modelo superó a un ARIMA equivalente tanto en predicciones de corto como de largo plazo, reduciendo significativamente el error de pronóstico [5]. Este resultado concuerda con otros estudios en los que las LSTM han capturado dinámicas no lineales sutiles en precios agrícolas, adaptándose mejor a cambios bruscos que los modelos lineales [6], [11]. No obstante, la eficacia de las redes neuronales depende de contar con suficientes datos para entrenamiento y de ajustar correctamente sus hiperparámetros; en contextos con series muy cortas o con patrones predominantemente lineales, métodos clásicos pueden seguir siendo la opción más robusta [7].

Otra vertiente relevante en el estado del arte son los enfoques híbridos que combinan modelos estadísticos y de aprendizaje profundo. En la literatura se han explorado sistemas que buscan aprovechar lo mejor de ambos mundos: por ejemplo, usar un ARIMA para modelar la estructura lineal básica de la serie, y luego aplicar una red neuronal sobre los residuos para capturar patrones no lineales restantes. Pandit et al. (2023) evaluaron modelos híbridos ARIMAX (ARIMA con variables exógenas) combinados con distintas técnicas de inteligencia artificial para pronosticar índices de rendimiento de cultivos en India, encontrando que la inclusión de una variable exógena relevante junto con la capacidad de las redes neuronales para procesar patrones complejos mejoró significativamente la precisión de los pronósticos [10]. De forma similar, revisiones sistemáticas recientes resaltan que muchos trabajos reportan menores errores de predicción al integrar modelos clásicos con algoritmos de aprendizaje automático, en comparación con usar cada enfoque por separado [11], [12]. Esto sugiere que no hay una solución única y universal para la predicción de precios: las estrategias más efectivas podrían ser específicas para cada producto o mercado, combinando diferentes técnicas según la naturaleza de la serie (lineal, altamente volátil, influenciada por factores externos, etc.). Precisamente, el presente proyecto adopta un enfoque integrador, probando tanto modelos estadísticos (ARIMA/SARIMA) como de aprendizaje profundo (LSTM) e incluso un modelo

híbrido propio (denominado LSTMX) que incorpora variables externas, con el fin de identificar cuál es la mejor técnica de predicción para cada producto analizado.

Objetivos Completados

Este proyecto desarrolló un sistema de predicción de precios de la canasta básica dominicana, logrando anticipar variaciones semanales de productos clave con un alto grado de precisión. Para alcanzar este objetivo general, se cumplieron objetivos específicos bajo la metodología SMART: (1) Se recopiló y depuró un histórico amplio de precios y factores económicos relacionados, (2) se implementaron múltiples modelos de series temporales (ARIMA, SARIMA, SARIMAX, LSTM y una variante mejorada LSTMX) ajustándolos con criterio cuantitativo, (3) se evaluó comparativamente el desempeño de cada modelo mediante métricas de error (MAE) identificando la técnica óptima para cada producto, y (4) se desarrolló una API y una interfaz web (AhorraYa) que integran el modelo ganador, brindando pronósticos actualizados y útiles a usuarios finales.

Metodología:

Para abordar el problema de investigación se siguió una metodología estructurada en fases consecutivas, abarcando desde la obtención de datos brutos hasta la implementación de una aplicación funcional. A continuación, se describen las etapas principales del proyecto, destacando las técnicas empleadas en cada una y cómo se fueron integrando para materializar la solución propuesta.

Diagrama de bloques del proyecto.

Este diagrama de arquitectura general ilustra los módulos principales del sistema y su interacción: fuentes de datos, preprocesamiento, análisis/modelado, y componentes de despliegue (API e interfaz). Se observa cómo el Módulo de Adquisición de Datos reúne la información de precios desde distintas fuentes (portales oficiales como ProConsumidor/SIDIP y datos abiertos del gobierno, así como registros del Banco Central para variables económicas). Estos datos alimentan al Módulo de Preprocesamiento, donde se realizan tareas de limpieza, transformación de formatos y consolidación en un dataset unificado. Luego, el Módulo de Análisis y Modelado toma el conjunto de datos limpio para efectuar el análisis exploratorio y entrenar los diversos modelos predictivos. Finalmente, los resultados de los modelos se integran en un Módulo de Servicio de Predicción (API backend) y se presentan al usuario a través de un Módulo de Visualización (interfaz web) desarrollado en Streamlit. A continuación, se detallan cada una de estas fases metodológicas:

  1. Recolección de datos: Se recopiló un amplio histórico de datos de precios semanales de productos básicos, abarcando varios años para asegurar suficiente información temporal. Las fuentes principales fueron portales oficiales dominicanos que proveen datos abiertos sobre precios: el portal Precios Justos del Ministerio de Industria y Comercio, el conjunto de datos abiertos del gobierno (datos.gob.do, dataset “Precios Justos”), y el Sistema Dominicano de Información de Precios (SIDIP) de Pro Consumidor. Estos portales suministran precios actualizados de diversos alimentos en distintos tipos de establecimientos (supermercados, mercados minoristas, etc.), lo que permitió recopilar series de tiempo por producto y por tipo de mercado. Complementariamente, se incluyeron variables macroeconómicas externas (ej. la tasa de cambio del dólar, el Índice de Precios al Consumidor – IPC) obtenidas de fuentes confiables como el Banco Central y publicaciones económicas, dado que tales factores podrían influir en el costo de los alimentos. Para la extracción de datos se combinaron descargas directas de datasets abiertos con técnicas de web scraping (automatización de la recolección en sitios web), asegurando así la obtención de un histórico completo y confiable. Al finalizar esta etapa se contaba con un conjunto de datos bruto que incluía, para cada fecha semanal, los precios de cada producto en diferentes mercados, junto con valores sincrónicos de variables económicas relevantes.
  2. Limpieza y preparación de datos: Una vez reunidos, los datos pasaron por un riguroso proceso de preprocesamiento. Esta fase fue crucial, pues la calidad de las predicciones depende directamente de la calidad de los datos de entrenamiento. Se depuraron registros inconsistentes o erróneos, se identificaron y manejaron valores faltantes (imputándolos o eliminándolos según el caso), y se filtraron outliers (valores atípicos) que pudieran distorsionar los análisis. Por ejemplo, si en una semana determinada algún producto mostraba un precio extremadamente fuera de rango debido a un error de captura, dicho dato se inspeccionó y, de ser necesario, se corrigió o descartó. También se homogeneizaron las unidades y formatos: todos los precios fueron convertidos a una unidad estándar (p. ej., RD$ por libra o por unidad, según correspondiera) para hacer comparables las series. En paralelo, las variables externas (tipo de cambio del dólar, IPC, etc.) se alinearon temporalmente con las series de precios, de modo que pudieran integrarse apropiadamente en los modelos posteriores. El resultado de esta etapa fue un dataset estructurado y limpio, listo para el análisis exploratorio y el modelado. Para

asegurar la trazabilidad, se documentaron las transformaciones aplicadas a los datos (por ejemplo, listas de outliers removidos y reglas de imputación).

  1. Análisis Exploratorio de Datos (EDA): Con los datos ya preparados, se realizó un análisis exploratorio para entender el comportamiento histórico de los precios. Se generaron gráficas de series temporales para visualizar las tendencias generales de cada producto a lo largo del tiempo, identificando periodos de aumentos, descensos y estacionalidades marcadas. Por ejemplo, se pudo notar que el precio del arroz selecto presentaba leves incrementos a finales de cada año (posiblemente ligado a festividades), mientras que el pollo procesado tendía a encarecerse en períodos de alta demanda como las semanas previas a feriados. Adicionalmente, se calcularon estadísticas descriptivas (media, desviación estándar, rangos) para cuantificar la variabilidad de precios de cada producto, y se examinaron correlaciones entre la serie de precios y las variables macroeconómicas. Esto permitió responder preguntas como: ¿el alza del dólar precede aumentos en ciertos alimentos? o ¿algún producto muestra un patrón estacional semanal o mensual? En este punto, también se verificó la estacionariedad de las series –requisito importante para ciertos modelos estadísticos– aplicando pruebas como la de Dickey-Fuller. Por ejemplo, se identificó que varias series tenían tendencia (no estacionarias), por lo que sería necesario diferenciarlas al aplicar un ARIMA. El EDA proporcionó intuiciones clave y validó supuestos de modelado: confirmó la presencia de estacionalidad anual en algunos productos, evidenció tendencias a largo plazo en otros, y ayudó a decidir qué factores externos valía la pena incluir en los modelos (por ejemplo, si la tasa de cambio mostraba correlación significativa con el precio de las habichuelas, eso sugería usarla como variable exógena en un modelo SARIMAX/LSTMX).

Diagrama de flujo del proceso general.

Este diagrama esquematiza la secuencia de pasos desde la extracción de datos hasta la visualización de resultados. En la etapa de extracción, se combinan los datos de SIDIP vía web scraping, datos de ProConsumidor (en formato PDF procesados con OCR) y la obtención complementaria de información de Precios Justos. Luego, en la Integración y Limpieza del Dataset, se unifican esas fuentes heterogéneas y se preprocesan los datos (como se describió en los pasos 1 y 2). A continuación, en la fase de Análisis y Entrenamiento, se alimentan los datos limpios al conjunto de modelos que se entrenan (ARIMA, SARIMA, SARIMAX, LSTM y LSTMX), realizando también la selección y ajuste de hiperparámetros. Finalmente, los pronósticos resultantes se visualizan en la interfaz Streamlit junto con los datos históricos, completando el ciclo. Este flujo garantiza que, desde la recopilación hasta la presentación, la información pase por etapas bien definidas que agregan valor: de datos crudos dispersos se llega a predicciones accionables para el usuario final.

  1. Modelado predictivo: En la etapa de modelado se implementaron y probaron diversos algoritmos de series temporales para generar pronósticos de precios, aprovechando las lecciones aprendidas en el EDA. Específicamente, se consideraron cinco enfoques principales: ARIMA, SARIMA, SARIMAX, LSTM y LSTMX. El modelo ARIMA (AutoRegresivo Integrado de Media Móvil) se usó como punto de partida por su eficacia conocida en series estacionarias y su capacidad para modelar patrones autorregresivos e integrados de una serie. Posteriormente, SARIMA (ARIMA estacional) extendió ese modelo incorporando términos estacionales para ajustar periodicidades anuales o mensuales observadas (por ejemplo, permitiendo que el modelo “recuerde” picos cada 12 meses si los hubiera). Por su parte, SARIMAX añadió la posibilidad de incluir variables exógenas –en este caso, factores macroeconómicos como la mencionada tasa de cambio del dólar u otros índices económicos– con la expectativa de mejorar la predicción si dichos factores tienen influencia significativa en los precios. Esta inclusión de variables externas está respaldada por la literatura, que ha mostrado que combinar información exógena en modelos de series de tiempo puede mejorar notablemente el desempeño del pronóstico [10], [11], siempre y cuando exista una correlación o causalidad de Granger entre la variable externa y la serie objetivo. Finalmente, se entrenó un modelo de red neuronal LSTM, apropiado para secuencias temporales complejas, con el fin de capturar patrones no lineales y de largo plazo que los métodos estadísticos tradicionales podrían pasar por alto [6]. Sobre la base de la LSTM, se desarrolló una variante denominada LSTMX, que constituye una contribución novedosa del proyecto: este modelo incorpora las mismas variables exógenas que SARIMAX (por eso la “X”) pero dentro del marco de una red neuronal. En otras palabras, LSTMX es una red LSTM multivariada que recibe como entradas tanto la serie de precios histórica como las series de factores externos (ej. tipo de cambio), permitiéndole aprender relaciones más ricas. La hipótesis detrás de LSTMX es que, al igual que un ARIMAX aprovecha variables auxiliares, una LSTM también puede beneficiarse de ellas para ajustar mejor sus predicciones – algo que investigaciones recientes avalan al mostrar mejoras con enfoques híbridos y multivariados [10], [6].

Cada modelo se entrenó individualmente con los datos históricos de cada producto, reservando una porción de los datos para validación. Para configurar los modelos se siguieron buenas prácticas reconocidas: en ARIMA/SARIMA se identificaron los

órdenes óptimos (parámetros p, d, q y sus análogos estacionales) mediante análisis de autocorrelación (ACF/PACF) y minimización de criterios de información como AIC. En LSTM/LSTMX se experimentó con distintas arquitecturas (número de neuronas, número de capas ocultas) y funciones de activación adecuadas para series de tiempo, empleando técnicas de early stopping y regularización para evitar sobreajuste. La fase de modelado también incluyó la realización de búsqueda en grilla (Grid Search) para ciertos hiperparámetros, con el fin de garantizar que cada modelo estuviera lo mejor ajustado posible. Por ejemplo, se probó en ARIMA un rango de valores para (p,d,q) y se eligió la combinación con menor AIC en la data de entrenamiento, mientras que en LSTM se evaluaron diferentes batch sizes y tasas de aprendizaje, seleccionando aquellas configuraciones que produjeron menor error en la validación. Este enfoque sistemático de ajuste se alinea con recomendaciones de la literatura para obtener modelos robustos [12].

  1. Evaluación comparativa de modelos: Tras entrenar los modelos, se evaluó su desempeño utilizando métricas cuantitativas de error. La principal métrica empleada fue el Error Absoluto Medio (MAE), por ser fácil de interpretar en unidades monetarias (pesos dominicanos). También se calculó, a modo informativo, la Raíz del Error Cuadrático Medio (RMSE) y el Error Porcentual Absoluto Medio (MAPE) para tener referencias adicionales, aunque el criterio de selección de modelos se basó en el MAE. La evaluación se llevó a cabo en dos escenarios de prueba: primero, usando datos históricos hasta abril de 2025 para generar pronósticos y medir errores (dejando fuera mayo de 2025 como prueba), y luego repitiendo lo mismo extendiendo la historia hasta mayo de 2025 (dejando junio como horizonte de validación). De este modo, se simuló el desempeño del sistema en momentos temporales distintos, comprobando la consistencia de resultados. Para cada producto, se comparó el MAE obtenido por los distintos modelos (ARIMA, SARIMA, SARIMAX, LSTM, LSTMX) tanto en la prueba de abril como en la de mayo. Esta evaluación reveló, por ejemplo, que ciertos productos con comportamientos más lineales se ajustaban bien con modelos ARIMA/SARIMA, mientras que otros con variaciones más erráticas podían ser mejor capturados por la LSTM. En función de los MAE obtenidos en la prueba más reciente (mayo 2025), se seleccionó el modelo “ganador” para cada producto, es decir, aquel con menor error de predicción. De manera ilustrativa, la siguiente gráfica resume los resultados de MAE por modelo para cada producto, destacando cuál técnica resultó más precisa en cada caso.
  2. Construcción de la aplicación e implementación: Con los modelos optimizados y seleccionados, la fase final consistió en integrar las predicciones en una aplicación práctica para el usuario. Para ello se desarrolló una API backend utilizando FastAPI, que encapsula la lógica de predicción: esta API carga los modelos entrenados (uno por producto, según el mejor identificado por su MAE) y expone endpoints para obtener pronósticos actualizados. La API fue diseñada de tal forma que, dada una solicitud para un producto específico, automáticamente utiliza el modelo óptimo correspondiente (por ejemplo, si el mejor modelo para huevos es LSTM, el API emplea ese; si para pollo es ARIMA, usa aquel otro) y devuelve la predicción de precio para el horizonte deseado (por defecto, la semana siguiente). Sobre esta base, se construyó la interfaz de usuario empleando Streamlit – un marco de desarrollo ágil para aplicaciones de data science. La aplicación web resultante, titulada “AhorraYa”, brinda a los usuarios una experiencia interactiva sencilla: permite seleccionar un producto de interés y consultar su predicción de precio para la próxima semana (o semanas siguientes, según se configure). Además de mostrar el valor pronosticado puntual, la interfaz despliega visualmente la serie histórica reciente junto con la proyección futura, para contextualizar la tendencia. También se incorporó un módulo de reportes automáticos: el sistema puede generar un informe breve que resume las tendencias observadas, el cambio porcentual esperado y alertas en caso de variaciones significativas, el cual podría descargarse en formato PDF o compartirse en redes sociales para beneficio de otros consumidores. Finalmente, AhorraYa incluye una sección de recomendaciones: con base en las predicciones y ciertas reglas sencillas, la aplicación sugiere acciones al usuario para ahorrar o evitar sobrecostos. Por ejemplo, si se anticipa que el precio del pollo aumentará considerablemente la próxima semana, la recomendación podría ser adelantar la compra de ese producto en la semana actual; o si cierto mercado presenta consistentemente precios más bajos para un artículo, la app podría sugerir ese establecimiento como opción de compra. Estas recomendaciones se generan de forma automática e imparcial, buscando guiar al consumidor hacia la decisión más económica e informada posible.

Diagrama de arquitectura de la API.

Diagrama de componentes de la interfaz AhorraYa.

Vale destacar que la arquitectura final del sistema permite su fácil actualización y escalabilidad. Los modelos pueden re-entrenarse periódicamente conforme ingresen nuevos datos (por ejemplo, incorporando los precios más recientes cada mes) y la API puede desplegarse en la nube para atender múltiples consultas simultáneas. La separación en módulos (ver diagrama de bloques) asegura que cada componente pueda mejorarse o reemplazarse independientemente – por ejemplo, se podría actualizar la interfaz sin tocar el backend, o incorporar un nuevo modelo en la API en caso de avances futuros en técnicas de predicción.

La metodología integró desde la obtención de datos brutos hasta la puesta en marcha de una solución tecnológica lista para su uso. Cada fase se apoyó en la anterior para asegurar coherencia y calidad: datos fiables alimentaron un análisis correcto, que a su vez permitió un modelado preciso, culminando en una herramienta práctica y amigable para el usuario. Se logró materializar un pipeline completo de ciencia de datos aplicado a una problemática real, cumpliendo con el objetivo de dotar a los ciudadanos y entidades dominicanas de una forma novedosa de anticipar y enfrentar las fluctuaciones en los precios de los alimentos básicos.

Resultados

Los hallazgos del proyecto son muy alentadores, tanto en las métricas de predicción como en la funcionalidad del sistema final. En cuanto al desempeño predictivo, la estrategia de probar múltiples modelos y seleccionar el más adecuado para cada producto demostró ser acertada. No emergió un “ganador universal”; por el contrario, cada producto básico tuvo una técnica distinta como su mejor pronosticador, lo cual aprovechó al máximo las fortalezas de cada enfoque. Cabe destacar que, en términos generales, todos los métodos evaluados lograron predicciones de alta exactitud (en promedio por encima del 96% de acierto), pero la selección personalizada modelo-por-producto permitió optimizar aún más la precisión en cada caso.

Al analizar detalladamente cada rubro, se observó que los modelos avanzados ofrecieron ventajas marcadas en ciertas series, mientras que en otras los métodos tradicionales fueron igual de efectivos. Por ejemplo, para la habichuela roja –cuyo comportamiento de precios parece depender de factores económicos adicionales– el modelo de red neuronal LSTM que incorporaba indicadores macroeconómicos logró las predicciones más certeras. En cambio, para otro producto como la habichuela negra, un modelo estadístico sencillo (ARIMA) bastó para pronosticar con excelente precisión, señal de que esa serie no presentaba patrones externos o no lineales lo suficientemente fuertes que ameritaran mayor complejidad. Dicho de otro modo, las técnicas de aprendizaje profundo brillaron especialmente cuando la dinámica de precios era compleja o influida por variables exógenas, mientras que en escenarios más estables o lineales un enfoque clásico resultó igualmente competitivo.

La conclusión es clara: no existe una fórmula única que sirva para todos los alimentos, lo cual justifica el enfoque flexible adoptado. Algunos modelos superaron por amplio margen a sus alternativas en ciertos casos, reduciendo el error de pronóstico a una fracción del obtenido por los demás; en otros productos, las diferencias entre técnicas fueron mínimas. Este hallazgo refuerza la importancia de evaluar tanto métodos estadísticos tradicionales como enfoques de aprendizaje profundo, adaptando la solución según las particularidades de cada serie de precios. La siguiente visualización compara de forma resumida el desempeño de todos los modelos probados:

Comparación visual del rendimiento de los modelos por producto. Cada conjunto de barras representa un producto básico (arroz, habichuelas, huevos y pollo), y la barra más baja en cada grupo indica qué modelo logró el menor error de predicción en ese caso. Como se aprecia en la imagen, el método óptimo cambia de un producto a otro, confirmando que ninguna técnica domina en todos los escenarios. También se nota que en algunos alimentos el modelo ganador aventaja claramente a los demás, mientras que en otros las discrepancias de desempeño resultan casi imperceptibles.

Gracias a este exhaustivo análisis, el sistema desarrollado incorpora automáticamente el modelo más adecuado para cada producto en su módulo de predicción. Es decir, cuando un usuario consulta el precio futuro de un alimento –por ejemplo, los huevos– la plataforma emplea en el backend la red LSTM especializada que mejores resultados obtuvo para ese artículo. De igual modo, si se pide la predicción para el pollo, el sistema invoca el modelo específico que demostró ser superior en esa serie (en este caso, una variante de LSTM entrenada con el índice de precios al consumidor). Este mecanismo asegura que la aplicación siempre ofrezca la mejor estimación disponible según nuestros hallazgos, sin que el usuario deba preocuparse por la complejidad técnica detrás.

Importante destacar que los modelos elegidos alcanzaron errores absolutos muy bajos en sus pronósticos. En términos prácticos, la diferencia promedio entre el precio pronosticado y el precio real suele ser de solo unos pocos pesos dominicanos. Dado que en muchos de estos productos una variación semanal típica ronda entre 1 y 5 pesos, un desvío medio de apenas RD$0.5 en las habichuelas o de alrededor de RD$3 en el pollo es lo suficientemente pequeño como para resultar útil en la práctica. En otras palabras, las predicciones fueron tan precisas que el error entra dentro de lo que podría considerarse una fluctuación normal, lo que brinda confianza para la toma de decisiones. Además, el sistema demostró ser capaz de adaptarse y mejorar con el tiempo: al agregar datos más recientes (por ejemplo, un mes adicional de precios) pudo recalibrar sus modelos sin necesidad de reprogramar nada, confirmando la superioridad de ciertos enfoques (como LSTMX en los casos mencionados) simplemente al alimentar la nueva información. Esto indica que la solución puede mantenerse vigente y afinada a medida que se incorporan nuevos datos, algo crucial para su uso en entornos reales cambiantes.

La herramienta resultante, bautizada AhorraYa, está plenamente funcional y pensada para el usuario común. Su interfaz web permite visualizar la serie histórica de precios de cada producto junto con el pronóstico de la semana siguiente en una gráfica interactiva, haciendo muy intuitiva la comprensión de la tendencia. Además, muestra el valor numérico predicho y cuánto varía con respecto al precio actual (por ejemplo: “Se espera que el precio suba 2.3% la próxima semana”), información presentada de forma clara incluso para personas sin formación técnica. Durante las pruebas con usuarios, estos confirmaron que la aplicación es fácil de entender y usar, logrando que los resultados de la predicción sean accesibles para cualquier persona.

También se incorporaron funcionalidades de valor agregado, como la generación automática de reportes en PDF y un módulo de recomendaciones, con el fin de maximizar la utilidad de la herramienta. Por ejemplo, un usuario puede descargar el informe semanal de precios y compartirlo con su comunidad local, mientras que un analista de la entidad reguladora (Pro Consumidor) podría emplear estos reportes para detectar a tiempo comportamientos anómalos en el mercado. Cabe mencionar que la arquitectura modular del sistema probó ser sólida, ya

que la API manejó correctamente múltiples consultas simultáneas y la interfaz se actualiza casi en tiempo real sin inconvenientes. En conjunto, el prototipo está listo para escalarse y funcionar de manera confiable en situaciones reales.

Un resultado particularmente notable fue la mejora obtenida al incorporar variables macroeconómicas en el modelo para ciertos productos. En los casos donde factores como la inflación o el tipo de cambio inciden en los costos (piénsese en algunos granos importados), añadir estos indicadores al modelo permitió reducir aún más el error de predicción, demostrando que esa información adicional fue valiosa. Este hallazgo abre la puerta a integrar en el futuro más fuentes de datos externas –por ejemplo, índices climáticos, precios internacionales de materias primas o costos de combustibles– para potenciar todavía más la precisión de las previsiones en escenarios complejos. Asimismo, se comprobó que los patrones estacionales típicos (por ejemplo, los picos de precios en diciembre) fueron capturados adecuadamente por los modelos que incorporaban estacionalidad, cumpliendo otro de los objetivos iniciales del proyecto. Esto significa que el sistema reconoce las alzas cíclicas esperadas y no se ve sorprendido por ellas, aportando confianza en sus pronósticos durante todo el año.

En resumen, los resultados respaldan plenamente la hipótesis de trabajo original: es posible anticipar –con errores acotados– las variaciones semanales de precios de productos básicos mediante técnicas de series de tiempo. Quedó demostrado que elegir el modelo adecuado para cada producto mejora de forma tangible la exactitud del pronóstico, en comparación con usar una única metodología para todos los casos. Dicho de otra forma, personalizar la estrategia de predicción por tipo de artículo rinde frutos claros en términos de precisión alcanzada.

La utilidad práctica de estas predicciones quedó de manifiesto al presentar el sistema a posibles usuarios finales y a expertos en economía. Las reacciones fueron muy positivas: los consumidores valoraron poder saber hacia dónde podrían moverse los precios la próxima semana, comentando que esa información les ayuda a decidir cuándo comprar (por ejemplo, aprovechar esta semana antes de que un producto suba de precio, o esperar si se anticipa una baja). Por su parte, las autoridades expresaron interés en la herramienta como complemento a sus sistemas actuales de monitoreo, considerando que podría servir para alertas tempranas de situaciones anómalas (por ejemplo, si se pronostica un alza inusual en algún alimento, investigarlo preventivamente antes de que ocurra). Estas impresiones sugieren que, con un refinamiento y validación adicionales, AhorraYa podría convertirse en un apoyo real para la toma de decisiones tanto a nivel micro (hogares) como macro (políticas de mercado). En definitiva, el sistema ha logrado conectar los precios pasados con predicciones futuras para orientar al consumidor sobre el mejor momento de compra, cumpliendo de forma práctica e intuitiva con el objetivo de reducir la incertidumbre en el mercado alimenticio.

Conclusión

En conclusión, el proyecto logró desarrollar con éxito un sistema integral de predicción de precios para productos básicos en República Dominicana, combinando métodos estadísticos tradicionales y técnicas modernas de aprendizaje profundo. Como resultado, se dispone de una herramienta que anticipa las fluctuaciones de precios con un nivel de precisión útil, lo que representa un aporte significativo para distintos actores: los consumidores pueden planificar sus compras con mejor información, evitando los impactos de alzas sorpresivas; los comerciantes y productores pueden ajustar inventarios y estrategias considerando las tendencias pronosticadas; y las autoridades disponen de alertas previas para focalizar inspecciones o medidas de estabilización en caso de incrementos inusuales. El sistema AhorraYa materializa estos logros en una interfaz amigable, democratizando el acceso a la inteligencia de datos sobre precios a cualquier ciudadano con acceso a internet.

El valor de este sistema radica en promover una gestión proactiva frente a la volatilidad de precios. Tradicionalmente, las respuestas eran reactivas (se actuaba después de que el precio subía); con esta solución, se abre la posibilidad de actuar antes del impacto. Por ejemplo, una familia puede decidir comprar ciertos víveres por adelantado si se prevé una subida considerable la próxima semana, o el Ministerio de Industria y Comercio podría preparar acuerdos con suplidores si observa que varios productos mostrarán alzas concurrentes debido a factores estacionales. En términos de transparencia de mercado, contar con predicciones al alcance del público empodera al consumidor y fomenta la competencia, ya que los comercios sabrán que los compradores tienen expectativas informadas y no solo conocerán el precio actual sino su posible trayectoria.

Aunque el proyecto alcanzó sus objetivos, quedan oportunidades de mejora y líneas de trabajo futuras. En primer lugar, sería deseable ampliar el catálogo de productos considerados, incorporando más alimentos de la canasta básica e incluso bienes no alimenticios cuyos precios afectan el presupuesto familiar. Cada nuevo producto requeriría recopilar su serie de precios e integrarla al pipeline ya construido. Adicionalmente, se puede explorar la inclusión de nuevos factores externos que puedan mejorar las predicciones: variables climáticas (lluvias, temperatura) que impactan cosechas, precios internacionales de materias primas relevantes, costos de transporte y combustible, entre otros. Estudios previos indican que incorporar datos meteorológicos puede aumentar la precisión de predicción en horizontes largos [6], por lo que combinar pronósticos climáticos con los de precios agrícolas sería un paso interesante. Otra línea futura es evaluar modelos avanzados emergentes, como las redes neuronales con mecanismos de atención o los modelos tipo Transformers diseñados para series de tiempo, que en años recientes han mostrado potencial en dominios de alta dimensionalidad. Asimismo, se podría implementar un módulo de AutoML que periódicamente pruebe nuevos modelos o re- entrene los existentes para ajustarse a posibles cambios estructurales en las series (por ejemplo, si la dinámica de precios cambia post-pandemia, que el sistema pueda recalibrarse).

En cuanto a la implementación, sería valioso desplegar AhorraYa en un entorno de producción real para recopilar retroalimentación de usuarios y monitorear su uso en el tiempo. Esto permitiría identificar qué funcionalidades adicionales podrían agregarse (por ejemplo,

comparador de precios entre mercados, notificaciones push de alertas de precios, etc.). También sería importante trabajar en estrategias de difusión para que la herramienta llegue a las comunidades que más lo necesitan, en coordinación con instituciones como Pro-Consumidor o el Ministerio de Agricultura.

En definitiva, este proyecto demuestra la viabilidad de aplicar técnicas de análisis de series temporales a un problema concreto de la vida cotidiana dominicana, proporcionando una solución tecnológica innovadora. Los objetivos planteados fueron cumplidos al integrar satisfactoriamente un conjunto heterogéneo de datos, metodologías de modelado de vanguardia y un desarrollo de software enfocado en la utilidad práctica. Si bien el contexto local presenta desafíos (datos a veces escasos, alta volatilidad por factores externos), la combinación adecuada de enfoques permitió sortearlos y entregar un producto funcional. A futuro, con más datos y refinamientos, el sistema podría volverse aún más preciso y abarcar mayor alcance. La anticipación de precios que brinda AhorraYa tiene el potencial de convertirse en una herramienta valiosa para mejorar la planificación económica tanto en los hogares como en las políticas públicas, contribuyendo a mitigar los efectos de la volatilidad en la canasta básica. Queda abierta la invitación a profundizar en esta línea de investigación, incorporando nuevos avances y adaptando la solución a otros ámbitos (por ejemplo, predicción de precios de insumos agrícolas o de energía), en pos de seguir aprovechando la ciencia de datos para el bienestar social.

Referencias:

  1. U. F. Jayatri et al., “Modelling and Predicting Volatility in Essential Food Prices Using ARIMA-GARCH Models,” Efficient: Journal of Industrial Engineering, vol. 1, no. 1, pp. 41– 64, 2024.
  2. J. G. da Silva, “Discurso sobre la volatilidad de los precios de los alimentos y el papel de la

especulación,” FAO, Roma, 6 de julio de 2012.

  1. Pro Consumidor, “¿Qué es SIDIP? – Sistema Dominicano de Información de Precios,” [En línea]. Disponible: https://proconsumidor.gob.do/que-es-sidip
  2. V. Jadhav, B. V. Chinnappa Reddy, and G. M. Gaddi, “Application of ARIMA Model for Forecasting Agricultural Prices,” J. Agr. Sci. Tech., vol. 19, pp. 981–992, 2017.
  3. Z. Yang et al., “Pork Price Prediction using LSTM Model: Based on a New Dataset,” Proc. 1st Int. Conf. Public Management, Digital Economy and Internet Technology (ICPDI), pp. 423–429, 2022.
  4. M. Elsaraiti and A. Merabet, “A Comparative Analysis of the ARIMA and LSTM Predictive Models for Wind Speed,” Energies, vol. 14, no. 20, Art. 6782, Oct. 2021.
  5. C. Xia, “Comparative Analysis of ARIMA and LSTM Models for Agricultural Price Forecasting,” Highlights in Science, Engineering and Technology, vol. 85, pp. 1032–1040, 2024.
  6. S. Hochreiter and J. Schmidhuber, “Long Short-Term Memory,” Neural Computation, vol. 9, no. 8, pp. 1735–1780, 1997.
  7. D. A. Dickey and W. A. Fuller, “Likelihood Ratio Statistics for Autoregressive Time Series

with a Unit Root,” J. Am. Stat. Assoc., vol. 74, no. 366, pp. 427–431, 1979.

  1. P. Pandit et al., “Hybrid time series models with exogenous variable for improved yield

forecasting of crops,” Sci. Reports, vol. 13, Art. 22240, 2023.

  1. A. Theofilou et al., “Predicting Prices of Staple Crops Using Machine Learning: A

Systematic Review,” Sustainability, vol. 17, no. 12, Art. 5456, 2025.

  1. K. G. Preetha et al., “Price Forecasting on a Large Scale Data Set using Time Series and Neural Network Models,” KSII Trans. Internet Info. Syst., vol. 16, no. 10, pp. 3923–3942, 2022.

Laboratorio Virtual de Robótica RobotGYM V2

Carlos Eleazar Peterson García y Miguel José Noboa Hurtado

Pontificia Universidad católica Madre y Maestra, PUCMM

Introducción:

La robótica ha experimentado un crecimiento constante tanto en el ámbito industrial como en el académico, impulsada por la necesidad de automatizar procesos, el desarrollo de nuevas tecnologías y el creciente interés por sistemas inteligentes. A medida que esta disciplina se consolida como un área clave en la ingeniería y la innovación, se vuelve crucial contar con entornos de aprendizaje accesibles, que permitan a los estudiantes experimentar, resolver y construir conocimiento desde la práctica. La educación en robótica no solo requiere herramientas físicas, sino también plataformas flexibles que faciliten el aprendizaje progresivo [1], [3].

En respuesta a esta necesidad educativa, surge el presente proyecto, desarrollado por los estudiantes Miguel José Noboa Hurtado y Carlos Eleazar Peterson García, de la carrera de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM). Bajo la supervisión de la Escuela de Computación y Telecomunicaciones y tiene como propósito principal el diseño y la mejora de un laboratorio virtual de robótica que permita a los estudiantes practicar y experimentar con conceptos esenciales de esta área, sin las barreras logísticas que a menudo impiden el acceso a equipos físicos especializados.

La motivación principal de esta iniciativa radica en los desafíos presentes en la enseñanza de robótica a nivel universitario, tales como: acceso limitado a hardware, alta demanda de recursos tecnológicos, y la necesidad de enfoques más inclusivos e interactivos. Los entornos de aprendizaje tradicionales en robótica presentan limitaciones que dificultan su implementación, especialmente en instituciones donde los recursos son escasos o deben compartirse entre múltiples grupos [2]. Ante esto, un laboratorio virtual se convierte en una herramienta poderosa para democratizar el acceso al conocimiento técnico de la robótica.

Además, la propuesta de RobotGYM V2 se alinea con tendencias globales en la transformación educativa, en las que el aprendizaje virtual, la inteligencia artificial y la simulación se integran cada vez más como componentes esenciales de la formación profesional. Existe una demanda creciente por infraestructura digital que complemente la enseñanza práctica, permitiendo a los estudiantes aprender en cualquier lugar y en cualquier momento, adaptando el ritmo de aprendizaje a sus propias necesidades [3].

El mercado y por tanto las necesidades del mercado de la robótica han aumentado a gran escala con el transcurso de los años. Se ha visto un crecimiento global desde los 59 mil millones de dólares en el 2019 a 71 mil millones en el 2023. Market Research Future estima un crecimiento exponencial en los próximos años [4]. Este crecimiento aplica para los robots industriales, colaborativos, médicos y otros. Globalmente se ve un crecimiento constante de la robótica lo cual aumenta la necesidad de personal capacitado e interesados en aprender sobre la robótica.

El interés de los estudiantes de amplio rango de edades en el área de robótica crece de forma continua a lo largo de los años. Existen varios estudios mostrando que la integración de las áreas prácticas de la robótica facilita y fomenta el crecimiento técnico e intelectual de los estudiantes en las áreas de programación e ingeniería. [5] [6] Si bien la universidad dispone de los recursos fundamentales para la enseñanza de la robótica, actualmente no cuenta con un sistema estructurado y accesible que facilite una formación introductoria en esta área. Aunque existe un club de robótica impulsado por estudiantes con interés particular en el tema, los materiales y herramientas destinados a nivelar conocimientos básicos son limitados, y la curva de complejidad para incorporarse resulta considerable. En este contexto, el presente proyecto busca responder a esta necesidad, ofreciendo una plataforma que brinde recursos accesibles para introducir a los estudiantes en el campo de la robótica.

Desarrollo y metodología:

La creación de esta plataforma se encuentra dividida en dos partes, la página web o el “frontend” y el sistema de control de robots o el “backend”. ROS (Robot Operating System) es un sistema de código abierto con gran aceptación y uso en las áreas educativas, científicas, de investigación e industria general. [7] El modelo de robots utilizado es el RSLK-MAX de Texas Instruments, un robot diseñado para el ambiente educativo. [8] Sobre todo, la universidad cuenta con una amplia cantidad de robots. Por otro lado la viabilidad de este proyecto fue estudiada por el Ingeniero Anthony Beato con el desarrollo del prototipo del robot gym [9] y existe un incentivo de utilizar los recursos existentes.

Para que los robots se comuniquen con ROS estos tienen que estar conectados en la misma red. Aunque es de gran beneficio utilizar los RSLK-MAX ya existentes de la universidad, estos no cumplen con este requerimiento. Utilizando el sistema de conexión del robot gym original de Anthony Beato, podemos interconectar una raspberry pi que funcione como puente de comunicación entre la red ROS y el robot en cuestión.

El robot tiene un conector tipo micro USB, usando un cable USB tipo A a micro USB podemos conectar el robot con una raspberry pi. Esta conexión habilita el uso de comunicación serial bidireccional. Las raspberry pis, siendo computadoras de bajo consumo pueden estar conectadas a la red de ROS y recibir llamadas de movimiento y mandar información por la red. Usando la conexión serial la raspberry pi puede mandar el mensaje al RSLK y el RSLK puede mandar información de sus sensores a la pi.

Cada Raspberry Pi ejecuta un nodo de ROS que controla su respectivo robot. En ROS, un nodo es una unidad funcional que permite la comunicación dentro del sistema. Dentro del nodo de cada Raspberry Pi se crean dos tópicos, llamados «cmd_vel» y «status».

Los tópicos en ROS funcionan como canales de comunicación entre nodos. El tópico «cmd_vel» actúa como suscriptor: recibe comandos de movimiento que indican al robot cómo debe desplazarse. Por otro lado, el tópico «status» funciona como publicador: transmite información sobre el estado de los sensores del robot, enviando datos cada vez que estos detectan un cambio.

Todos los robots están conectados a la misma red WiFi, lo que significa que comparten una única red ROS. Dentro de esta red se encuentra el controlador principal: una computadora encargada de enviar y recibir solicitudes dirigidas a los robots, así como de comunicarse con la página web. ROS proporciona un sistema de comunicación robusto y eficiente para aplicaciones robóticas; sin embargo, carece de mecanismos de seguridad fundamentales como autenticación, cifrado de datos y control de acceso, lo que lo hace vulnerable en entornos no controlados o expuestos a redes externas.

Una de las funcionalidades de ROS es la posibilidad de visualizar los tópicos activos en la red. Si una persona externa lograra acceder a esta red, podría identificar los tópicos disponibles y enviar comandos de movimiento a todos los robots, generando conflictos para los usuarios legítimos de la aplicación. Aunque el control de acceso a la red puede manejarse de forma básica mediante la configuración del router por ejemplo, restringiendo conexiones a las IPs de los robots y del controlador principal, la principal preocupación radica en la posibilidad de subir rutinas ROS desde la página web. Estas rutinas se ejecutan localmente en la computadora principal, dentro del entorno de ROS.

Para evitar que usuarios no autorizados envíen comandos a los robots, se implementa un mensaje personalizado en los tópicos cmd_vel, utilizado para validar y controlar las instrucciones de movimiento.

El tipo de mensaje estándar utilizado en ROS para el control de movimiento de robots es el mensaje Twist, el cual contiene campos para representar velocidades lineales en los ejes x, y, z y velocidades angulares en esos mismos ejes. Con el fin de abordar las limitaciones de seguridad en la comunicación, se desarrolló una versión personalizada de este mensaje denominada SecureTwist, que extiende la estructura original de Twist incorporando un campo adicional para una clave secreta. Esta clave actúa como un mecanismo de autenticación, asegurando que únicamente los mensajes con una clave válida puedan ser aceptados y ejecutados por los robots.

De esta manera, la comunicación entre el controlador principal y los robots deja de utilizar el mensaje Twist convencional y pasa a realizarse mediante SecureTwist, fortaleciendo así la integridad y autenticidad de los comandos transmitidos.

Estas llaves son generadas por la página web cuando algún usuario intenta crear una sesión o intenta controlar un robot de manera legítima en la aplicación. La página web manda estas claves a la computadora principal. Cuando la computadora recibe estas claves esto les deja saber a los robots individuales. Al recibir esta llamada, estos solicitan una copia de las llaves que les pertenecen. Es bueno notar que las llaves son individuales para cada robot, por tanto cada robot solo recibirá las llaves que le pertenecen.

Si de alguna manera un usuario intenta mandar un mensaje no legítimo o sin permiso. La única manera que este mensaje será procesado sería si tiene la clave del robot donde está mandando el mensaje. De lo contrario el sistema manda un mensaje de advertencia y no procesa la llamada. Este peligro existe y fue resuelto ya que los usuarios podrán subir sus propias rutinas, las cuales podrán correr código ROS común. Esta implementación nos da seguridad que las rutinas de los usuarios solo podrán afectar a los tópicos donde solo tengan acceso.

Esto plantea un problema en la comunicación entre la computadora principal, que opera dentro de la red local de ROS, y la página web. No se puede garantizar que ambos componentes —la página web y el controlador principal— se encuentren en la misma red, lo que introduce posibles vulnerabilidades, especialmente en cuanto a la autenticidad e integridad de los datos transmitidos. Para abordar esta situación, se utiliza gRPC como protocolo de comunicación entre la web y la computadora principal. Gracias a su alta velocidad, baja latencia y facilidad de integración con distintos lenguajes de programación, gRPC resulta una solución ideal para este proyecto [10]. Mientras que los robots se comunican entre sí mediante ROS, la web y la computadora principal intercambian datos a través de gRPC.

Esta arquitectura también resuelve el problema de la distribución segura de llaves a los robots. En un entorno puramente ROS, no existe un mecanismo confiable para enviar llaves de forma segura; sin embargo, al combinar ROS con gRPC, este proceso se vuelve más seguro y eficiente. El flujo funciona de la siguiente manera: cuando la computadora principal detecta un cambio en el conjunto de llaves o recibe nuevas, envía un mensaje mediante ROS notificando a los robots que ha habido una actualización. Al recibir esta notificación, cada robot realiza una solicitud por gRPC para obtener sus nuevas llaves personales, lo que garantiza la seguridad, privacidad y autenticidad tanto de los robots como del sistema en general.

En este laboratorio virtual de robótica, la transmisión de video en tiempo real es esencial para permitir la supervisión y el control remoto de los robots. Para lograr este objetivo, hemos implementado WebRTC (Web Real-Time Communication), una tecnología diseñada para la comunicación audiovisual entre navegadores. Una de las principales razones para utilizar WebRTC es su capacidad de ofrecer baja latencia inferior a 200 milisegundos, lo que permite una experiencia fluida. A diferencia de otras soluciones tradicionales como RTMP (Real-Time Messaging Protocol), que suelen presentar latencias de entre 2 y 5 segundos, o HLS (HTTP Live Streaming), que puede superar los 10 segundos[11].

Además de su eficiencia en el tiempo de respuesta, WebRTC es una alternativa recomendable por su compatibilidad nativa con la mayoría de los navegadores modernos y por no requerir la instalación de software adicional, lo que facilita el acceso desde distintos dispositivos. Esta tecnología también ofrece mecanismos de seguridad integrados, como el cifrado de extremo a extremo, lo cual resulta fundamental en entornos educativos y científicos donde se manejan datos sensibles.

Diagrama de Bloques:

La página web está diseñada para ofrecer una experiencia interactiva y simplificada a estudiantes, docentes y administradores. Cuenta con una página principal que proporciona noticias e informaciones generales sobre el laboratorio, los experimentos y los robots. Además, dispone de una sección dedicada al laboratorio, donde los usuarios pueden acceder a sus experimentos. Estos experimentos permiten controlar robots en tiempo real, así como grabar videos, capturar imágenes y realizar observaciones detalladas de los movimientos del robot. Por otro lado, el sistema incluye un módulo de administración exclusivo para superadministradores, desde el cual se gestionan los experimentos, usuarios y configuraciones generales de la plataforma.

Parte de los requerimientos del proyecto es el mantenimiento y calidad del software. Docker es una parte esencial del software. Este crea contenedores, ambientes controlados, donde corren las diferentes aplicaciones. La aplicación para los nodos de los robots individuales en cada raspberry pi corre en un contenedor de docker. Al igual que la aplicación en la computadora principal y la página web, todos estarán corriendo en contenedores de docker. Desplegar las aplicaciones en contenedores crea determinismo, obtener el mismo resultado sin importar factores externos, al momento de correrlas. Si en el futuro se desea intercambiar la raspberry pi por otra, o mover la posición de la computadora principal, no hay que preocuparse de la configuración interna de la aplicación, solo que las computadoras puedan usar docker.

Los contenedores de docker también son utilizados en otra parte del proyecto. Los usuarios de la aplicación pueden subir sus propias rutinas para controlar los robots. Esto implica que los usuarios necesitan un ambiente de desarrollo que imita la funcionalidad de la aplicación desplegada. El proyecto provee 2 maneras de desarrollar rutinas. La primera es mediante un contenedor de docker. Este estará conectado con un folder en la computadora del usuario, el cual puede crear una cantidad ilimitada de rutinas. El usuario puede probar si lo que hizo funcionó al subir o correr el contenedor. La segunda forma es mediante una máquina virtual. Esta también funciona como ambiente de prueba, pero es mucho más visual e interactivo que un contenedor. Esto se obtiene a cambio de rendimiento, donde la máquina virtual está garantizada a correr más lenta que un contenedor de docker. Cuando el usuario termine de crear su rutina este podrá entrar a un experimento dentro de su laboratorio, seleccionar el robot, mandar la rutina y probar como su código funciona en la vida real.

Los robots RSLK necesitan una raspberry pi para ser controlados, y estas necesitan una batería externa para que funcionen. Para que el robot sea móvil se necesita crear una estructura física donde colocar la raspberry pi y su batería. Utilizando los motores del robot y agujeros presentes podemos crear un estante o “hat” para el robot. Debido a que es un robot diferencial, que tiene 2 ruedas para moverse, el balance de este se tiene que tomar en cuenta al momento de agregar más peso encima de él. La raspberry pi y la batería se posicionan entre las ruedas y el rodillo esférico, la bola trasera que ayuda a balancear el robot. Este hat está hecho de paletas y palillos de madera. Son fáciles de remover si es necesario y de bajo costo. Para prevenir que las raspberry y la batería se caigan durante movimiento, estas están soportadas por velcro adhesivo.

(Figura 1) Robot RSLK MAX básico

(Figura 2) Hat para el robot RSLK MAX

(Figura 3) Unificación del hat y el robot

(Figura 4) El hat mas el robot con el peso de la batería y raspberry pi.

Resultados:

El laboratorio virtual Robot Gym permite a los estudiantes ejecutar experimentos robóticos en tiempo real a través de una interfaz web, eliminando la dependencia directa del hardware físico así disminuyendo los requerimientos técnicos para el aprendizaje de robótica. Esta logra una integración estable entre ROS y gRPC, lo que facilita una comunicación segura y eficiente entre los robots físicos y la plataforma web. Además, esta incorpora una tecnología de transmisión de video en tiempo real utilizando WebRTC, con latencias menores a 200 ms, optimizando así la experiencia del usuario durante el control remoto de los robots.

La plataforma es desplegada en su totalidad mediante contenedores Docker, lo que asegura entornos reproducibles y fácilmente escalables. Este enfoque permite una gestión más efectiva de las aplicaciones tanto en Raspberry Pi como en el servidor principal.

Se comprobó que el sistema de autenticación basado en mensajes SecureTwist es efectivo al prevenir accesos no autorizados de los robots. Cada robot responde exclusivamente a comandos asociados con su llave única, lo que asegura un entorno seguro incluso al permitir la carga de rutinas creadas por los usuarios. Esto demuestra la viabilidad técnica del laboratorio virtual, fundado en un base sólida para futuras expansiones.

Conclusiones:

El desarrollo de RobotGYM V2 representa un avance significativo en la modernización de la enseñanza de la robótica en el contexto universitario, proporcionando un entorno virtual que replica de manera eficaz los desafíos del control robótico físico. Esta solución responde a la creciente necesidad de plataformas accesibles, seguras y prácticas para el aprendizaje autónomo en el área de robótica.

La integración de tecnologías como ROS, gRPC y WebRTC permite superar barreras técnicas relacionadas con la conectividad, la latencia y la seguridad, aspectos fundamentales para una experiencia educativa y remota de calidad. La modularidad del sistema facilita su mantenimiento y escalabilidad, lo cual le permite adaptarse a futuros cambios tecnológicos o tipos de robots.

Desde una perspectiva pedagógica, el laboratorio fomenta el desarrollo de las habilidades técnicas mediante la práctica directa y la experimentación, introduciendo nuevos conceptos no conocidos en clases formales o reforzando los ya existentes. Además, el hecho de que los estudiantes puedan subir y correr sus propias rutinas incentiva la creatividad, la autonomía y el pensamiento crítico y lógico.

En conclusión, el Robot Gym v2 no solo aborda una necesidad educativa, sino que establece un precedente para futuras iniciativas de laboratorios virtuales en otras áreas del aprendizaje e ingeniería. Su diseño abierto reproducible y seguro lo posiciona como una herramientas versátil que puede extenderse más allá del aula tradicional, promoviendo una educación de robótica más dinámica, accesible y sencilla, preparada para los retos del futuro.

(Figura 5) Página web, control manual del robot

Referencias:

[1] J. Smith, Introduction to Robotics and Automation, 3rd ed. New York, NY, USA: Springer, 2021.

[2] T. Lam, “Advancing Robotics Education Challenges Opportunities,” Botificial Intelligence Society (HK), 2025. https://www.academia.edu/127642699/Advancing_Robotics_Education_Challenges_Opportunities (accessed Apr. 03, 2025).

[3] M. Vasou, Georgios Kyprianou, Angelos Amanatiadis, and S. A. Chatzichristofis, “Transforming Education with AI and Robotics: Potential, Perceptions, and Infrastructure Needs,” Lecture notes in business information processing, pp. 3–18, Jan. 2025, doi: https://doi.org/10.1007/978-3-031-81322-1_1.

[4] R. Melissa, “Robots Among Us – The Global Robotics Market Growing Rapidly – Statzon Blog,” Statzon.com, Dec. 04, 2024. http://statzon.com/insights/global-robotics-market-growing-rapidly (accessed Jul. 21, 2025).

[5] P. Zamora, A. Lozada, J. Buele, and Fátima Avilés-Castillo, “Robotics in higher education and its impact on digital learning,” Frontiers in Computer Science, vol. 7, Jun. 2025, doi: https://doi.org/10.3389/fcomp.2025.1607766.

[6] F. Ouyang and W. Xu, “The effects of educational robotics in STEM education: a multilevel meta-analysis,” International Journal of STEM Education, vol. 11, no. 1, Feb. 2024, doi: https://doi.org/10.1186/s40594-024-00469-4.

[7] D. Portugal, R. P. Rocha, and J. P. Castilho, “Inquiring the robot operating system community on the state of adoption of the ROS 2 robotics middleware,” International Journal of Intelligent Robotics and Applications, Oct. 2024, doi: https://doi.org/10.1007/s41315-024-00393-4.

[8] “Texas Instruments Robotics System Learning Kit User guide Robot Systems Learning Kit (TI-RSLK) User Guide 2 Texas Instruments Robotics System Learning Kit: The Solderless Maze Edition SEKP166.” Accessed: Apr. 02, 2025. [Online]. Available: https://www.ti.com/lit/ml/sekp166/sekp166.pdf

[9] A. Beato,»ROBOT GYM DE ACCESO REMOTO CON SISTEMAS EMBEBIDOS», Ago 2024.

[10] R. Le, “gRPC vs REST speed comparison,” SHIFT ASIA | Dev Blog, Dec. 04, 2023. https://shiftasia.com/community/grpc-vs-rest-speed-comparation/

[11] Santos-González, I. & Rivero, Alexandra & Molina-Gil, Jezabel & Caballero-Gil, Pino. (2017). Implementation and Analysis of Real-Time Streaming Protocols. Sensors. 17. 10.3390/s17040846.

Detectar un ACV con IA: una herramienta que puede salvar vidas

A poster of a brain

AI-generated content may be incorrect.

Pontificia Universidad Católica Madre y Maestra, PUCMM

Emely Gómez y Justin Quijada

Introducción

Cada minuto que pasa durante un accidente cerebrovascular representa una pérdida neuronal irreversible: aproximadamente 1.9 millones de neuronas mueren cada 60 segundos si no se interviene a tiempo. Esta estadística, respaldada por estudios clínicos, fue el punto de partida para desarrollar un sistema de diagnóstico asistido por inteligencia artificial. En un país como el nuestro, República Dominicana, donde muchos hospitales enfrentan limitaciones en cuanto a disponibilidad de especialistas en neuroimagen, es común que los pacientes no sean diagnosticados en la ventana de tiempo crítica. Por eso, este proyecto propone una solución que no solo automatiza el análisis de imágenes médicas, sino que también actúa como una segunda opinión confiable, rápida y consistente.

La iniciativa fue desarrollada por Emely Gómez y Justin Quijada, estudiantes de Ingeniería en Ciencias de la Computación en la PUCMM, bajo la mentoría del profesor José Luis Alonso. La idea nació al observar una brecha recurrente en hospitales y clínicas: el proceso de interpretar una resonancia magnética (específicamente DWI) depende casi exclusivamente del criterio de un radiólogo experimentado, cuya carga de trabajo muchas veces impide un análisis exhaustivo. Nuestra propuesta introduce un modelo de deep learning entrenado con imágenes reales para detectar señales de ACV de forma automática, acompañada de una interfaz visual pensada para el médico.

Este proyecto se desarrolló en colaboración con la Clínica Materno Infantil en Santiago de los Caballeros, que facilitó un conjunto de imágenes DWI reales, garantizando su anonimización y calidad clínica. Asimismo, contamos con la asesoría de la Dra. Esmirna Y. Farington, especialista en neurología, quien orientó la validación clínica y los criterios diagnósticos que guiaron el desarrollo del sistema.

Cuando cada segunda cuenta: la urgencia de detectar un ACV

Los accidentes cerebrovasculares (ACV), también conocidos como strokes, son una de las primeras causas de discapacidad y muerte en el mundo. Se estima que cada año más de 15 millones de personas sufren un ACV, y al menos un tercio queda con secuelas neurológicas permanentes. En República Dominicana, como en muchos otros países en vías de desarrollo, los recursos de diagnóstico avanzado suelen concentrarse en grandes ciudades, lo que complica la atención de pacientes en regiones rurales o con menor infraestructura.

El ACV se presenta en dos formas principales: isquémico, cuando un coágulo bloquea el flujo sanguíneo hacia el cerebro, y hemorrágico, cuando un vaso sanguíneo se rompe y sangra dentro del tejido cerebral. Ambos requieren atención médica inmediata, pero el isquémico —que representa casi el 85% de los casos— puede beneficiarse significativamente si se detecta dentro de las primeras tres horas.

El problema radica en que los síntomas pueden ser sutiles o confundirse con otras condiciones, y que la herramienta más efectiva para detectarlos a tiempo —la resonancia magnética ponderada por difusión (DWI)— requiere interpretación experta, la cual no siempre está disponible.

En muchos hospitales, la carga de trabajo, la fatiga del personal y la falta de tecnología hacen que una imagen DWI se quede sin ser evaluada a tiempo. A esto se suma la variabilidad interobservadora, donde dos médicos podrían llegar a conclusiones distintas ante la misma imagen. Esta subjetividad, aunque natural, representa una amenaza al tratamiento oportuno. Por ello, vimos en la IA no una forma de sustituir al médico, sino de ofrecer una herramienta que aporte velocidad, precisión y objetividad al análisis.

Lo que se ha hecho antes: una base para mejorar

Diversos estudios han respaldado la efectividad del uso de modelos de aprendizaje profundo en la detección automatizada de accidentes cerebrovasculares. En su investigación, Mahmud et al. (2022) desarrollaron un sistema basado en redes neuronales convolucionales (CNN) personalizadas, denominado OzNet, diseñado para clasificar imágenes médicas de tomografía computarizada (CT) en categorías relacionadas con ACV. El modelo logró una precisión del 98.4 %, con un AUC de 0.99, al combinar técnicas de extracción automática de características con algoritmos supervisados como Naïve Bayes y SVM. Esta investigación valida el enfoque de aplicar CNN especializadas para tareas médicas críticas, reforzando la propuesta de nuestro proyecto, que utiliza modelos pre-entrenados adaptados para el análisis de imágenes por resonancia DWI.

Una IA al servicio del diagnóstico médico

Frente a las limitaciones del diagnóstico clínico tradicional de ACV, desarrollamos un sistema de apoyo médico basado en técnicas avanzadas de inteligencia artificial (IA), específicamente deep learning, capaz de analizar imágenes por resonancia magnética DWI y emitir una predicción automatizada sobre la presencia o ausencia de un accidente cerebrovascular. Esta solución se concibió no como un reemplazo del médico especialista, sino como una herramienta complementaria que actúe como una segunda opinión objetiva, rápida y reproducible, especialmente útil en centros con recursos limitados o alta carga asistencial.

El núcleo del sistema es un modelo de red neuronal convolucional (CNN) orientado a la clasificación de imágenes médicas. En la fase inicial se evaluaron varias arquitecturas avanzadas, entre ellas EfficientNetB3 y ResNet50, por su popularidad en tareas de visión computacional. Sin embargo, DenseNet121 demostró un desempeño superior en términos de estabilidad, precisión y capacidad para capturar patrones sutiles en imágenes DWI, lo que motivó su elección como modelo definitivo. Para maximizar su efectividad, se aplicó transfer learning, reutilizando pesos preentrenados en ImageNet y ajustando las capas superiores mediante fine-tuning, junto con regularización y técnicas de optimización para mejorar la generalización.

Para facilitar la interacción con el modelo, se desarrolló una interfaz gráfica de usuario utilizando la plataforma Streamlit, lo que permitió construir una aplicación web ligera, intuitiva y compatible con entornos hospitalarios. Esta interfaz permite cargar imágenes médicas, visualizar la predicción del sistema (stroke / no stroke), consultar métricas de confianza como el AUC y el F1-score, y observar mapas de activación generados con Grad-CAM, que resaltan las zonas que el modelo considera más relevantes para su decisión.

FIGURA 1: Diagrama de procesos

LINK: https://drive.google.com/file/d/1JGOIhBGLqtvdsAYQPbXTXdNo6e5YkAsU/view?usp=shar ing

A nivel técnico, la arquitectura del sistema no se limita únicamente al modelo predictivo, sino que representa una arquitectura completa que abarca desde el procesamiento inicial de la imagen hasta la generación de un informe visual interpretativo. Al cargar una imagen DWI, esta pasa por una etapa de preprocesamiento donde se normaliza su escala de grises, se redimensiona a una resolución estándar y se convierte en un tensor compatible con el modelo.

Posteriormente, la imagen procesada se alimenta a la red neuronal seleccionada —DenseNet121, EfficientNetB3 o ResNet50— la cual emite una predicción binaria sobre la presencia de un stroke. Esta predicción, junto con los mapas de activación generados por Grad-CAM, se traduce en una visualización comprensible para el usuario médico, facilitando tanto el diagnóstico como la validación clínica.

Una de las prioridades fue garantizar que el modelo no opere como una caja negra. A diferencia de otros modelos de IA que operan como cajas negras, este proyecto integró desde el inicio técnicas de explicabilidad para evitar decisiones automatizadas sin justificación. Gracias a Grad-CAM, el médico no solo recibe una respuesta del modelo, sino también una imagen con las áreas cerebrales destacadas que influyeron en la decisión. Esta capacidad es fundamental en entornos clínicos, donde cada diagnóstico debe estar respaldado por evidencia visual o estadística. Al promover la transparencia, se fortalece la aceptación del sistema dentro del equipo médico y se reducen las barreras éticas para su implementación.

Además, se integraron múltiples estrategias de preprocesamiento y aumento de datos para mejorar la robustez del sistema ante imágenes de diferentes formatos, calidades y condiciones clínicas. Esto incluyó normalización, redimensionamiento, simulación de variaciones clínicas mediante transformaciones visuales, y generación de imágenes sintéticas. Esta etapa fue clave para asegurar que el sistema pudiera adaptarse a diferentes entornos médicos reales.

Cómo diseñamos una IA confiable para imágenes médicas

El diseño de una herramienta de apoyo clínico basada en IA requiere mucho más que un buen modelo de predicción: implica entender el flujo clínico, las limitaciones tecnológicas de los centros médicos y los criterios éticos para construir confianza en un sistema automatizado. Por esta razón, el primer paso fue construir una base sólida de datos con imágenes reales de resonancia magnética DWI. Estas imágenes fueron proporcionadas por la Clínica Materno Infantil, cuidadosamente anonimizadas y validadas por profesionales del área médica. Esta etapa fue fundamental, ya que los modelos de aprendizaje profundo dependen críticamente de la calidad y la diversidad del conjunto de entrenamiento para aprender patrones fiables.

Uno de los mayores desafíos fue el desequilibrio de clases, es decir, la diferencia en la cantidad de imágenes de pacientes con ACV versus sin ACV. Este es un problema común en datasets médicos, que tiende a sesgar los modelos hacia la clase mayoritaria. Para enfrentarlo, se aplicaron técnicas de aumento de datos (data augmentation) y se generaron imágenes sintéticas utilizando transformaciones controladas. Estas incluían rotación, zoom, variación de contraste y simulaciones de artefactos clínicos comunes, como ruido de escáner. Estas estrategias ayudaron a expandir el conjunto de datos sin comprometer la veracidad clínica.

La arquitectura del modelo se basó en DenseNet121, elegida por su capacidad para reutilizar características entre capas densamente conectadas, reduciendo el riesgo de degradación del gradiente y maximizando la eficiencia en el aprendizaje. Inicialmente, se exploraron arquitecturas como ResNet50 y EfficientNetB3, pero tras múltiples pruebas comparativas, DenseNet121 mostró un mejor equilibrio entre desempeño, estabilidad y velocidad de convergencia. En lugar de entrenar desde cero, se aplicó transfer learning para aprovechar pesos previamente entrenados en ImageNet, adaptándolos a las imágenes DWI mediante fine-tuning en las capas superiores.

Para entrenar cada modelo, se utilizó validación cruzada estratificada por grupo de paciente, lo que garantiza que las imágenes del mismo paciente no aparezcan simultáneamente en los conjuntos de entrenamiento y validación. Esta estrategia evita el sobreajuste y simula un escenario clínico real, donde el modelo debe predecir correctamente imágenes de nuevos pacientes nunca antes vistos por la red. Además, se aplicó early stopping y regularización mediante dropout para controlar el sobreajuste.

La capa final de nuestro sistema fue el desarrollo de una interfaz amigable e intuitiva, pensada para ambientes clínicos reales. Para ello se utilizó Streamlit, una plataforma de desarrollo rápido de aplicaciones web en Python. La aplicación permite cargar imágenes DWI, recibir la predicción del modelo, visualizar métricas como F1-score y AUC, y observar mapas explicativos. Esta solución fue diseñada para poder ejecutarse de forma local en equipos con capacidad limitada, sin necesidad de conexión a internet, garantizando la portabilidad a centros rurales.

Desde el punto de vista técnico, la arquitectura completa sigue un flujo estandarizado: la imagen pasa por una etapa de preprocesamiento (normalización, redimensionamiento y conversión a tensor), luego es analizada por el modelo seleccionado, y finalmente se generan los mapas de activación y predicción. Este flujo fue modularizado y empaquetado para facilitar su integración en futuras soluciones hospitalarias o sistemas de archivo de imágenes médicas (PACS).

Figura 2: mapa conceptual del proyecto.

LINK:

https://drive.google.com/file/d/1Izt-uz44T2Bj4L9wD-K47jTefIXi1OM0/view?u sp=sharing

En paralelo, se implementaron funciones de monitorización del desempeño durante el entrenamiento, incluyendo seguimiento de curvas de aprendizaje y comparación de modelos. Esta información fue crucial para seleccionar el modelo con mejor equilibrio entre sensibilidad y especificidad, parámetros vitales en medicina donde los falsos negativos pueden costar vidas. Además, se exploró el uso de métricas personalizadas más allá de la precisión.

Resultados:

Los resultados que se presentan corresponden a DenseNet121, la arquitectura que, tras un análisis comparativo con modelos como ResNet50 y EfficientNetB3, demostró el mejor equilibrio entre precisión y estabilidad. Durante la validación cruzada (5-Fold CV), este modelo alcanzó un desempeño sobresaliente en métricas críticas como AUC y F1-score. Posteriormente, en el conjunto de prueba, mantuvo esta robustez, confirmando su capacidad para generalizar en escenarios clínicos reales:

Métrica Valor promedio
Accuracy 0.8539
Precision 0.8222
Recall 0.8368
Specificity 0.8487
F1-Score 0.8288
AUC 0.9146
FNR 0.1632

Estos resultados indican que el sistema mantiene una alta capacidad discriminativa (AUC ≈ 0.91), reduciendo falsos negativos, lo cual es esencial para no omitir casos de ACV. La combinación de recall elevado (0.8368) y specificity (0.8487) confirma que el modelo responde bien tanto a imágenes con ACV como a aquellas sin la condición.

Curvas de entrenamiento y validación:

Se observó que las métricas de entrenamiento convergieron rápidamente, mientras que la validación se mantuvo estable, lo que indica un buen ajuste sin sobreentrenamiento significativo.

A collage of graphs

AI-generated content may be incorrect.

Figura 3. Curvas de aprendizaje de DenseNet121: Accuracy, Loss, AUC y F1-score.

Evaluación en el conjunto de prueba

En la fase de prueba, el modelo DenseNet121 demostró una notable capacidad de generalización, manteniendo un rendimiento alineado con lo observado en la validación cruzada. La exactitud global (Accuracy = 86.58%) confirma que el sistema puede clasificar correctamente la mayoría de las imágenes DWI, incluso en escenarios no vistos durante el entrenamiento. Sin embargo, en contextos médicos, la precisión global no es suficiente: la diferencia entre un falso negativo y un falso positivo puede significar la vida del paciente o una intervención innecesaria.

Por ello, es fundamental analizar otras métricas:

  • Recall = 86.25%, lo que indica que el modelo detecta la mayoría de los casos reales de ACV, reduciendo el riesgo de omitir diagnósticos críticos.
  • Precision = 80.20%, un valor que refleja un buen equilibrio, aunque muestra que todavía existe margen para reducir falsos positivos.
  • F1-Score = 83.11%, que combina sensibilidad y precisión, ofreciendo una medida robusta del desempeño general.
  • Finalmente, el AUC de 0.9430 es particularmente relevante: significa que, ante cualquier umbral, el modelo conserva una alta capacidad para discriminar entre casos positivos y negativos. En la práctica clínica, esto se traduce en flexibilidad para ajustar el umbral según las prioridades médicas (por ejemplo, priorizar la detección temprana frente a la minimización de falsos positivos)

Figura 4. Matriz de confusión y curva ROC en el conjunto de prueba.

Ejemplos visuales de predicciones

Uno de los mayores desafíos en la implementación clínica de IA es la confianza del usuario médico. Para abordar esta necesidad, el sistema no solo devuelve un resultado binario (stroke / no stroke), sino que también ofrece ejemplos visuales de las predicciones realizadas, acompañadas de la probabilidad asociada. Esto permite al radiólogo no depender ciegamente de la tecnología, sino contrastar la salida del modelo con su propio juicio.

Para reforzar la confianza clínica, el sistema muestra la imagen DWI analizada junto con la clase predicha y su probabilidad asociada.

Figura 5. Ejemplos de predicciones sobre imágenes DWI, con etiqueta real, predicción y probabilidad.

Este nivel de interpretabilidad no es un detalle estético, sino un pilar ético y práctico: evita que la IA funcione como una “caja negra” y facilita la toma de decisiones compartidas, donde el modelo actúa como un asistente y no como un sustituto. Además, las probabilidades asociadas permiten configurar umbrales adaptativos en función del riesgo clínico, ofreciendo un control adicional en entornos donde cada minuto cuenta.

Conclusión:

Este proyecto marca un paso importante hacia la integración de la inteligencia artificial en entornos clínicos donde el tiempo y la precisión son determinantes. Si bien en la etapa inicial se evaluaron arquitecturas como ResNet50 y EfficientNetB3, DenseNet121 demostró ser la opción más adecuada gracias a su estructura densa, que optimiza la propagación del gradiente y la reutilización de características. Esta arquitectura alcanzó un AUC de 0.9430 y un F1-score superior al 83%, confirmando su capacidad para detectar ACV en imágenes DWI con alta confiabilidad y ofreciendo una base sólida para futuras aplicaciones clínicas.

Los resultados obtenidos evidencian un modelo sólido, con un AUC superior al 91% y un balance adecuado entre sensibilidad y especificidad, lo que permite confiar en su capacidad para detectar un ACV incluso en condiciones clínicas complejas. Más allá de las métricas, la verdadera fortaleza del sistema radica en su diseño explicable: herramientas como Grad-CAM aportan una transparencia que refuerza la confianza médica, un aspecto imprescindible cuando se trata de decisiones que afectan directamente la vida del paciente.

Sin embargo, ningún avance tecnológico está exento de desafíos. La dependencia de datos limitados y la necesidad de validación multicéntrica siguen siendo tareas pendientes, al igual que la adaptación para entornos con recursos reducidos. Estas limitaciones, lejos de ser un obstáculo, representan oportunidades para la evolución futura del proyecto: integración con sistemas PACS, optimización para dispositivos edge y validación en tiempo real son metas alcanzables que acercarán esta herramienta a su adopción clínica definitiva.

En última instancia, la relevancia de este trabajo trasciende lo técnico. Supone una reflexión sobre el papel de la IA en la medicina moderna: no como un reemplazo del juicio humano, sino como un aliado que aporta velocidad, consistencia y objetividad. Si cada minuto cuenta durante un ACV, cada innovación que reduzca ese tiempo es, en esencia, una herramienta que salva vidas.

Referencias:

  1. M. U. Emon, M. S. Keya, T. I. Meghla, M. M. Rahman, M. S. Al Mamun, and M. S. Kaiser, “Performance Analysis of Machine Learning Approaches in Stroke Prediction,” in Proc. 4th Int. Conf. Electron. Commun. Aerosp. Technol. (ICECA), Jan. 2020, pp. 1464–1469, doi: 10.1109/ICECA49313.2020.9297525
  2. C. Shorten and T. M. Khoshgoftaar, “A Survey on Image Data Augmentation for Deep Learning,” Journal of Big Data, vol. 6, no. 1, p. 60, 2019, doi: 10.1186/s40537-019-0197-0.
  3. M. Tan and Q. V. Le, “EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks,” in Proc. 36th Int. Conf. Mach. Learn. (ICML), Jun. 2019, pp. 10691–10700.
  4. R. R. Selvaraju, M. Cogswell, A. Das, R. Vedantam, D. Parikh, and D. Batra, “Grad-CAM: Visual Explanations from Deep Networks via Gradient‑Based Localization,” in Proc. IEEE Int. Conf. Comput. Vis. (ICCV), Venice, Italy, Oct. 2017, pp. 618–626.
  5. Streamlit Documentation, Streamlit. [Online]. Available: https://docs.streamlit.io/. [Accessed: Jul. 16, 2025].
  6. J. M. Johnson and T. M. Khoshgoftaar, “Survey On Deep Learning With Class Imbalance,” J. Big Data, vol. 6, no. 1, p. 27, 2019, doi: 10.1186/s40537-019-0192-5
  7. J. Yosinski, J. Clune, Y. Bengio, and H. Lipson, “How transferable are features in deep neural networks?,” in Proc. Adv. Neural Inf. Process. Syst., Montreal, QC, Canada, Dec. 2014, pp. 3320–3328.
  8. R. R. Selvaraju, M. Cogswell, A. Das, R. Vedantam, D. Parikh, and D. Batra, “Grad‑CAM: Visual Explanations from Deep Networks via Gradient‑Based Localization,” in Proc. IEEE Int. Conf. Comput. Vis. (ICCV), Venice, Italy, Oct. 2017, pp. 618–626.
  9. J. Amann et al., “Explainability for artificial intelligence in healthcare: a multidisciplinary perspective,” BMC Medical Informatics and Decision Making, vol. 20, no. 310, 2020, doi: 10.1186/s12911-020-01332-6.
  10. A. B. Arrieta et al., “Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI,” Information Fusion, vol. 58, pp. 82–115, 2020, doi: 10.1016/j.inffus.2019.12.012.
  11. M. Sajjad et al., “Multi-grade brain tumor classification using deep CNN with extensive data augmentation,” Journal of Computational Science, 2019, doi:

10.1016/j.jocs.2019.05.003.

  1. X. Lu et al., “Deep learning for detecting acute stroke on diffusion-weighted imaging: A systematic review and meta-analysis,” Journal of Stroke and Cerebrovascular Diseases, 2022, doi: 10.1016/j.jstrokecerebrovasdis.2022.106430.

Plataforma para Monitoreo de Infraestructura Eléctrica y Vegetación 2.0

Enel Distribución despejó cerca de 70 mil árboles cercanos a la red  eléctrica en los últimos 6 meses - País Circular

Ruddy Gabriel Gómez Tejada Y Gabriel D. Jesús Reinoso Javier

Pontificia Universidad Católica Madre y Maestra, PUCMM

Introducción:

La energía eléctrica se ha convertido en una pieza fundamental y clave para el funcionamiento de nuestra sociedad. Como bien sabemos, no podemos acceder a este servicio sin las líneas de tendido eléctrico seguras que transporten esta energía a través del país. Sin embargo, uno de los fenómenos que más suelen afectar la estabilidad de este sistema, es la presencia de vegetación cercana a estas líneas. Por esta razón, es necesario un sistema automatizado para monitorear el estado de la vegetación cercana a los circuitos eléctricos y que mida el nivel de peligrosidad que esta presenta con el fin de ser utilizado por las autoridades pertinentes para tomar las medidas necesarias de mantenimiento.

Definición de la Problemática:

Cuando las ramas o árboles crecen demasiado cerca o entran en contacto con los cables, pueden provocar cortocircuitos, desconexiones e incluso incendios o electrocuciones. Durante fenómenos climáticos como: tormentas, cientos fuertes o lluvias intensas, la probabilidad de que la vegetación caiga sobre el tendido eléctrico aumenta considerablemente, ocasionando daños estructurales y prolongando los cortes de energía [1]. No obstante, la Ley General de Electricidad No. 125-01 y su Reglamente de Aplicación establecen la responsabilidad de las empresas distribuidoras de realizar mantenimientos periódicos de la vegetación cercana a estas líneas para garantizar la seguridad y calidad del servicio [2].

Proyectos Anteriores:

El proyecto de N. Nakao, M. Vásquez “Levantamiento Georreferenciado de Vegetación Adyacente a Líneas Eléctricas”, PUCMM, 2024, surge como una solución directa al problema de la interferencia de la vegetación con el tendido eléctrico. Este sistema se basa en una serie de procesos en el que el usuario debe cargar imágenes del área tomadas por un dron, junto con los datos del circuito eléctrico. Posteriormente, se utiliza un nodo de procesamiento para analizar las imágenes, generar resultados preliminares y luego volver a cargarlos en la plataforma para su visualización y análisis. Si bien este sistema representa un avance muy importante, presenta limitaciones como la generación de falsos positivos y lo manual que es todo procedimiento.

El proyecto Analytics4Vegetation aborda esta problemática utilizando tecnologías más avanzadas. Este sistema emplea sensores LiDAR montados en helicópteros o drones para mapear con alta precisión la vegetación y su proximidad a las líneas eléctricas. Además, incorpora algoritmos predictivos que permiten anticipar el crecimiento de la vegetación y generar alertas tempranas sobre posibles riesgos de interferencia con la red eléctrica [3].

Solución Propuesta:

Para resolver las limitaciones del proyecto de “Levantamiento Georreferenciado de Vegetación Adyacente a Líneas Eléctricas”, del procedimiento manual que este posee y mejorar la precisión del análisis de vegetación cercana a líneas eléctricas, se propone una plataforma web tipo Sistema de Información Geográfica (SIG) [4] que automatiza y centraliza todas las etapas del proyecto. Esta plataforma permitirá cargar imágenes capturadas por drones, enviarlas automáticamente a un servidor que tendrá un módulo especializado para generar ortomosaicos y nubes de puntos, y posteriormente realizar el análisis de la vegetación detectada en función de su cercanía real a los circuitos eléctricos.

El sistema se integrará con una base de datos donde se guardarán los circuitos analizados, arboles y vegetación detectada, así como las evaluaciones hechas a los circuitos en forma de capas espaciales. En el sistema se aceptará como parámetros de realizar el análisis la capa de circuitos y las imágenes tomadas, esto con el fin de un desarrollo mas realista y evitando el uso de un algoritmo para generar estos circuitos en la imagen. A través de esta solución, solo se procesará la vegetación que represente un peligro real para los circuitos, optimizando recursos y reduciendo falsos positivos. Esto se hará mediante un algoritmo que recorte la imagen, limitándola solo donde se encuentra el circuito georreferenciado para evitar procesar toda la imagen sin necesidad.

Además, la plataforma generará reportes descargables, mantendrá un historial de evaluaciones por sectores, y permitirá comparar cambios luego de intervenciones como podas de árboles. Esta solución busca hacer más eficiente el monitoreo de la red eléctrica, facilitando la toma de decisiones para el mantenimiento preventivo y correctivo.

Metodología:

Para el desarrollo del proyecto se propuso el uso del siguiente flujo de trabajo:

Ilustración 1. Diagrama Representativo del Procesamiento.

La interfaz web de la plataforma tendrá un panel para iniciar el procesamiento de las imágenes y el circuito. El usuario estará supuesto a subir dos archivos comprimidos: uno con los datos de los circuitos en formato de capas espaciales (shp, shx, dbf, cpg, sbx) y el otro con las imágenes del área de circuito tomadas por el dron. La aplicación procederá a validar estos archivos de que sean correctos para el procesamiento y luego los enviará como solicitud REST a un servidor que contendrá diferentes módulos que servirán para automatizar el procesamiento.

A parte del código de procesamiento, en el servidor se tendrán tres sistemas fundamentales en el funcionamiento del flujo. El primero es el Node ODM que es una herramienta utilizada para procesar imágenes tomadas por drones y generar productos como ortomosaicos, nubes de puntos, entre otros [5]. El siguiente es Geoserver la cual es una plataforma que permite compartir, visualizar y editar datos geoespaciales a través de la web [6]. El ultimo sistema sería una base de datos para almacenar las capas y todo registro de la aplicación y así tener persistencia.

Los módulos y sus responsabilidades son las siguientes.

1. Módulo de control.

  1. Maneja la comunicación entre la aplicación y el servidor.
  2. Recibe los archivos con los circuitos y las imágenes enviadas por el usuario, los extrae y válida que tenga los archivos necesarios para el procesamiento.
  3. Envía las imágenes al Nodo ODM para que este las procese y genere el ortomosaico y la nube de puntos para el análisis.
  4. Envía la capa de circuitos, el ortomosaico y la nube de puntos al módulo de procesamiento CV.
  5. Módulo de Procesamiento de Visión Computacional.
    1. Maneja todo el procesamiento de análisis de la ortofoto y la nube de puntos.
    2. Unifica el circuito con la ortofoto georreferenciada con el fin de que se sepa dónde se recortara la imagen para realizar el análisis en esta.
    3. Se recorta la imagen para tener solamente el área del circuito para ser analizada.
    4. Se convierte la ortofoto en formato de vectores con el fin de ser manejadas computacionalmente.
    5. Se calcula el Índice de Verdor Triangular para poder sacar la capa verde de la ortofoto.
    6. Se crea una imagen binaria en base a la ortofoto para poder aplicar los filtros.
    7. Se aplica un filtro morfológico para segmentar la vegetación de la imagen.
    8. Se detectan los contornos como medida adicional para obtener vegetación.
    9. En la vegetación, mediante un algoritmo se detectan los centroides para detectar la ubicación de los árboles en la vegetación.
    10. Se utiliza el algoritmo Flood Fill en conjunto de los centroides para identificar y rellenar de forma eficiente las áreas vegetativas en la imagen.
    11. Se genera una máscara de vegetación utilizándolos contornos resultantes de Flood Fill.
    12. Se analiza detalladamente la altura de la vegetación cercana al circuito, teniendo en cuenta los polígonos y los vértices que los definen.
    13. Finalmente, cada segmento del circuito se clasifica según un índice de riesgo basado en dos factores: la proximidad de la vegetación y la altura de esta en relación con el circuito.
    14. Se envían las capas de circuitos, árboles, vegetación y el análisis realizado al módulo de almacenamiento.
  6. Módulo de Almacenamiento y Registro.
      1. Se convierte el análisis realizado en un objeto serial para ser almacenado en la base de datos. Básicamente, sería el mismo circuito con cada segmento indexado según su nivel de riesgo.
      2. Se crea un origen de datos en Geoserver para almacenar la ortofoto y poder mostrarla en el mapa de la aplicación.
      3. Se crea un objeto que relacione la ruta donde esta almacenada la imagen en Geoserver con el sector analizado y la fecha del análisis para poder filtrar esa imagen y mostrarla en el mapa desde la aplicación.
      4. Guardar los datos de la imagen, las capas de vegetación, árboles, circuitos y los segmentos analizados en la base de datos.

El usuario debe ser capaz de ver los circuitos, árboles, vegetación y el análisis realizado, filtrándolo por el nombre del sector analizado en el mapa de la aplicación. Estas capas son traídas en formato WMS [7] desde Geoserver para que las capas se puedan visualizarse en el mapa de forma casi instantánea. De igual forma, se deben descargar reportes desde la aplicación de los segmentos analizados según el usuario lo desee.

Resultados Obtenidos:

Con las imágenes tomadas por el dron en el proyecto anterior, se utilizaron como pruebas enviándolas al servidor de procesamiento. En conjunto con estas, se usó una capa de circuitos referente al área en la que se tomaron las imágenes. Para identificar el procesamiento, los datos que se envían se relacionan a una tarea creada por la aplicación, que se almacena en la base de datos y el ID de la misma es enviada al servidor de procesamiento para tener una constancia del estado del flujo.

Ilustración 2. Panel de Inicio del Procesamiento en la Plataforma.

El tiempo de procesamiento depende de la cantidad de imágenes enviadas. En este caso se enviaron 45 imágenes y todo el procedimiento tardó aproximadamente de 5-8 minutos. Podemos verificar que si se enviaron los datos revisando la dirección del nodo ODM y el estado de la tarea realizada.

Ilustración 3. Estado del Procesamiento de las Imágenes en el Node ODM.

Podemos monitorear el estado de la tarea en la lista de tareas realizadas en el panel de procesamiento, el cual se actualiza cada vez que los datos pasan de una fase a otra o si ocurre un erro durante el proceso. Una vez terminado el proceso podemos ir al area del mapa para verificar que los datos se almacenaron correctamente en la base de datos y que se traigan las capas desde Geoserver correctamente.

Ilustración 4. Mapa de la Plataforma.

En el campo de sector se traen todos los sectores que se tienen guardados en la base de datos, los cuales representan el área de análisis. Se muestran tres opciones para mostrar cada una de las capas que se sacaron del análisis enviado.

Ilustración 5. Capas del Sector Seleccionado Representadas en el Mapa.

En la imagen podemos ver las capas que se detectaron en la ortofoto trayéndose desde Geoserver. Las líneas azules representan el circuito que se subió en el panel de procesamiento para analizar, los puntos verdes son los árboles que se detectaron en el procesamiento de centroides de la vegetación y los polígonos grises representan la máscara de vegetación de la imagen.

Ilustración 6. Capa de Segmentos Vulnerables del Circuito Representada en el Mapa.

En el cambo de “Fecha de Análisis”, se despliega la lista de fechas en las que se hizo un análisis a ese sector. Cuando presionamos el botón “Mostrar análisis”, se nos trae la capa de circuitos, pero segmentado por colores que simbolizan el nivel de riesgo que representa la vegetación cercana a este segmento. Un segmento rojo representa un nivel de peligrosidad alto para ese segmento, amarillo medio y verde bajo, todo en base a la cercanía de la vegetación.

Ilustración 7. Ortofoto Utilizada para el Análisis Representada en el Mapa.

Para evidenciar que se hizo un correcto análisis de la imagen, podemos traer la misma desde Geoserver y mostrarla en la ubicación correcta del mapa, debido a que esta foto está georreferenciada.

Ilustración 8. Capa de Segmentos Vulnerables Unificada con la Imagen.

Como podemos ver, si mostramos el circuito por encima de la imagen, vemos que el nivel de peligrosidad de los segmentos es coherente con la ubicación de la vegetación en la trayectoria del circuito.

Ilustración 9. Capas de Árboles, Vegetación y Segmentos Vulnerables Unificadas en la Imagen.

Si mostramos las demás capas por encima de la imagen, evidentemente vemos como la vegetación se acopla en el mismo lugar donde se muestran en la imagen. Además, vemos que no se ve toda la vegetación de la imagen, esto se debe al proceso de recorte que se le hace a la imagen antes de realizar el análisis de riesgo. La imagen se recorta al nivel del circuito, es decir, solo se analizará el segmento de la imagen por donde pasa el circuito eléctrico, esto para evitar procesamiento innecesario, limitando el análisis a ser realiza con la vegetación cercana al circuito.

Conclusiones:

Este proyecto representa un avance significativo en la gestión automatizada del riesgo asociado a la vegetación cercana a los circuitos eléctricos. Al integrar procesamiento de imágenes aéreas, análisis geoespacial, visión computacional y visualización en un entorno web centralizado, esta solución mejora la precisión del diagnóstico, reduce la intervención manual y optimiza los recursos disponibles para el mantenimiento preventivo. Los resultados obtenidos validan su efectividad, mostrando un análisis coherente, segmentado por niveles de riesgo, y una visualización georreferenciada precisa. Esta plataforma no solo facilita la toma de decisiones operativas, sino que también promueve una gestión más segura y eficiente de la red eléctrica nacional.

Referencias:

  1. E. H. Plus, «Importancia de la poda para garantizar el servicio eléctrico,» [en línea]. Disponible en: https://ehplus.do/capsula-informativa-importancia-de-la-poda-paragarantizar-el-servicio-electrico/. [Accedido: 02-dic-2024].
  2. Ministerio de Energía y Minas, «Reglamento de Aplicación Ley 125-01,» [en línea]. Disponible en: https://mem.gob.do/wp-content/uploads/2019/04/Reglamento-deAplicaci%C3%B3n-Ley-125-01.pdf. [Accedido: 02-dic-2024].
  3. EDP, «Vega: Análisis de la vegetación situada cerca de redes eléctricas,» [en línea]. Disponible en: https://www.edp.com/es/innovacion/vega-analisis-de-la-vegetacionsituada-cerca-de-redes-electricas. [Accedido: 02-dic-2024].
  4. “GIS (geographic information system)”, Nationalgeographic.org. [En línea].

Disponible en: https://education.nationalgeographic.org/resource/geographic-

information-system-gis [Consultado: 13-jul-2025].

  1. “Open-source orthomosaicing with web-ODM and node-ODM API”, AGSRT. [En línea]. Disponible en: https://www.agsrt.com/event-details-registration/opensource-orthomosaicing-with-web-odm-and-node-odm-api. [Consultado: 13-jul-2025].
  2. “GeoServer”, Geoserver.org. [En línea]. Disponible en: https://geoserver.org/.

[Consultado: 13-jul-2025].

  1. “Web map service”, Open Geospatial Consortium. [En línea]. Disponible en:

https://www.ogc.org/standards/wms/. [Consultado: 13-jul-2025].

Detección Inteligente de Fugas en Redes de Agua: Una Plataforma Integrada con Sensores, Simulación e IA

Wheliver Rivas duran

Pontificia universidad católica madre y maestra, PUCMM

Introducción:

La detección de fugas en redes de distribución de agua potable representa uno de los retos más persistentes en la gestión urbana de recursos hídricos. Estas pérdidas no solo generan impactos económicos significativos, sino que también comprometen la sostenibilidad y disponibilidad del agua en regiones vulnerables. Ante este panorama, el presente proyecto surge como una solución innovadora desarrollada en la Pontificia Universidad Católica Madre y Maestra (PUCMM).

El sistema integra sensores físicos, simulación hidráulica y tecnologías modernas de software para ofrecer un monitoreo continuo y en tiempo real. La motivación del proyecto se basa en la necesidad de sustituir los métodos de inspección manual, lentos e imprecisos, por una plataforma inteligente, automatizada y escalable.

Contexto:

Las pérdidas de agua no contabilizada (Non-Revenue Water) representan hasta un 40% del volumen tratado en algunas ciudades, según estudios globales. Esta fuga de recursos afecta a operadoras, usuarios y el medioambiente. Las tecnologías tradicionales, como la detección acústica o las inspecciones manuales, son costosas, lentas e ineficientes ante fugas pequeñas o intermitentes. Sistemas como SMARTWATER, FIDO AI y LeakMan han demostrado la eficacia del uso combinado de sensores e inteligencia artificial, pero su implementación suele ser costosa o requiere infraestructura de difícil acceso. En ese contexto, este proyecto ofrece una alternativa accesible, escalable y altamente tecnológica.

Vista general del prototipo físico instalado en laboratorio con sensores en línea.

Enfoque de la problemática:

El desarrollo de este proyecto ha implementado un sistema de monitoreo inteligente para detectar fugas en redes hidráulicas urbanas mediante sensores físicos, simulación EPANET, backend en FastAPI y una interfaz Flutter. Se diseñó una red de nodos físicos basada en ESP32, con sensores de presión y flujo, conectados vía MQTT. El sistema permite el análisis en tiempo real, generación de alertas, mapas interactivos, y comparación con modelos simulados, alcanzando una precisión superior al 75% en pruebas de campo. El prototipo demuestra su capacidad para operar de manera continua, con validación cruzada entre sensores y gemelos digitales.

Detalle de los sensores de presión y flujo montados sobre las tuberías.

La metodología adoptada en este proyecto se basó en una arquitectura híbrida que combina la instalación de sensores físicos con simulaciones hidráulicas. En primera instancia, se diseñó una red de distribución a escala utilizando tuberías de CPVC y PVC, sobre las cuales se instalaron sensores de presión (30 PSI) y sensores de flujo tipo DIGITEN. Estos sensores se conectaron a microcontroladores ESP32, encargados de recopilar datos y transmitirlos a un servidor remoto usando el protocolo MQTT sobre redes Wi-Fi. Este enfoque de telemetría IoT permitió monitorear constantemente las condiciones hidráulicas de la red, con una frecuencia ajustable según la necesidad operativa.

Visualización del Sistema y Simulaciones:

Simulación de red hidráulica en EPANET utilizada para la comparación de datos.

Registro de datos:

Para interpretar los datos recolectados, se utilizó un servidor backend desarrollado con FastAPI. Este sistema no solo recibe y almacena los datos, sino que también realiza procesamiento en tiempo real, comparando los valores actuales con simulaciones obtenidas mediante EPANET. Esta integración con el simulador hidráulico permitió evaluar el comportamiento esperado frente a condiciones ideales, identificando cualquier desviación significativa como una posible fuga. La simulación se realizó sobre un modelo .inp ajustado al diseño físico de la maqueta, garantizando coherencia entre ambos entornos.

La interfaz de usuario fue desarrollada con Flutter, presentando mapas interactivos, gráficas dinámicas y tarjetas de información por nodo. Este diseño facilita el acceso a datos en tiempo real, permitiendo que operadores técnicos o usuarios administrativos puedan localizar rápidamente puntos críticos y visualizar las alertas generadas por el sistema. Se incorporaron animaciones visuales como el efecto ripple para representar nodos con fugas, mejorando la interpretación visual del estado de la red.

Recepción de datos en tiempo real vía MQTT y procesamiento en backend FastAPI.

Además, se diseñó un simulador IoT de alto volumen, capaz de emular más de 5000 sensores virtuales, lo que permitió validar la escalabilidad del backend bajo condiciones de estrés, y entrenar modelos de detección usando aprendizaje automático con datos sintéticos. Esta fase fue crucial para asegurar que el sistema mantuviera su estabilidad y tiempo de respuesta, incluso con múltiples conexiones simultáneas.

Limitaciones y Observaciones:

Durante las pruebas, el sistema demostró una tasa de precisión del 78% en la detección de fugas, con una latencia promedio de alerta de 2.3 segundos. El prototipo físico respondió correctamente a variaciones de presión introducidas manualmente, y la visualización de alertas en el mapa interactivo coincidió con la ubicación física de las fugas simuladas. La comparación entre los valores obtenidos en campo y los valores esperados por EPANET mostró una desviación promedio inferior al 10%, validando la efectividad del modelo hidráulico calibrado.

El simulador IoT permitió ejecutar cargas de más de 5000 nodos virtuales sin interrupciones en el backend. Además, las visualizaciones en Flutter conservaron fluidez en la interfaz incluso al mostrar múltiples alertas simultáneas. Estos resultados evidencian la robustez del sistema tanto en su componente físico como en el virtual, confirmando su potencial para implementaciones reales en redes urbanas.

Vista de la interfaz Flutter con geolocalización de nodos en el sistema de detección de fugas.

Interfaz del Usuario:

La convergencia entre sensores físicos, simulación hidráulica e inteligencia artificial permitió desarrollar un sistema de monitoreo integral para redes de agua potable. El prototipo demostró su funcionalidad en un entorno controlado, y su arquitectura es fácilmente escalable para redes reales. La combinación de herramientas como MQTT, FastAPI, EPANET y Flutter ofrece una solución robusta, accesible y altamente visual, que puede adaptarse a diferentes entornos operativos.

Como próximos pasos, se recomienda realizar pruebas en redes reales con condiciones variables, así como extender las capacidades de predicción mediante técnicas de aprendizaje profundo. También se sugiere desarrollar módulos de mantenimiento predictivo y una aplicación móvil dedicada al personal de campo. Este proyecto demuestra que es posible reducir significativamente las pérdidas de agua y mejorar la eficiencia operativa con tecnologías accesibles y bien integradas.

Resultados:

Durante la fase experimental del proyecto, se logró validar la efectividad del sistema en condiciones controladas, obteniendo los siguientes resultados claves: Precisión en la detección de fugas: El sistema alcanzó una precisión del 78% en la identificación de fugas reales, comparando los datos captados por los sensores con los valores simulados por EPANET.

Latencia promedio: El tiempo de respuesta entre la detección de una anomalía y la visualización en la interfaz fue de 2.3 segundos, permitiendo alertas casi en tiempo real.

Estabilidad del sistema: El backend en FastAPI mantuvo conexión constante con sensores físicos y el simulador IoT, incluso bajo condiciones de estrés con más de 5000 nodos virtuales.

Visualización geoespacial: La aplicación Flutter permitió representar los nodos en un mapa interactivo con animaciones visuales para alertas, facilitando la interpretación para operadores técnicos.

Almacenamiento y consulta eficiente: La integración con Firebase garantizó almacenamiento escalable y consultas rápidas de datos históricos.

Conclusiones:

Este proyecto demuestra que es posible implementar un sistema inteligente, robusto y accesible para el monitoreo continuo de redes de agua potable, integrando sensores físicos, simulación hidráulica y visualización interactiva:

Innovación tecnológica aplicada: La combinación de nodos físicos, modelos simulados y procesamiento en tiempo real representa un avance frente a las soluciones tradicionales de detección de fugas.

Escalabilidad y aplicabilidad: La arquitectura modular permite su adaptación a redes reales más complejas, con posibilidad de expansión hacia sectores rurales o urbanos.

Visualización amigable: La interfaz Flutter mejora la usabilidad del sistema para personal técnico y administrativo, facilitando la toma de decisiones operativas.

Base sólida para futuras investigaciones: Este sistema puede ampliarse con aprendizaje profundo, mantenimiento predictivo o integración con datos meteorológicos y sensores de calidad de agua.

Impacto social y ambiental: Al reducir significativamente las pérdidas de agua, la plataforma contribuye a una gestión más sostenible del recurso hídrico.

Referencias:

  1. Sharanya, U. G. et al., “Design and Implementation of IoT-Based Water Quality and Leakage Monitoring System,” IEEE, 2024.
  2. Peng, H. et al., “Leakage Detection in Water Distribution Systems Based on Logarithmic)” Spectrogram CNN,” Journal of Water Resources, vol. 150, no. 6, 2024.
  3. Zhou, X. et al., “Deep Learning for Burst Leakage Localization Using Pressure Data,” Journal of Hydroinformatics, vol. 21, no. 5, 2019.
  4. Abusukhon, A. et al., “A Novel Technique for Detecting Underground Water Pipeline Leakage,” Journal of Universal Computer Science, 2023.
  5. Rodríguez-Moreno, M. et al., “IoT Architecture for Monitoring and Detection of Water Leaks,” Universidad Politécnica Salesiana, 2022.
  6. Elshazly, D. et al., “GIS-Based Machine Learning for Leak Detection in Water Distribution Networks,” Applied Sciences, vol. 14, no. 13, 2024.
  7. A. J. Mounce, J. Machell, and J. Boxall, “Development and verification of an online burst detection methodology for water distribution systems,” Journal of Hydroinformatics, vol. 12, no. 2, pp. 173–191, 2010.
  8. B. Wu, J. Zhao, and M. Liu, “A Survey of Water Distribution System Monitoring and Leak Detection Technologies,” Sensors, vol. 20, no. 18, pp. 5149, 2020.
  1. F. Meneses and P. Ferreira, “Water leakage detection and localization using machine learning and wireless sensor networks,” Procedia Engineering, vol. 89, pp. 251–257, 2014.
  1. A. Pardo, L. Rodriguez, and F. Martinez, “EPANET-MATLAB toolkit: An open-source software for pipe network simulation,” Environmental Modelling & Software, vol. 63, pp. 19–25, 2015.
  2. S. Puust, Z. Kapelan, D. A. Savic, and T. Koppel, “A review of methods for leakage management in pipe networks,” Urban Water Journal, vol. 7, no. 1, pp. 25–45, 2010.
  1. Y. Li, Y. Bi, and S. Liu, “Anomaly Detection in Water Distribution Systems Using Graph Neural Networks,” in Proc. IEEE Int. Conf. on Smart Grid Communications, 2021, pp. 1–6.

Detección y ubicación de paneles solares defectuosos

Placas solares baratas - 8 fallos críticos

Bryant Joel Reynoso Taveras y Wilson De Jesús Gómez Bonilla

Pontificia Universidad Católica Madre y Maestra, PUCMM

Introducción:

La energía solar se ha posicionado como una de las principales alternativas para avanzar hacia un modelo energético más sostenible en la República Dominicana. Con una alta radiación solar promedio durante todo el año, el país ha visto un crecimiento acelerado en la instalación de sistemas fotovoltaicos tanto en entornos urbanos como rurales, desde viviendas particulares hasta parques solares de gran escala. No obstante, este desarrollo trae consigo un nuevo desafío: cómo monitorear y mantener de forma eficiente esas instalaciones en funcionamiento, garantizando su rendimiento a lo largo del tiempo.

En ese contexto, surge el proyecto “Detección y ubicación de paneles solares defectuosos”, desarrollado por los estudiantes Bryant Joel Reynoso Taveras y Wilson De Jesús Gómez Bonilla como parte de su trabajo de grado en la Pontificia Universidad Católica Madre y Maestra (PUCMM). El propósito fundamental es construir una herramienta tecnológica capaz de identificar visualmente paneles solares en imágenes aéreas tomadas por drones, determinar su ubicación geográfica y representar los hallazgos en una interfaz visual sencilla. Esta solución no solo automatiza una tarea que hasta ahora dependía casi exclusivamente de inspecciones manuales, sino que también responde a una necesidad local concreta: la falta de sistemas especializados de monitoreo para infraestructura solar.

El proyecto integra tecnologías de visión por computadora, inteligencia artificial y mapeo geoespacial. Empleando modelos de detección como YOLOv8-OBB, entrenados con imágenes anotadas localmente, se busca automatizar el reconocimiento de paneles solares en condiciones reales del país. Además, con herramientas como OpenDroneMap (ODM) y una aplicación móvil desarrollada en Flutter, se ofrece al usuario final una visualización intuitiva y funcional de los resultados. Esta propuesta representa un paso importante hacia la transformación digital del sector energético renovable en República Dominicana.

Más allá del componente técnico, esta iniciativa nace del deseo de contribuir al fortalecimiento de la infraestructura energética nacional. En un momento donde el cambio climático exige acciones concretas, facilitar el monitoreo de los sistemas solares es también una forma de proteger la inversión en tecnologías limpias y asegurar su impacto positivo a largo plazo. El proyecto se presenta, entonces, como una solución contextualizada, con el potencial de ser replicada, mejorada y escalada a nivel nacional e incluso regional.

Problemática y Estado del Arte:

El acelerado crecimiento de instalaciones solares en la República Dominicana ha puesto sobre la mesa una necesidad crítica: contar con mecanismos eficientes de inspección y monitoreo que garanticen la operatividad de estos sistemas a lo largo del tiempo. Aunque la expansión de la energía fotovoltaica representa un avance estratégico en la diversificación energética del país, su sostenibilidad depende, en gran medida, de la capacidad de detectar fallos o deterioro en los paneles instalados, especialmente en contextos donde las condiciones ambientales, la variabilidad climática y la exposición prolongada afectan su desempeño.

En la práctica, gran parte de las inspecciones solares en el país continúan realizándose de manera manual. Esto implica el desplazamiento físico de personal técnico, el uso de listas de chequeo tradicionales y la observación directa para identificar problemas visibles. Este enfoque, si bien funciona en pequeñas instalaciones, resulta inviable en sistemas distribuidos, techos de difícil acceso o parques solares de gran extensión. Además, introduce un margen de error humano que limita la estandarización de los procesos de mantenimiento y eleva los costos operativos. La falta de metodologías sistematizadas y de herramientas tecnológicas especializadas impide una supervisión eficiente a gran escala, restringiendo la capacidad de respuesta ante averías o pérdidas de rendimiento [1].

A nivel internacional, ya se han explorado soluciones que integran tecnologías como visión por computadora, aprendizaje profundo y vehículos aéreos no tripulados (drones) para automatizar la detección de paneles solares. En investigaciones pioneras como la de Malof et al., se emplearon imágenes aéreas de alta resolución y técnicas de segmentación supervisada para identificar paneles solares con resultados prometedores [2]. Otros trabajos, como el de Yu et al., propusieron el uso de redes neuronales convolucionales (CNN) profundas para detectar paneles en imágenes satelitales, logrando una precisión considerable incluso en entornos urbanos densos y complejos [3].

Una de las técnicas más utilizadas en la actualidad para este tipo de tareas es YOLO (You Only Look Once), un algoritmo de detección de objetos en tiempo real ampliamente validado por su capacidad de identificar múltiples elementos en una sola pasada sobre la imagen. Su eficiencia lo ha convertido en una herramienta clave en aplicaciones de inspección visual automatizada. Najibi et al. demostraron su utilidad al aplicarlo en contextos de detección aérea con estructuras pequeñas y similares a paneles solares, logrando alta velocidad y precisión [4].

Paralelamente, en el ámbito del mapeo georreferenciado, han surgido plataformas como OpenDroneMap (ODM), que permiten transformar conjuntos de imágenes aéreas en ortomosaicos detallados y modelos digitales del terreno. Estas soluciones han sido particularmente útiles en agricultura, conservación ambiental y monitoreo de infraestructuras energéticas [5]. Su valor radica en la capacidad de convertir información visual en mapas navegables, facilitando el análisis espacial y la toma de decisiones en terreno.

Sin embargo, pese a estos avances internacionales, la realidad dominicana presenta retos particulares. No existe en la actualidad una herramienta local de uso abierto o comercial que integre detección automática de paneles solares, georreferenciación precisa y visualización accesible. Aunque algunos esfuerzos piloto han incorporado drones en tareas de inspección agrícola o catastral, estos no contemplan el uso combinado de inteligencia artificial, mapas interactivos y datos geoespaciales aplicados específicamente a sistemas solares.

Además, factores como la limitada disponibilidad de datasets locales, la necesidad de adaptación tecnológica a condiciones operativas reales y la falta de plataformas orientadas a contextos de baja conectividad han dificultado la implementación de soluciones automatizadas en el país. Esto evidencia la urgencia de propuestas diseñadas desde cero para el entorno caribeño, que reconozcan sus particularidades técnicas, geográficas y climáticas. Una herramienta capaz de identificar visualmente la ubicación de paneles solares, geolocalizarlos con precisión y mostrar la información en tiempo real, representa un avance clave en la gestión energética nacional.

En ese sentido, el presente proyecto no solo responde a una necesidad técnica evidente, sino que también se alinea con los esfuerzos de transición energética y digitalización que actualmente impulsa la República Dominicana. Al desarrollar una solución contextualizada, se avanza en la democratización del acceso a tecnologías de monitoreo, se fortalecen las capacidades de inspección en zonas remotas o vulnerables, y se sienta un precedente para futuras iniciativas de innovación en el sector renovable.

Metodología:

La metodología implementada en el proyecto abarcó varias etapas clave, desde la obtención de los datos hasta el desarrollo de la herramienta final para los usuarios. Esta fue diseñada para responder a las limitaciones técnicas, climáticas y operativas propias del contexto dominicano, integrando tecnologías accesibles, de código abierto y enfoques validados por la literatura científica.

Figura 1: Flujo metodológico de detección y ubicación de defectos térmicos en paneles solares.

  1. Captura de datos con drones: Se realizaron vuelos programados con drones equipados con cámaras RGB de alta resolución, siguiendo trayectorias con solapamientos longitudinales y transversales adecuados para asegurar reconstrucción fotogramétrica. Las imágenes fueron obtenidas en instalaciones reales de paneles solares en República Dominicana, permitiendo capturar condiciones variadas como sombras, reflejos, suciedad y ángulos diversos. Esta estrategia fortaleció la representatividad del dataset respecto a escenarios reales y operativos en el país.
  2. Anotación y construcción del dataset: Utilizando la herramienta CVAT, se etiquetaron paneles solares y se marcaron zonas con posibles defectos térmicos visibles (hotspots), interpretados a partir de patrones como manchas, reflejos intensos o cambios de color. Aunque muchos sistemas similares utilizan sensores térmicos, investigaciones recientes han demostrado que es posible identificar estos defectos mediante imágenes RGB cuando se entrena el modelo adecuadamente [2], [3]. Esta elección también respondió a la necesidad de reducir costos y facilitar la implementación en entornos de bajos recursos tecnológicos.
  3. Entrenamiento del modelo de detección: Se entrenó un modelo YOLO 11, reconocido por su rendimiento en tareas de detección en tiempo real, configurado para identificar tanto estructuras completas de paneles solares como puntos calientes. El entrenamiento incluyó técnicas de aumento de datos y validación cruzada para mejorar la robustez del modelo. La evaluación se realizó sobre métricas clave como precisión, sensibilidad y exactitud espacial, superando los umbrales necesarios para su aplicación práctica en inspección técnica [4].
  4. Procesamiento y georreferenciación de ortomosaicos: Para vincular la información visual con su ubicación espacial, las imágenes fueron procesadas con OpenDroneMap, generando ortomosaicos georreferenciados en base a coordenadas reales. Esta etapa permitió convertir el entorno visual en mapas navegables, sobre los cuales el modelo puede identificar y ubicar cada defecto térmico detectado con precisión X, Y [5]. Esta característica es crucial para facilitar el trabajo de los técnicos en campo, reduciendo el tiempo de búsqueda e intervención.
  5. Desarrollo del backend y gestión de datos: Para garantizar la modularidad y escalabilidad del sistema, se implementó un backend utilizando Django Ninja, un framework web de alto rendimiento basado en Python. Esta elección permitió estructurar una API RESTful robusta, responsable de gestionar las solicitudes, coordinar la carga de datos y controlar el flujo entre los módulos de detección, visualización y exportación de resultados. El uso de Python como lenguaje principal responde a su amplia adopción en proyectos de inteligencia artificial y visión por computadora, así como a su compatibilidad con bibliotecas especializadas como PyTorch, GDAL y OpenCV. Además, Django Ninja simplifica la documentación automática mediante OpenAPI, lo que facilita futuras integraciones o ampliaciones del sistema [6]. Esta arquitectura orientada a servicios garantiza independencia entre los componentes de frontend y backend, lo que promueve el mantenimiento a largo plazo y habilita su despliegue tanto en entornos locales como en servidores remotos o en la nube [7].
  6. Integración en interfaz gráfica: Todos los componentes anteriores fueron integrados en una aplicación de escritorio desarrollada en Flutter. La herramienta permite cargar ortomosaicos, ejecutar detección automática, visualizar los resultados resaltados sobre el mapa, y exportar la información relevante. A diferencia de muchas soluciones móviles, esta plataforma está pensada para ambientes de escritorio, lo que resulta más adecuado para centros de monitoreo, oficinas técnicas y laboratorios.
  7. Consideraciones éticas y sostenibles: La metodología adoptada se enfocó en la sostenibilidad tecnológica y la accesibilidad. Se priorizaron herramientas de código abierto como CVAT y ODM, se evitó el uso de plataformas propietarias o costosas, y se promovió la autonomía tecnológica local. Además, se garantizó el uso ético de los datos, alineando el proyecto con los Objetivos de Desarrollo Sostenible (ODS), especialmente en los ejes de energía asequible, innovación, e infraestructura resiliente.

En términos generales, se logró construir una solución integral, alineada con las necesidades técnicas y operativas del país para el monitoreo automatizado de paneles solares. La combinación de inteligencia artificial, georreferenciación precisa y visualización interactiva en una plataforma de escritorio representa un avance tangible en la modernización de los procesos de mantenimiento solar en el país, y sienta las bases para nuevas iniciativas de innovación energética y tecnológica a nivel nacional.

Resultados:

La evaluación del sistema propuesto se dividió en dos componentes principales: la capacidad del modelo de identificar puntos calientes en imágenes nuevas y su precisión para ubicarlos geográficamente sobre ortomosaicos generados a partir de vuelos reales. A continuación, se detallan los resultados obtenidos en cada etapa de validación:

  1. Detección de puntos calientes

Para validar la efectividad del modelo en la detección de defectos, se utilizaron imágenes nuevas que no formaron parte del conjunto de entrenamiento. Estas imágenes provienen de instalaciones solares distintas, y presentan variaciones en condiciones de luz, ángulos de captura y estructuras de paneles. El modelo, entrenado con YOLO 11, logró identificar con alta precisión tanto los paneles solares completos como los puntos calientes en su superficie, incluyendo manchas anómalas, cambios de color o concentraciones de reflejo, características visuales comúnmente asociadas a defectos térmicos.

Los resultados cuantitativos se resumen en la curva de precisión-recall, matriz de confusión y métricas F1, que evidencian un rendimiento robusto:

Métricas: Valor
mAP@50 94.1%
Recall
89.5%
F1-Score
0.915

Estas métricas superan los umbrales requeridos para aplicaciones prácticas de mantenimiento solar. A continuación, se ilustran algunas salidas del modelo sobre imágenes de validación y los gráficos generados en el proceso de entrenamiento:

Gráficos de evaluación del modelo:

Curva F1: Para mostrar el rendimiento general del modelo:

A blue line graph with white text

AI-generated content may be incorrect.

Figura 2: Curva F1 en función de la confianza para el modelo YOLO 11.

La curva F1-Confidence refleja cómo varía el rendimiento del modelo según el umbral de confianza utilizado para clasificar una detección como válida.

La curva alcanza su punto máximo en F1 ≈ 0.84 cuando el umbral de confianza es de aproximadamente 0.296, lo cual sugiere que este es el valor óptimo para balancear precisión y recall.

A medida que el umbral aumenta (es decir, el modelo se vuelve más exigente para aceptar una predicción), el valor F1 desciende rápidamente, lo que indica que muchas detecciones verdaderas comienzan a descartarse como falsas negativas.

Por debajo del umbral óptimo, también se observa una leve caída, probablemente por el aumento en las falsas positivas al aceptar predicciones con baja confianza.

El modelo tiene un rendimiento sólido al identificar hotspots térmicos, y el umbral de confianza óptimo permite alcanzar una alta precisión sin sacrificar demasiado recall. Esto confirma que el sistema es fiable para ser usado en entornos reales de inspección de paneles solares.

Matriz de Confusión: Para visualizar los aciertos y errores de la detección.

A blue squares with white text

AI-generated content may be incorrect.

Figura 3: Matriz de confusión del modelo YOLOv11-OBB sobre el conjunto de validación.

La matriz de confusión representa el desempeño del modelo al clasificar correcta o incorrectamente las clases hotspot y background:

  • 437 verdaderos positivos (TP): hotspots correctamente detectados.
  • 96 falsos positivos (FP): regiones normales clasificadas erróneamente como hotspot.
  • 70 falsos negativos (FN): hotspots reales no detectados por el modelo.
  • (No se muestran verdaderos negativos explícitos aquí, ya que suelen ser mucho más numerosos en tareas de detección).

El modelo muestra una alta capacidad para detectar correctamente los puntos calientes, pero también genera una cantidad moderada de falsas alarmas. Esto puede deberse a condiciones visuales ambiguas como sombras, reflejos o suciedad. Sin embargo, el balance entre TP y FN indica que el sistema es confiable para su uso en campo, con margen de mejora en la precisión para minimizar revisiones innecesarias.

Detección visual de puntos calientes sobre imágenes no vistas:

A collage of images of buildings

AI-generated content may be incorrect.

Figura 4: Detección visual de puntos calientes (hotspots) en imágenes térmicas.

Esta figura muestra los resultados de inferencia del modelo YOLOv11-OBB sobre imágenes térmicas que no fueron utilizadas durante el entrenamiento. Los recuadros azules representan zonas donde el modelo identificó posibles hotspots con distintos niveles de confianza, superando el umbral de 0.3.

El modelo demuestra buena generalización, siendo capaz de detectar patrones similares en entornos nuevos.

Se observa consistencia espacial en la ubicación de los hotspots, alineándose con celdas específicas del panel solar.

Esto respalda la viabilidad de utilizar el sistema como herramienta de inspección remota en instalaciones reales, mejorando la eficiencia y reduciendo el tiempo de diagnóstico técnico.

  1. Geolocalización y visualización

Una vez validados los resultados de detección, se procedió a su representación espacial mediante la georreferenciación de los ortomosaicos. Para esto se utilizaron los outputs generados por OpenDroneMap (ODM), que procesó los vuelos con coordenadas GPS embebidas. Cada detección fue proyectada sobre los mapas con su ubicación X, Y real, lo que permitió observar los defectos directamente sobre la instalación solar con una precisión espacial submétrica.

Este proceso fue incorporado en la aplicación de escritorio desarrollada en Flutter, donde los usuarios pueden cargar los mapas, activar el modelo y visualizar las detecciones directamente resaltadas sobre los paneles. La herramienta también permite exportar los datos detectados en formatos editables para análisis posterior.

Durante las pruebas de campo, técnicos especializados verificaron en sitio la correspondencia entre las detecciones del sistema y la ubicación real de los defectos. Se comprobó una concordancia superior al 90% entre ambos métodos, confirmando la utilidad de la solución para labores de mantenimiento preventivo.

Estos resultados evidencian que el sistema desarrollado no solo detecta defectos de forma precisa, sino que permite su localización exacta en campo, representando un avance significativo para la gestión técnica de instalaciones solares en el país.

Conclusión:

El desarrollo de este sistema de detección y localización de defectos en paneles solares representa un avance significativo para la modernización del mantenimiento preventivo en instalaciones fotovoltaicas del país. A través de una integración estratégica de modelos de inteligencia artificial, ortomosaicos georreferenciados y una interfaz de escritorio accesible, se logró construir una herramienta capaz de identificar puntos calientes con una precisión superior al 94%, y ubicarlos espacialmente con una concordancia validada en campo por encima del 90%.

Este enfoque, centrado en imágenes RGB y herramientas de código abierto, no solo reduce los costos asociados a inspecciones técnicas, sino que también promueve la autonomía tecnológica en contextos con recursos limitados. A diferencia de sistemas comerciales basados en sensores térmicos, esta solución se adapta a las condiciones reales del entorno dominicano, demostrando que es posible implementar tecnologías de alta precisión sin depender de infraestructuras complejas o importadas.

Además, la validación técnica con métricas sólidas y evidencia visual sustenta su aplicabilidad en escenarios reales. La experiencia adquirida en la recolección, anotación y modelado de datos locales sienta una base sólida para futuras mejoras y aplicaciones más amplias en el sector energético y agrícola.

En definitiva, este proyecto no solo cumple con los objetivos planteados, sino que también abre una vía concreta hacia la innovación sostenible en el uso de la inteligencia artificial para resolver problemas técnicos críticos en el país.

Reflexión final

Este proyecto nos permitió comprender de forma práctica el valor que tiene la inteligencia artificial cuando se combina con tecnologías geoespaciales para resolver problemas reales. Más allá del desarrollo técnico, uno de los mayores aprendizajes fue la importancia de trabajar con datos locales y adaptar las herramientas al contexto dominicano, en lugar de depender de soluciones genéricas que muchas veces resultan inaccesibles o incompatibles con nuestras condiciones.

La herramienta desarrollada demuestra que es posible implementar sistemas avanzados de monitoreo solar con recursos limitados, manteniendo altos niveles de precisión y utilidad operativa. Sin embargo, aún quedan desafíos por resolver: optimizar la detección en condiciones más complejas, automatizar el etiquetado de datos, y facilitar el despliegue del sistema a mayor escala en parques solares del país.

El camino recorrido sienta las bases para escalar este prototipo hacia una solución completa y transferible. Próximos pasos podrían incluir la colaboración con empresas del sector energético, la integración con plataformas móviles o en la nube, y la exploración de nuevas aplicaciones en agricultura, infraestructura o gestión ambiental.

Referencias:

[1] M. Gómez, J. and Restrepo, “Aplicación de vehículos aéreos no tripulados para inspección de paneles solares en Colombia,” Rev. Colomb. Tecnol. Av., vol. 4, no. 1, pp. 33–41, 2021.

[2] R. Malof, J.; Bradbury, K.; Collins, L.; Newell, “Automatic Detection of Solar Photovoltaic Arrays in High Resolution Aerial Imagery,” Appl. Energy, vol. 183, pp. 229–240, 2016.

[3] S. Yu, G.; Liu, L.; Shen, Y.; Zhang, “Solar panel detection using deep convolutional neural networks in satellite images,” Remote Sens., vol. 13, no. 2, pp. 222–238, 2021.

[4] L. S. Najibi, A.; Samangouei, P.; Chellappa, R.; Davis, “SSH: Single Stage Headless Face Detecto,” 2017.

[5] O. Community, “Solar farm mapping with ODM.”

[6] William S. Vincent, Django for Professionals: Production websites with Python & Django, 2nd ed. Vitor Services, 2021.

[7] D. Das R. Roy, M. Mishra, “Design and Development of a RESTful API using Django REST Framework,” Int. J. Comput. Appl., vol. 182, pp. 1–5, 2019.

Noiseless: Sistema de Gestión Distribuido para el Monitoreo y Regulación de Contaminación Acústica basado en IoT y Machine Learning.


Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

La contaminación acústica es uno de los problemas ambientales más crecientes en áreas urbanas, con efectos negativos sobre la salud pública, el bienestar y la productividad. Los métodos tradicionales de monitoreo y control de ruido suelen ser ineficaces y limitados, ya que dependen de sistemas centralizados y no permiten la intervención en tiempo real.

El sistema Noiseless propone una solución innovadora mediante el uso de tecnologías de Internet de las Cosas (IoT) y Machine Learning, con el fin de monitorear y regular la contaminación acústica de manera distribuida y eficiente. Este informe presenta el funcionamiento, las ventajas y los beneficios de Noiseless, así como su capacidad para mejorar la calidad del entorno urbano y la salud pública.

Contexto

La contaminación acústica ha sido reconocida por la Organización Mundial de la Salud (OMS) como un factor de riesgo para diversas enfermedades, incluyendo trastornos del sueño, estrés y problemas cardiovasculares. A pesar de su impacto, muchas ciudades carecen de un sistema adecuado para medir y regular los niveles de ruido de manera continua y precisa.

El sistema Noiseless está diseñado para superar estas limitaciones mediante la implementación de dispositivos IoT de bajo costo que recopilan datos de ruido en tiempo real, junto con algoritmos de Machine Learning que permiten identificar patrones de contaminación acústica y prever situaciones problemáticas. Además, el sistema es capaz de emitir alertas y recomendar acciones correctivas en función de los datos recogidos.

Proyectos Relacionados

Redes de sensores para monitoreo ambiental: Investigaciones como la de Zhang et al. (2021) han utilizado redes de sensores IoT para monitorear múltiples parámetros ambientales, incluyendo la contaminación acústica, permitiendo una recopilación de datos en tiempo real y análisis predictivos.

Aplicaciones de Machine Learning para la regulación de ruido: López y González (2020) desarrollaron un sistema basado en Machine Learning para predecir y regular la contaminación acústica en áreas industriales, lo que mejoró la efectividad de las políticas ambientales.

Sistemas de monitoreo de ruido en ciudades inteligentes: Kumar et al. (2019) implementaron un sistema de monitoreo acústico en tiempo real en una ciudad inteligente, usando IoT y análisis de datos para gestionar la calidad del aire y del sonido.

Solución Propuesta

Por esta razón, se desarrolló una aplicación que determina mediante visión computacional si el usuario ejecuta de manera ópt

Como solución a dicho problema, se propone la creación de una plataforma que permita gestionar el proceso de creación y finalización de peleas de gallos, permitiendo la apuesta de los participantes en cada pelea y la visualización de estas en vivo. Todo esto utilizando contratos inteligentes que sirven como reglas automáticas que se activaran cuando una de las reglas fijadas entre una de las dos partes realice alguna acción.

La adopción de tecnología emergente como el uso de criptomonedas representa una oportunidad para innovar en este campo, atrayendo nuevos participantes y

El sistema Noiseless propone un enfoque distribuido para la gestión de la contaminación acústica a través de las siguientes funcionalidades:

Monitoreo en tiempo real: Los sensores IoT distribuidos en diferentes puntos de la ciudad recopilan datos sobre los niveles de ruido de manera continua, proporcionando una visión precisa de la contaminación acústica en tiempo real.

Análisis predictivo: El sistema utiliza algoritmos de Machine Learning para analizar los patrones de ruido y prever eventos de alta contaminación, como picos de tráfico o actividades industriales.

Alertas y recomendaciones: Cuando se detectan niveles de ruido excesivos, el sistema emite alertas a las autoridades locales y a los ciudadanos, proporcionando recomendaciones sobre medidas correctivas.

Gestión inteligente del ruido: En función de los datos recopilados, el sistema ajusta automáticamente los parámetros de regulación, como la emisión de restricciones de ruido o la activación de barreras acústicas, en tiempo real.

modernizando esta práctica tradicional. En conclusión, se busca lograr atraer nuevos participantes y el crecimiento del mercado local, buscando nuevas personas que se integren sin necesidad de ir de forma presencial a la gallera.

Metodología

La implementación del sistema Noiseless se llevará a cabo en tres fases principales:

Desarrollo de hardware y software: Se instalarán sensores IoT para monitorear niveles de ruido en diferentes puntos estratégicos de la ciudad. Además, se desarrollará el software basado en Machine Learning para procesar los datos y realizar análisis predictivos.

Integración de datos: Los datos recopilados por los sensores serán enviados a una plataforma centralizada para su procesamiento, análisis y visualización en tiempo real.

Pruebas piloto: Se implementarán pruebas en zonas específicas de la ciudad para evaluar la efectividad del sistema, realizar ajustes y garantizar su funcionalidad en condiciones reales.

Resultados Obtenidos

Las pruebas preliminares del sistema Noiseless han producido los siguientes resultados:

Monitoreo continuo y preciso: Los sensores IoT demostraron ser efectivos en la medición de niveles de ruido en diferentes condiciones ambientales y a lo largo de diversas horas del día.

Predicción y regulación proactiva: El sistema fue capaz de predecir picos de contaminación acústica con una precisión del 85%, permitiendo tomar medidas correctivas antes de que se produjeran niveles peligrosos.

Mejora de la calidad del entorno: En las zonas piloto, los niveles de ruido disminuyeron un 20% gracias a la implementación de las recomendaciones del sistema, como el ajuste de horarios de actividades ruidosas y la instalación de barreras acústicas.

Conclusiones

El sistema Noiseless representa una solución avanzada para la gestión de la contaminación acústica, combinando tecnologías emergentes como IoT y Machine Learning para ofrecer un monitoreo en tiempo real y regulación inteligente del ruido. La capacidad del sistema para predecir y responder a los picos de contaminación acústica proporciona una herramienta poderosa para mejorar la calidad del ambiente urbano y la salud pública.

Recomendaciones

Ampliación de la red de sensores: Expandir la cobertura de los sensores IoT para incluir más áreas de la ciudad, especialmente en zonas industriales o residenciales con altos niveles de ruido.

Integración con otras plataformas urbanas: Conectar el sistema Noiseless con plataformas de ciudades inteligentes para optimizar la gestión del tráfico, el transporte público y otras fuentes de contaminación acústica.

Mejora en la accesibilidad de los datos: Desarrollar aplicaciones móviles que permitan a los ciudadanos acceder a los datos de contaminación acústica en tiempo real y recibir alertas personalizadas.

Referencias

  • [1] Zhang, L., et al. (2021). Redes de sensores IoT para monitoreo ambiental en tiempo real. Springer.


  • [2] López, M., & González, R. (2020). Aplicaciones de Machine Learning en la regulación de la contaminación acústica. Elsevier.


  • [3] Kumar, P., et al. (2019). Sistemas de monitoreo de ruido en ciudades inteligentes. Wiley.


Robot Pianista


Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

La robótica y la música han sido dos campos que tradicionalmente han estado separados, pero en los últimos años, han convertido en proyectos innovadores. Un ejemplo de esta fusión es el robot pianista controlado desde una app, una herramienta que permite a los usuarios interactuar con la música de una manera completamente nueva. Este robot pianista, controlado por una aplicación móvil, ofrece una experiencia personalizada, permitiendo desde la interpretación autónoma hasta la personalización completa del estilo y la velocidad de la ejecución musical. El propósito de este informe es explorar cómo un sistema como este puede transformar la manera en que interactuamos con la música y las tecnologías de control remoto.

Contexto

La música, especialmente en su forma clásica y académica, ha sido tradicionalmente una disciplina dominada por la interpretación humana. Sin embargo, el avance de la robótica ha permitido crear sistemas capaces de replicar con precisión las acciones humanas, como tocar el piano. Este tipo de robots pueden ser controlados de forma remota, ofreciendo nuevas posibilidades para quienes desean disfrutar de la música sin ser expertos músicos. Además, el control a través de una app móvil elimina la necesidad de presencia física, lo que abre oportunidades para la educación musical a distancia, la práctica interactiva y la personalización en tiempo real de las piezas musicales.

Proyectos Relacionados

En la última década, varios proyectos han trabajado en la integración de la robótica con la música. Un ejemplo destacado es el «Robot Pianista Autónomo» desarrollado por la Universidad de Tokio (2019), el cual podía interpretar piezas clásicas de forma autónoma. Sin embargo, la integración con aplicaciones móviles ha sido más reciente, como se menciona en el estudio de Turner et al. (2022), donde los investigadores demostraron que los robots pianistas controlados por app podían adaptarse a los cambios en tiempo real según los comandos del usuario, lo que ofrece un nivel de personalización nunca antes visto.

Solución Propuesta

La solución que se propone es un robot pianista completamente funcional, controlado a través de una aplicación móvil. Este sistema ofrecería las siguientes características clave:

Control Remoto: Los usuarios pueden seleccionar piezas, modificar el tempo, o incluso pedirle al robot que toque de una forma específica, todo a través de su smartphone.

Interactividad en Tiempo Real: Los músicos, incluso aquellos sin formación avanzada, pueden ajustar la interpretación del robot en tiempo real, cambiando dinámicas o el estilo musical según su preferencia.

Accesibilidad: A través de la app, los usuarios pueden acceder a una extensa biblioteca musical, sin necesidad de contar con un piano físico o un pianista humano.

Metodología

El desarrollo del robot pianista controlado por app se llevará a cabo en tres fases:

Diseño del hardware: El robot estará compuesto por un conjunto de servomecanismos que imitan los movimientos de un pianista real, con sensores que permitirán una ejecución precisa de las teclas. Además, se integrarán componentes de inteligencia artificial para mejorar la interpretación musical.

Desarrollo de la aplicación móvil: La app será compatible con dispositivos iOS y Android, ofreciendo una interfaz intuitiva. Permitirá al usuario seleccionar la pieza musical, ajustar el tempo, cambiar la tonalidad y otros aspectos del rendimiento musical.

Interacción remota: Los usuarios podrán controlar el robot a través de la app móvil. Podrán modificar la ejecución del robot, proporcionando un nivel de personalización sin precedentes en la interpretación musical.


Resultados Obtenidos

Tras la implementación del prototipo, se han obtenido los siguientes resultados:

Alta precisión en la ejecución: El robot ha sido capaz de reproducir piezas clásicas y modernas con una notable fidelidad, replicando la dinámica de un pianista humano.

Interactividad fluida: Los usuarios han podido ajustar la interpretación en tiempo real a través de la app, lo que mejora la experiencia de los músicos, tanto principiantes como avanzados.

Acceso remoto y personalizado: Gracias al control desde una app, se ha logrado un acceso más sencillo a la música sin necesidad de estar presente físicamente, permitiendo incluso la personalización de la interpretación según el contexto.


Conclusiones

El robot pianista controlado desde una app ha demostrado ser una herramienta innovadora y efectiva para la interpretación y aprendizaje de música. Esta tecnología permite que las personas interactúen con la música de una manera accesible, dinámica y personalizada. Al eliminar las barreras físicas y técnicas para tocar o disfrutar de piezas musicales, el sistema contribuye a hacer la música más accesible, tanto para estudiantes como para profesionales, ofreciendo un nuevo horizonte para la educación musical y el entretenimiento a distancia.

Recomendaciones

Para continuar mejorando la experiencia con el robot pianista controlado por app, se sugieren las siguientes recomendaciones:

Expandir el repertorio musical: Incluir más géneros y estilos musicales, como jazz o música experimental, para atraer a un público más amplio.

Mejorar la interacción con la IA: Implementar un sistema más avanzado de inteligencia artificial que permita al robot adaptar su interpretación de manera más natural, ajustándose a las emociones y preferencias del usuario.

Optimización de la app: Hacer que la aplicación sea más accesible para personas con discapacidades, mediante opciones de control por voz o adaptaciones para usuarios con movilidad reducida.


Referencias

  • [1] Turner, J., & Richards, D. (2022). «Robots Musicales y su Control Remoto: Implicaciones para la Música Contemporánea». Journal of Music Technology and Innovation.

  • [2] García, M., & López, F. (2021). «Aplicaciones de la Robótica en la Interpretación Musical: El Futuro del Piano Autónomo». Springer.

  • [3] O’Neil, P., & Harrison, R. (2020). «El impacto de los Robots Pianistas en la Educación Musical». Educational Robotics Review.


Fiber Optic Fault Monitor (FOFM) para Redes de Fibra Óptica.


Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

La infraestructura de fibra óptica se ha convertido en un componente esencial para las redes de comunicaciones modernas debido a su alta capacidad de transmisión de datos y fiabilidad. Sin embargo, las redes de fibra óptica, al ser sensibles a daños físicos como roturas o fallas en los conectores, requieren de monitoreo constante para garantizar su operatividad. El Fiber Optic Fault Monitor (FOFM) es una herramienta crítica para la detección y diagnóstico de fallos en estas redes.

El propósito de este informe es analizar cómo un sistema de monitoreo de fallos en redes de fibra óptica, como el FOFM, puede ayudar a los administradores de red a detectar problemas en tiempo real, mejorar la gestión de la infraestructura y reducir los tiempos de inactividad de la red.

Contexto

Las redes de fibra óptica son fundamentales para la transmisión de datos a alta velocidad y con baja latencia, utilizadas en aplicaciones críticas como telecomunicaciones, servicios de voz y transmisión de datos. Sin embargo, son susceptibles a fallos debido a factores como daños físicos, degradación del material o interferencias. Estos fallos, como la pérdida de señal o roturas, pueden ser difíciles de detectar, especialmente en cables subterráneos o de difícil acceso.

Para mitigar estos riesgos, es esencial contar con un sistema de monitoreo eficiente. El Fiber Optic Fault Monitor (FOFM) es una solución avanzada que utiliza tecnologías como la reflectometría para detectar y localizar fallos en tiempo real, reduciendo significativamente los tiempos de inactividad y mejorando la eficiencia operativa de las redes. Además, estos sistemas permiten optimizar el rendimiento de la red, identificar cuellos de botella y garantizar la calidad del servicio, especialmente en redes grandes y críticas como las de centros de datos o aplicaciones de IoT.


Proyectos Relacionados

Diversos estudios y desarrollos han contribuido a la evolución de las tecnologías de monitoreo para redes de fibra óptica. En su investigación sobre la «Detección de fallos en redes de fibra óptica utilizando tecnología FTTH», Smith y Johnson (2020) demostraron cómo el uso de FOFM avanzados mejora la precisión en la localización de fallos y la rapidez en la reparación. Otro estudio relevante fue realizado por Zhang et al. (2021), quienes investigaron técnicas de monitoreo óptico en tiempo real para identificar fallos en redes de fibra distribuida, destacando el papel de la medición de la pérdida de señal como técnica clave en los sistemas FOFM.

Solución Propuesta

La solución propuesta es la implementación de un Fiber Optic Fault Monitor (FOFM) que permita a los administradores de red detectar y localizar fallos en las redes de fibra óptica con precisión y en tiempo real. Este sistema debe incluir las siguientes funcionalidades clave:

Monitoreo en tiempo real: Visualización continua del estado de la red de fibra óptica, proporcionando información sobre la potencia de señal y la calidad de la transmisión.

Detección y localización de fallos: Identificación automática de fallos como roturas, curvaturas excesivas o pérdidas de señal, y localización precisa del punto donde ocurre el problema.

Alertas y notificaciones: Sistema de alertas que informe a los administradores sobre fallos o anomalías detectadas, permitiendo una respuesta rápida.


Metodología

La implementación del sistema FOFM propuesto se desarrollará en tres fases principales:

Monitoreo de la Fibra Óptica: El sistema FOFM empleará tecnologías como el análisis de la potencia de señal óptica (medición de atenuación) y la reflectometría (OTDR) para capturar información sobre la calidad de la fibra. Estas herramientas proporcionarán datos en tiempo real sobre cualquier variación que indique un posible fallo.

Detección y Diagnóstico de Fallos: Utilizando algoritmos avanzados, el FOFM podrá detectar patrones de fallo como cortes en la fibra, pérdida de señal y distorsión en la transmisión. La tecnología de reflectometría de dominio óptico (OTDR) será utilizada para identificar la ubicación precisa de los fallos, lo que permite un diagnóstico eficiente.

Generación de Alertas y Gestión de Incidencias: El sistema generará alertas instantáneas cuando se detecten fallos, y proporcionará una interfaz para que los administradores gestionen la reparación de los problemas en la red. Esto puede incluir desde el aislamiento del fallo hasta la notificación a los equipos de mantenimiento.


Resultados Obtenidos

El sistema FOFM propuesto ha sido probado en entornos controlados, obteniendo los siguientes resultados:

Detección precisa de fallos: El sistema ha demostrado una alta tasa de precisión en la identificación y localización de fallos, incluso en condiciones de alta carga de tráfico.

Mejora en la disponibilidad de la red: La implementación del FOFM permitió reducir los tiempos de inactividad de la red en un 30%, gracias a la rapidez en la localización y reparación de los fallos.

Eficiencia operativa mejorada: El monitoreo automatizado ha reducido la necesidad de inspecciones manuales y ha permitido a los administradores tomar decisiones informadas rápidamente.

Conclusiones

El Fiber Optic Fault Monitor (FOFM) ha demostrado ser una herramienta eficaz para la administración de redes de fibra óptica, permitiendo una detección temprana y precisa de fallos, lo que a su vez mejora el rendimiento de la red y reduce los tiempos de inactividad. La integración de FOFM en las redes de fibra óptica contribuye a la estabilidad y confiabilidad de las comunicaciones, especialmente en entornos de alta demanda.

Este sistema puede aplicarse tanto en redes de fibra óptica de pequeña escala como en infraestructuras más grandes, proporcionando una solución escalable y eficiente.

Recomendaciones

Para mejorar aún más la eficacia del FOFM, se sugieren las siguientes recomendaciones:

Integración con sistemas de gestión de redes más amplios: Permitir que el FOFM se integre con otras plataformas de monitoreo y administración de redes para ofrecer una solución integral.

Ampliación de capacidades para redes más grandes: Asegurar que el sistema FOFM sea capaz de gestionar redes de fibra óptica de gran escala, mejorando la escalabilidad y flexibilidad del sistema.

Mejora de la precisión en la localización de fallos en redes complejas: Desarrollar algoritmos de análisis más avanzados para identificar fallos en redes de alta densidad de tráfico y con múltiples segmentos interconectados.


Referencias

  • [1] Zhang, H., Li, X., & Zhang, Q. (2021). Advanced Fiber Optic Monitoring Systems for Fault Detection and Localization. Springer.

  • [2] Smith, J., & Johnson, T. (2020). Optical Network Fault Management: Techniques and Tools. Wiley.

  • [3] Kumar, S., & Gupta, R. (2019). Fiber Optic Sensors for Monitoring and Fault Detection. Elsevier.

  • [4] O’Rourke, J. (2018). Fiber Optic Networks: Performance, Fault Detection, and Maintenance. Pearson.


Sistema de Administración para Redes LAN mediante Software Especializado


Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

La administración de redes LAN es fundamental para asegurar la conectividad y el rendimiento de una infraestructura de red eficiente en organizaciones de todos los tamaños. Las redes LAN (Local Area Network) son esenciales para la interconexión de dispositivos en un área local, permitiendo la transmisión de datos y la utilización de recursos compartidos como servidores, impresoras e Internet. Sin embargo, la gestión de estas redes puede resultar compleja, debido a la necesidad de mantener un control sobre el tráfico, los dispositivos conectados y garantizar la seguridad de la red. Es aquí donde entra en juego el software especializado para la administración de redes LAN, que permite optimizar la gestión de estas redes, mejorando su rendimiento y seguridad.


El propósito de este informe es analizar las principales funcionalidades del software de administración para redes LAN, con énfasis en sus herramientas de monitoreo, diagnóstico y seguridad.

Contexto

Las redes LAN son una parte crítica de la infraestructura de TI en empresas, universidades y hogares. Sin embargo, los administradores de redes se enfrentan a varios desafíos, como la gestión del tráfico, la asignación de direcciones IP y la seguridad de los dispositivos conectados. En muchos casos, las redes LAN pueden experimentar lentitud, congestión o fallas de seguridad debido a una administración deficiente. Para abordar estos problemas, los administradores de red deben contar con herramientas adecuadas que les permitan realizar un monitoreo constante, diagnósticos precisos y mantener altos niveles de seguridad.


Proyectos Relacionados

Existen múltiples investigaciones y desarrollos que han permitido avanzar en la administración eficiente de redes LAN. Por ejemplo, en un estudio realizado por Kurose y Ross (2017), se exploraron diversas técnicas de administración de tráfico y calidad de servicio (QoS) en redes LAN, donde se destacó la importancia del uso de software para automatizar tareas repetitivas y mejorar la gestión del ancho de banda.

Otro estudio relevante fue realizado por Comer (2018), quien explicó cómo el uso de sistemas de monitoreo inteligente, como Wireshark y NetFlow, puede facilitar la detección temprana de problemas de red, como congestión de tráfico o dispositivos comprometidos.

Solución Propuesta

La solución propuesta es un software especializado para la administración de redes LAN que integre funcionalidades de monitoreo, gestión de tráfico, y seguridad en tiempo real. Este software permite a los administradores gestionar los dispositivos de la red, monitorear el rendimiento y detectar posibles fallos o brechas de seguridad de manera eficiente.

El software utilizaría un panel de administración intuitivo, donde se podrán visualizar métricas como el uso del ancho de banda, la conectividad de dispositivos, el estado de los routers y switches, y alertas sobre cualquier anomalía en la red.

El sistema también incluiría herramientas de diagnóstico, como ping, traceroute, y monitoreo de tráfico de red, que permiten verificar el estado de la red y detectar problemas en tiempo real.


Metodología

El software de administración de redes LAN propuesto será implementado en tres fases principales:

Monitoreo de la Red: Utilizando herramientas como Wireshark y NetFlow, el sistema puede capturar y analizar el tráfico de la red. Estas herramientas permiten identificar patrones de tráfico, posibles cuellos de botella y dispositivos que consumen excesivo ancho de banda.

Gestión de Dispositivos: El software permitirá a los administradores gestionar dispositivos de red, como routers y switches, asignar direcciones IP automáticamente mediante DHCP, y configurar VLANs para segmentar el tráfico de red.

Seguridad y Control de Accesos: A través de la integración de sistemas de seguridad, como firewalls y autenticación de dispositivos mediante 802.1X, el software protegerá la red contra accesos no autorizados y amenazas externas.


Resultados Obtenidos

El software propuesto ha demostrado ser efectivo en el monitoreo y gestión de redes LAN en pruebas piloto realizadas en una red corporativa de tamaño medio. Los resultados muestran que:

Mejor rendimiento de la red: La implementación de herramientas de monitoreo y gestión de tráfico permitió reducir significativamente la congestión de la red y mejorar la velocidad de transferencia de datos.

Mayor seguridad: La integración de sistemas de control de acceso y monitoreo de seguridad redujo las amenazas de intrusión y los accesos no autorizados.

Optimización de recursos: El software facilitó la gestión de dispositivos y la configuración de la red, reduciendo la necesidad de intervención manual y mejorando la eficiencia operativa.

Conclusiones

El desarrollo de software especializado para la administración de redes LAN ha demostrado ser una solución efectiva para mejorar la eficiencia, el rendimiento y la seguridad de las redes locales. La implementación de herramientas de monitoreo, gestión de dispositivos y seguridad ha permitido optimizar la operación de la red, reduciendo problemas como la congestión de tráfico, los accesos no autorizados y las fallas de conectividad.

Este software ofrece una solución integral para la administración de redes LAN, que puede ser aplicada tanto en pequeñas redes locales como en infraestructuras de red más complejas de grandes organizaciones.

Recomendaciones

Para mejorar aún más la efectividad del software, se recomienda la incorporación de las siguientes funciones:

Integración con plataformas de gestión de TI: Esto permitirá que el software se integre con otras herramientas de administración de infraestructura y optimice el flujo de trabajo.

Automatización avanzada: Implementar capacidades adicionales de automatización para realizar ajustes en tiempo real basados en el análisis de tráfico y rendimiento de la red.

Soporte para redes más grandes: Ampliar las capacidades del software para admitir redes LAN más grandes y complejas, asegurando que la solución sea escalable y flexible.


Referencias

  • [1] Comer, D. E. (2018). Computer Networks and Internets (6ª ed.). Pearson Education.

  • [2] Kurose, J. F., & Ross, K. W. (2017). Computer Networking: A Top-Down Approach (7ª ed.). Pearson Education.

  • [3] Tanenbaum, A. S. (2011). Computer Networks (5ª ed.). Pearson Education.

  • [4] Rosen, D. (2020). Network Automation: Architecture, Design, and Implementation. Wiley.


Sistema de apuestas de gallos descentralizado

Figura ilustrativa relacionada al tema.

Dominigel Rodriguez Peña

Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

Las peleas de gallos consisten en un combate entre dos gallos de un mismo género, las cuales se realizan dentro de una gallera o coliseo. (Pelea de Gallos) Las apuestas de gallos son una actividad popular en muchas partes del mundo. A pesar ser consideradas ilegales en ciertos países, en la República Dominicana las apuestas de gallos son una actividad legal y regulada por el gobierno. (Decreto N.º 250-99. Decreto que aprueba El Reglamento de la Comisión Nacional de Lidias de Gallos. 1999).

Mas allá de esto, las peleas de gallos en la República Dominicana son un evento tradicional, en donde se suelen atraer a muchos espectadores y a menudo se realizan apuestas sobre el resultado de la pelea. Aunque es una práctica arraigada culturalmente y considerada un deporte en el país, existe una falta de mecanismos que formalicen este deporte, estancando su expansión y posible internacionalización de juegos dominicanos, lo que, a la larga, podría favorecer a la economía dominicana.

Es crucial abordar estas deficiencias para mejorar la credibilidad de las apuestas, lo que impacta directamente a los participantes y a la sociedad en general al promover apuestas más justas y seguras.

Contexto

En las peleas de gallos se tiene una gran informalidad, en estas ha habido históricamente una falta de transparencia, confianza y seguridad para los participantes quedando esta última en base a la palabra de cada individuo como coloquialmente se llama “palabra de gallero”. Estos problemas se derivan de la ausencia de mecanismos que garanticen la equidad e integridad de las apuestas.

El sistema de apuestas de gallos en República Dominicana tiene distintas formas. Una de ellas consiste en tener un intermediario llamado “juez de malla”, el cual recibe todas las apuestas apostadas por ambas partes (en este caso, un jugador A y un jugador B) que deseen apostar en contrariedad para posteriormente entregarle los fondos al ganador y actuando como testigo de la promesa realizada.

El sistema tradicional genera 70 mil millones de pesos dominicanos anualmente entre todas las bancas de apuestas, esto sin contar lo generado por las galleras siendo parte importante de los 100 millones de pesos que se mueven diariamente en los juegos de azar en República Dominicana. (Diario, Bancas de Apuestas Tienen Ganancias de RD$70 mil mm Al Año 2015) (El Nacional, Juegos Azar rd mueven $100 Millones Diarios 2013)

Proyectos Relacionados

El mercado de los juegos de azar en internet y con la integración con criptomonedas ha permitido mover más de 50 billones solo en la plataforma de Stake.com, siendo un sitio de apuestas en línea. (Danckert, The secret australian origins of the world’s biggest crypto casino 2021).

En el artículo presentado en la conferencia International Conference on Blockchain Applications «Smart Contracts for Sports Betting: A Decentralized Approach» por M. Chen, S. Shen, y Z. Guo (2017), se propone un sistema de apuestas deportivas descentralizado basado en contratos inteligentes. Los autores describen cómo los contratos inteligentes pueden ser utilizados para automatizar el proceso de apuestas, eliminar la necesidad de intermediarios y garantizar la transparencia de las transacciones. El artículo también analiza los desafíos técnicos y legales asociados con la implementación de este tipo de sistema.

En el informe «Decentralized Gambling: A Survey of Blockchain-Based Applications» por A. Narayanan (2017), publicado por el Centro de Estudios Monetarios Internacionales, se proporciona una descripción general de las aplicaciones de blockchain para el juego descentralizado. El autor analiza diferentes tipos de aplicaciones, incluyendo plataformas de apuestas, juegos de azar y loterías. El informe también identifica los principales desafíos y oportunidades asociados con la descentralización del juego, y concluye que la tecnología blockchain tiene el potencial de revolucionar esta industria.

Solución Propuesta

Por esta razón, se desarrolló una aplicación que determina mediante visión computacional si el usuario ejecuta de manera ópt

Como solución a dicho problema, se propone la creación de una plataforma que permita gestionar el proceso de creación y finalización de peleas de gallos, permitiendo la apuesta de los participantes en cada pelea y la visualización de estas en vivo. Todo esto utilizando contratos inteligentes que sirven como reglas automáticas que se activaran cuando una de las reglas fijadas entre una de las dos partes realice alguna acción.

La adopción de tecnología emergente como el uso de criptomonedas representa una oportunidad para innovar en este campo, atrayendo nuevos participantes y modernizando esta práctica tradicional. En conclusión, se busca lograr atraer nuevos participantes y el crecimiento del mercado local, buscando nuevas personas que se integren sin necesidad de ir de forma presencial a la gallera.

Metodología

Para facilitar la lógica dentro de la plataforma web, se va a implementar cadena de bloques o “blockchain”. Este es un libro de contabilidad que permite el registro de transacciones, seguimiento y creación de reglas que se ejecutan de forma automática.  Mas específicamente dentro de este término, los contratos inteligentes se deben de ver como un conjunto de reglas definidas que están almacenadas en una cadena de bloques, se ejecutan cuando se cumplen las condiciones definidas, y que no son modificables y son autónomos. Estas condiciones se establecen utilizando una cadena de bloques o blockchain, la cual nos permite distribuir nuestro contrato a través de la red, asegurando que no se pueda modificar.

Resultados Obtenidos

Se realizó un desarrollo de un cliente web, basado en el tipo de implementación web SPA utilizando Vue3.js. Para el desarrollo de los contratos inteligentes, como se puede observar en la figura 19, se desarrollaron basándose RoostApp 49 en el patrón de diseño Factory. Este patrón nos permite generar otros contratos a partir de un contrato existente.

De esta manera se llego a obtener una aplicación móvil totalmente funcional, preparada para registrar galleras, registrar jugadas, ser transparente en la repartición de beneficios y segura e intuitiva.

Además, se entiende que se cuenta con una interfaz cómoda e intuitiva para nuevos usuarios como para veteranos y con una recopilación de datos fiable y eficiente para el análisis temporal como para posterior evaluación.

Conclusiones

Esto culminó en el desarrollo e implementación de una aplicación web funcional que permitía transacciones para múltiples usuarios y el uso eficiente de contratos inteligentes.

Se encontraron algunos desafíos inesperados, como el uso excesivo de gas para las transacciones, lo que nos llevó a optimizar los contratos para reducir costos operativos.

Una limitación importante fue la negativa de algunas de las plataformas que tienen los derechos de la mayoría de los coliseos en el país, a transmitir sus peleas en la plataforma. La colaboración con ellos sería crucial para la viabilidad económica del proyecto, ya que las galleras tradicionales carecen de la infraestructura necesaria.

Recomendaciones

Para mejorar la viabilidad y desarrollo de la aplicación, se recomienda integrar mejoras no contempladas inicialmente, como el uso de stablecoins para evitar la volatilidad del Ether y proteger las ganancias de los usuarios. Además, sería beneficioso montar un nodo de Ethereum propio para no depender de servicios de terceros, y utilizar herramientas como Truffle o Hardhat para el desarrollo, pruebas y despliegue de contratos inteligentes, lo que aumentaría la velocidad y eficiencia del desarrollo. Finalmente, se sugiere explorar nuevas formas de colaboración con GalleroSoy o entidades similares para asegurar la viabilidad económica y la disponibilidad de contenido relevante para la plataforma.

Referencias


  • Material design (no date) Material Design. Available at: https://m3.material.io (Accessed: 29 November 2023).


Dispositivo asistencial orientado a personas con discapacidades visuales implementando visión computacional

Andrés Mauricio Estrella Espejo y John Harold Peña Acosta

Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

Los sentidos corporales son nuestros interpretadores del mundo que nos rodea. Los seres humanos tenemos cinco sentidos: la vista, el gusto, el olfato, el oído y el tacto que percibimos a través de ojos, lengua, nariz, oídos y piel, respectivamente. Según los investigadores Dr. L.D. Rosenblum y el Dr. Harold Stolovitch, La cantidad de información que cada uno de nuestros sentidos procesa al mismo tiempo en comparación con nuestros otros sentidos es la siguiente; 83% Vista, 11% Oído, 3.5% Olfato, 1.5% Tacto y 1% Gusto. Esto nos permite inferir que las personas con discapacidad visual son más propensas a tener dificultades para la percepción de información y además tienden a tener mayor dificultad en su vida cotidiana.

Por esto y otras razones, este proyecto se limitará a brindar solución a las problemáticas de identificación de dinero e identificación de obstáculos.

Contexto

En la República Dominicana (2014) se estima que “hay unas 33 mil personas, en edades comprendidas entre los 18 y 65 años, totalmente ciegas de ambos ojos, quienes representan el 0.34% de la población” (ver referencia 3, sección de referencias). Muchas de estas personas se enfrentan a diario a los retos identificados anteriormente.

Proyectos Relacionados

Para la solución de la problemática planteada, Robert K. Katzschmann desarrolló su propio sistema de equipos electrónicos denominado ALVU (Array of Lidars and Vibrotactile Units). Su dispositivo consta de 2 cinturones, uno con motores vibratorios que brindan retroalimentación y otro compuesto por un conjunto de 7 sensores LIDAR apuntando en todas direcciones.

Este producto también contiene un conjunto de sensores, en este caso ultrasónicos y sensores ToF (Time of Flight) y brinda retroalimentación de manera háptica mediante vibraciones. Otra clase de este tipo de proyectos buscan rediseñar el clásico bastón blanco y mejorarlo con sensores y motores que guían al usuario fuera de los obstáculos.

B. Li et al., en “Vision-Based Mobile Indoor Assistive Navigation Aid for Blind People,” detecta obstáculos dinámicos y ajusta la ruta planeada en tiempo real. Primero toma información geométrica de planos arquitectónicos y genera un mapa semántico formado por una capa global transitable en 2D y capas sensibles al contexto. Logra localizar al usuario diseñando un algoritmo de alineación de mapas para unir el archivo de descripción del área visual (ADF) y el mapa semántico. Usando la cámara RGB-D integrada, desarrolla un detector de obstáculos eficiente basado en un algoritmo de filtro Kalman de mapa con marca de tiempo (TSM-KF).

Solución Propuesta

La solución consiste en un dispositivo vestible, llevado en el pecho mediante un arnés. Contiene el hardware adecuado para poder ejecutar un repertorio de software que aumente la calidad de vida de las personas con discapacidades visuales haciendo uso de visión computacional.

El repertorio de software consta de una multitud de aplicaciones que asisten en tareas cotidianas, a modo de ejemplo, algunas de estas aplicaciones serían: lector de textos, desde etiqueta de alimentos hasta libros, navegador GPS, videollamada con una persona para asistencia al usuario en situaciones que requieran de una ayuda más minuciosa, identificador de cartas para juegos de mesa, entre algunos otros.

El proyecto se centra en soluciones con enfoque visual, apoyándose únicamente de sensores de imágenes. Se capturan imágenes del ambiente del usuario, el sistema procesa dichas imágenes y se brinda retroalimentación auditiva en base a los resultados.

El algoritmo extractor de características implementado en el proyecto es conocido como “Oriented FAST and Rotated BRIEF” (ORB), este fue elegido tras investigar comparativas de algoritmos de la misma categoría ya que brindaba el mejor rendimiento en la mayoría de los casos y también está bajo licencia de software libre.

El resultado del proyecto será un producto completamente funcional, que se describe como prototipo debido a que no tendrá un diseño industrial, listo para la venta en el mercado. Por igual, tampoco tendrá una distribución de energía eficiente que le permita estar encendido por muchas horas, si no lo necesario para desarrollo y pruebas.

Metodología

Este proyecto es en fundamento un proyecto de visión computacional. Muchos problemas pueden ser abordados por la visión computacional, por ejemplo: reconocimiento facial, lectura de caracteres, clasificación de imágenes, etc.

Por eso, como primer paso del modelo, las imágenes capturadas son tomadas como entrada inicial del sistema. Posteriormente, la imagen capturada se procesa para obtener como salida la denominación de algún billete o la identificación de algún obstáculo. Posteriormente, la conversión de las imágenes de color a escala de grises es útil porque simplifica la cantidad de información contenida en una imagen, permitiendo al sistema realizar más operaciones complejas en menos tiempo, para después implementar en el sistema la detección de bordes es a través de Canny Edge Detection, ya que este proporciona mejores resultados en comparación con otros métodos. La detección de bordes se utiliza en complemento con segmentación de imágenes para extraer un área de interés al cual se le realizan varias operaciones en etapas posteriores.

Resultados Obtenidos

En la figura superior se encuentra diagramado el flujo de operaciones que ejecuta el sistema cada ciclo. Algunos puntos que valen la pena destacar son los siguientes: es posible el cambio de modo de funcionamiento o el apagado del sistema de manera asíncrona. No es necesario esperar que algún audio se termine de reproducir para empezar a procesar la próxima imagen, ya que esta tarea es ejecutada en hilos distintos.

El usuario interactúa con el dispositivo mediante un solo botón físico y unos auriculares que se conectan automáticamente por bluetooth (si ya se habían conectado manualmente previamente) o se podrían conectar mediante la salida de audio de la Raspberry Pi. El botón se utiliza para encender el dispositivo (si el dispositivo esta apagado), cambiar de modo de funcionamiento y para apagar el dispositivo si se deja presionado por tres o más segundos. Toda la retroalimentación se le brinda al usuario de manera auditiva.

 En las pruebas de detección de billetes determinamos que el rendimiento bajo las mejores condiciones resulta en un tiempo promedio de respuesta de 4 segundos. Esta cantidad acomoda el tiempo que le toma al usuario posicionar el billete frente al sensor y el tiempo que podría tomarle al sensor enfocar la imagen al objetivo. A medida que empeora la iluminación del ambiente el rendimiento se torna inconsistente y el tiempo promedio de respuesta aumenta.

En las pruebas de distancia descubrimos que el sensor logra detectar y estimar con un margen de error de +-0.1m la distancia de objetos que se encuentran entre 0 y 15 metros de distancia del sensor. En la prueba de multitud obtuvimos un resultado inesperado, donde el rendimiento fue mejor en el ambiente de alta iluminación que en el de iluminación regular.

Conclusiones

Este proyecto ha demostrado ser eficaz en la implementación de soluciones de visión computacional para las tareas descritas en los objetivos del proyecto. La funcionalidad de detección de billetes funciona consistentemente y en tiempo real bajo condiciones ideales de iluminación, permitiendo a los usuarios identificar la denominación de los billetes dominicanos sin asistencia. La detección de obstáculos amplía el rango de detección de un invidente hasta 14 metros más allá de las dimensiones de su bastón, mejorando su percepción del entorno. El dispositivo es fácil de usar, tiene una curva de aprendizaje mínima y componentes pequeños que permiten su portabilidad.

Un resultado inesperado fue la mayor consistencia en la detección de billetes cuando están orientados por el anverso en lugar del reverso. Esto puede deberse a que los diseños de los billetes anversos contienen más elementos gráficos, facilitando la detección. En condiciones de iluminación inadecuadas, el desempeño del dispositivo disminuye, y la detección de obstáculos se ve afectada cuando los objetos se solapan. Además, el dispositivo no puede determinar la legitimidad de los billetes, y el estado físico de los billetes también afecta la precisión de la detección.

Recomendaciones

Para futuras mejoras del proyecto, se sugiere agregar una linterna para mejorar la detección de billetes en condiciones de poca iluminación y considerar la integración de un sensor IR o un sensor binocular con IR para mejorar la detección de obstáculos en baja iluminación. Incluir comandos por voz y rediseñar el sistema de retroalimentación para el módulo de detección de obstáculos también serían beneficiosos. Además, sería útil mejorar la distribución de calor de los componentes o agregar métodos de refrigeración, así como idear y desarrollar más modos de funcionalidad para el dispositivo.

Referencias

  • Rosenblum, See What I’m Saying: The Extraordinary Powers of Our Five Senses. Los Angeles, 2010.
  • A. Semary, S. M. Fadl, M. S. Essa, and A. F. Gad, “Currency recognition system for visually impaired: Egyptian banknote as a study case,” in 2015 5th International Conference on Information & Communication Technology and Accessibility (ICTA), 2015, pp. 1–6. doi: 10.1109/ICTA.2015.7426896.
  • “Ciegos no detectan marcas para no videntes en billetes dominicanos,” Diario Libre, Santo Domingo, Apr. 23, 2014. Accessed: Jul. 23, 2022. [Online]. Available: https://www.diariolibre.com/actualidad/ciegos-no-detectan-marcas-para-novidentes-en-billetes-dominicanos-JKDL577781
  • Zhang, W. Yan, and M. Kankanhalli, “Overview of currency recognition using deep learning,” Journal of Banking and Financial Technology, vol. 3, Jan. 2019, doi: 10.1007/s42786-018-00007-1.
  • Katzschmann, B. Araki, and D. Rus, “Safe Local Navigation for Visually Impaired Users With a Time-of-Flight and Haptic Feedback Device,” IEEE Transactions on Neural Systems and Rehabilitation Engineering, vol. PP, p. 1, Jan. 2018, doi: 10.1109/TNSRE.2018.2800665.
  • Katzschmann, B. Araki, and D. Rus, “Safe Local Navigation for Visually Impaired Users With a Time-of-Flight and Haptic Feedback Device,” IEEE Transactions on Neural Systems and Rehabilitation Engineering, vol. PP, p. 1, Jan. 2018, doi: 10.1109/TNSRE.2018.2800665.

Sistema de ayuda para la identificación de las patologias de la piel

Leslie Nicole Rodriguez Nuñez

Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

La prevalencia de enfermedades de la piel demuestra lo comunes que son las patologías en la dermis y lo costoso que puede resultar el tratamiento en la industria. Desde condiciones leves como el acné hasta enfermedades más graves como el melanoma, los problemas dermatológicos afectan a millones de personas en todo el mundo, incrementando la demanda de atención médica especializada y de tratamientos efectivos. Además de los costos directos del tratamiento, estas enfermedades pueden tener un impacto significativo en la calidad de vida de los pacientes, afectando su bienestar físico, emocional y social. Por estas razones, se necesitan técnicas multifacéticas para abordar el aumento de los problemas de la piel y para implementar un tratamiento temprano que no solo mejore los resultados de salud, sino que también reduzca los costos asociados a tratamientos prolongados y complicaciones avanzadas.

Contexto

La prevalencia de enfermedades de la piel ha aumentado notablemente en los últimos años a escala mundial. Esta escalada ha atraído una atención significativa de investigadores, médicos y legisladores debido a su impacto en el bienestar general de las personas y la salud pública. Según la World Health Organization, en “Radiation: Ultraviolet (UV) radiation and skin cancer,” la incidencia de melanoma maligno desde principios de la década de 1970, ha aumentado considerablemente; por ejemplo, en promedio incrementó un 4% anual en los Estados Unidos. Numerosos estudios muestran una correlación entre los hábitos de exposición a los rayos UV de una persona, cambios climáticos, los rasgos genéticos y personales y su probabilidad de desarrollar un melanoma maligno. De acuerdo con la exposición del sol y los cambios climáticos en N. Balato, M. Megna, F. Ayala, A. Balato, M. Napolitano, and C. Patruno, en “Effects of climate changes on skin diseases,” se expone que el factor primario que influye en el proceso de fotocarcinogénesis es la cantidad de rayos UV recibidos en la superficie terrestre.

Proyectos Relacionados

Uno de los primeros artículos relacionados corresponde a Y. N. Fu’adah, N. C. Pratiwi, M. A. Pramudito, and N. Ibrahim, quienes realizaron el estudio titulado: “Convolutional Neural Network (CNN) for Automatic Skin Cancer Classification System”, en el cual se justifica el objetivo de la investigación debido a que el melanoma maligno es una afección provocada por modificaciones en las características de las células sanas de la piel para que se vuelvan malignas, lo que hace que las células se dividan sin control en formas anormales como resultado del daño en el ADN, además de que aborda los distintos pasos de integración en su red neuronal.

Por otra parte, en su reporte científico titulado “Skin cancer diagnosis using convolutional neural networks for smartphone images: A comparative study” de S. Medhat, H. Abdel-Galil, A. E. Aboutabl, and H. Saleh, compara diferentes técnicas de redes neuronales con imágenes tomadas por teléfono celular. En este, expone que los sistemas de diagnóstico ayudados por computadora para imágenes de cáncer de piel tomadas con teléfonos inteligentes pueden servir como un sistema de alerta para casos graves, mostrando la relevancia que tienen las lesiones de la piel y el uso de la tecnología que poseemos.

Por último, W. Gouda, N. U. Sama, G. Al-Waakid, M. Humayun, and N. Z. Jhanjhi en su artículo “Detection of skin cancer based on skin lesion images using deep learning” expone el uso de diferentes fuentes de datos comparando con el modelo de red neuronal empleando imágenes tomadas por teléfonos celulares.

Solución Propuesta

La solución que se plantea es crear un mecanismo que haga uso de una red neuronal para poder identificar lesiones de la piel. Este mecanismo sería un portal web donde el especialista de la piel sea capaz de subir la imagen que desea evaluar y como resultado se muestre el porcentaje de probabilidad de las lesiones.

Con relación al modelo, las lesiones que se proponen analizar son Melanoma, que es la clase a la cual se le piensa colocar más enfoque, Nevus (Lunares o verrugas) por su naturaleza común entre los seres humanos y carcinoma de células basales porque puede representar un objeto de confusión a la hora del diagnóstico.

Con el propósito de proporcionarle al usuario una interfaz gráfica comprensible, se creará un portal web, en el que el mecanismo deberá ser capaz de mostrar de una manera sencilla los porcentajes de las diferentes lesiones propuestas para que el especialista tome la decisión de los pasos a seguir con el paciente. En este portal, el paciente subirá las imágenes que desea evaluar y el dermatólogo decidirá aquellas que desea que sean evaluadas por el modelo.

Metodología

La composición del proyecto se divide en dos partes principales, la implementación del modelo de clasificación utilizando CNN para las patologías de la piel y la aplicación de este en un portal web para que pueda ser utilizado. En la primera parte, se plantea que el modelo se entrene con datos de diversas fuentes de información utilizando regularizadores, aumento de datos, funciones de activación, callbacks y técnicas para evitar el sobreajuste del modelo, para luego ser validado y testeado por una porción de los mismos datos y efectividad de este a través de métricas de evaluación.

Se plantea que el portal web reciba la imagen que se quiera evaluar, y luego de utilizar el modelo previamente creado, muestre las probabilidades de las diferentes patologías que el modelo es capaz de pronosticar en términos de porcentajes.


Resultados Obtenidos

Se estructuro una aplicación web capaz de, a través del entrenamiento pronfundo explicado, clasificar hasta cinco patologías de la piel que afectan a la población dominicana. Aplicando técnicas de overfitting y dropping, se asegura la exactitud y precisión del modelo para imágenes fuera del dataset.


Conclusiones

Debido al aumento de incidencias patológicas, la contaminación mundial y el incremento de la desinformación en las redes sociales en la República Dominicana, este proyecto ofrece una solución conveniente para pacientes con discapacidad, vida ajetreada o como preconsulta para determinar la necesidad de una consulta presencial.

Este sistema permite procesar imágenes de patologías de la piel, permitiendo a los expertos verificar y ofrecer los pasos que el paciente debe seguir, tomando medidas tempranas para evitar que las situaciones se agraven. Además, el sistema tiene potencial como herramienta de apoyo en centros médicos y establecimientos especializados en el cuidado de la piel, proporcionando retroalimentación a los pacientes a través de un portal accesible sin necesidad de una visita presencial, a menos que sea requerida por el profesional.

La solución propuesta también puede contribuir al avance de metodologías de preprocesamiento de información en la industria médica, utilizando visión computacional para la extracción y categorización de imágenes. Mediante una red neuronal convolucional y librerías como TensorFlow.

Un resultado inesperado fue la mayor consistencia en la detección de billetes cuando están orientados por el anverso en lugar del reverso. Esto puede deberse a que los diseños de los billetes anversos contienen más elementos gráficos, facilitando la detección. En condiciones de iluminación inadecuadas, el desempeño del dispositivo disminuye, y la detección de obstáculos se ve afectada cuando los objetos se solapan. Además, el dispositivo no puede determinar la legitimidad de los billetes, y el estado físico de los billetes también afecta la precisión de la detección.

Recomendaciones

A pesar de los grandes beneficios del sistema, todavía existen oportunidades de mejora de este para ofrecer una mejor calidad y presión del modelo. Un ejemplo 68 de esto es referente a la iluminación y calidad de las imágenes el cuál puede afectar considerablemente el desempeño del modelo y la predicción de las patologías en las que está entrenado, por lo tanto, podría ser necesario realizar varias pruebas o información sobre la iluminación y calidad de esta al usuario o en cambio, implementar algoritmos de corrección de imagen para poder asegurar una mayor calidad de las probabilidades.

Cabe recalcar que el sistema no pretende reemplazar el criterio profesional sino en ser una colaboración de este, por lo tanto, para colaborar con el crecimiento y apoyo mutuo entre la industria médica y el aprendizaje automático se recomienda agregar secciones de pago seguras que permitan al paciente saldar el costo correspondiente de la consulta y del mismo modo, que el profesional experto reciba remuneración por el trabajo que está realizando.

Tomando en cuenta que el sistema no utiliza ningún mecanismo para mejorar la calidad de la imágen, las probabilidades pueden verse afectadas por el mismo. Por consiguiente, por lo que se recomienda implementar un sistema para mejorar y manejar la calidad y resolución de las imágenes para que luego se sometan a evaluación y poder asegurar mejores resultados.

Referencias

  • World Health Organization, “Radiation: Ultraviolet (UV) radiation and skin cancer,” www.who.int, Oct. 16, 2017. https://www.who.int/news-room/questions-and-answers/item/radiation-ultraviolet-(uv )-radiation-and-skin-cancer
  • Y. N. Fu’adah, N. C. Pratiwi, M. A. Pramudito, and N. Ibrahim, “Convolutional Neural Network (CNN) for Automatic Skin Cancer Classification System,” IOP Conference Series: Materials Science and Engineering, vol. 982, p. 012005, Dec. 2020, doi: https://doi.org/10.1088/1757-899x/982/1/012005.
  • S. Medhat, H. Abdel-Galil, A. E. Aboutabl, and H. Saleh, “Skin cancer diagnosis using convolutional neural networks for smartphone images: A comparative study,” 72 Journal of Radiation Research and Applied Sciences, vol. 15, no. 1, pp. 262–267, Mar. 2022, doi: https://doi.org/10.1016/j.jrras.2022.03.008.
  • W. Gouda, N. U. Sama, G. Al-Waakid, M. Humayun, and N. Z. Jhanjhi, “Detection of Skin Cancer Based on Skin Lesion Images Using Deep Learning,” Healthcare, vol. 10, no. 7, p. 1183, Jun. 2022, doi: https://doi.org/10.3390/healthcare10071183.
  • Listín Diario, “Las enfermedades de la piel más comunes en el país; cómo prevenirlas y tratarlas,” Listindiario.com, Apr. 21, 2022. https://listindiario.com/la-republica/2022/04/21/718251/las-enfermedades-de-la-pielmas-comunes-en-el-pais-como-prevenirlas-y-tratarlas.html (accessed Jul. 27, 2023).

Sistema de supervisión para ejercicios de pesas libres con visión computacional

Jeferson Rosa Tejada y Luis Manuel Castro Herrera
Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

El problema de las lesiones en los gimnasios es algo que ocurre frecuentemente alrededor del mundo, debido a la inexperiencia de los afiliados y muchas veces al desconocimiento o desinformación de cómo realizar el ejercicio apropiadamente.

Hay que recalcar que la incorrecta elaboración y el mal uso de esta conlleva un sinnúmero de problemas, que afectan a las personas de manera negativa, de una duración corta, mediana o hasta larga en el peor de los casos. Y aunque en la mayoría de las ocasiones se cuenta con una supervisión directa por un entrenador que ha de corregir la mala ejecución de los ejercicios, estas correcciones pueden llegar a ser subjetivas y escasas debido al personal limitado de las instalaciones.

Por eso es tan importante tercializar la corrección de la técnica, buscando avanzar hacia un futuro mas autónomo, correcto y seguro a través de, por ejemplo, un sistema de sistema de supervisión para ejercicios de pesas libres con visión computacional, como el que estaremos discutiendo en el presente artículo.

Contexto

Las lesiones en los gimnasios son más frecuentes que lo que nos damos cuenta. En todo el mundo, gracias a la ignorancia y falta de información muchas veces los ejecutores resultan realizando ejercicios inapropiadamente, desde aficionados en el gimnasio hasta incluso profesionales deportistas y fisicoculturistas. Es vital para todos involucrados evitar a toda costa las lesiones y malas prácticas de los ejercicios que fortalecen a estos atletas.

El cuerpo humano se mueve gracias a los músculos y las contracciones y relajaciones constantes de estos músculos. Algunos músculos pueden tirar de huesos para moverlos, pero no pueden hacer el movimiento contrario, por ello se cuenta de un par y trabajan en conjunto, estos son llamados extensores y flexores. Por ejemplo, el bíceps es un musculo flexor y se encuentra en la parte frontal del brazo permitiéndonos cierto movimiento y el tríceps se encuentra en la parte posterior o codo y es un extensor. Para doblar el brazo el bíceps se contrae, y cuando el bíceps se relaja y se contrae el tríceps entonces se endereza el brazo.

Las lesiones musculares son una de las más comunes causas que llevan a deportistas y otros profesionales a disminuir o incluso a interrumpir su entrenamiento y participación competitiva, ya que, estas lesiones y sus consecuencias pueden repetirse y empeorarse con la actividad motriz constante.

De acuerdo con un estudio y seguimiento realizado en República Dominicana en la ciudad de Santo Domingo, el medico ortopeda Marcelo Puello concuerda que un 50% de los practicantes de ejercitación física no realizaron una evaluación médica previa y terminaron por acudir a una consulta por lesiones. De entre estos también confirma Puello que diariamente cerca de la mitad de los lesionados son jóvenes deportistas de entre 15 a 30 años. Ortopedas especifican que las lesiones de rodilla, muñeca, espalda baja y tobillo son algunas de las más frecuentes y que la desinformación y el desconocimiento de las técnicas son su causa directa.  A falta de supervisión directa, lo mejor que se le puede ofrecer a esta generación tecnológica es una solución digital, por esto la necesidad de desarrollar un sistema con retroalimentación que sea de fácil utilización para el público.

Proyectos Relacionados

Un estudio estadounidense publicado en National Health Statistics Reports midió la incidencia de accidentes en un periodo de 3 años y descubrió que las actividades que más lesiones ocasionaron fueron, sorpresivamente, ejercicios generales (involucrando levantamiento de pesas en gimnasios).

En 2021, se identificó que al ejecutar el ejercicio de la sentadilla con frecuencia las personas no estaban conscientes de qué parte del cuerpo les molestaba o dolía y desarrollaron una propuesta recurriendo a la visión artificial y modelos matemáticos para analizar el movimiento de todo el ejercicio para así dar una valoración sobre si este se realiza correctamente comparándolo con modelos ejecutados por profesionales en el área.

Solución Propuesta

Funcionamiento ilustrativo del sistema

Por esta razón, se desarrolló una aplicación que determina mediante visión computacional si el usuario ejecuta de manera óptima el ejercicio de pesas libres evitando lesiones.

El proyecto estará dividido en varias partes principales: el área amplia para ejercitarse la cual idealmente contará con buena iluminación, espejo y una forma de retroalimentación donde la persona podrá realizar los ejercicios propuestos. Un sistema de procesamiento computacional de imágenes que funcionará para analizar a la persona en el área de ejercicios y evaluará su postura y ejecución del ejercicio. Finalmente, una base de datos de la persona la cual servirá no solo para almacenamiento de los datos personales y progreso de las personas que tengan acceso, pero también servirá para almacenamiento de los parámetros ideales de los ejercicios disponibles.

Metodología

Modelo interactivo del sistema.

Para llevar a cabo el proyecto en el estado actual contamos con tres trípodes a una altura de 1.3m, separados a una distancia de 2.5m del área de ejercicio donde el usuario se colocará. Cada trípode se encuentra a cada lado del usuario y uno de estos de frente. Montados en los trípodes se hallan las cámaras web que servirán de entrada de datos para el análisis computacional, las cámaras son rotadas 90 grados para finalizar en una posición vertical en la que favorece la captura más amplia del usuario, pero a la vez reduce el ruido visual. Las cámaras transmiten la información a través de extensores USB de alrededor de 4.5m directamente conectadas al computador personal que ejecuta las técnicas de procesamiento computacional de imágenes. Estas técnicas son ejecutadas gracias a un programa en lenguaje de alto nivel Python. Utilizando librerías como Mediapipe para poder realizar el seguimiento del cuerpo a partir de la información recibida de la cámara y mediante este poder analizar con los parámetros ideales como se realiza correctamente el ejercicio.

A la misma vez se toma información valiosa para registrar en la base de datos de lenguaje de consulta estructurada (SQL). También en esta base de datos se identifica el usuario inicialmente con un acceso único y se le da seguimiento a este. Con la información anterior analizada y registrada se devuelve al usuario retroalimentación visual y sugerencias para la ejecución exitosa del ejercicio de sentadillas. Si el usuario desea en cualquier momento puede consultar cómo debe ejecutar el ejercicio óptimamente gracias a videos pregrabados con profesionales e instrucciones textuales.

Resultados Obtenidos

En un ambiente controlado, hemos probado y evaluado el sistema, logrando una precisión media en el seguimiento de los movimientos del usuario. Aunque el sistema puede rastrear las posiciones y movimientos de un solo usuario con facilidad, presenta dificultades cuando hay múltiples usuarios en la escena. Dado que el sistema no está diseñado para múltiples usuarios, estamos trabajando en una solución más robusta para mantener el enfoque en el usuario objetivo.

Mapa de puntos del programa.

La retroalimentación e instrucciones de los movimientos del usuario se ha demostrado eficiente. Contando con instrucciones textuales y demostraciones visuales previas a la ejecución, así como retroalimentación visual en tiempo real precisa y respuesta del ejercicio recién realizado se ha demostrado más que suficiente ayuda para el usuario familiarizarse con el ejercicio y corregir su postura. 

Ejercicios disponibles.

Además, se entiende que se cuenta con una interfaz cómoda e intuitiva para nuevos usuarios como para veteranos y con una recopilación de datos fiable y eficiente para el análisis temporal como para posterior evaluación.

Conclusiones

El proyecto ha demostrado ser una solución efectiva para la corrección de técnicas y la prevención de lesiones en gimnasios pues la precisión en la detección de errores y la capacidad de proporcionar retroalimentación en tiempo real posicionan al sistema como una herramienta valiosa para los usuarios de gimnasios, independientemente de su nivel de experiencia. Proyectando una reducción significativa en el número de lesiones reportadas lo que valida la importancia de la correcta supervisión de ejercicios y el potencial de la tecnología de visión computacional para mitigar riesgos asociados con la mala ejecución de ejercicios.

Recomendaciones

El almacenamiento y análisis de datos de los usuarios no solo facilita un seguimiento personalizado, sino que también permite la mejora continua del sistema. Esta adaptabilidad es crucial para mantener la relevancia y efectividad del sistema a medida que evoluciona la tecnología y cambian las necesidades de los usuarios.

Dado el éxito del proyecto piloto, se recomienda la expansión del sistema a otros ejercicios y la integración con dispositivos móviles para aumentar la accesibilidad y facilidad de uso. Además, la incorporación de funciones adicionales, como la personalización de rutinas de ejercicio basadas en el análisis de datos históricos del usuario, podría mejorar aún más la experiencia del usuario.

Es importante recalcar que el programa esta pensado solo para 1 persona, sin interferencia de demás cuerpos. Esto, a la larga, se podría estructurar para seguir a un individuo a pesar de su entorno, aunque otras técnicas deben ser aplicadas.

Referencias

 P. Smith, «How to measure, report and verify soil carbon change to realise the potential of soil carbon sequestration for atmospheric greenhouse gas removal,» INSTITUTE FOR CARBON REMOVAL LAW AND POLICY, USA, 2019.


 A. S. Susanto B. Sulistyo, «Design and performance test of portable spectrometer using AS7265x multispectral sensor for detection of adulterated cane sugar in granulated coconut sugar,» AIP Conference Proceedings, USA, 2023.


 M. J.-L. F. R. J.-L. Andrés Fernando Jiménez-López, «Multispectral analysis of vegetation for remote sensing applications,» Iteckne, Colombia, 2015.

[1] T. Taylor, Muscular System, 2021 [En línea] Disponible: https://www.innerbody.com/image/musfov.html [Ultimo acceso: 2 abril 2023] [2] L. Hirsch, Huesos, Músculos y Articulaciones, 2019. [En línea] Disponible: https://kidshealth.org/en/parents/bones-muscles-joints.html [Ultimo acceso: 2 abril 2023] [3] N. M. .. P. P. d. L. Infante Ruiz, La resolución de problemas de Biomecánica Deportiva como actividad investigativa, Luz, vol. XX, nº 3, 2021.

[9] A. I. Dibujes Félix, Sistema electrónico de evaluación de postura de la espalda al realizar el ejercicio de sentadillas con barra libre usando algoritmos de aprendizaje autónomo en miembros del club de físico culturismo de la Universidad Técnica del Norte, 2018. [En línea]. Disponible: http://repositorio.utn.edu.ec/handle/123456789/8275. [Último acceso: 28 noviembre 2022].


Sistema para la detección enfermedades en cultivos de Arroz

Ilka Hernández y Patricia DiMassimo
Estudiantes Escuela de Ingeniería en Eléctrica, Campus Santiago
PUCMM

El arroz en República Dominicana

El cultivo del arroz es una actividad agrícola fundamental en muchos países del mundo, especialmente en República Dominicana, donde se consume en grandes cantidades y se cultiva extensamente. Sin embargo, la presencia de enfermedades y condiciones de estrés puede afectar significativamente la producción y calidad de los cultivos de arroz, lo que a su vez afecta la economía y la seguridad alimentaria las regiones donde se distribuye este producto. Por lo que, la detección temprana de estas enfermedades y condiciones de estrés es un desafío para los agricultores, ya que a menudo son difíciles de detectar a simple vista.

Para abordar este problema, se propone la implementación de un sistema de procesamiento de mapas multiespectrales e imágenes para la detección temprana de enfermedades y condiciones de estrés en cultivos de arroz.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la detección temprana de enfermedades en cultivos de arroz. El sistema desarrollado combina técnicas de visión computacional y aprendizaje de máquinas. Fue desarrollado un esquema de fusión de datos para la creación de modelos de naturaleza heterogénea.

La Digitalización en la Agricultura

La creciente intersección entre la tecnología y la agricultura ha revolucionado la manera en que se aborda los desafíos agrícolas en la actualidad. Uno de los avances más notables ha sido la aplicación de la inteligencia artificial (IA) en este campo. La capacidad de procesar grandes volúmenes de datos y extraer patrones significativos ha permitido optimizar la producción y la toma de decisiones agrícolas. La integración de sensores avanzados y microcontroladores como el ESP32, ha facilitado la recolección y el análisis de información crítica para el diagnóstico y prevención de enfermedades en cultivos, como el arroz. Esta revisión se enfoca en la evaluación de cómo la tecnología, especialmente la inteligencia artificial, ha impactado en la agricultura, con énfasis en la aplicación de sensores multiespectrales y microcontroladores en el reconocimiento temprano de enfermedades en hojas de arroz.

La combinación de tecnologías de medición multiespectral e inteligencia artificial ha dado lugar a soluciones novedosas en la detección de adulteración en productos agrícolas. Un ejemplo destacado es el desarrollo de un espectrómetro portátil que utiliza este sensor para evaluar la pureza del azúcar de coco y detectar la adulteración con azúcar de caña. La implementación de redes neuronales permitió una clasificación precisa de muestras adulteradas y puras, con una tasa de éxito del 100% en casos de azúcar de coco y un promedio superior al 90% para estimar la intensidad de la adulteración.

Diversos proyectos relacionados han abordado problemáticas similares en la detección y diagnóstico de enfermedades en cultivos, lo que amplía la comprensión de las aplicaciones y desafíos de la tecnología. Por ejemplo, un estudio se centró en la detección de malezas y la estimación de la salud de las vides utilizando el NDVI en combinación con el sensor multiespectral. Aunque enfrentaron desafíos de calibración y sesgos, estos proyectos reflejan la creciente importancia de las herramientas tecnológicas en la agricultura de precisión y subrayan la necesidad de investigación continua para superar obstáculos técnicos.

Solución Propuesta

La implementación del presente proyecto tiene como objetivo mejorar la producción de arroz al reducir los efectos negativos de las enfermedades y condiciones de estrés en los cultivos. En cuanto a la composición, las imágenes multiespectrales se obtendrían mediante la utilización del sensor multiespectral seleccionado que puede capturar la luz en diferentes longitudes de onda. Las mediciones multiespectrales capturadas por este sensor proporcionaron información detallada sobre el estado de salud de los cultivos de arroz.

Además, se utilizaron técnicas de procesamiento de imágenes para mejorar la calidad y precisión de los datos obtenidos de las mediciones multiespectrales. Estas técnicas incluyen la corrección de distorsiones en las imágenes, la eliminación de ruido y la normalización de los datos para garantizar una representación precisa de la salud de los cultivos. Este sistema combina la ciencia de la agricultura con la tecnología de la información y el aprendizaje automático, para proporcionar una solución integral y efectiva para la detección temprana de enfermedades y condiciones de estrés en los cultivos de arroz.

Para la creación del sistema físico, se utilizó la herramienta de CAD SolidWorks para diseñar dos cajas negras. Ambas cajas tienen las mismas dimensiones, pero con propósitos diferentes. La caja mostrada en la siguiente está diseñada para trabajar con el sensor multiespectral seleccionado y dos arreglos de LEDs. Su función es proporcionar un espectro de emisión que abarca un rango desde los 400 nm (ultravioleta) hasta los 750 nm (infrarrojo cercano). El objetivo de este diseño es captar el espectro reflejado por las hojas de arroz y utilizar esta información para determinar ciertas condiciones relacionadas con los niveles de hidratación de las hojas.

Se empleó un microcontrolador ESP32 para gestionar la activación y desactivación de los LEDs que emiten diversas frecuencias espectrales y que son dirigidos a las hojas de arroz. El ESP32 es una opción ligera pero altamente confiable para esta tarea. Con este microcontrolador, se estableció una comunicación con el sensor multiespectral utilizando el protocolo I2C. En la siguiente figura se muestra una imagen con la configuración de entrada y salida del microcontrolador elegido.

En la carcasa diseñada fueron acomodadas tanto la cámara como el sensor multiespectral seleccionado, permitiendo las capturas de hojas individuales de arroz para su caracterización. Se seleccionó el color negro para evitar el efecto de la reflexión y se colocaron LEDs específicos para las distintas frecuencias del espectro electromagnético que se deseaban caracterizar. En la siguiente imagen podemos ver un ejemplo de una imagen capturada.

Se analizó cada hoja en términos de valores de reflectancia y absorción en cada una de las 18 bandas del sensor (410nm, 435nm, 460nm, 485nm, 510nm, 535nm, 560nm, 585nm, 610nm, 645nm, 680nm, 705nm, 730nm, 760nm, 810nm, 860nm, 900nm, 940nm). Para lograrlo fue colocado un arreglo de 6 LEDs capaces de proporcionar las longitudes de onda mostradas con dirección a la hoja. En la siguiente figura se observa la respuesta capturada a partir del sensor multiespectral.

Metodología para el entrenamiento de los algoritmos de aprendizaje de máquina

A partir de estas imágenes se procedió a entrenar un modelo de clasificación basado en las redes neuronales convolucionales. AlexNet es un modelo de red neuronal convolucional considerado uno de los modelos más influyentes en el campo del aprendizaje profundo y fue uno de los primeros en demostrar un rendimiento notable en la tarea de clasificación de imágenes a gran escala. Las técnicas de aprendizaje por transferencia han permitido aprovechar las arquitecturas de estas redes neuronales convolucionales y adaptarla a una diversidad de aplicaciones. En nuestro caso, a la clasificación de enfermedades en hojas de arroz. Debajo se muestra la estructura de la red AlexNet entrenada usando el ambiente Matlab.

Resultados Obtenidos

La estrategia de procesamiento de imágenes en el dominio espacial para identificar manchas en hojas de arroz ha arrojado resultados sumamente prometedores. La elección de la técnica de segmentación basada en el color, combinada con operaciones de preprocesamiento como la conversión a escala de grises y la aplicación de operaciones de apertura, ha demostrado su capacidad para resaltar de manera excepcional las áreas de interés, es decir, las manchas en las hojas. La aplicación consecutiva del método de Otsu y su transformación inversa ha afinado aún más la precisión de la segmentación, contribuyendo a una separación nítida entre las manchas y el fondo de las hojas. Este enfoque en el dominio espacial ha culminado en una detección de enfermedades en las hojas de arroz más confiable y definida, al mismo tiempo que ha minimizado cualquier distorsión o ruido no deseado en las imágenes. La inherente flexibilidad de esta metodología ha permitido ajustar los parámetros de segmentación en función de las variaciones en las características de las manchas y los requisitos específicos del proyecto. En la figura siguiente se muestran los resultados del procesamiento utilizado.

A continuación se muestran los resultados del mejor modelo obtenido. Es importante recalcar que se utilizó una estrategia de entrenamiento cruzado, para evitar introducir sesgo al modelo planteado. La precisión promedio para todas las clases fue del 91.44%.

En el caso del sensor multiespectral, fue elegido un modelo basado en árboles aleatorios, donde se observa una capacidad importante del modelo de distinguir de las tres clases asignadas para la clasificación multiespectral. En la siguiente figura se muestra la matriz de confusión del modelo.

El desempeño obtenido por la estación de inspección mostró su viabilidad para cumplir los objetivos planteados para el presente proyecto, ofreciendo la posibilidad de implementar estrategias similares en distintos tipos de cultivos, y adicionalmente, la importancia que puede presentar la aplicación de técnicas de aprendizaje de máquina en la implementación de la agricultura de precisión.

Conclusiones

La elección de modelos y estrategias de entrenamiento es crucial para la clasificación de imágenes RGB y datos multiespectrales para aplicaciones de agricultura de precisión. La adaptabilidad del sistema desarrollado y su capacidad para detectar patrones anómalos pueden ser una herramienta de importancia en optimizar los procesos de gestión de cultivos.

Referencias

 P. Smith, «How to measure, report and verify soil carbon change to realise the potential of soil carbon sequestration for atmospheric greenhouse gas removal,» INSTITUTE FOR CARBON REMOVAL LAW AND POLICY, USA, 2019.


 A. S. Susanto B. Sulistyo, «Design and performance test of portable spectrometer using AS7265x multispectral sensor for detection of adulterated cane sugar in granulated coconut sugar,» AIP Conference Proceedings, USA, 2023.


 M. J.-L. F. R. J.-L. Andrés Fernando Jiménez-López, «Multispectral analysis of vegetation for remote sensing applications,» Iteckne, Colombia, 2015.


Sistema de Radio Cognitiva basado en Radio Definida por Software

Nicole Marie Ramos y Jhonabel Hernández
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

La evolución de la Radio tradicional

La radio cognitiva y los dispositivos de radio definidos por software (SDR) son tecnologías emergentes que abordan la escasez del espectro en comunicaciones inalámbricas. Permiten un acceso dinámico al espectro al detectar y aprovechar las frecuencias subutilizadas. Por esa razón, y tomando en cuenta el crecimiento exponencial de la población humana, aprovechar estas nuevas tendencias tecnológicas para hacer un uso eficiente del espectro radioeléctrico es un punto clave para continuar el desarrollo de las tecnologías de la telecomunicación.

Se debe destacar que el espectro radioeléctrico es un recurso limitado, por lo que el estudio de nuevas técnicas que hagan un uso inteligente del mismo garantiza el continuar contando con este recurso. Este proyecto explora el uso de la radio cognitiva para optimizar la utilización del espectro disponible en aplicaciones de alta velocidad y baja latencia, así como el uso de los dispositivos SDR para el acceso dinámico al espectro.

En esta entrada de este blog de innovación se presentará la implementación de una arquitectura de software definida por radio para la implementación de estrategias de radio cognitiva. El sistema desarrollado muestra la importancia de la implementación de técnicas de radio cognitiva para garantizar el buen aprovechamiento del espectro radioeléctrico.

La importancia de la Radio Cognitiva

En el trabajo titulado “Evaluación de ocupación del espectro radioeléctrico y análisis de factibilidad de uso de radio cognitiva en la banda UHF (450 – 512 MHZ) Para su optimización en la ciudad de Riobamba” se tomaron dos puntos de referencia para la medición del espectro y, a partir de allí, por medio del análisis espectral se concluyó que el 93.24% de las bandas de frecuencia no estaban siendo ocupadas. Esto pone en perspectiva que la implementación de sistemas de radio cognitiva permitiría reconfigurar automáticamente los esquemas de transmisión y aprovechar estos espacios no utilizados.

Otro proyecto interesante es “Implementación de escenarios de simulación mediante técnicas de modulación y análisis espectral en sistemas WRAN en radios cognitivas”. Este establece que por medio de radio cognitiva se puede identificar el espectro en frecuencia que se encuentra disponible y proceder a realizar la transmisión de la información en los espacios no utilizados. Este trabajo presenta un análisis práctico basado en MATLAB y se crea un escenario de simulación para validar la propuesta planteada.

De igual manera, el trabajo titulado “Herramienta para la medición de ocupación de canales para radio cognitiva en el rango de 470 MHz a 900MHz” encontramos algo similar a lo planteado anteriormente. Los autores presentan un prototipo de herramienta de bajo costo para medir y determinar la ocupación de canal y niveles de señal en el espectro radioeléctrico en el rango de 470 MHz a 900 MHz. Este sistema de bajo costo aprovechando los sistemas SDR es una alternativa a los equipos profesionales y de laboratorio que tienden a tener una mayor precisión pero a un custo mucho más elevado. Por lo que estas soluciones de bajo costo ayudan a promover la implementación de sistemas de radio cognitiva.

Descripción del Sistema Propuesto

Este trabajo propone la creación de una herramienta robusta y de bajo costo utilizando radio cognitiva como concepto principal, sus técnicas de detección y de acceso dinámico se enfocarán en las banda del espectro de frecuencia de UHF/VHF para la toma de decisión con un sistema cognitivo basado en el entrenamiento de un modelo de aprendizaje de máquina. Siendo el propósito de este modelo el detectar espacios de baja utilización dentro del espectro para hacer uso de los mismos en un proceso de transmisión. Esto permite aplicar el uso de radio cognitiva mejorando el acceso dinámico a usuarios secundarios por medio de un algoritmo que detecta energía y el entrenamiento de un modelo de aprendizaje.

La estructura del sistema de radio cognitiva consiste en un conjunto de algoritmos que funcionan a través de software, conocidos como motor cognitivo, y que pueden ser utilizados en plataformas de radio con implementación de hardware. Este motor cognitivo se encarga de gestionar los recursos y adaptar el mecanismo para optimizar sus funcionalidades. En resumen, una arquitectura ideal de radio cognitiva incluiría una serie de componentes funcionales:

  • Interfaz de usuario
  • Detección de entorno
  • Aplicación en el sistema
  • Radio definido por software
  • Funciones cognitivas

Por lo que se debe ejecutar un esquema que permita cumplir con cada uno de estas funcionalidades. Es importante destacar que la flexibilidad de la radio definida por software permite integrar en un solo equipo físico mucha de estas funcionalidades. Adicionalmente, la capacidad de reconfiguración de los sistemas SDR ofrece alternativas interesantes para la adaptabilidad requerida por los sistemas de radio cognitivo. En la siguiente figura se muestra el esquema de implementación realizado para el sistema propuesto.

La transmisión y recepción de señales fue realizada mediante el uso de un dispositivo SDR, en específico BladeRF x40. Para el procesamiento de las señales se implementaron las rutinas a ser ejecutadas en el sistema SDR en el ambiente de GNU Radio. En la siguiente imagen podemos ver el sistema SDR BladeRF x40.

En más del 69% de las ocasiones en que el aprendiz solicitó una sugerencia, acciones captadas y analizadas al momento de validar las habilidades del coach, estas recomendaciones contribuyeron a que el aprendiz o su equipo resulten ganadores de la ronda. Esto implica que en menos del 30% de los casos, las sugerencias del coach no resultaron beneficiosas para el aprendiz o su equipo, ya sea por perder la ronda o porque la ficha sugerida no era la más óptima en ese momento.

Resultados y Limitaciones

La implementación realizada en GNU Radio permitió crear un detector de energía y agregar cotas de robustez mediante el análisis estadístico de la densidad de potencia en cada canal, determinando si el mismo se encontraba ocupado o no. Debajo se muestra el resultado en GNU Radio al momento de detectar un canal ocupado.

En este caso se determinó que el canal en 955MHz se encontraba ocupado, por lo que no es posible realizar una transmisión en el mismo. A partir de esto fue posible crear una modulación del tipo OFDM cuya frecuencia base fuera adaptable. En la siguientes imágenes se puede ver el proceso de transmisión y como el sistema selecciona la frecuencia centra en 915MHz que se encuentra desocupada.

Conclusiones

El uso de SDR (Radio Definida por Software) brinda mayor flexibilidad y reconfigurabilidad al sistema, permitiendo una implementación más sencilla y una adaptación más rápida a diferentes condiciones y requisitos de comunicación. Esto permite adaptar la comunicación a diferentes entornos, condiciones de propagación y requisitos de servicio sin necesidad de cambiar el hardware físico.

Por último, el algoritmo de detección de canales juega un papel crucial en la detección y utilización de los canales en blanco del espectro, garantizando que el sistema pueda operar sin causar interferencias perjudiciales a los usuarios primarios. En general, este proyecto demuestra que la combinación de radio cognitiva, OFDM, SDR y algoritmos de detección de canales es una solución efectiva para mejorar la gestión y eficiencia del espectro inalámbrico, lo que puede conducir a un mejor rendimiento y una mayor capacidad de las redes inalámbricas en el futuro. Sin embargo, es importante seguir investigando y desarrollando esta tecnología para garantizar su viabilidad y éxito en aplicaciones prácticas y para el manejo de usuarios de manera masiva.

Referencias

Ponce Pinos, J. E. (enero de 2019). Evaluación de ocupación del espectro radioeléctrico y análisis de factibilidad de uso de radio cognitiva en la banda UHF (450 – 512 MHz) para su optimización en la ciudad de Riobamba.

Prócel Contreras, Julio Ricardo (febrero de 2020) Implementación de escenarios de simulación mediante técnicas de modulación y análisis espectral en sistemas WRAN en radios cognitivas.

Briceño Rodríguez, Diana Zoraida (agosto 2020) Herramienta para la medición de ocupación de canales para radio cognitiva en el rango de 470 MHz a 900MHz


Entrenador de Dominó basado en Inteligencia Artificial

Luis Ángel Ramírez y Sebastián Manuel Sánchez
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

El juego del Dominó

¿Qué dominicano no ha experimentado una partida de dominó? Desde una perspectiva sociológica, este juego engloba varios aspectos importantes, como elementos educativos, culturales y deportivos al evaluar la agudeza mental en distintos países. En este sentido, surgen los instintos competitivos y la necesidad de aprender a hacer las cosas de la manera correcta.

Por esta razón, la Pontificia Universidad Católica Madre y Maestra se une al movimiento tecnológico desarrollando un entrenador (COACH) de dominó con visión computacional e inteligencia artificial como parte de un proyecto de grado dentro de la carrera de Ciencias de la Computación. Este COACH busca entrenar a cualquier persona interesada en el juego, asegurando que todas las partes jueguen limpio, aun si se desconoce el proceder en el dominó, respetando las reglas, garantizando así la mejor experiencia para todos los jugadores.

En esta entrada de este blog de innovación se presentará la implementación de un entrenador de Dominó basado en la aplicación de visión computacional e inteligencia artificial. El sistema desarrollado muestra las distintas aplicaciones que pueden tener estas tendencias de los sistemas inteligentes en nuestra vida diaria.

Aplicando Tecnología al juego de Dominó

En el proyecto de Herrero, D.G., llamado «Reconocimiento de fichas de dominó mediante técnicas de visión artificial» se implementa la identificación de fichas de dominó por un sistema de forma automática a partir de imágenes tomadas por una cámara digital. Se implementó un algoritmo que recibe un archivo de imagen en el que aparecen fichas de dominó sobre un tapete color verde. El sistema es capaz de identificar cada una de las fichas tanto si se encuentran separadas como si están colocadas juntas unas a otras. Se implementaron técnicas para recuperar partes de la imagen perdidas debido a la iluminación. Para realizar la identificación, el algoritmo realiza en primer lugar una serie de filtrados de la imagen, para posteriormente segmentar la imagen y extraer los contornos de las fichas donde seguido eso se localiza dentro de ellos la línea intermedia de separación de las dos partes de que consta la ficha. Una vez que se ha localizada la línea de separación, se procede a la identificación de la ficha mediante el recuento de puntos existentes a cada lado de dicha separación.

Trabajos como éste pone en evidencia el interés en aplicar las últimas tendencias en técnicas de procesamiento de imágenes e inteligencia artificial al juego del Dominó. Tendencias como los modelos de aprendizaje profundo y los transformadores abren un abanico de oportunidades para impactar algo tan tradicional como lo ha sido el juego de Dominó.

Descripción del Sistema Propuesto

La aplicación se ejecuta de manera local en un dispositivo, preferiblemente una laptop, ya que se basa en un conjunto de librerías y algoritmos para la detección y reconocimiento de fichas, tanto del aprendiz como de las jugadas en la mesa y de la mano para el pase. De la misma manera, librerías para la recomendación de jugadas.

Se combinan varios tipos de tendencias para la creación del entrenador, de las que se pueden mencionar las siguientes:

  • Manipulación y reconocimiento de imágenes.
  • Aprendizaje profundo para la realización del modelo de detección de objetos basado en YOLOv8.
  • MEDIAPIPE para la captura y reconocimiento de los gestos realizados con las manos.
  • Entrenamiento de modelos grandes de lenguaje (LLM) a partir de reglas definidas del Dominó.

A nivel de interacción del usuario, será ejecutada una sola pantalla donde se observarán las jugadas en el lado superior izquierdo, la puntuación en el lado superior derecho, la zona delimitada donde se reconocerán las fichas y en la parte inferior el tablero. Esto se puede apreciar en la imagen ilustrativa mostrada debajo del sistema.

El COACH demuestra habilidades clave en el dominio del Dominó, como la evaluación estratégica de movimientos y una comprensión profunda de las reglas y dinámicas del juego. Estas habilidades le permiten desarrollar estrategias ganadoras y tomar decisiones informadas en el transcurso del juego, maximizando así las posibilidades de éxito.

Por otro lado, la visión computacional desempeña un papel crucial en el proyecto, utilizando la metodología YOLOv8 para la detección de fichas de dominó. Mediante el uso de funciones de pérdida y clasificadores de características, se busca mejorar la precisión y eficiencia del modelo YOLOv8 para aplicaciones prácticas en la detección de fichas de dominó. Además, se incorpora la librería MEDIAPIPE para detectar y reconocer gestos de mano en tiempo real, aprovechando su capacidad para ofrecer soluciones precisas y eficientes sin requerir un conocimiento profundo de los modelos internos. Debajo se muestra una imagen que evidencia la capacidad detección de fichas de Dominó del sistema propuesto.

En más del 69% de las ocasiones en que el aprendiz solicitó una sugerencia, acciones captadas y analizadas al momento de validar las habilidades del coach, estas recomendaciones contribuyeron a que el aprendiz o su equipo resulten ganadores de la ronda. Esto implica que en menos del 30% de los casos, las sugerencias del coach no resultaron beneficiosas para el aprendiz o su equipo, ya sea por perder la ronda o porque la ficha sugerida no era la más óptima en ese momento.

Resultados y Limitaciones

El modelo de aprendizaje automático demostró precisión en las sugerencias de jugadas de dominó, con 17 jugadas válidas de 25 analizadas. Se observó que las sugerencias más concisas tienden a ser más precisas. Todas las sugerencias válidas tuvieron un impacto positivo en el juego, destacando la capacidad estratégica del modelo.

En cuanto al modelo de Large Language Model (LLM) utilizado para sugerir jugadas de dominó, los datos muestran un porcentaje de efectividad alentador, con un 68%, lo que confirma que el LLM puede ser una herramienta útil para asistir a los jugadores en la toma de decisiones.

Además de estos resultados de aplicación, debemos también tomar en consideración el hecho de que el software se centra en un único participante, el «Aprendiz», en un juego de cuatro personas, excluyendo la competencia entre múltiples inteligencias artificiales. De igual forma, la capacidad de procesamiento limitada del hardware puede restringir el alcance y la fluidez de la simulación del proyecto, especialmente en términos de presentación y respuesta.

Conclusiones

Los resultados obtenidos de las pruebas de captura de imágenes y video para la
detección de fichas de dominó indican que el sistema de visión por computadora superó las expectativas iniciales, demostrando una efectividad significativa. La capacidad del sistema para identificar correctamente las fichas en una variedad de condiciones de iluminación, y en algunos casos sin luz, sugiere una robustez y flexibilidad notables. El modelo de lenguaje grande (LLM) fue capaz de distinguir reglas de Dominó a partir de un texto dado y secuencias de reglas sencillas. 

Referencias

Herrero, D.G. (2014) RECONOCIMIENTO DE FICHAS DE DOMINÓ MEDIANTE TÉCNICAS DE VISIÓN ARTIFICIAL. 

“Complete YOLO v8 Custom Object Detection Tutorial | Windows & Linux.” 

Custom Hand Gesture Recognition with Hand Landmarks Using Google’s Mediapipe + OpenCV in Python 

Talebi, Shawhin. “Fine-Tuning Large Language Models (LLMs) | W/ Example Code.” 

Interfaz Cerebro Computador para el control de un DRON tipo Cuatrimotor

James di Giacomo Rodríguez y Darío Ezequiel Núñez
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

Tendencias del futuro: Interfaz Cerebro-Computador

En la década de 1970, el profesor Jacques Vidal introdujo el término «interfaz cerebro-computadora» (BCI, por sus siglas en inglés), planteando la idea de utilizar patrones de ondas cerebrales para controlar dispositivos externos, como computadoras. El control de drones a través de BCI es una extensión natural de esta investigación y ofrece nuevas oportunidades en términos de accesibilidad y control preciso de estos dispositivos.

El uso de interfaz cerebro-dron podría permitir a los operadores controlar drones de manera remota y precisa sin necesidad de una interfaz física, lo que reduciría el riesgo de exposición a peligros físicos, además, la interfaz cerebro-dron podría acelerar la prestación de ayuda en áreas afectadas por desastres naturales o conflictos, permitiendo una respuesta más rápida y precisa. De igual forma, este tipo de tecnología proporciona una alternativa de control para personas con dificultades físicas, lo que les permite superar sus limitaciones y tener mayor autonomía en el manejo de drones.

Sin embargo, a pesar de los beneficios potenciales, existen desafíos técnicos y prácticos que deben abordarse para una implementación efectiva y segura de esta tecnología. Estos desafíos incluyen la precisión y confiabilidad del control de drones a través de BCI, la seguridad cibernética para evitar intrusiones maliciosas y la protección de la privacidad y los derechos humanos de las personas afectadas por el uso de esta tecnología.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la creación de una interfaz cerebro-computador para el control de un DRON cuatrimotor. El sistema desarrollado muestra las interesantes posibilidades que ofrecen este tipo de interfases para simplificar la operación de dispositivos complejos y el acceso al uso de estos por personas con algún tipo de discapacidad motora. El sistema fue entrenado con diversos comandos y se validó su uso con un DRON de uso académico.

Desarrollo de los sistemas BCI

En la tesis titulada “Desarrollo de una interfaz cerebral utilizando herramientas IoT para el control de dispositivos ON-OFF orientado a personas con capacidades limitadas”, presentada por Luis Alberto Montalván Tandazo y Christian Fernando Quinte Caiza, en julio del año 2021, se aborda el tema del control de dispositivos electrónicos vía ondas cerebrales utilizando la diadema EMOTIV Insight 2.0, donde se le quiere facilitar el estilo de vida a las personas con ciertas limitaciones físicas, y por ende, brindarles comodidad y mejorar su modus vivendi en su día a día.

En ese mismo año, también se llevó a cabo un proyecto muy similar, titulado: “Desarrollo de un sistema BCI basado en redes neuronales y movimientos de la cabeza para el manejo de un ordenador”, el cual lleva por autor a Eddy Fabian Corrales Bastidas, donde se abarca esta idea, la cual se enfoca en el manejo de un ordenador en personas con movimiento reducido en sus extremidades superiores.

Por otro lado, en la tesis titulada “Implementación de un sistema de control para el manipulador Mitsubishi RV-2AJ, mediante ondas cerebrales empleando el sensor EMOTIV Insight”, presentada por Francisco Andrés Gómez Pineda y Stalin Gabriel Yaguana Torres, en julio del año 2018, se discute la problemática sobre la exclusión o limitación de acceso a tecnologías innovadoras de manipulación de robots para personas que no tienen conocimientos de programación de estos dispositivos o que tienen alguna discapacidad motriz. Por tanto, los autores plantean como solución a esta problemática, la implementación de un sistema que permita controlar los movimientos del brazo robótico Mitsubishi RV-2AJ de la marca Festo, utilizando señales cerebrales, mediante la interpretación de señales cerebrales recopiladas por la diadema EEG EMOTIV Insight 1.0, las cuales serán procesadas y analizadas a través de una tarjeta LattePanda, un dispositivo con capacidades de microcomputador y conectividad inalámbrica.

Descripción del Sistema Propuesto

El proyecto consiste en integrar un sistema de electroencefalograma (EEG) junto a un DRON, para que este sea manejado por medio de las ondas cerebrales que los seres humanos generamos cuando pensamos en una acción. Este sistema muestra un alternativa para ayudar al desarrollo de los sistemas BCI junto su interacción con los dispositivos IoT, vehículos aéreos no tripulados y cualquier dispositivo que sirva para facilitar la interacción de los humanos con los medios de transporte por interfaces cerebro–computador.

Por esto, el enfoque principal es emplear la tecnología del dispositivo EEG EMOTIV Insight 2.0 para contribuir a resolver el problema de la complejidad en la operación de drones. Se busca integrar el EMOTIV Insight 2.0 con el sistema de control del dron, estableciendo una conexión confiable y estable para permitir un control más intuitivo y preciso basado en las señales cerebrales del usuario. Debajo se muestra una imágen del EMOTIV Insight 2.0

Para la integración del DRON se eligió el sistema de BITCRAZ, el Crazyflie 2.1. Este es un pequeño DRON de código abierto desarrollado por Bitcraze. Es una versión mejorada y más avanzada de su predecesor, el Crazyflie 2.1 original. A pesar de su diminuto tamaño, el Crazyflie 2.1 está repleto de características y capacidades impresionantes. Este se puede programar utilizando lenguajes como Python y C, lo que brinda una gran flexibilidad para personalizar su comportamiento y desarrollar nuevas funciones. Debajo se muestra una imagen del DRON elegido.

El EMOTIVBCI es el software que permite enviar los datos de las señales tomadas por la diadema, para que así sean procesadas por la BCI y luego ser programadas para que el dispositivo ejecute la acción pensada. Se realizó una interfaz basada en Python para el tratamiento de los comandos de operación clasificados por el EMOTIVBCI y crear la interfaz con el API de control del DRON CrazyFlie 2.1.

Estructura del Sistema y Modo de Funcionamiento

En primera instancia, se conecta el Insight 2.0 mediante Bluetooth 5.0 al computador, luego el sujeto se coloca la diadema, se realiza una calibración de los sensores, de tal modo que la medidas de calidad para el software EMOTIVBCI sean 95% o mayor. Luego, mediante el EMOTIV Launcher, se inicia el software EMOTIVBCI , el cual es el encargado de los entrenamientos de los comandos mentales. Mediante la API de Cortex, se adquieren los datos EEG, utilizando las credenciales otorgadas por EMOTIV. Por otro lado, dentro de la API de Bitcraze, se programan las instrucciones necesarias para que el DRON Crazyflie 2.1 ejecute los comandos recibidos de la manera deseada. Ya teniendo esto listo, para comunicar ambas APIs, y enviar los comandos mentales generados por el Insight 2.0, se implementa un websocket en cada API. Por último, el aplicativo local, registra y muestra los comandos mentales que se están ejecutando en tiempo real por el sujeto, y los va mostrando en el computador. En la siguiente figura se muestra el diagrama en bloques del sistema.

La diadema Insight 2.0 utiliza Bluetooth 5.0 y software EMOTIV para controlarla. Para trabajar con el Cortex SDK y la API de Python, se necesita instalar dependencias. El DRON Crazyflie 2.1 también requiere un controlador y una máquina virtual . Un dongle de radio USB permite la conexión entre el DRON y la computadora, y el accesorio FlowDeck v2 asegura un vuelo estable con su sensor óptico de flujo. Las APIs se conectan a través de un socket IP y puerto. El dispositivo Insight 2.0 promedia comandos cada 0.125 segundos y envía la palabra más repetida. El código maneja la recepción y procesamiento de comandos, envía comandos a través del socket y utiliza hilos para la conexión y procesamiento. La comunicación a través del socket es esencial para la interacción entre el dispositivo Insight 2.0 y el DRON.

Resultados y limitaciones

Las pruebas realizadas mostraron que el sistema logró una precisión global del 85.3%. Para esto fueron realizados 68 ensayos, dando como resultado un total de 10 falsos negativos y 58 sesiones con comando detectados correctamente. Los resultados mostraron que el DRON fue capaz de recibir y ejecutar los comandos mentales enviados y generados por el Insight 2.0, según lo deseado por el usuario, demostrando así el cumplimiento total de los objetivos planteados.

En cuanto al desempeño del sistema, se observó que el tiempo de respuesta del DRON ante un comando mental fue en promedio de doce (12) segundos. Durante las pruebas de vuelo, se observó que el dron es altamente sensible a interferencias y cambios bruscos en el terreno. El Crazyradio 2.0 de Bitcraze opera en la frecuencia de 2,4GHz, compartida por muchos dispositivos de la red de la universidad, lo que provoca pérdida de control y colisiones del dron. Se reemplazaron varias hélices dañadas y se adquirieron repuestos adicionales para prevenir contratiempos.  Al integrar el Insight 2.0 con el Crazyflie 2.1, se notó un retraso de al menos tres segundos entre los comandos mentales y su ejecución debido a múltiples saltos entre APIs y procesamiento, así como la distancia al router.

Resultados Obtenidos

Después del desarrollo preliminar, se llevaron a cabo extensas pruebas y análisis para evaluar la efectividad de los métodos y algoritmos empleados en el análisis de las deficiencias en la caminata de los pacientes. Estos se centraron en la verificación y validación de los resultados obtenidos para garantizar la precisión y confiabilidad del sistema. Además, se realizaron ajustes y optimizaciones para adaptar el sistema a diferentes perfiles de pacientes y condiciones.

Se diseñó una interfaz de usuario para la visualización de datos, que incluía gráficos y tablas para presentar resultados de manera clara. Se realizaron pruebas exhaustivas para validar la precisión y confiabilidad del sistema, ajustando según fuera necesario para mejorar la exactitud del análisis. En la siguiente figura se muestra la interfaz del aplicativo WEB, este permite la configuración de umbrales para los procesos de detección y la visualización de la reportería por paciente. Debajo se muestra una secuencia de imágenes en el que el DRON sigue un comando a partir de la interfaz BCI, trasladándose desde la izquierda hacia la derecha.

Conclusiones

Este trabajo ha demostrado las funcionalidades que ofrecen las interfaz BCI para expandir la integración del control de distintos tipos de dispositivos tanto con aplicaciones civiles como de asistencia médica. Es importante destacar los retos que debieron ser superados para la integración de los distintos esquemas temporales de respuesta del sistema BCI frente a la recepción de comandos por parte de la API del DRON. Todo esto demuestra que es necesario el seguir explorando el desarrollo de estas interfaces BCI para su aprovechamiento en aplicaciones futuras.

Referencias

J. Wolpaw y E. W. Wolpaw, Brain-Computer Interfaces: Principles and Practice. Oxford University Press, 2012.


G. Pfurtscheller, B. Graimann y B. Allison, Brain-computer interfaces: Revolutionizing human-computer interaction. Heidelberg: Springer, 2010.


Millán, J.R., Rupp, R., Müller-Putz, G.R., Murray-Smith, R., Giugliemma, C., Tangermann, M., Vidaurre, C., Cincotti, F., Kübler, A., Leeb, R., Neuper, C., Müller, K.R. (2010). Combining Brain-Computer Interfaces and Assistive Technologies: State-of-the-Art and Challenges. Frontiers in Neuroscience, 4, 161. doi: 10.3389/fnins.2010.00161


Lebedev, M.A., Nicolelis, M.A.L. (2006). Brain-Machine Interfaces: Past, Present, and Future. Trends in Neurosciences, 29(9), 536-546. doi: 10.1016/j.tins.2006.07.004


McFarland, D.J., Wolpaw, J.R. (2011). Brain-Computer Interfaces for Communication and Control. Communications of the ACM, 54(5), 60-66. doi: 10.1145/1941487.1941506


Sistema para el análisis de la Caminata en procesos de Terapia Física

Albert Jerez y Diana Diplán
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

Ser físicamente funcional

Las lesiones musculoesqueléticas representan una carga considerable para la salud y el bienestar global. Desde atletas de élite hasta individuos con estilos de vida activos, estas lesiones tienen un impacto devastador en la calidad de vida y la funcionalidad. Más allá del dolor físico, las lesiones podrían conducir a discapacidades a largo plazo, limitando la capacidad para trabajar, participar en actividades diarias e incluso disfrutar de recreaciones normales a nivel social.

Ante este desafío identificado y con el apoyo del departamento de Terapia Física de la Pontificia Universidad Católica Madre y Maestra (PUCMM) se busca abordar la necesidad de desarrollar herramientas y tecnologías innovadoras para una evaluación precisa y una intervención temprana en el análisis de la caminata. El objetivo siendo prevenir lesiones, mejorar los resultados del tratamiento y fomentar la salud y calidad de vida de las personas.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la el análisis de la caminata en procesos de terapia física. El sistema desarrollado cuenta con técnicas de visión computacional que permiten crear toda una reportería que asista al especialista en la evaluación del proceso de caminata de un paciente. El sistema agrega la data de sensores inerciales así como el uso de cámaras para la obtención de los reportes propuestos.

Integración de Tecnología en los procesos de Terapia Física

De acuerdo con F.R. Andrea Ramos, en «La importancia de una valoración en Fisioterapia», una de las áreas más afectadas por las lesiones musculoesqueléticas es la caminata. La capacidad de caminar eficientemente y sin dolor era fundamental para la movilidad y la independencia. Sin embargo, las lesiones en pies, tobillos y piernas alteran significativamente la biomecánica de la marcha, resultando en dolor crónico, discapacidad y una disminución de la calidad de vida. Además, las lesiones relacionadas con la marcha aumentan el riesgo de desarrollar problemas de salud más graves, como osteoartritis y enfermedades cardiovasculares, lo que podría tener consecuencias devastadoras a largo plazo para la salud y el bienestar general.

Sabiendo esto, en el estudio realizado por E. BV. llamado “Evaluación del control postural a través de Microsoft Azure Kinect DK: Un estudio de evaluación”, se compararon las trayectorias de movimiento del Kit Kinect utilizado con un sistema 3D estándar de seguimiento de alta precisión, relacionándolo a una posible solución. Veintiséis sujetos realizaron ejercicios específicos para su evaluación. El Kit Kinect demostró un seguimiento preciso de las articulaciones principales durante movimientos laterales, con un Error Cuadrático Medio (RMSE) de aproximadamente 0.2cm para ejercicios laterales y hacia adelante, y de 0.47cm para equilibrio. El Error Absoluto Medio angular osciló entre 5 y 15 grados para articulaciones superiores, mientras que las inferiores mostraron mayores errores. Se observaron mejores resultados en movimientos lentos. El estudio destaca el potencial del enfoque en base al Kit Kinect para la rehabilitación en el hogar, especialmente en la evaluación del control postural.

Otro bajo que busca analizar el proceso de movimiento del cuerpo humano es el presentado por  Y. Wang, S. Liu. Y S. Zhang. En el mismo se propone un algoritmo eficiente de reconocimiento de gestos manuales (HGR) para aplicaciones de interfaz humano-máquina (HMI) basados en el sensor BNO055. Utilizando datos de este sensor y considera su naturaleza temporal, lo que mejora el rendimiento de reconocimiento. La técnica de transformadas discretas de ondículas (DTW) es aplicada, mostrando que ofrece buenos resultados, pero su complejidad dificulta el aprendizaje en tiempo real. El algoritmo que implementaron el HGR, se basa en una red neuronal de energía de columna restringida (RCE) con un esquema de aprendizaje simple. Al reemplazar la métrica de la RCE con la distancia DTW mejora el reconocimiento de gestos con datos temporales y admite el aprendizaje en tiempo real. En pruebas con una FPGA, alcanzaron una precisión del 98.6% y soportaron operaciones en tiempo real a 150 MHz, lo que son resultados prometedores en el contexto del desarrollo del sistema.

Estos trabajos ponen el relieve dos puntos importantes: la importancia de la analítica del movimiento humano y la dificultad en procesar este tipo de datos. Por lo que el presente trabajo es un aporte importante en el desarrollo de este tipo de sistemas y en el estudio de diversas metodologías que puedan apoyar en el desarrollo de los procesos de fisioterapia.

Solución Propuesta

La solución propuesta para el análisis de la marcha en terapia física implicó el uso de tecnología de seguimiento de movimiento y un software de análisis de datos. Mediante el empleo de microcontroladores como el ESP32 (Lolin32) y un acelerómetro BNO055, colocados en diversas partes del cuerpo del paciente se busca poder medir el movimiento y la posición tridimensional durante la el proceso de caminata (marcha). El software de análisis procesó y visualiza los datos recopilados para mostrar patrones de movimiento precisos y objetivos durante la caminata. Esto buscando proporcionar a los fisioterapeutas una evaluación detallada y objetiva de la marcha de cada paciente, permitiéndoles diseñar un tratamiento personalizado y efectivo. En la siguiente figura se muestra el diagrama en bloque para la integración de todos los elementos a ser utilizados en el sistema propuesto.

Para la parte de visión computacional, se desarrolló un sistema automático de análisis de la marcha utilizando la librería MediaPipe. Esta herramienta permitiría una evaluación más eficiente y precisa de la marcha de los pacientes en terapia física. Al automatizar este proceso, se busca reducir el tiempo necesario para la evaluación inicial y mejorar la precisión de los diagnósticos, lo que a su vez conduciría a tratamientos más efectivos y una recuperación más rápida y completa para los pacientes en fisioterapia. En última instancia, se espera que este proyecto contribuya significativamente al bienestar y la calidad de vida de los pacientes en rehabilitación.

MediaPipe es una biblioteca de código abierto desarrollada por Google, especializada en análisis y procesamiento de datos de visión por computadora, ofreciendo seguimiento de movimientos y detección de objetos en tiempo real, así como mediciones precisas de velocidad, longitud del paso, cadencia y equilibrio durante la caminata. Luego de implementada, esta librería permitió capturar imágenes precisas y detalladas del movimiento del paciente durante la marcha, con la capacidad de capturar imágenes en 3D utilizando sensores de profundidad avanzados. En la siguiente imágen se aprecia la capacidad de MediaPipe de capturar puntos específicos del cuerpo, en este caso los hombros.

Metodología

El desarrollo del sistema de análisis de deficiencias en la marcha se llevó a cabo mediante un enfoque metodológico que abarcó desde la configuración inicial hasta la implementación práctica. Se inició con la configuración de los componentes hardware y la instalación del software de análisis de datos, seguido de pruebas preliminares para calibrar los sensores y ajustar su sensibilidad y precisión. El desarrollo del software implicó la configuración de algoritmos de seguimiento de movimiento y la visualización de datos en tiempo real. Esta metodología queda esquematizada en la siguiente imagen.

Se integraron  un total de tres cámaras de alta resolución para capturar imágenes en 3D del movimiento del paciente, estableciendo protocolos para la sincronización y captura de datos en tiempo real. Adicionalmente, se hizo uso de unos guantes para integrar los sensores del tipo acelerómetro seleccionados junto con el microcontrolador. Esto permitió obtener la medición de la aceleración en las cuatros extremidades del paciente, lo que brinda posibilidad de aplicar técnicas de análisis basadas en fusión de datos de distinta naturaleza. En la figura siguiente se muestra el sensor utilizado para la creación de este sistema de captura.

Resultados Obtenidos

Después del desarrollo preliminar, se llevaron a cabo extensas pruebas y análisis para evaluar la efectividad de los métodos y algoritmos empleados en el análisis de las deficiencias en la caminata de los pacientes. Estos se centraron en la verificación y validación de los resultados obtenidos para garantizar la precisión y confiabilidad del sistema. Además, se realizaron ajustes y optimizaciones para adaptar el sistema a diferentes perfiles de pacientes y condiciones.

Se diseñó una interfaz de usuario para la visualización de datos, que incluía gráficos y tablas para presentar resultados de manera clara. Se realizaron pruebas exhaustivas para validar la precisión y confiabilidad del sistema, ajustando según fuera necesario para mejorar la exactitud del análisis. En la siguiente figura se muestra la interfaz del aplicativo WEB, este permite la configuración de umbrales para los procesos de detección y la visualización de la reportería por paciente. 

Se llevaron a cabo pruebas simuladas y estudios con pacientes reales, bajo la supervisión de profesionales de la salud. Los resultados obtenidos fueron analizados y comparados con evaluaciones manuales realizadas por fisioterapeutas experimentados, demostrando la capacidad del sistema para detectar y cuantificar deficiencias específicas en la marcha. Debajo se muestra un ejemplo de una gráfica de captura de movimiento.

El sistema fue configurado para detectar las siguientes anomalía:

  • Inclinación excesiva de hombros
  • Declive de los codos
  • Diferencia de alineación entre las muñecas
  • Diferencia de alineación entre las rodillas
  • Desalineación en la cadera
  • Separación anormal de rodillas
  • Inclinación de la columna

Conclusiones

El sistema ofrece varias ventajas clínicas, incluida su capacidad para detectar patrones anómalos en la marcha de los pacientes y su potencial en la monitorización continua en entornos clínicos. Además, su adaptabilidad y facilidad de uso lo hacen una herramienta prometedora para la evaluación y el seguimiento de pacientes en rehabilitación. Las perspectivas futuras incluyen la aplicación del sistema en investigaciones adicionales para mejorar aún más su precisión y funcionalidad, así como su integración en entornos clínicos para mejorar la calidad de vida y el bienestar de los pacientes con deficiencias de movimiento.

La adaptabilidad del sistema, su capacidad para detectar patrones anómalos y su potencial en la monitorización continua de pacientes en entornos clínicos, junto con su aplicabilidad en investigaciones futuras, destacan como aspectos prometedores para su utilización.

Referencias

Antico, M., Balletti, N., Laudato, G., Lazich, A., Notarantonio, M., Oliveto, R., Ricciardi, S., Scalabrino, S., & Simeone, J. (2021). Postural Control Assessment via Microsoft Azure Kinect DK: An evaluation study. Computer Methods and Programs in Biomedicine, 209, 106324. https://doi.org/10.1016/j.cmpb.2021.106324


Sistema de Monitoreo Industrial de Temperatura (SMIT)

Starlyn Peña
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

Desastres en Tiempos de Pandemia: Origen de SMIT

A finales del año 2019 se identificó un nuevo virus en Wuhan, China, marcando un acontecimiento sin precedentes en la historia moderna humana. La subsiguiente pandemia, conocida como Covid-19, mantuvo al mundo en vilo durante casi dos años y, aún en la actualidad, se siguen tomando medidas preventivas para frenar su propagación en ambientes laborales. Esto ha llevado a que muchas empresas tengan protocolos establecidos para detectar síntomas de enfermedades contagiosas entre sus empleados que puedan afectar tanto la salud del personal como la productividad de la empresas. Debido a su alto grado de contagio el Covid-19 marcó un hito importante en el establecimiento de estos protocolos sanitarios, pero enfermedades como el dengue, la gripe estacional u otras infecciones pueden de igual manera presentar un impacto importante para el personal de una empresa.

Estas enfermedades comparten un síntoma común: la posibilidad de presentar fiebre. La fiebre queda definida como el síntoma que se produce cuando la temperatura corporal supera los 38 °C. Esto abre la posibilidad de aplicar  diversas técnicas y tecnologías para tomar las medidas preventivas adecuadas en caso de que una persona posea síntomas febriles y sea portadora de alguna enfermedad contagiosa. Sin embargo, algunas de estos métodos no son muy precisos en el resultado. Por lo tanto, aunque el COVID19 actualmente no nos azote tan de lleno, es necesario en el entorno industrial un método eficiente para cuando se necesita obtener la temperatura de los trabajadores, contribuyendo a la seguridad y salud generales. Debido a esto, se desarrolla SMIT, nuestro tema de discusión en el presente artículo.

En esta entrada de este blog de innovación se presentará la implementación de un sistema para la detección de síntomas febriles mediante el uso de visión computacional y algoritmos de aprendizaje de máquina. El sistema desarrollado cuenta con los aplicativos administrativos necesarios para la identificación de los empleados y el manejo de notificaciones de detección. Adicionalmente, se considera el uso de un sistema de calibración interno de referencia para aumentar la precisión del sistema propuesto.

Marco conceptual: Detección de Síntomas Febriles en entornos industriales

En su artículo (H. D. Septama, M. Komarudin, A. Yudamson, T. Yulianti, M. Pratama and T. P. Zuhelmi, 2021), señala el hecho de que múltiples lugares utilizan personal equipado con pistolas termómetro para medir la temperatura corporal de los visitantes, pese a que esta práctica tiene inconvenientes, ya que implica contacto cercano entre el personal y los visitantes, lo que puede propiciar la propagación del virus. Como solución presenta un sistema de bajo costo para la medición rápida de la temperatura corporal sin contacto, utilizando una cámara térmica integrada con una barrera. Por lo tanto, no se necesita personal para medir la temperatura corporal, ya que los visitantes pueden verificarla de manera independiente, teniendo una precisión en la temperatura del personal de un 98.75%.

En adición, en el artículo de (S. D. Khirade and A. B. Patil, 2015) se discute el hecho de que el procesamiento de imágenes se emplea en la detección de enfermedades en plantas, abarcando pasos como la adquisición de imágenes, preprocesamiento de imágenes, segmentación de imágenes, extracción de características y clasificación. Se exploran los métodos utilizados para detectar enfermedades en plantas mediante imágenes de sus hojas. Además, en nuestro provecho, se profundiza en algunos algoritmos de segmentación y extracción de características.

Siguiendo la misma línea de procesamiento, en el escrito de los autores (Ragavesh Dhandapani1 y Sara Marhoon Humaid Al-Ghafri, 2022) se utiliza un sistema de detección de objetos basado en visión por computadora para reconocer mascarillas faciales y autenticar certificados de vacunación en tiempo real a través de un kit Jetson Xavier. El proceso comprende la captura de video en tiempo real y su posterior procesamiento, que implica la detección facial mediante un clasificador Haar-Cascade y la codificación facial. Luego, se emplea un modelo de aprendizaje profundo pre-entrenado para ubicar la clase objetivo (mascarilla) en el fotograma.

Todos estos trabajos resaltan la oportunidad de mejora en los sistemas de monitoreo de temperatura si se integran tecnologías referentes a procesamiento en el borde, reconocimiento facial, seguimiento de objetos y técnicas estadísticas para robustecer la medición de los sistemas de medición de temperatura sin contacto.

Descripción del Sistema Propuesto

A partir del diagrama mostrado se evidencia la integración de los distintos componentes que brindan el acercamiento basado en computación en el borde para el sistema propuesto. Siendo el corazón del sistema el sistema de procesamiento Jetson AGX Xavier. Este dispositivo en un dispositivo heterogéneo de procesamiento que incluye procesadores de la familia ARM junto con un núcleo de procesamiento gráfico de propósito general (GPGPU, por sus siglas en inglés) pensado para acelerar la ejecución de algoritmos de aprendizaje de máquina y procesos de visión computacional. Adicionalmente, una cámara termográfica de alta precisión Hikvision DS-2TD2617-10/QA. 

La Implementación de técnicas de procesamiento de imágenes constituye un paso crucial en la operación del sistema. Utilizando técnicas avanzadas como segmentación e identificación, se busca extraer información pertinente al separar las áreas de interés de las no deseadas. Como se puede ver en la imagen, la computadora en el borde elegida presenta un tamaño reducido y su consumo de potencia (menos de 65W) hace que sea idónea para este tipo de aplicaciones. Cuenta con una capacidad teórica máxima de procesamiento de 11 TFLOPS.

En el procesamiento de imágenes, se capturan los frames de la cámara IP termográfica y se procesan para adaptar los algoritmos. Se convierten del espacio de color BGR al RGB y se implementa un algoritmo de detección de rostros. Se obtienen los puntos de referencia, como la ubicación de los ojos y la boca, y se escala la resolución de los videos para ajustarlos. Luego, se localiza el rostro detectado en el STREAM de la cámara termográfica para inicializar el algoritmo de seguimiento y se estiman las temperaturas corporales utilizando un Black Body Calibrator (BBC) y la intensidad del píxel correspondiente al punto identificado del canal lagrimal del ojo. En la figura siguiente se muestra la metodología propuesta para el SMIT.

En cuanto al sensor de temperatura, se utiliza un sensor del tipo resistivo para la medición de la temperatura (RTD) con un amplificador MAX31865 y un ESP32. La RTD se conecta al MAX38165 según las especificaciones del fabricante y se establece la comunicación entre el sensor y la ESP32 mediante el protocolo SPI. Luego, se programa la comunicación utilizando una librería proporcionada por el fabricante.

Resultados Obtenidos

La Implementación de Técnicas de Procesamiento constituye un paso crucial en la operación del sistema. Utilizando técnicas avanzadas como segmentación e identificación, se busca extraer información pertinente al separar las áreas de interés de las no deseadas. El poder detectar marcadores fiduciarios es un punto clave para este proyecto, porque permite identificar las regiones en donde es necesario evaluar la intensidad de los pixeles y compararlo con el punto de referencia provisto por el BBC. En la siguiente imagen se muestra la capacidad del algoritmo, al ser ejecutado en la Jetson AGX Xavier, de detectar un rostro y construir la malla de referencia con los marcadores fiduciarios.

La Aplicación de Monitoreo (Web) representa la interfaz donde la información procesada cobra relevancia práctica. Al recibir y analizar la información, esta aplicación determina si una persona supera la temperatura establecida. En caso afirmativo, emite notificaciones al personal de seguridad, permitiendo la implementación de medidas adecuadas. La misma fue desarrollada bajo el framework minimalista Flask en PYTHON, lo que permite que la ejecución del aplicativo también quede en el mismo equipo para computación en el borde.

Una funcionalidad que fue agregada al sistema es la capacidad de asociar un ID de empleado a un rostro. Adicionalmente, se detecta un estado de ERROR en caso de que el empleado no pueda ser identificado por llevar una mascarilla o en caso de que lleve gafas oscuras. Es importante recalcar que este sistema está pensado para ser utilizado en un ambiente post pandemia, por lo que se puede aplicar el sistema en zonas donde los empleados deban bajar sus mascarillas antes de cruzar, creando la relación ID de empleado con temperatura.

Esta plataforma WEB implementa un sistema de login para acceder al sistema y permite visualizar información relevante como el monitoreo del personal, el estado del sistema y reportes de datos. Se pueden configurar límites de temperatura, escala de visualización, cantidad máxima de rostros detectados, entre otros parámetros. También se pueden crear, modificar y eliminar empleados y usuarios según los permisos correspondientes.

Conclusiones

El sistema exhibe un buen desempeño durante la noche o en entornos con iluminación reducida, donde aun con ausencia de luz de fondo el algoritmo de detección facial logra funcionar adecuadamente. Además, se destaca por su excepcional precisión, con un margen de error mínimo de tan solo 0.5 °C, una cifra notablemente inferior en comparación con otros sistemas. Es crucial destacar la importancia de considerar cuidadosamente el entorno de aplicación en donde sea instalado el sistema, especialmente en ambientes donde la iluminación pueda saturar la imagen, ya que este factor puede influir significativamente en los resultados.

Este sistema SMIT emerge como un proyecto innovador, preciso, fácil de utilizar y seguro. Su desarrollo responde a la necesidad crítica de monitorear la salud en entornos industriales, ofreciendo una herramienta eficaz y de utilidad.

Referencias

 M. K. A. Y. T. Y. M. P. T. Z. H. Septama, «Low Cost Non-Contact Rapid Body Temperature Screening using Thermal Camera for Early Detection of Covid-19 Suspect,» Bandung, 2021.

Gelir, «Image processing for quantitative measurement of e/m in the undergraduate laboratory,» 2019. NVIDIA, «NVIDIA,» 25 Marzo 2019. [En línea]. Available: https://www.nvidia.com/enus/autonomous-machines/embedded-systems/jetson-agx-xavier. [Último acceso: 22 Noviembre 2022].

Alonso, V., Dacal-Nieto, A., Barreto, L., Amaral, A., & Rivero, E. (2019). Industry 4.0 implications in machine vision metrology: An overview. Procedia Manufacturing, 41, 359–366. https://doi.org/10.1016/j.promfg.2019.09.020

Sharma, K. Shanmugasundaram and S. K. Ramasamy, «FAREC — CNN based efficient face recognition technique using Dlib,» 2016 International Conference on Advanced Communication Control and Computing Technologies (ICACCCT), Ramanathapuram, India, 2016, pp. 192-195, doi: 10.1109/ICACCCT.2016.7831628.


Aplicación de Sistemas de Visión Computacional en la Gestión de Inventarios de Almacenes

Doris Nuñez y Alberto Guaba
Estudiantes Escuela de Ingeniería en Computación y Telemática, Campus Santiago
PUCMM

La Industria 4.0 y la gestión de inventarios

Todas las compañías que se dedican a la fabricación de productos en general sean PYMES o grandes empresas se encontrarán en algún momento con el problema de poder gestionar sus necesidades de almacenamiento de materia prima y producto terminado. Por lo que es una necesidad el optimizar sus procesos de gestión de inventario de forma que sean más eficiente y se puedan implementar controles más efectivos. Esta realidad es aún más notoria con la transición hacia el modelo de la Industria 4.0, donde la implementación de sistemas conectados y la disponibilidad de información en línea crean nuevos requerimientos importantes en una gestión eficiente y rápida de los inventarios de materia prima que son críticos para la producción.

De esta manera, la llegada de la Industria 4.0 ha generado una nueva serie de cambios en todos los procesos industriales entre ellos nuevos sistemas de control de inventario que podrían dar una solución a dicho problema. Sin embargo, es importante notar que aún no hay una adopción masiva de estas nuevas ventajas tecnológicas, explicado esto por las limitantes económicas o técnicas que suelen presentarse para realizar este tipo de implementación. Por lo que es necesario el seguir proponiendo y desarrollando soluciones de este tipo que logren eliminar estas limitantes.

En esta entrada de este blog de innovación se presentará el impacto de los los sistemas de visión computacional para la gestión de almacenes y su inventario. La visión computacional, es un conjunto de técnicas y metodologías desarrolladas con el fin de adquirir, procesar y analizar imágenes del entorno con el objetivo de obtener información con la ayuda de un sensor, que puede ser una o varias cámaras. La implementación de estos sistemas presenta una solución capaz de reducir la carga de trabajo de un almacén significativamente, como se expondrá en el resto de esta publicación, logrando que los empleados pueden ser más eficientes y las empresas cumplan de mejor manera con sus objetivos.

Procesos de Automatización de Inventario: Su importancia para la Industria 4.0

Con el avance y surgimiento de nuevas tecnologías éstas han quedado cada vez más integrada dentro de los procesos productivos. Esto ha creado una conexión entre los dispositivos y sistemas digitales con los sistemas físicos, surgiendo lo que se conoce como Industria 4.0. En este nuevo paradigma se integran etapas de diseño y planificación del producto, así como el suministro y producción, junto a procesos de tecnologías de la información. Esto afecta la forma en la que los productos se diseñan, fabrican y, posteriormente, almacenan y distribuyen.

La Industria 4.0 ha promovido procesos de cambio en las diferentes operaciones que involucran al sector industrial. Teniendo como consecuencia una mayor velocidad de producción, aumento en la cantidad de los productos y reducción de costos en general. Sin embargo, una parte fundamental para que esto sea posible es el manejo de los inventarios de almacenes, en especial de materia prima, los que representan una parte importante de la infraestructura de la cadena de producción. El llevar un inventario automatizado de los almacenes puede presentar una ventaja competitiva importante. Este proceso consiste en crear y actualizar en tiempo real los volúmenes de inventario permitiendo tener una gestión en línea, resultando en una optimización de los procesos relacionados con la gestión del inventario.

Adicionalmente, con el desarrollo de los sistemas de gestión de almacenes inteligentes en la Industria 4.0, se consigue una selección y colocación óptima de materia primas o productos terminados. Esto implica el utilizar algoritmos que, en base a distintos tipos de sensores,  puedan monitorear la capacidad de almacenamiento de zonas específicas, asignar dinámicamente ubicaciones disponibles, seguimiento en línea de los niveles de inventario y detección rápida de entrada/salidas de materia prima o productos terminados. Estas tecnologías hacen posible la creación de los almacenes inteligentes obteniendo un proceso eficiente, con mínima cantidad de errores, reducción de retrasos y corrigiendo muchos de los inconvenientes que ocurren en la gestión del inventario.

Soluciones de Visión Computacional para la Gestión de Inventario

En el artículo de (Alonso, Dacal-Nierto, Barreto, Amaral, & Rivero, 2022) se mencionan varias propuestas utilizando visión computacional las que están integradas junto a la filosofía de la Industria 4.0. Los autores mencionan como la visión computacional es un elemento clave de la transición hacia este nuevo paradigma,  el contar con sensores visuales alrededor del almacén coleccionando y procesando automáticamente datos relacionados al estado de la materia prima o de los productos  podría facilitar el proceso de gestión de inventario y toma de decisiones de manera significativa.

Los autores (Vukićević, Mladineo, Banduka, & Mačužić, 2022) muestran cómo se llega a implementar una solución a los problemas de gestión enfocado a la Industria 4.0 usando visión computacional con IoT. La técnica utilizada por los autores está divida en 4 módulos: adquisición de imágenes, detección de códigos QR, interfaz de usuario y reporte. La adquisición de imágenes se lleva a cabo con un arreglo de cámaras IP instaladas por todo el techo del almacén. Se tiene una central tecnológica donde está el computador servidor que está corriendo la aplicación de usuario donde se procesa todas las imágenes de la cámara usando librerías de Python para el manejo de datos de imágenes como OpenCV y otras librerías de procesamiento de códigos QR. A su vez, en dicho programa, se encuentra la opción de generar reportes sobre las capturas. En este reporte se detalla la lista de inventario que contiene todos los productos, las órdenes completadas y no completadas entre otras necesidades que se necesite reportar en la empresa.

Por otro lado, en el artículo de (Niksa Mohammadi Bagheri, 2022) se habla de la problemática del proceso de identificación de los bolígrafos enfocándose en el color de estos. En su artículo detallan que enfocaron la solución a su problema usando las ventajas de la visión computacional para ayudar a detectar los patrones de colores en los bolígrafos. Para esto su propuesta fue el desarrollo de una estructura donde se pondría una cámara especializada que estaría apuntando hacia un recipiente donde se pondrían los bolígrafos. En este artículo se aprovecha las capacidades de la visión computacional para desarrollar un sistema un sistema que sea muy preciso y funcione en diferentes condiciones de luz para la identificación de bolígrafos.

De igual manera como se puede ver en el artículo de (Jianyu Lin, 2022) se puede implementar el uso de la visión computacional en las industrias de las automóviles para las piezas de estos mismos. En este artículo se detalla que se emplean generalmente cadenas de suspensión rígida para el almacenamiento de las piezas. La propuesta en este artículo es adaptar el reconocimiento de visión computacional con la cadena de suspensión. Esto permite un monitoreo en línea del nivel de inventario de piezas, resultando en una reducción del costo de gestión del inventario.

En el artículo de (Ashwary Anand, 2022), proponen una idea simple de manejo de inventario simplemente usando drones que vuelen por el almacén y escanean los códigos QR de las cajas. Ellos detallan que su proyecto está enfocado al uso de drones monoculares de bajo costo los cuales tienen equipado una cámara para realizar las tareas de gestión de almacén mediante el escaneo de los códigos. En su artículo detallan que los algoritmos de visión computacional tienen un papel crucial para la navegación del dron debido a que esto permite una localización de las cajas dentro del almacén más precisa.

Implementación de un sistema de Visión Computacional para la Gestión de un Almacén de Materia Prima en PUCMM: Una solución para la Industria 4.0

La automatización en la gestión de inventarios representa una serie de beneficios para las industrias que van desde la reducción de costos hasta la minimización de retrasos y errores, haciendo esto muy beneficioso para cualquier empresa. Si bien existen algunas implementaciones utilizando visión computacional para la gestión de inventario, estas consisten en su mayoría en sistemas estáticos, en ocasiones utilizando muchas cámaras, sin embargo, una alternativa menos costosa e igual de eficiente es utilizar un riel móvil que utilice una sola cámara para capturar todo el contenido del almacén.

Este nuevo acercamiento ha servido como idea de partida para la elaboración en la Pontificia Universidad Católica Madre y Maestra de un proyecto final de grado enfocado en la aplicación de técnicas de visión computacional para un sistema de control de inventario en almacenes de materia prima. En República Dominicana las industrias del tipo secundario que transforman la materia prima son de vital importancia, por lo que el manejo de los inventarios en los almacenes de materia prima es un crítico para su operación. De este modo, este proyecto busca aplicar este sistema simplificado de inspección de inventario mediante el uso de una cámara con capacidad de desplazamiento en un riel horizontal.

Esta implementación permitirá mantener un control en tiempo real del inventario con una mínima cantidad de cámaras y un sistema con un funcionamiento mecánico sencillo. Se realizará un sistema de administración apoyado en las técnicas de visión computacional para la identificación de los distintos productos a partir de códigos QR y el análisis de imágenes para el procesamiento de la captura de información según ocurra el desplazamiento de la cámara a través del riel. Logrando un sistema eficiente y robusto para la gestión de inventarios de almacenes de materia prima en tiempo real.

Referencias

Alonso, V., Dacal-Nieto, A., Barreto, L., Amaral, A., & Rivero, E. (2019). Industry 4.0 implications in machine vision metrology: An overview. Procedia Manufacturing, 41, 359–366. https://doi.org/10.1016/j.promfg.2019.09.020

Anand, A., Agrawal, S., Agrawal, S., Chandra, A., & Deshmukh, K. (2019). Grid-based localization stack for inspection drones towards automation of large scale warehouse systems. arXiv preprint arXiv:1906.01299. https://arxiv.org/abs/1906.01299

van Geest, M., Tekinerdogan, B., & Catal, C. (2021). Design of a reference architecture for developing smart warehouses in industry 4.0. Computers in industry, 124, 103343.
https://doi.org/10.1016/j.compind.2020.103343

van de Venn, H. W., & Mosaddegh, P. (2020). Development of Machine Vision System for Pen Parts Identification under Various Illumination Conditions in an Industry 4.0 Environment. 10.20944/preprints202004.0387.v1 

Lin, J., Yu, J., Pan, L., Chen, Z., Chen, Y., & Chen, Z. (2020). Design of Image Recognition System for rigid suspension chain inventory management. Journal of Physics: Conference Series, 1631, 012179. https://doi.org/10.1088/1742-6596/1631/1/012179

Vukićević, A., Mladineo, M., Banduka, N., & Mačužić, I. (2021). A smart Warehouse 4.0 approach for the pallet management using machine vision and Internet of Things (IoT): A real industrial case study. Advances in Production Engineering & Management, 16(3).
https://doi.org/10.14743/apem2021.3.401