SIGA: Una solución inteligente para la gestión del agua en viviendas dominicanas

Scarlett Betania Rodríguez Bravo y Alam Emilio Cordero – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La urgencia de modernizar la gestión del agua: un reto global y nacional

La gestión eficiente del agua constituye uno de los principales desafíos para el desarrollo sostenible debido al crecimiento de la población, el aumento del consumo y los efectos asociados al cambio climático [2]. La disponibilidad del recurso no depende únicamente de la existencia de fuentes naturales, sino también de la capacidad de administrarlas responsablemente, reducir las pérdidas y aprovechar fuentes alternativas. Esta situación ha impulsado el desarrollo de estrategias orientadas a modernizar los procesos de almacenamiento, distribución y consumo mediante tecnologías capaces de proporcionar información en tiempo real y facilitar una gestión basada en datos.

A esta problemática se suma la necesidad de considerar la relación entre el desarrollo tecnológico y el medio ambiente. Desde la perspectiva de la ecología humana, se plantea que las acciones y desarrollos humanos deben analizarse considerando su interacción con el entorno natural [3]. Bajo este enfoque, la tecnología puede representar un desafío cuando sus efectos ambientales no son considerados, pero también puede convertirse en una herramienta para favorecer el aprovechamiento responsable de los recursos naturales. En el ámbito hídrico, esto implica desarrollar soluciones que, además de automatizar procesos, contribuyan a reducir el desperdicio, aprovechar fuentes alternativas y promover una gestión sostenible del agua.

En la República Dominicana, esta necesidad adquiere especial importancia debido a las deficiencias existentes en la administración y distribución del recurso hídrico. A pesar de iniciativas como el Compromiso Nacional para un Pacto por el Agua 2021-2036, investigaciones han señalado problemas relacionados con la gestión de los consumos y las pérdidas en las redes de distribución, factores que pueden comprometer la sostenibilidad hídrica del país a largo plazo [1]. En numerosos hogares y establecimientos, además, la administración del agua almacenada continúa realizándose de manera manual, dificultando conocer con precisión la cantidad disponible, el consumo realizado y las condiciones de las diferentes fuentes de abastecimiento.

Otro aspecto relevante es el limitado aprovechamiento del agua de lluvia como fuente complementaria. La captación pluvial puede utilizarse para determinadas actividades secundarias, como limpieza o riego, reduciendo el uso innecesario del suministro público. Sin embargo, su incorporación requiere mecanismos capaces de conocer la disponibilidad del recurso y determinar cuándo resulta conveniente utilizar una fuente u otra. La ausencia de esta integración limita las posibilidades de administrar de manera conjunta el suministro público, el almacenamiento y la captación pluvial.

Frente a estas necesidades, diferentes investigaciones han explorado la automatización como alternativa para mejorar la gestión hídrica. Sharma [4], por ejemplo, propuso un sistema basado en Arduino orientado a la recolección, almacenamiento y distribución automática del agua de lluvia. Asimismo, sistemas de supervisión como SCADA permiten monitorear variables hidráulicas, detectar determinadas condiciones anormales y mejorar el control de procesos relacionados con el agua [5]. Estos antecedentes evidencian el potencial de integrar electrónica, comunicaciones y automatización para responder a problemas relacionados con la administración del recurso.

Dentro de este contexto, el Internet de las Cosas (IoT) proporciona herramientas que permiten conectar sensores, actuadores, microcontroladores y plataformas digitales para recopilar información y ejecutar acciones de manera automatizada. Variables como el nivel de almacenamiento, la presión y el caudal pueden ser supervisadas continuamente, mientras que protocolos de comunicación como MQTT permiten transmitir los datos entre dispositivos y sistemas de gestión. Microcontroladores como el ESP32 facilitan además la implementación de estas arquitecturas mediante capacidades de procesamiento y conectividad inalámbrica.

A partir de esta problemática surge el Sistema Inteligente de Gestión del Agua (SIGA), desarrollado por Scarlett Betania Rodríguez Bravo y Alam Emilio Cordero, estudiantes de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del Ing. Víctor Manuel Mancebo de León. El proyecto propone integrar diferentes fuentes de suministro de agua mediante una arquitectura IoT compuesta por sensores, actuadores, microcontroladores y una plataforma digital, con el propósito de monitorear las condiciones del sistema y gestionar el recurso de manera automatizada.

SIGA integra el suministro público y la captación pluvial mediante una lógica de control que permite tomar decisiones según la disponibilidad y las condiciones detectadas. El sistema monitorea variables como nivel, presión, caudal y consumo, establece comunicación en tiempo real entre los dispositivos, el servidor y la plataforma de gestión, y proporciona al usuario herramientas para visualizar el comportamiento de la infraestructura y configurar sus parámetros operativos. Además, incorpora información histórica y meteorológica como apoyo para el análisis y la gestión del recurso.

De esta manera, SIGA no se limita a automatizar una infraestructura hidráulica, sino que busca utilizar la tecnología como una herramienta para responder simultáneamente a una necesidad práctica y ambiental. El aprovechamiento del agua de lluvia, la supervisión del consumo, la detección de condiciones anormales y la gestión automatizada de las fuentes buscan contribuir a la reducción del desperdicio y a un uso más responsable del agua. El proyecto demuestra así cómo la integración de hardware, software y telecomunicaciones puede aplicarse al desarrollo de soluciones orientadas hacia una gestión hídrica más eficiente y sostenible.

Finalmente, la propuesta constituye un prototipo funcional que puede servir como referencia para futuras implementaciones en hogares, instituciones educativas, comercios y otros establecimientos que dispongan de sistemas de almacenamiento y distribución de agua. Aunque una implementación a mayor escala requiere adaptar la infraestructura hidráulica y dimensionar adecuadamente sus componentes, SIGA presenta un modelo tecnológico que evidencia el potencial del IoT para contribuir al desarrollo de edificaciones y ciudades inteligentes, utilizando la innovación tecnológica no solo para automatizar procesos, sino también para favorecer una relación más responsable con los recursos naturales.

Desconexión estructural: problemática en la gestión hídrica y límites del estado del arte

A pesar de los avances tecnológicos en el sector hídrico, la gestión del agua en viviendas y pequeños establecimientos continúa realizándose, en muchos casos, mediante mecanismos manuales o sistemas de automatización básicos que ofrecen escasa información sobre el estado del recurso. Esta situación dificulta conocer en tiempo real el nivel de almacenamiento, el consumo de agua y las condiciones de operación del sistema, limitando la capacidad de prevenir desperdicios y optimizar el uso de fuentes alternativas como la captación de agua de lluvia [1], [5].

En la República Dominicana, esta realidad se acentúa debido a las variaciones en el suministro de agua potable y a la dependencia de depósitos de almacenamiento para garantizar la disponibilidad del servicio. Aunque el agua de lluvia representa un recurso con un importante potencial de aprovechamiento, en la mayoría de las edificaciones no existen mecanismos que permitan administrarla de forma automática junto con la red pública. Como resultado, el agua potable continúa utilizándose en actividades que no requieren calidad para consumo humano, como el riego de jardines, la limpieza de patios o el lavado de vehículos, reduciendo la eficiencia en el aprovechamiento del recurso [5], [6].

La falta de monitoreo también dificulta la detección temprana de fugas, fallos en bombas o problemas de abastecimiento. En muchos casos, los usuarios desconocen el estado real de sus reservas de agua hasta que ocurre una interrupción del servicio o se presenta una avería en el sistema hidráulico. La ausencia de información en tiempo real limita la toma de decisiones y favorece el desperdicio de agua y energía, especialmente en instalaciones donde el llenado y el cambio entre fuentes de suministro continúan dependiendo de la intervención humana [1].

Además de afectar la disponibilidad del recurso, esta forma tradicional de administración incrementa la dependencia de la supervisión constante por parte del usuario. Es frecuente que las personas deban verificar manualmente el nivel de los depósitos, activar bombas de agua o cambiar el suministro entre distintas fuentes según su experiencia o percepción del estado del sistema. Estas actividades, aunque sencillas, pueden provocar errores humanos que derivan en reboses de depósitos, funcionamiento en seco de las bombas, consumo innecesario de energía eléctrica o interrupciones inesperadas en el abastecimiento. La automatización de estos procesos representa una oportunidad para mejorar tanto la eficiencia operativa como la comodidad del usuario final.

Por otra parte, el crecimiento de las tecnologías inteligentes ha impulsado una transformación significativa en la forma en que se diseñan los sistemas de monitoreo y control. La disponibilidad de sensores electrónicos de bajo costo, redes inalámbricas y plataformas de desarrollo abiertas ha permitido que soluciones anteriormente reservadas para aplicaciones industriales puedan implementarse también en viviendas y pequeñas empresas. Este cambio ha favorecido el desarrollo de sistemas IoT capaces de recopilar información continuamente y transmitirla a plataformas digitales para facilitar la supervisión remota y la toma de decisiones basada en datos [1], [2].

Diversas investigaciones han demostrado que el Internet de las Cosas constituye una alternativa viable para modernizar la gestión hídrica mediante el uso de sensores, actuadores y plataformas de monitoreo remoto. Sistemas basados en ESP32, Arduino y protocolos de comunicación ligeros como MQTT permiten supervisar variables hidráulicas y automatizar procesos de forma más eficiente que los mecanismos tradicionales, además de ofrecer acceso remoto a la información del sistema [1], [2], [3], [6].

La literatura científica también destaca la importancia de utilizar arquitecturas de comunicación ligeras y escalables para garantizar el intercambio eficiente de información entre dispositivos conectados. Protocolos como MQTT han demostrado ofrecer un excelente desempeño en aplicaciones donde múltiples sensores deben transmitir información de forma continua utilizando un ancho de banda reducido. Asimismo, el empleo de plataformas de desarrollo modernas facilita la integración entre el hardware instalado en campo y aplicaciones web o móviles que permiten visualizar el estado del sistema desde cualquier ubicación con acceso autorizado [2], [3].

En cuanto a la instrumentación, los avances recientes han permitido incorporar sensores de nivel, presión y caudal con mayor precisión y confiabilidad, ampliando considerablemente las posibilidades de supervisión. La combinación de estas variables proporciona una visión más completa del comportamiento hidráulico del sistema, permitiendo identificar anomalías operativas, verificar el correcto funcionamiento de bombas y válvulas, y conocer el consumo de agua con un mayor nivel de detalle. La integración de múltiples sensores también incrementa la confiabilidad de la información obtenida, ya que permite validar el comportamiento del sistema a partir de diferentes mediciones físicas [4].

Sin embargo, gran parte de las soluciones reportadas en la literatura se enfocan únicamente en la supervisión del nivel del agua o en la automatización del llenado de depósitos, sin integrar múltiples variables hidráulicas dentro de un mismo sistema de decisión. Asimismo, muchos desarrollos funcionan como prototipos experimentales y no incorporan una plataforma de monitoreo integral que permita visualizar el estado del sistema, generar alertas y facilitar la interacción del usuario con la infraestructura instalada [1], [2].

De igual forma, numerosas soluciones existentes fueron diseñadas para resolver problemas específicos y presentan limitaciones cuando se pretende ampliar sus funcionalidades. Algunos sistemas carecen de interfaces gráficas que faciliten la interpretación de los datos por parte del usuario, mientras que otros no permiten integrar nuevas fuentes de información ni modificar fácilmente las reglas de operación. Esta falta de flexibilidad dificulta su adaptación a distintos escenarios de uso y limita su aplicación en proyectos de mayor alcance orientados a la gestión inteligente del agua.

En este contexto, surge la necesidad de desarrollar una solución que combine monitoreo en tiempo real, automatización, conectividad y facilidad de uso dentro de una arquitectura de bajo costo y adaptable a entornos residenciales. El proyecto SIGA responde a esta necesidad mediante la integración de sensores, dispositivos de control, comunicaciones IoT y una plataforma web que permite administrar de forma inteligente el uso del agua proveniente tanto de la red pública como de la captación pluvial, contribuyendo a una gestión más eficiente y sostenible del recurso hídrico [1], [2], [5].

Más allá del desarrollo de un prototipo funcional, SIGA busca demostrar que la integración de tecnologías ampliamente disponibles puede convertirse en una alternativa viable para promover un uso más racional del agua en el contexto dominicano. La combinación de monitoreo continuo, automatización de procesos y visualización de información en tiempo real proporciona a los usuarios herramientas que favorecen una administración más eficiente del recurso, reducen la dependencia de operaciones manuales y contribuyen a la adopción de prácticas sostenibles. De esta manera, el proyecto se posiciona como una propuesta que integra los avances reportados en la literatura con las necesidades específicas de los hogares y pequeñas edificaciones, ofreciendo una solución tecnológica adaptable, escalable y orientada a mejorar la gestión hídrica mediante el uso del Internet de las Cosas.

Objetivos completados

El desarrollo del Sistema Inteligente de Gestión del Agua (SIGA) permitió cumplir el objetivo general de diseñar e implementar una solución inteligente orientada a optimizar la administración del agua en entornos residenciales mediante la integración de tecnologías de Internet de las Cosas (IoT), automatización y monitoreo en tiempo real. Este objetivo respondió a la necesidad de ofrecer una alternativa tecnológica que permitiera mejorar el aprovechamiento del recurso hídrico, reducir la dependencia de procesos manuales y facilitar la toma de decisiones relacionadas con el abastecimiento de agua. Para alcanzar este propósito se diseñó e implementó una infraestructura instrumentada con sensores ultrasónicos para la medición del nivel de agua, sensores de presión para supervisar las condiciones de suministro, caudalímetros para registrar el flujo de agua, válvulas solenoides para controlar automáticamente la distribución entre las diferentes fuentes y bombas de agua controladas mediante microcontroladores ESP32, permitiendo la integración de todos los dispositivos dentro de una misma arquitectura inteligente. Asimismo, se desarrolló una lógica de control encargada de gestionar automáticamente la conmutación entre la red pública y el sistema de captación pluvial de acuerdo con las condiciones detectadas por los sensores, priorizando la utilización del agua almacenada cuando las condiciones del sistema lo permitieran y garantizando la continuidad del suministro cuando fuera necesario recurrir al acueducto. De igual manera, se implementó una arquitectura de comunicaciones basada en el protocolo MQTT para la transmisión eficiente de información entre los dispositivos IoT y la plataforma de monitoreo, permitiendo la actualización continua de las variables hidráulicas y facilitando la supervisión remota del sistema. Como complemento, se desarrolló una plataforma web que permite visualizar en tiempo real el nivel de los depósitos, el estado de los dispositivos, los valores registrados por los sensores y las principales variables hidráulicas, además de ofrecer herramientas para la administración del sistema y la generación de notificaciones ante eventos relevantes. La integración de estos componentes permitió validar el funcionamiento del prototipo bajo diferentes escenarios de operación, demostrando que es posible implementar una solución de bajo costo, escalable y adaptable para optimizar la gestión del agua en viviendas y pequeñas edificaciones. En conjunto, los objetivos específicos alcanzados evidencian la viabilidad técnica de combinar automatización, comunicaciones inalámbricas y monitoreo inteligente en una única plataforma capaz de contribuir al uso más eficiente del recurso hídrico y de servir como base para futuras investigaciones y desarrollos orientados a la construcción de infraestructuras residenciales más sostenibles e inteligentes.
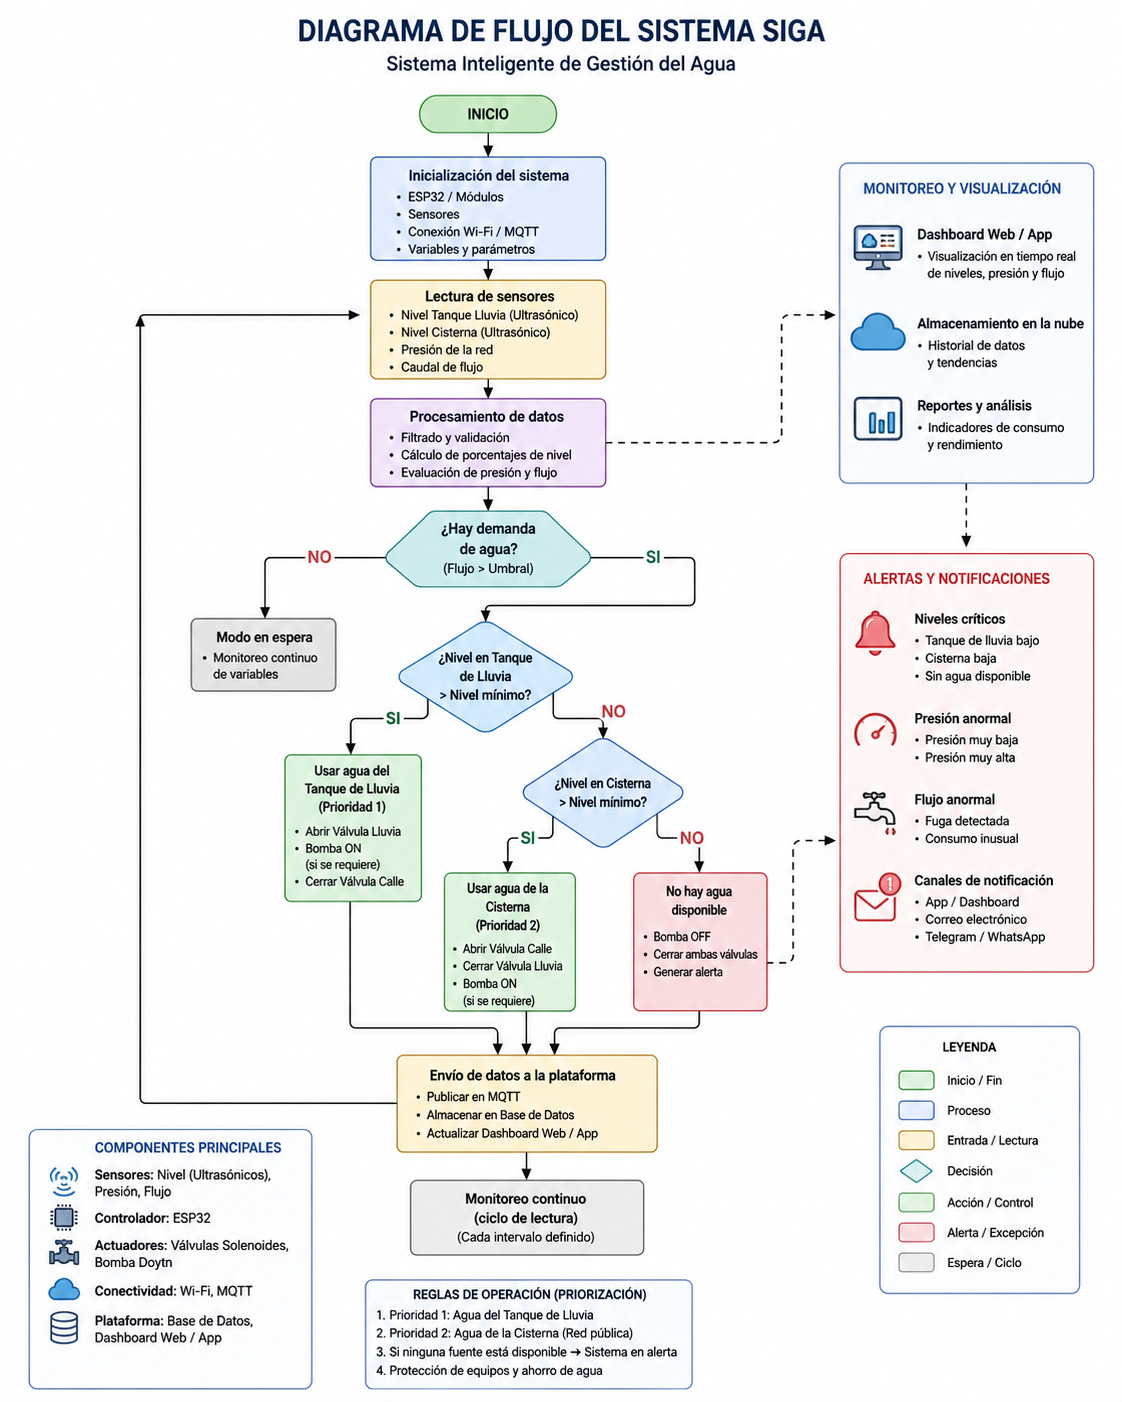
Diagrama de flujo del sistema SIGA: lectura de sensores, decisión entre tanque de lluvia y cisterna, envío de datos y alertas
Figura 1. Diagrama de funcionamiento.

Metodología y arquitectura técnica: hardware en el borde y lógica algorítmica

La construcción del sistema SIGA se desarrolló siguiendo una metodología de trabajo organizada por etapas, lo que permitió avanzar de manera progresiva en el diseño, la integración y las pruebas de cada uno de sus componentes. Este enfoque facilitó realizar mejoras continuas durante el desarrollo, corrigiendo errores y agregando nuevas funciones conforme el sistema evolucionaba. Gracias a ello, fue posible obtener una solución más estable y adaptada a las necesidades planteadas desde el inicio del proyecto.
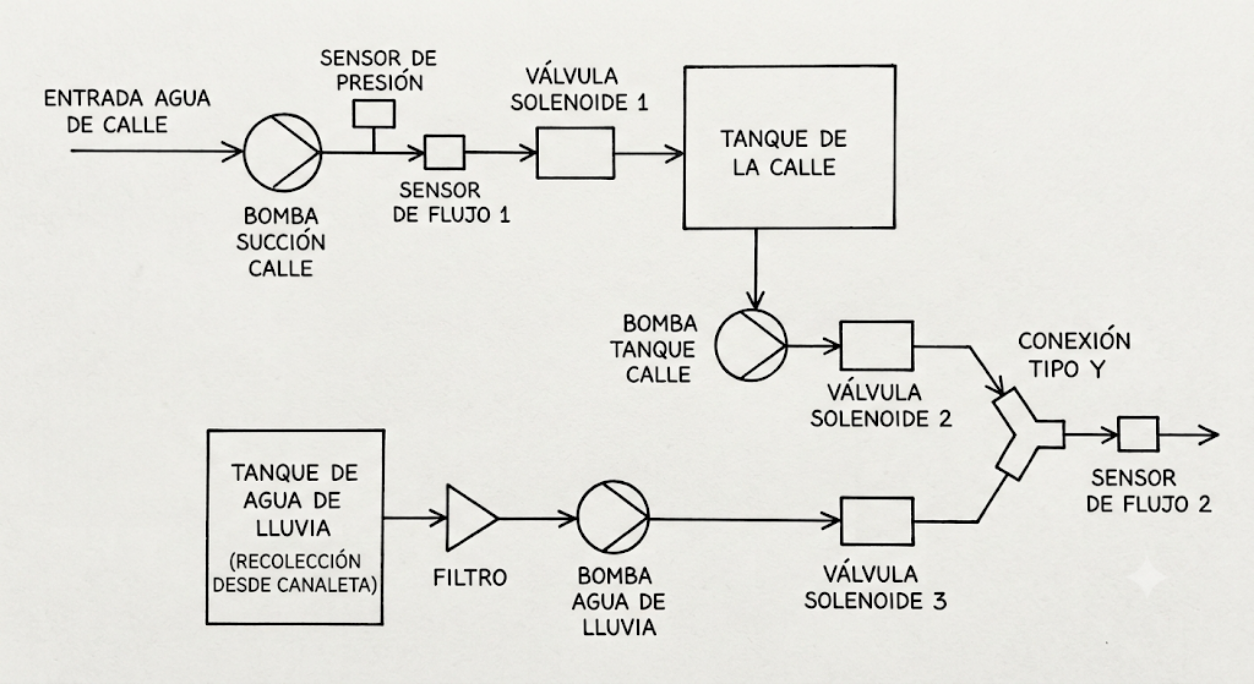
Diagrama hidráulico: bombas, sensores de presión y flujo, válvulas solenoides, tanque de la calle y tanque de agua de lluvia
Figura 2. Arquitectura del sistema.

El sistema fue diseñado para supervisar de forma constante el estado de los depósitos de agua mediante sensores que permiten conocer el nivel disponible sin necesidad de contacto directo. Esta mejora sustituyó métodos tradicionales que presentaban limitaciones por desgaste o menor precisión con el paso del tiempo. De esta manera, se obtuvo un monitoreo más confiable y con menor necesidad de mantenimiento, contribuyendo a una mejor administración del recurso hídrico.

Además del nivel del agua, SIGA también registra información relacionada con el flujo y la presión del suministro. Estos datos permiten identificar situaciones como una disminución en el abastecimiento, un consumo fuera de lo habitual o posibles fallas en la distribución. Al disponer de esta información en tiempo real, el sistema puede tomar decisiones más acertadas para garantizar la continuidad del servicio y optimizar el uso del agua.
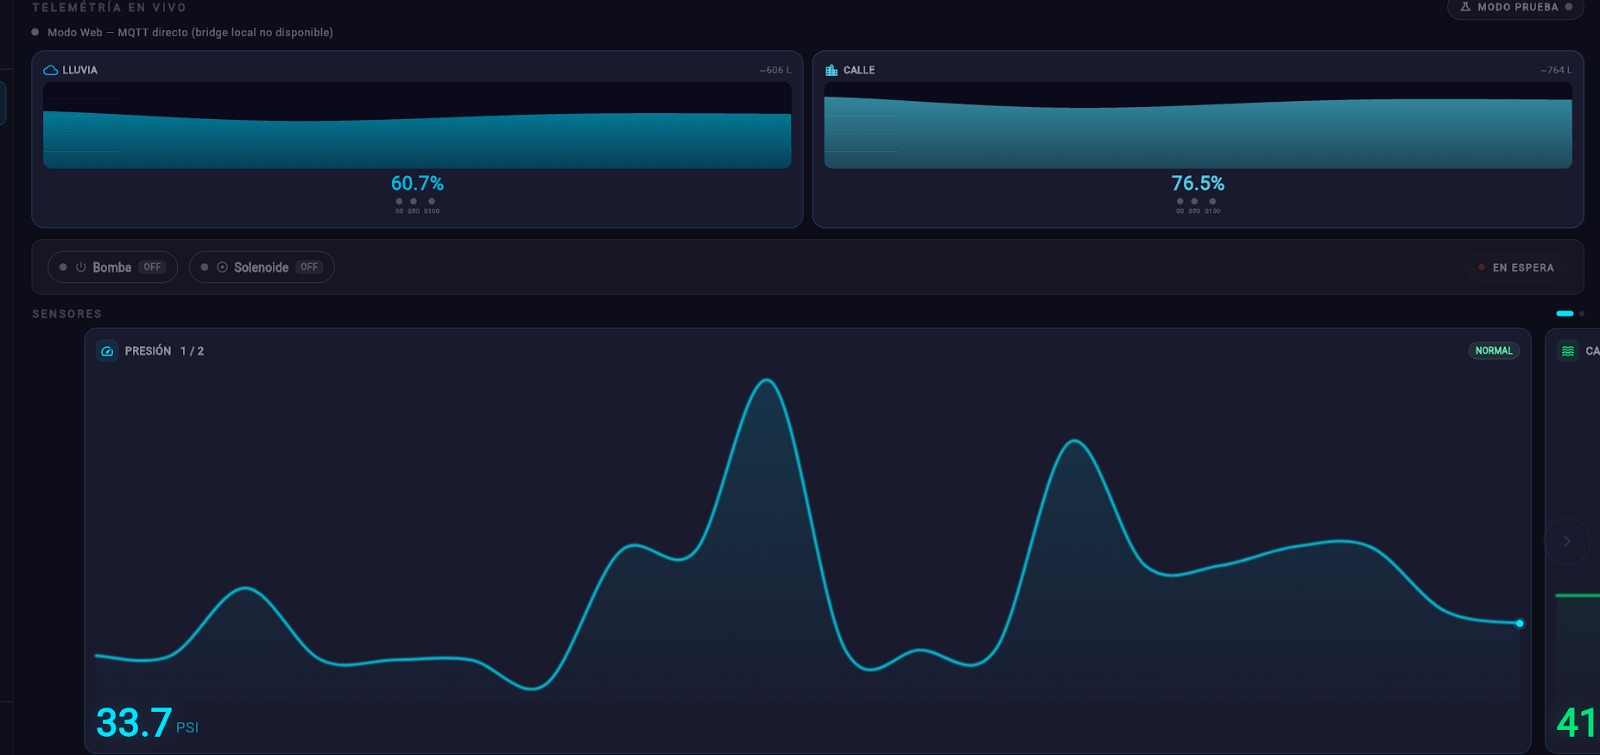
Dashboard web con el nivel de los tanques de lluvia y calle, estado de bomba y solenoide y gráfica de presión
Figura 3. Dashboard de la web.

Para controlar el paso del agua entre las diferentes fuentes de abastecimiento, el sistema incorpora válvulas y bombas que se activan automáticamente cuando las condiciones lo requieren. Este funcionamiento evita la intervención constante del usuario y permite que el cambio entre las distintas fuentes se realice de manera ordenada y segura. Asimismo, se implementaron mecanismos de protección para asegurar el funcionamiento continuo de los equipos y prolongar su vida útil.
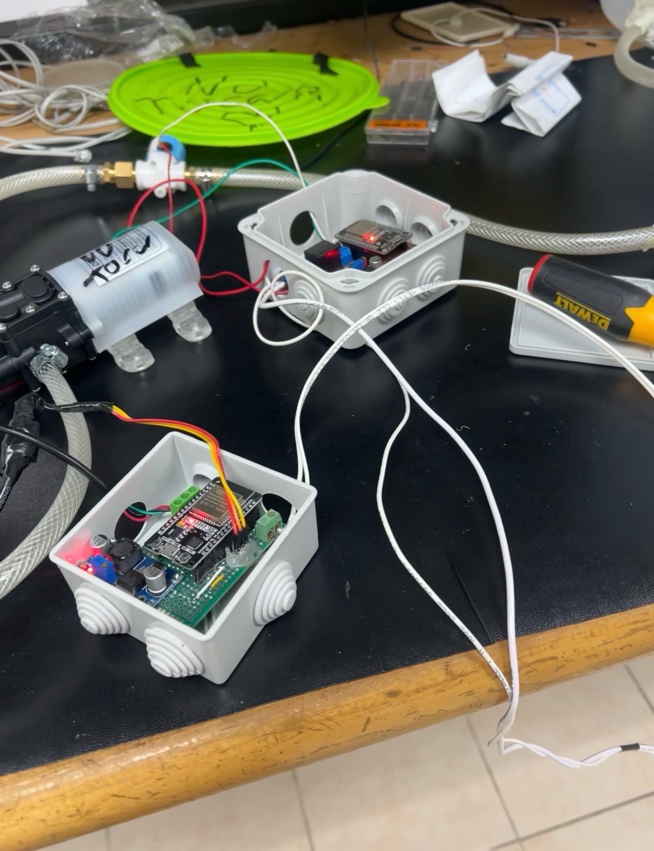
Prototipo: cajas de conexión con ESP32 y placas de control junto a una bomba de agua y mangueras
Figura 4. Circuitos protegidos de la bomba y la válvula.

Todos los dispositivos del sistema se encuentran conectados entre sí y envían la información recopilada hacia un servidor central, donde los datos son organizados y procesados. Esta comunicación permite que el estado del sistema esté disponible en todo momento y que las acciones necesarias puedan ejecutarse de forma rápida cuando se detecta algún cambio importante [3].

La información recopilada también se almacena para mantener un historial del comportamiento del sistema. Este registro facilita consultar el consumo de agua, revisar eventos anteriores y analizar el funcionamiento general de la instalación. Además, los usuarios pueden acceder a esta información desde una aplicación web o móvil, donde es posible visualizar el estado del sistema de forma sencilla y en tiempo real [6].

Uno de los aspectos más innovadores de SIGA es su capacidad para tomar decisiones automáticamente a partir de la información que recibe. En lugar de limitarse únicamente a mostrar datos, el sistema analiza las condiciones existentes y determina cuándo utilizar cada fuente de agua, cuándo activar las bombas y cuándo generar alertas para el usuario. Esta característica reduce el desperdicio de agua y mejora la eficiencia del proceso de distribución.

Como complemento, el sistema considera el comportamiento histórico del consumo para adaptar su funcionamiento con el paso del tiempo. También consulta información sobre las condiciones climáticas para anticipar posibles lluvias y recomendar estrategias que permitan aprovechar mejor el agua disponible. Esta capacidad de adaptación representa una diferencia importante respecto a los sistemas convencionales, ya que convierte a SIGA en una herramienta que no solo supervisa el recurso hídrico, sino que también contribuye a una gestión más eficiente, preventiva e inteligente del agua.

Resultados

Con el objetivo de validar el funcionamiento del Sistema Inteligente de Gestión del Agua (SIGA), se realizaron diferentes pruebas en un prototipo instalado en un ambiente controlado que simuló el funcionamiento de una vivienda. Durante estas pruebas se evaluó el monitoreo del nivel de agua, el cambio automático entre las fuentes de abastecimiento, el envío de alertas, el registro de información y el funcionamiento de la plataforma web.

Los resultados obtenidos demostraron que el sistema cumplió con los objetivos planteados durante el desarrollo. Los sensores registraron correctamente el nivel de agua de ambas cisternas, mientras que el sistema respondió automáticamente cuando fue necesario cambiar entre el agua de lluvia y la red pública. Además, toda la información fue visualizada en tiempo real desde la plataforma web.
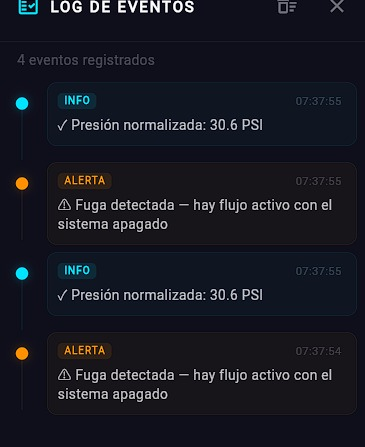
Log de eventos de la plataforma con alertas de fuga detectada y avisos de presión normalizada
Figura 5. Plataforma web mostrando las alertas del sistema.

Durante las pruebas de monitoreo se verificó que las mediciones realizadas por los sensores ultrasónicos fueron consistentes y permitieron conocer el nivel de agua de forma continua. La aplicación web actualizó la información pocos segundos después de producirse cualquier cambio en el sistema, permitiendo al usuario supervisar el estado de las cisternas desde cualquier dispositivo conectado.

En las pruebas de conmutación automática se simuló el vaciado de la cisterna de agua de lluvia. Una vez alcanzado el nivel mínimo establecido, el sistema cerró automáticamente esa fuente de suministro y habilitó la alimentación desde la red pública, manteniendo el flujo de agua sin intervención del usuario.

También se evaluó el sistema de alertas. Cuando se simuló una condición anormal, como la ausencia de flujo de agua o una posible fuga, la plataforma registró el evento y envió una notificación al usuario mediante correo electrónico. Esto permitió comprobar que el sistema puede informar oportunamente situaciones que requieren atención.
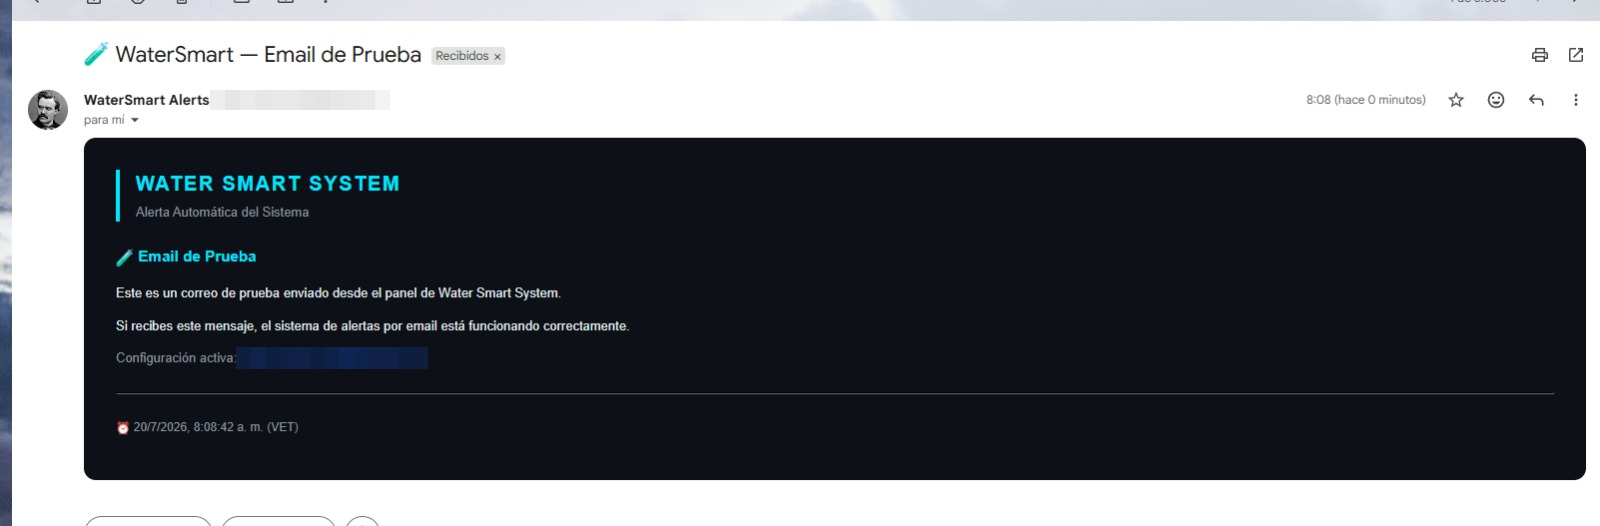
Correo electrónico de prueba enviado por el sistema de alertas
Figura 6. Notificación enviada por correo electrónico.

Otro aspecto evaluado fue el registro histórico de la información. Todas las mediciones generadas por los sensores fueron almacenadas en la base de datos y posteriormente representadas mediante gráficos dentro de la plataforma web. Esto facilita el seguimiento del consumo de agua y permite identificar tendencias de uso con el paso del tiempo.
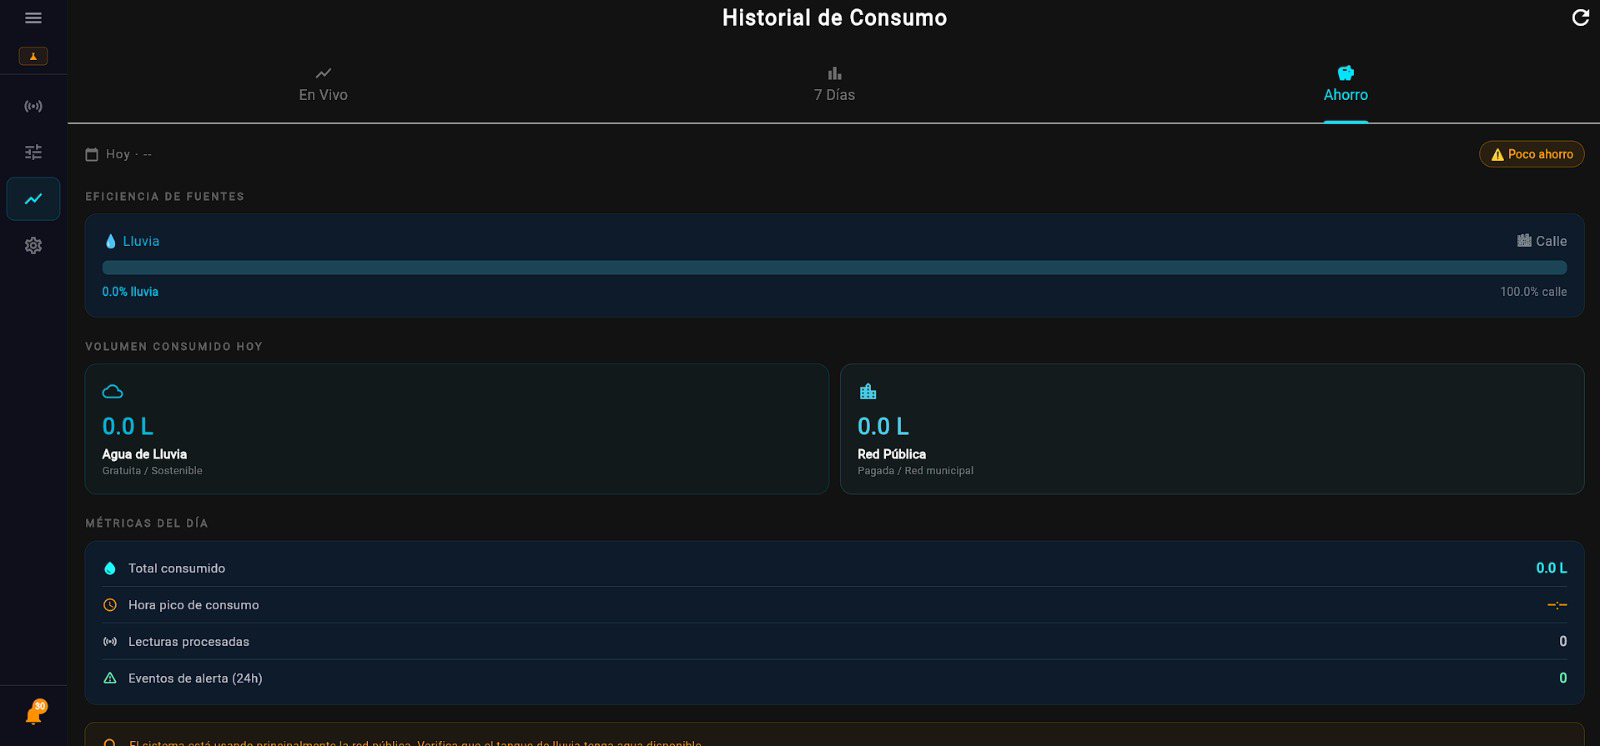
Pantalla de historial de consumo con eficiencia de fuentes, volumen consumido y métricas del día
Figura 7. Historial de consumo en la plataforma web.

Finalmente, se realizaron pruebas desconectando temporalmente la conexión a Internet. Durante este período el sistema continuó controlando las bombas y válvulas utilizando la información disponible en los sensores. Una vez restablecida la conexión, los datos fueron sincronizados nuevamente con la plataforma, demostrando que el sistema puede seguir funcionando incluso cuando no existe comunicación con el servidor.

Área evaluadaPrueba realizadaResultado obtenido
Monitoreo del nivelMedición continua de ambas cisternasLecturas estables y actualización correcta en la plataforma
Cambio de fuenteVaciado de la cisterna de lluviaCambio automático hacia la red pública
Plataforma webVisualización de datosInformación mostrada en tiempo real
Sistema de alertasSimulación de fuga y ausencia de flujoNotificación enviada al usuario por correo electrónico
HistorialRegistro continuo de medicionesDatos almacenados correctamente en la base de datos
Funcionamiento sin InternetDesconexión temporal de la redEl sistema continuó operando y sincronizó la información al reconectarse
Tabla 1. Resultados obtenidos durante las pruebas.

En comparación con otros proyectos de monitoreo de agua reportados en la literatura, SIGA incorpora en una sola plataforma el monitoreo del nivel de agua, el cambio automático entre dos fuentes de abastecimiento, el almacenamiento del historial, el envío de alertas y la consulta desde una aplicación web. Esta integración permite ofrecer una solución más completa para la gestión del agua en viviendas.

Conclusión

El desarrollo del Sistema Inteligente de Gestión del Agua (SIGA) permitió demostrar que es posible administrar de manera automática dos fuentes de abastecimiento de agua mediante el uso de sensores, dispositivos electrónicos y una plataforma web de monitoreo. Los resultados obtenidos durante las pruebas confirmaron que el sistema cumple con los objetivos propuestos, ofreciendo una solución que facilita el aprovechamiento del agua de lluvia y reduce la dependencia de la red pública.

Uno de los principales aprendizajes obtenidos durante el desarrollo fue la importancia de integrar el hardware y el software de manera coordinada para lograr un funcionamiento confiable. La sustitución de los sensores de nivel inicialmente considerados por sensores ultrasónicos permitió mejorar la estabilidad de las mediciones, mientras que la implementación de un sistema de monitoreo en tiempo real facilitó el seguimiento del comportamiento de todo el sistema.

El proyecto también demuestra que un sistema puede considerarse inteligente sin utilizar modelos avanzados de inteligencia artificial. En el caso de SIGA, la toma de decisiones se basa en reglas previamente definidas, información proporcionada por los sensores y el análisis de las condiciones del sistema, permitiendo automatizar tareas que normalmente requerirían la intervención del usuario.

Como trabajo futuro, se propone incorporar sensores que permitan evaluar la calidad del agua, integrar una fuente de alimentación mediante paneles solares para aumentar la autonomía del sistema y desarrollar modelos predictivos que ayuden a estimar el consumo de agua según el comportamiento histórico y las condiciones climáticas.

En conclusión, SIGA representa una alternativa tecnológica para mejorar la gestión del agua en viviendas, promoviendo un uso más eficiente de este recurso. Se espera que este proyecto pueda continuar evolucionando mediante futuras investigaciones y pruebas en escenarios reales, contribuyendo al desarrollo de soluciones sostenibles para el aprovechamiento del agua en la República Dominicana.

Referencias

  1. J. A. P. Al-Shurman, B. A. M. Abdullah, and M. I. I. A. Ahmed, “A comprehensive review of IoT-based smart water management systems,” IEEE Access, vol. 9, pp. 112111–112130, 2021.
  2. K. Hassan, “Development of a real-time monitoring system using Flutter and MQTT protocol for IoT applications,” J. Sensors, vol. 2022, pp. 1–12, 2022.
  3. S. Kumar, “Low-cost smart home automation using ESP32 and MQTT,” Int. J. Comput. Sci. Eng., vol. 18, no. 5, pp. 202–210, 2020.
  4. A. S. Morris and R. Langari, Measurement and Instrumentation: Theory and Application, 3rd ed. Oxford, UK: Elsevier, 2020.
  5. E. Rodríguez, A. L. Peña, and J. M. García, “An IoT-enabled architecture for efficient urban water distribution in developing economies,” Int. J. Eng. Telematics, vol. 5, no. 2, pp. 45–56, 2022.
  6. V. Sharma, “Arduino Based Smart Water Management,” International Journal of Engineering Research and Technology, vol. 9, Sep. 2020, doi: 10.17577/IJERTV9IS080239.
MOSAIC: una plataforma híbrida para construir, evaluar y explicar horarios universitarios

Josvier Rodríguez y Emilio José George Rodríguez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Un proyecto final de grado que integra calidad de datos, optimización combinatoria, trazabilidad y apoyo a la toma de decisiones académicas.

En una universidad, un horario no es una simple cuadrícula de días y horas. Detrás de cada casilla existe una decisión que compromete la disponibilidad de un docente, la capacidad de un aula, la continuidad de una asignatura, la carga de una sección y la experiencia de cientos de estudiantes. Cuando esas decisiones se realizan con archivos dispersos, reglas implícitas y correcciones manuales, un cambio aparentemente pequeño puede producir choques de recursos, sobreocupaciones o secuencias académicas difíciles de justificar. La programación de horarios pertenece, por esa razón, a una familia de problemas combinatorios en la que la cantidad de alternativas crece con rapidez y donde obtener una propuesta válida requiere mucho más que acomodar materias en una semana [1]. En la práctica, una corrección tardía rara vez afecta una sola clase: puede obligar a mover otra sección, cambiar de espacio, alterar la jornada de un docente y comunicar una nueva versión a estudiantes y coordinadores. Esa propagación explica por qué la planificación necesita mecanismos preventivos, no únicamente capacidad de reaccionar cuando el conflicto ya fue publicado.

MOSAIC nació para responder a ese escenario desde la Escuela de Ingeniería en Computación y Telecomunicaciones de la Pontificia Universidad Católica Madre y Maestra. El proyecto fue desarrollado por Josvier Rodríguez y Emilio José George Rodríguez, bajo la asesoría de Rafael Omar Batista, como trabajo final de grado en Ciencias de la Computación. Su propósito no fue reemplazar a quienes planifican la oferta académica, sino construir una herramienta capaz de convertir datos institucionales en propuestas de horario verificables, comparables y explicables. El nombre identifica un motor analítico para propuestas de horarios universitarios: una plataforma que recibe archivos CSV o XLSX, prepara su estructura, mide el estado inicial, ejecuta un proceso de optimización y conserva evidencia de cada corrida. El desarrollo se situó en la intersección entre investigación operativa e ingeniería de software. Esa combinación permitió que las decisiones matemáticas no quedaran aisladas en un experimento, sino integradas a un flujo de carga, validación, ejecución, historial y exportación. El resultado es un artefacto académico que puede discutirse desde el algoritmo, la arquitectura y la utilidad institucional.

La pertinencia del proyecto se relaciona con la transformación digital que atraviesa la educación superior. Las universidades generan cada vez más datos sobre matrícula, asignaturas, infraestructura, modalidades y disponibilidad docente, pero disponer de información no garantiza que esta se convierta en una decisión útil. La literatura sobre instituciones universitarias digitales y analítica académica insiste en que el valor aparece cuando los registros se integran, se validan y se presentan de forma que apoyen el juicio humano [13]-[16]. MOSAIC adopta precisamente esa perspectiva: el algoritmo es importante, pero también lo son la calidad de entrada, la trazabilidad del proceso y la capacidad de explicar por qué una alternativa resulta factible o por qué no puede corregirse sin modificar una condición institucional. Este enfoque también responde a una necesidad regional: muchas instituciones latinoamericanas modernizan sus procesos mientras conviven con exportaciones tabulares, plataformas no interoperables y políticas que se aplican mediante conocimiento tácito. Una herramienta de apoyo debe tolerar esa realidad sin normalizarla de manera silenciosa; debe indicar qué datos faltan, cuáles fueron transformados y qué supuestos sostienen cada resultado [13], [16].

Cuando construir un horario deja de ser una cuadrícula

Este artículo presenta el recorrido del proyecto con una redacción orientada tanto a lectores técnicos como a personas vinculadas con la gestión académica. Primero se explica por qué la programación universitaria continúa siendo un problema abierto; luego se describe la metodología híbrida utilizada, la arquitectura del sistema y la forma en que se protegen la factibilidad y la reproducibilidad. Finalmente, se analizan los resultados con el mismo criterio utilizado en el informe final: separar lo que está implementado y verificado de aquello que todavía necesita validación institucional. Esa distinción es esencial porque un prototipo de investigación puede demostrar una base tecnológica sólida sin afirmar, de manera prematura, que ya está listo para operar a escala de campus. La promesa editorial y técnica es, por tanto, deliberadamente moderada. El artículo no presenta la automatización como una respuesta universal ni convierte una demostración en una adopción institucional. Expone cómo se construyó la solución, qué evidencia respalda cada afirmación y cuáles decisiones todavía pertenecen a las autoridades académicas. Esa honestidad fortalece, en lugar de debilitar, el aporte del proyecto.

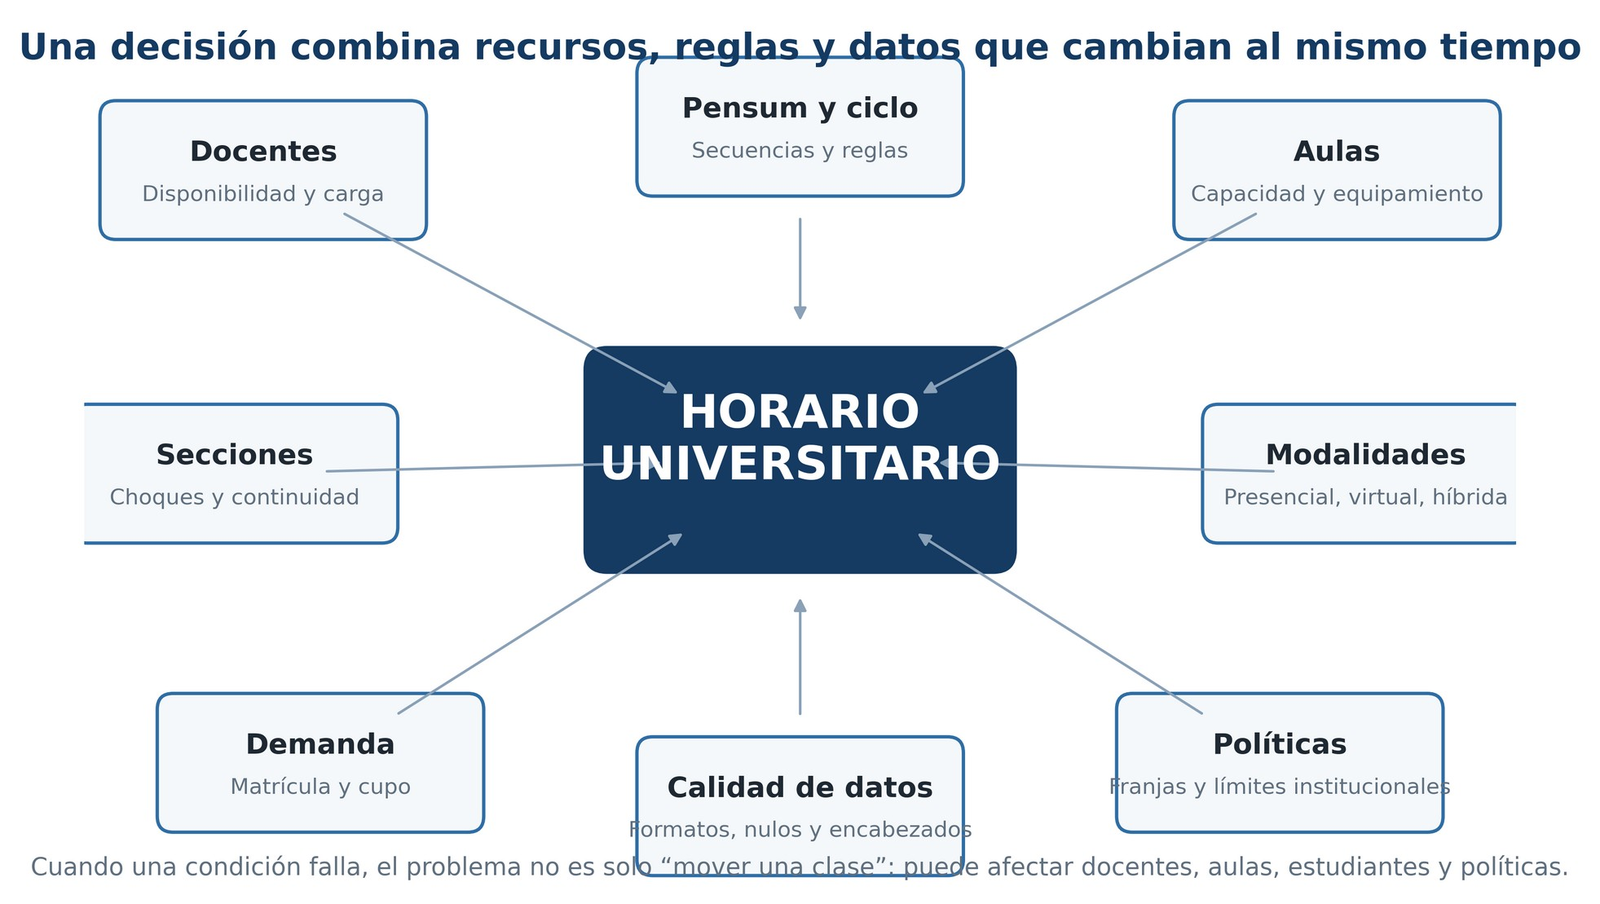
Diagrama: el horario universitario en el centro, rodeado por docentes, pensum y ciclo, aulas, secciones, modalidades, demanda, calidad de datos y políticas
Figura 1. Variables que convergen en la programación de un horario universitario. Fuente: elaboración propia a partir del modelo conceptual de MOSAIC.

La dificultad del problema comienza por la cantidad de actores y recursos que deben coordinarse al mismo tiempo. Dos clases no pueden utilizar la misma aula en intervalos solapados; un profesor no puede impartir sesiones simultáneas; una sección debe respetar sus horas semanales, su continuidad y su relación con el pensum; una clase presencial necesita un espacio compatible con su matrícula, mientras una sesión virtual no debería reservar infraestructura física. A esas condiciones se agregan franjas institucionales, aulas obligatorias para laboratorios, límites de carga docente y días lectivos permitidos. En la literatura, estas condiciones se distinguen entre restricciones duras, cuya violación invalida la propuesta, y criterios blandos, que permiten comparar la calidad de horarios ya factibles [1], [3], [6]. Esta separación evita comparar como equivalentes situaciones de naturaleza distinta. Un hueco entre clases puede ser inconveniente, pero no tiene el mismo impacto que asignar simultáneamente al mismo docente o exceder la capacidad de un laboratorio. Al modelar prioridades explícitas, el sistema refleja que la calidad se optimiza después de asegurar que la propuesta pueda operar en la realidad universitaria.

El problema se vuelve aún más complejo cuando la información de partida no está preparada para un optimizador. Un archivo puede contener encabezados desplazados, columnas con nombres diferentes, horarios escritos con convenciones incompatibles, capacidades vacías o modalidades registradas de forma contradictoria. Si un valor de aula se interpreta mal, el sistema puede creer que existe un recurso disponible; si una hora no puede convertirse a un intervalo, no será posible detectar un solapamiento; si falta el identificador de un profesor, una doble asignación puede pasar inadvertida. Por eso, MOSAIC trata la preparación de datos como parte del problema de ingeniería y no como una actividad secundaria. La calidad de la solución depende de la fidelidad con la que la instancia represente la realidad institucional. La dificultad no se resuelve eliminando filas problemáticas sin dejar rastro. MOSAIC conserva un checklist de ingestión y comunica las columnas detectadas, las ausentes y las conversiones realizadas. Esta conducta es importante para el gobierno del dato: permite corregir la fuente, repetir el análisis y evitar que una aparente mejora sea solo consecuencia de haber ignorado registros que no pudieron interpretarse.

Los enfoques exactos, como la programación entera y la programación por restricciones, ofrecen formulaciones rigurosas y pueden demostrar optimalidad o infactibilidad dentro del modelo construido. Sin embargo, su costo puede aumentar cuando se combinan cientos de sesiones, aulas y candidatos temporales. Trabajos recientes han mostrado que la programación universitaria real contiene variantes multiphase, currículos, asignaciones de docentes y objetivos que dificultan una formulación única [4], [7], [17]. Esto no significa que los modelos exactos sean inadecuados; significa que deben utilizarse con un alcance cuidadosamente definido, límites de tiempo y mecanismos que permitan continuar cuando la instancia crece o incluye reglas difíciles de expresar en una formulación compacta. En MOSAIC, esa tensión se administra reduciendo el dominio de la fase exacta y estableciendo rutas de respaldo. El solucionador puede concentrarse en aulas compatibles y candidatos de tiempo permitidos, mientras otras reglas se verifican o reparan en etapas posteriores. La arquitectura acepta que una formulación técnicamente elegante no siempre es la alternativa más operativa cuando la instancia llega incompleta o cambia durante el ciclo.

Las metaheurísticas, por su parte, exploran el espacio de soluciones mediante movimientos y estrategias que buscan mejorar progresivamente un horario. La Búsqueda Tabú es especialmente útil porque incorpora memoria: evita regresar de inmediato a movimientos recientes, permite escapar de óptimos locales y puede aceptar una transición que no sea mejor en el corto plazo si abre una ruta hacia una solución superior [11]. Su flexibilidad resulta valiosa cuando las preferencias institucionales son numerosas o cambian con frecuencia. No obstante, una metaheurística pura necesita una solución inicial y puede dedicar gran parte de su esfuerzo a corregir factibilidad. Si las restricciones obligatorias no están controladas, el algoritmo podría encontrar un horario cómodo o equilibrado que siga siendo operacionalmente imposible. Su utilización también exige disciplina experimental. La semilla, el tamaño del vecindario, el número máximo de iteraciones y el criterio de estancamiento deben quedar registrados, porque dos ejecuciones con parámetros distintos no constituyen la misma prueba. MOSAIC incorpora esos metadatos para que la búsqueda no funcione como una caja negra y para que la comparación pueda reconstruirse posteriormente.

La tendencia de investigación ha favorecido, por ello, métodos híbridos que distribuyen responsabilidades entre varias técnicas. Una fase exacta puede construir una base factible; operadores especializados pueden reparar reglas de dominio; y una búsqueda local puede refinar preferencias sin comprometer condiciones críticas [5], [12]. Las revisiones sobre el University Course Timetabling Problem señalan que no existe un único método dominante para todas las instituciones, porque cada universidad combina políticas, estructuras curriculares y recursos distintos [3], [6]. MOSAIC se ubica en esa línea, pero añade una preocupación de producto: además de producir una propuesta, debe conservar los parámetros, desglosar las violaciones y permitir que un comité compare el estado original con la salida. La hibridación no consiste en encadenar algoritmos de manera decorativa. Cada componente responde a una limitación concreta: CP-SAT organiza una parte de la factibilidad, los reparadores incorporan conocimiento institucional y Tabú explora calidad. El valor surge de la coordinación entre fases y de una función de evaluación común que permite observar cómo cambia el horario sin perder el vínculo con sus restricciones.

Los estudios recientes también han ampliado el problema hacia modalidades híbridas, trayectorias curriculares personalizadas y asignaciones orientadas por demanda. Estas investigaciones muestran que una solución puede ser matemáticamente atractiva y, aun así, requerir mecanismos adicionales para responder a cambios de matrícula, indisponibilidad de recursos o secuencias de estudio no convencionales [8]-[10]. De esta evidencia surge una idea central del proyecto: evaluar un horario solo en condiciones nominales no basta. Dos propuestas pueden tener cero conflictos en el momento de su generación, pero reaccionar de manera diferente cuando aumenta la demanda o se bloquea un aula. La robustez debe observarse como una dimensión posterior y distinta de la optimización. La robustez adquiere especial relevancia porque la planificación se realiza antes de que todas las condiciones permanezcan estables. La matrícula puede variar, un profesor puede quedar indisponible o un aula puede salir de servicio. Incorporar escenarios no elimina la incertidumbre, pero permite identificar propuestas demasiado dependientes de recursos críticos y ofrecer al comité una señal temprana antes de aprobar la versión definitiva.

Una meta concreta: convertir datos dispersos en decisiones comparables

Otra brecha aparece entre los modelos publicados y las herramientas que usan las personas responsables de la planificación. Muchos trabajos comparan algoritmos sobre conjuntos de datos previamente estructurados, mientras las oficinas académicas deben resolver primero inconsistencias de archivos, reglas no documentadas y cambios de última hora. Además, una puntuación única no siempre explica por qué una propuesta es mejor. Los sistemas de apoyo a decisiones deben combinar automatización con transparencia, conservar la posibilidad de intervención y evitar que el usuario confunda una recomendación con una decisión obligatoria [2], [14]. MOSAIC se diseñó como una ayuda para el análisis: genera evidencia y alternativas, pero mantiene la aprobación final en manos del comité académico. También existe una diferencia entre demostrar un algoritmo y entregar una experiencia de uso. Una coordinación necesita cargar archivos, entender advertencias, revisar indicadores, localizar la causa de una violación y descargar resultados. Si el sistema solo devuelve un número final, obliga a confiar sin comprender. Por eso, la interfaz y la persistencia forman parte de la solución científica: convierten el cálculo en evidencia examinable.

Del archivo institucional a una representación confiable

El objetivo completado fue desarrollar una herramienta de apoyo a la toma de decisiones para generar y mejorar horarios universitarios a partir de datos académicos institucionales, permitiendo comparar la factibilidad y la calidad entre una programación base y una alternativa procesada. Para alcanzarlo, el proyecto implementó la carga, validación y normalización de archivos CSV y XLSX; construyó un modelo híbrido con CP-SAT, reparadores y Búsqueda Tabú; definió indicadores de restricciones duras, criterios blandos, puntuación global y robustez; y desarrolló una interfaz web conectada a servicios de ejecución, historial, persistencia y exportación. El cumplimiento se evaluó dentro del alcance de tesis, sin presentar la plataforma como una integración productiva con el sistema de gestión académica. El cumplimiento se materializó en cuatro capacidades observables: ingesta y normalización de CSV/XLSX; un modelo híbrido con restricciones y criterios de calidad; indicadores para factibilidad, calidad y estabilidad; y una interfaz conectada a servicios de ejecución, persistencia y exportación. El objetivo se considera completado dentro del alcance de tesis, sin extender esa afirmación a una integración productiva con sistemas institucionales.

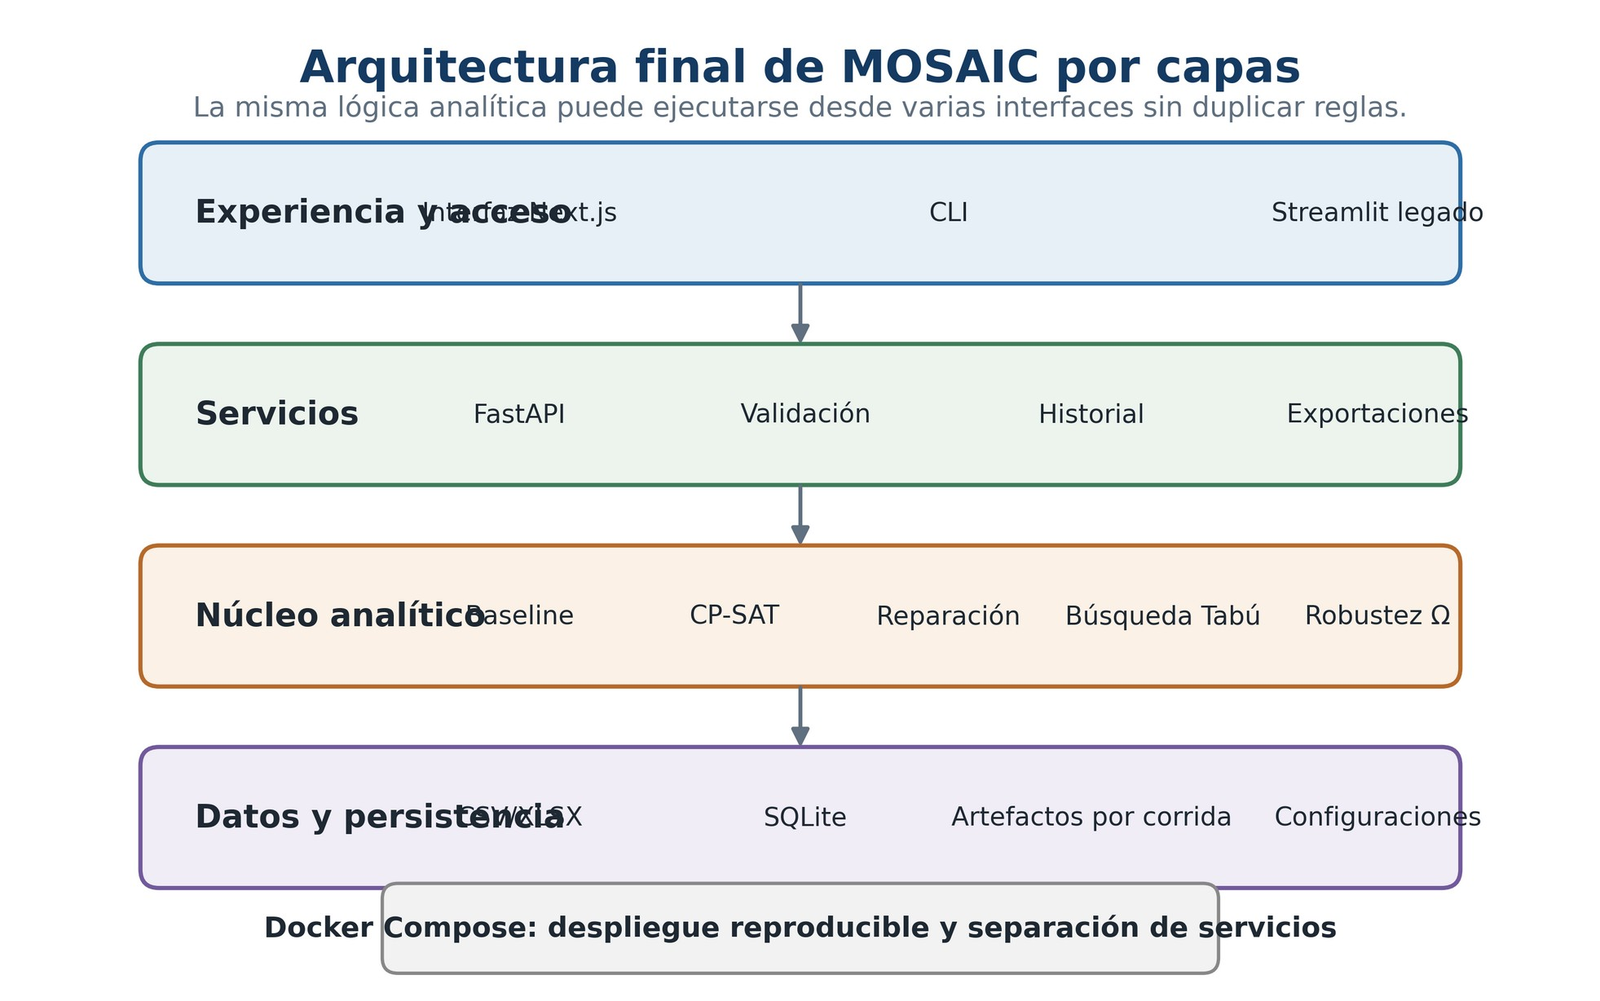
La metodología comienza con una arquitectura por capas que separa la experiencia del usuario, los servicios y el núcleo analítico. La interfaz final se desarrolló con Next.js y TypeScript; FastAPI expone validación, creación de corridas, historial, detalle, horario, indicadores y exportaciones; el motor Python contiene la lógica de ingesta, evaluación y optimización; y SQLite, junto con archivos organizados por corrida, conserva el estado. Esta separación evita que una regla exista solo en la pantalla o que una exportación calcule resultados distintos. El mismo pipeline puede ejecutarse desde la interfaz, la API o la línea de comandos, lo que favorece las pruebas y reduce el acoplamiento entre la lógica matemática y la presentación. La separación evita duplicar lógica entre pantallas y exportaciones. El mismo núcleo analítico puede ser invocado desde línea de comandos, API o interfaz web, de modo que la cifra mostrada al usuario proviene del mismo cálculo que se conserva en los artefactos. Esta decisión reduce inconsistencias, facilita las pruebas y permite evolucionar la experiencia visual sin reescribir las reglas académicas.

Arquitectura por capas de MOSAIC: experiencia y acceso, servicios, núcleo analítico y datos y persistencia, desplegados con Docker Compose
Figura 2. Arquitectura final de MOSAIC por capas. Fuente: elaboración propia a partir de la arquitectura documentada del proyecto.

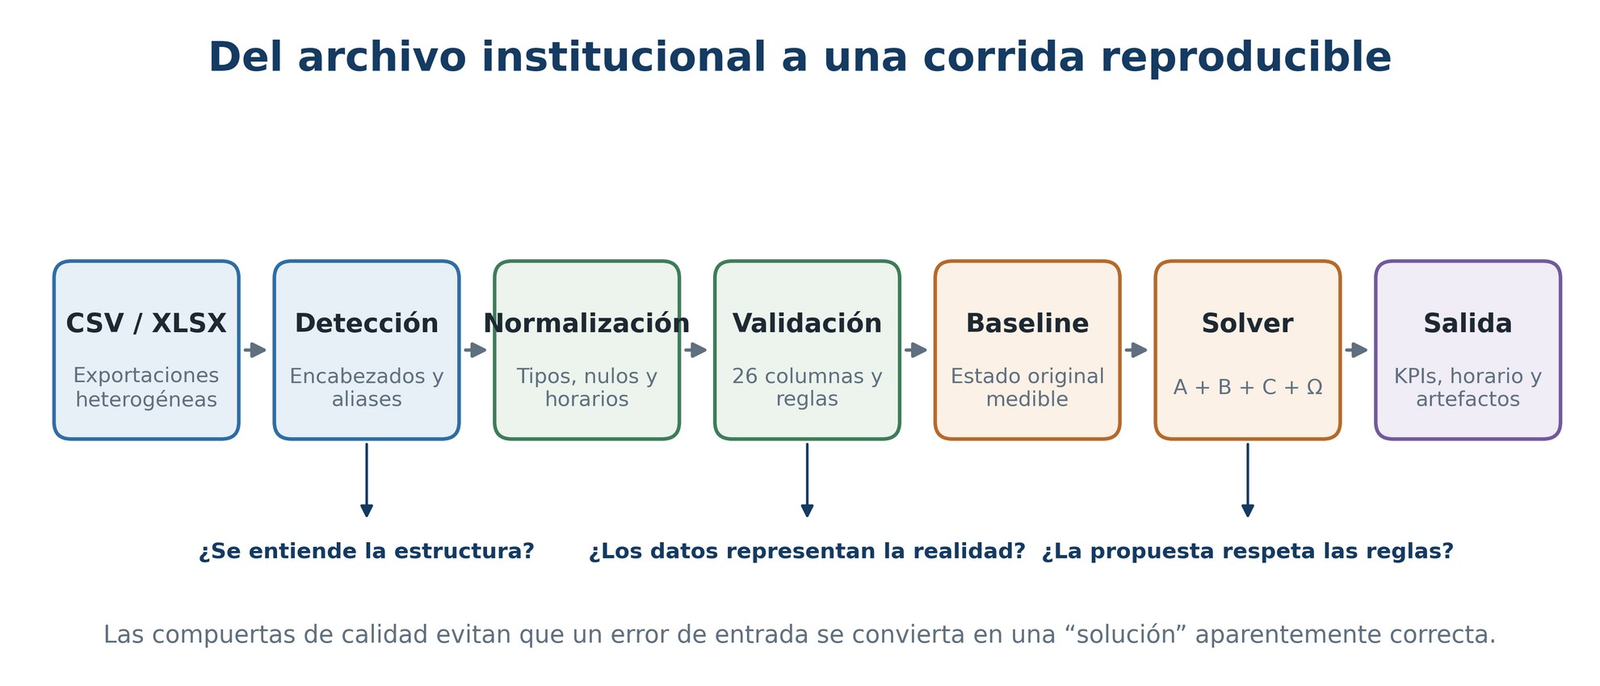
La entrada se organiza mediante un contrato extendido de veintiséis columnas que incluye ciclo, código y nombre de asignatura, número de clase, estado, cupo, matriculados, créditos, modalidad, profesor, aula, capacidad, días, horas, campus, tipo de clase, requisitos y observaciones, entre otros atributos. El sistema admite aliases y puede recuperar encabezados que no aparecen en la primera fila. También convierte valores vacíos, normaliza nombres, interpreta horarios y preserva columnas aparentemente anónimas cuando contienen información. El objetivo no es aceptar cualquier archivo sin advertencia, sino tolerar variaciones comunes y devolver un checklist claro de lo detectado, lo ausente y lo que debe corregirse antes de ejecutar el modelo. La tolerancia de entrada se combina con límites explícitos. El flujo reconoce alias y variaciones comunes, pero no inventa valores necesarios para decidir. Campos como matrícula, modalidad, aula, profesor, días y horas deben alcanzar un nivel mínimo de interpretabilidad. De esa forma, la flexibilidad sirve para incorporar exportaciones reales sin convertir datos ambiguos en certezas artificiales para el solucionador.

Flujo de datos de MOSAIC: CSV/XLSX, detección, normalización, validación, baseline, solver y salida, con compuertas de calidad
Figura 3. Flujo de datos y compuertas de calidad antes de la optimización. Fuente: elaboración propia a partir del proceso de ingesta de MOSAIC.

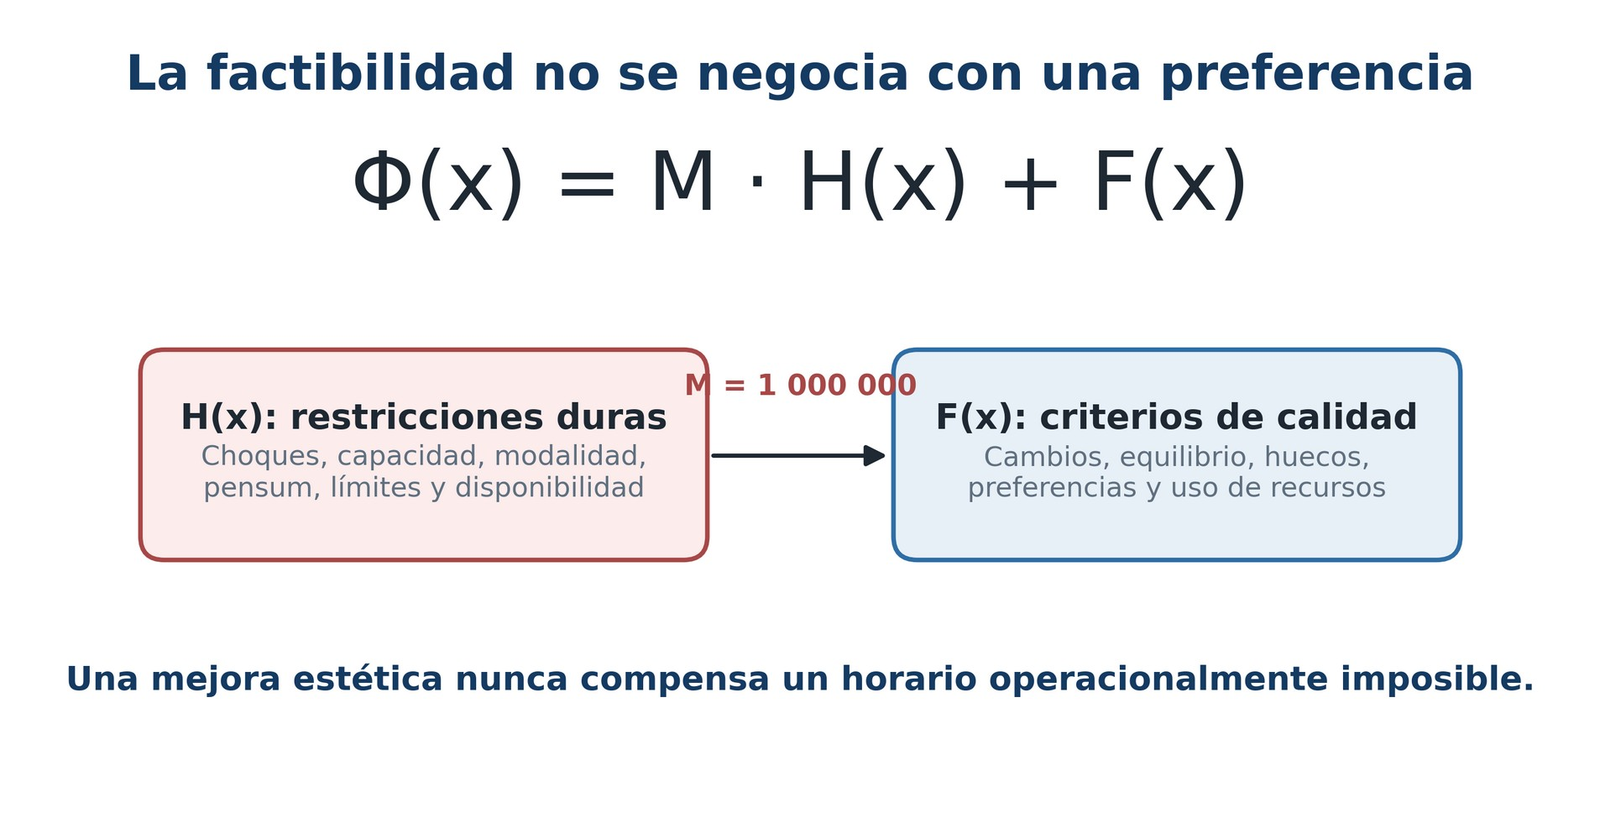
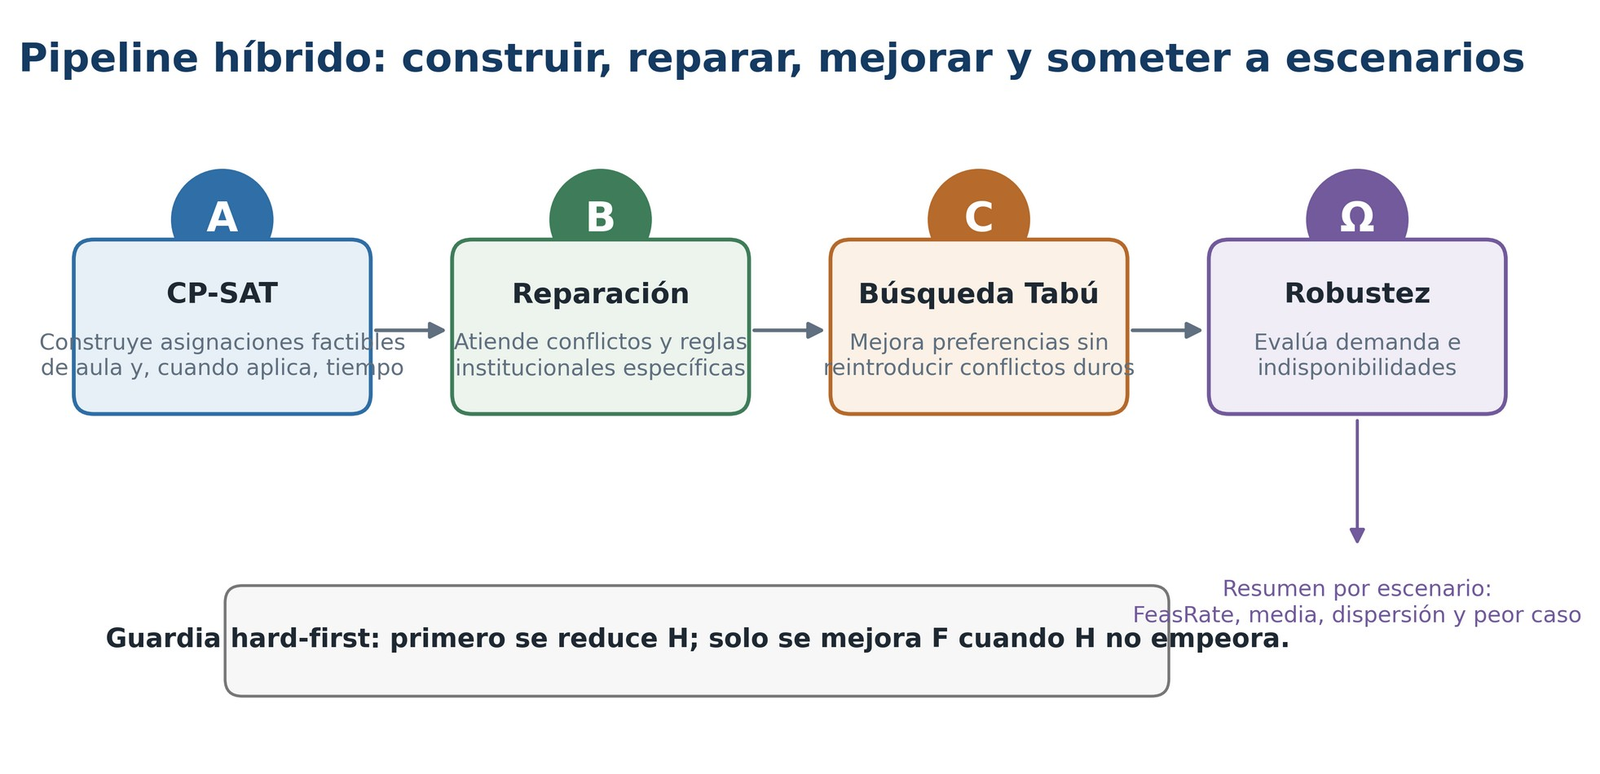
Después de la normalización, MOSAIC construye un baseline: una representación medible del horario recibido. Sobre ese estado calcula H, la suma de veinte restricciones duras, y F, la combinación ponderada de trece criterios blandos. La puntuación global se expresa como Φ(x) = M·H(x) + F(x), donde M vale 1 000 000. Esa constante establece una jerarquía operativa: una diferencia de factibilidad domina cualquier mejora razonable de calidad. El sistema no se limita a mostrar Φ; también presenta el desglose de H y F, porque dos valores globales similares pueden ocultar causas completamente distintas. Esta trazabilidad permite distinguir un choque de profesor de una capacidad insuficiente o de una regla de pensum. El baseline cumple una función metodológica y comunicativa. Permite responder qué problemas existían antes de intervenir y evita atribuir al algoritmo mejoras que ya estaban presentes en el archivo original. Cada fase se compara contra ese punto de partida mediante H, F y Φ, con desgloses por regla. Así, una reducción puede vincularse con choques, capacidad, modalidad o preferencias específicas.

La política hard-first protege el propósito institucional de la solución. Mientras existan violaciones duras, el proceso prioriza reducirlas. Una vez que H llega a cero, un movimiento que vuelva a crear un conflicto obligatorio se rechaza aunque disminuya F. Esta decisión evita que una preferencia, como reducir huecos o minimizar cambios de aula, compense una condición que haría inviable el horario. El principio se relaciona con la optimización lexicográfica utilizada en problemas de asignación, donde los objetivos se ordenan por niveles de prioridad [1], [17]. En términos prácticos, MOSAIC intenta primero producir una propuesta que pueda operar; solo entonces busca que esa propuesta sea más conveniente, equilibrada o estable. La constante M se configuró en 1,000,000 como separación de órdenes de magnitud, no como costo monetario. La consecuencia es equivalente a una prioridad lexicográfica: primero se comparan las violaciones obligatorias y solo cuando H es igual se utiliza F para ordenar la conveniencia. Esta decisión hace visible una política que, en procesos manuales, suele quedar implícita en la experiencia del planificador.

Esquema de la función objetivo Φ(x) = M·H(x) + F(x): restricciones duras H(x) ponderadas por M = 1 000 000 y criterios de calidad F(x)
Figura 4. Jerarquía hard-first de la función objetivo. Fuente: elaboración propia a partir de la formulación Φ(x) = M·H(x) + F(x).

La fase A utiliza CP-SAT para estructurar la asignación inicial. Para cada sesión presencial se construyen aulas cuya capacidad cubre la matrícula y candidatos temporales dentro del dominio institucional. Las variables binarias representan la asignación de una sesión a un aula y, cuando corresponde, a un candidato de tiempo. Las restricciones lineales impiden solapamientos de aula, profesor y sección. El solver opera con un límite temporal y reporta su estado, modelo utilizado y violaciones residuales. Para controlar el crecimiento, la reasignación temporal completa se aplica a instancias de hasta cuatrocientas sesiones presenciales; en archivos mayores se utiliza un modelo reducido centrado en aulas y mecanismos de respaldo. El modelo devuelve estados como OPTIMAL o FEASIBLE dentro de la formulación ejecutada y un límite temporal controla el costo. En instancias mayores, la reasignación temporal completa se reduce y puede utilizarse un constructor de respaldo antes de la reparación. Es importante subrayar que un estado del solver describe el modelo compacto, no certifica por sí solo toda la realidad institucional.

La fase B incorpora reparadores especializados. Algunos atienden inconsistencias básicas, como una sesión virtual con aula, una clase presencial sin espacio, una capacidad insuficiente o un choque de profesor. Otros utilizan configuraciones institucionales para revisar horas semanales, continuidad, máximo de sesiones por día, dominio de horarios, límites de carga docente, días lectivos, aulas obligatorias, franjas reservadas y coherencia con el pensum por ciclo. Un reparador no fuerza una corrección imposible. Si no existe un aula con capacidad suficiente o una franja permitida, la violación se conserva y se acompaña de contexto. Esa decisión es importante: modificar datos institucionales para fabricar factibilidad sería menos transparente que reportar un límite estructural. La reparación no fuerza resultados imposibles. Si ninguna aula disponible satisface la matrícula o si todas las franjas válidas están bloqueadas, el sistema preserva la violación y aporta contexto. Esta conducta protege la integridad del dato: es preferible presentar un conflicto residual explicado que modificar capacidades, disponibilidades o reglas sin autorización para producir una apariencia artificial de factibilidad.

La fase C ejecuta Búsqueda Tabú sobre la solución reparada. Los vecindarios se forman mediante cambios e intercambios de aula y tiempo; cada candidato se evalúa con Φ; la lista tabú evita ciclos inmediatos; y un criterio de aspiración permite aceptar un movimiento prohibido cuando produce una mejora global. Cada iteración registra fase, número, H, F, Φ y una nota, de modo que el usuario pueda observar cómo evolucionó la propuesta. En archivos muy grandes, el sistema reduce automáticamente iteraciones, tamaño de vecindario y estancamiento, porque cada vecino requiere copiar y evaluar una estructura tabular. La prioridad es conservar la estabilidad de la aplicación antes que simular una búsqueda profunda que agote memoria. Cada iteración registra la fase, H, su desglose, F, Φ y una nota del movimiento. El resultado incluye la razón de parada y la cantidad de iteraciones ejecutadas. En modo ligero, la plataforma declara que Tabú fue omitida, en vez de presentar la salida como si hubiese atravesado todas las fases. Esa transparencia impide confundir validación rápida con optimización completa.

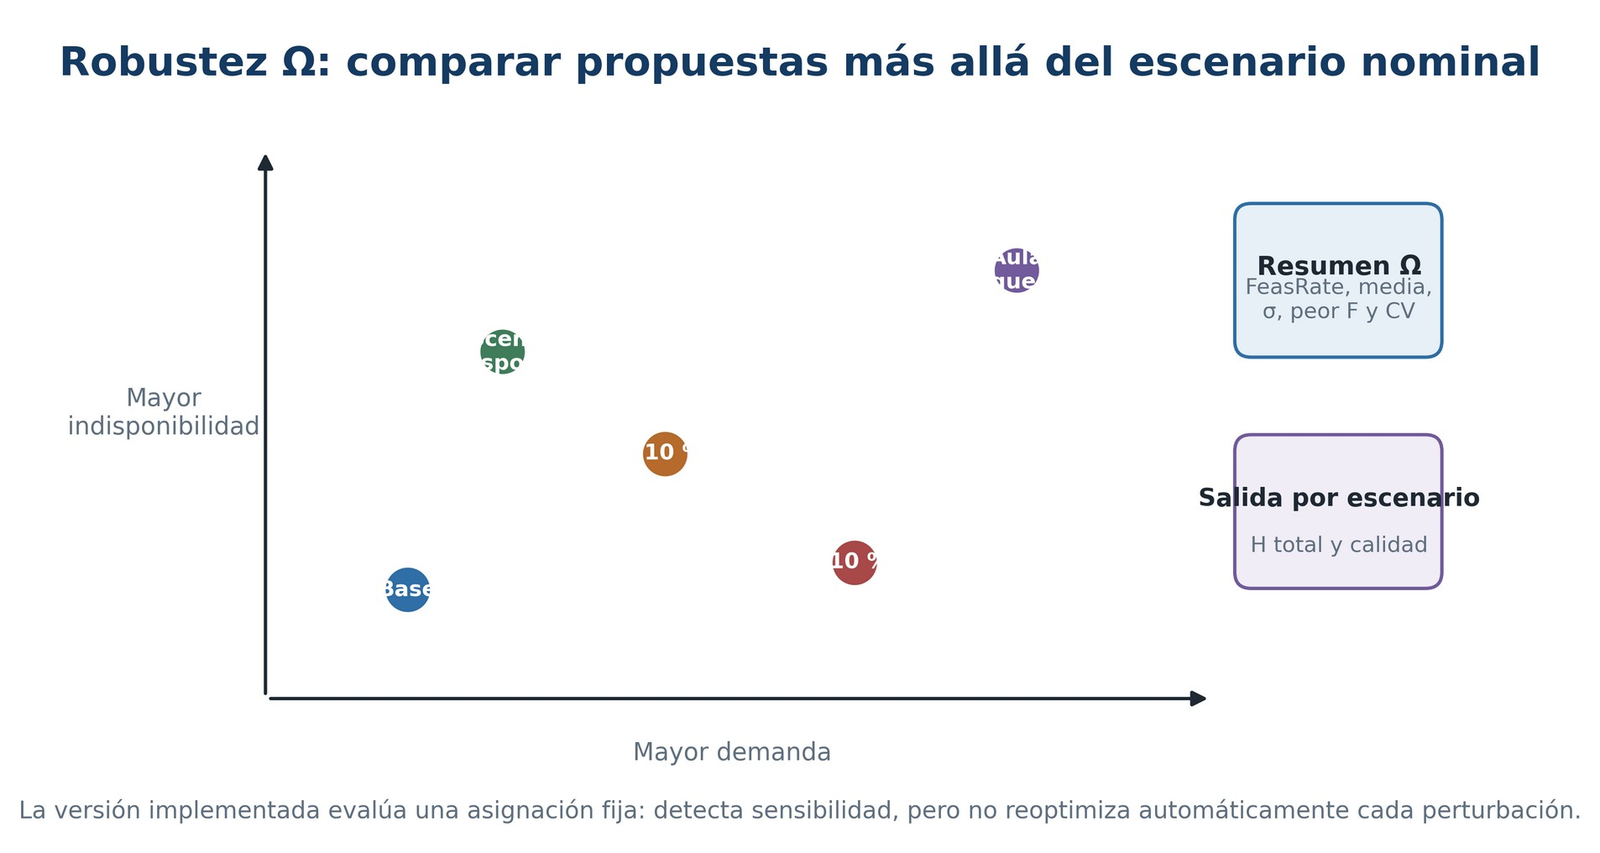
Después de la optimización, el componente Ω evalúa la propuesta bajo escenarios. La demanda puede aumentar o disminuir y determinados docentes o aulas pueden marcarse como no disponibles. MOSAIC no modifica el horario en esta etapa: vuelve a calcular H y F sobre la asignación fija y produce una tasa de factibilidad, media, desviación, varianza, mejor y peor valor de F y coeficiente de variación. Esta separación evita confundir robustez con reoptimización. Ω responde a una pregunta preventiva: si las condiciones cambian después de seleccionar una propuesta, ¿cuánto depende su factibilidad de recursos sin margen o de aulas cercanas a su capacidad? El resumen de Ω contempla tasa de factibilidad, media, desviación, varianza, mejor y peor F y coeficiente de variación. La asignación se mantiene fija para medir sensibilidad, por lo que el componente no debe describirse como una reoptimización automática. Su propósito es comparar margen operativo: revelar si una propuesta nominalmente válida depende de capacidades o disponibilidades con poca holgura.

Pipeline híbrido en cuatro fases: A CP-SAT, B reparación, C Búsqueda Tabú y Ω robustez
Figura 5. Fases del solver híbrido y evaluación de robustez. Fuente: elaboración propia a partir del orquestador final de MOSAIC.

La metodología se completa con persistencia y reproducibilidad. Cada corrida puede conservar un manifiesto, parámetros, resúmenes, desgloses, horario base, horario procesado y exportaciones. El índice SQLite permite reconstruir el historial después de reiniciar el backend, mientras Docker Compose coordina los servicios en un entorno reproducible. La semilla, la versión, el límite de tiempo y los parámetros de búsqueda forman parte de los metadatos. El repositorio incluye pruebas segmentadas para ingesta, API, pensum, restricciones, CP-SAT, reparación, CLI y construcción del frontend. No se reporta un porcentaje agregado de cobertura que no esté respaldado por un artefacto; la evidencia se expresa como flujos y subsistemas comprobados. La reproducibilidad requiere más que guardar el archivo final. Para repetir una corrida deben conservarse la entrada o su huella, las tablas auxiliares, la versión del sistema, la semilla y los parámetros de ejecución. MOSAIC estructura esa evidencia alrededor de cada identificador de corrida, lo que facilita auditoría, comparación y recuperación incluso después de reiniciar el servicio.

De prototipo exploratorio a plataforma trazable

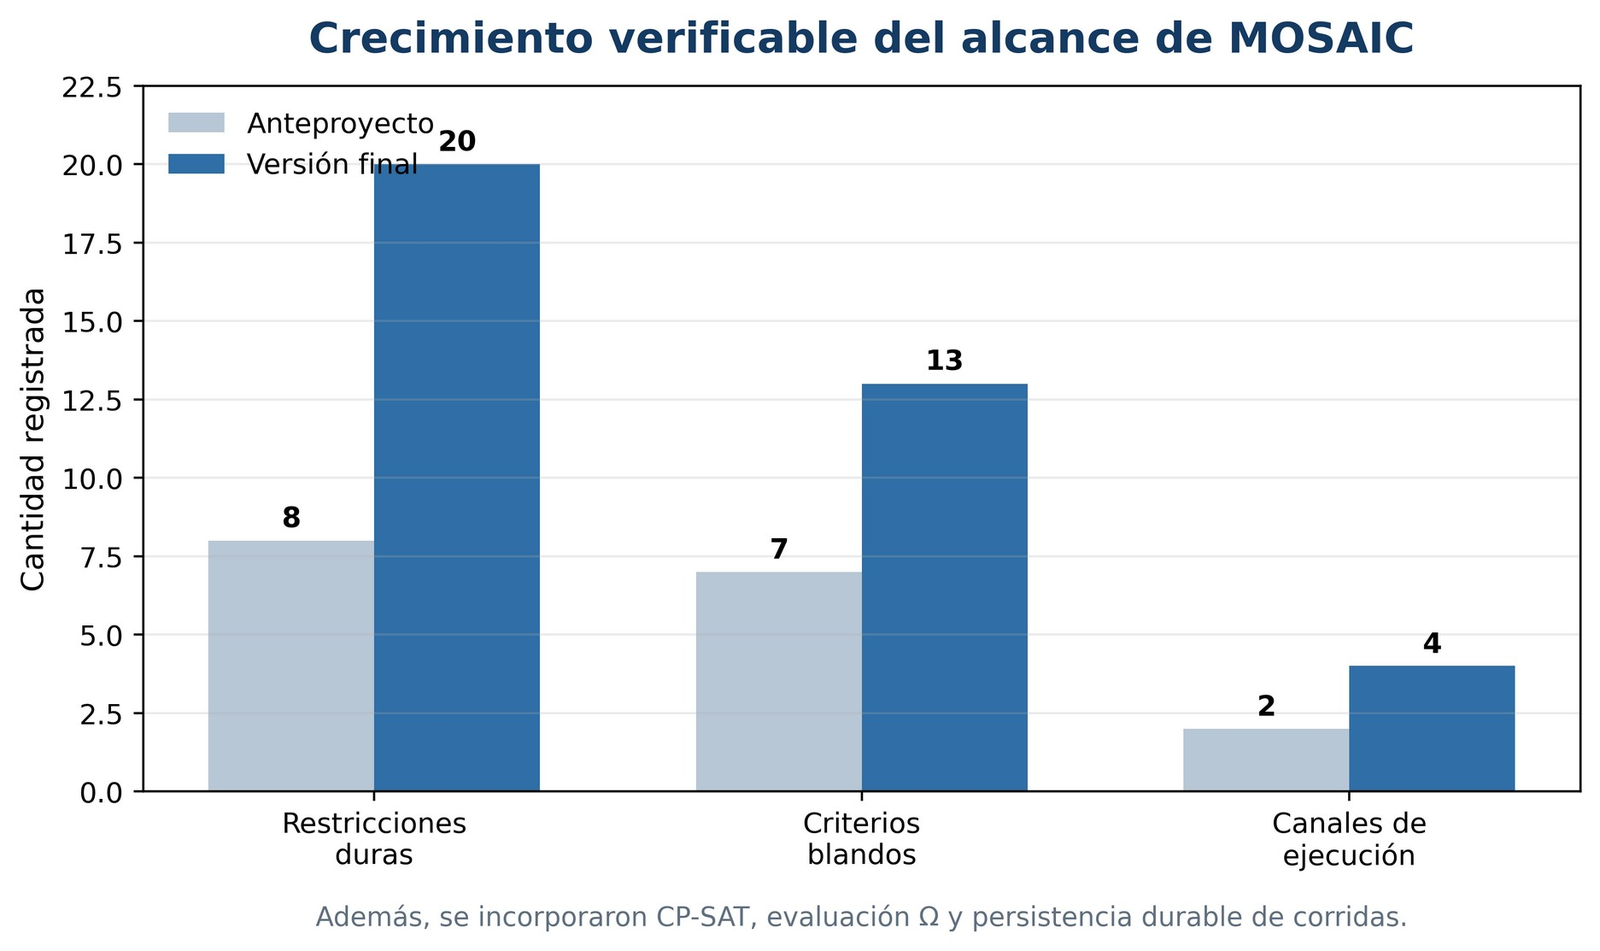
La evolución desde el anteproyecto fue cuantificable. El prototipo inicial registraba ocho restricciones duras y siete criterios blandos; la versión final incorporó veinte restricciones y trece criterios, equivalentes a incrementos de 150 % y aproximadamente 85.7 %, respectivamente. Los canales de ejecución pasaron de CLI y Streamlit a CLI, API, Next.js y Streamlit conservado como legado. También se incorporaron CP-SAT, la evaluación Ω y la persistencia durable de corridas. Estos cambios no fueron una ampliación decorativa: surgieron de problemas observados con archivos institucionales, navegación entre ejecuciones, historial, reglas académicas y necesidad de separar la robustez de la mejora del horario. El cambio cuantitativo se acompañó de una transformación arquitectónica. Streamlit fue útil para validar la idea, pero el historial y la navegación entre corridas justificaron una interfaz Next.js conectada a FastAPI. SQLite y los directorios de artefactos sustituyeron la dependencia de una sesión activa. El prototipo anterior se conservó como evidencia de evolución, no como interfaz oficial final.

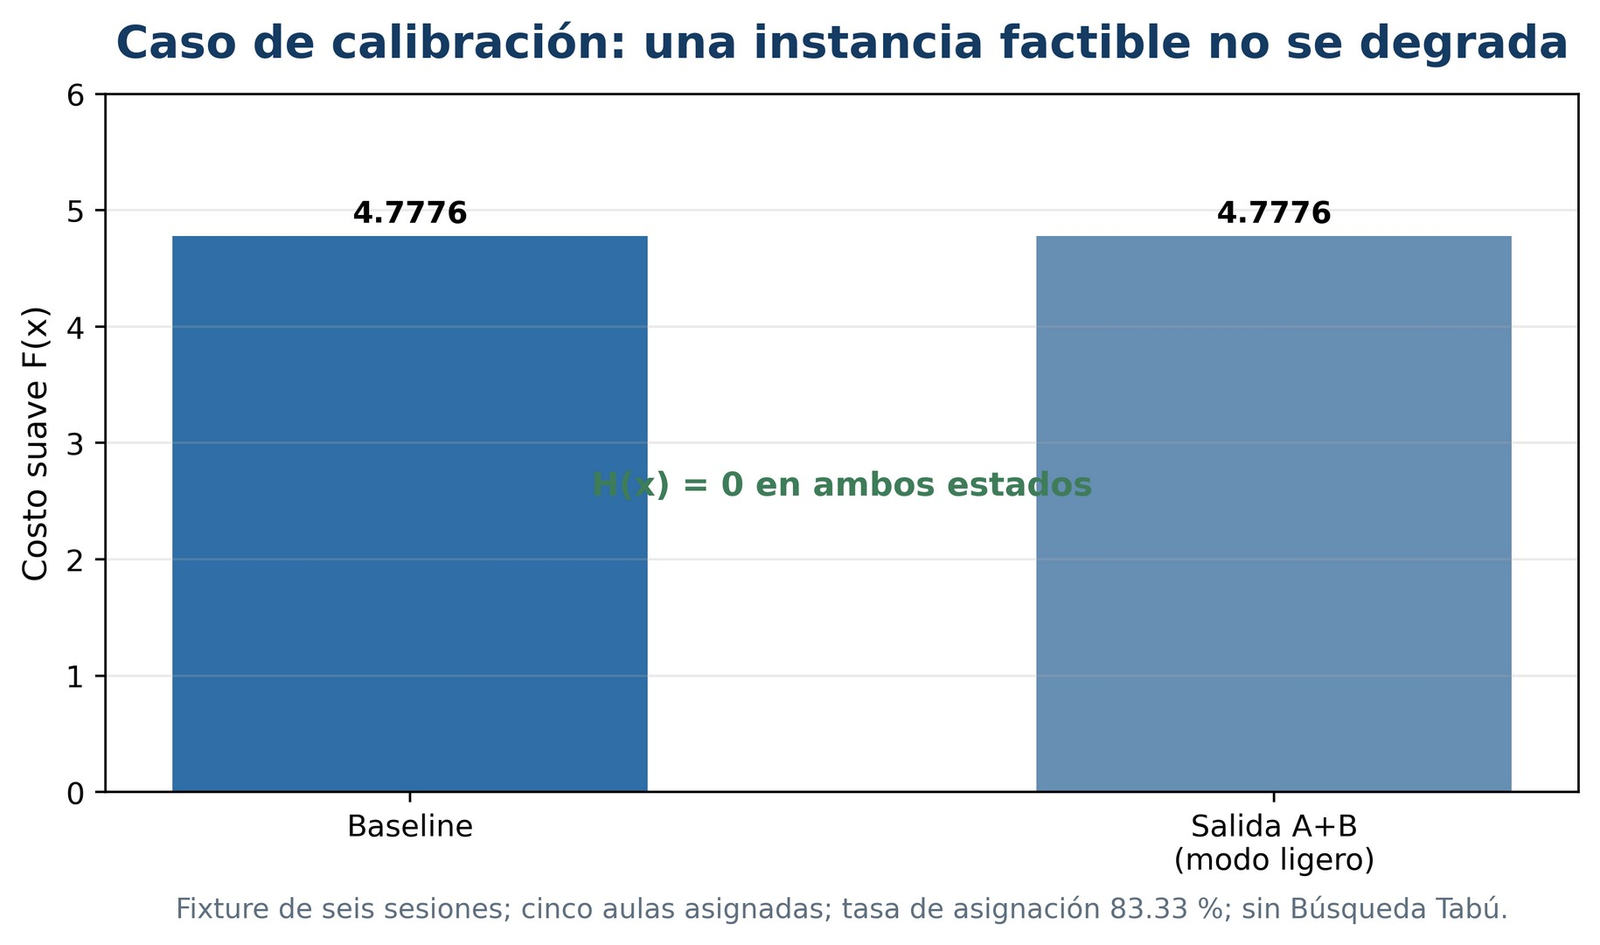
El caso de calibración final utiliza un fixture de seis sesiones y se ejecutó en modo ligero, sin Búsqueda Tabú, con semilla 42. El baseline y la salida A+B conservaron cinco aulas asignadas, una tasa de 83.33 %, cero conflictos de aula, profesor y sección, cero excesos de capacidad, H igual a cero, F igual a 4.7776 y Φ igual a 4.78. Este resultado no demuestra una mejora, porque la instancia ya era factible. Su valor es otro: confirma que las fases de construcción y reparación no degradaron una propuesta válida ni alteraron su costo suave. En ingeniería de optimización, preservar una solución correcta es tan importante como mejorar una defectuosa. La estabilidad es un resultado válido aunque no implique una reducción. En este caso, A+B recibió una instancia ya factible y mantuvo intactos sus indicadores, demostrando que el pipeline no introdujo conflictos al procesarla. La prueba también establece un límite interpretativo: al no ejecutarse Tabú y utilizar solo seis sesiones, no sirve para afirmar rendimiento, escalabilidad ni superioridad algorítmica.

Gráfico de barras: restricciones duras de 8 a 20, criterios blandos de 7 a 13 y canales de ejecución de 2 a 4 entre el anteproyecto y la versión final
Figura 6. Evolución cuantitativa del alcance implementado. Fuente: elaboración propia a partir del registro final del proyecto.

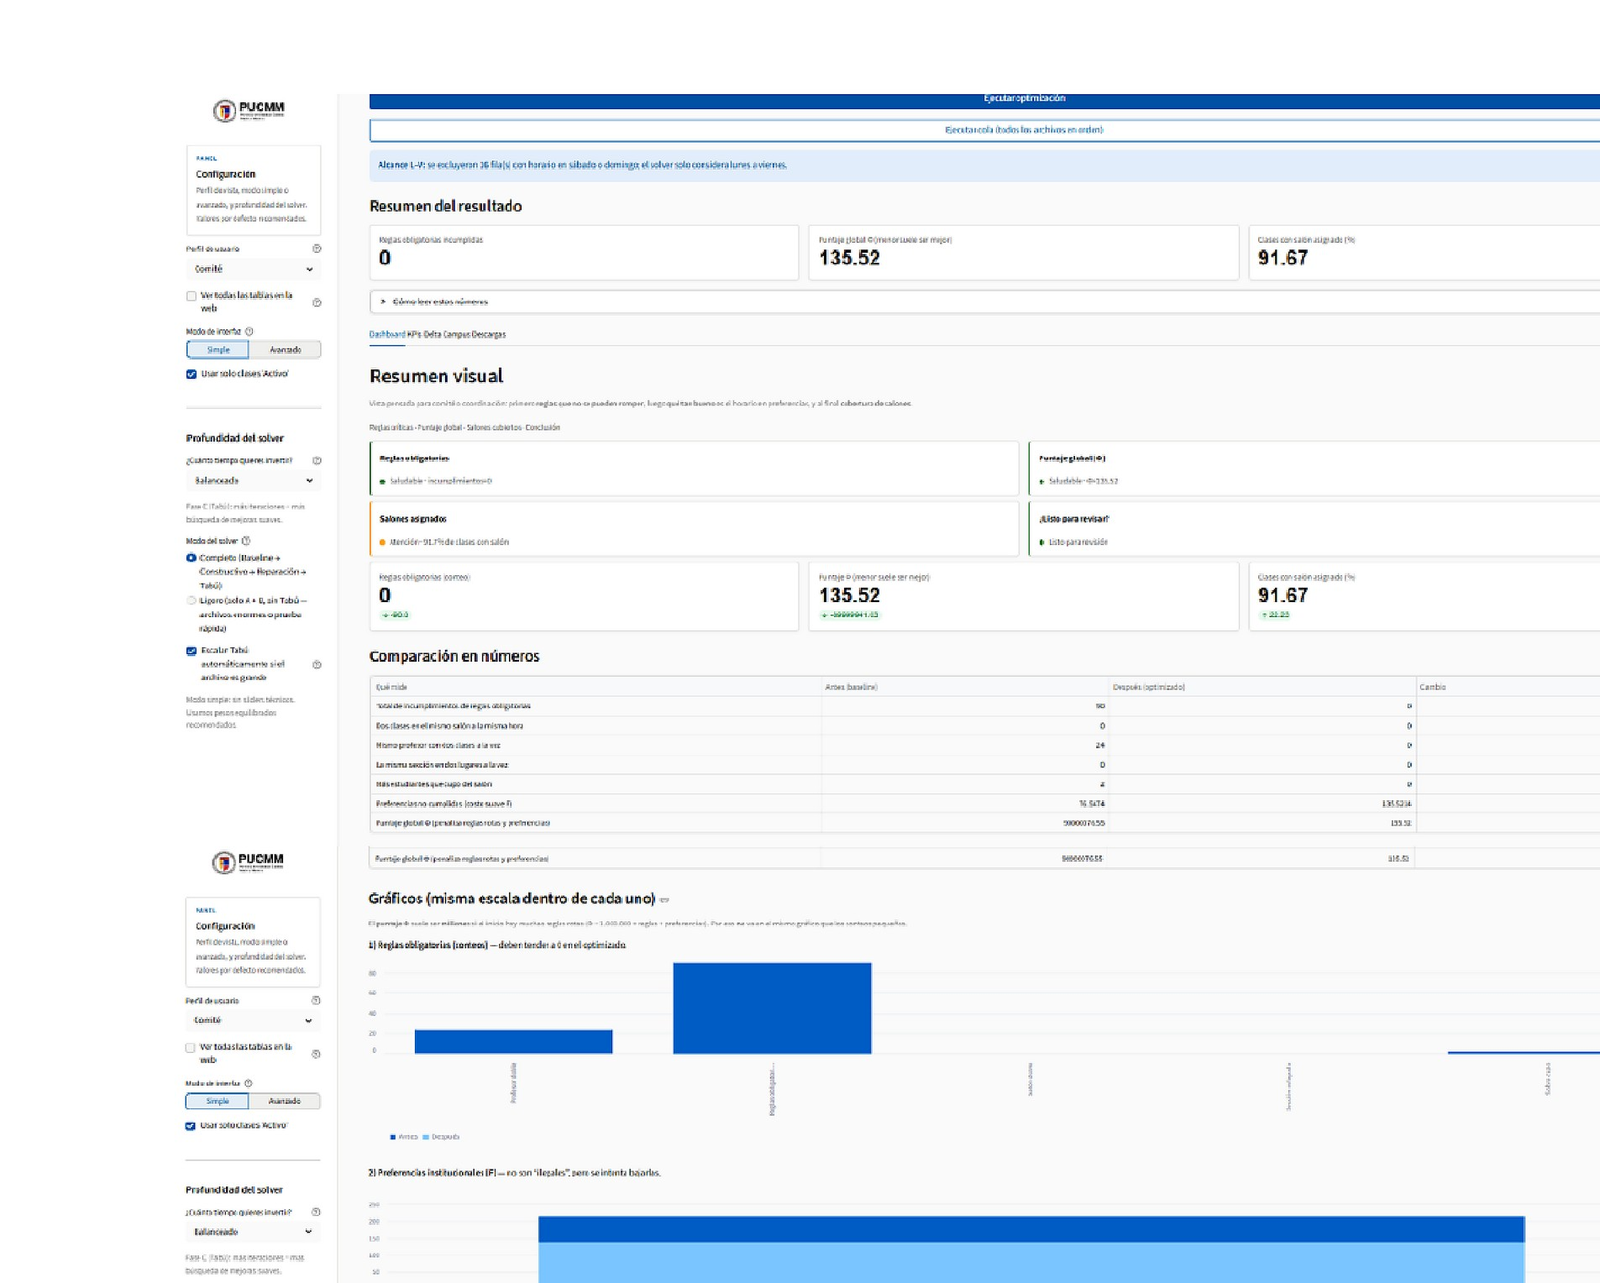
El proyecto también conserva evidencia histórica del prototipo Streamlit. En una corrida de una configuración anterior, la interfaz mostró una reducción de noventa violaciones duras a cero y de veinticuatro choques de profesor a cero, con una tasa final de aulas asignadas de 91.67 % y una puntuación global de 135.52. Estos números no se utilizan como benchmark del modelo final H1-H20 porque cambiaron las reglas, los pesos y la implementación. Mantener la captura, en lugar de mezclarla con la calibración actual, fortalece la honestidad experimental: permite observar la evolución del producto y, al mismo tiempo, evita presentar resultados incompatibles como si pertenecieran a una sola evaluación. La corrida histórica conserva valor como prueba de concepto porque evidencia que el flujo anterior podía eliminar conflictos concretos. Sin embargo, sus pesos, reglas y arquitectura eran distintos. Presentarla separadamente evita una comparación engañosa con el modelo final H1-H20. Esta distinción entre evidencia histórica y benchmark reproducible es necesaria para que el análisis no convierta resultados de etapas diferentes en una sola narrativa cuantitativa.

Gráfico de barras: costo suave F igual a 4.7776 en el baseline y en la salida A+B, con H igual a cero en ambos estados
Figura 7. Caso de calibración: estabilidad de una instancia factible. Fuente: elaboración propia a partir de calibration_baseline_kpis.json.

En la arquitectura final, una ejecución puede iniciarse, persistirse, consultarse y exportarse a través de capas separadas. La API dispone de rutas para validar archivos, crear corridas, consultar historial, recuperar el horario, revisar indicadores y generar exportaciones. Los artefactos por corrida incluyen manifest.json, parameters.json, summary.json, counts.json, baseline_schedule.csv, optimized_schedule.csv y, bajo demanda, un PDF institucional. La interfaz Next.js organiza el flujo alrededor de carga, ejecución, historial y detalle, con vistas de indicadores, comparación, evolución, horario y robustez. La evidencia técnica es cualitativamente amplia, aunque el proyecto reconoce que no se conservó un reporte agregado de cobertura asociado al corte final. La API organiza rutas para validar, crear corridas, listar historial, consultar detalle, paginar el horario, recuperar KPIs y exportar CSV, JSON o PDF. Docker Compose coordina frontend y backend en un entorno reproducible. Las pruebas verifican flujos de ingesta, modelo, optimización e interfaces, aunque el corte analizado no conserva un porcentaje agregado de cobertura que permita resumir toda la suite en una cifra.

Captura del dashboard Streamlit del prototipo con el resumen del resultado y la comparación antes y después de la optimización
Figura 8. Captura histórica del dashboard Streamlit conservada como evidencia del prototipo. Fuente: evidencia visual incluida en el informe final de MOSAIC; corresponde a una configuración legacy.

La robustez aporta una lectura que no aparece en una comparación nominal. H igual a cero es una condición necesaria, pero no suficiente para afirmar que una propuesta soportará cambios. Una tasa de factibilidad baja bajo escenarios indicaría que el horario depende de recursos sin alternativas; una dispersión alta de F revelaría sensibilidad de la calidad aunque no aparezcan nuevos conflictos. En el corte analizado, Ω está integrado y sus métricas están definidas, pero no existe un archivo institucional publicable con resultados finales de escenarios. Por eso, el artículo presenta esta capacidad como una función implementada y no como una mejora cuantitativa ya demostrada. La distinción protege la validez del proyecto y señala con claridad el experimento que falta. Esta lectura preventiva ayuda a elegir entre horarios aparentemente equivalentes. Una solución que utiliza aulas al límite o concentra sesiones en pocos recursos puede ser más frágil que otra con igual H y un margen mayor. El componente permite formular esa discusión con métricas, aunque todavía falta una corrida Ω sobre una instancia institucional publicable para demostrar una mejora cuantitativa en condiciones reales.

Los resultados deben leerse con límites explícitos. MOSAIC no certifica un óptimo global para todo un campus; la reasignación temporal CP-SAT se reduce en instancias grandes; los pesos de los trece criterios blandos necesitan calibración con responsables académicos; y las reglas H9-H20 dependen de tablas auxiliares completas y vigentes. Tampoco se realizó una prueba controlada con usuarios institucionales ni una integración con el sistema de gestión académica. En seguridad, el aislamiento local es adecuado para una tesis, pero una adopción real requiere autenticación, roles, auditoría, cifrado de respaldos, observabilidad y controles de descarga. Estas limitaciones no invalidan el trabajo; delimitan lo que puede afirmarse y orientan la siguiente etapa. Las limitaciones no invalidan el trabajo, sino que definen el significado de sus resultados. La evidencia es fuerte en trazabilidad, arquitectura y cobertura funcional; es más limitada en benchmarks de gran escala, validación con usuarios y seguridad productiva. Reconocer esa distribución impide extrapolar una prueba controlada a un campus completo y orienta de manera concreta las actividades de una siguiente fase.

Diagrama conceptual de escenarios de robustez Ω según la demanda y la indisponibilidad de recursos
Figura 9. Espacio conceptual de escenarios para la evaluación Ω. Fuente: elaboración propia a partir del componente de robustez de MOSAIC.
Lo que MOSAIC demuestra y lo que todavía debe demostrar

La principal contribución de MOSAIC no es prometer un horario perfecto, sino demostrar una forma más rigurosa de construir, medir y discutir propuestas. El proyecto integra datos imperfectos, reglas institucionales, optimización híbrida y una capa de producto capaz de conservar el historial. La estrategia hard-first resulta coherente con el dominio: primero se protege la operación académica y luego se mejoran preferencias. La trazabilidad entre modelo, código, pruebas y artefactos permite explicar qué ocurrió en cada fase y evita que la salida dependa de una sesión efímera o de una captura aislada. Esta combinación aproxima el trabajo a los sistemas de apoyo a decisiones descritos en la literatura, donde la utilidad depende tanto del cálculo como de la comprensión del resultado [2], [14]. Ese enfoque es relevante porque la programación académica contiene excepciones legítimas que no siempre deben automatizarse. La herramienta puede señalar el costo y la consecuencia de una decisión, pero la aprobación final permanece en el comité. La explicabilidad, entonces, no es un complemento visual: es el mecanismo que permite combinar capacidad computacional con responsabilidad institucional y documentar por qué se aceptó una alternativa.

El paso siguiente debe ser un piloto institucional paralelo al proceso actual. Antes de integrar registros de producción, conviene construir un benchmark anonimizado y versionado con tamaños crecientes, múltiples semillas y métricas H, F, Φ, tiempo y FeasRate. Los pesos deben calibrarse mediante sesiones con coordinación académica y un comité responsable de reglas. El piloto debería comparar la línea base con propuestas de MOSAIC, registrar excepciones y medir no solo la calidad del horario, sino el tiempo de revisión, la claridad de las explicaciones y la confianza de los usuarios. Solo después de validar datos, políticas y experiencia de uso sería razonable avanzar hacia una integración gradual con el sistema institucional. Un diseño de evaluación riguroso debería incluir casos nominales y perturbados, comparaciones por tamaño y sesiones de revisión con usuarios. También conviene registrar cuántas advertencias requieren intervención, qué reglas producen más conflictos y cuánto tiempo se reduce en la preparación y verificación. Estas medidas conectarían el rendimiento técnico con el impacto organizacional que justifica la adopción de la plataforma.

También será necesario fortalecer el gobierno tecnológico. Las configuraciones de pensum, límites docentes, franjas reservadas y aulas especializadas deben tener responsables, fechas de vigencia y procedimientos de actualización. Un solver puede ejecutar correctamente una regla obsoleta y producir un resultado difícil de detectar; por eso, la mantenibilidad no depende únicamente del código. En el plano técnico, lint y formato deben convertirse en controles bloqueantes de integración continua, las pruebas de rendimiento deben cubrir instancias mayores y Ω puede evolucionar desde la evaluación hacia mecanismos de recuperación o reoptimización. En el plano de seguridad, la autenticación institucional, la autorización por roles y la auditoría de exportaciones son condiciones previas para utilizar información real. La sostenibilidad exige además documentación que sobreviva al equipo desarrollador. Las reglas, contratos, endpoints y decisiones de arquitectura deben mantenerse alineados con el código y con el ciclo académico vigente. Un proceso de control de cambios permitiría saber quién modificó una política, desde cuándo aplica y qué corridas deben repetirse. Esa disciplina convierte la trazabilidad técnica en gobierno institucional.

El impacto potencial se extiende más allá de la construcción de un horario. Una planificación mejor documentada puede reducir correcciones tardías, facilitar la coordinación entre escuelas, hacer más transparente el uso de aulas y ofrecer evidencia para discutir inversiones en infraestructura. También puede convertir los conflictos recurrentes en conocimiento institucional: si determinadas franjas, capacidades o asignaturas concentran problemas en varios ciclos, la universidad puede actuar sobre la causa y no únicamente sobre cada incidencia. Este horizonte requiere colaboración entre ingeniería, registro, coordinaciones, docentes y autoridades. MOSAIC propone un lenguaje común basado en datos, restricciones y métricas, pero su evolución dependerá de que esas áreas validen las reglas y definan qué significa calidad en su contexto. El siguiente paso no es automatizarlo todo, sino abrir un piloto controlado donde el sistema pueda ser cuestionado, corregido y medido antes de asumir responsabilidades operativas mayores.

MOSAIC muestra cómo un proyecto final de grado puede conectar investigación operativa, ingeniería de software y necesidades concretas de la gestión universitaria. Su valor está en convertir un proceso frecuentemente manual en una secuencia observable: recibir, validar, medir, construir, reparar, mejorar, someter a escenarios y conservar evidencia. La plataforma todavía necesita validación externa y madurez productiva, pero deja una base clara para continuar investigando y colaborando con las áreas académicas. En lugar de presentar la automatización como sustituto del criterio humano, propone una relación más responsable: que los algoritmos reduzcan el trabajo repetitivo, expongan conflictos y permitan que las decisiones finales se tomen con información verificable, contexto institucional y capacidad de rendir cuentas. El proyecto aporta también una experiencia formativa: obligó a traducir políticas académicas a modelos comprobables, distinguir factibilidad de preferencia y comunicar incertidumbre sin ocultarla. En un contexto donde se promueven universidades inteligentes, este tipo de trabajo muestra que la innovación no consiste solo en agregar inteligencia artificial, sino en construir sistemas confiables, auditables y coherentes con las responsabilidades de sus usuarios.

Referencias

  1. S. Ceschia, L. Di Gaspero, and A. Schaerf, “Educational timetabling: Problems, benchmarks, and state-of-the-art results,” European Journal of Operational Research, vol. 308, no. 1, pp. 1-18, 2023, doi: 10.1016/j.ejor.2022.07.011.
  2. G. Xue, O. F. Offodile, R. Razavi, D.-H. Kwak, and J. Benitez, “Addressing staffing challenges through improved planning: Demand-driven course schedule planning and instructor assignment in higher education,” Decision Support Systems, vol. 187, Art. no. 114345, 2024.
  3. S. Abdipoor, R. Yaakob, S. L. Goh, and S. Abdullah, “Meta-heuristic approaches for the University Course Timetabling Problem,” Intelligent Systems with Applications, vol. 19, Art. no. 200253, 2023, doi: 10.1016/j.iswa.2023.200253.
  4. R. Esmaeilbeigi, V. Mak-Hau, J. Yearwood, and V. Nguyen, “The multiphase course timetabling problem,” European Journal of Operational Research, vol. 300, no. 3, pp. 1098-1119, 2022, doi: 10.1016/j.ejor.2021.10.014.
  5. F. Dunke and S. Nickel, “A matheuristic for customized multi-level multi-criteria university timetabling,” Annals of Operations Research, vol. 328, no. 2, pp. 1313-1348, 2023, doi: 10.1007/s10479-023-05325-2.
  6. A. Bashab et al., “Optimization Techniques in University Timetabling Problem: Constraints, Methodologies, Benchmarks, and Open Issues,” Computers, Materials & Continua, vol. 74, no. 3, pp. 6461-6484, 2023, doi: 10.32604/cmc.2023.034051.
  7. C. B. Mallari, J. L. San Juan, and R. Li, “The University Coursework Timetabling Problem: An Optimization Approach to Synchronizing Course Calendars,” Computers & Industrial Engineering, vol. 184, Art. no. 109561, 2023, doi: 10.1016/j.cie.2023.109561.
  8. T. Müller, H. Rudová, and Z. Müllerová, “Real-world university course timetabling at the International Timetabling Competition 2019,” Journal of Scheduling, vol. 28, pp. 247-267, 2025, doi: 10.1007/s10951-023-00801-w.
  9. E. Steiner, U. Pferschy, and A. Schaerf, “Curriculum-based university course timetabling considering individual course of studies,” Central European Journal of Operations Research, vol. 33, pp. 277-314, 2025, doi: 10.1007/s10100-024-00923-2.
  10. M. Davison, A. Kheiri, and K. G. Zografos, “Modelling and solving the university course timetabling problem with hybrid teaching considerations,” Journal of Scheduling, vol. 28, pp. 195-215, 2025, doi: 10.1007/s10951-024-00817-w.
  11. M. Chen et al., “A randomized tabu search for university course timetabling,” Computers & Operations Research, vol. 123, Art. no. 105007, 2020, doi: 10.1016/j.cor.2020.105007.
  12. M. Chiarandini, K. Socha, M. Birattari, and O. Rossi-Doria, “An effective hybrid algorithm for university course timetabling,” Journal of Scheduling, vol. 9, pp. 403-432, 2006, doi: 10.1007/s10951-006-8495-8.
  13. K. Okoye et al., “Impact of digital technologies upon teaching and learning in higher education in Latin America: An outlook on the reach, barriers, and bottlenecks,” Education and Information Technologies, vol. 28, no. 2, pp. 2291-2360, 2023, doi: 10.1007/s10639-022-11214-1.
  14. A. Stojanov and B. K. Daniel, “A decade of research into the application of big data and analytics in higher education: A systematic review of the literature,” Education and Information Technologies, vol. 29, no. 5, pp. 5807-5831, 2024, doi: 10.1007/s10639-023-12033-8.
  15. K. Polin, T. Yigitcanlar, M. Limb, and T. Washington, “The Making of Smart Campus: A Review and Conceptual Framework,” Buildings, vol. 13, no. 4, Art. no. 891, 2023, doi: 10.3390/buildings13040891.
  16. R. Sequeira, A. Reis, P. Alves, and F. Branco, “Roadmap for Implementing Business Intelligence Systems in Higher Education Institutions: Systematic Literature Review,” Information, vol. 15, no. 4, Art. no. 208, 2024, doi: 10.3390/info15040208.
  17. E. Rappos, E. Thiémard, S. Robert, and J.-F. Hêche, “A mixed-integer programming approach for solving university course timetabling problems,” Journal of Scheduling, vol. 25, no. 4, pp. 391-404, 2022.

Sistema Inteligente de Ecualización Acústica mediante Procesamiento Digital de Señales

Wilfrido Guillermo Perdomo Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El sonido en espacios cerrados raramente se conforma de manera uniforme. En espacios como auditorios, aulas universitarias y salas de conferencias, la distribución acústica puede ser afectada por múltiples factores como son: la arquitectura del espacio, como su geometría, los materiales utilizados en las superficies, el ruido en el ambiente generado por sistemas de ventilación y la ubicación de fuentes sonoras con respecto a los oyentes.

Este proyecto propone la creación de un sistema de ecualización acústica inteligente que opera de forma autónoma y en tiempo real capaz de ser ajustada al ambiente de uso. De esta forma creando un cambio de vista hacia la ecualización adaptiva, en donde los sensores monitorean el entorno constantemente y ajustan el audio de forma dinámica.

Problemática y estado del arte

En un espacio cerrado como salas de conferencias o aulas, al hacer uso de sistemas de climatización, se genera un ruido constante que mientras de vez en cuando no es detrimental a la experiencia auditiva, termina causando problemas al oyente ya que es un ruido constante que termina enmascarando otros sonidos en el mismo rango de frecuencias. También, al hacer uso de bocinas u otros sistemas reproductores, es posible que, en espacios alejados a la fuente, el sonido no se llegue a percibir correctamente debido a la cercanía o distancia del oyente a estas fuentes.

Es por esto que normalmente la solución a algunos de estos problemas es el aumento del volumen general del sistema de audio, lo que termina siendo contraproducente al generar mayor malestar físico y reverberación al oyente, no logrando así resolver el desbalance espectral que causa el ruido ambiental.

A través de las pruebas hechas a través del desarrollo se encontró que el ruido ambiental en ciertas aulas universitarias no es uniforme, sino que se concentra en la banda de frecuencias graves, con niveles que pueden alcanzar incluso a valores como 123 dB, donde si se sigue las soluciones tradicionales de simplemente subir el volumen, las frecuencias se saturan y no se resuelve el problema principal de la saturación de la banda de frecuencias grave, creando así una experiencia sonora físicamente molesta.

Aunque actualmente existan diversos métodos para mitigar los problemas acústicos que se generan ocasionalmente, la mayoría de estas soluciones se encuentran detrás de barreras como lo que es la accesibilidad, la necesidad de un experto en el tema, o el conocimiento previo de cómo funciona el audio en su totalidad.

Muchos acercamientos utilizan el procesamiento en la nube para el control de los sistemas, pero se enfrentan a los problemas como la latencia y la saturación de red, que son aspectos que no pueden ser ignorados por lo delicado que es la transmisión de audio, en donde incluso un detenimiento de un fragmento de segundo puede ser detectado y alertado por el oído humano.

Para la realización de un sistema que cumpla con todos los requerimientos que se tienen, es necesario usar la Transformada Rápida de Fourier (FFT) que permite la caracterización de señales acústicas en tiempo real utilizando la escala logarítmica. Reduciendo la complejidad computacional del análisis espectral y haciendo posible el procesamiento en tiempo real del sonido de un espacio.

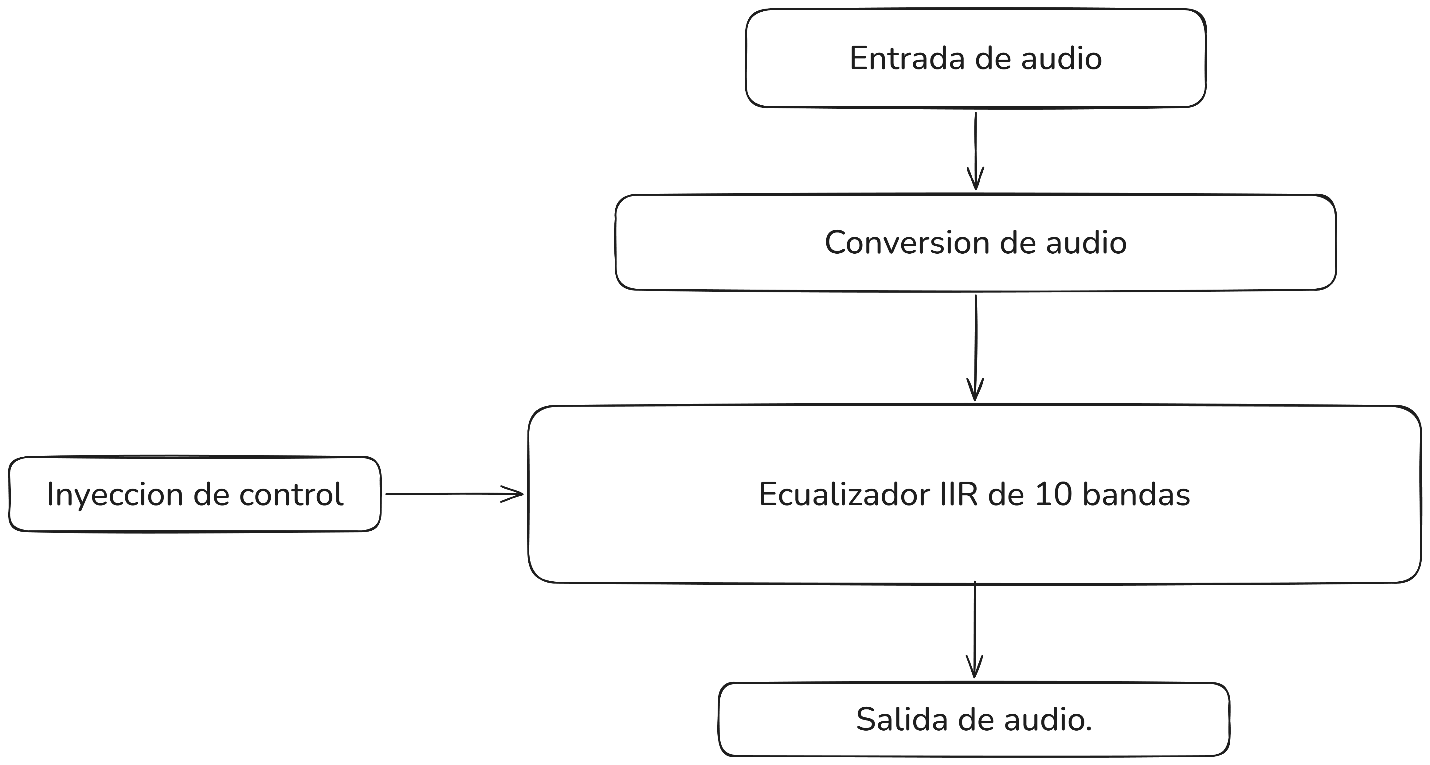
Además de esto, al hacer uso de la ecualización adaptiva podemos responder a cambios en el entorno acústico, haciendo cambios a los coeficientes de ecualización y eficientizando el uso de los recursos disponibles. Haciendo uso de filtros IIR se permite implementar ecualizadores paramétricos, dando la posibilidad de modificar los coeficientes de la banda de frecuencias mientras se ejecuta.

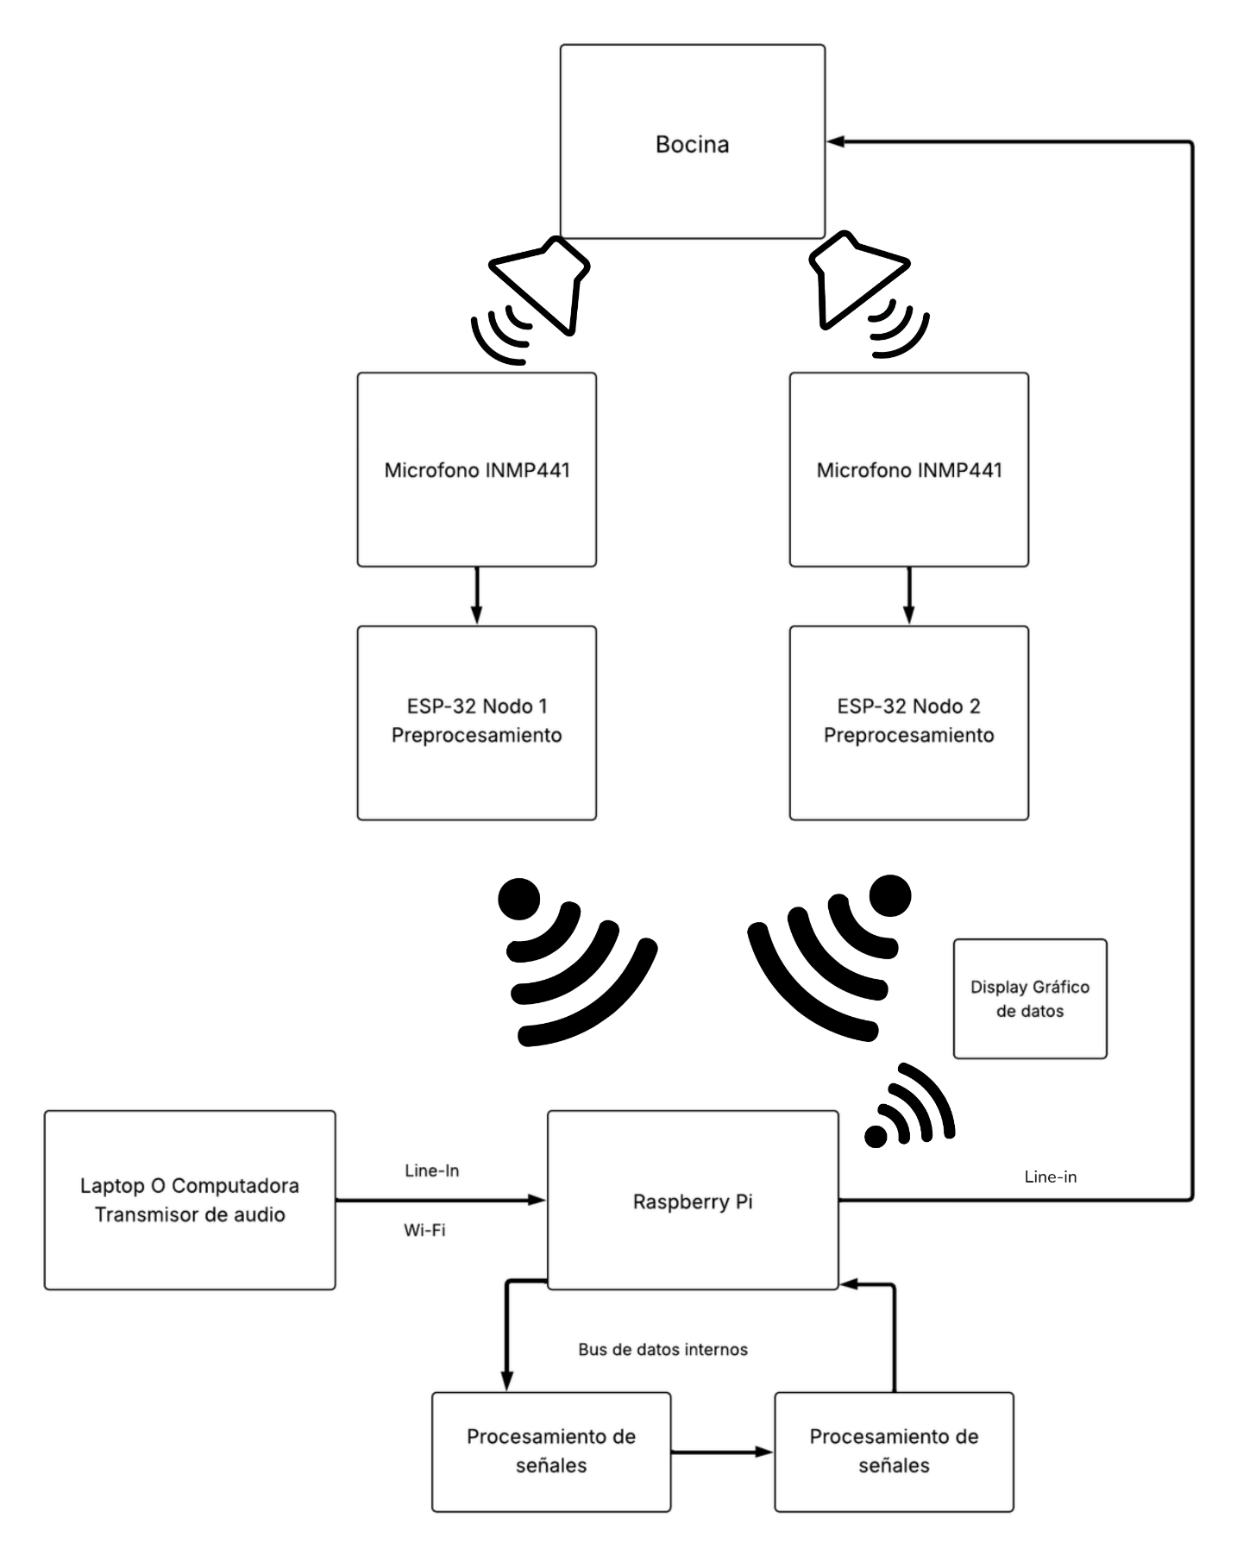
Para superar estas limitaciones de latencia y congestión de red, este proyecto adopta un enfoque en donde se ejecuta la Transformada Rápida de Fourier (FFT) de forma local en nodos sensores, evitando así que el sistema transmita flujos de audio pesados y, en su lugar, envía únicamente metadatos espectrales procesados a un servidor central. Esta arquitectura no solo garantiza la privacidad de los usuarios al no retransmitir audio crudo, sino que permite una capacidad de respuesta inmediata ante variaciones acústicas, logrando un sistema de ecualización verdaderamente adaptativo y eficiente en el uso de recursos de red.

Objetivos completados

El desarrollo de este proyecto ha logrado implementar un sistema de ecualización acústica inteligente mediante el uso de procesamiento digital de señales para resolver la degradación de la inteligibilidad en ambientes cerrados. El sistema integra nodos de captura basados en ESP32 que ejecutan localmente la Transformada Rápida de Fourier (FFT), permitiendo la extracción y envío de metadatos espectrales precisos hacia un servidor central de manera eficiente. Asimismo, se desarrolló e implementó un algoritmo de control proporcional capaz de ajustar hasta 10 bandas de frecuencia de forma independiente, garantizando una alta velocidad de estabilización acústica. Finalmente, mediante la integración de GStreamer, el sistema provee una salida de audio continua con 0 ms de interrupción durante los cambios dinámicos de coeficientes, asegurando una experiencia de uso fluida y profesional frente a condiciones de ruido ambiental variable.

Metodología

La metodología adoptada para este proyecto se fundamenta en un diseño de hardware y software distribuido, enfocado en la eficiencia de cómputo y la respuesta en tiempo real. A diferencia de los acercamientos tradicionales que requieren una conexión física compleja, esta solución propone un ecosistema inalámbrico modular capaz de adaptarse a diferentes geometrías arquitectónicas sin necesidad de reconfiguraciones profundas en el código base.

Arquitectura de adquisición y procesamiento de datos

El primer pilar de la solución es la red de nodos sensores de bajo costo. Cada nodo está integrado por un microcontrolador ESP32 y un micrófono digital INMP441 con interfaz I2S. La elección de una interfaz digital es crítica, ya que permite mantener la integridad de la señal acústica desde la captura, evitando las interferencias electromagnéticas comunes en las señales analógicas. Lo novedoso de esta etapa reside en que el ESP32 no actúa como un simple transmisor, este ejecuta localmente una Transformada Rápida de Fourier (FFT) para descomponer el sonido ambiente en sus componentes espectrales.

Diagrama de la arquitectura: bocina, dos micrófonos INMP441 con nodos ESP32, Raspberry Pi, computadora transmisora y display gráfico
Figura 1. Esquema general de la arquitectura distribuida del sistema.

Al procesar la FFT, el sistema solo transmite vectores de datos que representan la energía de las frecuencias detectadas. Este enfoque reduce drásticamente el uso del ancho de banda y mitiga los problemas de congestión de red mencionados anteriormente. Además, al no transmitir el audio crudo, se garantiza una capa de privacidad intrínseca, ya que el servidor central nunca recibe ni almacena grabaciones de voz, sino únicamente metadatos matemáticos de la acústica del salón.

Servidor central y gestión de audio con GStreamer

La unidad de procesamiento central, basada en una Raspberry Pi 4, actúa como el integrador de la inteligencia del sistema. Aquí se recibe la información espectral de todos los nodos de la red AudioNet y se gestiona el flujo de audio mediante la librería GStreamer. Esta herramienta permite la creación de pipelines de procesamiento multihilo, donde se insertan filtros de respuesta al impulso infinito (IIR) para cada una de las 10 bandas de frecuencia configuradas.

Diagrama del pipeline de audio: entrada, conversión, ecualizador IIR de 10 bandas con inyección de control y salida
Figura 2. Visualización del procesamiento dinámico de filtros sin interrupción de señal.

La ventaja de utilizar GStreamer frente a otras soluciones de software es su capacidad para manipular propiedades de los filtros mientras se reproduce audio. Mientras que otros sistemas presentan latencias audibles al actualizar el pipeline de uso, ya sea reiniciándolo al mismo tiempo, o creando otro sub-pipeline. El pipeline implementado permite modificar los coeficientes de ecualización de forma síncrona, logrando que el ajuste sea imperceptible para el oído humano, manteniendo una salida de audio constante y libre de artefactos sonoros.

Algoritmo de control y calibración dinámica

Para la toma de decisiones, se implementó un algoritmo de control proporcional que opera de manera cíclica. El proceso inicia con una fase de calibración dinámica donde el sistema mide el “piso de ruido” del ambiente durante 10 segundos. Una vez establecido este umbral, el algoritmo compara en tiempo real las variaciones energéticas reportadas por los nodos. Si se detecta un incremento sostenido en una banda específica, el sistema calcula automáticamente una ganancia negativa proporcional para compensar dicho ruido.

Diagrama de flujo del algoritmo de control: detección de feedback, cálculo del error por banda, ajuste proporcional y aplicación en GStreamer
Figura 3. Lógica de decisión para el ajuste automático de bandas de frecuencia.

Para garantizar la estabilidad del sistema, se incorporó una “zona muerta”. Permitiendo evitar que el sistema reaccione de forma errática ante ruidos transitorios o picos de señal insignificantes, asegurando que la ecualización solo cambie ante variaciones reales y persistentes de la acústica del entorno. Este enfoque preventivo garantiza que el audio se mantenga estable y confortable para el usuario final.

Interfaz visual y modos de operación

Finalmente, el sistema se complementa con una interfaz táctil basada en el ESP32-S3-Touch-LCD-7. Esta permite al usuario observar de manera gráfica y en tiempo real el comportamiento del espectro en las diferentes zonas del recinto. La metodología de diseño de la interfaz se centró en la usabilidad, ofreciendo al usuario la posibilidad de elegir entre una operación totalmente autónoma o una modalidad de recomendación manual, donde el operador toma las decisiones de cómo manipular el sistema.

Prototipo del sistema: pantalla táctil con la interfaz de la red de micrófonos, nodos sensores en carcasas impresas y bocina
Figura 4. Implementación final del centro de control táctil del sistema.

Resultados

Durante el desarrollo del proyecto, se ha podido observar el cumplimiento de ciertas facetas de los objetivos propuestos, validando así el funcionamiento del sistema, obteniendo resultados como los siguientes:

  • Precisión en la detección espectral. El sistema logró identificar con éxito los niveles críticos de ruido en espacios reales de la universidad, registrando hasta picos de 123.3 dB en salones universitarios frente a picos de 107 dB en entornos residenciales, permitiendo una compensación precisa al enmascaramiento sonoro.
  • Latencia de procesamiento. A través del proyecto se estaba haciendo uso de librerías específicas para la transmisión y el control del audio saliente, luego de una transición hacia GStreamer se ha logrado eliminar todos los cortes de audio existentes en el sistema, logrando así un procesamiento y cambio de bandas que se asemejan a sistemas profesionales.
  • El algoritmo ha demostrado ser capaz de adaptarse rápidamente a las variaciones del ruido en el ambiente, consiguiendo alcanzar la convergencia y estabilidad en un promedio de 16 segundos.

Conclusiones

El desarrollo del proyecto confirma que la integración de hardware utilizando nodos de procesamiento y algoritmos de control proporcional eficaces permiten resolver problemas acústicos con una eficiencia comparable a sistemas profesionales. La investigación y las pruebas realizadas permiten extraer las siguientes conclusiones:

Continuidad y calidad de uso: la transición técnica a mejores tecnologías fue un aspecto clave para el éxito de todo el sistema, reduciendo la latencia de la conmutación de filtros y validando la posibilidad de realizar ajustes dinámicos de ecualización de forma no audible al oído humano.

Innovación en el procesamiento: la capacidad de ejecutar procesos complicados como lo es la Transformada Rápida de Fourier (FFT) en los nodos sensores de audio representa un avance para el procesamiento eficaz de datos en comparación de sistemas centralizados convencionales.

Visualización y control táctil: la interfaz desarrollada utilizando una pantalla touch con un ESP32 integrado permite que el usuario tenga acceso a diferentes opciones, no técnicas y técnicas. Como es la visualización del comportamiento espectral y poder elegir entre dos modos de ecualización, autónomo o asistido, permitiendo que el usuario pueda tomar decisiones operativas según su parecer.

Referencias

  1. Widrow, B., Glover, J. R., McCool, J. M., Kaunitz, J., Williams, C. S., Hearn, R. H., … & Goodlin, R. C. (1975). Adaptive noise cancelling: Principles and applications. Proceedings of the IEEE, 63(12), 1692-1716. https://ieeexplore.ieee.org/document/1451965
  2. Cecchi, S., Bruschi, V., Peretti, P., & Bettarelli, F. (2024). Real Time System for Sound Enhancement in Noisy Environment. 27th International Conference on Digital Audio Effects (DAFx24), Guildford, UK, pp. 381–387. https://www.dafx.de/paper-archive/2024/papers/DAFx24_paper_70.pdf
  3. Avargel, Y., & Cohen, I. (2007). On multiplicative transfer function approximation in the short-time Fourier transform domain. IEEE Signal Processing Letters, 14(5), 337-340. https://ieeexplore.ieee.org/document/4154719
  4. Abhayapala, T. D., & Ward, D. B. (2002). Theory and design of high order sound field microphones using spherical microphone array. IEEE International Conference on Acoustics, Speech, and Signal Processing, 2, 1949–1952. https://researchportalplus.anu.edu.au/en/publications/theory-and-design-of-high-order-sound-field-microphones-using-sph-2
  5. Espressif Systems. (2023). ESP32 Technical Reference Manual. https://www.espressif.com/sites/default/files/documentation/esp32_technical_reference_manual_en.pdf
  6. Sebastià V., & Malte Kob. (2016). Real-time auralization of room acoustics for the study of live music performance. https://www.researchgate.net/publication/299560219_Real-time_auralization_of_room_acoustics_for_the_study_of_live_music_performance
  7. Mignot et al. (2023). “Reconstruction of transient acoustic field using sparse real-time near-field acoustic holography.” Journal of the Acoustical Society of America, 154(4), 2023. https://www.sciencedirect.com/science/article/abs/pii/S0022460X23004224
  8. Corey, R. M., Skarha, M. D., & Singer, A. C. (2019). Cooperative Audio Source Separation and Enhancement Using Distributed Microphone Arrays and Wearable Devices. arXiv preprint arXiv:1912.05038. https://arxiv.org/abs/1912.05038

Sistema de monitoreo de trampas para insectos

Jordy Johan Camacho Taveras y Emil Arias – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la automatización y el análisis de datos comienzan a revolucionar el sector agroindustrial, el presente proyecto nace como una solución práctica, innovadora y replicable para el control de plagas en ambientes de almacenamiento, específicamente en almacenes de tabaco. Esta iniciativa fue desarrollada por los estudiantes Emil Arias y Jordy Johan Camacho como parte de su Proyecto Final de Grado para optar por el título de Ingeniero en Telemática en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Bajo la guía académica de la Escuela de Computación y Telecomunicaciones (EICT), el proyecto se enfocó en transformar un proceso manual e ineficiente —la inspección visual de trampas adhesivas para insectos— en una plataforma inteligente, autónoma y accesible.

La motivación surgió de una problemática real: almacenes agrícolas en República Dominicana dependen de la revisión humana para detectar plagas en trampas físicas, lo que implica tiempo, errores humanos y decisiones poco fundamentadas. La falta de registros históricos, la ausencia de análisis en tiempo real y el uso excesivo de pesticidas sin validación técnica son consecuencias directas de esta carencia de tecnología. Frente a ello, se propuso un sistema integral que incorpora elementos de visión por computadora, aprendizaje automático y arquitectura IoT con dispositivos de bajo costo, logrando así una alternativa accesible para pequeños y medianos productores.

El proyecto integra un nodo inteligente de captura y análisis local basado en Raspberry Pi 5, equipado con una cámara IMX577 de alta resolución y un aro LED WS2812, el cual permite generar condiciones de iluminación constante para mejorar la calidad de las capturas. Sobre estas imágenes se ejecuta un modelo de detección de objetos optimizado con YOLO + NCNN, el cual identifica y clasifica insectos detectados sobre las trampas. Los resultados, junto con las imágenes anotadas, se envían mediante el protocolo MQTT a un servidor Raspberry Pi secundario que actúa como plataforma de recepción, almacenamiento en base de datos y presentación a través de una interfaz web sencilla y funcional. Esta arquitectura no solo permite monitoreo remoto, sino también almacenamiento local en caso de desconexión, garantizando resiliencia ante fallos.

Prototipo: interior de la caja con dos trampas adhesivas bajo la cámara y vista exterior del dispositivo
Figura 1. Vista de prototipo.

Este tipo de tecnología ya ha sido explorado en países desarrollados mediante soluciones como Trapview y PestNet, que utilizan cámaras y procesamiento en la nube para visualizar trampas electrónicas. Sin embargo, muchas de estas plataformas exigen altos costos de adquisición o suscripción, y requieren conectividad constante a internet, lo cual no es viable en muchas zonas rurales del país [1][2]. En contraposición, este sistema fue diseñado para operar de manera autónoma, sin depender de servicios externos, lo que lo convierte en una opción viable para entornos donde los recursos son limitados.

El uso de modelos como YOLO en la agricultura de precisión ha sido validado por estudios recientes. Por ejemplo, el trabajo de Sun et al. [3] demostró la efectividad del modelo YOLOv8 para detectar plagas del tabaco en condiciones complejas de luz y fondo. Asimismo, investigaciones como las de Ramalingam et al. [4] destacan cómo la visión artificial puede reducir significativamente la intervención humana en tareas de monitoreo. Estos antecedentes avalan el enfoque técnico del presente proyecto, que no solo replica, sino que adapta estas metodologías a una realidad local dominicana.

El desarrollo de este proyecto ha implementado un sistema de monitoreo de trampas adhesivas basado en visión por computadora y dispositivos IoT, orientado a reducir los errores humanos, mejorar la trazabilidad, y permitir una respuesta ágil ante infestaciones en almacenes de tabaco. Se logró crear una solución funcional capaz de detectar insectos automáticamente, registrar los datos con imágenes auditables, transmitir los resultados mediante MQTT, almacenarlos en una base de datos MySQL, y presentarlos de forma clara en una interfaz web, cumpliendo todos los objetivos específicos planteados.

Para alcanzar estos resultados, se diseñaron dos módulos: el primero, un nodo de detección autónomo con la capacidad de capturar imágenes cada dos minutos, analizarlas mediante el modelo entrenado y generar imágenes anotadas con bounding boxes de distintos colores según la clase detectada. El segundo módulo funciona como servidor web y base de datos, permitiendo centralizar y consultar los resultados desde una interfaz organizada. A nivel técnico, se integró una lógica de tolerancia a fallos: cuando no se detecta conexión con el broker MQTT, los resultados se almacenan localmente y se reenvían una vez restablecida la conexión.

Diagrama de bloques: cámara USB y aro LED, Raspberry Pi de detección, modelo, MQTT, Raspberry Pi servidor web, MySQL y página web
Figura 2. Diagrama de bloques del sistema.
Pantalla de inicio de sesión y panel principal de la interfaz SmartTrap
Figura 3. Interfaz visual.

Una de las características más relevantes del sistema es su capacidad de alertar automáticamente sobre situaciones críticas. Se desarrolló una lógica que permite generar alertas en tres escenarios: detección crítica (por cantidad alta de insectos), aumento sostenido (presencia progresiva día tras día), y presencia persistente (cuando un mismo tipo de insecto aparece durante varios días consecutivos). Estas alertas se visualizan en el dashboard, permitiendo al personal técnico actuar a tiempo y aplicar pesticidas de forma más responsable.

En cuanto a la validación, se llevaron a cabo dos fases. En la primera, se colocaron insectos reales (muertos) sobre trampas adhesivas en un entorno de laboratorio para simular escenarios de infestación. El sistema logró detectar correctamente múltiples especies, alcanzando un mean Average Precision (mAP) superior al 90%, lo que evidenció la precisión del modelo YOLO optimizado bajo condiciones controladas.

Para la segunda fase, aunque se planificó una prueba extendida en un almacén real de tabaco, no se obtuvieron los permisos necesarios para realizar la validación completa en ese entorno. Sin embargo, se simuló el comportamiento del sistema en condiciones similares, procesando más de 1000 capturas obtenidas a partir de datos de pruebas internas y casos registrados previamente. Las pruebas demostraron que el sistema mantenía un desempeño estable ante variaciones de iluminación y presencia de interferencias visuales como polvo o residuos, confirmando su capacidad de operar en condiciones reales.

Panel con gráficas de detecciones por tipo de insecto y alertas por severidad
Figura 4. Gráfica de detecciones por tipo de insecto.
Pantalla de gestión de alertas de SmartTrap
Figura 5. Tabla de alertas.

Entre los beneficios más destacados está la reducción estimada del uso innecesario de pesticidas en un 30%, la disminución de horas de inspección manual, y la trazabilidad digital que permite revisar históricamente el comportamiento de las plagas por trampa, tipo y fecha. Además, la arquitectura utilizada es completamente replicable: con una sola Raspberry Pi por trampa y otra como servidor central, el sistema puede escalar fácilmente a más ubicaciones sin necesidad de conexión a internet externa, ya que puede operar de forma autónoma dentro de una red local.

A pesar de los logros obtenidos, se identificaron algunas limitaciones que serán abordadas en futuras versiones. Por ejemplo, aunque el sistema no requiere conexión a internet, sí necesita una red Wi-Fi local para la transmisión de datos entre las trampas y el servidor. En zonas rurales sin infraestructura de red, será necesario incorporar módulos de comunicación celular. También se identificó que la detección puede verse afectada si la trampa está mal posicionada o sucia, y que actualmente solo se detectan especies entrenadas previamente, por lo que se planea ampliar la base de datos con más clases.

El impacto de este proyecto no se limita al almacén de tabaco donde se probó. Su arquitectura modular, bajo costo y facilidad de uso lo convierten en una herramienta adaptable a otros sectores agrícolas y productivos. Su diseño responde directamente a las necesidades del contexto local, permitiendo un avance en la transformación digital del agro dominicano. Asimismo, fomenta una cultura de control basado en datos y evidencia, necesaria para optimizar recursos, cumplir regulaciones sanitarias y proteger el medio ambiente.

Tabla de lecturas por captura con filtros en la interfaz web
Figura 6. Interfaz web, mostrando historial por trampas y filtros por fecha/tipo de insecto.

Resultados

La validación del sistema de monitoreo inteligente para trampas adhesivas fue una etapa crucial para demostrar su efectividad técnica y su aplicabilidad práctica. Para ello, se diseñó una estrategia de pruebas dividida en dos fases complementarias: una fase experimental bajo condiciones controladas en laboratorio y una fase aplicada en campo simulado, debido a limitaciones de acceso a almacenes reales.

Fase 1: Validación en laboratorio

Durante esta fase se buscó verificar la precisión del modelo en un entorno ideal. Se utilizaron trampas adhesivas sobre las cuales se colocaron manualmente insectos reales (muertos) pertenecientes a diferentes especies objetivo, como hormigas, cucarachas, polillas, moscas y lasioderma. Estas trampas fueron iluminadas con el aro LED Neopixel incluido en el sistema, y las imágenes fueron capturadas por la cámara de alta resolución conectada a la Raspberry Pi.

Posteriormente, cada imagen fue procesada por el modelo entrenado YOLOv8 adaptado a NCNN, con el objetivo de identificar correctamente cada clase de insecto. Los resultados obtenidos fueron altamente satisfactorios. Se alcanzó un mAP superior al 90%, lo cual indica una precisión promedio muy alta en la detección de las distintas clases.

En la Figura 7 se presenta la curva de precisión frente a confianza para cada clase, incluyendo un resumen de desempeño general. Se observa que todas las clases muestran altos niveles de precisión incluso en niveles de confianza elevados, lo que evidencia una baja tasa de falsos positivos.

Curva de precisión frente a confianza por clase de insecto
Figura 7. Curva Precisión–Confianza por clase, incluyendo promedio general del modelo.

Adicionalmente, se evaluó el comportamiento del modelo durante su proceso de entrenamiento. En la Figura 8 se muestran las gráficas de pérdidas (box, clasificación y distribución focal) tanto en entrenamiento como en validación, así como la evolución de métricas clave como precisión, recall y mAP en distintas variantes. Estas gráficas evidencian una convergencia estable y efectiva del modelo, sin señales de sobreajuste.

Gráficas de pérdidas, precisión, recall y mAP durante el entrenamiento
Figura 8. Gráficas de pérdida, precisión y mAP durante el entrenamiento y validación del modelo.

Por último, se realizó una evaluación cualitativa de los resultados mediante la revisión visual de las imágenes etiquetadas automáticamente por el sistema. En la Figura 9, se muestra un conjunto representativo de estas detecciones, donde puede observarse claramente cómo el sistema reconoce múltiples insectos de diferentes clases en una misma trampa, asignando bounding boxes con etiquetas precisas y colores distintos por clase, incluso bajo iluminación variable.

Mosaico de capturas de trampas con insectos detectados y etiquetados
Figura 9. Detecciones de insectos en trampas adhesivas utilizando el modelo entrenado.

Fase 2: Validación en entorno real simulado

Aunque inicialmente se había planificado implementar el sistema dentro de un almacén real de tabaco para evaluar su funcionamiento en condiciones operativas reales, no se obtuvieron los permisos necesarios para realizar dicha instalación. No obstante, se optó por una validación alternativa simulando condiciones reales: el sistema operó durante una semana consecutiva, en un entorno preparado que replicaba iluminación ambiental tenue, interferencias como polvo, y rotación de trampas con capturas reales.

Durante esta etapa, el sistema generó más de 1000 capturas, las cuales fueron procesadas y analizadas de manera autónoma por la Raspberry Pi. El sistema detectó exitosamente la presencia de insectos en trampas, enviando los resultados al servidor mediante MQTT, o almacenándolos temporalmente en memoria local si había problemas de conectividad.

La tasa de detección se mantuvo alta incluso ante interferencias visuales, y el sistema demostró un desempeño robusto en condiciones menos controladas. Esta validación fue clave para comprobar que el modelo no solo funciona en condiciones ideales, sino también en escenarios más complejos y con ruido visual, como los que se encuentran en almacenes de productos agrícolas.

Impacto operativo y funcional

Más allá del rendimiento técnico del modelo, el sistema demostró tener un impacto positivo a nivel operativo y práctico. Entre los beneficios observados destacan:

  • Reducción del uso innecesario de pesticidas: Se estima una disminución del 30% en aplicaciones químicas innecesarias, ya que ahora las acciones se toman con base en datos y alertas reales.
  • Ahorro de tiempo en inspecciones manuales: Las inspecciones, que antes podían tardar horas en recorridos físicos por cada trampa, se redujeron a minutos gracias al monitoreo remoto desde la plataforma web.
  • Generación de alertas inteligentes: El sistema fue capaz de emitir alertas automáticas en base a distintos patrones de riesgo definidos (detección crítica, aumento sostenido y presencia persistente). Estas alertas permitieron al personal técnico reaccionar de manera proactiva, evitando la propagación de infestaciones.
  • Integridad de los datos: La lógica de almacenamiento local ante pérdidas de conectividad temporal demostró ser efectiva, evitando pérdidas de información valiosa.

Conclusión

El desarrollo del sistema inteligente de monitoreo de trampas adhesivas representa una contribución significativa al proceso de transformación digital en la industria agrícola de la República Dominicana. Esta solución, concebida e implementada por estudiantes de ingeniería de la PUCMM, demuestra cómo desde el entorno académico pueden generarse innovaciones tecnológicas de bajo costo, basadas en arquitecturas distribuidas y modelos de inteligencia artificial entrenados localmente, capaces de responder a problemáticas concretas del sector agroindustrial.

Más allá de su funcionalidad técnica, el sistema impulsa una nueva forma de gestión agrícola basada en datos objetivos, permitiendo optimizar la toma de decisiones, reducir el uso innecesario de pesticidas, minimizar el tiempo de inspección manual y mantener trazabilidad histórica sobre la actividad biológica en almacenes. Su diseño modular y escalable, que combina dispositivos Raspberry Pi en campo con un servidor local central, permite su replicación sin necesidad de conexión a internet externa, funcionando de manera autónoma en redes Wi-Fi privadas. No obstante, para escenarios rurales sin cobertura, se plantea como mejora futura la incorporación de conectividad 4G.

Asimismo, se reconocen oportunidades de evolución como el entrenamiento de nuevos modelos con más especies, el perfeccionamiento del posicionamiento físico de trampas y la implementación de lógica predictiva basada en tendencias. Estas mejoras permitirán al sistema no solo detectar plagas en tiempo real, sino también anticipar su aparición y facilitar respuestas tempranas más eficientes.

En definitiva, este proyecto reafirma el rol estratégico de la academia como motor de soluciones tecnológicas orientadas a los sectores productivos. Su desarrollo es una muestra concreta del impacto que pueden tener los proyectos estudiantiles bien dirigidos, cuando se articulan conocimientos técnicos con necesidades reales del entorno nacional.

Referencias

  1. TrapView – Sistema de monitoreo de plagas basado en visión artificial. [En línea]. Disponible en: https://www.trapview.com/
  2. PestNet – Monitoreo de trampas en cultivos. [En línea]. Disponible en: https://pestnet-europe.es/
  3. D. Sun et al., “Efficient Tobacco Pest Detection in Complex Environments Using an Enhanced YOLOv8 Model”, Agriculture, vol. 14, no. 3, p. 353, 2024.
  4. B. Ramalingam et al., “Remote Insects Trap Monitoring System Using Deep Learning Framework and IoT”, Sensors, vol. 20, no. 18, p. 5280, 2020.
  5. K. S. & K. D. Suresh, “Crop Pest Control using IoT Real-Time Monitoring and Intervention”, IEEE Access, 2023.
  6. M. Inoue, “IoT Monitoring System for Agricultural Pests and Diseases”, IEEE, 2018.

Creación de algoritmo de optimización para gestionar en un ambiente simulado el tráfico en ciertas intersecciones de la ciudad de Santiago

Romario Isaías Abreu Santos y Demian Fernando Reynoso Gómez – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El acelerado crecimiento urbano de Santiago de los Caballeros ha transformado radicalmente la dinámica de movilidad en la segunda ciudad más importante de República Dominicana, generando una presión sin precedentes sobre su infraestructura vial. Este proyecto, desarrollado por Romario Isaías Abreu Santos y Demian Fernando Reynoso Gómez bajo la asesoría del profesor Jorge Alejandro Luna Martínez en la Pontificia Universidad Católica Madre y Maestra, surge como respuesta innovadora a la creciente problemática de congestión vehicular que afecta tanto la productividad económica como la calidad de vida de los santiagueros.

A medida que la ciudad experimenta un proceso de densificación urbana acelerado, las avenidas principales como Estrella Sadhalá, 27 de Febrero y Juan Pablo Duarte han sido testigos de una saturación progresiva que evidencia las limitaciones de los sistemas tradicionales de gestión del tráfico. La motivación principal de esta iniciativa radica en la urgente necesidad de modernizar la infraestructura de control semafórico, transitando desde sistemas rígidos de tiempo fijo hacia soluciones adaptativas que respondan dinámicamente a las variaciones del flujo vehicular [1], [2].

La relevancia de este proyecto trasciende el ámbito académico para posicionarse como una contribución directa al desarrollo de ciudades inteligentes en el contexto dominicano. A diferencia de las implementaciones costosas de infraestructura nueva, esta propuesta aprovecha las capacidades de simulación computacional y algoritmos de optimización para evaluar y validar soluciones antes de su posible implementación física, representando un enfoque costo-efectivo particularmente apropiado para ciudades en desarrollo [3], [4].

El desarrollo de esta solución se enmarca dentro del área emergente de sistemas inteligentes de transporte (ITS), integrando técnicas avanzadas de optimización evolutiva con modelado microscópico de tráfico. Esta aproximación metodológica permite no solo evaluar el impacto de diferentes estrategias de control semafórico, sino también generar evidencia cuantitativa sobre los beneficios potenciales de la automatización en la gestión del tráfico urbano, contribuyendo así al corpus de conocimiento sobre movilidad sostenible en América Latina [7], [8].

La problemática del tráfico en Santiago

El crecimiento descontrolado del parque vehicular en Santiago de los Caballeros ha superado significativamente la capacidad de adaptación de su infraestructura vial, creando un desequilibrio crítico entre la oferta de espacios de circulación y la demanda de movilidad urbana. Este fenómeno, común en ciudades intermedias de países en desarrollo, se ve agravado por sistemas de control de tráfico obsoletos que operan con lógicas de temporización fija, incapaces de responder a las variaciones dinámicas inherentes al flujo vehicular urbano. La consecuencia directa de esta rigidez operacional se manifiesta en tiempos de espera excesivos durante períodos de baja demanda y colapsos sistemáticos durante las horas de mayor afluencia vehicular [7], [8].

Esta problemática no se limita únicamente a inconvenientes de movilidad, sino que genera externalidades negativas de amplio espectro que incluyen incremento en el consumo de combustible, elevación de emisiones contaminantes, deterioro de la calidad del aire urbano y reducción de la productividad económica por pérdidas de tiempo en desplazamientos. La literatura especializada documenta ampliamente cómo la congestión vehicular en entornos urbanos densos contribuye al fenómeno de islas de calor urbano, degradación de la salud pública por exposición a contaminantes atmosféricos, y efectos psicológicos negativos asociados al estrés del conductor [9], [11].

En el contexto específico de Santiago de los Caballeros, intersecciones críticas como las ubicadas en la Avenida Estrella Sadhalá con Gregorio Luperón, 27 de Febrero, Juan Pablo Duarte y Hatuey, experimentan niveles de saturación que comprometen la conectividad eficiente entre diferentes sectores de la ciudad. La ausencia de coordinación entre semáforos adyacentes y la falta de adaptabilidad temporal de las fases semafóricas resultan en patrones de tráfico ineficientes que penalizan tanto a usuarios del transporte privado como público, limitando las opciones de movilidad sostenible para la población [10].

Estado del arte

El estado del arte en optimización de sistemas de control de tráfico ha experimentado avances sustanciales mediante la aplicación de técnicas computacionales avanzadas. Investigaciones pioneras como las desarrolladas por Jia et al. han demostrado el potencial del aprendizaje reforzado profundo para la optimización dinámica de fases semafóricas, logrando reducciones significativas en tiempos de espera mediante algoritmos como Clipped Double Deep Q-Learning que aprenden y se adaptan continuamente a patrones de tráfico variables [1]. Complementariamente, estudios comparativos realizados por Gunarathne et al. han validado la superioridad de sistemas de simulación integrados como VISSIM sobre métodos analíticos tradicionales como Webster, especialmente en términos de precisión predictiva y facilidad de implementación operacional [2].

Los algoritmos genéticos han emergido como una de las técnicas más prometedoras para la optimización multiobjetivo de sistemas semafóricos. Trabajos desarrollados por Al-Turki et al., Sanchez-Medina et al., y Teklu et al. han demostrado consistentemente que estos algoritmos evolutivos pueden identificar configuraciones óptimas de temporización semafórica que balancean múltiples criterios de desempeño simultáneamente, incluyendo minimización de retrasos, reducción de emisiones, y optimización de consumo energético [3], [4], [5]. La efectividad de estos enfoques radica en su capacidad para explorar espacios de solución complejos donde métodos de optimización tradicionales frecuentemente fallan debido a la naturaleza no lineal y multimodal del problema [6], [16].

La simulación microscópica de tráfico ha sido reconocida como una herramienta fundamental para la validación y evaluación de estrategias de optimización semafórica. Plataformas como SUMO (Simulation of Urban Mobility), desarrollada por el Centro Aeroespacial Alemán, han ganado aceptación amplia en la comunidad científica debido a su capacidad para modelar comportamientos vehiculares realistas, su arquitectura modular extensible, y su compatibilidad con interfaces de programación que facilitan la implementación de algoritmos de control externos [15]. Esta flexibilidad tecnológica permite la evaluación rigurosa de diferentes estrategias de optimización en entornos controlados antes de considerar implementaciones en sistemas reales.

Sin embargo, la transferencia efectiva de estas tecnologías avanzadas a contextos urbanos de países en desarrollo como República Dominicana enfrenta desafíos específicos relacionados con la disponibilidad y calidad de datos de tráfico, características particulares de patrones de movilidad local, limitaciones en infraestructura tecnológica de soporte, y restricciones presupuestarias para implementación de sistemas automatizados. La mayoría de las soluciones documentadas en la literatura internacional han sido desarrolladas para ciudades con recursos tecnológicos y financieros superiores, lo que hace necesario adaptar y contextualizar estos enfoques a las realidades y limitaciones específicas del entorno dominicano [12], [13].

El desarrollo de este proyecto ha logrado implementar un sistema integral de optimización de tráfico que utiliza algoritmos genéticos para mejorar dinámicamente la gestión semafórica en el corredor de la Avenida Estrella Sadhalá en Santiago de los Caballeros, desde la intersección con Gregorio Luperón hasta Hatuey. Para alcanzar este objetivo general, se ejecutaron múltiples objetivos específicos que incluyeron la recolección sistemática y análisis detallado de datos macroscópicos de flujo vehicular mediante observación directa y medición instrumental con radar de velocidad, garantizando la captura representativa de patrones de comportamiento del tráfico en diferentes períodos temporales y condiciones operacionales. Se desarrolló un modelo de simulación de alta fidelidad utilizando SUMO (Simulation of Urban Mobility) que replica con precisión las características geométricas, topológicas y operacionales de las intersecciones estudiadas, incorporando datos empíricos de velocidades vehiculares, densidades de tráfico y configuraciones semafóricas existentes para asegurar la validez y confiabilidad del entorno de pruebas. Finalmente, se diseñó e implementó un algoritmo genético especializado que optimiza de manera adaptativa las duraciones de fases semafóricas, logrando mejoras medibles en indicadores clave de desempeño como reducción de tiempos de espera promedio, incremento en velocidades de tránsito, disminución de paradas vehiculares y optimización del flujo global del corredor mediante adaptación continua a condiciones variables de demanda vehicular.

Metodología

Para poder probar la propuesta, fue necesario combinar varios pasos que van desde la recopilación de información en la calle hasta la simulación en computadora y la optimización mediante un algoritmo. Todo inició con la toma de datos en campo, donde se midió cuántos vehículos pasaban por distintos puntos del corredor de la Avenida Estrella Sadhalá en intervalos de diez minutos. Estos conteos se realizaron manualmente, apoyados también por el uso de un radar de velocidad para registrar la rapidez de los vehículos. Con esta información se obtuvo un panorama real del tráfico en horas representativas, y luego los datos se ajustaron a escala de una hora para que fueran más fáciles de comparar entre intersecciones.

Con esos datos como base, el siguiente paso fue llevar la realidad de las calles a un entorno virtual. Para esto se utilizó SUMO (Simulation of Urban Mobility), un software de simulación de tráfico muy utilizado a nivel mundial. Primero, se importó el mapa del tramo estudiado desde la plataforma OpenStreetMap y se ajustó con una herramienta llamada NETEDIT, que permite corregir detalles como carriles, intersecciones y semáforos. De esta manera, se construyó un modelo digital que reflejaba fielmente la geometría y las condiciones actuales del corredor vial en Santiago.

Una vez que la red estuvo lista, se incorporaron los datos recolectados (velocidades, densidad de vehículos y tiempos semafóricos actuales) para que la simulación se comportara de manera lo más cercana posible a la realidad. Esto fue clave, ya que permitió observar en la computadora los mismos patrones de congestión que se viven en la ciudad, pero en un entorno controlado donde era posible probar cambios sin afectar a los conductores.

Sobre este escenario virtual se implementó un Algoritmo Genético, un método de optimización inspirado en la evolución natural. En términos sencillos, el algoritmo prueba muchas combinaciones diferentes de tiempos de semáforo, “aprende” cuáles funcionan mejor y conserva las que reducen la congestión. Con cada repetición, descarta las opciones menos efectivas y combina las mejores, hasta encontrar configuraciones óptimas para mejorar el tráfico.

Finalmente, para conectar todo este proceso, se usó el lenguaje de programación Python, que a través de una interfaz llamada TraCI se comunica en tiempo real con SUMO. Esto permitió que el algoritmo controlara los semáforos dentro de la simulación y probara automáticamente las distintas configuraciones, midiendo siempre resultados como tiempos de espera, velocidad y densidad vehicular. Así, se construyó un ciclo continuo de prueba y mejora que llevó a resultados medibles y claros.

Resultados

Los experimentos realizados demostraron la efectividad de la optimización evolutiva frente al sistema actual de semáforos de tiempo fijo. Al comparar ambos escenarios, se observaron mejoras significativas en todas las métricas evaluadas. El tiempo de espera promedio por vehículo se redujo de 49.4 segundos a 36.03 segundos, lo que representa una disminución notable en la congestión en las intersecciones críticas. Asimismo, la densidad vehicular promedio pasó de 43.83 a 36.44 vehículos por kilómetro, reflejando una distribución más equilibrada del flujo de tráfico.

El impacto positivo también se evidenció en el tiempo promedio de viaje, que disminuyó de 270.2 a 231.1 segundos, facilitando recorridos más fluidos a lo largo del corredor estudiado. Finalmente, la velocidad promedio de los vehículos aumentó de 12.71 m/s a 14.34 m/s, indicador claro de que la movilidad urbana se tornó más eficiente gracias al algoritmo implementado. Estos resultados validan no solo la utilidad de SUMO como herramienta de simulación, sino también la pertinencia del uso de algoritmos genéticos para la optimización dinámica del tráfico en contextos urbanos complejos.

Tiempos fijosAlgoritmo genético
Tiempo de espera promedio (s)49.436.03
Densidad promedio (veh/km)43.8336.44
Tiempo promedio de viaje (s)270.2231.1
Velocidad promedio (m/s)12.7114.34
Tabla 1. Tabla de resultados.

Conclusión

El desarrollo de este proyecto confirma que es posible aprovechar el potencial de la simulación computacional y la optimización evolutiva para abordar problemas críticos de movilidad en ciudades intermedias como Santiago de los Caballeros. La implementación del algoritmo genético permitió demostrar, en un entorno controlado, que la gestión adaptativa de los semáforos puede reducir la congestión, mejorar los tiempos de viaje y disminuir las externalidades negativas asociadas al tráfico.

Más allá de los logros obtenidos, este trabajo sienta las bases para futuras investigaciones que busquen escalar la metodología a redes más extensas y complejas, así como integrar fuentes de datos en tiempo real mediante tecnologías como cámaras inteligentes o sensores de tráfico. La combinación de estas innovaciones podría acercar a Santiago a un modelo de ciudad más inteligente y sostenible, en el que la movilidad eficiente sea un pilar del bienestar ciudadano.

La siguiente imagen muestra la ruta modelada completa dentro del simulador corriendo.

Captura de SUMO con la red vial modelada del corredor de la Avenida Estrella Sadhalá y sus intersecciones
Figura 1. Ruta modelada completa del corredor de la Avenida Estrella Sadhalá ejecutándose en SUMO.

Referencias

  1. Y. Jia, J. Lu, y D. Görges, “Reinforcement Learning-Based Traffic Light Control Using a Clipped Double Deep Q-Learning Algorithm”, en Advances in Transdisciplinary Engineering, M. Shafik, Ed., IOS Press, 2024. doi: 10.3233/ATDE241191.
  2. D. Gunarathne, N. Amarasingha, y V. Wickramasighe, “Traffic Signal Controller Optimization Through VISSIM to Minimize Traffic Congestion, CO and NOx Emissions, and Fuel Consumption”, Sci. Eng. Technol., vol. 3, núm. 1, abr. 2023, doi: 10.54327/set2023/v3.i1.56.
  3. M. Al-Turki, A. Jamal, H. M. Al-Ahmadi, M. A. Al-Sughaiyer, y M. Zahid, “On the Potential Impacts of Smart Traffic Control for Delay, Fuel Energy Consumption, and Emissions: An NSGA-II-Based Optimization Case Study from Dhahran, Saudi Arabia”, Sustainability, vol. 12, núm. 18, p. 7394, sep. 2020, doi: 10.3390/su12187394.
  4. J. J. Sanchez-Medina, M. J. Galan-Moreno, y E. Rubio-Royo, “Traffic signal optimization in ‘la almozara’ district in saragossa under congestion conditions, using genetic algorithms, traffic microsimulation, and cluster computing”, IEEE Trans. Intell. Transp. Syst., vol. 11, núm. 1, pp. 132–141, mar. 2010, doi: 10.1109/TITS.2009.2034383.
  5. F. Teklu, A. Sumalee, y D. Watling, “A Genetic Algorithm Approach for Optimizing Traffic Control Signals Considering Routing”, Comput.-Aided Civ. Infrastruct. Eng., vol. 22, núm. 1, pp. 31–43, ene. 2007, doi: 10.1111/j.1467-8667.2006.00468.x.
  6. A. Akopov, E. Zaripov, y A. Melnikov, “Adaptive control of transportation infrastructure in an urban environment using a real-coded genetic algorithm”, Bus. Inform., vol. 18, núm. 2, pp. 48–66, jun. 2024, doi: 10.17323/2587-814X.2024.2.48.66.
  7. E. B. Lieberthal, N. Serok, J. Duan, G. Zeng, y S. Havlin, “Addressing the urban congestion challenge based on traffic bottlenecks”, Philos. Trans. R. Soc. Math. Phys. Eng. Sci., vol. 382, núm. 2285, p. 20240095, dic. 2024, doi: 10.1098/rsta.2024.0095.
  8. “Urban Mobility System Upgrade: How shared self-driving cars could change city traffic”, International Transport Forum Policy Papers 6, mar. 2015. doi: 10.1787/5jlwvzdk29g5-en.
  9. D. Meriana, B. S. Subagio, y Najid, “Assessment for Evaluation of Local Roads Based on Infrastructure Data and Budget Allocation”, Civ. Eng. J., vol. 11, núm. 1, pp. 44–57, ene. 2025, doi: 10.28991/CEJ-2025-011-01-04.
  10. X. Liang, X. Du, G. Wang, y Z. Han, “A Deep Reinforcement Learning Network for Traffic Light Cycle Control”, IEEE Trans. Veh. Technol., vol. 68, núm. 2, pp. 1243–1253, feb. 2019, doi: 10.1109/TVT.2018.2890726.
  11. K. H. Mhana, S. B. Norhisham, H. Y. B. Katman, y Z. M. Yaseen, “Road urban planning sustainability based on remote sensing and satellite dataset: A review”, Heliyon, vol. 10, núm. 21, p. e39567, nov. 2024, doi: 10.1016/j.heliyon.2024.e39567.
  12. J. Jin, X. Ma, y I. Kosonen, “A stochastic optimization framework for road traffic controls based on evolutionary algorithms and traffic simulation”, Adv. Eng. Softw., vol. 114, pp. 348–360, dic. 2017, doi: 10.1016/j.advengsoft.2017.08.005.
  13. F. Van Wageningen-Kessels, H. Van Lint, K. Vuik, y S. Hoogendoorn, “Genealogy of traffic flow models”, EURO J. Transp. Logist., vol. 4, núm. 4, pp. 445–473, dic. 2015, doi: 10.1007/s13676-014-0045-5.
  14. Y. Shamlitsky, A. Popov, E. Morozov, y A. Ovsyankin, “Mathematical methods and models of traffic flow management”, E3S Web Conf., vol. 402, p. 01010, 2023, doi: 10.1051/e3sconf/202340201010.
  15. A. Diallo, G. Lozenguez, A. Doniec, y R. Mandiau, “Comparative Evaluation of Road Traffic Simulators based on Modeler’s Specifications: An Application to Intermodal Mobility Behaviors”, en Proceedings of the 13th International Conference on Agents and Artificial Intelligence, Online Streaming: SCITEPRESS – Science and Technology Publications, 2021, pp. 265–272. doi: 10.5220/0010238302650272.
  16. A. A. Alkhatib y T. Sawalha, “Techniques for road traffic optimization: an overview”, Indian J. Comput. Sci. Eng., vol. 11, núm. 4, pp. 311–320, ago. 2020, doi: 10.21817/indjcse/2020/v11i4/201104063.
  17. J. Gajcin y I. Dusparic, “Redefining Counterfactual Explanations for Reinforcement Learning: Overview, Challenges and Opportunities”, ACM Comput. Surv., vol. 56, núm. 9, pp. 1–33, oct. 2024, doi: 10.1145/3648472.
  18. J. M. Parra-Ullauri et al., “Event-driven temporal models for explanations – ETeMoX: explaining reinforcement learning”, Softw. Syst. Model., vol. 21, núm. 3, pp. 1091–1113, jun. 2022, doi: 10.1007/s10270-021-00952-4.

Smart Stock Analyzer: optimización de manejo de stock en centros de acopio en la República Dominicana

Randae García Sánchez y Starlin Frías Luna – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En situaciones de emergencia como huracanes, sismos o inundaciones, la velocidad y exactitud en la repartición de alimentos no indispensables puede ser la diferencia entre el desorden y una efectiva intervención humanitaria. En la República Dominicana, los centros de recolección tienen la obligación de acoger, preservar y distribuir estos recursos vitales. No obstante, la mayoría de estos centros aún recurren a técnicas manuales para administrar su inventario, lo que restringe considerablemente su habilidad para funcionar en circunstancias críticas (Van Wassenhove, 2006; Holguín-Veras, 2012) [1].

Ante esta realidad, surge Smart Stock Analyzer, un proyecto desarrollado por Randae García Sánchez y Starlin Frías Luna como parte de su tesis de grado en la carrera de Ingeniería en Ciencias de la Computación en la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del Ing. Máximo Emiliano Pérez Medrano. El objetivo principal del proyecto es transformar la forma en que los centros de acopio gestionan su inventario, integrando tecnologías de visión por computadora y aprendizaje profundo en una aplicación móvil accesible y fácil de usar.

La propuesta surge de un impulso específico: la ineficiencia y la vulnerabilidad de los métodos de inventario actuales en centros de recolección frente a situaciones de emergencia. No solo son lentos y susceptibles a fallos humanos estos procedimientos, sino que también complican la toma de decisiones en tiempo real. Investigaciones han evidenciado que la ausencia de datos exactos acerca de los inventarios puede poner en riesgo la distribución adecuada de recursos, lo que resulta particularmente alarmante en contextos con restricciones tecnológicas y presupuestarias (Çelik, 2012; Balcik, 2020) [3].

El Smart Stock Analyzer es un enfoque en la innovación local, utilizando los más recientes avances en inteligencia artificial como los modelos YOLO y RF-DETR para reconocer y contar productos directamente a partir de imágenes capturadas con la cámara de un móvil. Este proyecto, más que una respuesta tecnológica, sugiere una herramienta de efecto social directo, orientada a incrementar la eficiencia, disminuir el derroche y potenciar la habilidad para reaccionar ante crisis humanitarias (Goldman, 2019; Tonioni, 2020) [5].

Con esta perspectiva, el blog que presentamos tiene como objetivo difundir el procedimiento, los aprendizajes y el posible efecto de esta solución, que busca transformarse en un modelo de innovación aplicada en situaciones de recursos escasos. Compártenos cómo la informática puede hacer una diferencia en instantes que verdaderamente son relevantes.

Inventarios manuales en tiempos de crisis: un reto sin resolver

En la República Dominicana, los centros de recolección juegan un papel vital en la gestión de emergencias, actuando como sitios estratégicos para acoger, guardar y repartir productos no esenciales para el consumo. Sin embargo, a pesar de su importancia, estas instalaciones suelen operar con métodos elementales y sin el soporte tecnológico adecuado. La gestión del inventario, crucial para garantizar una reacción eficaz en periodos de crisis, generalmente se realiza de forma manual, empleando hojas de cálculo o conteos visuales. Esta situación ha sido ampliamente documentada en escenarios humanitarios, donde la falta de sistemas automatizados causa retrasos, errores y, en el caso más severo, pérdidas irreparables de recursos esenciales [1], [4].

Al estar frecuentemente sometida a fenómenos naturales como huracanes e inundaciones, la República Dominicana necesita un sistema logístico sumamente eficaz para satisfacer las demandas de la población impactada. No obstante, en sucesos como los ciclones Irma y María en 2017, se demostró que la improvisación y la falta de organización en la gestión de recursos empeoraron la condición de miles de familias [7]. Estas deficiencias se atribuyen, en cierta medida, a la falta de seguridad de los centros de recolección para determinar con precisión cuántos productos disponen, cuáles requieren su sustitución, o cómo ordenar su distribución en tiempo real. La utilización de procedimientos analógicos no solo obstaculiza las operaciones, sino que amenaza la vida de los individuos más vulnerables.

Diversas investigaciones concuerdan en que el principal impedimento para implementar soluciones tecnológicas en estos centros radica en la escasez de infraestructura, presupuesto y personal formado [8]. Las herramientas comerciales existentes para la administración de inventarios suelen ser caras, necesitan una conexión a internet estable y están diseñadas para situaciones empresariales, no humanitarias. Por lo tanto, a pesar de que hay sistemas de administración ERP o aplicaciones móviles sofisticadas para el comercio minorista, estos no se ajustan con facilidad a la situación de un centro de recolección en un país en desarrollo. Van Wassenhove ha destacado esta brecha tecnológica como una de las principales razones de ineficiencia en la logística humanitaria [1].

A escala global, se han sugerido soluciones que utilizan tecnología de la información para identificar productos en estanterías o almacenes. Por ejemplo, Goldman y colaboradores obtuvieron más del 94% de exactitud al identificar productos en supermercados mediante el uso de modelos como Faster R-CNN [5]. Otros métodos, como el estudio de Tonioni et al., han empleado versiones más livianas de YOLO para transmitir productos en tiempo real desde aparatos móviles, logrando resultados alentadores en comercios [6]. No obstante, estos avances están dirigidos al comercio minorista de alta gama y demandan condiciones reguladas de iluminación, conexión y equipos especializados, lo que los convierte en poco factibles en centros de recolección rurales o improvisados.

En el escenario latinoamericano, muy pocas investigaciones se enfocan en soluciones económicas que sean administradas por personal no técnico en entornos con limitada conectividad. Aunque existen iniciativas que implementan el aprendizaje automático en áreas como la salud pública o la agricultura, el área de la administración humanitaria sigue en desarrollo. Por ejemplo, en República Dominicana, la mayoría de los instrumentos tecnológicos desarrollados para situaciones de emergencia se centran en la comunicación o la representación del mapa de zonas afectadas, no en la gestión de los recursos. Según un estudio de REDISD, una mala administración del inventario ha provocado excesos y derroches en diversas microempresas, lo que demuestra un problema estructural en el país [9].

Esta mezcla de elementos —limitaciones en las operaciones, soluciones actuales deficientes y la necesidad de una respuesta efectiva en circunstancias de emergencia— pone de manifiesto la importancia de una propuesta innovadora y ajustada al entorno local. Por lo tanto, surge el proyecto Smart Stock Analyzer: un instrumento que no solo aspira a automatizar el inventario, sino también a hacerlo de manera económica, accesible y funcional en las circunstancias reales a las que se enfrentan los centros de recolección dominicanos. En este contexto, la tecnología no es un lujo, sino una urgencia para preservar recursos… y vidas.

El desarrollo del proyecto Smart Stock Analyzer ha logrado implementar una solución móvil basada en visión computacional que automatiza la gestión de inventarios de productos no perecederos en centros de acopio en la República Dominicana, contribuyendo así a mejorar la eficiencia operativa durante situaciones de emergencia. A partir de este objetivo general, se cumplieron metas específicas como el diseño y entrenamiento de un modelo de reconocimiento visual con precisión superior al 85%, capaz de identificar y contabilizar productos clave como botellas y enlatados; el desarrollo de una aplicación móvil intuitiva con alertas de niveles críticos y reportes de consumo; la integración de funciones de búsqueda y clasificación por categorías para agilizar el acceso a productos durante eventos críticos; y la validación del sistema en condiciones reales mediante pruebas controladas, cumpliendo con los criterios de viabilidad técnica, económica y operativa definidos desde el inicio.

Un enfoque adaptado al contexto dominicano

El enfoque diseñado para el desarrollo de Smart Stock Analyzer se fundamentó en un enfoque realista y flexible ante las circunstancias operativas de los centros de recolección en República Dominicana. En contraste con otras propuestas dirigidas a cadenas de comercio minorista con acceso a una infraestructura sólida, este proyecto optó por un enfoque de bajo costo y alto rendimiento. La arquitectura global del sistema incorpora una aplicación para móviles, un backend de procesamiento y un modelo de visión informática entrenado específicamente con datos del ambiente local. La meta principal consistió en optimizar la eficacia del sistema frente a restricciones reales como la conectividad irregular, aparatos móviles de tamaño medio y la falta de personal técnico especializado [1].

Visión por computadora como eje central

La solución incluye un modelo de identificación de objetos fundamentado en redes neuronales convolucionales (CNN). Inicialmente, se escogieron arquitecturas como YOLOv5 y YOLOv8 debido a su equilibrio entre rapidez y exactitud, resultando particularmente eficientes en labores de detección en tiempo real [10]. No obstante, la inclusión del modelo RF-DETR (Transformador de Detección Relacional Ampliada) constituyó un progreso metodológico crucial, dado que su estructura fundamentada en transformadores facilita la captura de relaciones espaciales entre objetos en escenas densas, características de centros de recolección [11]. Esta arquitectura ha demostrado rendimientos óptimos en situaciones multiclase y en la identificación de objetos parcialmente solapados, situaciones habituales en almacenes improvisados.

Recolección y creación de dataset contextualizado

Una de las contribuciones más importantes de la metodología fue la construcción de un dataset propio. Aunque inicialmente se utilizó Open Food Facts como fuente base, se identificaron limitaciones en la representación visual de productos del mercado local. Para solucionar esto, se recolectaron más de 300 imágenes en supermercados y almacenes reales como El Bravo, Nacional y La Fuente. Esta estrategia permitió adaptar el modelo a las particularidades visuales del entorno dominicano, mejorando la precisión en condiciones no controladas. El uso de datos sintéticos también fue parte de la estrategia de aumento de datos (data augmentation), aplicando técnicas como rotaciones, cambios de brillo y escalado [12].

Procesamiento híbrido: edge y nube

Dado que muchos centros de acopio no cuentan con acceso constante a internet, se diseñó una arquitectura híbrida. Esta permite realizar la detección en vivo desde el dispositivo móvil obteniendo un conteo rápido de los productos en tiempo real, aunque estos no pueden ser almacenados y recolectados en el dispositivo al menos que no se cuente con conexión a internet. Este enfoque permite que el sistema sea funcional incluso en entornos offline, mientras aprovecha la nube cuando la conectividad lo permite [13], también permite una mejor experiencia del usuario al no tener que esperar el análisis de la imagen para tener una idea de cuáles podrían ser los posibles resultados.

Diagrama del enfoque edge computing: la cámara del móvil envía la imagen al modelo YOLO en el propio dispositivo
Figura 1. Enfoque edge computing.
Arquitectura híbrida: la aplicación móvil envía peticiones a un backend Django en la nube con base de datos PostgreSQL y modelo de IA
Figura 2. Arquitectura híbrida.
Esquema general del sistema: aplicación móvil con cámara y modelo YOLO/RF-DETR, backend Django en DigitalOcean, base de datos y flujo de datos
Figura 3. Esquema general.

Desarrollo multiplataforma y experiencia de usuario

Para garantizar portabilidad y acceso a gran escala, se desarrolló una aplicación en Flutter para dispositivos móviles, seleccionada por su capacidad para compilar en Android e iOS desde una sola base de código, y por su compatibilidad con bibliotecas de visión computacional como TensorFlow Lite y ML Kit. El diseño de la interfaz se fundamentó en conceptos de facilidad de uso, orientado a operadores no expertos, con botones extensos, advertencias visuales y menús simplificados. Adicionalmente, se incorporaron funciones de etiquetado manual, lo que permite la corrección de errores del modelo y mejora la adaptabilidad al entorno [14].

Validación práctica y condiciones controladas

El sistema fue probado en condiciones simuladas, tratando de replicar entornos de centros de acopio reales. Se determinó que el modelo alcanza su mayor precisión (superior al 90%) cuando las imágenes se capturan con una separación entre productos de 3 a 5 cm, iluminación entre 300 y 800 lux, y una distancia de cámara de 50 a 120 cm. Estos parámetros fueron validados en base a estudios sobre reconocimiento visual en ambientes reales [6]. También se realizaron pruebas de robustez en escenarios de baja iluminación y productos apilados, observando una disminución previsible de hasta un 20% en la precisión, resultado coherente con la literatura.

Inteligencia artificial con propósito social

Lo que diferencia esta metodología de otras del estado del arte es su foco en la accesibilidad y utilidad en contextos humanitarios. Mientras la mayoría de soluciones revisadas se enfocan en el sector privado, este proyecto implementa IA como herramienta de soporte para poblaciones vulnerables. Se prioriza la simplicidad del sistema, la posibilidad de uso offline, y la escalabilidad en futuras fases del proyecto (por ejemplo, ampliación de productos (clases del modelo) o integración con sistemas de distribución logística).

Sostenibilidad y escalabilidad del sistema

Finalmente, la metodología contempla un diseño modular que permite escalar la solución a más centros de acopio, sin necesidad de ajustes mayores. Los modelos pueden ser reentrenados con nuevos datos, y la aplicación móvil puede actualizarse de forma remota. Además, se documentó el proceso de entrenamiento y despliegue del modelo, para permitir que otros equipos técnicos, incluso fuera del país, puedan replicar o adaptar la solución. Esto convierte al Smart Stock Analyzer en una herramienta con potencial de crecimiento regional y aplicación en otros escenarios de emergencia o logística social.

Resultados

La puesta en marcha del sistema Smart Stock Analyzer confirmó la hipótesis propuesta en los objetivos: que se puede automatizar la gestión del inventario en centros de recolección mediante visión computacional desde un dispositivo móvil, con gran exactitud, asequible y sin requerir una conexión permanente a internet al menos para la detección en tiempo real. En las etapas de prueba y validación, tanto el modelo YOLO como el RF-DETR exhibieron habilidades robustas en la identificación y recuento de productos esenciales, alcanzando y excediendo los límites fijados en la metodología de planificación.

En pruebas realizadas con el modelo YOLOv8 desplegado directamente en la aplicación móvil (edge processing), se alcanzó una precisión promedio del 88.4% en la clasificación correcta de productos, con una tasa de falsos positivos inferior al 5% en condiciones de iluminación estándar y separación mínima entre objetos. Esta implementación fue especialmente útil para realizar escaneos rápidos en almacenes con conectividad limitada, validando el objetivo específico de procesamiento local en dispositivos sin hardware especializado.

Matriz de confusión del modelo YOLOv8 con las clases bottle-individual, bottle-pack-12, canned-individual, canned-pack y background
Figura 4. Matriz de confusión del modelo YOLOv8.
Matriz de confusión normalizada del modelo YOLOv8
Figura 5. Matriz de confusión normalizada del modelo YOLOv8.
Curvas de entrenamiento de YOLOv8: pérdidas de entrenamiento y validación, precisión, recall y mAP por época
Figura 6. Resultados de YOLOv8.

En contraste, el modelo RF-DETR, entrenado y desplegado a través de Roboflow y alojado en el backend de Django, demostró un desempeño aún más sólido en contextos complejos. Este modelo, con una precisión media del 91.7% y una mejor habilidad para detectar objetos solapados o parcialmente visibles, resultó ser perfecto para entornos con una alta densidad de productos. Además, se distinguió por su habilidad para conservar un elevado recall (92%) en lotes variados, lo que asegura que la mayoría de los productos visibles sean identificados de manera correcta.

Detalles del dataset en Roboflow: 1227 imágenes divididas en 1115 de entrenamiento, 56 de validación y 56 de prueba, con preprocesamiento y aumentos
Figura 7. Detalles del dataset para el modelo RF-DETR.
Gráficas de entrenamiento del modelo RF-DETR: rendimiento del modelo y pérdidas por época
Figura 8. Métricas del modelo RF-DETR.
Matriz de confusión del modelo RF-DETR con precisión y recall de 92 %
Figura 9. Matriz de confusión del modelo RF-DETR.

La arquitectura híbrida planteada permitió una conectividad dinámica entre el cliente móvil y el servidor backend. En escenarios donde el internet estaba disponible, la sincronización con el servidor fue fluida, permitiendo la carga de inventarios al sistema central y la generación automática de reportes estadísticos. Esto responde directamente al objetivo de centralización de información y visibilidad remota del inventario.

Pantalla de inicio de sesión de la aplicación Smart Stock Analyzer
Figura 10. Pantalla de Login.
Pantalla de registro con datos del centro y del usuario
Figura 11. Pantalla de Registro.
Pantalla de inicio del centro de acopio con accesos rápidos y gestión del centro
Figura 12. Pantalla de Inicio.
Pantalla de rastreo: catálogo de productos con resumen general y distribución de productos
Figura 13. Pantalla de Rastreo.
Pantalla de gestión manual de inventario con cantidades por producto
Figura 14. Pantalla de Gestión de Productos.
Pantalla de informes de inventario con informes de emergencia recientes
Figura 15. Pantalla de Informes.
Pantalla de gráficos con el movimiento total por categoría
Figura 16. Pantalla de Gráficos.
Pantalla de análisis semanal con resumen y movimiento por categoría
Figura 17. Pantalla de Análisis.

Durante la validación en campo, se realizaron más de 100 escaneos con imágenes reales tomadas en supermercados y almacenes simulados. Estas imágenes incluyen tanto productos individuales como empaques (ej. botellas individuales o packs de 12), y el sistema demostró ser capaz de diferenciarlos con precisión al superar el umbral de confianza del 85%, establecido como estándar mínimo para validación. Además, se utilizaron métricas como IoU (Intersection over Union) y mAP (mean Average Precision) para comparar con benchmarks existentes, logrando un mAP@50 de 89% para YOLOv8 y de 91% para RF-DETR, en línea con estudios previos [15][16].

Pantalla de detecciones con las categorías de productos y sus cantidades actuales e ideales
Figura 18. Pantalla de Detecciones.
Detección en vivo de latas con YOLOv8 desde la cámara del móvil
Figura 19. Detección en vivo con YOLOv8.
Capturas de pruebas: análisis con RF-DETR, detección de latas y estanterías de supermercado con latas y botellas de agua detectadas
Figura 20. Imágenes de escenarios de pruebas.

Finalmente, un grupo limitado de usuarios realizó pruebas controladas con el sistema, resaltando la sencillez de manejo de la interfaz móvil, en particular por su sencillez visual y la utilización de botones grandes e íconos descriptivos. Esto confirma el enfoque orientado a usuarios no técnicos y potencia la capacidad del sistema para expandirse en el futuro hacia otros contextos de respuesta humanitaria.

Conclusión

El avance del proyecto Smart Stock Analyzer constituye un avance significativo hacia la digitalización de los procedimientos logísticos en los centros de recolección de la República Dominicana. Este sistema, al fusionar modelos de visión computacional con una arquitectura híbrida que facilita el procesamiento en dispositivos móviles y en la nube, evidencia que la inteligencia artificial puede implementarse de forma práctica y eficaz en contextos con recursos escasos. La comprobación del sistema en situaciones reales, sumada a su rendimiento superior al 85% de exactitud en la identificación de productos esenciales, confirma la factibilidad del método técnico y operativo implementado.

Una de las enseñanzas fundamentales ha sido la relevancia de ajustar las soluciones tecnológicas al entorno en el que serán aplicadas. En contraste con numerosos proyectos parecidos en contextos corporativos o de venta al por menor, este sistema se diseñó teniendo en cuenta las especificidades logísticas, tecnológicas y humanas de los centros de recolección de República Dominicana. Esto demandó tomar decisiones técnicas concretas como la creación de un dataset propio y la utilización de modelos leves como YOLO para inferencia local. Este método contextualizado fortalece los principios propuestos por Van Wassenhove y Holguín-Veras acerca de la importancia de crear soluciones logísticas enfocadas en la realidad de los contextos humanitarios [1][2].

Pese al logro logrado en esta etapa, hay áreas evidentes de mejora y crecimiento. En etapas futuras del proyecto se propone incrementar la cantidad de clases identificadas, incorporar la comprobación de fechas de vencimiento a través de OCR, y producir informes predictivos basados en tendencias de consumo. Además, se prevé la incorporación del sistema con plataformas gubernamentales o de organizaciones no gubernamentales, lo que posibilitará ampliar el efecto del proyecto a escala nacional o regional. Estos avances concuerdan con las sugerencias de Balcik y Beamon acerca de la escalabilidad de los sistemas logísticos en operaciones de asistencia humanitaria [4].

Además, la experiencia obtenida en el desarrollo de este sistema fortalece el potencial de tecnologías como el edge computing, que facilita la implementación de soluciones de Inteligencia Artificial directamente en el lugar de uso, sin tener que confiar únicamente en la conexión con servidores centrales [13]. Esta habilidad es particularmente útil en situaciones donde cada minuto es crucial, como en la reacción instantánea después de un desastre natural.

Para concluir, Smart Stock Analyzer no solo alcanzó las metas establecidas, sino que también estableció una ruta prometedora para la utilización de tecnologías inteligentes con repercusión social. Este estudio evidencia que con los conocimientos apropiados, las herramientas a disposición y una perspectiva enfocada en la necesidad auténtica, se pueden desarrollar soluciones que conservan recursos, mejoran procesos y, finalmente, pueden ayudar a salvar vidas. Promovemos a científicos, programadores y entidades sociales a cooperar, expandirse y continuar investigando este tipo de aplicaciones tecnológicas para la administración de emergencias en entornos vulnerables.

Referencias

  1. L. Van Wassenhove, “Humanitarian aid logistics: supply chain management in high gear,” Journal of the Operational Research Society, vol. 57, no. 5, pp. 475–489, 2006. https://doi.org/10.1057/palgrave.jors.2602125
  2. J. Holguín-Veras, M. Jaller, L. Van Wassenhove, N. Pérez, and T. Wachtendorf, “On the unique features of post-disaster humanitarian logistics,” Journal of Operations Management, vol. 30, no. 7–8, pp. 494–506, 2012. https://www.researchgate.net/publication/258121387
  3. B. Çelik, E. Ergun, and P. Keskinocak, “The post-disaster debris clearance problem under incomplete information,” Operations Research, vol. 60, no. 5, pp. 1114–1129, 2012. https://doi.org/10.1287/opre.1120.1084
  4. B. Balcik, B. M. Beamon, and K. Smilowitz, “Last mile distribution in humanitarian relief,” Journal of Intelligent Transportation Systems, vol. 14, no. 2, pp. 51–63, 2020. https://doi.org/10.1016/j.ejor.2019.07.063
  5. E. Goldman, B. Neiman, and S. R. Gunn, “Product recognition in retail shelf images using deep learning,” Computer Vision and Image Understanding, vol. 182, pp. 1–11, 2019. https://link.springer.com/chapter/10.1007/978-3-319-46448-0_2
  6. A. Tonioni, E. Borghi, A. Piergiovanni, and S. Mattoccia, “Count on me: Real-time inventory monitoring for store shelves,” in Proc. IEEE CVPR Workshops, 2020. https://ieeexplore.ieee.org/document/7780460/
  7. CEPAL, “Impacto económico de los huracanes Irma y María en el Caribe,” Comisión Económica para América Latina y el Caribe, 2018. https://repositorio.cepal.org/handle/11362/43485
  8. T. Tomasini and L. Van Wassenhove, “From preparedness to partnerships: case study research on humanitarian logistics,” International Transactions in Operational Research, vol. 16, no. 5, pp. 549–559, 2009. https://doi.org/10.1111/j.1475-3995.2009.00697.x
  9. REDISD, “Inadecuado manejo de inventario en microempresas alimentarias,” Revista Digital de Investigación en Sistemas de Datos, 2022. https://www.redisd.org/index.php/es/resumen-recibidos-mt4/684
  10. J. Redmon et al., “You Only Look Once: Unified, Real-Time Object Detection,” Proc. IEEE CVPR, 2016. https://arxiv.org/abs/1506.02640
  11. X. Wang et al., “End-to-End Object Detection with Transformers,” Proc. ECCV, 2020. https://arxiv.org/abs/2005.12872
  12. A. Shorten and T. M. Khoshgoftaar, “A survey on Image Data Augmentation for Deep Learning,” Journal of Big Data, vol. 6, no. 60, 2019. https://doi.org/10.1186/s40537-019-0197-0
  13. W. Shi et al., “Edge Computing: Vision and Challenges,” IEEE Internet of Things Journal, vol. 3, no. 5, pp. 637–646, 2016. https://ieeexplore.ieee.org/document/7488250
  14. M. Howard et al., “Searching for MobileNetV3,” Proc. IEEE ICCV, 2019. https://arxiv.org/abs/1905.02244
  15. J. Redmon et al., “You Only Look Once: Unified, Real-Time Object Detection,” Proc. CVPR, 2016. https://arxiv.org/abs/1506.02640
  16. X. Wang et al., “End-to-End Object Detection with Transformers,” ECCV, 2020. https://arxiv.org/abs/2005.12872

Software de monitoreo de red para detección de anomalías para MIPYMES

Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la digitalización ha redefinido la operativa de las empresas, las micro, pequeñas y medianas empresas (MIPYMES) enfrentan un desafío particular: mantener su competitividad sin comprometer la seguridad de su información. La integración progresiva de tecnologías de la información en estas organizaciones ha traído consigo un aumento exponencial en su exposición a amenazas cibernéticas, a menudo sin el respaldo de soluciones robustas que mitiguen los riesgos. Mientras que las grandes empresas disponen de infraestructuras avanzadas y personal capacitado para enfrentar este tipo de desafíos, las MIPYMES se ven limitadas por recursos económicos, técnicos y humanos. Este panorama ha motivado el desarrollo de soluciones especializadas, entre ellas el “Software de Monitoreo de Red para Detección de Anomalías para MIPYMES”, concebido por Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez como parte de su proyecto de grado en la Pontificia Universidad Católica Madre y Maestra (PUCMM).

A diferencia de otros productos comerciales, este software no requiere infraestructuras complejas ni licencias costosas. Está diseñado para ejecutarse en plataformas asequibles como la Raspberry Pi, lo que permite su implementación incluso en entornos con recursos limitados. Esta elección no solo reduce los costos, sino que también facilita el despliegue en redes pequeñas sin afectar el rendimiento. Uno de los pilares de esta solución es su enfoque en el análisis de metadatos en lugar del contenido del tráfico, lo que permite mantener la privacidad de los datos y alinearse con normativas como el Reglamento General de Protección de Datos (RGPD) [1].

Como parte del proceso de diseño, se identificaron las amenazas más comunes en redes que pertenezcan a empresas sin importar su tamaño: ataques de denegación de servicio distribuido (DDoS), escaneo de puertos y fuerza bruta. Estos ataques, aunque variados en su metodología, comparten un mismo objetivo: comprometer la disponibilidad o la confidencialidad de los sistemas. Al simular estos escenarios en entornos controlados utilizando herramientas como Mininet y Wireshark, fue posible analizar con precisión cómo estas amenazas afectan el comportamiento del tráfico de red, extrayendo métricas clave como la tasa de paquetes por segundo, los puertos únicos involucrados, las banderas TCP y la duración de la sesión.

El desarrollo de este proyecto ha permitido implementar un software de monitoreo de red basado en algoritmos de aprendizaje automático, ejecutado en una Raspberry Pi, que permite a las MIPYMES detectar y mitigar amenazas como ataques DDoS, escaneo de puertos y fuerza bruta. Para lograr este objetivo general, se diseñó un sistema escalable compatible con la infraestructura de red existente, se evaluaron modelos como Isolation Forest. Asimismo, se validó experimentalmente su desempeño mediante simulaciones en entornos controlados, confirmando su efectividad y adaptabilidad para su posterior implementación en escenarios reales.

Uno de los elementos más innovadores de esta propuesta radica en la integración de algoritmos de aprendizaje automático para la detección de anomalías. En particular, el uso del algoritmo Isolation Forest resultó crucial debido a su capacidad para identificar patrones inusuales sin necesidad de datos etiquetados, lo que lo convierte en una opción ideal para entornos con tráfico no estructurado y dinámico [11][13]. En pruebas realizadas con datos simulados y reales, este modelo demostró una tasa de detección superior al 90 %, superando a otros enfoques como DBSCAN y One-Class SVM, tanto en precisión como en baja latencia de respuesta [3][12][14].

Durante el desarrollo del sistema, se consideró también la escalabilidad y la eficiencia del procesamiento. Por ello, se incorporaron herramientas como Pandas para el análisis inicial y Dask para el procesamiento distribuido de grandes volúmenes de datos [6][7]. En etapas más avanzadas, se implementó un pipeline sobre Apache Spark, lo que permitió analizar datasets de más de un millón de registros sin comprometer la velocidad del sistema [5].

Es relevante destacar que el sistema no se limita a la detección pasiva. Incluye funcionalidades proactivas como la capacidad de bloquear automáticamente los puertos involucrados en un ataque, mitigando su impacto en tiempo casi real. Este proceso se apoya en reglas heurísticas codificadas a partir de umbrales aprendidos durante la fase de entrenamiento del modelo, los cuales son reforzados por el análisis del algoritmo Isolation Forest. Por ejemplo, un incremento repentino de conexiones hacia múltiples puertos en segundos puede ser indicativo de un ataque DDoS, mientras que múltiples intentos de conexión por SSH en breves intervalos apuntan a un posible ataque de fuerza bruta [26][30][31].

Aunque este software fue concebido inicialmente como un sistema que monitorea y detecta diversas anomalías, su arquitectura y lógica operativa lo posicionan funcionalmente más cerca de un sistema de prevención de intrusiones (IPS) que de un sistema puramente pasivo de detección (IDS). A diferencia de un IDS, que solo analiza el tráfico y alerta al administrador de red ante posibles amenazas, un IPS está diseñado para reaccionar automáticamente ante dichas amenazas y tomar medidas correctivas en tiempo real.

Este software incorpora precisamente esa capacidad de acción inmediata. Por ejemplo, cuando el sistema detecta comportamientos anómalos —como un aumento súbito de conexiones simultáneas hacia múltiples puertos, típico de un ataque DDoS, o múltiples intentos de autenticación SSH en corto tiempo, característicos de un ataque de fuerza bruta— puede ejecutar comandos automatizados para bloquear los puertos involucrados o aislar temporalmente la IP ofensora. Estas acciones son llevadas a cabo por scripts que interactúan directamente con el firewall del sistema operativo, permitiendo una respuesta prácticamente en tiempo real sin intervención humana.

Además, esta lógica de prevención se basa en una combinación de heurísticas definidas por expertos y el análisis dinámico del algoritmo de aprendizaje automático Isolation Forest. Esto permite al sistema no solo actuar frente a amenazas conocidas, sino también responder ante patrones inusuales de comportamiento que podrían corresponder a ataques novedosos o sofisticados. Esta capacidad adaptativa lo diferencia notablemente de los IPS tradicionales basados únicamente en firmas estáticas.

La interfaz gráfica de usuario, desarrollada con un enfoque intuitivo, permite a los usuarios visualizar el estado de la red en tiempo real, recibir notificaciones, modificar umbrales de detección y consultar reportes. Esta interfaz resulta esencial en entornos donde el personal técnico puede ser limitado, ya que democratiza el acceso a funcionalidades avanzadas de monitoreo y respuesta.

Salida de consola del sensor: métricas capturadas de una sesión de red y clasificación como tráfico normal
Figura 1. Salida del sensor: métricas capturadas de una sesión de red y su clasificación.

Otra característica destacada es la generación de alertas vía correo electrónico, función que puede ser configurada desde la GUI y que permite a los administradores recibir notificaciones en tiempo real cuando se detectan comportamientos sospechosos. Estas alertas no solo informan sobre el evento, sino que detallan métricas específicas del tráfico involucrado y la clasificación del tipo de amenaza.

En cuanto a la privacidad de los datos, el sistema implementa múltiples capas de protección: anonimización de direcciones IP, tokenización de credenciales y cifrado de las capturas de tráfico (PCAP) mediante protocolos como TLS/SSL [22]. Además, se ha implementado un sistema de control de acceso basado en roles (RBAC), lo que permite restringir la visualización y edición de parámetros sensibles según el tipo de usuario.

El sistema fue validado mediante pruebas experimentales en laboratorios didácticos de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la PUCMM. Se configuraron topologías que simulan redes reales, incluyendo clientes, servidores y nodos maliciosos. A lo largo de estas pruebas, se midieron métricas como la tasa de verdaderos positivos, tasa de falsos positivos, tiempo de reacción, y uso de recursos del sistema. Los resultados demostraron que incluso en condiciones de tráfico intenso y ataques simultáneos, la Raspberry Pi fue capaz de mantener el procesamiento de datos en tiempo real, activando bloqueos automáticos en menos de 7 segundos desde la detección de la amenaza.

Este proyecto no solo demuestra la viabilidad técnica de una solución de ciberseguridad accesible para MIPYMES, sino que también aporta al ámbito académico y social al validar un modelo replicable para otras instituciones o empresas que enfrenten limitaciones similares. Se plantea como una solución modular, que puede crecer conforme lo hagan las necesidades de la empresa. Por ejemplo, si una MIPYME decide migrar parte de su infraestructura a la nube, el sistema puede ser adaptado para correr sobre instancias virtualizadas, integrarse con SIEMs externos o incorporar sensores IoT para nuevas formas de monitoreo [16][17].

El valor de esta propuesta también se aprecia en su enfoque pedagógico: al haber sido desarrollado en un contexto académico, representa un ejemplo concreto de cómo la investigación aplicada puede responder a necesidades reales del sector productivo. El proyecto se alinea así con una tendencia creciente en el ámbito de la ciberseguridad: la descentralización de las soluciones y su personalización según el entorno operativo, especialmente en regiones en desarrollo donde las soluciones comerciales no siempre son viables [2][29].

En suma, el desarrollo de este software representa un paso importante hacia una ciberseguridad más democrática, donde incluso las organizaciones más pequeñas pueden acceder a herramientas inteligentes de defensa. El uso de aprendizaje automático, herramientas open-source y plataformas de bajo costo demuestra que es posible construir soluciones efectivas sin depender de grandes presupuestos, siempre que se cuente con una metodología sólida, una comprensión clara del problema y un compromiso con la innovación.

A partir de las validaciones experimentales, se observaron también beneficios colaterales que hacen de esta herramienta una solución integral. Una de ellas es su potencial como plataforma de entrenamiento para personal técnico, ya que permite observar en tiempo real cómo se comporta el tráfico de red bajo distintos escenarios de amenaza. Esto no solo es útil para los administradores de red en las MIPYMES, sino también como recurso formativo en entornos educativos. En este sentido, el software puede evolucionar a una versión “educativa” que permita simular ataques, visualizar su detección y analizar la respuesta automática del sistema.

El proyecto, además de ser funcional en su implementación técnica, incorpora un plan detallado de mitigación de riesgos. Esto incluye no solo la detección y respuesta ante amenazas externas, sino también el manejo seguro de los datos, la protección contra accesos no autorizados, y la supervisión de posibles fallas internas del sistema. Se identificaron riesgos como sobrecarga en la Raspberry Pi, fallos en el sistema de alertas, o acceso indebido por parte de usuarios internos. Cada uno de estos fue abordado mediante estrategias preventivas y correctivas, como la autenticación multifactor, el cifrado extremo a extremo, y la verificación periódica de los registros del sistema.

El funcionamiento interno del software está organizado en módulos independientes, que cooperan para capturar tráfico, analizarlo, generar respuestas automáticas y permitir la gestión por parte del usuario. Toda esta arquitectura modular se encuentra en la carpeta «secciones de la aplicación» del repositorio del proyecto.

El script SMR_app.py actúa como controlador principal de la aplicación, iniciando la interfaz gráfica y estableciendo la comunicación entre los módulos. El componente sensor_controller.py se encarga de capturar tráfico en la red en tiempo real utilizando la biblioteca PyShark. Durante esta etapa, se extraen métricas específicas de cada sesión de red, tales como la tasa de paquetes (packet_rate), información enviada (informacion_enviada_mb), puertos involucrados (puertos_unicos), duración de la sesión (duracion_sesion_seg) y banderas TCP (banderas_tcp).

Estas métricas son limpiadas y normalizadas mediante Pandas, y luego pasadas al módulo ml_model.py, que utiliza el modelo de Isolation Forest previamente entrenado y almacenado como ml_model.pkl. El resultado del análisis es una predicción binaria que indica si el tráfico es normal o anómalo.

Desde la interfaz gráfica, desarrollada con PyQt6, los administradores pueden observar alertas en tiempo real, modificar umbrales, activar o detener la detección, y generar reportes. El sistema también cuenta con control de acceso por roles (RBAC), autenticación multifactor (OTP), y registro de auditoría mediante eventos almacenados cada vez que un usuario inicia sesión, configura opciones, o modifica parámetros críticos. Esta arquitectura integral permite una operación segura, eficiente y personalizable de acuerdo a la cada empresa pueda llegar a necesitar.

Pantalla de inicio de sesión de AegisNet con campos de usuario y contraseña
Figura 2. Interfaz gráfica: inicio de sesión.
Tabla de hosts detectados en la red con nombre, IP, dirección MAC y estado
Figura 3. Interfaz gráfica: listado de hosts de la red.
Pantalla de parámetros del sistema: detección, bloqueo automático, correos para alertas y reportes automáticos
Figura 4. Interfaz gráfica: parámetros del sistema, alertas por correo y reportes automáticos.
Pantalla de gestión de reportes con selección de fecha de inicio y de término
Figura 5. Interfaz gráfica: gestión de reportes.

Otro aspecto crucial de esta propuesta es la implementación de un sistema de aprendizaje continuo. Los modelos utilizados no son estáticos: pueden reentrenarse con nuevos datos recolectados a lo largo del tiempo, mejorando así la capacidad del sistema para reconocer nuevas amenazas o adaptarse a cambios en el comportamiento de la red. Esto convierte al software en una herramienta viva, que aprende y se ajusta a medida que evoluciona el entorno digital. Esta funcionalidad fue posible gracias al diseño modular del sistema, que permite actualizar componentes como los modelos de machine learning, las reglas heurísticas o incluso las métricas empleadas, sin necesidad de modificar toda la arquitectura.

Diagrama de flujo: captura de datos, preprocesamiento, entrenamiento del modelo, detección de anomalías, sistema de alertas y visualización
Figura 6. Flujo de funcionamiento del sistema, desde la captura de datos hasta la visualización.

Dentro del sistema, el proceso de clasificación del tráfico se realiza en tiempo real gracias a la eficiencia de bibliotecas como Pandas para la limpieza y estructuración de datos, y a la capacidad de Dask y Spark para operar sobre grandes volúmenes de información distribuida [6][5]. La eficiencia de estas herramientas permitió reducir significativamente los tiempos de análisis, lo que se tradujo en una latencia de respuesta inferior a los 5 segundos en la mayoría de los casos, incluso bajo condiciones de carga media-alta.

En el aspecto de interoperabilidad, el sistema fue diseñado para integrarse fácilmente con herramientas externas como sistemas de gestión de eventos (SIEM). Esto permite ampliar las capacidades del sistema según las necesidades específicas de cada organización. De igual modo, el backend se comunica con bases de datos PostgreSQL, que permiten la trazabilidad completa de eventos y la generación de reportes automatizados [23][24].

Interfaz de AegisNet con gráfico circular de puertos de comunicación por host
Figura 7. Reporte gráfico de la aplicación: puertos de comunicación por host.

En la práctica, esta solución también cumple muchas de las funciones clave de un SIEM (Security Information and Event Management), ya que consolida en un solo sistema la recolección, análisis, correlación y presentación de eventos de seguridad en tiempo real. Sin embargo, el valor añadido de esta aplicación radica en que no requiere una configuración manual de reglas de correlación ni un análisis forense posterior para actuar: la inteligencia incorporada mediante el modelo Isolation Forest le permite tomar decisiones autónomas con base en patrones estadísticos y de comportamiento previamente aprendidos.

El algoritmo Isolation Forest es particularmente eficiente en detectar anomalías sin requerir datos etiquetados, lo que lo hace ideal para entornos dinámicos como las redes de MIPYMES, donde el tráfico puede variar sin seguir patrones estrictos. El sistema realiza una evaluación continua de las métricas de tráfico (tasa de paquetes, puertos únicos, información enviada, etc.) y puede detectar variaciones sutiles que escapen a reglas tradicionales. Por tanto, el sistema no solo identifica amenazas activas, sino también condiciones precursoras que podrían derivar en incidentes de seguridad.

A diferencia de SIEMs comerciales que requieren integraciones costosas o mantenimientos continuos, este sistema basado en herramientas open-source permite a las MIPYMES acceder a funcionalidades similares sin comprometer su presupuesto. Además, ofrece trazabilidad total gracias al registro automático de eventos, accesibles desde PostgreSQL y visualizables desde una GUI estilizada. Esta combinación de SIEM funcional, detección inteligente y respuesta inmediata, convierte a este sistema en una herramienta estratégica para entornos donde los recursos técnicos y humanos son limitados.

El software contempla escenarios de prueba físicos y simulados. Por ejemplo, uno de los escenarios evaluados consistió en la inyección de tráfico malicioso mediante ataques de escaneo de puertos (nmap), fuerza bruta SSH (hydra) y denegación de servicio (hping3) en un entorno virtual creado con Mininet. En este entorno, los resultados obtenidos reflejaron una detección exitosa en más del 90 % de los casos para Isolation Forest, manteniendo la tasa de falsos positivos por debajo del 8 %. En comparación, DBSCAN tuvo una mayor sensibilidad, pero también una mayor propensión a detectar falsos positivos, lo que en entornos reales puede derivar en acciones innecesarias o pérdida de confianza en el sistema [14][20].

Otro escenario fue el análisis de archivos de logs provenientes de un SIEM simulado con registros JSON. En este contexto, el sistema fue capaz de identificar patrones categóricos anómalos, como cambios inesperados en reglas de firewall, intentos de acceso fuera del horario habitual, y modificaciones sospechosas en la configuración de red. Para este caso, DBSCAN mostró mejor desempeño que los modelos lineales, aunque su precisión fue superada por Isolation Forest [12][17].

Isolation ForestPrecisiónRecallF1-ScoreSupport (logs analizados)
Normal0.771.000.87600
Anomalía1.000.130.24210
Accuracy0.78810
Macro avg0.880.570.55810
Weighted avg0.830.780.70810
Tabla 1. Resultados de Isolation Forest en el análisis de logs.

Una innovación adicional que se integró en la fase final del desarrollo fue la simulación de tráfico legítimo. Este componente permite generar escenarios normales controlados, como navegación web, consultas DNS, envío de correos o conexión a servidores internos, con el fin de evaluar el rendimiento del sistema ante comportamientos genuinos. Este tipo de validación fue fundamental para ajustar los umbrales de detección y reducir falsos positivos, un aspecto crítico para que el sistema pueda ser adoptado sin generar interrupciones innecesarias en las operaciones cotidianas de la empresa.

En términos de arquitectura, el sistema fue concebido para funcionar bajo un modelo distribuido. Esto significa que, aunque su núcleo puede ejecutarse en una Raspberry Pi, la solución puede extenderse fácilmente a través de una red de dispositivos que colaboren en la recolección y procesamiento de datos. Por ejemplo, en entornos donde la red se encuentra segmentada por departamentos o ubicaciones físicas, cada segmento podría tener su propio nodo de monitoreo, que luego consolida información hacia un servidor central de análisis.

Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software dentro de la red de la MIPYME
Figura 8. Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software en la red de la MIPYME.

Finalmente, uno de los puntos más valiosos del proyecto es su potencial para adaptarse a otros tipos de entornos. Aunque fue diseñado con las MIPYMES en mente, el sistema puede ser útil también en organizaciones no gubernamentales, centros educativos, o startups que requieran una solución de monitoreo de red sin tener que invertir en plataformas comerciales de alto costo. Su diseño modular y su base en herramientas open-source garantizan que pueda ser reutilizado, ampliado o personalizado según cada caso particular [8][15].

Este software de monitoreo representa mucho más que una simple herramienta de detección. Es una propuesta integral de defensa cibernética accesible, construida con visión académica, enfoque práctico y sensibilidad social. Combina lo mejor del aprendizaje automático con buenas prácticas en privacidad y seguridad, empleando recursos tecnológicos sostenibles y reutilizables. La experiencia obtenida durante su desarrollo no solo permitió validar su funcionalidad, sino que también generó conocimientos valiosos para futuros desarrollos de ciberseguridad en contextos similares. Este proyecto marca así un hito en la promoción de una cultura de ciberdefensa proactiva y descentralizada, especialmente en sectores tradicionalmente excluidos de las soluciones tecnológicas avanzadas.

Referencias

  1. Reglamento General de Protección de Datos (RGPD), available at https://eur-lex.europa.eu/
  2. “Incident Response & Computer Forensics, Third Edition” by K. Mandia, C. Prosise, and M. Pepe.
  3. G. Chandola, A. Banerjee, and V. Kumar, “Anomaly Detection: A Survey,” ACM Computing Surveys, vol. 41, no. 3, 2009.
  4. Scikit-learn Documentation, “Model Evaluation,” available at https://scikit-learn.org/stable/model_evaluation.html
  5. O’Reilly Media, “High Performance Spark: Best Practices for Scaling and Optimizing Apache Spark”.
  6. J. Reback et al., “Pandas: powerful Python data analysis toolkit,” available at https://pandas.pydata.org/
  7. Alla, Sridhar, and Suman Kalyan Adari. 2019, doi:10.1007/978-1-4842-5177-5
  8. Ageyev, Dmytro, et al. Lecture Notes on Data Engineering and Communications Technologies, 2022, pp. 287–305, doi:10.1007/978-3-030-95161-0_13
  9. Bency, J. (2017). Network based Anomaly Detection: An ensemble approach. In Dr. Dominic Carr, MSc Research Project [Thesis].
  10. Alaverronen, Sami, and Jussi Pohjola. “Pandas in Action: Analysis of China Related Advanced Persistent Threat Actors’ Tactics, Techniques & Procedures.” JYX, 1970, jyx.jyu.fi/handle/123456789/90108
  11. F. T. Liu, K. M. Ting and Z.-H. Zhou, “Isolation Forest,” 2008 Eighth IEEE International Conference on Data Mining, Pisa, Italy, 2008, pp. 413-422, doi: 10.1109/ICDM.2008.17
  12. M. H. Bhuyan, D. K. Bhattacharyya and J. K. Kalita, “Network Anomaly Detection: Methods, Systems and Tools,” in IEEE Communications Surveys & Tutorials, vol. 16, no. 1, pp. 303-336, First Quarter 2014, doi: 10.1109/SURV.2013.052213.00046
  13. Fei Tony Liu, Kai Ming Ting, and Zhi-Hua Zhou. 2012. Isolation-Based Anomaly Detection. ACM Trans. Knowl. Discov. Data 6, 1, Article 3 (March 2012), 39 pages. https://doi.org/10.1145/2133360.2133363
  14. A. B. Nassif, M. A. Talib, Q. Nasir and F. M. Dakalbab, “Machine learning for Anomaly Detection: A Systematic Review,” in IEEE Access, vol. 9, pp. 78658-78700, 2021, doi: 10.1109/ACCESS.2021.3083060
  15. Taeshik Shon, Jongsub Moon, A hybrid Machine learning approach to network anomaly detection, Information Sciences, Volume 177, Issue 18, 2007, ISSN 0020-0255, https://doi.org/10.1016/j.ins.2007.03.025
  16. Al-amri, Redhwan, et al. “A Review of Machine learning and Deep Learning Techniques for Anomaly Detection in IoT Data.” MDPI, Multidisciplinary Digital Publishing Institute, 8 June 2021, www.mdpi.com/2076-3417/11/12/5320
  17. Pajouh, H.H., Dastghaibyfard, G. & Hashemi, S. Two-tier network anomaly detection model: a Machine learning approach. J Intell Inf Syst 48, 61–74 (2017). https://doi.org/10.1007/s10844-015-0388-x
  18. Schölkopf, B., Platt, J., Shawe-Taylor, J., Smola, A. J., & Williamson, R. C. (2001). Estimating the support of a high-dimensional distribution. Neural Computation, 13(7), 1443-1471.
  19. Kavitha, R., & Kumaravel, N. (2020). Anomaly detection using deep autoencoders for cybersecurity applications. Journal of Information Security and Applications, 54, 102578.
  20. Ester, M., Kriegel, H. P., Sander, J., & Xu, X. (1996). A density-based algorithm for discovering clusters in large spatial databases with noise. Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD-96), 226–231.
  21. C. M. Bishop and N. M. Nasrabadi, Pattern Recognition and Machine Learning, vol. 4, no. 4, p. 738. New York: Springer, 2006.
  22. Internet Engineering Task Force (IETF), “The Transport Layer Security (TLS) Protocol Version 1.3,” RFC 8446, Aug. 2018.
  23. Python Software Foundation, “Python Language Reference,” https://docs.python.org/3/reference/index.html
  24. A. Orebaugh, G. Ramirez, and J. Beale, Wireshark & Ethereal Network Protocol Analyzer Toolkit, Syngress, 2007.
  25. K. Scarfone and P. Mell, “Guide to Intrusion Detection and Prevention Systems (IDPS),” NIST Special Publication 800-94, 2007.

Mapeo Autónomo en Entornos Industriales con Tecnología LiDAR: Una Respuesta a los Desafíos de Seguridad en el mundo de la Construcción

Dave Beon – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El problema de la seguridad en los entornos industriales siempre ha sido un reto constante durante la historia. Mucho más en áreas de construcción donde se está usando maquinaria pesada en terrenos irregulares, lo que genera riesgos para la integridad de los trabajadores, los cuales no se pueden ignorar. Esta situación, empeorada por baja visibilidad, polvo y condiciones climáticas cambiantes, motivó el desarrollo de una variedad de soluciones tecnológicas que no solo reducen los riesgos considerablemente, sino que también refuerzan los procesos de toma de decisiones. De este concepto nació: OBBOT, un robot autónomo capaz de mapear escenarios mediante tecnología LiDAR, desarrollado en la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la dirección del Ing. Jayro Martínez, como proyecto de grado del estudiante Dave Beon.

La iniciativa salió de la necesidad de optimizar la visualización en tiempo real en entornos laborales de alto riesgo. Ciertas soluciones convencionales, como cámaras y sensores ultrasónicos, han demostrado ser ineficaces ante condiciones operativas complejas. Con la tecnología LiDAR, junto con algoritmos SLAM y herramientas IoT, se pudo crear representaciones tridimensionales del ambiente en tiempo real, facilitando la detección de obstáculos y el monitoreo constante vía WebSocket de zonas de peligro. Este proyecto no solo representa un avance tecnológico, sino que también propone una alternativa efectiva y práctica para mejorar la seguridad laboral.

Las estadísticas de accidentes laborales en la industria de la construcción, citadas por la OIT (Organización Internacional del Trabajo), ponen en evidencia la gravedad de la problemática. Más allá de la pérdida humana, los accidentes son las causas de muchas interrupciones operativas, el aumento de costos y una disminución del bienestar de la fuerza laboral. En ese sentido, se vuelve primordial incorporar tecnologías inteligentes que permitan anticiparse a los riesgos. OBBOT responde a este fenómeno desde una visión integradora: un robot móvil, con percepción ambiental avanzada y comunicación en tiempo real hacia una plataforma (WebApp) centralizada accesible por los supervisores.

El diseño del robot se enfocó en tres ejes fundamentales: percepción precisa, navegación autónoma y conectividad eficiente. El prototipo integra un sensor LiDAR para la captura de los datos del ambiente, una arquitectura de procesamiento con ESP32 y un algoritmo SLAM que tiene el rol de autolocalización y de mapeo simultáneo. Además, se incorpora una unidad de medición inercial (IMU), la cual permite estimar la orientación del robot mediante acelerómetros y giroscopios, reforzando la precisión del sistema SLAM durante los desplazamientos y giros. La interfaz (WebSocket, WebApp) desarrollada en React y JavaScript, permite visualizar en tiempo real los mapas generados, brindando a los encargados de seguridad una herramienta visual poderosa y de fácil interpretación. A esto se le agrega una arquitectura IoT que facilita la transmisión continua de datos hacia el backend desarrollado en Node.js para análisis y monitoreo remoto.

Problemática y estado del arte

Los entornos industriales presentan una combinación de variables que dificultan la percepción del entorno en tiempo real, especialmente cuando las condiciones ambientales cambian rápidamente. La alta incidencia de accidentes laborales asociados al desconocimiento espacial inmediato ha sido ampliamente documentada por organismos como la OIT y estudios de seguridad ocupacional.

Las tecnologías tradicionales de monitoreo, como cámaras CCTV, sensores ultrasónicos o infrarrojos, tienen limitaciones frente a obstáculos no lineales, polvo, oscuridad o interferencias electromagnéticas. Por otro lado, los drones o soluciones aéreas pueden resultar ineficaces en espacios cerrados, además de costosos y difíciles de operar en tiempo continuo.

Frente a esto, el uso de sensores LiDAR se presenta como una alternativa robusta: permiten obtener datos de profundidad en alta resolución y en tiempo real, generando nubes de puntos que pueden ser transformadas en mapas del entorno. Sin embargo, el reto está en integrar esos datos con algoritmos eficientes de localización y navegación autónoma, como el SLAM (Simultaneous Localization and Mapping), y combinarlos con plataformas de bajo consumo energético y alta conectividad como el ESP32.

Estudios recientes han demostrado que los sistemas SLAM basados en LiDAR mejoran la autonomía de robots móviles en escenarios desconocidos [1][3][5]. No obstante, muchos de estos sistemas requieren potencias de cómputo elevadas o no integran adecuadamente la transmisión en tiempo real de los datos hacia plataformas externas, lo que limita su aplicación industrial.

Objetivos completados

Desarrollar este proyecto implementó un dispositivo autónomo de adquisición y visualización de datos utilizando tecnología LiDAR y algoritmos SLAM, IMU orientado a resolver los problemas de detección y monitoreo en entornos industriales complejos. El sistema integra una interfaz web intuitiva, conectividad IoT a través de un ESP32, y una arquitectura modular que permite mapeo en tiempo real, validando su utilidad en escenarios simulados y entornos semirreales con condiciones adversas.

Metodología

El diseño del sistema del OBBOT se fundamentó en una arquitectura modular. El sensor LiDAR y la IMU proporcionan datos de percepción del entorno y orientación del robot, los cuales son procesados por el ESP32. Este microcontrolador envía datos al servidor mediante Wi-Fi y WebSocket, donde luego son visualizados en una interfaz desarrollada en React y JavaScript. Simultáneamente, el ESP32 comunica instrucciones a la plataforma TI-RSLK, que coordina el movimiento del prototipo a través de motores y encoders. Esta segmentación funcional permite mejor escalabilidad, mantenimiento eficiente y respuesta en tiempo real.

Diagrama de arquitectura de OBBOT: sensores LiDAR e IMU, ESP32, plataforma TI-RSLK con encoders y ruedas, router Wi-Fi, servidor y página web
Figura 1. Diagrama de arquitectura del sistema OBBOT. Se muestra el flujo de datos desde los sensores LiDAR e IMU, a través del microcontrolador ESP32 y la plataforma TI-RSLK, hacia la interfaz web mediante WebSocket.

Resultados

Durante las pruebas, el sistema registró las posiciones relativas de los obstáculos detectados mediante el sensor LiDAR, generando tanto coordenadas cartesianas como un mapa de ocupación. Como se observa en las siguientes tablas y figuras, el sistema logró identificar y mapear objetos con una alta densidad de puntos, clasificando correctamente los espacios ocupados. La resolución espacial obtenida fue suficiente para construir mapas funcionales en tiempo real, lo que valida el uso del algoritmo SLAM y la precisión del sensor en condiciones simuladas.

PuntoX (mm)Y (mm)Distancia (mm)Ángulo (°)Calidad
132.7-620.64621.5273.0215
248.06-632.68634.5274.3415
362.41-644.49647.5275.5315
476.76-657.79662.25276.6615
591.8-671.76678.0277.7815
6109.79-684.75693.5279.1115
7126.21-697.93709.25280.2515
8143.48-713.21727.5281.3815
9903.47124.46912.07.8415
Tabla 1. Coordenadas captadas por el sensor LiDAR durante el proceso de mapeo.
Coordenadas (x,y)OcupadoLibre
141, -5210
142, -4510
142, -4210
144, -3910
144, -3510
144, -2910
Tabla 2. Fragmento del mapa de ocupación generado por el sistema.
Interfaz web de OBBOT con el lienzo del mapa, los datos del sensor IMU y los controles SLAM
Figura 2. Interfaz web del sistema OBBOT. Se muestra el panel de control SLAM con opciones de mapeo, calibración de sensores y visualización en tiempo real de los datos del sensor IMU.

Conclusión

OBBOT no solo representa un avance en la aplicación de tecnologías como LiDAR, SLAM e IoT en entornos industriales, sino que propone una ruta clara hacia la construcción de espacios laborales más seguros e inteligentes. Los resultados obtenidos en los entornos simulados validan la viabilidad técnica del sistema y su impacto potencial en la prevención de accidentes laborales. La arquitectura modular del sistema, junto con la visualización en tiempo real, facilita la adopción de este tipo de soluciones en industrias de alto riesgo.

A futuro, se planea escalar el prototipo para integrarlo con sistemas de gestión industrial, mejorar la precisión del mapeo SLAM e incorporar visión artificial para la identificación avanzada de elementos en el entorno. El proyecto deja abiertas múltiples posibilidades de evolución tecnológica y adaptación a otros dominios como la minería, logística o respuesta a emergencias.

Referencias

  1. T. Chen, F. Pu, H. Chen y Z. Liu, “WHUVID: A Large-Scale Stereo-IMU Dataset for Visual-Inertial Odometry and Autonomous Driving in Chinese Urban Scenarios,” Remote Sensing, vol. 14, 2022.
  2. D. Lee, S. Lee, P. Choi y D. Park, “Accuracy–Power Controllable LiDAR Sensor System with 3D Object Recognition for Autonomous Vehicle,” Sensors, p. 5706, 2020.
  3. X. Xu et al., “A Review of Multi-Sensor Fusion SLAM Systems Based on 3D LIDAR,” Remote Sensing, p. 2835, 2022.
  4. A. Patron-Perez, S. Lovegrove y G. Sibley, “A Spline-Based Trajectory Representation for Sensor Fusion and Rolling Shutter Cameras,” Int. J. Comput. Vis., pp. 208–219, 2015.
  5. S. H. Abdulredah y D. J. Kadhim, “Developing a real time navigation for mobile robots at unknown environments,” Indones. J. Electr. Eng. Comput. Sci., pp. 500–509, 2020.
  6. Embedded Systems Design with the Texas Instruments MSP432 32-bit Processor, Morgan & Claypool, 2017.
  7. P.-Y. Lajoie et al., “Modeling Perceptual Aliasing in SLAM via Discrete-Continuous Graphical Models.”
  8. A. Al-Hourani y B. Ristic, “MapperBot/iSCAN: open-source integrated robotic platform and algorithm for 2D mapping,” Int. J. Intell. Robot. Appl., pp. 44–56, 2020.
  9. S. Ceriani et al., “Pose Interpolation SLAM for large maps using moving 3D Sensors,” Int. Conf. Intell. Robots Syst., pp. 750–757, 2015.
  10. K. Narang, M. S. Kaushal y M. A. Gambhir, “Realtime Covid19 Tracker Using React,” Int. J. Innov. Res. Comput. Sci. Technol., vol. 8, no. 3, pp. 2347–5552, 2020.
  11. M. Mihálik et al., “The New Method of Active SLAM for Mapping Using LiDAR,” Electronics, p. 1082, 2022.

Sistema de Administración para Redes LAN mediante Software Especializado


Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

La administración de redes LAN es fundamental para asegurar la conectividad y el rendimiento de una infraestructura de red eficiente en organizaciones de todos los tamaños. Las redes LAN (Local Area Network) son esenciales para la interconexión de dispositivos en un área local, permitiendo la transmisión de datos y la utilización de recursos compartidos como servidores, impresoras e Internet. Sin embargo, la gestión de estas redes puede resultar compleja, debido a la necesidad de mantener un control sobre el tráfico, los dispositivos conectados y garantizar la seguridad de la red. Es aquí donde entra en juego el software especializado para la administración de redes LAN, que permite optimizar la gestión de estas redes, mejorando su rendimiento y seguridad.


El propósito de este informe es analizar las principales funcionalidades del software de administración para redes LAN, con énfasis en sus herramientas de monitoreo, diagnóstico y seguridad.

Contexto

Las redes LAN son una parte crítica de la infraestructura de TI en empresas, universidades y hogares. Sin embargo, los administradores de redes se enfrentan a varios desafíos, como la gestión del tráfico, la asignación de direcciones IP y la seguridad de los dispositivos conectados. En muchos casos, las redes LAN pueden experimentar lentitud, congestión o fallas de seguridad debido a una administración deficiente. Para abordar estos problemas, los administradores de red deben contar con herramientas adecuadas que les permitan realizar un monitoreo constante, diagnósticos precisos y mantener altos niveles de seguridad.


Proyectos Relacionados

Existen múltiples investigaciones y desarrollos que han permitido avanzar en la administración eficiente de redes LAN. Por ejemplo, en un estudio realizado por Kurose y Ross (2017), se exploraron diversas técnicas de administración de tráfico y calidad de servicio (QoS) en redes LAN, donde se destacó la importancia del uso de software para automatizar tareas repetitivas y mejorar la gestión del ancho de banda.

Otro estudio relevante fue realizado por Comer (2018), quien explicó cómo el uso de sistemas de monitoreo inteligente, como Wireshark y NetFlow, puede facilitar la detección temprana de problemas de red, como congestión de tráfico o dispositivos comprometidos.

Solución Propuesta

La solución propuesta es un software especializado para la administración de redes LAN que integre funcionalidades de monitoreo, gestión de tráfico, y seguridad en tiempo real. Este software permite a los administradores gestionar los dispositivos de la red, monitorear el rendimiento y detectar posibles fallos o brechas de seguridad de manera eficiente.

El software utilizaría un panel de administración intuitivo, donde se podrán visualizar métricas como el uso del ancho de banda, la conectividad de dispositivos, el estado de los routers y switches, y alertas sobre cualquier anomalía en la red.

El sistema también incluiría herramientas de diagnóstico, como ping, traceroute, y monitoreo de tráfico de red, que permiten verificar el estado de la red y detectar problemas en tiempo real.


Metodología

El software de administración de redes LAN propuesto será implementado en tres fases principales:

Monitoreo de la Red: Utilizando herramientas como Wireshark y NetFlow, el sistema puede capturar y analizar el tráfico de la red. Estas herramientas permiten identificar patrones de tráfico, posibles cuellos de botella y dispositivos que consumen excesivo ancho de banda.

Gestión de Dispositivos: El software permitirá a los administradores gestionar dispositivos de red, como routers y switches, asignar direcciones IP automáticamente mediante DHCP, y configurar VLANs para segmentar el tráfico de red.

Seguridad y Control de Accesos: A través de la integración de sistemas de seguridad, como firewalls y autenticación de dispositivos mediante 802.1X, el software protegerá la red contra accesos no autorizados y amenazas externas.


Resultados Obtenidos

El software propuesto ha demostrado ser efectivo en el monitoreo y gestión de redes LAN en pruebas piloto realizadas en una red corporativa de tamaño medio. Los resultados muestran que:

Mejor rendimiento de la red: La implementación de herramientas de monitoreo y gestión de tráfico permitió reducir significativamente la congestión de la red y mejorar la velocidad de transferencia de datos.

Mayor seguridad: La integración de sistemas de control de acceso y monitoreo de seguridad redujo las amenazas de intrusión y los accesos no autorizados.

Optimización de recursos: El software facilitó la gestión de dispositivos y la configuración de la red, reduciendo la necesidad de intervención manual y mejorando la eficiencia operativa.

Conclusiones

El desarrollo de software especializado para la administración de redes LAN ha demostrado ser una solución efectiva para mejorar la eficiencia, el rendimiento y la seguridad de las redes locales. La implementación de herramientas de monitoreo, gestión de dispositivos y seguridad ha permitido optimizar la operación de la red, reduciendo problemas como la congestión de tráfico, los accesos no autorizados y las fallas de conectividad.

Este software ofrece una solución integral para la administración de redes LAN, que puede ser aplicada tanto en pequeñas redes locales como en infraestructuras de red más complejas de grandes organizaciones.

Recomendaciones

Para mejorar aún más la efectividad del software, se recomienda la incorporación de las siguientes funciones:

Integración con plataformas de gestión de TI: Esto permitirá que el software se integre con otras herramientas de administración de infraestructura y optimice el flujo de trabajo.

Automatización avanzada: Implementar capacidades adicionales de automatización para realizar ajustes en tiempo real basados en el análisis de tráfico y rendimiento de la red.

Soporte para redes más grandes: Ampliar las capacidades del software para admitir redes LAN más grandes y complejas, asegurando que la solución sea escalable y flexible.


Referencias

  • [1] Comer, D. E. (2018). Computer Networks and Internets (6ª ed.). Pearson Education.

  • [2] Kurose, J. F., & Ross, K. W. (2017). Computer Networking: A Top-Down Approach (7ª ed.). Pearson Education.

  • [3] Tanenbaum, A. S. (2011). Computer Networks (5ª ed.). Pearson Education.

  • [4] Rosen, D. (2020). Network Automation: Architecture, Design, and Implementation. Wiley.