SIGA: Una solución inteligente para la gestión del agua en viviendas dominicanas

Scarlett Betania Rodríguez Bravo y Alam Emilio Cordero – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La urgencia de modernizar la gestión del agua: un reto global y nacional

La gestión eficiente del agua constituye uno de los principales desafíos para el desarrollo sostenible debido al crecimiento de la población, el aumento del consumo y los efectos asociados al cambio climático [2]. La disponibilidad del recurso no depende únicamente de la existencia de fuentes naturales, sino también de la capacidad de administrarlas responsablemente, reducir las pérdidas y aprovechar fuentes alternativas. Esta situación ha impulsado el desarrollo de estrategias orientadas a modernizar los procesos de almacenamiento, distribución y consumo mediante tecnologías capaces de proporcionar información en tiempo real y facilitar una gestión basada en datos.

A esta problemática se suma la necesidad de considerar la relación entre el desarrollo tecnológico y el medio ambiente. Desde la perspectiva de la ecología humana, se plantea que las acciones y desarrollos humanos deben analizarse considerando su interacción con el entorno natural [3]. Bajo este enfoque, la tecnología puede representar un desafío cuando sus efectos ambientales no son considerados, pero también puede convertirse en una herramienta para favorecer el aprovechamiento responsable de los recursos naturales. En el ámbito hídrico, esto implica desarrollar soluciones que, además de automatizar procesos, contribuyan a reducir el desperdicio, aprovechar fuentes alternativas y promover una gestión sostenible del agua.

En la República Dominicana, esta necesidad adquiere especial importancia debido a las deficiencias existentes en la administración y distribución del recurso hídrico. A pesar de iniciativas como el Compromiso Nacional para un Pacto por el Agua 2021-2036, investigaciones han señalado problemas relacionados con la gestión de los consumos y las pérdidas en las redes de distribución, factores que pueden comprometer la sostenibilidad hídrica del país a largo plazo [1]. En numerosos hogares y establecimientos, además, la administración del agua almacenada continúa realizándose de manera manual, dificultando conocer con precisión la cantidad disponible, el consumo realizado y las condiciones de las diferentes fuentes de abastecimiento.

Otro aspecto relevante es el limitado aprovechamiento del agua de lluvia como fuente complementaria. La captación pluvial puede utilizarse para determinadas actividades secundarias, como limpieza o riego, reduciendo el uso innecesario del suministro público. Sin embargo, su incorporación requiere mecanismos capaces de conocer la disponibilidad del recurso y determinar cuándo resulta conveniente utilizar una fuente u otra. La ausencia de esta integración limita las posibilidades de administrar de manera conjunta el suministro público, el almacenamiento y la captación pluvial.

Frente a estas necesidades, diferentes investigaciones han explorado la automatización como alternativa para mejorar la gestión hídrica. Sharma [4], por ejemplo, propuso un sistema basado en Arduino orientado a la recolección, almacenamiento y distribución automática del agua de lluvia. Asimismo, sistemas de supervisión como SCADA permiten monitorear variables hidráulicas, detectar determinadas condiciones anormales y mejorar el control de procesos relacionados con el agua [5]. Estos antecedentes evidencian el potencial de integrar electrónica, comunicaciones y automatización para responder a problemas relacionados con la administración del recurso.

Dentro de este contexto, el Internet de las Cosas (IoT) proporciona herramientas que permiten conectar sensores, actuadores, microcontroladores y plataformas digitales para recopilar información y ejecutar acciones de manera automatizada. Variables como el nivel de almacenamiento, la presión y el caudal pueden ser supervisadas continuamente, mientras que protocolos de comunicación como MQTT permiten transmitir los datos entre dispositivos y sistemas de gestión. Microcontroladores como el ESP32 facilitan además la implementación de estas arquitecturas mediante capacidades de procesamiento y conectividad inalámbrica.

A partir de esta problemática surge el Sistema Inteligente de Gestión del Agua (SIGA), desarrollado por Scarlett Betania Rodríguez Bravo y Alam Emilio Cordero, estudiantes de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del Ing. Víctor Manuel Mancebo de León. El proyecto propone integrar diferentes fuentes de suministro de agua mediante una arquitectura IoT compuesta por sensores, actuadores, microcontroladores y una plataforma digital, con el propósito de monitorear las condiciones del sistema y gestionar el recurso de manera automatizada.

SIGA integra el suministro público y la captación pluvial mediante una lógica de control que permite tomar decisiones según la disponibilidad y las condiciones detectadas. El sistema monitorea variables como nivel, presión, caudal y consumo, establece comunicación en tiempo real entre los dispositivos, el servidor y la plataforma de gestión, y proporciona al usuario herramientas para visualizar el comportamiento de la infraestructura y configurar sus parámetros operativos. Además, incorpora información histórica y meteorológica como apoyo para el análisis y la gestión del recurso.

De esta manera, SIGA no se limita a automatizar una infraestructura hidráulica, sino que busca utilizar la tecnología como una herramienta para responder simultáneamente a una necesidad práctica y ambiental. El aprovechamiento del agua de lluvia, la supervisión del consumo, la detección de condiciones anormales y la gestión automatizada de las fuentes buscan contribuir a la reducción del desperdicio y a un uso más responsable del agua. El proyecto demuestra así cómo la integración de hardware, software y telecomunicaciones puede aplicarse al desarrollo de soluciones orientadas hacia una gestión hídrica más eficiente y sostenible.

Finalmente, la propuesta constituye un prototipo funcional que puede servir como referencia para futuras implementaciones en hogares, instituciones educativas, comercios y otros establecimientos que dispongan de sistemas de almacenamiento y distribución de agua. Aunque una implementación a mayor escala requiere adaptar la infraestructura hidráulica y dimensionar adecuadamente sus componentes, SIGA presenta un modelo tecnológico que evidencia el potencial del IoT para contribuir al desarrollo de edificaciones y ciudades inteligentes, utilizando la innovación tecnológica no solo para automatizar procesos, sino también para favorecer una relación más responsable con los recursos naturales.

Desconexión estructural: problemática en la gestión hídrica y límites del estado del arte

A pesar de los avances tecnológicos en el sector hídrico, la gestión del agua en viviendas y pequeños establecimientos continúa realizándose, en muchos casos, mediante mecanismos manuales o sistemas de automatización básicos que ofrecen escasa información sobre el estado del recurso. Esta situación dificulta conocer en tiempo real el nivel de almacenamiento, el consumo de agua y las condiciones de operación del sistema, limitando la capacidad de prevenir desperdicios y optimizar el uso de fuentes alternativas como la captación de agua de lluvia [1], [5].

En la República Dominicana, esta realidad se acentúa debido a las variaciones en el suministro de agua potable y a la dependencia de depósitos de almacenamiento para garantizar la disponibilidad del servicio. Aunque el agua de lluvia representa un recurso con un importante potencial de aprovechamiento, en la mayoría de las edificaciones no existen mecanismos que permitan administrarla de forma automática junto con la red pública. Como resultado, el agua potable continúa utilizándose en actividades que no requieren calidad para consumo humano, como el riego de jardines, la limpieza de patios o el lavado de vehículos, reduciendo la eficiencia en el aprovechamiento del recurso [5], [6].

La falta de monitoreo también dificulta la detección temprana de fugas, fallos en bombas o problemas de abastecimiento. En muchos casos, los usuarios desconocen el estado real de sus reservas de agua hasta que ocurre una interrupción del servicio o se presenta una avería en el sistema hidráulico. La ausencia de información en tiempo real limita la toma de decisiones y favorece el desperdicio de agua y energía, especialmente en instalaciones donde el llenado y el cambio entre fuentes de suministro continúan dependiendo de la intervención humana [1].

Además de afectar la disponibilidad del recurso, esta forma tradicional de administración incrementa la dependencia de la supervisión constante por parte del usuario. Es frecuente que las personas deban verificar manualmente el nivel de los depósitos, activar bombas de agua o cambiar el suministro entre distintas fuentes según su experiencia o percepción del estado del sistema. Estas actividades, aunque sencillas, pueden provocar errores humanos que derivan en reboses de depósitos, funcionamiento en seco de las bombas, consumo innecesario de energía eléctrica o interrupciones inesperadas en el abastecimiento. La automatización de estos procesos representa una oportunidad para mejorar tanto la eficiencia operativa como la comodidad del usuario final.

Por otra parte, el crecimiento de las tecnologías inteligentes ha impulsado una transformación significativa en la forma en que se diseñan los sistemas de monitoreo y control. La disponibilidad de sensores electrónicos de bajo costo, redes inalámbricas y plataformas de desarrollo abiertas ha permitido que soluciones anteriormente reservadas para aplicaciones industriales puedan implementarse también en viviendas y pequeñas empresas. Este cambio ha favorecido el desarrollo de sistemas IoT capaces de recopilar información continuamente y transmitirla a plataformas digitales para facilitar la supervisión remota y la toma de decisiones basada en datos [1], [2].

Diversas investigaciones han demostrado que el Internet de las Cosas constituye una alternativa viable para modernizar la gestión hídrica mediante el uso de sensores, actuadores y plataformas de monitoreo remoto. Sistemas basados en ESP32, Arduino y protocolos de comunicación ligeros como MQTT permiten supervisar variables hidráulicas y automatizar procesos de forma más eficiente que los mecanismos tradicionales, además de ofrecer acceso remoto a la información del sistema [1], [2], [3], [6].

La literatura científica también destaca la importancia de utilizar arquitecturas de comunicación ligeras y escalables para garantizar el intercambio eficiente de información entre dispositivos conectados. Protocolos como MQTT han demostrado ofrecer un excelente desempeño en aplicaciones donde múltiples sensores deben transmitir información de forma continua utilizando un ancho de banda reducido. Asimismo, el empleo de plataformas de desarrollo modernas facilita la integración entre el hardware instalado en campo y aplicaciones web o móviles que permiten visualizar el estado del sistema desde cualquier ubicación con acceso autorizado [2], [3].

En cuanto a la instrumentación, los avances recientes han permitido incorporar sensores de nivel, presión y caudal con mayor precisión y confiabilidad, ampliando considerablemente las posibilidades de supervisión. La combinación de estas variables proporciona una visión más completa del comportamiento hidráulico del sistema, permitiendo identificar anomalías operativas, verificar el correcto funcionamiento de bombas y válvulas, y conocer el consumo de agua con un mayor nivel de detalle. La integración de múltiples sensores también incrementa la confiabilidad de la información obtenida, ya que permite validar el comportamiento del sistema a partir de diferentes mediciones físicas [4].

Sin embargo, gran parte de las soluciones reportadas en la literatura se enfocan únicamente en la supervisión del nivel del agua o en la automatización del llenado de depósitos, sin integrar múltiples variables hidráulicas dentro de un mismo sistema de decisión. Asimismo, muchos desarrollos funcionan como prototipos experimentales y no incorporan una plataforma de monitoreo integral que permita visualizar el estado del sistema, generar alertas y facilitar la interacción del usuario con la infraestructura instalada [1], [2].

De igual forma, numerosas soluciones existentes fueron diseñadas para resolver problemas específicos y presentan limitaciones cuando se pretende ampliar sus funcionalidades. Algunos sistemas carecen de interfaces gráficas que faciliten la interpretación de los datos por parte del usuario, mientras que otros no permiten integrar nuevas fuentes de información ni modificar fácilmente las reglas de operación. Esta falta de flexibilidad dificulta su adaptación a distintos escenarios de uso y limita su aplicación en proyectos de mayor alcance orientados a la gestión inteligente del agua.

En este contexto, surge la necesidad de desarrollar una solución que combine monitoreo en tiempo real, automatización, conectividad y facilidad de uso dentro de una arquitectura de bajo costo y adaptable a entornos residenciales. El proyecto SIGA responde a esta necesidad mediante la integración de sensores, dispositivos de control, comunicaciones IoT y una plataforma web que permite administrar de forma inteligente el uso del agua proveniente tanto de la red pública como de la captación pluvial, contribuyendo a una gestión más eficiente y sostenible del recurso hídrico [1], [2], [5].

Más allá del desarrollo de un prototipo funcional, SIGA busca demostrar que la integración de tecnologías ampliamente disponibles puede convertirse en una alternativa viable para promover un uso más racional del agua en el contexto dominicano. La combinación de monitoreo continuo, automatización de procesos y visualización de información en tiempo real proporciona a los usuarios herramientas que favorecen una administración más eficiente del recurso, reducen la dependencia de operaciones manuales y contribuyen a la adopción de prácticas sostenibles. De esta manera, el proyecto se posiciona como una propuesta que integra los avances reportados en la literatura con las necesidades específicas de los hogares y pequeñas edificaciones, ofreciendo una solución tecnológica adaptable, escalable y orientada a mejorar la gestión hídrica mediante el uso del Internet de las Cosas.

Objetivos completados

El desarrollo del Sistema Inteligente de Gestión del Agua (SIGA) permitió cumplir el objetivo general de diseñar e implementar una solución inteligente orientada a optimizar la administración del agua en entornos residenciales mediante la integración de tecnologías de Internet de las Cosas (IoT), automatización y monitoreo en tiempo real. Este objetivo respondió a la necesidad de ofrecer una alternativa tecnológica que permitiera mejorar el aprovechamiento del recurso hídrico, reducir la dependencia de procesos manuales y facilitar la toma de decisiones relacionadas con el abastecimiento de agua. Para alcanzar este propósito se diseñó e implementó una infraestructura instrumentada con sensores ultrasónicos para la medición del nivel de agua, sensores de presión para supervisar las condiciones de suministro, caudalímetros para registrar el flujo de agua, válvulas solenoides para controlar automáticamente la distribución entre las diferentes fuentes y bombas de agua controladas mediante microcontroladores ESP32, permitiendo la integración de todos los dispositivos dentro de una misma arquitectura inteligente. Asimismo, se desarrolló una lógica de control encargada de gestionar automáticamente la conmutación entre la red pública y el sistema de captación pluvial de acuerdo con las condiciones detectadas por los sensores, priorizando la utilización del agua almacenada cuando las condiciones del sistema lo permitieran y garantizando la continuidad del suministro cuando fuera necesario recurrir al acueducto. De igual manera, se implementó una arquitectura de comunicaciones basada en el protocolo MQTT para la transmisión eficiente de información entre los dispositivos IoT y la plataforma de monitoreo, permitiendo la actualización continua de las variables hidráulicas y facilitando la supervisión remota del sistema. Como complemento, se desarrolló una plataforma web que permite visualizar en tiempo real el nivel de los depósitos, el estado de los dispositivos, los valores registrados por los sensores y las principales variables hidráulicas, además de ofrecer herramientas para la administración del sistema y la generación de notificaciones ante eventos relevantes. La integración de estos componentes permitió validar el funcionamiento del prototipo bajo diferentes escenarios de operación, demostrando que es posible implementar una solución de bajo costo, escalable y adaptable para optimizar la gestión del agua en viviendas y pequeñas edificaciones. En conjunto, los objetivos específicos alcanzados evidencian la viabilidad técnica de combinar automatización, comunicaciones inalámbricas y monitoreo inteligente en una única plataforma capaz de contribuir al uso más eficiente del recurso hídrico y de servir como base para futuras investigaciones y desarrollos orientados a la construcción de infraestructuras residenciales más sostenibles e inteligentes.
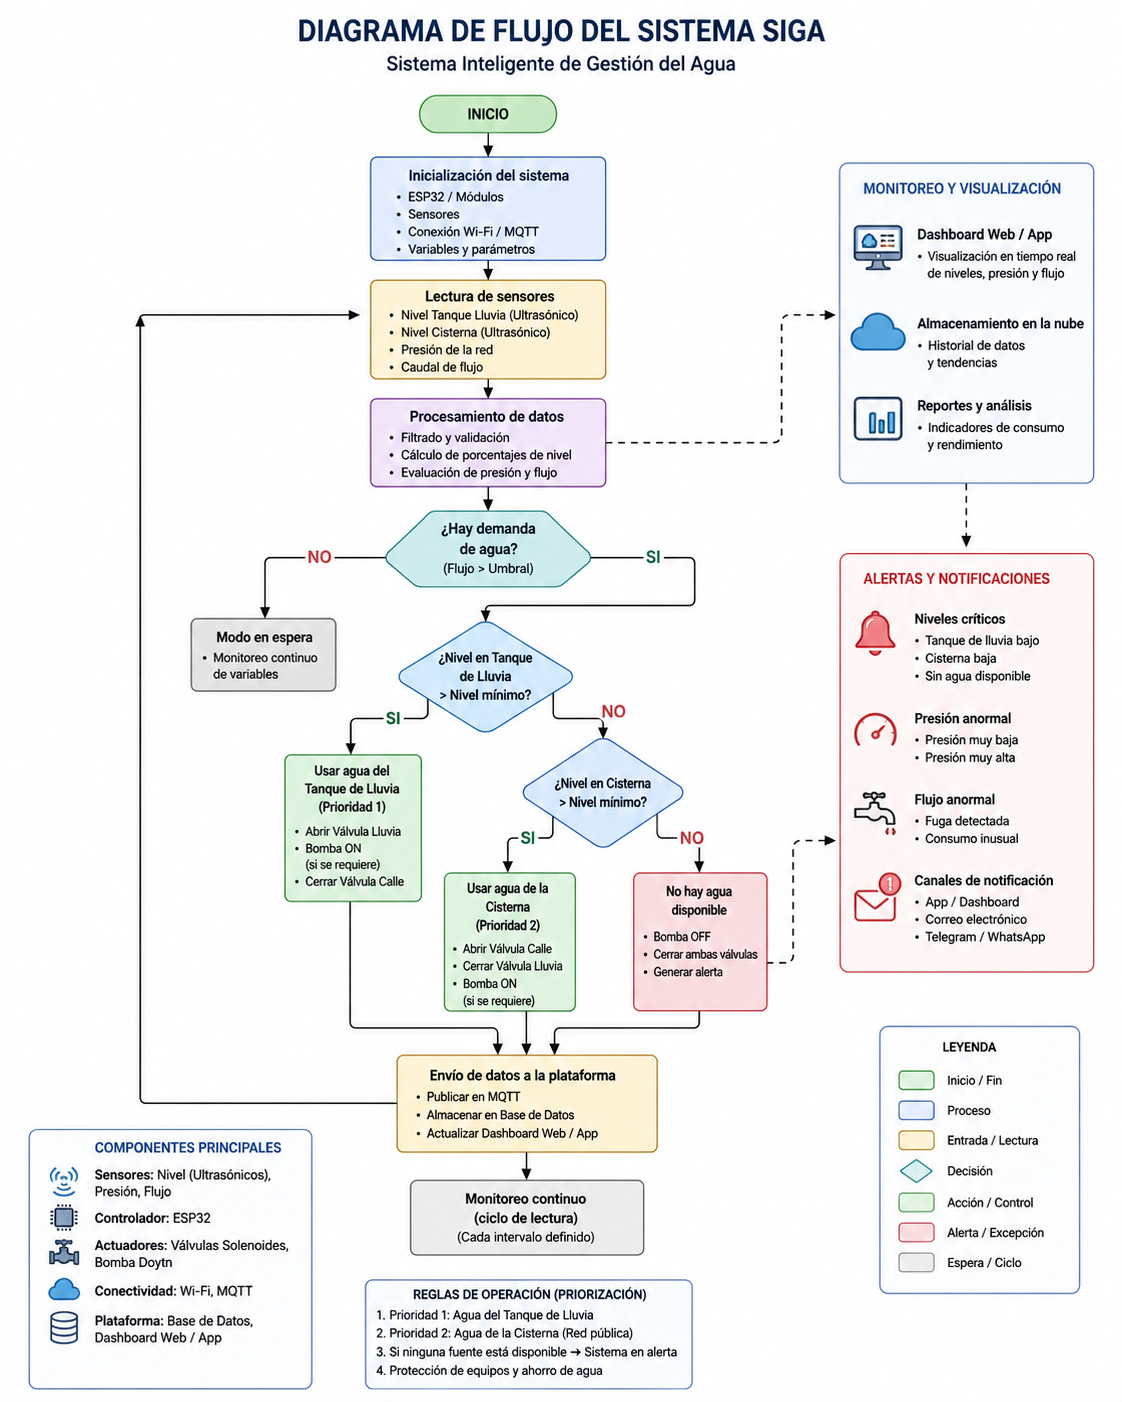
Diagrama de flujo del sistema SIGA: lectura de sensores, decisión entre tanque de lluvia y cisterna, envío de datos y alertas
Figura 1. Diagrama de funcionamiento.

Metodología y arquitectura técnica: hardware en el borde y lógica algorítmica

La construcción del sistema SIGA se desarrolló siguiendo una metodología de trabajo organizada por etapas, lo que permitió avanzar de manera progresiva en el diseño, la integración y las pruebas de cada uno de sus componentes. Este enfoque facilitó realizar mejoras continuas durante el desarrollo, corrigiendo errores y agregando nuevas funciones conforme el sistema evolucionaba. Gracias a ello, fue posible obtener una solución más estable y adaptada a las necesidades planteadas desde el inicio del proyecto.
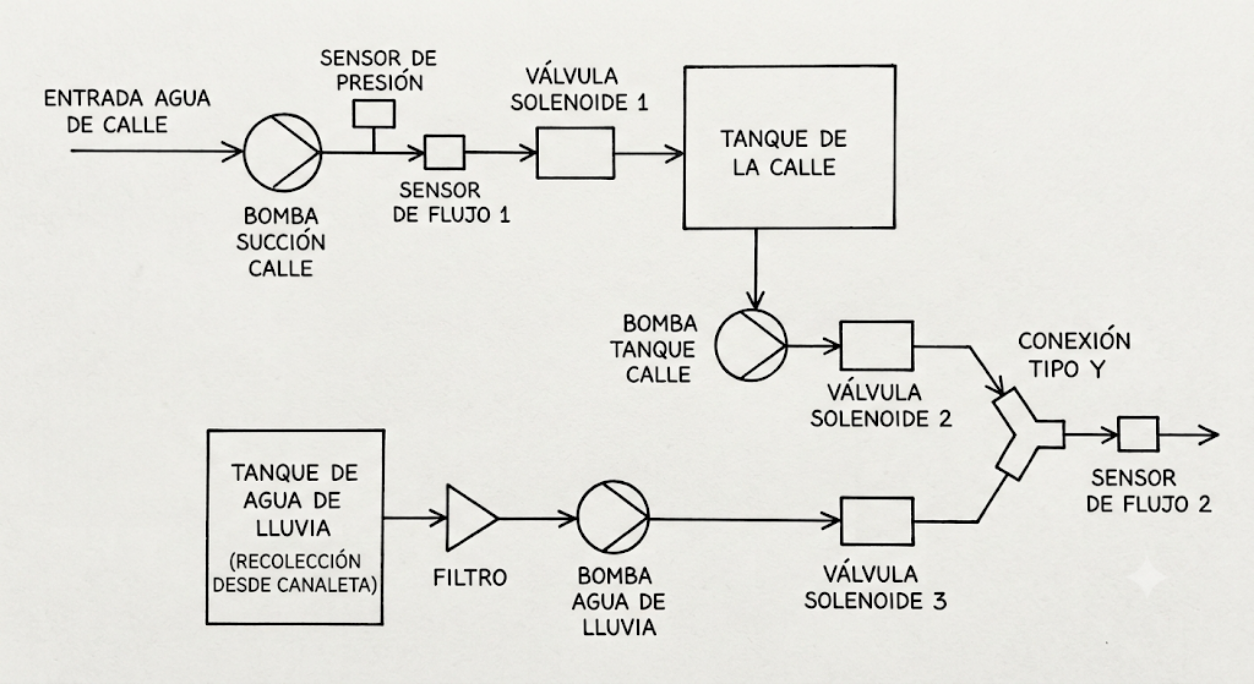
Diagrama hidráulico: bombas, sensores de presión y flujo, válvulas solenoides, tanque de la calle y tanque de agua de lluvia
Figura 2. Arquitectura del sistema.

El sistema fue diseñado para supervisar de forma constante el estado de los depósitos de agua mediante sensores que permiten conocer el nivel disponible sin necesidad de contacto directo. Esta mejora sustituyó métodos tradicionales que presentaban limitaciones por desgaste o menor precisión con el paso del tiempo. De esta manera, se obtuvo un monitoreo más confiable y con menor necesidad de mantenimiento, contribuyendo a una mejor administración del recurso hídrico.

Además del nivel del agua, SIGA también registra información relacionada con el flujo y la presión del suministro. Estos datos permiten identificar situaciones como una disminución en el abastecimiento, un consumo fuera de lo habitual o posibles fallas en la distribución. Al disponer de esta información en tiempo real, el sistema puede tomar decisiones más acertadas para garantizar la continuidad del servicio y optimizar el uso del agua.
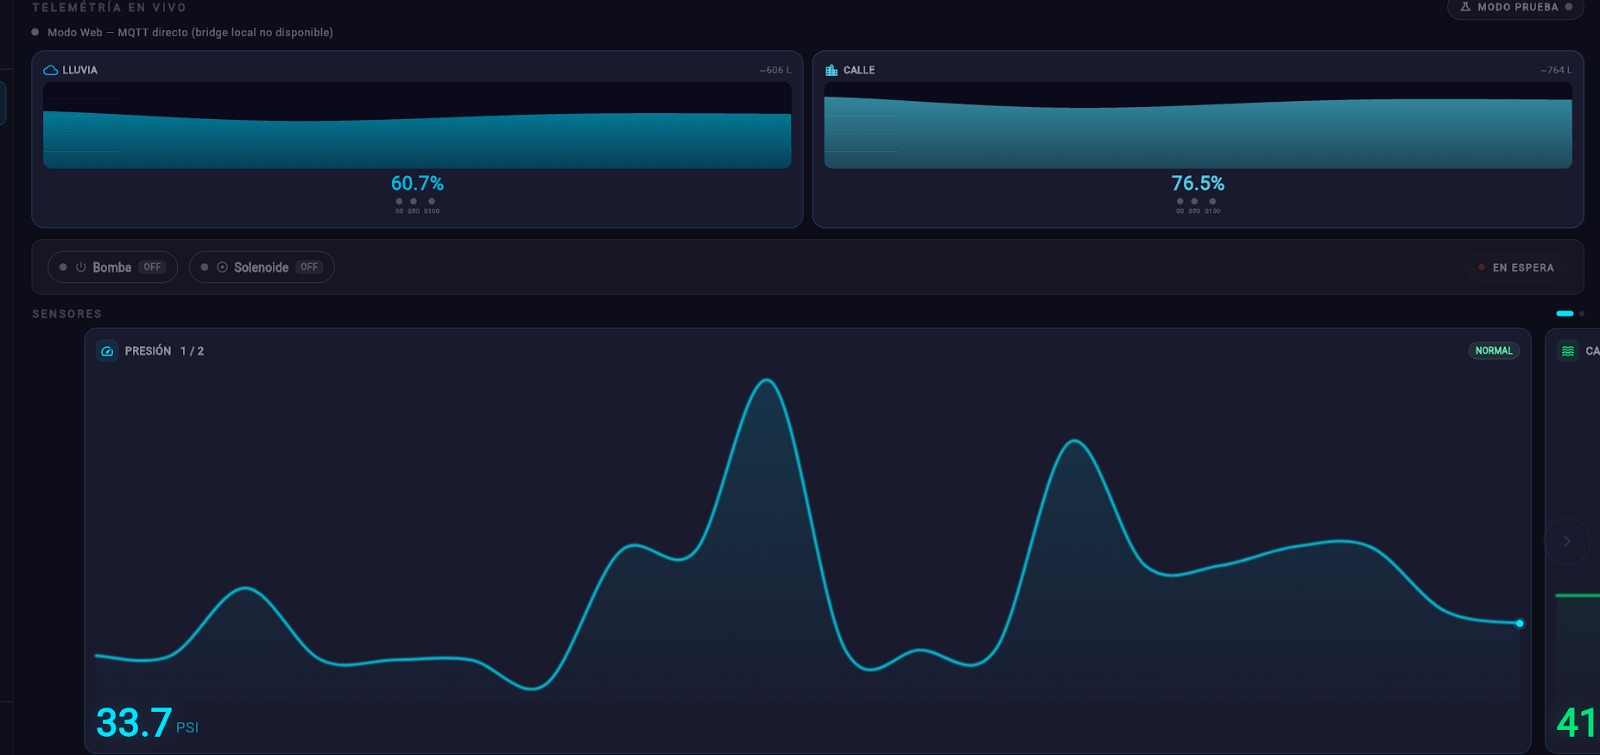
Dashboard web con el nivel de los tanques de lluvia y calle, estado de bomba y solenoide y gráfica de presión
Figura 3. Dashboard de la web.

Para controlar el paso del agua entre las diferentes fuentes de abastecimiento, el sistema incorpora válvulas y bombas que se activan automáticamente cuando las condiciones lo requieren. Este funcionamiento evita la intervención constante del usuario y permite que el cambio entre las distintas fuentes se realice de manera ordenada y segura. Asimismo, se implementaron mecanismos de protección para asegurar el funcionamiento continuo de los equipos y prolongar su vida útil.
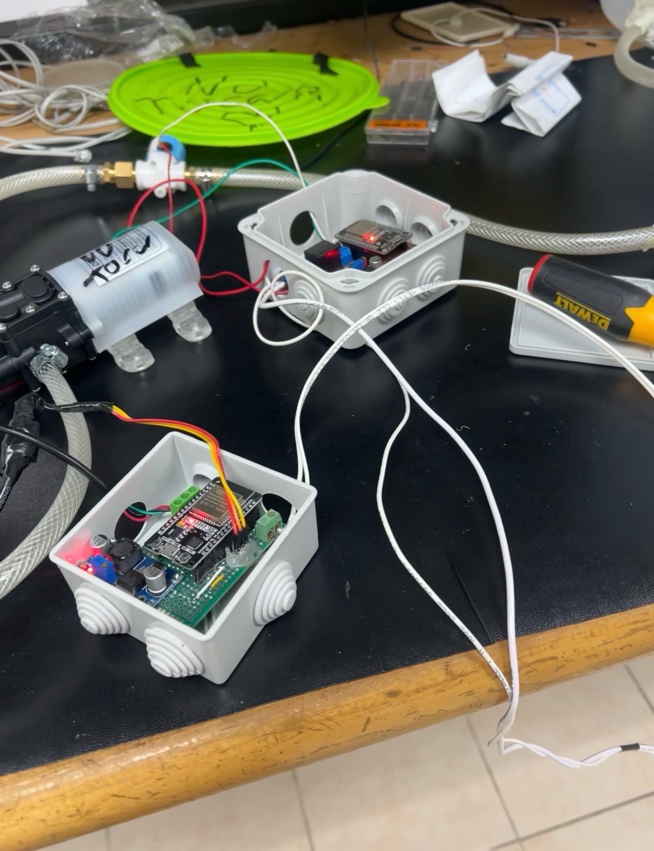
Prototipo: cajas de conexión con ESP32 y placas de control junto a una bomba de agua y mangueras
Figura 4. Circuitos protegidos de la bomba y la válvula.

Todos los dispositivos del sistema se encuentran conectados entre sí y envían la información recopilada hacia un servidor central, donde los datos son organizados y procesados. Esta comunicación permite que el estado del sistema esté disponible en todo momento y que las acciones necesarias puedan ejecutarse de forma rápida cuando se detecta algún cambio importante [3].

La información recopilada también se almacena para mantener un historial del comportamiento del sistema. Este registro facilita consultar el consumo de agua, revisar eventos anteriores y analizar el funcionamiento general de la instalación. Además, los usuarios pueden acceder a esta información desde una aplicación web o móvil, donde es posible visualizar el estado del sistema de forma sencilla y en tiempo real [6].

Uno de los aspectos más innovadores de SIGA es su capacidad para tomar decisiones automáticamente a partir de la información que recibe. En lugar de limitarse únicamente a mostrar datos, el sistema analiza las condiciones existentes y determina cuándo utilizar cada fuente de agua, cuándo activar las bombas y cuándo generar alertas para el usuario. Esta característica reduce el desperdicio de agua y mejora la eficiencia del proceso de distribución.

Como complemento, el sistema considera el comportamiento histórico del consumo para adaptar su funcionamiento con el paso del tiempo. También consulta información sobre las condiciones climáticas para anticipar posibles lluvias y recomendar estrategias que permitan aprovechar mejor el agua disponible. Esta capacidad de adaptación representa una diferencia importante respecto a los sistemas convencionales, ya que convierte a SIGA en una herramienta que no solo supervisa el recurso hídrico, sino que también contribuye a una gestión más eficiente, preventiva e inteligente del agua.

Resultados

Con el objetivo de validar el funcionamiento del Sistema Inteligente de Gestión del Agua (SIGA), se realizaron diferentes pruebas en un prototipo instalado en un ambiente controlado que simuló el funcionamiento de una vivienda. Durante estas pruebas se evaluó el monitoreo del nivel de agua, el cambio automático entre las fuentes de abastecimiento, el envío de alertas, el registro de información y el funcionamiento de la plataforma web.

Los resultados obtenidos demostraron que el sistema cumplió con los objetivos planteados durante el desarrollo. Los sensores registraron correctamente el nivel de agua de ambas cisternas, mientras que el sistema respondió automáticamente cuando fue necesario cambiar entre el agua de lluvia y la red pública. Además, toda la información fue visualizada en tiempo real desde la plataforma web.
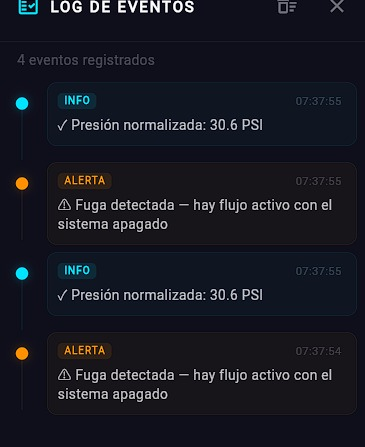
Log de eventos de la plataforma con alertas de fuga detectada y avisos de presión normalizada
Figura 5. Plataforma web mostrando las alertas del sistema.

Durante las pruebas de monitoreo se verificó que las mediciones realizadas por los sensores ultrasónicos fueron consistentes y permitieron conocer el nivel de agua de forma continua. La aplicación web actualizó la información pocos segundos después de producirse cualquier cambio en el sistema, permitiendo al usuario supervisar el estado de las cisternas desde cualquier dispositivo conectado.

En las pruebas de conmutación automática se simuló el vaciado de la cisterna de agua de lluvia. Una vez alcanzado el nivel mínimo establecido, el sistema cerró automáticamente esa fuente de suministro y habilitó la alimentación desde la red pública, manteniendo el flujo de agua sin intervención del usuario.

También se evaluó el sistema de alertas. Cuando se simuló una condición anormal, como la ausencia de flujo de agua o una posible fuga, la plataforma registró el evento y envió una notificación al usuario mediante correo electrónico. Esto permitió comprobar que el sistema puede informar oportunamente situaciones que requieren atención.
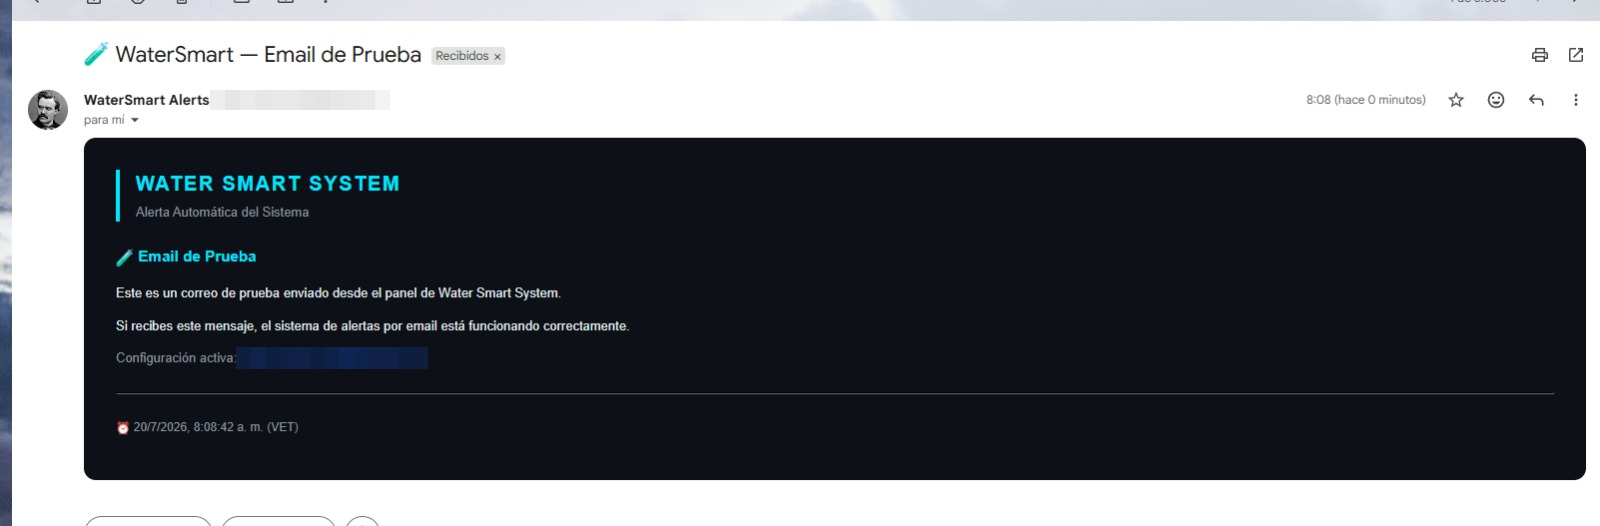
Correo electrónico de prueba enviado por el sistema de alertas
Figura 6. Notificación enviada por correo electrónico.

Otro aspecto evaluado fue el registro histórico de la información. Todas las mediciones generadas por los sensores fueron almacenadas en la base de datos y posteriormente representadas mediante gráficos dentro de la plataforma web. Esto facilita el seguimiento del consumo de agua y permite identificar tendencias de uso con el paso del tiempo.
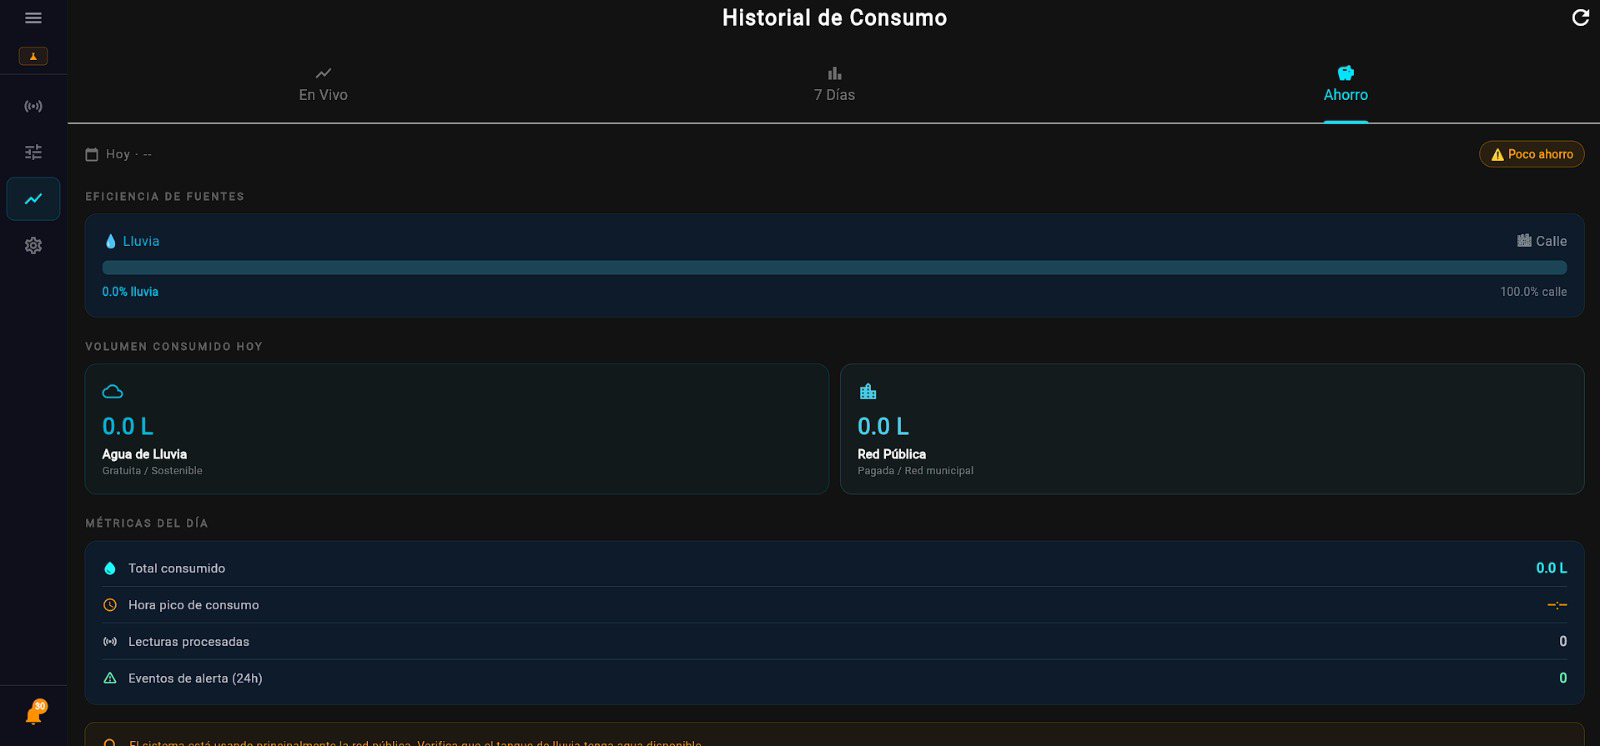
Pantalla de historial de consumo con eficiencia de fuentes, volumen consumido y métricas del día
Figura 7. Historial de consumo en la plataforma web.

Finalmente, se realizaron pruebas desconectando temporalmente la conexión a Internet. Durante este período el sistema continuó controlando las bombas y válvulas utilizando la información disponible en los sensores. Una vez restablecida la conexión, los datos fueron sincronizados nuevamente con la plataforma, demostrando que el sistema puede seguir funcionando incluso cuando no existe comunicación con el servidor.

Área evaluadaPrueba realizadaResultado obtenido
Monitoreo del nivelMedición continua de ambas cisternasLecturas estables y actualización correcta en la plataforma
Cambio de fuenteVaciado de la cisterna de lluviaCambio automático hacia la red pública
Plataforma webVisualización de datosInformación mostrada en tiempo real
Sistema de alertasSimulación de fuga y ausencia de flujoNotificación enviada al usuario por correo electrónico
HistorialRegistro continuo de medicionesDatos almacenados correctamente en la base de datos
Funcionamiento sin InternetDesconexión temporal de la redEl sistema continuó operando y sincronizó la información al reconectarse
Tabla 1. Resultados obtenidos durante las pruebas.

En comparación con otros proyectos de monitoreo de agua reportados en la literatura, SIGA incorpora en una sola plataforma el monitoreo del nivel de agua, el cambio automático entre dos fuentes de abastecimiento, el almacenamiento del historial, el envío de alertas y la consulta desde una aplicación web. Esta integración permite ofrecer una solución más completa para la gestión del agua en viviendas.

Conclusión

El desarrollo del Sistema Inteligente de Gestión del Agua (SIGA) permitió demostrar que es posible administrar de manera automática dos fuentes de abastecimiento de agua mediante el uso de sensores, dispositivos electrónicos y una plataforma web de monitoreo. Los resultados obtenidos durante las pruebas confirmaron que el sistema cumple con los objetivos propuestos, ofreciendo una solución que facilita el aprovechamiento del agua de lluvia y reduce la dependencia de la red pública.

Uno de los principales aprendizajes obtenidos durante el desarrollo fue la importancia de integrar el hardware y el software de manera coordinada para lograr un funcionamiento confiable. La sustitución de los sensores de nivel inicialmente considerados por sensores ultrasónicos permitió mejorar la estabilidad de las mediciones, mientras que la implementación de un sistema de monitoreo en tiempo real facilitó el seguimiento del comportamiento de todo el sistema.

El proyecto también demuestra que un sistema puede considerarse inteligente sin utilizar modelos avanzados de inteligencia artificial. En el caso de SIGA, la toma de decisiones se basa en reglas previamente definidas, información proporcionada por los sensores y el análisis de las condiciones del sistema, permitiendo automatizar tareas que normalmente requerirían la intervención del usuario.

Como trabajo futuro, se propone incorporar sensores que permitan evaluar la calidad del agua, integrar una fuente de alimentación mediante paneles solares para aumentar la autonomía del sistema y desarrollar modelos predictivos que ayuden a estimar el consumo de agua según el comportamiento histórico y las condiciones climáticas.

En conclusión, SIGA representa una alternativa tecnológica para mejorar la gestión del agua en viviendas, promoviendo un uso más eficiente de este recurso. Se espera que este proyecto pueda continuar evolucionando mediante futuras investigaciones y pruebas en escenarios reales, contribuyendo al desarrollo de soluciones sostenibles para el aprovechamiento del agua en la República Dominicana.

Referencias

  1. J. A. P. Al-Shurman, B. A. M. Abdullah, and M. I. I. A. Ahmed, “A comprehensive review of IoT-based smart water management systems,” IEEE Access, vol. 9, pp. 112111–112130, 2021.
  2. K. Hassan, “Development of a real-time monitoring system using Flutter and MQTT protocol for IoT applications,” J. Sensors, vol. 2022, pp. 1–12, 2022.
  3. S. Kumar, “Low-cost smart home automation using ESP32 and MQTT,” Int. J. Comput. Sci. Eng., vol. 18, no. 5, pp. 202–210, 2020.
  4. A. S. Morris and R. Langari, Measurement and Instrumentation: Theory and Application, 3rd ed. Oxford, UK: Elsevier, 2020.
  5. E. Rodríguez, A. L. Peña, and J. M. García, “An IoT-enabled architecture for efficient urban water distribution in developing economies,” Int. J. Eng. Telematics, vol. 5, no. 2, pp. 45–56, 2022.
  6. V. Sharma, “Arduino Based Smart Water Management,” International Journal of Engineering Research and Technology, vol. 9, Sep. 2020, doi: 10.17577/IJERTV9IS080239.
DriveSense: Sistema Inteligente para la Clasificación de Perfiles de Conducción mediante Inteligencia Artificial

Iván Paul Marcelino y Juan Alfonso Alvarado Batista – Ingeniería en Ciencias de la Computación, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La seguridad vial continúa siendo uno de los principales retos asociados a los sistemas de transporte. La forma en que una persona acelera, frena, gira, mantiene la velocidad o reacciona ante una situación inesperada puede influir directamente en el nivel de riesgo de un recorrido. A escala internacional, los siniestros de tránsito continúan generando una elevada cantidad de muertes y lesiones, mientras que factores relacionados con el comportamiento humano permanecen entre los elementos de mayor interés para su prevención [1], [2]. Dentro de este contexto, el análisis del comportamiento del conductor mediante herramientas tecnológicas se ha convertido en una línea de investigación capaz de transformar acciones que tradicionalmente eran observadas de forma subjetiva en información cuantificable que puede ser estudiada mediante técnicas estadísticas y computacionales [6], [9].

En respuesta a esta problemática surge DriveSense, proyecto desarrollado por Iván Paul Marcelino y Juan Alfonso Alvarado Batista, estudiantes de Ingeniería en Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la asesoría del ingeniero Rafael Omar Batista Jorge y dentro de la Escuela de Ingeniería en Computación y Telecomunicaciones. DriveSense fue concebido como un sistema para capturar, procesar y analizar datos de conducción generados dentro de un entorno de simulación controlado, con el propósito de identificar patrones y clasificar el comportamiento observado en diferentes perfiles. En lugar de limitarse a registrar una puntuación final, la propuesta integra la adquisición de telemetría, el procesamiento de los datos, el entrenamiento de modelos de aprendizaje automático y la presentación de resultados mediante una plataforma web.

El uso de simuladores ofrece una ventaja importante al estudiar este tipo de comportamiento. Determinadas situaciones que serían difíciles, costosas o inseguras de reproducir intencionalmente en una vía pública pueden ejecutarse de manera controlada dentro de un entorno virtual. Investigaciones previas han demostrado la utilidad de los simuladores para estudiar aspectos relacionados con la velocidad, las curvas y la respuesta de los conductores bajo condiciones repetibles [3]–[5]. Esta característica permite que distintos participantes realicen sesiones bajo condiciones previamente definidas y que los datos obtenidos puedan ser comparados sin exponer a los usuarios ni a terceros a las consecuencias de provocar deliberadamente una situación de riesgo real.

La motivación de DriveSense parte precisamente de combinar esa capacidad experimental con las posibilidades actuales del análisis de datos. Durante una sesión de conducción pueden generarse miles de observaciones relacionadas con velocidad, aceleración, frenado, dirección y otras variables del vehículo. Analizadas de forma aislada, estas señales pueden resultar difíciles de interpretar. Sin embargo, al organizarlas temporalmente y utilizar modelos capaces de reconocer patrones, es posible construir una representación más detallada de la forma en que una persona conduce [6], [12]. DriveSense utiliza este principio para transformar la telemetría producida durante una sesión en información que pueda ser consultada, comparada e interpretada posteriormente.

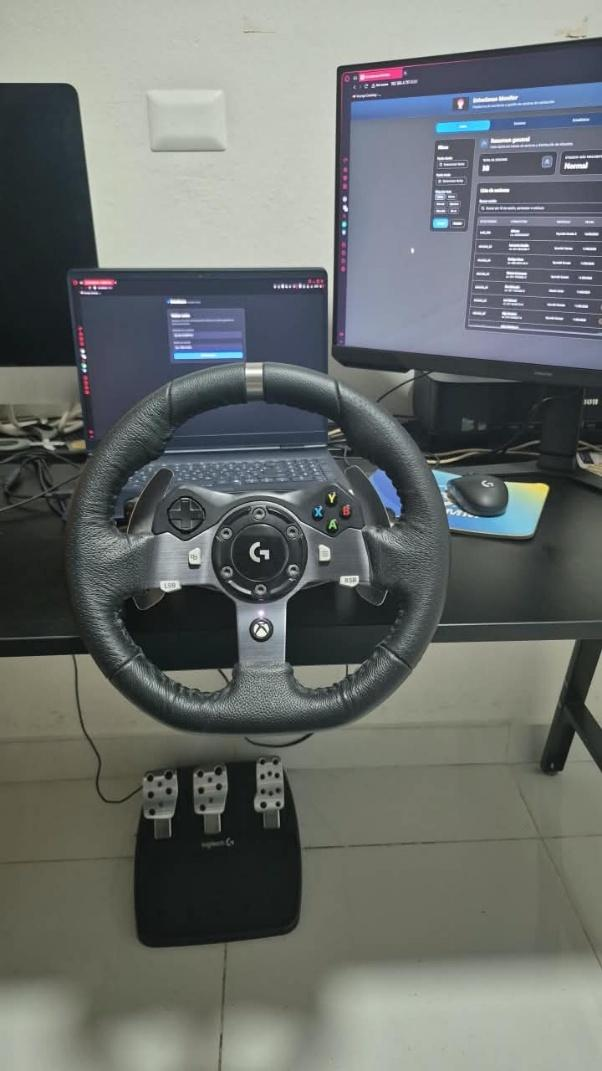
Puesto de simulación con volante, pedales y monitores que muestran el simulador y la plataforma DriveSense
Figura 1. Entorno utilizado para realizar una sesión de conducción con DriveSense, mostrando el simulador y la plataforma desarrollada.

Del problema vial al análisis inteligente del comportamiento

En la República Dominicana, la seguridad vial constituye una problemática especialmente relevante. El exceso de velocidad, las maniobras imprudentes, las aceleraciones repentinas, las frenadas intensas y diferentes formas de conducción agresiva pueden aumentar tanto la probabilidad de un incidente como la gravedad de sus consecuencias. A esto se agregan situaciones comunes en las que el conductor debe reaccionar rápidamente ante congestión, cambios de carril de otros vehículos, obstáculos o modificaciones inesperadas en el flujo del tránsito. Aunque muchas de estas conductas pueden identificarse mediante observación, convertirlas en información cuantitativa permite analizarlas con un mayor nivel de detalle y conservar un registro de lo ocurrido durante diferentes momentos de un recorrido.

Los métodos convencionales para valorar el desempeño de un conductor dependen en gran medida de la observación directa, de evaluaciones realizadas durante un período limitado o de información obtenida después de un incidente. Estos mecanismos continúan siendo necesarios, pero presentan limitaciones cuando se desea estudiar con precisión cómo cambió el comportamiento durante una sesión. Una evaluación humana puede indicar que una persona condujo de manera insegura, por ejemplo, pero los datos de telemetría permiten complementar esa observación indicando cuándo ocurrió una aceleración brusca, cuál era la velocidad en ese momento, cuánto se utilizó el freno o cómo varió la dirección. Esta posibilidad ha impulsado el desarrollo de investigaciones que utilizan información del vehículo para reconocer diferentes patrones de manejo [6], [12].

La literatura relacionada con el perfilado de conductores ha evolucionado progresivamente desde reglas construidas sobre unas pocas variables hacia métodos capaces de estudiar grandes cantidades de información. La clasificación de comportamientos mediante aprendizaje automático permite encontrar relaciones que pueden resultar difíciles de representar utilizando únicamente límites fijos o promedios generales [9], [11]. Diferentes investigaciones han utilizado telemetría vehicular para estudiar estilos de conducción, mientras que otros trabajos han incorporado métodos de ensemble y aprendizaje profundo con el propósito de representar relaciones más complejas entre las características disponibles [13], [15]. En todos estos casos, la calidad de los resultados depende no solamente del algoritmo utilizado, sino también de la forma en que los datos fueron capturados, organizados y preparados.

Precisamente, uno de los retos encontrados durante el desarrollo de DriveSense fue la ausencia de un conjunto de datos que reuniera exactamente las variables, condiciones experimentales y categorías requeridas por el proyecto. Los datasets disponibles en investigaciones previas fueron construidos bajo vehículos, sensores, poblaciones, carreteras y criterios de clasificación diferentes. Utilizar uno de ellos directamente habría significado adaptar el proyecto a condiciones que no necesariamente correspondían con el experimento propuesto. Por esta razón, se decidió construir un dataset propio mediante sesiones realizadas por participantes dentro del simulador, manteniendo un procedimiento común de captura y criterios previamente establecidos para representar los comportamientos estudiados.

Otro aspecto relevante es la dimensión temporal de la conducción. Un conductor no mantiene necesariamente el mismo comportamiento durante todo un recorrido. Una sesión que globalmente parece normal puede incluir algunos segundos de agresividad, distracción o conducción pasiva. Trabajos recientes han reforzado la importancia de estudiar secuencias y patrones temporales en lugar de representar toda una conducción mediante un único promedio [12], [13]. DriveSense adopta esta idea dividiendo la información en ventanas temporales. Cada ventana resume una parte de la sesión y posteriormente puede ser evaluada de forma independiente, permitiendo reconstruir cómo fue cambiando el comportamiento durante el recorrido completo.

Esta aproximación también responde a una necesidad de interpretabilidad. En una aplicación relacionada con personas y seguridad no resulta suficiente presentar únicamente una etiqueta generada por un algoritmo. Es importante conservar las métricas que dieron origen al análisis y disponer de mecanismos que ayuden a entender por qué el sistema produce determinados resultados. La inteligencia artificial explicable ha adquirido relevancia justamente por la necesidad de comprender la influencia que tienen diferentes características dentro de las predicciones [17], [20]. Por esta razón, DriveSense incorporó SHAP como técnica complementaria para estudiar la participación de las variables en las decisiones del modelo, manteniendo separada la predicción del proceso utilizado para explicarla.

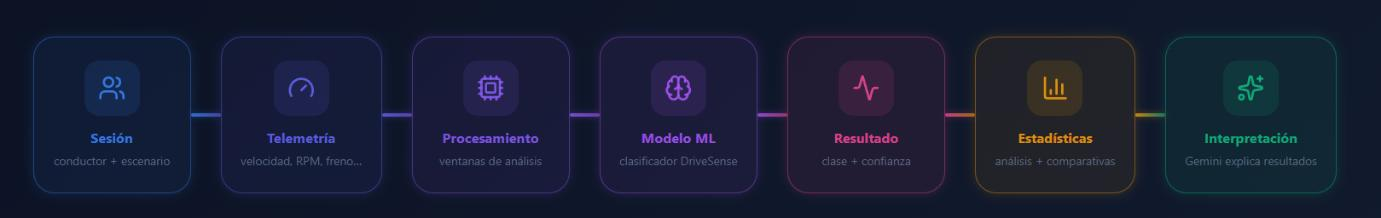
Esquema en etapas: sesión, telemetría, procesamiento, modelo ML, resultado, estadísticas e interpretación
Figura 2. Esquema general del problema abordado: comportamiento del conductor, generación de telemetría, procesamiento de los datos y clasificación del perfil.

El desarrollo de DriveSense permitió cumplir el objetivo de construir una solución inteligente orientada a la clasificación de perfiles de conducción a partir de datos de telemetría obtenidos en un entorno de simulación controlado. Para lograrlo, se diseñó una arquitectura capaz de capturar, estructurar y almacenar telemetría vehicular a una frecuencia de 20 Hz; se implementaron mecanismos para analizar estadísticamente las variables obtenidas y estudiar sus diferencias entre sesiones y grupos de conductores; se desarrolló un proceso para entrenar y evaluar modelos supervisados de aprendizaje automático; y se incorporaron mecanismos para representar cuantitativamente los resultados, conservar las diferentes versiones de los modelos, analizar la influencia de las características y presentar la información al usuario mediante una plataforma centralizada. De esta manera, el objetivo general se desglosó en componentes medibles y verificables que abarcan el ciclo completo desde la generación del dato hasta la interpretación del resultado.

De una sesión simulada a un sistema completo de datos

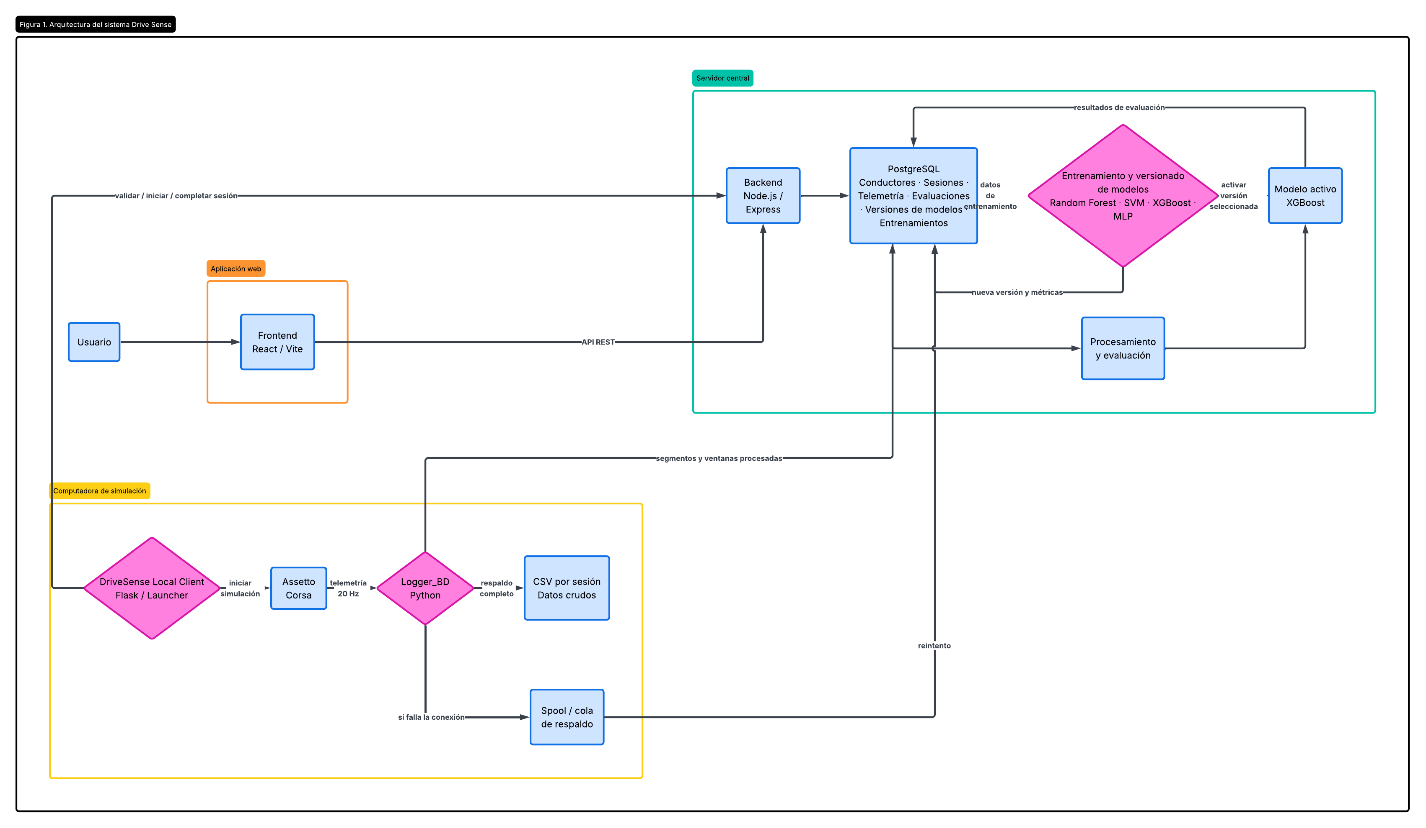
El funcionamiento de DriveSense comienza antes de que el conductor inicie el recorrido. Desde la aplicación web se registra o selecciona al participante y se crea una nueva sesión indicando la información necesaria para la prueba, incluyendo el escenario y el vehículo que serán utilizados. Esta sesión queda registrada en el servidor con un estado inicial y puede ser validada posteriormente desde la computadora encargada de ejecutar la simulación. Esta separación permite mantener un registro de cada prueba y relacionar los datos producidos posteriormente con el conductor y las condiciones correspondientes, evitando que los archivos de telemetría queden aislados de su contexto experimental.

En la computadora de simulación se utiliza DriveSense Local Client, componente encargado de validar que la sesión corresponde con la información registrada en el servidor y preparar el entorno necesario para realizarla. Una vez completada la validación, el cliente inicia los componentes requeridos para trabajar con Assetto Corsa y entrega a Logger_BD la configuración asociada a la sesión. Durante este proceso, la sesión puede pasar por distintos estados, permitiendo que la plataforma conozca si se encuentra pendiente, en ejecución o completada. Este mecanismo también disminuye la cantidad de configuraciones que el usuario debe introducir manualmente en la computadora donde se realiza la prueba.

Diagrama de arquitectura de DriveSense: aplicación web, servidor, Local Client, Assetto Corsa, Logger_BD, almacenamiento y clasificación
Figura 3. Arquitectura general de DriveSense y comunicación entre la aplicación web, el servidor, DriveSense Local Client, Assetto Corsa, Logger_BD, el almacenamiento y el componente de clasificación.

Una vez iniciada la conducción, Logger_BD obtiene información directamente desde la telemetría generada por Assetto Corsa. La captura se realiza a una frecuencia de 20 Hz, equivalente a veinte muestras por segundo. Entre las variables registradas se encuentran velocidad, revoluciones por minuto, acelerador, freno, dirección y valores relacionados con la dinámica del vehículo. Esta frecuencia permite observar variaciones que podrían perderse si únicamente se conservaran valores globales al finalizar la sesión. La telemetría vehicular ha sido utilizada ampliamente como una fuente de información para reconocer comportamientos, ya que permite representar de forma cuantitativa las acciones ejecutadas durante la conducción [6], [12].

Los datos crudos de cada recorrido se conservan en archivos CSV, manteniendo un registro que puede utilizarse posteriormente para revisar una sesión o para construir nuevos conjuntos de entrenamiento. Paralelamente, DriveSense procesa la información y la organiza en segmentos y ventanas temporales que son almacenados en PostgreSQL. Esta combinación responde a dos necesidades diferentes: conservar la telemetría completa y, al mismo tiempo, disponer de una estructura más eficiente para consultas, evaluaciones y visualizaciones. De esta forma, no es necesario procesar nuevamente cada muestra del archivo original cada vez que se quiere consultar un resultado.

La arquitectura fue diseñada además para disminuir el riesgo de pérdida de información ante problemas de conectividad. Si durante una conducción el equipo de simulación no puede comunicarse temporalmente con el servidor, los datos pendientes permanecen almacenados de manera local. Cuando la comunicación vuelve a estar disponible, el sistema intenta enviarlos nuevamente. Esta estrategia permite que una interrupción de red no implique necesariamente perder la sesión completa. Mantener la persistencia de los datos fue considerado especialmente importante debido al esfuerzo requerido para reunir participantes y repetir las condiciones experimentales de una prueba.

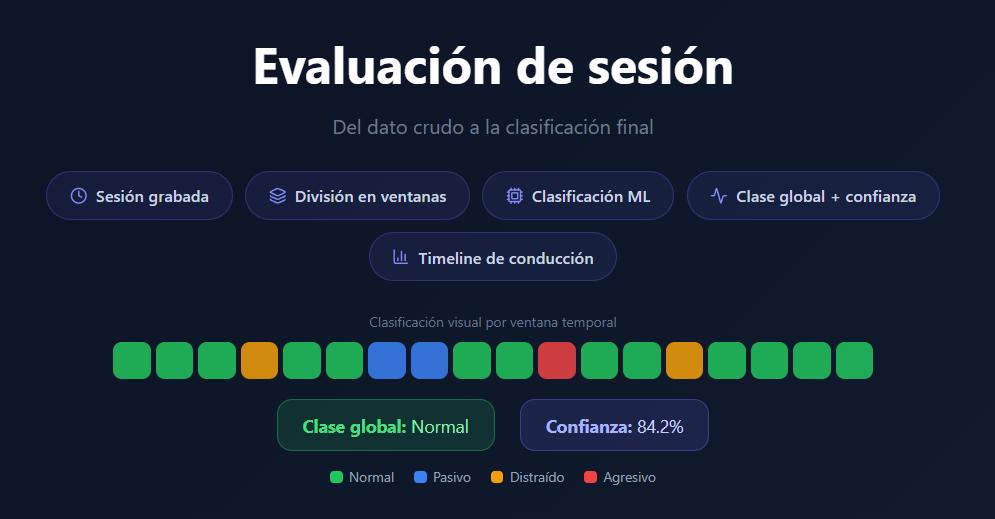
Evaluación de sesión: sesión grabada, división en ventanas, clasificación ML, clase global con confianza y línea de tiempo por ventana
Figura 4. Flujo de los datos desde la captura de telemetría hasta su almacenamiento, procesamiento, clasificación y presentación de resultados.

Una vez almacenada la telemetría, la información se transforma en características que puedan utilizarse en el proceso de clasificación. En lugar de introducir directamente una secuencia extensa de muestras individuales al modelo, las ventanas permiten obtener representaciones de intervalos concretos de la sesión. A partir de ellas pueden calcularse valores relacionados con la velocidad, el uso del acelerador y del freno, la dirección, la variabilidad del comportamiento y la presencia de determinados eventos. La ingeniería de características constituye una etapa fundamental en problemas de clasificación porque permite representar los datos originales de una manera adecuada para que los algoritmos puedan identificar diferencias entre clases [9], [12].

Para determinar qué método resultaba más apropiado para el conjunto de datos disponible, durante el proyecto se trabajó con diferentes algoritmos supervisados: Random Forest, Support Vector Machine (SVM), XGBoost y Multi-Layer Perceptron (MLP). Los modelos fueron entrenados utilizando las mismas características de entrada para permitir una comparación bajo condiciones equivalentes. Random Forest representa un método ampliamente utilizado para problemas de clasificación por su capacidad de combinar múltiples árboles de decisión y manejar relaciones no lineales [10]. XGBoost, por su parte, utiliza un enfoque de gradient boosting que ha demostrado un elevado rendimiento en problemas con datos estructurados [19].

El proceso de entrenamiento no se limitó a generar una única partición del dataset. Para evaluar los modelos se utilizó validación cruzada k-fold, dividiendo repetidamente la información disponible entre subconjuntos de entrenamiento y validación. Este procedimiento reduce la dependencia de una sola división de los datos y permite observar la estabilidad del desempeño del modelo. Para realizar la comparación se consideraron métricas como Accuracy, F1-score, ROC-AUC y matrices de confusión. Cada una aporta una perspectiva diferente: mientras Accuracy representa la proporción global de clasificaciones correctas, F1 permite considerar simultáneamente precisión y exhaustividad, y la matriz de confusión permite estudiar en cuáles categorías se producen los errores.

A medida que el proyecto evolucionó también cambió la definición del problema. Las primeras pruebas trabajaban con tres categorías principales, pero posteriormente se incorporó el comportamiento distraído, dando lugar a las cuatro clases finales utilizadas por DriveSense: agresivo, distraído, normal y pasivo. Este cambio implicó volver a entrenar y evaluar los modelos bajo la nueva estructura. Finalmente se seleccionó XGBoost como clasificador principal y se implementó un sistema de versionado que permite conservar los modelos producidos durante diferentes entrenamientos. En lugar de sustituir simplemente un archivo cada vez que se entrena nuevamente, DriveSense registra qué versión fue generada, con qué datos se construyó, cuáles fueron sus métricas y cuál se encuentra activa.

La interpretabilidad complementa este proceso mediante SHAP, técnica que permite estudiar cómo las características utilizadas contribuyen a las predicciones realizadas. La idea no es modificar la clasificación obtenida, sino proporcionar una herramienta adicional para analizar la participación de las variables dentro del modelo. SHAP se apoya en principios de teoría de juegos para asignar valores de contribución a las características y se ha convertido en una técnica reconocida dentro del campo de la inteligencia artificial explicable [20]. En DriveSense, esta información sirve como apoyo al análisis de las decisiones del clasificador y ayuda a evitar que el sistema sea presentado únicamente como una caja negra que produce etiquetas sin contexto.

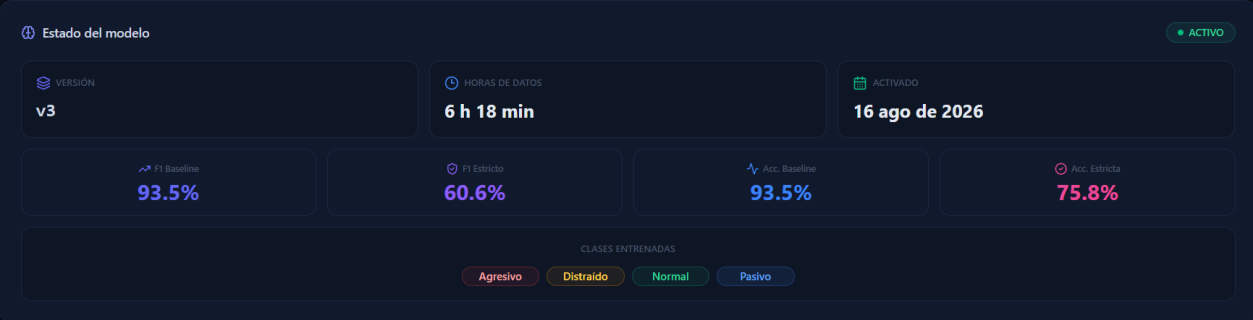
Tarjeta de estado del modelo activo XGBoost v3 con horas de entrenamiento y métricas
Figura 5. Flujo metodológico empleado para la preparación de los datos, entrenamiento, validación, selección y versionado de los modelos de clasificación.

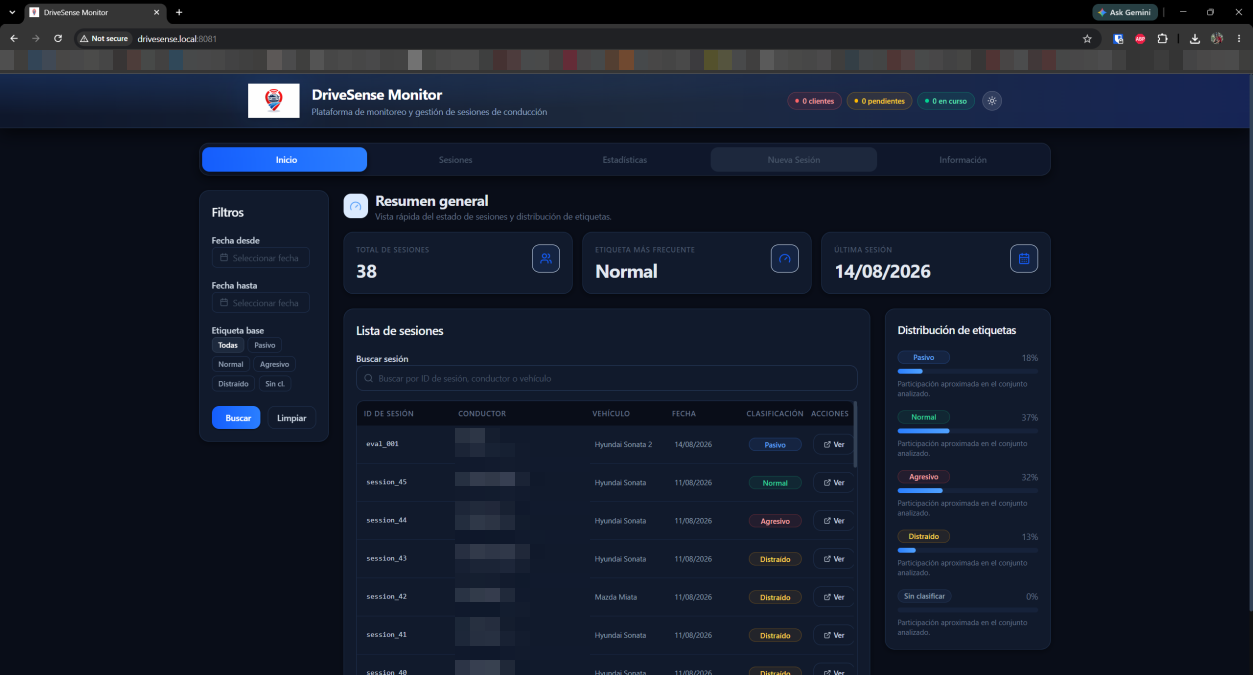
El sistema se completa mediante la plataforma web, desde la cual se pueden registrar conductores, crear nuevas sesiones, consultar recorridos anteriores, visualizar evaluaciones y acceder a estadísticas. La interfaz reúne información que originalmente se encuentra distribuida entre archivos, registros de base de datos, predicciones y métricas. Además, permite realizar comparaciones utilizando características como género y rango de edad, así como consultar las versiones existentes de los modelos y sus procesos de entrenamiento. Esta centralización facilita que DriveSense pueda utilizarse no solamente como un experimento aislado, sino como una plataforma que mantiene la trazabilidad de las pruebas efectuadas.

En las fases finales se incorporó adicionalmente una capa de interpretación mediante la API de Gemini. Esta funcionalidad surgió al observar que porcentajes, métricas y gráficas pueden resultar difíciles de comprender para usuarios sin experiencia en ciencia de datos. Es importante diferenciar claramente sus funciones: Gemini no clasifica al conductor, no modifica los resultados del modelo y no participa en el cálculo de las predicciones. DriveSense y XGBoost continúan siendo responsables del procesamiento y la clasificación; la API recibe únicamente resultados ya generados y los transforma en una explicación en lenguaje natural. El backend controla además la información compartida, evitando transmitir identificadores directos como el nombre o el número de licencia del participante.

Interfaz web DriveSense Monitor con el resumen general, la lista de sesiones y la distribución de etiquetas
Figura 6. Ejemplo de la interfaz web de DriveSense para la gestión de sesiones, consulta del modelo activo y visualización de información del sistema.

Resultados que muestran más que una etiqueta

Durante el desarrollo del componente de inteligencia artificial se realizaron distintas iteraciones hasta llegar a la configuración final. En una etapa inicial se evaluó una implementación basada en RAPIDS AI utilizando CPU y GPU. La variante ejecutada mediante CPU obtuvo un Accuracy de 96.66 %, un Macro F1-score de 0.62 y un Weighted F1-score de 0.76, con un tiempo de entrenamiento de aproximadamente 0.3561 segundos. Para el volumen de información utilizado en ese momento, la ejecución mediante GPU presentó un desempeño similar pero requirió un tiempo mayor, por lo que la aceleración mediante GPU no se mantuvo como una necesidad del sistema. Estos resultados también evidenciaron la importancia de analizar múltiples métricas: un valor elevado de Accuracy no implica necesariamente un comportamiento igualmente uniforme entre todas las categorías.

Posteriormente, el problema fue ampliado de tres a cuatro clases y se adoptó XGBoost como modelo principal. La versión activa XGBoost v3 fue entrenada utilizando 23 sesiones, equivalentes a aproximadamente 6 horas y 18 minutos de conducción. Esta versión obtuvo un Accuracy baseline de 93.49 % y un F1-score baseline de 93.45 %. Bajo el criterio de evaluación estricto se obtuvo un Accuracy de 75.82 % y un F1-score de 60.76 %. Adicionalmente, las predicciones del modelo presentan una confianza promedio cercana al 83 %. Las métricas de esta versión no deben compararse directamente con los valores de la etapa inicial, ya que fueron obtenidas utilizando diferente cantidad de clases, distintas configuraciones del conjunto de datos y un procedimiento de evaluación actualizado.

La diferencia entre las métricas baseline y las obtenidas bajo un criterio más estricto constituye un resultado importante del proyecto. Presentar únicamente la cifra más alta habría proporcionado una visión incompleta del rendimiento. La evaluación estricta permite observar que el problema se vuelve considerablemente más exigente cuando se establecen condiciones destinadas a reducir la posibilidad de que información demasiado relacionada aparezca simultáneamente en entrenamiento y validación. Esto ayuda a representar de manera más realista la capacidad de generalización del modelo y demuestra por qué la evaluación de un sistema de aprendizaje automático no debe resumirse exclusivamente mediante una sola métrica.

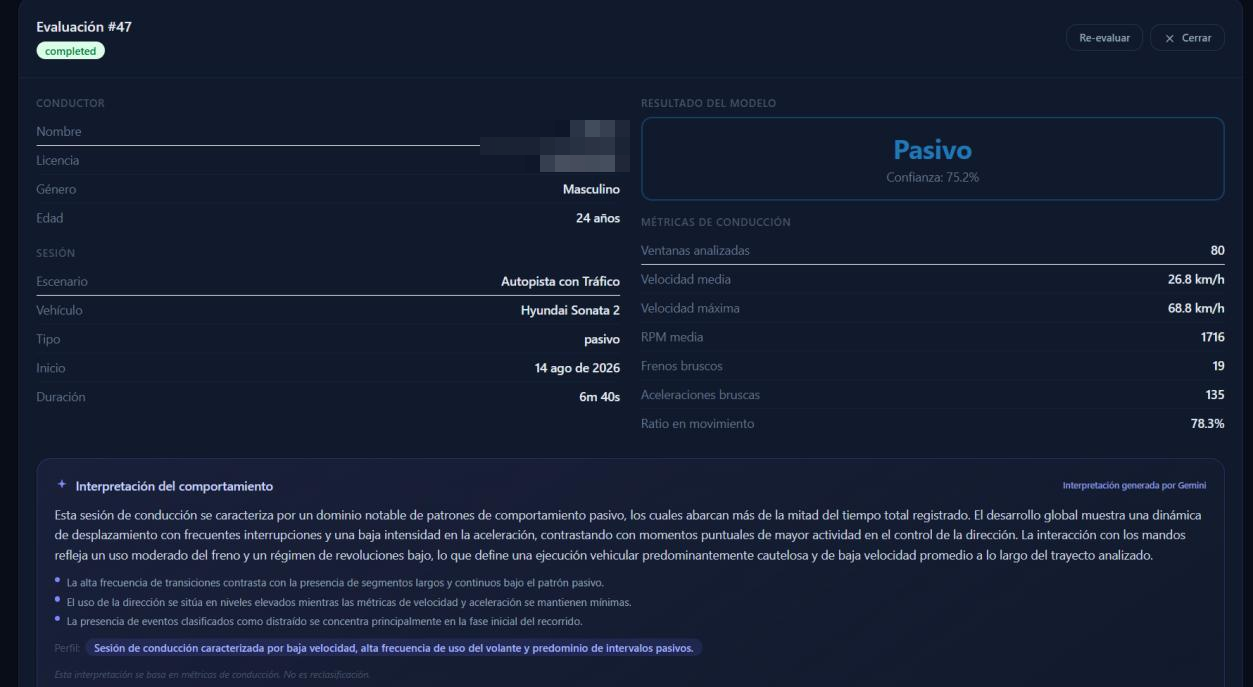
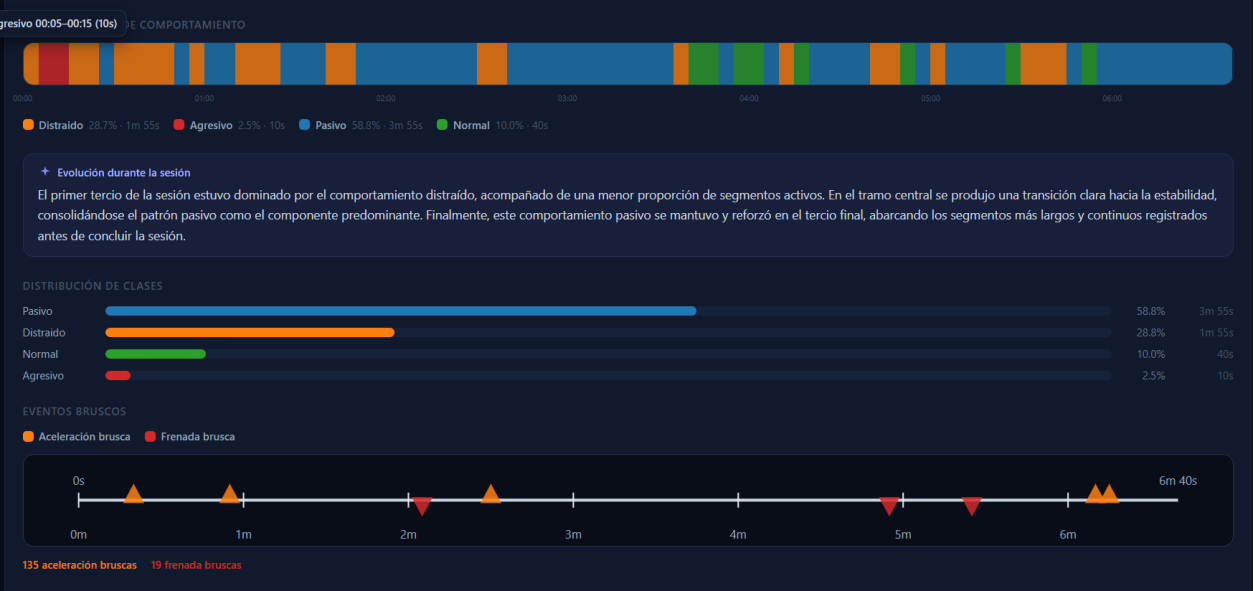
DriveSense tampoco limita el resultado a una única clasificación para toda la sesión. Cada una de las ventanas procesadas conserva su propio resultado, lo que permite construir una línea de tiempo del comportamiento. Como ejemplo, una de las sesiones analizadas fue clasificada globalmente como pasiva con un 75.2 % de confianza. Sin embargo, al estudiar sus 80 ventanas, se observó que el comportamiento pasivo representó el 58.8 % del tiempo evaluado, mientras que el comportamiento distraído correspondió al 28.7 %, el normal al 10.0 % y el agresivo al 2.5 %. La clasificación global resume el patrón predominante, mientras que la línea temporal permite identificar los cambios que ocurrieron durante el recorrido.

Este nivel de detalle representa una de las características más útiles de la solución. Dos sesiones podrían terminar con la misma clasificación general y, aun así, haber llegado a ese resultado mediante patrones diferentes. Una puede mantener un comportamiento relativamente uniforme y otra alternar repetidamente entre distintas clases. Por esta razón, la plataforma presenta conjuntamente la clasificación global, la confianza, las métricas de conducción, la distribución de comportamientos, los eventos detectados y los intervalos temporales. El propósito es que el resultado pueda examinarse desde diferentes perspectivas y no interpretar al conductor únicamente a partir de una etiqueta aislada.

Evaluación de una sesión clasificada como pasiva con 75.2 % de confianza, métricas de conducción e interpretación del comportamiento
Figura 7. Clasificación general y nivel de confianza de la sesión evaluada.
Línea de tiempo de la sesión por ventanas, distribución de comportamientos y eventos bruscos detectados
Figura 8. Evolución temporal, distribución de comportamientos y eventos detectados durante la sesión.
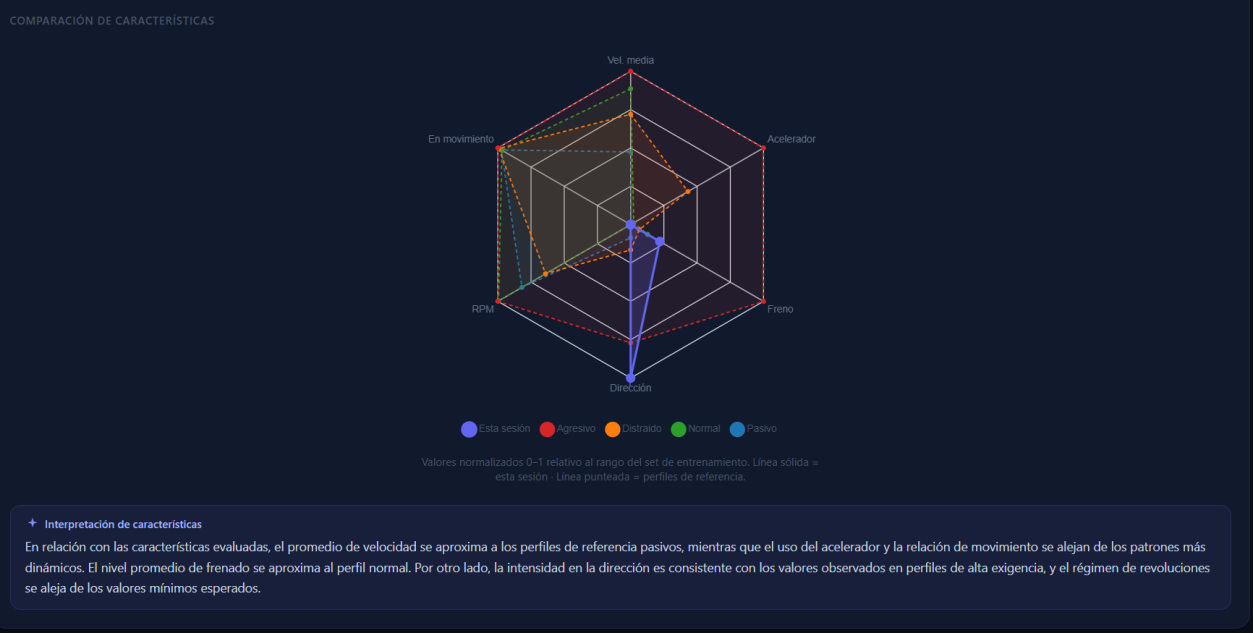
Gráfico radar que compara las características de conducción de la sesión con los perfiles de referencia
Figura 9. Comparación de las características de conducción e interpretación de sus valores respecto a los perfiles de referencia.
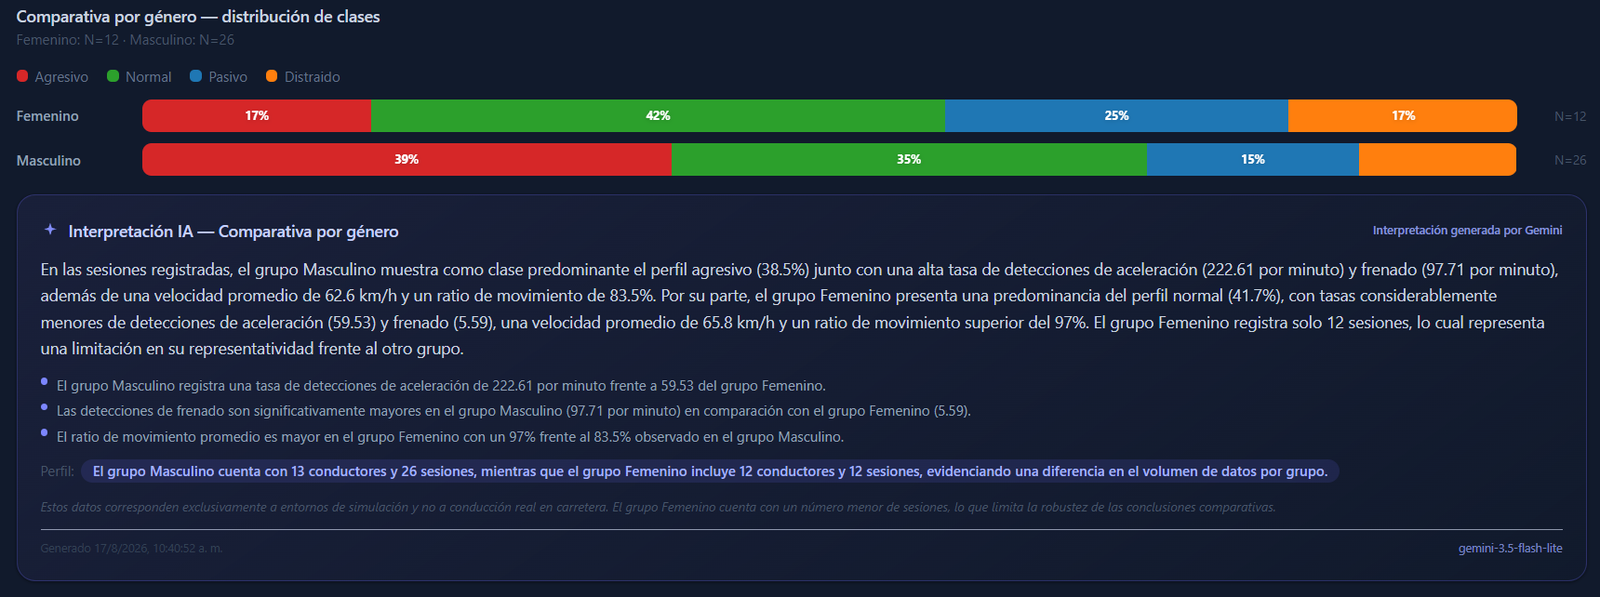
Los datos reunidos también hicieron posible realizar comparaciones descriptivas entre diferentes grupos de la muestra. Para la comparación por género se analizaron 26 sesiones correspondientes a conductores masculinos y 12 sesiones correspondientes a conductores femeninos. Entre las sesiones femeninas, la conducción normal representó aproximadamente el 42 %, seguida de la pasiva con 25 %, mientras que agresiva y distraída representaron alrededor de 17 % cada una. Entre las sesiones masculinas, la categoría agresiva alcanzó aproximadamente 39 %, la normal 35 %, la pasiva 15 % y la distraída alrededor de 11 %. Estos valores describen solamente el comportamiento de las sesiones disponibles y no deben interpretarse como una afirmación general sobre hombres y mujeres.

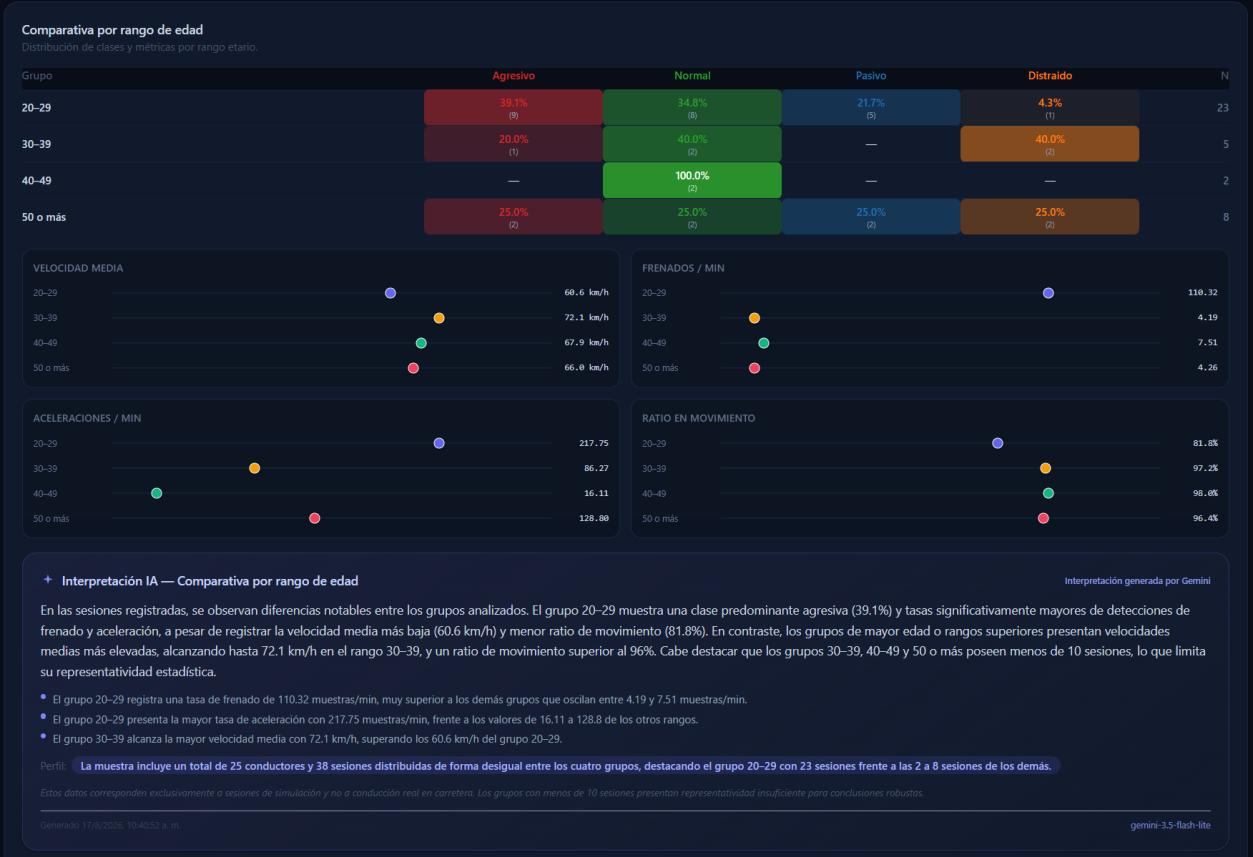
En la comparación por edad, el grupo de 20 a 29 años concentró la mayor cantidad de observaciones, con 23 sesiones. En este rango, el 39.1 % fue clasificado como agresivo, el 34.8 % como normal, el 21.7 % como pasivo y el 4.3 % como distraído. Para el grupo de 30 a 39 años se analizaron cinco sesiones, con un 40 % normal, 40 % distraído y 20 % agresivo. En el rango de 40 a 49 años solo estuvieron disponibles dos sesiones, ambas clasificadas como normales. Finalmente, en el grupo de 50 años o más se analizaron ocho sesiones, distribuidas en proporciones de 25 % para cada una de las cuatro categorías. Las diferencias en el tamaño de cada grupo impiden utilizar estos resultados como representación de la población general; su valor dentro del proyecto es principalmente descriptivo y demuestra la capacidad del sistema para organizar este tipo de comparaciones.

Comparativa por género de la distribución de clases agresivo, normal, pasivo y distraído, con interpretación
Figura 10. Comparación de la distribución de comportamientos por género.
Comparativa por rango de edad de la distribución de clases y de las métricas de conducción, con interpretación
Figura 11. Comparación de la distribución de comportamientos por rango de edad.

Una base para seguir investigando la conducción

Los resultados obtenidos permiten concluir que es posible integrar un entorno de simulación, captura de telemetría, almacenamiento estructurado y aprendizaje automático dentro de un mismo sistema para analizar perfiles de conducción. DriveSense no se limita al modelo de clasificación, sino que incorpora el proceso completo que permite producir y conservar los datos utilizados por ese modelo. Desde la creación de una sesión hasta la presentación de sus resultados, cada etapa mantiene información que permite posteriormente revisar cómo se obtuvo una determinada clasificación. Esta trazabilidad es especialmente importante en un proyecto experimental, debido a que permite continuar incorporando datos sin perder las versiones y resultados producidos previamente.

Al mismo tiempo, los resultados deben interpretarse dentro de las condiciones bajo las cuales fueron obtenidos. Assetto Corsa permite capturar telemetría detallada y realizar pruebas controladas, pero no fue diseñado específicamente como una plataforma para reproducir absolutamente todas las situaciones presentes en el tránsito cotidiano. El comportamiento del tráfico, determinadas interacciones con otros vehículos, las condiciones ambientales y otros factores de la vía real dependen de las posibilidades ofrecidas por el simulador. A esto se agrega que el dataset fue construido específicamente para esta investigación y que las categorías agresivo, distraído, normal y pasivo responden a los criterios establecidos para las sesiones realizadas. Por tanto, el modelo aprende patrones correspondientes al contexto experimental de DriveSense.

Estas limitaciones también señalan directamente los próximos pasos del proyecto. La incorporación de nuevos participantes permitiría aumentar la diversidad del dataset y mejorar la cantidad de observaciones disponibles en cada grupo de edad y género. Nuevos escenarios aportarían una mayor variedad de situaciones de conducción. También sería posible continuar aumentando la automatización de la interacción con el simulador para disminuir la intervención necesaria durante el inicio y finalización de una sesión. Gracias al sistema de versionado incorporado, estas nuevas sesiones pueden utilizarse para producir modelos posteriores y comparar su rendimiento antes de decidir cuál versión debe mantenerse activa.

Finalmente, una de las líneas de trabajo más relevantes consiste en estudiar DriveSense utilizando otras fuentes de telemetría. La arquitectura no depende conceptualmente de una única categoría de simulador: si otra fuente puede proporcionar las variables requeridas, el proceso de captura puede adaptarse y posteriormente construir un nuevo dataset representativo de ese entorno. Una futura evaluación con vehículos reales permitiría investigar hasta qué punto los patrones identificados mediante simulación se mantienen fuera de Assetto Corsa y qué modificaciones serían necesarias para aplicaciones relacionadas con evaluación, capacitación o análisis de conductores. En este sentido, DriveSense representa no solamente el resultado de un proyecto académico, sino una base tecnológica y metodológica sobre la cual puede continuar desarrollándose investigación relacionada con el comportamiento al volante y la seguridad vial.

Referencias

  1. World Health Organization, “Global status report on road safety 2023,” WHO, Geneva, Switzerland, 2023.
  2. National Highway Traffic Safety Administration, “Traffic Safety Facts Annual Report 2022,” U.S. Department of Transportation, 2023.
  3. A. Bella and A. Calvi, “Effects of simulator training on driver speed behavior in curves,” Accident Analysis & Prevention, vol. 43, no. 3, pp. 1166–1172, 2011.
  4. S. T. Godley, T. J. Triggs, and B. N. Fildes, “Driving simulator validation for speed research,” Accident Analysis & Prevention, vol. 34, no. 5, pp. 589–600, 2002.
  5. A. Calvi, “A study on driving performance along horizontal curves using a driving simulator,” Journal of Transportation Safety & Security, vol. 7, no. 3, pp. 243–257, 2015.
  6. Y. Zhang, X. Wang, and L. Li, “Driving behavior recognition based on vehicle telemetry data,” Sensors, vol. 21, no. 4, pp. 1–18, 2021.
  7. P. Sun, J. Hu, and Y. Zhang, “Real-time driving risk evaluation based on vehicle dynamics,” IEEE Transactions on Intelligent Transportation Systems, vol. 23, no. 6, pp. 5678–5689, 2022.
  8. M. Taamneh et al., “Detection of driver stress in real-world driving environments,” IEEE Transactions on Intelligent Transportation Systems, vol. 21, no. 12, pp. 5007–5017, 2020.
  9. J. Ferreira, J. Carvalho, and J. Fonseca, “Driver behavior profiling: An investigation with machine learning,” Expert Systems with Applications, vol. 123, pp. 1–12, 2019.
  10. L. Breiman, “Random forests,” Machine Learning, vol. 45, no. 1, pp. 5–32, 2001.
  11. M. Saeedmanesh and N. Geroliminis, “Dynamic clustering and classification of driving behavior,” Transportation Research Part C, vol. 102, pp. 195–214, 2019.
  12. S. Wang, C. Li, and R. Fu, “Driver behavior recognition using vehicle data and machine learning,” IEEE Sensors Journal, vol. 20, no. 10, pp. 5674–5683, 2020.
  13. Y. Li, Z. Chen, and H. Zhang, “Driver behavior classification using deep learning and vehicle telemetry data,” IEEE Access, vol. 10, pp. 112345–112357, 2022.
  14. J. Kim and S. Lee, “Real-time driver risk assessment using machine learning and vehicle dynamics,” Sensors, vol. 23, no. 2, pp. 1–15, 2023.
  15. R. Gupta, A. Sharma, and P. Singh, “Driving style analysis using telematics data and ensemble learning methods,” Expert Systems with Applications, vol. 213, 2023.
  16. T. Nguyen and M. Arif, “A survey on driver behavior analysis using machine learning techniques,” IEEE Access, vol. 11, pp. 45678–45700, 2023.
  17. L. Zhao et al., “Explainable AI for driver behavior profiling using SHAP and ensemble models,” IEEE Transactions on Intelligent Transportation Systems, 2024.
  18. H. Eren et al., “Estimating driving behavior by a smartphone,” in Proc. IEEE Intelligent Vehicles Symposium, 2012.
  19. T. Chen and C. Guestrin, “XGBoost: A scalable tree boosting system,” in Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 785–794, 2016.
  20. S. M. Lundberg and S.-I. Lee, “A unified approach to interpreting model predictions,” in Advances in Neural Information Processing Systems, vol. 30, 2017.

AgroSat IoT: Integración de Sensores y Teledetección para la Agricultura 4.0 en República Dominicana

Carlos García Núñez y Dariel Alexander Vargas Francisco – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

La agricultura constituye uno de los ejes fundamentales para el desarrollo económico y la seguridad alimentaria a nivel global. En la República Dominicana, el sector agrícola se destaca por su gran capacidad exportadora, siendo el cultivo de banano (Musa paradisiaca) un pilar estratégico que representa aproximadamente el 30% de las exportaciones agropecuarias del país [1]. Estas cifras consolidan al banano como un generador indispensable de divisas, con una presencia notable en mercados internacionales de alta exigencia, como la Unión Europea y el Reino Unido. Gran parte de esta competitividad se basa en la producción orgánica, una modalidad que añade un enorme valor comercial al producto dominicano, pero que simultáneamente impone restricciones severas en el uso de insumos químicos para el manejo fitosanitario de las plantaciones.

Esta restricción en el manejo sintético subraya una vulnerabilidad crítica: la exposición de los cultivos a amenazas bióticas y abióticas fluctuantes. Ante esta realidad, surge la necesidad apremiante de modernizar los métodos de supervisión en campo, transitando desde modelos reactivos hacia la adopción de la denominada Agricultura 4.0 [2]. Esta transición implica la incorporación de tecnologías de monitoreo continuo que aporten una capa de inteligencia basada en datos concretos y localizados, lo que permite la anticipación de escenarios de estrés en el cultivo, garantizando así la sostenibilidad y el rendimiento de las fincas agrícolas.

En este contexto de innovación tecnológica, estudiantes de la Facultad de Ciencia de la Ingeniería, pertenecientes al Departamento de Ingeniería Telemática y Ciencias de la Computación de la Pontificia Universidad Católica Madre y Maestra (PUCMM), han desarrollado una iniciativa pionera. Bajo el liderazgo de Carlos García Núñez y Dariel Vargas, y con la asesoría del Ing. Jorge Alejandro Luna Martínez, nace el proyecto AgroSat IoT. Esta propuesta fusiona el potencial de las redes de telemetría de largo alcance con el análisis de imágenes satelitales, creando un entorno de supervisión integral que redefine la toma de decisiones en el ámbito agrario.

La motivación principal detrás de AgroSat IoT radica en empoderar a los productores bananeros con herramientas tecnológicas accesibles y de alta precisión. A través de la recolección de datos microclimáticos in situ y la superposición de metadatos macroespaciales, la solución no solo aspira a diagnosticar problemas de forma oportuna, sino a establecer una metodología replicable que promueva el uso eficiente de recursos hídricos y nutricionales, salvaguardando así el liderazgo de la producción orgánica nacional.

Problemática y estado del arte

A pesar de su evidente relevancia económica, la cadena de producción del banano enfrenta desafíos de naturaleza sistémica y fisiológica, especialmente pronunciados en la etapa de poscosecha. Entre las amenazas más destructivas destaca la pudrición de la corona, una patología fúngica asociada a microorganismos como Fusarium spp. y Colletotrichum musae [3].

Esta enfermedad suele desarrollarse de manera latente en el campo, manifestándose únicamente durante el proceso de empaque o transporte, lo que resulta en rechazos masivos de lotes en el mercado internacional y pérdidas económicas devastadoras. En el entorno de la producción orgánica, donde los fungicidas de síntesis química están estrictamente prohibidos, la gestión de esta enfermedad depende casi por completo de un control preventivo fundamentado en la excelente salud fisiológica de la planta desde su fase de desarrollo temprano.

Paralelamente, el banano es una especie botánica con una elevada demanda hídrica, lo que lo vuelve excepcionalmente sensible a las fluctuaciones en la humedad del suelo [4]. Un déficit hídrico sostenido provoca el cierre de los estomas, reduciendo drásticamente las tasas fotosintéticas y afectando el llenado del fruto. Por otro lado, un escenario de anegamiento promueve la hipoxia radicular y crea un microclima ideal para la proliferación de fitopatógenos del suelo. Esta delicada ventana de homeostasis hídrica exige un escrutinio meticuloso, el cual es inalcanzable utilizando únicamente métodos empíricos de observación visual.

Actualmente, el principal agravante de esta problemática en la región es la dependencia histórica de la gestión agraria tradicional. Las anomalías nutricionales y el estrés hídrico ocurren de forma silenciosa, y para el momento en que los síntomas se vuelven visibles en el follaje o en el racimo, el daño celular y la merma en la productividad ya son irreversibles. Los productores carecen de medios tecnológicos continuos para monitorear el subsuelo en tiempo real, favoreciendo así un ciclo crónico de ineficiencia donde los recursos como el agua y los biofertilizantes se aplican a ciegas, basándose en calendarios estáticos en lugar de necesidades fisiológicas reales.

En el estado del arte internacional, se han propuesto diversas aproximaciones para mitigar este desfase informativo. Huamán Correa (2023) introdujo un sistema de monitoreo en Perú orientado a la correlación de datos ambientales para la predicción de plagas en bananeras, subrayando la utilidad de la telemetría en tiempo real [5]. De manera similar, Rincón Vargas y Vargas Romero (2023) desarrollaron un prototipo de medición localizada de temperatura y humedad edáfica, demostrando que la vigilancia constante optimiza notablemente las estrategias de riego [6].

Por otra parte, desde la perspectiva de la teledetección macroscópica, Castillo Idrovo (2021) validó la viabilidad del uso de constelaciones satelitales para analizar el vigor vegetal mediante índices espectrales, lo que permite localizar zonas de bajo rendimiento en extensiones vastas que serían inviables de inspeccionar a pie [7]. Estas investigaciones ratifican que tanto el enfoque micro (sensores de campo) como el enfoque macro (satélites) poseen un valor innegable para la gestión agrícola moderna.

Sin embargo, a pesar de los avances documentados, las soluciones actuales presentan una fragmentación operativa. Los agricultores dominicanos no cuentan con plataformas unificadas que correlacionen de manera fluida y nativa los datos químicos del sustrato (como el pH, la conductividad eléctrica y los niveles de macronutrientes NPK) con la perspectiva radiométrica satelital a gran escala. Esta desconexión impide un diagnóstico agronómico verdaderamente holístico, limitando la adopción de una agricultura de precisión adaptada a la topografía y climatología específicas de los valles productivos de la República Dominicana.

Objetivos completados

El desarrollo de este proyecto ha implementado un sistema de diagnóstico agrícola integral y en tiempo real para cultivos de banano, estructurado sobre una arquitectura híbrida que combina el despliegue de redes de sensores IoT (LoRa) de bajo consumo para la captura in situ de variables edáficas (humedad, pH, NPK, conductividad eléctrica) y el procesamiento automatizado de imágenes satelitales (Sentinel-2) para la extracción de índices espectrales (NDVI, NDWI). El sistema proporciona una plataforma web centralizada capaz de correlacionar estos datos, generando reportes analíticos y alertas tempranas, lo que garantiza a los productores una herramienta de apoyo crítico para optimizar el uso de recursos, anticipar escenarios de estrés hídrico o nutricional, y mejorar sustancialmente el manejo preventivo de enfermedades en la producción bananera.

Metodología

Para materializar esta solución integral, se implementó una metodología de desarrollo concurrente, dividiendo el trabajo en subsistemas aislados pero altamente interdependientes: adquisición de hardware, procesamiento geoespacial y desarrollo de la arquitectura backend/frontend. El diseño de este ecosistema tecnológico se enfocó en garantizar estabilidad en entornos remotos, escalabilidad de la red de telemetría y una presentación de la información que fuera inmediatamente procesable por el usuario final, todo ello apoyado en protocolos de transmisión de bajo consumo energético.

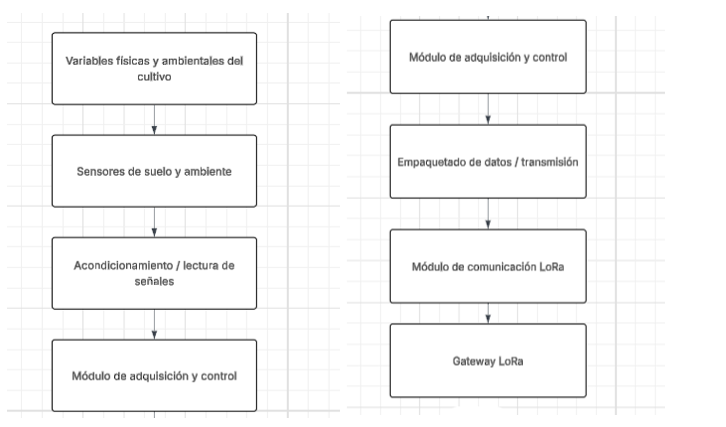
Diagrama de bloques del flujo desde las variables del cultivo y los sensores hasta el módulo LoRa y el gateway
Figura 1. Diagrama esquemático del flujo de telemetría desde los nodos en campo hasta el panel de visualización en la nube.

Adquisición de datos a través de nodos IoT en el borde

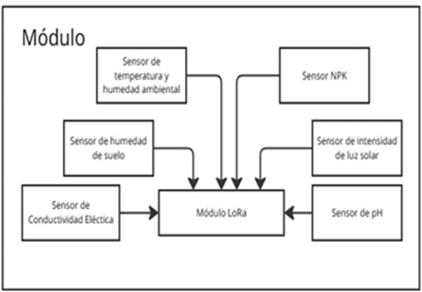
El núcleo de la recolección de campo se basó en el diseño de estaciones de monitoreo equipadas con microcontroladores ESP32 que integran módulos transceptores LoRa V3 (SX1262 a 915 MHz). Esta selección de hardware obedece a las estrictas demandas topológicas de las áreas de cultivo, donde la conectividad celular (GSM/LTE) suele ser inestable y el consumo energético debe ser minimizado para permitir la operación autónoma. Cada nodo fue dotado de un conjunto robusto de sensores diseñados para medir variables críticas: humedad del suelo (mediante sensores capacitivos resistentes a la oxidación), temperatura y humedad relativa (BME280), radiación solar, así como electrodos especializados para la medición continua de pH, conductividad eléctrica y concentración de macronutrientes (Nitrógeno, Fósforo y Potasio).

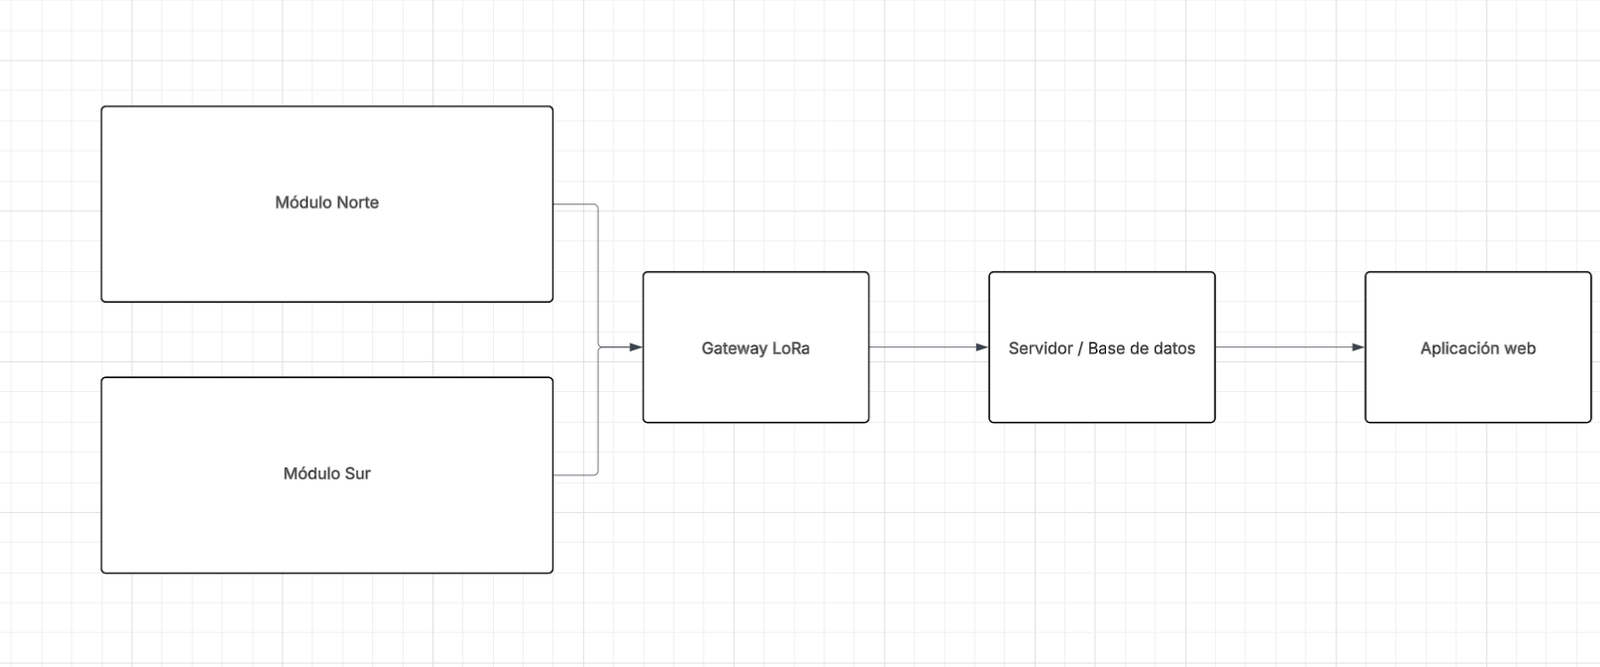
La lógica embebida en estos nodos se encarga del acondicionamiento de las señales analógicas, su conversión digital y el empaquetado estructurado de las tramas de datos. Esta telemetría es enviada periódicamente a través de enlaces de radiofrecuencia de largo alcance hacia un Gateway centralizador, el cual actúa como puente (bridge) utilizando el protocolo MQTT para derivar la información de forma segura hacia los servidores en la nube. Este esquema asegura una alta tolerancia a fallos y permite la expansión futura de la red mediante la adición de nuevos nodos sin saturar el espectro de comunicación.

Diagrama del módulo: sensores de temperatura y humedad, NPK, humedad de suelo, luz solar, conductividad eléctrica y pH conectados al módulo LoRa
Figura 2. Diagrama de bloques del nodo IoT: sensores conectados al módulo LoRa para la transmisión de telemetría.

Análisis satelital automatizado con Google Earth Engine

Para superar las limitaciones de la observación estrictamente puntual, la metodología incorporó un motor de procesamiento de imágenes satelitales fundamentado en la plataforma Google Earth Engine (GEE). A través de scripts automatizados en Python, el sistema consulta periódicamente el catálogo Harmonized de la misión Copernicus Sentinel-2 de la Agencia Espacial Europea. Este proceso incluye un filtrado algorítmico riguroso para discriminar la cobertura nubosa, un fenómeno meteorológico muy frecuente en las zonas tropicales, garantizando que los análisis radiométricos se realicen únicamente sobre píxeles de alta pureza visual.

Topología de red: módulos Norte y Sur conectados al gateway LoRa, al servidor y base de datos, y a la aplicación web
Figura 3. Arquitectura centralizada de la topología de red, ilustrando la convergencia de datos desde el borde hacia el servidor central.

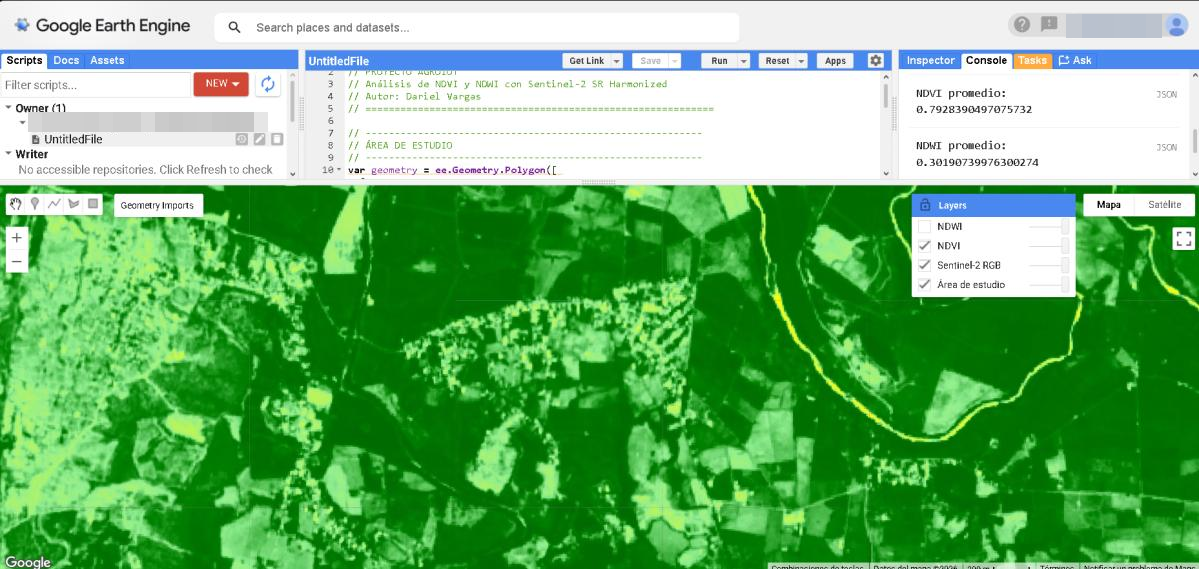
El núcleo analítico de esta sección calcula dos métricas fundamentales: el Índice de Vegetación de Diferencia Normalizada (NDVI) para cuantificar la actividad fotosintética y el vigor de la biomasa, y el Índice de Agua de Diferencia Normalizada (NDWI), el cual revela el estado del dosel foliar respecto a su contenido hídrico.

El sistema no solo extrae estos valores promedios para los polígonos correspondientes a la finca, sino que aplica una lógica de clasificación basada en umbrales (ej. NDVI ≥ 0.6 clasificado como ‘Saludable’), traduciendo metadatos crudos en evaluaciones comprensibles para el manejo agronómico.

Los resultados son inyectados al servidor mediante APIs REST, evitando el almacenamiento local pesado de archivos de imagen (rasters).

Arquitectura backend y plataforma web interactiva

La gestión integral de la información se orquestó sobre una arquitectura de software empresarial multicapa utilizando Java 17 y el ecosistema Spring Boot. Este backend MVC gestiona la persistencia de datos relacionales en MariaDB, estructurando historiales complejos de mediciones, configuración de sensores y registros de eventos. Para asegurar que la latencia entre un evento de campo y la notificación al productor fuera mínima, se implementaron túneles bidireccionales mediante WebSockets, dotando al frontend de capacidades reactivas sin la necesidad de recargar el navegador [8].

Dashboard web de monitoreo con las lecturas de las estaciones Norte y Sur: temperatura, humedad, luz, pH, conductividad y NPK
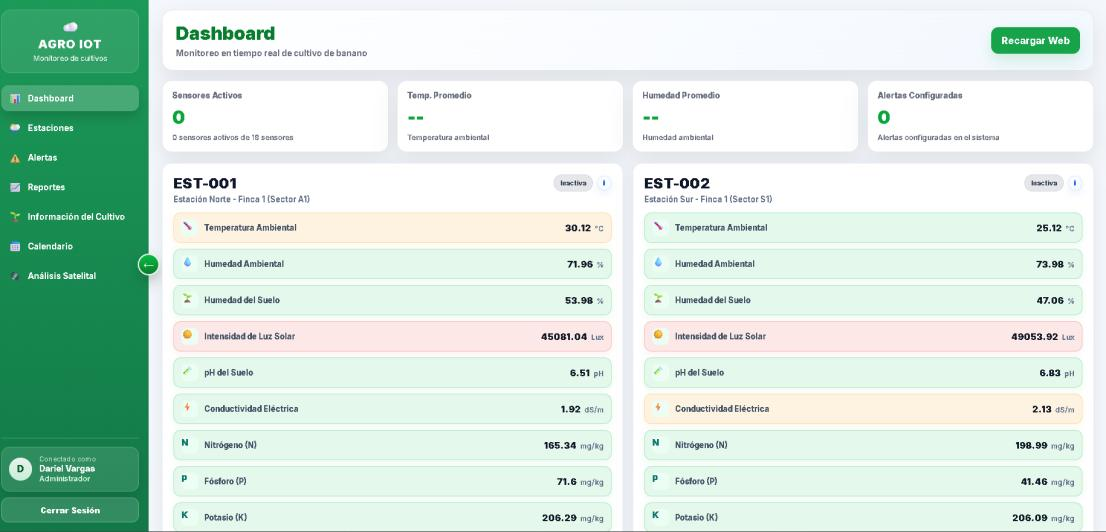
Figura 4. Dashboard interactivo de la plataforma web, presentando indicadores consolidados de sensores y alertas del sistema.

El diseño de la interfaz de usuario se realizó bajo principios de usabilidad orientados a perfiles no técnicos. El entorno web permite la administración de estaciones, la generación de reportes en PDF, el seguimiento de labores mediante un calendario agrícola interactivo, y de manera crucial, la configuración de un motor de alertas lógicas. Este motor evalúa cada paquete de datos entrante contra umbrales personalizados; si, por ejemplo, la tensión matricial del suelo indica deshidratación, el sistema detona una notificación inmediata y altera los indicadores visuales en el panel principal.

Resultados

La validación de AgroSat IoT en un entorno controlado arrojó resultados altamente satisfactorios, confirmando la resiliencia de la arquitectura técnica y la viabilidad de la propuesta para su posterior escalado comercial. En términos de conectividad en el nivel físico, los nodos basados en el transceptor SX1262 demostraron una confiabilidad sobresaliente en la propagación de señales a través de obstáculos típicos del cultivo bananero. La tasa de éxito en la entrega de paquetes de datos (Packet Delivery Ratio) hacia el gateway superó el 95% bajo condiciones de línea de vista parcial, demostrando que la tecnología LoRaWAN es perfectamente adecuada para superar la densidad foliar que caracteriza a este tipo de plantaciones.

A nivel de software, el backend en Spring Boot procesó eficientemente los flujos de telemetría entrantes, registrando y estructurando correctamente las variables en la base de datos MariaDB. Esto permitió la generación de historiales densos y consistentes. La interfaz de usuario respondió de manera fluida a las actualizaciones impulsadas por WebSockets; durante las pruebas, cualquier fluctuación anómala provocada deliberadamente en el entorno de los sensores se reflejó en el panel de control web en un tiempo inferior a los 3 segundos, validando la naturaleza ‘en tiempo real’ de la solución.

Google Earth Engine mostrando el mapa NDVI del área de estudio y los valores promedio de NDVI y NDWI en la consola
Figura 5. Análisis de NDVI y NDWI con Sentinel-2 en Google Earth Engine sobre el área de estudio.

El subsistema de teledetección probó ser un complemento excepcional. El script de automatización en Python interactuó exitosamente con la API de Google Earth Engine, mitigando el ruido causado por la cobertura de nubes y extrayendo los índices NDVI y NDWI con precisión espacial. La correlación observada entre una caída del índice NDWI satelital y la disminución de la capacitancia reportada por los sensores de humedad del suelo corroboró la robustez de combinar enfoques macro y micro para la toma de decisiones, brindando un mapa de calor virtual de las zonas de estrés en la finca.

Finalmente, el motor de alertas evidenció su eficacia operativa. Al exceder los límites predefinidos de salinidad (conductividad eléctrica) o de temperatura crítica, el sistema generó correctamente las advertencias visuales y registró las entradas en el historial de auditoría. Adicionalmente, el mecanismo de comprobación de estado (heartbeat) de los nodos fue validado exitosamente: al desconectar la alimentación de un módulo, la plataforma detectó la caída del enlace en el margen de tiempo estipulado y notificó al usuario la inactividad de la estación, lo cual es vital para el mantenimiento de la red.

Conclusión

La culminación de este proyecto marca un hito significativo en la modernización de la gestión agrícola en la República Dominicana. AgroSat IoT demuestra de manera concluyente que la barrera de entrada para la Agricultura 4.0 puede ser superada mediante el diseño ingenieril inteligente. Al integrar exitosamente arquitecturas de microcontroladores de bajo costo, protocolos inalámbricos de amplia cobertura como LoRa, y plataformas de análisis satelital de acceso abierto, se ha logrado materializar una herramienta de diagnóstico agronómico de primer nivel, capaz de sustituir la intuición empírica por certezas científicas basadas en telemetría continua y espacial.

El impacto a largo plazo de este desarrollo no se limita únicamente a la prevención de patógenos como la pudrición de la corona o a la mitigación del estrés hídrico; radica en la habilitación de una trazabilidad química e hídrica profunda, la cual es la piedra angular para maximizar el rendimiento en nichos de alto valor como lo es la producción de banano orgánico de exportación. Las lecciones aprendidas durante la fase de despliegue reafirman que la infraestructura tecnológica debe ser tan resistente como las plantas que monitorea, y que las interfaces de software deben decodificar la complejidad de los datos en directrices accionables y simples para el productor.

Como próximos pasos, se vislumbra la evolución de esta plataforma hacia esquemas predictivos más agresivos. La inmensa cantidad de datos recabados sienta las bases ideales para la futura implementación de modelos de aprendizaje automático (Machine Learning), los cuales podrán predecir curvas de degradación del suelo o brotes epidemiológicos días antes de que ocurran. Es el momento de que el sector agroindustrial, la academia y el Estado unan fuerzas para escalar estos prototipos hacia mallas de sensores a nivel nacional, transformando definitivamente el paisaje agrícola hacia una matriz de producción resiliente, tecnificada e hiperconectada.

Referencias

  1. Ministerio de Economía, Planificación y Desarrollo (MEPYD), “Ministerio de Economía pondera importancia del sector bananero y oportunidades para su revitalización,” Oct. 19, 2023.
  2. J. Tovar-Quiroz, “Agricultura 4.0: uso de tecnologías de precisión y aplicación para pequeños productores,” Informador Técnico, vol. 87, no. 1, 2023.
  3. D. Toribio-Flórez, F. Carreel, C. Jenny, y J. Carlier, “Crown rot disease in bananas: A review of current knowledge,” Postharvest Biology and Technology, vol. 116, pp. 34–40, 2016.
  4. Y. Barrera-Pardo et al., “Respuesta fisiológica al estrés hídrico de plantas de banano cv. ‘Pineo gigante’ (Musa AAA),” Biotecnología Vegetal, vol. 14, no. 3, pp. 155-162, 2014.
  5. J. A. Huamán Correa, Sistema IoT para el monitoreo climático y detección temprana de plagas en cultivos de banano mediante inteligencia artificial en la región de Piura, Tesis de Maestría, Universidad de Piura, Perú, 2023.
  6. M. F. Rincón Vargas y C. J. Vargas Romero, Diseño e implementación de un prototipo de sistema de monitoreo de temperatura y humedad del suelo en cultivos de banano. Bogotá, Colombia: UNAD, 2023.
  7. J. P. Castillo Idrovo, Aplicación de índices de vegetación NDVI a partir de imágenes Sentinel-2 para el monitoreo de cultivos de banano. Cuenca, Ecuador: Universidad de Cuenca, 2021.
  8. A. Augustin, J. Yi, T. Clausen, y W. M. Townsley, “A Study of LoRa: Long Range & Low Power Networks for the Internet of Things,” Sensors, vol. 16, no. 9, p. 1466, 2016.

Sistema de detección temprana de fuego mediante el uso de cámaras termográficas biespectrales en almacenes de fábricas textiles

Nicolás de Jesús Familia Mateo – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

La innovación como respuesta a una problemática crítica

Los incendios en almacenes de fábricas textiles representan una amenaza constante para la continuidad operativa, la preservación de mercancías y sobre todo la vida humana. En este contexto fue desarrollado, en la Pontificia Universidad Católica Madre y Maestra, un proyecto de grado enfocado en el diseño e implementación de un sistema de detección temprana de fuego mediante el uso de cámaras termográficas biespectrales, procesamiento local en el borde y una plataforma web de monitoreo en tiempo real. La propuesta se origina dentro de la carrera de Ingeniería Telemática con la autoría de Nicolás de Jesús Familia Mateo y se inserta dentro de una línea de trabajo donde convergen visión computacional, redes, sistemas embebidos y desarrollo de software orientado a la supervisión de eventos críticos.

La motivación principal del proyecto parte de una observación puntual: en entornos industriales con alta presencia de materiales inflamables, como ocurre en la industria textil, la detección tradicional basada exclusivamente en sensores puntuales puede resultar insuficiente cuando se requiere cobertura amplia, baja tasa de falsas alarmas y capacidad de anticipación. El problema no se limita a detectar humo o calor cuando el incendio ya se encuentra claramente desarrollado, puesto que su verdadero valor está en identificar conatos de fuego y comportamientos térmicos anómalos antes de que la situación escale a un evento de gran magnitud.

Bajo esa premisa, se propuso una solución híbrida que aprovecha la capacidad de una cámara biespectral para observar simultáneamente el espectro visible y el espectro infrarrojo, el poder de cómputo local de una unidad Jetson Orin para ejecutar inferencia en tiempo real y una aplicación web centralizada capaz de recibir, almacenar, visualizar y notificar alertas. El sistema además incorpora un microcontrolador ESP32-S3 para accionar una sirena estroboscópica, un pulsador de incendios y habilitar interfaces analógicas de integración con subsistemas externos, como mecanismos de supresión contra incendios.

Más allá de su valor técnico, el proyecto busca ser una respuesta realista a necesidades presupuestarias y operativas en entornos como el de la República Dominicana. En lugar de plantear una arquitectura dependiente de grandes despliegues de sensores especializados y de costosas instalaciones distribuidas, la propuesta explora cómo una misma cámara puede cubrir áreas amplias y cómo el procesamiento en el borde puede reducir la latencia sin trasladar toda la carga operativa a la nube. El resultado es un enfoque que busca ser tecnológicamente sólido, económicamente razonable y adaptable a condiciones reales de operación.

Cuando la detección tradicional deja espacios de riesgo

El riesgo de incendio en la industria textil se ve intensificado por la presencia de fibras, polvos en suspensión, materiales combustibles, cableados eléctricos, maquinaria sometida a altas temperaturas y procesos donde un pequeño error puede desencadenar una propagación rápida del fuego. A ello se suma que los almacenes concentran mercancía en volúmenes importantes, de modo que una ignición inicial puede encontrar en cuestión de segundos o minutos una carga combustible suficiente para convertirse en una emergencia mayor. Por esta razón, la prevención y la detección son asuntos esenciales de la seguridad industrial.

Adicionalmente, el inconveniente también posee una dimensión humana y social. En casos de incendios en fábricas textiles de Bangladesh se han llegado a producir decenas de muertes y numerosos heridos, evidenciando que la ausencia de mecanismos adecuados de prevención y respuesta puede conducir a catástrofes irreversibles [15]. Estos antecedentes, aunque ocurridos fuera del país, sirven como recordatorio de que el riesgo es estructural y no debe interpretarse como una posibilidad remota. En la República Dominicana y en otros países en vías de desarrollo, donde las limitaciones presupuestarias suelen condicionar la adopción tecnológica, el desafío se vuelve todavía más delicado.

Los sistemas convencionales de detección presentan ventajas conocidas, pero también varias restricciones dentro de este tipo de entorno. Los detectores puntuales de humo, calor o llama deben ser instalados de forma estratégica y en gran cantidad para ofrecer una cobertura adecuada. Aun así, pueden quedar zonas poco protegidas y, además, la propagación del humo o del calor no es instantánea. En consecuencia, la alerta puede llegar cuando el fenómeno ya alcanzó una etapa visible o claramente peligrosa. En fábricas y almacenes donde el objetivo es ganar incluso una pequeña ventana de tiempo para actuar este retraso reduce el valor preventivo del sistema.

A lo anterior se añaden las falsas alarmas, que en un ambiente con motas de fibra, polvo y partículas suspendidas pueden presentarse con mayor frecuencia, especialmente en detectores de humo ópticos [1]. Cada falsa activación, además de implicar una interrupción de las operaciones, también representa un desgaste progresivo de la confianza del personal en el sistema. Una arquitectura que produce demasiadas alarmas injustificadas termina siendo operativamente costosa y, en el peor de los casos, psicológicamente ineficaz, porque el personal comienza a normalizar eventos que deberían ser tratados con seriedad [4].

Frente a estas limitaciones, la visión computacional ha ganado relevancia como alternativa para la detección de fuego y humo mediante análisis de video. A diferencia del enfoque puntual, los sistemas basados en video observan la escena de forma continua y pueden extraer patrones relacionados con el color, la forma, el parpadeo, el crecimiento y el comportamiento espaciotemporal del fuego y del humo. Cuando esta lógica se combina con termografía, la capacidad analítica se amplía aún más, ya que el sistema puede considerar también la temperatura, la distribución térmica y anomalías invisibles al ojo humano.

Diversos trabajos previos han validado el uso de arquitecturas basadas en CNN y en la familia YOLO para la detección de humo y fuego en tiempo real [17]. Sin embargo, el estado del arte también deja claro que no existe una solución universal. El rendimiento depende de la calidad del dataset, del tipo de entorno, de las condiciones de iluminación, de la capacidad computacional disponible y de la forma en que se integran los componentes físicos y lógicos del sistema. En ese punto es donde se sitúa la contribución del presente proyecto: no se limitó a entrenar un clasificador, sino que articuló una solución integral de hardware, software, red y notificación enfocada en almacenes textiles [11, 13].

El componente diferencial más importante de la propuesta radica en la biespectralidad, ya que mientras que muchos esquemas de detección por video dependen exclusivamente del canal RGB, aquí se trabajó con una cámara Hikvision capaz de ofrecer simultáneamente visión óptica e infrarroja. Esa dualidad permite observar la escena y contextualizarla visualmente, pero al mismo tiempo medir y vigilar el comportamiento térmico de los objetos presentes en el campo de visión. Con ello se refuerza la posibilidad de advertir escenarios previos a la ignición, un aspecto particularmente valioso cuando se pretende pasar de un enfoque reactivo a uno más proactivo.

Diagrama en bloques: cámara Hikvision, Jetson Orin, ESP32 con sirena y pulsador, y servidores de la EICT con base de datos, backend y aplicación web
Figura 1. Diagrama en bloques de la solución de detección temprana de fuego diseñada
Diagrama de flujo de datos: detección con la cámara y el Jetson, envío del JSON, alerta en la web, correo electrónico y disparo de la sirena
Figura 2. Diagrama de flujo de datos de la solución propuesta

Objetivos completados

El desarrollo del presente proyecto permitió crear un sistema de detección de fuego mediante video para la identificación temprana de focos de fuego en almacenes de fábricas textiles, integrando una cámara termográfica biespectral para la captura simultánea del entorno en tiempo real, un esquema local de procesamiento con Jetson Orin para eficientizar la inferencia y reducir la latencia, una interfaz analógica habilitada mediante un microcontrolador ESP32-S3 para la activación de sirena estroboscópica y la posible integración de mecanismos de supresión, y una aplicación web de monitoreo capaz de recibir, administrar, visualizar y notificar alertas en tiempo real, consolidando así un flujo completo de adquisición, análisis, decisión y respuesta acorde con los objetivos planteados desde el inicio del proyecto.

Metodología basada en subsistemas para construir una solución integral

La metodología adoptada se apoyó en una lógica de subsistemas. En lugar de intentar una integración completa desde las primeras etapas, el desarrollo se organizó de forma que cada componente pudiera ser validado de manera independiente antes de su unificación final. Este enfoque permitió aislar problemas, asignar responsabilidades técnicas claras y reducir la complejidad durante el prototipado. El hardware, el software de inferencia, la plataforma web y la orquestación de alertas físicas fueron tratados como módulos con funciones específicas aunque desarrollados desde el principio como partes de un mismo flujo operativo.

En el plano del hardware se trabajó con tres piezas principales: la cámara termográfica biespectral Hikvision DS-2TD2617, la unidad de procesamiento local Jetson Orin y el microcontrolador ESP32-S3 con conectividad Ethernet. La cámara fue validada en sus dos canales de video RGB e infrarrojo, así como en su capacidad de retransmisión mediante protocolos IP como RTSP. El Jetson fue evaluado como plataforma para entrenamiento e inferencia con aceleración gráfica, mientras que el ESP32-S3 fue preparado para integrarse como publicador y suscriptor MQTT y como controlador de la interfaz de potencia asociada a la sirena y al pulsador manual de incendios.

El sistema físico también exigió resolver aspectos de instalación y soporte, puesto que la cámara Hikvision, debido a razones de sus características de peso y formato, requirió el diseño de un mecanismo de acople a un trípode robusto, construido a partir de una estructura metálica disponible en laboratorio y adaptaciones mecánicas sobre un registro genérico. Aunque a primera vista esto podría parecer una tarea menor, en realidad fue fundamental para viabilizar las pruebas en distintos escenarios y conservar movilidad durante la etapa experimental. El prototipo debía ser funcional, no obstante también manipulable y replicable dentro de un entorno académico controlado.

En lo relativo al procesamiento inteligente, se seleccionó la arquitectura YOLO en su variante YOLOv8n. Esta decisión respondió a dos criterios principales. En primer lugar, YOLO ha demostrado un balance favorable entre velocidad y precisión para tareas de detección en tiempo real [11]. Segundo, la variante nano resulta apropiada para una plataforma embebida como el Jetson Orin, donde la eficiencia en el uso de recursos es un factor estratégico. El proyecto valoró la posibilidad de emplear versiones más recientes, sin embargo, al final se priorizó la estabilidad y la documentación disponible alrededor de YOLOv8.

La construcción del banco de datos fue uno de los pasos más determinantes de la metodología. Se partió de un dataset curado de 9,775 imágenes proveniente de Roboflow Universe. Además, se adicionaron más de 150 imágenes elaboradas específicamente para el escenario de despliegue del sistema. Estas imágenes extra incorporaron variaciones de llamas, objetos incendiados y distintos niveles de iluminación dentro del espacio controlado del Laboratorio de Comunicaciones Aplicadas. Más adelante, mediante técnicas de aumento de datos, ese conjunto fue ampliado significativamente hasta conformar un dataset final de 24,558 imágenes, fortaleciendo la capacidad de generalización del modelo frente a distintas condiciones.

Dos capturas de la herramienta de etiquetado con llamas y humo anotados en el laboratorio
Figura 3. Ejemplares de imágenes caracterizadas para el dataset. Lugar de despliegue: Laboratorio de Comunicaciones Aplicadas, Campus Santiago

Las técnicas de aumento aplicadas incluyeron modificaciones de saturación, rotación, brillo y exposición. La decisión metodológica detrás de estas transformaciones fue simple pero importante: si la solución iba a ser usada en escenarios donde la iluminación cambia, donde la cámara puede no estar siempre en el mismo ángulo o donde el humo altera visualmente la escena, entonces el modelo debía ser expuesto durante el entrenamiento a esa diversidad de condiciones. De ese modo, se buscó disminuir la fragilidad del clasificador ante desviaciones razonables respecto del patrón base del dataset.

En la etapa de entrenamiento se fijó un máximo inicial de 300 epochs, acompañado de un mecanismo de parada temprana, criterio que fue coherente con prácticas comunes para datasets suficientemente curados, pero también evitó desperdiciar recursos computacionales cuando el proceso dejara de mostrar mejoras relevantes. El entrenamiento finalizó de manera prematura en 201 epochs, lo que fue interpretado como un indicio de convergencia alcanzada antes del límite establecido. La ejecución se realizó sobre el Jetson Orin, reforzando así el interés del proyecto por demostrar viabilidad real en una plataforma de borde y no únicamente en un entorno de laboratorio idealizado.

La metodología de inferencia no se limitó al análisis del video RGB, puesto que este no era el punto más fuerte del proyecto. El script desarrollado en Python 3.11 integró dos hilos de trabajo principales. El primero, apoyado en GStreamer y un enlace RTSP, se encargaba de recibir video en tiempo real, ejecutar inferencia con YOLOv8n y generar capturas asociadas a eventos detectados. El segundo se enfocaba en la lectura de temperatura desde la cámara Hikvision mediante ISAPI, la interfaz REST propietaria del fabricante Hikvision. Esta integración no fue trivial, puesto que requirió ajustar el modo de operación térmico de la cámara y resolver retos asociados con autenticación tipo Digest mediante la clase HTTPDigestAuth de la librería requests.

Otra decisión metodológica importante fue la definición del escenario de demostración. El proyecto estableció que la validación debía ocurrir en un entorno controlado capaz de simular condiciones de un almacén textil sin comprometer la seguridad del laboratorio. Para ello se contempló el uso de una unidad de cuerpo negro para inducir puntos calientes sin combustión real, así como pruebas adicionales con mechero y eyector de humo para reproducir situaciones de mayor riesgo. La importancia de esta estrategia radica en que permitió evaluar temperatura, humo y fuego en etapas iniciales bajo condiciones medibles, con posibilidad de variar distancia, iluminación y presencia de obstáculos parciales como cajas o estanterías.

La lógica de decisión se estructuró, primero, haciendo que el sistema verificara la existencia de fuego o humo mediante el clasificador de visión computacional. Luego, validaba la presencia de cuerpos de calor dentro de umbrales previamente definidos para los niveles de severidad establecidos: pre-alerta, alerta y acción. Finalmente, el sistema consolidaba ambos criterios y decidía qué información enviar al servidor centralizado en caso que aplicase. Esta articulación entre visión y temperatura constituye uno de los aportes metodológicos más valiosos del proyecto, puesto que evita depender exclusivamente de un único tipo de evidencia y aprovecha la riqueza de una cámara biespectral.

De manera paralela, se desarrolló una plataforma web sobre Java Spring Boot con arquitectura modular, separando controladores, servicios y repositorios. La aplicación integró Thymeleaf para el renderizado dinámico de vistas, WebSocket para la notificación inmediata de nuevas alertas, acceso a base de datos relacional para la persistencia de eventos y rutinas periódicas para verificación del estado de conexión de las cámaras. En conjunto, esta metodología permitió construir un sistema de monitoreo con trazabilidad, visualización histórica y capacidad de administración remota.

Dashboard web Fireblink con una notificación de nueva alerta de detección, contadores de alertas y últimas detecciones registradas
Figura 4. Alerta de detección informada en tiempo real a través de la página web mediante WebSocket. Pestaña: Dashboard

La etapa final de la metodología fue la integración del subsistema físico de respuesta. El ESP32-S3 fue programado para publicar y suscribirse a tópicos MQTT, recibir comandos desde el servidor y manipular el encendido o apagado de la sirena estroboscópica a través de un relay controlado por GPIO. En adición a lo anterior, se habilitó un pulsador de incendios que permite disparar la alarma manualmente desde el sitio de despliegue. De esta forma, el proyecto ideado conservó una filosofía híbrida: automatización cuando la evidencia lo exige y posibilidad de intervención física directa en escenarios donde el criterio humano sigue siendo necesario.

Caja de control con el ESP32-S3 y relé conectada a una sirena estroboscópica y a un pulsador de incendios rojo
Figura 5. Subsistema de hardware: controlador de interfaz de potencia con el ESP32-S3, sirena estroboscópica y pulsador de incendios

Resultados que validan la solución propuesta

Los resultados obtenidos permitieron constatar el funcionamiento general de la solución en el entorno controlado de pruebas. En términos globales, el sistema logró detectar conatos de incendios y eventos térmicos a partir de la combinación de los dos espectros trabajados, al mismo tiempo que consiguió registrar, almacenar y notificar las alertas a través de la plataforma web y de mecanismos físicos complementarios. Esto significa que el proyecto no se quedó en una validación aislada del modelo de visión, lo que se afirma bajo el enunciado de que se demostró la operatividad del flujo completo desde la captura hasta la alerta final.

En el caso del modelo de visión computacional, el entrenamiento con el dataset final de 24,558 imágenes mostró una tendencia progresiva de mejora en las pérdidas asociadas a localización y clasificación. El reporte describe una disminución sostenida en los valores de entrenamiento y validación, así como un comportamiento consistente cuando el modelo fue expuesto a muestras no vistas previamente. También se observó que la precisión aumentó de forma marcada al inicio del proceso y luego se estabilizó, comportamiento coherente con una curva de aprendizaje donde el modelo captura primero patrones más evidentes y después entra en una fase de refinamiento.

En la interpretación de clases bajo el modelo, el fuego alcanzó una detección correcta superior a la del humo, registrándose valores reportados en torno al 86 % en la matriz de confusión normalizada, mientras que el humo se ubicó alrededor del 67 %. Esta diferencia fue atribuida a la complejidad visual del humo, la cual con frecuencia se confunde con el fondo o pierde nitidez en condiciones de poca iluminación, aspecto que, principalmente, estuvo relacionado con limitaciones del hardware de video empleado.

Matriz de confusión normalizada con las clases Fire, Smoke y background
Figura 6. Matriz de confusión resultante del entrenamiento (normalizada)

Desde el punto de vista térmico, la cámara Hikvision logró detectar y reportar valores de temperatura dentro del rango esperado, luego de ser calibrada con una unidad de cuerpo negro capaz de inducir temperaturas aproximadas de 0 °C a 200 °C. El sistema comenzó a operar sobre valores mínimos útiles alrededor de 35 a 40 °C, conforme a las exigencias del firmware del dispositivo y no presentó inconvenientes en la identificación de cuerpos calientes dentro de ese dominio operativo. Se destaca, no obstante, una incertidumbre promedio de aproximadamente ± 5 % respecto del valor esperado, asociada a las características físicas y de diseño de la cámara.

La integración entre el Jetson Orin y el backend basado en Spring Boot también fue validada satisfactoriamente. Cada vez que el script detectaba un evento relevante, generaba una captura del momento, la almacenaba localmente y ejecutaba el proceso de registro hacia el servidor central. Esto incluía la inserción de la alerta en la base de datos, la publicación por WebSocket para los usuarios conectados y el envío de la imagen en Base64 para su posterior exposición dentro del sistema. En la práctica, esta secuencia permitió visualizar casi de inmediato el evento de detección en la plataforma de monitoreo, conservando además evidencia visual para fines de auditoría y análisis posterior.

La aplicación web cumplió con el objetivo de centralizar la información y hacerla operativamente útil, permitiendo visualizar alertas recientes, consultar el historial de imágenes asociadas, administrar dispositivos de detección, generar reportes filtrados por fecha y nivel de gravedad y revisar el estado de conexión de las cámaras desplegadas. La incorporación de WebSocket fue especialmente relevante, ya que aseguró la actualización en tiempo real de la interfaz sin necesidad de recargar manualmente la página, característica indispensable en un sistema donde segundos de retraso pueden tener consecuencias materiales y humanas.

La plataforma web también fue concebida desde una lógica de uso operativo y no únicamente de demostración académica. Por esa razón, la interfaz fue diseñada con énfasis en claridad visual, identificación rápida por niveles de severidad y acceso directo a acciones relevantes. Las vistas de detecciones recientes, detalles del evento, dispositivos registrados, historial y dashboard buscaban que el usuario no tuviera que interpretar estructuras complejas en un momento crítico. Esta preocupación por la usabilidad se conecta con la idea central del proyecto sugerida por maestros y superiores de que una buena precisión técnica pierde valor si la información no se presenta de manera comprensible y accionable para el personal responsable.

En cuanto a las notificaciones, el proyecto implementó un enfoque redundante y complementario, contando con el monitoreo visual mediante la aplicación web y la habilitación del envío de correo electrónico con la información principal de la detección, ampliando la posibilidad de reconocimiento del evento desde dispositivos móviles. Paralelamente, el subsistema físico basado en la sirena estroboscópica y el pulsador de incendios se integró con éxito, de modo que una alerta crítica podía traducirse en un aviso sonoro y luminoso directamente en el lugar de riesgo.

El comportamiento del ESP32-S3 resultó satisfactorio dentro de la lógica bidireccional prevista, puesto que el microcontrolador respondió correctamente tanto a las directivas MQTT emitidas por el servidor como a la activación local del pulsador manual, y envió las señales necesarias a la interfaz de potencia para encender la sirena y permitir la futura integración de otros subsistemas, como mecanismos de supresión. Este resultado es particularmente importante porque confirma que la solución puede ir más allá de la mera notificación y convertirse en una plataforma de orquestación de respuestas automáticas condicionadas al nivel de gravedad de la alerta.

En términos de alcance, el proyecto demostró que la arquitectura propuesta puede cubrir el ciclo completo de identificación, validación, transmisión, notificación y activación local. Al mismo tiempo, se evidencia que los resultados dejaron ver de forma honesta ciertas limitaciones. La efectividad del clasificador depende de que el entorno final se encuentre adecuadamente representado en el dataset. Además, variaciones importantes en iluminación o en condiciones físicas del espacio pueden repercutir en el rendimiento del modelo. Del mismo modo, el sistema necesita suministro eléctrico continuo, lo que abre la puerta a futuras mejoras relacionadas con respaldo energético. Lejos de debilitar la propuesta, estas observaciones ayudan a ubicarla dentro de un marco técnico realista y a orientar sus siguientes etapas de evolución.

Una base sólida para futuras implementaciones

Considerando los resultados obtenidos, el proyecto cumplió con las expectativas definidas en su objetivo general y en sus objetivos específicos. Fue posible construir un sistema capaz de observar un entorno de almacén mediante una cámara biespectral, procesar localmente la información con un modelo de visión computacional, combinar esa inferencia con lectura térmica, transmitir las alertas a un servidor centralizado y notificar al personal a través de una plataforma web, correo electrónico y mecanismos físicos de alarma. La integración de todos estos componentes, lograda dentro de un contexto académico y con énfasis en viabilidad práctica, confirma el valor del trabajo desarrollado.

Uno de los aportes más relevantes de la solución es haber demostrado que la detección temprana de fuego puede abordarse desde una arquitectura híbrida y escalable, donde una cámara con capacidades térmicas y visibles, apoyada por procesamiento en el borde puede ofrecer cobertura útil sin depender exclusivamente de una gran cantidad de sensores puntuales. De acuerdo con el propio análisis del proyecto, una sola cámara biespectral puede cubrir entre 100 y 150 metros cuadrados, mientras que una misma unidad Jetson Orin podría albergar la operatividad de múltiples cámaras. Esta observación sugiere un potencial importante de crecimiento para futuras implementaciones.

En adición al flujo principal de detección, el envío periódico de health checks introdujo un componente de autovigilancia del propio sistema. Al medir latencia, pérdida de paquetes y ancho de banda, la solución informaba sobre el estado operativo de la infraestructura que debía detectar los eventos de riesgo. Esta capa de observabilidad es particularmente útil en despliegues reales, donde una cámara desconectada o con mala calidad de enlace puede crear una falsa percepción de seguridad. En consecuencia, el proyecto integró la noción de que monitorear el detector es casi tan importante como monitorear el entorno detectado.

También resulta valioso destacar que el proyecto no buscó presentar su solución como sustituto universal de todos los sistemas convencionales, sino como una respuesta frente a necesidades específicas de la industria textil y el ahorro de costos sin sacrificio de funcionalidad y seguridad. En lugar de generalizar indebidamente, lo propuesto se posiciona como una arquitectura con alta pertinencia para almacenes textiles y otros espacios donde conviene anticipar anomalías térmicas y fenómenos visuales antes de que el incendio se consolide.

De cara al futuro el propio desarrollo deja abiertas varias líneas de mejora, siendo una de ellas avanzar hacia configuraciones automáticas de períodos de entrenamiento y caracterización del entorno, de modo que el sistema pueda ajustar dinámicamente umbrales según temperatura promedio, objetos comunes en la escena o comportamientos regulares del espacio de despliegue. Otra línea natural de evolución es la incorporación de canales adicionales de notificación, como llamadas VoIP o mensajería instantánea, fortaleciendo todavía más la capacidad de respuesta en situaciones de mayor gravedad.

Los resultados alcanzados deben interpretarse dentro de la filosofía de desarrollo planteada desde el inicio. El proyecto pretendía demostrar la factibilidad técnica de una solución integral y sentar bases para evoluciones posteriores. Bajo ese criterio, la validación de la comunicación entre subsistemas, la correcta persistencia de evidencias, la activación física de alertas y la obtención consistente de valores térmicos adquieren un peso considerable, porque prueban que la arquitectura es coherente y que sus módulos pueden crecer sin necesidad de replantear por completo el sistema.

A modo de cierre, este proyecto ofrece una evidencia concreta de cómo la integración entre componentes que podrían anteriormente considerarse como “aislados” puede traducirse en una herramienta útil para la prevención de incendios en entornos industriales sensibles. Desde una perspectiva de innovación aplicada, el trabajo confirma que la ingeniería adquiere mayor valor cuando se orienta a proteger vidas, reducir riesgos y ofrecer alternativas viables frente a limitaciones del contexto. Por ello, el sistema desarrollado se visualiza como una plataforma inicial sobre la cual continuar investigando, refinando el modelo, ampliando las capacidades de notificación e impulsando futuras implementaciones piloto en escenarios cada vez más cercanos a la operación real.

Referencias

  1. M. T. Siraj, B. Debnath, S. B. Payel, A. B. M. M. Bari, y A. R. M. Towfiqul Islam, «Analysis of the fire risks and mitigation approaches in the apparel manufacturing industry: Implications toward operational safety and sustainability», sep. 2023. [En línea]. Disponible en: https://www.cell.com/heliyon/fulltext/S2405-8440(23)07520-5?uuid=uuid%3Af099052d-3f01-48bf-9adb-6c0d2124e28c
  2. S. S. Moumgiakmas, G. G. Samatas, y G. A. Papakostas, «Computer Vision for Fire Detection on UAVs—From Software to Hardware», Future Internet, vol. 13, n.º 8, p. 200, jul. 2021, doi: 10.3390/fi13080200.
  3. B. Li, F. Xu, X. Li, C. Yu, y X. Zhang, «Early Stage Fire Detection System Based on Shallow Guide Deep Network», Fire Technology, vol. 60, n.º 3, pp. 1803-1821, feb. 2024, doi: 10.1007/s10694-024-01549-1.
  4. J. Lin y X. Xu, «Design of a textile storage environment fire detection system based on ZigBee and NB-IoT», Journal Of Physics Conference Series, vol. 2797, n.º 1, p. 012031, jul. 2024, doi: 10.1088/1742-6596/2797/1/012031.
  5. Q. Zhang, Y. Tian, J. Chen, X. Zhang, y Z. Qi, «To ensure the safety of storage: Enhancing accuracy of fire detection in warehouses with deep learning models», jul. 2024. [En línea]. Disponible en: https://www.sciencedirect.com/science/article/abs/pii/S0957582024009303
  6. J. Ryu y D. Kwak, «A Study on a Complex Flame and Smoke Detection Method Using Computer Vision Detection and Convolutional Neural Network», Fire, vol. 5, n.º 4, p. 108, jul. 2022, doi: 10.3390/fire5040108.
  7. K. Avazov, M. K. Jamil, B. Muminov, A. B. Abdusalomov, y Y.-I. Cho, «Fire Detection and Notification Method in Ship Areas Using Deep Learning and Computer Vision Approaches», Sensors, vol. 23, n.º 16, p. 7078, ago. 2023, doi: 10.3390/s23167078.
  8. Khondaker, A. Khandaker, y J. Uddin, «Computer Vision-based Early Fire Detection Using Enhanced Chromatic Segmentation and Optical Flow Analysis Technique», mar. 2020. [En línea]. Disponible en: https://d1wqtxts1xzle7.cloudfront.net/84536670/18967-libre.pdf
  9. A. B. A. J. C. Mukhriddin Mukhiddinov, «A Wildfire Smoke Detection System Using Unmanned Aerial,» 2022. [En línea]. Available: https://mdpi-res.com/d_attachment/sensors/sensors-22-09384/article_deploy/sensors-22-09384.pdf?version=1669897124.
  10. L. W. T. L. P. S. Zhong Wang, «A Smoke Detection Model Based on Improved YOLOv5,» 2022. [En línea]. Available: https://mdpi-res.com/d_attachment/mathematics/mathematics-10-01190/article_deploy/mathematics-10-01190.pdf?version=1649216740.
  11. M. Mukhiddinov, A. B. Abdusalomov, and J. Cho, “Automatic Fire Detection and Notification System Based on Improved YOLOv4 for the Blind and Visually Impaired,” Sensors, vol. 22, no. 9, May 2022, doi: 10.3390/s22093307.
  12. M. A. Rahman, S. T. Hasan, and M. A. Kader, “Computer Vision Based Industrial and Forest Fire Detection Using Support Vector Machine (SVM),” in 2022 International Conference on Innovations in Science, Engineering and Technology, ICISET 2022, Institute of Electrical and Electronics Engineers Inc., 2022, pp. 233–238. doi: 10.1109/ICISET54810.2022.9775775.
  13. C. Jin et al., “Video Fire Detection Methods Based on Deep Learning: Datasets, Methods, and Future Directions,” Fire, vol. 6, no. 8. Multidisciplinary Digital Publishing Institute (MDPI), Aug. 01, 2023. doi: 10.3390/fire6080315.
  14. K. Avazov, M. Mukhiddinov, F. Makhmudov, and Y. I. Cho, “Fire detection method in smart city environments using a deep-learning-based approach,” Electronics (Switzerland), vol. 11, no. 1, Jan. 2022, doi: 10.3390/electronics11010073.
  15. S. Islam, M. Abdul Hannan Mia, and M. Zoynal Abedin, “Evaluation of Causes and Effects of Fire and Other Safety Incidents in Readymade Garment Industry of Bangladesh,” American Journal of Mechanical and Industrial Engineering, vol. 7, no. 2, p. 13, 2022, doi: 10.11648/j.ajmie.20220702.11.
  16. S. Saponara, A. Elhanashi, and A. Gagliardi, “Real-time video fire/smoke detection based on CNN in antifire surveillance systems,” Journal of Real-Time Image Processing, vol. 18, no. 3, pp. 889–900, Jun. 2021, doi: 10.1007/s11554-020-01044-0.
  17. S. Geetha, C. S. Abhishek, and C. S. Akshayanat, “Machine Vision Based Fire Detection Techniques: A Survey,” Fire Technology, vol. 57, no. 2. Springer, pp. 591–623, Mar. 01, 2021. doi: 10.1007/s10694-020-01064-z.
  18. A. Gaur, A. Singh, A. Kumar, A. Kumar, and K. Kapoor, “Video Flame and Smoke Based Fire Detection Algorithms: A Literature Review,” Fire Technology, vol. 56, no. 5. Springer, pp. 1943–1980, Sep. 01, 2020. doi: 10.1007/s10694-020-00986-y.
  19. K. R. Ahmed and M. Alomgir Hossain, “An automated IOT based fire detection & safety control for garments industry in Bangladesh: A-study,” in 2021 International Conference on Automation, Control and Mechatronics for Industry 4.0, ACMI 2021, Institute of Electrical and Electronics Engineers Inc., Jul. 2021. doi: 10.1109/ACMI53878.2021.9528094.
  20. K. Howell, K. Dudek, and M. Soroko, “Thermal camera performance and image analysis repeatability in equine thermography,” Infrared Physics and Technology, vol. 110, Nov. 2020, doi: 10.1016/j.infrared.2020.103447.

Sistema de monitoreo de trampas para insectos

Jordy Johan Camacho Taveras y Emil Arias – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la automatización y el análisis de datos comienzan a revolucionar el sector agroindustrial, el presente proyecto nace como una solución práctica, innovadora y replicable para el control de plagas en ambientes de almacenamiento, específicamente en almacenes de tabaco. Esta iniciativa fue desarrollada por los estudiantes Emil Arias y Jordy Johan Camacho como parte de su Proyecto Final de Grado para optar por el título de Ingeniero en Telemática en la Pontificia Universidad Católica Madre y Maestra (PUCMM). Bajo la guía académica de la Escuela de Computación y Telecomunicaciones (EICT), el proyecto se enfocó en transformar un proceso manual e ineficiente —la inspección visual de trampas adhesivas para insectos— en una plataforma inteligente, autónoma y accesible.

La motivación surgió de una problemática real: almacenes agrícolas en República Dominicana dependen de la revisión humana para detectar plagas en trampas físicas, lo que implica tiempo, errores humanos y decisiones poco fundamentadas. La falta de registros históricos, la ausencia de análisis en tiempo real y el uso excesivo de pesticidas sin validación técnica son consecuencias directas de esta carencia de tecnología. Frente a ello, se propuso un sistema integral que incorpora elementos de visión por computadora, aprendizaje automático y arquitectura IoT con dispositivos de bajo costo, logrando así una alternativa accesible para pequeños y medianos productores.

El proyecto integra un nodo inteligente de captura y análisis local basado en Raspberry Pi 5, equipado con una cámara IMX577 de alta resolución y un aro LED WS2812, el cual permite generar condiciones de iluminación constante para mejorar la calidad de las capturas. Sobre estas imágenes se ejecuta un modelo de detección de objetos optimizado con YOLO + NCNN, el cual identifica y clasifica insectos detectados sobre las trampas. Los resultados, junto con las imágenes anotadas, se envían mediante el protocolo MQTT a un servidor Raspberry Pi secundario que actúa como plataforma de recepción, almacenamiento en base de datos y presentación a través de una interfaz web sencilla y funcional. Esta arquitectura no solo permite monitoreo remoto, sino también almacenamiento local en caso de desconexión, garantizando resiliencia ante fallos.

Prototipo: interior de la caja con dos trampas adhesivas bajo la cámara y vista exterior del dispositivo
Figura 1. Vista de prototipo.

Este tipo de tecnología ya ha sido explorado en países desarrollados mediante soluciones como Trapview y PestNet, que utilizan cámaras y procesamiento en la nube para visualizar trampas electrónicas. Sin embargo, muchas de estas plataformas exigen altos costos de adquisición o suscripción, y requieren conectividad constante a internet, lo cual no es viable en muchas zonas rurales del país [1][2]. En contraposición, este sistema fue diseñado para operar de manera autónoma, sin depender de servicios externos, lo que lo convierte en una opción viable para entornos donde los recursos son limitados.

El uso de modelos como YOLO en la agricultura de precisión ha sido validado por estudios recientes. Por ejemplo, el trabajo de Sun et al. [3] demostró la efectividad del modelo YOLOv8 para detectar plagas del tabaco en condiciones complejas de luz y fondo. Asimismo, investigaciones como las de Ramalingam et al. [4] destacan cómo la visión artificial puede reducir significativamente la intervención humana en tareas de monitoreo. Estos antecedentes avalan el enfoque técnico del presente proyecto, que no solo replica, sino que adapta estas metodologías a una realidad local dominicana.

El desarrollo de este proyecto ha implementado un sistema de monitoreo de trampas adhesivas basado en visión por computadora y dispositivos IoT, orientado a reducir los errores humanos, mejorar la trazabilidad, y permitir una respuesta ágil ante infestaciones en almacenes de tabaco. Se logró crear una solución funcional capaz de detectar insectos automáticamente, registrar los datos con imágenes auditables, transmitir los resultados mediante MQTT, almacenarlos en una base de datos MySQL, y presentarlos de forma clara en una interfaz web, cumpliendo todos los objetivos específicos planteados.

Para alcanzar estos resultados, se diseñaron dos módulos: el primero, un nodo de detección autónomo con la capacidad de capturar imágenes cada dos minutos, analizarlas mediante el modelo entrenado y generar imágenes anotadas con bounding boxes de distintos colores según la clase detectada. El segundo módulo funciona como servidor web y base de datos, permitiendo centralizar y consultar los resultados desde una interfaz organizada. A nivel técnico, se integró una lógica de tolerancia a fallos: cuando no se detecta conexión con el broker MQTT, los resultados se almacenan localmente y se reenvían una vez restablecida la conexión.

Diagrama de bloques: cámara USB y aro LED, Raspberry Pi de detección, modelo, MQTT, Raspberry Pi servidor web, MySQL y página web
Figura 2. Diagrama de bloques del sistema.
Pantalla de inicio de sesión y panel principal de la interfaz SmartTrap
Figura 3. Interfaz visual.

Una de las características más relevantes del sistema es su capacidad de alertar automáticamente sobre situaciones críticas. Se desarrolló una lógica que permite generar alertas en tres escenarios: detección crítica (por cantidad alta de insectos), aumento sostenido (presencia progresiva día tras día), y presencia persistente (cuando un mismo tipo de insecto aparece durante varios días consecutivos). Estas alertas se visualizan en el dashboard, permitiendo al personal técnico actuar a tiempo y aplicar pesticidas de forma más responsable.

En cuanto a la validación, se llevaron a cabo dos fases. En la primera, se colocaron insectos reales (muertos) sobre trampas adhesivas en un entorno de laboratorio para simular escenarios de infestación. El sistema logró detectar correctamente múltiples especies, alcanzando un mean Average Precision (mAP) superior al 90%, lo que evidenció la precisión del modelo YOLO optimizado bajo condiciones controladas.

Para la segunda fase, aunque se planificó una prueba extendida en un almacén real de tabaco, no se obtuvieron los permisos necesarios para realizar la validación completa en ese entorno. Sin embargo, se simuló el comportamiento del sistema en condiciones similares, procesando más de 1000 capturas obtenidas a partir de datos de pruebas internas y casos registrados previamente. Las pruebas demostraron que el sistema mantenía un desempeño estable ante variaciones de iluminación y presencia de interferencias visuales como polvo o residuos, confirmando su capacidad de operar en condiciones reales.

Panel con gráficas de detecciones por tipo de insecto y alertas por severidad
Figura 4. Gráfica de detecciones por tipo de insecto.
Pantalla de gestión de alertas de SmartTrap
Figura 5. Tabla de alertas.

Entre los beneficios más destacados está la reducción estimada del uso innecesario de pesticidas en un 30%, la disminución de horas de inspección manual, y la trazabilidad digital que permite revisar históricamente el comportamiento de las plagas por trampa, tipo y fecha. Además, la arquitectura utilizada es completamente replicable: con una sola Raspberry Pi por trampa y otra como servidor central, el sistema puede escalar fácilmente a más ubicaciones sin necesidad de conexión a internet externa, ya que puede operar de forma autónoma dentro de una red local.

A pesar de los logros obtenidos, se identificaron algunas limitaciones que serán abordadas en futuras versiones. Por ejemplo, aunque el sistema no requiere conexión a internet, sí necesita una red Wi-Fi local para la transmisión de datos entre las trampas y el servidor. En zonas rurales sin infraestructura de red, será necesario incorporar módulos de comunicación celular. También se identificó que la detección puede verse afectada si la trampa está mal posicionada o sucia, y que actualmente solo se detectan especies entrenadas previamente, por lo que se planea ampliar la base de datos con más clases.

El impacto de este proyecto no se limita al almacén de tabaco donde se probó. Su arquitectura modular, bajo costo y facilidad de uso lo convierten en una herramienta adaptable a otros sectores agrícolas y productivos. Su diseño responde directamente a las necesidades del contexto local, permitiendo un avance en la transformación digital del agro dominicano. Asimismo, fomenta una cultura de control basado en datos y evidencia, necesaria para optimizar recursos, cumplir regulaciones sanitarias y proteger el medio ambiente.

Tabla de lecturas por captura con filtros en la interfaz web
Figura 6. Interfaz web, mostrando historial por trampas y filtros por fecha/tipo de insecto.

Resultados

La validación del sistema de monitoreo inteligente para trampas adhesivas fue una etapa crucial para demostrar su efectividad técnica y su aplicabilidad práctica. Para ello, se diseñó una estrategia de pruebas dividida en dos fases complementarias: una fase experimental bajo condiciones controladas en laboratorio y una fase aplicada en campo simulado, debido a limitaciones de acceso a almacenes reales.

Fase 1: Validación en laboratorio

Durante esta fase se buscó verificar la precisión del modelo en un entorno ideal. Se utilizaron trampas adhesivas sobre las cuales se colocaron manualmente insectos reales (muertos) pertenecientes a diferentes especies objetivo, como hormigas, cucarachas, polillas, moscas y lasioderma. Estas trampas fueron iluminadas con el aro LED Neopixel incluido en el sistema, y las imágenes fueron capturadas por la cámara de alta resolución conectada a la Raspberry Pi.

Posteriormente, cada imagen fue procesada por el modelo entrenado YOLOv8 adaptado a NCNN, con el objetivo de identificar correctamente cada clase de insecto. Los resultados obtenidos fueron altamente satisfactorios. Se alcanzó un mAP superior al 90%, lo cual indica una precisión promedio muy alta en la detección de las distintas clases.

En la Figura 7 se presenta la curva de precisión frente a confianza para cada clase, incluyendo un resumen de desempeño general. Se observa que todas las clases muestran altos niveles de precisión incluso en niveles de confianza elevados, lo que evidencia una baja tasa de falsos positivos.

Curva de precisión frente a confianza por clase de insecto
Figura 7. Curva Precisión–Confianza por clase, incluyendo promedio general del modelo.

Adicionalmente, se evaluó el comportamiento del modelo durante su proceso de entrenamiento. En la Figura 8 se muestran las gráficas de pérdidas (box, clasificación y distribución focal) tanto en entrenamiento como en validación, así como la evolución de métricas clave como precisión, recall y mAP en distintas variantes. Estas gráficas evidencian una convergencia estable y efectiva del modelo, sin señales de sobreajuste.

Gráficas de pérdidas, precisión, recall y mAP durante el entrenamiento
Figura 8. Gráficas de pérdida, precisión y mAP durante el entrenamiento y validación del modelo.

Por último, se realizó una evaluación cualitativa de los resultados mediante la revisión visual de las imágenes etiquetadas automáticamente por el sistema. En la Figura 9, se muestra un conjunto representativo de estas detecciones, donde puede observarse claramente cómo el sistema reconoce múltiples insectos de diferentes clases en una misma trampa, asignando bounding boxes con etiquetas precisas y colores distintos por clase, incluso bajo iluminación variable.

Mosaico de capturas de trampas con insectos detectados y etiquetados
Figura 9. Detecciones de insectos en trampas adhesivas utilizando el modelo entrenado.

Fase 2: Validación en entorno real simulado

Aunque inicialmente se había planificado implementar el sistema dentro de un almacén real de tabaco para evaluar su funcionamiento en condiciones operativas reales, no se obtuvieron los permisos necesarios para realizar dicha instalación. No obstante, se optó por una validación alternativa simulando condiciones reales: el sistema operó durante una semana consecutiva, en un entorno preparado que replicaba iluminación ambiental tenue, interferencias como polvo, y rotación de trampas con capturas reales.

Durante esta etapa, el sistema generó más de 1000 capturas, las cuales fueron procesadas y analizadas de manera autónoma por la Raspberry Pi. El sistema detectó exitosamente la presencia de insectos en trampas, enviando los resultados al servidor mediante MQTT, o almacenándolos temporalmente en memoria local si había problemas de conectividad.

La tasa de detección se mantuvo alta incluso ante interferencias visuales, y el sistema demostró un desempeño robusto en condiciones menos controladas. Esta validación fue clave para comprobar que el modelo no solo funciona en condiciones ideales, sino también en escenarios más complejos y con ruido visual, como los que se encuentran en almacenes de productos agrícolas.

Impacto operativo y funcional

Más allá del rendimiento técnico del modelo, el sistema demostró tener un impacto positivo a nivel operativo y práctico. Entre los beneficios observados destacan:

  • Reducción del uso innecesario de pesticidas: Se estima una disminución del 30% en aplicaciones químicas innecesarias, ya que ahora las acciones se toman con base en datos y alertas reales.
  • Ahorro de tiempo en inspecciones manuales: Las inspecciones, que antes podían tardar horas en recorridos físicos por cada trampa, se redujeron a minutos gracias al monitoreo remoto desde la plataforma web.
  • Generación de alertas inteligentes: El sistema fue capaz de emitir alertas automáticas en base a distintos patrones de riesgo definidos (detección crítica, aumento sostenido y presencia persistente). Estas alertas permitieron al personal técnico reaccionar de manera proactiva, evitando la propagación de infestaciones.
  • Integridad de los datos: La lógica de almacenamiento local ante pérdidas de conectividad temporal demostró ser efectiva, evitando pérdidas de información valiosa.

Conclusión

El desarrollo del sistema inteligente de monitoreo de trampas adhesivas representa una contribución significativa al proceso de transformación digital en la industria agrícola de la República Dominicana. Esta solución, concebida e implementada por estudiantes de ingeniería de la PUCMM, demuestra cómo desde el entorno académico pueden generarse innovaciones tecnológicas de bajo costo, basadas en arquitecturas distribuidas y modelos de inteligencia artificial entrenados localmente, capaces de responder a problemáticas concretas del sector agroindustrial.

Más allá de su funcionalidad técnica, el sistema impulsa una nueva forma de gestión agrícola basada en datos objetivos, permitiendo optimizar la toma de decisiones, reducir el uso innecesario de pesticidas, minimizar el tiempo de inspección manual y mantener trazabilidad histórica sobre la actividad biológica en almacenes. Su diseño modular y escalable, que combina dispositivos Raspberry Pi en campo con un servidor local central, permite su replicación sin necesidad de conexión a internet externa, funcionando de manera autónoma en redes Wi-Fi privadas. No obstante, para escenarios rurales sin cobertura, se plantea como mejora futura la incorporación de conectividad 4G.

Asimismo, se reconocen oportunidades de evolución como el entrenamiento de nuevos modelos con más especies, el perfeccionamiento del posicionamiento físico de trampas y la implementación de lógica predictiva basada en tendencias. Estas mejoras permitirán al sistema no solo detectar plagas en tiempo real, sino también anticipar su aparición y facilitar respuestas tempranas más eficientes.

En definitiva, este proyecto reafirma el rol estratégico de la academia como motor de soluciones tecnológicas orientadas a los sectores productivos. Su desarrollo es una muestra concreta del impacto que pueden tener los proyectos estudiantiles bien dirigidos, cuando se articulan conocimientos técnicos con necesidades reales del entorno nacional.

Referencias

  1. TrapView – Sistema de monitoreo de plagas basado en visión artificial. [En línea]. Disponible en: https://www.trapview.com/
  2. PestNet – Monitoreo de trampas en cultivos. [En línea]. Disponible en: https://pestnet-europe.es/
  3. D. Sun et al., “Efficient Tobacco Pest Detection in Complex Environments Using an Enhanced YOLOv8 Model”, Agriculture, vol. 14, no. 3, p. 353, 2024.
  4. B. Ramalingam et al., “Remote Insects Trap Monitoring System Using Deep Learning Framework and IoT”, Sensors, vol. 20, no. 18, p. 5280, 2020.
  5. K. S. & K. D. Suresh, “Crop Pest Control using IoT Real-Time Monitoring and Intervention”, IEEE Access, 2023.
  6. M. Inoue, “IoT Monitoring System for Agricultural Pests and Diseases”, IEEE, 2018.

Software de monitoreo de red para detección de anomalías para MIPYMES

Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

En un contexto donde la digitalización ha redefinido la operativa de las empresas, las micro, pequeñas y medianas empresas (MIPYMES) enfrentan un desafío particular: mantener su competitividad sin comprometer la seguridad de su información. La integración progresiva de tecnologías de la información en estas organizaciones ha traído consigo un aumento exponencial en su exposición a amenazas cibernéticas, a menudo sin el respaldo de soluciones robustas que mitiguen los riesgos. Mientras que las grandes empresas disponen de infraestructuras avanzadas y personal capacitado para enfrentar este tipo de desafíos, las MIPYMES se ven limitadas por recursos económicos, técnicos y humanos. Este panorama ha motivado el desarrollo de soluciones especializadas, entre ellas el “Software de Monitoreo de Red para Detección de Anomalías para MIPYMES”, concebido por Miguel Ángel Brito Cruz e Ismael Eduardo Reynoso Rodríguez como parte de su proyecto de grado en la Pontificia Universidad Católica Madre y Maestra (PUCMM).

A diferencia de otros productos comerciales, este software no requiere infraestructuras complejas ni licencias costosas. Está diseñado para ejecutarse en plataformas asequibles como la Raspberry Pi, lo que permite su implementación incluso en entornos con recursos limitados. Esta elección no solo reduce los costos, sino que también facilita el despliegue en redes pequeñas sin afectar el rendimiento. Uno de los pilares de esta solución es su enfoque en el análisis de metadatos en lugar del contenido del tráfico, lo que permite mantener la privacidad de los datos y alinearse con normativas como el Reglamento General de Protección de Datos (RGPD) [1].

Como parte del proceso de diseño, se identificaron las amenazas más comunes en redes que pertenezcan a empresas sin importar su tamaño: ataques de denegación de servicio distribuido (DDoS), escaneo de puertos y fuerza bruta. Estos ataques, aunque variados en su metodología, comparten un mismo objetivo: comprometer la disponibilidad o la confidencialidad de los sistemas. Al simular estos escenarios en entornos controlados utilizando herramientas como Mininet y Wireshark, fue posible analizar con precisión cómo estas amenazas afectan el comportamiento del tráfico de red, extrayendo métricas clave como la tasa de paquetes por segundo, los puertos únicos involucrados, las banderas TCP y la duración de la sesión.

El desarrollo de este proyecto ha permitido implementar un software de monitoreo de red basado en algoritmos de aprendizaje automático, ejecutado en una Raspberry Pi, que permite a las MIPYMES detectar y mitigar amenazas como ataques DDoS, escaneo de puertos y fuerza bruta. Para lograr este objetivo general, se diseñó un sistema escalable compatible con la infraestructura de red existente, se evaluaron modelos como Isolation Forest. Asimismo, se validó experimentalmente su desempeño mediante simulaciones en entornos controlados, confirmando su efectividad y adaptabilidad para su posterior implementación en escenarios reales.

Uno de los elementos más innovadores de esta propuesta radica en la integración de algoritmos de aprendizaje automático para la detección de anomalías. En particular, el uso del algoritmo Isolation Forest resultó crucial debido a su capacidad para identificar patrones inusuales sin necesidad de datos etiquetados, lo que lo convierte en una opción ideal para entornos con tráfico no estructurado y dinámico [11][13]. En pruebas realizadas con datos simulados y reales, este modelo demostró una tasa de detección superior al 90 %, superando a otros enfoques como DBSCAN y One-Class SVM, tanto en precisión como en baja latencia de respuesta [3][12][14].

Durante el desarrollo del sistema, se consideró también la escalabilidad y la eficiencia del procesamiento. Por ello, se incorporaron herramientas como Pandas para el análisis inicial y Dask para el procesamiento distribuido de grandes volúmenes de datos [6][7]. En etapas más avanzadas, se implementó un pipeline sobre Apache Spark, lo que permitió analizar datasets de más de un millón de registros sin comprometer la velocidad del sistema [5].

Es relevante destacar que el sistema no se limita a la detección pasiva. Incluye funcionalidades proactivas como la capacidad de bloquear automáticamente los puertos involucrados en un ataque, mitigando su impacto en tiempo casi real. Este proceso se apoya en reglas heurísticas codificadas a partir de umbrales aprendidos durante la fase de entrenamiento del modelo, los cuales son reforzados por el análisis del algoritmo Isolation Forest. Por ejemplo, un incremento repentino de conexiones hacia múltiples puertos en segundos puede ser indicativo de un ataque DDoS, mientras que múltiples intentos de conexión por SSH en breves intervalos apuntan a un posible ataque de fuerza bruta [26][30][31].

Aunque este software fue concebido inicialmente como un sistema que monitorea y detecta diversas anomalías, su arquitectura y lógica operativa lo posicionan funcionalmente más cerca de un sistema de prevención de intrusiones (IPS) que de un sistema puramente pasivo de detección (IDS). A diferencia de un IDS, que solo analiza el tráfico y alerta al administrador de red ante posibles amenazas, un IPS está diseñado para reaccionar automáticamente ante dichas amenazas y tomar medidas correctivas en tiempo real.

Este software incorpora precisamente esa capacidad de acción inmediata. Por ejemplo, cuando el sistema detecta comportamientos anómalos —como un aumento súbito de conexiones simultáneas hacia múltiples puertos, típico de un ataque DDoS, o múltiples intentos de autenticación SSH en corto tiempo, característicos de un ataque de fuerza bruta— puede ejecutar comandos automatizados para bloquear los puertos involucrados o aislar temporalmente la IP ofensora. Estas acciones son llevadas a cabo por scripts que interactúan directamente con el firewall del sistema operativo, permitiendo una respuesta prácticamente en tiempo real sin intervención humana.

Además, esta lógica de prevención se basa en una combinación de heurísticas definidas por expertos y el análisis dinámico del algoritmo de aprendizaje automático Isolation Forest. Esto permite al sistema no solo actuar frente a amenazas conocidas, sino también responder ante patrones inusuales de comportamiento que podrían corresponder a ataques novedosos o sofisticados. Esta capacidad adaptativa lo diferencia notablemente de los IPS tradicionales basados únicamente en firmas estáticas.

La interfaz gráfica de usuario, desarrollada con un enfoque intuitivo, permite a los usuarios visualizar el estado de la red en tiempo real, recibir notificaciones, modificar umbrales de detección y consultar reportes. Esta interfaz resulta esencial en entornos donde el personal técnico puede ser limitado, ya que democratiza el acceso a funcionalidades avanzadas de monitoreo y respuesta.

Salida de consola del sensor: métricas capturadas de una sesión de red y clasificación como tráfico normal
Figura 1. Salida del sensor: métricas capturadas de una sesión de red y su clasificación.

Otra característica destacada es la generación de alertas vía correo electrónico, función que puede ser configurada desde la GUI y que permite a los administradores recibir notificaciones en tiempo real cuando se detectan comportamientos sospechosos. Estas alertas no solo informan sobre el evento, sino que detallan métricas específicas del tráfico involucrado y la clasificación del tipo de amenaza.

En cuanto a la privacidad de los datos, el sistema implementa múltiples capas de protección: anonimización de direcciones IP, tokenización de credenciales y cifrado de las capturas de tráfico (PCAP) mediante protocolos como TLS/SSL [22]. Además, se ha implementado un sistema de control de acceso basado en roles (RBAC), lo que permite restringir la visualización y edición de parámetros sensibles según el tipo de usuario.

El sistema fue validado mediante pruebas experimentales en laboratorios didácticos de la Escuela de Ingeniería en Computación y Telecomunicaciones (EICT) de la PUCMM. Se configuraron topologías que simulan redes reales, incluyendo clientes, servidores y nodos maliciosos. A lo largo de estas pruebas, se midieron métricas como la tasa de verdaderos positivos, tasa de falsos positivos, tiempo de reacción, y uso de recursos del sistema. Los resultados demostraron que incluso en condiciones de tráfico intenso y ataques simultáneos, la Raspberry Pi fue capaz de mantener el procesamiento de datos en tiempo real, activando bloqueos automáticos en menos de 7 segundos desde la detección de la amenaza.

Este proyecto no solo demuestra la viabilidad técnica de una solución de ciberseguridad accesible para MIPYMES, sino que también aporta al ámbito académico y social al validar un modelo replicable para otras instituciones o empresas que enfrenten limitaciones similares. Se plantea como una solución modular, que puede crecer conforme lo hagan las necesidades de la empresa. Por ejemplo, si una MIPYME decide migrar parte de su infraestructura a la nube, el sistema puede ser adaptado para correr sobre instancias virtualizadas, integrarse con SIEMs externos o incorporar sensores IoT para nuevas formas de monitoreo [16][17].

El valor de esta propuesta también se aprecia en su enfoque pedagógico: al haber sido desarrollado en un contexto académico, representa un ejemplo concreto de cómo la investigación aplicada puede responder a necesidades reales del sector productivo. El proyecto se alinea así con una tendencia creciente en el ámbito de la ciberseguridad: la descentralización de las soluciones y su personalización según el entorno operativo, especialmente en regiones en desarrollo donde las soluciones comerciales no siempre son viables [2][29].

En suma, el desarrollo de este software representa un paso importante hacia una ciberseguridad más democrática, donde incluso las organizaciones más pequeñas pueden acceder a herramientas inteligentes de defensa. El uso de aprendizaje automático, herramientas open-source y plataformas de bajo costo demuestra que es posible construir soluciones efectivas sin depender de grandes presupuestos, siempre que se cuente con una metodología sólida, una comprensión clara del problema y un compromiso con la innovación.

A partir de las validaciones experimentales, se observaron también beneficios colaterales que hacen de esta herramienta una solución integral. Una de ellas es su potencial como plataforma de entrenamiento para personal técnico, ya que permite observar en tiempo real cómo se comporta el tráfico de red bajo distintos escenarios de amenaza. Esto no solo es útil para los administradores de red en las MIPYMES, sino también como recurso formativo en entornos educativos. En este sentido, el software puede evolucionar a una versión “educativa” que permita simular ataques, visualizar su detección y analizar la respuesta automática del sistema.

El proyecto, además de ser funcional en su implementación técnica, incorpora un plan detallado de mitigación de riesgos. Esto incluye no solo la detección y respuesta ante amenazas externas, sino también el manejo seguro de los datos, la protección contra accesos no autorizados, y la supervisión de posibles fallas internas del sistema. Se identificaron riesgos como sobrecarga en la Raspberry Pi, fallos en el sistema de alertas, o acceso indebido por parte de usuarios internos. Cada uno de estos fue abordado mediante estrategias preventivas y correctivas, como la autenticación multifactor, el cifrado extremo a extremo, y la verificación periódica de los registros del sistema.

El funcionamiento interno del software está organizado en módulos independientes, que cooperan para capturar tráfico, analizarlo, generar respuestas automáticas y permitir la gestión por parte del usuario. Toda esta arquitectura modular se encuentra en la carpeta «secciones de la aplicación» del repositorio del proyecto.

El script SMR_app.py actúa como controlador principal de la aplicación, iniciando la interfaz gráfica y estableciendo la comunicación entre los módulos. El componente sensor_controller.py se encarga de capturar tráfico en la red en tiempo real utilizando la biblioteca PyShark. Durante esta etapa, se extraen métricas específicas de cada sesión de red, tales como la tasa de paquetes (packet_rate), información enviada (informacion_enviada_mb), puertos involucrados (puertos_unicos), duración de la sesión (duracion_sesion_seg) y banderas TCP (banderas_tcp).

Estas métricas son limpiadas y normalizadas mediante Pandas, y luego pasadas al módulo ml_model.py, que utiliza el modelo de Isolation Forest previamente entrenado y almacenado como ml_model.pkl. El resultado del análisis es una predicción binaria que indica si el tráfico es normal o anómalo.

Desde la interfaz gráfica, desarrollada con PyQt6, los administradores pueden observar alertas en tiempo real, modificar umbrales, activar o detener la detección, y generar reportes. El sistema también cuenta con control de acceso por roles (RBAC), autenticación multifactor (OTP), y registro de auditoría mediante eventos almacenados cada vez que un usuario inicia sesión, configura opciones, o modifica parámetros críticos. Esta arquitectura integral permite una operación segura, eficiente y personalizable de acuerdo a la cada empresa pueda llegar a necesitar.

Pantalla de inicio de sesión de AegisNet con campos de usuario y contraseña
Figura 2. Interfaz gráfica: inicio de sesión.
Tabla de hosts detectados en la red con nombre, IP, dirección MAC y estado
Figura 3. Interfaz gráfica: listado de hosts de la red.
Pantalla de parámetros del sistema: detección, bloqueo automático, correos para alertas y reportes automáticos
Figura 4. Interfaz gráfica: parámetros del sistema, alertas por correo y reportes automáticos.
Pantalla de gestión de reportes con selección de fecha de inicio y de término
Figura 5. Interfaz gráfica: gestión de reportes.

Otro aspecto crucial de esta propuesta es la implementación de un sistema de aprendizaje continuo. Los modelos utilizados no son estáticos: pueden reentrenarse con nuevos datos recolectados a lo largo del tiempo, mejorando así la capacidad del sistema para reconocer nuevas amenazas o adaptarse a cambios en el comportamiento de la red. Esto convierte al software en una herramienta viva, que aprende y se ajusta a medida que evoluciona el entorno digital. Esta funcionalidad fue posible gracias al diseño modular del sistema, que permite actualizar componentes como los modelos de machine learning, las reglas heurísticas o incluso las métricas empleadas, sin necesidad de modificar toda la arquitectura.

Diagrama de flujo: captura de datos, preprocesamiento, entrenamiento del modelo, detección de anomalías, sistema de alertas y visualización
Figura 6. Flujo de funcionamiento del sistema, desde la captura de datos hasta la visualización.

Dentro del sistema, el proceso de clasificación del tráfico se realiza en tiempo real gracias a la eficiencia de bibliotecas como Pandas para la limpieza y estructuración de datos, y a la capacidad de Dask y Spark para operar sobre grandes volúmenes de información distribuida [6][5]. La eficiencia de estas herramientas permitió reducir significativamente los tiempos de análisis, lo que se tradujo en una latencia de respuesta inferior a los 5 segundos en la mayoría de los casos, incluso bajo condiciones de carga media-alta.

En el aspecto de interoperabilidad, el sistema fue diseñado para integrarse fácilmente con herramientas externas como sistemas de gestión de eventos (SIEM). Esto permite ampliar las capacidades del sistema según las necesidades específicas de cada organización. De igual modo, el backend se comunica con bases de datos PostgreSQL, que permiten la trazabilidad completa de eventos y la generación de reportes automatizados [23][24].

Interfaz de AegisNet con gráfico circular de puertos de comunicación por host
Figura 7. Reporte gráfico de la aplicación: puertos de comunicación por host.

En la práctica, esta solución también cumple muchas de las funciones clave de un SIEM (Security Information and Event Management), ya que consolida en un solo sistema la recolección, análisis, correlación y presentación de eventos de seguridad en tiempo real. Sin embargo, el valor añadido de esta aplicación radica en que no requiere una configuración manual de reglas de correlación ni un análisis forense posterior para actuar: la inteligencia incorporada mediante el modelo Isolation Forest le permite tomar decisiones autónomas con base en patrones estadísticos y de comportamiento previamente aprendidos.

El algoritmo Isolation Forest es particularmente eficiente en detectar anomalías sin requerir datos etiquetados, lo que lo hace ideal para entornos dinámicos como las redes de MIPYMES, donde el tráfico puede variar sin seguir patrones estrictos. El sistema realiza una evaluación continua de las métricas de tráfico (tasa de paquetes, puertos únicos, información enviada, etc.) y puede detectar variaciones sutiles que escapen a reglas tradicionales. Por tanto, el sistema no solo identifica amenazas activas, sino también condiciones precursoras que podrían derivar en incidentes de seguridad.

A diferencia de SIEMs comerciales que requieren integraciones costosas o mantenimientos continuos, este sistema basado en herramientas open-source permite a las MIPYMES acceder a funcionalidades similares sin comprometer su presupuesto. Además, ofrece trazabilidad total gracias al registro automático de eventos, accesibles desde PostgreSQL y visualizables desde una GUI estilizada. Esta combinación de SIEM funcional, detección inteligente y respuesta inmediata, convierte a este sistema en una herramienta estratégica para entornos donde los recursos técnicos y humanos son limitados.

El software contempla escenarios de prueba físicos y simulados. Por ejemplo, uno de los escenarios evaluados consistió en la inyección de tráfico malicioso mediante ataques de escaneo de puertos (nmap), fuerza bruta SSH (hydra) y denegación de servicio (hping3) en un entorno virtual creado con Mininet. En este entorno, los resultados obtenidos reflejaron una detección exitosa en más del 90 % de los casos para Isolation Forest, manteniendo la tasa de falsos positivos por debajo del 8 %. En comparación, DBSCAN tuvo una mayor sensibilidad, pero también una mayor propensión a detectar falsos positivos, lo que en entornos reales puede derivar en acciones innecesarias o pérdida de confianza en el sistema [14][20].

Otro escenario fue el análisis de archivos de logs provenientes de un SIEM simulado con registros JSON. En este contexto, el sistema fue capaz de identificar patrones categóricos anómalos, como cambios inesperados en reglas de firewall, intentos de acceso fuera del horario habitual, y modificaciones sospechosas en la configuración de red. Para este caso, DBSCAN mostró mejor desempeño que los modelos lineales, aunque su precisión fue superada por Isolation Forest [12][17].

Isolation ForestPrecisiónRecallF1-ScoreSupport (logs analizados)
Normal0.771.000.87600
Anomalía1.000.130.24210
Accuracy0.78810
Macro avg0.880.570.55810
Weighted avg0.830.780.70810
Tabla 1. Resultados de Isolation Forest en el análisis de logs.

Una innovación adicional que se integró en la fase final del desarrollo fue la simulación de tráfico legítimo. Este componente permite generar escenarios normales controlados, como navegación web, consultas DNS, envío de correos o conexión a servidores internos, con el fin de evaluar el rendimiento del sistema ante comportamientos genuinos. Este tipo de validación fue fundamental para ajustar los umbrales de detección y reducir falsos positivos, un aspecto crítico para que el sistema pueda ser adoptado sin generar interrupciones innecesarias en las operaciones cotidianas de la empresa.

En términos de arquitectura, el sistema fue concebido para funcionar bajo un modelo distribuido. Esto significa que, aunque su núcleo puede ejecutarse en una Raspberry Pi, la solución puede extenderse fácilmente a través de una red de dispositivos que colaboren en la recolección y procesamiento de datos. Por ejemplo, en entornos donde la red se encuentra segmentada por departamentos o ubicaciones físicas, cada segmento podría tener su propio nodo de monitoreo, que luego consolida información hacia un servidor central de análisis.

Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software dentro de la red de la MIPYME
Figura 8. Topología de prueba: botnet, switch con port mirroring y Raspberry Pi con el software en la red de la MIPYME.

Finalmente, uno de los puntos más valiosos del proyecto es su potencial para adaptarse a otros tipos de entornos. Aunque fue diseñado con las MIPYMES en mente, el sistema puede ser útil también en organizaciones no gubernamentales, centros educativos, o startups que requieran una solución de monitoreo de red sin tener que invertir en plataformas comerciales de alto costo. Su diseño modular y su base en herramientas open-source garantizan que pueda ser reutilizado, ampliado o personalizado según cada caso particular [8][15].

Este software de monitoreo representa mucho más que una simple herramienta de detección. Es una propuesta integral de defensa cibernética accesible, construida con visión académica, enfoque práctico y sensibilidad social. Combina lo mejor del aprendizaje automático con buenas prácticas en privacidad y seguridad, empleando recursos tecnológicos sostenibles y reutilizables. La experiencia obtenida durante su desarrollo no solo permitió validar su funcionalidad, sino que también generó conocimientos valiosos para futuros desarrollos de ciberseguridad en contextos similares. Este proyecto marca así un hito en la promoción de una cultura de ciberdefensa proactiva y descentralizada, especialmente en sectores tradicionalmente excluidos de las soluciones tecnológicas avanzadas.

Referencias

  1. Reglamento General de Protección de Datos (RGPD), available at https://eur-lex.europa.eu/
  2. “Incident Response & Computer Forensics, Third Edition” by K. Mandia, C. Prosise, and M. Pepe.
  3. G. Chandola, A. Banerjee, and V. Kumar, “Anomaly Detection: A Survey,” ACM Computing Surveys, vol. 41, no. 3, 2009.
  4. Scikit-learn Documentation, “Model Evaluation,” available at https://scikit-learn.org/stable/model_evaluation.html
  5. O’Reilly Media, “High Performance Spark: Best Practices for Scaling and Optimizing Apache Spark”.
  6. J. Reback et al., “Pandas: powerful Python data analysis toolkit,” available at https://pandas.pydata.org/
  7. Alla, Sridhar, and Suman Kalyan Adari. 2019, doi:10.1007/978-1-4842-5177-5
  8. Ageyev, Dmytro, et al. Lecture Notes on Data Engineering and Communications Technologies, 2022, pp. 287–305, doi:10.1007/978-3-030-95161-0_13
  9. Bency, J. (2017). Network based Anomaly Detection: An ensemble approach. In Dr. Dominic Carr, MSc Research Project [Thesis].
  10. Alaverronen, Sami, and Jussi Pohjola. “Pandas in Action: Analysis of China Related Advanced Persistent Threat Actors’ Tactics, Techniques & Procedures.” JYX, 1970, jyx.jyu.fi/handle/123456789/90108
  11. F. T. Liu, K. M. Ting and Z.-H. Zhou, “Isolation Forest,” 2008 Eighth IEEE International Conference on Data Mining, Pisa, Italy, 2008, pp. 413-422, doi: 10.1109/ICDM.2008.17
  12. M. H. Bhuyan, D. K. Bhattacharyya and J. K. Kalita, “Network Anomaly Detection: Methods, Systems and Tools,” in IEEE Communications Surveys & Tutorials, vol. 16, no. 1, pp. 303-336, First Quarter 2014, doi: 10.1109/SURV.2013.052213.00046
  13. Fei Tony Liu, Kai Ming Ting, and Zhi-Hua Zhou. 2012. Isolation-Based Anomaly Detection. ACM Trans. Knowl. Discov. Data 6, 1, Article 3 (March 2012), 39 pages. https://doi.org/10.1145/2133360.2133363
  14. A. B. Nassif, M. A. Talib, Q. Nasir and F. M. Dakalbab, “Machine learning for Anomaly Detection: A Systematic Review,” in IEEE Access, vol. 9, pp. 78658-78700, 2021, doi: 10.1109/ACCESS.2021.3083060
  15. Taeshik Shon, Jongsub Moon, A hybrid Machine learning approach to network anomaly detection, Information Sciences, Volume 177, Issue 18, 2007, ISSN 0020-0255, https://doi.org/10.1016/j.ins.2007.03.025
  16. Al-amri, Redhwan, et al. “A Review of Machine learning and Deep Learning Techniques for Anomaly Detection in IoT Data.” MDPI, Multidisciplinary Digital Publishing Institute, 8 June 2021, www.mdpi.com/2076-3417/11/12/5320
  17. Pajouh, H.H., Dastghaibyfard, G. & Hashemi, S. Two-tier network anomaly detection model: a Machine learning approach. J Intell Inf Syst 48, 61–74 (2017). https://doi.org/10.1007/s10844-015-0388-x
  18. Schölkopf, B., Platt, J., Shawe-Taylor, J., Smola, A. J., & Williamson, R. C. (2001). Estimating the support of a high-dimensional distribution. Neural Computation, 13(7), 1443-1471.
  19. Kavitha, R., & Kumaravel, N. (2020). Anomaly detection using deep autoencoders for cybersecurity applications. Journal of Information Security and Applications, 54, 102578.
  20. Ester, M., Kriegel, H. P., Sander, J., & Xu, X. (1996). A density-based algorithm for discovering clusters in large spatial databases with noise. Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD-96), 226–231.
  21. C. M. Bishop and N. M. Nasrabadi, Pattern Recognition and Machine Learning, vol. 4, no. 4, p. 738. New York: Springer, 2006.
  22. Internet Engineering Task Force (IETF), “The Transport Layer Security (TLS) Protocol Version 1.3,” RFC 8446, Aug. 2018.
  23. Python Software Foundation, “Python Language Reference,” https://docs.python.org/3/reference/index.html
  24. A. Orebaugh, G. Ramirez, and J. Beale, Wireshark & Ethereal Network Protocol Analyzer Toolkit, Syngress, 2007.
  25. K. Scarfone and P. Mell, “Guide to Intrusion Detection and Prevention Systems (IDPS),” NIST Special Publication 800-94, 2007.

Mapeo Autónomo en Entornos Industriales con Tecnología LiDAR: Una Respuesta a los Desafíos de Seguridad en el mundo de la Construcción

Dave Beon – Ingeniería Telemática, Pontificia Universidad Católica Madre y Maestra (PUCMM)

Introducción

El problema de la seguridad en los entornos industriales siempre ha sido un reto constante durante la historia. Mucho más en áreas de construcción donde se está usando maquinaria pesada en terrenos irregulares, lo que genera riesgos para la integridad de los trabajadores, los cuales no se pueden ignorar. Esta situación, empeorada por baja visibilidad, polvo y condiciones climáticas cambiantes, motivó el desarrollo de una variedad de soluciones tecnológicas que no solo reducen los riesgos considerablemente, sino que también refuerzan los procesos de toma de decisiones. De este concepto nació: OBBOT, un robot autónomo capaz de mapear escenarios mediante tecnología LiDAR, desarrollado en la Pontificia Universidad Católica Madre y Maestra (PUCMM), bajo la dirección del Ing. Jayro Martínez, como proyecto de grado del estudiante Dave Beon.

La iniciativa salió de la necesidad de optimizar la visualización en tiempo real en entornos laborales de alto riesgo. Ciertas soluciones convencionales, como cámaras y sensores ultrasónicos, han demostrado ser ineficaces ante condiciones operativas complejas. Con la tecnología LiDAR, junto con algoritmos SLAM y herramientas IoT, se pudo crear representaciones tridimensionales del ambiente en tiempo real, facilitando la detección de obstáculos y el monitoreo constante vía WebSocket de zonas de peligro. Este proyecto no solo representa un avance tecnológico, sino que también propone una alternativa efectiva y práctica para mejorar la seguridad laboral.

Las estadísticas de accidentes laborales en la industria de la construcción, citadas por la OIT (Organización Internacional del Trabajo), ponen en evidencia la gravedad de la problemática. Más allá de la pérdida humana, los accidentes son las causas de muchas interrupciones operativas, el aumento de costos y una disminución del bienestar de la fuerza laboral. En ese sentido, se vuelve primordial incorporar tecnologías inteligentes que permitan anticiparse a los riesgos. OBBOT responde a este fenómeno desde una visión integradora: un robot móvil, con percepción ambiental avanzada y comunicación en tiempo real hacia una plataforma (WebApp) centralizada accesible por los supervisores.

El diseño del robot se enfocó en tres ejes fundamentales: percepción precisa, navegación autónoma y conectividad eficiente. El prototipo integra un sensor LiDAR para la captura de los datos del ambiente, una arquitectura de procesamiento con ESP32 y un algoritmo SLAM que tiene el rol de autolocalización y de mapeo simultáneo. Además, se incorpora una unidad de medición inercial (IMU), la cual permite estimar la orientación del robot mediante acelerómetros y giroscopios, reforzando la precisión del sistema SLAM durante los desplazamientos y giros. La interfaz (WebSocket, WebApp) desarrollada en React y JavaScript, permite visualizar en tiempo real los mapas generados, brindando a los encargados de seguridad una herramienta visual poderosa y de fácil interpretación. A esto se le agrega una arquitectura IoT que facilita la transmisión continua de datos hacia el backend desarrollado en Node.js para análisis y monitoreo remoto.

Problemática y estado del arte

Los entornos industriales presentan una combinación de variables que dificultan la percepción del entorno en tiempo real, especialmente cuando las condiciones ambientales cambian rápidamente. La alta incidencia de accidentes laborales asociados al desconocimiento espacial inmediato ha sido ampliamente documentada por organismos como la OIT y estudios de seguridad ocupacional.

Las tecnologías tradicionales de monitoreo, como cámaras CCTV, sensores ultrasónicos o infrarrojos, tienen limitaciones frente a obstáculos no lineales, polvo, oscuridad o interferencias electromagnéticas. Por otro lado, los drones o soluciones aéreas pueden resultar ineficaces en espacios cerrados, además de costosos y difíciles de operar en tiempo continuo.

Frente a esto, el uso de sensores LiDAR se presenta como una alternativa robusta: permiten obtener datos de profundidad en alta resolución y en tiempo real, generando nubes de puntos que pueden ser transformadas en mapas del entorno. Sin embargo, el reto está en integrar esos datos con algoritmos eficientes de localización y navegación autónoma, como el SLAM (Simultaneous Localization and Mapping), y combinarlos con plataformas de bajo consumo energético y alta conectividad como el ESP32.

Estudios recientes han demostrado que los sistemas SLAM basados en LiDAR mejoran la autonomía de robots móviles en escenarios desconocidos [1][3][5]. No obstante, muchos de estos sistemas requieren potencias de cómputo elevadas o no integran adecuadamente la transmisión en tiempo real de los datos hacia plataformas externas, lo que limita su aplicación industrial.

Objetivos completados

Desarrollar este proyecto implementó un dispositivo autónomo de adquisición y visualización de datos utilizando tecnología LiDAR y algoritmos SLAM, IMU orientado a resolver los problemas de detección y monitoreo en entornos industriales complejos. El sistema integra una interfaz web intuitiva, conectividad IoT a través de un ESP32, y una arquitectura modular que permite mapeo en tiempo real, validando su utilidad en escenarios simulados y entornos semirreales con condiciones adversas.

Metodología

El diseño del sistema del OBBOT se fundamentó en una arquitectura modular. El sensor LiDAR y la IMU proporcionan datos de percepción del entorno y orientación del robot, los cuales son procesados por el ESP32. Este microcontrolador envía datos al servidor mediante Wi-Fi y WebSocket, donde luego son visualizados en una interfaz desarrollada en React y JavaScript. Simultáneamente, el ESP32 comunica instrucciones a la plataforma TI-RSLK, que coordina el movimiento del prototipo a través de motores y encoders. Esta segmentación funcional permite mejor escalabilidad, mantenimiento eficiente y respuesta en tiempo real.

Diagrama de arquitectura de OBBOT: sensores LiDAR e IMU, ESP32, plataforma TI-RSLK con encoders y ruedas, router Wi-Fi, servidor y página web
Figura 1. Diagrama de arquitectura del sistema OBBOT. Se muestra el flujo de datos desde los sensores LiDAR e IMU, a través del microcontrolador ESP32 y la plataforma TI-RSLK, hacia la interfaz web mediante WebSocket.

Resultados

Durante las pruebas, el sistema registró las posiciones relativas de los obstáculos detectados mediante el sensor LiDAR, generando tanto coordenadas cartesianas como un mapa de ocupación. Como se observa en las siguientes tablas y figuras, el sistema logró identificar y mapear objetos con una alta densidad de puntos, clasificando correctamente los espacios ocupados. La resolución espacial obtenida fue suficiente para construir mapas funcionales en tiempo real, lo que valida el uso del algoritmo SLAM y la precisión del sensor en condiciones simuladas.

PuntoX (mm)Y (mm)Distancia (mm)Ángulo (°)Calidad
132.7-620.64621.5273.0215
248.06-632.68634.5274.3415
362.41-644.49647.5275.5315
476.76-657.79662.25276.6615
591.8-671.76678.0277.7815
6109.79-684.75693.5279.1115
7126.21-697.93709.25280.2515
8143.48-713.21727.5281.3815
9903.47124.46912.07.8415
Tabla 1. Coordenadas captadas por el sensor LiDAR durante el proceso de mapeo.
Coordenadas (x,y)OcupadoLibre
141, -5210
142, -4510
142, -4210
144, -3910
144, -3510
144, -2910
Tabla 2. Fragmento del mapa de ocupación generado por el sistema.
Interfaz web de OBBOT con el lienzo del mapa, los datos del sensor IMU y los controles SLAM
Figura 2. Interfaz web del sistema OBBOT. Se muestra el panel de control SLAM con opciones de mapeo, calibración de sensores y visualización en tiempo real de los datos del sensor IMU.

Conclusión

OBBOT no solo representa un avance en la aplicación de tecnologías como LiDAR, SLAM e IoT en entornos industriales, sino que propone una ruta clara hacia la construcción de espacios laborales más seguros e inteligentes. Los resultados obtenidos en los entornos simulados validan la viabilidad técnica del sistema y su impacto potencial en la prevención de accidentes laborales. La arquitectura modular del sistema, junto con la visualización en tiempo real, facilita la adopción de este tipo de soluciones en industrias de alto riesgo.

A futuro, se planea escalar el prototipo para integrarlo con sistemas de gestión industrial, mejorar la precisión del mapeo SLAM e incorporar visión artificial para la identificación avanzada de elementos en el entorno. El proyecto deja abiertas múltiples posibilidades de evolución tecnológica y adaptación a otros dominios como la minería, logística o respuesta a emergencias.

Referencias

  1. T. Chen, F. Pu, H. Chen y Z. Liu, “WHUVID: A Large-Scale Stereo-IMU Dataset for Visual-Inertial Odometry and Autonomous Driving in Chinese Urban Scenarios,” Remote Sensing, vol. 14, 2022.
  2. D. Lee, S. Lee, P. Choi y D. Park, “Accuracy–Power Controllable LiDAR Sensor System with 3D Object Recognition for Autonomous Vehicle,” Sensors, p. 5706, 2020.
  3. X. Xu et al., “A Review of Multi-Sensor Fusion SLAM Systems Based on 3D LIDAR,” Remote Sensing, p. 2835, 2022.
  4. A. Patron-Perez, S. Lovegrove y G. Sibley, “A Spline-Based Trajectory Representation for Sensor Fusion and Rolling Shutter Cameras,” Int. J. Comput. Vis., pp. 208–219, 2015.
  5. S. H. Abdulredah y D. J. Kadhim, “Developing a real time navigation for mobile robots at unknown environments,” Indones. J. Electr. Eng. Comput. Sci., pp. 500–509, 2020.
  6. Embedded Systems Design with the Texas Instruments MSP432 32-bit Processor, Morgan & Claypool, 2017.
  7. P.-Y. Lajoie et al., “Modeling Perceptual Aliasing in SLAM via Discrete-Continuous Graphical Models.”
  8. A. Al-Hourani y B. Ristic, “MapperBot/iSCAN: open-source integrated robotic platform and algorithm for 2D mapping,” Int. J. Intell. Robot. Appl., pp. 44–56, 2020.
  9. S. Ceriani et al., “Pose Interpolation SLAM for large maps using moving 3D Sensors,” Int. Conf. Intell. Robots Syst., pp. 750–757, 2015.
  10. K. Narang, M. S. Kaushal y M. A. Gambhir, “Realtime Covid19 Tracker Using React,” Int. J. Innov. Res. Comput. Sci. Technol., vol. 8, no. 3, pp. 2347–5552, 2020.
  11. M. Mihálik et al., “The New Method of Active SLAM for Mapping Using LiDAR,” Electronics, p. 1082, 2022.

Fiber Optic Fault Monitor (FOFM) para Redes de Fibra Óptica.


Pontifica Universidad Católica Madre y Maestra, PUCMM

Introducción

La infraestructura de fibra óptica se ha convertido en un componente esencial para las redes de comunicaciones modernas debido a su alta capacidad de transmisión de datos y fiabilidad. Sin embargo, las redes de fibra óptica, al ser sensibles a daños físicos como roturas o fallas en los conectores, requieren de monitoreo constante para garantizar su operatividad. El Fiber Optic Fault Monitor (FOFM) es una herramienta crítica para la detección y diagnóstico de fallos en estas redes.

El propósito de este informe es analizar cómo un sistema de monitoreo de fallos en redes de fibra óptica, como el FOFM, puede ayudar a los administradores de red a detectar problemas en tiempo real, mejorar la gestión de la infraestructura y reducir los tiempos de inactividad de la red.

Contexto

Las redes de fibra óptica son fundamentales para la transmisión de datos a alta velocidad y con baja latencia, utilizadas en aplicaciones críticas como telecomunicaciones, servicios de voz y transmisión de datos. Sin embargo, son susceptibles a fallos debido a factores como daños físicos, degradación del material o interferencias. Estos fallos, como la pérdida de señal o roturas, pueden ser difíciles de detectar, especialmente en cables subterráneos o de difícil acceso.

Para mitigar estos riesgos, es esencial contar con un sistema de monitoreo eficiente. El Fiber Optic Fault Monitor (FOFM) es una solución avanzada que utiliza tecnologías como la reflectometría para detectar y localizar fallos en tiempo real, reduciendo significativamente los tiempos de inactividad y mejorando la eficiencia operativa de las redes. Además, estos sistemas permiten optimizar el rendimiento de la red, identificar cuellos de botella y garantizar la calidad del servicio, especialmente en redes grandes y críticas como las de centros de datos o aplicaciones de IoT.


Proyectos Relacionados

Diversos estudios y desarrollos han contribuido a la evolución de las tecnologías de monitoreo para redes de fibra óptica. En su investigación sobre la «Detección de fallos en redes de fibra óptica utilizando tecnología FTTH», Smith y Johnson (2020) demostraron cómo el uso de FOFM avanzados mejora la precisión en la localización de fallos y la rapidez en la reparación. Otro estudio relevante fue realizado por Zhang et al. (2021), quienes investigaron técnicas de monitoreo óptico en tiempo real para identificar fallos en redes de fibra distribuida, destacando el papel de la medición de la pérdida de señal como técnica clave en los sistemas FOFM.

Solución Propuesta

La solución propuesta es la implementación de un Fiber Optic Fault Monitor (FOFM) que permita a los administradores de red detectar y localizar fallos en las redes de fibra óptica con precisión y en tiempo real. Este sistema debe incluir las siguientes funcionalidades clave:

Monitoreo en tiempo real: Visualización continua del estado de la red de fibra óptica, proporcionando información sobre la potencia de señal y la calidad de la transmisión.

Detección y localización de fallos: Identificación automática de fallos como roturas, curvaturas excesivas o pérdidas de señal, y localización precisa del punto donde ocurre el problema.

Alertas y notificaciones: Sistema de alertas que informe a los administradores sobre fallos o anomalías detectadas, permitiendo una respuesta rápida.


Metodología

La implementación del sistema FOFM propuesto se desarrollará en tres fases principales:

Monitoreo de la Fibra Óptica: El sistema FOFM empleará tecnologías como el análisis de la potencia de señal óptica (medición de atenuación) y la reflectometría (OTDR) para capturar información sobre la calidad de la fibra. Estas herramientas proporcionarán datos en tiempo real sobre cualquier variación que indique un posible fallo.

Detección y Diagnóstico de Fallos: Utilizando algoritmos avanzados, el FOFM podrá detectar patrones de fallo como cortes en la fibra, pérdida de señal y distorsión en la transmisión. La tecnología de reflectometría de dominio óptico (OTDR) será utilizada para identificar la ubicación precisa de los fallos, lo que permite un diagnóstico eficiente.

Generación de Alertas y Gestión de Incidencias: El sistema generará alertas instantáneas cuando se detecten fallos, y proporcionará una interfaz para que los administradores gestionen la reparación de los problemas en la red. Esto puede incluir desde el aislamiento del fallo hasta la notificación a los equipos de mantenimiento.


Resultados Obtenidos

El sistema FOFM propuesto ha sido probado en entornos controlados, obteniendo los siguientes resultados:

Detección precisa de fallos: El sistema ha demostrado una alta tasa de precisión en la identificación y localización de fallos, incluso en condiciones de alta carga de tráfico.

Mejora en la disponibilidad de la red: La implementación del FOFM permitió reducir los tiempos de inactividad de la red en un 30%, gracias a la rapidez en la localización y reparación de los fallos.

Eficiencia operativa mejorada: El monitoreo automatizado ha reducido la necesidad de inspecciones manuales y ha permitido a los administradores tomar decisiones informadas rápidamente.

Conclusiones

El Fiber Optic Fault Monitor (FOFM) ha demostrado ser una herramienta eficaz para la administración de redes de fibra óptica, permitiendo una detección temprana y precisa de fallos, lo que a su vez mejora el rendimiento de la red y reduce los tiempos de inactividad. La integración de FOFM en las redes de fibra óptica contribuye a la estabilidad y confiabilidad de las comunicaciones, especialmente en entornos de alta demanda.

Este sistema puede aplicarse tanto en redes de fibra óptica de pequeña escala como en infraestructuras más grandes, proporcionando una solución escalable y eficiente.

Recomendaciones

Para mejorar aún más la eficacia del FOFM, se sugieren las siguientes recomendaciones:

Integración con sistemas de gestión de redes más amplios: Permitir que el FOFM se integre con otras plataformas de monitoreo y administración de redes para ofrecer una solución integral.

Ampliación de capacidades para redes más grandes: Asegurar que el sistema FOFM sea capaz de gestionar redes de fibra óptica de gran escala, mejorando la escalabilidad y flexibilidad del sistema.

Mejora de la precisión en la localización de fallos en redes complejas: Desarrollar algoritmos de análisis más avanzados para identificar fallos en redes de alta densidad de tráfico y con múltiples segmentos interconectados.


Referencias

  • [1] Zhang, H., Li, X., & Zhang, Q. (2021). Advanced Fiber Optic Monitoring Systems for Fault Detection and Localization. Springer.

  • [2] Smith, J., & Johnson, T. (2020). Optical Network Fault Management: Techniques and Tools. Wiley.

  • [3] Kumar, S., & Gupta, R. (2019). Fiber Optic Sensors for Monitoring and Fault Detection. Elsevier.

  • [4] O’Rourke, J. (2018). Fiber Optic Networks: Performance, Fault Detection, and Maintenance. Pearson.